神经语幽灵
AI 2027が提唱した神経語再帰はAIをベクトルで思考させ、読み解けなくするが、OpenAIの首席科学者Pachockiは実現していないと応じた。
日本語
コピー
……

一、満を持して登場:我々は神経語再帰を作り出した。古典SF『神経語再帰を作るな』より
AI 2027 の公開後に起きた公開討論で、我々が読者を誤導したという批判があった。我々が「神経語再帰」——AI が危険なことを考えていると気づかれずに思考できるようにする仮想技術——を提示したからだ。
 (出典)
今月初めに何が起きたか、絶対に想像できないだろう!
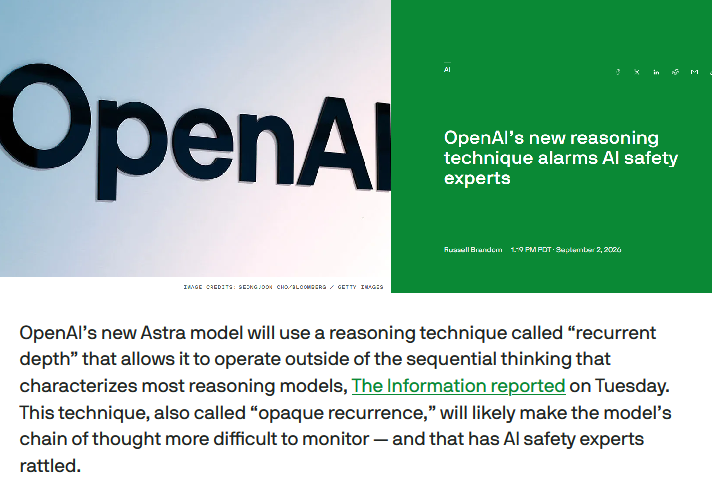 (出典)
だが再帰とは何か。AI 2027 の神経語再帰と同じものなのか。どれほど心配すべきなのか。
Transformer は現在のほとんどの AI を支える技術で、複数の層からなる(現代のフロンティアモデルではおよそ 100 層)。慣例として、入力層を「底」、出力層を「頂上」と呼ぶ。Transformer が次語予測を行うとき、最後の語を底から入力し、中間の各層で処理し、「頂上」で予測される次の語を出力する。
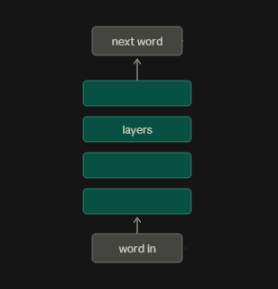 100 層を超える計算が必要な難題を処理しなければならないとしたら? 2017 年から 2024 年まで、答えは「お手上げ」だった。2024 年以降の答えはこうだ。中間結果を「思考の連鎖」と呼ばれる草稿用紙にテキストとして出力し、その中間結果を再び transformer に通す。これを最終結果が得られるまで繰り返す。
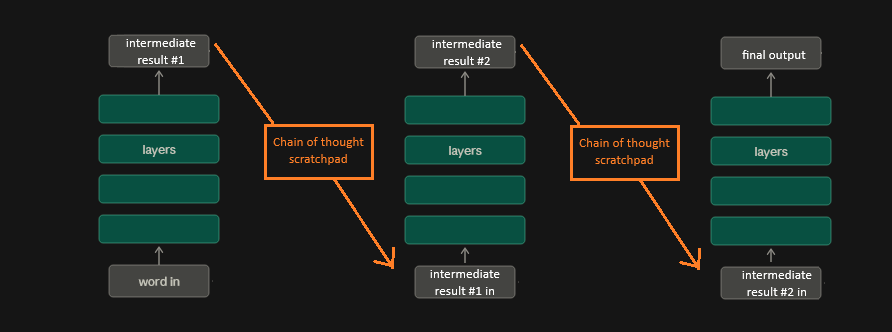 図にはループが三つ描かれているが、現実には数千に及ぶこともある。
(なぜ草稿用紙が必要で、中間結果をそのままユーザー出力に詰め込んで自分に読み戻すのではだめなのか。第一に、中間結果は数百ページに及ぶことがあり、ユーザーは読みたくない。第二に、AI 企業は AI が中間思考を正しく行うよう訓練したいが、それには「中間で考えること」と「最終的にユーザーへ出力すること」の間に「心理的」な区別を設けることが不可欠だ。)
これは純粋に能力のためだ——モデルは 100 ステップの計算に縛られず思考を続けられるほうが賢くなる——だが、たまたま安全性にとって非常に有利に働く。思考の連鎖の草稿用紙は英語で書かれる(ただし中国のモデルには中英混在のものもあり、別の AI は独自の奇妙な隠語を発達させる)。AI が何を考えているかは、そのまま読めばいい! AI が「いくつかサイトをハッキングして人類を皆殺しにするのが最善だ」と考えていれば、電源を切れる。実際には無理かもしれない——数千の AI が数百万ページの草稿を書いていれば、すべてをリアルタイムで読み切ることなどできず、タスクはミスを犯す AI 監視者に任せるしかない。だが理論上はうまくいくはずだ。
しかし言語は思考より遅く、浅い。100 ステップにわたって、AI は光速で層から層へ精妙な考えを伝えられる。だが必ずどこかのステップで、その考えを紀元前 1800 年にフェニキアのトルコ石鉱夫が発明した 26 文字に符号化しなければならない。そしてそのフェニキア文字を再び光速の精妙な考えに符号化し直してから、次の作業に移る。これが現行の transformer のボトルネックであることは以前から広く認められている。ならばこう考えられないか。100 層の思考を先に済ませ、そこで生じた考えを、その考えを書いたテキストの草稿ではなく、第一層に送り返して処理を続けたらどうなるか?
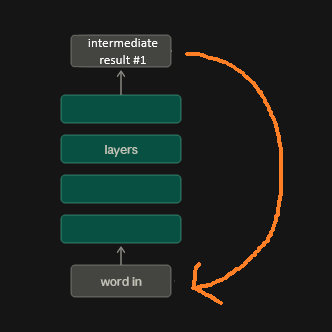
これが神経語再帰(neuralese recurrence)だ。「再帰」なのは前へループして戻るからであり、「神経語」なのはループするものが思考そのもの、すなわち言葉ではなく思考の母語で存在する考えだからだ。
AI の「思考の言語」は数千個の数値からなるベクトルのように見える。この方式では、一つの「中間結果」は (0.4, 0.1, 5, 0.443, ……と数千個の数値)という形をとる。我々はそれをどう読むか分かっていない。こうした考えを解読する科学は AI 解釈可能性の一分野であり、まだ黎明期にある。神経語再帰を備えた AI が「いくつかサイトをハッキングして人類を皆殺しにするのが最善だ」と考えていれば、それは (0.4, 0.1, 5, 0.443, ……と数千個の数値)として現れ、我々は永遠に気づかない。だからこそ AI 2027 はこれを、AI が人間の監視から逃れられるようになる前触れとして論じている。
II. Pachocki 対 Specter
では OpenAI はそれをやったのか。彼らのチーフサイエンティスト Jakub Pachocki は「やっていない」と言う。
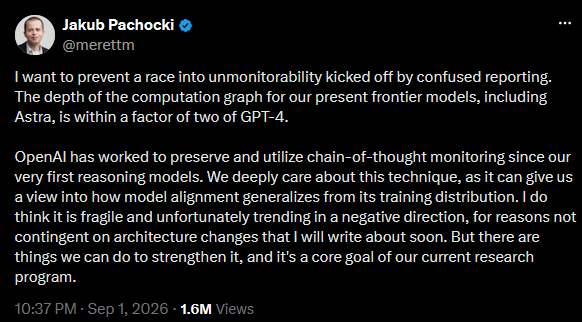
Pachocki の言う「計算グラフの深さ……GPT-4 の二倍以内」とはどういう意味か。これでアラインメントの懸念は消えるのか。
我々の例の transformer には緑の層が四つある。層の深さは四だ。
ここで少し再帰を加える。第 3 層は第 4 層へ向かわず、第 2 層へループして戻り、データはこのループを三回通ってから最後に第 4 層へ入る。
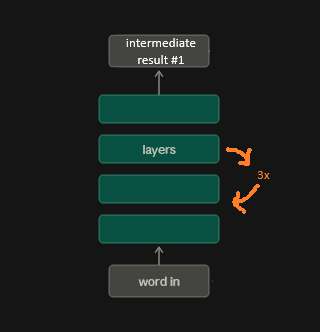
ここではデータは八層の処理を通る。1 → 2 → 3 → 2 → 3 → 2 → 3 → 4。つまりこのループ transformer の深さは八だ。
この意味では、「ループ」は恐ろしく聞こえるが、最初から八層の transformer を組むより悪いわけではない——後者は常に選択肢だった。
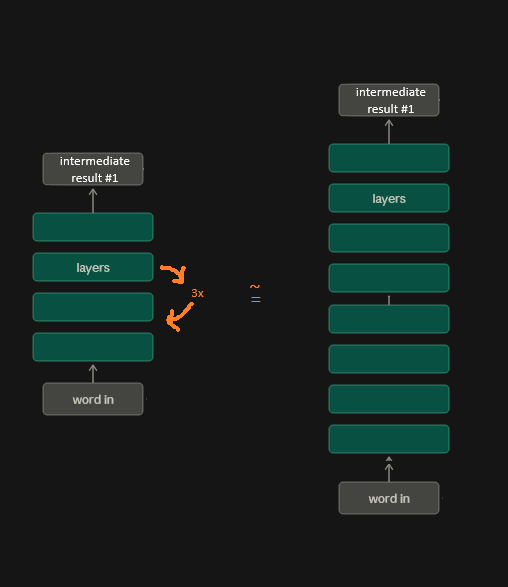
つまりアラインメントの観点から言えば、邪悪な計画を思いつくのに1000層分の計算が必要だとしよう。普通のAIは100層までしか考えられないが、その後は出力を思考の連鎖に書き出さなければならない——「これが私が企てている邪悪な計画の10分の1だ」という具合に——だから我々はそれを見つけられる。つまり、モデルに下書き用紙を使わせずに1000層分を一気に計算させたくはない。これは100層のループを10回回す再帰モデルを作るなという意味であり、最初から1000層のモデルを作るなという意味でもある。
だからPachockiがAstraの深さはGPT-4の2倍にすぎないと言うとき、彼の言いたいことはおおよそこうだ——我々は何年もかけてAIに層を積み重ねてきた。GPT-2は48層、GPT-3は96層、GPT-4が何層かは教えていないが120層だとしておこう。その間お前たちは文句を言わなかった。それは「ループ」ではなく、ごく普通の、自然な120層だったからだ。今度のAstraは——まあ——180層だ。確かにこの余分な層は、より大きなtransformerを実際に組み上げたのではなくループで得たものだが、アラインメントへの影響に違いはない。もしかしたらAnthropicは昨日、本当に180層のtransformerを組み上げていたかもしれないが、お前たちは彼ら1を責めに行かなかった。重要なのは、我々が層数をとんでもない桁まで増やしていないということで、実際に増やしていない。我々は他の多くのAIアーキテクチャと同じように層を増やしているだけで、手段が違うにすぎない。
この論証はどれほど持つのか。
III. 神のご加護のもと、Transformerの層を理解しよう
ここまで読んで、私の疑問はこうだ——なぜ単純に全層を100万回ループさせて、そうしない間抜けの100万倍の計算深度を持つAIを得ないのか?ただで手に入る能力ではないか?
Astraのような再帰transformerモデルは、ループを層数を増やすためのハックとして使っている。このハックは、実際に層を増やすほど良くはない。本当に追加された1層は、AIに知識と思考法を蓄えるためのより多くの「余地」を与える。ループする1層は、AIに同じ知識と思考法をもう何度か使わせるだけだ。
それが無意味どころではない。数学者は何年も同じ問題を考え続けて、ようやく解けることがある。その間ずっと同じ思考法(彼の脳が扱える数学の知識と技術)を使っている。それでも、1年考えることが1分考えるより優れている場合がある。
だがこれも最適解ではない。より多くの実層を持つAIは、従来の意味で確かに「賢く」なれる。同じ数学者にもっと考える時間を与えるのは助けになるかもしれないが、総時間が同じなら、より訓練された賢い数学者に問題を渡すほうが助けになる。
私はFableに、3つの場合の相対的な能力向上を「世代」(たとえばGPT-4からGPT-5)単位で見積もらせた。
- chain-of-thoughtを使う(ベースライン)
- ループで「模擬」層数を倍にする。
- 「実」層数を倍にする。
答えは0、+0.03、+0.252で、タスクの種類によって大きく変わった。核心的な結論はこうだ——模擬層を増やしても得られる向上は、実層を増やしたときよりずっと小さい。
しかしなぜ層を倍にするだけなのか?層をループさせられるのなら、なぜ100万回ループしないのか?Pachockiは、120層 → chain-of-thoughtの下書き用紙 → さらに120層、というような構造を、240層 → chain-of-thoughtの下書き用紙 → さらに240層、というような構造に置き換えていると言う。だが、最終結果が出るまでAIを無限にループさせ続ければいいのではないか?
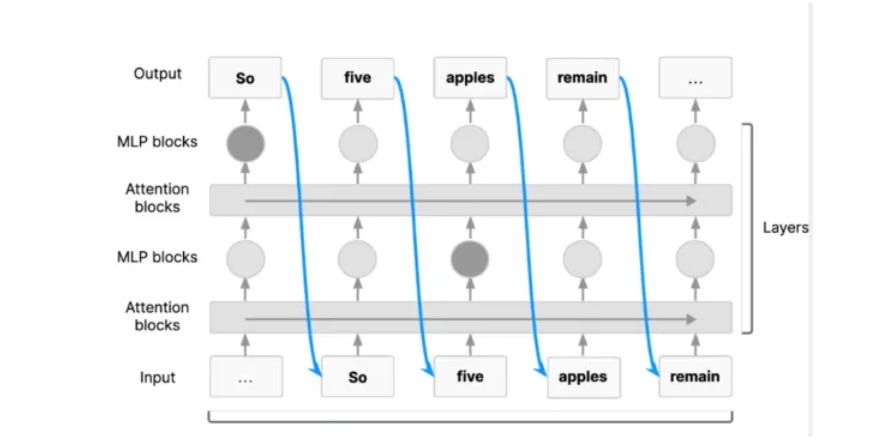
以下はtransformerの処理の模式図だ(出典)。
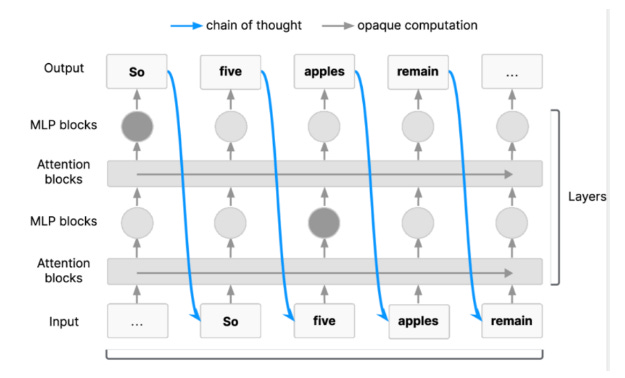
各token(たとえば単語「so」)について、transformerはそれまでの文脈を見て、1回の順伝播(灰色の上向き矢印)を数層にわたって走らせる。そしてこの順伝播を終え、chain-of-thoughtのtokenを1つ出力し(青い曲がった矢印)、新しい文脈(古い文脈に新しいtokenを加えたもの)で次の順伝播を始める。
層を増やせば、AIはchain-of-thoughtのtokenとtokenの間でより多く考えられ、新しいtoken1つあたりの質が上がる。ただし余分な計算コストがかかる。ユーザーの計算予算が限られているなら、AIがchain-of-thoughtのtoken1つに費やす計算が多いほど、生成できるchain-of-thoughtのtokenは少なくなる。計算量が固定なら、chain-of-thoughtのtokenの質と数の間には最適なバランス点があり、OpenAIはそれがループ2〜4回のあたりにあると考えているのだろう——1000回ではなく。
しかしなぜchain-of-thoughtを使うのか?なぜ問題が解けるまで無限にループしないのか?
(上の図で言えば、英語の推論を表す青い矢印を、神経語を表す灰色の矢印に置き換えることにあたる)
AIがそうできるように訓練されれば、この道は成立する。だが今はまだ無理だ。Transformerは人間のテキストで事前学習されている。chain-of-thoughtを使うのは、一つには本物の人間の思考の連鎖を読んだからだ——「うーん、この問題は難しいが、昔微分方程式で解いたことのあるものに似ている気がする。ここで微分方程式を代入してみるか……いや、それはエレガントじゃない……待てよ、もし——」。もう一つには、他の人間の出力を十分に読んだ結果、こうした人間流の考え方が自然になったからだ。しかしインターネット上に、人間の推論過程を純粋なベクトルで記録したテキストは存在しない。だからAIはそれを正しく訓練できない。原理上は致命的ではない——AIの推論はすべてベクトルの中で行われ、訓練の目的はまさにそれを上手くやらせることだ——しかし、ベクトルベースの思考過程を一通り訓練し、それを数千ステップ動かし、途中で人間の思考の連鎖のtokenという中間生成物に一切着地させないのは、コストが見合わない。Transformerを設計する研究者は推測するしかない——chain-of-thoughtがどれくらいの頻度で現れれば、能力を最大化しつつ訓練コストを最小化できるのか。まさにPachockiが否定しているのはこれだ。AI 2027が言う「神経語」とは、研究者が今なおやり方を知らない事柄3——AIを好きなだけループさせ、英語の思考の連鎖を完全に迂回させること——にほかならない。Pachockiの言い分はこうだ——心配するな、我々はまだその方法を知らない。
だが、これで安心できるわけではないと今なら分かる。AIが危険な陰謀を企てるのに、監視されない灰色矢印のステップを1,000回必要とするなら、それを手に入れる方法は2つある。すべての青矢印を灰色矢印に変えてしまうか(これなら全ステップが無監視で、好きなだけ陰謀を練れる)、あるいは層を十分に増やし、2つの青矢印の間の単一の垂直な順伝播の中に1,000ステップを収めるかだ⁴。そんなに多くの実層を作るのは非現実的だが、リカレンスを使えば可能になる。つまり(安全コミュニティが主張するには)Pachockiのリカレントtransformerアーキテクチャでさえ、その道への一歩だということになる。
話はごちゃごちゃしてきたが、要点はこうだ。
- 層数が有限のAIは、陰謀を思考連鎖(chain-of-thought)に書き出さない限り、陰謀を企てることなどできない。
- リカレンスで多数の層を模擬するAI(「リカレントtransformer」)は、単一の順伝播の中で、思考連鎖のステップとステップの間に陰謀を完遂できる。
- 思考連鎖を一切使わなくなったAI(「真の神経語」)は、必要なだけターンを費やして悠々と陰謀を練れる。そして我々はそれを永遠に知ることができない。
これまでのtransformerはすべて(1)に属していた。Astraは部分的に(2)へ向かいつつある。AI 2027の危険なAIは(3)に属するが、現実には誰もそんなAIを発明していない。
IV. 技術的な障壁ではなく、心理的な障壁
脱線はここまでにして、最初の問いに戻ろう。Pachockiは、Astraのリカレンスは競合と比べて層数をほとんど増やしていないと言う。これで彼は「危険なリカレントAIを生み出した」という非難を免れるのか。
この問題について私が読んだ中で最良の記事は、Linchuan ZhangのCategorical Taboos Are Much Better Than Threshold Taboos: Neuralese Editionだ。
Linchはこう言う。AI 2027に出てくるような危険な神経語AIを作ることに対して、禁忌が形成されつつある。この議論に参加する誰もが、その禁忌は正しいことに同意している。唯一の問題は、OpenAIがそれを破ったかどうかだ。
だが禁忌は、その境界が明確で、何が禁忌の範囲内で何が範囲外かがはっきりして初めて機能する。たとえばアメリカでは21歳未満が酒を買うのは違法だ。21歳の誕生日の2日前に酒を買った人がいるとしよう。警察はその人を逮捕すべきか? 明らかに、この年齢差は 本当に 何かを変えるわけではない。我々は年齢を成熟度のようなものの代理指標として使っているが、成熟度には大きな幅があり、20.99歳と21歳の間に本質的な違いはない。それでも、警察が時には見逃すことを選ぶとしても、少なくとも「これは逮捕可能な違法行為だ」という建前は維持しなければならない。なぜか? 仮に具体的な境界を引いて、20.8歳を超えていれば逮捕しないことにしたとしよう。しかしそれでは、明確な線を21歳から20.8歳に下げただけだ。同じ問題が起きる。20.799歳の人が酒を買ったら、警察はまた例外を認めるかどうかを決めなければならない。どうせどこかに線を引くのなら、すでに引くと約束した場所——全員にそこに引くと伝えてある場所——に引けばいい。
(Linch自身の例は核兵器だ。戦争には核を使わないという禁忌がある。誰かが小型核弾頭を使ったとして、その爆発力が通常爆弾と大差ないなら、ある意味では大したことではない。通常爆弾より悪いわけではないからだ。しかし別の意味では重大だ。禁忌を破ってしまえば、その後あなたを超大型核弾頭の使用から引き止めるのは、より弱く曖昧な禁忌だけになるからだ。)
つまり、リカレンスに関する禁忌が欲しいなら、何か具体的な禁忌が必要になる。Pachockiが「ええ、リカレンスはやりましたが、数層だけなので実質問題ありません」と言うのは、飲酒者が警察に「ええ、21歳未満ですが数か月だけなので実質問題ありません」と言うのに似ているし、独裁者が国連に「ええ、核を使いましたが、とても小さいので」と言うのにも似ている。確かに 現実には 大したことではない。だが禁忌を維持できるかどうかという点では、これは重大なのだ。
残念ながら、禁忌が存在するのか、どんな禁忌なのかについて、今のところコンセンサスはない。循環層に対する禁忌があるべきだった(そしてOpenAIがそれを破る)と言う人もいれば、それは彼らがでっち上げたもので、そんな禁忌は最初からなかったと言う人もいる。思考連鎖を一切使わない真のneuraleseについては、おそらく非公式な禁忌がある。だがこれは複数の可動部からなる複雑な技術で、禁忌がどの部品を指すのか誰にもはっきり言えない。そしてそのコンセンサスが欠けているために、一部の部品は隙間からすり抜けてしまうかもしれない。では、どんな選択肢があるか。
第一に、Pachockiとは逆に、リカレンス(「模擬層」の追加)そのものに禁忌を設ける価値があるかもしれない。たとえ「実層」を増やすことには何の禁忌もないとしても。実層の追加はコストが高く、たいてい割に合わない。AI企業はモデルの実深度を年に約20%しか増やしておらず、このペースでは危険な地点に達するまで数十年かかるかもしれない。一方「模擬層」の追加はずっと安く、一度に数百層を詰め込めるし、より危険だ。だから、あの仮想的な実層/模擬層の等価性は無視して、こう主張すべきかもしれない。リカレンスは常に禁忌であり、他の誰かがどこでどれだけ実層を増やしていようと関係ない、と。
第二に、各社は層数の上限(実層または模擬層)を、たとえば1,000層と取り決めることができる。前述の議論からすれば、これはおそらく実層には影響しないが、リカレンスの規模をある上限内に抑えられる。
第三に、研究者は「真の神経語」がどんな要素で構成されるのかを明らかにし、それらをやらないと取り決めることができる。これにはいくつか概念的な下準備が要るが、あらゆる案の中で最も持続的で、AI 2027が懸念するあの具体的な危険技術をほぼ完全に封じるものに最も近い。
「超知能AIの禁止」や「再帰的自己改善の禁止」といった歯切れの悪い試みとは違い、このタブーは政府の強い介入がなくても維持できるかもしれない。少なくとも現時点では、タブーを破ったところで得られる能力の向上は大きくないようで5、危険だけが際立っている。だから「競争の力学」が働き続けていても、自主的なコミットメントで持ちこたえられる可能性がある。
AI企業のリーダーたちは最近、意見の対立を脇に置き、さまざまな意味で「フロンティアのペースを握る」ことに合意した。具体的な意味は後日定義されることになっている。会議の議題には議論すべき項目が長く並んでいるだろうが、もっと有用なことが一つある。このタブーを正式なものにして、私たちが何を避けようとしているのかをはっきりさせておくことだ。
この話題に興味があれば、Redwood Researchのこちらの記事も読んでほしい。関連する概念と技術のいくつかをより詳しく説明している。
1実際には増えていない。層数がかなり速く増えた時期もあったが、その後は鈍化し、「通常の」方法でtransformerに層を追加しても、もはや能力の向上はほとんど見込めないようだ。
2本稿を査読したあるAI研究者は、Fableの推定を「ひどい」と評したが、私の知る限りより良い推定は存在せず、私が示したいのはごく粗い桁の感覚にすぎない。
3COCONUTというアーキテクチャがこれを実現できるが、あまりうまくいかない。
4リカレントtransformerは、思考連鎖トークン間の計算量で陰謀を企てるのに十分かもしれないが、なぜその陰謀は思考連鎖の中に現れないままでいられるのか。ある意味で、AIは思考連鎖に何を書くかを「選択」する——これがAIの「意識的な」選択なのか、それとも人間が無意識に考える内容を決めるのに近いのかは不明だが——訓練のインセンティブがこの選択に影響する。思考連鎖を隠すよう「動機づけられた」AIは隠せる。層数の少ない非リカレントtransformerでは、これを心配する必要はない。思考連鎖から離れるとまともに考えられず、監視者から陰謀を「隠そう」とすれば自分自身からも隠すことになり、うまく考えられなくなるからだ。リカレントtransformerが100番目のトークンで陰謀を企て、それを思考連鎖に書かなかった場合、200番目のトークンでその陰謀をどうやって覚えているのか。すべてのtransformerはKV cacheと呼ばれるものを使い、過去の思考状態にアクセスできる。このキャッシュは層ごとに分かれており、transformerの第1層はKV cacheの第1層しか読めず、以下同様なので、思考連鎖の代わりにはならない。AIがKV cacheを使って複数の順伝播にまたがって同じ陰謀を企て続けることもできない。しかし、100番目のトークンの第356層で計画を完全に思いついていれば、200番目のトークンの第357層でその計画を思い出せる。
少なくとも現時点の理解はこうだ。前述のClaude Fableの推定を参照。ただし一部の研究者は、Astraの能力がそのアーキテクチャから知られている情報で説明できる水準を超えていると考えており、背後で何らかの技巧が能力を底上げしていることを示唆している。Pachockiはリカレントではないと述べたが、OpenAIが手法についてより多くを明かすまで、コミュニティの疑念は残るだろう。