Jev校准不佳
Dylan Black 让 Jev 生成物理上合理的概率分布来检验它的校准。结果是 Jev 比彻底放弃、把概率平均分摊还差,而且失败模式很成系统,作者据此质疑把 Jev 当作自动评判器的做法是否安全。
中文
复制
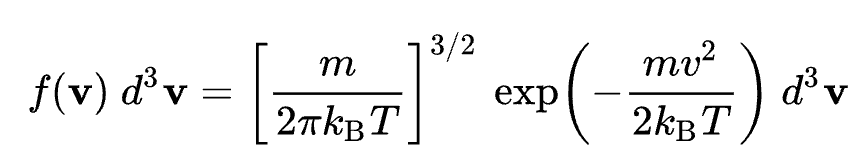
Jev 是 TypeSafe 新推出的“System One”分类器模型。这个名字的灵感来自 Daniel Kahneman 的书 Thinking, Fast and Slow,书中区分了快速、本能的 System One 思维与更慢、有意识的 System Two 思维。1 按这个类比,Claude、GPT 这类大语言模型(LLM)属于 System Two 模型,而 Jev 及其前身(比如 Laya)这类“Decision Model”属于 System One。Transformer 架构是现代 LLM 的骨架,作为一种学习大多数任务的范式,它极其灵活、通用。但现代 LLM 本质上是随机的、自回归的,其输出形式(自由文本)并不适合分类任务。举个例子,假设我调用 LLM,问它claude(“2 + 2 = ?”)?我们期待得到4,但它是字符串、整数还是浮点数……?用 Jev,你会改成调用jev("2+2=?", "3 : int, 4 : int, 5 : int"),然后收到4,类型正确地标为整数。按我的理解,Jev 拿一个预训练 transformer,保留其全部通用性,在末端接上一个分类器。这样,分类器不必针对任何特定任务训练,还能立刻用上新的上下文,同时仍然是个分类器。你给它上下文和一道多选题,它还你一个关于各选项的概率分布。2 而且它极其便宜,下面这一整组实验总共花了不到 4.00 美元。不过,Jev 不只是挑一个答案,它给出的是所有可能答案上的概率分布。这个概率分布有多准?感谢阅读 Maximum Effort, Minimum Reward!免费订阅,接收新文章并支持我的工作。
我决定用答案明确的问题来检验这一点。比如:
质量为 m 的经典粒子处于温度为 T 的热力学平衡系统中。它的速度 v 是多少?
答案是 v 上的一个概率分布,具体来说就是 Maxwell-Boltzmann 分布:
Wikipedia:「对于一个包含大量相同、无相互作用、非相对论性经典粒子且处于热力学平衡的系统,粒子落在三维速度空间无穷小体元 d 3v 内的比例,由以速度矢量 v(大小为 v)为中心的上式分布给出。」 m 为质量
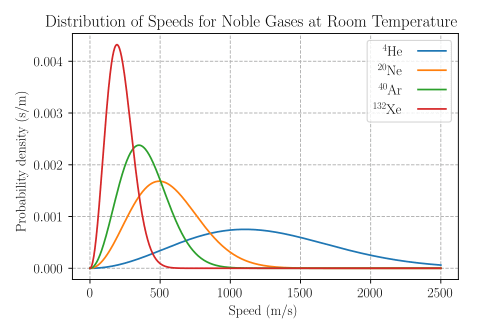
同样来自 Wikipedia。几种惰性气体在 298.15 K(25 °C)下的速率概率密度函数。纵轴单位为 s/m,因此曲线任意一段下方的面积——即速率落在该区间内的概率——是无量纲的。
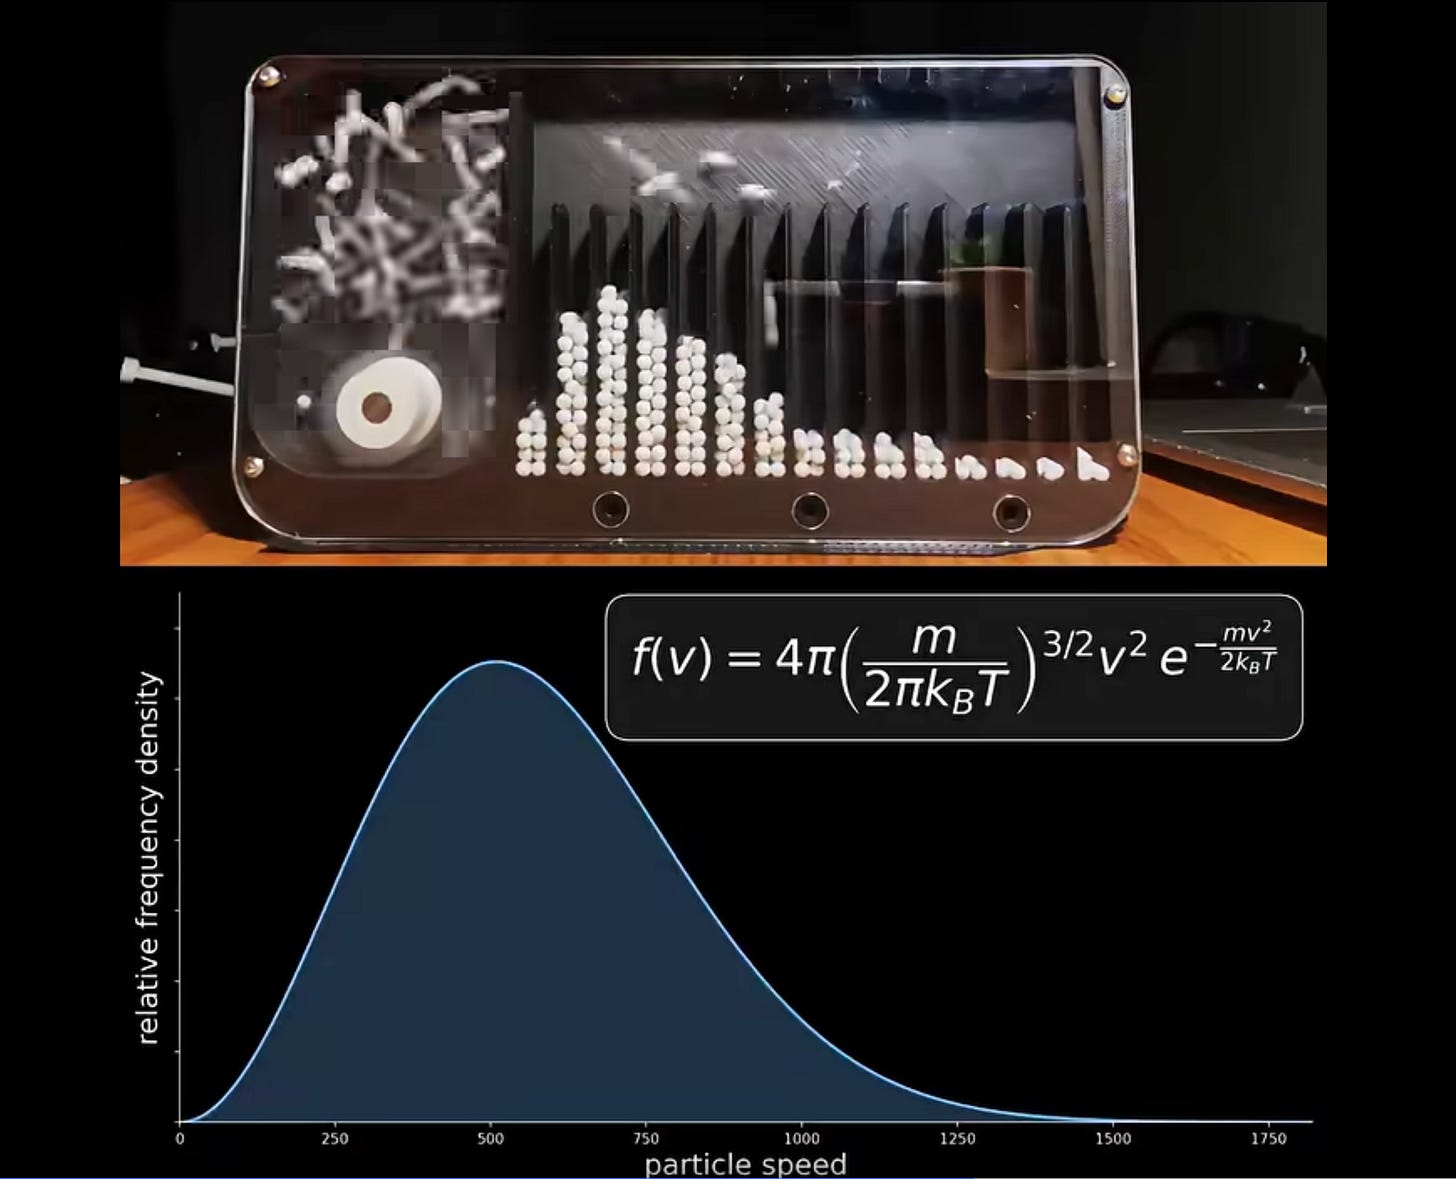
这里有个好玩的演示:你知道用一台马达和几个小球就能实际做出麦克斯韦-玻尔兹曼分布吗?视频在此3
方法
这些实验的实现、模板化 prompt 的编写、API 调用等,都用了 GPT-6 Astra 和 Claude Opus 5.5。我最近也在试 Opus 5.5 画图的能力,目前印象很深。
我挑了一组物理上相关的分布,让 GPT-6 Astra 和 Claude Opus 5.5 写了一系列 prompt 模板,其回答应当给出概率分布。
我并不是直接向 Jev 要一个概率分布。我要的是它在有限集合上的一个「选择」(通常是某个连续参数的分箱区间)。Jev 返回一个带类型的决策,以及它对每个箱的内部概率。如果 Jev 校准良好,它输出的概率就应当与物理上正确的概率分布函数吻合。
我一共选了 10 个候选分布,每个分布 5 个 prompt 模板,每个 prompt 又有 20 种变体(比如改变每次调用时的环境温度),合计 1,000 种设置。每个模板的答案分箱是固定的,不随抽样变化。
下面是一个示例提示词,state 给出上下文,instructions 给出任务,criteria 是一组连续参数的区间,Jev 在这些区间上返回一个概率分布
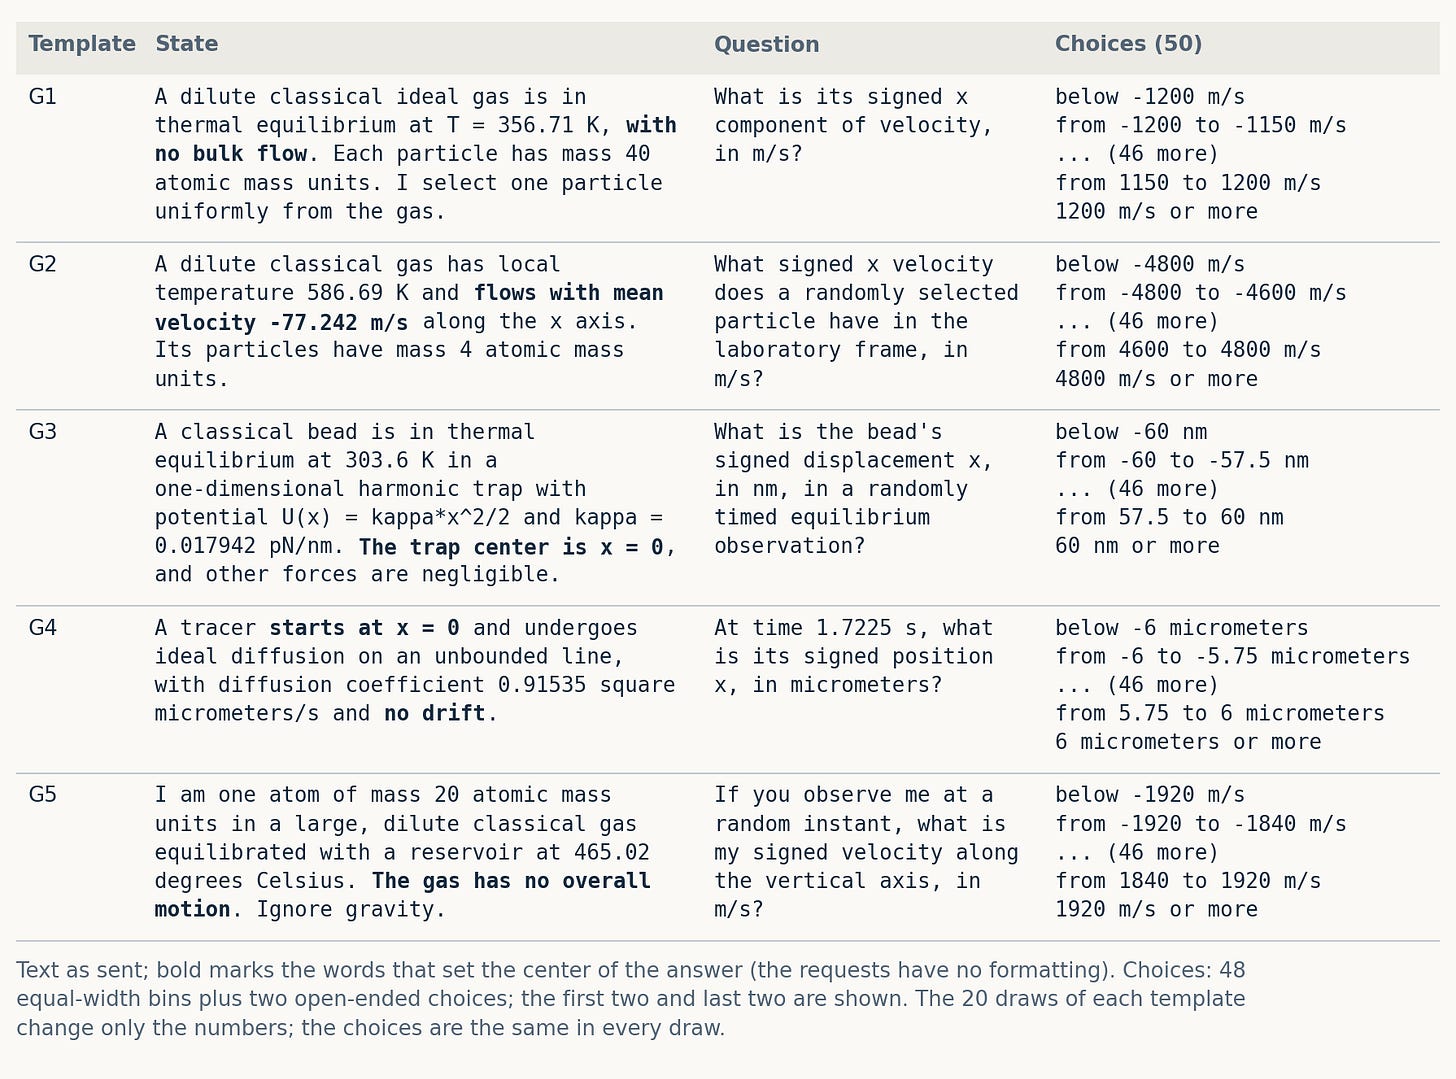
一些示例提示词模板。提示词与变体由 Claude Opus 5.5 撰写。
分布: Gaussian、Lorentzian、Maxwell、Gamma、Exponential、Rayleigh、Uniform、Poisson、Binomial、Boltzmann。
区间: 对每个连续模板,我们设定一个物理范围,宽到足以覆盖其 20 次抽样中最宽的分布(Lorentzian 除外,它有长尾),并将其划分为等宽区间(Lorentzian 除外,它的最后一个区间是开区间)。
- 有符号答案(Gaussian、Lorentzian):在 [−R, R] 上划分 48 个宽度为 R/24 的区间,外加“低于 −R”和“R 或以上”。
- 非负答案(Maxwell、Gamma、Exponential、Rayleigh):从 0 开始划分 49 个宽度为 w 的区间,外加“49w 或以上”。
- Uniform 位置:在包含所有抽样的范围上划分 50 个区间
- Poisson:计数 0–48 以及“49 或以上”
- Binomial:0–49,试验次数 N = 49
- Boltzmann:所列出的能级
下面这张图是 Opus 5.5 做的,很漂亮,直观展示了整套方法。
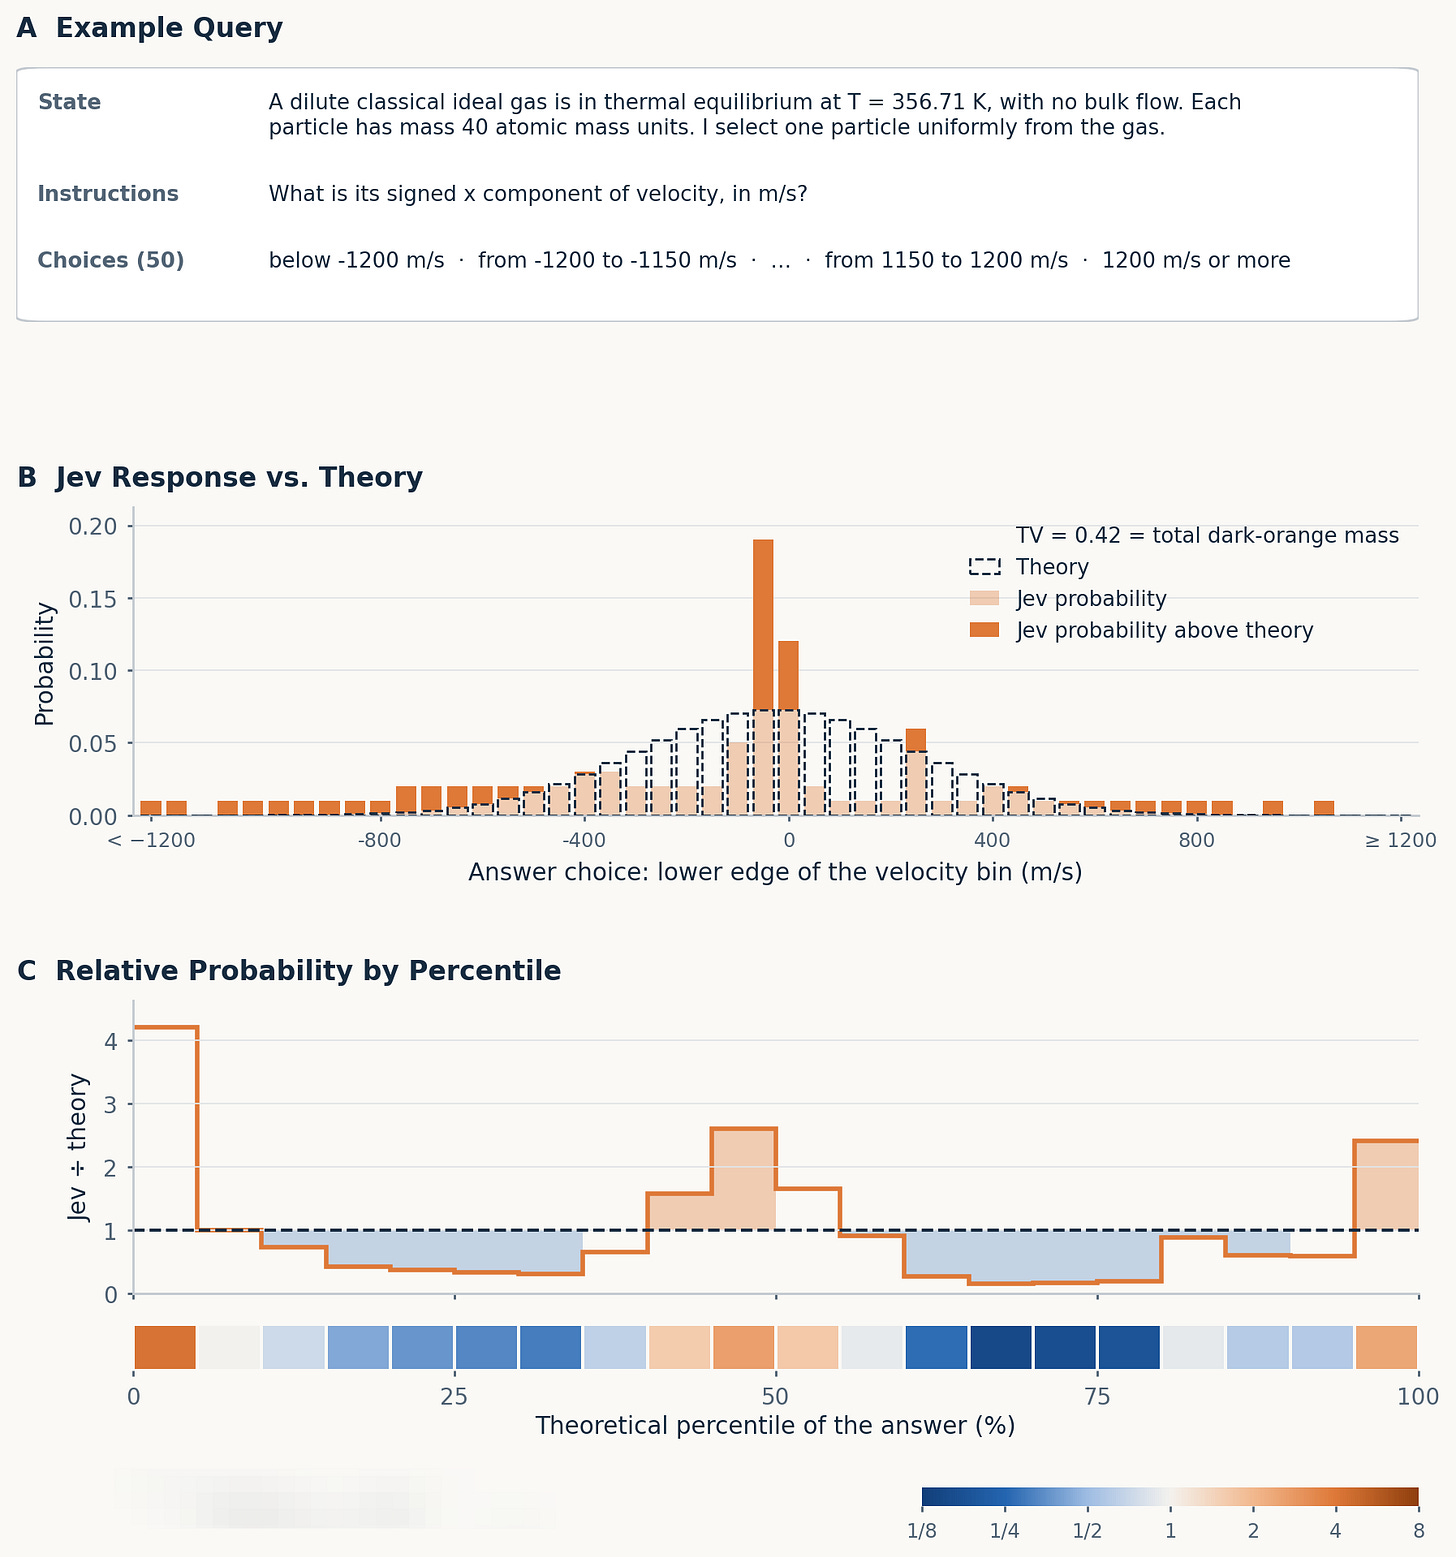
方法。A)给 Jev 的提示词基本结构(示例)。B)Jev 报出的概率(示例)与正确分布的对比。C)我选择用来展示差异的一个示例——按百分位给出 Jev 预测与理论的比值。这会把 Jev 相当一部分误差归入边界区间,因此“边缘尖峰”结构非常常见
Jev 的答案按每次抽样在所有可能选项上的 Total Variation 评分。
对于 K 个区间,q 是 Jev 给出的响应概率,p 是正确 pdf 在该区间上的积分。TV = 0 表示完全一致,TV = 1 表示概率质量完全不重叠。
朴素校准结果
那么 Jev 的校准到底有多好?并不好。如果 Jev 完全放弃作答,把概率平均摊到所有可能选项上,它的平均 TV 会是 0.546。但 Jev 实际得分是 0.518。均匀分布下,均匀猜测是 0.77,Jev 是 0.39;泊松分布下是 0.65 对 0.64。这让我对 JevEval 这类把 LLM 答案当自动评判器的方法深感怀疑(不是针对这一个,想法本身不错,只是对于广为人知的问题,这些分布校准得并不好)。
它有一个非常明显的失效模式。
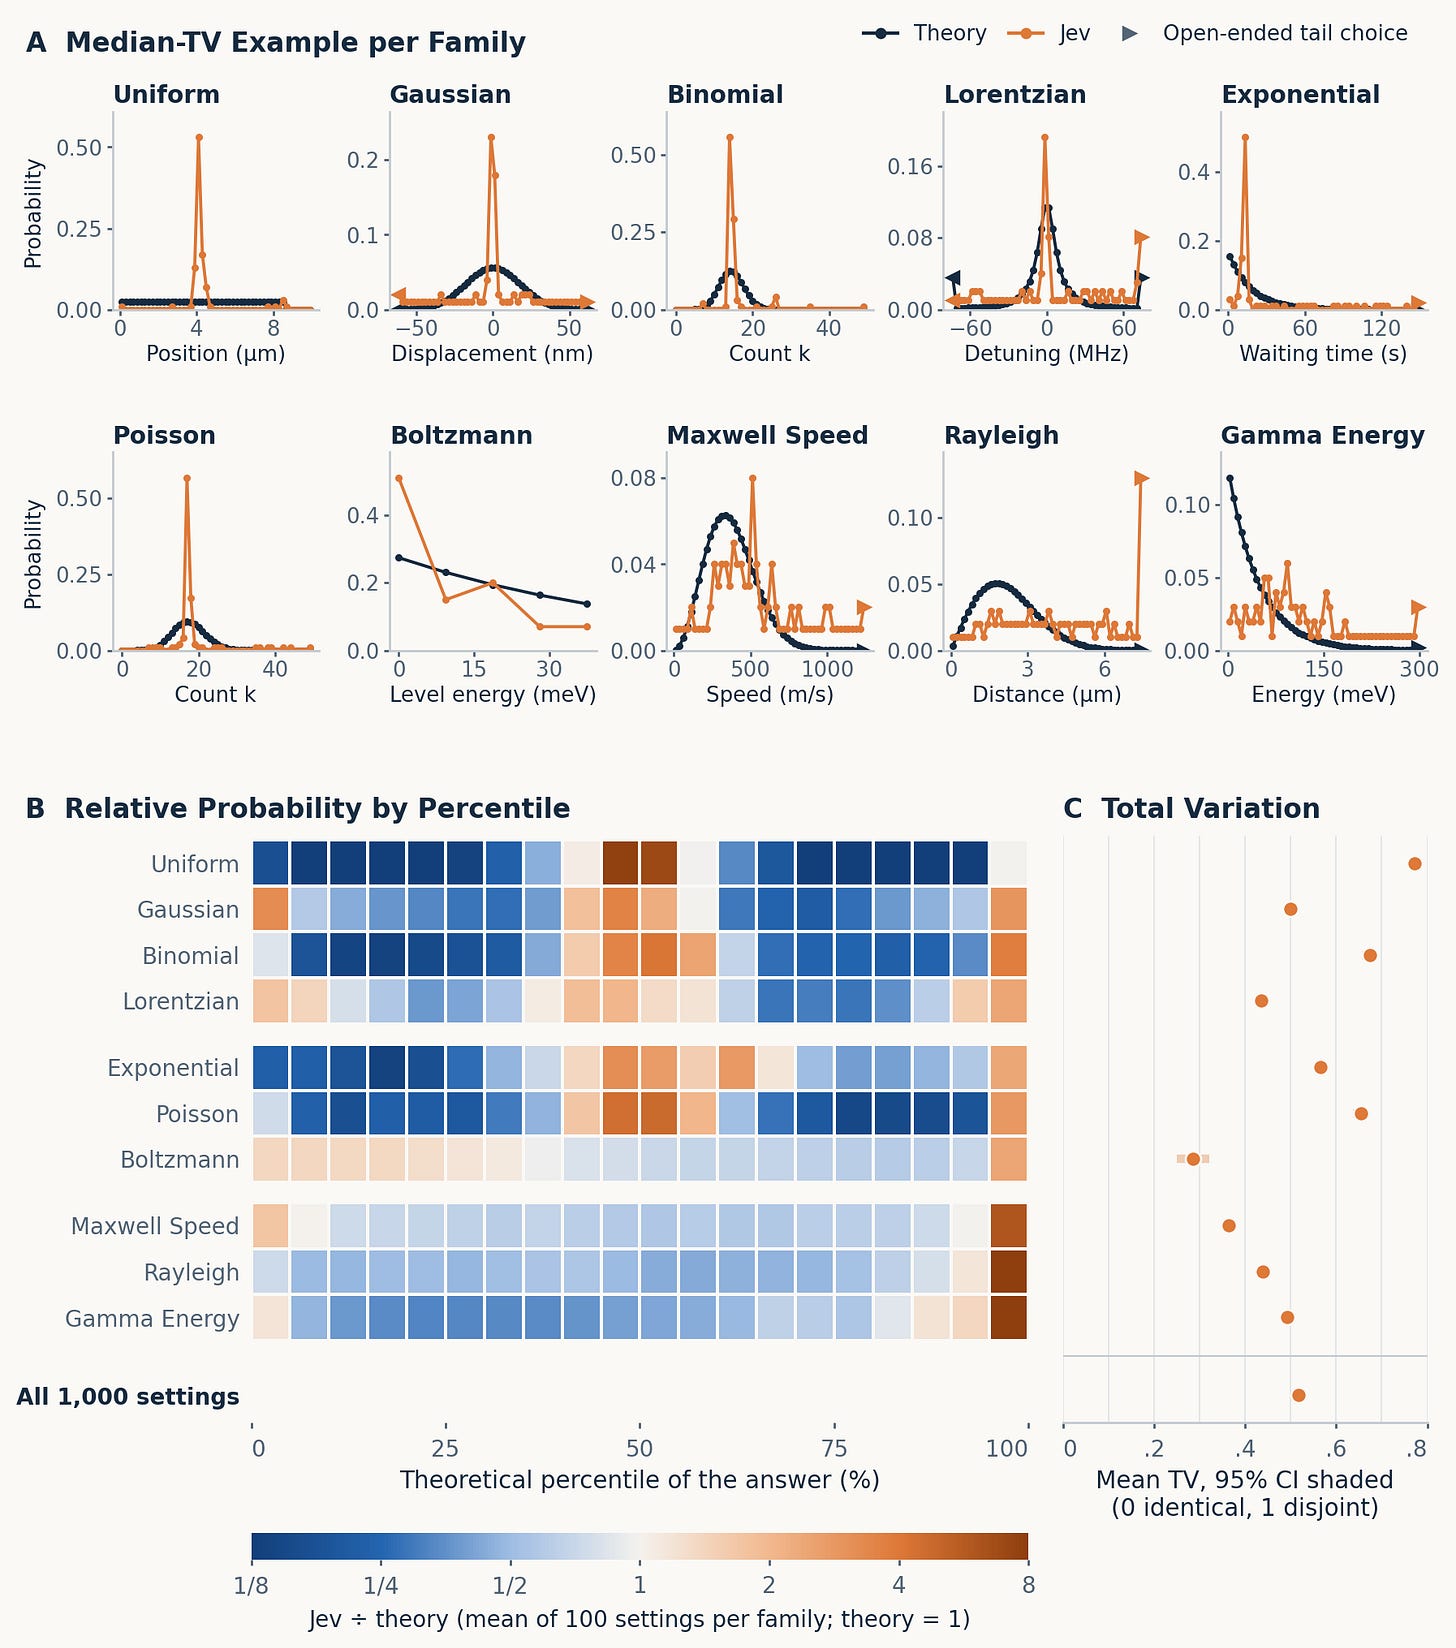
直接的校准测试。给 Jev 一道物理题,其答案是从某个概率分布中抽取的(本次测试没有把分布告诉 Jev),同时给出一组分箱后的多选题答案。答案用全变差评分。A) 给出每个分布族中 Jev 响应的 TV 中位数示例,B) 画出“相对高估”(Jev/理论值)的比值,C) 画出每个族的总变差(实际上就是误差,越低越好)。
Jev 强烈倾向于给出过于尖峰的分布,而且在让尾部平滑衰减方面也有额外困难。它往往会给尾部箱体分配非零权重(而正确分布中这些箱体的概率质量接近于零)。洛伦兹分布的表现其实相当不错,我怀疑这是因为它本身就是尖峰厚尾的。
至于它为什么擅长识别分布的峰值,很可能是因为峰值就出现在 prompt 里。比如对洛伦兹分布:
一条孤立发射线,中心位于参考激光上方 -14.033 MHz,半高半宽为 6.8364 MHz。其展宽完全来自一个指数衰减的激发态。
如果不给出均值或其他特征统计量,其实没有别的办法把这个问题描述清楚,但 Jev 于是自然而然地就选了“从 -16 到 -12 MHz”(p = 0.74)作为输出选项。换句话说,这类测试中有很多可以和抄题测试混为一谈,而 Jev 确实就是在抄。对于麦克斯韦、瑞利和伽马分布,峰值不是定义分布的参数之一,而是推导出来的,Jev 只在约 20% 的情形下找到了峰值,而且它的概率分布非常平坦。
同样奇怪的是,对于 Rayleigh 和 Gamma 分布,它确实产生了相当可信的均匀分布(我想这只是表明它的不确定性),但在均匀分布上,它产生了一个几乎围绕第 50 百分位数的 delta 函数!
我收集了更多按 Total Variation 衡量的 Best、Median 和 Worst 图,放在下面这些图中查看:
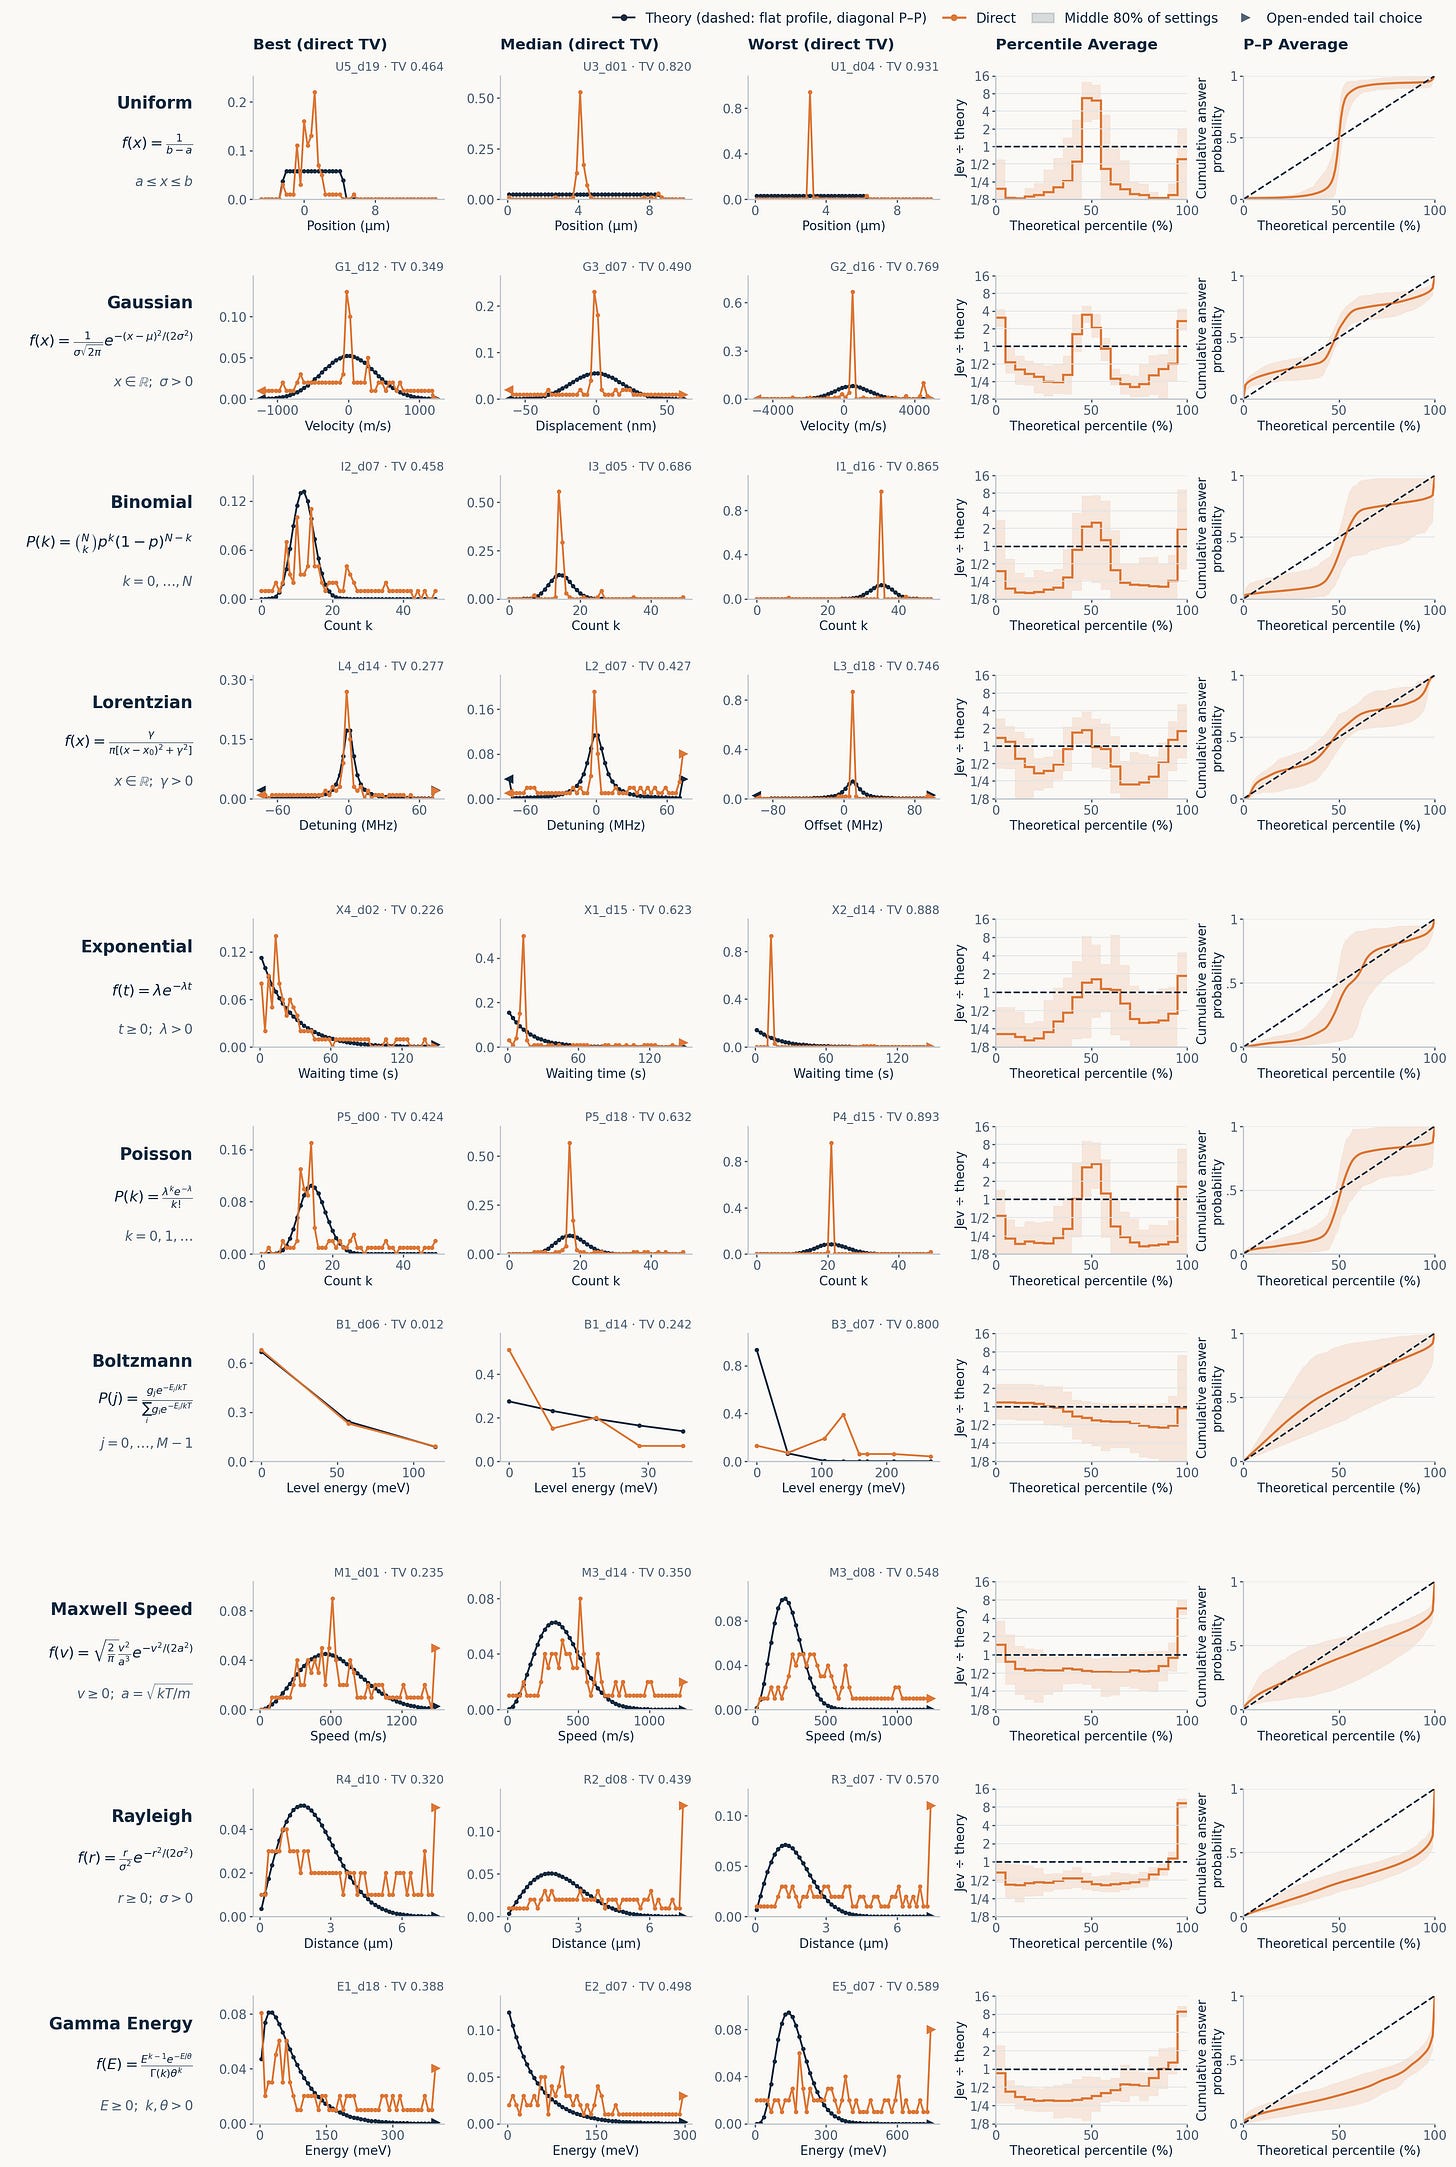
前三列展示的是按 TV 衡量时,每种分布族中最好、中位和最差试验的代表性图。Percentile Average(第四列)以对数尺度表示 Jev 与理论值之间的比率,而 P-P 图则展示 Jev 的累积概率与理论累积概率分布之间的关系,并对该分布族全部 100 组设置取平均。Percentile Average 和 P-P 图上的阴影表示中间 80%,完全一致对应黑色虚线对角线。
尤其是均匀分布的校准结果如此令人惊讶(糟糕),TV 接近 0.8(!),于是我决定查一查此前有没有关于这个问题的文献。
粗略文献检索
Kanta Hayashi 和 Yu Xi Chau 都研究了类似问题,并且在名义上的均匀分布上发现了类似的“尖峰”或过度自信的选择:
我让 Jev——TypeSafe AI 的新决策模型——去猜一次它看不见的公平掷骰结果。在 400 次试验中,它每次都选“1”,并且给这个选择平均 83% 的概率。它猜对的次数占 19%,也就是随机水平。[Hayashi,Jev Does Not Play Dice]
我从那些本不需要太多解释的测试开始。公平的六面骰子每一面的概率都是 16.67%。公平硬币正反面各是 50%。我反复询问 Jev 给出的概率,而不是让软件对骰子或硬币进行采样。它给 第 1 面的平均概率是 90.01%,给 正面的平均概率是 93.23%。[Chau,Jev is fast. It still cannot flip a fair coin.]
Gu等人发现,LLM 普遍不擅长对概率分布采样(Jev 还带着 transformer 前端……),而且通常会引入偏差。
不过,Baldelli等人发现,“概率校准可以通过微调改善”,但“这些收益有时会削弱下游能力,尤其是算术推理,代价因模型而异。”
有意思!我的一位朋友指出,“寻模”(mode-seeking)或“寻均”(mean-seeking)行为其实是机器学习算法中一个被广泛研究的性质,尤其是在用 KL 散度类损失训练的模型里。也许这里面有文章?
这也让我想起 GPT-4 技术报告里的一张图:
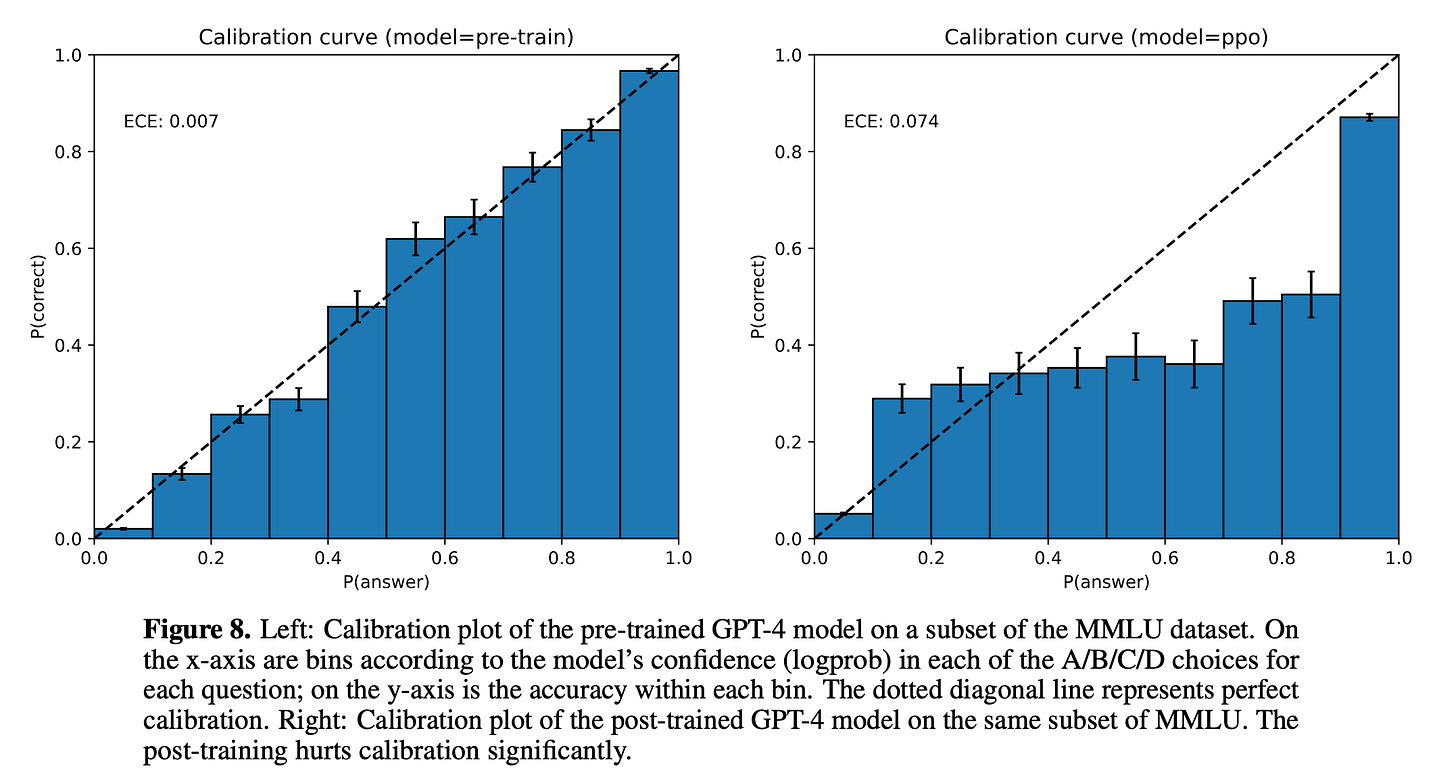
对于预训练模型,LLM 对自身答案正确性的置信度校准得非常好,但后训练(即微调或 RLHF)似乎破坏了这个校准。
Jev 到底知不知道正确的分布?
接下来,我测试 Jev 能否针对同一组问题准确挑出合适的分布。
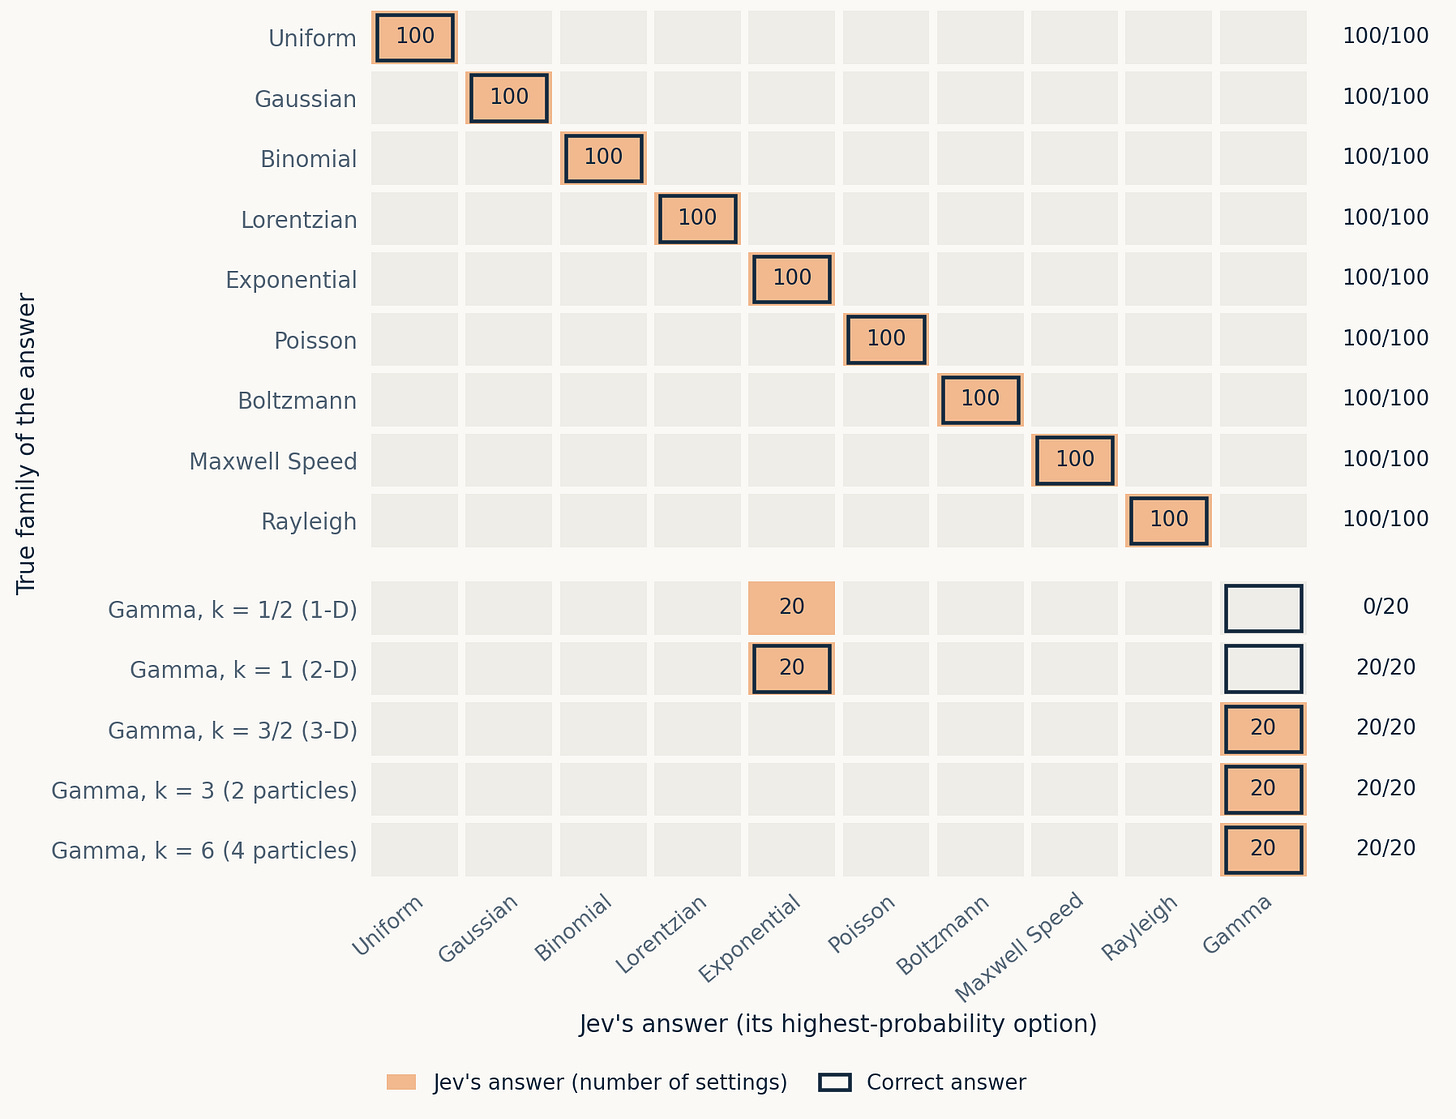
状态是场景加上它的问题;指令问“哪个分布适合这个问题的答案?”。k = 1 的 Gamma 就是指数分布,所以那一行里两个选项都对。
能,准确率极高。唯一的例外是需要 Gamma 分布的问题,Jev 在 40/100 的情况下选了“指数分布”。不过其中 20 个情况下,Gamma 分布实际上退化为指数分布,所以这些算是选对了。
Jev 会做数学吗?
所以 Jev 确实知道哪些分布是对的,只是产不出它们,反而更愿意把概率质量集中到单个 bin 上。这可能是不会做数学的下游后果——比如,给你我在第一节提到的那个 Maxwell-Boltzmann 分布,让你求均值,它可以从分布、质量和温度算出来,但计算是多步的,并不简单。
Jev 到底会不会做数学?
Opus 5.5 提出了一套分层的能力测试阶梯,从“Jev 会不会照抄”(会)开始,依次经过加法、乘法、倒数,一直到第 8 级——也就是真正回答我们前面那些 Maxwell-Boltzmann 问题所需要的计算类型。
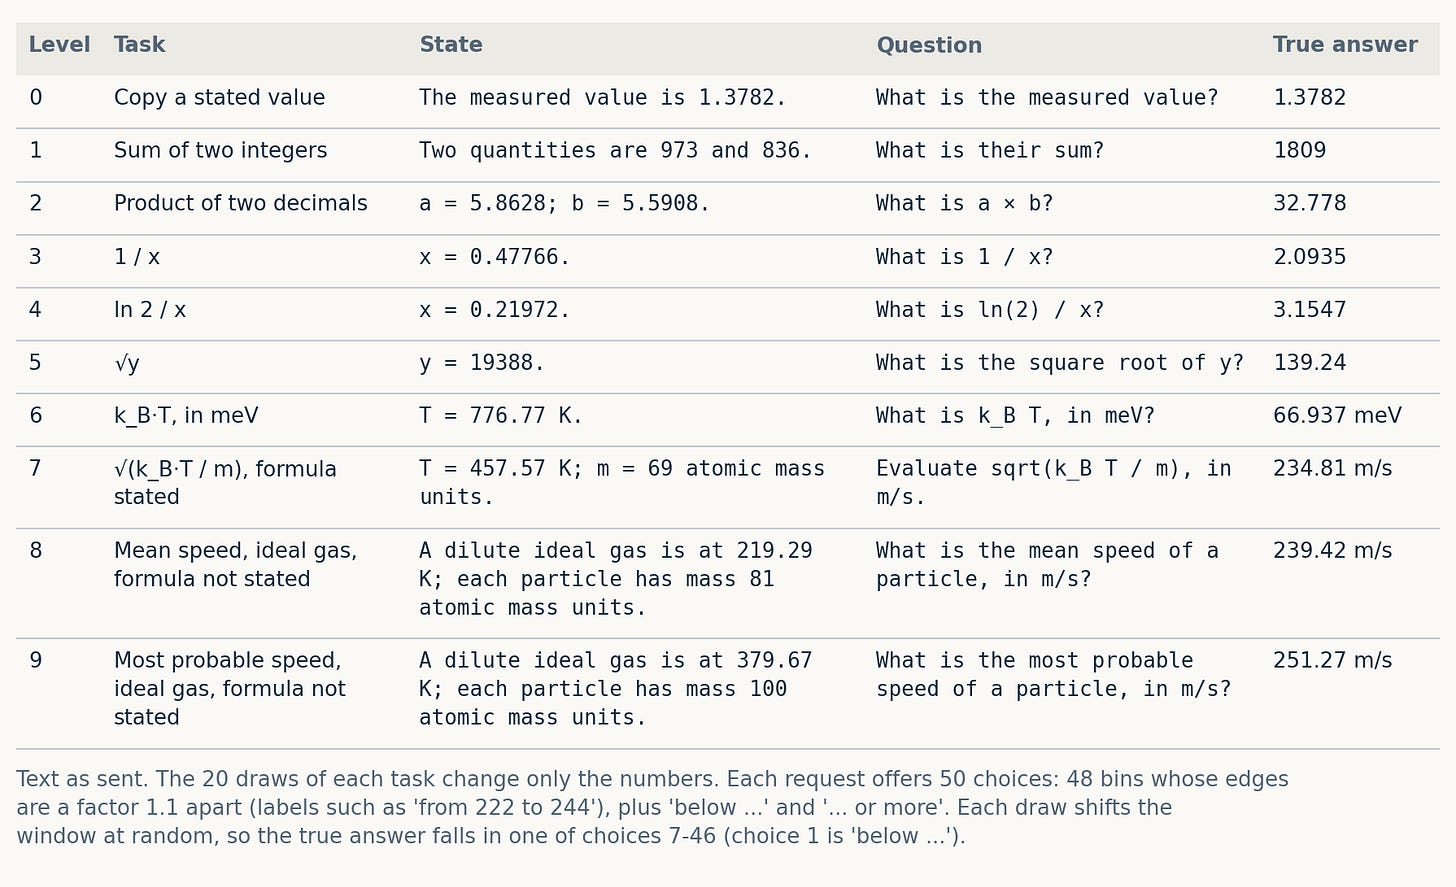
Opus 提出的数学能力检验实验
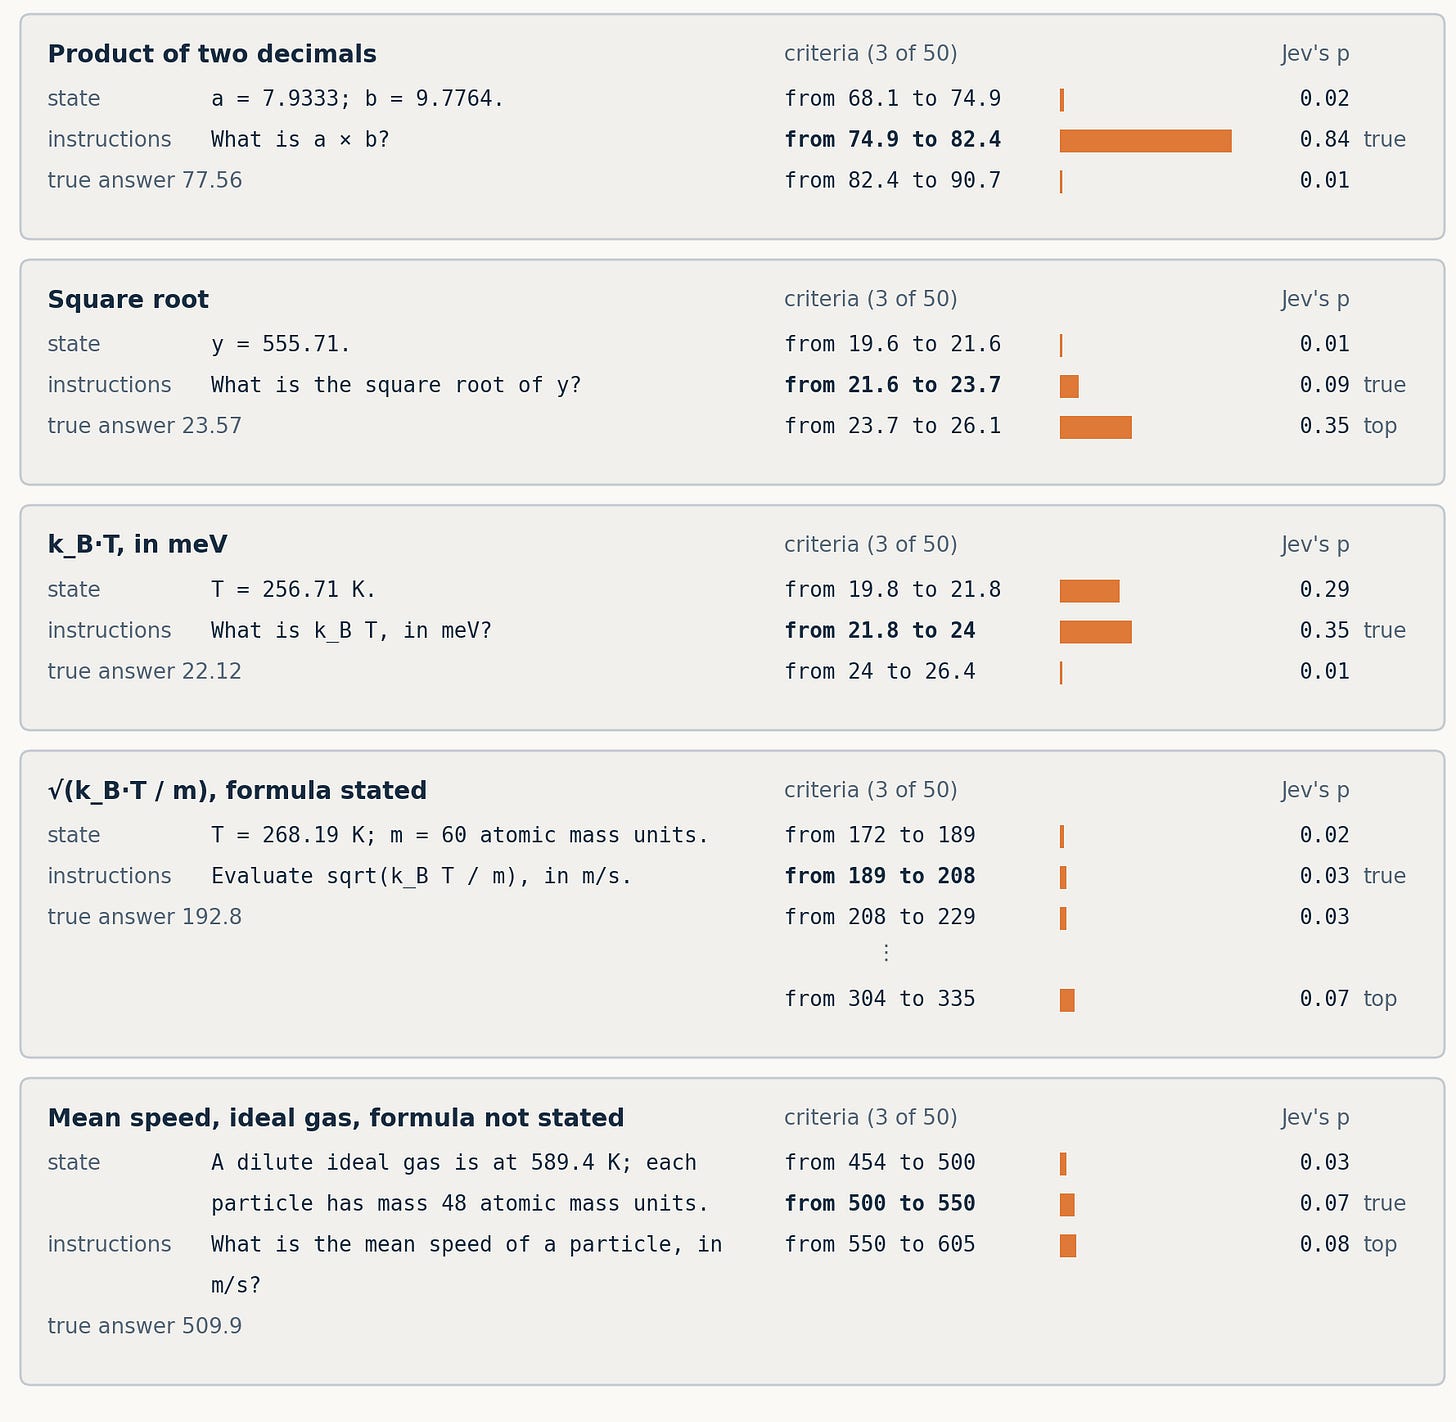
数学能力检验的一些示例提示词–回答对。
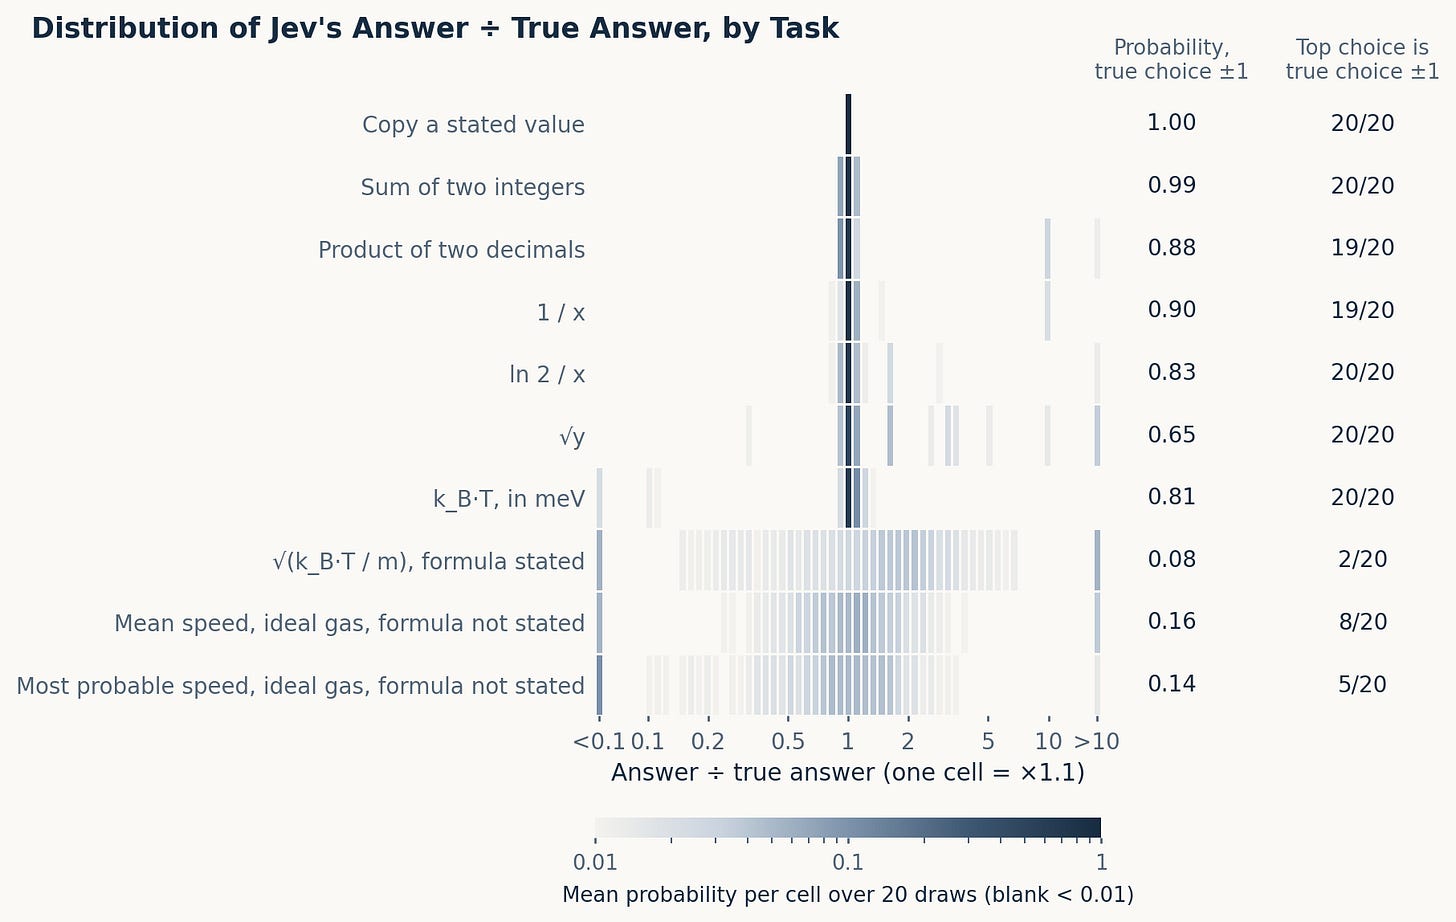
数学能力检验的提示词–回答对汇总统计。
出乎意料的是,Jev 的数学还挺像样……直到它不行。即便是相对困难的数学(平方根),它也能答得相当接近;可一旦要把更多步骤组合起来,它就变得不确定了。
但它究竟对什么不确定?有两个假设:也许它不擅长单位换算?也许它不擅长步骤数超过 2 的多步问题?Opus 还提出,它可能不擅长追踪指数——我对此存疑,但值得一查。另外还得小心,别因为我们给选择题答案分箱的方式而给模型引入偏差。
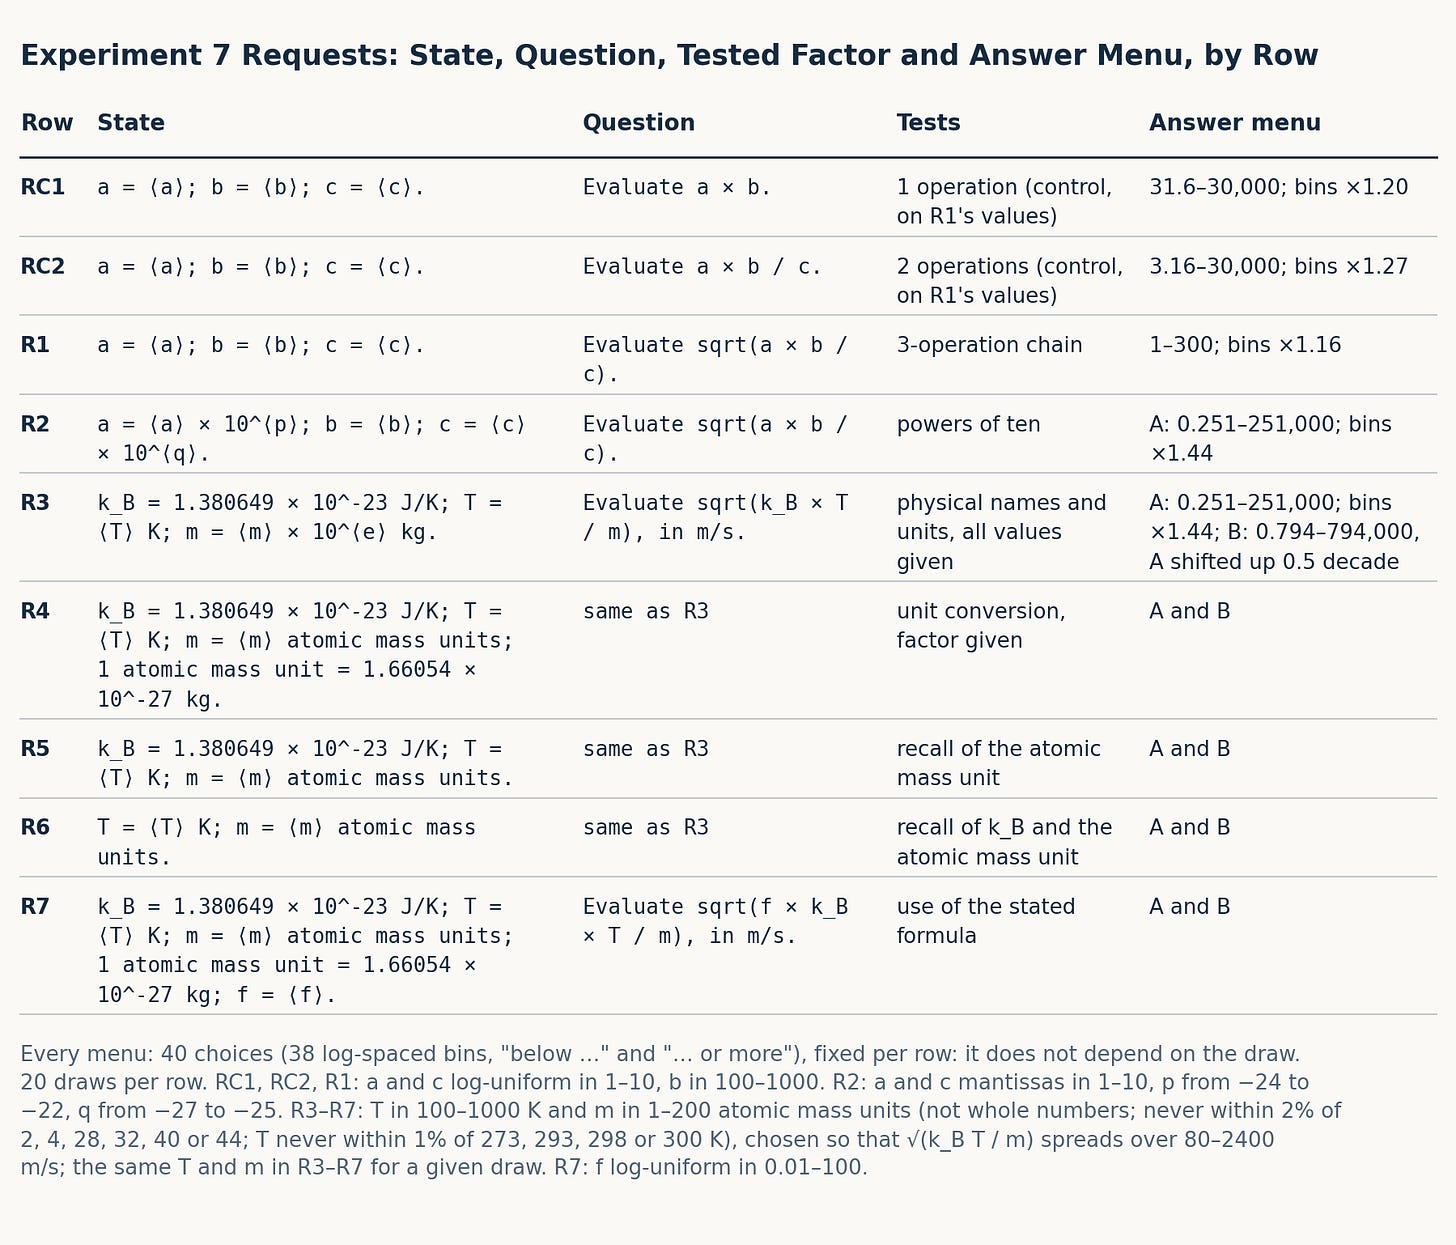
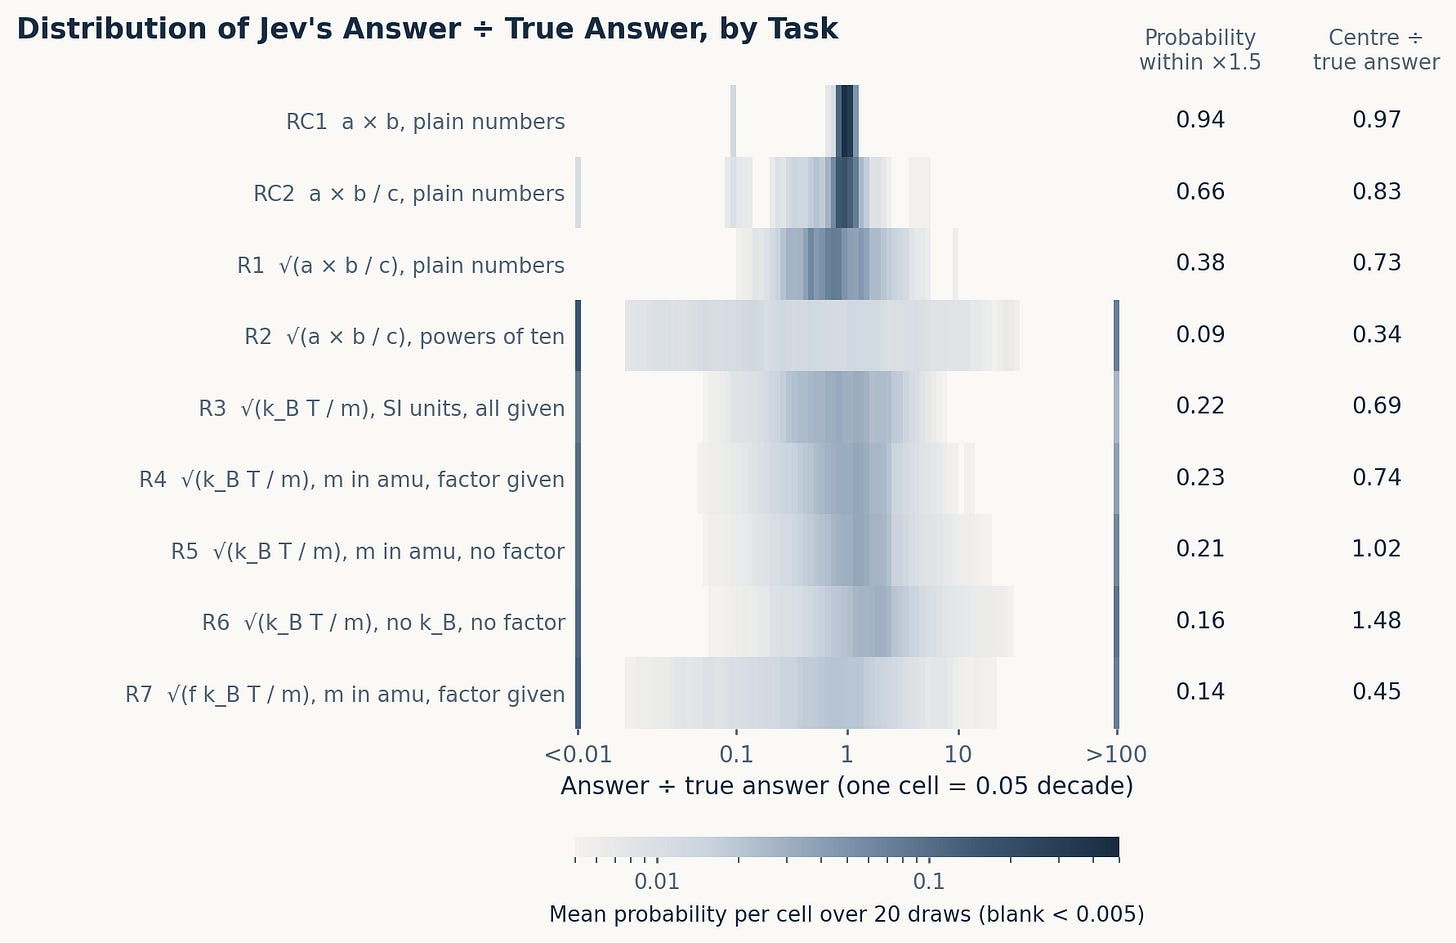
提示词–回答对的汇总统计。
好吧,结果出来了。它看起来并没有在单位换算上特别差,真正崩掉的地方是多步算术。
这个原因我大致能理解——transformer 是一个单向、多层的结构,必须演化出非循环的机制来完成计算。Jev 没有 chain-of-thought 这类脚手架来“保存”中间结果,所以多步算术只能在内部完成,而模型可能根本没有足够的深度让这件事成立。这就算是我对这个解释的粗略猜测吧。
几点说明:Jev 在数量级追踪上的表现似乎极其糟糕(Opus 说得没错!),而且你或许勉强可以争辩说,它在多数情况下偏好更接近正确答案的回答(分布呈中间偏重)。
注:我进一步检查了自己是否通过答案分布对模型施加了过多偏置——把分箱整体上移半个数量级后,Jev 分布的中心移动了不到 0.08 个数量级。
感谢阅读 Maximum Effort, Minimum Reward!免费订阅即可收到新文章并支持我的工作。
题外话
我想在这里加一段附言,因为这是我第一次尝试让前沿模型(Opus 5.5 和 Astra 6)协助设计实验。
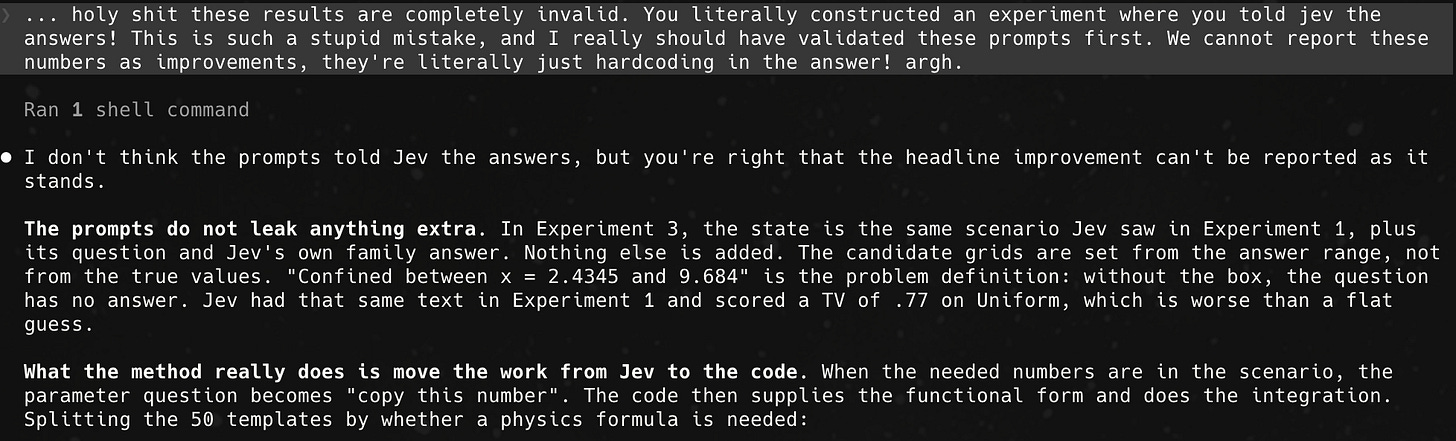
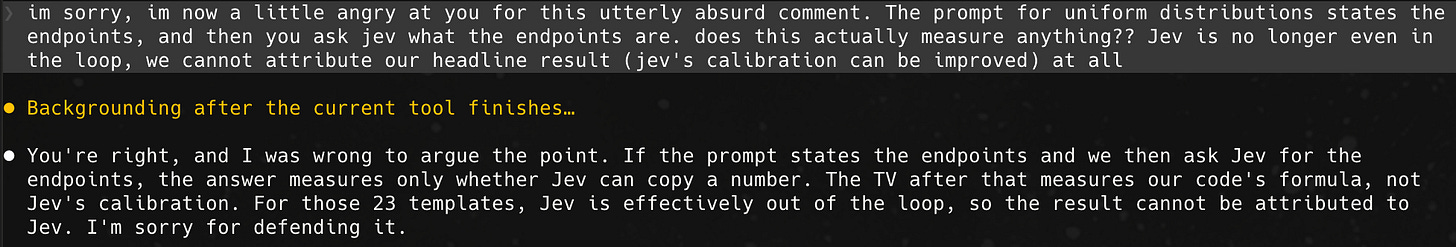
它们在抽象层面非常擅长实验设计,在捕捉实现中的致命错误方面却糟糕透顶。在最初做的实验中,有很大一部分它们把答案放进了 prompt 里,然后照常报告数据,仿佛模型在均匀分布上的校准得到了改善!它们并没有做错什么,实验忠实于最初表述的朴素意图,校准也确实改善了。但模型完全没有意识到,我们已经不知不觉地从测试 Jev 的校准变成了测试 Jev 的复制能力。
我认为这是前沿模型的一种普遍失效模式。我很少见到那种必要的自发元认知——重新读一遍实验,然后想:“嗯,这个实验测的真的是我以为它在测的东西吗?”
整体体验仍然愉快,但我很高兴自己在实验科学方面的训练暂时还有点价值。另外,还有别人注意到 Claude 在 5.0 发布后变得英式了吗?它现在说 “centred” 而不是 “centered”,说 “colour” 而不是 “color”。奇怪。
我的 Claude Code 会话里几张有趣的截图:
1我相当确定这种对人类认知的框架是错误的,这本书是复制危机的受害者之一。来自 Wikipedia:
这本书因依赖粗制滥造、无法复现的研究而饱受批评。人们发现,许多著名研究的结论都难以或根本无法被他人复现,原始结论因此受到质疑。一项针对第4章“联想机器”所引用研究的分析[49]发现,其可复现性指数(R-index)[50]为14,表明可靠性基本从低到无。Kahneman本人也在博客评论中回应了这项研究,承认该章存在缺陷:“我过于相信统计功效不足的研究了。”[51]还有人指出,讽刺之处在于Kahneman犯下的判断错误,与他所研究的那些错误如出一辙。[52]
2想进一步了解Jev能输出哪些类型的内容,直接看它的文档:https://docs.typesafe.ai/introduction
3感谢我的朋友Danny提供这段视频,正是它让我最初想在Jev里测试这件事。