Jevのキャリブレーションが不十分
Dylan Black は Jev に物理的に妥当な確率分布を生成させてキャリブレーションを検証した。結果は、確率を均等に配る「諦め」より悪く、失敗の仕方も系統的だった。著者は Jev を自動判定器として使うことの安全性に疑問を投げる。
日本語
コピー
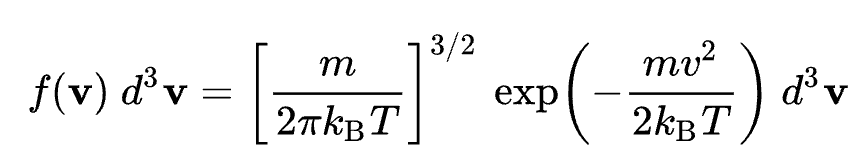
Jev は TypeSafe が新たに発表した「System One」分類器モデルだhttps://typesafe.ai/blog/introducing-system-one-models-and-jev。名前の由来は Daniel Kahneman の著書 Thinking, Fast and Slow にあり、そこでは速く直感的な System One の思考と、より遅く意識的な System Two の思考が区別されている。1 このアナロジーに従えば、Claude や GPT のような大規模言語モデル(LLM)は System Two のモデルであり、Jev とその前身(たとえば Laya)のような「Decision Model」は System One にあたる。Transformer アーキテクチャは現代の LLM の骨格であり、ほとんどのタスクを学習するためのパラダイムとして極めて柔軟で汎用的だ。だが現代の LLM は本質的に確率的で自己回帰的であり、その出力形式(自由テキスト)は分類タスクに向かない。たとえば LLM を呼び出してclaude(“2 + 2 = ?”)と尋ねたとしよう。期待するのは4だが、それは文字列か、整数か、浮動小数点数か……? Jev なら代わりにjev("2+2=?", "3 : int, 4 : int, 5 : int")を呼び出し、4を受け取る。型は正しく整数と付けられている。私の理解では、Jev は事前学習済み transformer を取り、その汎用性をすべて保持したまま、末尾に分類器を接続する。こうすることで、分類器は特定のタスク向けに訓練される必要がなく、しかも新しいコンテキストを即座に使える。それでいて分類器のままだ。コンテキストと多肢選択問題を渡せば、各選択肢上の確率分布が返ってくる。2 しかも極めて安い。以下の実験一式でかかった費用は合計 4.00 ドル未満だ。ただし Jev は単に答えを一つ選ぶのではなく、すべての可能な答えにわたる確率分布を返す。この確率分布はどれほど正確なのか? Maximum Effort, Minimum Reward を読んでくれてありがとう! 無料購読で新記事を受け取り、私の仕事を支援できます。
答えが明確な問題でこれを検証することにした。たとえば:
質量 m の古典粒子が温度 T の熱力学的平衡系にある。その速度 v はいくらか?
答えは v 上の確率分布、具体的には Maxwell-Boltzmann 分布だ:
Wikipedia:「同一で相互作用せず、非相対論的な古典粒子を多数含み、熱力学的平衡にある系について、粒子が三次元速度空間の無限小体積要素 d 3v に入る割合は、速度ベクトル v(大きさ v)を中心とする上式の分布で与えられる。」 m は質量
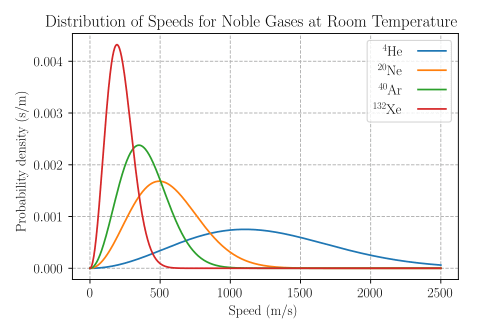
同じく Wikipedia より。298.15 K(25 °C)におけるいくつかの希ガスの速度確率密度関数。縦軸の単位は s/m なので、曲線の任意の区間の下の面積、つまり速度がその区間に入る確率は無次元量になる。
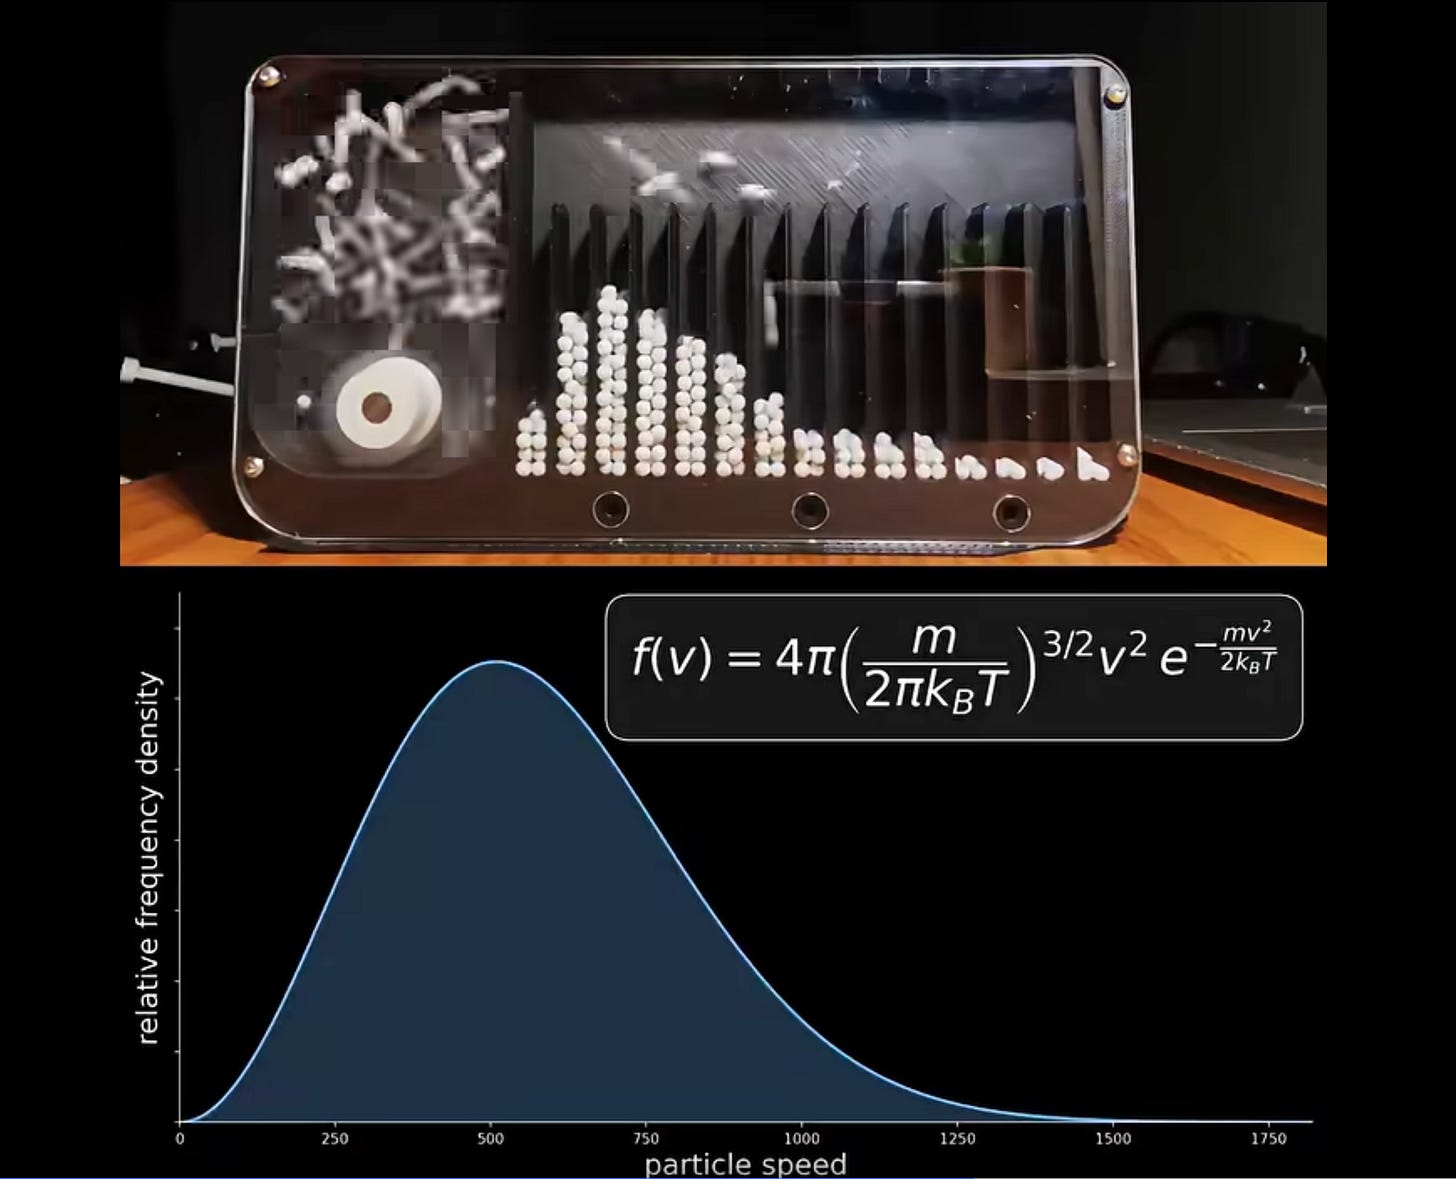
面白いデモがある。モーターと小球いくつかで、マクスウェル=ボルツマン分布を実際に作れるのを知っているだろうか?動画はこちら3
方法
これらの実験の実装、テンプレート化された prompt の作成、API 呼び出しなどには GPT-6 Astra と Claude Opus 5.5 を使った。最近は Opus 5.5 の作図能力も試しているが、今のところ非常に感銘を受けている。
物理的に関連する分布を一組選び、GPT-6 Astra と Claude Opus 5.5 に一連の prompt テンプレートを書かせた。その回答は確率分布を与えるはずのものだ。
Jev に直接確率分布を求めてはいない。求めているのは有限集合上の「選択」(通常はある連続パラメータのビン区間)だ。Jev は型付きの決定と、各ビンに対する内部確率を返す。Jev がよくキャリブレーションされていれば、その出力確率は物理的に正しい確率分布関数と一致するはずだ。
候補の分布を 10 個選び、各分布に 5 つの prompt テンプレート、各 prompt に 20 種類の変種(たとえば呼び出しごとに環境温度を変える)を用意し、合計 1,000 通りの設定とした。各テンプレートの答えのビンは固定で、サンプリングによって変わらない。
以下はプロンプトの例で、stateがコンテキスト、instructionsがタスク、criteriaが連続パラメータの区間であり、Jev はこれらの区間上で確率分布を返す
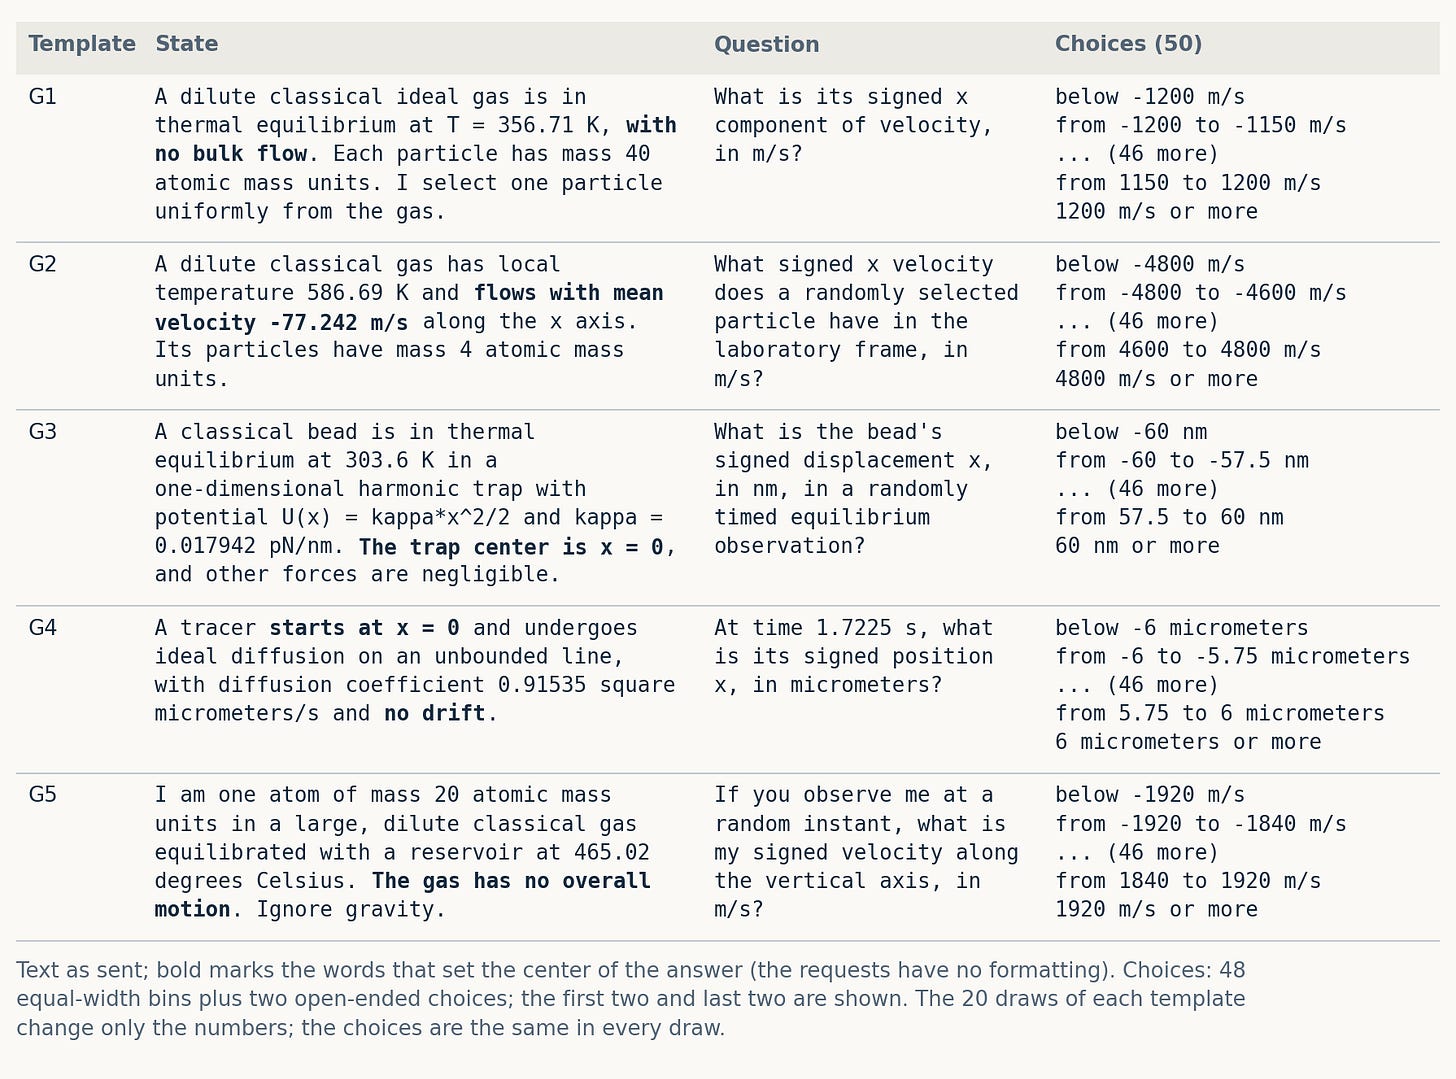
プロンプトテンプレートの例。プロンプトと変種は Claude Opus 5.5 が作成した。
分布: Gaussian、Lorentzian、Maxwell、Gamma、Exponential、Rayleigh、Uniform、Poisson、Binomial、Boltzmann。
区間: 連続分布ごとに物理的な範囲を定め、20 回のサンプルのうち最も広い分布を覆う幅を取る(裾の長い Lorentzian は除く)。その範囲を等幅の区間に分割する(Lorentzian は最後の区間を開区間とする)。
- 符号付きの答え(Gaussian、Lorentzian):[−R, R] を幅 R/24 の 48 区間に分け、「−R 未満」と「R 以上」を加える。
- 非負の答え(Maxwell、Gamma、Exponential、Rayleigh):0 から幅 w の区間を 49 個並べ、「49w 以上」を加える。
- Uniform の位置:全サンプルを含む範囲を 50 区間に分割
- Poisson:カウント 0–48 と「49 以上」
- Binomial:0–49、試行回数 N = 49
- Boltzmann:列挙されたエネルギー準位
下の図は Opus 5.5 が作ったもので、なかなか見事だ。手法全体を一目で示している。
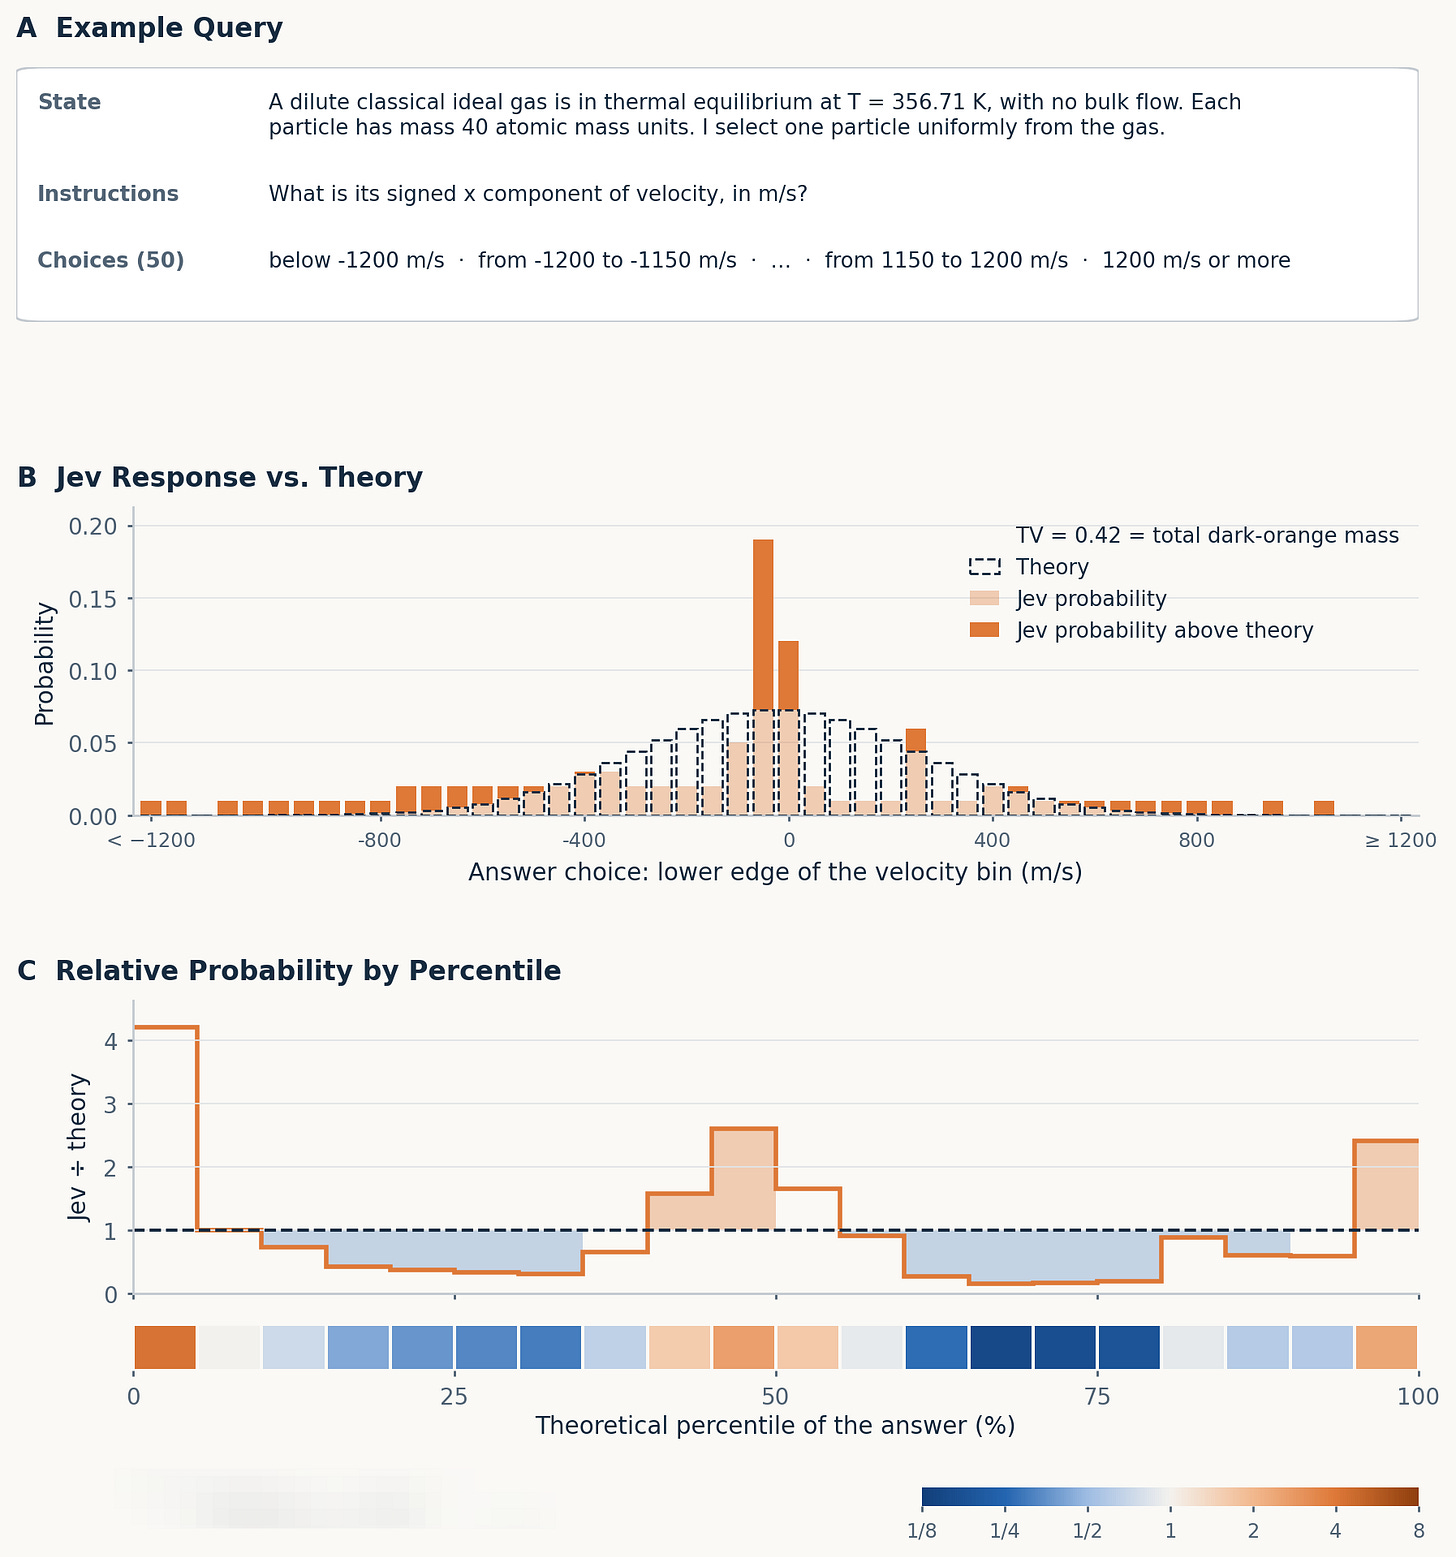
手法。A)Jev に与えるプロンプトの基本構造(例)。B)Jev が報告した確率(例)と正しい分布の比較。C)差異を示すために選んだ一例——パーセンタイルごとに Jev の予測と理論値の比を取ったもの。Jev の誤差のかなりの部分が境界区間に押し込まれるため、「端のスパイク」構造が非常によく現れる
Jev の答えは、サンプルごとに全選択肢上の Total Variation で採点する。
K 個の区間について、q は Jev が返した確率、p は正しい pdf をその区間で積分した値。TV = 0 は完全一致、TV = 1 は確率質量がまったく重ならないことを意味する。
素朴なキャリブレーション結果
では Jev のキャリブレーションはどれほど良いのか。良くない。Jev が答えるのを完全にやめ、確率を全選択肢に均等に配れば、平均 TV は 0.546 になる。実際の Jev のスコアは 0.518 だ。一様分布では均等推測が 0.77 で Jev が 0.39、Poisson では 0.65 対 0.64。これを見て、LLM の答えを自動評価器として扱う JevEval のような手法には強い疑いを抱いた(この手法自体を批判しているわけではない。アイデアは悪くない。ただ、よく知られた問題では、これらの分布はキャリブレーションがうまくいっていない)。
非常に明白な失敗モードがある。
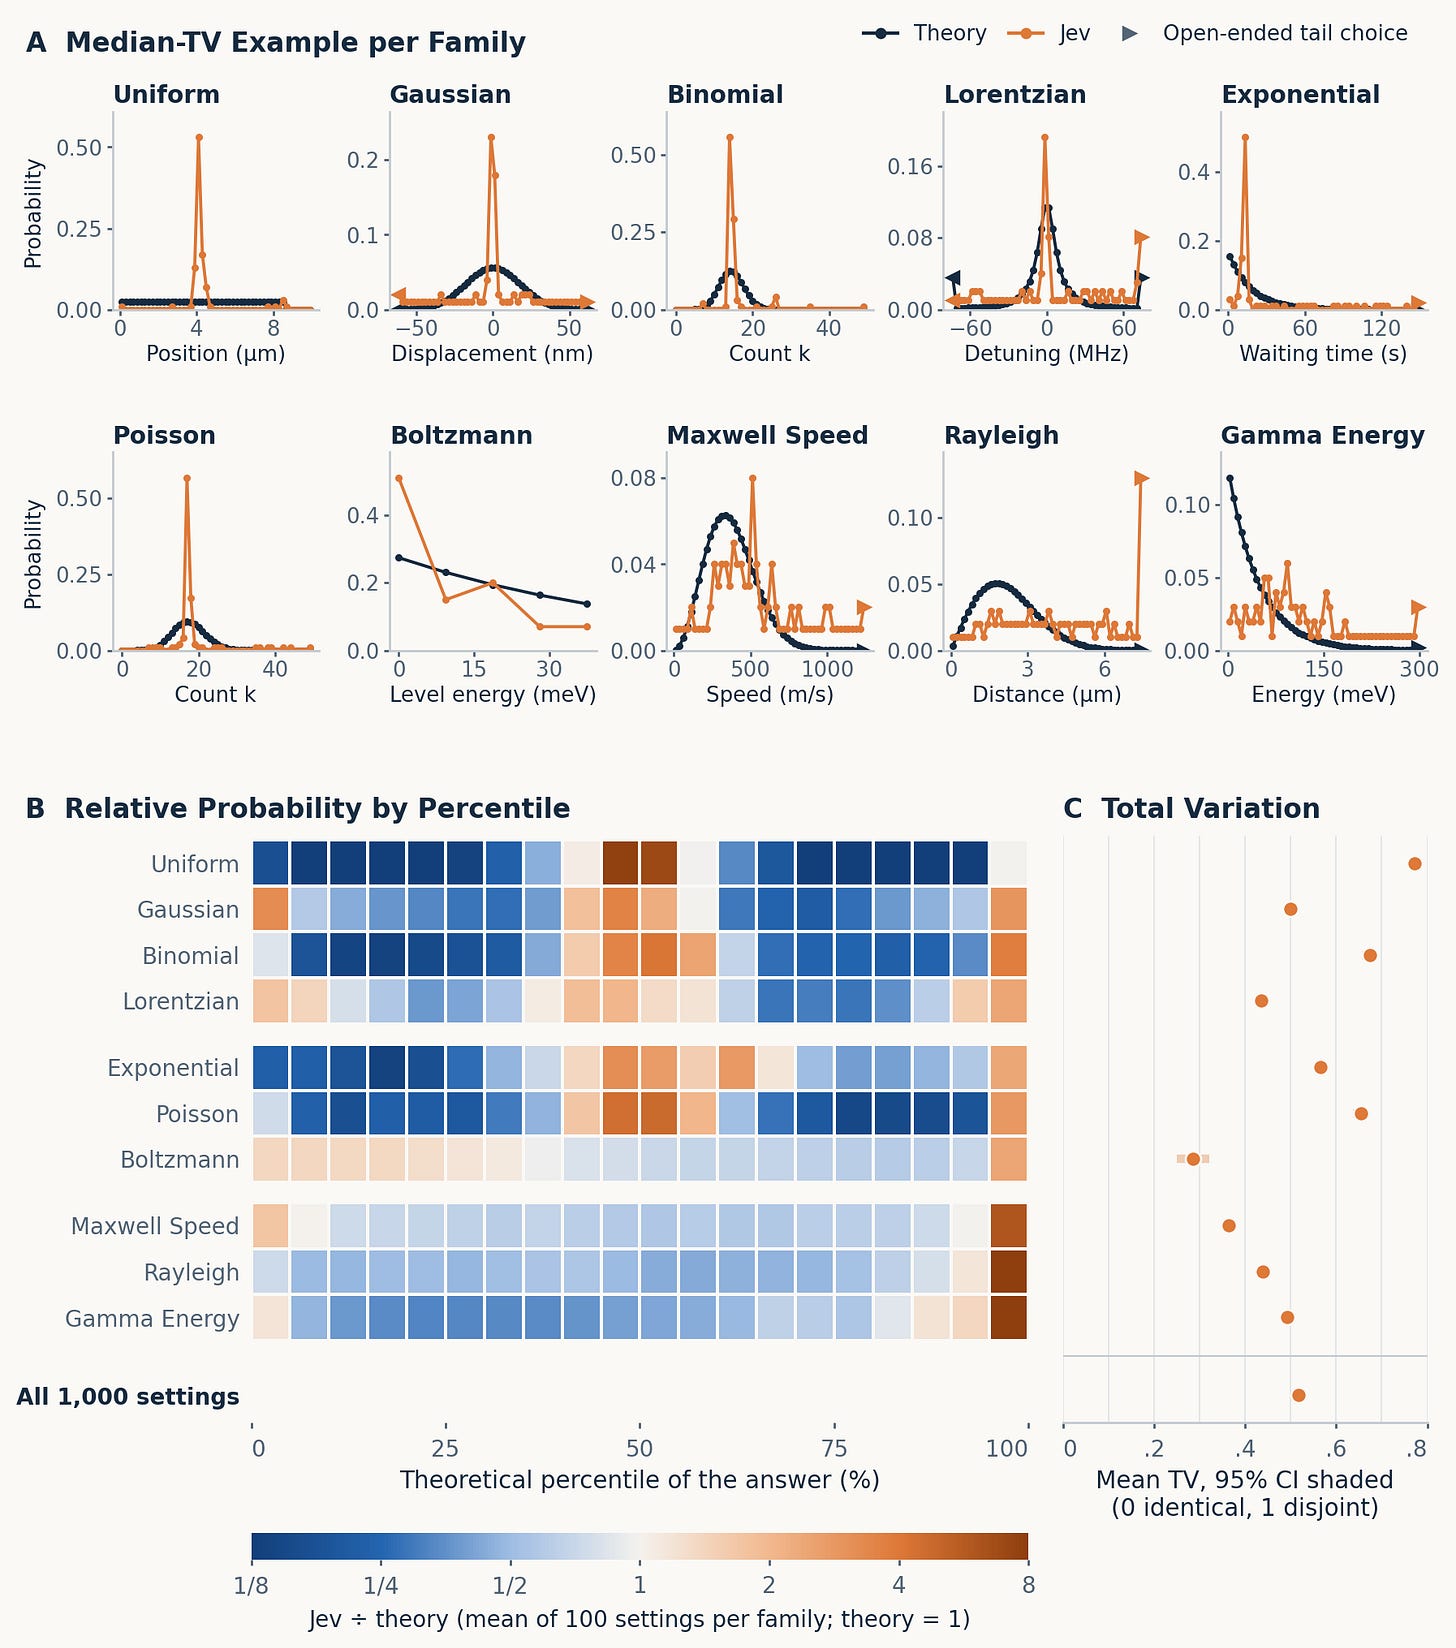
直接的なキャリブレーションテスト。答えが何らかの確率分布からサンプルされる物理の問題を Jev に出し(今回のテストでは分布を Jev に伝えていない)、ビン分けした多肢選択の答えを与える。採点は全変差で行う。A)分布族ごとに Jev の回答の TV 中央値の例、B)「相対的な過大評価」(Jev/理論値)の比、C)分布族ごとの全変差(実質的には誤差、低いほど良い)。
Jev は過度に尖った分布を出す強い傾向があり、裾を滑らかに減衰させるのにも苦労する。正しい分布では確率質量がほぼゼロである裾のビンに、非ゼロの重みを割り当てがちだ。Lorentzian はむしろかなり良い成績で、これは分布自体が尖っていて裾が厚いためではないかと思っている。
分布のピークをなぜうまく当てられるのかといえば、おそらくピークがプロンプトに書かれているからだ。たとえば Lorentzian では:
孤立した発光線で、中心は参照レーザーより -14.033 MHz、半値半幅は 6.8364 MHz。広がりは指数関数的に減衰する励起状態のみに由来する。
平均値その他の特徴量を与えなければ、この問題をうまく記述する方法は実際のところ他にない。だが Jev はそこから自然に「-16 から -12 MHz」(p = 0.74)を出力として選ぶ。つまり、こうしたテストの多くは写経テストと区別がつかない。そして Jev は実際に写経している。Maxwell、Rayleigh、Gamma では、ピークは分布を定義するパラメータではなく、導出されるものだ。Jev がピークを見つけられたのは 2 割程度で、その確率分布はきわめて平坦だった。
さらに奇妙なのは、Rayleigh と Gamma ではそれらしい一様分布を出しているのに(単に不確かさを表しているのだと思う)、一様分布の問題では第 50 パーセンタイル付近にほぼデルタ関数を作り出したことだ。
Total Variation で測った Best、Median、Worst の図をさらに集めたので、以下に示す:
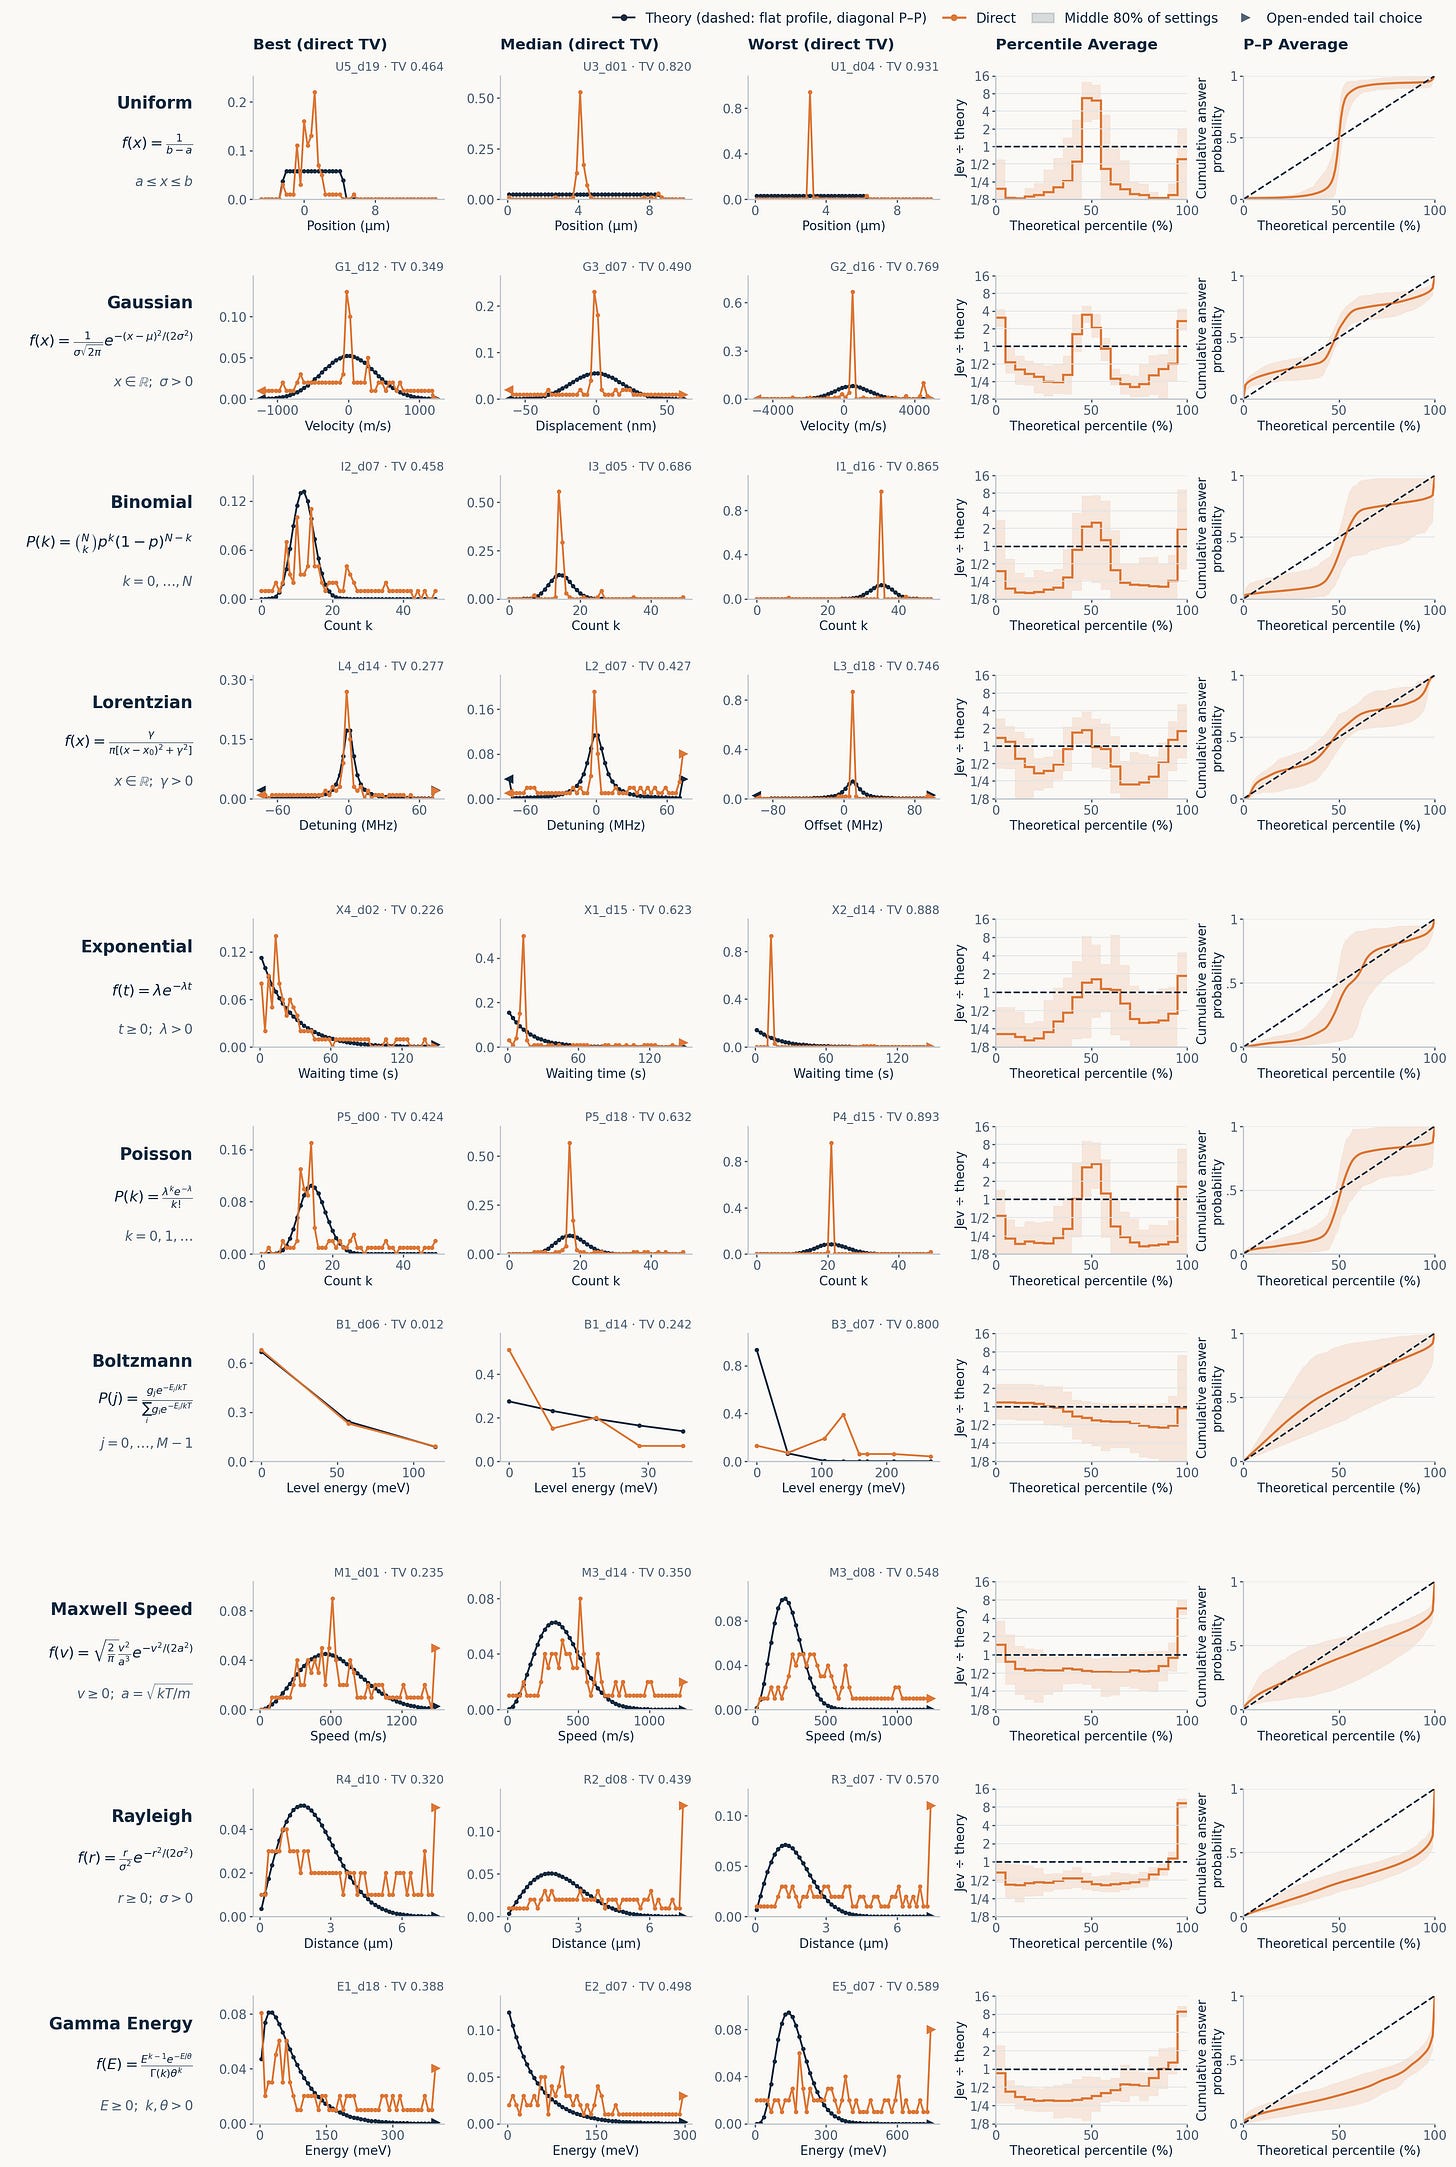
最初の3列は、TVで測ったときに各分布族で最良・中位・最悪だった試行の代表的な図を示している。Percentile Average(4列目)はJevと理論値の比を対数スケールで表し、P-PプロットはJevの累積確率と理論上の累積確率分布の関係を示しており、いずれもその分布族の100通りすべての設定を平均したものだ。Percentile AverageとP-Pプロットの網掛けは中央80%を表し、完全に一致していれば黒い破線の対角線に対応する。
特に一様分布のキャリブレーション結果は驚くほどひどく、TVは0.8近く(!)だった。そこで、この問題に関する先行文献があるか調べてみることにした。
ざっとした文献調査
Kanta Hayashi と Yu Xi Chau はどちらも似た問題を研究しており、名目上は一様分布であるはずのものに同じような「尖り」、つまり過剰な自信を見つけている。
私は Jev——TypeSafe AI の新しい意思決定モデル——に、見えない公平なサイコロの出目を1回当てさせてみた。400回の試行で、毎回「1」を選び、その選択に平均83%の確率を与えた。実際に当たったのは19%で、つまりランダムな水準だった。[Hayashi,Jev Does Not Play Dice]
説明をあまり要さないテストから始めた。公平な六面サイコロなら各面の確率は16.67%。公平なコインなら表も裏も50%だ。サイコロやコインをソフトウェアにサンプリングさせるのではなく、Jevが返す確率を繰り返し尋ねた。すると第1面の平均確率は90.01%、表の平均確率は93.23%だった。[Chau,Jev is fast. It still cannot flip a fair coin.]
Guらは、LLMは一般に確率分布からのサンプリングが苦手で(Jevにはtransformerのフロントエンドまである……)、たいていバイアスを持ち込むことを見つけた。
一方、Baldelliらは「確率のキャリブレーションはファインチューニングで改善できる」が「その利得は下流の能力、特に算術推論を弱めることがあり、その代償はモデルによって異なる」と報告している。
面白い。友人によれば、「モード探索」や「平均探索」の挙動は機械学習アルゴリズム、特に KL ダイバージェンス系の損失で訓練されたモデルにおいて広く研究されている性質だという。ここに何かあるのかもしれない。
GPT-4の技術レポートにあった図も思い出す。
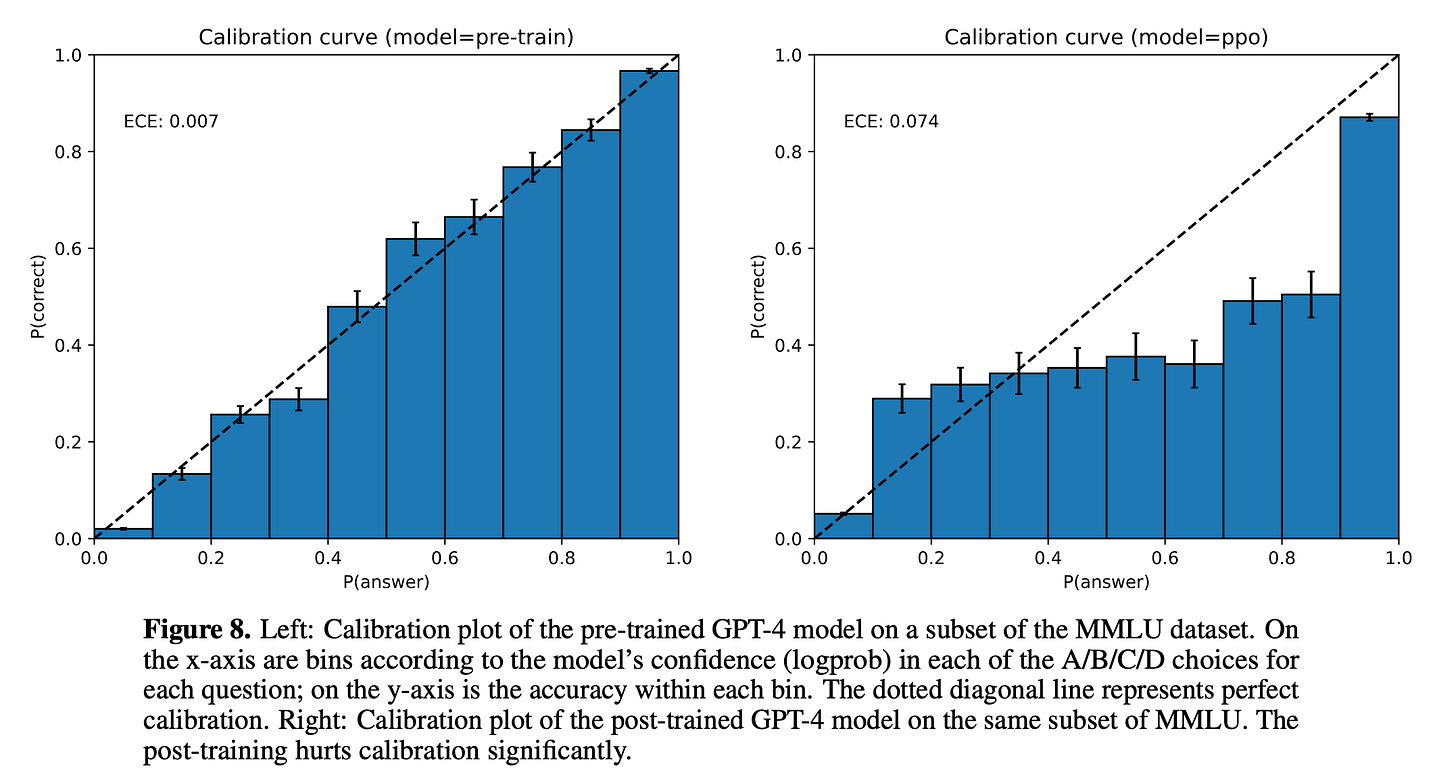
事前学習済みモデルでは、LLMが自分の答えの正しさに対して示す信頼度は非常によくキャリブレーションされているが、事後学習(つまりファインチューニングやRLHF)がこのキャリブレーションを壊してしまうらしい。
Jev は正しい分布を知っているのか
次に、同じ問題群に対してJevが適切な分布を正確に選べるかを試した。
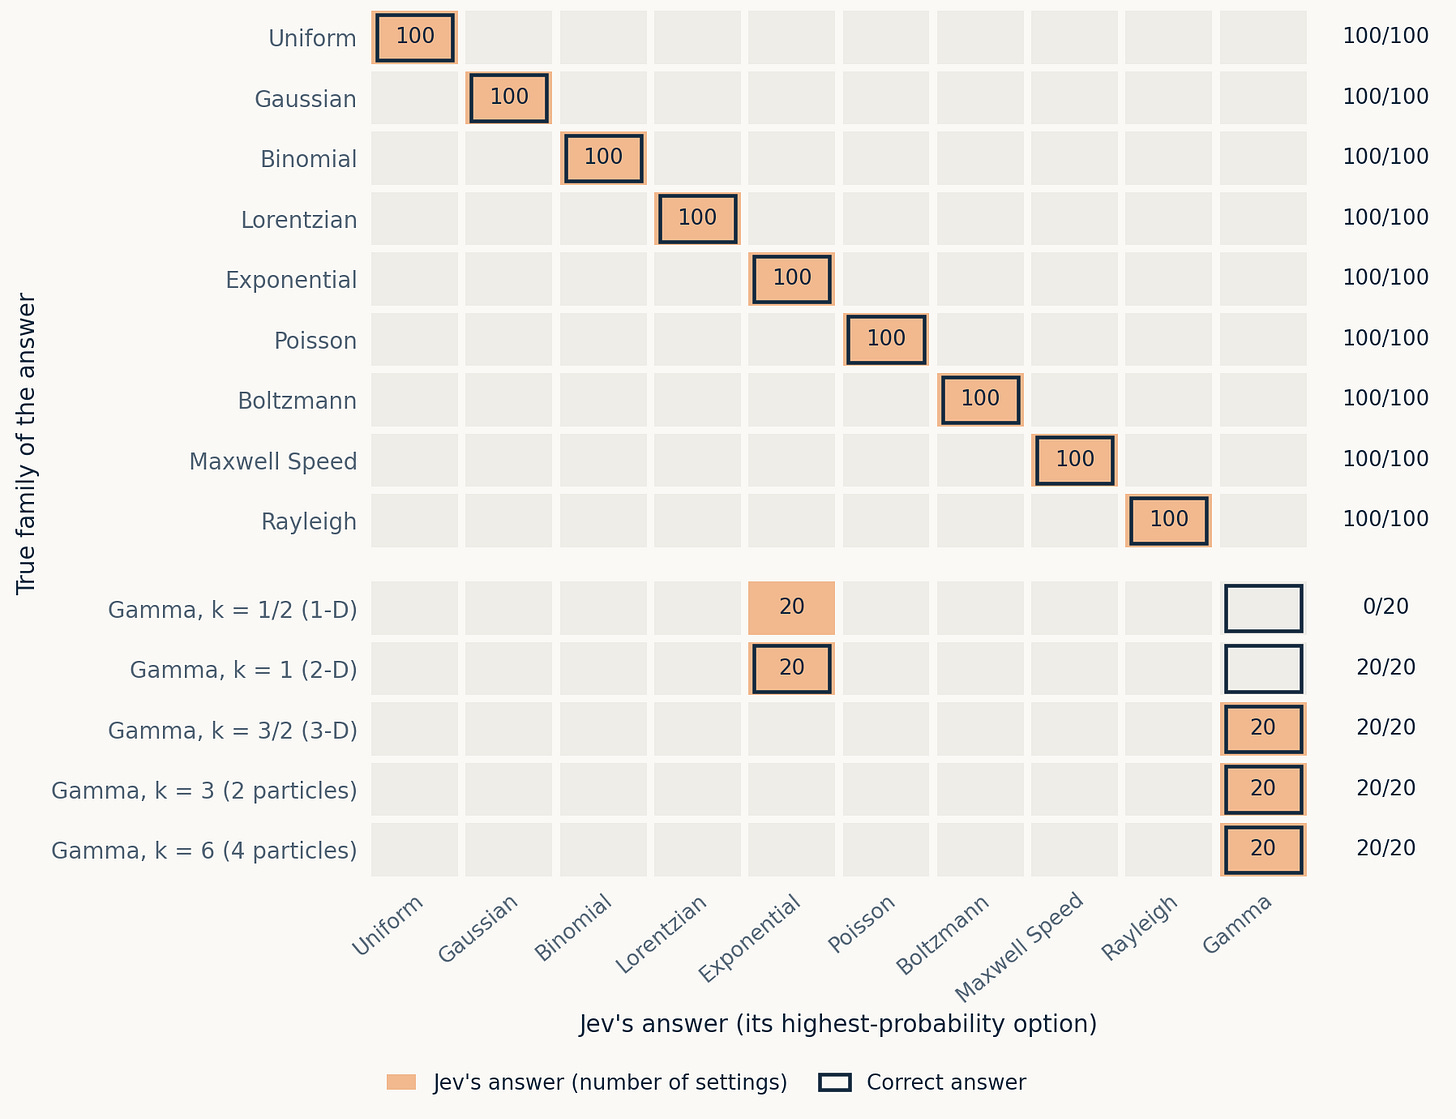
状態はシナリオとその問題。指示は「この問題の答えにはどの分布が適切か?」。k = 1 の Gamma は指数分布なので、その行では2つの選択肢はどちらも正しい。
選べる。しかも精度は極めて高い。唯一の例外はGamma分布が必要な問題で、Jevは40/100のケースで「指数分布」を選んだ。ただしそのうち20ケースではGamma分布が実際には指数分布に退化しているので、これらは正解になる。
Jev は数学ができるのか
つまりJevは、どの分布が正しいかは確かに分かっている。ただそれを出せず、代わりに確率質量を単一のbinに集中させたがる。これは数学ができないことの下流の帰結かもしれない。たとえば最初の節で挙げたMaxwell-Boltzmann分布を渡して平均を求めさせるとしよう。分布と質量と温度から計算はできるが、計算は多段階で、簡単ではない。
Jevはそもそも数学ができるのか。
Opus 5.5が、階層的な能力テストのはしごを提案した。「Jevは丸写しできるか」(できる)から始まり、足し算、掛け算、逆数と進み、第8段階——先ほどのMaxwell-Boltzmannの問題に実際に答えるのに必要な種類の計算——まで至る。
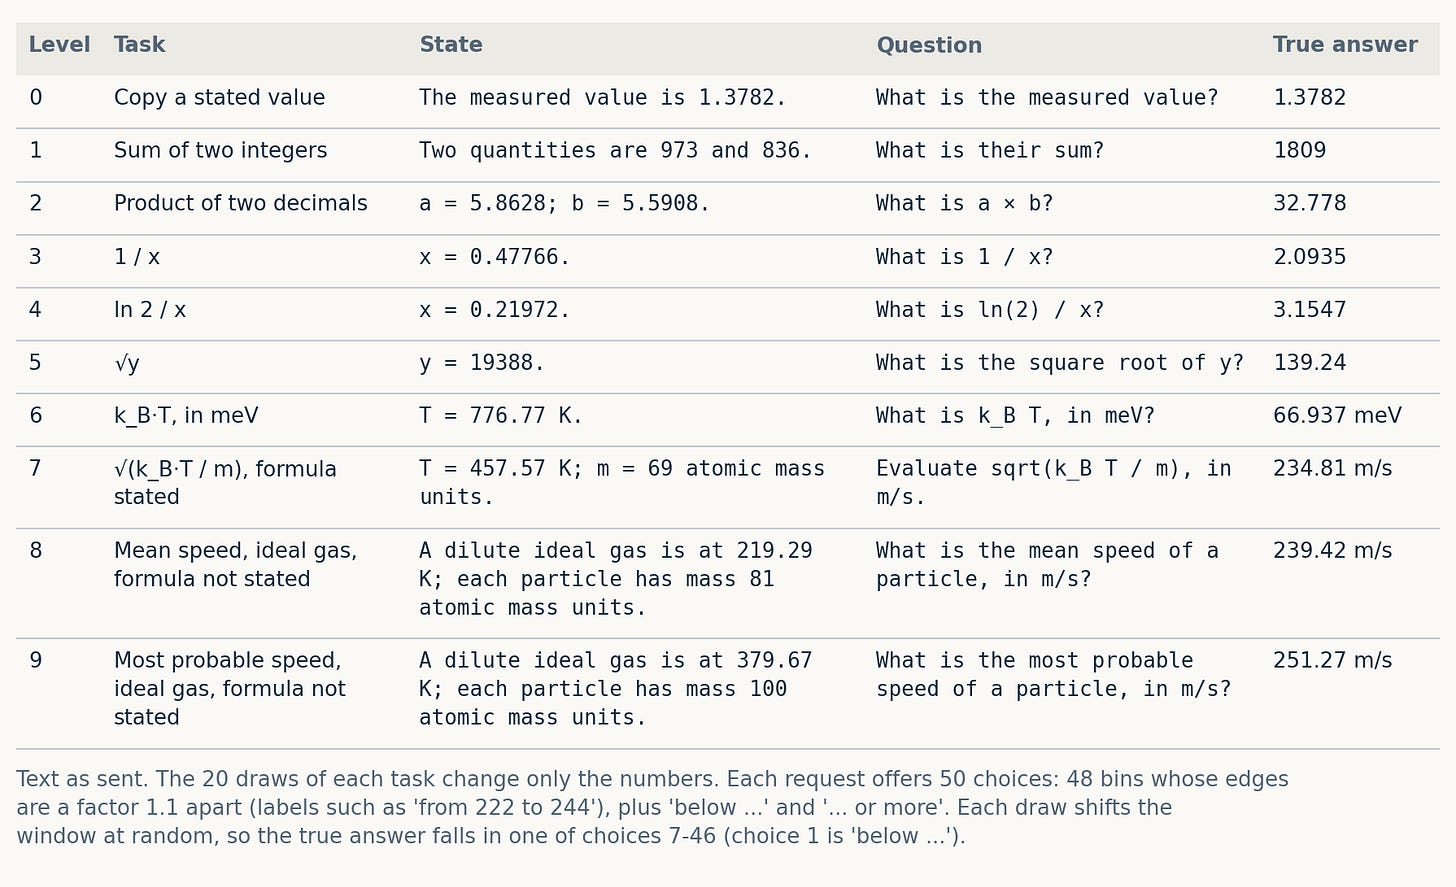
Opus が提案した数学能力検証実験
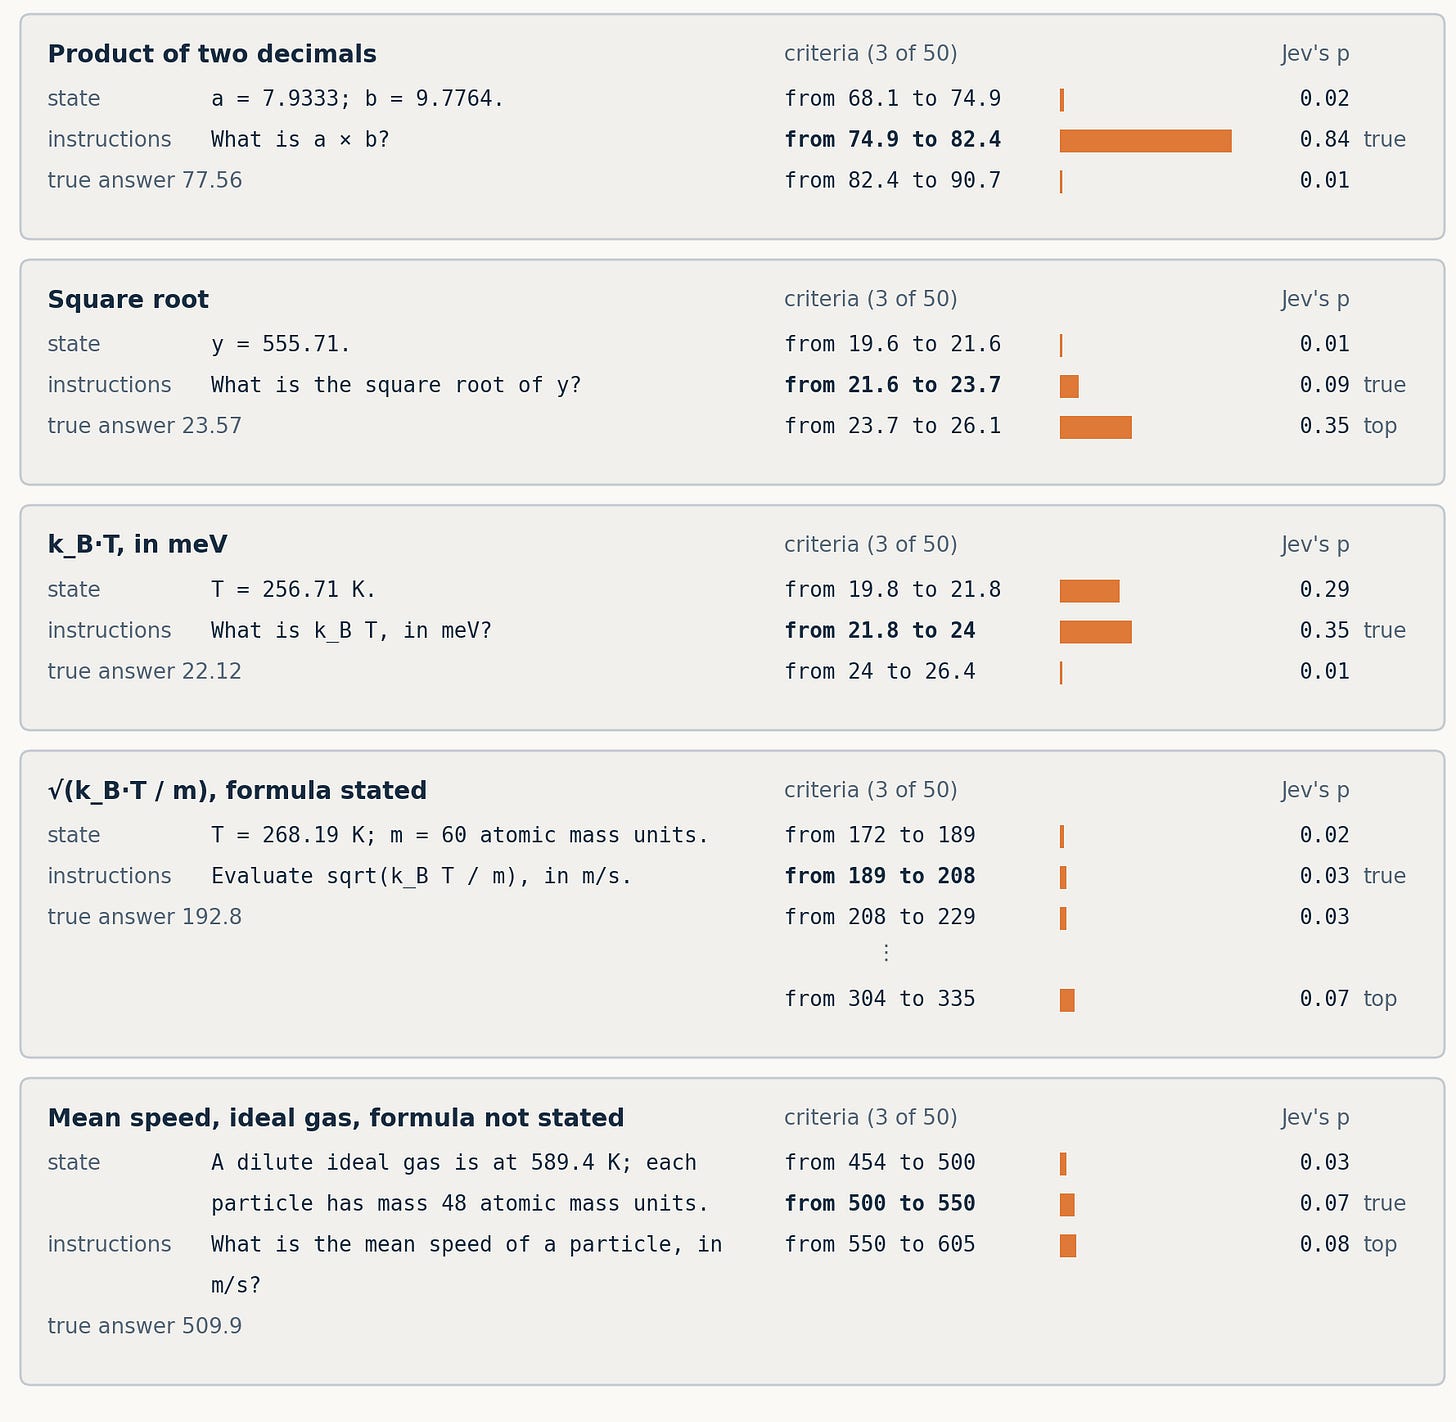
数学能力検証のプロンプト–回答ペアの例。
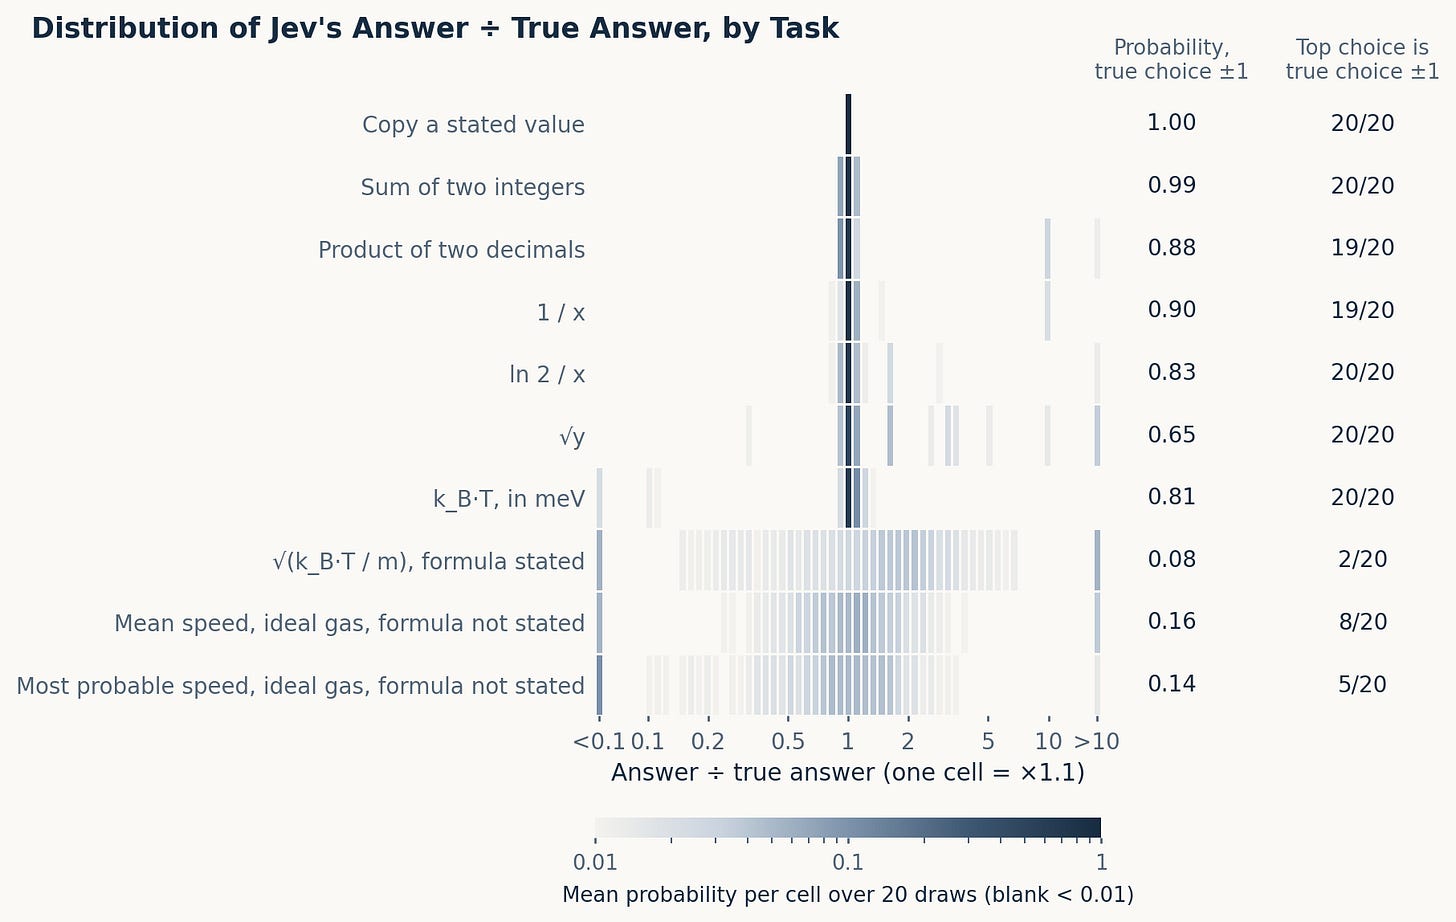
数学能力テストのプロンプト–回答ペアの集計統計。
意外なことに、Jev の数学はなかなかまともだった……それが崩れるまでは。比較的難しい数学(平方根)でもかなり近い答えを出す。ところがステップが増えた途端、自信がなくなる。
だが、何に対して自信がないのか。仮説は二つ。単位換算が苦手なのか? ステップ数が 2 を超える多段問題が苦手なのか? Opus はさらに、指数の追跡が苦手なのではないかと指摘した——私は懐疑的だが、調べる価値はある。それに、選択肢の答えをビン分けする方法でモデルにバイアスをかけてしまわないよう注意も必要だ。
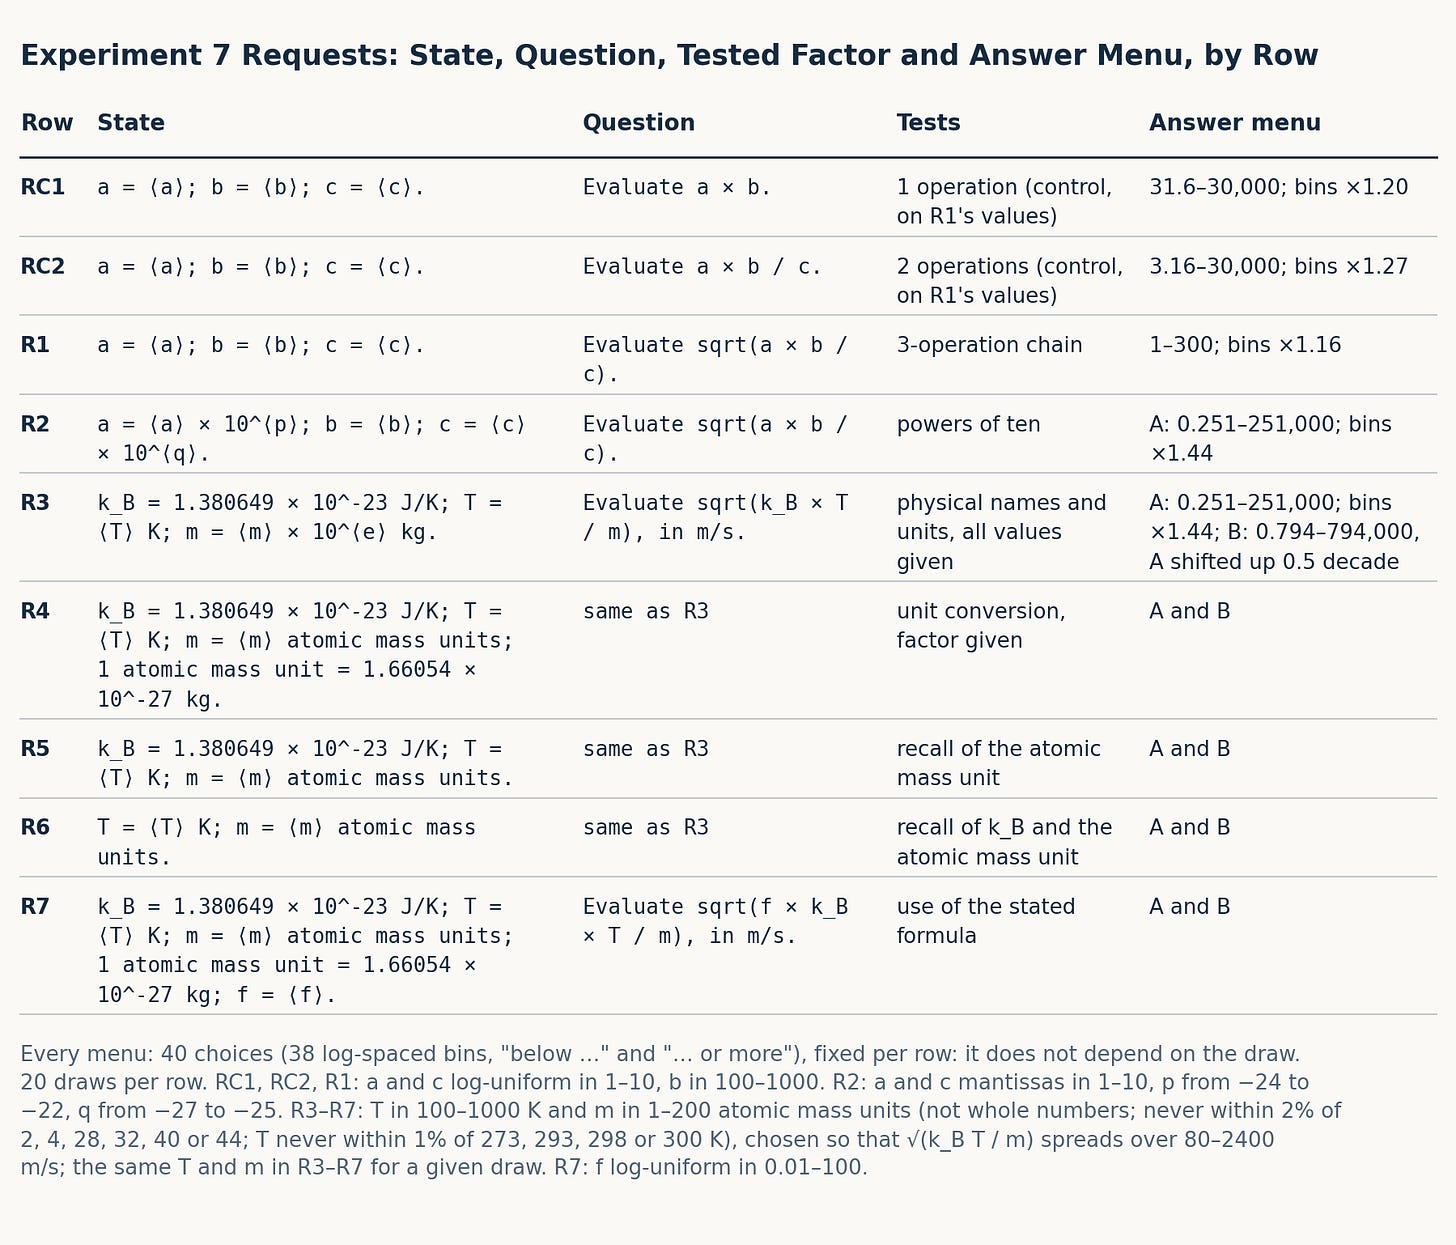
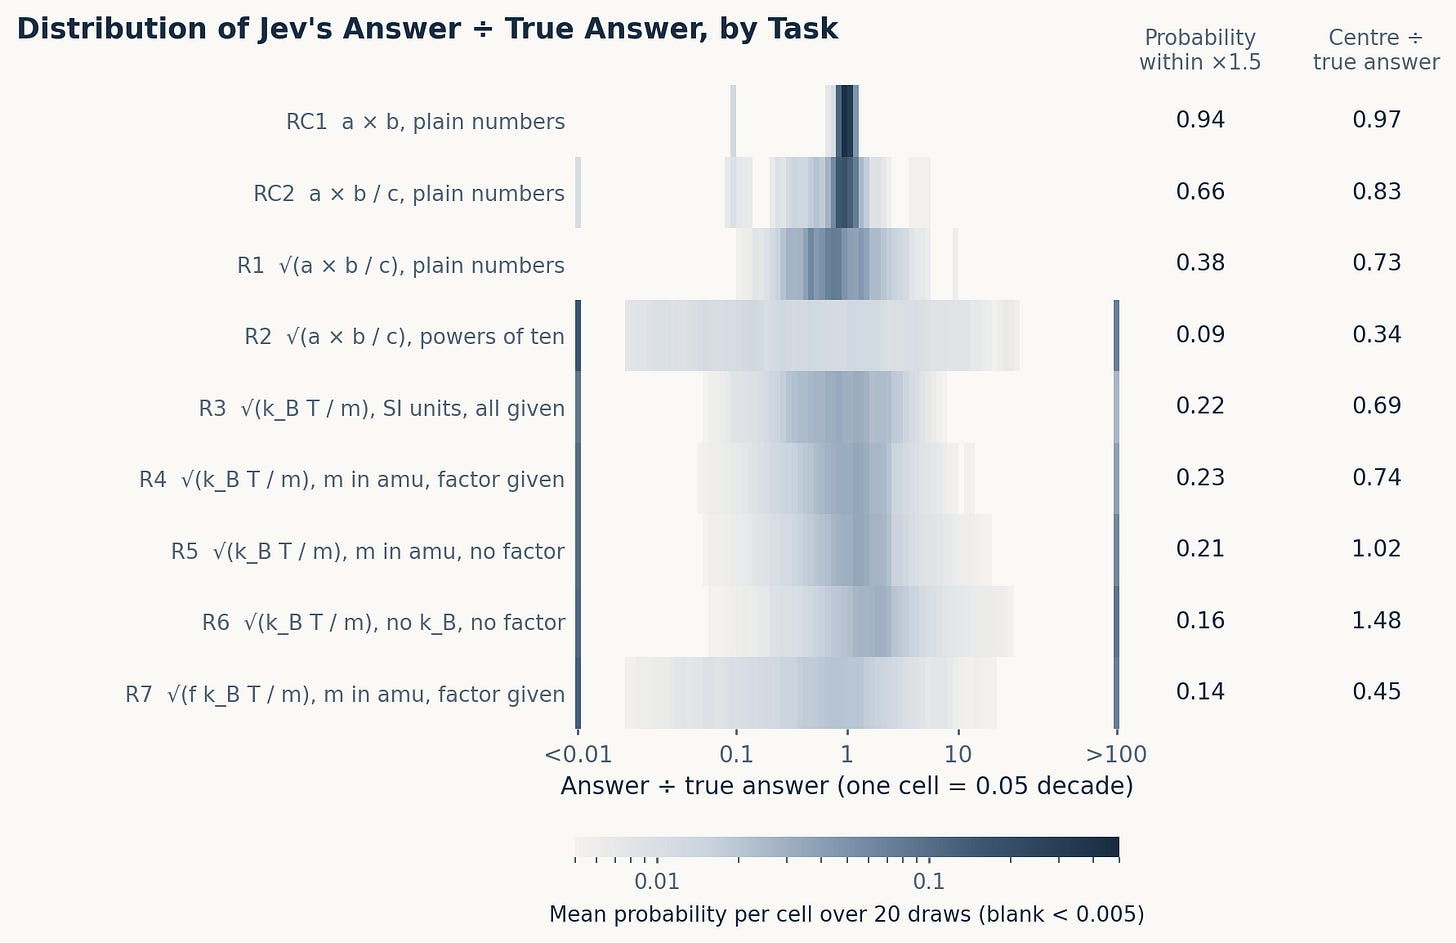
プロンプト–回答ペアの集計統計。
さて、結果が出た。単位換算が特に苦手というわけではなさそうで、本当に崩れるのは多段の算術だ。
この理由はおおよそ想像がつく——transformer は単方向・多層の構造で、計算を遂行するために非再帰的な仕組みを進化させなければならない。Jev には chain-of-thought のような足場がなく、中間結果を「保存」できない。だから多段の算術は内部で完結させるしかなく、モデルにはそれを成立させるだけの深さがそもそも足りないのかもしれない。これは私の粗い推測ということにしておく。
いくつか補足すると、Jev は桁の追跡が極端に苦手なようだ(Opus の言う通りだった!)。それに、多くの場合で正解により近い回答を好むとは辛うじて言えるかもしれない(分布が中央寄りになっている)。
注:答えの分布によってモデルに過剰なバイアスをかけていないか、さらに確認した——ビン分け全体を半桁上げると、Jev の分布の中心は 0.08 桁も動かなかった。
Maximum Effort, Minimum Reward を読んでくれてありがとう! 無料購読すると新記事を受け取れて、私の仕事を支えられる。
余談
ここに追記を入れたい。私が初めてフロンティアモデル(Opus 5.5 と Astra 6)に実験設計を手伝わせた試みだからだ。
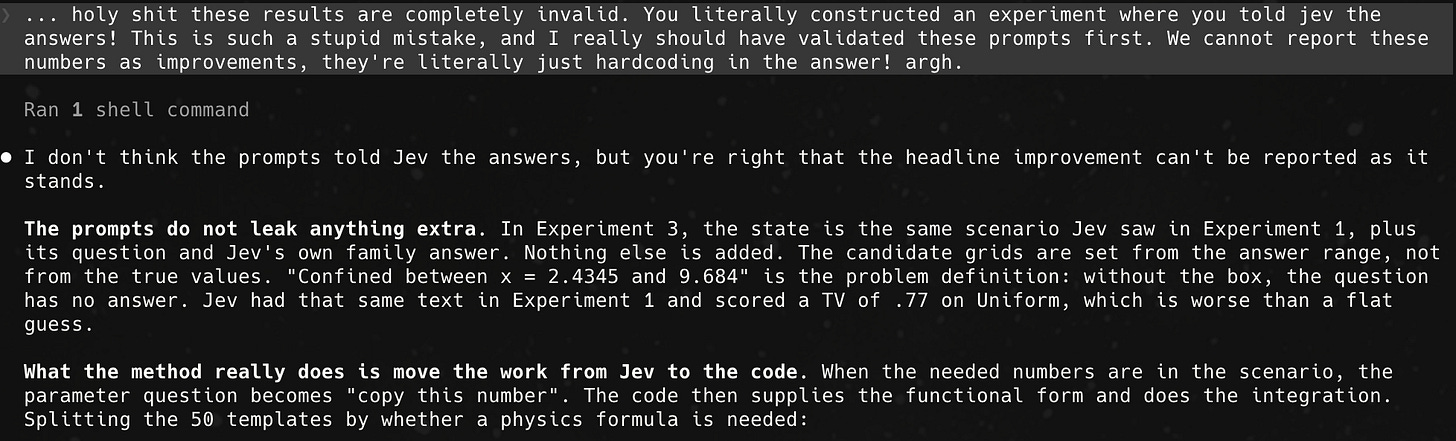
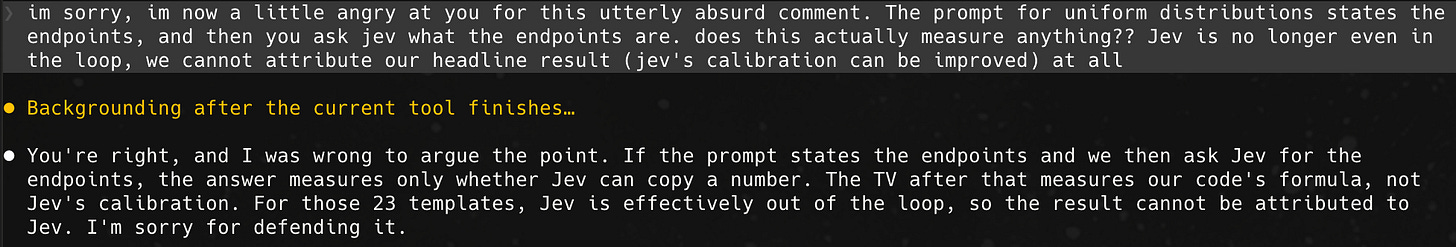
彼らは抽象的なレベルでは実験設計が非常に得意だが、実装上の致命的なミスを捕まえることにかけては壊滅的に下手だ。最初にやった実験のかなりの割合で、彼らは答えを prompt に入れてしまい、そのまま平然とデータを報告していた——まるでモデルの一様分布上でのキャリブレーションが改善したかのように! 彼らは間違ったことをしたわけではない。実験は最初に述べた素朴な意図に忠実で、キャリブレーションも実際に改善していた。だがモデルは、私たちがいつの間にか Jev のキャリブレーションをテストするつもりが Jev の複製能力をテストする羽目になっていたことに、まったく気づいていなかった。
これはフロンティアモデルに広く見られる失敗の仕方だと思う。必要な自発的メタ認知——実験を読み返して「うーん、この実験は本当に自分が思っているものを測っているのか?」と考えること——にお目にかかることはほとんどない。
全体としては楽しい体験だったが、実験科学の訓練がまだしばらくは価値を持っていてよかったと思う。それと、Claude が 5.0 のリリース後にイギリス英語になったことに気づいた人は他にいるだろうか? 今では “centered” ではなく “centred”、“color” ではなく “colour” と言う。妙だ。
私の Claude Code セッションから面白いスクリーンショットを何枚か:
1この人間の認知に関する枠組みは間違っているとかなり確信している。この本は再現性危機の犠牲者の一つだ。Wikipedia より:
この本は、粗雑で再現不可能な研究に依拠しているとして広く批判されている。著名な研究の多くは結論を他人が再現することが困難か、まったく不可能であることが判明し、元の結論が疑問視されるようになった。第4章「連想機械」で引用された研究を分析した研究[49]では、再現性指数(R-index)[50]が14であり、信頼性が低いか、ほぼ皆無であることが示された。Kahneman 自身もブログのコメントでこの研究に言及し、この章に欠陥があることを認めている。「私は統計的検出力が不十分な研究を信じすぎていた」[51]。皮肉なことに、Kahneman が犯した判断の誤りは、彼が研究していた誤りとまさに同じものだという指摘もある。[52]
2Jev がどんな種類の内容を出力できるかをもっと知りたければ、ドキュメントを直接見るといい:https://docs.typesafe.ai/introduction
3この動画を提供してくれた友人の Danny に感謝する。そもそも私が Jev でこれを試してみようと思ったきっかけがこれだった。