文本分类的语言模型:从词袋到Jev
从朴素贝叶斯、RNN、CNN 到 Transformer,Raschka 梳理了文本分类的整条技术路线,再用 IMDb 实测 Jev:Choice API 达 96.47% 准确率、成本 0.65 美元,与微调后的 ModernBERT 相当,且不需训练。
中文
复制
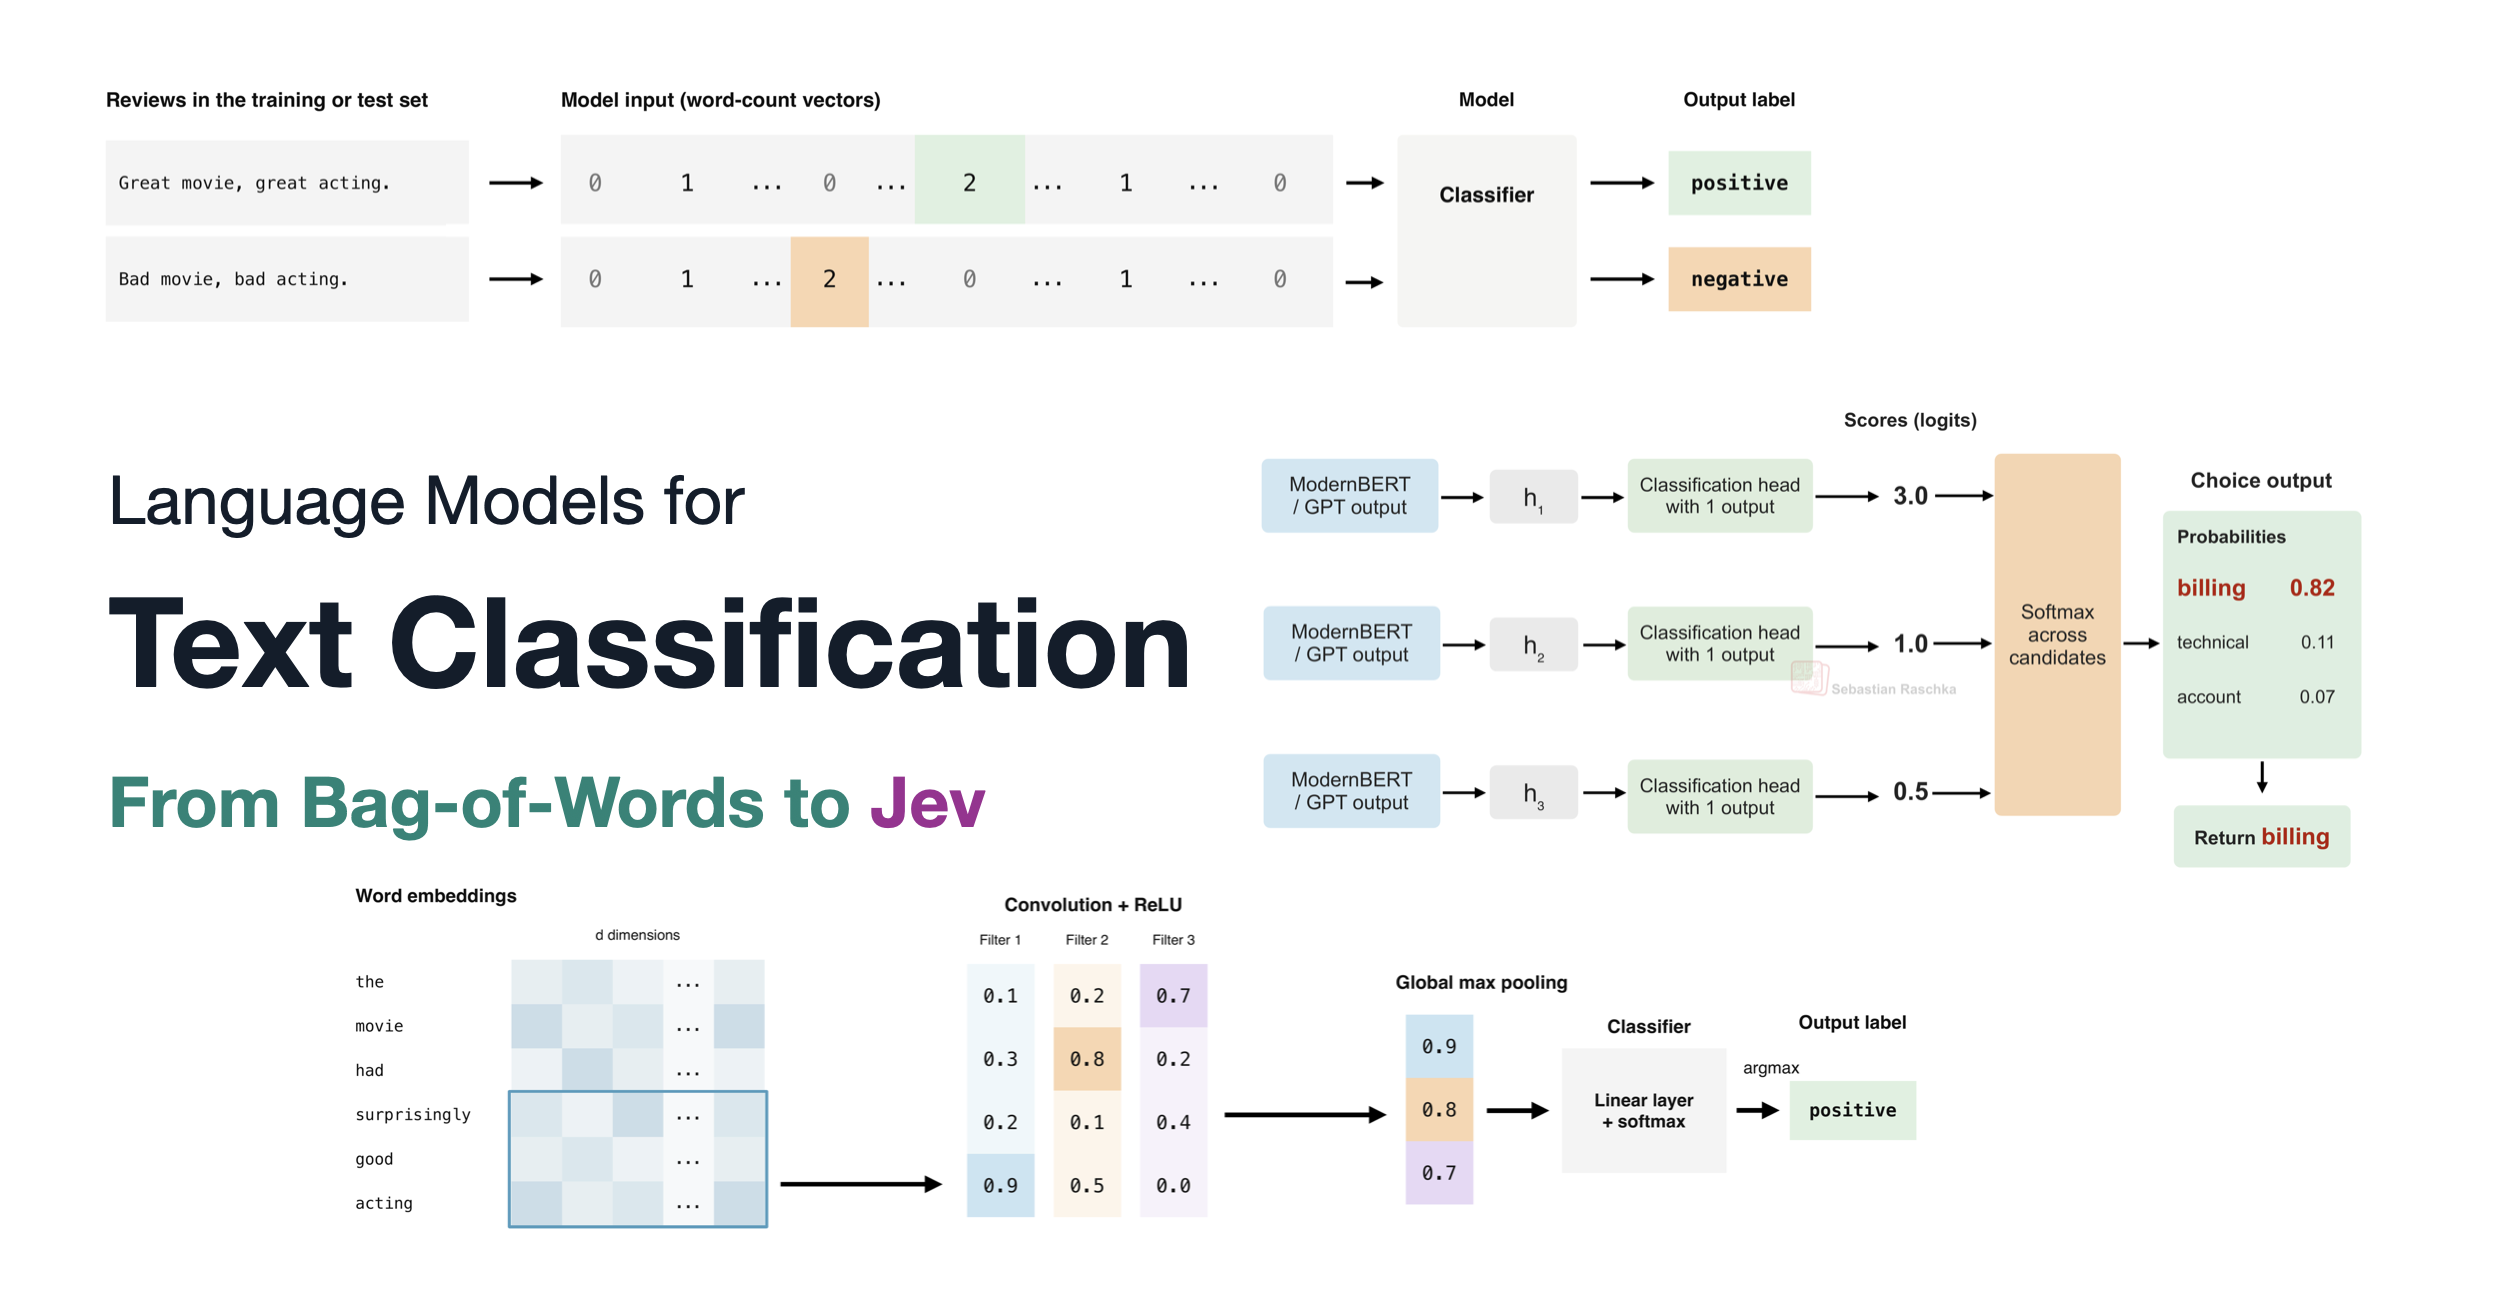
用于文本分类的语言模型:从词袋到 Jev
词袋、RNN、CNN、Transformer、类 Jev API 与校准的可视化指南
最近发布的 Jev AI 模型在过去两周里成了技术社区里的一种文化现象。Jev 的目标是给东西分类,但人们很容易把它贬为“不过是个分类器”。而我自己对 Jev 的看法,在过去几天里也变了不少。起初我想的是“分类器曾经是我的看家本领,这种东西我自己就能轻松搭出来”(后面还会细说),后来变成了“哇,它实际效果比我以为的要好。”
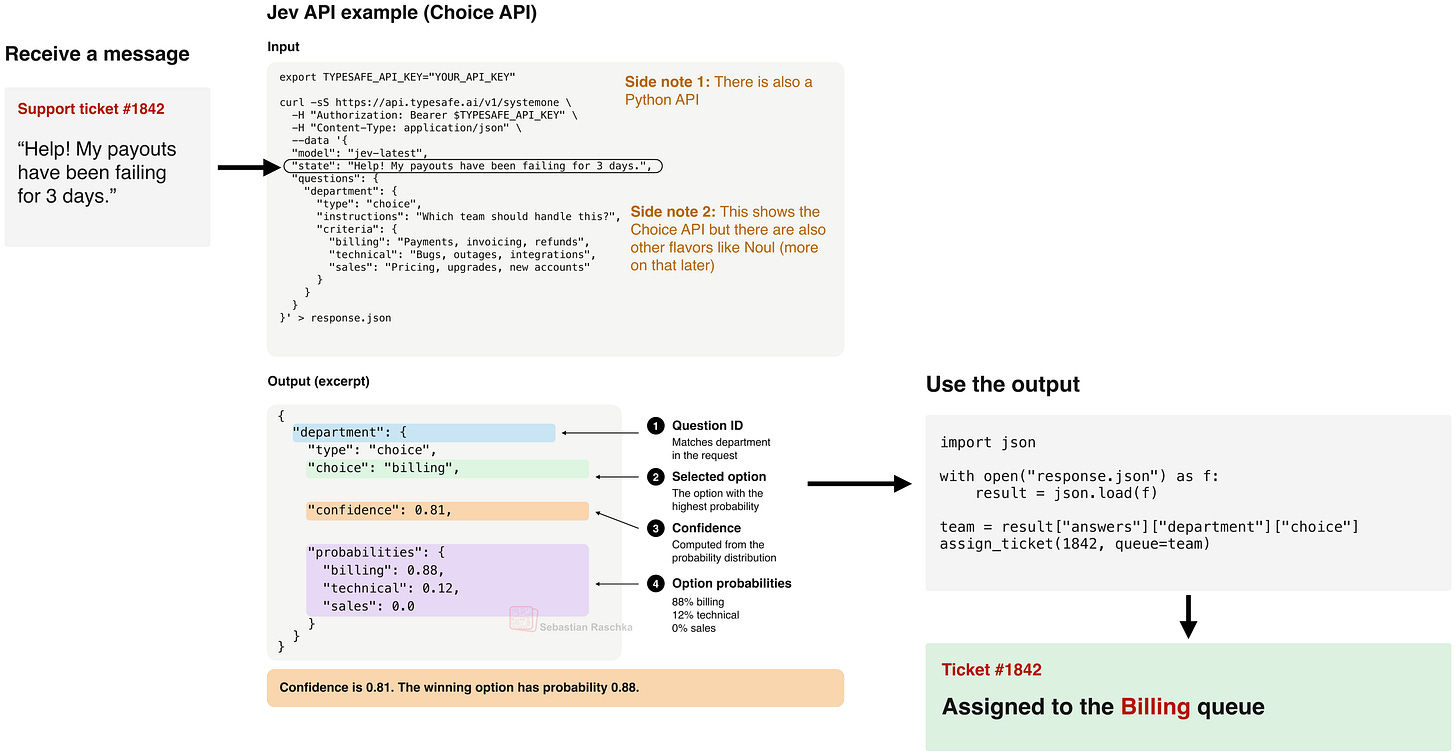 图 1:Jev API 速览;细节稍后展开。
当然,最新的 SOTA GPT 和开放权重 LLM 也能做 Jev 那类分类任务,而且还能胜任更通用的决策。但 Jev 的优势在于,它做这些分类任务要快得多、便宜得多。
在光谱的另一端,对于一个狭窄、定义明确的问题,Jev 的分类效果、速度和成本大概都赢不过专用分类器。但它真正的卖点在于,它比那些任务专用模型通用得多。
那么,Jev 背后的方法是什么(基于合理推测),它能做什么,又为什么这么火?这些我打算在本文后面回答。不过我觉得,先简要回顾一下用于决策的语言模型的发展史,会是个不错的开头。这或许也有助于拨开一些炒作,看清 Jev 究竟擅长什么(“Jev 本质上是个文本分类器”,但“Jev 也不‘只是’个文本分类器”。)
附注:我与 Jev 没有任何关联,也没有获得 Jev 的免费访问权限。本文不是产品背书,只是一篇技术文章,借梳理文本分类的历史,帮你理解最近的这波热度。
这篇文章比较长,我建议在浏览器里阅读,左侧有目录菜单可用。
1. Transformer 之前的语言建模与分类
为了完整起见,在把 Jev 放进上下文之前(此处并无双关之意),我觉得按时间顺序讲最合理。这一节里,我想简单走一遍应用文本分类的历程:朴素贝叶斯、逻辑回归,以及 transformer 模型出现之前更经典的(深度)神经网络。
1.1 词袋:朴素贝叶斯、逻辑回归与 XGBoost
当年,也就是 15 年前我读研的时候,尽管循环神经网络已经存在(后面会讲),文本分类通常还是用词袋表示来做,因为它简单直接,在中等规模数据集上就能取得不错的结果。
简而言之,词袋表示可以理解为一种方法,它让长度不一的自由文本输入,能够喂给那些要求固定大小输入向量的经典分类器(朴素贝叶斯、逻辑回归、SVM、随机森林、XGBoost 等等)。
现实世界中,它的应用范围很广,从新闻文章分类到电子邮件垃圾邮件过滤,都能见到它的身影。据说 Gmail 最初的垃圾邮件过滤器用的就是朴素贝叶斯模型,配合词袋表示。
顺带一提,我写过关于这个方法的文章,正好是 12 年前。那是我在 arXiv 上最早分享的内容之一。
 图 2:我在 2014 年写的一篇旧教程,用词袋模型讲解朴素贝叶斯分类器。
那么,词袋表示到底是什么?它是一种把长度不一的自由文本转换成固定大小表示的方法,供前面提到的那些“经典”分类器使用。比如:
- 训练样本 1:“Zentropa 是我这些年看过的最具原创性的电影。如果你喜欢受黑色电影影响的独特惊悚片,那这部正好能解掉那些年复一年堵满影院的 Hollywood 暑期大片的腻。Von Trier 后来的作品如 Breaking the Waves 获得了更多赞誉,但这才是他真正最好的作品。”
- 训练样本 2:“这部电影简直糟透了。John Ritter 在演摔跤滑稽戏,75% 的演员念台词像在照着提词卡读,剪辑糟糕,混音糟糕。”
- 训练样本 3:“Zentropa 与 The Third Man 有很多共同之处,后者也是一部黑色电影风格的片子,背景设在战后欧洲的废墟之中。”
(上面的例子摘自广为人知的 IMDb 电影评论分类数据集。)
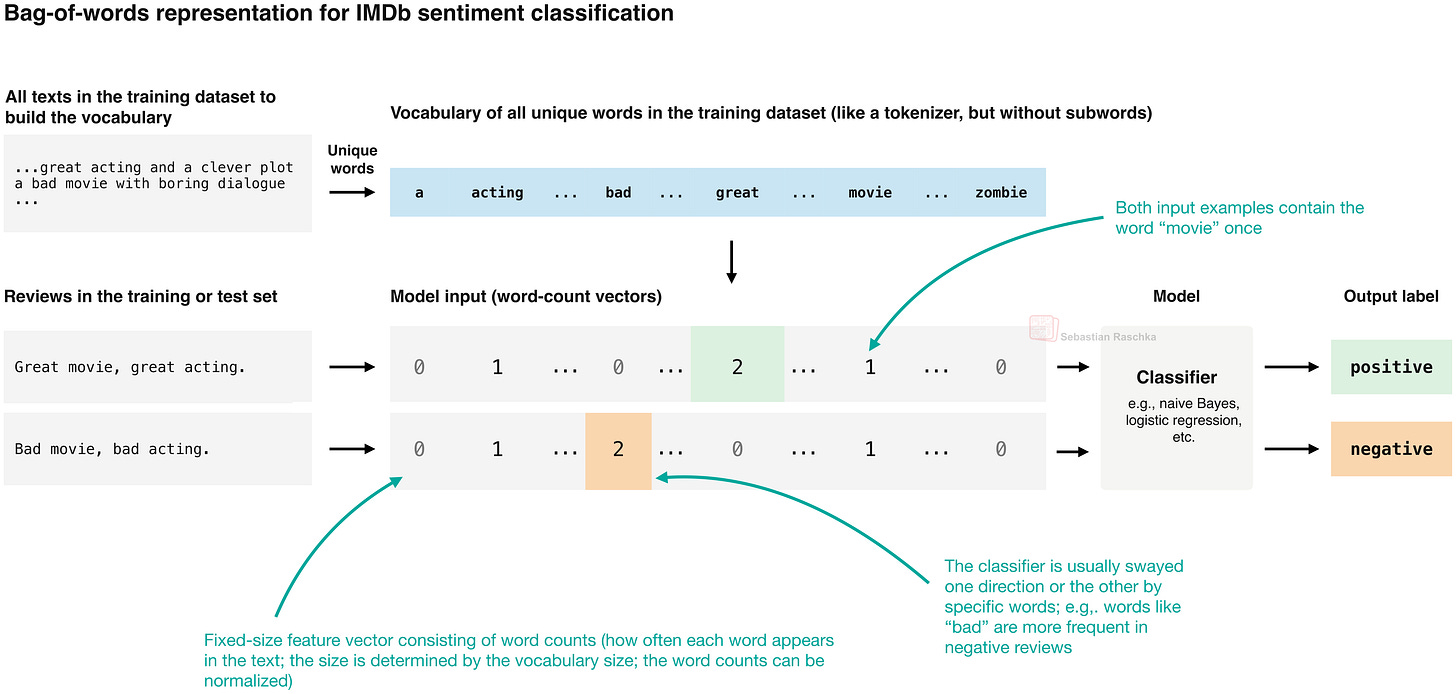 图 3:词袋表示的示意图。
词袋模型首先构建词表,也就是训练集中所有不重复的词(也可以选择去掉所谓的停用词,比如 “a” 和 “the”,这些词在大多数语境下几乎不携带语义信息)。
词袋表示会给词表中的每个词分配向量中的一个位置,从而得到这些固定大小的输入。然后统计每个词在文档中出现的次数。举例来说,如果词表有 50,000 个不重复的词,那么无论输入是只有十个词还是有 30 万个词,都会生成一个固定大小、包含 50,000 个条目的向量。注意,大多数条目都是零,因为每篇文档只包含词表的一小部分。(除了直接表示原始计数,也有 TF-IDF 之类的归一化方案。)
有了这些词频向量之后,就可以在带标签的训练集上训练分类器,比如标记为垃圾邮件或非垃圾邮件的邮件。以逻辑回归模型为例,它会学习特征权重,把某些词(及其出现次数)与特定标签关联起来。比如,某些词可能提高预测为垃圾邮件的概率,另一些则可能降低它。
这种方法的计算成本很低,当某些词能提供关于标签的强线索时,效果可以很好。在垃圾邮件分类这类简单任务中,它往往足以快速得到相当准确的结果。
但这种思路最大的短板之一在于:词袋表示天生就会丢掉词序。比如 “the dog bites the man” 和 “the man bites the dog” 描述的是两件不同的事,生成的向量却一模一样。
(有一些变通办法可以保留部分局部词序,比如把词对或更长的序列,也就是 n-gram,作为特征加进去,代价是词表会变大。)
尽管有这些缺陷,我仍然认为词袋在某些低风险场景下自有其位置,因为它实在太便宜了;而词袋表示 + 逻辑回归至今仍是我处理任何文本分类问题的首选基线,因为实现起来太容易了。
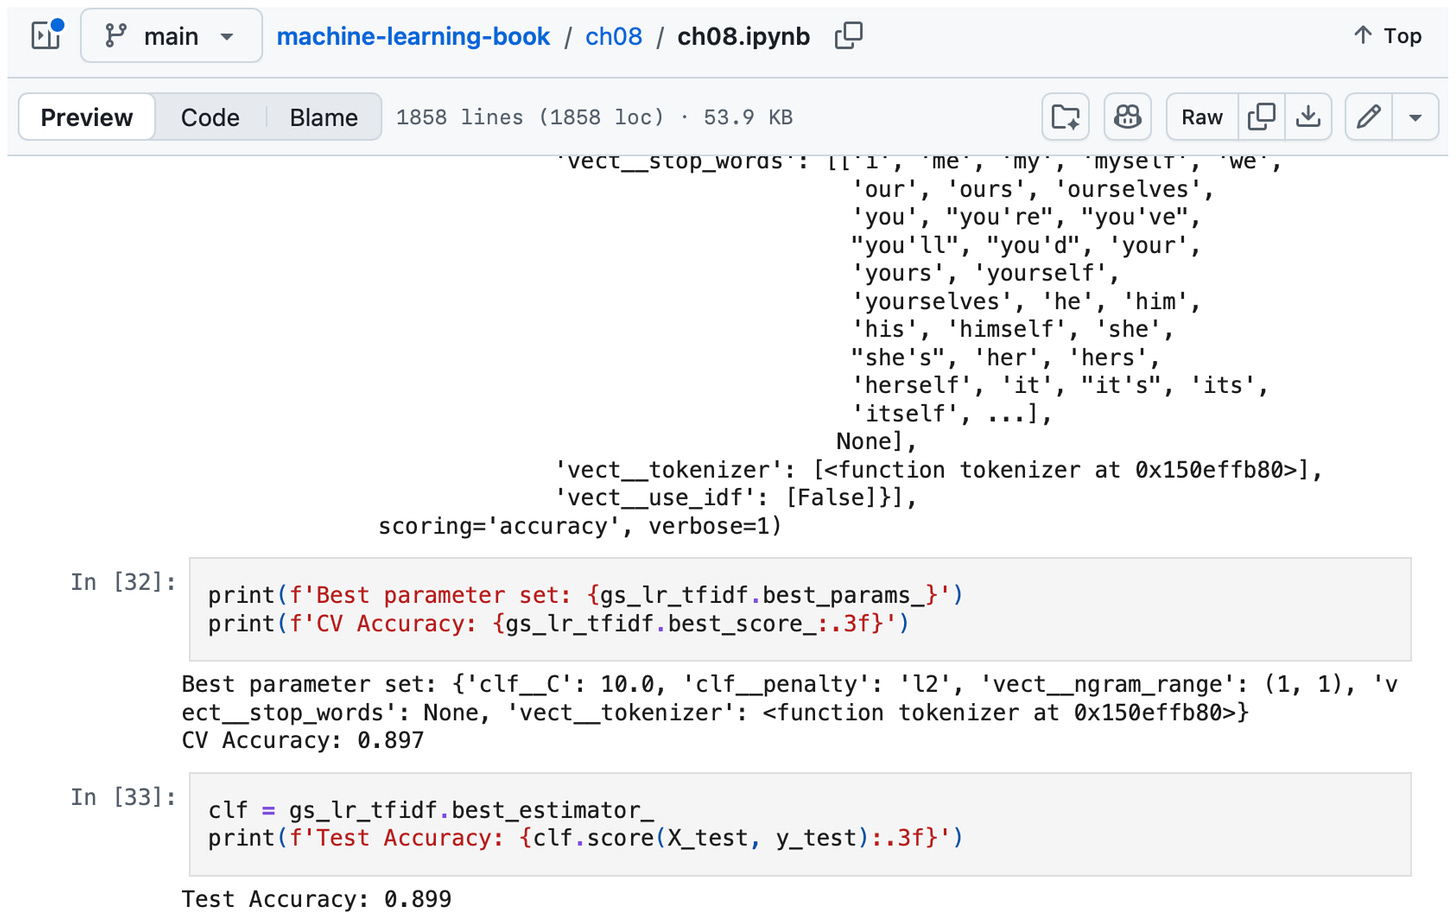 图 4:想动手搭一个简单逻辑回归分类器的话,我写过一篇教程在这里。这个模型(在平衡数据集上)能达到 89.9% 的准确率。
1.2 用于文本分类的深度神经网络
前面说的词袋模型同样可以用在(简单的)深度神经网络上,比如多层感知机。但缺点依旧:句子结构和词序还是会丢。 不过,更复杂的神经网络架构可以绕开词袋这套变通做法:卷积神经网络(CNN)和循环神经网络(RNN),它们可以直接把词嵌入作为输入。
1.2.1 词嵌入
首先,在把输入文本喂给模型之前,得先把它转换成合适的表示。词袋是一种表示,词嵌入向量是另一种。区别在于:词袋向量通过统计每个词表词出现的次数来表示整段文本,而词嵌入把单个词表示成一个稠密的学习到的数值向量。
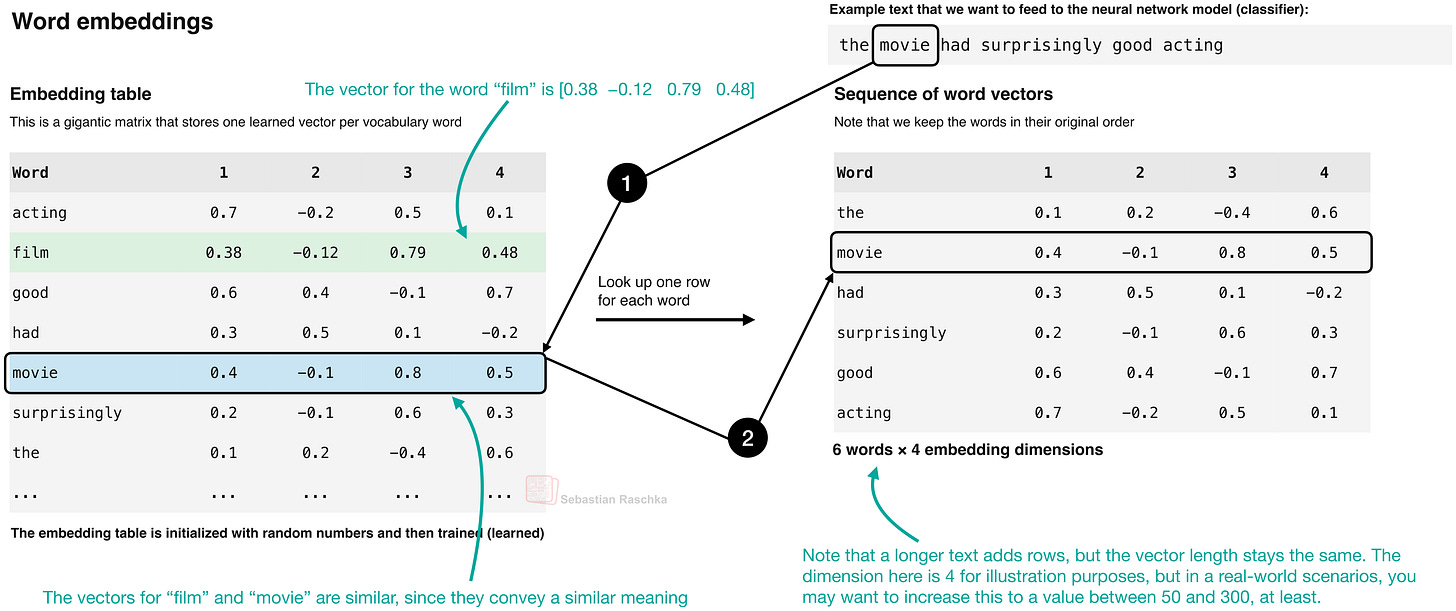 图 5:词嵌入的构建示意。
- 词嵌入的工作方式与 LLM 中的嵌入层类似,都是把输入 token 转换成稠密向量。嵌入可以在模型外部完成(例如两种经典且流行的学习方法是 Word2Vec 和 GloVe),也可以把嵌入层作为神经网络架构的一部分,在训练过程中学习和调整。这些经典嵌入在查表时是与上下文无关的。比如 “bank” 这个词,在 “river bank” 和 “bank account” 中得到的是同一个向量(如你所知,上下文可以通过 attention 之类的机制来处理)。关于嵌入的更多资料,下面这些可能有用:第 2 章:Working with Text Data(这是 LLM 的章节,但足以让你理解词或 token 的嵌入是怎么回事;在 LLM 的 tokenizer 里,我们会把词拆成子词 token;而在 Word2Vec 里,通常 1 个词就是 1 个 token。)
- Understanding the Difference Between Embedding Layers and Linear Layers(这篇图文说明了在什么情况下嵌入向量在数学上等价于 Linear 层和矩阵乘法。)
1.2.2 循环神经网络(RNN)
由于在座许多人应该都熟悉循环神经网络(RNN),这一节我会讲得简短些。RNN 是自然语言处理中经典的神经网络架构,其流行变体可以追溯到 20 世纪 80 年代和 90 年代初。2017 年问世的 Transformer(它使用的注意力机制最早正是在 RNN 中提出的;简要时间线见我的《理解大语言模型》)随后在许多 NLP 应用中逐渐取代了 RNN。
RNN 一次读取序列(比如文本)中的一个词。每一步,它把当前词的嵌入(上一节讨论过)与上一步的隐藏状态结合起来。可以把隐藏状态看作一个固定大小的向量,用来概括到目前为止处理过的文本,因此词序变得重要,因为重新排列词语会改变状态更新的顺序。
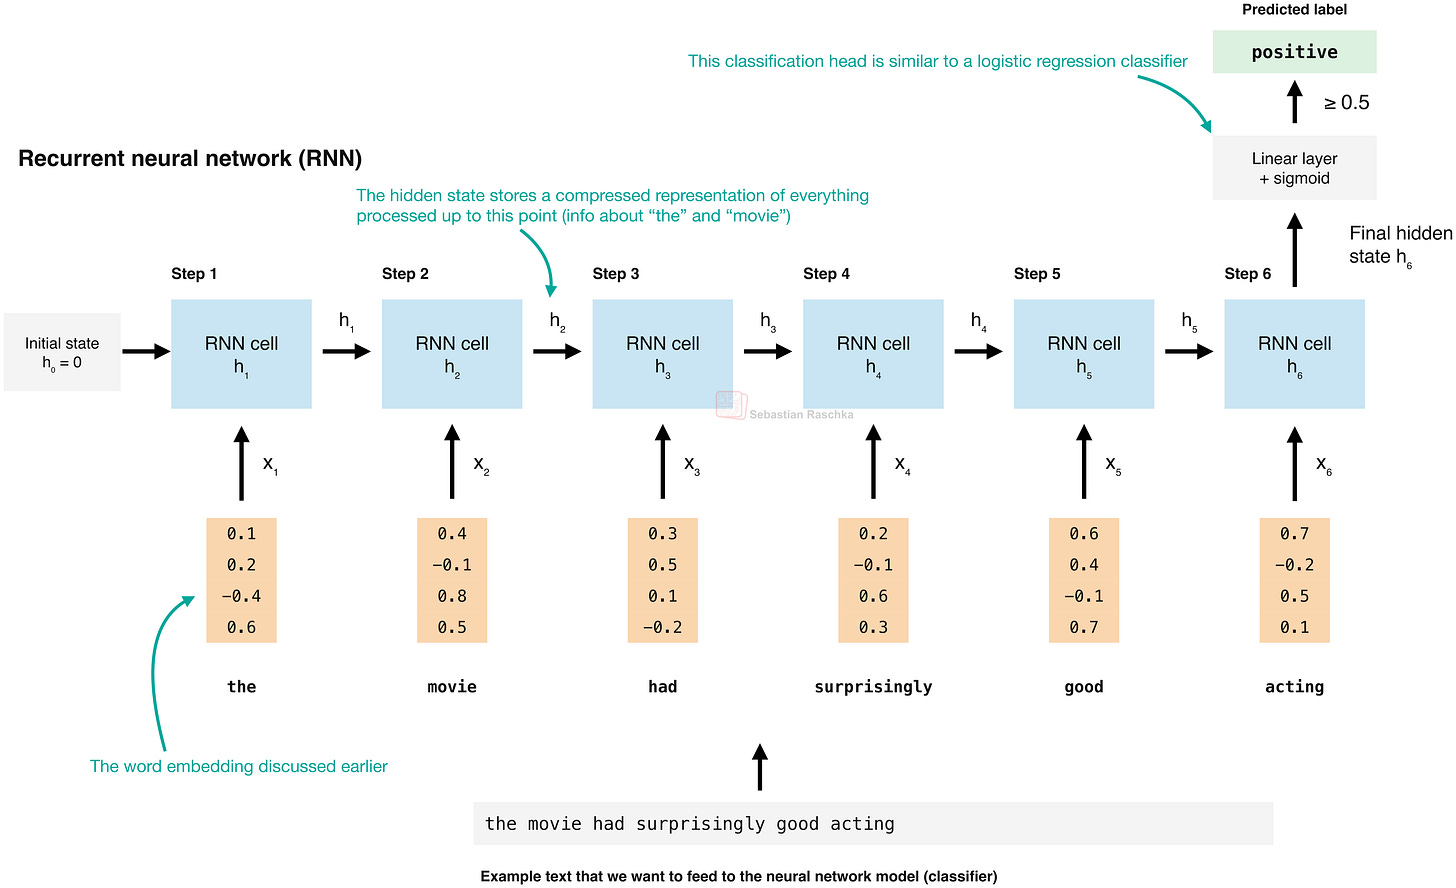 图 6:RNN 分类器示意图。
注意上图展示的是 RNN 的展开表示,也就是说,RNN 对每个输入复用同一套层,这正是“循环”一词的由来。也正因为是“循环”的,输入文本可以有任意长度。下图把“循环”的展开表示与折叠表示并排展示。注意两者是同一个架构,只是可视化方式不同。
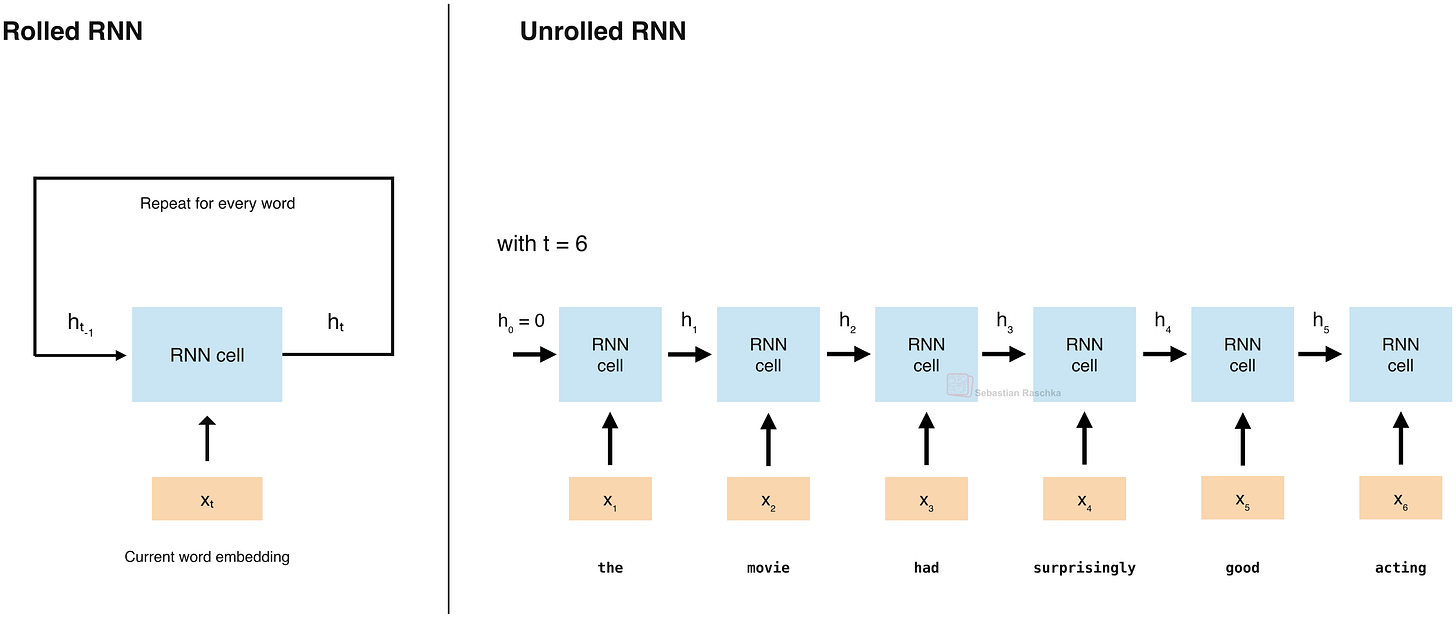 图 7:同一个 RNN 的折叠与展开示意图。
RNN 出了名地难训练,对此有不少重要改进,比如 1997 年提出的长短期记忆(LSTM)网络,以及 2014 年提出的门控循环单元(GRU),它们用学习得到的门来控制信息的保留与更新。(还有更近的 xLSTM:扩展长短期记忆,2024 年提出。)
此外,状态空间模型也受到这种“固定大小隐藏状态按顺序更新”思路的启发,它比 Transformer 的注意力更省算力。但瓶颈依然在于隐藏状态能保留多少信息,而且它仍必须按顺序处理。(有趣的是:注意力最早是为 RNN 开发的,之后才有 Transformer 架构,不过这是另一个故事了;我在《理解大语言模型》一文中写过。)
结论是,RNN 可以用来训练文本分类器。回到 IMDb 影评数据集,带逻辑回归的词袋分类器达到了约 89.9% 的准确率(在平衡数据集上),而 LSTM RNN 只有 85.66%。没错,RNN 确实更难训练(请继续关注下面的 ULMFiT 方法,它训练的 RNN 准确率高得多)。
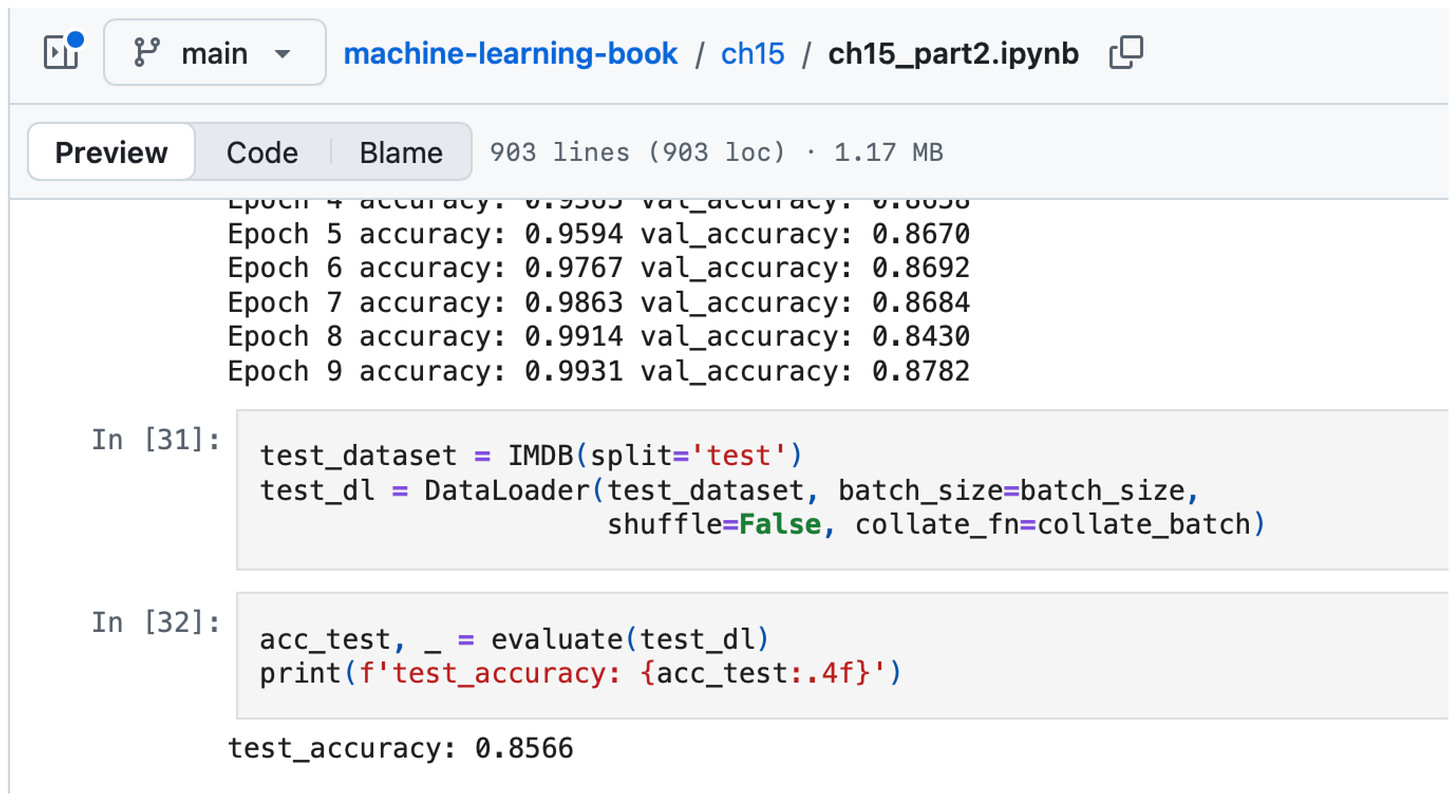 图 8:一个带 LSTM 的简单 RNN 教程。该模型达到 85.66% 的准确率(在平衡数据集上);更高的训练准确率表明存在明显的过拟合。
注意这个 RNN 是从零开始训练的。更好的做法是先在更大的数据集上预训练模型,再在这个目标数据集上微调(传统上,我们把这种做法称为“迁移学习”)。
在自然语言处理领域,提出这一方法的论文中影响力最大的之一当属 ULMFiT(2018),它在 IMDb 上取得了 95.4% 的测试准确率。
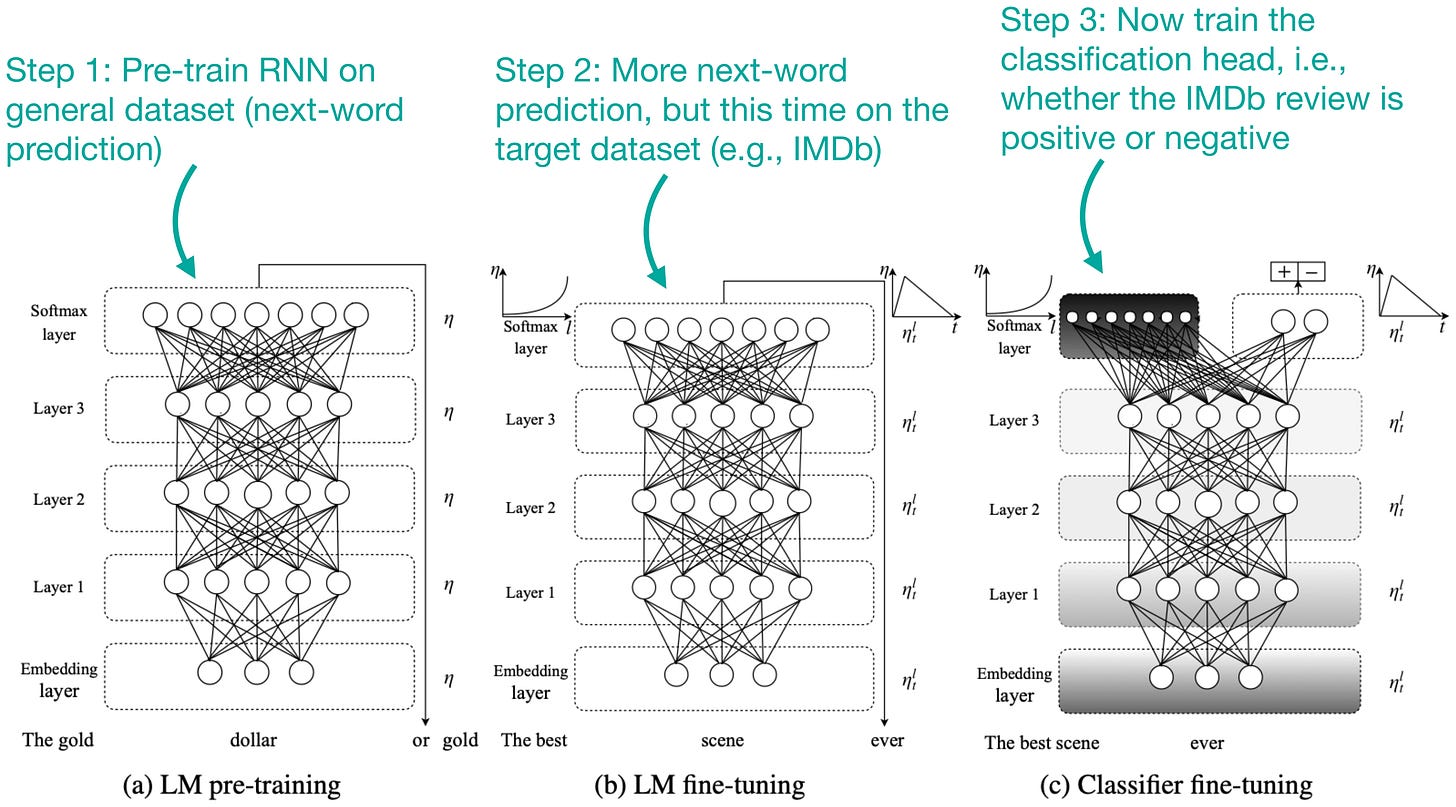 图 9:ULMFiT 论文中的标注图。
1.2.3 卷积神经网络(CNN)
你大概是从计算机视觉里认识卷积神经网络(CNN)的。不过,用它处理文本同样可行,只是历史上不那么常见。
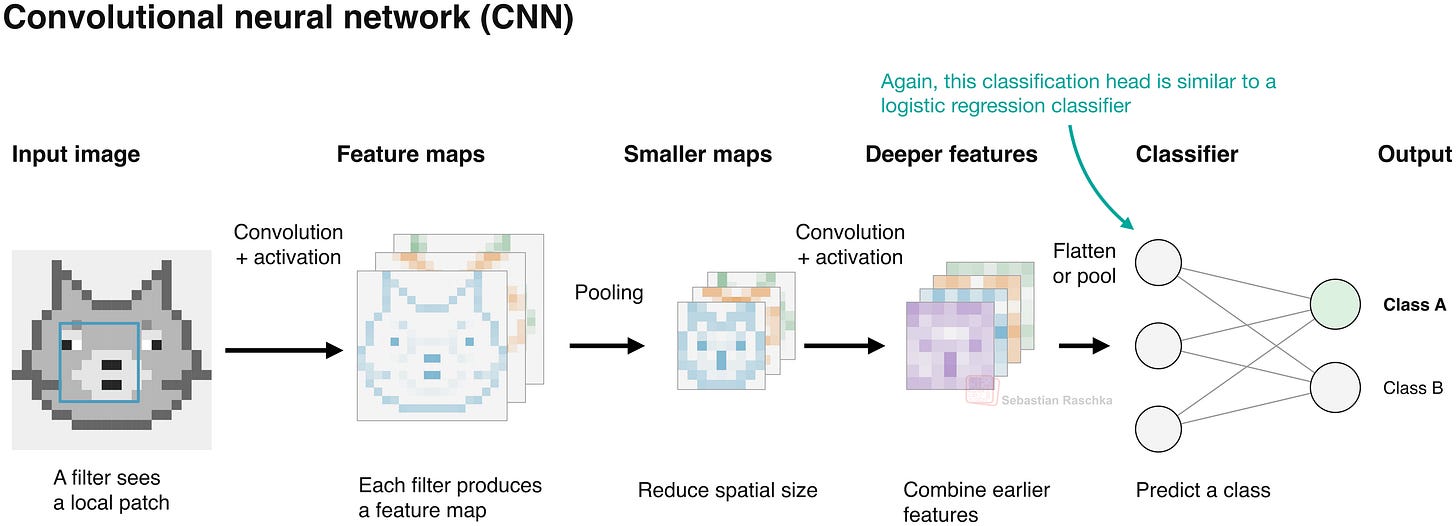 图 10:用卷积神经网络(CNN)对图像分类的示意图。
如上图图像分类的例子所示,CNN 把学到的滤波器作用在图像块(窗口)上。类似地,在自然语言领域,我们可以把学到的滤波器作用在相邻词向量的窗口上。
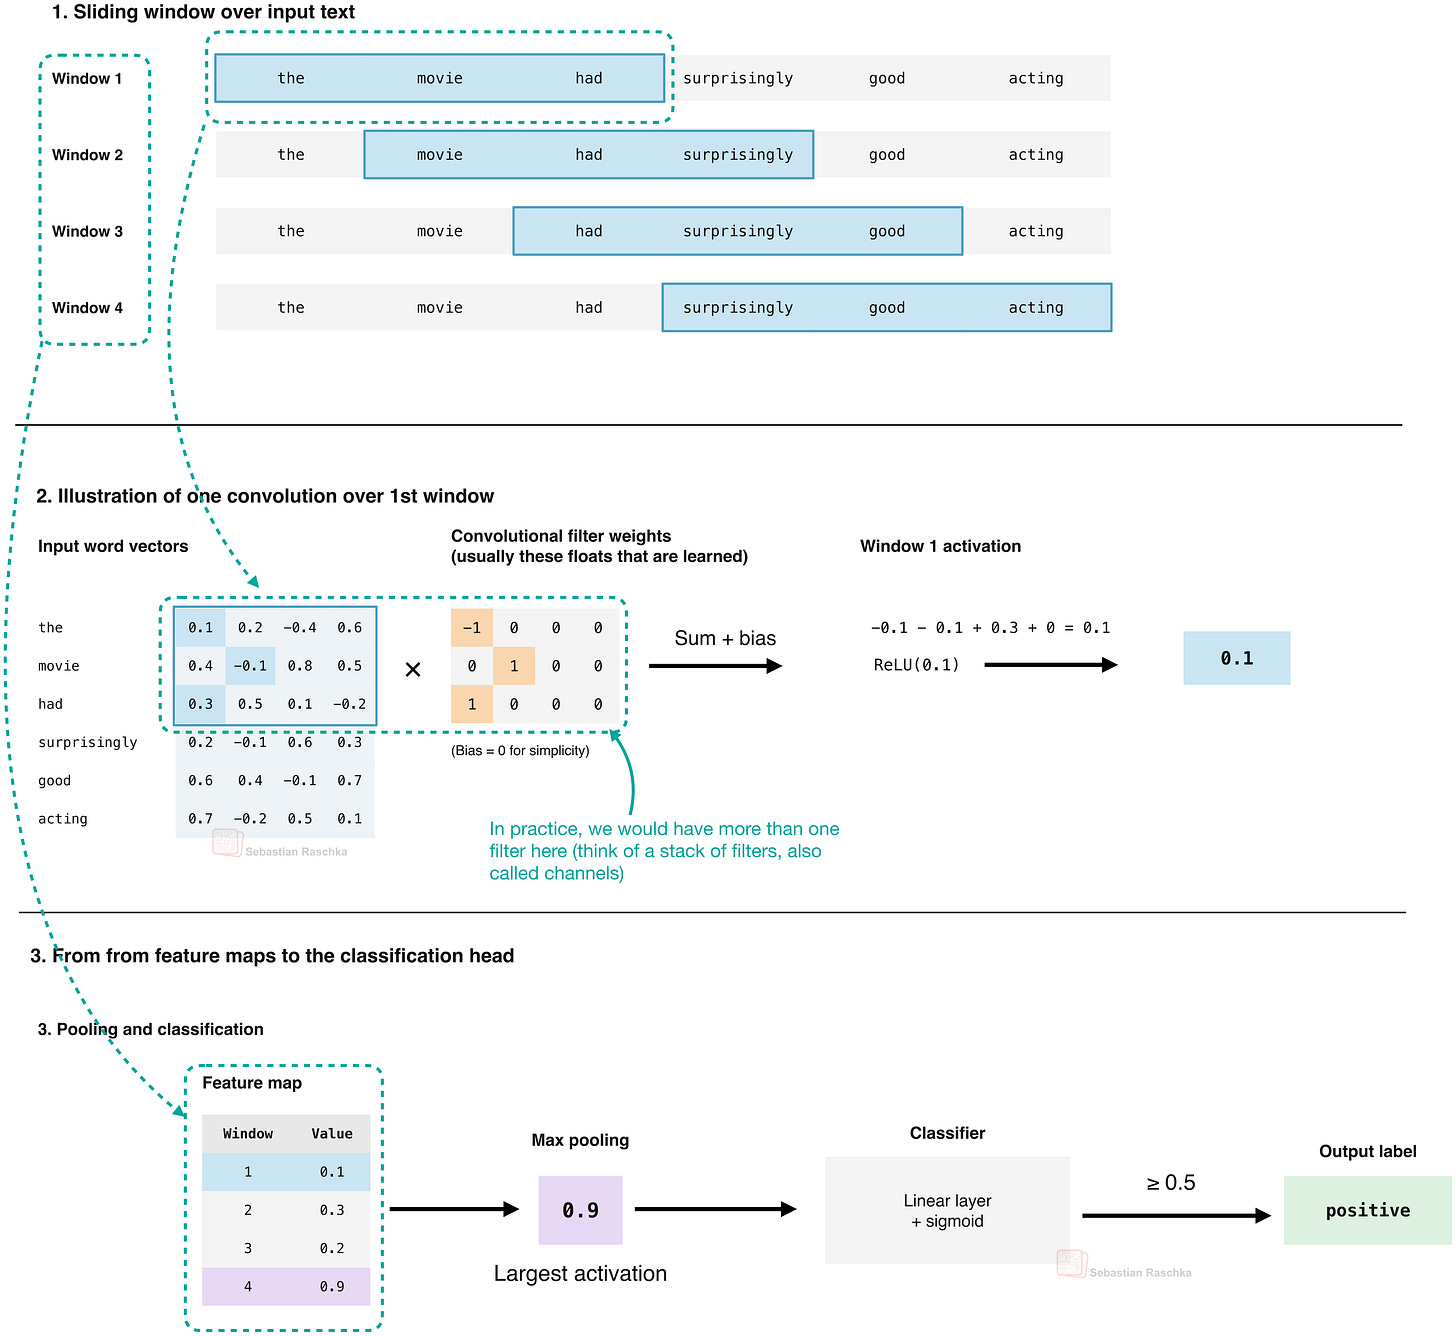 图 11:用于文本分类的 CNN,逐步展示。为简单起见只画了 1 个滤波器(通道)。
如上图所示,窗口大小为 3 的卷积滤波器对每一组相邻的三个词使用相同的权重。它在输入上滑动时,每次沿“the movie had surprisingly good acting”移动一个词。这样就得到四个窗口(为简单起见忽略填充):
- 1:“the movie had”
- 2:“movie had surprisingly”
- 3:“had surprisingly good”
- 4:“surprisingly good acting”
因此在最后一层,也就是分类头之前,我们可以把结果展平或做全局最大池化,再接到分类头上。展平保留了全部信息,但产生的向量长度会随输入文本长度变化。(比如“the movie had surprisingly good acting”更长,特征图就会更长。)所以要想不受输入长度影响,这里用全局最大池化更合适。
简而言之,文本 CNN 可以像下面这样可视化。
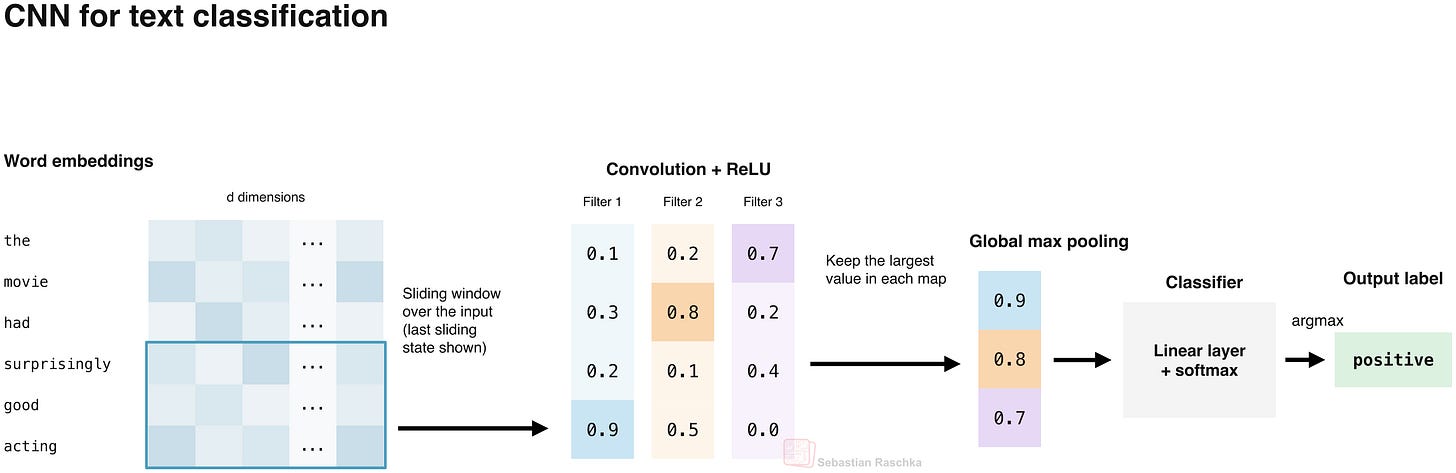 图 12:带多个滤波器(通道)的文本分类 CNN。
另外,各位置上的滤波器计算可以并行执行,这一点很好,避免了 RNN 那种逐步依赖。
做个快速对比:在上述 IMDb 数据集上,我的实验显示这样的 CNN 准确率约为 90.07%(但要注意这高度依赖具体架构;比如你可能从计算机视觉领域知道,准确率的波动可以很大)。(例如,老牌的 AlexNet 在 ImageNet 上 top-1 准确率约 62.5%,而 ConvNeXt V2-H 能到 88.9%。)
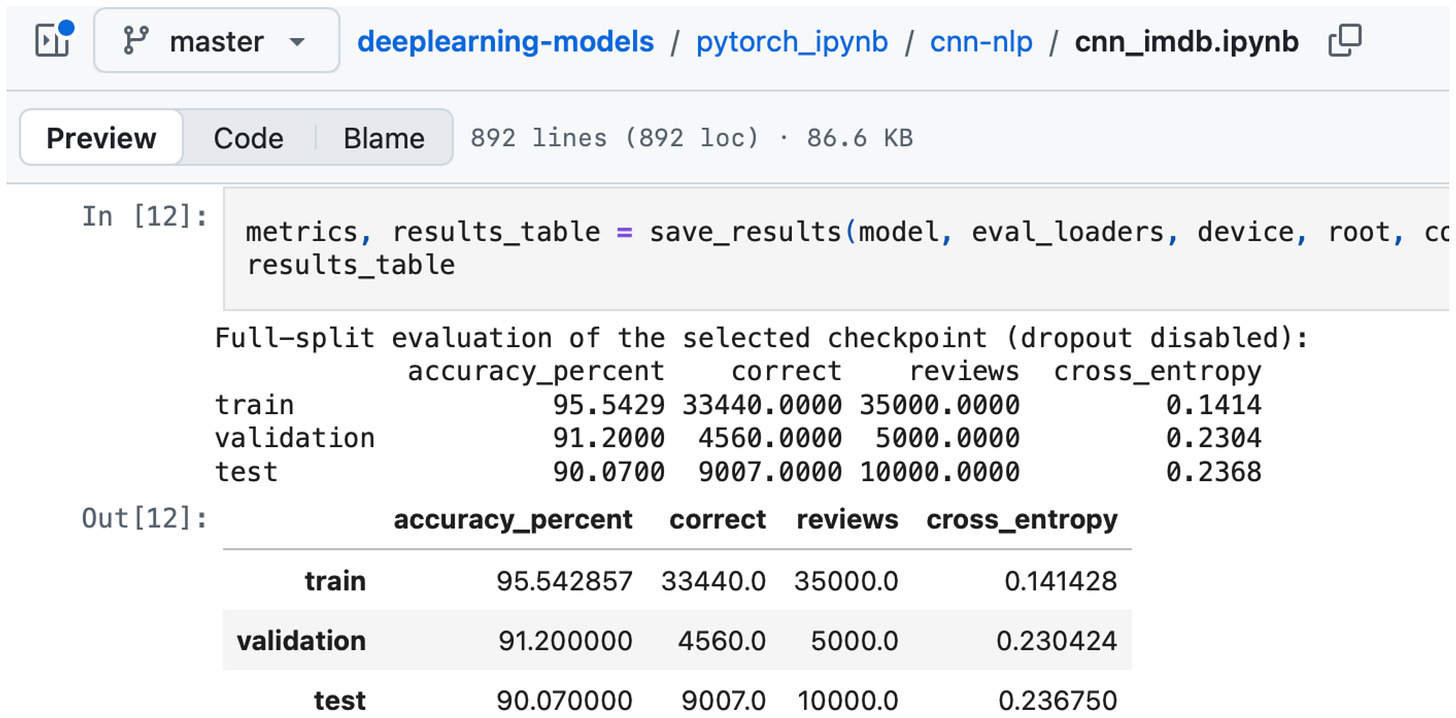 图 13:训练用于 IMDb 影评分类的 CNN;在这个平衡数据集上准确率为 90.07%。源代码见这里。
2. Transformer
2017 年,最初的 transformer 架构在 Attention Is All You Need 论文中提出。这个话题已经被讲得太多(我讲过,别人也讲过),所以我只聚焦与分类相关的部分。对注意力机制和其他架构细节感兴趣的读者,请看我相关的文章:
关键在于,最初的 transformer 架构是用于语言翻译的编码器-解码器结构,但它很容易改造成文本分类任务,下面几节我会具体演示。
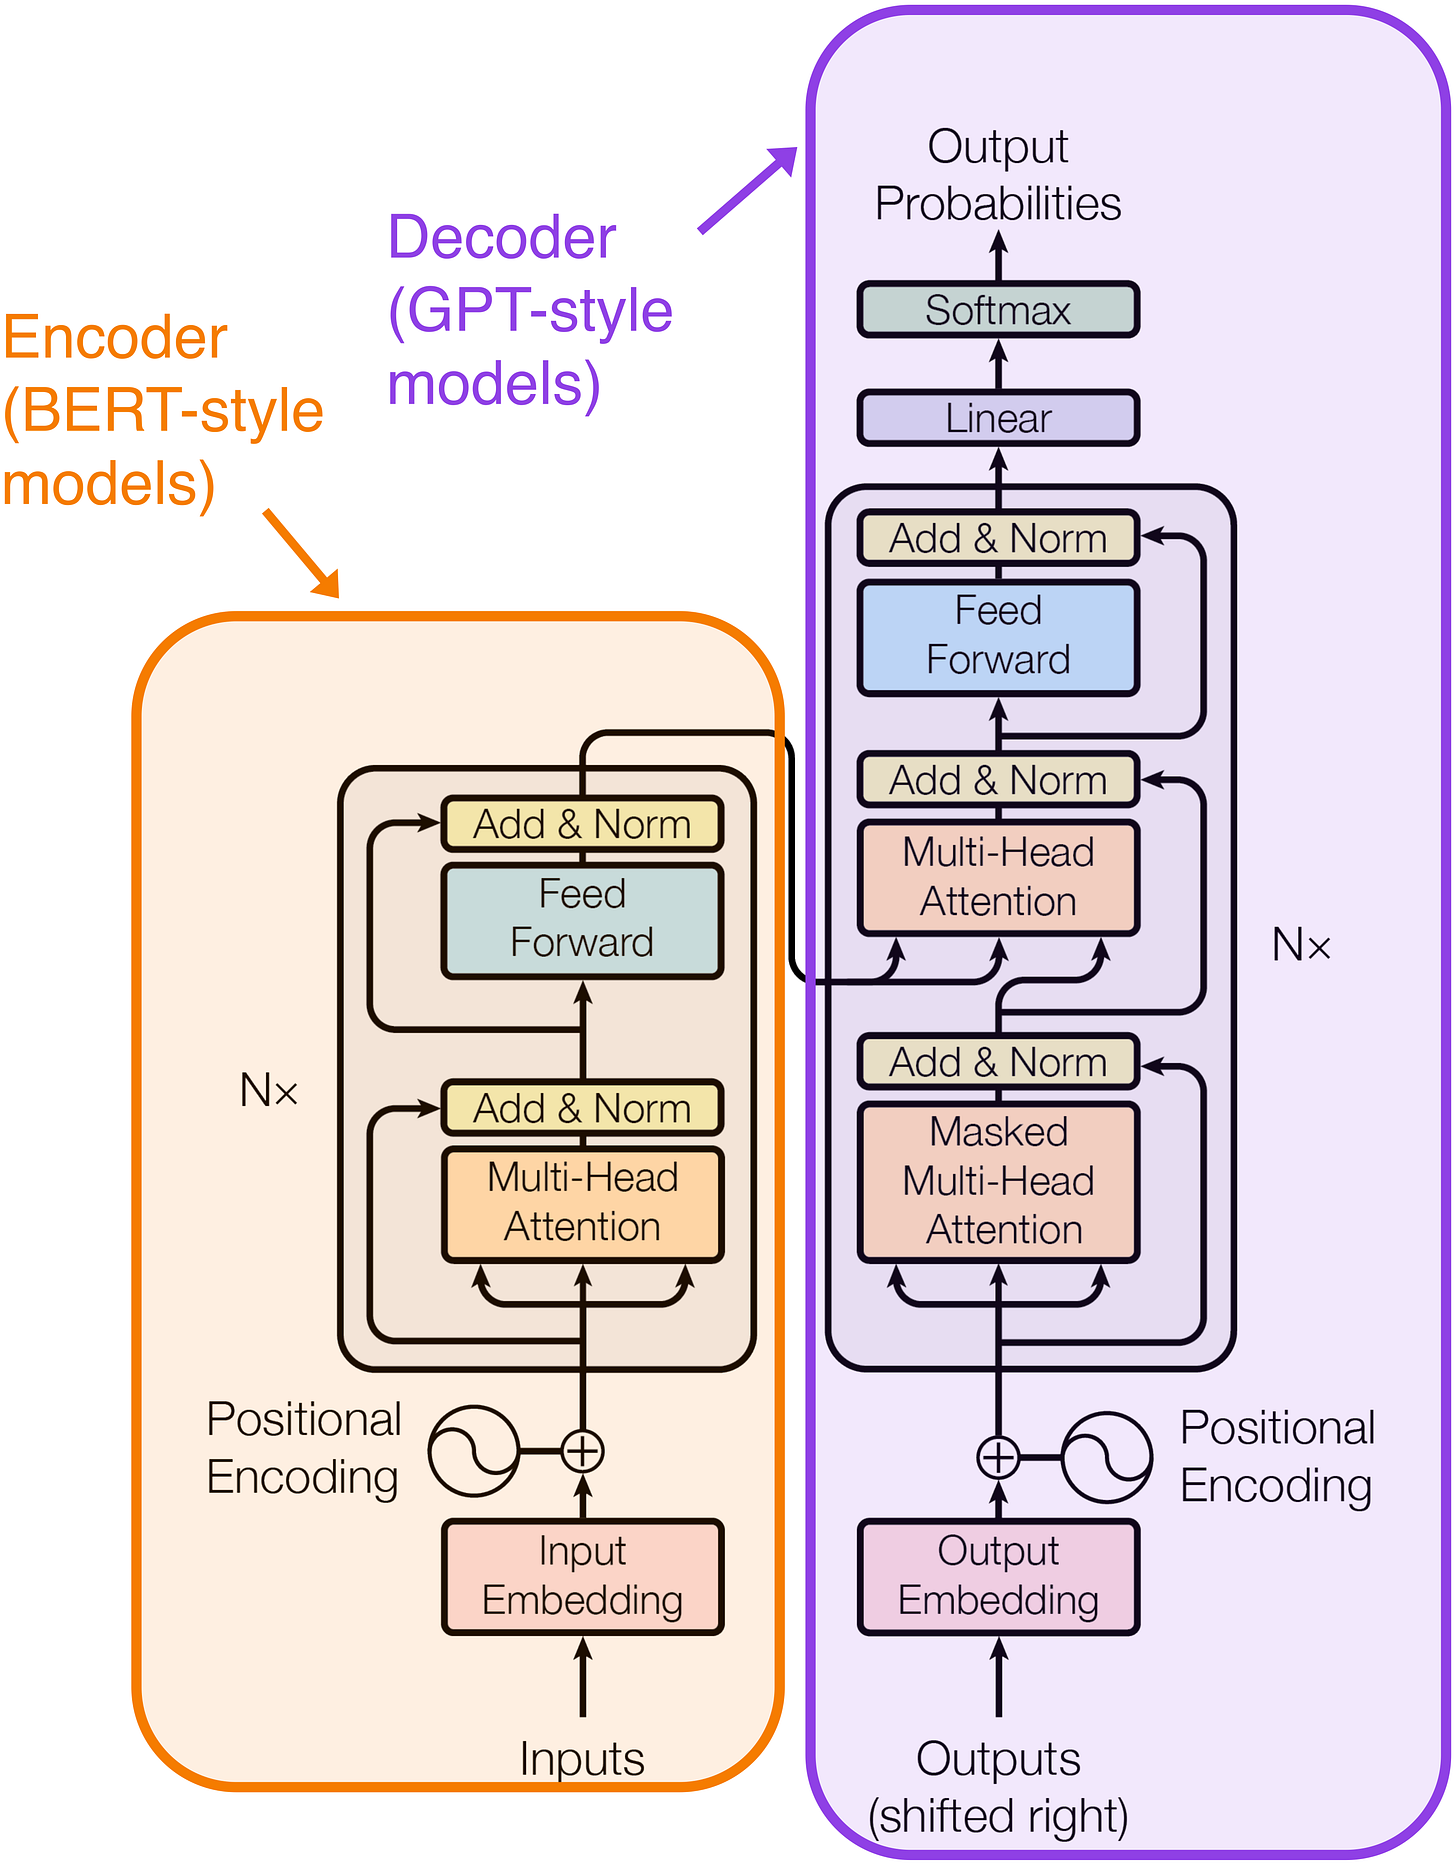
图 14:出自 Attention Is All You Need 的原始 transformer 架构。
2.1 编码器式语言模型
最初那几年我记得太清楚了。当时基本上就是两种路线的对峙:
- 以 BERT 为代表的编码器式模型,主要由 Google 开发;
- 以 GPT 为代表的解码器式模型,主要由 OpenAI 开发。
编码器式模型天生就是文本分类器,而 GPT 模型能靠涌现能力做零样本和少样本分类,但它的强项更多在生成任务上。
先从编码器式模型说起,讲讲怎么微调它们、用它们做文本分类。
用 transformer 有一个共通点,不管编码器式还是解码器式:我们用的都是在大型文本语料上预训练好的模型,除了拿它们做零样本或少样本分类器,还可以在目标数据集上微调(类似前面 RNN 一节提到的 ULMFiT)。
下面这张图截自 2018 年的 BERT 论文,可以看到 BERT 这类编码器式模型在第一个位置有一个分类 token,正好方便我们针对分类任务微调。
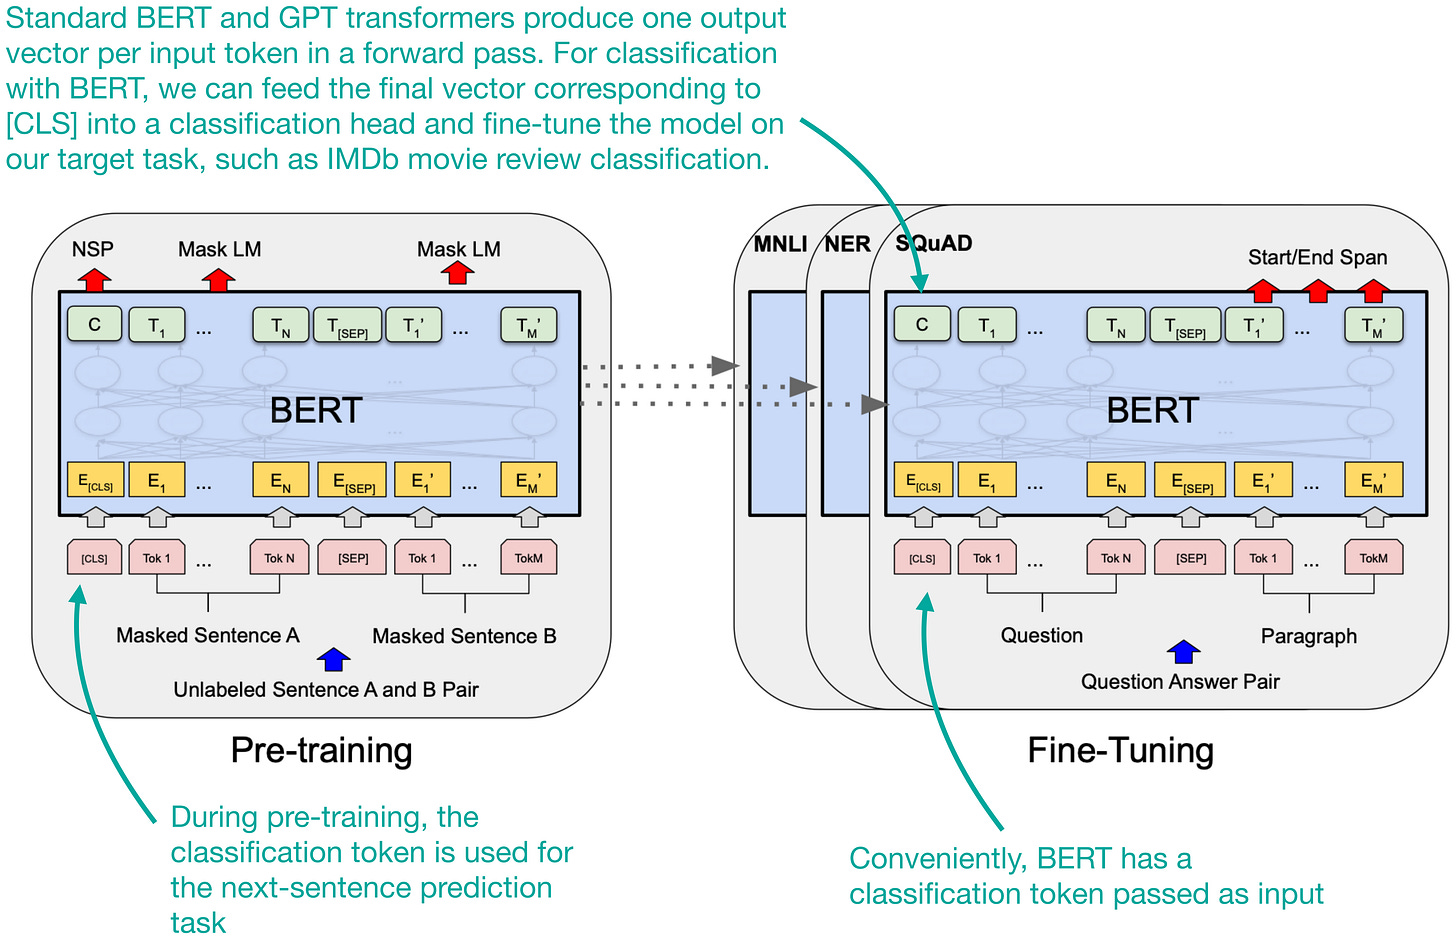
图 15:出自原始 BERT 论文 的标注图。
BERT 模型的热度远不如自回归的 GPT 式 transformer,好在偶尔还是有人更新、翻新它们。最近的一个例子是 2024 年的 ModernBERT,我做分类任务时经常首选它。
如下图所示,在 IMDb 影评上,ModernBERT 只需很少的微调就能达到约 95% 的准确率。
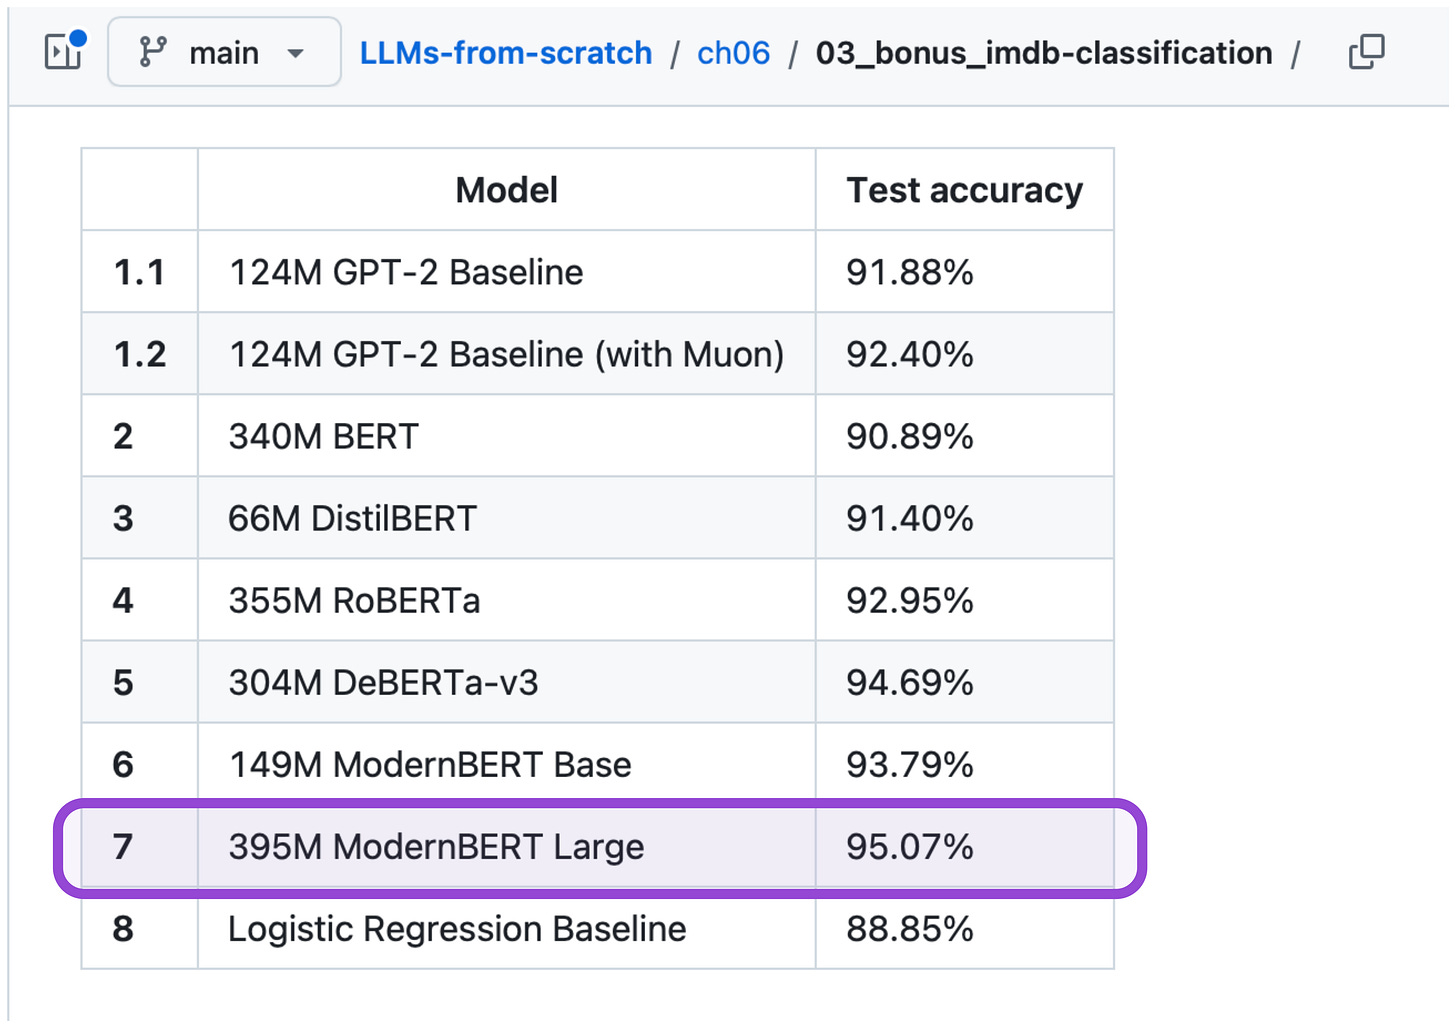
图 16:用不同的 LLM 微调后对 IMDb 影评做分类;源码在这里。(我几乎没怎么调超参数,再花点功夫大概还能提升 1–2%;不过这里想说明的一点也正是:不用费多大劲就能拿到相当不错的结果。)
2.2 Decoder 式 LLM
GPT 这类 LLM 属于 decoder 式、自回归的 transformer,是生成文本和代码时万众瞩目的焦点(没有双关的意思)。
不过,正如我在 Build A Large Language Model (From Scratch) 一书第 6 章中所讲的,作为微调的入门(在讲指令微调之前),我们也可以把它们改作文本分类之用。
当然,也可以直接给 LLM 写提示词,如下面的截图所示。
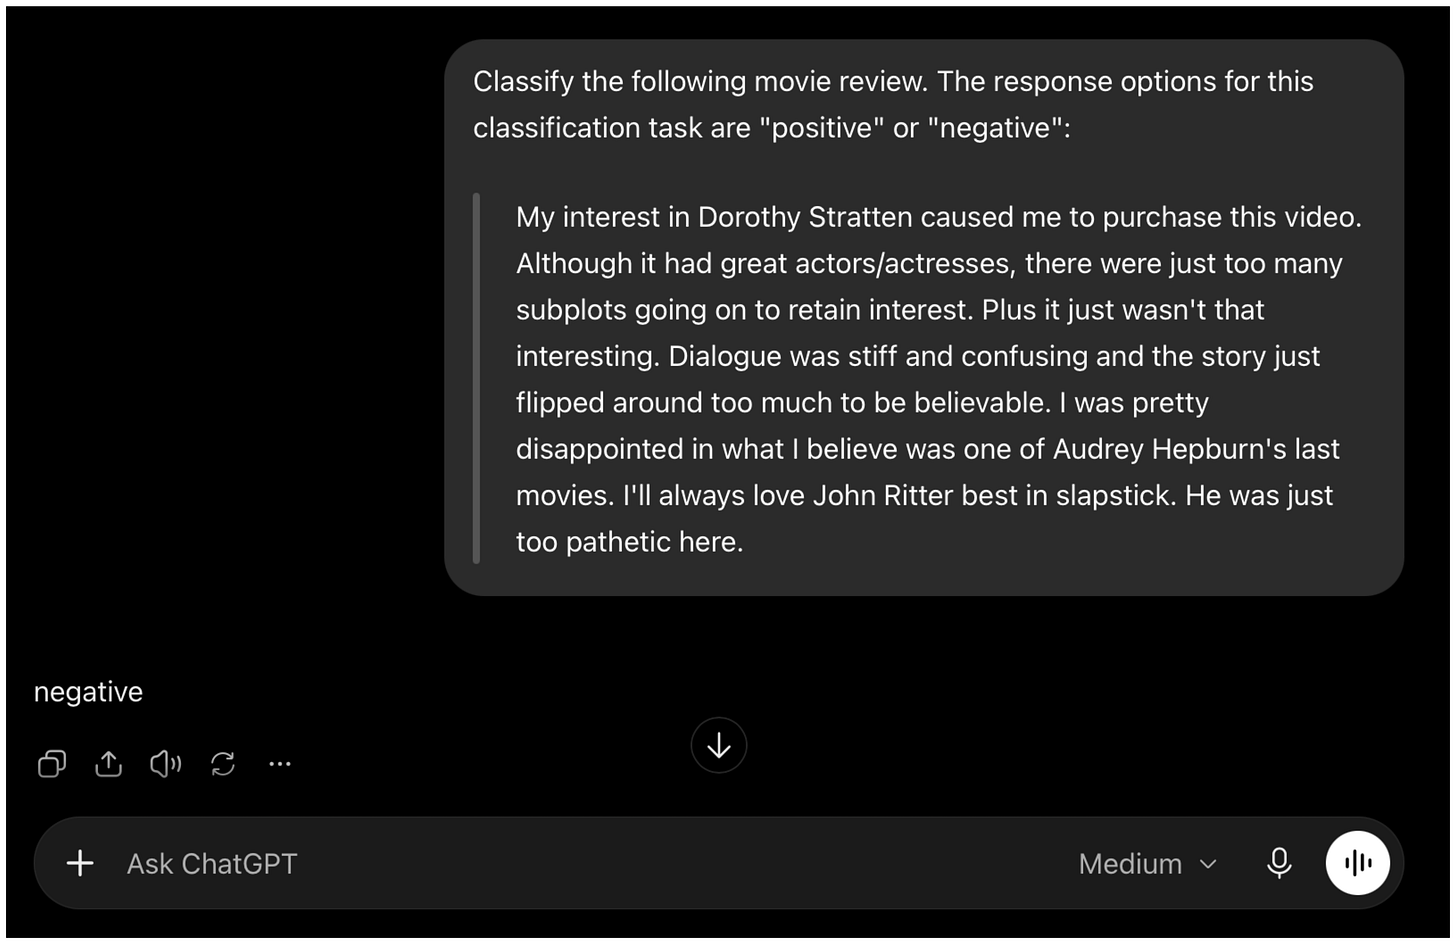
图 17:用提示词让 LLM 对一条影评做分类。
但如果我们想要结构化输出,而且心里有明确的目标领域,这种做法就过于脆弱、效率也低。
我们可以把输出层换成一个更精简的分类头,如下图所示:
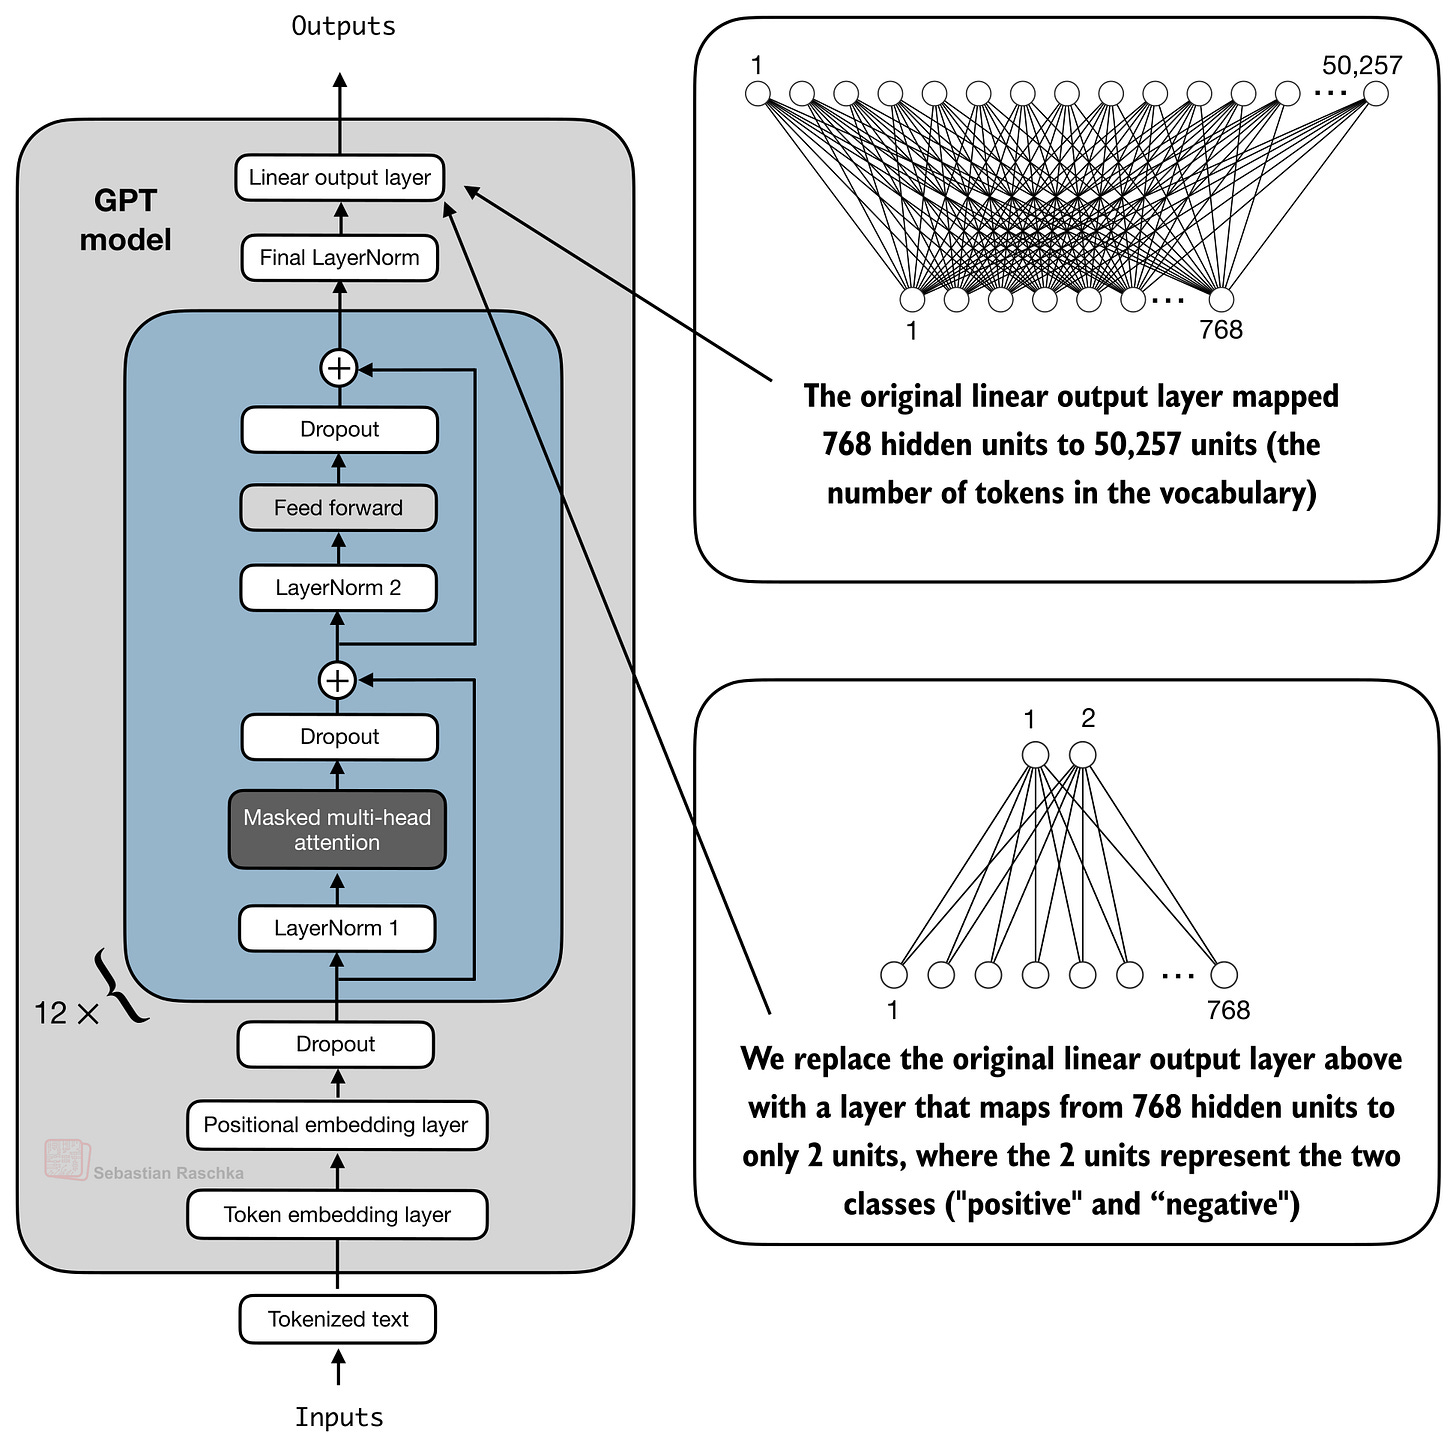
图 18:把 GPT 式模型的输出层换成更精简的分类头。
微调有几个需要注意的地方。比如,由于自回归注意力掩码的存在,设计微调方式时必须小心,确保分类 token 能拿到序列中所有其他 token 的信息。
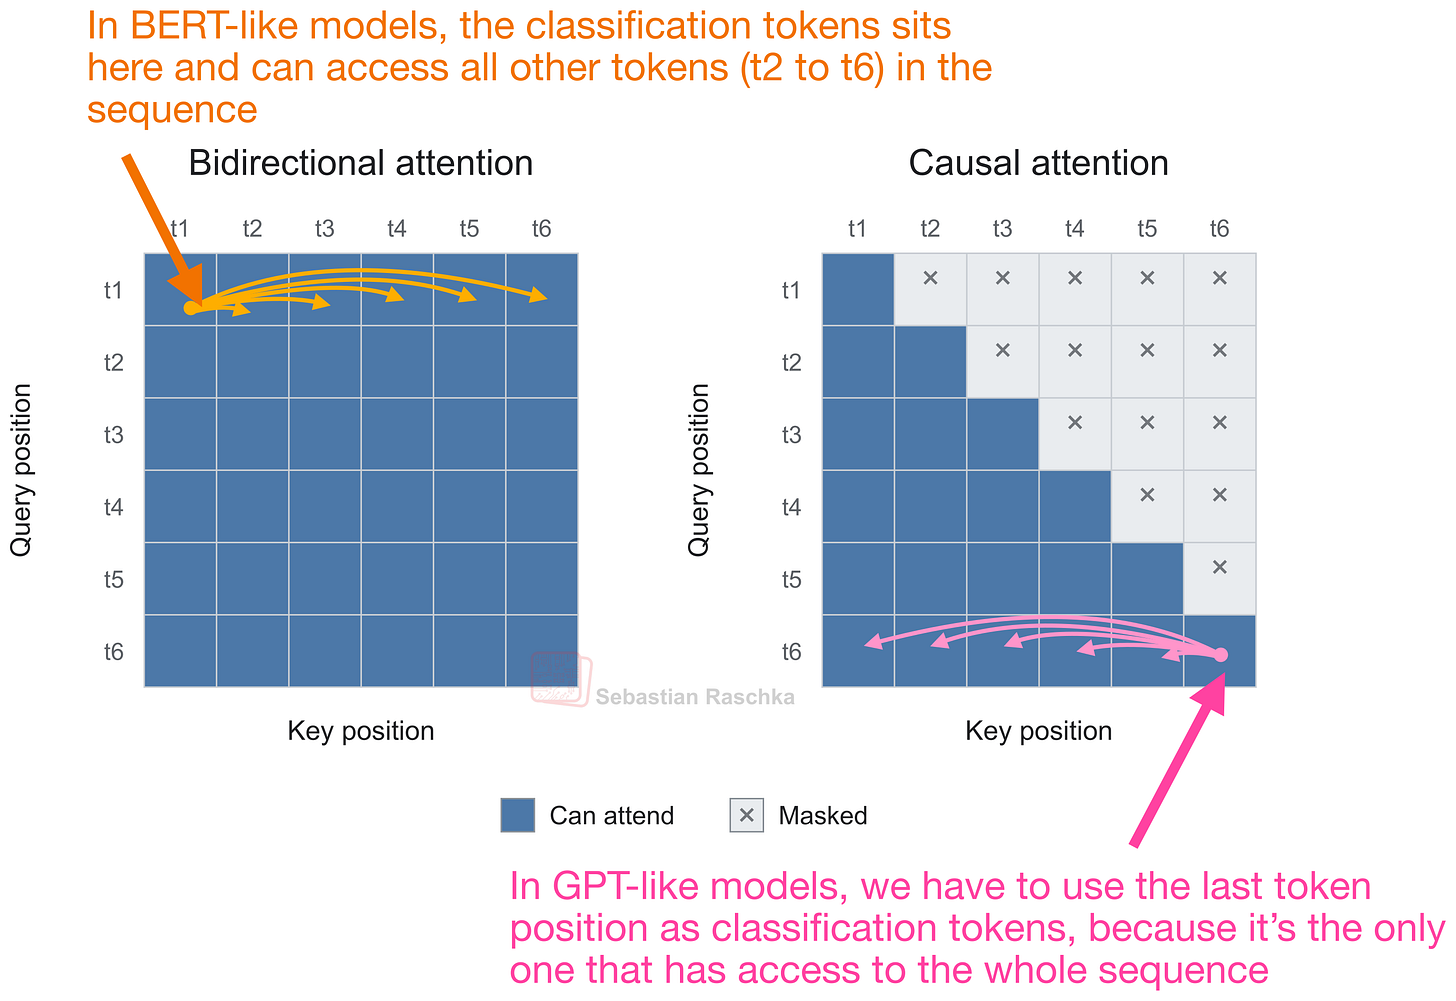
图 19:BERT 与 GPT 中的注意力掩码。
如果你对更多技术细节感兴趣,可以看我最近这篇端到端的文章 Building an AI Text Detector From Scratch:
总的来说,相比 BERT 系变体,用 GPT 式 LLM 的好处是可选的现代开放权重架构非常多。从小号的 Qwen 3 0.6B,到最新的 Kimi、GLM 或 DeepSeek,任君挑选。(当然,从效率角度看,拿这种参数超过 1B 的模型做分类有点杀鸡用牛刀,但——确实能做。)
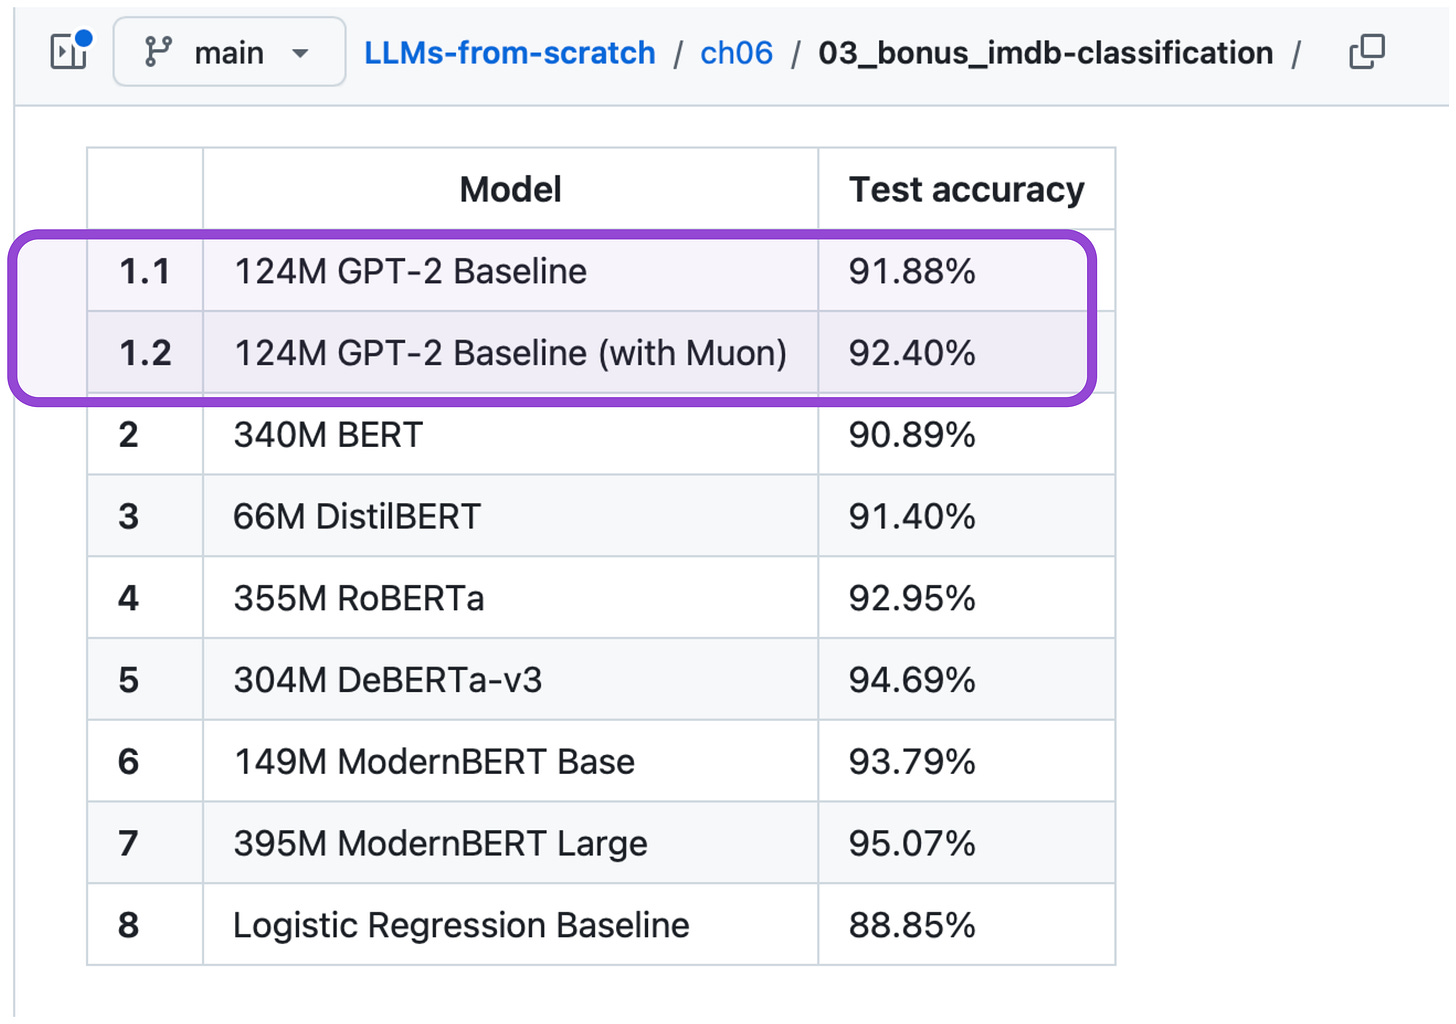
图 20:在上述 IMDb 电影评论数据集上,一个相对较小的 GPT-2 124M 模型可以达到约 92% 的准确率;更大、更新的 LLM(比如近期的某个 Qwen3 变体)大概率会表现更好。
2.3 编码器-解码器式架构
最初的 transformer 架构(编码器-解码器)后来分裂为两种范式——BERT 这类编码器式模型和 GPT 这类解码器式 LLM——但与此同时,也有人尝试使用编码器-解码器式的变体,其中最新的一个变体(多少有些出人意料)是 DeepSeek V4.1 Flash。(不过在这个例子里,它用的是因果编码器,而不是 T5 那样的双向编码器。)
如果只看用于分类的编码器-解码器架构,最知名的候选大概是 Google 在 2019 年提出的 T5(Text-to-Text Transfer Transformer)。
在架构上,T5 与最初的 transformer 的差异既包括对架构本身的更新(下面会总结),也包括训练方式的改变。最初的 transformer 是用监督方式训练来做机器翻译的;T5 则是在无标注文本上做预训练,采用 span corruption:编码器接收缺失若干片段的文本,解码器负责生成这些缺失的片段。
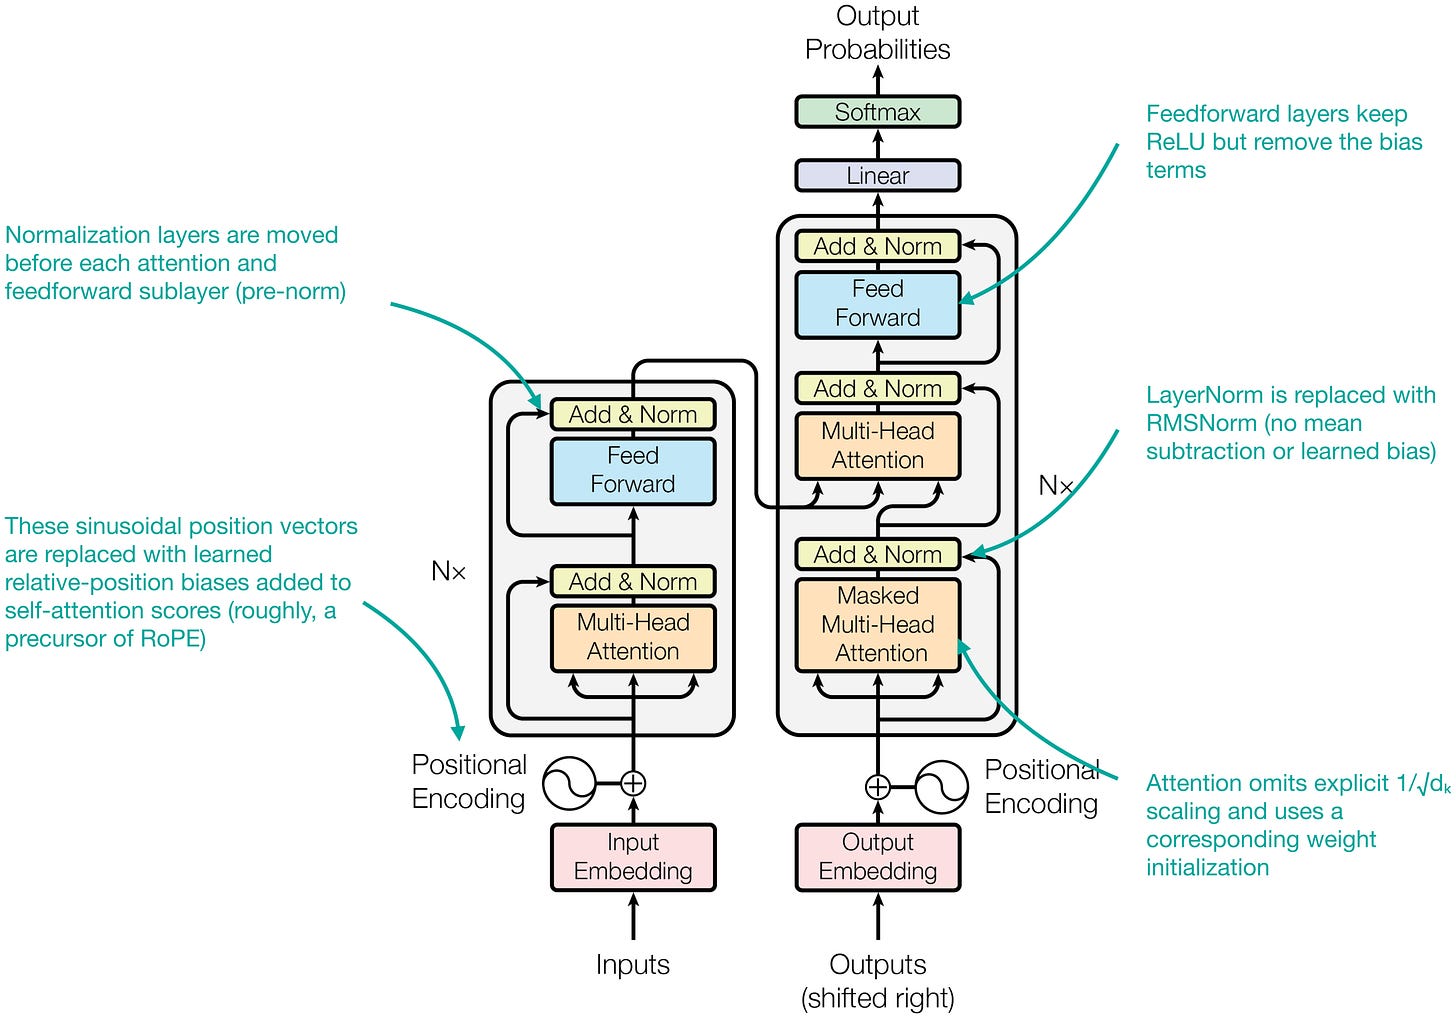
图 21:T5 对最初 transformer 架构所做的改动。(架构图取自 Attention Is All You Need。)
现在,我们可以像上面处理 RNN、CNN 和其他 transformer 方法那样,给 T5 加一个分类头来使用它。
除此之外,我们也可以(训练它)让解码器直接输出类别标签的预测(比如 IMDb 电影评论数据集里的 “positive” 或 “negative”),就像普通的 LLM 那样。不妨把这种做法叫作 text-to-text 分类。
GPT 式 LLM 虽然是在海量文本上训练的,但通常开箱就能把 text-to-text 分类做得不错,前面已经展示过(为方便起见,这里再放一次那张图)。
图 22:用 GPT 模型做文本到文本分类。
不过对 T5 来说,更常见的做法是进一步微调 decoder,让它在特定目标领域的这类任务上表现更好。
对 T5 而言,两种方法都可行。总结如下:
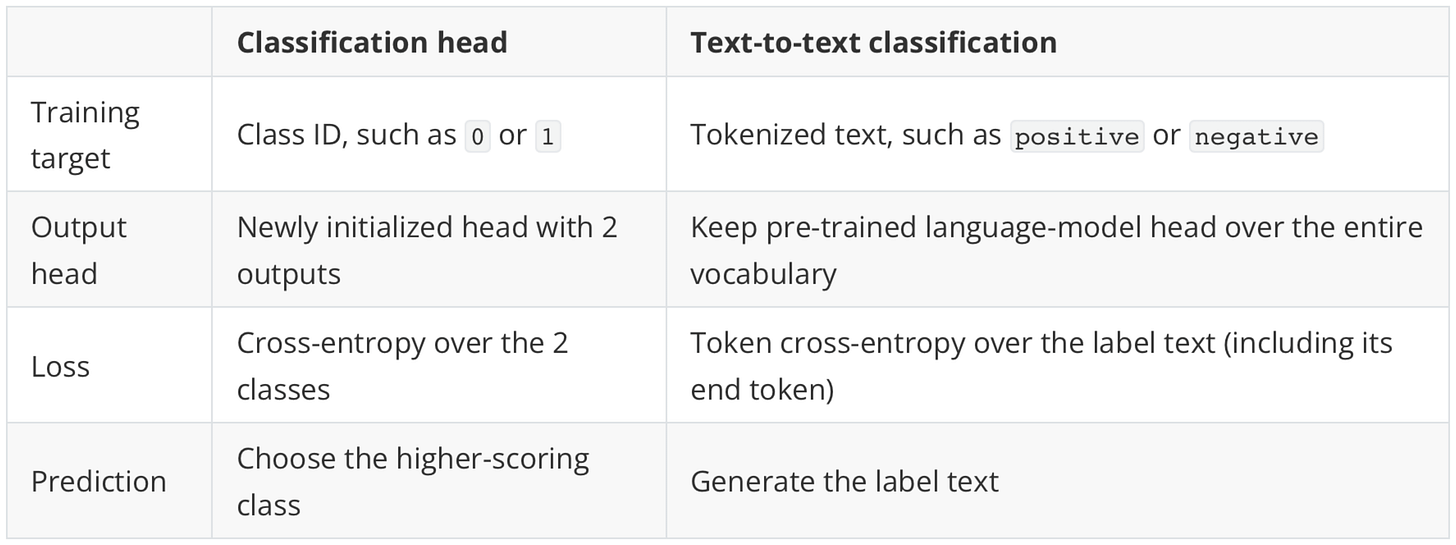
图 23:分类头与文本到文本方法对比。
3. Jev 概览
到目前为止,我们已经看到文本分类有很多种做法:从逻辑回归、朴素贝叶斯加词袋表示这类传统方法,到给 GPT-6 之类最新的前沿 LLM 写 prompt,再到给任意开放权重 LLM 加一个分类头做微调(或者做文本到文本分类)。
起初我(差点)把它当成“不过是个分类器”而没当回事——这种东西我经常为自然语言输入的分类任务写(比如我最近公开的AI Detector 文章就是一个例子)。
3.1 Jev 与现有的文本到文本分类
不过在继续讨论之前,先简单介绍一下 Jev。Jev 是 TypeSafe AI 发布的新模型,几周前才结束隐身状态,引起了不小的关注(一开始看着有点奇怪,因为它长得就像一个分类器)。
Jev 是专有模型(虽然发布之后紧跟着冒出了大量快速复刻的开源版本,这个后面再说),使用成本相对便宜,号称在决策能力上与 GPT-5.6 Luna 相当,同时速度和成本都好了几个数量级:
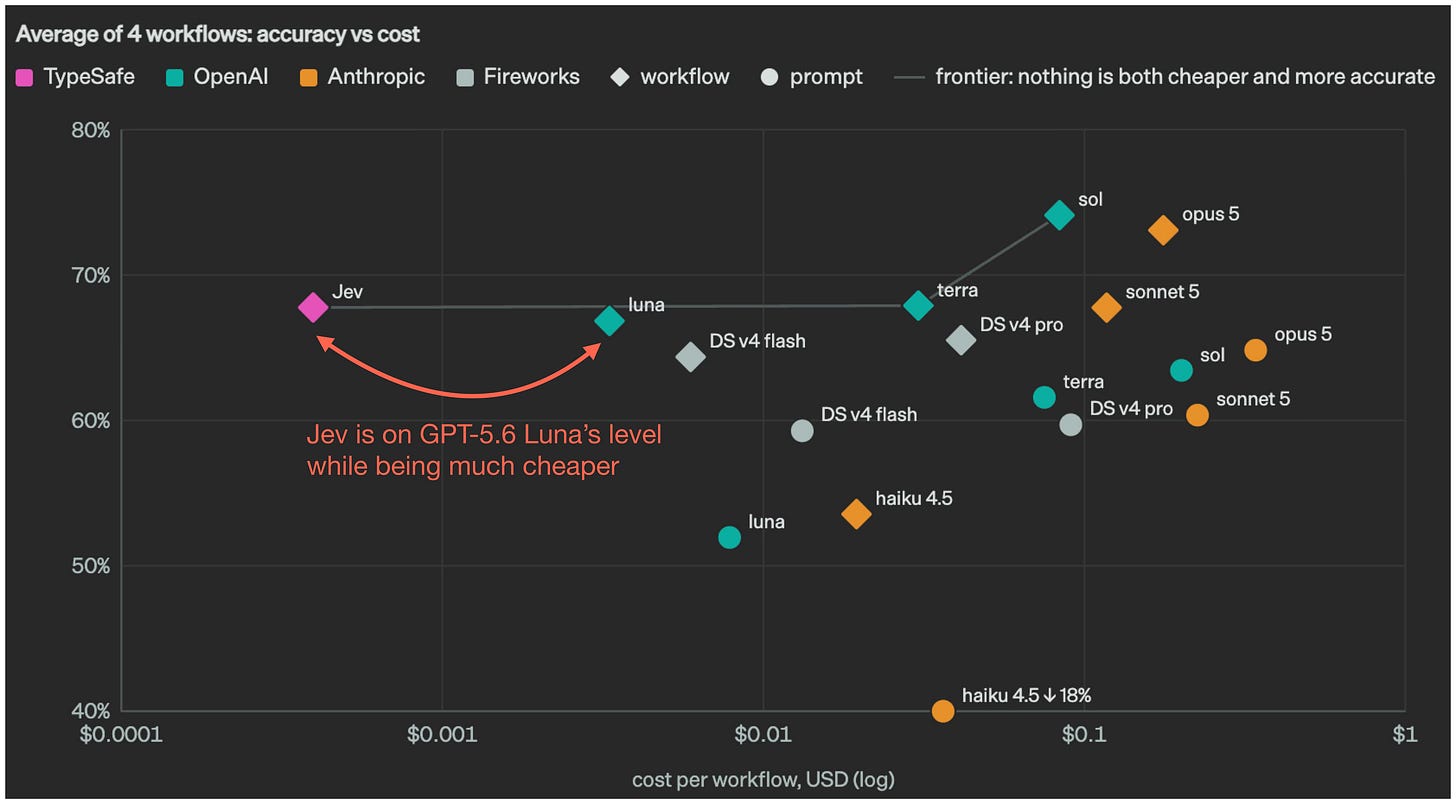
图 24:来自 TypeSafe AI 博客的基准测试。
这里的 GPT-Luna,可以理解为前面讨论过的文本到文本分类方法。
那为什么这么火?我觉得一部分原因是 API 好用,而且它在各类任务上都表现很好,不需要自己再做微调。
比如,我可以用它来对客服工单/邮件进行分类(我录了一个视频版来展示响应时间):
或者,我也可以让同一个模型实时玩俄罗斯方块(这里用的是 Choice API):
在展开技术细节之前,也许最简洁的解释是这样的:2022 年的 ChatGPT 之所以令人兴奋,是因为它是一个通用聊天模型,能生成各种文本;同样,技术社区对 Jev 感到兴奋的原因之一,是它堪称分类领域的 ChatGPT 时刻——它能低成本地对各种文本输入进行分类,而不必为每个任务微调一个专用分类器。
(截至本文写作时,关于其架构和具体训练算法,外界所知甚少,只知道一位创始人说它是通过“Reinforcement Learning for Calibrated Decisions”训练的,这一点后面再细说。)
3.2 Jev API
过去几年,我们已经习惯了拿更大、更强、也更贵的 GPT 式 LLM 去应对各种问题;而对于有针对性的决策或分类任务,像 Jev 这样便宜又快速的做法,对大多数人来说可能颇为新鲜。尤其是那些一次性任务,收集训练数据再微调一个定制 ModernBERT 实在太繁琐,我们大可以直接扔一个 Luna 式的模型上去。
除了因通用性(也就是开箱即用、在不同目标领域都表现良好)而受欢迎之外,Jev 的 API 也相当好用,我们可以在终端里用 curl 调用,也可以通过它的 Python API 调用。
简而言之,主要有三种 API 类型,如下所示。先从 Choice API 说起,它适合多分类。
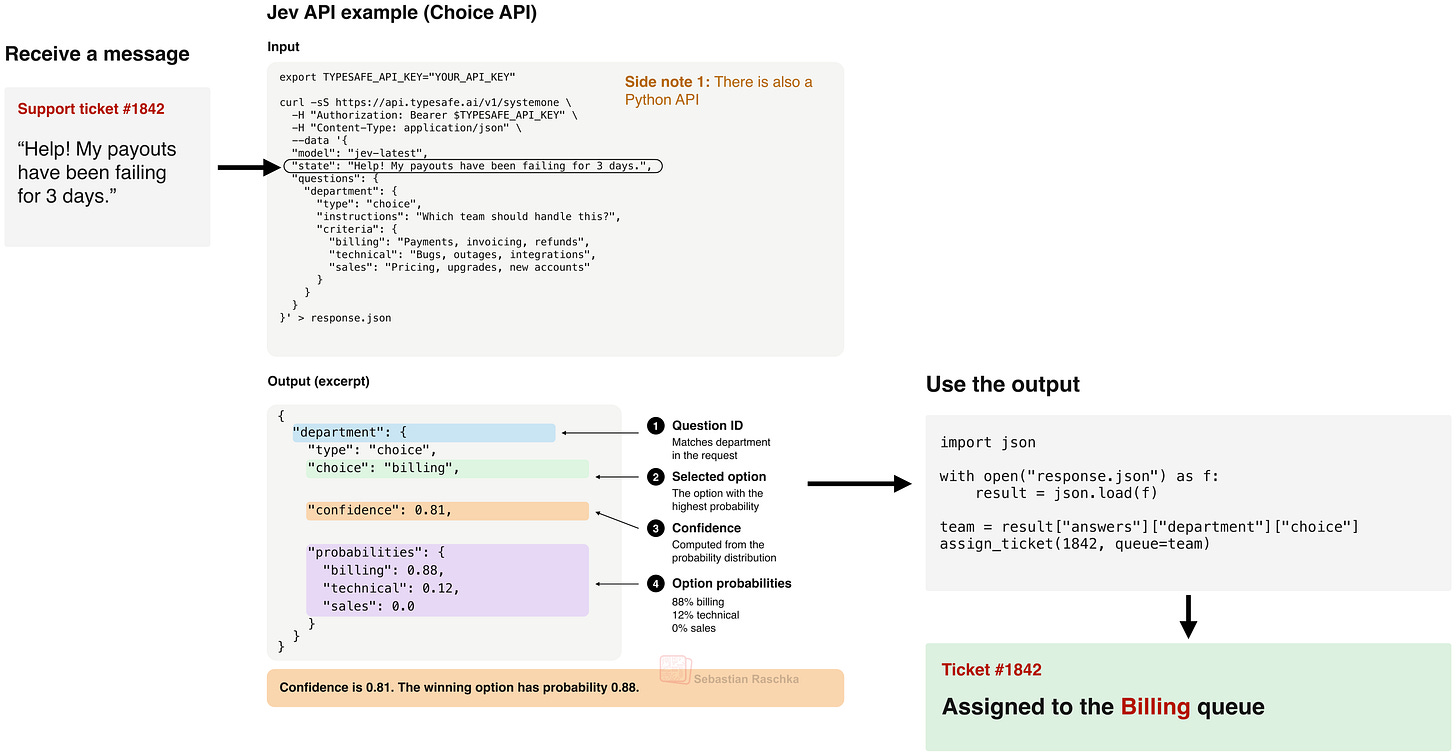
图 25:Jev 的 Choice API。用于多分类。
接下来是 Noul API,它更简单,为某个问题给出一个“是”的概率。
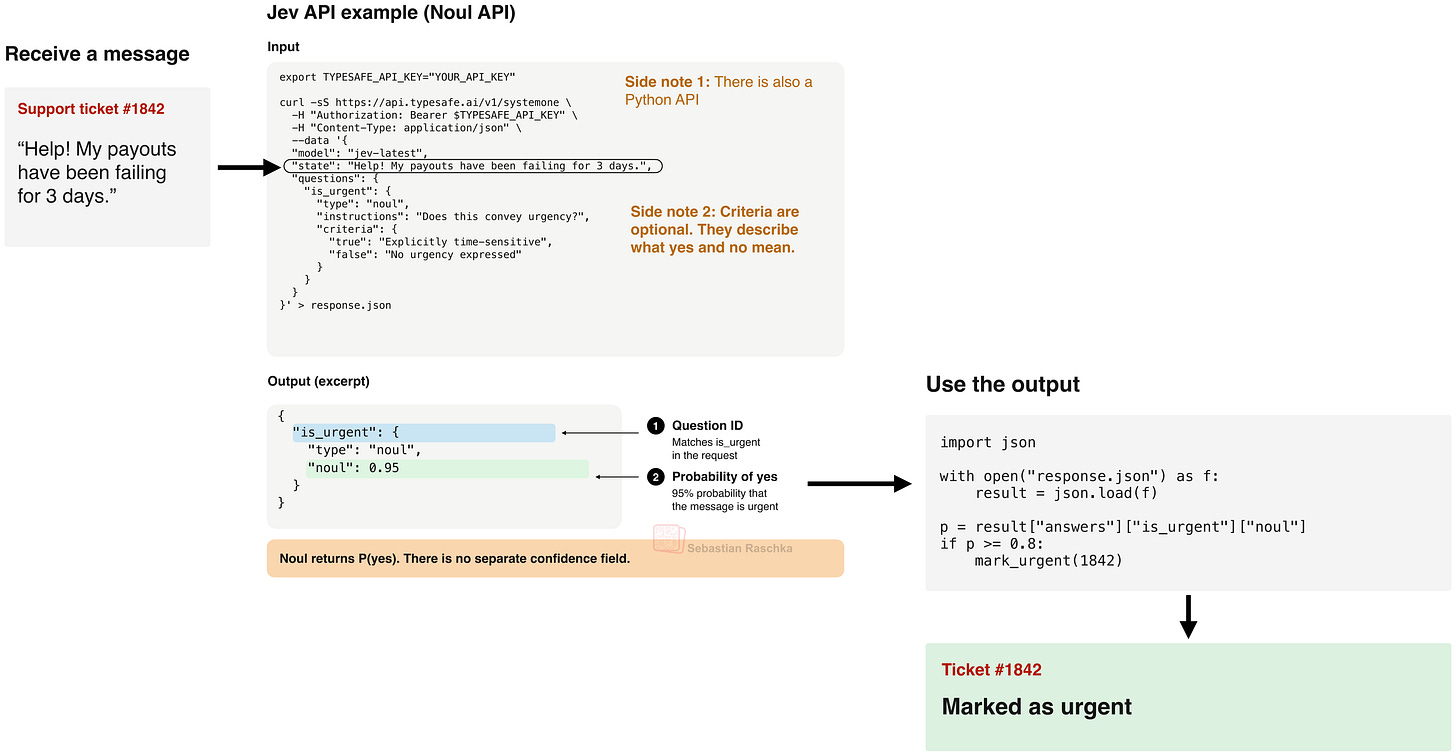
图 26:Jev 的 Noul API。用于二分类或多标签分类(配合多个 Noul 问题)。
最后,Score API 会根据评分标准等级给出分数(下例中为 0、1、2)。
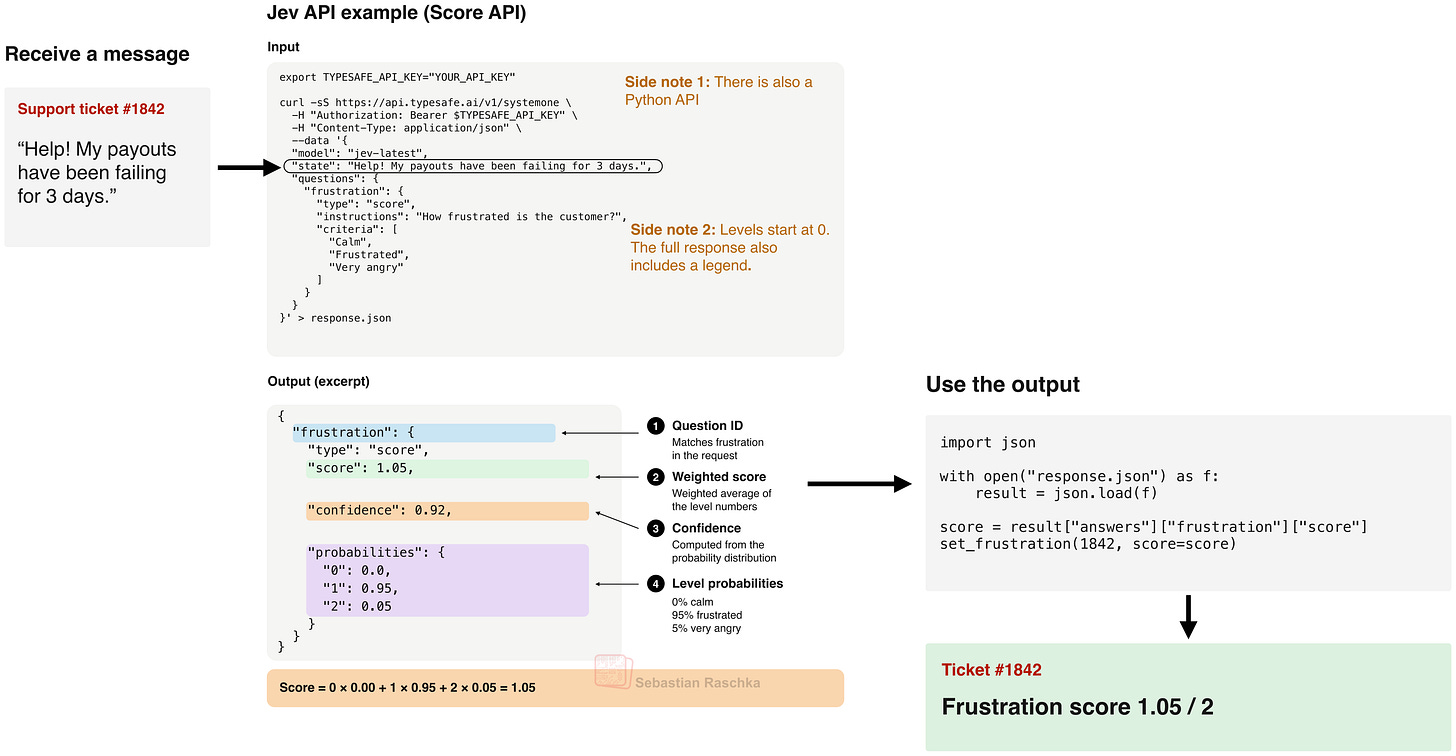
图 27:Jev 的 Score API。用于序数分类。
总结一下,各 API 及其适用场景如下。
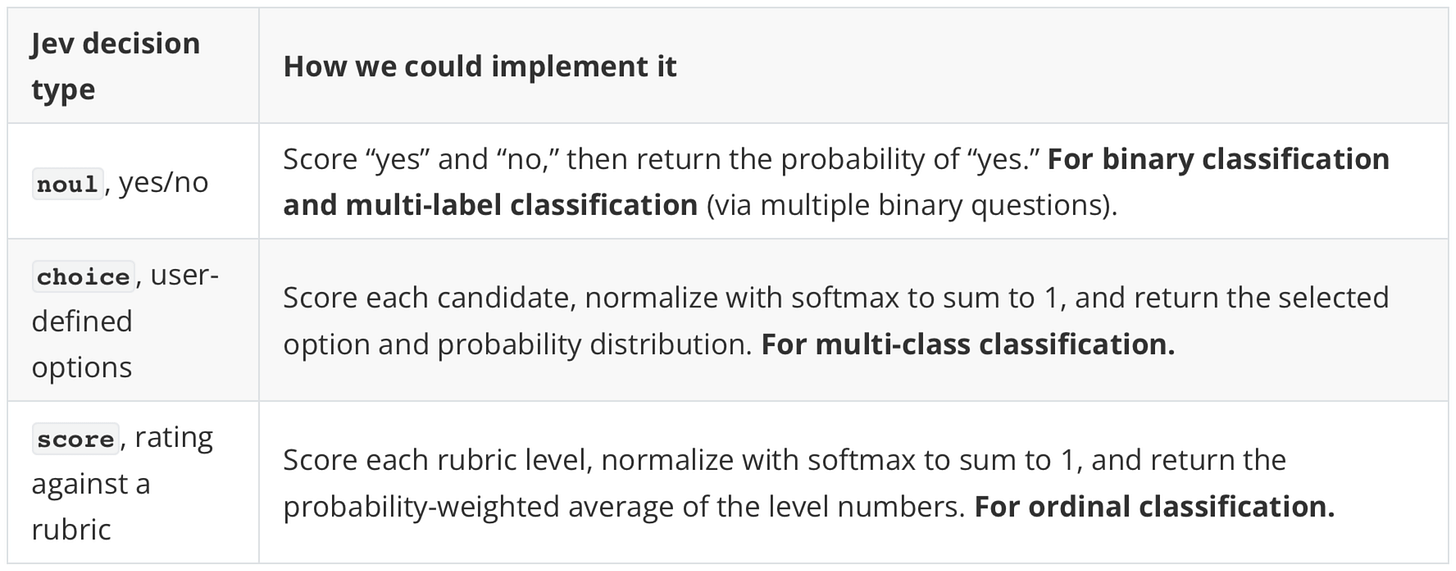
图 28:Jev API 速查表。
3.3 用 Jev 对 IMDb 分类
为了让这些 API 更具体,也为了回答 Jev 在前面提到的 IMDb 数据集上表现如何,我们可以用 Choice 或 Noul API 跑一遍。
先看 Choice API。每条评论的格式如下:
export TYPESAFE_API_KEY="YOUR_API_KEY"

curl -sS https://api.typesafe.ai/v1/systemone \
 -H "Authorization: Bearer $TYPESAFE_API_KEY" \
 -H "Content-Type: application/json" \
 -d '{
 "model": "jev-1.13.0",
 "state": "The acting was excellent and the story kept me engaged throughout. I would happily watch this movie again.",
 "questions": {
 "sentiment": {
 "type": "choice",
 "instructions": "What is the overall sentiment of this movie review?",
 "criteria": {
 "negative": "An overall unfavorable opinion of the movie",
 "positive": "An overall favorable opinion of the movie"
 }
 }
 }
 }'
如果要用显式标签处理二分类(这里就是)或多分类问题,Choice API 很方便。
实际返回可能长这样:
{
 "model": "jev-1.13.0",
 "answers": {
 "sentiment": {
 "type": "choice",
 "choice": "positive",
 "confidence": 1.0,
 "probabilities": {
 "negative": 0.0,
 "positive": 1.0
 }
 }
 },
 "usage": {
 "input_tokens": 342,
 "output_tokens": 32
 }
}
除了 "choice": "positive" 标签,我们还能拿到这次预测的置信度,以及每个类别的概率。(confidence 字段反映的是概率分布的集中程度,与分配给获胜类别的概率不是一回事。)置信度在实际应用中很有用。Jev 的一个卖点是,根据文档,这些概率是良好校准的(校准的问题后面再细说)。
我们也可以用 Noul API 来分类这些评论。沿用同样的电影评论分类上下文,格式如下:
curl -sS https://api.typesafe.ai/v1/systemone \
 -H "Authorization: Bearer $TYPESAFE_API_KEY" \
 -H "Content-Type: application/json" \
 -d '{
 "model": "jev-1.13.0",
 "state": "The acting was excellent and the story kept me engaged throughout. I would happily watch this movie again.",
 "questions": {
 "is_positive": {
 "type": "noul",
 "instructions": "Does this review express an overall positive opinion of the movie?",
 "criteria": {
 "true": "An overall favorable opinion of the movie",
 "false": "An overall unfavorable opinion of the movie"
 }
 }
 }
 }'
通过 Noul API 得到的答案是:
{
 "model": "jev-1.13.0",
 "answers": {
 "is_positive": {
 "type": "noul",
 "noul": 0.98
 }
 },
 "usage": {
 "input_tokens": 328,
 "output_tokens": 21
 }
}
(有意思的是,同样的文本,正面类别给的是 0.98 而不是 1.0。)
我们还可以对每个类别各问一个问题,从而把 Noul API 用于多分类,例如:
- “这篇文章讲的是金融吗?”
- “这篇文章讲的是政治吗?”
- “这篇文章讲的是科技吗?”
这里每个问题(彼此独立)返回一个概率,这些概率不必加起来等于 1。所以,如果多分类任务中每段文本可以有多个标签,我们可能更倾向 Noul;而如果分类问题只有一个最终答案,Choice 用起来更方便。
现在,我们在测试集的 25,000 条电影评论上分别用 Choice 和 Noul 运行 Jev,得到以下结果:
- Choice:准确率 96.47%(24,117 条正确)
- 总运行时间:22 分 24 秒
- 15,456,663 个输入 token,总成本 $0.6492
Noul:
- 准确率 96.20%(24,050 条正确)
- 总运行时间:23 分 3 秒
- 15,106,663 个输入 token,总成本 $0.6345
注意,Choice 和 Noul 在性能和运行时间上的微小差异可能来自随机波动,因为和其他 LLM 一样,这些运行并非完全确定性的。
比如,我在同一测试集上又跑了一遍 Choice API,结果就略有不同,如下所示。
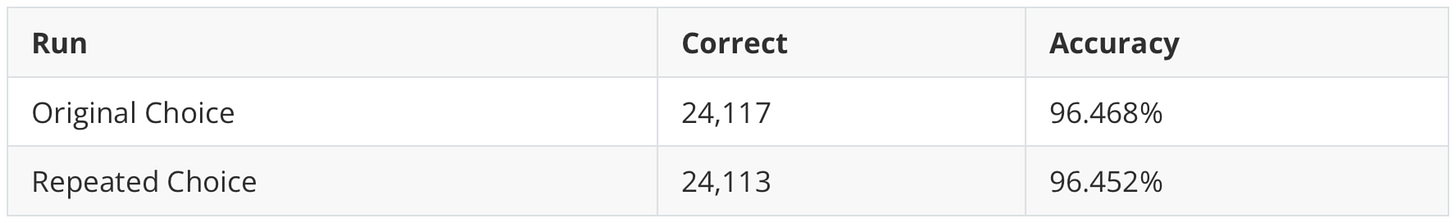
图 29:重复运行 Jev。
(大规模服务 LLM 和其他模型时出现的不确定性,可能源于依赖批次的 GPU kernel 执行改变了浮点运算的顺序,Horace He 去年在一篇不错的博客文章里解释了这一点。)
总之,结果整体看起来相当不错(前提是:我们并不知道 IMDb 测试集是否属于训练集的一部分)。
作为参照,一个 ModernBERT 模型
- 在训练集上微调用了 23 分钟;
- 在测试集上评估用了 7 分钟。
相比之下,最好的 ModernBERT 模型准确率与之相近,如下所示(我认为再调一调超参数,还能再高 1–2%)。注意这是在 DGX Spark 上跑的,通过量化和更快的硬件还有可能获得更快的推理性能。
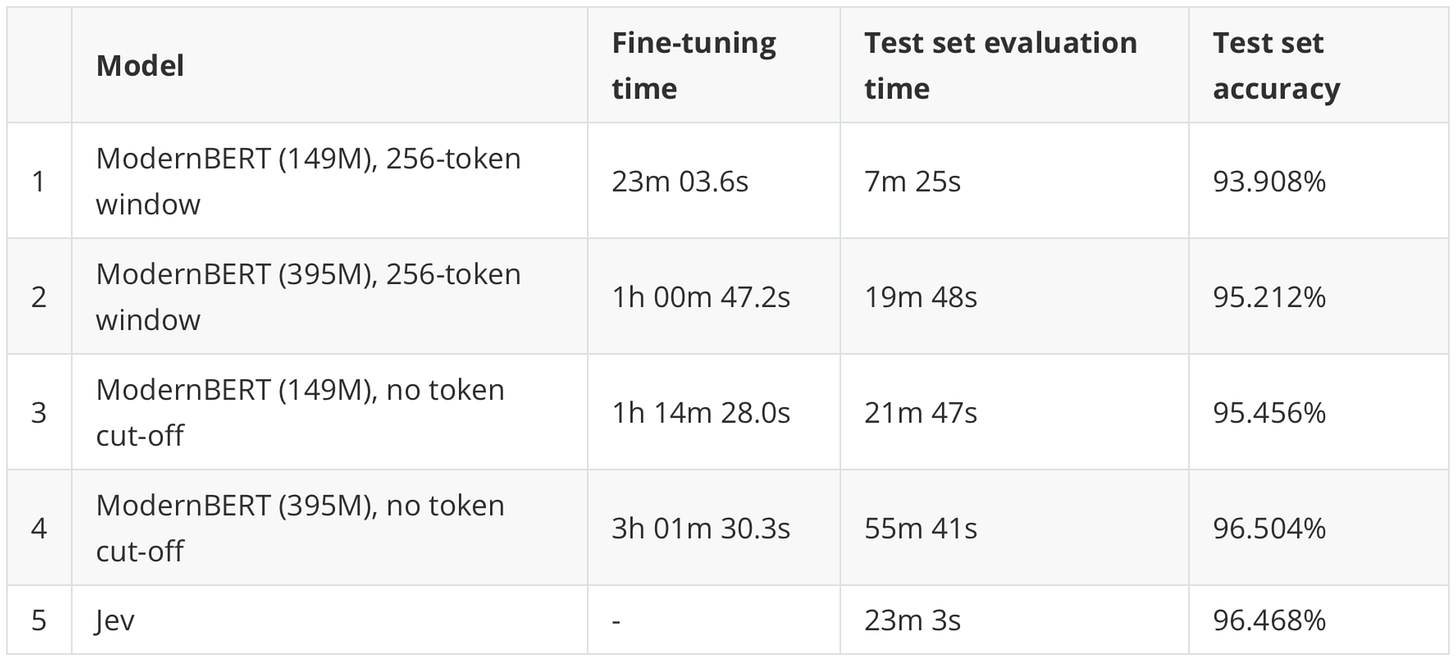
图 30:ModernBERT 与 Jev 对比。
但我们的 ModernBERT 模型没法玩俄罗斯方块,也没法做电影分类之外的任何事——除非我们针对新任务重新微调它。不过那样的话,我们也可以直接上一个 GPT-5.6 Luna 或 GPT-6 Luna 模型(稍慢一些,也更贵)。
一条经典的经验法则是:
- 一次性的决策任务,用便宜的 LLM(比如 GPT-6 Luna);
- 要反复做同一件事,就微调一个专用分类器。
现在,像 Jev 这样的方案已经可以取代上面的做法:一来相比 Luna 能降低延迟、节省成本,二来省去了微调自定义模型的功夫。(当然,如果任务量非常大,又想在某个特定任务上把速度和准确率拉满,微调仍然是有意义的。)
4. 用 Jev API 改造 BERT 系和 GPT 系模型
当然,我们也可以在 (Modern)BERT 或任何 GPT 系模型之上加一层类 Jev API。加这层 API 相当直接。事实上,Jev 一发布,我就搭了一个类 Jev 的 ModernBERT 模型,用来演示自己动手做一个 Jev 模型有多简单。
我最终没有发布这个 Jev 克隆版,因为中途改了主意。也就是说,在 ModernBERT 之上套一层类 Jev API 是小事,拿一堆分类任务去微调它也是小事。但要让这个模型在没有大量训练和测试的情况下,在 Tetris 这类五花八门的任务上都表现良好,就不是小事了。(另外,蹭这波热度赶出来的 Jev 克隆版已经够多了;世界不缺又一个速成品,当然,一个足够强的开放权重版本还是受欢迎的。)
不过,如果你对这种改造方式感兴趣,这里简单说一下思路。比如,我们可以像前面演示的那样,给任何 BERT、GPT 或 T5 系模型加一个小型分类头,从而实现类 Jev 的 Choice API。但分类头的输出节点数不再等于类别数,而是只留 1 个输出节点,如下图所示对 GPT 模型的修改。
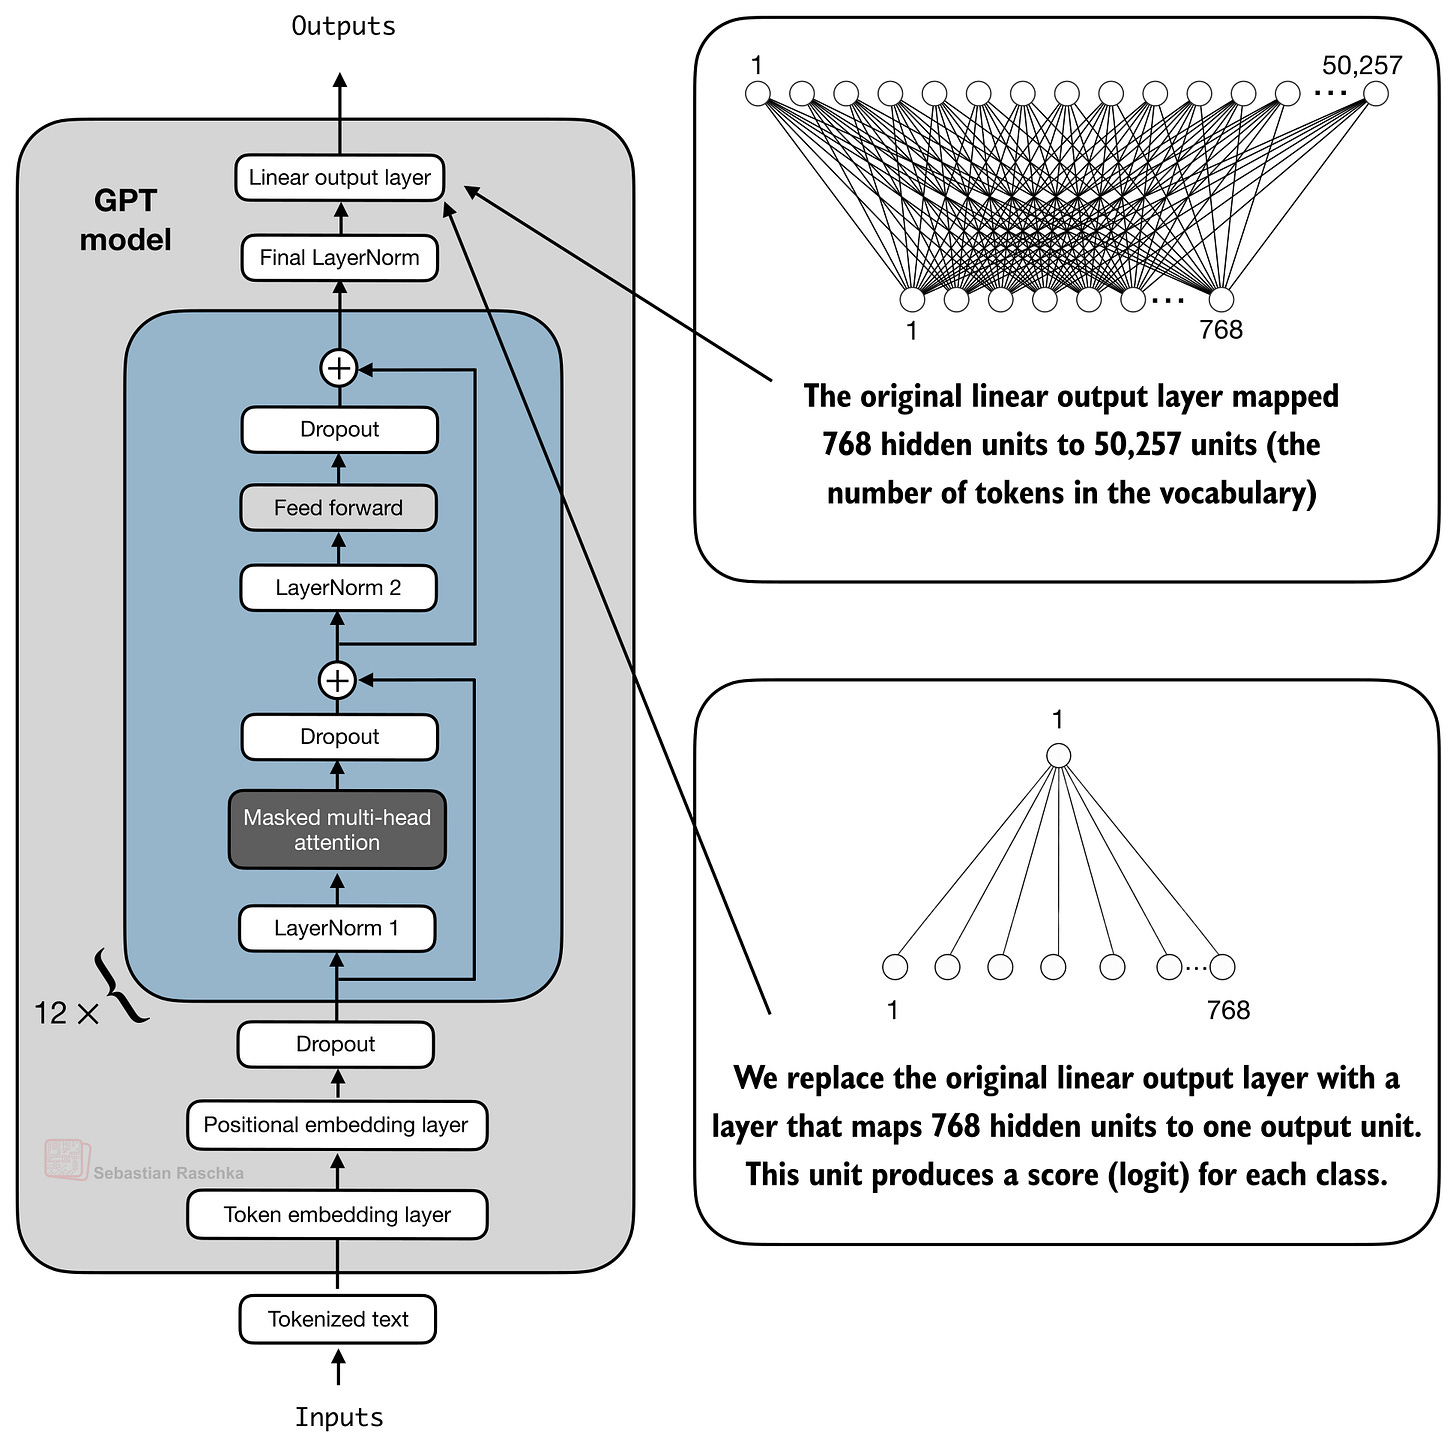
图 31:把 GPT 模型的输出层(原本映射到整个词表)替换成只有一个节点的输出头。
前面我们讨论过针对特定任务微调这类模型,比如类别标签数量预先确定的电影评论分类(这里是“正面”和“负面”)。换成这种“1 个输出节点”的配置后,我们其实可以把它扩展成任意数量的类别。
要把这个方法扩展到任意数量的类别(这里以 3 类为例,把客户工单分到 “billing”、“technical”、“account” 三个类别中),可以按下图来做。
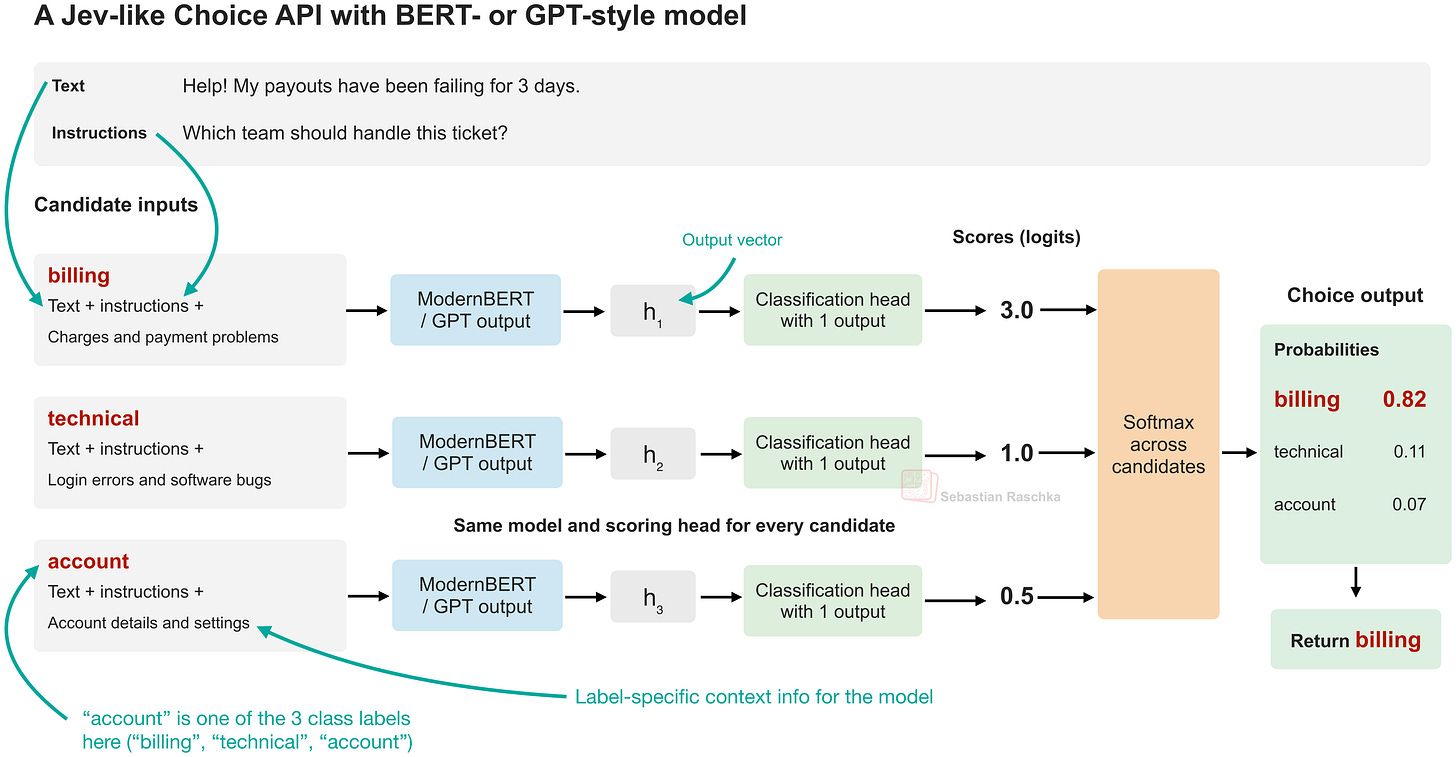
图 32:用 BERT 或 GPT 风格的模型配合类似 Jev 的选择 API。
如上图所示,对每个候选选项,我们把输入文本、任务指令和该候选的描述一起喂给模型。分类(打分)头把输出表示映射为一个标量分数。然后对所有候选的分数做 softmax,得到概率分布,返回概率最高的选项。
这里的要点是,所提出的头对每个类别只有一个输出。每个类别描述都会产生自己的表示,由同一个头通过输出层(本质上是一个 logistic regression 模型)打分:
其中
- si 是类别标签 i 的标量分数;
- w 是可学习的权重;
- b 是可学习的偏置单元;
- hi 是 transformer 在分类头之前的输出。
对于 N 个候选,这会得到 N 个分数。softmax 随后返回 N 个概率。当 N 变化时,学到的参数 w 和 b 保持不变。
关于 hi 需要注意:
- BERT 风格的编码器模型使用
[CLS]token 的最终隐藏状态(可选地经过一个池化层); - GPT 风格的自回归模型通常使用最后一个非 padding token 的隐藏状态,之所以需要这样,是因为前面讨论过的自回归特性(最后一个非 padding token 可以关注到前面的文本、指令和候选描述)。
然后,我们用交叉熵损失针对正确选项联合微调模型和打分头。由于所有候选共享同一个打分头,我们可以在不改变架构的情况下改变选项的数量和描述。但同样,这在陌生任务上效果如何,取决于训练数据。
顺便问一句,为什么用 BERT 或 GPT 这类基于 transformer 的模型,而不是前面提到的更简单的 RNN 和 CNN 架构?从技术角度看,上面说的那套方法用哪种都行。但基于 transformer 的模型扩展性非常好,意味着它们可以在更大的数据集上预训练,并从中获得比其它模型更多的收益。另外,它们能很好地利用上下文提供的信息(这要归功于 attention)。所以,如果我们希望模型能很好地泛化到不同的目标任务上,而不必为每个任务做显式微调,那么在一个高质量数据集上预训练一个基于 transformer 的模型,大概率比基于 RNN 或 CNN 的模型更接近这个目标。
5. Jev 的架构与训练算法
那么,Jev 为什么能在这么多不同的任务上表现如此出色(从电影评论到玩俄罗斯方块这种完全随意的任务)?遗憾的是,其架构、算法和训练数据的细节都没有公开。另外别忘了,它背后有一整个团队和一家估值数百万美元的公司,他们专门研究这个模型并为之付出了大量努力;我们不可能指望用一些公开数据集训练一个类 ModernBERT 的模型一周,就能达到那种性能水平。
话虽如此,如果非要我做个有根据的猜测,在架构方面,我猜他们用的是类似 ModernBERT 的小模型,所以延迟才这么低。
至于训练数据,如前所述,TypeSafe AI 的 CEO 说过下面这段话:
我们的数据 100% 是合成的(但显然不是 LLM 直接吐出来的那种垃圾)
所以,没错,我认为大部分精力都花在了整理这个数据集上。这也是我多年来一直向学生和合作者强调的事情。说个简短的轶事:大约 8 年前,我和社会科学系的另一位教授合作,帮忙设计一个文本分类问题的实验方案。她的学生花了很多天对 bag-of-words 基线和 BERT 模型做超参数调优,才勉强挤出约 2-5% 的准确率。然后我建议我们各自坐下来花几天时间手工标注更多数据(我记得我们最初的数据集大约 300 个样本,我们把它翻了一倍),结果准确率提升了 10-20% 以上。是的,为此绘制学习曲线很重要 :)。
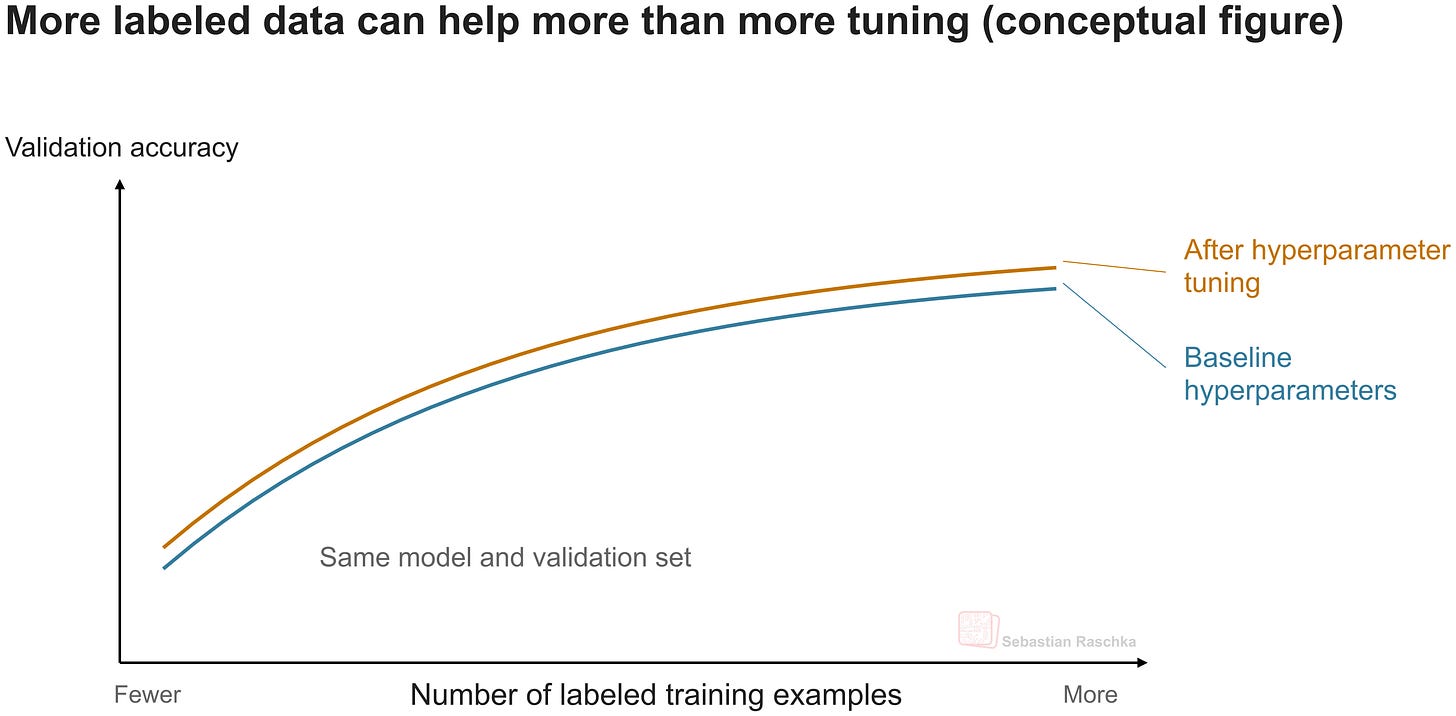
图 33:经验法则——更多数据往往比额外的超参数调优更有帮助。
最后是训练算法。具体细节同样不得而知,但 TypeSafe AI 的博客文章指出,他们使用了一种名为 Reinforcement Learning for Calibrated Decisions(RLCD)的新算法:
“我们搭建了一套完全围绕自动化构建的新技术栈:全新的模型架构、用于最大化效率的并行采样器,以及我们称之为 Reinforcement Learning for Calibrated Decisions(RLCD)的训练方法。”
该方法并未公开。已发表的方法中有一个校准目标与之相似,即 RLCR(Reinforcement Learning with Calibration Rewards),出自 2025 年的论文 Beyond Binary Rewards: Training LMs to Reason About Their Uncertainty。在展开更多细节之前,下一节先简要介绍校准的一般概念。
5.1 关于校准
校准并非新话题,对于任何需要使用和评估类别归属概率的生产模型,我都建议做这一步。简而言之,校准会调整模型的概率估计,使其更贴近实际观测到的类别频率。
以之前的 IMDb 电影分类问题为例。模型可能给某条评论打出 74% 正面、26% 负面。这些是概率估计,但模型可能过度自信或信心不足。不评估校准,就不能假定这些数值可靠。也就是说,在 50% 的阈值下,74% 正面和 54% 正面的预测都会得到“正面”这一类别标签,尽管模型在 74% 的情况下表现出更高的信心。
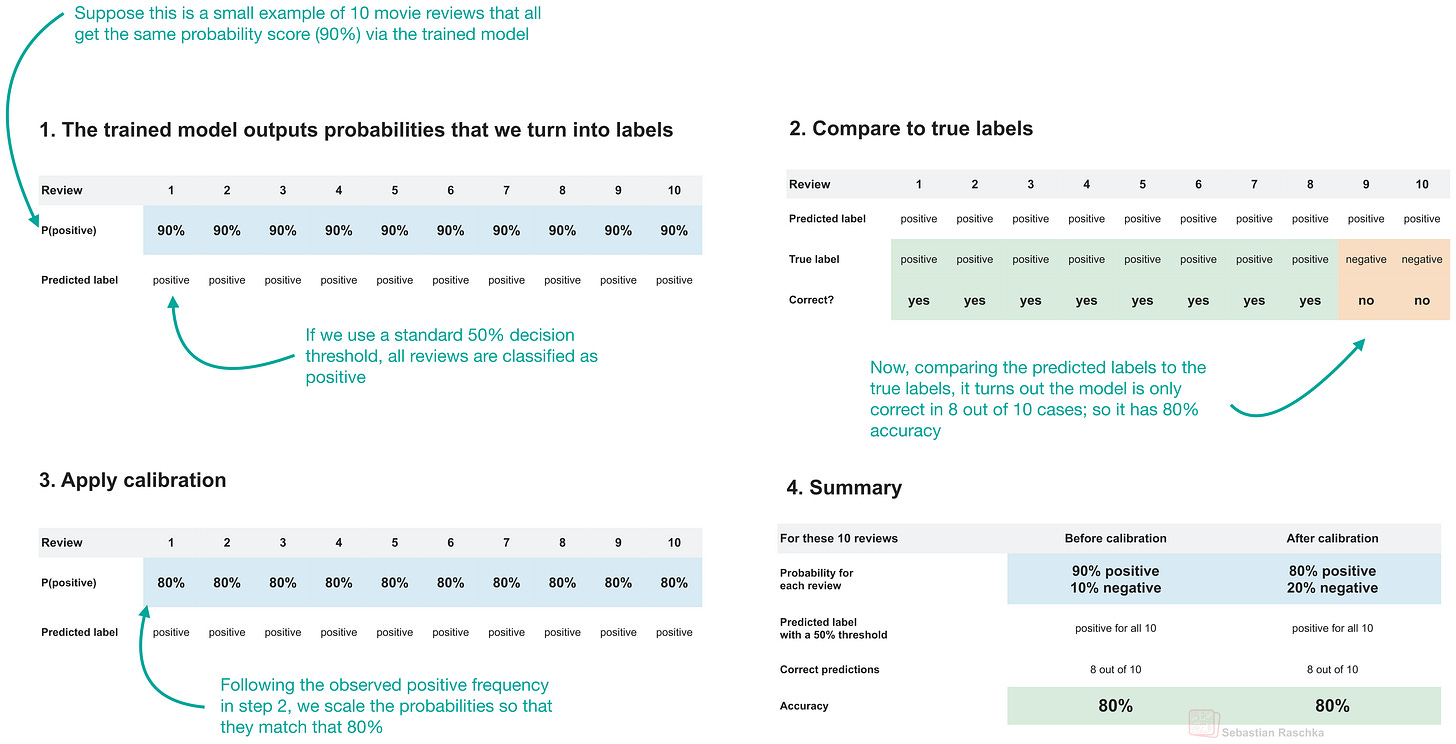
图 34:校准工作原理示意。
校准技术使用一个单独的带标签数据集(例如留出的验证集)来调整这些概率估计。校准成功后,在被赋予约 74% 正面概率的大量评论中,大约应有 74% 确实是正面的。更多信息可参考经典的 scikit-learn 文档。
实现这一目标的方法有很多。例如,我在自己的 AI detector project 中使用的温度缩放(temperature scaling)。温度缩放会在应用 softmax 之前,将模型的 logits 除以一个温度值(T)。我们在固定模型权重的前提下,通过在校准数据集上最小化交叉熵损失来学习 T(一个正数)。温度大于 1 会降低最高概率类别的置信度,温度在 0 到 1 之间则会提高它。随后,我们把同一个温度用于新的预测。由于这种缩放保留了 logits 的排序,当我们选取概率最高的类别时,预测类别保持不变。
5.2 带校准奖励的强化学习(RLCR)
Jev 的 RLCD 训练方法仍是专有的,但我们可以讨论一个相关的思路:带校准奖励的强化学习(RLCR),它出自 2025 年的论文 Beyond Binary Rewards: Training LMs to Reason About Their Uncertainty。(请注意,这两种方法之间并没有官方确认的联系,但我推测它们可能相关。)
带可验证奖励的强化学习(RLVR)通常对正确答案奖励 1,对错误答案奖励 0。(如需全面的讲解与实现,我推荐看看我的书 Build A Reasoning Model (From Scratch) :)。)
简而言之,RLCR 对不准确的置信度估计额外加了一项惩罚。
因此,在传统的 RLVR 方法中,奖励 R 根据答案是否正确取 0 或 1(为简单起见,这里忽略可选的格式奖励和长度惩罚)。
在 RLCR 中,模型生成推理过程和答案,随后进行一次不确定性分析并给出一个数值置信度(q)。修改后的奖励为
其中,答案正确时 c 为 1,否则为 0。例如,一个错误答案若给出 90%(0.9)的置信度,获得的奖励为 -0.81,因为
置信度为 20% 时,奖励是 -0.04。以 90% 置信度给出正确答案则得到 0.99。(熟悉校准模型评估的读者可能已经注意到,平方误差项正是对「答案正确」这一给定概率的 Brier 惩罚。)
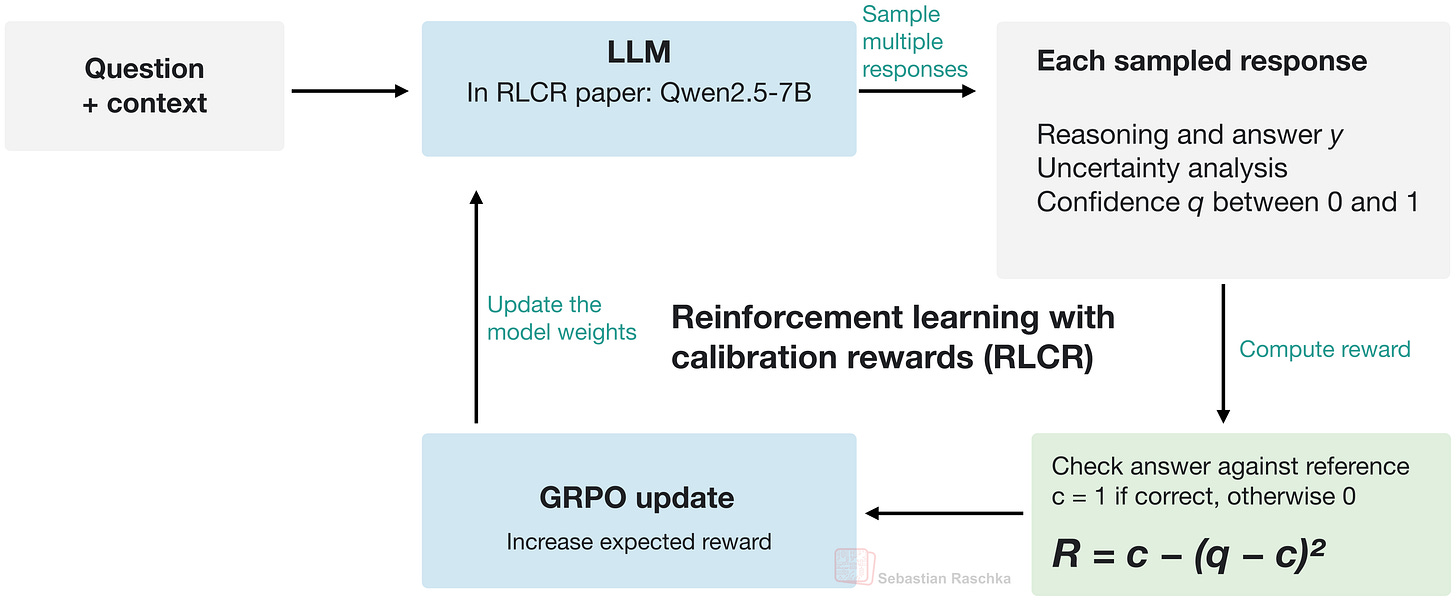
图 35:RLCR 概览。
注意,不确定性分析和 q 都由同一个模型(这里是 Qwen2.5-7B)在它的回答中生成。
不确定性分析是一段书面评估,说明它的答案可能在哪里出错。回答之后,模型会检查缺失的证据、含糊的措辞、可疑的假设或可能的推理错误。论文中的提示词要求它指出具体的不确定性,而不是提出修正。
此外,系统提示词明确要求给出 q,即标签内一个 0 到 1 之间的数字,表示模型估计自己的答案正确的概率。所有这些部分都由系统在同一次回答中依次生成。
为便于说明,模型的回答可能如下:
...对问题的推理...
positive

这段文字提到了一篇正面的影评,但它与第二段的联系并不清楚。

0.6
下面是论文中一张带注释的图,展示了它相比使用温度缩放的普通 RLVR 如何改善期望校准误差。
在 HotpotQA 上,与 RLVR 相比,RLCR 将期望校准误差(ECE)从 0.37 降到 0.03,准确率相近(62.1% 对 63.0%)。在另外六个数据集上,平均 ECE 从 0.46 降到 0.21,准确率则从 53.9% 升到 56.2%。这些是论文表 1(a) 中的结果。
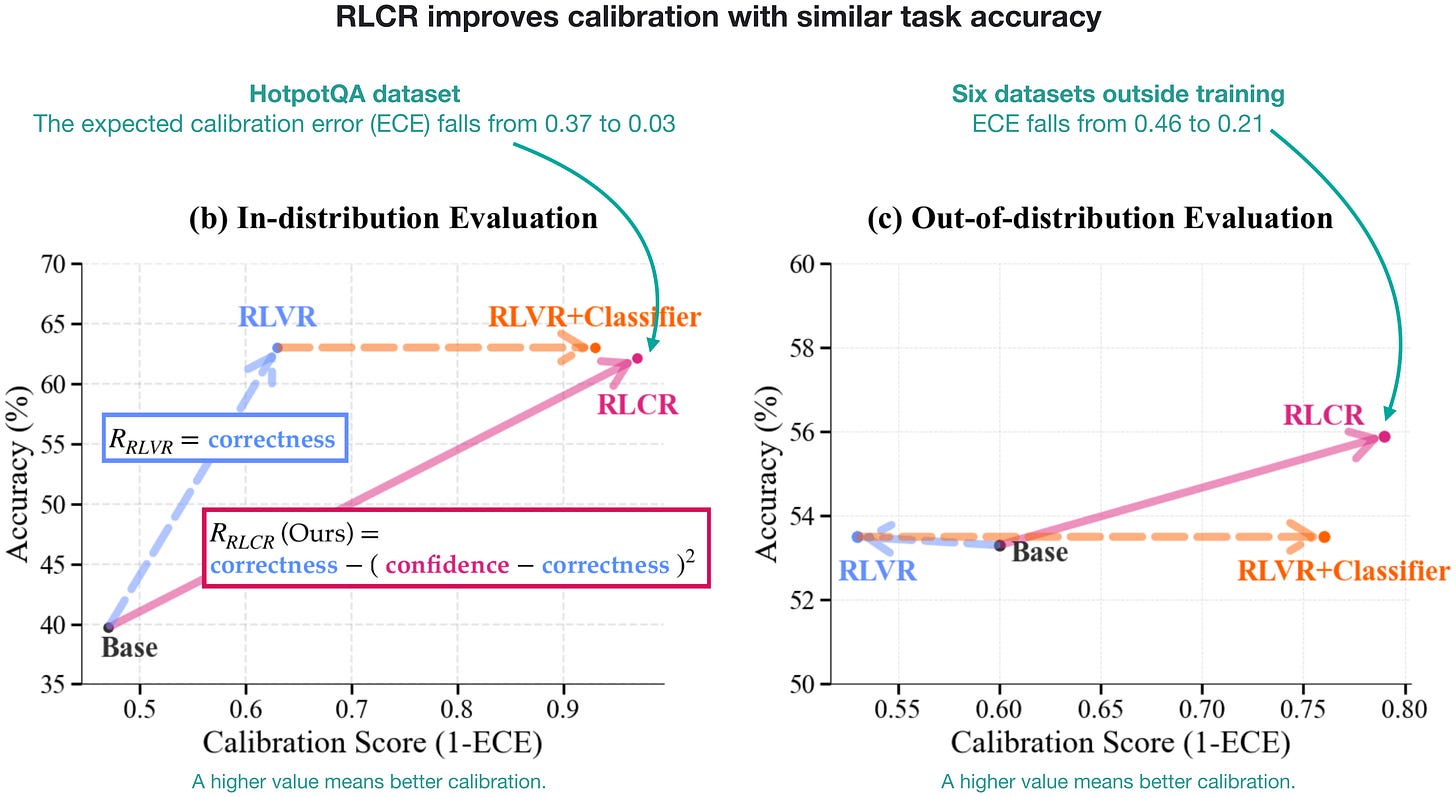
图 36:来自论文 Beyond Binary Rewards: Training LMs to Reason About Their Uncertainty 的 RLCR 结果。
从概念上讲,「RLVR + Classifier」中的「Classifier」是一个监督式二分类器,用来预测生成的答案是否正确。
对于 Jev,我可以直接把校准奖励施加到类型化决策上,而不生成推理文本。例如,我们可以给一个 GPT 风格的模型配上 2.2 节所示的那种分类头,并调整 RL 训练目标,去奖励准确的决策和校准良好的概率。我们会把骨干网络和分类头一起训练。这个做法受 RLCR 启发,至于 Jev 的 RLCD 是不是这么工作的,目前还不清楚。
另一种做法是,既然 Direct Policy Optimization(DPO)是 Reinforcement Learning with Human Feedback(RLHF)的交叉熵(CE)替代方案,我们也可以直接在分类器的概率上最小化 CE + Brier 损失。我用 ModernBERT 试过,相比常规的温度缩放有小幅提升。
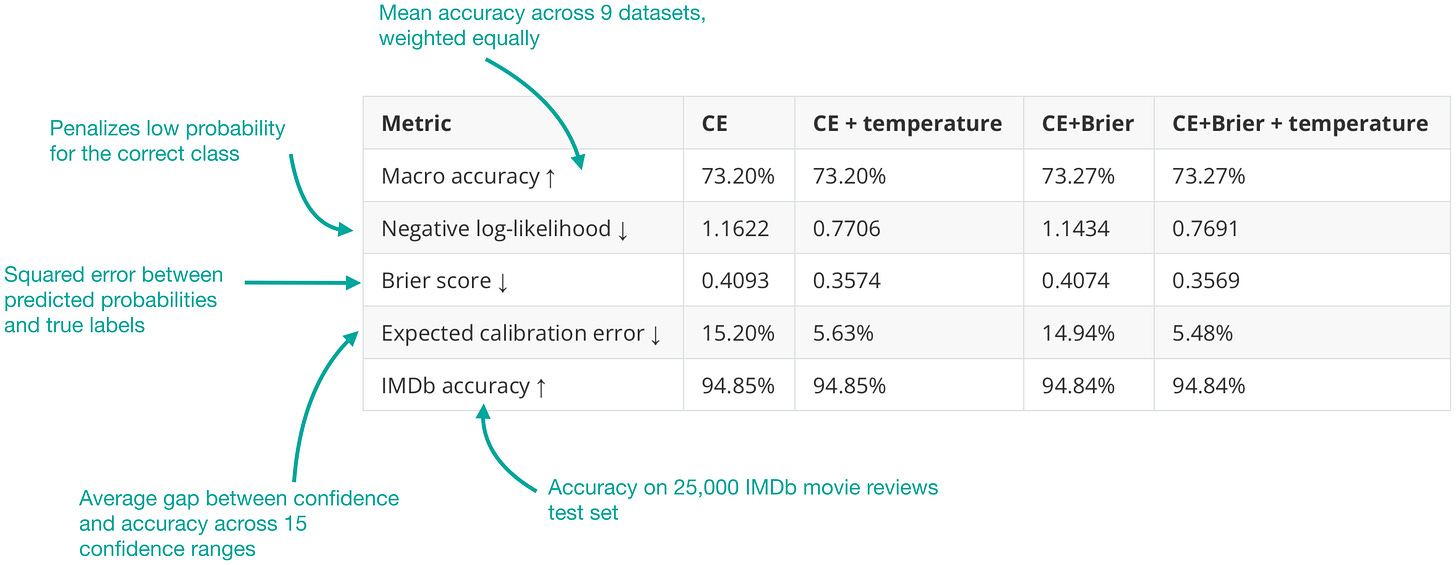
图 37:通过受 RLCR 启发的 Brier 损失优化对 ModernBERT 的改进。↑ 表示越高越好。↓ 表示越低越好。
6. Jev 是给谁用的?
前面已经把 Jev 讲得比较细了,那 Jev 是给谁用的?按我的判断,目标受众相当大,落在这样两类人的交集里:a)不想为每个决策任务都去微调一个定制分类器,想省时间;b)想比用 GPT-6 这类“大炮”LLM 更省钱。
此外还能想到不少有意思的用例。下面列了一小串想法。
6.1 Jev 的用例
用例清单似乎列不完。当然,有些很花哨的例子,比如让它玩 Tetris 这类电子游戏(我在前面的视频里演示过,用来展示这个 API 的低延迟)。不过对大多数人来说,整理邮件更实用。比如可以把 Jev 当作额外的垃圾邮件过滤器、优先级排序工具等等。
但除了这些,它也可以用来增强 LLM-agent harness。在这里它可以用来
- 作为常规 LLM-agent harness 的预筛选器,扫描我们的上下文里有没有 prompt injection;
- 为模型选择推理投入等级;
- 从你注册的技能库里挑一个 skill.md;
- 当作评估或自我改进的裁判;
- 找出相关文件,用来构建上下文。
这份清单几乎列不完。甚至有人在 arXiv 上发了一篇综述,分析了最近短短几天内冒出来的 2,170 个 Jev 相关项目。
6.2 关于 Jev 克隆和本地 Jev
Jev 发布之后,涌现出成百上千个快速克隆版本。我翻过的大部分,都只是拿 ModernBERT 或 Qwen 做 SFT 微调,再套一个仿 Jev 的 API 的速成示例。
据我所知,没有一个能在如此广泛的任务上达到 Jev 的性能水平。把这些项目和 Jev 相比,就像拿 Alpaca(早期基于原始 LLaMA 开放权重模型做指令微调的 LLM)比 GPT-6。精神上或许相似,但在真实任务上效果参差不齐。
无意冒犯,但它们看起来就是蹭热度的速成项目,我不想在这里专门推荐某一个。
这里唯一的例外可能是 GLiNER,这个项目已经存在大约 3 年了。它和 Jev 本质上不是一回事,但能用于类似的场景。不过从基准测试来看,Jev 明显更强。
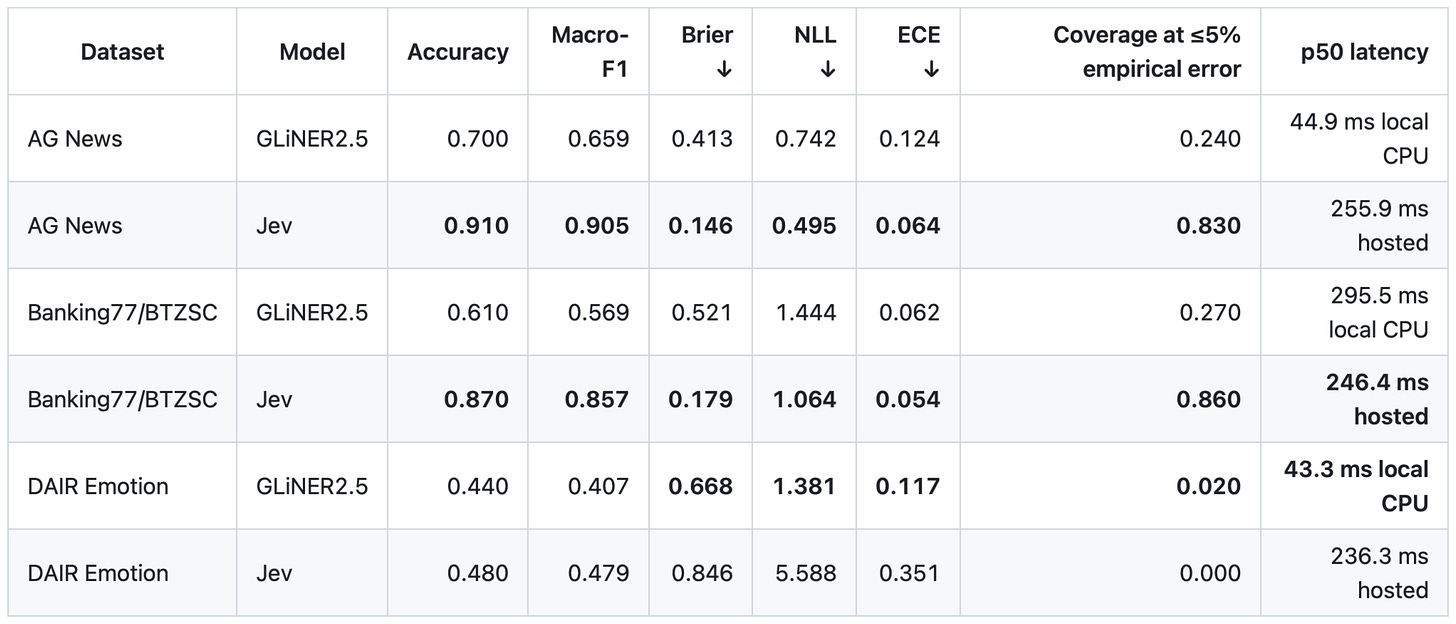
图 38:GLiNER 与 Jev 的对比,来自 https://github.com/AbdelStark/jev-benchmarks/blob/main/results/reports/btzsc-pilot-v1.md
总之,对一个优秀的开放权重 Jev 替代品,需求是真实存在的。原因未必是成本(Jev 已经足够便宜),而是隐私。(另外,Jev 走网络都这么快,想象一下跑在强劲的本地硬件上会有多快。)
所以,我当然希望 Jev 能迎来自己的 DeepSeek(或者 Kimi、GLM、MiMo)时刻。我相信有人在做这件事,但需要时间。TypeSafe AI 投入了一支专家团队,做了好几个月。指望一周内复现那套开发和评估工作并不现实。(不过,它比万亿参数模型更小、更高效,所以按理说不会花那么久。)
结论
总的来说,乍看之下,Jev 似乎没有带来什么本质上的新东西。毕竟可以说“它就是个分类器”(上面套了个好用的 API)。但它在极其广泛的任务上都出奇地好用。从这个意义上说,它是专用分类器的即插即用版本。
当然,专家仍会对专用模型进行微调,但如今要证明微调专用模型的合理性,门槛已经高得多——直接拿一个 Jev 或类 Jev 模型来用,就能得到足够好的结果。
另外,我并不指望 Jev 和类 Jev 模型能解锁新能力,或解决此前无法解决的任务。不过,如果我们将这类模型纳入 agent harness,让它们在其中辅助昂贵的 GPT-6 或 Opus 5.5 做决策,那么未来使用 agent harness 可能会快得多,也便宜得多。