テキスト分類の言語モデル:bag-of-wordsからJevまで
ナイーブベイズ、RNN、CNNからTransformerまで、Raschkaはテキスト分類の技術的系譜を整理し、さらにIMDbでJevを実測:Choice APIは96.47%の精度、コスト0.65ドルで、微調整済みModernBERTに匹敵し、学習不要。
日本語
コピー
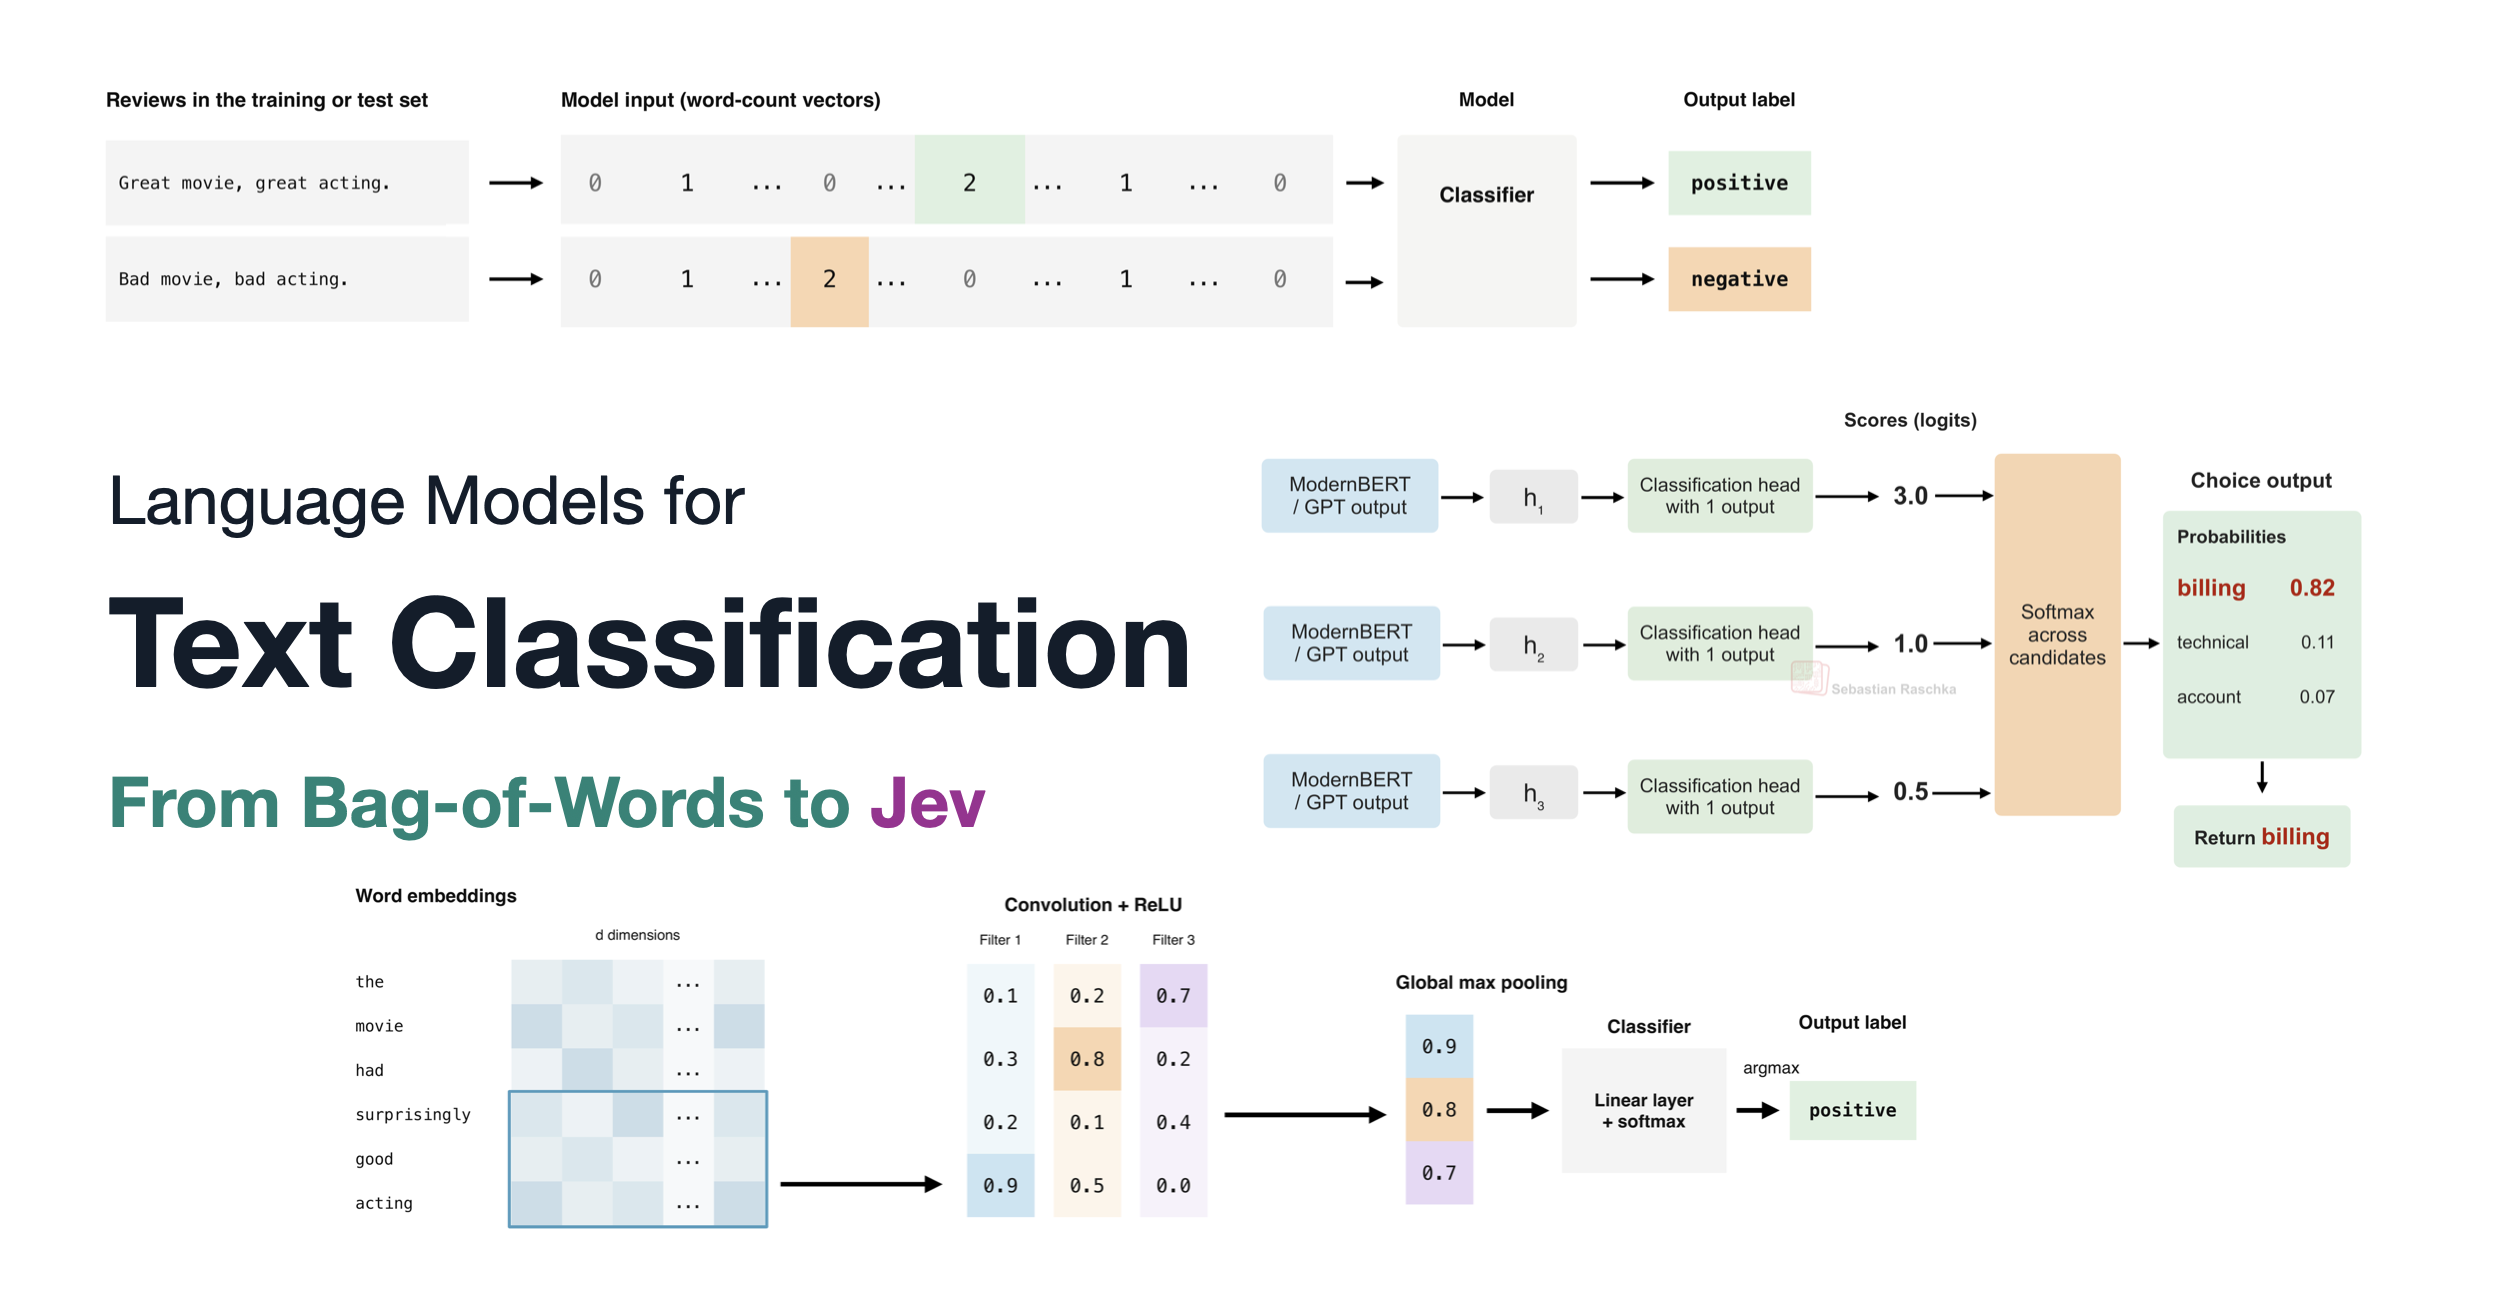
テキスト分類のための言語モデル:Bag-of-Words から Jev まで
Bag-of-Words、RNN、CNN、Transformer、Jev 風 API、そしてキャリブレーションの可視化ガイド
最近リリースされた Jev AI モデルは、この2週間で技術コミュニティの文化的現象となった。Jev の目的は物事を分類することだが、人はすぐに「ただの分類器だ」と貶したがる。私自身の Jev に対する見方も、この数日でかなり変わった。最初は「分類器はかつて自分の得意分野で、こんなものは自分で楽に作れる」(後で詳しく触れる)と思っていたのが、今では「実際の性能は思っていたよりずっと良い」に変わっている。
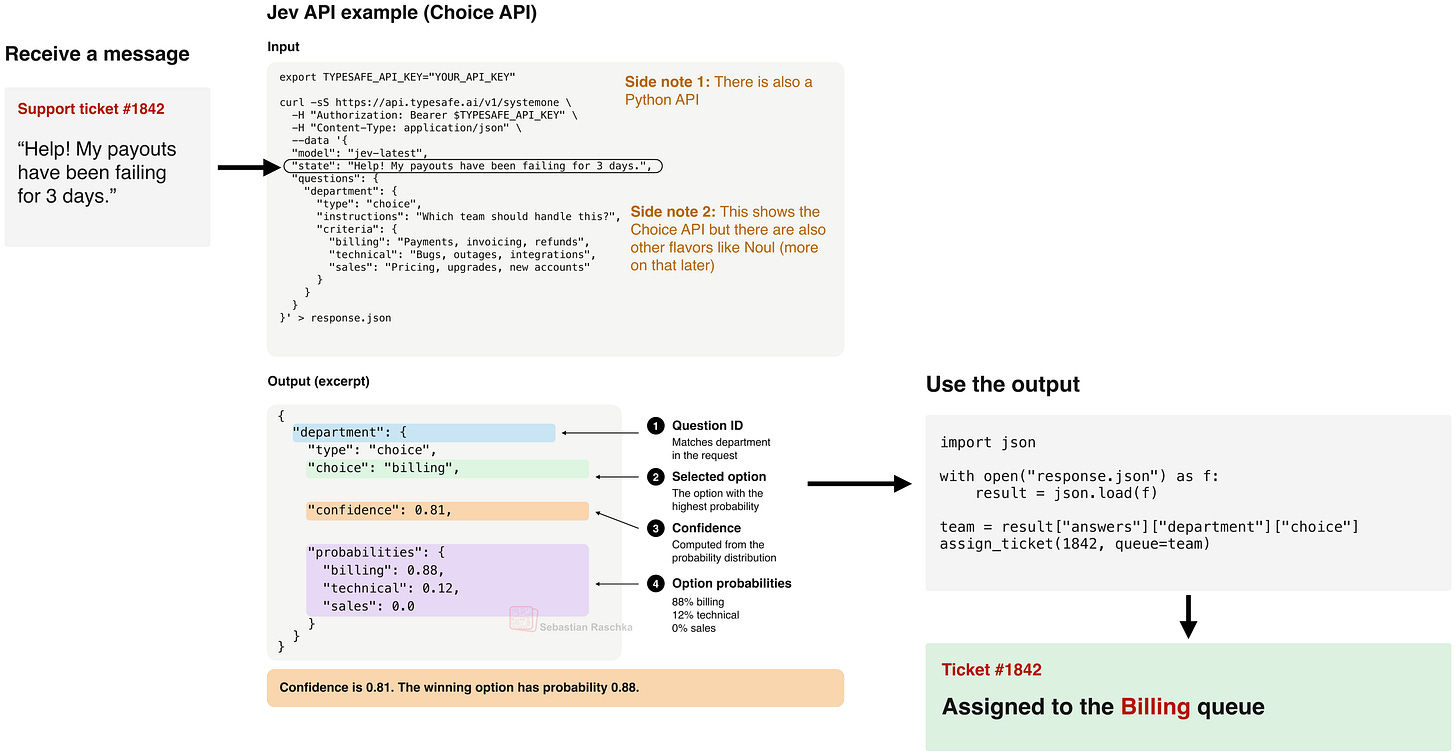 図 1:Jev API の概要。詳細は後述する。
もちろん、最新の SOTA GPT やオープンウェイト LLM も Jev のような分類タスクはできるし、より汎用的な意思決定もこなせる。だが Jev の強みは、そうした分類タスクをはるかに速く、はるかに安くこなせる点にある。
逆の端では、狭く明確に定義された問題に対しては、Jev の分類精度・速度・コストはどれも専用分類器に勝てないだろう。しかし本当の売りは、そうしたタスク専用モデルよりずっと汎用的であることだ。
では、Jev の背後にある手法は何なのか(もっともらしい推測に基づく)、何ができて、なぜこれほど話題なのか。これらは本記事の後半で答えるつもりだ。ただ、まず意思決定に使われる言語モデルの発展史を簡単に振り返っておくのが良い出発点だと思う。それによって誇張がいくらか剥がれ、Jev が実際に何を得意とするのかが見えやすくなるかもしれない(「Jev は本質的にテキスト分類器だ」、しかし「Jev は『ただの』テキスト分類器でもない」)。
付記:私は Jev と何の関係もなく、Jev への無料アクセスも得ていない。本記事は製品の推奨ではなく、テキスト分類の歴史をたどりながら最近の盛り上がりを理解するための技術記事にすぎない。
この記事は長い。ブラウザで読むことを勧める。左側に目次メニューがある。
1. Transformer 以前の言語モデリングと分類
完全を期すため、Jev を文脈に置く前に(ここに駄洒落の意図はない)、時系列で話すのが最も合理的だと思う。この節では、テキスト分類の応用の歩みを簡単になぞりたい:ナイーブベイズ、ロジスティック回帰、そして transformer モデル以前のより古典的な(深層)ニューラルネットワークだ。
1.1 Bag-of-Words:ナイーブベイズ、ロジスティック回帰、XGBoost
昔、つまり私が大学院生だった15年前、リカレントニューラルネットワークはすでに存在していた(後で触れる)ものの、テキスト分類は通常 Bag-of-Words 表現で行われていた。単純明快で、中規模のデータセットでも良い結果が得られたからだ。
手短に言えば、Bag-of-Words 表現とは、長さの異なる自由テキストの入力を、固定サイズの入力ベクトルを要求する古典的な分類器(ナイーブベイズ、ロジスティック回帰、SVM、ランダムフォレスト、XGBoost など)に食わせられるようにする方法だと理解すればよい。
実世界での応用は幅広く、ニュース記事の分類からメールのスパムフィルタリングまで見られる。Gmail の初期のスパムフィルタはナイーブベイズモデルと Bag-of-Words 表現を使っていたと言われている。
ちなみに、私はこの手法について書いたことがある。ちょうど12年前だ。arXiv で最初に共有した内容の一つだった。
 図 2:私が 2014 年に書いた古いチュートリアルで、Bag-of-Words モデルを使ってナイーブベイズ分類器を解説している。
では、Bag-of-Words 表現とは一体何か。長さの異なる自由テキストを、前述の「古典的」分類器が使える固定サイズの表現に変換する方法だ。例えば:
- 訓練サンプル 1:「Zentropa はここ数年で私が観た中で最も独創的な映画だ。フィルム・ノワールの影響を受けた独特のスリラーが好きなら、これが毎年夏に映画館を埋め尽くす Hollywood の大作に食傷した口をちょうど癒してくれる。Von Trier の後の作品、例えば Breaking the Waves はもっと高い評価を得たが、これこそが彼の真の最高傑作だ。」
- 訓練サンプル 2:「この映画はひどいの一言。John Ritter はプロレスのドタバタを演じていて、俳優の75%は台詞をプロンプターから読んでいるようで、編集は酷く、ミックスも酷い。」
- 訓練サンプル 3:「Zentropa は The Third Man と多くの共通点がある。後者もフィルム・ノワール風の作品で、戦後ヨーロッパの廃墟を舞台にしている。」
(上の例は広く知られた IMDb 映画レビュー分類データセットから抜粋した。)
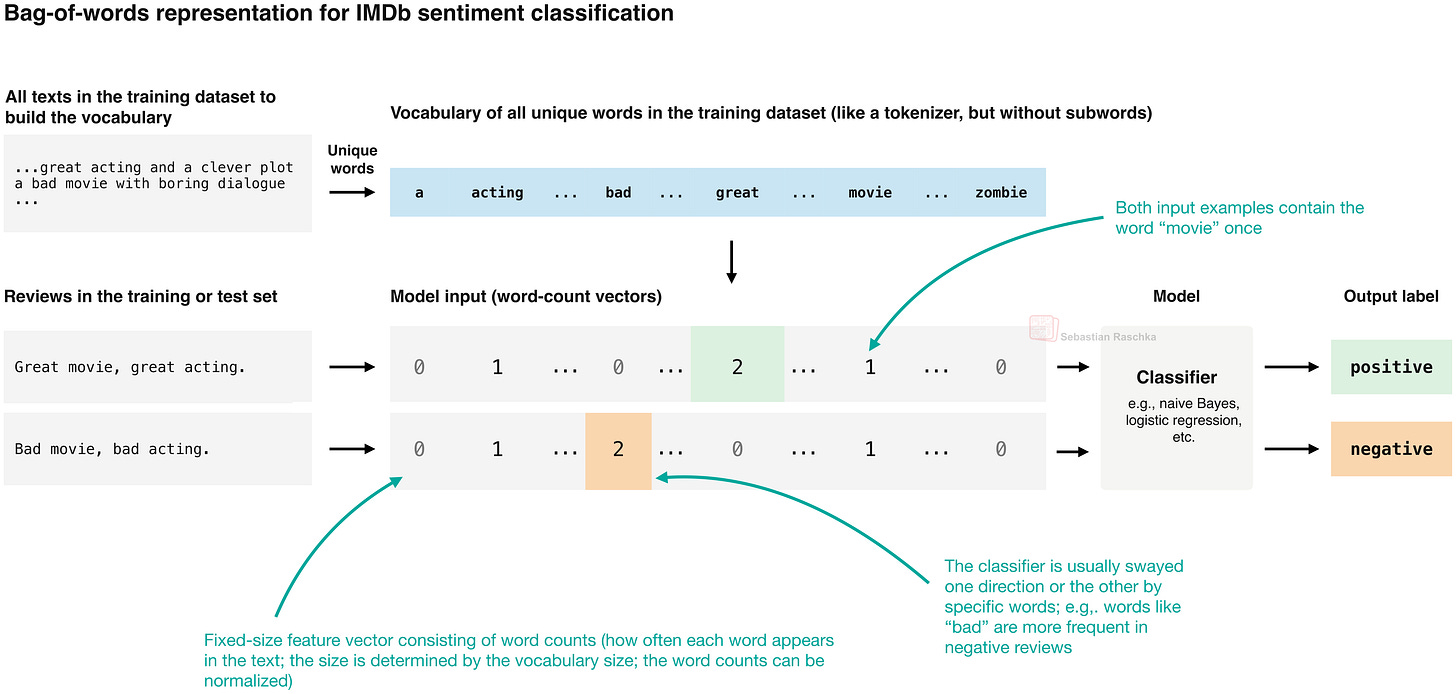 図 3:Bag-of-Words 表現の模式図。
Bag-of-Words モデルはまず語彙を構築する。つまり訓練集合に含まれるすべての重複しない語だ(いわゆるストップワード、例えば "a" や "the" のようにほとんどの文脈で意味情報をほとんど運ばない語を除くこともできる)。
Bag-of-Words 表現は語彙の各語にベクトル内の一つの位置を割り当て、こうして固定サイズの入力が得られる。そして各語が文書中に現れる回数を数える。例えば語彙に 50,000 個の重複しない語があれば、入力が10語でも30万語でも、固定サイズの 50,000 エントリのベクトルが生成される。ほとんどのエントリはゼロであることに注意。各文書は語彙のごく一部しか含まないからだ。(生のカウントをそのまま表す以外に、TF-IDF のような正規化の方法もある。)
これらの単語頻度ベクトルが手に入れば、ラベル付きの訓練セットで分類器を訓練できる。たとえば、迷惑メールかそうでないかをラベル付けしたメールだ。ロジスティック回帰モデルを例に取ると、これは特徴量の重みを学習し、特定の単語(とその出現回数)を特定のラベルに関連付ける。ある単語は迷惑メールである確率を押し上げ、別の単語は押し下げる、といった具合だ。
この手法は計算コストが低く、ある単語がラベルについて強い手がかりを与える場合にはよく機能する。迷惑メール分類のような単純なタスクなら、素早くそこそこ正確な結果を得るのに十分なことが多い。
だが、この発想の最大の弱点の一つは、bag-of-words 表現が本質的に語順を捨ててしまうことだ。「the dog bites the man」と「the man bites the dog」は別の出来事を述べているのに、生成されるベクトルはまったく同じになる。
(語のペアやより長い系列、つまり n-gram を特徴量として加えれば、局所的な語順を部分的に保つ回避策もある。代償は語彙が大きくなることだ。)
こうした欠点はあるものの、bag-of-words には低リスクな場面でそれなりの居場所があると思っている。何しろあまりに安上がりなのだ。そして bag-of-words 表現 + ロジスティック回帰は、今でもあらゆるテキスト分類問題に取りかかるときの最初のベースラインだ。実装があまりに簡単だからだ。
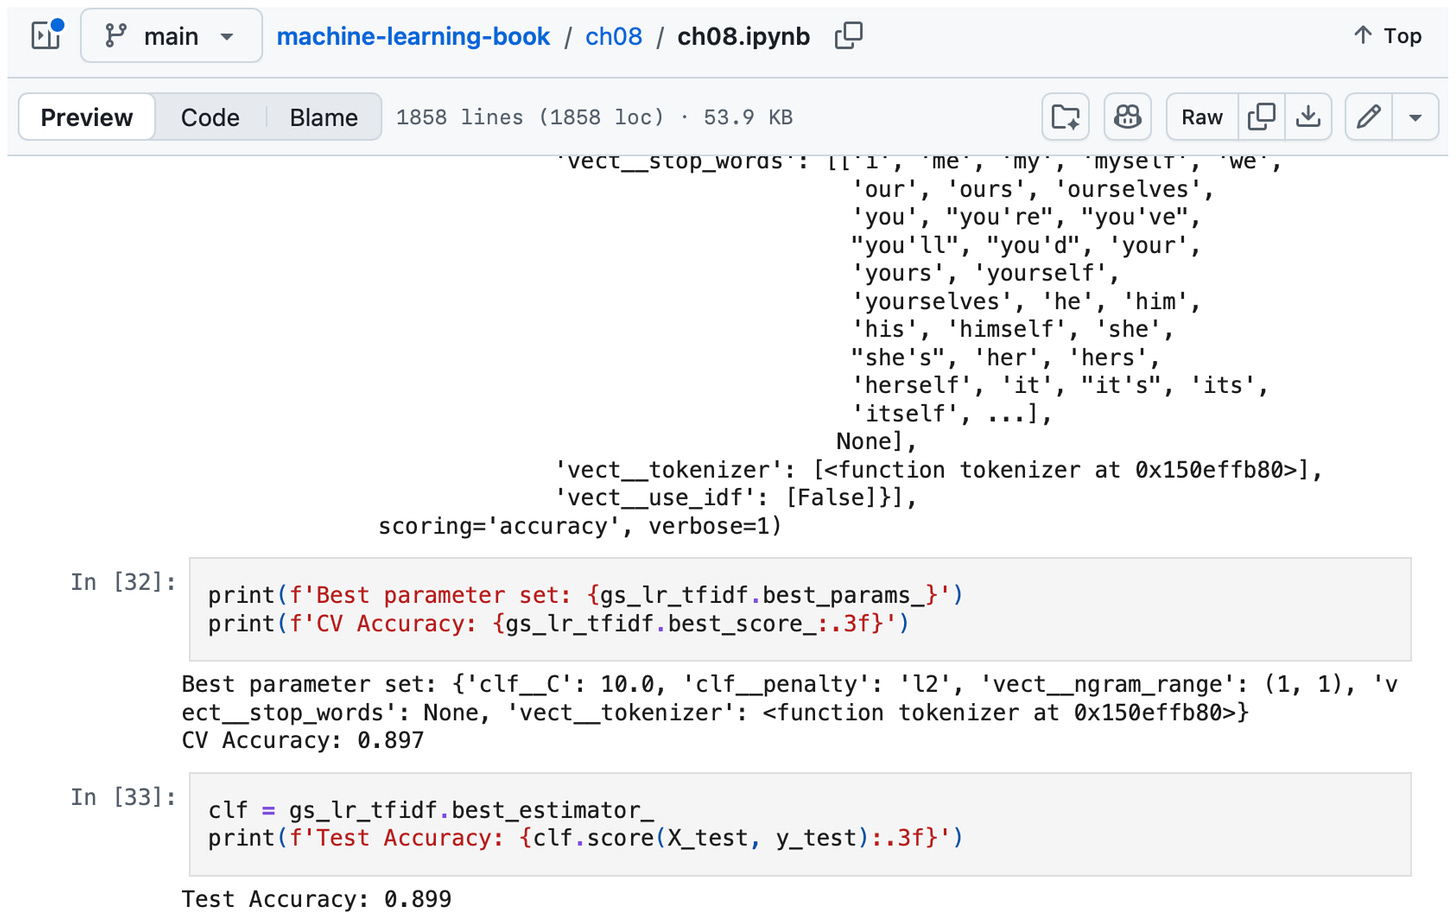 図 4:簡単なロジスティック回帰分類器を自分で作ってみたいなら、チュートリアルをこちらに書いた。このモデルは(バランスの取れたデータセットで)89.9% の精度に達する。
1.2 テキスト分類のためのディープニューラルネットワーク
先ほどの bag-of-words モデルは、(単純な)ディープニューラルネットワーク、たとえば多層パーセプトロンにも使える。だが欠点は変わらない。文の構造と語順はやはり失われる。 ただし、より複雑なニューラルネットワークのアーキテクチャなら bag-of-words の回避策を迂回できる。畳み込みニューラルネットワーク(CNN)とリカレントニューラルネットワーク(RNN)は、単語埋め込みをそのまま入力として扱える。
1.2.1 単語埋め込み
まず、入力テキストをモデルに食わせる前に、適切な表現に変換しなければならない。bag-of-words は一つの表現であり、単語埋め込みベクトルはまた別の表現だ。違いはこうだ。bag-of-words ベクトルは語彙中の各単語の出現回数を数えてテキスト全体を表すのに対し、単語埋め込みは個々の単語を稠密な学習済み数値ベクトルとして表す。
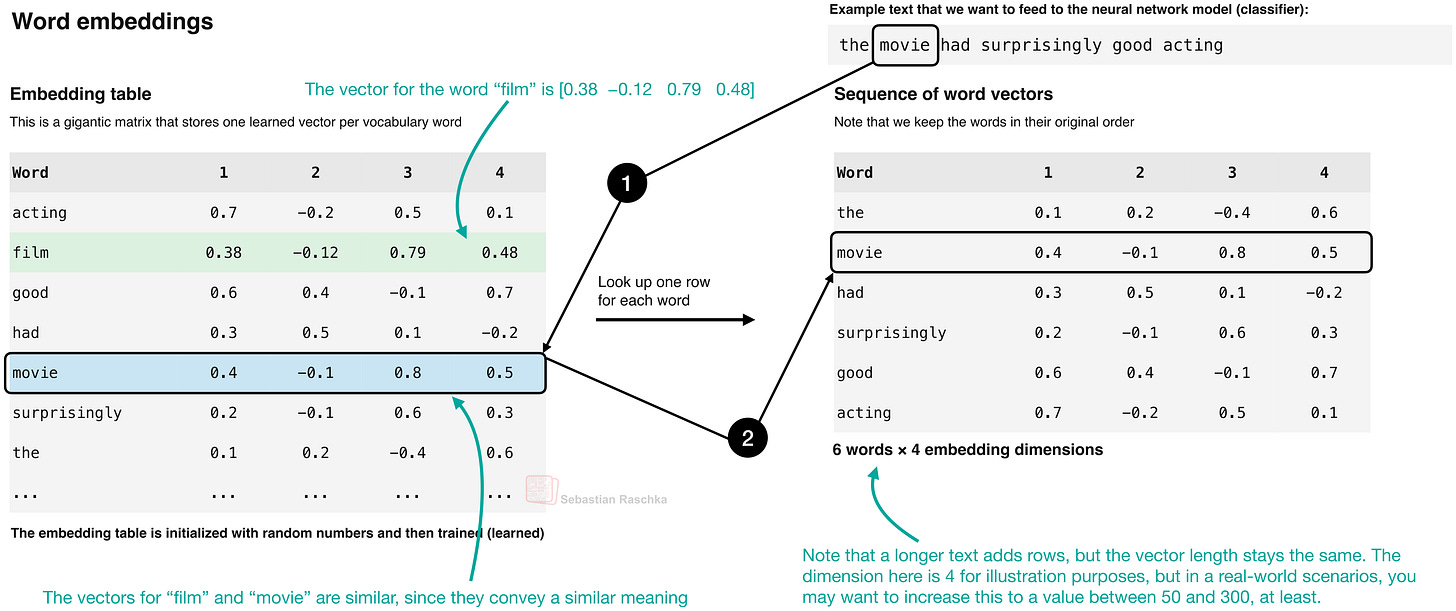 図 5:単語埋め込みの構築の様子。
- 単語埋め込みは、LLM の埋め込み層と同様に、入力トークンを稠密ベクトルに変換する形で機能する。埋め込みはモデルの外部で作ることもできる(たとえば古典的でよく使われる学習手法が Word2Vec と GloVe だ)。ニューラルネットワークのアーキテクチャの一部として埋め込み層を組み込み、訓練中に学習・調整することもできる。これらの古典的な埋め込みは、参照時に文脈に依存しない。たとえば「bank」という単語は、「river bank」でも「bank account」でも同じベクトルになる(ご存じのとおり、文脈は attention のような仕組みで扱える)。埋め込みについてさらに知りたいなら、次の資料が役に立つかもしれない:第 2 章:Working with Text Data(LLM の章だが、単語やトークンの埋め込みがどういうものかを理解するには十分だ。LLM の tokenizer では単語をサブワードトークンに分割するが、Word2Vec では通常 1 単語が 1 トークンになる。)
- Understanding the Difference Between Embedding Layers and Linear Layers(どういう場合に埋め込みベクトルが Linear 層と行列積と数学的に等価になるかを、図解で説明している。)
1.2.2 リカレントニューラルネットワーク(RNN)
ここにいる多くの読者はリカレントニューラルネットワーク(RNN)に馴染みがあるだろうから、この節は短めにする。RNN は自然言語処理における古典的なニューラルネットワークのアーキテクチャで、その普及した変種は 1980 年代から 90 年代初頭にさかのぼる。2017 年に登場した Transformer(これが使う attention 機構は、そもそも RNN の中で最初に提案された。簡単な年表は私の『大規模言語モデルを理解する』にある)は、その後多くの NLP アプリケーションで RNN に取って代わっていった。
RNN は系列(たとえばテキスト)を一度に一語ずつ読む。各ステップで、現在の単語の埋め込み(前節で扱ったもの)と前ステップの隠れ状態を組み合わせる。隠れ状態は、それまで処理したテキストを要約する固定サイズのベクトルだと考えればよい。だから語順が重要になる。語の並びを変えれば状態更新の順序が変わるからだ。
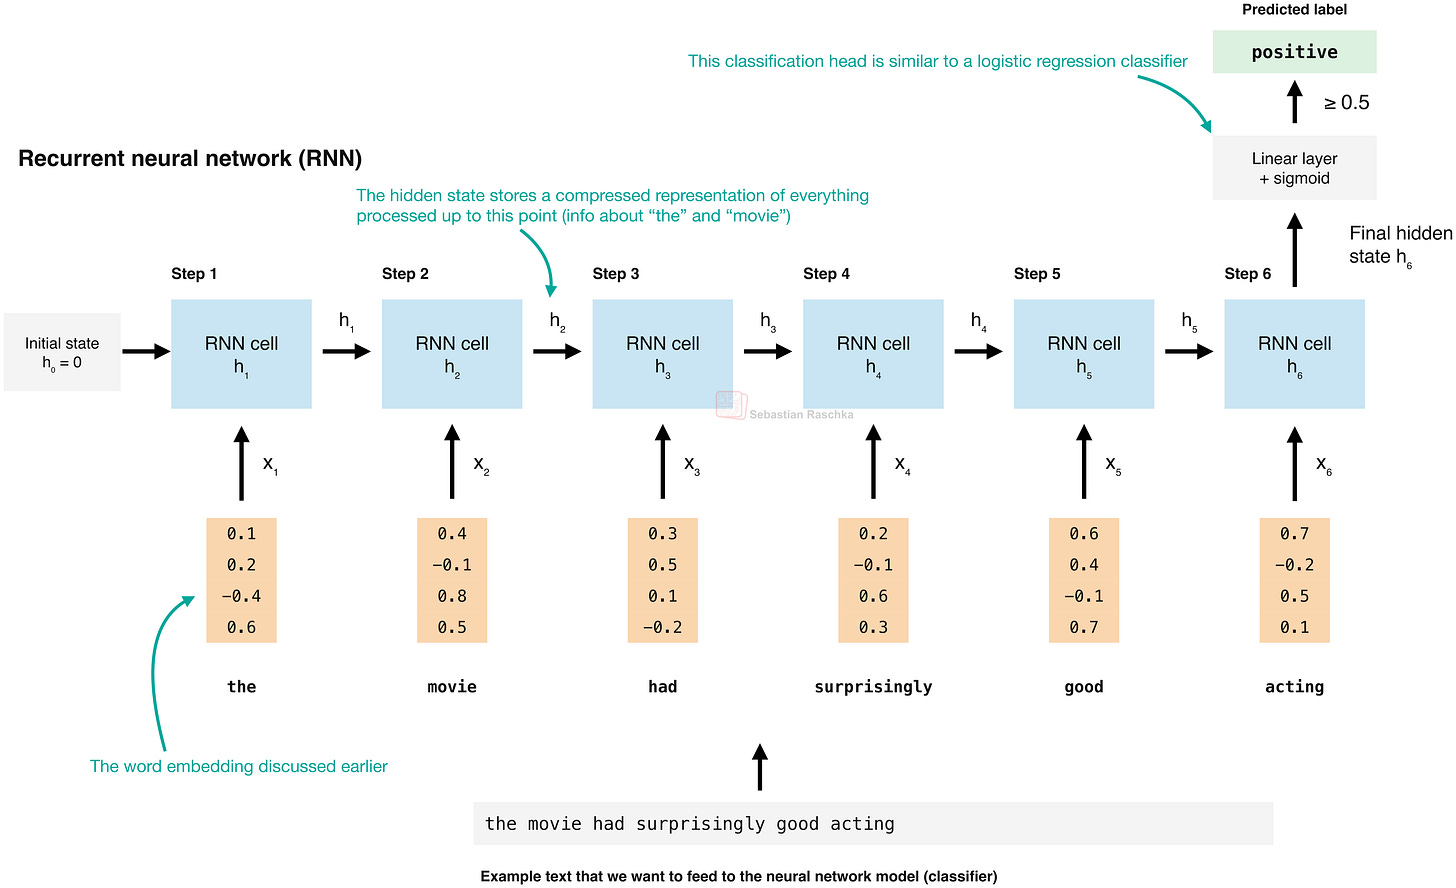 図 6:RNN 分類器の模式図。
上の図は RNN の展開表現を示している点に注意。つまり RNN は各入力に対して同じ層のセットを再利用しており、これが「リカレント」という言葉の由来だ。また「リカレント」であるがゆえに、入力テキストは任意の長さでよい。下の図は「リカレント」の展開表現と折りたたみ表現を並べて示している。どちらも同じアーキテクチャで、可視化の仕方が違うだけだ。
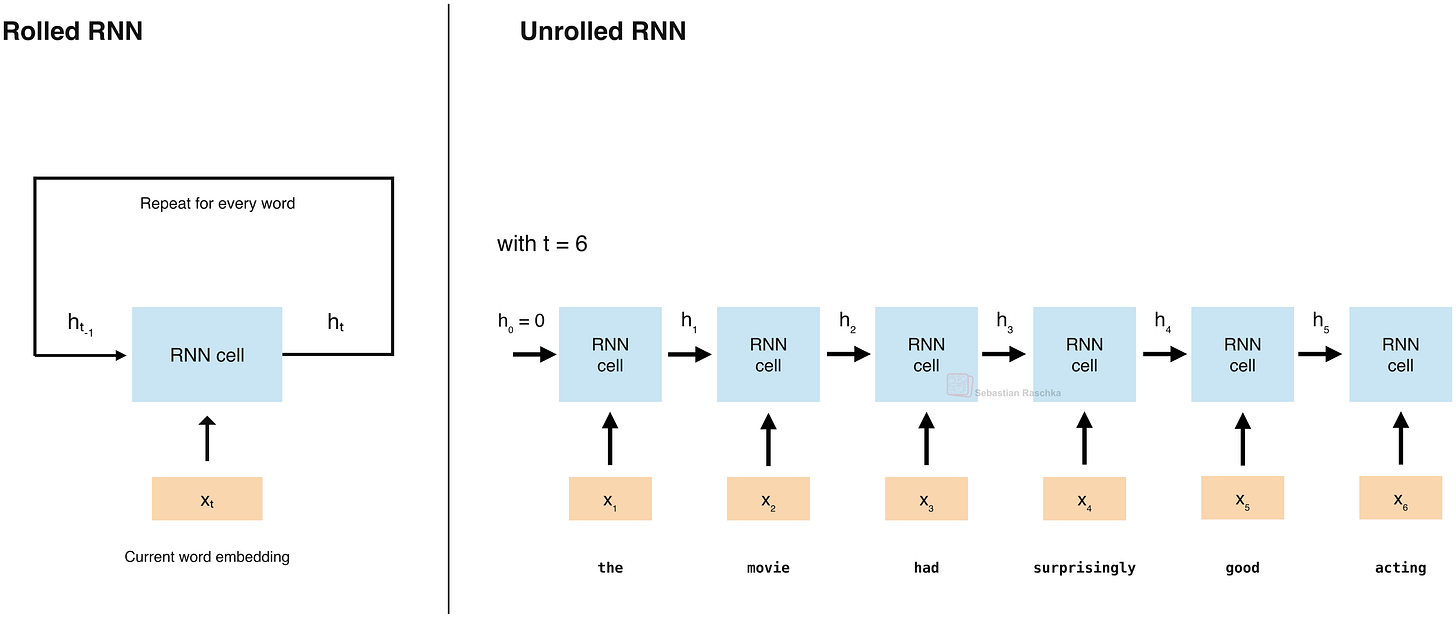 図 7:同じ RNN の折りたたみ表現と展開表現。
RNN は訓練が難しいことで知られており、これに対して重要な改良がいくつもある。1997 年に提案された長・短期記憶(LSTM)ネットワークや、2014 年に提案されたゲート付き回帰型ユニット(GRU)は、学習されたゲートで情報の保持と更新を制御する。(より新しいものでは、2024 年に提案された xLSTM:拡張長・短期記憶 もある。)
また、状態空間モデルもこの「固定サイズの隠れ状態を順に更新する」という発想の影響を受けている。Transformer のアテンションより計算量は少ない。ただしボトルネックは依然として、隠れ状態にどれだけの情報を保持できるかであり、しかも逐次処理が必須である点は変わらない。(面白いことに、アテンションはもともと RNN のために開発されたもので、Transformer アーキテクチャより先に存在した。ただそれは別の話。『大規模言語モデルを理解する』で書いた。)
結論として、RNN はテキスト分類器の訓練に使える。IMDb の映画レビューデータセットに戻ると、ロジスティック回帰を使った bag-of-words 分類器は(バランスの取れたデータセットで)約 89.9% の精度に達したのに対し、LSTM RNN は 85.66% にとどまった。そう、RNN の訓練は実際に難しい(後述の ULMFiT に注目してほしい。あれははるかに高い精度で RNN を訓練する)。
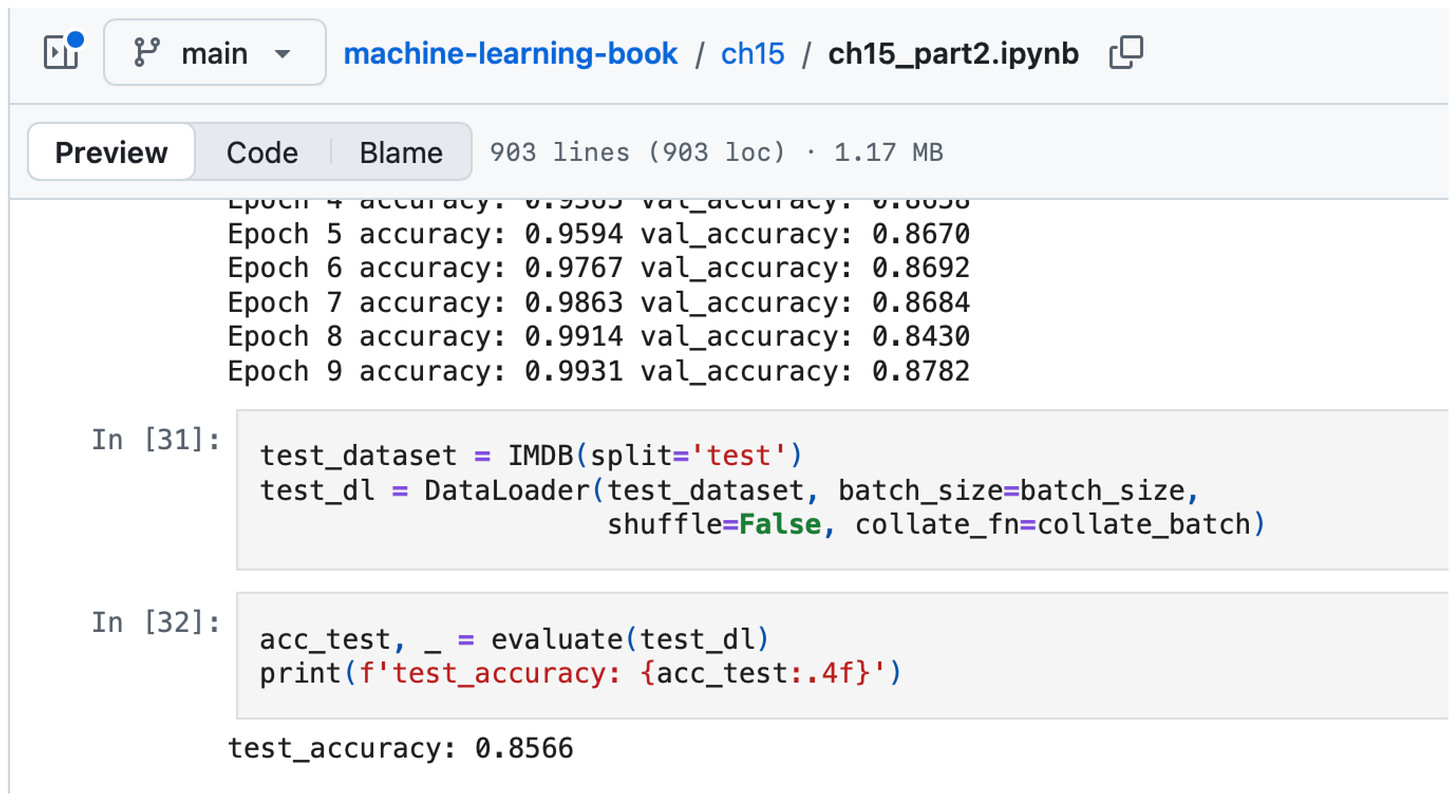 図 8:LSTM を使ったシンプルな RNN のチュートリアル。このモデルは(バランスの取れたデータセットで)85.66% の精度に達する。訓練精度がそれより高いのは、明らかな過学習を示している。
この RNN はゼロから訓練されている点に注意。より良いのは、まず大きなデータセットでモデルを事前訓練し、そのあと目的のデータセットでファインチューニングする方法だ(伝統的に、これを「転移学習」と呼ぶ)。
自然言語処理の分野で、この手法を提案した中で最も影響力の大きい論文の一つが ULMFiT(2018)で、IMDb で 95.4% のテスト精度を達成した。
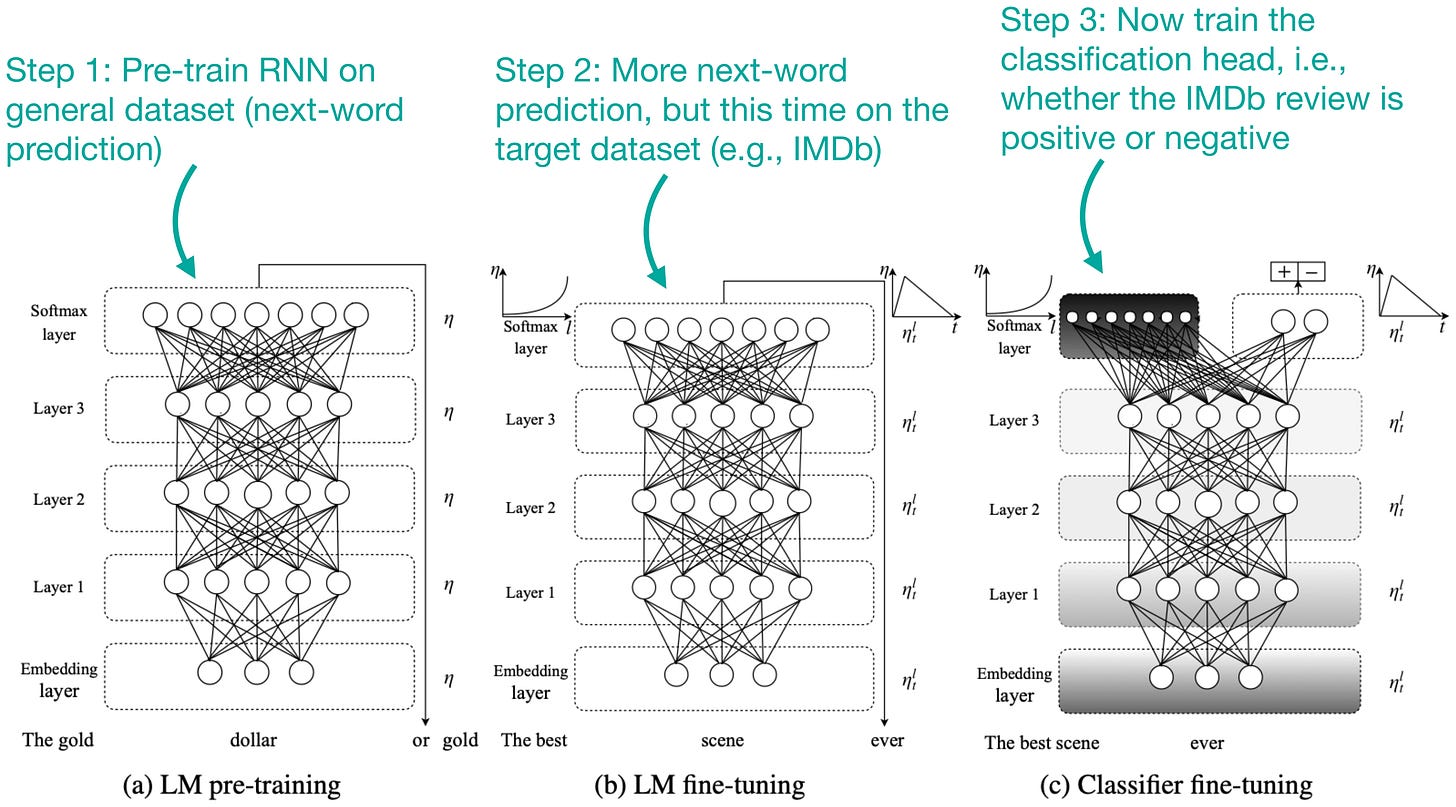 図 9:ULMFiT 論文の注釈付き図。
1.2.3 畳み込みニューラルネットワーク(CNN)
畳み込みニューラルネットワーク(CNN)は、おそらくコンピュータビジョンで知ったはずだ。だがテキストの処理にも使える。歴史的にはあまり一般的ではなかっただけで。
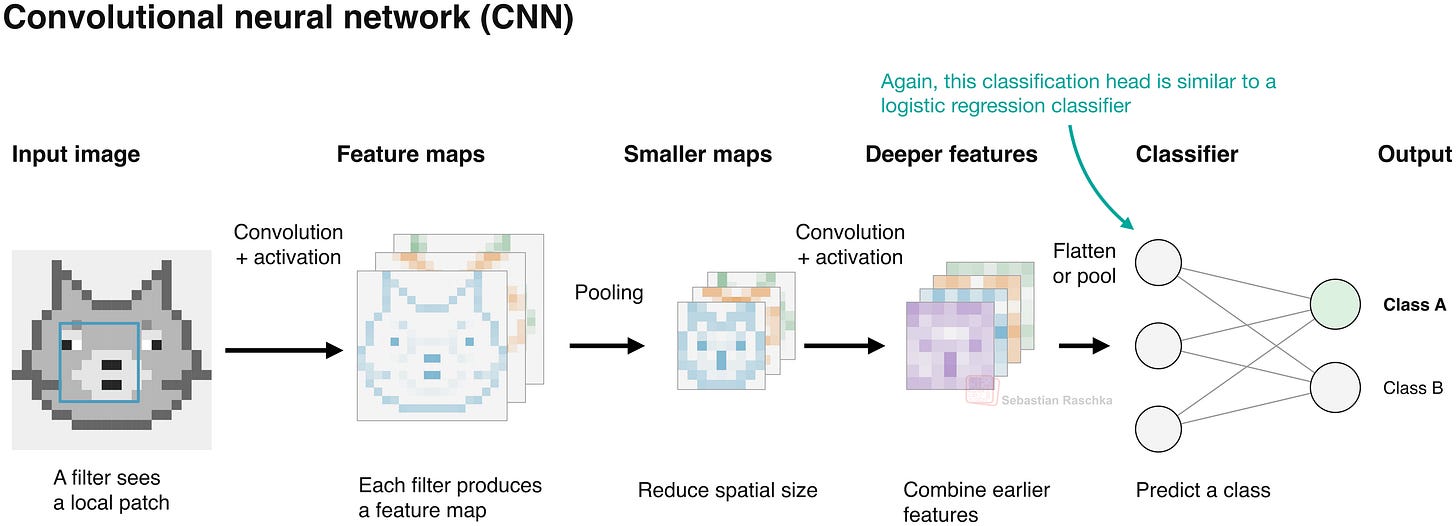 図 10:畳み込みニューラルネットワーク(CNN)で画像を分類する図。
上の画像分類の例が示すように、CNN は学習したフィルタを画像のパッチ(ウィンドウ)に適用する。同じように自然言語では、学習したフィルタを隣接する単語ベクトルのウィンドウに適用できる。
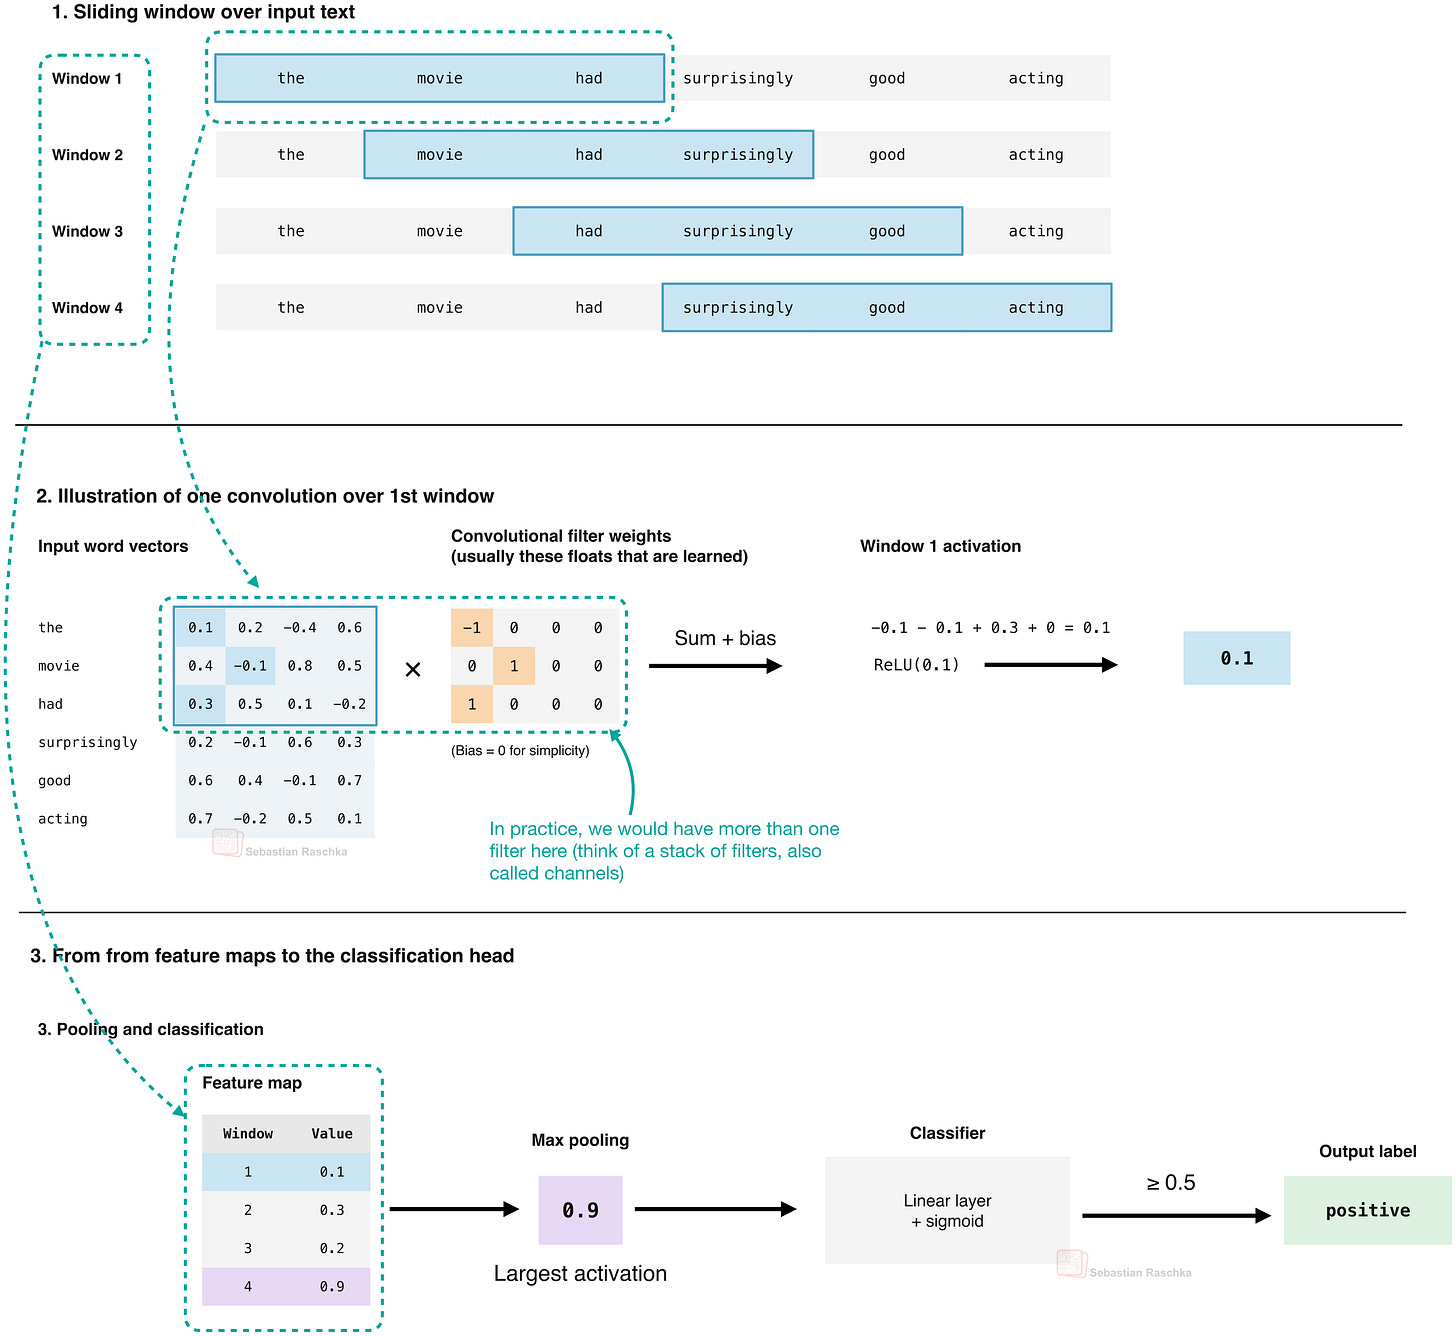 図 11:テキスト分類のための CNN を段階的に示した図。簡単のためフィルタ(チャネル)は 1 つだけ描いている。
上の図のように、ウィンドウサイズ 3 の畳み込みフィルタは、隣接する 3 単語の組それぞれに同じ重みを使う。入力上をスライドしながら、「the movie had surprisingly good acting」に沿って 1 単語ずつ移動する。こうして 4 つのウィンドウが得られる(簡単のためパディングは無視する):
- 1:「the movie had」
- 2:「movie had surprisingly」
- 3:「had surprisingly good」
- 4:「surprisingly good acting」
したがって最終層、つまり分類ヘッドの手前で、結果をフラット化するかグローバル最大プーリングしてから分類ヘッドに渡せる。フラット化は情報をすべて保持するが、生成されるベクトルの長さが入力テキストの長さで変わる。(たとえば「the movie had surprisingly good acting」が長ければ、特徴マップも長くなる。)入力長の影響を受けないようにするなら、ここではグローバル最大プーリングのほうが適している。
要するに、テキスト CNN は次のように可視化できる。
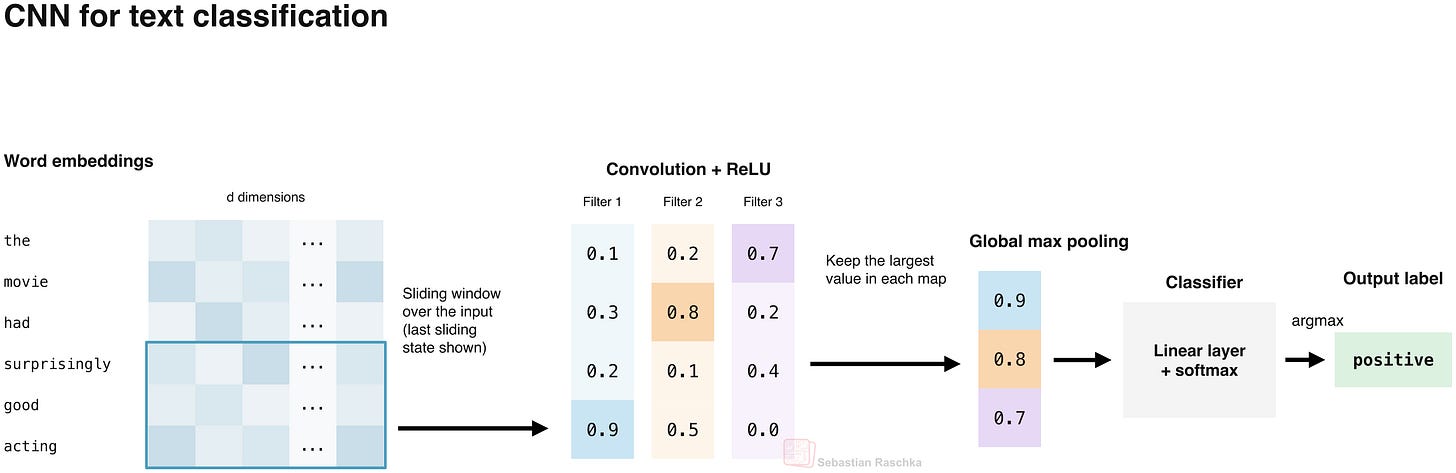 図 12:複数のフィルタ(チャネル)を持つテキスト分類 CNN。
また、各位置のフィルタ計算は並列に実行できる。これは RNN のような逐次依存を避けられるという点で良い。
簡単に比較すると、上記の IMDb データセットで、私の実験ではこの CNN の精度は約 90.07% だった(ただしこれがアーキテクチャに強く依存することには注意。たとえばコンピュータビジョンの分野で知られているように、精度の変動は非常に大きくなりうる)。(例えば、古株の AlexNet は ImageNet で top-1 精度約 62.5%、ConvNeXt V2-H は 88.9% に達する。)
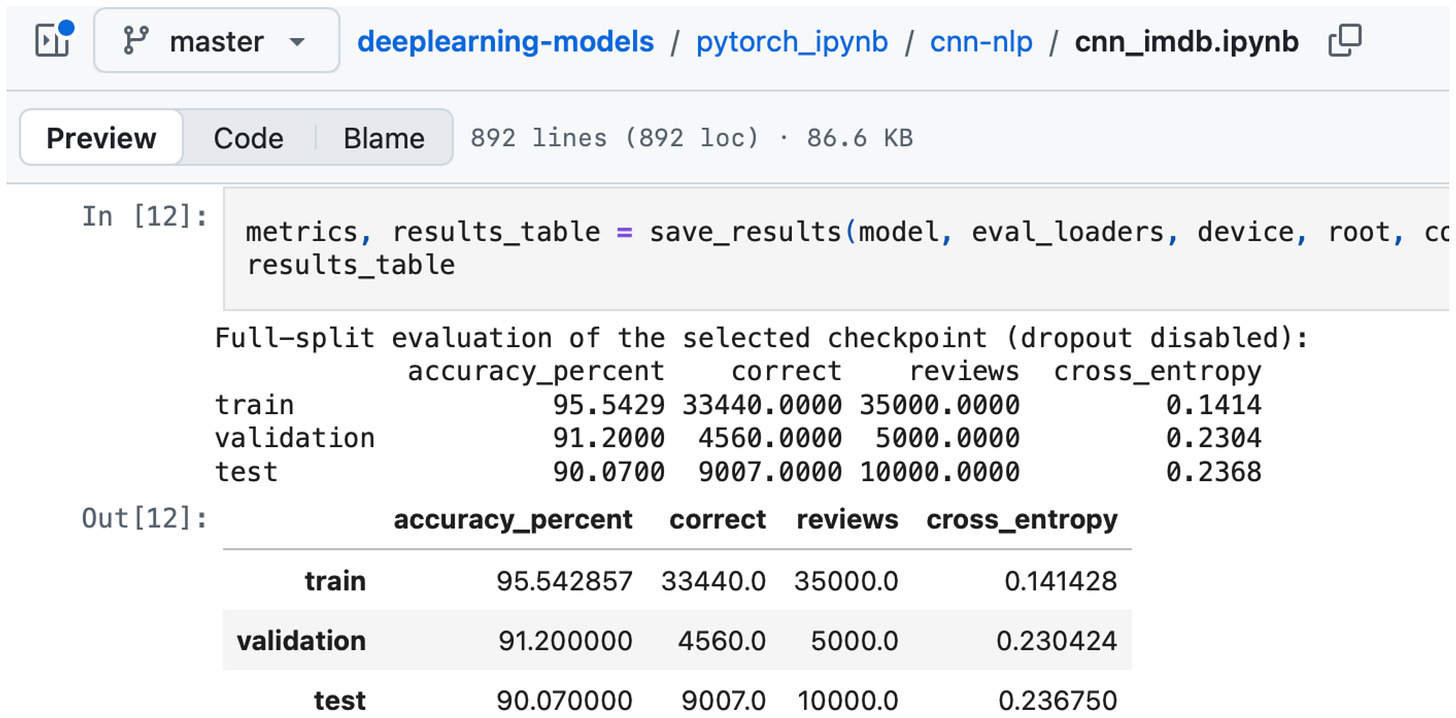 図 13:IMDb のレビュー分類用に訓練した CNN。このバランスの取れたデータセットで精度は 90.07%。ソースコードはこちら。
2. Transformer
2017 年、最初の transformer アーキテクチャが Attention Is All You Need 論文で提案された。この話題はもう語り尽くされている(私も話したし、他の人も話した)ので、分類に関係する部分だけに絞る。アテンション機構やその他のアーキテクチャの詳細に興味のある読者は、私の関連記事を参照してほしい:
要点は、最初の transformer アーキテクチャは言語翻訳のためのエンコーダ・デコーダ構造だが、テキスト分類タスクに容易に作り変えられるということだ。以下の節で具体的に示す。
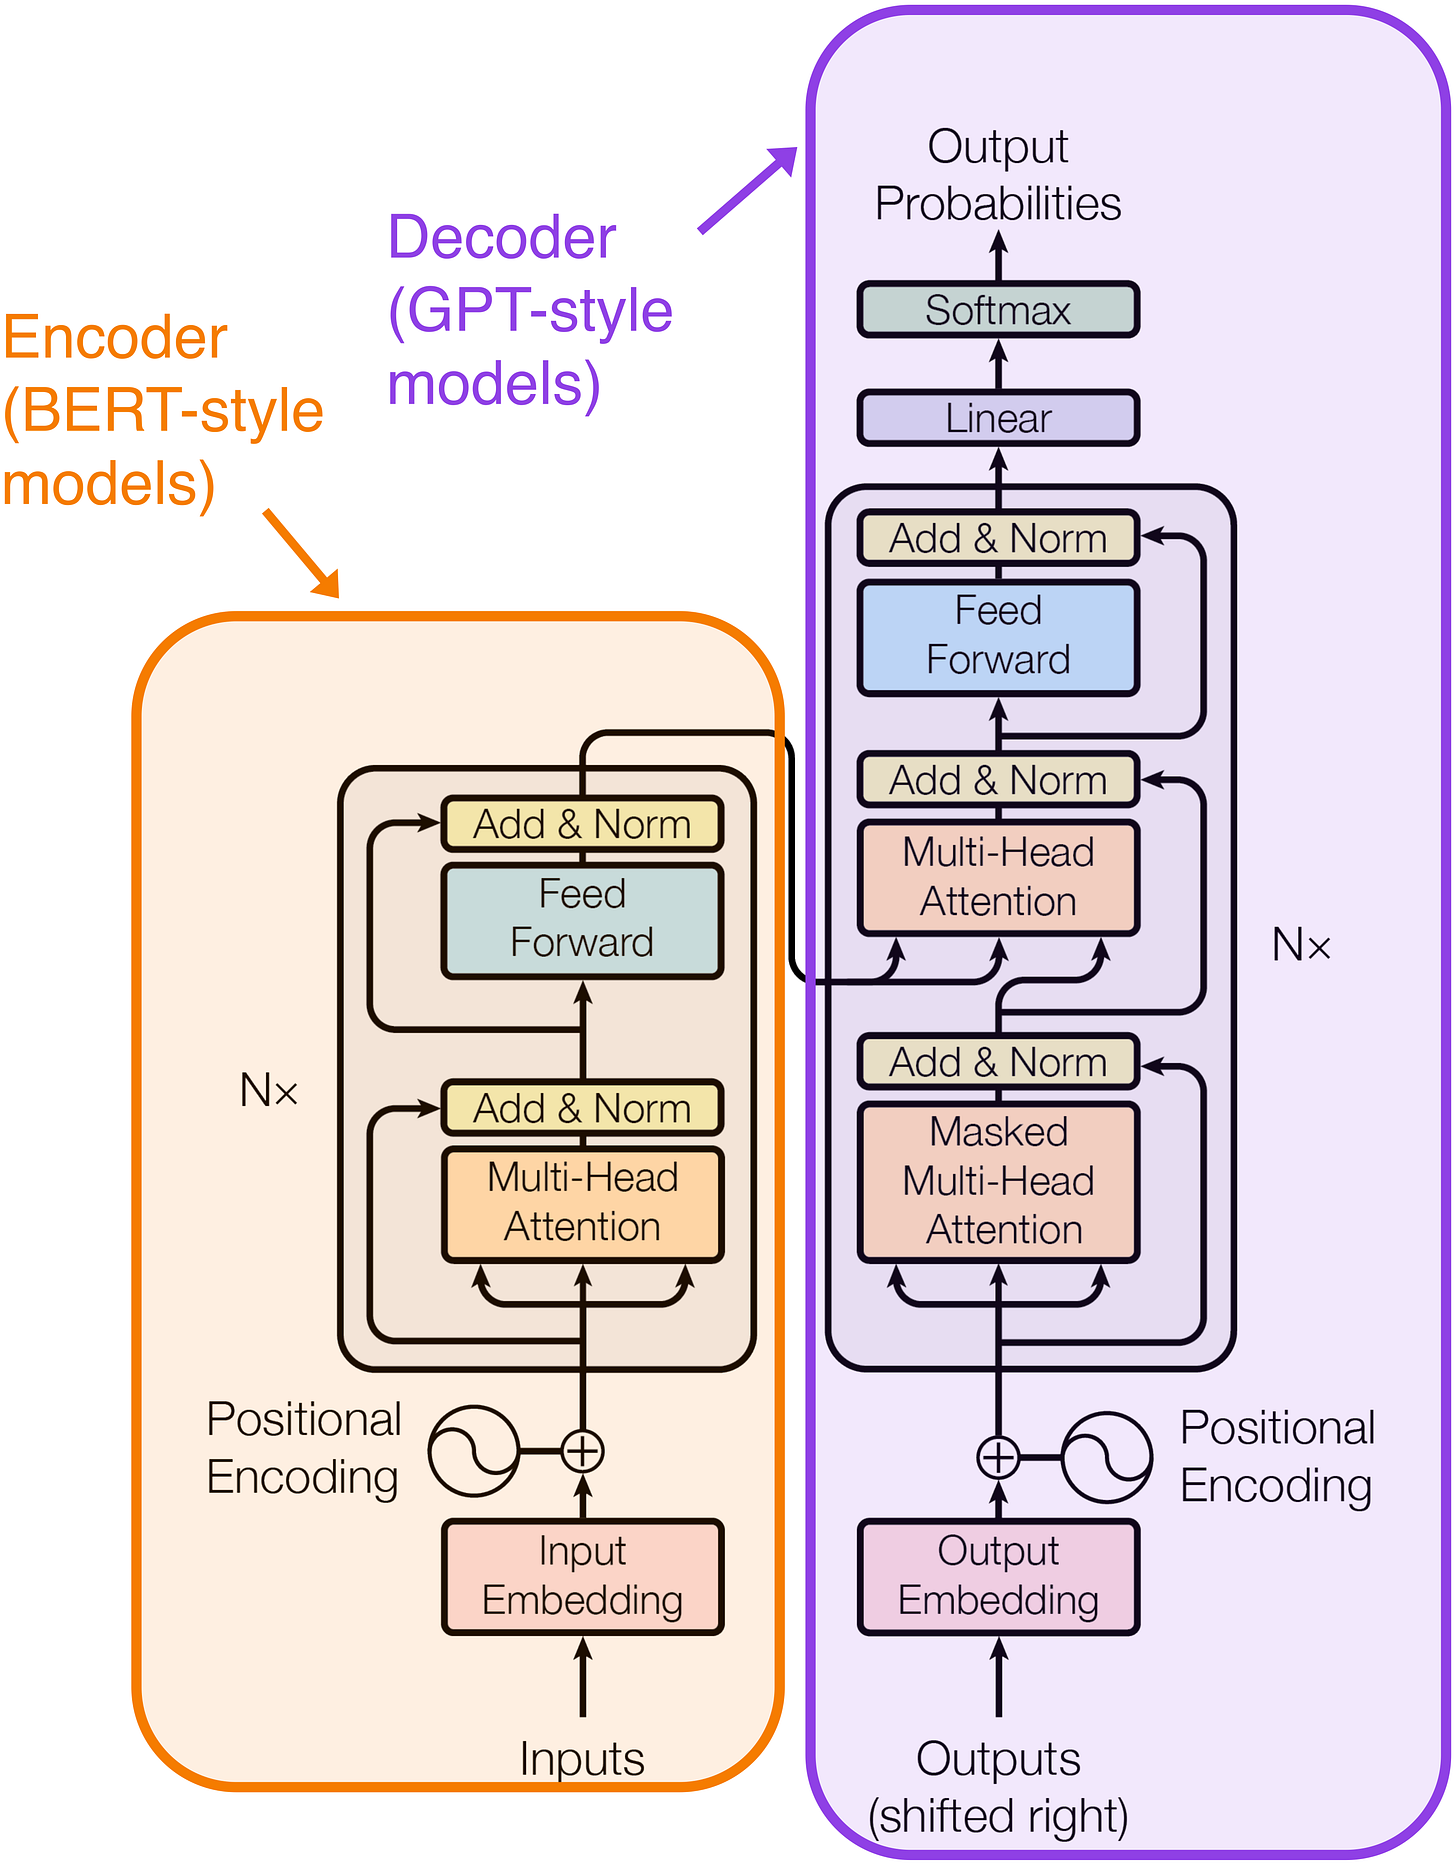
図 14:オリジナルの transformer アーキテクチャ。出典は Attention Is All You Need。
2.1 エンコーダ型言語モデル
最初の数年のことはよく覚えている。当時は基本的に 2 つの路線が対峙していた。
- BERT に代表されるエンコーダ型モデル。主に Google が開発。
- GPT に代表されるデコーダ型モデル。主に OpenAI が開発。
エンコーダ型モデルは生まれつきテキスト分類器だ。一方の GPT モデルは、創発的な能力によってゼロショット分類や少数ショット分類もできるが、本領はどちらかといえば生成タスクにある。
まずはエンコーダ型モデルから始めて、その微調整の仕方とテキスト分類への使い方を見ていく。
transformer を使ううえで、エンコーダ型でもデコーダ型でも共通する点がひとつある。大規模なテキストコーパスで事前学習済みのモデルを使うということで、ゼロショットや少数ショットの分類器として使う以外に、目的のデータセットで微調整もできる(先ほどの RNN の節で触れた ULMFiT と同じだ)。
次の図は 2018 年の BERT 論文 からの引用で、BERT のようなエンコーダ型モデルでは先頭位置に分類トークンがあり、分類タスク向けの微調整にちょうど都合がよいことがわかる。
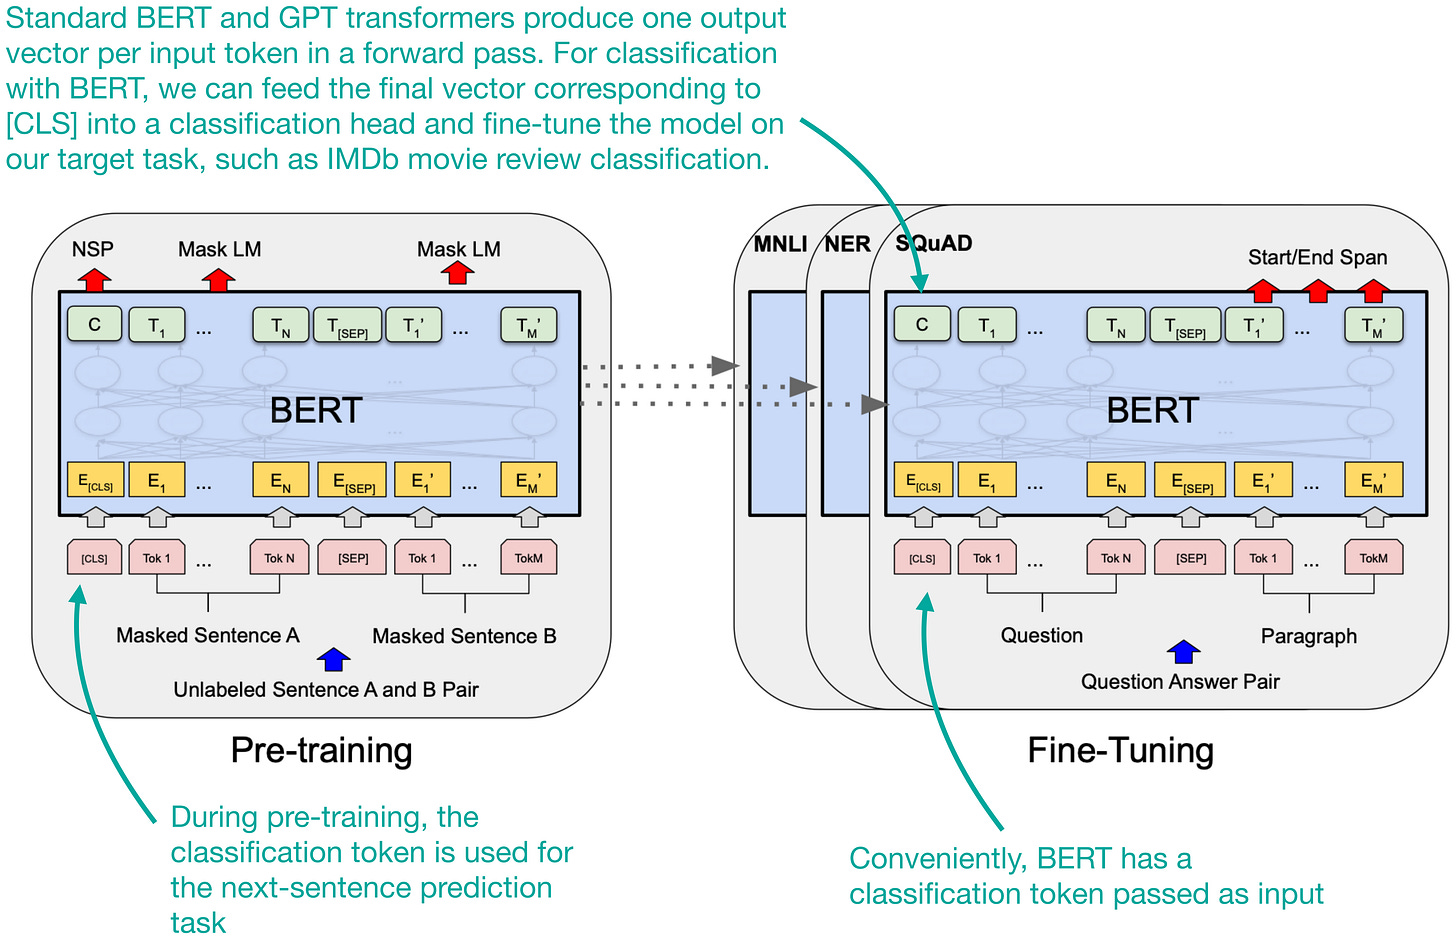
図 15:オリジナルの BERT 論文 からの注釈付き図。
BERT モデルの人気は自己回帰型の GPT 系 transformer には遠く及ばないが、それでも時折アップデートや刷新が行われている。最近の例では 2024 年の ModernBERT があり、自分が分類タスクをやるときはたいていこれを第一候補にしている。
次の図のとおり、IMDb の映画レビューでは ModernBERT はわずかな微調整で約 95% の精度に達する。
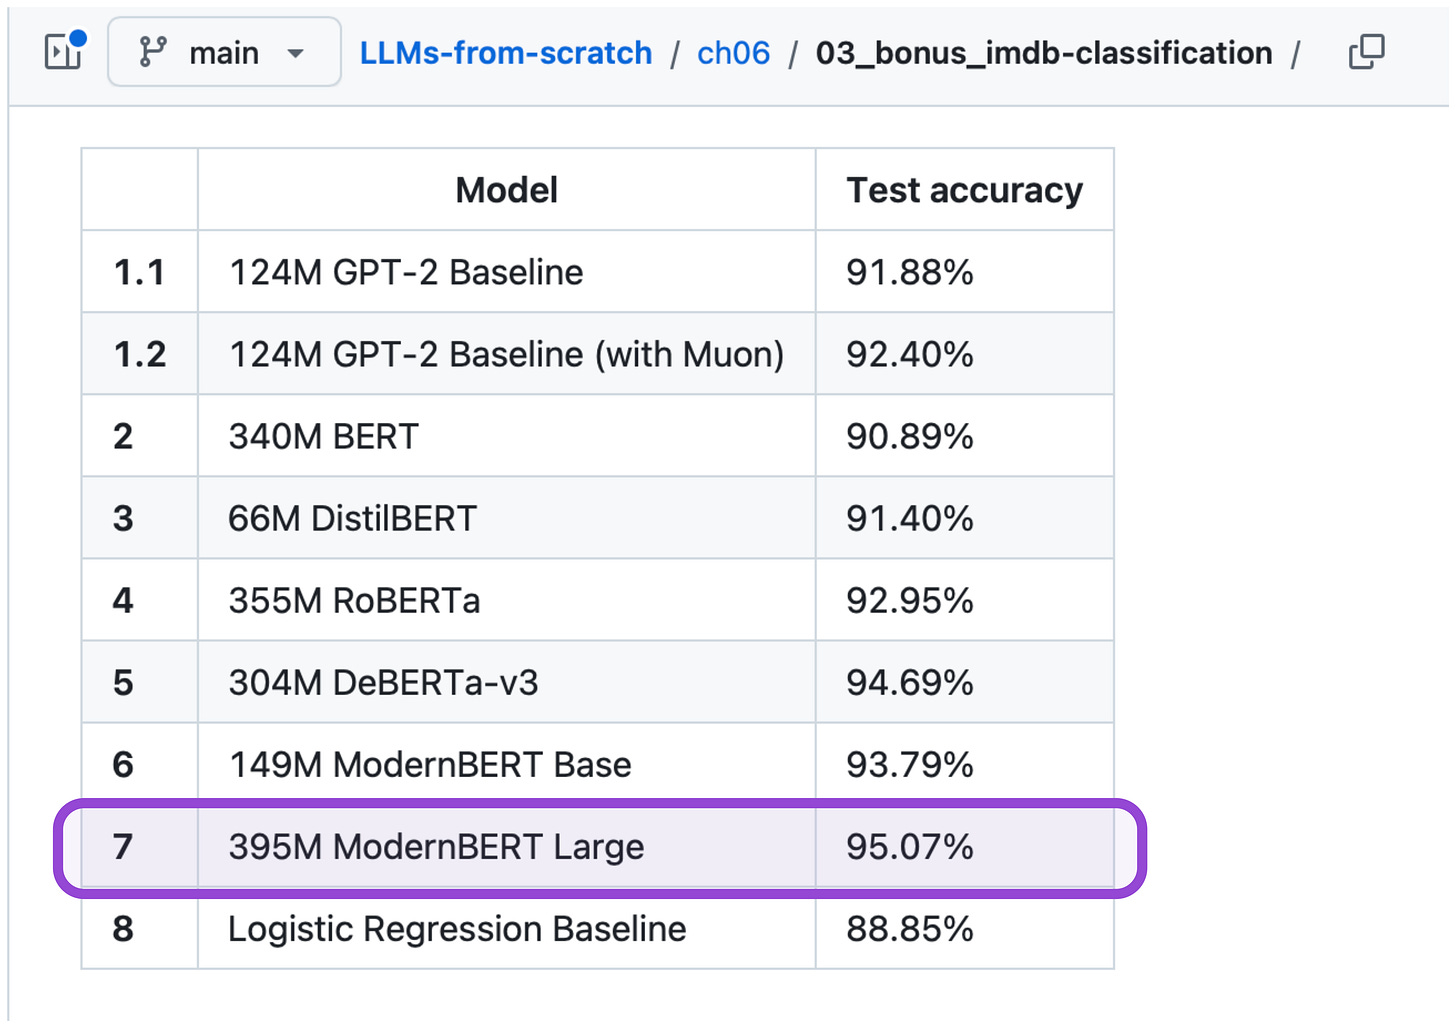
図 16:さまざまな LLM を微調整して IMDb の映画レビューを分類した結果。ソースコードはこちら。(ハイパーパラメータはほとんど調整しておらず、もう少し手をかければおそらくあと 1〜2% は伸びる。ただ、ここで示したいのは、それほど手間をかけずともかなり良い結果が得られるという点でもある。)
2.2 デコーダ型 LLM
GPT のような LLM はデコーダ型の自己回帰 transformer で、テキストやコードを生成する際に注目の的になる(かけ言葉のつもりはない)。
とはいえ、Build A Large Language Model (From Scratch) の第 6 章で書いたように、微調整の入門として(指示微調整の前に)テキスト分類用に作り替えることもできる。
もちろん、次のスクリーンショットのように LLM に直接プロンプトを書く手もある。
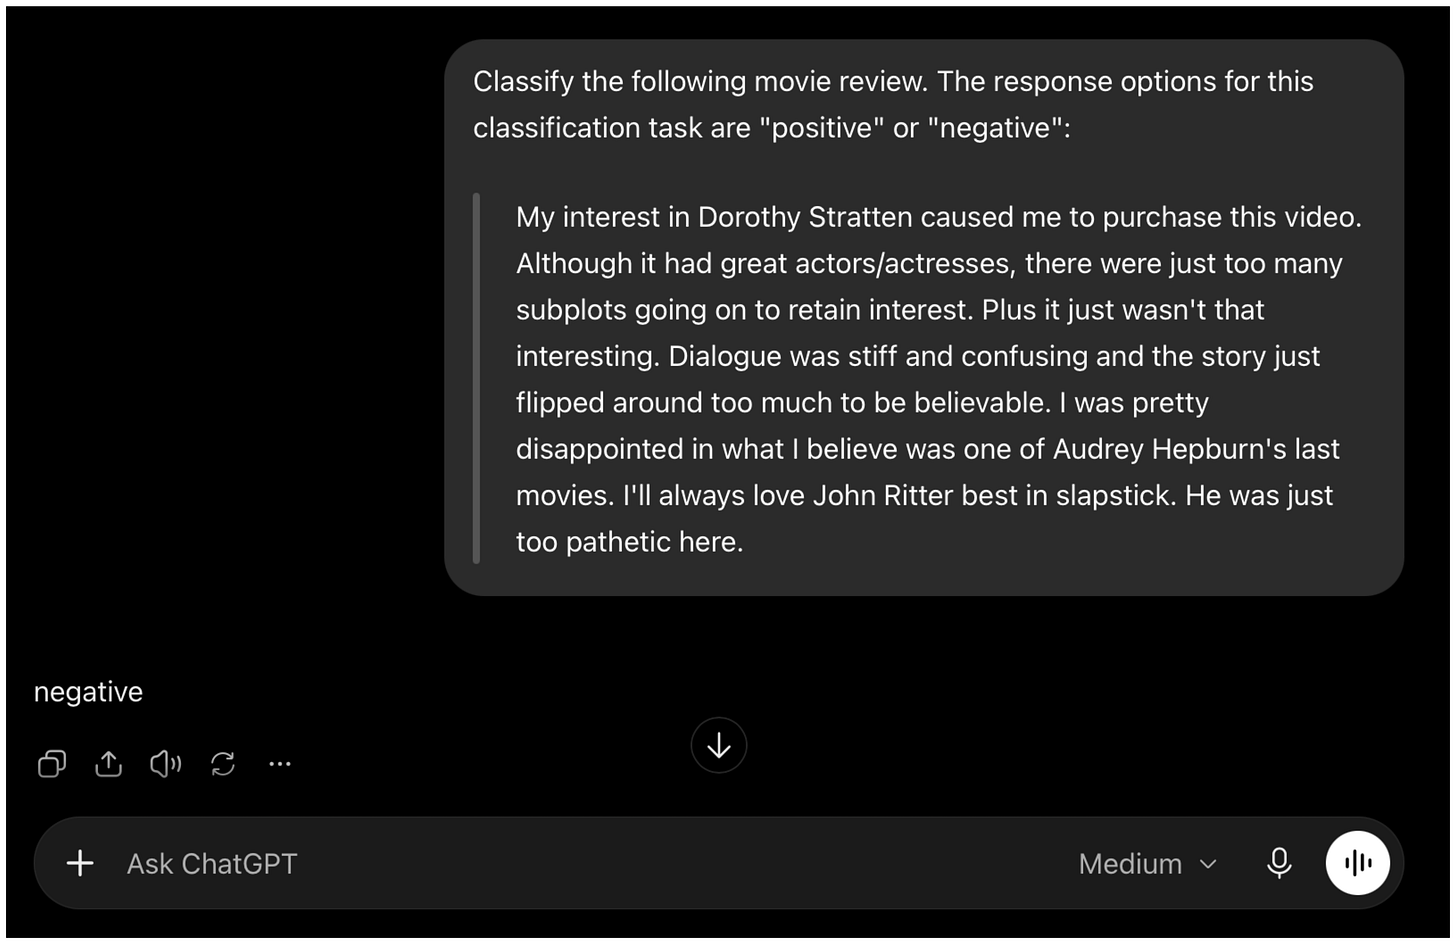
図 17:プロンプトで LLM にレビューを 1 件分類させる。
だが、構造化された出力が欲しく、対象領域がはっきりしているなら、この方法は脆すぎるし効率も悪い。
出力層をもっと簡素な分類ヘッドに差し替えることもできる。次の図のとおりだ。
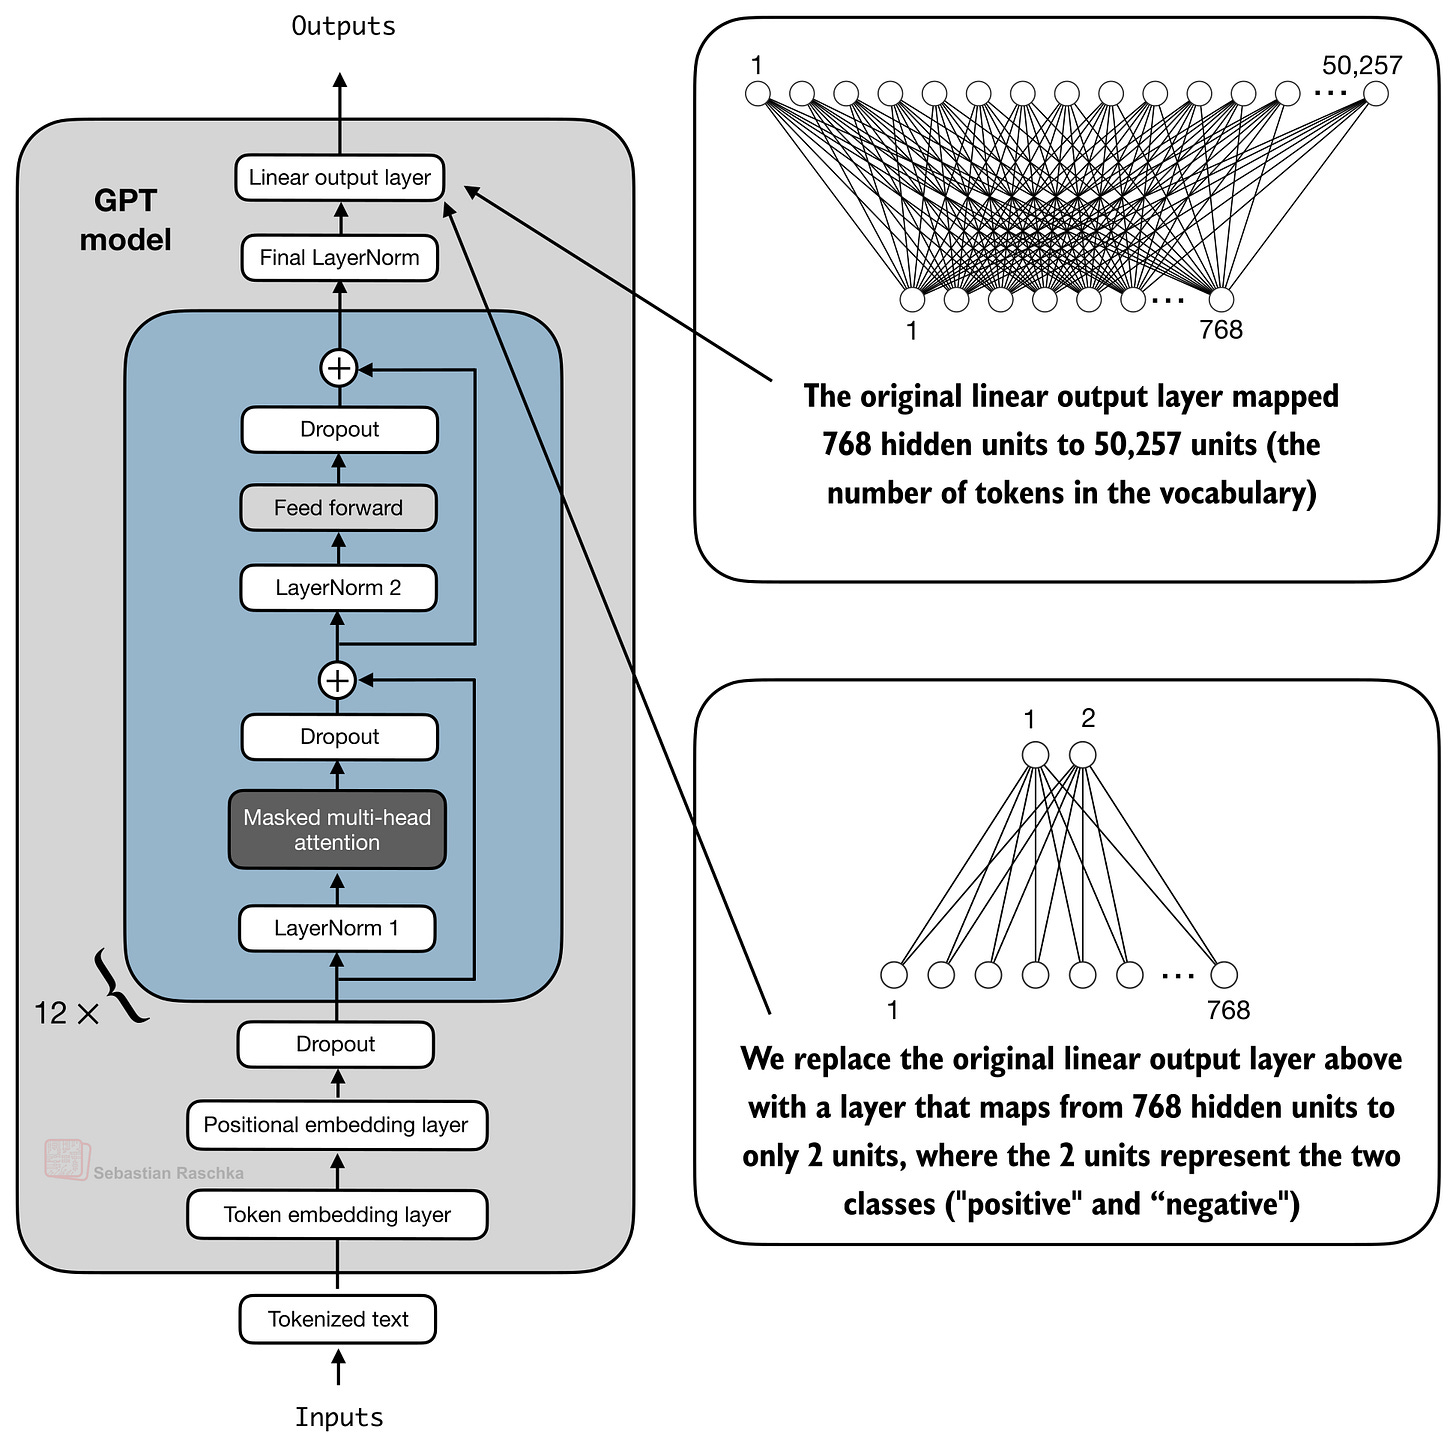
図 18:GPT 系モデルの出力層をより簡素な分類ヘッドに差し替える。
微調整にはいくつか注意点がある。たとえば自己回帰のアテンションマスクがあるため、分類トークンが系列中の他のすべてのトークンの情報を確実に受け取れるよう、微調整の設計には気をつけなければならない。
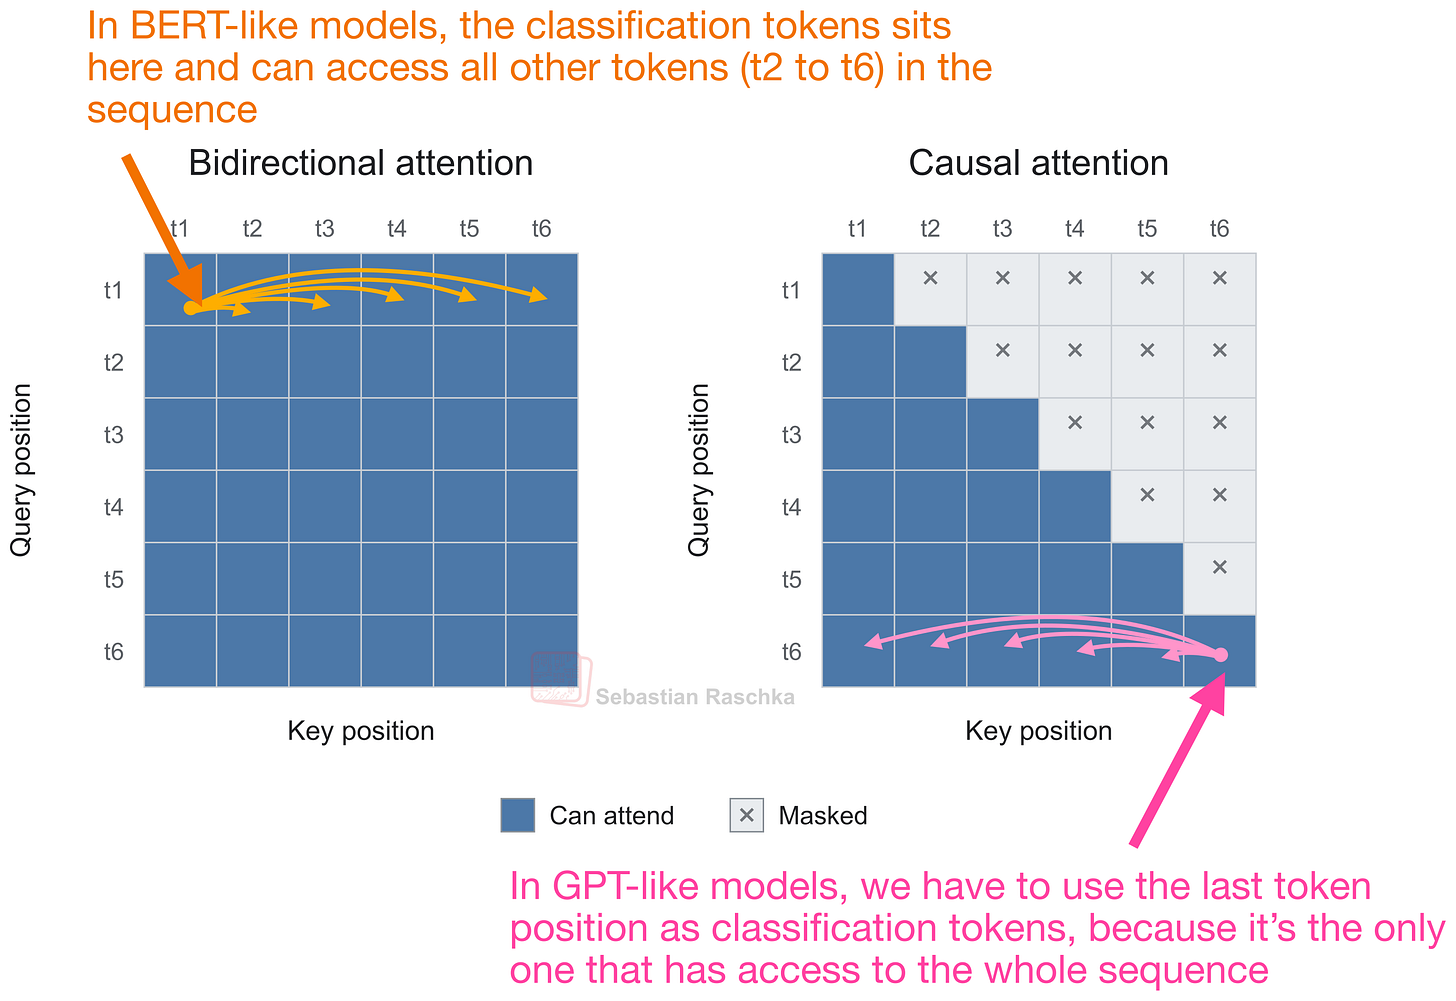
図 19:BERT と GPT のアテンションマスク。
技術的な詳細に興味があれば、最近書いた端から端までを扱う記事 Building an AI Text Detector From Scratch を読んでほしい。
全体として、BERT 系の変種と比べて GPT 系 LLM を使う利点は、選べる現代的なオープンウェイトのアーキテクチャが非常に多いことだ。小さいところでは Qwen 3 0.6B から、最新の Kimi、GLM、DeepSeek まで、好みで選べる。(もちろん効率の面からいえば、パラメータが 1B を超えるようなモデルを分類に使うのは牛刀をもって鶏を割くようなものだが——実際にできるのは確かだ。)
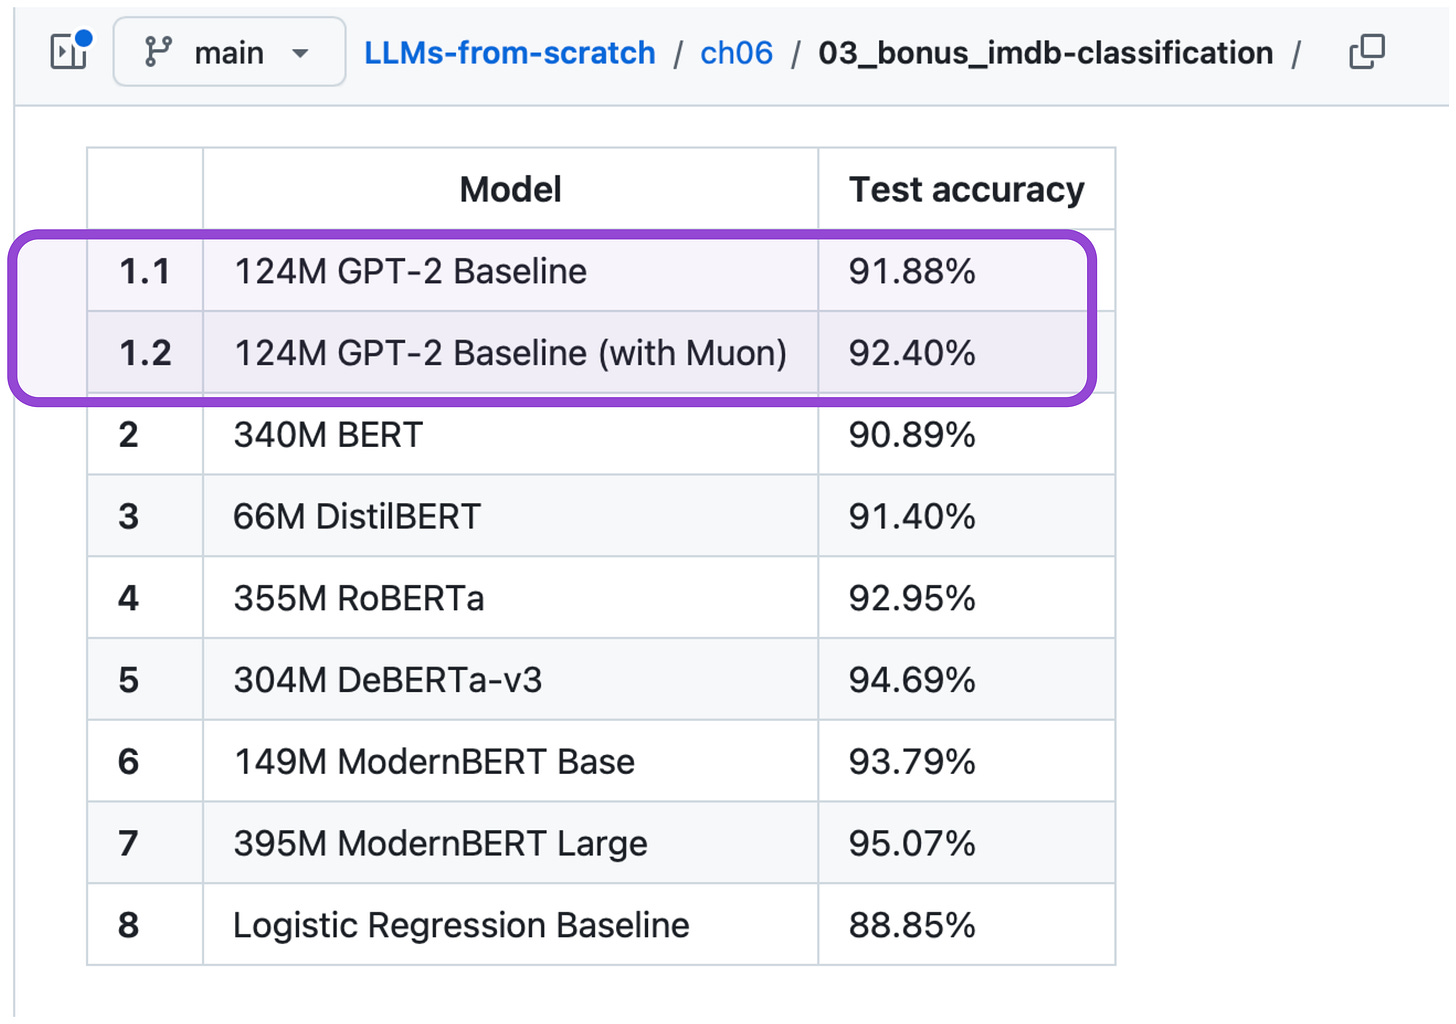
図 20:上記の IMDb 映画レビューのデータセットでは、比較的小さい GPT-2 124M でも約 92% の精度に達する。より大きく新しい LLM(たとえば最近のある Qwen3 の変種)なら、おそらくもっと良い成績を出すだろう。
2.3 エンコーダ・デコーダ型アーキテクチャ
オリジナルの transformer アーキテクチャ(エンコーダ・デコーダ)は後に 2 つのパラダイムに分裂した。BERT のようなエンコーダ型モデルと、GPT のようなデコーダ型 LLM だ。だが同時に、エンコーダ・デコーダ型の変種を使う試みもあり、その最新のひとつ(いくらか意外なことに)が DeepSeek V4.1 Flash だ。(ただしこの例では、T5 のような双方向エンコーダではなく因果エンコーダを使っている。)
分類用のエンコーダ・デコーダアーキテクチャに限れば、最も名の知られた候補はおそらく Google が 2019 年に発表した T5(Text-to-Text Transfer Transformer)だろう。
アーキテクチャの面では、T5 と原初の transformer の違いは、アーキテクチャ自体の更新(後述)だけでなく、訓練方法の変更にもある。原初の transformer は機械翻訳のために教師あり学習で訓練された。T5 はラベルなしテキストで事前学習し、span corruption を採用する。エンコーダがいくつかの断片が欠けたテキストを受け取り、デコーダがその欠けた断片を生成する。
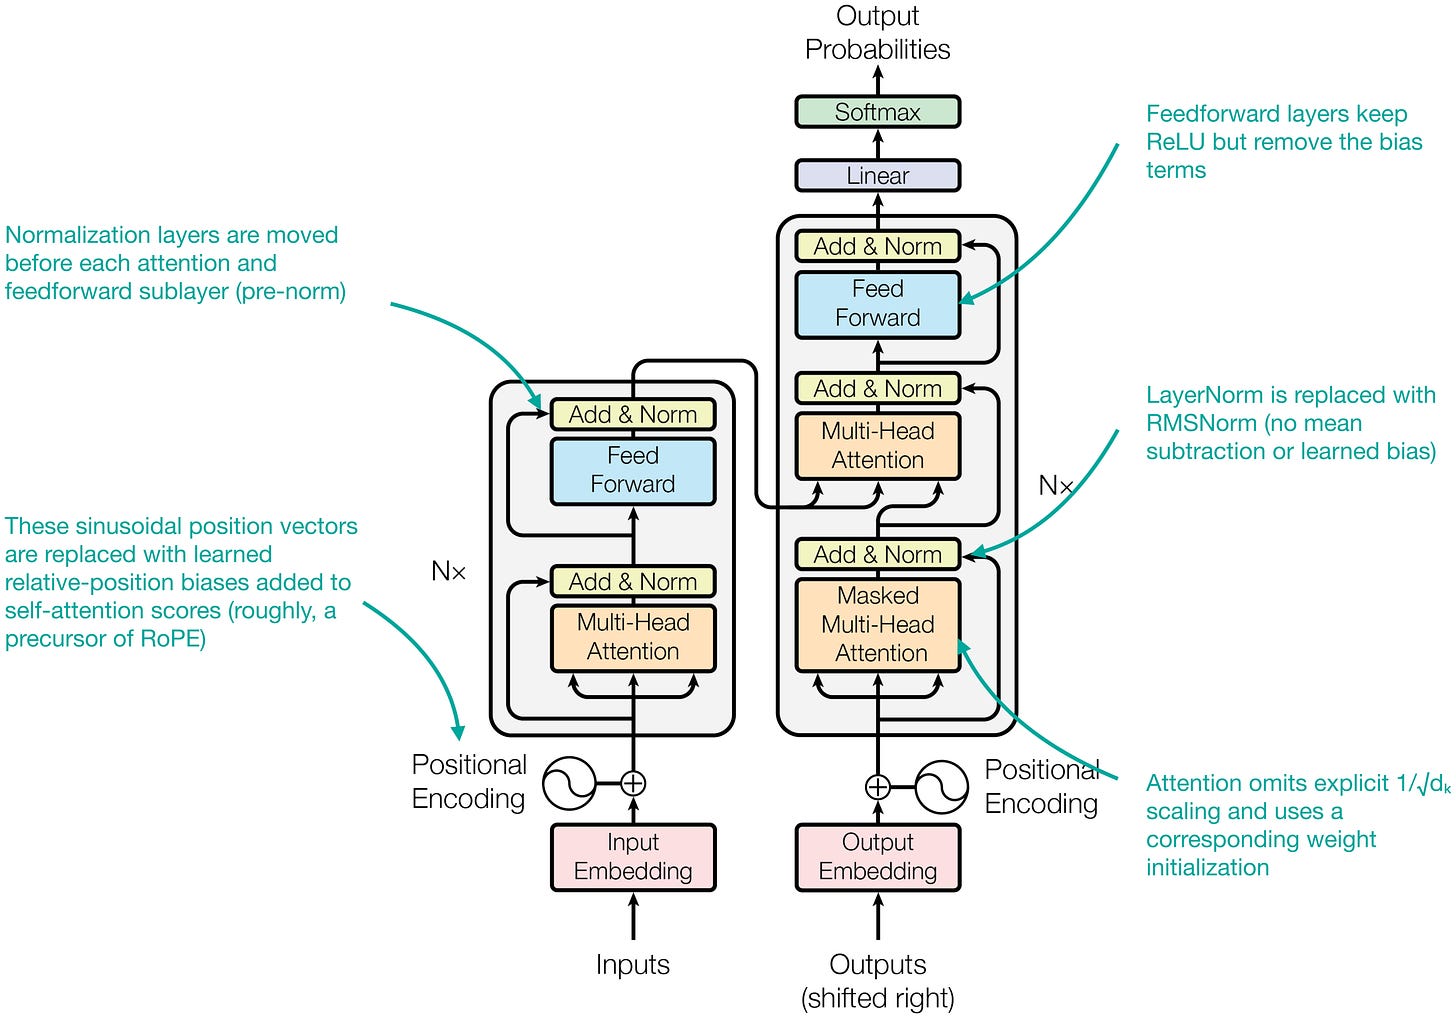
図 21:T5 が原初の transformer アーキテクチャに加えた変更。(アーキテクチャ図は Attention Is All You Need より。)
ここで、上で RNN、CNN、その他の transformer 手法に対して行ったのと同じように、T5 に分類ヘッドを付けて使うことができる。
それとは別に、(訓練によって)デコーダがクラスラベルの予測を直接出力するようにもできる(たとえば IMDb 映画レビューデータセットの "positive" や "negative")。ふつうの LLM と同じやり方だ。この方法を text-to-text 分類と呼ぶことにしよう。
GPT 系の LLM は大量のテキストで訓練されているが、たいていはそのままでも text-to-text 分類をかなりうまくこなす。これはすでに示した(便宜上、もう一度あの図を載せておく)。
図 22:GPT モデルによる text-to-text 分類。
ただし T5 の場合、より一般的なのはデコーダをさらに微調整し、特定の対象領域でこの種のタスクの性能を上げるやり方だ。
T5 ではどちらの方法も使える。まとめると次のとおり。
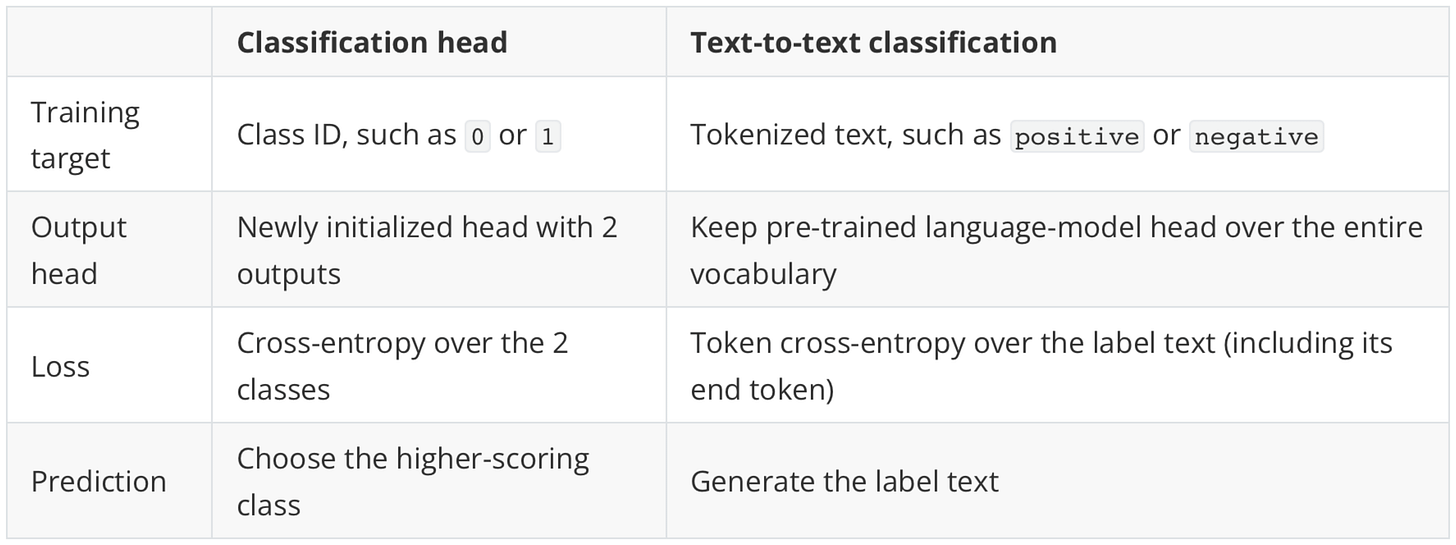
図 23:分類ヘッドと text-to-text の比較。
3. Jev 概観
ここまでで、テキスト分類には多くのやり方があることを見てきた。ロジスティック回帰やナイーブベイズ+bag-of-words 表現といった従来の手法から、GPT-6 のような最新のフロンティア LLM にプロンプトを書く方法、任意のオープンウェイト LLM に分類ヘッドを付けて微調整する方法(あるいは text-to-text 分類)まで。
当初、私はこれを「ただの分類器じゃないか」と(危うく)軽く見てしまった。自然言語入力の分類タスク用なら、こうしたものはよく自分で書いている(たとえば最近公開した AI Detector の記事がその一例だ)。
3.1 Jev と既存の text-to-text 分類
だが話を進める前に、Jev について簡単に紹介しておこう。Jev は TypeSafe AI が発表した新しいモデルで、数週間前にステルスを解除してかなりの注目を集めた(最初は少し奇妙に見えた。分類器そっくりの見た目だったからだ)。
Jev はプロプライエタリなモデル(ただし発表直後に高速なオープンソースの再現実装が大量に出てきた。これについては後述する)で、利用コストは比較的安く、意思決定能力では GPT-5.6 Luna に匹敵すると謳いながら、速度とコストは数桁良い。
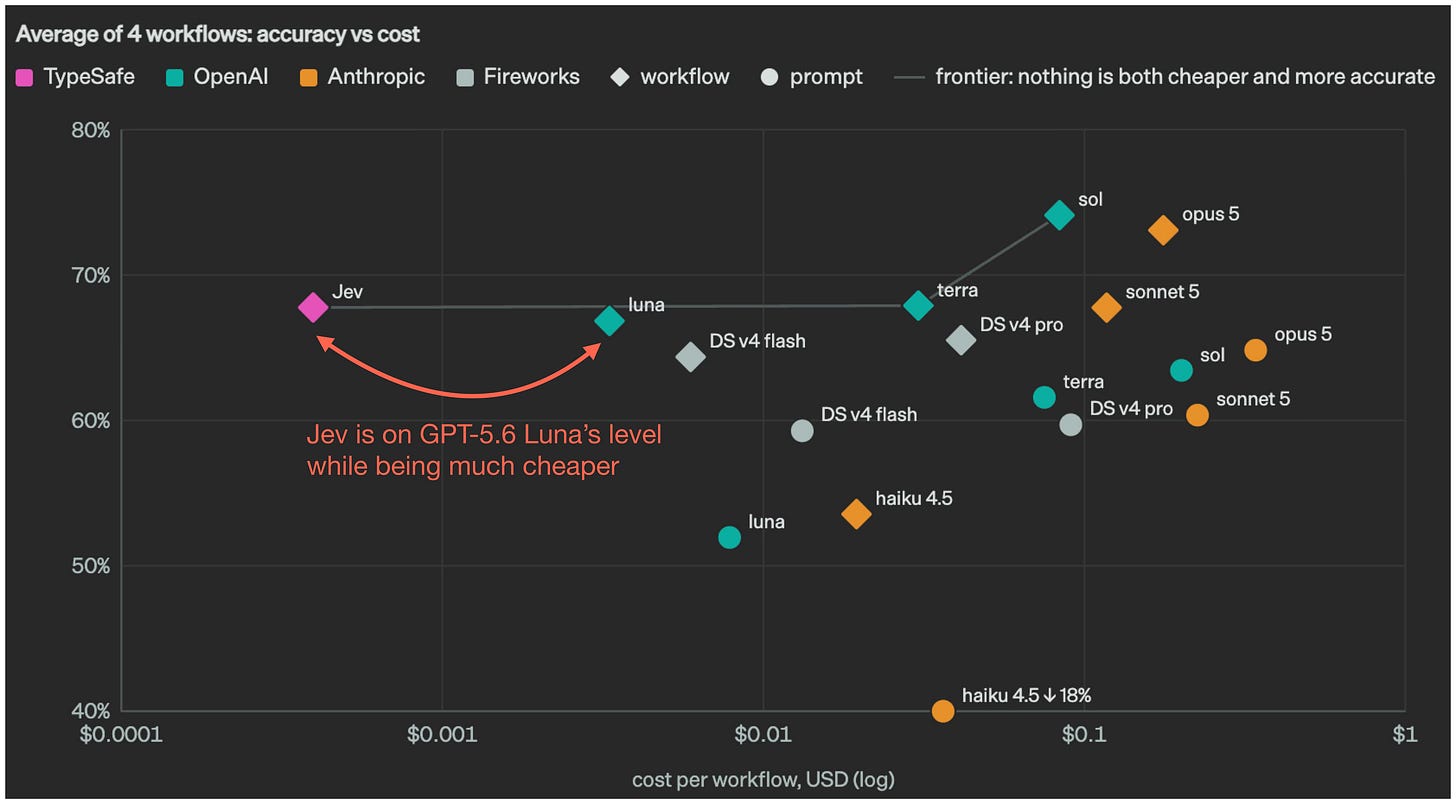
図 24:TypeSafe AI ブログよりのベンチマーク。
ここでの GPT-Luna は、先に論じた text-to-text 分類の手法と理解してよい。
ではなぜこれほど話題なのか。理由の一つは API が使いやすく、各種タスクでよく機能し、自分で微調整する必要がないからだと思う。
たとえば、これでカスタマーサポートのチケットやメールを分類できる(応答時間を示すために動画版も撮った)。
あるいは、同じモデルにリアルタイムでテトリスをプレイさせることもできる(ここでは Choice API を使っている)。
技術的な詳細に入る前に、おそらく最も簡潔な説明はこうだ。2022 年の ChatGPT が話題になったのは、あらゆるテキストを生成できる汎用チャットモデルだったからだ。同じように、技術コミュニティが Jev に興奮している理由の一つは、これが分類における ChatGPT の瞬間と言えるものだからだ。タスクごとに専用の分類器を微調整しなくても、さまざまなテキスト入力を低コストで分類できる。
(本稿執筆時点で、そのアーキテクチャと具体的な訓練アルゴリズムについて外部が知っていることはほとんどない。創業者の一人が「Reinforcement Learning for Calibrated Decisions」で訓練したと述べていることだけが手がかりで、これについては後で詳しく触れる。)
3.2 Jev API
ここ数年、私たちはより大きく、より強く、より高価な GPT 系 LLM をあらゆる問題にぶつけることに慣れてきた。だが的を絞った意思決定や分類タスクなら、Jev のように安くて速いやり方は多くの人にとって新鮮かもしれない。とくに一度きりのタスクでは、訓練データを集めて専用の ModernBERT を微調整するのは面倒すぎる。Luna 系のモデルをそのまま放り込めば済む。
汎用性(つまりそのまま使えて、対象領域が変わってもよく機能する)で歓迎されているのに加え、Jev の API もかなり使いやすい。ターミナルから curl で呼び出せるし、Python API からも呼び出せる。
要するに、API は大きく3種類ある。まず Choice API から。多クラス分類に向く。
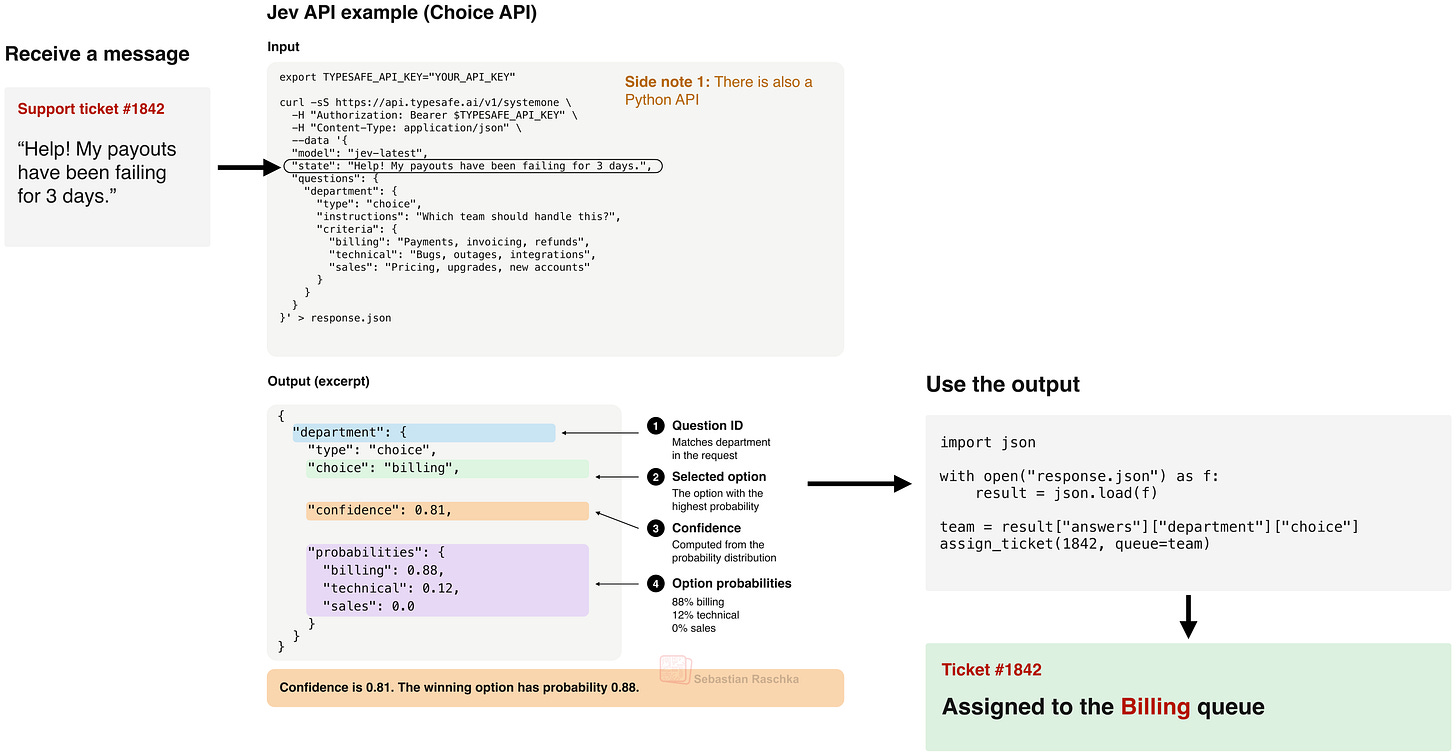
図 25:Jev の Choice API。多クラス分類用。
次は Noul API。ある問いに対して「はい」の確率を返す、よりシンプルなものだ。
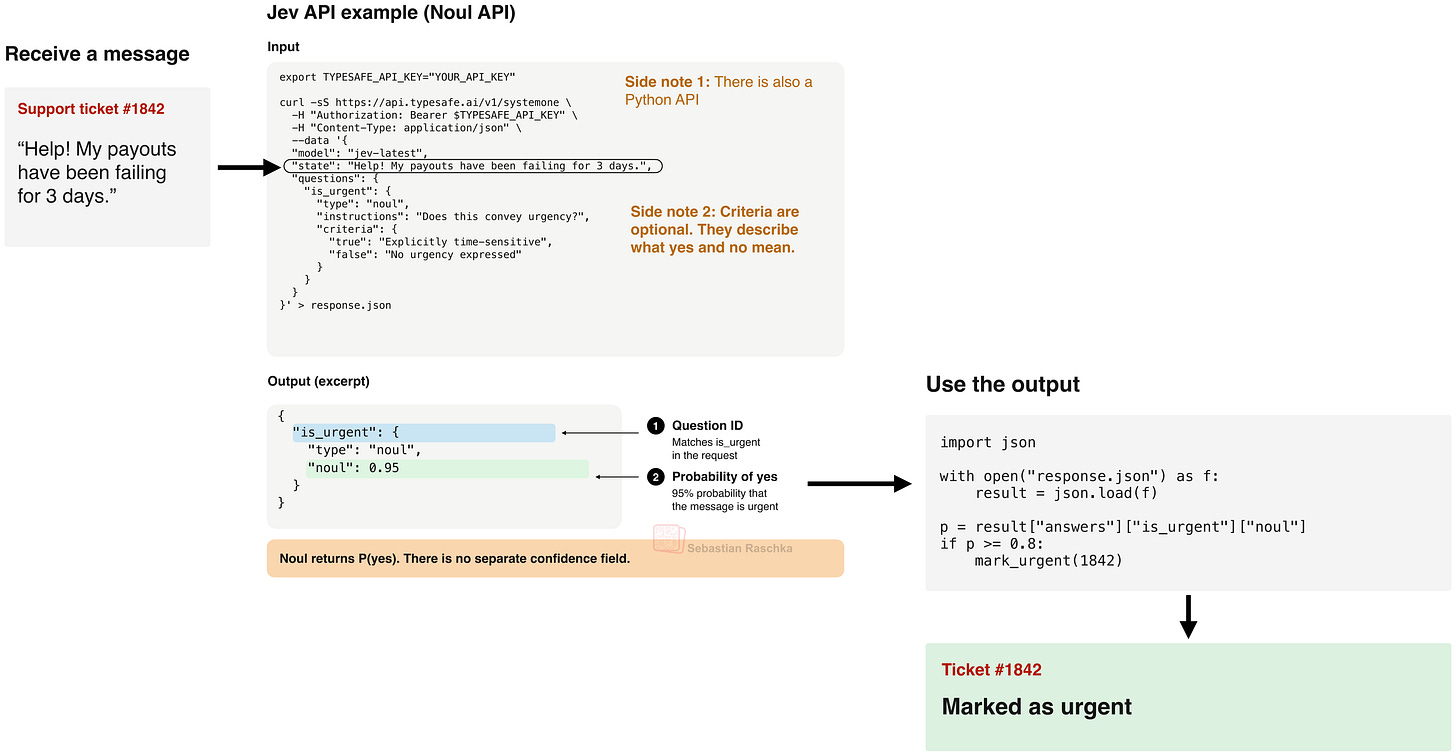
図 26:Jev の Noul API。二値分類、または複数ラベル分類(複数の Noul の問いを組み合わせる)用。
最後は Score API。評価基準の段階に応じて点数(下の例では 0、1、2)を返す。
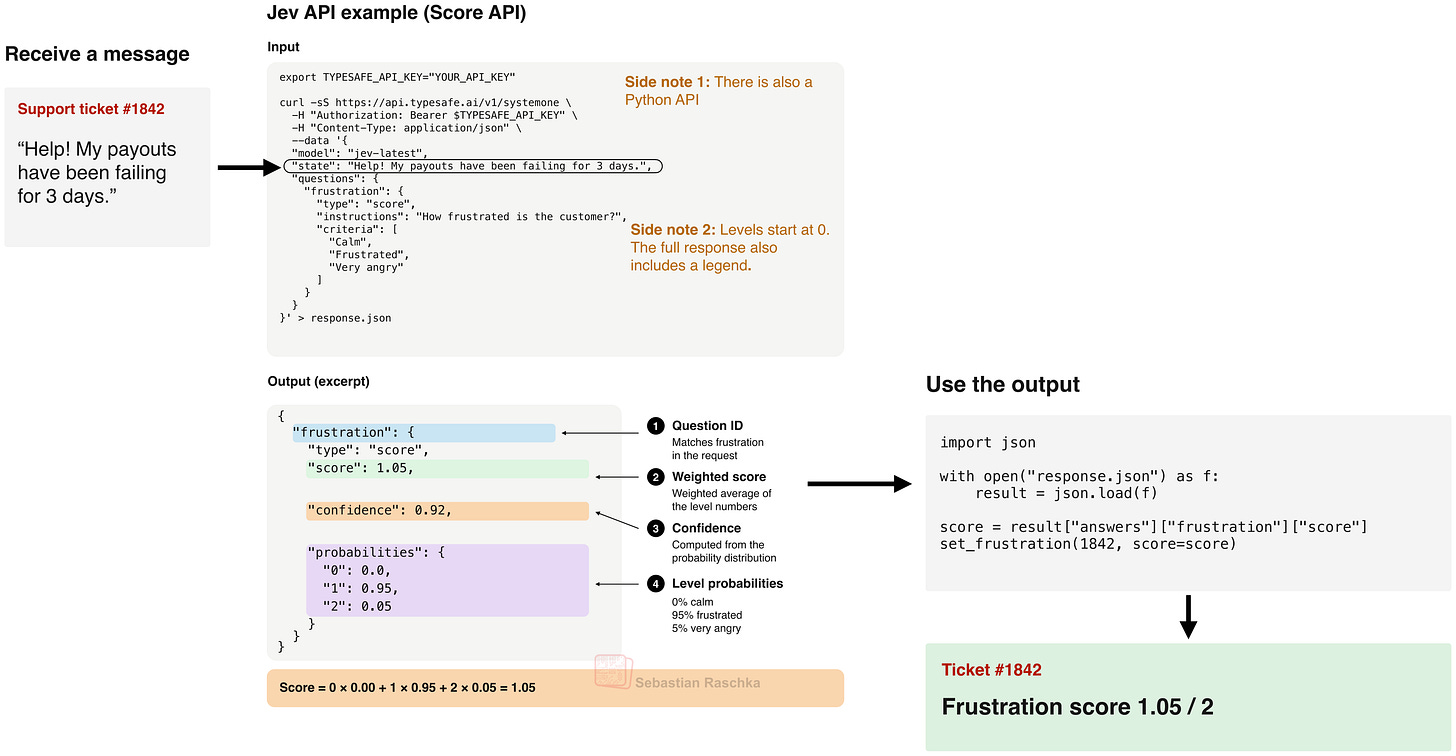
図 27:Jev の Score API。順序分類用。
各 API とその用途をまとめると次のようになる。
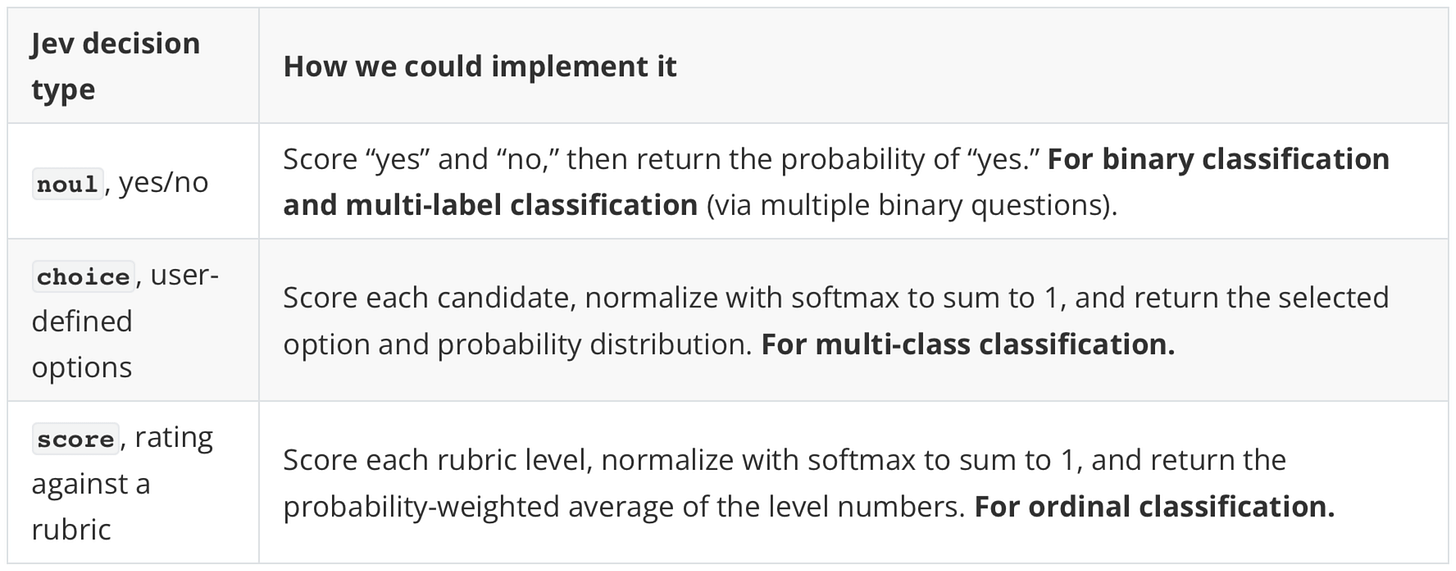
図 28:Jev API 早見表。
3.3 Jev で IMDb を分類する
これらの API を具体的にイメージするため、また先ほど触れた IMDb データセットで Jev がどう機能するかを確かめるため、Choice API か Noul API を走らせてみよう。
まず Choice API。各レビューの形式は次のとおり:
export TYPESAFE_API_KEY="YOUR_API_KEY"

curl -sS https://api.typesafe.ai/v1/systemone \
 -H "Authorization: Bearer $TYPESAFE_API_KEY" \
 -H "Content-Type: application/json" \
 -d '{
 "model": "jev-1.13.0",
 "state": "The acting was excellent and the story kept me engaged throughout. I would happily watch this movie again.",
 "questions": {
 "sentiment": {
 "type": "choice",
 "instructions": "What is the overall sentiment of this movie review?",
 "criteria": {
 "negative": "An overall unfavorable opinion of the movie",
 "positive": "An overall favorable opinion of the movie"
 }
 }
 }
 }'
二値分類(ここがまさにそう)や多クラス分類を明示的なラベルで扱うなら、Choice API は便利だ。
実際の戻り値はこんな感じになる:
{
 "model": "jev-1.13.0",
 "answers": {
 "sentiment": {
 "type": "choice",
 "choice": "positive",
 "confidence": 1.0,
 "probabilities": {
 "negative": 0.0,
 "positive": 1.0
 }
 }
 },
 "usage": {
 "input_tokens": 342,
 "output_tokens": 32
 }
}
"choice": "positive" ラベルに加えて、この予測の confidence と、各クラスの確率が得られる。(confidence フィールドが表すのは確率分布の集中度であり、勝ったクラスに割り当てられた確率とは別物だ。)confidence は実運用で役に立つ。Jev の売りのひとつは、ドキュメントによればこれらの確率がよく校正されていることだ(校正については後で詳しく触れる)。
同じレビューは Noul API でも分類できる。同じ映画レビュー分類のコンテキストを使い、形式は次のとおり:
curl -sS https://api.typesafe.ai/v1/systemone \
 -H "Authorization: Bearer $TYPESAFE_API_KEY" \
 -H "Content-Type: application/json" \
 -d '{
 "model": "jev-1.13.0",
 "state": "The acting was excellent and the story kept me engaged throughout. I would happily watch this movie again.",
 "questions": {
 "is_positive": {
 "type": "noul",
 "instructions": "Does this review express an overall positive opinion of the movie?",
 "criteria": {
 "true": "An overall favorable opinion of the movie",
 "false": "An overall unfavorable opinion of the movie"
 }
 }
 }
 }'
Noul API で得られる答えは:
{
 "model": "jev-1.13.0",
 "answers": {
 "is_positive": {
 "type": "noul",
 "noul": 0.98
 }
 },
 "usage": {
 "input_tokens": 328,
 "output_tokens": 21
 }
}
(面白いことに、同じテキストでポジティブクラスに 1.0 ではなく 0.98 が返っている。)
各クラスについて個別に問いを立てれば、Noul API を多クラス分類にも使える。たとえば:
- 「この記事は金融について書かれていますか?」
- 「この記事は政治について書かれていますか?」
- 「この記事はテクノロジーについて書かれていますか?」
ここでは各問いが(互いに独立に)1つの確率を返し、それらが合計 1 になる必要はない。つまり、多クラス分類で各テキストに複数のラベルが付きうるなら Noul が向いており、分類の答えが最終的に1つなら Choice のほうが扱いやすい。
では、テストセットの映画レビュー 25,000 件で Jev を Choice と Noul それぞれで走らせた結果がこちら:
- Choice: 正解率 96.47%(24,117 件正解)
- 総実行時間:22 分 24 秒
- 入力トークン 15,456,663、総コスト $0.6492
Noul:
- 正解率 96.20%(24,050 件正解)
- 総実行時間:23 分 3 秒
- 入力トークン 15,106,663、総コスト $0.6345
Choice と Noul の性能差・実行時間差がわずかなのは、ランダムな揺らぎによるものだろう。他の LLM と同様、これらの実行は完全に決定的ではないからだ。
たとえば、同じテストセットで Choice API をもう一度走らせると、結果は次のように少し変わった。
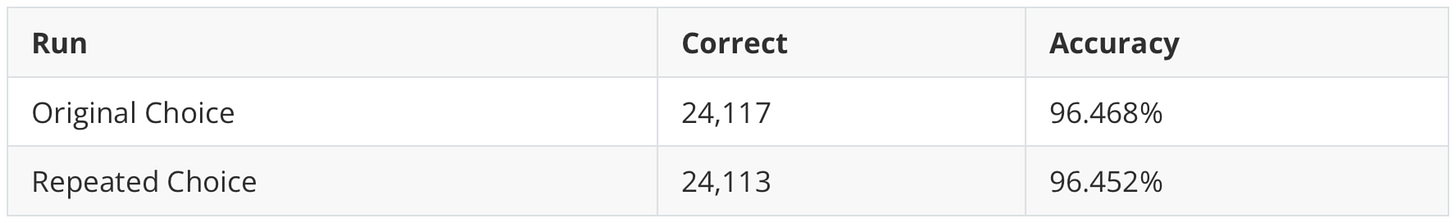
図 29:Jev の繰り返し実行。
(LLM やその他のモデルを大規模にサービス提供するときに生じる非決定性は、バッチに依存する GPU カーネルの実行が浮動小数点演算の順序を変えることに由来しうる。Horace He が昨年、優れたブログ記事で説明している。)
ともあれ、結果は全体としてかなり良さそうに見える(ただし、IMDb のテストセットが訓練セットの一部かどうかは分かっていない)。
参考までに、ある ModernBERT モデルは
- 訓練セットでのファインチューニングに 23 分
- テストセットでの評価に 7 分
を要した。
これに対して、最良の ModernBERT モデルの正解率は同程度だ。次のとおり(ハイパーパラメータをさらに調整すれば、あと 1〜2% は上がると思う)。なお、これは DGX Spark 上で走らせたもので、量子化とより高速なハードウェアによって推論性能はさらに上げられる可能性がある。
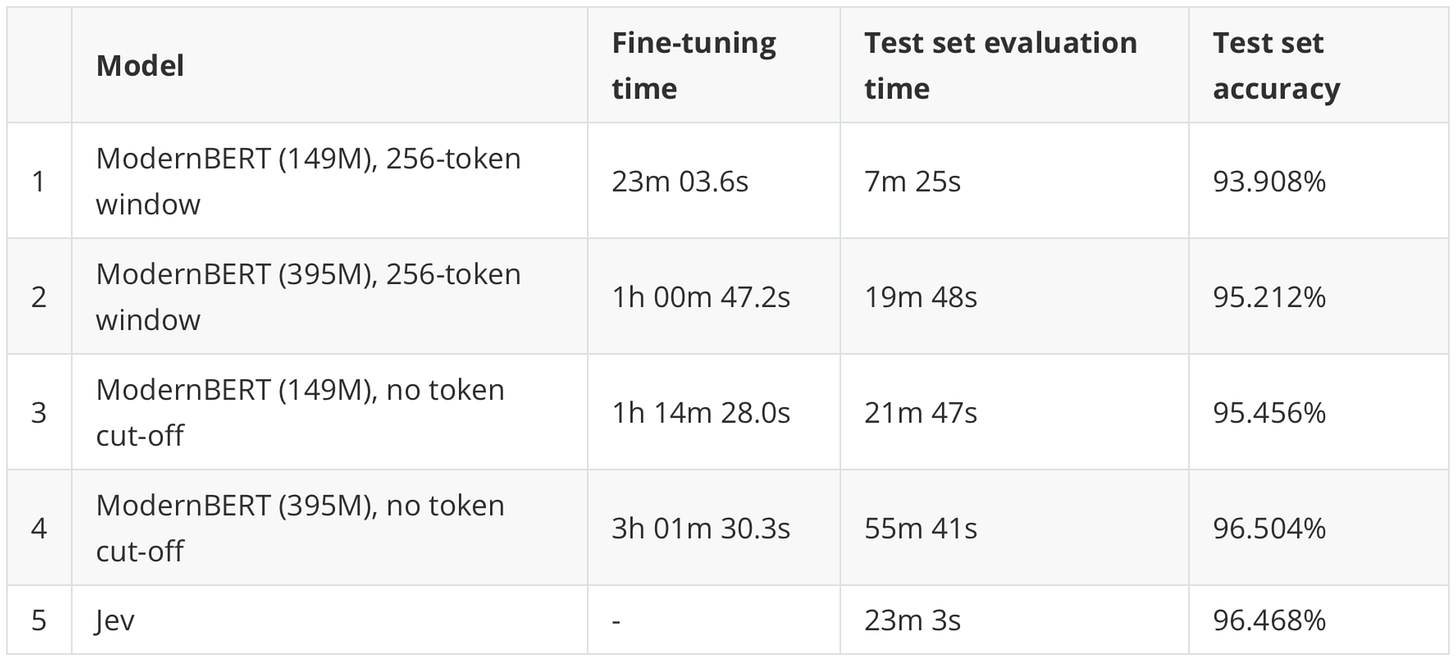
図 30:ModernBERT と Jev の比較。
だが、我々の ModernBERT モデルはテトリスもできないし、映画の分類以外の何もできない。新しいタスクに合わせてファインチューニングし直さない限りは。とはいえ、それなら GPT-5.6 Luna や GPT-6 Luna のモデルをそのまま使えばいい(少し遅く、より高価だが)。
古典的な経験則がある:
- 一度きりの判断タスクなら、安価な LLM(たとえば GPT-6 Luna)に投げればいい。
- 同じ処理を何度も繰り返すなら、専用の分類器をファインチューニングする。
今なら Jev のようなアプローチがこの使い分けを置き換えられる。Luna よりレイテンシが低くコストも抑えられるうえ、カスタムモデルをファインチューニングする手間も要らない。(もちろん、タスク量が非常に多く、特定のタスクで速度と精度を突き詰めたいなら、ファインチューニングには依然として意味がある。)
4. Jev API で BERT 系・GPT 系モデルを作り変える
(Modern)BERT や任意の GPT 系モデルの上に Jev 風の API をかぶせることもできる。この層を足すのはごく簡単だ。実際、Jev の公開直後に ModernBERT で Jev 風のモデルを組み、自分で Jev モデルを作るのがどれほど容易かを示した。
結局この Jev クローンは公開しなかった。途中で考えが変わったからだ。ModernBERT の上に Jev 風 API をかぶせるのは大したことではないし、分類タスクを山ほど使ってファインチューニングするのも大したことではない。だが、大量の訓練とテストなしに、Tetris のような雑多なタスクでこのモデルをきちんと動かすのは簡単ではない。(そもそもこの話題に便乗した Jev クローンはもう十分すぎるほど出ている。また粗製乱造が一つ増える必要はない。とはいえ、十分に強いオープンウェイト版が出れば歓迎されるだろう。)
それでもこの改造に興味があれば、考え方を簡単に説明しておく。たとえば先ほど示したように、任意の BERT、GPT、T5 系モデルに小さな分類ヘッドを足せば、Jev 風の Choice API を実現できる。ただし分類ヘッドの出力ノード数をクラス数と等しくするのではなく、下図のように GPT モデルを改造して出力ノードを 1 つだけにする。
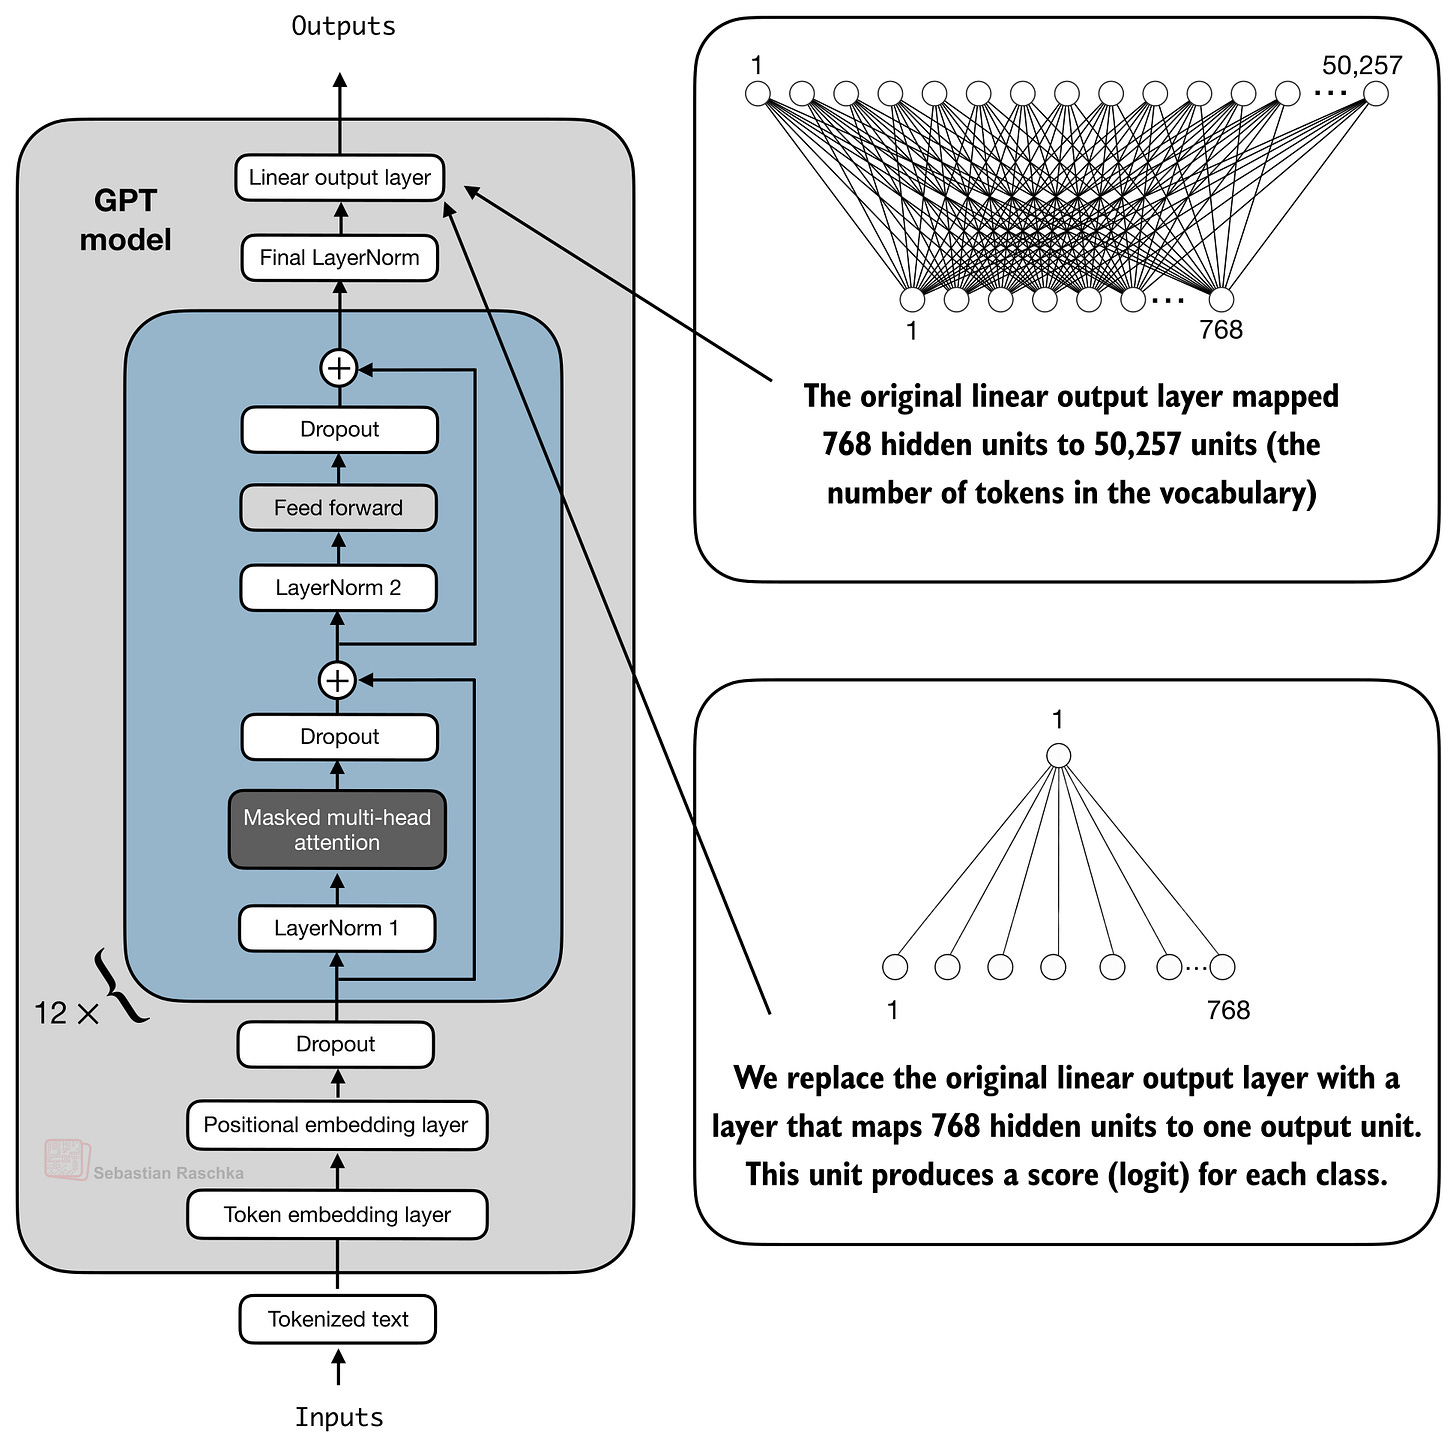
図 31:GPT モデルの出力層(本来は語彙全体に写像する)を、ノードが 1 つだけの出力ヘッドに置き換える。
先に、クラスラベル数が決まっているタスク向けにこうしたモデルをファインチューニングする話をした。たとえば「ポジティブ」「ネガティブ」の 2 クラスに分ける映画レビュー分類だ。この「出力ノード 1 つ」の構成に変えると、実は任意のクラス数に拡張できる。
この方法を任意のクラス数に拡張するには(ここでは 3 クラス、顧客チケットを "billing"、"technical"、"account" に振り分ける例で見る)、下図のようにする。
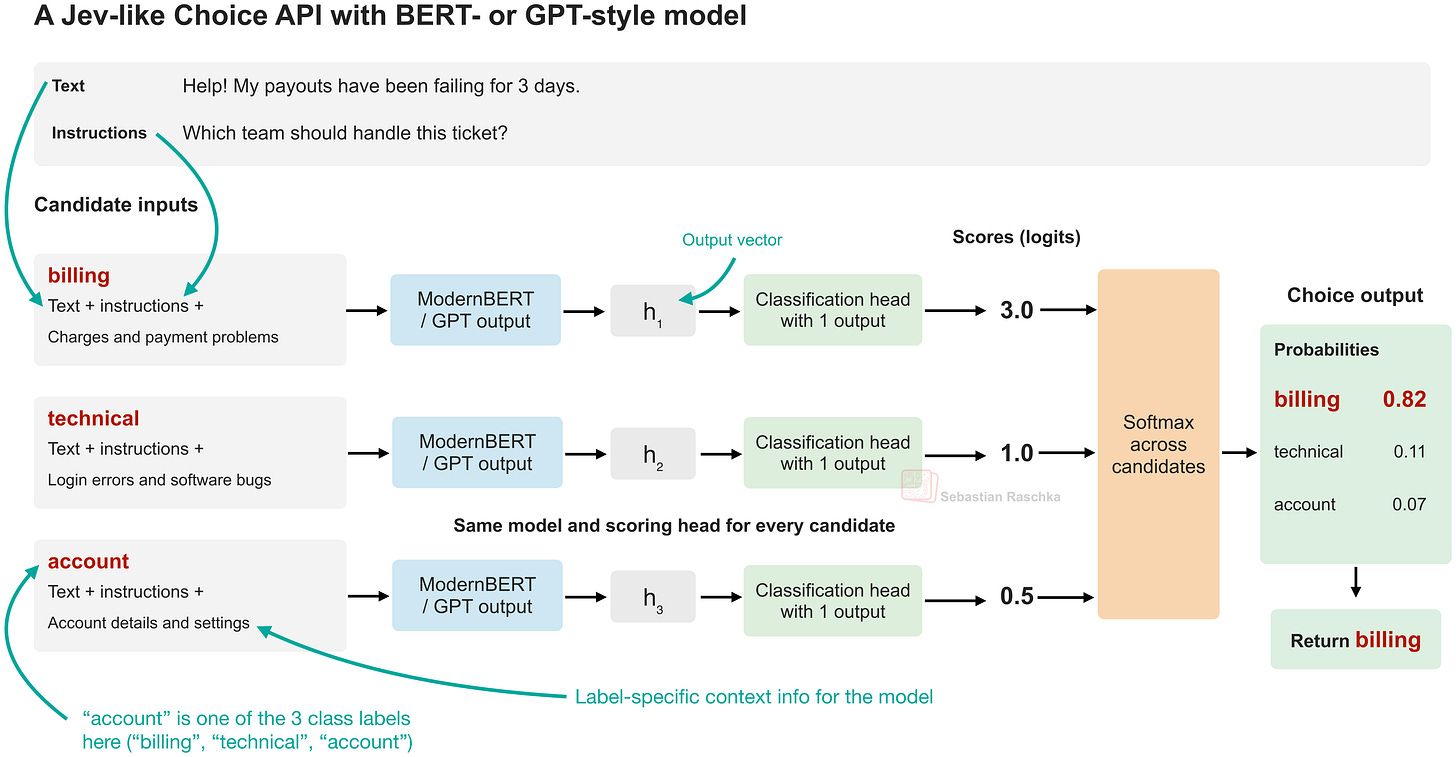
図 32:BERT または GPT スタイルのモデルと、Jev 風の選択 API を組み合わせる。
図のように、候補の選択肢ごとに、入力テキスト・タスク指示・その候補の説明をまとめてモデルに与える。分類(スコアリング)ヘッドが出力表現をスカラーのスコアに写像する。そして全候補のスコアに softmax をかけて確率分布を得て、確率が最も高い選択肢を返す。
要点は、このヘッドがクラスごとに出力を 1 つしか持たないことだ。各クラスの説明がそれぞれ表現を生み、同じヘッドが出力層(実体はロジスティック回帰モデル)を通してそれを採点する:
ここで
- si はクラスラベル i のスカラースコア;
- w は学習可能な重み;
- b は学習可能なバイアス項;
- hi は分類ヘッド直前の transformer の出力。
N 個の候補に対して N 個のスコアが得られる。softmax はその後 N 個の確率を返す。N が変わっても、学習済みパラメータ w と b は変わらない。
hi については次の点に注意:
- BERT スタイルのエンコーダモデルは
[CLS]token の最終隠れ状態を使う(必要ならプーリング層を 1 つ挟んでもよい); - GPT スタイルの自己回帰モデルは通常、最後の非 padding token の隠れ状態を使う。こうする必要があるのは前述の自己回帰的な性質のためだ(最後の非 padding token は前にあるテキスト・指示・候補の説明に注意を向けられる)。
そして正解の選択肢に対して交差エントロピー損失でモデルとスコアリングヘッドをまとめてファインチューニングする。全候補が同じスコアリングヘッドを共有するので、アーキテクチャを変えずに選択肢の数や説明を変えられる。ただし繰り返しになるが、未知のタスクでこれがどれだけ効くかは訓練データ次第だ。
ついでに言えば、なぜ先に挙げたより単純な RNN や CNN のアーキテクチャではなく、BERT や GPT のような transformer ベースのモデルを使うのか。技術的には、ここで述べた方法はどれでも成立する。だが transformer ベースのモデルはスケーリングが非常にうまく、より大きなデータセットで事前学習でき、そこから他のモデルより多くのものを得られる。加えて、文脈が与える情報をうまく活用できる(attention のおかげだ)。だから、タスクごとに明示的にファインチューニングしなくても様々な目標タスクにうまく汎化してほしいなら、高品質なデータセットで transformer ベースのモデルを事前学習する方が、RNN や CNN ベースのモデルよりその目標に近づける可能性が高い。
5. Jev のアーキテクチャと学習アルゴリズム
では、なぜ Jev はこれほど多くの異なるタスク(映画レビューから Tetris のような完全に場当たり的なタスクまで)でこれほど優れた性能を出せるのか。残念ながら、そのアーキテクチャ、アルゴリズム、訓練データの詳細は公開されていない。それに忘れてはならないのは、その後ろにはチーム全体と数百万ドル規模の企業があり、彼らがこのモデルに特化して取り組み、多大な労力を注いできたということだ。公開データセットで ModernBERT 風のモデルを 1 週間訓練すれば、その性能水準に届くと期待するのは無理がある。
とはいえ、根拠のある推測を求められるなら、アーキテクチャ面では ModernBERT に似た小型モデルを使っているのだろう。だからレイテンシがそこまで低いのだ。
訓練データについては、前述のとおり TypeSafe AI の CEO がこう述べている:
我々のデータは 100% 合成だ(ただし、明らかに LLM が直接吐き出したようなゴミではない)
つまり、そう、大部分の労力はこのデータセットの整備に費やされたと私は見ている。これは私が何年も学生や共同研究者に強調してきたことでもある。短い逸話を一つ。約 8 年前、社会科学部の別の教授と共同で、テキスト分類問題の実験計画の設計を手伝ったことがある。彼女の学生は何日もかけて bag-of-words ベースラインと BERT モデルのハイパーパラメータを調整し、ようやく 2〜5% 程度の精度を絞り出した。そこで私が、それぞれ何日か座って手作業でデータにラベルを付けようと提案した(確か、最初のデータセットは 300 サンプルほどで、それを倍にした)。すると精度は 10〜20% 以上向上した。そう、そのためには学習曲線を描くことが大事だ :)。
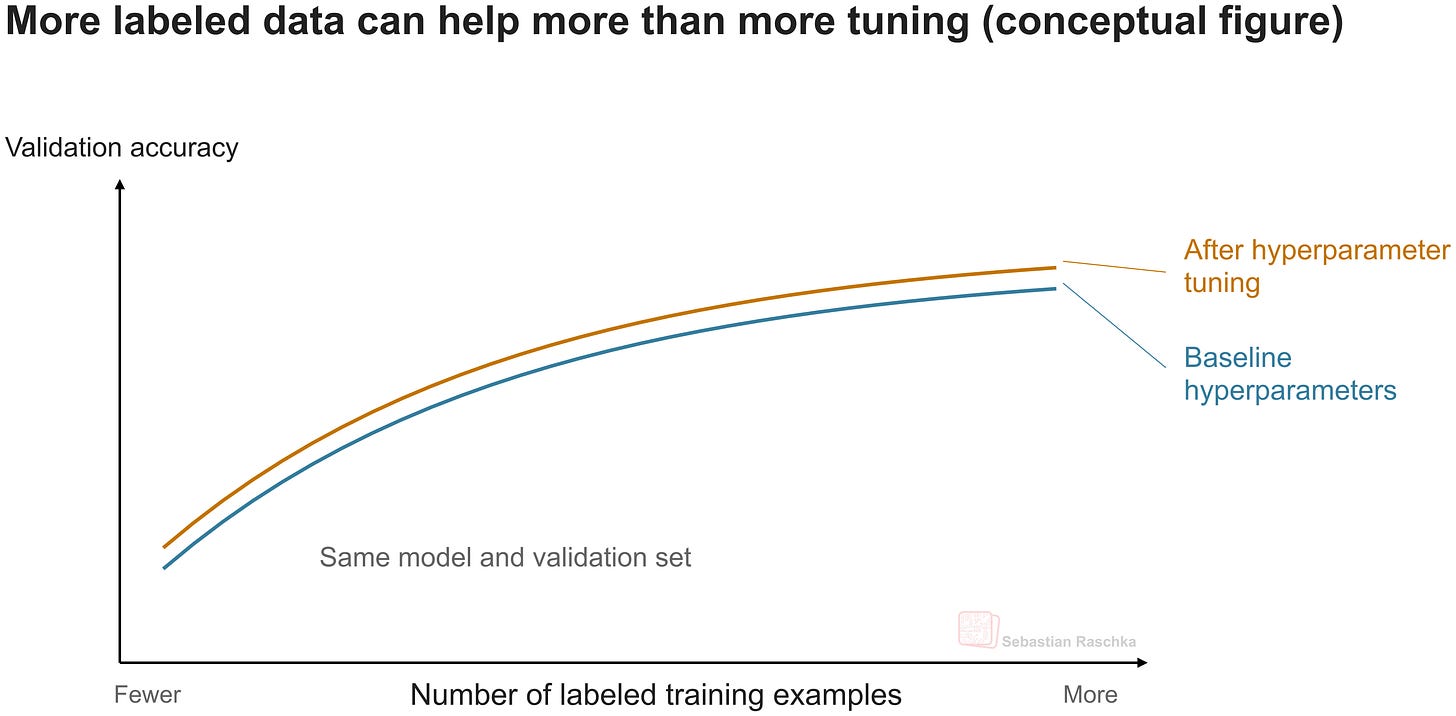
図 33:経験則——追加のハイパーパラメータ調整よりも、データを増やすほうが役立つことが多い。
最後は訓練アルゴリズムだ。具体的な詳細はこれまた不明だが、TypeSafe AI のブログ記事は指摘している、彼らが Reinforcement Learning for Calibrated Decisions(RLCD)と呼ばれる新しいアルゴリズムを使っていると:
「我々は自動化された構築を中心に据えたまったく新しい技術スタックを組み上げた。新しいモデルアーキテクチャ、効率を最大化する並列サンプラー、そして我々が Reinforcement Learning for Calibrated Decisions(RLCD)と呼ぶ訓練手法だ。」
この手法は公開されていない。公表された手法の中に、これと似た校正目標を持つものがある。2025 年の論文 Beyond Binary Rewards: Training LMs to Reason About Their Uncertainty に登場する RLCR(Reinforcement Learning with Calibration Rewards)だ。詳細に入る前に、次の節で校正という一般的な概念を簡単に紹介する。
5.1 校正について
校正は新しい話題ではない。カテゴリ帰属確率を使ったり評価したりする本番モデルには、この手順を勧めている。簡単に言えば、校正とはモデルの確率推定を調整し、実際に観測されるカテゴリ頻度に近づけることだ。
先ほどの IMDb 映画分類の問題を例に取ろう。モデルはあるレビューに対して 74% がポジティブ、26% がネガティブと出すかもしれない。これらは確率推定だが、モデルは過信しているかもしれないし、自信がなさすぎるかもしれない。校正を評価しなければ、これらの数値が信頼できるとは仮定できない。つまり、50% のしきい値では、74% ポジティブも 54% ポジティブも「ポジティブ」というカテゴリラベルになるが、モデルは 74% の場合のほうが高い自信を示している。
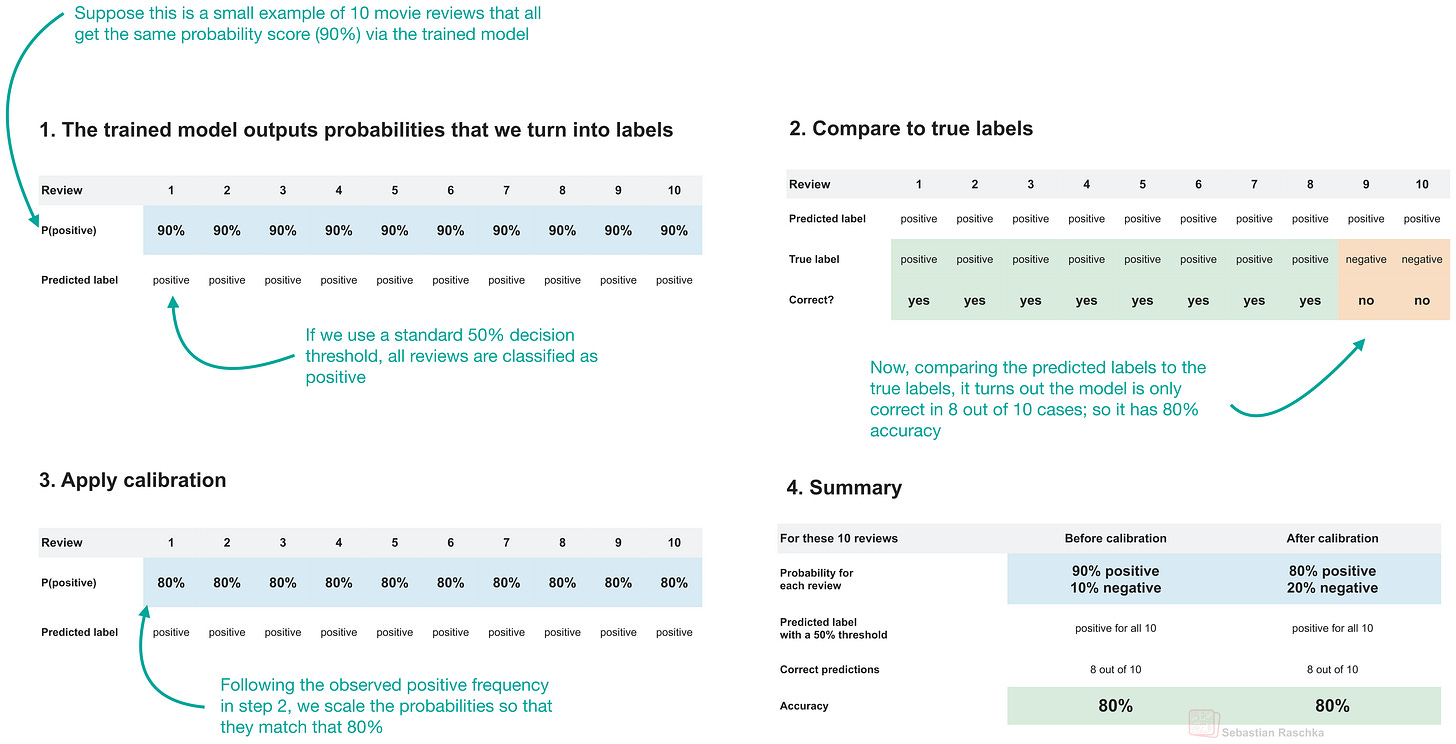
図 34:校正の仕組みの模式図。
校正技術は、別のラベル付きデータセット(たとえばホールドアウトした検証セット)を使ってこれらの確率推定を調整する。校正が成功すれば、約 74% のポジティブ確率が与えられた大量のレビューのうち、およそ 74% が実際にポジティブであるはずだ。詳しくは定番の scikit-learn のドキュメントを参照してほしい。
これを実現する方法は多くある。たとえば、私が自分の AI detector project で使っている温度スケーリング(temperature scaling)。温度スケーリングは、softmax を適用する前にモデルの logits を温度値(T)で割る。モデルの重みを固定したまま、校正データセット上で交差エントロピー損失を最小化することで T(正の数)を学習する。温度が 1 より大きいと最高確率カテゴリの信頼度が下がり、0 から 1 の間だと上がる。その後、同じ温度を新しい予測に使う。このスケーリングは logits の順序を保つので、確率が最も高いカテゴリを選ぶとき、予測カテゴリは変わらない。
5.2 校正報酬付き強化学習(RLCR)
Jev の RLCD 訓練手法は依然として専有だが、関連するアイデアなら議論できる。校正報酬付き強化学習(RLCR)で、2025 年の論文 Beyond Binary Rewards: Training LMs to Reason About Their Uncertainty に由来する。(この 2 つの手法の間に関係があると公式に確認されたわけではないが、関連している可能性があると私は推測している。)
検証可能な報酬による強化学習(RLVR)は通常、正解には報酬 1、不正解には報酬 0 を与える。(包括的な解説と実装については、私の著書 Build A Reasoning Model (From Scratch) を見てほしい :)。)
手短に言えば、RLCR は不正確な信頼度推定に対して追加のペナルティ項を加える。
したがって、従来の RLVR 手法では、報酬 R は答えが正しいかどうかに応じて 0 か 1 を取る(簡単のため、ここではオプションのフォーマット報酬と長さペナルティは無視する)。
RLCR では、モデルが推論過程と回答を生成し、その後で不確実性分析を行って数値の信頼度(q)を出す。修正後の報酬は
ここで c は回答が正しければ 1、そうでなければ 0 となる。たとえば、誤った回答に 90%(0.9)の信頼度を付けると報酬は -0.81 になる。
信頼度が 20% なら報酬は -0.04。正しい回答を 90% の信頼度で出せば 0.99 だ。(キャリブレーションされたモデルの評価に馴染みのある読者なら気づいているだろうが、この二乗誤差項は「回答が正しい」という事象に対する確率に与える Brier ペナルティそのものだ。)
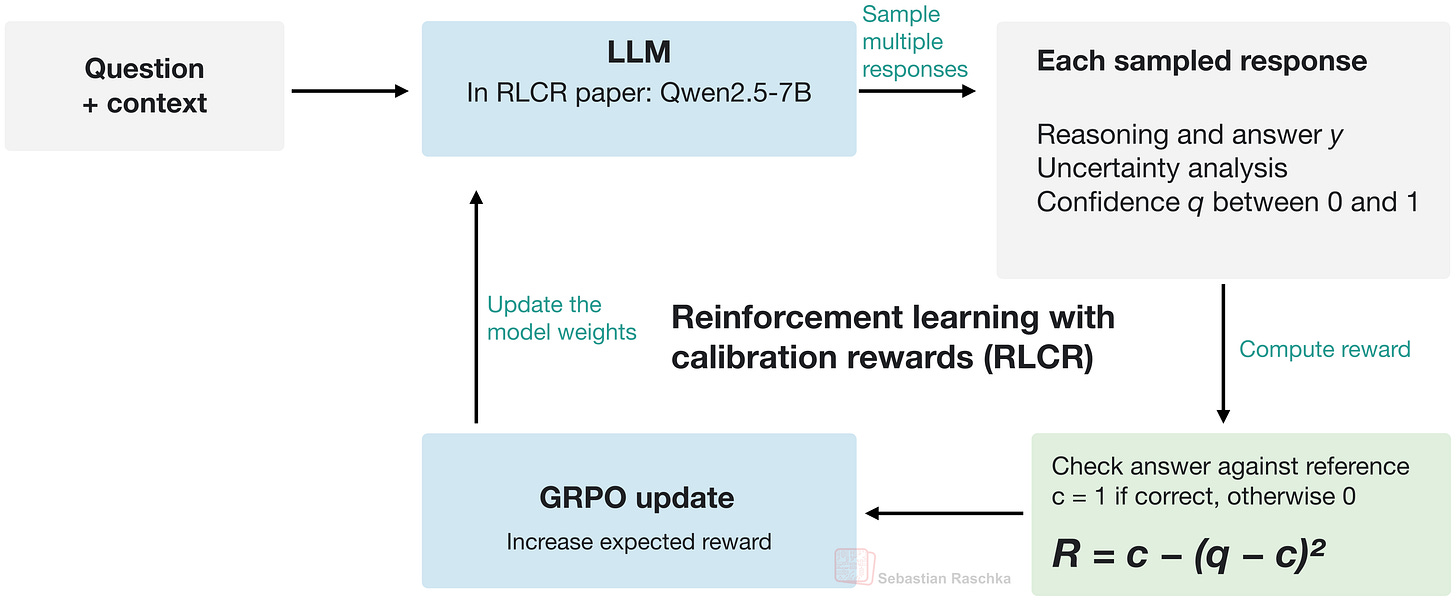
図 35:RLCR の概要。
不確実性分析と q はどちらも、同じモデル(ここでは Qwen2.5-7B)が自身の回答の中で生成する。
不確実性分析は、自分の回答がどこで間違っていそうかを述べた文章による評価だ。回答の後、モデルは根拠の欠落、曖昧な言い回し、怪しい仮定、推論の誤りかもしれない箇所を点検する。論文のプロンプトは、修正案を示すのではなく、具体的な不確実性を指摘するよう求めている。
さらにシステムプロンプトは、タグ内に 0 から 1 の数値として q、つまり自分の回答が正しいとモデルが見積もる確率を明示的に出力するよう指示する。これらはすべて、システムが同一の回答の中で順に生成させる。
説明のため、モデルの回答は次のようになる。
...問題についての推論...
positive

この文章は肯定的な映画レビューに触れているが、第 2 段落とのつながりがはっきりしない。

0.6
以下は論文に載っている注釈付きの図で、温度スケーリングを使う通常の RLVR と比べて期待キャリブレーション誤差をどれだけ改善するかを示している。
HotpotQA では、RLCR は RLVR と比べて期待キャリブレーション誤差(ECE)を 0.37 から 0.03 に下げ、精度はほぼ同等(62.1% 対 63.0%)だった。他の 6 データセットでは、平均 ECE が 0.46 から 0.21 に下がり、精度は 53.9% から 56.2% に上がった。これは論文の表 1(a) の結果である。
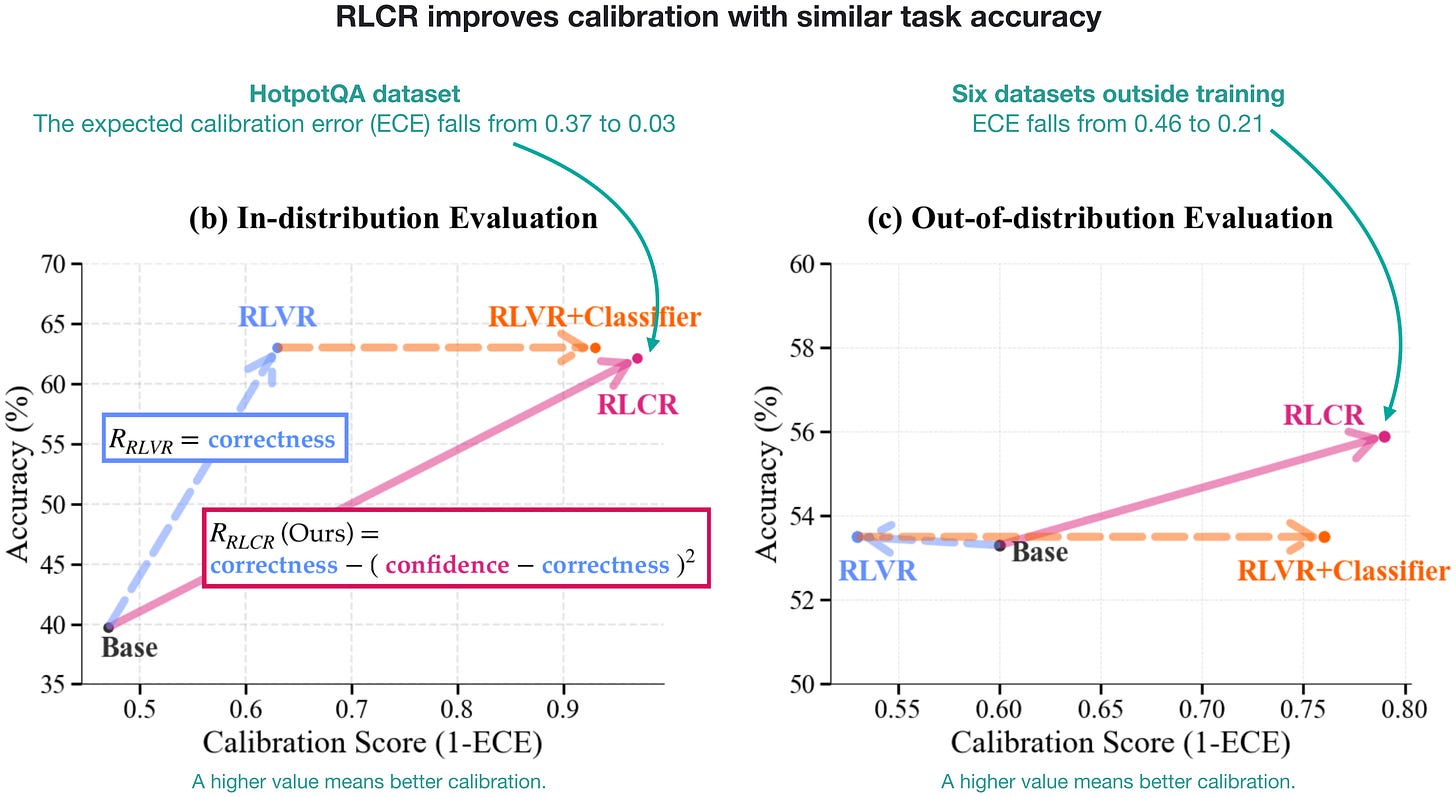
図 36:論文 Beyond Binary Rewards: Training LMs to Reason About Their Uncertainty の RLCR の結果。
概念的には、「RLVR + Classifier」の「Classifier」は、生成された回答が正しいかどうかを予測する教師あり二値分類器だ。
Jev の場合、推論テキストを生成せずに、キャリブレーション報酬を型付きの判断に直接適用できる。たとえば、GPT 系のモデルに 2.2 節で示したような分類ヘッドを付け、正確な判断とキャリブレーションの取れた確率を報酬するよう RL の訓練目標を調整すればよい。バックボーンと分類ヘッドは一緒に訓練する。このやり方は RLCR に着想を得たもので、Jev の RLCD がそう動いているかは今のところ不明だ。
別の方法として、Direct Policy Optimization(DPO)が Reinforcement Learning with Human Feedback(RLHF)の交差エントロピー(CE)による代替であるように、分類器の確率に対して CE + Brier 損失を直接最小化することもできる。ModernBERT で試したところ、通常の温度スケーリングと比べてわずかに改善した。
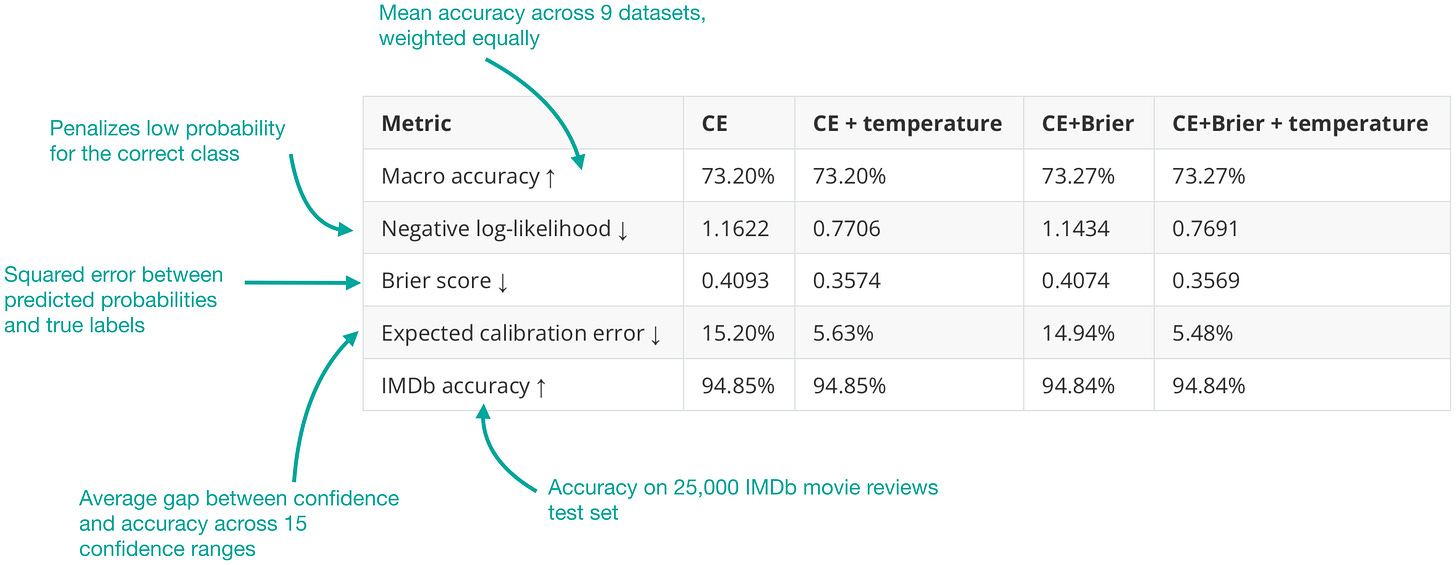
図 37:RLCR に着想を得た Brier 損失による最適化で ModernBERT を改善した結果。↑ は高いほど良い。↓ は低いほど良い。
6. Jev は誰のためのものか?
ここまで Jev をかなり詳しく見てきたが、Jev は誰のためのものなのか。私の見立てでは、ターゲット層はかなり広く、次の 2 つの条件が重なる人たちだ。a)判断タスクのたびに専用の分類器を微調整する時間を節約したい、b)GPT-6 のような「大砲」級の LLM を使うよりコストを抑えたい。
ほかにも面白いユースケースがいろいろ考えられる。以下はそのごく一部だ。
6.1 Jev のユースケース
ユースケースの一覧は際限なく挙げられそうだ。もちろん、Tetris のようなビデオゲームを遊ばせるといった派手な例もある(この API の低遅延を示すために、以前の動画で実演した)。ただ、ほとんどの人にとってはメールの整理のほうが実用的だろう。たとえば Jev を追加のスパムフィルタや優先度付けのツールとして使える。
それだけでなく、LLM-agent harness の強化にも使える。ここでは次のような用途が考えられる。
- 通常の LLM-agent harness のプレフィルタとして、コンテキスト内の prompt injection を走査する
- モデルの推論投入レベルを選ぶ
- 登録したスキルライブラリから skill.md を 1 つ選ぶ
- 評価や自己改善のジャッジとして使う
- コンテキスト構築に使う関連ファイルを見つける
このリストはほとんど際限がない。わずか数日のうちに 2,170 件の Jev 関連プロジェクトが出現し、それを分析したレビューが arXiv に出たほどだ。
6.2 Jev クローンとローカル Jev について
Jev のリリース後、急速に作られたクローンが何百、何千と現れた。私が目を通した大半は、ModernBERT か Qwen を SFT で微調整し、Jev 風の API をかぶせただけの即席サンプルだった。
私の知る限り、これほど幅広いタスクで Jev の性能水準に達するものはない。これらのプロジェクトと Jev を比べるのは、Alpaca(元祖 LLaMA のオープンウェイトモデルを指示微調整した初期の LLM)と GPT-6 を比べるようなものだ。精神は似ていても、実タスクでの出来はまちまちだ。
失礼を承知で言えば、ただの便乗の即席プロジェクトに見えるので、ここで特定の一つを推薦する気はない。
唯一の例外は GLiNER だろう。このプロジェクトはもう 3 年ほど存在している。Jev とは本質的に別物だが、似た用途に使える。とはいえベンチマークを見る限り、Jev のほうが明らかに強い。
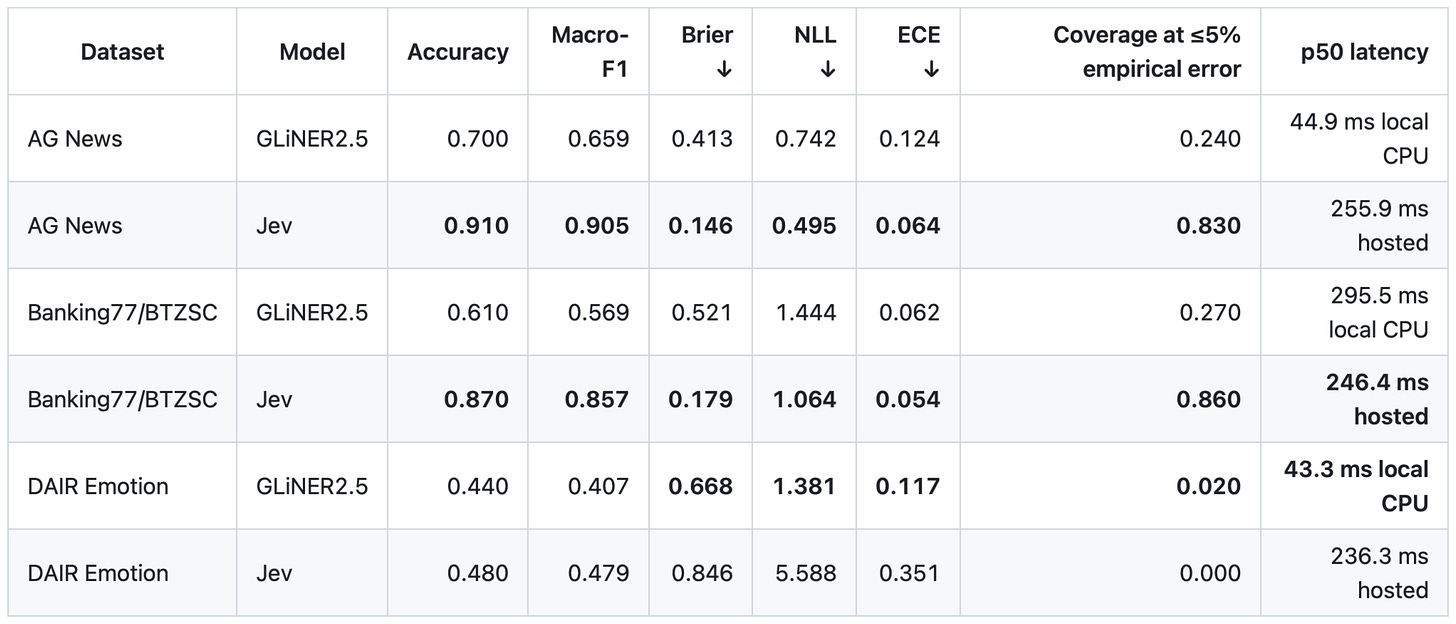
図 38:GLiNER と Jev の比較、https://github.com/AbdelStark/jev-benchmarks/blob/main/results/reports/btzsc-pilot-v1.md より
いずれにせよ、優れたオープンウェイトの Jev 代替品への需要は実在する。理由はコストではない(Jev はすでに十分安い)。プライバシーだ。(それに、ネットワーク越しでこれだけ速いなら、強力なローカルハードウェアで動かしたらどれほど速いか想像してみてほしい。)
だから私は、Jev に DeepSeek(あるいは Kimi、GLM、MiMo)の瞬間が来てほしいと願っている。誰かが取り組んでいると信じているが、時間はかかる。TypeSafe AI は専門家チームを投入し、数か月を費やした。あの開発と評価の作業を 1 週間で再現しろというのは無理な話だ。(とはいえ、兆パラメータモデルより小さく効率的なので、理屈の上ではそこまで長くはかからないはずだ。)
結論
全体として、一見すると Jev は本質的に新しいものを何ももたらしていないように思える。何しろ「ただの分類器だ」(その上に使いやすい API が乗っている)と言えてしまう。だが、極めて幅広いタスクで驚くほどよく機能する。その意味では、専用分類器の即戦力版だ。
もちろん、専門家はこれからも専用モデルを微調整するだろう。だが今、専用モデルの微調整を正当化するハードルはずっと高くなっている。Jev か Jev 系モデルをそのまま使えば、十分に良い結果が得られるからだ。
また、Jev や Jev 系モデルが新しい能力を引き出したり、これまで解けなかったタスクを解決したりするとは期待していない。ただ、こうしたモデルを agent harness に組み込み、その中で高価な GPT-6 や Opus 5.5 の意思決定を補助させれば、今後の agent harness の利用はずっと速く、ずっと安くなる可能性がある。