FaceSwap MiniMax H3 LoRA:顔差し替えの実践ガイド
AIModels.fyi による実践ガイド。UntMods の FaceSwap_MiniMaxH3_REF2VA LoRA を使い、MiniMax H3 の参照動画モデルで顔を差し替える。ノード設定と FAQ 付き。
日本語
コピー
概要
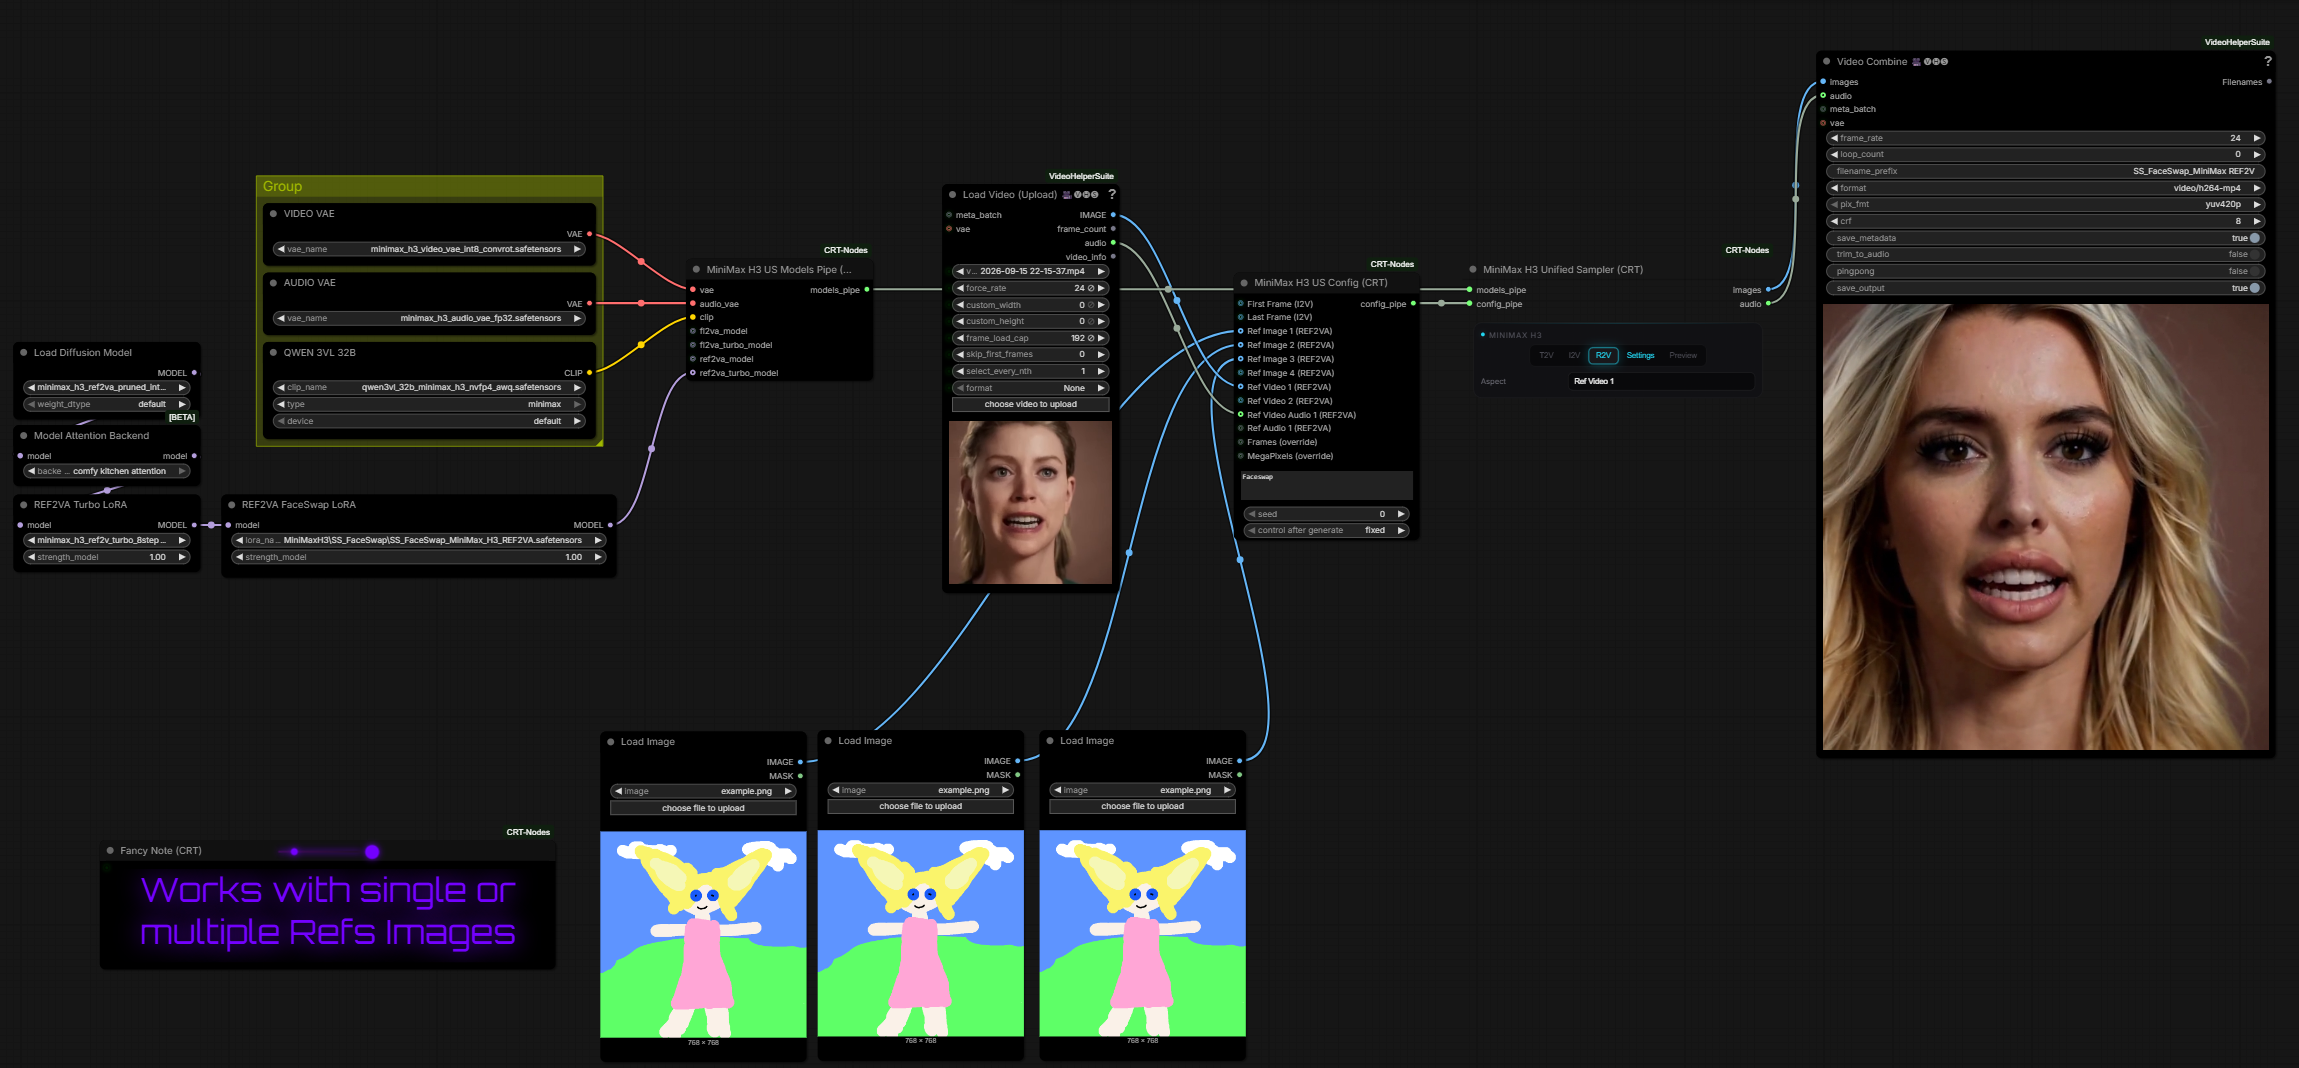
FaceSwap_MiniMaxH3_REF2VA は MiniMax H3 ref2va 参照動画生成モデル向けの LoRA アダプターだ。UntMods が作成したもので、参照動画に登場する顔のアイデンティティを、1つまたは複数の参照顔のアイデンティティに置き換える。ベースモデルが提供する動画生成ワークフローはそのまま使う。アダプターはトリガーワード Faceswap を1つ使い、README では LoRA 強度を 1 と指定している。最も重要な要件は互換性で、MiniMax H3 のワークフローと MH3 形式に準拠した入力動画が必要になる。付属のワークフローは CRT-Nodes を使うが、メンテナは自前のワークフローでも構わないとしている。提供された資料には、ベースモデルのパラメータ数、出力解像度、コンテキストウィンドウ、学習データセット、学習ステップ数、GPU メモリ要件、推論時間、バッチサイズの推奨値は書かれていない。そのため、このアダプターについてこれらの数値は確認できない。
最適な用途
参照動画生成におけるアイデンティティ置換。 元動画があり、そこに映る顔のアイデンティティを1つまたは複数の参照顔に変えたいときに使う。この LoRA は動画全体の見た目ではなく、まさにこの操作を対象にしている。生成した短いクリップで演者の顔を差し替えつつ、元の動きやシーン構造は保つ、といったワークフローに向く。複数の参照顔によるアイデンティティ転移。 説明では、参照動画のアイデンティティを「Reference(s)」のアイデンティティで変更できるとされている。複数の参照顔を渡すワークフローに適しているが、README には参照数の上限も、参照画像の選び方も書かれていない。ComfyUI ベースの MiniMax H3 実験。 メンテナは CRT-Nodes で組んだワークフローを公開し、自前のワークフローを使うことも認めている。すでにノードベースの動画パイプラインで MiniMax H3 を動かしていて、新しいモデルを学習せずに顔入れ替え専用のアダプターを足したい開発者に向く。より低コストな LoRA 配備。 このアダプターは、設定されたしきい値を下回るブロックをあらかじめ剪定してある。説明によれば、これで軽くなり LoRA のアーティファクトも減り、学習ベースと同じ強度を保てるという。剪定していない LoRA より小さなアダプターとクリーンな結果を求めるユーザーに向いているかもしれないが、リポジトリにはファイルサイズもベンチマーク測定値もない。
制約
このアダプターは MiniMax H3 ref2va モデル専用だ。README は他のベースモデルとの互換性を確認しておらず、fl2va やその他の MiniMax H3 派生モデルに対応するかも述べていない。別の構成で動作を確認するまでは、必要なベースモデルとワークフローの組み合わせは厳密に固定されていると考えるべきだ。モデルカードには量子化の品質評価がない。サンプル動画はあるが、アイデンティティ類似度スコア、時間的一貫性スコア、顔解像度の上限、失敗率、他の顔入れ替えシステムとの比較は報告されていない。これらのサンプルからは、横顔、遮蔽、速い動き、複数人、異常な照明、表情、低品質な元素材での挙動は分からない。README によれば、アダプターにはトリガーワード Faceswap と LoRA 強度 1 が必要だ。テスト済みの強度範囲は書かれておらず、強度を変えるとアイデンティティ転移が弱まったり、アーティファクトが出たりする可能性がある。メンテナは剪定で LoRA のアーティファクトを減らせるとしているが、この主張を裏付ける数値比較はない。ワークフローは CRT-Nodes に依存し、入力動画は MH3 形式に準拠していなければならない。README はこの形式を定義しておらず、必要な寸法、フレームレートの制限、対応コーデック、前処理コマンドも示していない。こうした詳細は MiniMax H3 のベースワークフローから得るか、共有されたワークフローを調べて把握するしかない。ドキュメントにはメモリ要件、推論速度、解像度、コンテキスト長、パラメータ数、量子化オプション、バッチサイズの推奨値もない。ハードウェアの計画とスループットの見積もりは、選んだ MiniMax H3 実装で実際に試すしかない。リポジトリは、このアダプターに同意、なりすまし、生体情報のプライバシー、欺瞞的なメディアに対する保護があるかどうかを述べていない。顔入れ替えは誤解を招く内容や同意のない内容を生みかねない。参照顔と元動画を使う前に許可を取り、合成メディアは適切な場面で明示し、適用される法律とプラットフォームの規則を確認すること。このモデルは Apache-2.0 ライセンスだ。このライセンスは通常、その条件に従う限り商用利用、改変、再配布を認めるが、アダプターのライセンスは顔、動画、ベースモデル、学習データ、生成コンテンツにまつわる権利までは解決しない。商用展開の前に、ライセンス全文と依存する各項目の条件を確認すること。
比較
h3/reference-to-video/lora
中心となるタスクが参照動画内の顔のアイデンティティを置き換えることで、専用のトリガーワード Faceswap(強度は 1 として記録)を使いたい場合は FaceSwap_MiniMaxH3_REF2VA を選ぶ。顔交換専用のアダプタではなく、音声同期付きの MiniMax H3 参照動画生成が必要な場合は h3/reference-to-video/lora を選ぶ。トレードオフの核心は特化度にある。このアダプタはアイデンティティ置換に特化しているのに対し、代替案は音声同期を備えたより汎用的な参照動画システムとして説明されている。
Minimax-H3-ComfyUI
すでに MiniMax H3 ref2va のパイプラインがあり、顔のアイデンティティ変換だけが必要な場合は FaceSwap_MiniMaxH3_REF2VA を選ぶ。MiniMax H3 向けのワークフロー、リポジトリ構成、サンプルを含む、より包括的な ComfyUI LoRA リポジトリが必要な場合は Minimax-H3-ComfyUI を選ぶ。ドキュメントによれば、これらの LoRA は主に ref2va でテストされており、fl2va でも動作するはずだがテストは少ないという。代替案はワークフローと LoRA の対応範囲がより広く、このアダプタは特定の顔交換動作を提供する。
MiniMax-H3-Realism-People-LoRA
アイデンティティ置換が必須の操作である場合は FaceSwap_MiniMaxH3_REF2VA を選ぶ。リアルな人物のレンダリング——顔のクローズアップ、自然な肌の質感、説得力のある表情や身振り、映画的なライティング、ドキュメンタリー風のカメラワーク——を優先する場合は MiniMax-H3-Realism-People-LoRA を選ぶ。トリガーワードは r34l1sm なので、これはリアリズムの問題を解決するものであり、ここで説明している明示的な顔のアイデンティティ置換ではない。入手できる情報には、この2つのアダプタの速度、コスト、品質を比較したベンチマークデータはない。
ltx-2.3-22b/reference-video-to-video/lora
パイプラインがすでに MiniMax H3 を使っていて、タスクが顔交換である場合は FaceSwap_MiniMaxH3_REF2VA を選ぶ。LTX-2.3 で音声付きの参照動画から動画への生成を行い、カスタム LoRA をサポートする必要がある場合は ltx-2.3-22b/reference-video-to-video/lora を選ぶ。2つのシステムは異なる基盤モデルのエコシステムを使っており、提供された情報からは速度、コスト、出力品質のどちらが優れているか判断できない。
LTX-Best-Face-ID
MiniMax H3 のワークフローで既存の参照動画を変換する場合は FaceSwap_MiniMaxH3_REF2VA を選ぶ。人物の参照写真とテキストプロンプトから、LTX-2.3 22B でアイデンティティを保持した参照画像からの動画生成を行いたい場合は LTX-Best-Face-ID を選ぶ。このモデルは overlap reference conditioning、TASS-RoPE、微分可能な ArcFace アイデンティティ損失を採用しているのに対し、このアダプタのドキュメントにはプルーニング済みの MiniMax H3 LoRA が1つ記録されているだけだ。もう一方の選択肢はアイデンティティ保持の設計がより明確だが、MiniMax H3 ではなく LTX-2.3 エコシステムに依存している。この方向性に関連する研究には ID-LoRA: Identity-Driven Audio-Video Personalization、Video2LoRA、LoRA-Edit の成果がある。これらの論文はアイデンティティのパーソナライズと制御可能な動画適応の背景を提供するが、このアダプタがそのいずれかの手法を実装していると示すには情報が足りない。
技術仕様
確認されている技術的詳細は以下のとおり:
-
モデルタイプ: LoRA アダプタ。
-
ベースモデル: MiniMax H3
ref2va。 -
タスク: 参照動画内の人物の顔を、1つ以上の参照入力のアイデンティティに置き換える。
-
トリガーワード:
Faceswap。 -
ドキュメントに記録された LoRA 強度:
1。 -
プルーニング: 設定された閾値を下回るブロックはプルーニング済み。
-
プルーニングの効果(主張): 重みが小さく、LoRA のアーティファクトが少なく、強度は学習済みベースモデルと一致する。
-
ワークフロー: メンテナがワークフローを1つ公開している。
-
ワークフローノード: CRT-Nodes。
-
代替ワークフローのサポート: メンテナは独自のワークフローを使えると述べている。
-
入力の制約: 入力動画は MH3 フォーマットに準拠している必要がある。
-
サンプル: リポジトリには
Faceswap_00120.mp4、Faceswap_00114.mp4、Faceswap_00058.mp4、Faceswap_00109.mp4、Faceswap_00107.mp4、Faceswap_00039.mp4、Faceswap_00040.mp4、Faceswap_00013.mp4という名前の MP4 サンプルが含まれている。 -
ライセンス: Apache-2.0。
-
タグ: Video-to-Video。
提供された README には、LoRA のファイル名、ファイル形式、ファイルサイズ、ベースモデルのパラメータ数、アダプタの rank、対象モジュール、プルーニング閾値、学習データセット、学習ステップ数、オプティマイザ、学習率、解像度、フレーム数、コンテキストウィンドウ、量子化、VRAM 要件、推論速度、対応するバッチサイズについての記載はない。
モデルの入力と出力
入力
-
MiniMax H3 フォーマットに準拠した参照動画。
-
1つまたは複数の顔参照アイデンティティ。
-
トリガーワード
Faceswap。 -
MiniMax H3
ref2vaベースモデル。 -
CRT-Nodes を使用するワークフロー、または互換性のあるカスタムワークフロー。
-
README で指定された LoRA 強度
1。
出力
-
参照動画の顔アイデンティティを、提供された1つまたは複数の参照アイデンティティに置き換えた動画。
-
リポジトリのサンプル出力は MP4 形式。
-
README には、出力解像度、フレームレート、音声の扱い、コーデック設定、必要な後処理についての記載がない。
クイックスタート
提供された資料には、モデルのファイル名、ComfyUI API リクエスト、Python のロードコード、推論呼び出しが含まれていない。実装の詳細をでっち上げることなく、検証済みでそのままコピーできる Python の例を示すことはできない。共有されている CRT-Nodes ワークフローを使い、MiniMax H3 ref2va ベースモデルをロードし、この LoRA をマウントし、LoRA 強度を 1 に設定し、Faceswap をトリガーワードとして使い、入力動画が MH3 形式に準拠していることを確認してほしい。
よくある質問
Q:FaceSwap_MiniMaxH3_REF2VA にはどのベースモデルが必要ですか? A:MiniMax H3 ref2va モデル向けに設計されている。他のベースモデルとの互換性はドキュメントでは確認されていない。Q:どのトリガーワードと LoRA 強度を使うべきですか? A:メンテナーの説明では、単一のトリガーワード Faceswap を使い、LoRA 強度は 1 に設定する。Q:このアダプターが想定する入力動画形式は何ですか? A:入力動画は MH3 形式に準拠している必要がある。README はこの形式の解像度、コーデック、フレームレート、フレーム数の要件を定義していない。Q:CRT-Nodes は必要ですか? A:共有ワークフローは CRT-Nodes を使っている。メンテナーは独自のワークフローを使ってもよいとしているが、MiniMax H3 の設定とこのアダプターが必要とする入力をサポートしている必要がある。Q:このモデルは商用利用できますか? A:このアダプターは Apache-2.0 で公開されており、ライセンス条項を守る限り商用利用が可能。ベースモデル、依存関係、ソース動画、参照顔、生成コンテンツに関する権利と条項も自分で確認する必要がある。Q:必要な VRAM と推論速度は? A:README は VRAM 要件、推論時間の計測値、スループットのデータ、バッチサイズの推奨を示していない。対象ハードウェアで MiniMax H3 ワークフロー全体をベンチマークしてほしい。Q:このアダプターをファインチューニングできますか? A:提供されたドキュメントはファインチューニングの手順、学習コード、データセット、オプティマイザ、フレームワークについて記述していない。この成果物を LoRA と位置づけ、プルーニングされていると説明しているが、学習設定を再現するのに十分な情報はない。Q:どのような品質問題をテストすべきですか? A:横顔のアングル、オクルージョン、速い動き、複数の顔、激しい照明変化、表情の下でのアイデンティティ保持をテストしてほしい。モデルカードにはサンプルがあるが、定量的な失敗分析や品質ベンチマークはない。Q:このモデルは活発にメンテナンスされていますか? A:提供された情報はメンテナーとサンプル動画を示しているが、リリースの頻度、issue への対応方針、更新履歴、メンテナンス状況については説明していない。メンテナンス活動は未確認とみなしてほしい。本記事は UntMods がメンテナンスする AI モデル FaceSwap_MiniMaxH3_REF2VA に関する簡易ガイドです。こうした分析が役に立ったなら、AIModels.fyi に参加するか、Twitter でフォローしてください。