Grace Blackwell には新しいスケジューラが要る、同じラックで使える GPU が 27% 増える
NVL72 はラック内の 72 基の GPU を 1 つの NVLink ファブリックにつなぐが、その帯域を使えるのは同じラックに収まったジョブだけだ。SkyPilot はトポロジーを意識した配置、故障時のインプレース交換、自動デフラグでマルチノードの学習と推論を NVLink 上に留める。
日本語
コピー
高速インターコネクトであればどれでも同じ性能が得られるわけではなく、選び方を誤ると大きなコストにつながる。同じ分散学習ジョブをInfiniBand上で実行すると、NVLinkを使った場合より性能が43%低下することがある。
これまでNVLinkは単一ノード内の通信に限られていた。そのためマルチノードのAIワークロードは、InfiniBandかそのクラウド版(AWSのEFA、GCPのGPUDirect-TCPX)で通信するしかなかった。NVIDIAのNVL72システムは、ラック内の72基のGPUを単一のNVLinkファブリックで接続することでこの制約を取り払い、異なるノード上のGPU同士でも桁違いの帯域幅でデータをやり取りできる。
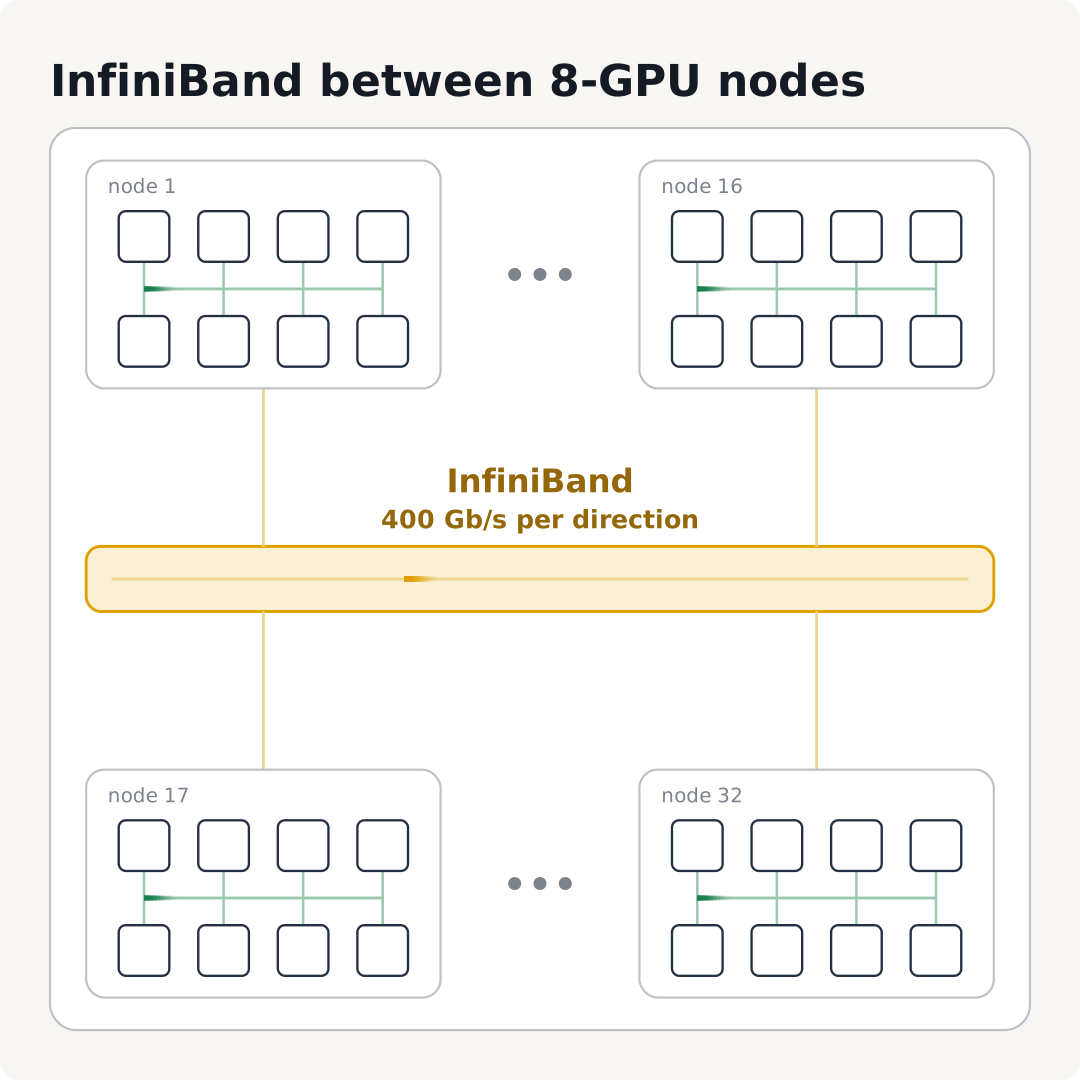
ただし、NVL72システムの利点を最大限に引き出せるかどうかは、ワークロードの配置に大きく左右される。複数のラックにまたがって分散するマルチノードジョブでは、依然としてInfiniBandがボトルネックとなる。ハードウェア障害でノードがオフラインになり、ジョブがそれぞれ異なるタイミングで終了して空き容量がラック間に散らばると、ラックローカリティの維持は難しくなる。
本記事では、大規模な学習と推論における通信ボトルネック、NVL72のラックスケールファブリック、GPU障害への耐性を考慮したスライスサイジング、そしてSkyPilot Platformがトポロジーを考慮した配置、ハードウェア障害からのインプレース復旧、共有クラスタの自動デフラグメンテーションによってマルチノードジョブをいかにラックローカルに保つかを解説する。
大規模な学習は通信の問題である
最先端の学習ジョブは数千基のGPUにまたがって実行される。そのためには次の2つの問いに答える必要がある。
- モデルをGPU間にどうシャードすれば、実際に動かせるのか。
- 計算予算が決まっているとき、学習スループットを最大化するには、シャードしたモデルを何個並列に動かせるのか。
1つ目の問いは、通常、次の組み合わせで答える。
- Tensor Parallelism(TP):層の重み行列をGPU間に分割する
- Expert Parallelism(EP):mixture-of-experts(MoE)層のエキスパートを別々のGPUに配置する
- Pipeline Parallelism(PP):モデルを層単位でGPU間に分割する
2つ目の問いの答えがData Parallelism(DP)の次数を決める。すなわち、シャードしたモデルのコピーをいくつ並列に学習させるかであり、それぞれが学習データの異なるスライスを担当する。
これらの並列化戦略のうち、テンソル並列のall-reduceとエキスパート並列のall-to-allという通信パターンは学習時のクリティカルパス上にあり、NVLink上に置くことが最も重要(§9.1.2)となる。
Tensor Parallelism
テンソル並列は各層の内部にある重み行列をGPU間に分割する。各GPUは層ごとにその一部だけを保持し、計算する。
Transformerの層はself-attentionとmulti-layer perceptron(MLP)という2つのブロックで構成される。各ブロックの中心は、2つの行列積(GEMM)を連続して行うことにある。Megatron-LM(§3)は、ブロックの1つ目のGEMMを列方向に、2つ目のGEMMを行方向に分割すれば、GPU間の同期は各GEMMの後ではなく、2つ目のGEMMの後にブロックごとに1回all-reduceするだけで済むことを示した。
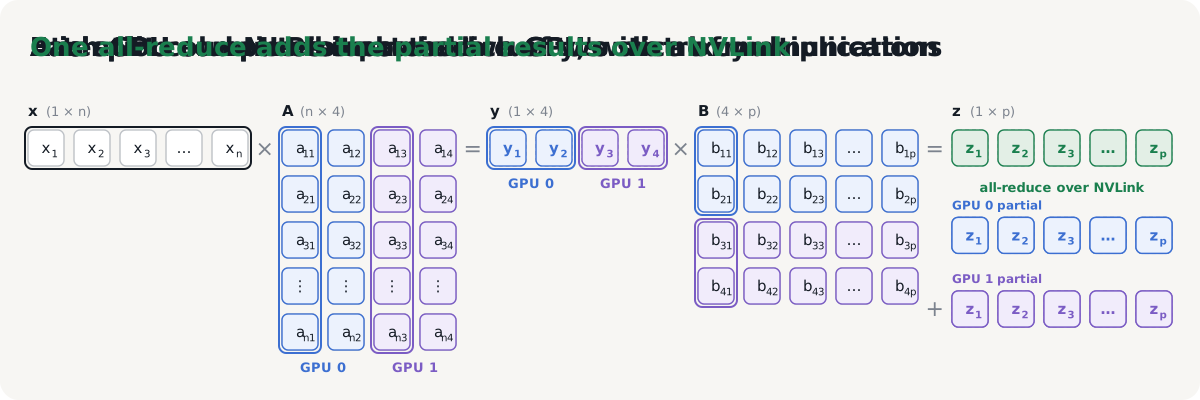
この最適化を行っても、テンソル並列ではフォワードパス中にトランスフォーマー層ごとに2回のall-reduceが必要になる。これらのall-reduceはトレーニング時のクリティカルパス上にあり、計算と完全にオーバーラップさせることはできない。そのため、テンソル並列は通常NVLink内に留められる。Hugging Faceの計測では、NVLinkからInfiniBandに移すとトレーニングのスループットが43%低下した。
エキスパート並列
mixture-of-experts(MoE)層では、MLPブロックがエキスパートと呼ばれる多数の小さなMLPと、各トークンを少数のエキスパートに振り分けるルーターに置き換えられる。エキスパート並列はMoE層を分割し、これらの小さく独立したエキスパートを別々のGPUに配置する。
エキスパート並列では、各MoE層のフォワードパスでdispatchとcombineという2回のall-to-all通信が必要になる。ルーターが各トークンに対して上位k個のエキスパートを選び、そのエキスパートをメモリに持つGPUへトークンをdispatchする。各GPUは受け取ったトークンに対してローカルのエキスパートを1回のグループ化された行列積で計算する。最後に、エキスパートの出力を各トークンの元のGPUへ送り返してcombineする。
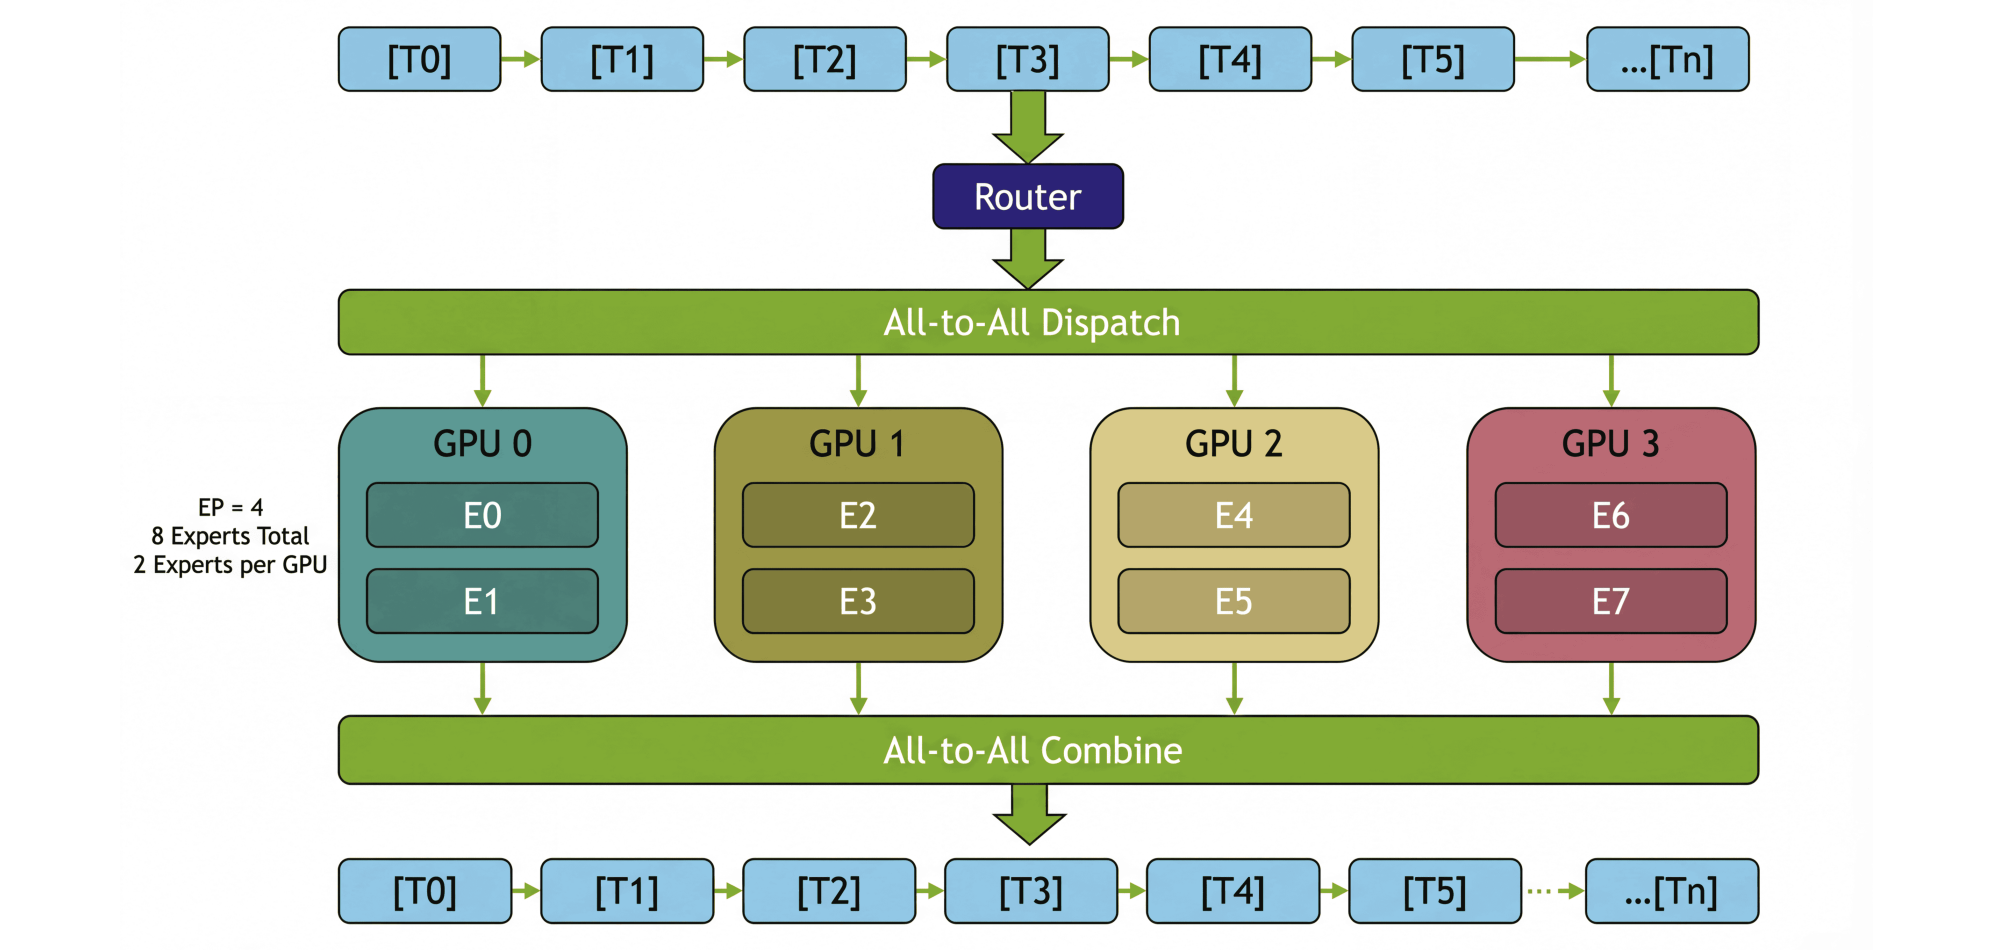
モデルがMoEレイヤーを増やし、各トークンをより多くのエキスパートにルーティングするようになると、all-to-all通信の量が増え、通信がボトルネックになる。
64-wayのエキスパート並列でMoEモデルを学習すると、各MoEレイヤーのエキスパートは64台のGPUに分散される。標準的な8-GPUサーバーでは、all-to-all通信は高速なNVLinkから外れ、はるかに細いInfiniBandインターコネクトを通ることになる。ここでは、最適化されていない通信が学習時間の最大60%を消費しうる(§1.2)。NVL72システムでは64台のGPUがすべて単一のNVLinkドメインに収まるため、通信のボトルネックは実質的に解消される(§9.2.2)。
推論にも高速なノード間ネットワークが要る
ここまで述べてきた並列化の手法は学習専用のものではない。単一のGPUには収まらないモデルを推論エンジンで動かせるようにするだけでなく、モデル並列はスループットの向上にも効く。モデルの重みをより多くのGPUに分割すれば、KVキャッシュ用のメモリが空く。そのぶんエンジンはより多くの同時リクエストを処理したり、より大きなコンテキストウィンドウを扱ったりできる。空くメモリがGPUの枚数以上に増えることもある。vLLMのベンチマークでは、モデルをテンソル並列で2台のGPUに分割したところ、KVキャッシュのブロック数が13.9倍に増え、スループットは3.9倍になった。
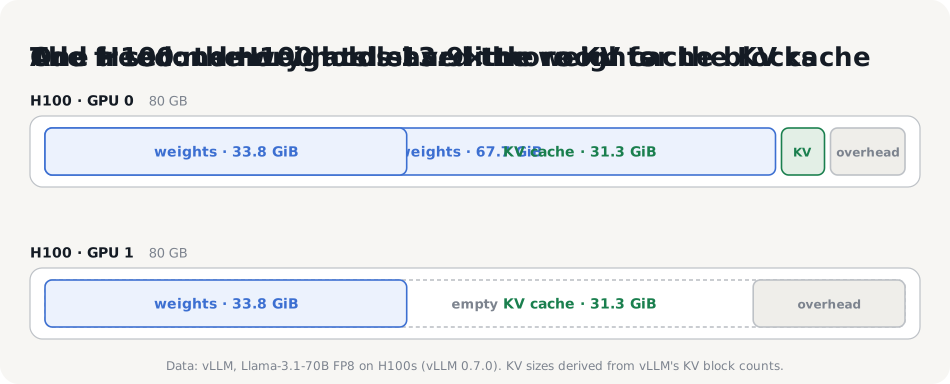
エキスパート並列も同じ理屈だ。エキスパート並列の次数が低いと、各GPUが抱えるエキスパート数が増え、KVキャッシュに使える領域が減る。WideEPは複数ノードにまたがるエキスパート並列構成を指し、GPUあたりのエキスパート数を大きく減らせる。代償はネットワークトラフィックで、all-to-allのたびに通信がより多くのGPUに広がる。標準的な8GPUサーバーでは、エキスパート並列グループは最大8GPUまでしか広げられず、それを超えるとInfiniBand経由の通信になり、GPUあたりの帯域幅は18分の1に落ちる。NVL72は、ラック内の72GPUすべてをNVLinkにつなぐことでこの制限を取り払う。DeepSeek-R1を対話速度で配信する場合、32-wayのエキスパート並列を使うGB200 NVL72は、8-wayまでしか組めない8GPUのB200サーバーに比べてGPUあたり最大4.4倍のスループットを出す。
ラックが新たなサーバーになる
NVL72はNVLinkを単一ノードからラック全体へ広げ、ラック全体を共有メモリを持つ巨大なアクセラレータのように動かす。
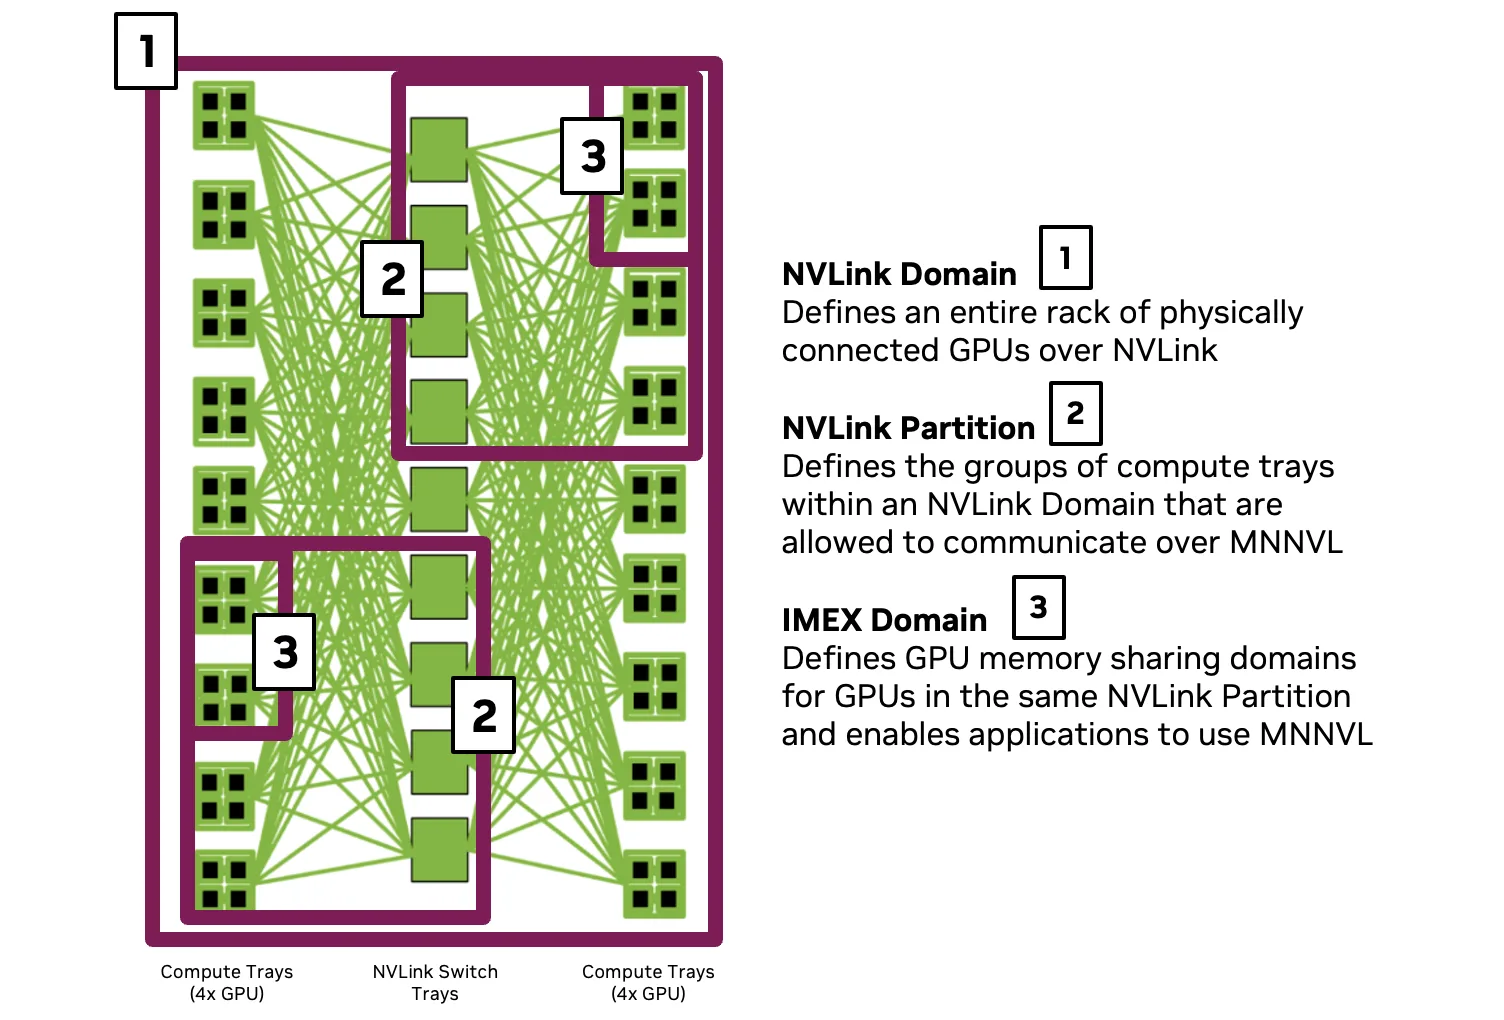
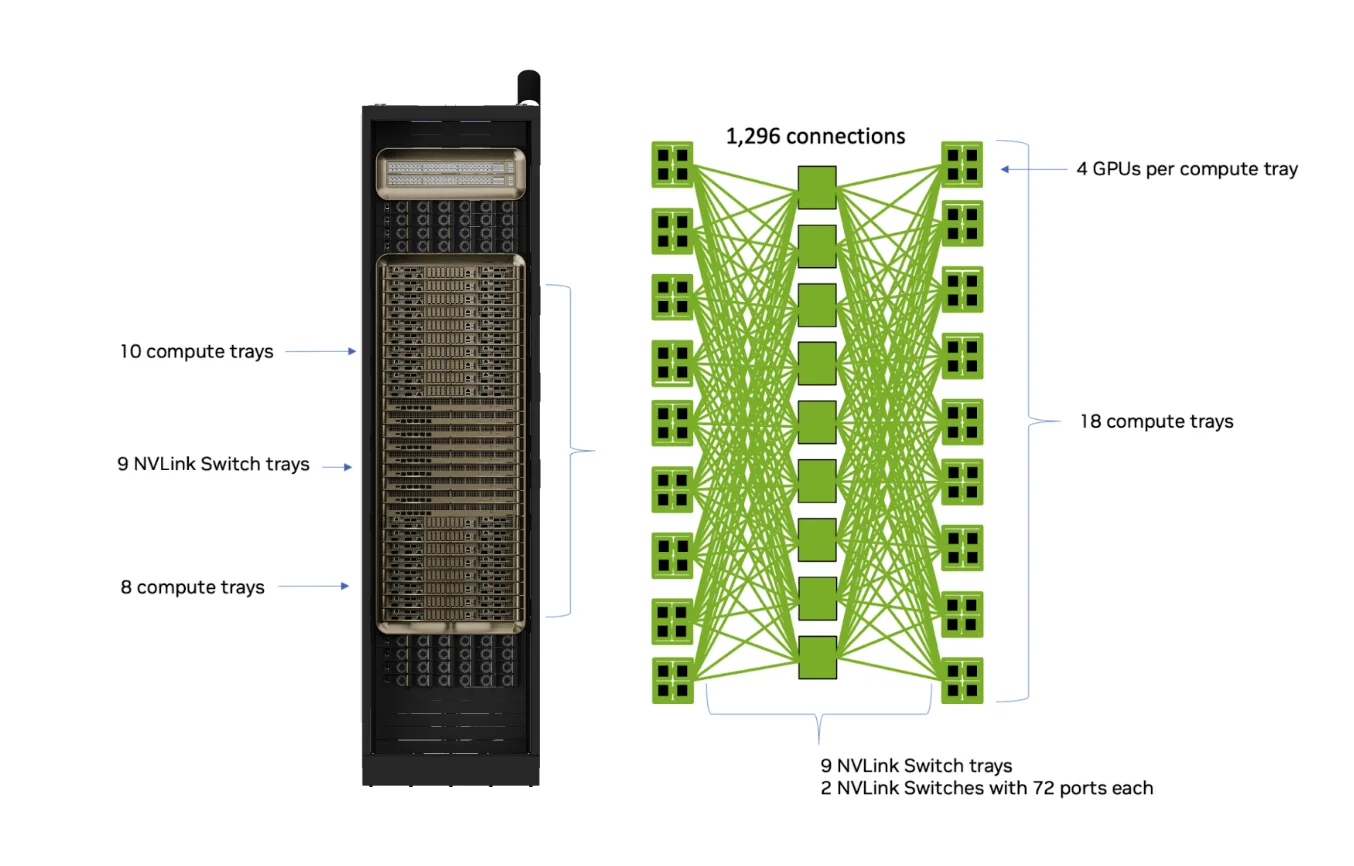
NVL72ラックの各GPUは18個のNVLinkポートを備えており、各ポートが双方向で100 GB/sの帯域を提供するため、GPU1基あたり合計1.8 TB/sとなる。各GPUのNVLinkポートは、ラックのファブリックバックプレーンを担う18基のNVSwitchチップのいずれか1基に接続されている。各NVSwitchチップは、各GPUから1本ずつ、計72本のNVLinkを受け入れるため、ラック内部の総帯域は130 TB/sになる。
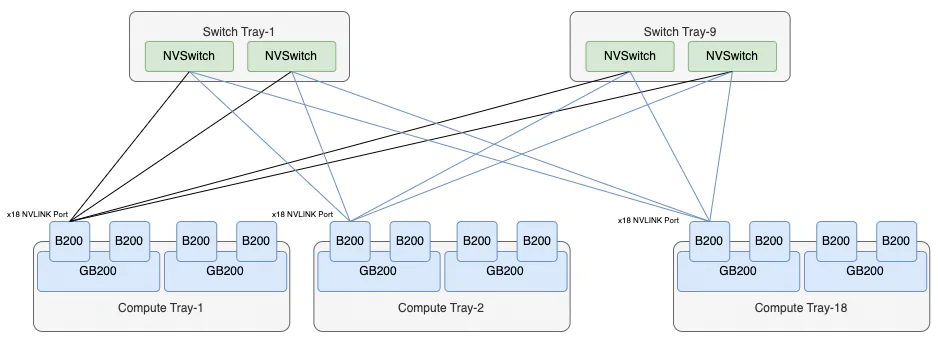
このネットワークトポロジにより、ファブリックは完全なノンブロッキング構成となる。ラック内のどの GPU からでも、他のどの GPU へも均一なレイテンシでデータを送信できるため、大規模な分散 AI ワークロードに最適だ。
ノードを減らすほうが信頼性は上がる
NVL72システムでは、クラスタの使用率を最大化しようと、18ノードのラックを丸ごとワークロードに割り当てたくなる。だが実際には、各ラックに予備ノードを2つほど残しておくほうが、使える容量は増える。
GPUは信頼できない。Metaはギガワット級のスーパークラスタで、信頼性向上にかなりのエンジニアリング工数を投じたうえで、4-GPUノードあたりの平均中断間隔(MTBI)が約490日だったと測定している。NVL72クラスタでは72-GPUのラックが計算の最小単位になるため、ラックを構成する4-GPUノードと比べて障害の影響範囲が18倍に広がる。ラックのMTBIは次式で与えられる。
上の式から、ラックはおよそ 490 / 18 ≈ 27 日ごとに中断されることになる。ジョブに 18 ノードのラックを丸ごと割り当てる場合、こうした中断が起きるたびに、故障ノードが修理されるまでラック全体がスケジュール不能になる。128 ラックのクラスタでは、これはつまり、5 時間おきに 1 つのラックがラック単位のジョブに使えなくなるということだ。
ラックごとに 2 ノードをスペアとして確保しておくと話が変わる。ノードが故障すると同じラック内のスペアが代わりに入るため、単一ノードの故障でラック全体が使えなくなることはなくなる。その代償は、すべてが正常な間、ラックあたり 2 ノードが遊んでいることだ。
このトレードオフを定量化するため、NVIDIA は 128 ラック(2,304 ノード)のクラスタを対象に、使用不能ノードの割合が増えるにつれてスライスサイズの違いが利用可能な容量にどう影響するかをモデル化した。
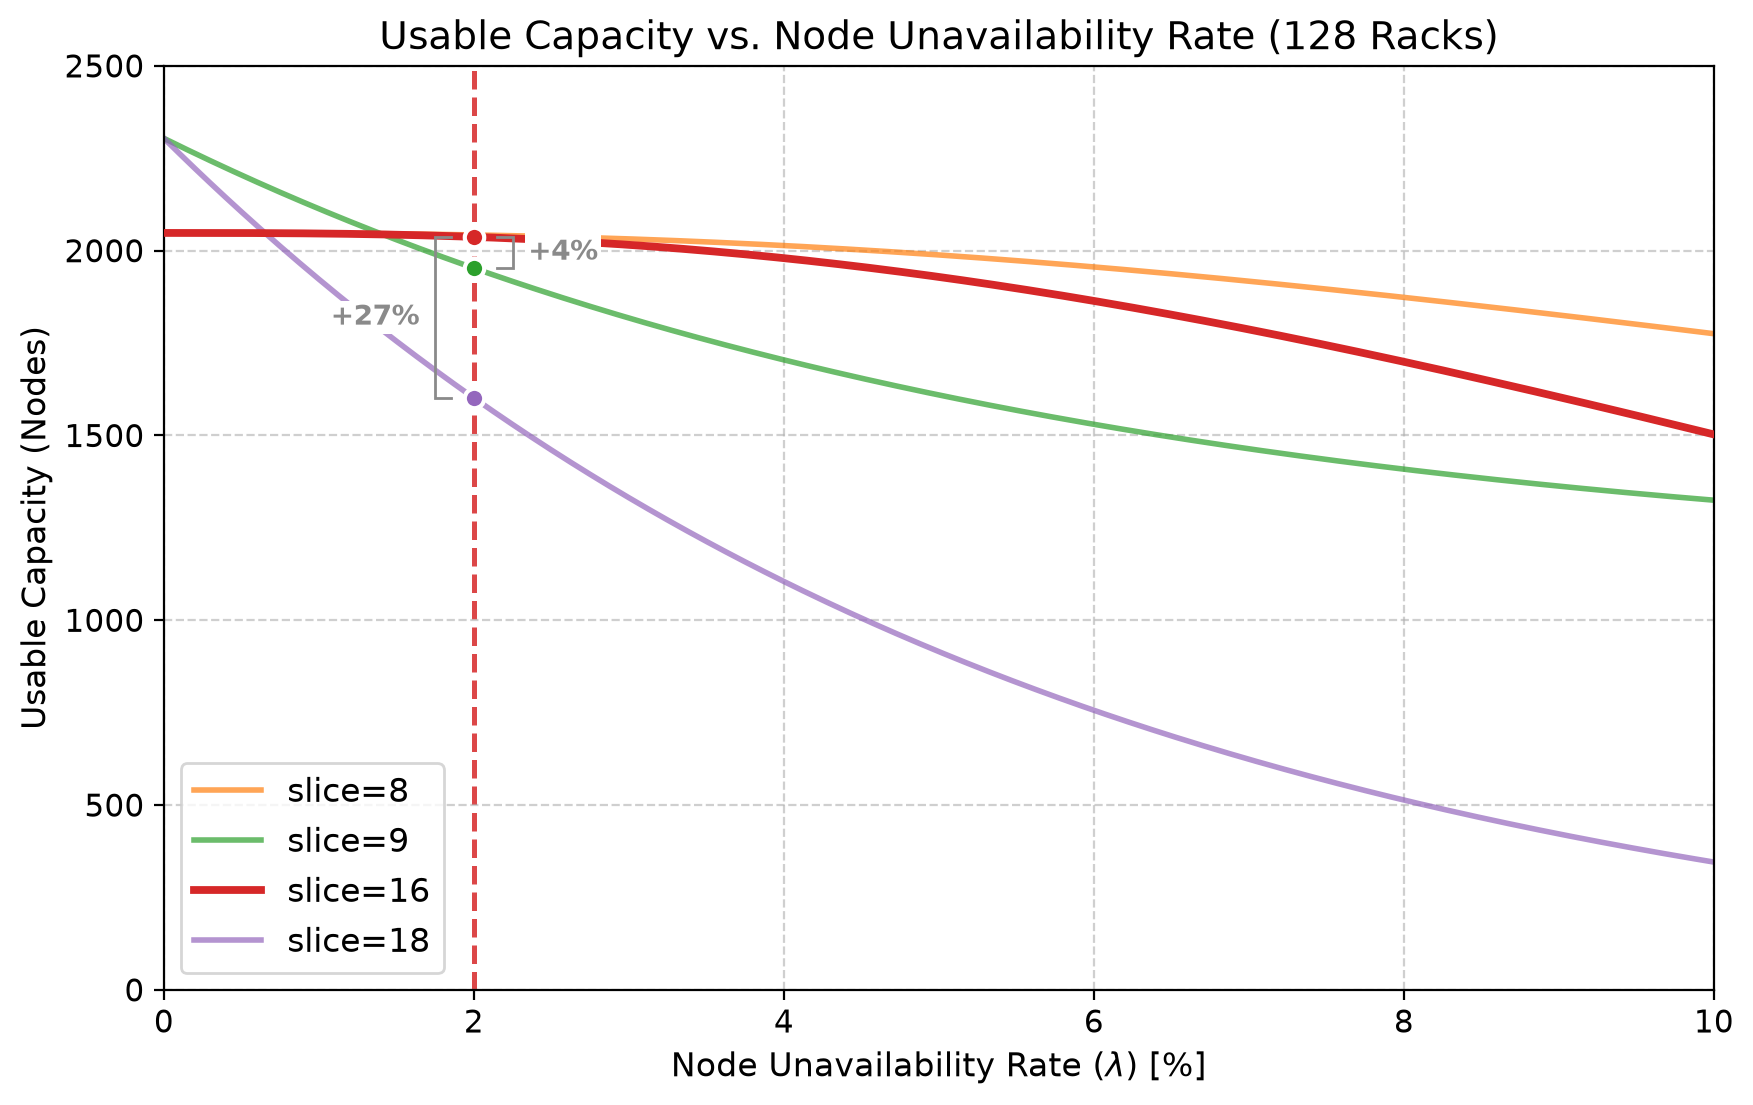
SkyPilotでは顧客のGPUを数万基規模で運用しており、本番のNVL72クラスタでは未稼働率が約2%という実測値が出ている。この数値をもとにNVIDIAのモデルで試算すると、16ノードのスライスは18ノードのスライスより使える容量が27%多い(2,037ノード対1,602ノード)。9ノードのスライスと比べても4%上回る。9ノードのスライスは2つでちょうど1ラックを埋めるが、その代わり1回の故障で半ラックを失う。16ノードのスライスなら、ラック内で最初の2回の故障までは完全に吸収できる。8ノードのスライスと比べると、16ノードのスライスはジョブあたりのNVLinkドメイン内GPU数が2倍になり、ノード未稼働率が約3.3%を超えるまでは使える容量の損失が1%未満で済む。
16ノードは分散AIワークロードにとって自然なサイズでもある。64 GPUは2の冪であり、並列化グループの一般的な構成単位と一致する。
最新のスケジューラはどうやってジョブをNVLink上に保つか
ここまでで、通信量の多い並列化手法がなぜNVLink上にあるべきか、NVL72がどうやってNVLinkを単一ノードからラック全体へ広げるか、そしてラックあたり2ノードの予備を持つ16ノードのスライスがなぜ本番クラスタから最大の使用可能容量を引き出せるかを説明した。SkyPilotはこれを実運用に落とし込んでいる。各スライスを単一ラックに配置し、ハードウェア故障からはその場で復旧し、ジョブの出入りに合わせてラック丸ごとを空けておく。
スケジューラはハードウェアを理解する必要がある
適切なスライスサイズを選ぶのは最初の一歩にすぎない。マルチノードのトレーニング実行で、各スライスが本当に単一ラック上に収まることをどう保証するのか。
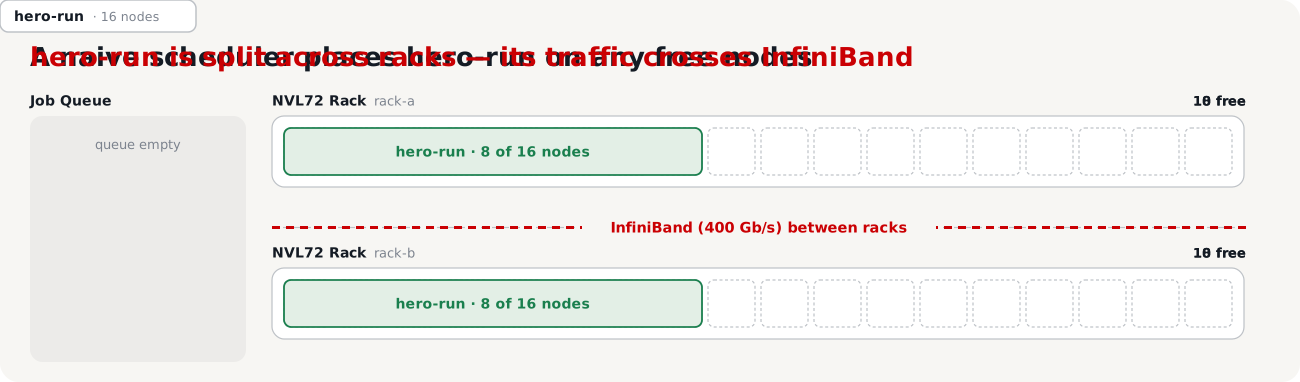
素朴なスケジューラはマルチノードジョブをラックをまたいで分割し、ワーカー間の通信をNVLink(双方向1.8 TB/s)ではなくInfiniBand(片方向400 Gb/s)で行わせてしまう。
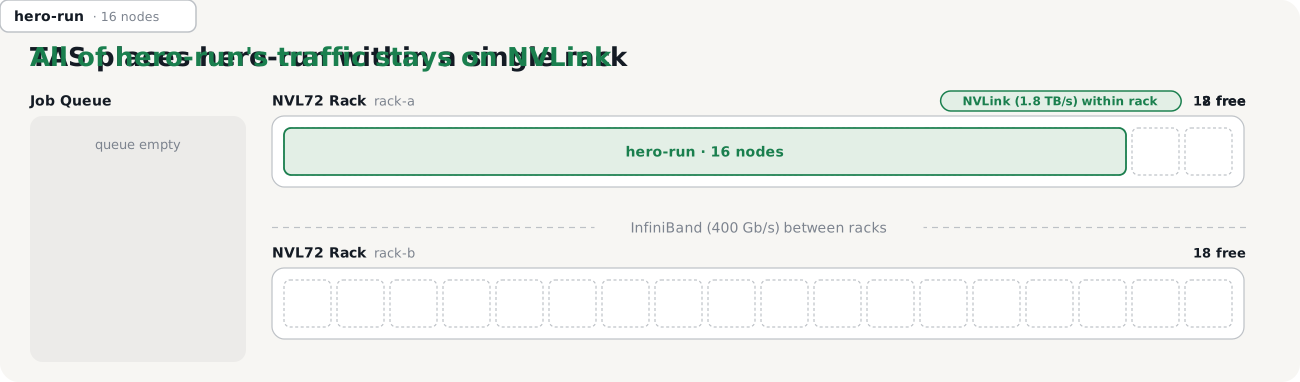
SkyPilotのトポロジー対応スケジューラ(TAS)は、ワーカーが同じラックに配置されることを保証します。
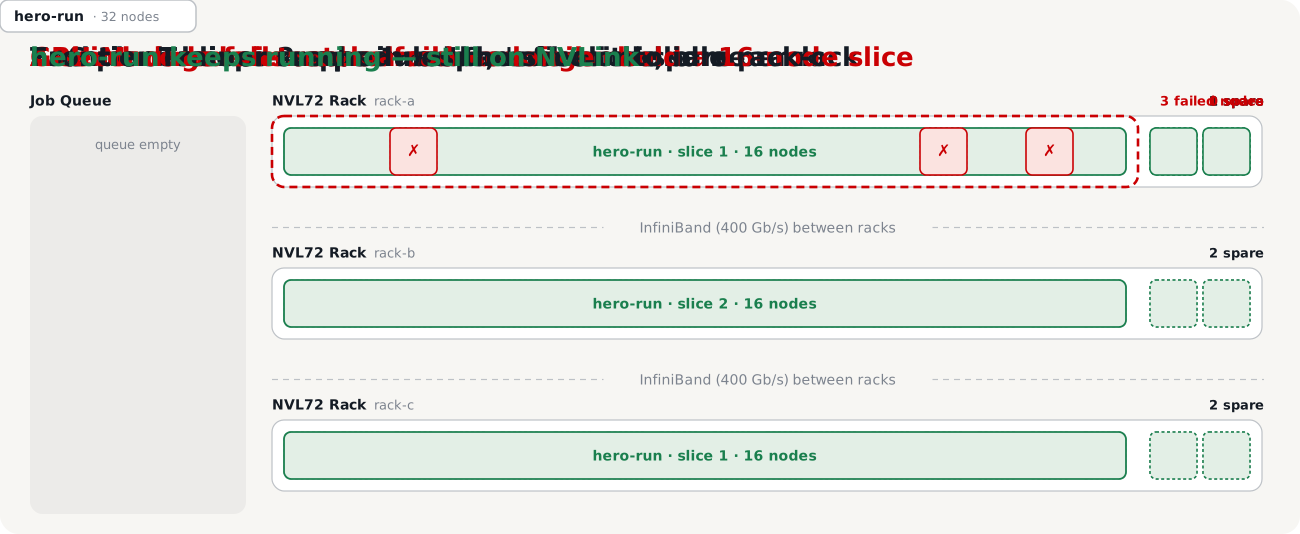
マルチラックのワークロードでは、TAS がジョブを 16 ノード(設定可能)のスライスに分割し、各スライスを予備ノード 2 台付きでそれぞれ別のラックに配置します。その後、SkyPilot の GPU Manager が GPU 障害を検知すると、SkyPilot Frontier Trainer は残りのノードを止めずに、故障したノードを予備の正常ノードとホットスワップできます。同じラックに予備が残っていない場合、Frontier Trainer は故障ラック上のスライスを正常なラックへ再スケジュールします:
スライス単位のスケジューリングがどれだけ効くかを測るため、NVIDIAのGR00Tチームは2つの異なるスケジューリングポリシーを比較した。ヒューマノイドロボット向けマルチモーダル基盤モデルGR00T N1.7の事前学習を、128ノード・512台のGB300 GPUで回したときの結果だ。1回目はノードを任意の数のラックに配置する素朴なスケジューラを使った。2回目は図10のようなラックを意識したスライスベースのポリシーで、ちょうど8ラックに配置した。ラックを意識した配置によってスループットは14.4%向上し、1イテレーションの時間は1.59秒から1.39秒に短縮された。
10,000基のGPUを抱えるクラスタなら、同じ高速化で1トレーニング時間あたり約1.67万ドル、1トレーニング日あたり約40万ドルが浮く。スケジューリングの判断を良くするだけでこれだけ変わる。
フラグメンテーションがラックスケールのジョブを妨げる
実際の大規模クラスタは共有されており、事前学習、RLのロールアウト、バッチ推論といった異種のワークロードが同じリソースを奪い合う。TASはスケジューリング時に同じラック内へワークロードをビンパッキングするが、ジョブはそれぞれ違うタイミングで終わるため、空いたノードがラックをまたいで散らばってしまう。これがフラグメンテーションだ。クラスタ全体ではラックスケールのジョブを動かせるだけの空きGPUがあるのに、ラックをまたいで散らばっているせいでジョブをスケジュールできない。
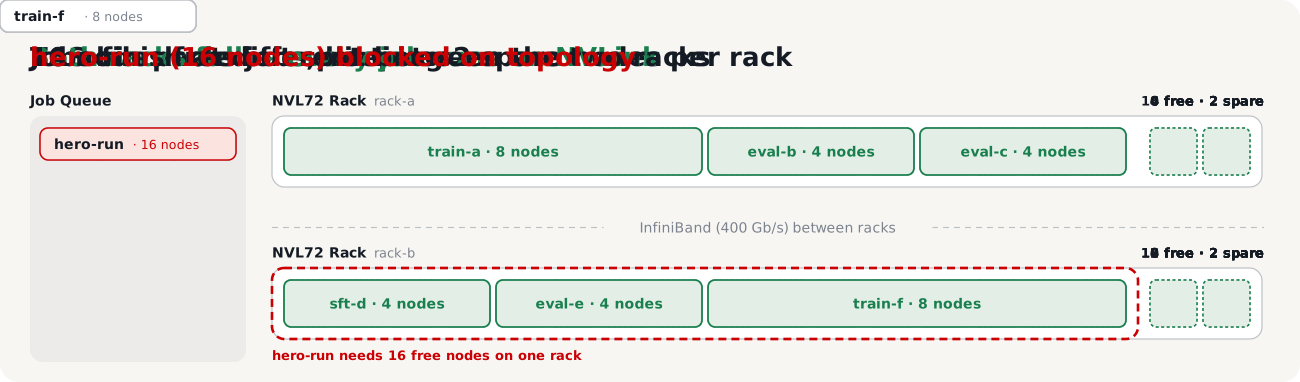
SkyPilotの自動デフラグメンテーション(Auto Defrag)は、この問題に対処するために作られた。ジョブが容量ではなくトポロジーによってブロックされている場合、Auto Defragはラック全体を空けるためにプリエンプトするワークロードのうち、影響が最も小さい組み合わせを探し出す。プリエンプトされたワークロードは他のラックで再スケジュールされ、ブロックされていたジョブをスケジュールできるようになる。
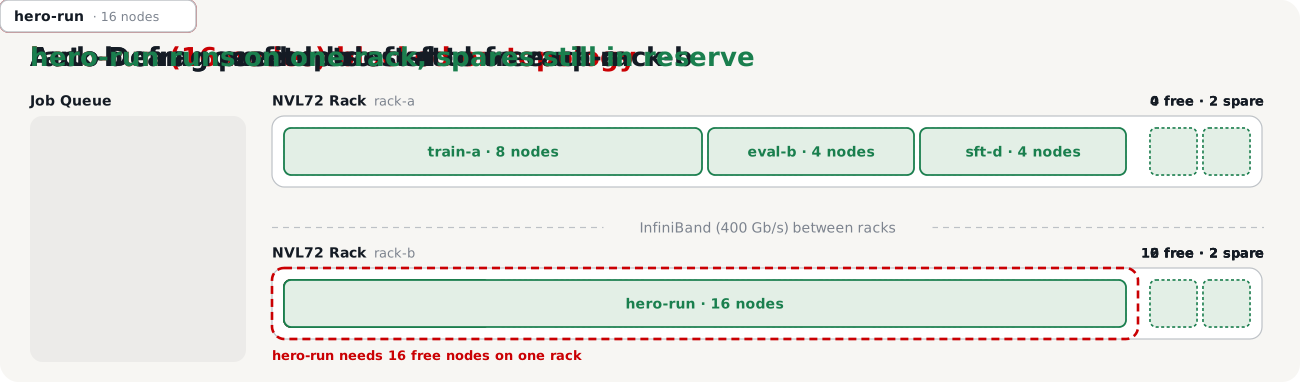
Auto Defrag がプリエンプトするのは、チェックポイントから再開できるマネージドジョブなど、安全に再起動できるワークロードだけです。インタラクティブな開発環境は、管理者が明示的に許可しない限り対象外です。
まとめ
大規模な AI ワークロードは分散実行が前提であり、ネットワークを最も酷使する通信パターンがクリティカルパス上にあります。NVL72 のようなラックスケールシステムは、このボトルネックをハードウェアで解消しようとしていますが、ハードウェアだけでは高速化は保証されません。ラックを意識した配置、ハードウェア障害への耐性、ジョブの出入りに応じた動的な再バランスが必要です。SkyPilot Platform は、このギャップを埋めるために作られています。Topology-Aware Scheduling はマルチノードジョブを NVLink 上に維持し、Frontier Trainer は GPU Manager がハードウェア障害を検知すると正常なスペアと入れ替え、Automatic Defragmentation は共有ラックを大規模ジョブのために空けておきます。NVL72 クラスタの運用でお困りなら、ぜひご相談ください。