Grace Blackwell 需要一个新调度器,同一批机架能多出 27% 可用 GPU
NVL72 把 72 块 GPU 放进一个 NVLink 域,但只有落在同一机架上的作业才吃得到这份带宽。SkyPilot 用拓扑感知调度、故障时就地换备件和自动碎片整理,让多节点训练与推理留在 NVLink 上。
中文
复制
高速互联并非生而平等,用错了代价相当高。同一个分布式训练任务跑在 InfiniBand 上,比跑在 NVLink 上性能下降 43%。
过去,NVLink 只能用于单节点内的通信,多节点 AI 负载不得不走 InfiniBand 或云上的替代方案(AWS 的 EFA、GCP 的 GPUDirect-TCPX)。NVIDIA 的 NVL72 系统打破了这一限制。机架内 72 块 GPU 全部接入统一的 NVLink fabric,跨节点 GPU 之间也能以高出一个数量级的带宽交换数据。
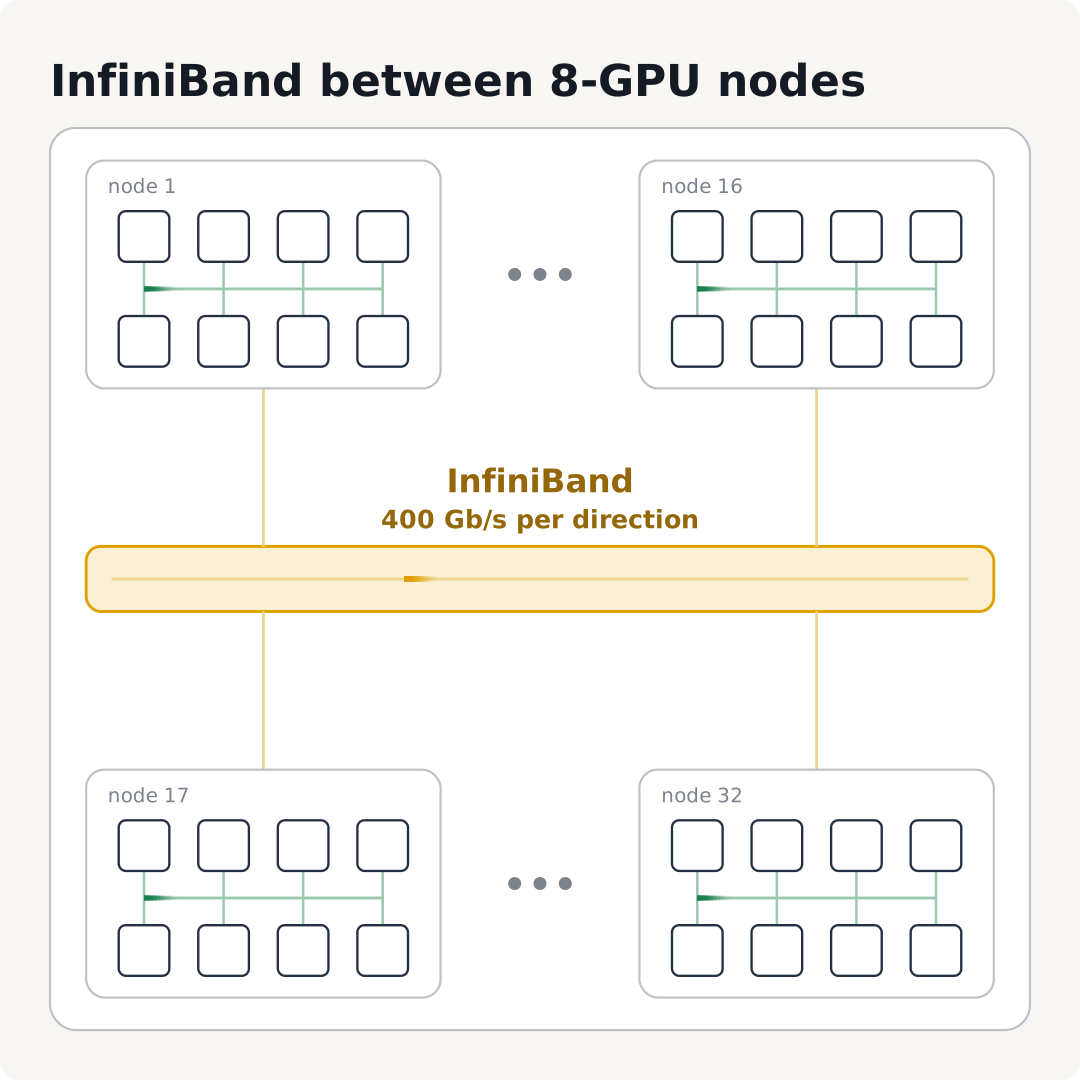
不过,要充分发挥 NVL72 系统的优势,很大程度上取决于工作负载的放置方式。跨机架分布的多节点任务仍然受制于 InfiniBand。硬件故障会让节点下线,任务完成时间又各不相同,空闲容量因此散落在各个机架之间,保持机架局部性越来越难。
这篇博客讨论大规模训练与推理中的通信瓶颈、NVL72 的机架级互联,以及为抵御 GPU 故障而进行的切片规模设计;同时介绍 SkyPilot Platform 如何通过拓扑感知放置、硬件故障原地恢复和共享集群自动碎片整理,让多节点任务保持机架局部。
大规模训练是一个通信问题
前沿训练任务要跑在数千块 GPU 上,这就必须回答两个问题。
- 如何把模型切分到各块 GPU 上,确保它真的能跑起来?
- 在给定算力预算下,能同时运行多少份切分后的模型,从而把训练吞吐拉到最高?
第一个问题通常靠下面几种方式的组合来解决。
- 张量并行(TP):把一层的权重矩阵拆分到多块 GPU 上
- 专家并行(EP):把混合专家(MoE)层的各个专家放到不同的 GPU 上
- 流水线并行(PP):按层把模型拆分到多块 GPU 上
第二个问题的答案决定了数据并行(DP)的度数,也就是同时训练的切分模型副本数,每份副本处理不同的训练数据分片。
在这些并行策略中,张量并行的 all-reduce 和专家并行的 all-to-all 通信模式位于训练的关键路径上,因此最需要留在 NVLink 上(§9.1.2)。
张量并行
张量并行把每一层内部的权重矩阵拆分到多块 GPU 上,每块 GPU 只存储并计算每一层的一个切片。
Transformer 层由自注意力和多层感知机(MLP)两个块组成。每个块的核心都是连续两次矩阵乘法(GEMM)。Megatron-LM(§3)表明,把块内第一个 GEMM 按列切分、第二个 GEMM 按行切分后,GPU 只需在每个块结束时通过一次 all-reduce 同步,位置在第二个 GEMM 之后,而不是每个 GEMM 之后都同步。
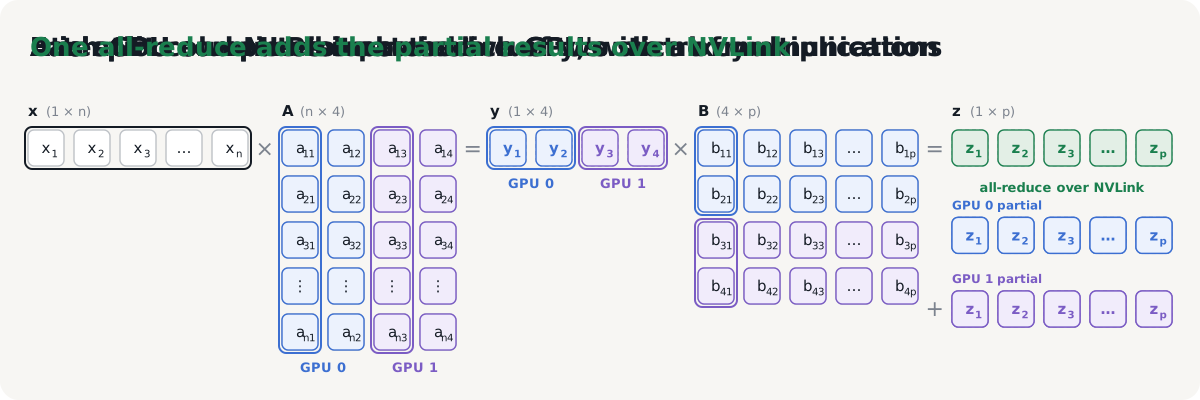
即便做了这项优化,张量并行在前向传播中仍然需要每层 transformer 做两次 all-reduce。这些 all-reduce 位于训练的关键路径上,无法与计算完全重叠。因此张量并行通常只跑在 NVLink 上。Hugging Face 测过,把它从 NVLink 挪到 InfiniBand 后,训练吞吐下降了 43%。
专家并行
在混合专家(MoE)层中,MLP 块被许多更小的 MLP(称为专家)和一个路由器取代,路由器把每个 token 发送给一小部分专家。专家并行把 MoE 层拆开,让这些彼此独立的小专家分布到不同的 GPU 上。
在专家并行下,每个 MoE 层在前向传播中需要两次 all-to-all 通信,dispatch 和 combine。路由器为每个 token 选出 top-k 个专家,把 token 发送到存有这些专家的 GPU 上。随后每块 GPU 用一次分组矩阵乘法,对收到的 token 计算本地专家。最后,专家输出被送回各 token 原来的 GPU 并合并。
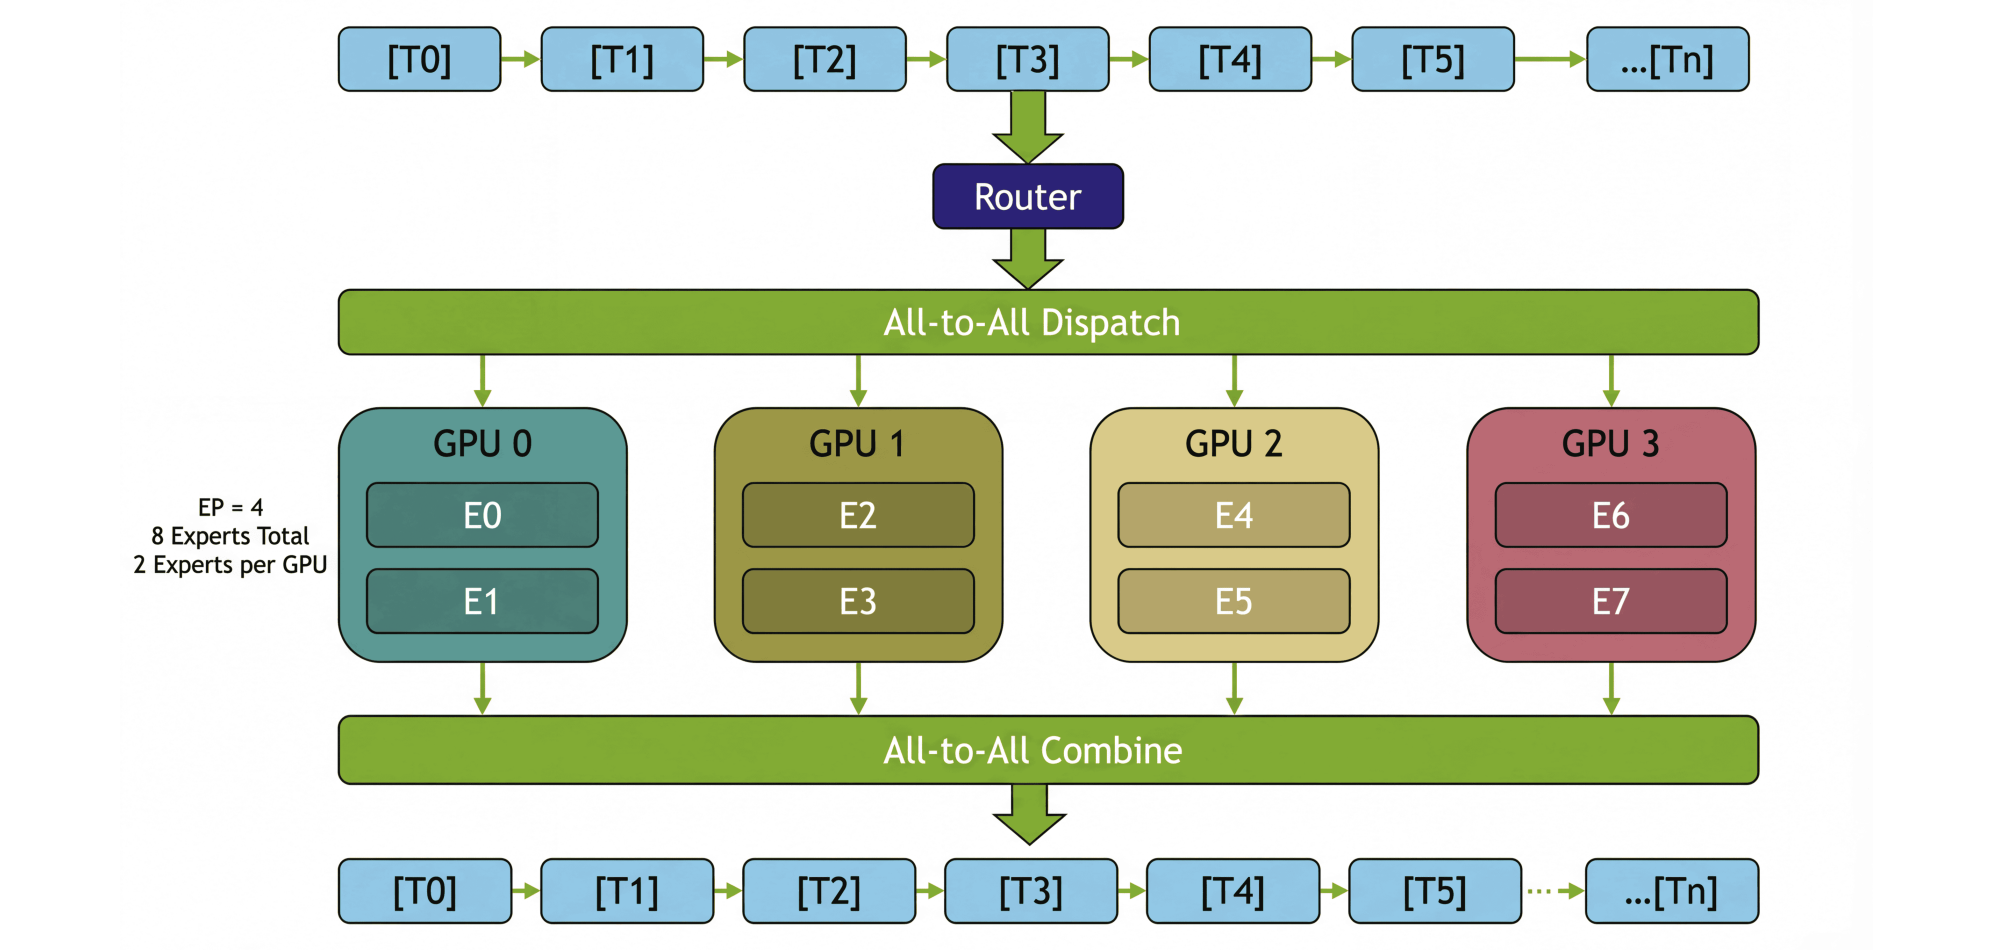
随着模型增加更多 MoE 层、将每个 token 路由到更多专家,all-to-all 通信量随之增长,形成通信瓶颈。
采用 64 路专家并行训练 MoE 模型,意味着每个 MoE 层的专家分散在 64 块 GPU 上。在标准的 8 卡服务器上,all-to-all 流量因此离开高带宽的 NVLink,改走带宽窄得多的 InfiniBand 互联,未经优化的通信可能占用高达 60% 的训练时间(§1.2)。在 NVL72 系统上,这 64 块 GPU 都处于同一个 NVLink 域内,有效消除了通信瓶颈(§9.2.2)。
推理同样需要快速的节点间网络
上文讨论的并行技术并非训练专属。除了让推理引擎能够服务单卡放不下的模型,模型并行还能提升吞吐。将模型权重分散到更多 GPU 上,就能腾出显存供 KV cache 使用,引擎因此可以处理更多并发请求,或支持更长的上下文窗口。有时腾出的显存增长得比 GPU 数量还快。在一项 vLLM 基准测试中,将模型张量并行切分到两块 GPU 上,KV cache 块的数量增加了 13.9 倍,吞吐提升了 3.9 倍。
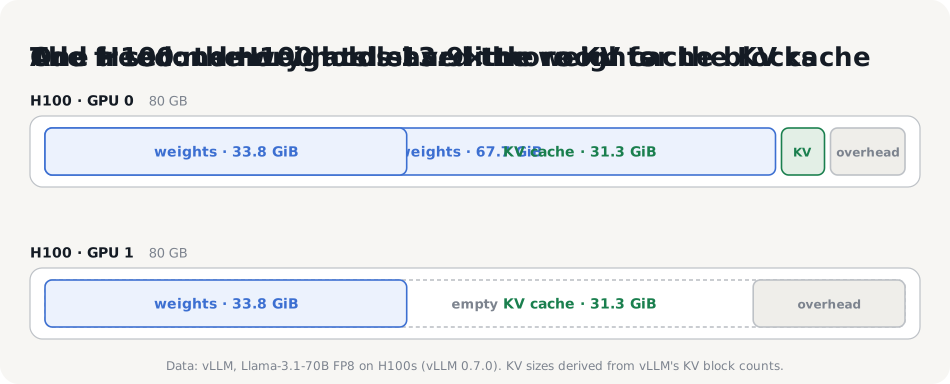
专家并行遵循同样的逻辑。专家并行度低时,每块 GPU 要承载大量专家,留给 KV cache 的空间就少了。WideEP 指跨多个节点的专家并行配置,它能大幅减少每块 GPU 上的专家数量。代价是网络流量,每次 all-to-all 都要跨更多 GPU。在标准的 8-GPU 服务器上,一个专家并行组最多只能覆盖八块 GPU,再往外就得走 InfiniBand,而每 GPU 带宽会下降 18 倍。NVL72 打破了这一限制,让机架内的 72 块 GPU 全部走 NVLink。以交互速度服务 DeepSeek-R1 时,采用 32 路专家并行的 GB200 NVL72,每 GPU 吞吐量最高可达 8-GPU B200 服务器的 4.4 倍,后者最多只能做到 8 路。
机架就是新的服务器
NVL72 把 NVLink 从单个节点扩展到整个机架,于是整个机架就像一台共享内存的巨型加速器。
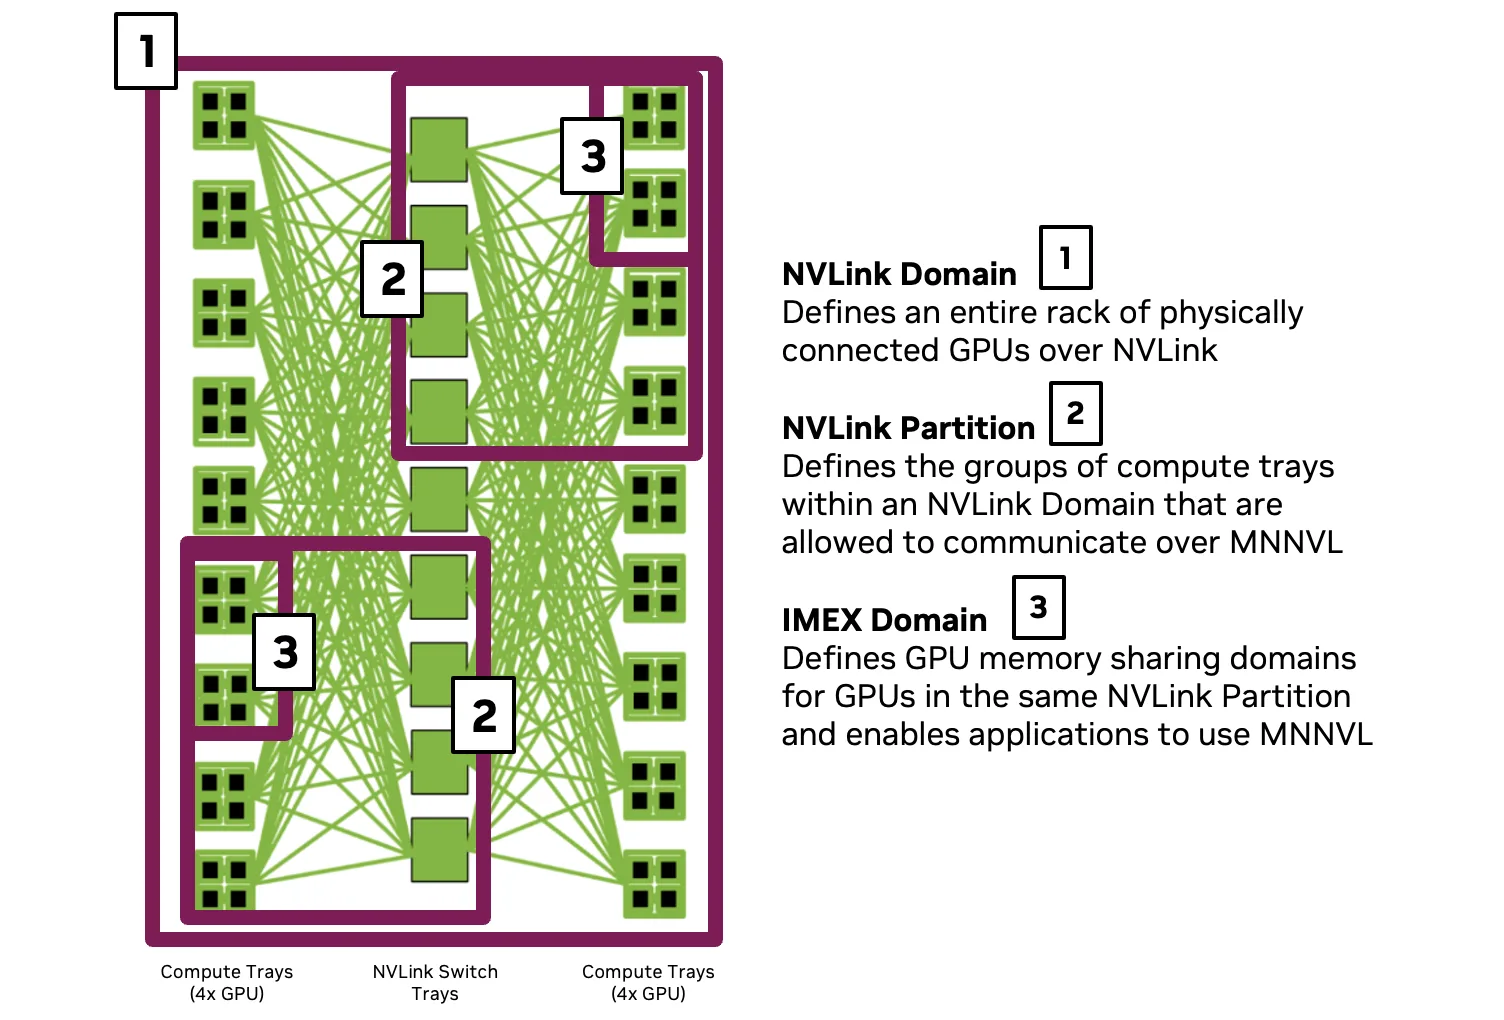
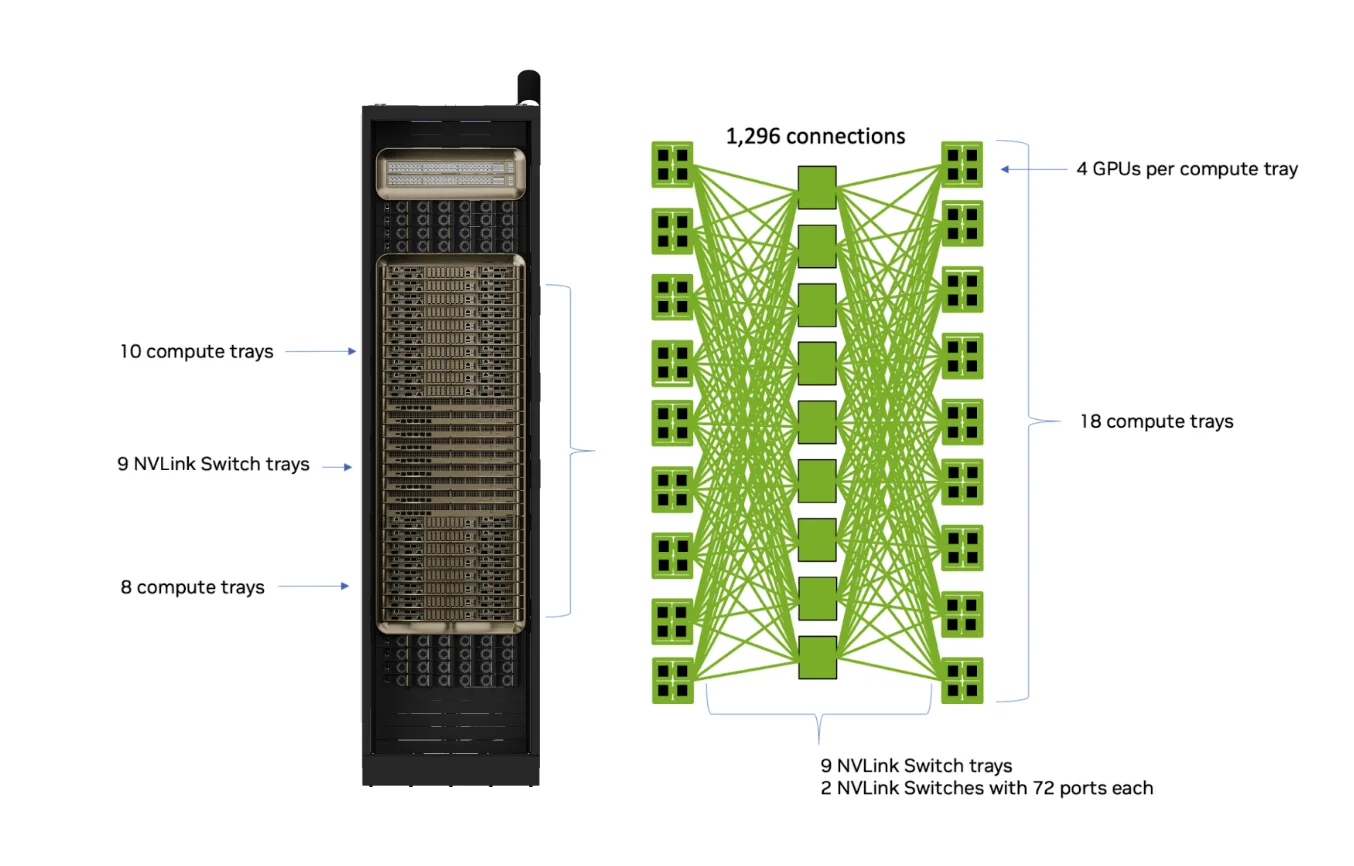
NVL72 机架上的每块 GPU 各有 18 个 NVLink 端口,每个端口提供 100 GB/s 的双向带宽,合计下来每块 GPU 的总带宽为 1.8 TB/s。一块 GPU 上的每个 NVLink 端口都对应机架交换背板上的 18 颗 NVSwitch 芯片之一。每颗 NVSwitch 芯片接入 72 条 NVLink 线路,每块 GPU 各占一条,因此机架内部的聚合带宽达到 130 TB/s。
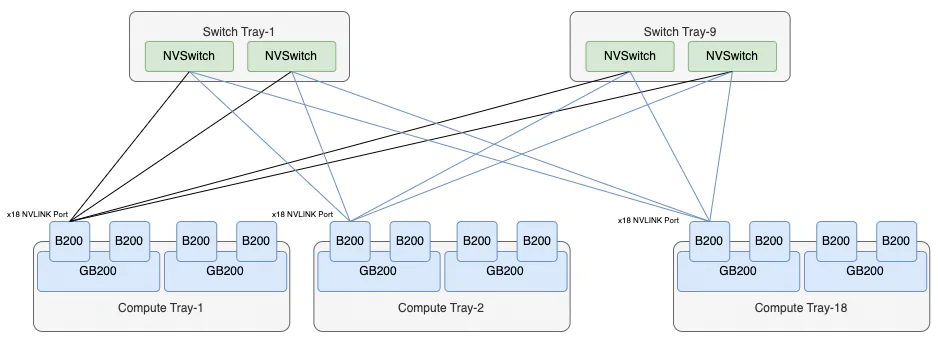
这种网络拓扑确保 fabric 完全无阻塞,也就是说,机架内任意一块 GPU 都能以一致的延迟向其他任意一块 GPU 传输数据,因此非常适合大规模分布式 AI 负载。
少即是多:每个机架少用几个节点,可靠性反而显著提升
使用 NVL72 系统时,人们很容易把整个 18 节点机架全部分配给工作负载,以最大化集群利用率。但在实践中,每个机架留出两个备用节点,反而能让团队从集群中获得更多可用容量。
GPU 并不可靠。Meta 在其吉瓦级超级集群上投入了大量工程力量来提升可靠性,即便如此,每个 4-GPU 节点的平均中断间隔(MTBI)也只有约 490 天。NVL72 集群把 72-GPU 机架作为计算的原子单位,故障影响范围因此比组成机架的 4-GPU 节点扩大了 18 倍。机架的 MTBI 按下面这个式子算。
按上面的公式,一个机架大约每 490 / 18 ≈ 27 天就会被打断一次。如果作业按整机架 18 个节点分配,那么每次中断都会让整个机架无法调度,直到故障节点修好为止。在 128 个机架的集群上,这意味着大约每 5 小时就有一个机架无法承接整机架作业。
每个机架预留两个节点作备用,情况就不一样了。节点故障时,同机架的备用节点顶上,单个节点故障不再让整个机架报废。代价是一切正常时,每个机架有两个节点闲着。
为了量化这一取舍,NVIDIA 在 128 机架(2,304 个节点)的集群上建模了不同切片大小如何影响可用容量,并考察了不可用节点占比上升时的变化。
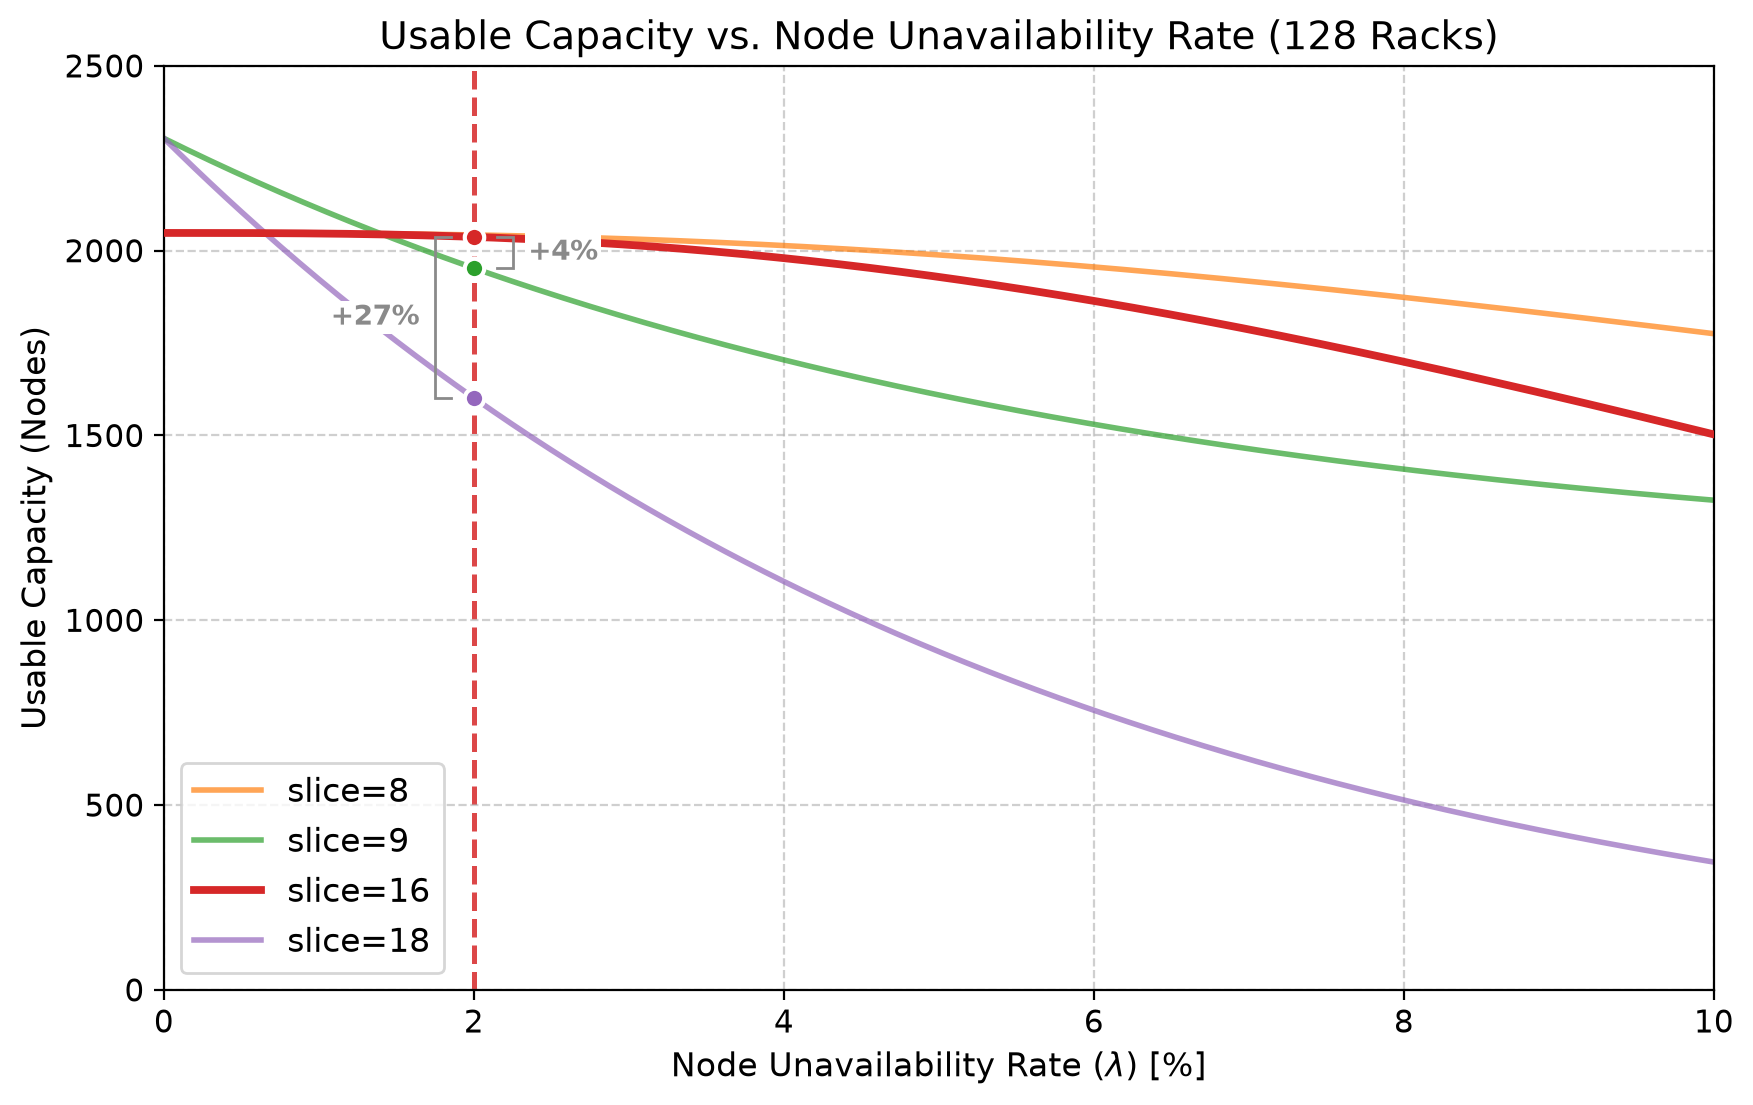
在 SkyPilot,我们管理着客户数以万计的 GPU;在生产环境的 NVL72 集群上,我们实测的不可用率约为 2%。按这一比例,NVIDIA 的模型显示,16 节点切片比 18 节点切片多提供 27% 的可用容量(2,037 对 1,602 个节点)。16 节点切片也比 9 节点切片高出 4%,尽管两个 9 节点切片恰好填满一个机架。使用 9 节点切片时,每次故障都会损失半个机架,而使用 16 节点切片时,一个机架内的前两次故障可以被完全吸收。与 8 节点切片相比,16 节点切片使每个作业在每个 NVLink 域内获得的 GPU 数量翻倍,而在节点不可用率超过约 3.3% 之前,损失的可用容量不到 1%。
16 节点对分布式 AI 负载来说也是一个自然的尺寸。64 个 GPU 是 2 的幂,这与并行组的常见规模相吻合。
现代调度器如何让作业留在 NVLink 上
至此,我们已经说明了为什么通信最密集的并行技术应当跑在 NVLink 上、NVL72 如何把 NVLink 从单节点扩展到整个机架,以及为什么每机架配两个备用节点的 16 节点切片能从生产集群中榨出最多的可用容量。SkyPilot 的做法是把每个切片放在单个机架上,硬件故障时就地恢复,并在作业来去之间保持整个机架空闲。
调度器需要理解硬件
选对切片大小只是第一步。研究者如何确保多节点训练任务的每个切片都真正落在同一个机架上?
简单的调度器会把多节点作业拆散到不同机架上,迫使 worker 通过 InfiniBand(单向 400 Gb/s)而不是 NVLink(双向 1.8 TB/s)通信。
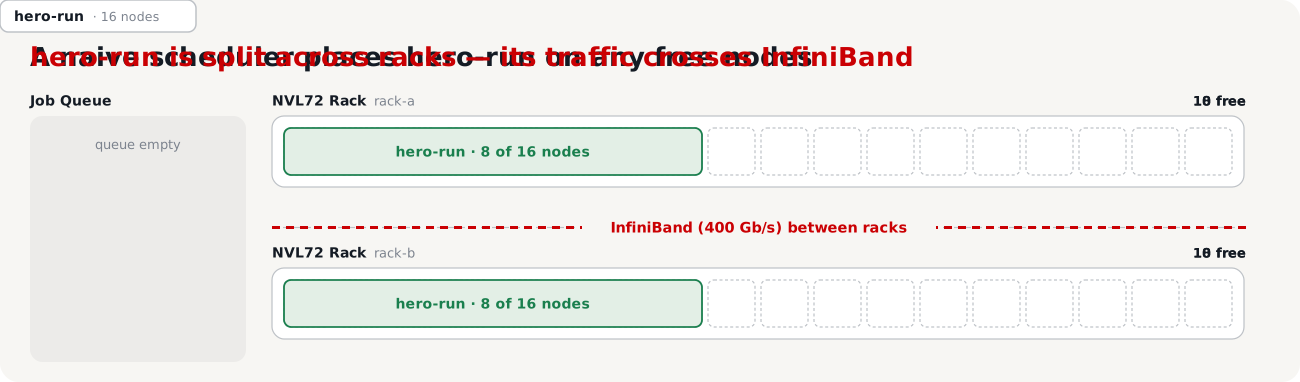
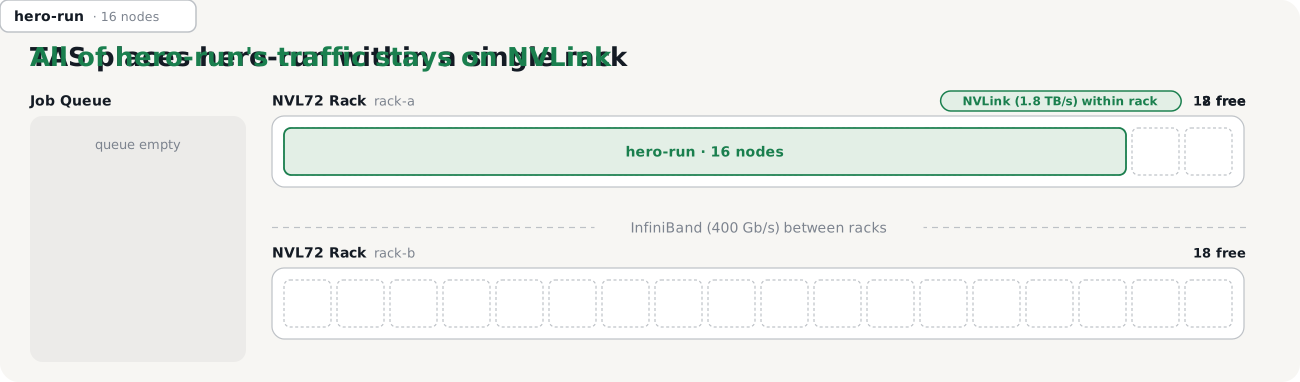
SkyPilot 的拓扑感知调度器(TAS)确保所有 worker 位于同一机架。
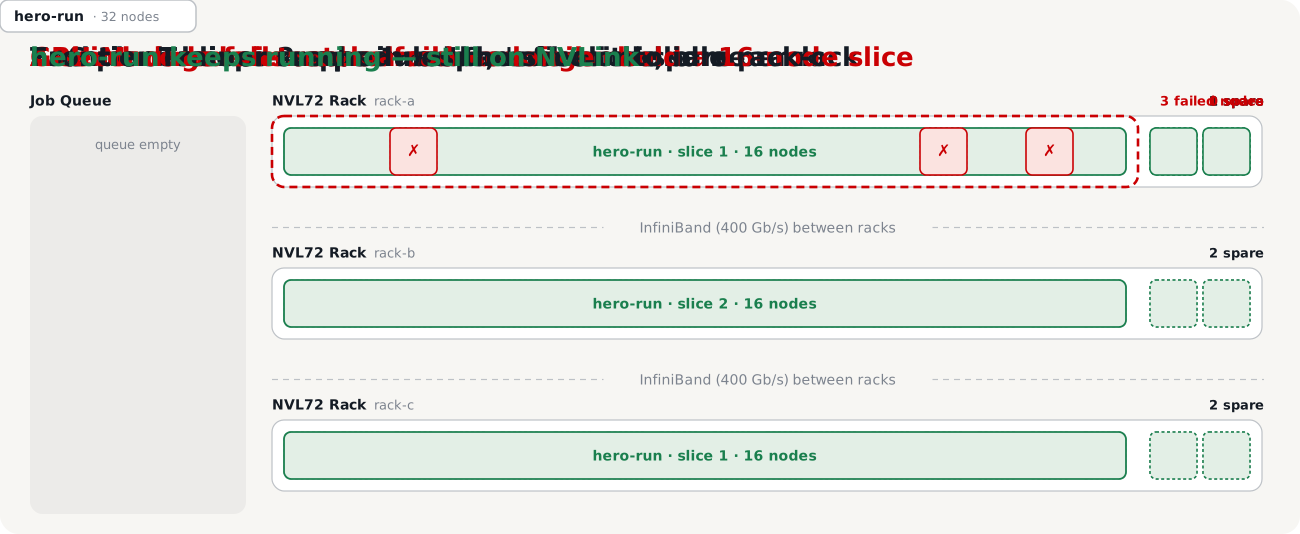
在多机架工作负载中,TAS 会将作业切分为 16 节点(可配置)的分片,每个分片放置于独立机架,并预留两个备用节点。当 SkyPilot 的 GPU Manager 检测到 GPU 故障时,SkyPilot Frontier Trainer 可用预留的健康节点热替换故障节点,其余节点继续运行、不中断。如果同一机架内已无备用节点,Frontier Trainer 会将故障机架上的分片重新调度到健康机架。
为了量化基于切片的调度所带来的影响,NVIDIA 的 GR00T 团队在 GR00T N1.7 的预训练过程中对比了两种不同调度策略的效果。GR00T N1.7 是面向人形机器人的多模态基础模型,训练在 128 个节点、共 512 块 GB300 GPU 上进行。第一次运行采用朴素调度器,将节点随意分散到任意数量的机架上;第二次运行则采用与图 10 类似的机架感知、基于切片的策略,将任务恰好放置在 8 个机架上。机架感知的放置方式将吞吐量提升了 14.4%,每次迭代的耗时从 1.59 s 缩短到 1.39 s。
在 10,000 块 GPU 的集群上,同样的加速效果相当于每训练小时省下约 1.67 万美元,每个训练日大约 40 万美元,只靠把调度决策做得更好。
碎片化让机架级作业无法调度
在实际使用中,大型集群是共享的,预训练、RL rollout、批量推理等异构工作负载都在争抢同一批资源。TAS 在调度时会将工作负载装箱到同一机架内,但各作业的完成时间不同,空闲节点便散落在各个机架上。这就是碎片化。集群的空闲 GPU 数量足以运行一个机架级作业,但这些 GPU 分散在不同机架,作业因此无法被调度。
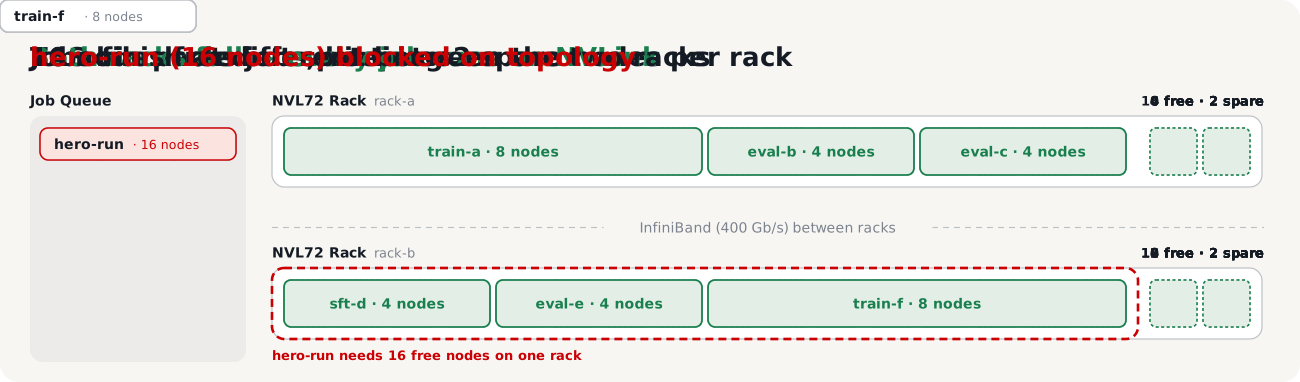
SkyPilot 的自动碎片整理(Auto Defrag)正是为解决这一问题而设计的。当某个作业因拓扑结构限制而非容量不足而无法调度时,Auto Defrag 会找出对现有负载干扰最小的一组工作负载进行抢占,从而腾出一整个机架。这些被抢占的工作负载会被重新调度到其他机架上,原本被阻塞的作业因此得以调度。
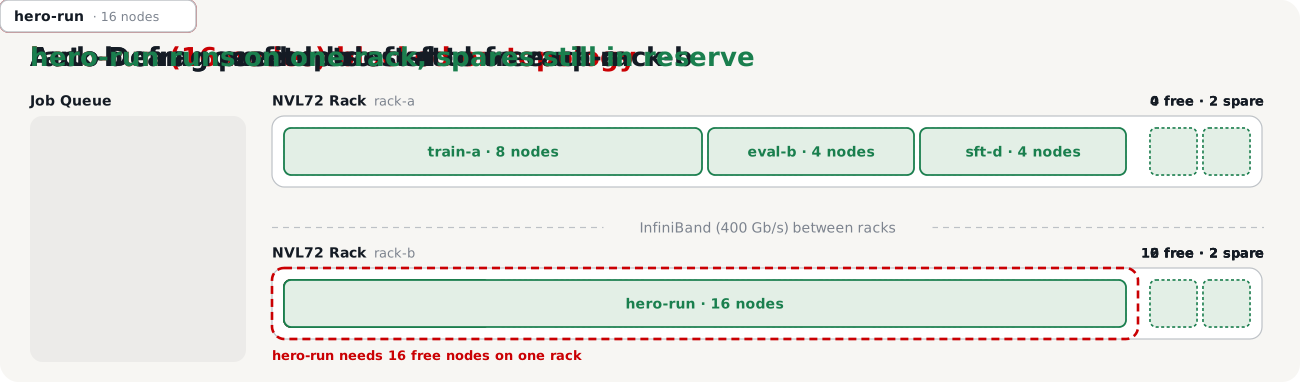
Auto Defrag 只会抢占那些可以安全重启的工作负载,例如从 checkpoint 恢复的托管作业。交互式开发环境不在其列,除非管理员明确将其纳入。
结论
大规模 AI 工作负载天生就是分布式的,而其中网络开销最大的通信模式恰恰位于关键路径上。NVL72 这类机架级系统试图用硬件解决这一瓶颈,但光有硬件并不能保证加速效果。这类系统需要机架感知的放置策略、对硬件故障的容错能力,以及随作业增减而动态调整的再平衡机制。SkyPilot Platform 正是为填补这一空白而打造。Topology-Aware Scheduling 让多节点作业留在 NVLink 上,GPU Manager 检测到硬件故障时 Frontier Trainer 会换上健康的备用节点,Automatic Defragmentation 则为大作业腾出共享机架的空位。如果你正在管理 NVL72 集群,欢迎与我们聊聊。