hutch:Emacsでのローカルコードレビュー
hutchはmagitのローカルコードレビューインターフェースです。作者はコメント追跡ではなくパッチをレビューすることを主張し、ホスティングプラットフォームが強いるコメント中心のワークフローがローカル開発に適さない理由を説明しています。
日本語
コピー
2026 年 10 月 5 日
まともな仕事をしてからもう四年になる。先月、ずっと続けてきたスタートアップを畳んだ。この数年はほとんどを AI agent のフロンティアなバックエンドで過ごしてきた。ようやく追いついたところだ。coding agent が本格的に飛び始めたのはこの500 日ほどの話で、しかも以前の指示ベースのやり方より本当に仕事をしてくれる。
タスクをこなす自動機械よりも、AI の教育面のほうが好きだというのは変わらないが、後者はコードレビューまわりのツール一式を生み出した。書くことやデプロイだけではない。レビュー agent の決まり文句はこうだ。agent が同僚より先に割り込み、あなたがまだ起きていなくてスマホにも触れていないうちに、二十個の pull request にくだらない指摘を撒き散らす。それが効くこともあるし、ある種の人には効く。だが、俺のようにコードがユーザーの元へ出る前に今でも人間が目を通す立場なら、その人間と、その時間を尊重したほうがいい。破壊側の端に立っていようと、古臭い側の端に立っていようと、これは変わらない。
ここまで長々と書いたのはつまり、agent がこれからどっちの方向に強くなろうと、俺たちが何かを気にかけているままでいたいということだ。「気にかける」を形式化する——高忠実度の agent 指示や prompt を用意するとか、より高度な趣味の良さを演出するとか——のではなく、ただ一言、おい、俺はここにいるぞ、これは全部分かってると言うだけの、それだけのことだ。
というわけで、長年の emacs ユーザーとして、また LLM と agent と coding harness をテキストバッファに詰め込む試み(!)を持ってきた:Hutch だ。Magit にヒントを得た小さなコードレビュー UI で、標準的な Magit の commit-push ワークフローにローカルで馴染む。上流が生み出した負担を少しでも分け合えればと思う。
はじめかた #
Magit を開いて dispatcher のバインドキー(通常は d)を押すと、DWIM バインドの隣に Hutch code review のアクションが増えているのが見える。Hutch は三つのスコープで動く。ステージ済みの変更、未プッシュの変更、そして現在のブランチと作業ブランチの間の変更だ。デフォルトはステージ済みの変更だけを扱う。これが一番役に立つからだ。
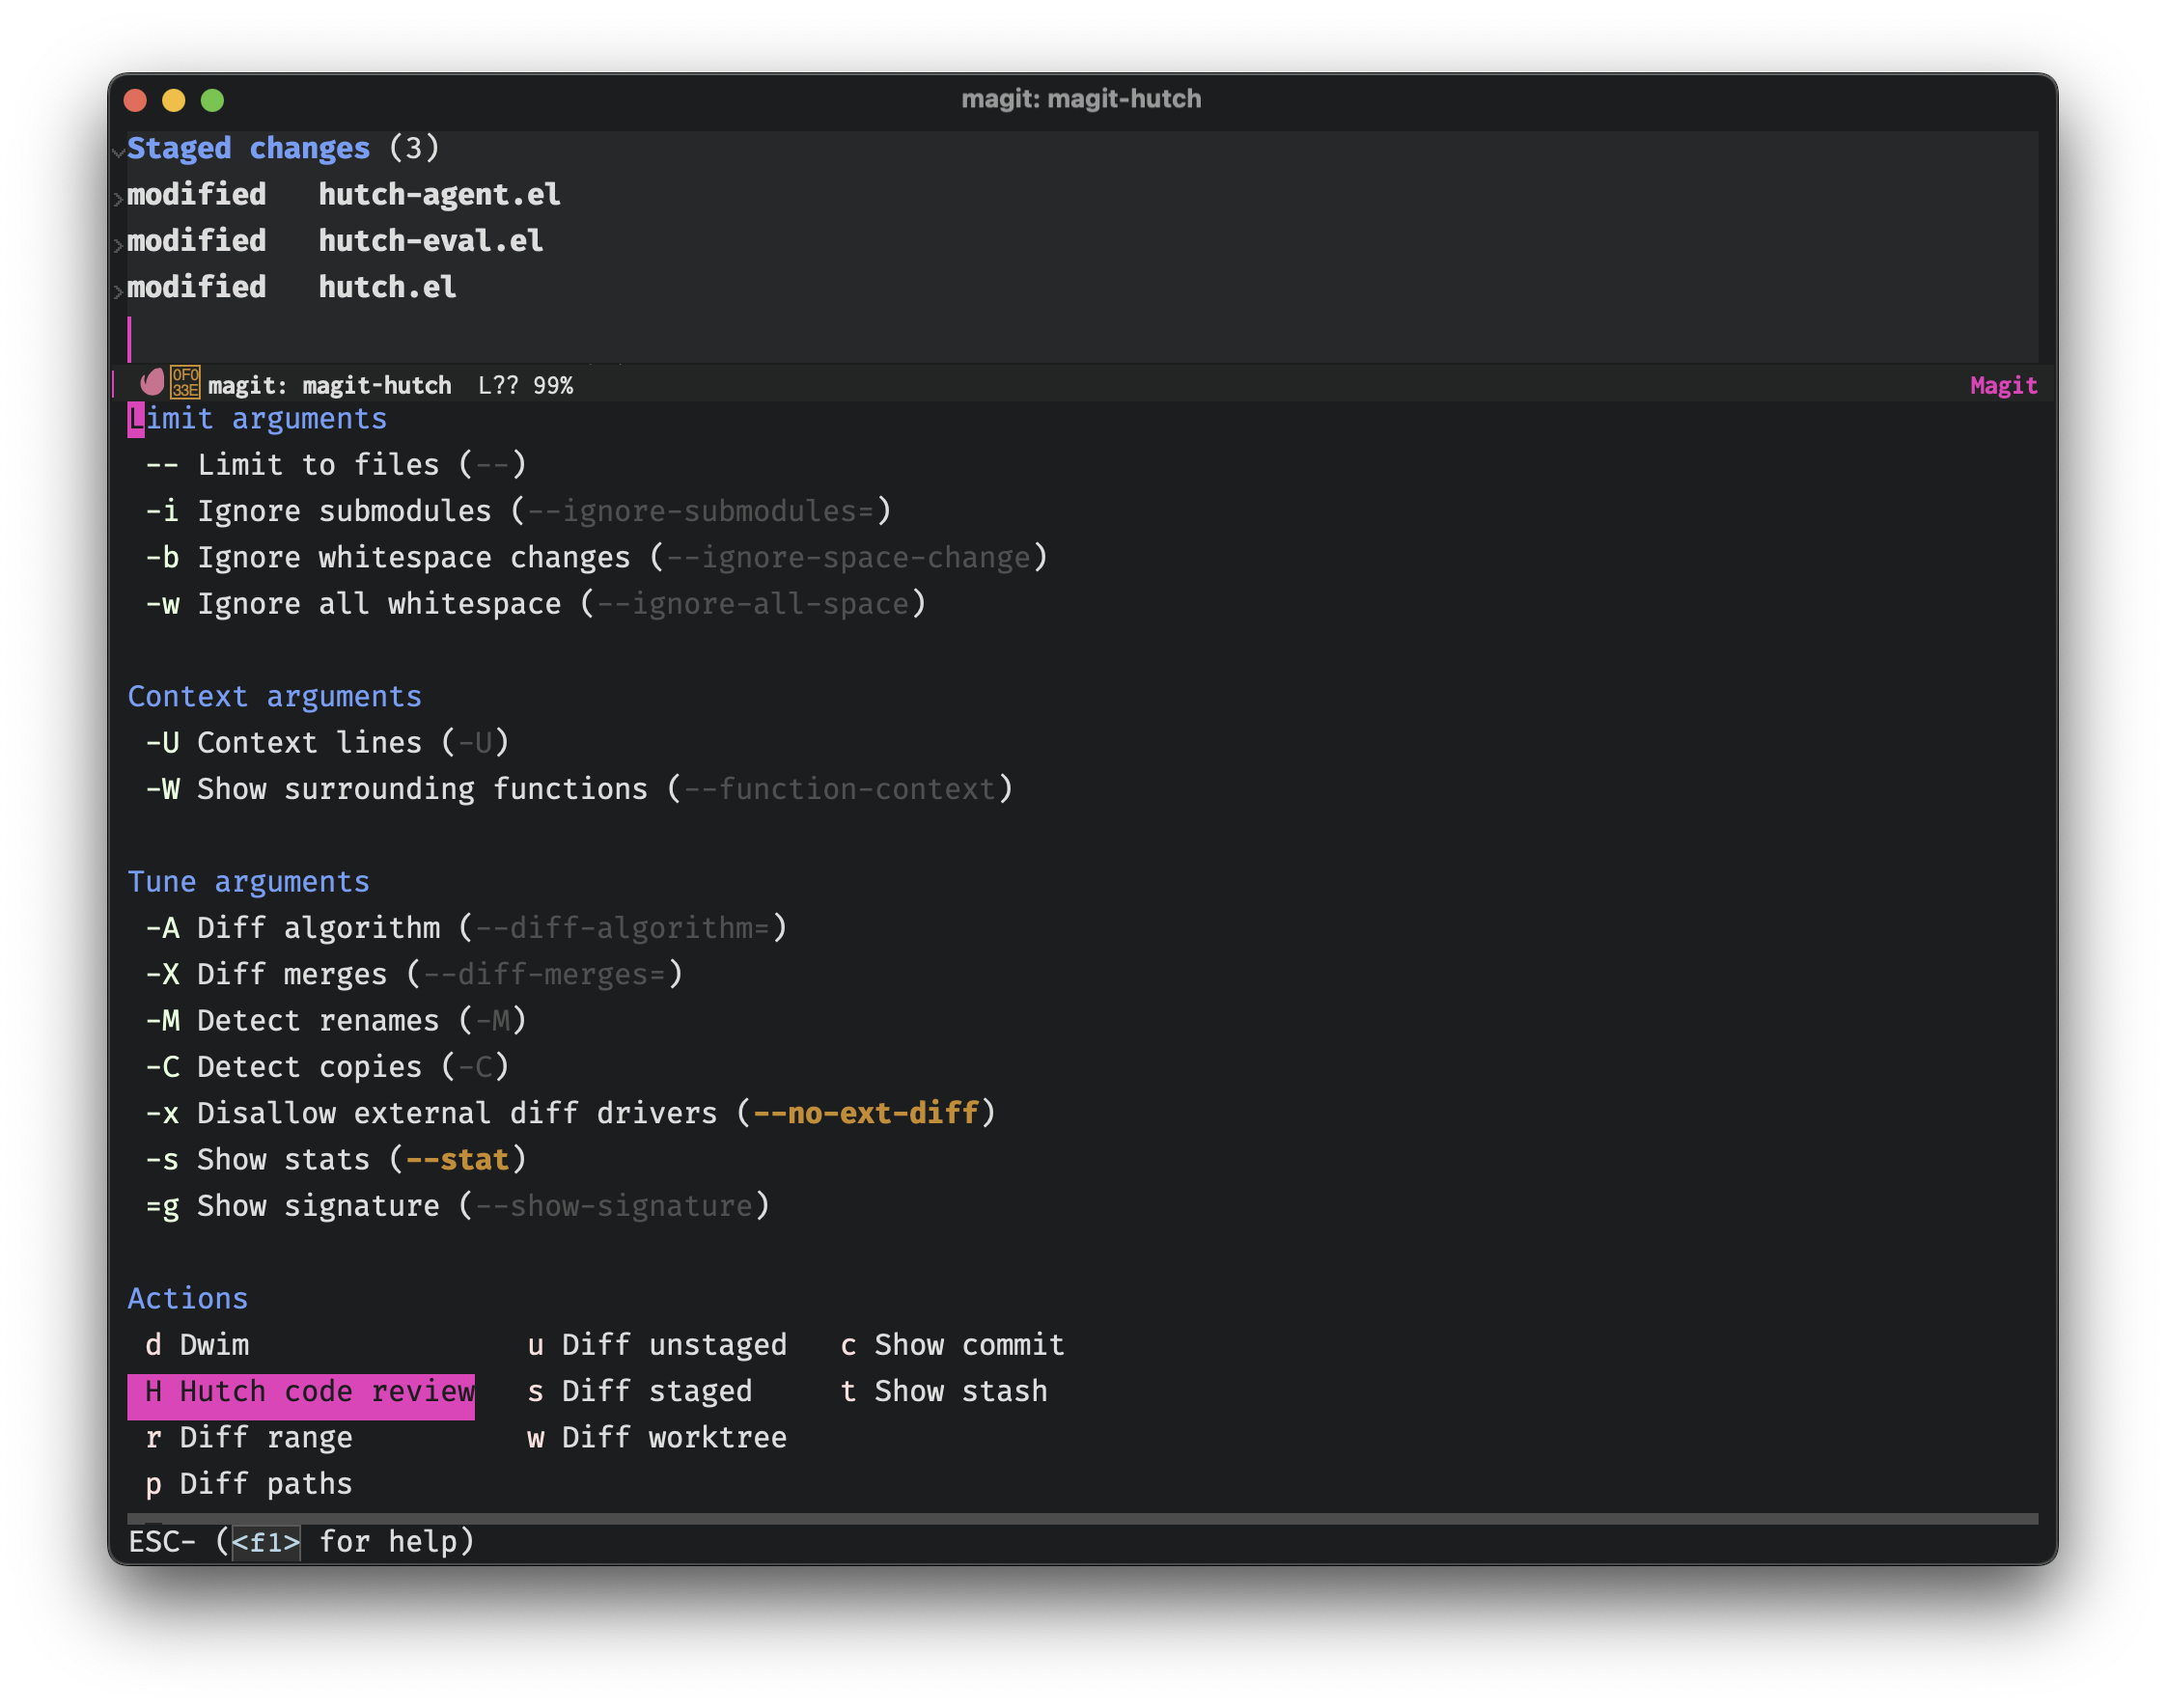
レビューが始まると、新しい *magit-hutch: code review* buffer にきれいなプログレスバーが出て、すべての findings 1 が片付くまで続く。この buffer は読み取り専用だが、あらかじめバインドされた操作は使える。
各 finding には種類(suggestion、comment、LGTM)、ファイル名、該当行番号、タイトル、説明が含まれる。suggestion にはさらに patch diff が付く。Hutch は Magit と Transient を使ってこれらのメニューを描画しているので、ほとんど標準のインターフェースのように使える。キーボード駆動のサブメニュー、diff の色分けとハイライト。suggestion が特別なのは、適用できるからだ。ある suggestion を適用対象としてマークするには、m でキューに入れる。
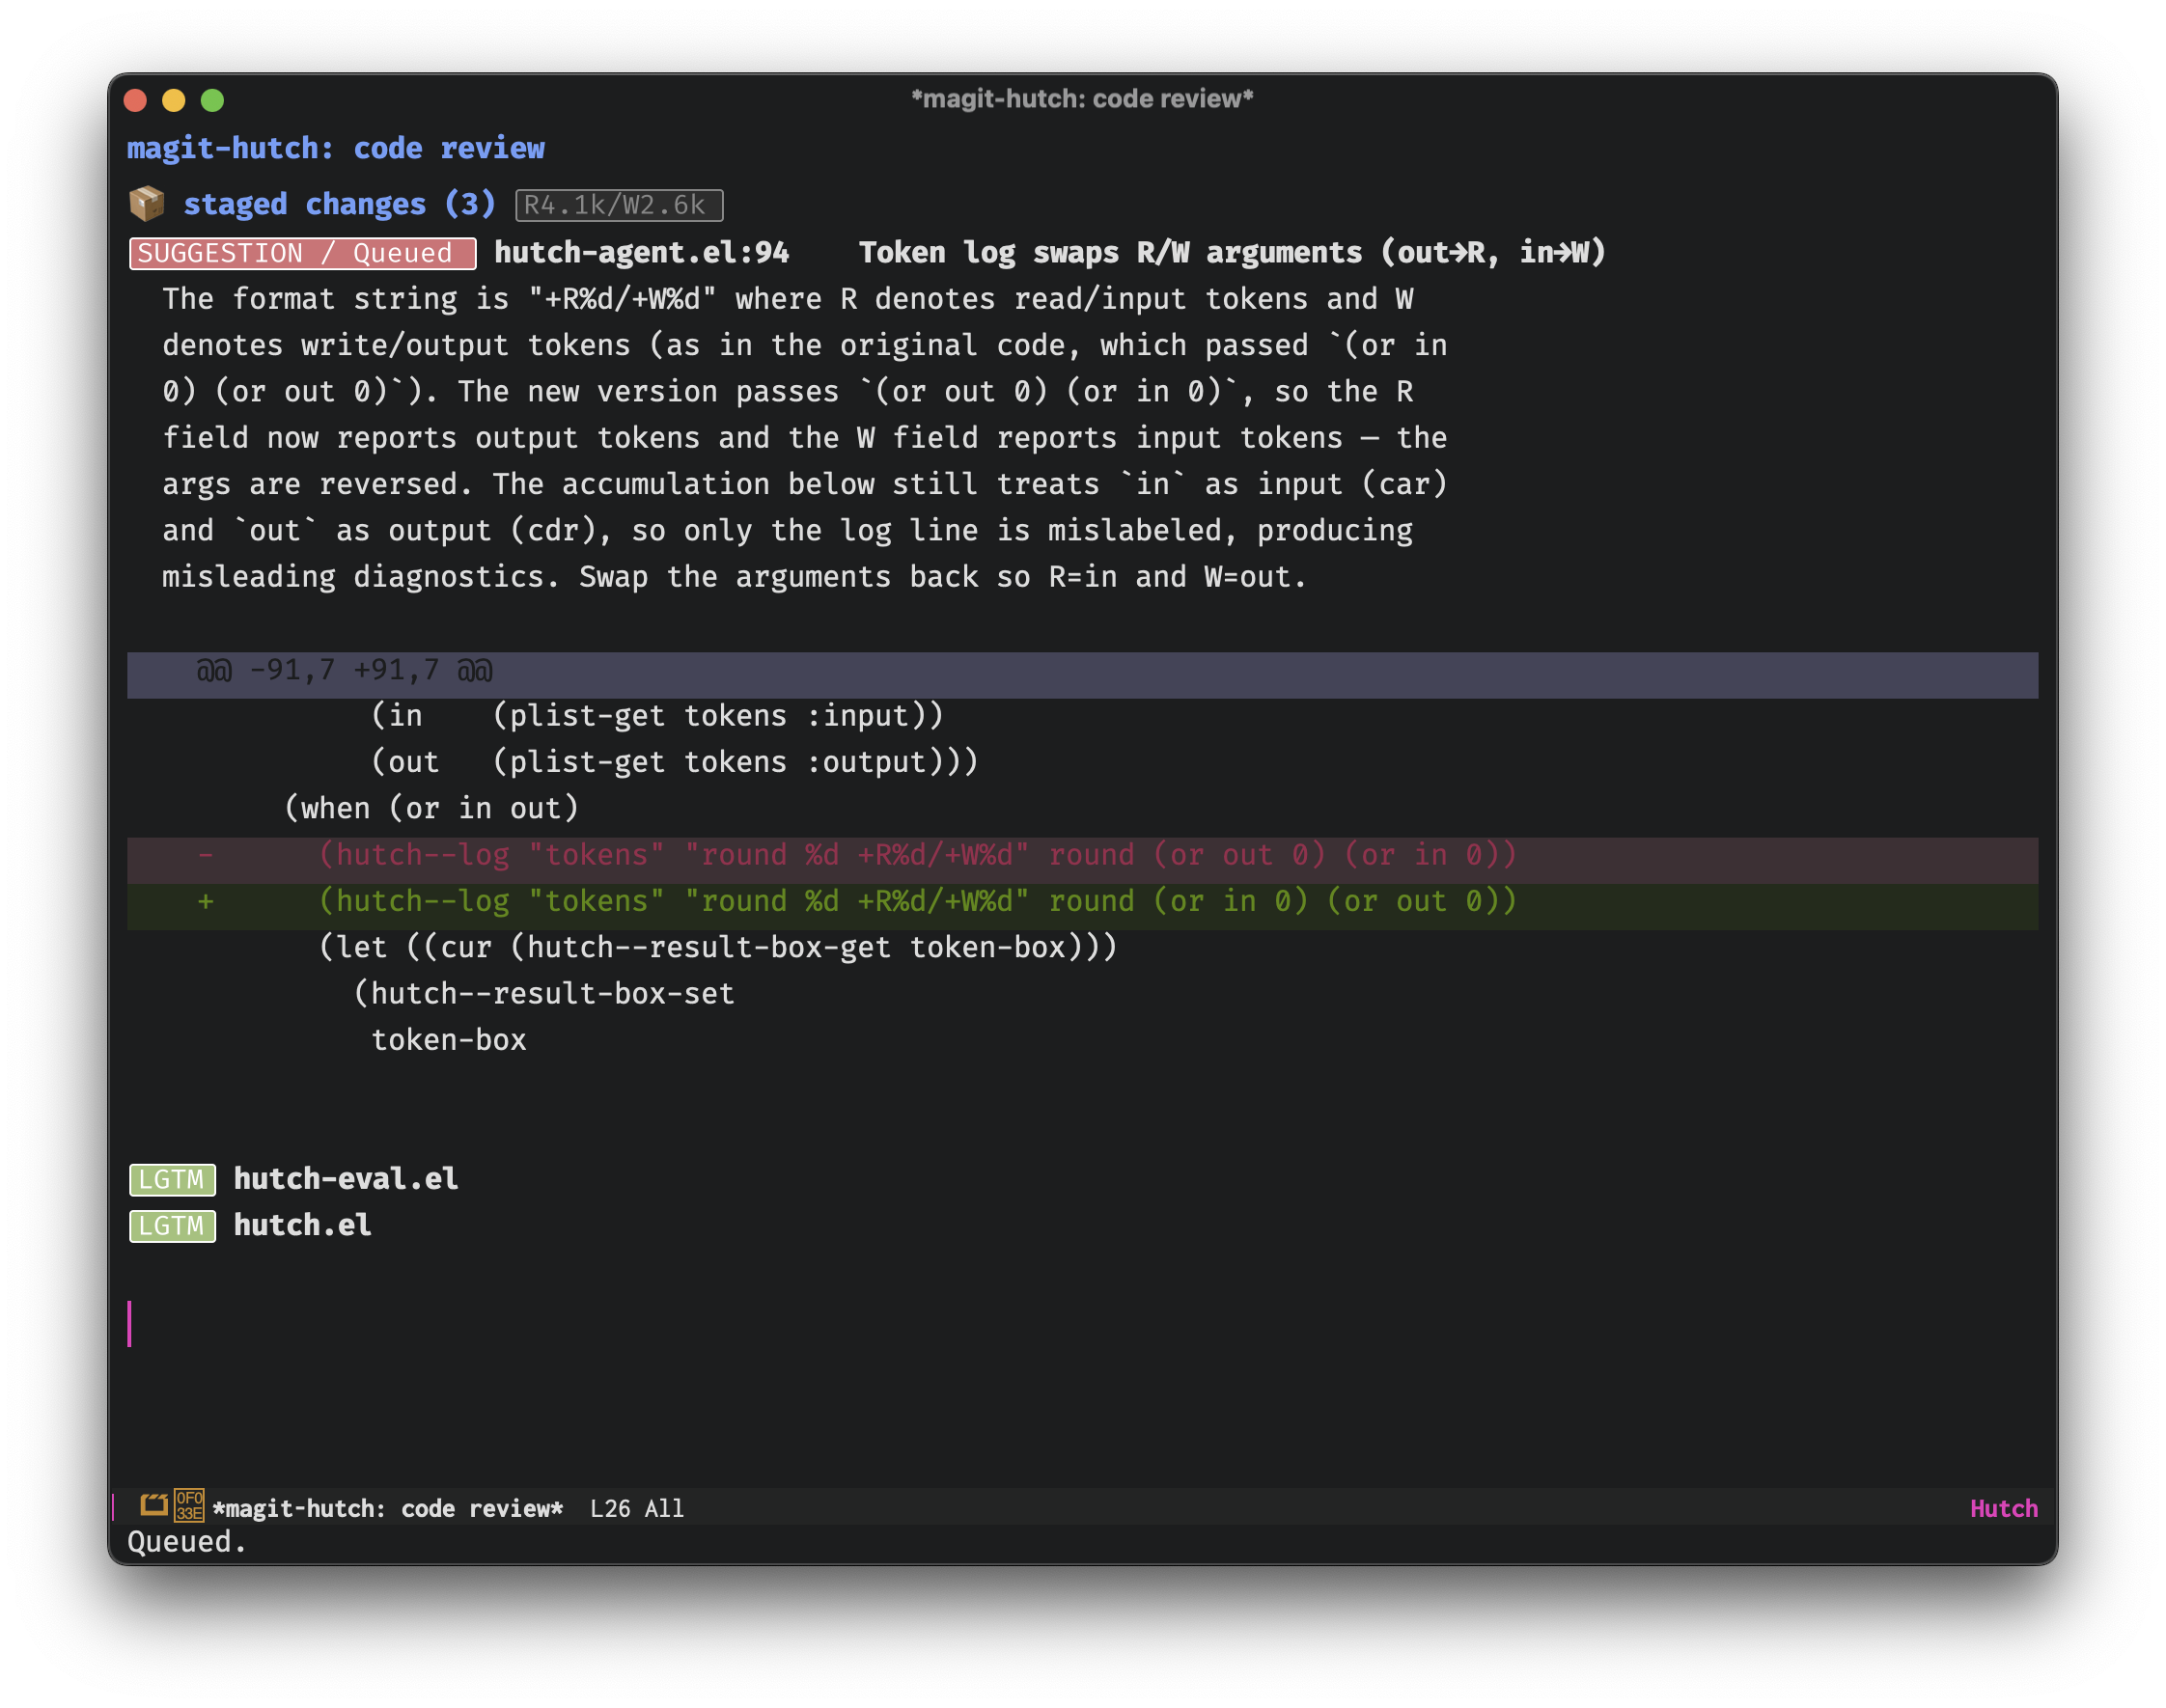
あとは A でキューに入れた suggestion をまとめて適用する。適用はスコープを意識するので、ステージ済みの変更に対して finding をキューに入れたなら、修正はステージ済みのファイルに直接当たる。
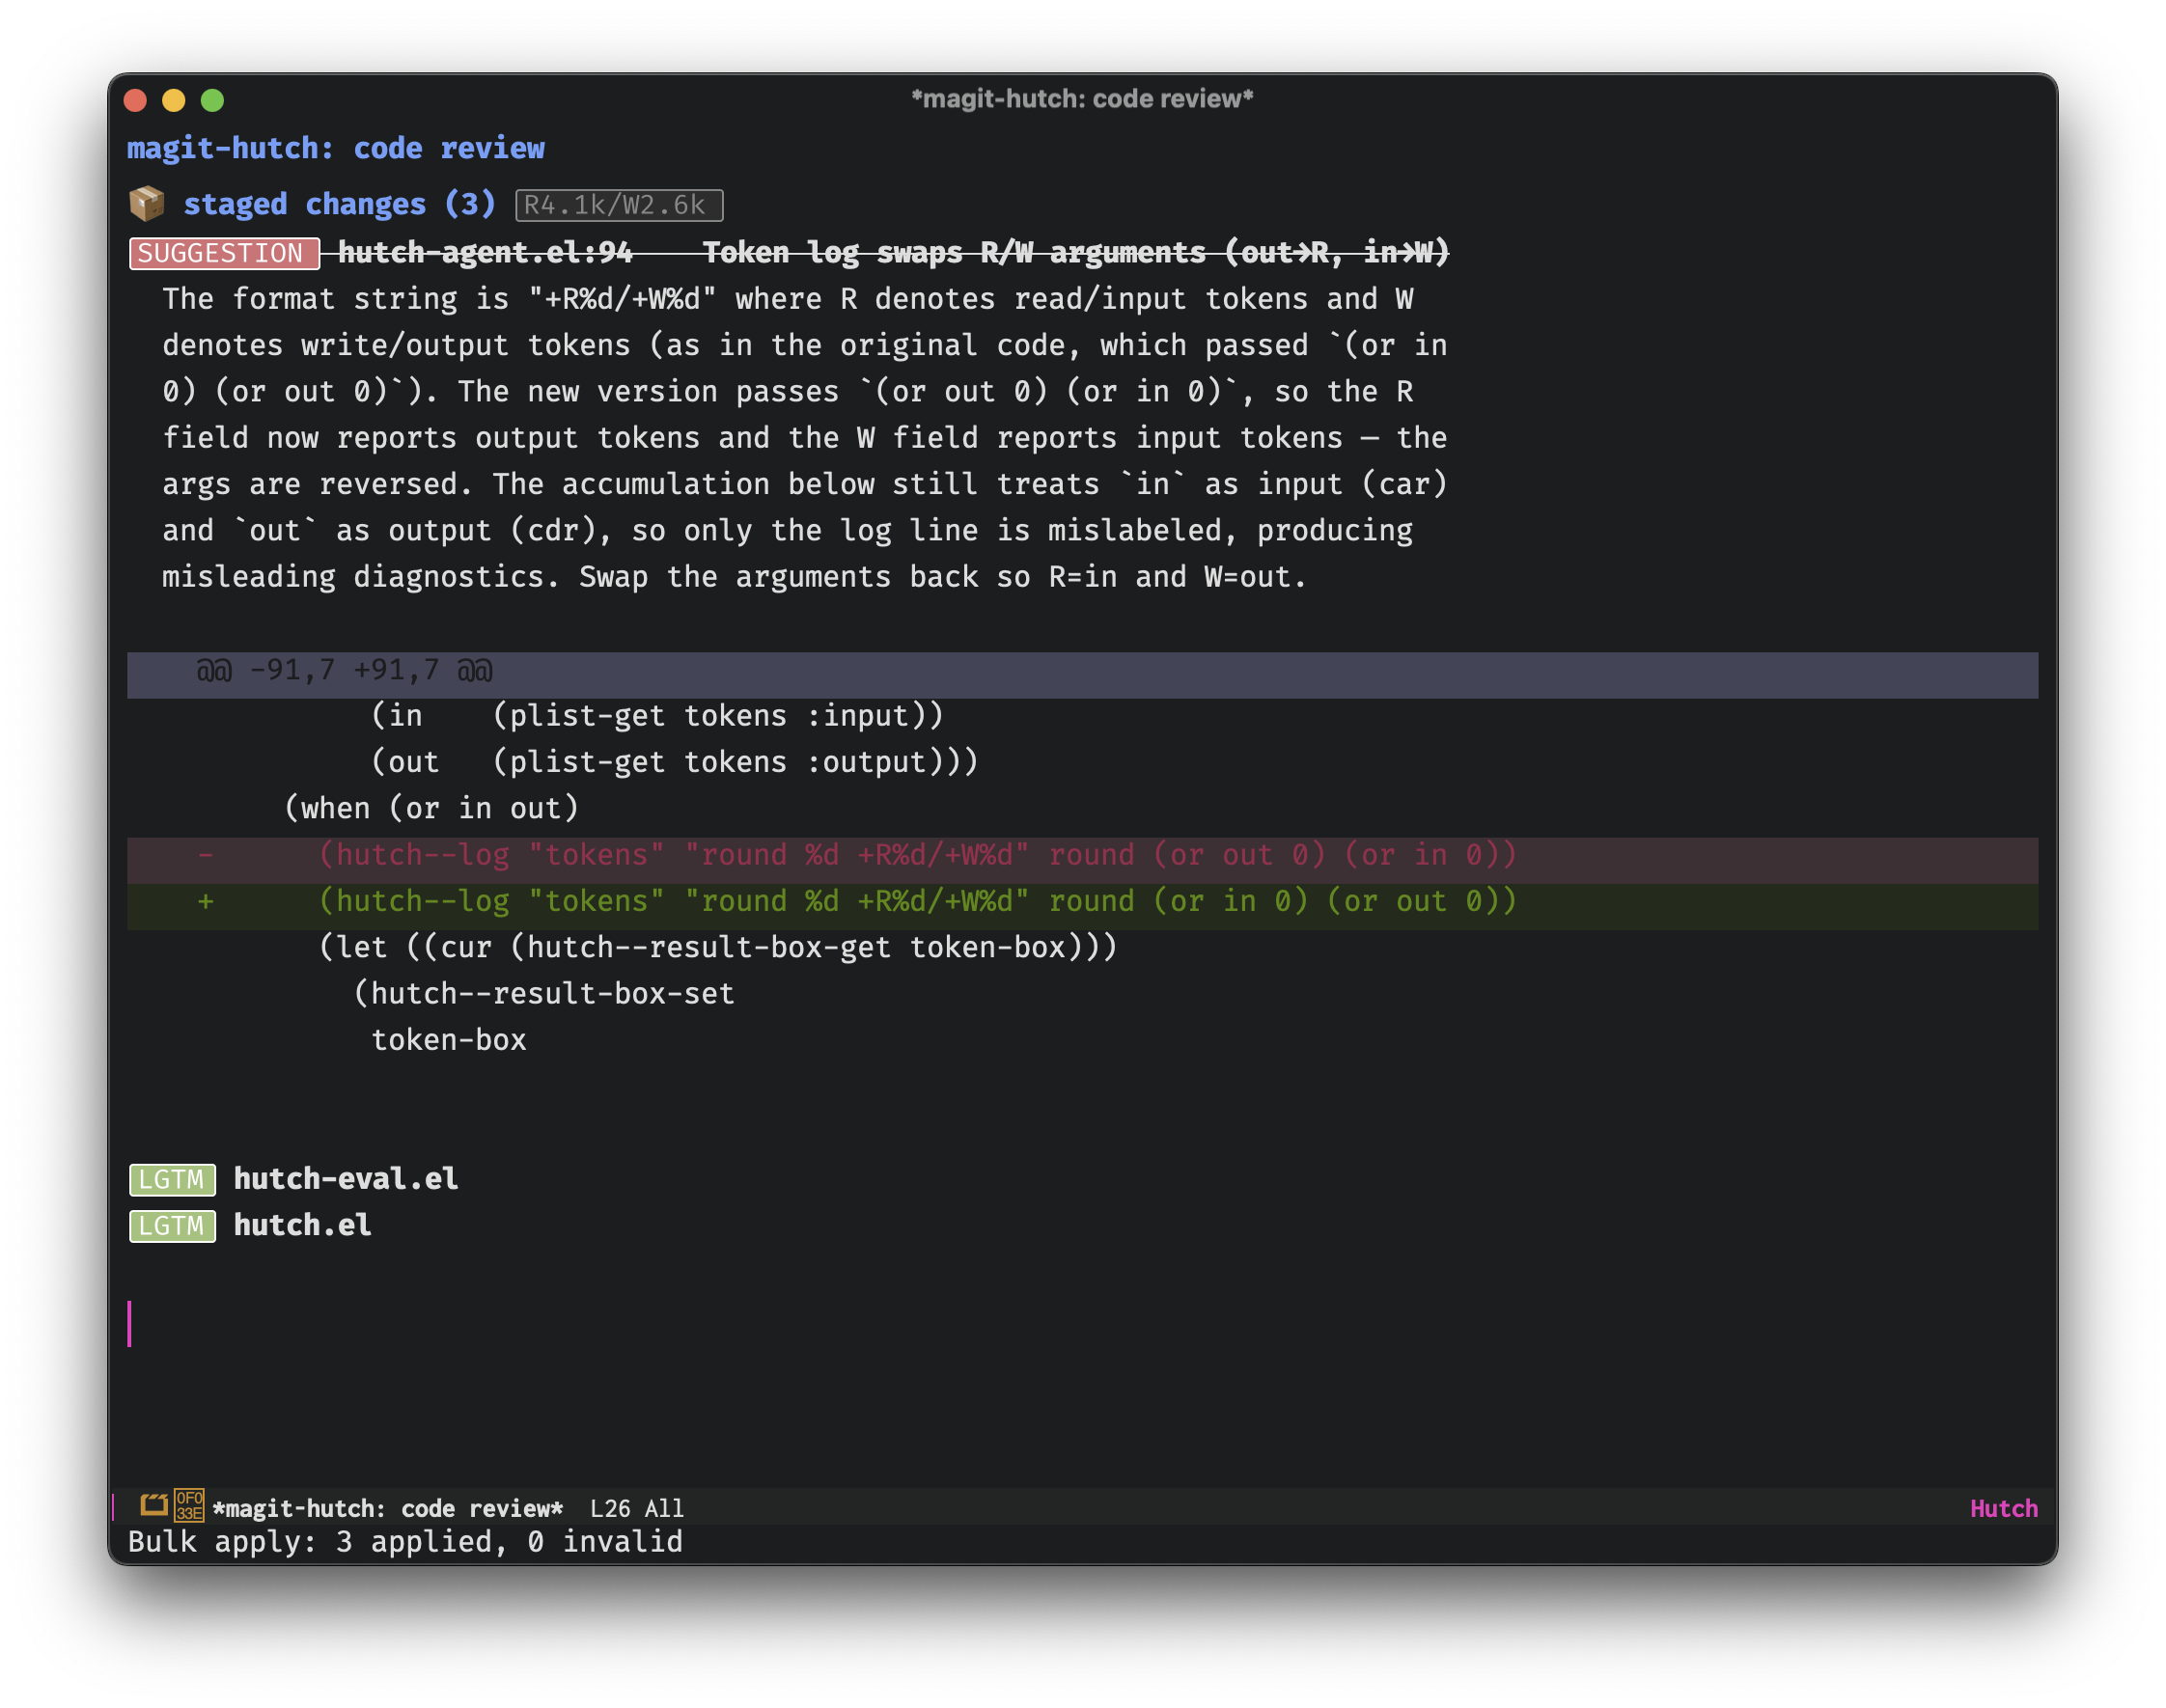
以上だ。既存の Emacs ユーザーなら、かなり素直に使えるはずだ。もちろん裏側にはいくつか面白い仕組みがあって、これから何節かに分けてその一部を紹介する。
コメントより patch を #
レビューのコメントや提案 patch を buffer 内に直接表示するときの大きな体験上の弱点は、コメントシステムにあるような既成のつなぎがないことだ。とはいえ GitHub では、レビュー画面が新しいコミット上の古くなったコメントを畳んでくれるし、ほとんどのレビューボットは変更を提案するなら suggestion の仕組みに頼っている。
Hutch の設計は、単なるテキストコメントよりも patch に寄っている。Aider leaderboard(と俺自身のいくつかの実験)によれば、SEARCH/REPLACE diff は、モデルに直接行番号まで正確な patch を生成させるより、モデル間での従順さがずっと高い。
Aider スタイルの diff では、SEARCH が一意になるだけの十分なコンテキストを周囲に確保し、できればインデントも保つ必要がある。Hutch の場合、ツールの関数 schema が file、search、replace のフィールドを最初から分けてくれている:
src/utils.clj
<<<<<<< SEARCH
(defn add [a b]
 (+ a b))
=======
(defn add [a b c]
 (+ a b c))
>>>>>>> REPLACE
古めの(あるいは安めの)モデルの多くは、diff を生成するよう求められると、read_file、read_diff、surrounding_context の呼び出しから逐語的にコピーするのではなく、記憶から SEARCH ブロックを復唱する傾向があることに気づいた。これではほぼ確実に diff が完全に壊れる。だからコミット前に検証する。SEARCH が欠けているか、複数箇所にマッチしたら、その発見は普通のコメントに格下げする。一意にヒットすれば、Hutch がローカルで unified diff を生成する:
SEARCH/REPLACE ブロックはファイルと照合して検証され、その後 unified diff として出力される。フローは2段階に分かれる。Agent ループでは、agent がツール(read_*)を呼び出し、old_lines を検証する。検証結果が AMBIGUOUS なら old_lines を修正してツール呼び出しのステップに戻る。OK ならレビューをコミットする。コメントとパッチだ。ループの後、各パッチはパッチ検証ゲートを通る。通過(OK)すれば hutch が unified diff を出力し、UI にレンダリングする。失敗(FAIL)すればパッチは通常のコメントに降格され、これも UI にレンダリングされる。
一連の udiff とコメントがレンダリングされ終われば、マークして一括適用できる。Hutch はファイルごとに、最も下の hunk から(ボトムアップで)適用していくので、行番号への影響が最小になる。各所見はそれぞれ独自の git apply を実行し、適用に失敗したものは自分自身を invalid とマークし、残りはそのまま着地できる。
このパッチとコメントの基盤には価値がある。数回キーを叩くだけで、読んで解析する作業が減り、本当に実行可能な分類処理に集中できるはずだ。もちろん、パッチが常に当たることを保証するものではないし、保証すべきでもない。
より強いモデルに替えれば、より単純な diff の手法でもたいていはうまく回る。だが、異なる、より安価なモデルをまたいで動くツールにとっては、最大限のサポートが必須だ。総じて、我々が構築してきた多くの agentic インフラについて思うのは、token:cost 比を最適化するためのノブをいくつか用意することが鍵だということだ。それは往々にして、「十分」なモデルのために厄介な回避策を講じることを意味する。
ぎりぎり十分なツール #
Hutch がコンテキストを取得するツール群はかなり簡素だ:
read_diffread_filesearch_codebasesurrounding_context
中でも surrounding_context が面白い。これは Tree-sitter をラップし、インストール済みの文法を使う。モデルが必要に応じて関連行の外側の定義へと拡張し、さらに外へと広げていく仕組みだ。私のテストでは、read_file をそのまま流し込む場合と比べて、読み取りのトークン消費は全体として少なく観測され、レビュー品質は同等だった 2。
モデルが出した所見はすべて一度に agent へ渡される。書き込み側では、verify_block が diff をローカルで検証し、他のコメントや LGTM 通知とともに、1回の submit_review ツール呼び出しでコミットする。submit_review 自体もいくつか後処理を通る。ファイルや行番号に関するハルシネーションの遮断、説明の長さの圧縮、そして該当しない場合に patch をコメントへ降格する処理だ。
コミットが着地すると、この一連のフローの出力は refs/hutch/id の下に永続化され、単独でコミットして共有したり(magit-post-commit-hook と組み合わせて)、後から再レンダリングしたりもできる。目を細めて見れば、stacked-diff のレビューツールにおける変更識別子に少し似ているが、その目的はレビューを git ツリーの中に残すことであって、人間のレビューのために changeset を識別することではない。我々は複数人による人間のレビューには関心がなく、すべてはローカルだ。
評価 #
Hutch をベンチマークする上で最もつらいのは、テキストバッファから直接比較できる出力を取り出すのが難しいことだ。最初に評価を回したときは、複数の headless emacs を起動し、agent の出力がレンダリングされる前に tee で横取りしていたが、後に Perfetto trace を出力し、それを評価の下層の媒体とする方式に切り替えた。
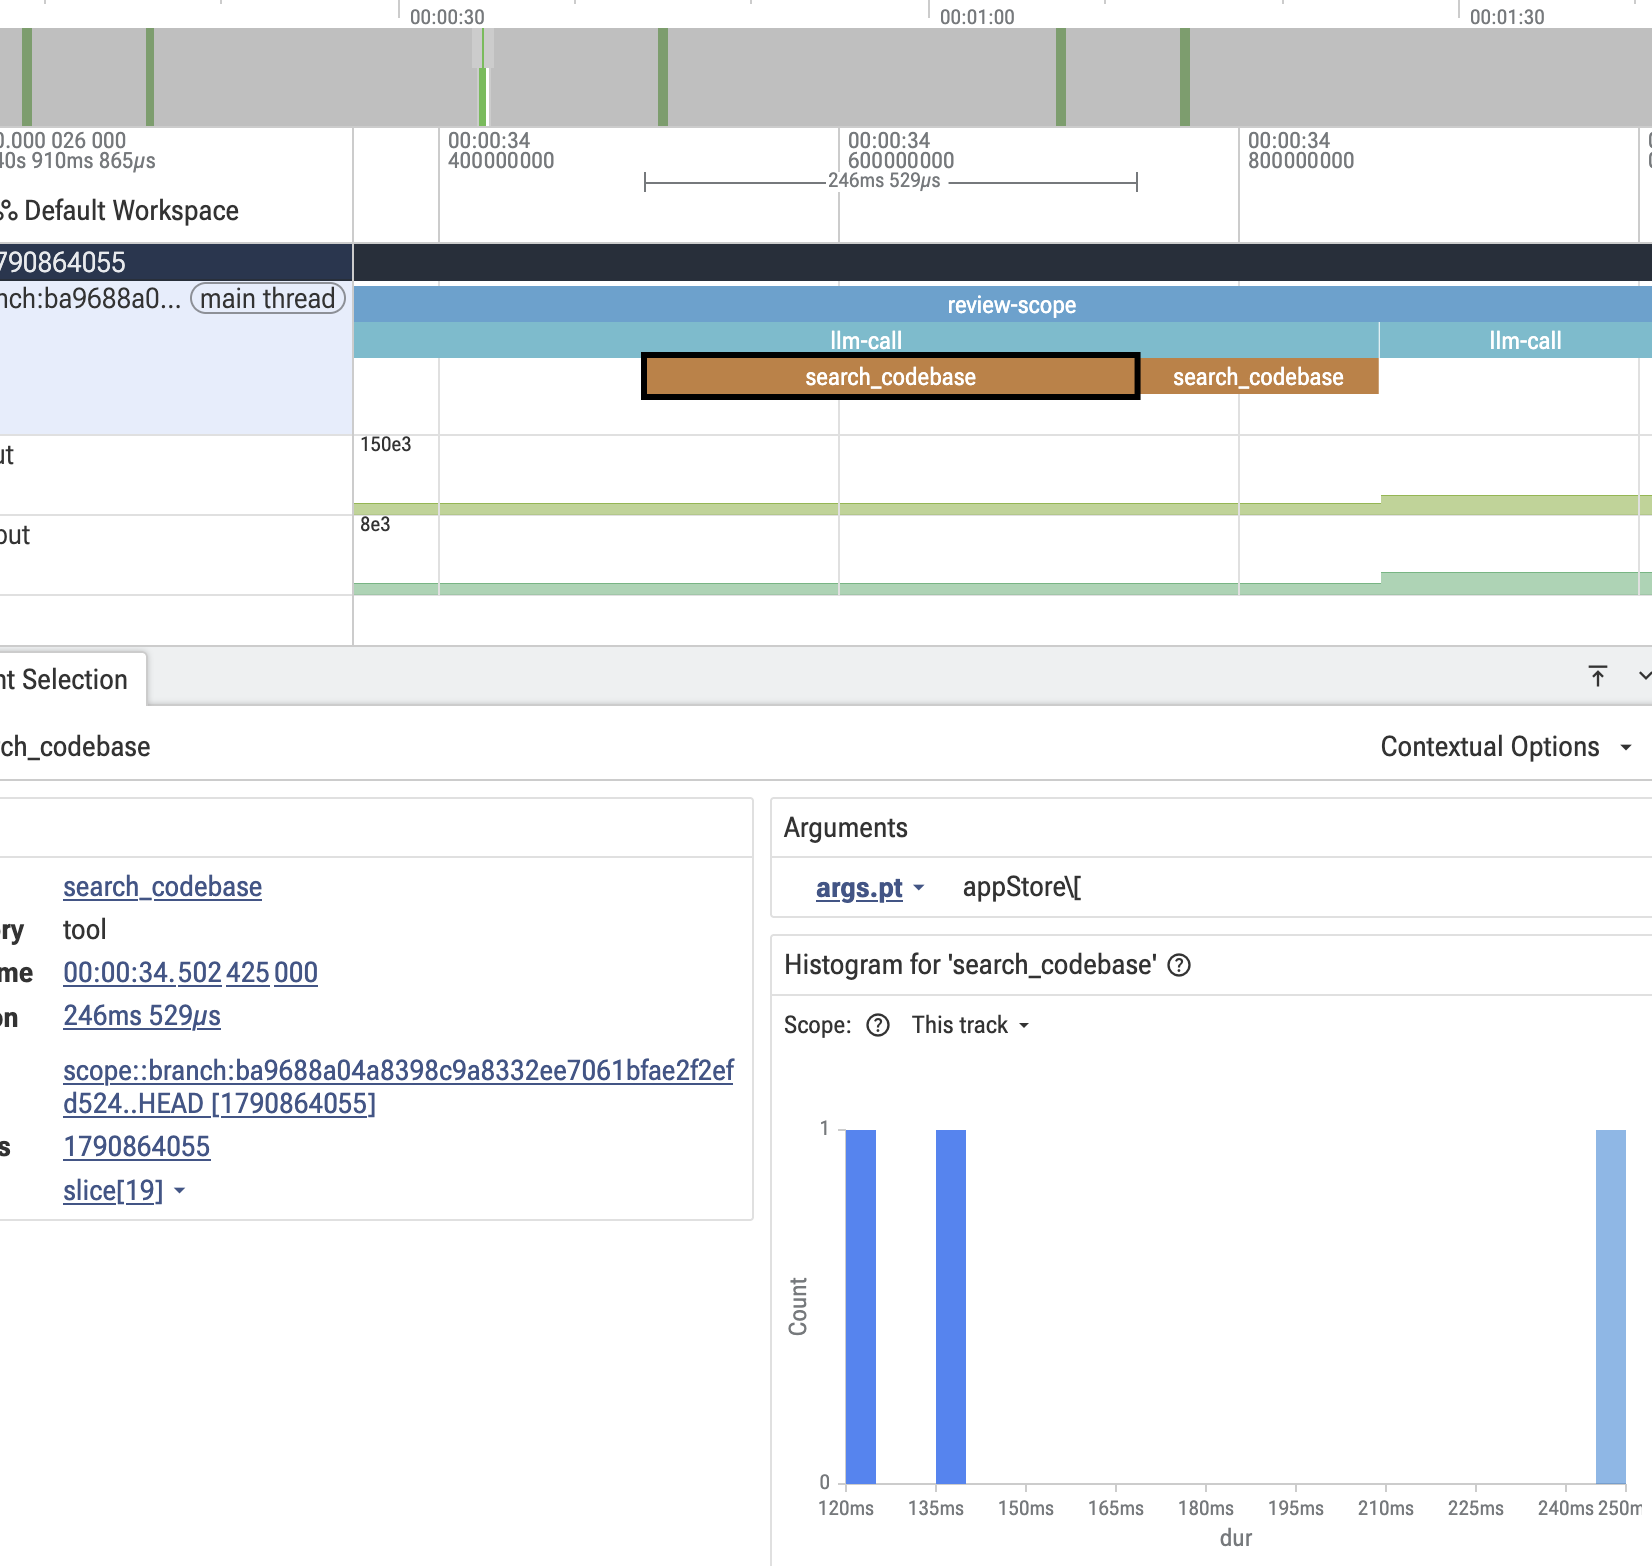
Perfetto で agent をトレースする手法は他所で見たことがない。おそらく理由があるのだろう。そもそもこういう用途向けに設計されていない。prompt や tool call といった一級の概念はない。カーネルやブラウザ向けであって、散文に満ちた抽象システム向けではない。
だが、単機で emacs ローカルの agent にとっては、ぎりぎり使える。この review はなぜ40ラウンドも回ったのか?、どのツールが並列実行されたか?、diff の読み取りにどれだけ wall time がかかったか? といった構造的な問いに答えられる。さらに重要なのは、無料でインフラも一切要らないことだ。hutch-trace-dir を設定すれば Perfetto trace が出力され、ui.perfetto.dev にそのまま読み込めばいい。手間がかからない。
以下の例はツール呼び出しとその合計所要時間を取り出すためのものだ。pipeline はこれだけ。dashboard も SDK も要らない:
SELECT
  name                       AS tool,
  COUNT(*)                   AS calls,
  ROUND(SUM(dur) / 1e6, 1)   AS total_ms
FROM slice
WHERE category = 'tool'
GROUP BY name
ORDER BY total_ms DESC;

-- tool                 calls  total_ms
--------------------------------------
-- search_codebase      18     4210.3
-- read_diff            7      2103.1
-- surrounding_context  12     880.5
-- read_file            3      412.7
-- submit_review        1      42.9
これを組み上げた上で、Martian の code review benchmark と CR-Bench プレプリントの戦略を混ぜて、Precision、Recall、Fβ スコアを計算する。評価の詳細は eval/README.org の 3 節により詳しく書いてある。おおまかに言えば、40 の PR、132 の golden でこの bench を回し、GPT 5.2 を分類 judge として使う。評価 pipeline は trace に対して直接クエリを走らせる。数字を見る限り、我々は Martian Offline Benchmark のリーダーボードで大体16位あたりにいるはずで、記憶を持たず単発で実行する agent としてはかなり競争力がある。
分類スコア以外にも、この agent 自体について触れておくべき点がいくつかある:
モデルごとにヒットした golden の異なる積み上げ棒グラフ。単独のみ、別の 1 モデルと共有、他の 2 モデルと共有に分ける。opus-4.8:単独 15、1 モデルと共有 17、2 モデルと共有 18(計 50)。glm-5.2:13、19、18(計 50)。gpt-5.5:6、16、18(計 40)。3 つの和集合は 78。
0102030405060708090ヒットした異なる golden
opus-4.8glm-5.2gpt-5.5
和集合 = 78
単独のみ
1 モデルと共有
2 モデルと共有
モデルが違えば引っかかるバグも違う。132 個の golden のうち、各モデルのヒット数は 40〜50 で、3 モデルすべてがヒットしたのは 18 個だけ。つまり 3 モデルを同時に走らせれば、理論上は単一モデルより約 55% 多くバグを捕まえられる計算になる。
要するに、各モデルの「何がバグか」という判断はかなりバラバラだ。
3 つの棒グラフは、40 個の PR それぞれの agent のターン数を昇順に並べたもの。opus-4.8:中央値 8 ターン、最大 26。glm-5.2:中央値 11、最大 39。gpt-5.5:中央値 35、最大 81 で、80 ターンの上限に近い PR がいくつもある。
020406080ターン
opus-4.8
glm-5.2
gpt-5.5
40 個の PR をターン数順に
40 個の PR をターン数順に
40 個の PR をターン数順に
ヒット率がほぼ同じでも、GPT 5.5 がデフォルトのターン上限(80)に達する回数は他のモデルよりずっと多い。Opus 4.8 はタスク完了に必要なターン数が 3 分の 1 で済む。
3 つの棒グラフは、有効な発見 1 件あたりに消費した出力 token を、PR ごとに 1 本の棒で昇順に並べたもの。opus-4.8:31 個の PR、中央値約 2,600、最大約 13,000。glm-5.2:34 個の PR、中央値約 3,600、最大約 15,000。gpt-5.5:34 個の PR、中央値約 3,000、最大約 27,500。
05,00010,00015,00020,00025,000出力 token / 有効な発見
opus-4.8
glm-5.2
gpt-5.5
PR を有効な発見あたりの token 数順に
PR を有効な発見あたりの token 数順に
PR を有効な発見あたりの token 数順に
token 効率では、Opus は有効な発見 1 件あたりの出力 token 消費が明らかに少なく、差は小さくない。ただ入力側で燃やすコンテキストは他モデルの 3 倍で、Hutch が毎ターン増え続けるコンテキストを再送しているせいだろう。
出師未捷 #
どうやらすべて手遅れらしい。もう誰もコードを手書きしたりレビューしたりしないし、エディタやバージョン管理を手で操作することもない。これは自分のため、そして自分がまだ実践しているワークフローのために作った。LLM と emacs を一緒に使うべきかどうかについて主張するつもりはない。このツールはどちらかというと