hutch:emacs中的本地代码审查
hutch 是 magit 的本地代码审查界面。其作者主张审查补丁而非跟踪评论,并解释了托管平台强加的以评论为中心的流程为何不适用于本地开发。
中文
复制
2026 年 10 月 5 日
我已经四年没有正经上过班了。上个月,我关掉了自己一直在做的那个创业项目。这些年里,大部分时间我都泡在 AI agent 前沿的后端。但现在我总算追上了。coding agent 真正起飞也就是这500 来天的事,而它们确实比之前的指令式做法更能干活。
虽说比起完成任务式的自动机器,我还是更喜欢 AI 在教学上的那一面,但后者已经催生了一整套围绕代码审查的工具,不只是写代码和部署。审查 agent 的典型话术是:agent 抢在你同事前面冲进来,趁你还没醒、还没摸到手机,就往二十个 pull request 上喷一堆废话。这有时管用,对某些人也管用。但如果你像我一样,代码上线给用户之前仍然要人来看,那就最好尊重这些人,也尊重他们的时间。不管你站在“颠覆一切”还是“老古董”这条光谱的哪一端,这一点都成立。
说了这么多,无非是想说:不管 agent 以后往哪个方向变得更强,我希望我们仍然在乎一些东西。不是把“在乎”形式化——搞什么高保真的 agent 指令和 prompt,或者摆出某种更高明的品味——而是简单到只是说一句:嘿,我还在,这些我都懂。
所以,作为一个多年的 emacs 用户,我又带来一次把 LLM、agent 和 coding harness 塞进你文本缓冲区(!)的尝试:Hutch。它是一个小巧的、受 Magit 启发的代码审查界面,在本地契合标准的 Magit commit-push 工作流,希望能帮忙分担一些上游制造出来的负担。
快速上手 #
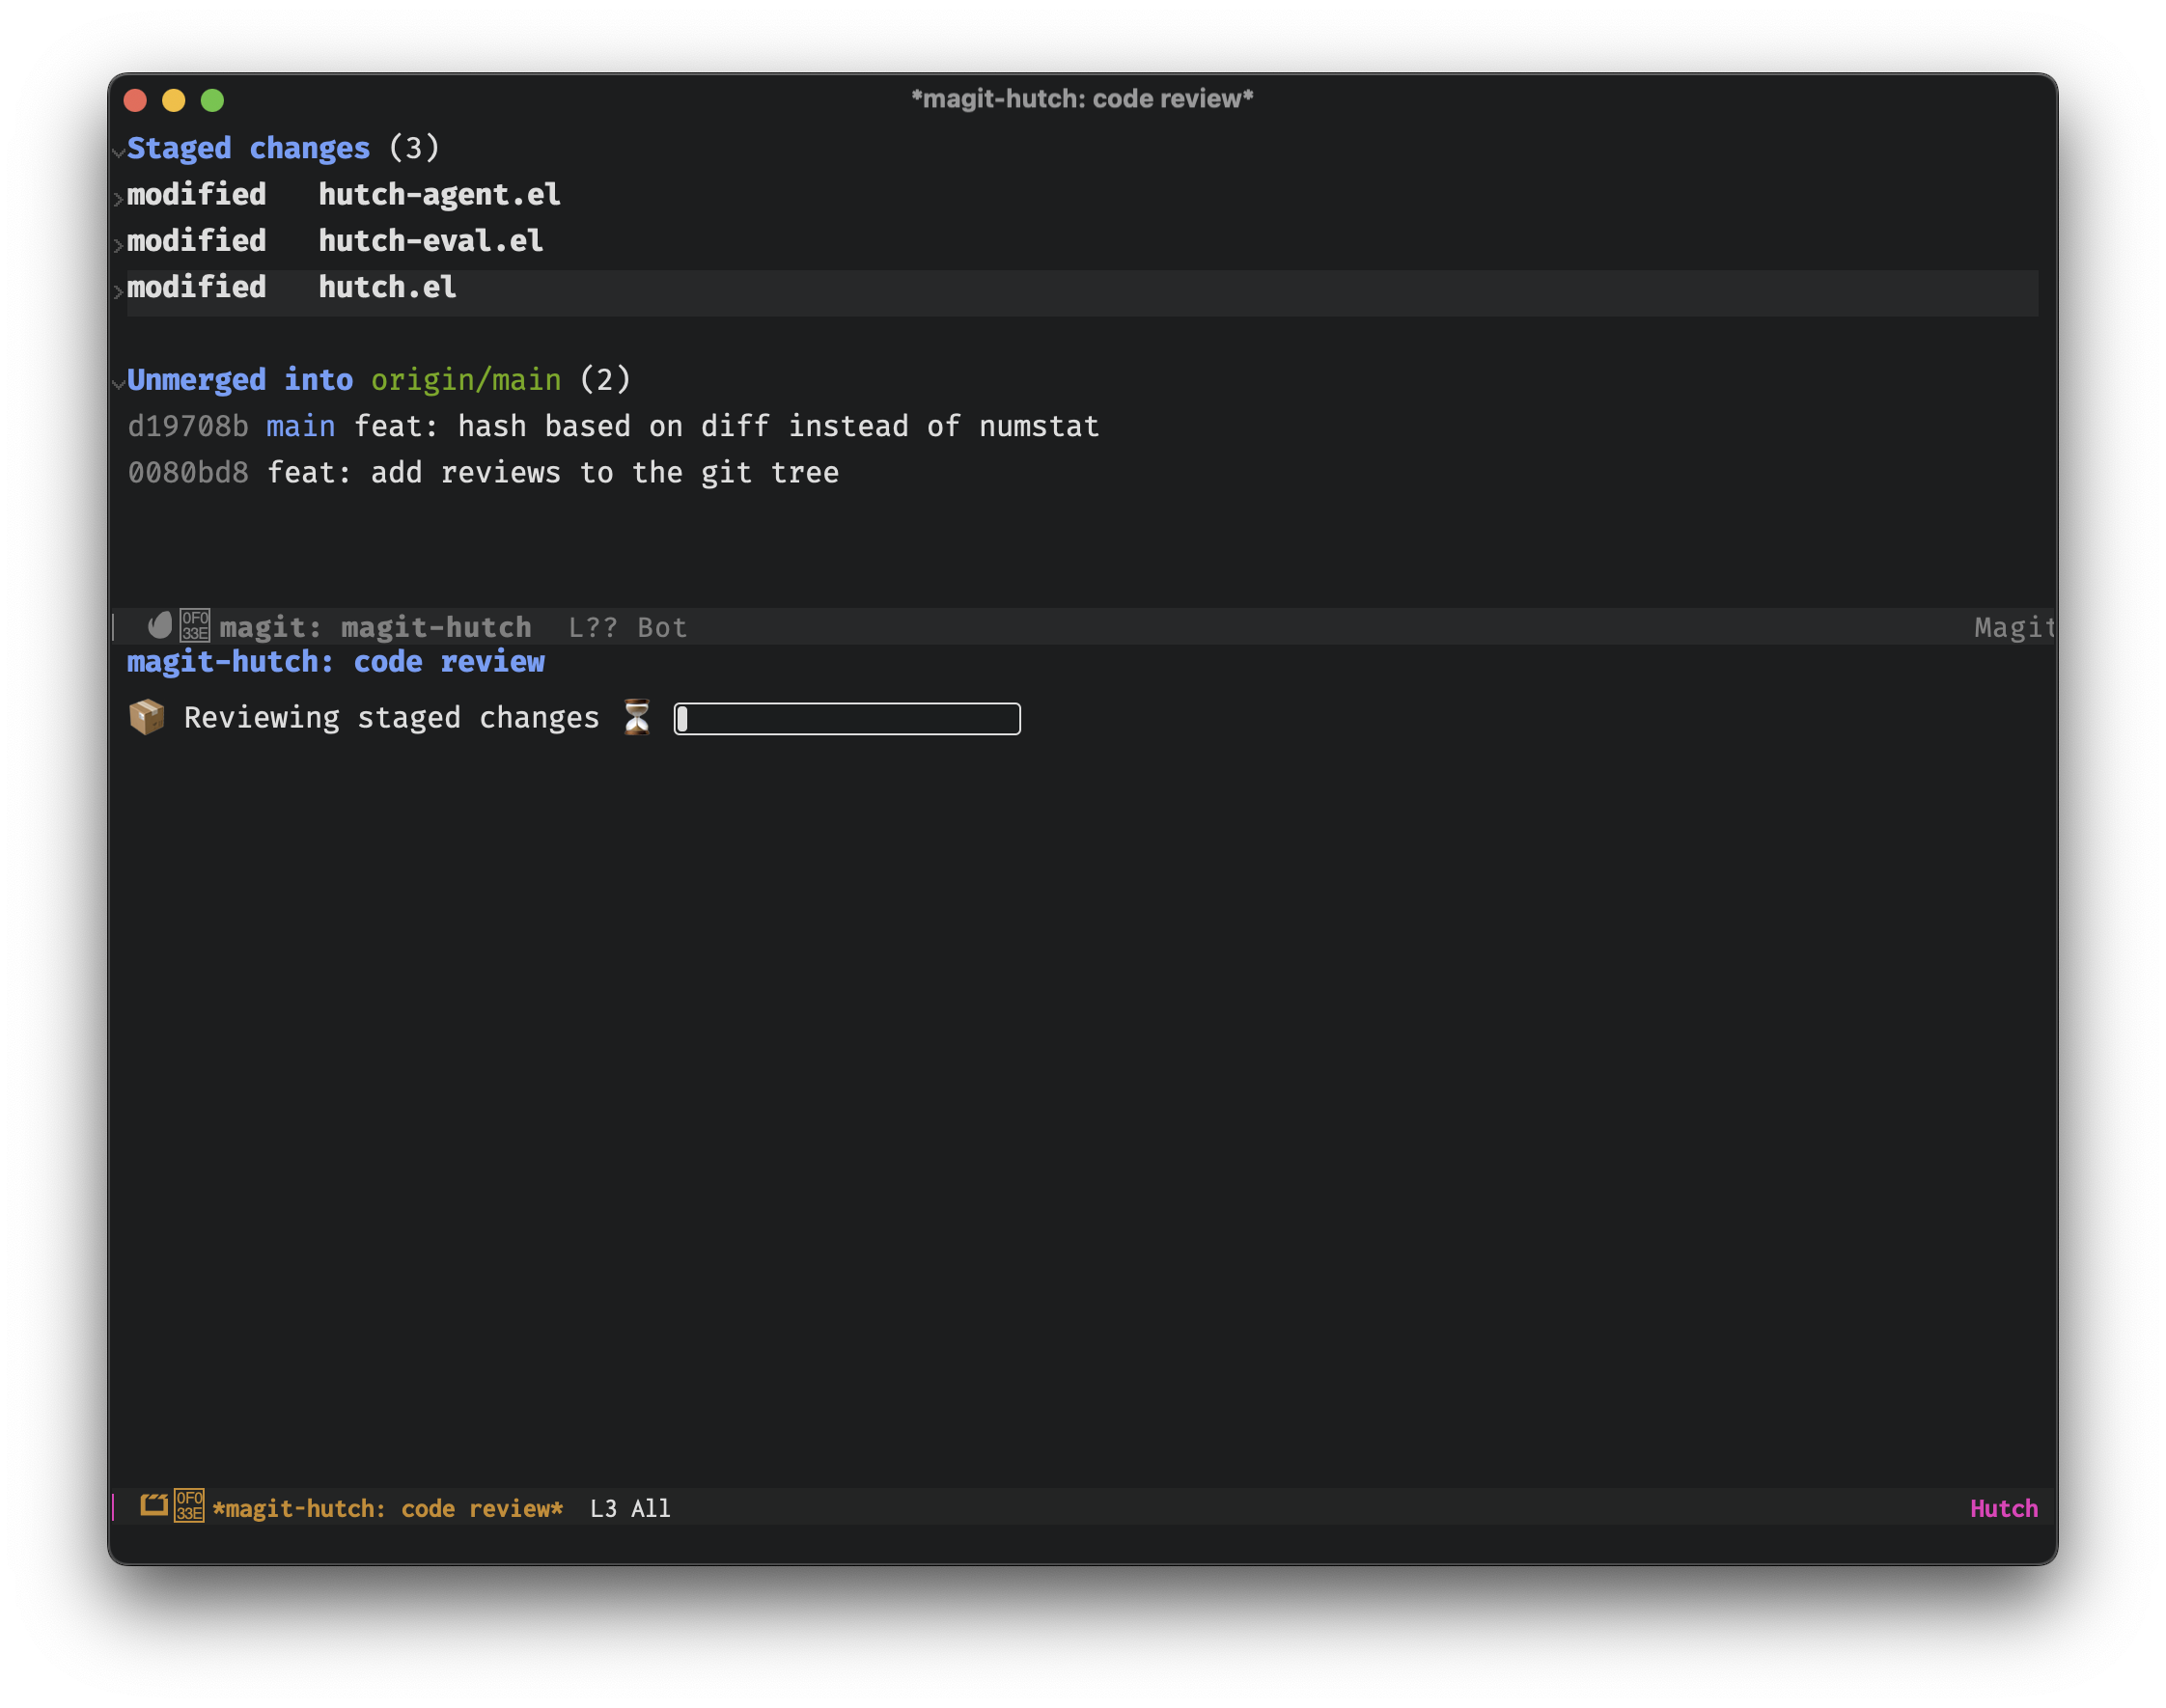
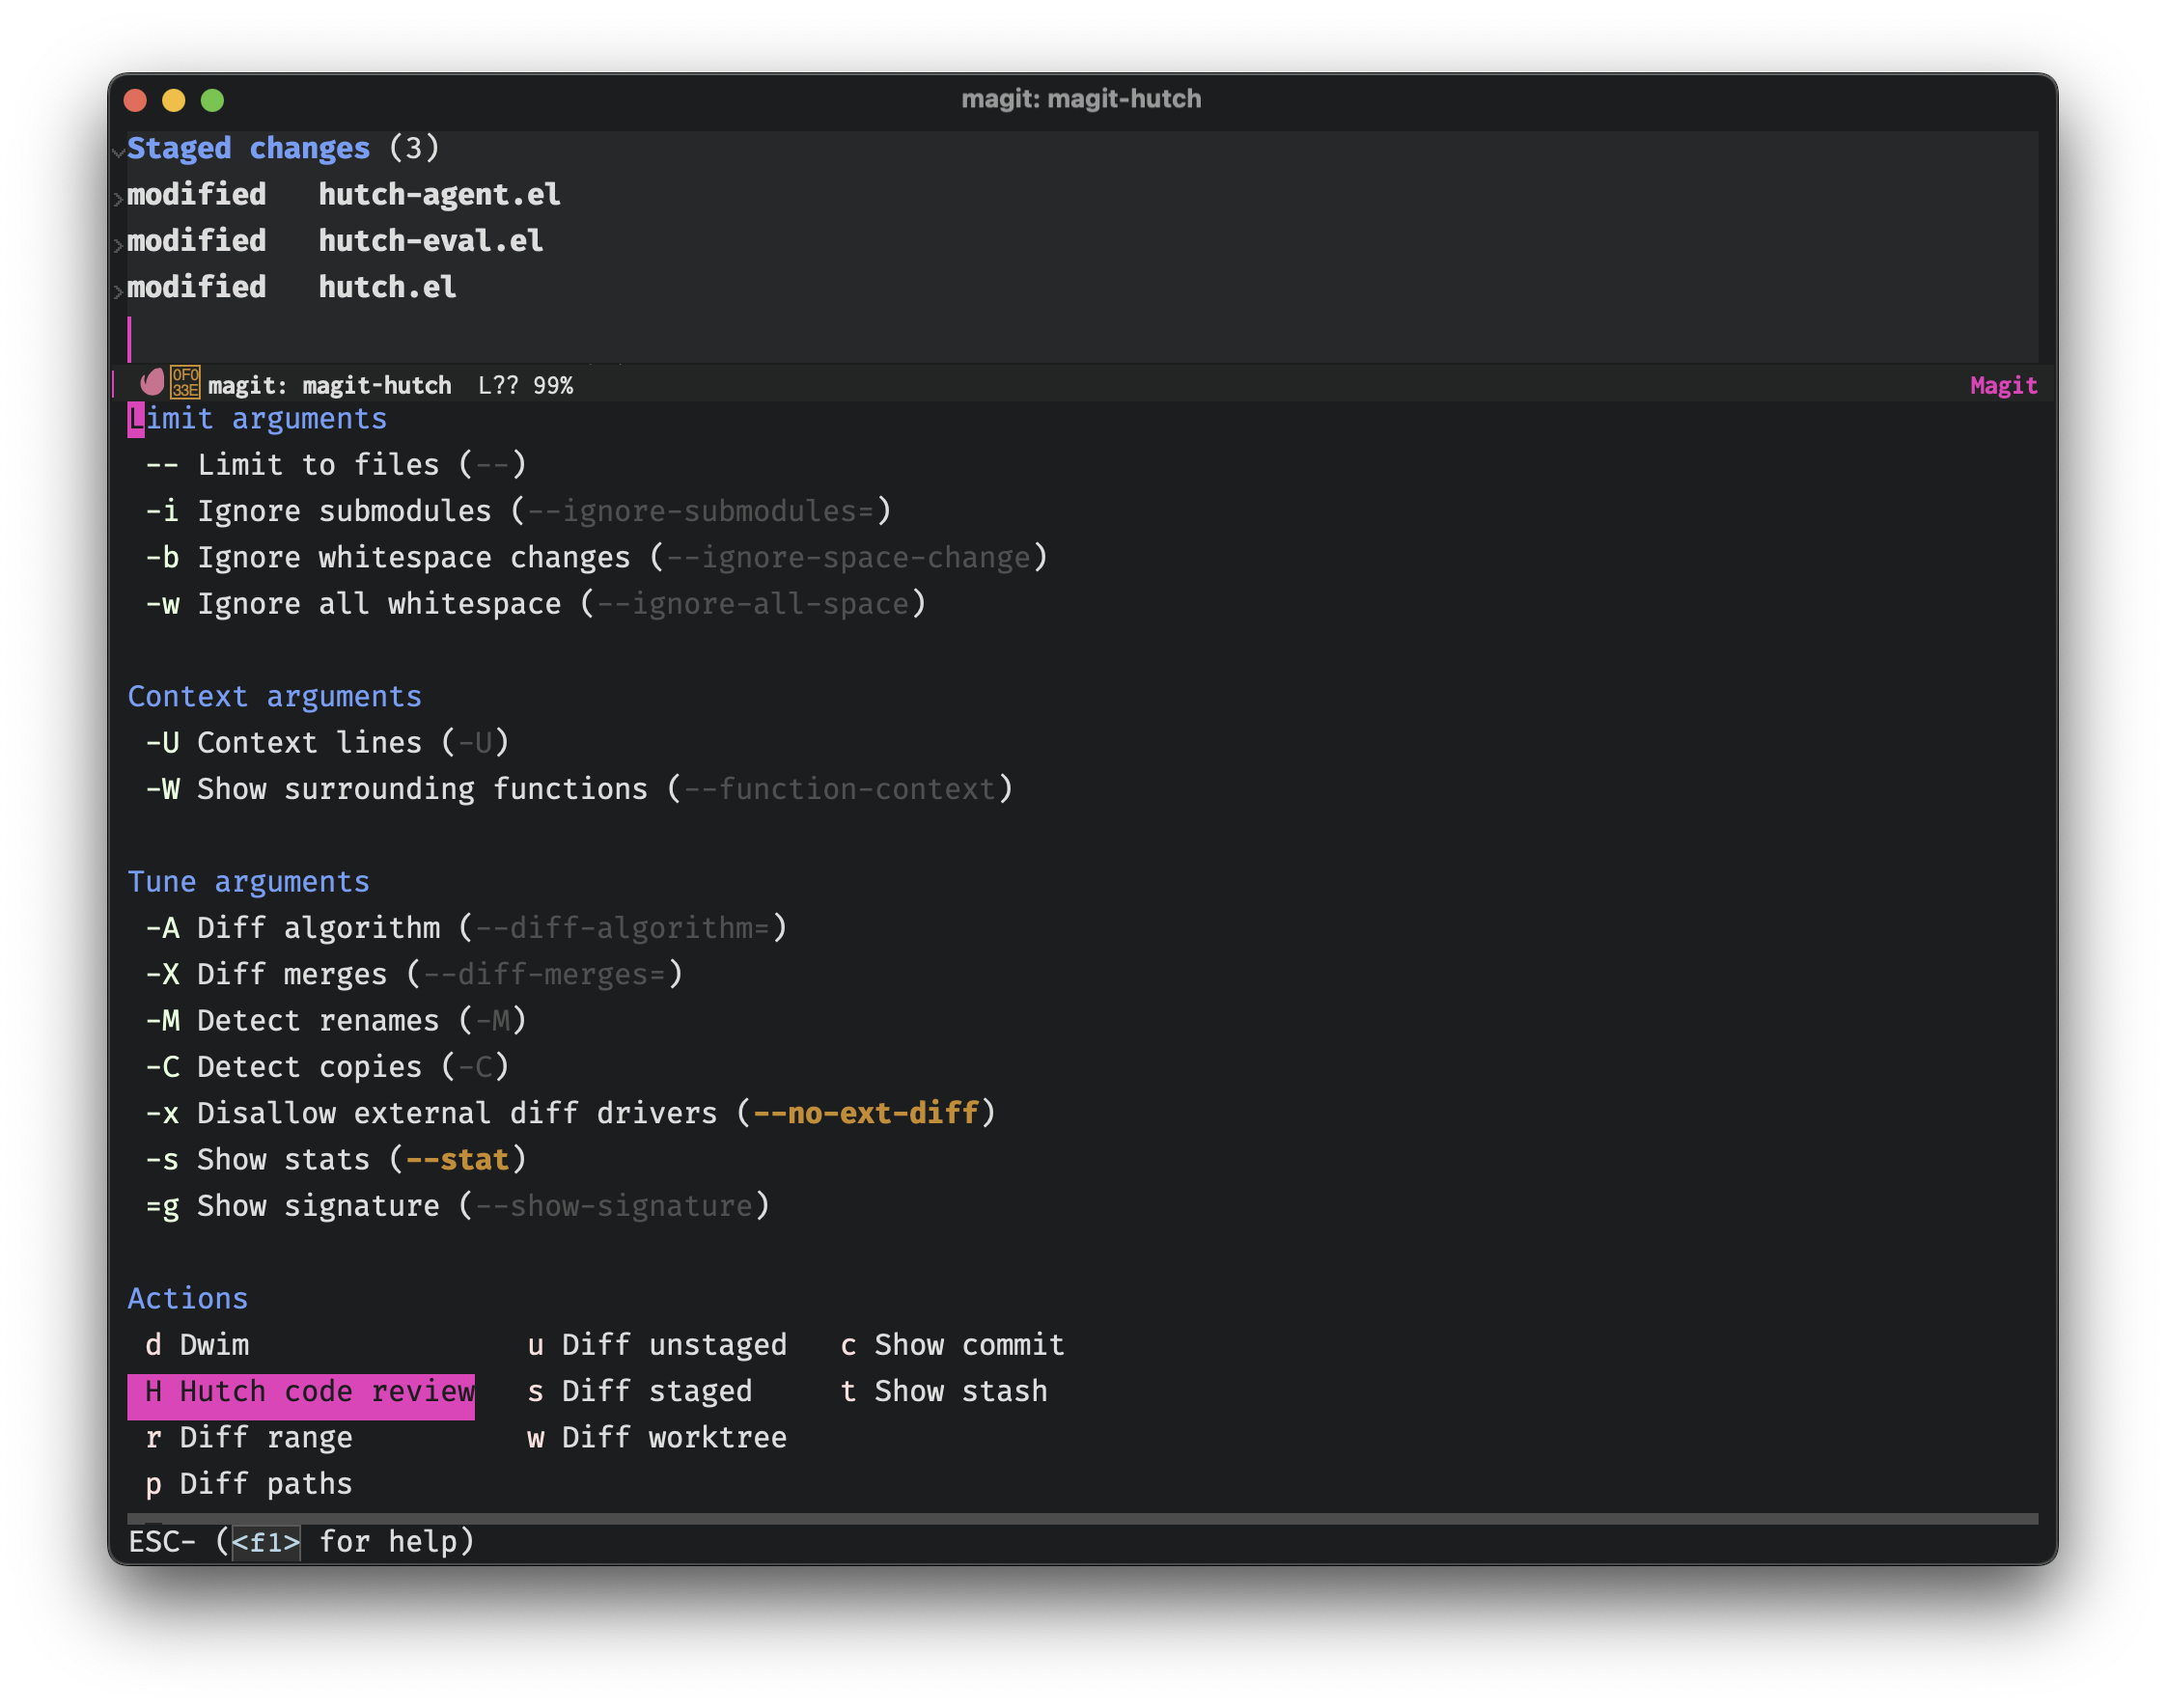
打开 Magit,按下 dispatcher 绑定键(通常是 d),你就会看到 DWIM 绑定旁边多出一个 Hutch code review 动作。Hutch 作用于三种范围:已暂存的改动、未推送的改动,以及当前分支与工作分支之间的改动。默认只处理已暂存的改动,因为这样最有用。
评审一开始,一个新的 *magit-hutch: code review* buffer 里就会出现一个漂亮的进度条,直到所有 findings 1 处理完毕。这个 buffer 是只读的,但你仍然可以使用预先绑定的操作。
每个 finding 都包含类型(suggestion、comment 或 LGTM)、文件名、相关行号、标题和描述。suggestion 还额外带有一个 patch diff。Hutch 借助 Magit 和 Transient 来渲染这些菜单,因此用起来几乎就像它自带的界面:键盘驱动的子菜单、diff 着色和高亮。suggestion 比较特殊,因为它们可以被应用。要把某个 suggestion 标记为待应用,用 m 将其加入队列。
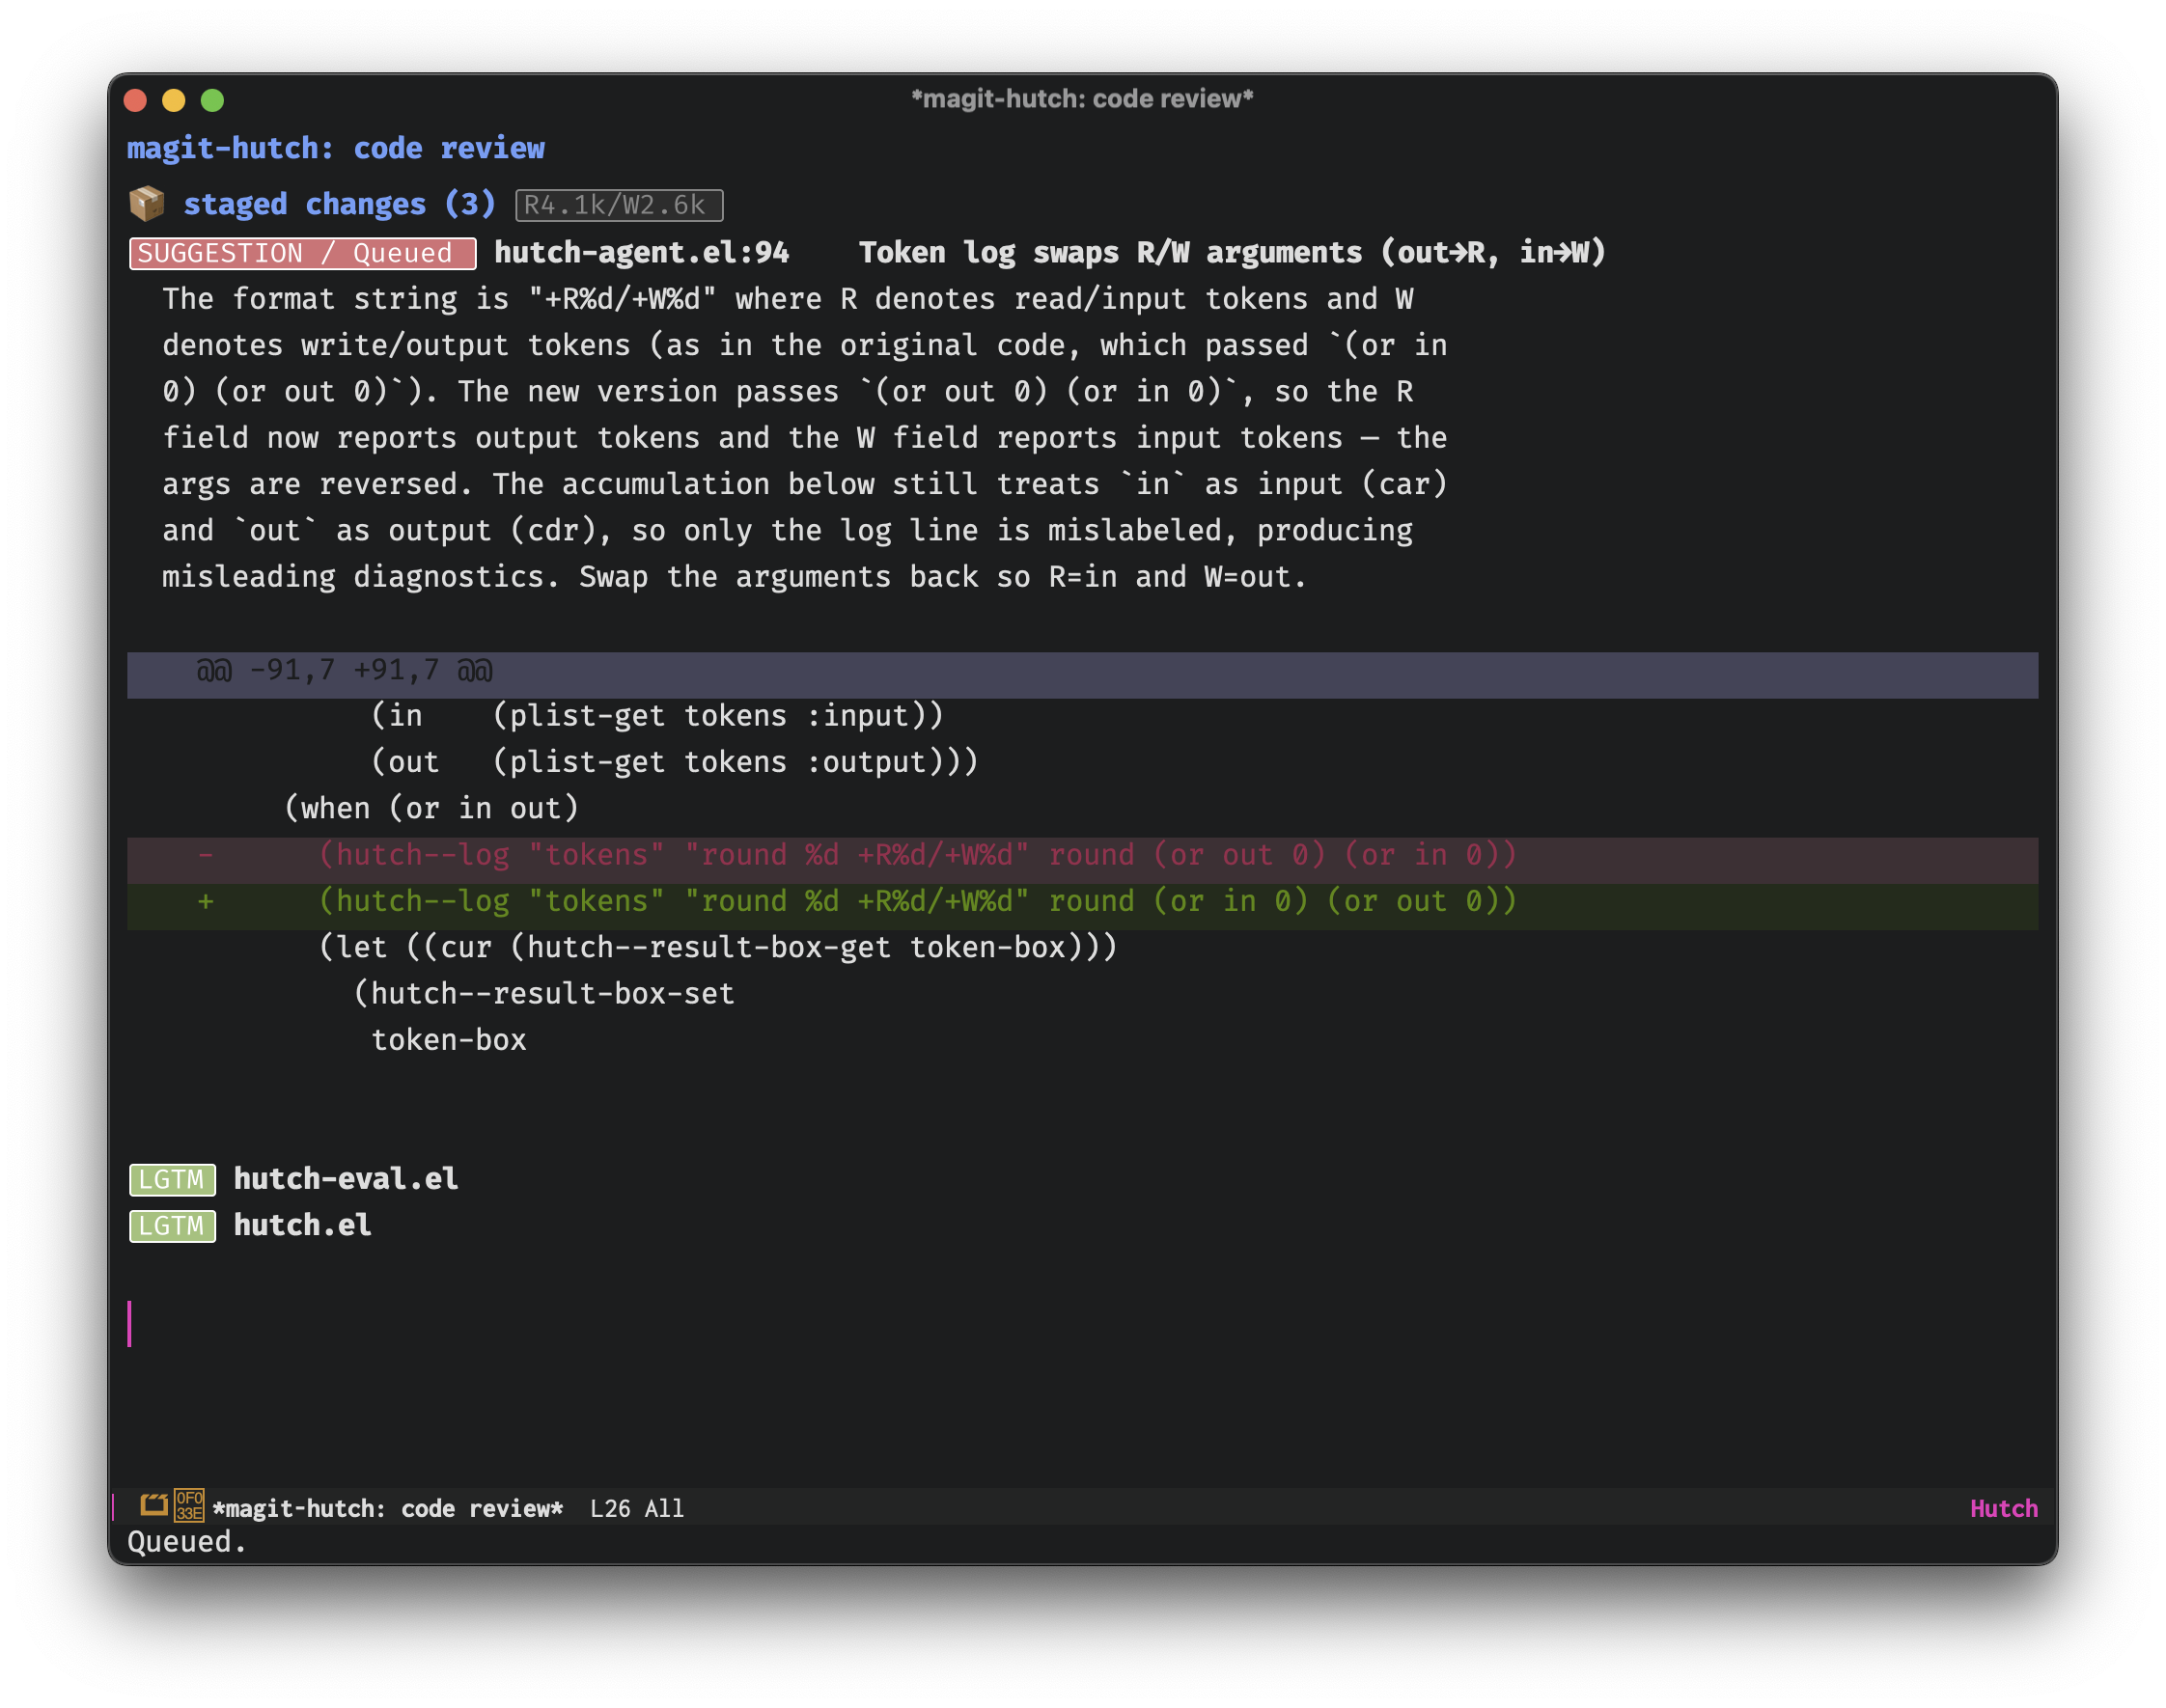
然后用 A 批量应用所有已排队的 suggestion。应用过程会感知作用域,所以如果你为已暂存的改动排队了一个 finding,修复会直接应用到已暂存的文件上。
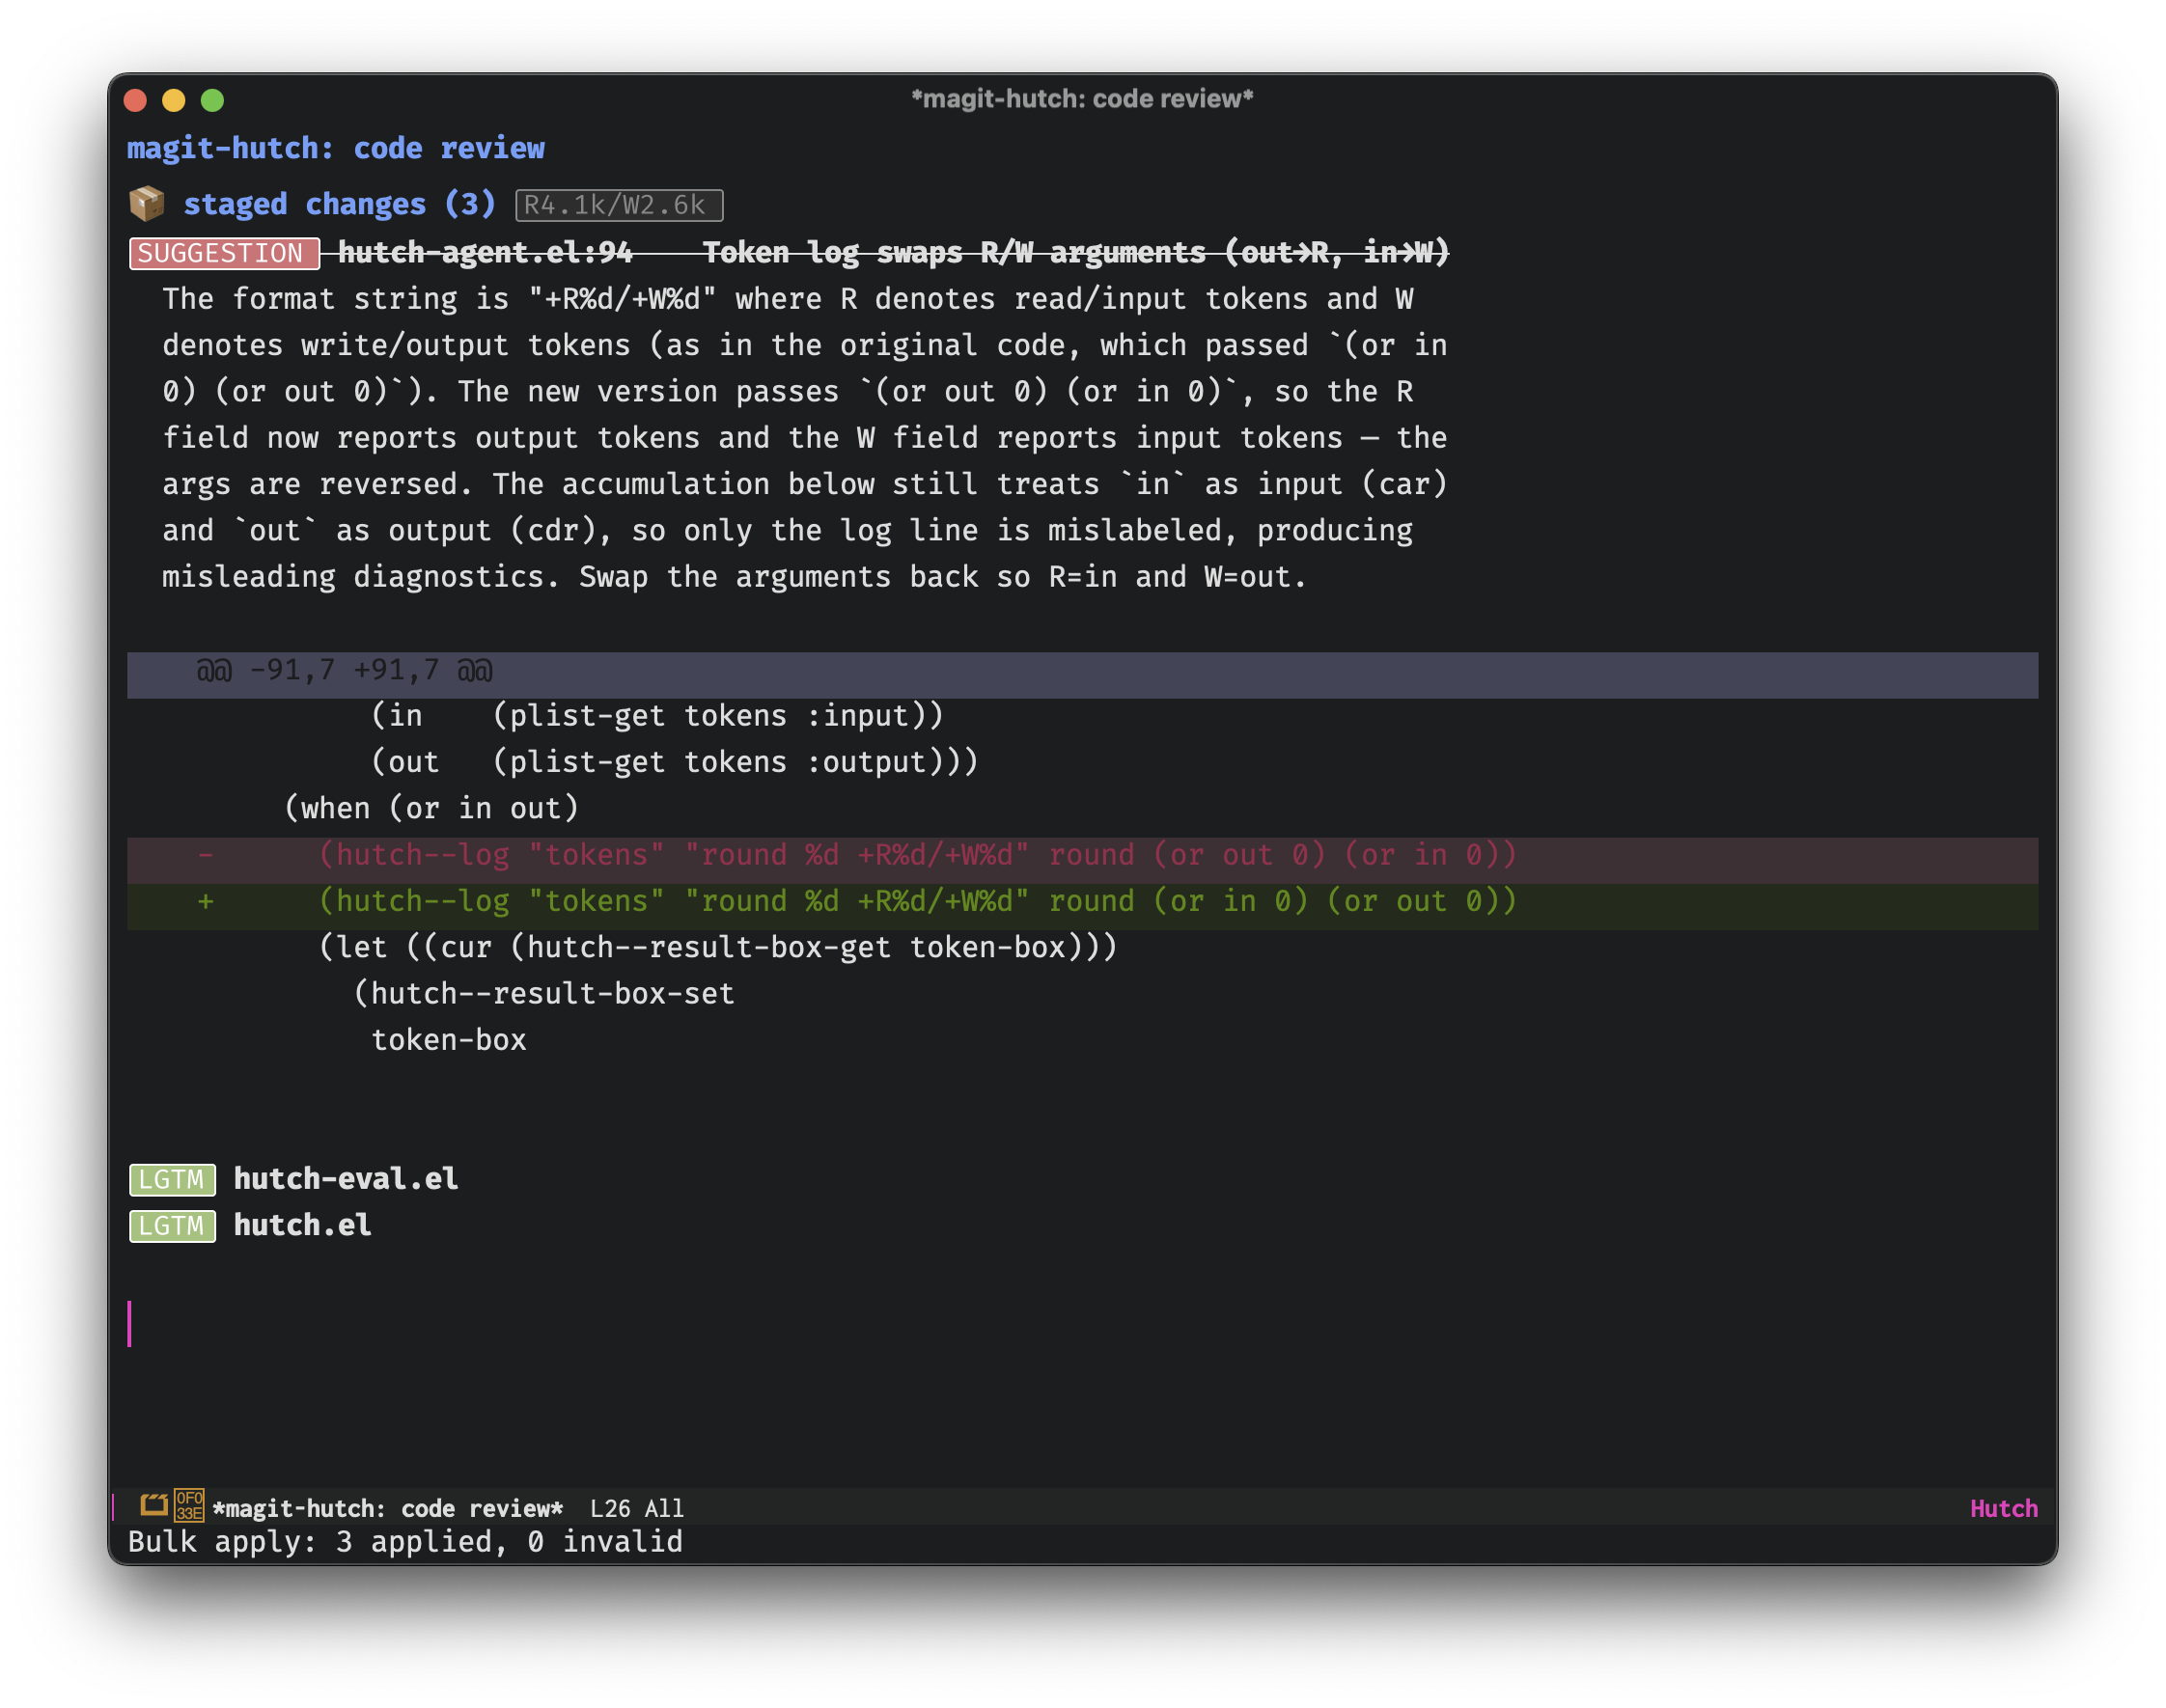
就是这样!对现有的 Emacs 用户来说,上手应该相当简单直观。当然,背后还有一些有意思的机制,我会在接下来几节里介绍其中一部分。
patch 优先于评论 #
在 buffer 内直接展示评审评论和建议的 patch,一个很大的体验短板在于:没有评论系统那种现成的连接组织。不过在 GitHub 上,评审界面会把新提交上的过时评论折叠起来,而且大多数评审机器人如果要提改动建议,都会依赖 suggestion 机制。
Hutch 的设计偏向 patch,而不只是文字评论。根据 Aider leaderboard(以及我自己的一些实验),SEARCH/REPLACE diff 在不同模型之间的服从度,远高于直接让模型生成行号精确的正确 patch。
对于 Aider 风格的 diff,你必须保证周围有足够的上下文让 SEARCH 唯一,最好还要保留缩进。在 Hutch 这里,工具的函数 schema 天然就把 file、search 和 replace 这几个字段拆开了:
src/utils.clj
<<<<<<< SEARCH
(defn add [a b]
 (+ a b))
=======
(defn add [a b c]
 (+ a b c))
>>>>>>> REPLACE
我注意到,很多较老(或较便宜)的模型在被要求生成 diff 时,倾向于凭记忆复述 SEARCH 块,而不是从 read_file、read_diff 或 surrounding_context 调用中逐字复制。这几乎必然会把 diff 彻底搞砸。所以我们在提交前会先验证。如果 SEARCH 缺失,或匹配到多处,该发现就降级为普通评论。若命中唯一,Hutch 会在本地生成 unified diff:
SEARCH/REPLACE 块会对照文件进行验证,然后以 unified diff 形式输出。流程图分两个阶段。Agent 循环:agent 调用工具(read_*),然后验证 old_lines。如果验证结果为 AMBIGUOUS,它会修正 old_lines 并回到工具调用步骤。如果结果为 OK,则提交审查:评论和补丁。循环之后:每个补丁都要经过补丁验证关卡。通过(OK)时,hutch 输出 unified diff 并在 UI 中渲染。失败(FAIL)时,补丁降级为普通评论,同样在 UI 中渲染。
一旦一系列 udiff 和评论渲染完成,就可以标记并批量应用。Hutch 按文件逐个应用,从最靠下的 hunk 开始(自底向上),这样对行号的扰动最小。每个发现各自运行自己的 git apply,应用失败的那个会把自己标记为 invalid,其余的可以继续落地。
这套补丁和评论基础设施是值得的:只需敲几下键,你就有望少做阅读和解析的活,把精力放在真正可执行的分类处理上。当然,这并不保证补丁永远能打上,也不该保证。
换成更强的模型,更简单的 diff 方法通常也能跑得不错。但对于一个要跨不同且更便宜的模型工作的工具来说,最大程度地提供支持是必须的。总的来说,我觉得我们构建的许多 agentic 基础设施,一个关键点就是要有一些旋钮来优化 token:cost 比。这往往意味着要为“够用”的模型做一些棘手的变通。
勉强够用的工具 #
Hutch 拉取上下文的工具集相当精简:
read_diffread_filesearch_codebasesurrounding_context
其中,surrounding_context 更有意思。它封装了 Tree-sitter,使用已安装的语法。它的工作方式是让模型按需扩展到相关行的外层定义,再继续向外扩展。在我的测试中,与直接灌入 read_file 相比,整体读取 token 消耗据观察更低,而审查质量相当 2。
模型给出的所有发现会一次性提交给 agent。在写入侧,verify_block 会在本地验证 diff,然后连同其他评论和 LGTM 通知,通过一次 submit_review 工具调用提交。submit_review 本身还会经过一些后处理,比如拦截关于文件和行号的幻觉、压缩描述长度,以及在不适用时将 patch 降级为评论。
提交落地后,这一整套流程的输出会持久化到 refs/hutch/id 下,也可以单独提交,用于分享(配合 magit-post-commit-hook)或日后重新渲染。眯着眼看,它有点像 stacked-diff 审查工具 的变更标识符,但它的目的是把审查留在 git 树里,而不是为人工审查标识 changeset。我们并不关心多方人工审查,一切都是本地的。
评估 #
给 Hutch 做基准测试,最难受的一点是很难从文本缓冲区里拉出可直接比较的输出。我最初跑评估时,会启动多个 headless emacs,并在 agent 输出渲染之前用 tee 接走,后来改用输出 Perfetto trace,并把它作为评估的底层载体。
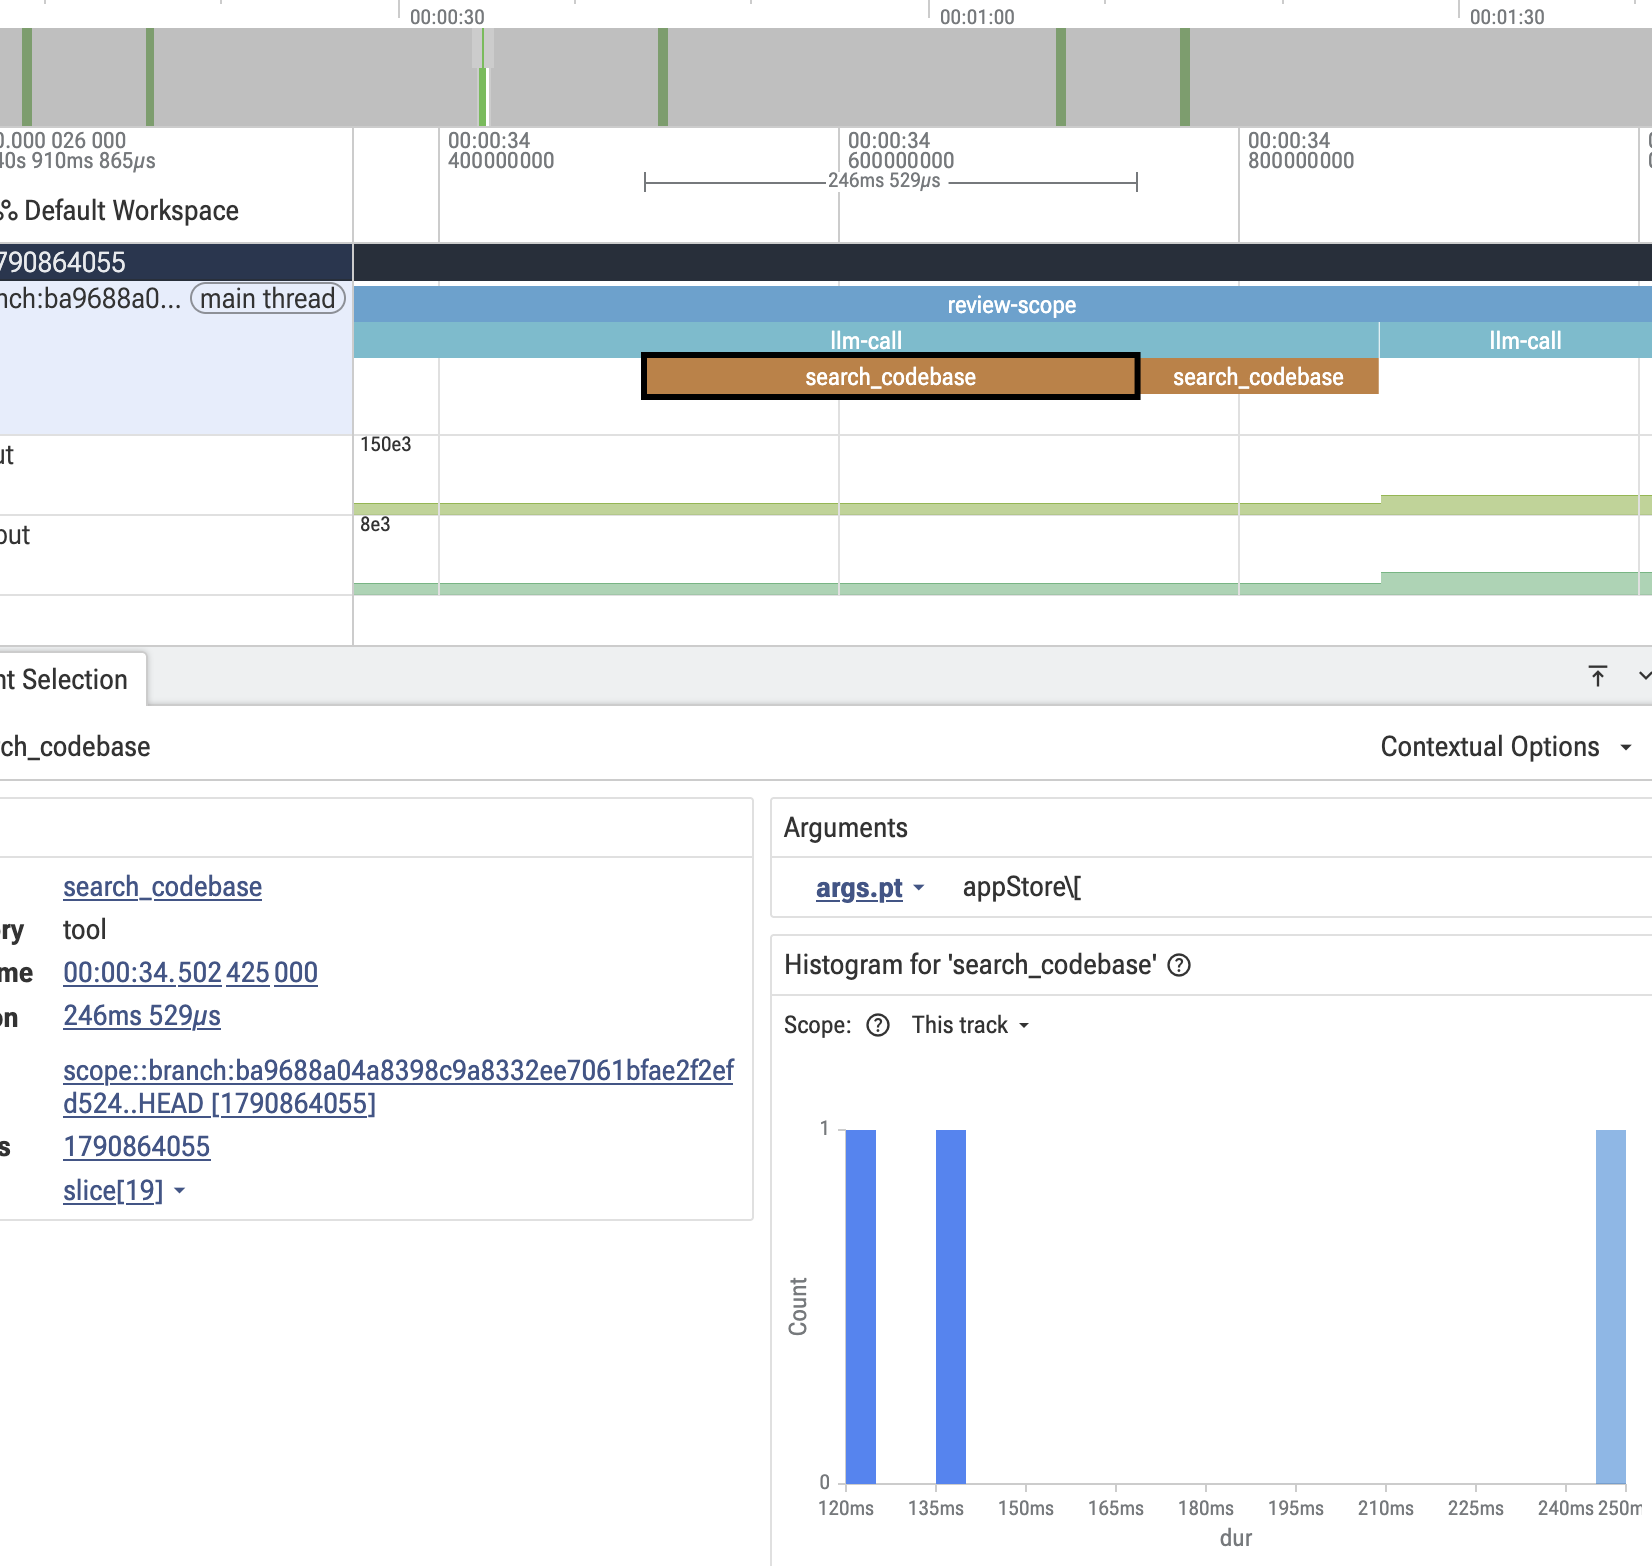
我没在别处见过用 Perfetto 追踪 agent 的做法。这大概是有原因的。它本来就不是为这种事设计的。它没有“prompt”或“tool call”这类一等概念。它是给内核和浏览器用的,而不是给一个充满散文的抽象系统用的。
但对单机、emacs 本地的 agent 来说,它勉强能用。你可以回答各种结构性问题,比如这次 review 为什么跑了 40 轮?、哪些工具是并行执行的?、读 diff 花了多少 wall time?等等。但更重要的是,它免费且不需要任何基础设施。只要设置 hutch-trace-dir,它就会输出 Perfetto trace,直接丢到 ui.perfetto.dev 上加载就行。很省事。
下面这个例子用来抓取工具调用及其总耗时。整条 pipeline 就这么多。不需要 dashboard,也不需要 SDK:
SELECT
  name                       AS tool,
  COUNT(*)                   AS calls,
  ROUND(SUM(dur) / 1e6, 1)   AS total_ms
FROM slice
WHERE category = 'tool'
GROUP BY name
ORDER BY total_ms DESC;

-- tool                 calls  total_ms
--------------------------------------
-- search_codebase      18     4210.3
-- read_diff            7      2103.1
-- surrounding_context  12     880.5
-- read_file            3      412.7
-- submit_review        1      42.9
搭好之后,我们混合采用 Martian 的 code review benchmark 和 CR-Bench 预印本中的策略,计算 Precision、Recall 和 Fβ 分数。评测细节在 eval/README.org 的 3 一节里有更详细的说明。大致来说,我们拿 40 个 PR、132 个 golden 跑这套 bench,用 GPT 5.2 作为分类 judge。评测 pipeline 直接对 trace 跑查询。看数字的话,我相信我们大概落在 Martian Offline Benchmark 排行榜第 16 名左右,对一个无记忆、单次执行的 agent 来说相当有竞争力。
除了分类打分之外,这个 agent 本身还有几点值得一说:
各模型命中的不同 golden 堆叠柱状图,分为独有、与另一个模型共享、与另外两个模型共享。opus-4.8:独有 15,与一个共享 17,与两个共享 18(共 50)。glm-5.2:13、19、18(共 50)。gpt-5.5:6、16、18(共 40)。三者并集为 78。
0102030405060708090命中的不同 golden
opus-4.8glm-5.2gpt-5.5
并集 = 78
独有
与 1 个共享
与 2 个共享
不同模型倾向于抓到不同的 bug。132 个 golden 中,每个模型命中 40–50 个,三个模型共同命中的只有 18 个。也就是说,假设三个模型一起跑,理论上能比单个模型多抓到约 55% 的 bug。
要我说,各模型对“什么算 bug”的判断一致性相当差。
三张柱状图,展示 40 个 PR 各自的 agent 轮数,按升序排列。opus-4.8:中位数 8 轮,最多 26。glm-5.2:中位数 11,最多 39。gpt-5.5:中位数 35,最多 81,其中好几个 PR 接近 80 轮的上限。
020406080轮次
opus-4.8
glm-5.2
gpt-5.5
40 个 PR 按轮次排序
40 个 PR 按轮次排序
40 个 PR 按轮次排序
命中率大致相同时,GPT 5.5 撞上我默认轮次上限(80)的次数远多于其他模型。Opus 4.8 完成任务所需的轮次只有三分之一。
三张柱状图,展示每个有效发现所消耗的输出 token,每个 PR 一根柱子,按升序排列。opus-4.8:31 个 PR,中位数约 2,600,最大约 13,000。glm-5.2:34 个 PR,中位数约 3,600,最大约 15,000。gpt-5.5:34 个 PR,中位数约 3,000,最大约 27,500。
05,00010,00015,00020,00025,000输出 token / 有效发现
opus-4.8
glm-5.2
gpt-5.5
PR 按每个有效发现的 token 数排序
PR 按每个有效发现的 token 数排序
PR 按每个有效发现的 token 数排序
在 token 效率上,Opus 每个有效发现消耗的输出 token 明显更少,优势不小,但输入侧烧掉的上下文是别人的三倍,可能是因为 Hutch 每轮都要重发不断增长的上下文。
出师未捷 #
据说这一切大概都为时已晚。已经没人真的手写或审查代码,也没人手动用编辑器和版本控制了。我做这个是为了自己,以及我仍在实践的工作流。我不想就应不应该把 LLM 和 emacs 一起用发表什么主张。这个工具更多是关于