折り紙 AI:ロードマップ
AI が生成した折り紙の画像は見た目が似ているだけで、実際に折れる展開図こそが設計だ。画像生成から展開図の自動求解までの道筋と難所を整理する。
日本語
コピー
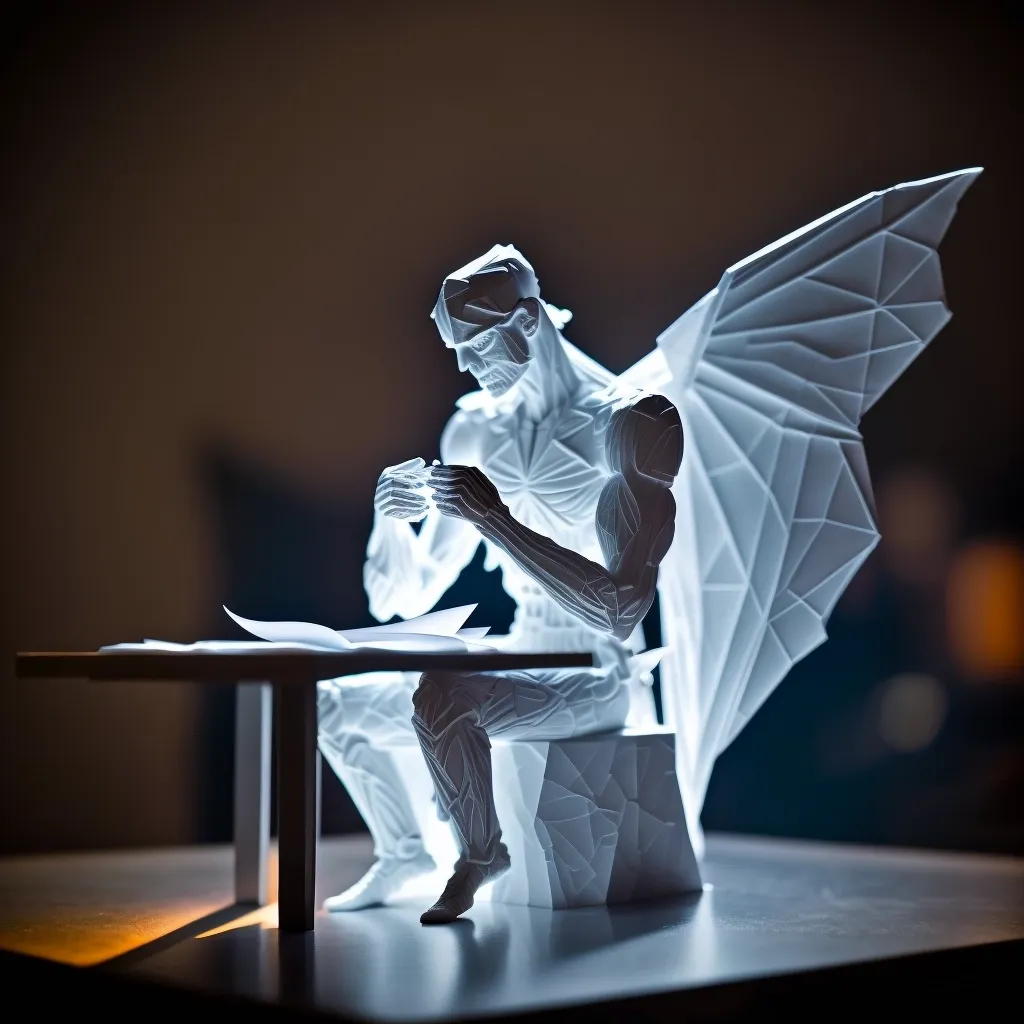
AIが設計した折り紙。画像はMidjourneyで生成
近年、Dall-E、Craiyon、Imagen、Stable Diffusion、Midjourney といったテキストから画像を生成するモデルの登場は、折り紙界にも関心を呼び起こした。私を含め何人かは、こうしたシステムで折り紙作品の画像を生成しようと試みている。この記事を書いている途中でChatGPTが公開された。扱うのは画像ではなくテキストだが、いくつか物足りない点はあるものの、AIの可能性を示している。一方でこうしたシステムは、生成される結果についても、インターネットから収集したデータの使い方についても懸念を招いており、折り紙界でも同じ懸念が上がっている。
本稿では、AIを折り紙に応用するためのロードマップを示す。今日すでに実現できていることを出発点に、既存の部品をどう活用し拡張すれば、最終的にユーザーの入力から折り紙を自動設計できるシステムになるかを構想する。これは今後の方向性の予測であると同時に、やるべきことのリストでもある。技術面を中心に扱い、コンピュータで折り紙を設計することが望ましいという前提に立つが、それでも、こうしたシステムが折り紙作家に何をもたらし、どんな論争を引き起こしうるかという議論を完全に飛ばすことはできない。技術的には可能でも、すぐには登場しそうにないツールについても触れる。
「AIが設計した」とは何を意味するか
折り紙作品をAIが設計するとは、どういうことか。AIは、人間のデザイナーに求めるのと同じことを果たすべきだ。すなわち、自ら作品を折るか、他の人がそれを見て折れるような記述を提示するか、どちらかである。まったく折らずに折り紙作品を設計することは十分可能で、私の設計でも実際に最後まで折るのはごく一部だ。AIが制御する折り紙マシンなら、どのみち何らかの形で作品の定義を先に受け取る必要があるのだから、折る工程は飛ばして「記述を提示する」工程に集中すればよい。
最近、「人工知能が設計した」折り紙というタイトルの投稿をいくつか見かけた。この言い方には戸惑った。というのも、それらはAIが設計したモデルではなく、折り紙風のオブジェクトの画像だからだ。折り紙風といっても、多くの場合、対象の主要な特徴を三角に区切っただけであり、よくても折り紙モデルの画像と表面的に似ているにすぎない。これらの画像は面白く印象的ではあるが、折り紙の設計とは言えない。設計は実行可能な定義でなければならない。同じ作者の後の投稿は、ほとんどがよりバランスの取れた説明になっている。
人間のデザイナーが設計を記録する方法はいくつもある。折り方の手順図、写真や動画のチュートリアル、あるいは折り図(CP)を描くこともある。折り図は扱いやすいとは言えないが、数学的に記述しやすく、モデルをほぼ曖昧さなく定義できるため、折り紙関連のコンピュータソフトの多くで第一の手段となっている。折り図には限界があるが、興味深いケースの大半は扱える。したがって、AIが簡単な入力(たとえば「大きな角を持つ鹿」というテキストプロンプト)から実際に折れる折り図を生成できれば、そのモデルは「AIが設計した」と認めてよいと私は考える。他の入力や出力でも成り立つかもしれないが、この方向の実用性と、AIおよび計算折り紙の既存の進展を踏まえると、テキストから折り図を生成するのがAIによる折り紙設計の最初のユーザーインターフェースになると予想している。
現状
現在の生成系テキスト画像AIは、それらしい折り紙風モデルの画像を描けるし、訓練データに含まれる特定のモデル(紙のボートや伝統的な鶴に限られることもある)を非常に忠実に再現することもある。大規模な商用システムは、Dall-E 2とCraiyon(旧Dall-E Mini)のように、無料の小規模システムより得意なことが多い。とはいえ進歩は非常に速く、新しいAIモデルが数週間で前世代を追い越すこともある。
こうしたAIシステムの重要な特徴として、特定のタスクでの性能は訓練に使ったデータセットに大きく左右される。訓練データに多く現れる作風(「油絵」など)や題材(「山小屋」や「森」など)はかなりうまく模倣するが、折り紙は苦手だ。訓練データに折り紙が多くないからである。
だがこの問題は簡単に解決できる。Stable DiffusionのDreamBoothのようなプロジェクトを使えば、既存のAIモデルに新しい物体のデータを追加できる。自分で試す時間はまだないが、実在の折り紙モデルの画像をまとめてこの方法でモデルに加えれば、折り紙関連のプロンプトへの反応は良くなるはずだ。また、何もカスタマイズしなくても、新しいモデルが生成する折り紙画像の質は上がっている。おそらく訓練データが大きくなったからだろう。私が試した中では、Dall-E 2が生成する折り紙モデルの画像が最も説得力があった。Midjourneyの作品は作風の癖が強く、そのぶん実際の折り紙モデルには見えにくい。
インスピレーション生成器
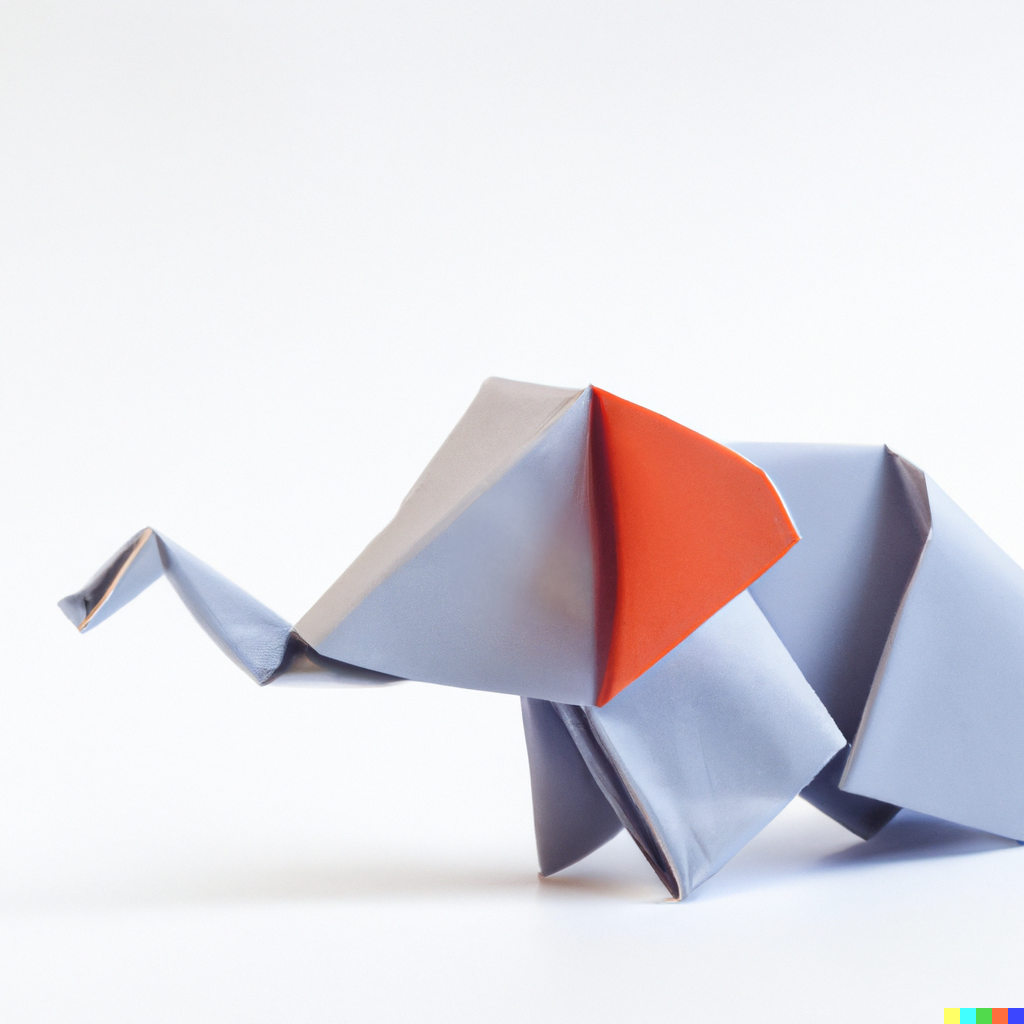
Dall-E 2 で生成したこの折り紙の象はなかなか説得力がある。これに似た折り紙の象を実際にデザインすることも、ひょっとすると可能かもしれない
この道はどこまで通じるのか。どんなに強力な AI システムでも、扱っているのは結局のところ画像でしかない。つまり、内部に「折り紙のモデルは紙を折って作るものだ」という概念はなく、そこから生じるモデル構造上の制約も理解していない。それでも、十分な訓練データと多少のプロンプト調整があれば、こうしたモデルは今日すでに、折り紙愛好家でも本物のモデルなのか折り紙風の絵なのか判断するのにしばらく見入ってしまうような折り紙モデルの画像を生成できる。
モデルに明らかな未折畳の特徴がなければ、それが本物の折り紙を表しているかどうかを判断するのは必ずしも簡単ではない。たとえば、ある企業ロゴに使われた折り紙風の象について、折り紙愛好家たちと SNS で議論したことがある。あの象は折り紙の経験がない人が、ネットで見つけた本物の折り紙作品に着想を得て描いたものにすぎない。その後、議論に参加していた一人が、その絵に似た折り紙モデルをデザインした。つまりあの象は、当の(人間の)デザイナーが知らないうちに、実際に折れるものだったのだ。AI が生成する折り紙風の画像でも同じことが起こりうる。
私の以前の定義に照らせば、これはまだ折り紙の設計とは言えないが、こうした考え方で目標に少し近づける。奇しくも、この記事を書いている最中に、それがすでに起きたことに気づいた。Grant Marshall(@FearlessFlourish)が、AI 生成画像のとおりに実際に折るチャレンジを始め、それを成功させた人が現れたのだ。残念なのは、実験そのものは称賛に値するのに、その説明が私が先に批判した大げさな言い回しを使い、AI がこのモデルを設計したと主張している点だ(それなら人間のデザイナーに挑む必要などあるだろうか)。
上で述べたこの段階を、私はインスピレーション生成段階と呼んでいる。AI が生成するのは折り紙風の画像で、人間の作り手はそれを着想として本物の折り紙モデルを設計できる。生成される画像が非常に写実的なら、あの手描きの象のように、折り紙で高い再現度で再現できるかもしれない。逆に、出来の良くない画像でも着想にはなりうる。折り紙作家が一枚の絵や、面白い形の石から着想を得るのと同じだ。着想そのものは折り紙とは無関係で、見る人の頭の中に何かの糸口を開くだけのことかもしれない。
折り上がったモデルではなく CP で作業する
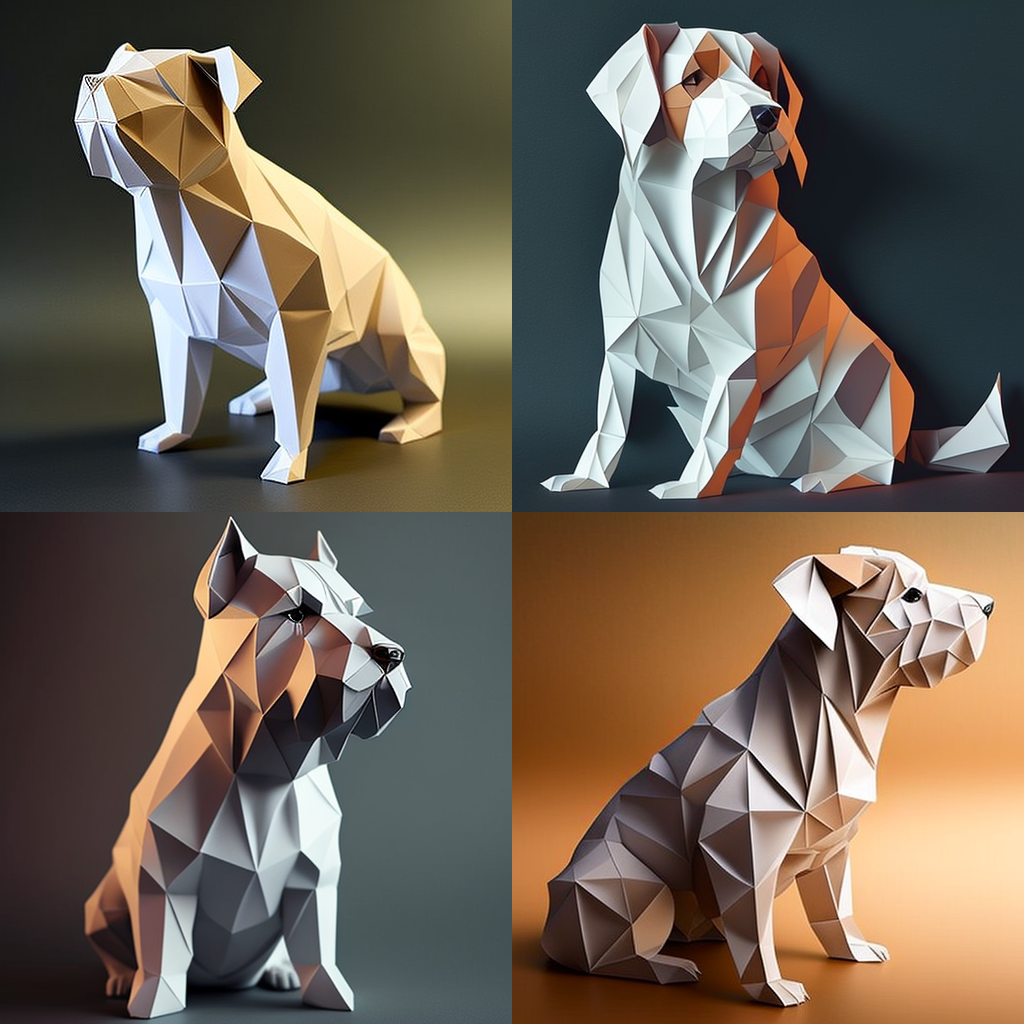
画像は良いが、Midjourney は折り紙の折痕図が何かを今のところ全く分かっていない(私が試した他のモデルも同じ)
今日すぐにでもできる実験がもう一つある。本物の折り紙の折痕図の画像を AI モデルに食わせ、そうした訓練セットから何を生成するかを見るのだ。デフォルトの状態では、私が試したモデルは折痕図が何かを全く分かっていないので、こうしたデータはカスタムの追加分としてしか入れられない。それでも、依然として画像空間で作業しているにせよ、AI モデルは折痕図を折り畳み可能にしている特徴を自力で見つけ出し(訓練データには折り畳み可能な折痕図しか入れないのだから)、生成画像の中でそれを再現できるかもしれない。単なる推測にすぎないが、今日のモデルが十分に訓練されれば、前川定理やその他の平坦折り可能性の規則を明示的に教わることなく、ほとんどの場合に正しい平坦折り可能な折痕図を生成するようになっても、AlphaGo Zeroの例があるだけに、私はそれほど驚かない。
可能性はより低いが、それでも私にはありうると思えるのは、特定の題材のモデルの折痕図を、ある程度は生成できるようになるかもしれないという点だ。折痕図の対称性は、完成したモデルの付属肢の数に依存する。こうした全体的な対称性があれば、一般的な場合に図を読んだり描いたりする能力がなくても、四足動物の折痕図とクモの折痕図を区別できる。この実験(および訓練セット)を、たとえばボックスプリーツのように単一の技法だけを使った折痕図に限定すれば、課題はさらに単純になる。
一方で、AI モデルに正しい折痕図を安定して生成させ、しかもそれが特定の動物——たとえば猫とは明らかに違う犬——の説得力のあるモデルとして折り上がるようにするのは、まったく別の話であり、現在の AI モデルではまず無理だろう。
画像だけを頼り、折り紙の規則を一切参照しないというのは極端に聞こえるかもしれないが、似たやり方が実際にうまくいくこともある。天気予報の実験では、気団や雲の背後にある挙動を一切参照せず、衛星画像だけを使った。AI にコンピュータゲームを遊ばせる実験も成功しているが、これも画面に見えている映像の画像だけを頼りにし、ゲームの規則についての明示的な知識を一切持たない。ほとんどの AI システムと同様、こうした手法は膨大な訓練セットに依存しており、折り紙の場面ではそれが問題になりうる。
これからどこへ向かうのか
ここで少し先へ早送りして、完璧な AI 駆動の折り紙設計ツールがどんなものかを想像してみよう。それをどう実現するかという難題は、しばらく脇に置いておく。以下は、私が思い描く対話の一例だ。
> a deer with large antlers
[a folded model representing a realistic deer with large antlers appears in the 3D view, with the CP (e.g. 22.5°) in a side panel ]
> box pleating
[a new CP, this time using box pleating, and corresponding rendered folded model are generated]
> cartoon style
[proportions are changed to make the deer look more like Bambi]
> add eyes
[previous model had a smooth face, now a new version appears in which eyes are clearly marked by folds]
> longer legs
[modified model appears]
…
[user is satisfied with the design, switches to shaping mode]
> lift front left leg up
[change is applied to 3D view, CP remains same since it’s just shaping]
[user grabs the ears in 3D view and moves them around as if shaping an actual paper model]
[user can export the CP as well as 3D view, both in drawing and photorealistic style]
[user can generate drawings of step-by-step folding instructions for the model automatically]
この先進的なツールは、設計の全工程をこなせるべきだ。つまり、入力はモデルについての大まかな説明だけでよく、依頼者が雇った人間の折り紙デザイナーに渡すものと似ている。画像生成や ChatGPT でのこれまでの経験からすると、テキストのプロンプトが適切な選択だろう。表現力が高く、簡潔で、共有や議論も容易だからだ。どんな入力に対しても無数の可能な解が存在し、どれが優れているとも言い難い以上、乱数シードを手動で設定できるべきだし、現在の画像生成モデルに見られるように、アルゴリズムの挙動を制御する追加の設定もおそらく必要になる。
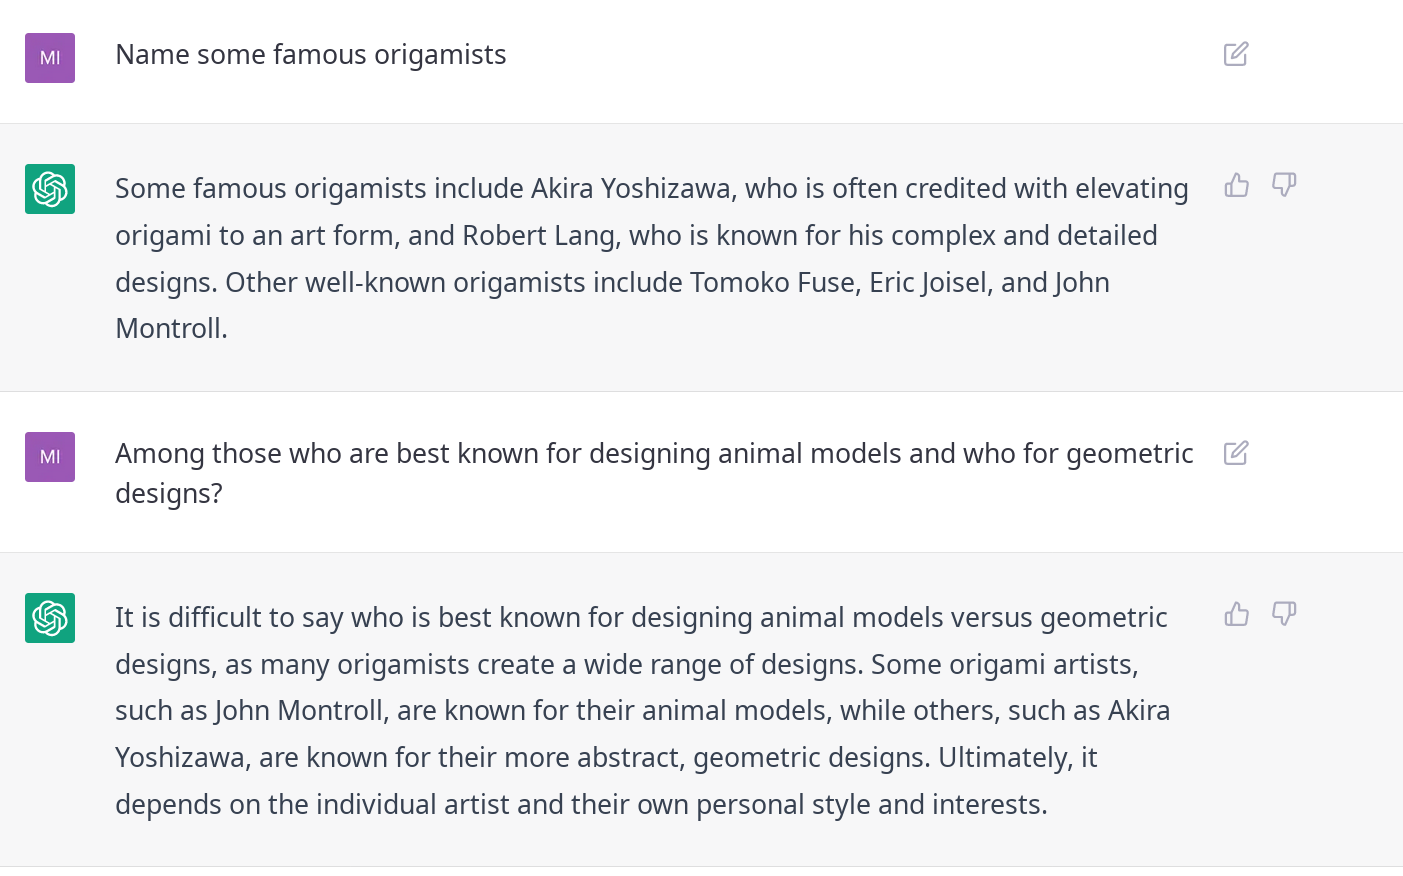
ChatGPT のインターフェースは、対話型の折り紙設計システムの出発点になりうる
システムには対話性も必要だ。プロンプトを手軽に書き換えたり、変更や制約を追加したりして、その影響をリアルタイムで確認できるようにしたい。ChatGPT が示した対話形式は、段階的に作り込んでいくための道具として向いているように思える。box pleating と 22.5° 法のどちらを使うかといったよく使う選択肢は、ボタンにすればタイプ量を減らせる。説明するより見せたほうが早い変更もあるので、CP が収束していく過程を分析したり、小さな手作業の修正を加えたりできる 3D ビューも用意すべきだろう。このビューは、プログラムが提案する整形とユーザーが手で加える整形の両方を試すのにも使える。最後に、CP の段階で手を入れるための、折り畳みシミュレータ付きの従来型 CP エディタも要るだろう。
CP を手で修正したりモデルをポーズ付けしたりする以外に、人間の作り手の役割は、思い通りの特徴をモデルが備えるまで設計過程を導く適切なプロンプトの列を設計し、最終的にそのモデルを折ることにある。実物を折る工程が、設計する工程よりも長く機械の能力の外にとどまっていても不思議ではない。折るには専用のハードウェアが要り、コストは高く、ソフトウェアに比べて再利用できる既製の部品も少ない。面白いのは、最も極端な場合——対話性を排し、人間は入力プロンプトを1つ与えるだけで、あとはすべて AI に任せる場合——でも、設計を始めることと、AI が生成した結果を受け入れるか拒否するかは、依然として人間の役割だということだ。
そこへ至る道
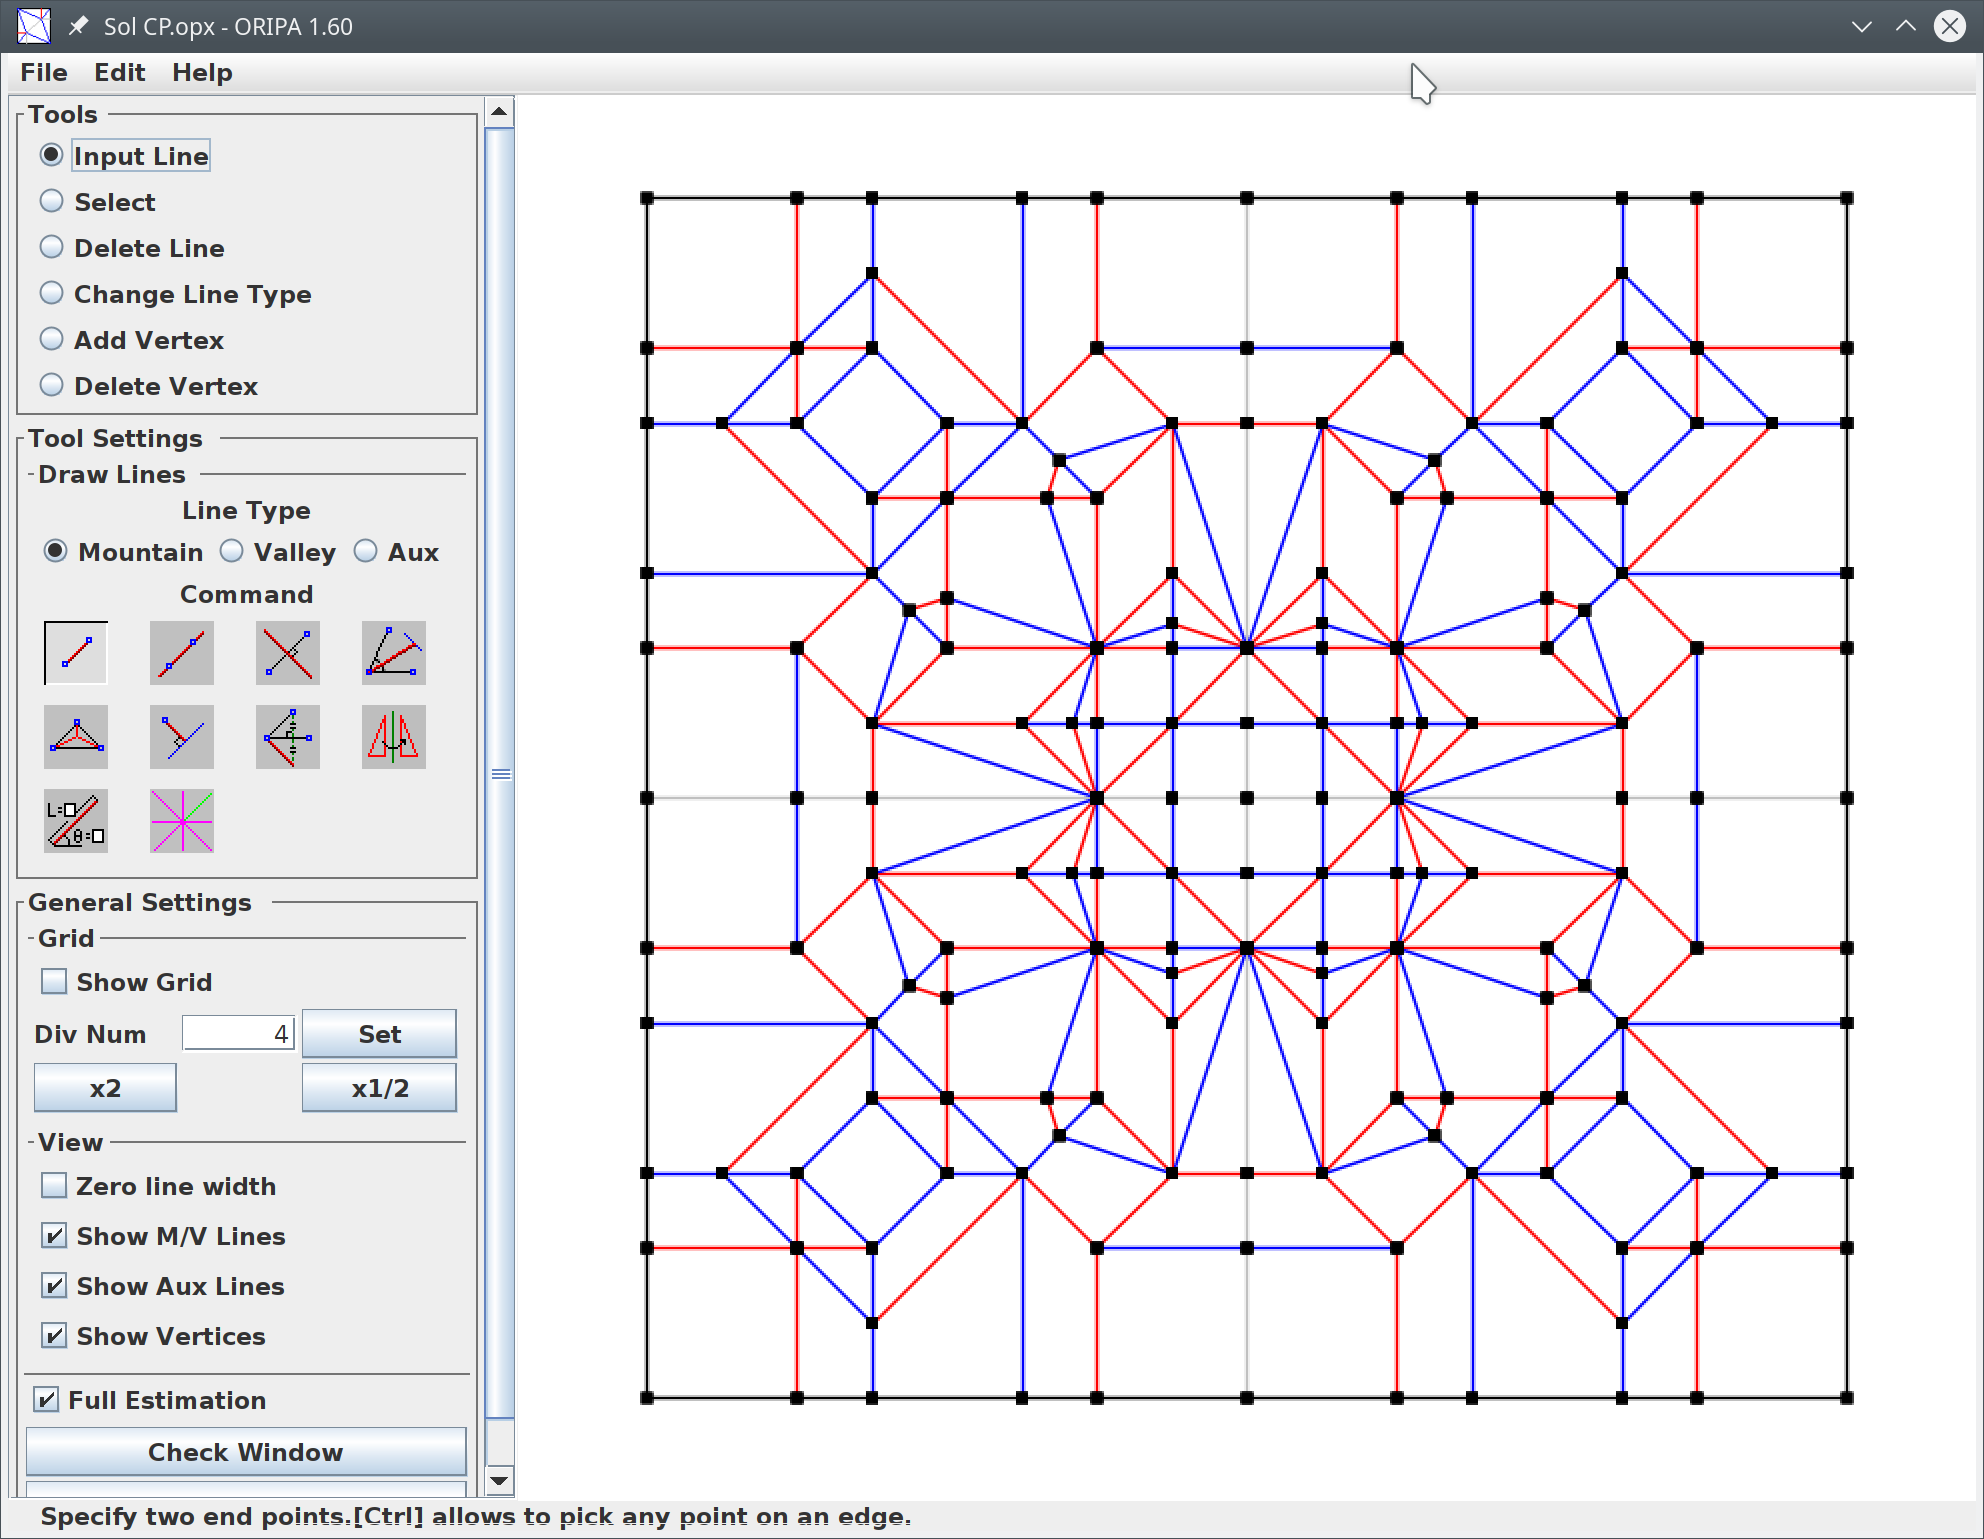
Oripa で折り図を編集する(私の Sol モデル)
上述の完璧なシステムを作り始める前に、すでに何があるかを考えてみよう。意外なことに、このシステムのかなりの部分はすでに揃っていて、しかも AI に一切頼らず、厳密なアルゴリズムだけで十分に動く。TreeMaker と Box Pleating Studio は、人型や動物の形といったモデルの線画を入力に取り、それを折り出せる折り図を生成する。Oripa などのツールを使えば、折り図を描き、それが正しいか確認し、プログラムに画面上で折らせることができる。Origami Simulator なら、折り図を仮想的に折り、一部をマウスでつかんで引っ張り、どう反応するかを見られる。
これらのサブシステムは単体でもかなり優れているが、適切な箇所に AI を少し持ち込めば、さらに先へ進める。既存の機能の性能を上げる変更もあれば、まったく新しい使い方を生む変更もある。
最低限
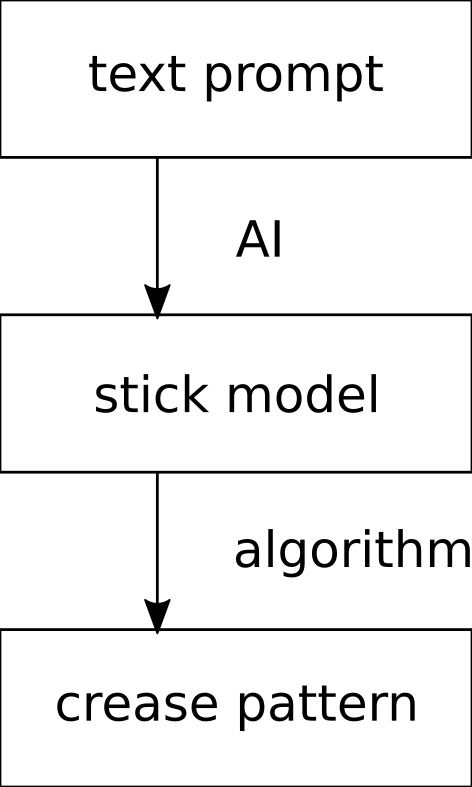
基本的なテキストから CP への AI パイプライン
私の定義に従えば、システムに折り紙を設計させるのに、今のところ厳密に欠けているのは1つだけだ。テキストから CP へのマッパーである。AI なしで棒人間から CP への変換がすでにできるのなら、足りないのはテキストから棒人間への段階だけで、今の生成モデルの能力からすれば、それは荒唐無稽には聞こえない。十分なデータ(実際に用意できる規模の)を与えさえすれば、既存のモデルは「大きな角を持つ鹿」といったプロンプトからそれらしい棒人間を生成するのがかなり得意になるはずだ。対処すべき問題が1つある。これらのモデルが生成するのはビットマップで、必要なのはベクター画像だ。とはいえビットマップからベクターへの変換は AI なしでもすでに良好に機能するし、棒人間は問題全体の中の特定の一部分にすぎないので、微調整すればもっとうまくできるだろう。
こうしたシステムの出力は粗い(折り紙の基本形の CP であって、モデルを本物の動物らしく見せるために通常行う整形は施されていない)が、それでもこれを「AI が設計した折り紙」と認めるつもりだ。
さらなる改良
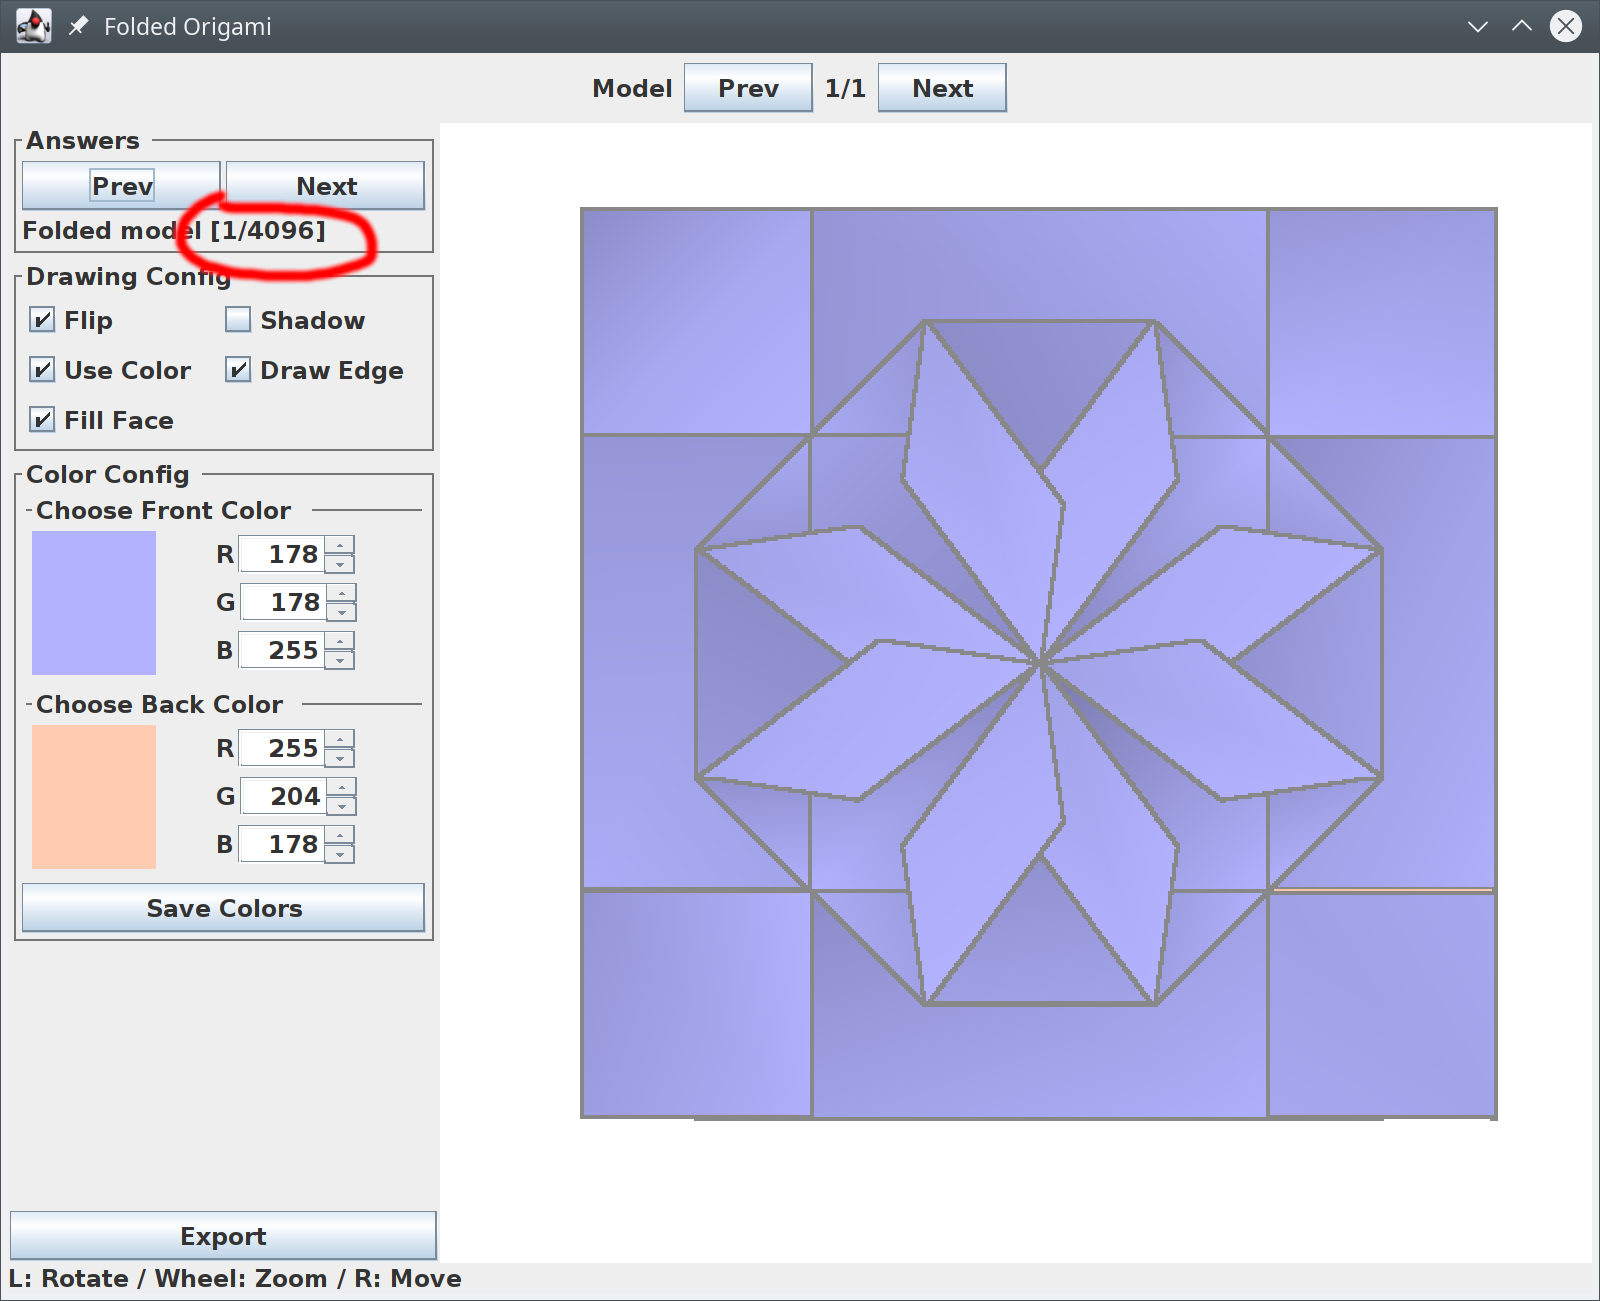
折り紙モデルによっては可能な層順が膨大にあり、AI がその整理を助けられる(Oripa での私の Sol モデル)
以下に挙げる改良は、前段の基本的な AI 折り紙設計システムを強化するものだが、その多くはそれとは独立に、既存のアルゴリズムベースのツールの拡張としても実装できる。
- 色替えやその他の設計上の特徴への対応
- 多様な設計パラダイムへの対応(ツリー法、ボックスプリーツ、六角形プリーツ、非平坦折り設計、曲線折りを伴う回転曲面など)
- スタイル転送
- 「ソフトな」変形によるポーズ付けと整形のシミュレーション。手動での誘導にも自動での実行にも対応する
- CP、段階的な手順、さらには動画チュートリアルまで、さまざまな形式でモデルの記述や折り方を自動生成する。この仕組みは AI が生成したモデルにも人間が設計したモデルにも使える——後者は図を描く手間に阻まれてあまり知られていないことが多い
- 人がモデルを折っている動画から、CP ではなく折り手順を生成する
- 段階的な手順の画像からモデルを仮想的に折り、その CP を求める。スマートフォンで撮った CP の写真からモデルを仮想的に折るのは、今ならすでに可能なはずだ(画像のベクター化+アルゴリズムによる CP の折り畳み)
- 折り上がったモデルの写真からモデルをリバースエンジニアリングする
- 折り紙に AI ベースの情報検索を使う。たとえば画像やテキストの説明からモデルの名前、作者、発表情報を探し出す(Spot the Creator という Facebook グループが人手でやっているのは、おおよそこれだ)。ChatGPT のようなモデルを適切なデータで訓練すれば、これはある程度すでに可能かもしれない。
- 設計の観点から筋の通る層順を自動で見つける。設計によっては可能な層順が膨大にあり、その生成には今のところ多大なリソースがかかり、ソフトウェア上での整理も難しい
- CP が平坦折り可能か、剛体折り可能かといった、NP 困難あるいはその他の計算量の大きいタスクの性能を上げる。ヒューリスティクスは存在するが、AI ならより良く、より速い結果を出せるかもしれない。
AI モデルは時間の経過とともに必ず改良され、同じ入力に対してより良い出力を、しかもより速く生成するようになる。完璧なシステムなど存在しないのだから、時間が経てば何らかの形の prompt engineering が現れ、設計者がこれらのツールをより効果的に使えるようになるのは必然だ。
折り紙 AI 研究の短期的なロードマップ
現在は インスピレーション生成器 の段階にある。上に挙げた折り紙 AI の応用のうち、高度なものは実装が難しいが、比較的容易なものもある。以下は、今まさに注力すべきだと私が考える方向性で、直接的な成果を狙いつつ、その後の研究の土台も築くものだ。
- 大量の折り紙モデルの画像で既存の text-to-image モデルをファインチューニングし、インスピレーション生成器 段階での性能を上げる。
- インスピレーション生成器 というアイデアを検証する。AI が生成した画像をもとに人が折り紙モデルを設計し、それが実際にどれくらいの頻度で可能なのか、また的を絞った訓練で本当に折れるモデルができる確率を高められるのかを調べる。
- 折り図(crease pattern)の画像で既存の text-to-image モデルをファインチューニングし、少なくとも大まかに正しい(つまり折れる)折り図を生成できるかどうかを調べる。その後、与えられたテーマに似たモデルの CP を生成できるかどうかを調べる。
- 折り紙関連の文献で大規模言語モデルをファインチューニングし、元の ChatGPT などと比べてこの分野の知識がどれだけ向上するかを確認する。
- 大規模言語モデルに折り紙の折り図を生成させることを試す。すでに Chat GPT に基本的な SVG を出力させることは可能なので、的を絞った訓練によって SVG や Oripa OPX 形式の CP を出力させられるかもしれない。自由文よりも厳密に折り手順を記述する略記法を開発する価値はあるだろう。おそらくチェスの棋譜記法のようなもので、その記法で記述されたモデルを使って AI を訓練する。明らかな問題は、訓練データをすべてゼロから生成しなければならないことだ。追記:FoldMation は折り紙の折り手順を記述するために DSL(ドメイン固有言語)を使っているらしく、上述のような機械学習にちょうど向いているかもしれない。
- text-to-stick-model 生成器を作る。前述のとおり、こうしたコンポーネントを構築して既存の折り紙設計ツールと組み合わせることが、粗い text-to-crease-pattern システムを実現する前に残されたほぼ唯一の部分だ。これが、完全な設計経路(まずは整形を含まない、折り可能なベース)を扱える最初の実用的な AI システムになるだろうと予想している。
これらの提案では、既存の AI モデルのファインチューニングに焦点を絞った。折り紙に特化したモデルをゼロから作るのは、現時点ではかなり非現実的に見えるからだ。手間もコストもそこにある。これらのアイデアがうまくいくかはまだ分からない。良い結果が出るかもしれないし、出ないかもしれないが、研究はここから始めるべきだと考えている。とはいえ、AI の分野では大規模言語モデルの成功など、大きな驚きが何度もあった。だから本当に折り紙を設計できる AI を生み出すのは、こうしたアイデアではなく、まったく別のアプローチかもしれない。
論争

Image generated with Dall-E 2
AI 画像生成器は、特にインターネット上のアーティストのコミュニティで、多くの論争を引き起こしている。この話題は独立した記事を書く価値があるほど広いので、ここでは議論の主な争点だけを挙げる。批判者はこう主張する。AI 生成画像は偽情報の作成と拡散に容易に使える。さまざまなステレオタイプを助長しやすい。その生成方法は実在のアーティストの作品を無断で利用しており、補償もなければ、直接的な剽窃にあたる場合さえある。最後の点はアーティストの失業や、真の創造性の衰退にもつながりかねない。
まず、論争の潜在的な程度は AI の用途によって異なると私は考えている。将来、折り紙ツールが AI を使って CP から折った複雑なモデルの妥当な層順を自動で見つけられるようになっても、それに文句を言う人はいないだろう。コンピュータグラフィックスの分野で、スマートな傷除去フィルターの使用に反対する人がほとんどいないのと同じだ。多くの議論を呼ぶのは、AI が設計者の役割を担えるようになったときだ。
こうした議論は折り紙コミュニティでも必ず起きるし、実際すでに起きている。ただし、折り紙界に関係するのは最後の種類の問題、つまり AI が芸術とアーティストに与える影響の問題だけだと思う。グラフィックデザイナーなどとは違い、折り紙の創作者でこの技で生計を立てている人はほとんどいない。さまざまな画像を大量生産することには明確な用途があり、人手ではなく自動化でそうした作業をこなす需要はある。だが、折り紙モデルを大量に設計することに現実的な用途は見当たらないので、面白さ以外にやる動機はほとんどない。だから AI が設計者の役割を担うことによる経済的な影響は、折り紙コミュニティでは他のメディアのコミュニティほど大きくないと考える。
もちろん、「人間の設計者として何年も経験を積まないとできない設計を、誰でも数分でできる」という問題は残る。AI ベースの作品が手作り設計のふりをされない限り、大きな問題にはならないだろう。自動車があっても人は走ったり自転車に乗ったりするし、マラソンもあれば自動車レースもある。商業化の度合いが低く、多くの人がただ楽しみでやっているおかげで、折り紙は他の分野でずっと深刻になっている論争をほぼ避けられているのは幸運だ。大量生産の動機がなければ、大量生産の能力も問題にならない。
折り紙コミュニティはこれまで、異なる仕事のやり方をする人たちに対してかなり寛容だったと思う。何が折り紙で何が折り紙でないかをめぐる議論はもちろんあるが、誰かが使った技法を別の誰かが受け入れないからといって、聖戦が起きたのを見たことはない。超複雑折り紙の分野のデザイナーは早くから高度なコンピュータツールを使ってきたし、ミニマルなウェットフォールディングのモデルを作る人たちはそんなツールにまったく関心がない。モデルを端から端まで設計できるAIを道具箱にもう一つ加えても、この態度は変わらないだろう。折り紙は程度の差こそあれ、自分で課した恣意的な制約1——たとえば切ったり糊を使ったりしないこと——が本質だ。今日でも、追加の道具を使えばずっと簡単に作れる作品はたくさんあり、それをあえて使わないという選択をしている。AI設計もそういう道具の一つにすぎず、使う作り手もいれば使わない作り手もいる。
一方で、「AIは盗用だ」という論は、折り紙に関しては他のメディアよりも根拠があるかもしれない。こうしたシステムがサンプルから学習する仕組みと、その出力と訓練データの関係は複雑で、白か黒かで割り切れる問題ではないと思う。ただ、折り紙の訓練セットは写真や芸術画像に比べてはるかに小さくなる。世界中で利用できるサンプルが少ないからだ。そのため、生成された作品のかなりの部分が訓練データをそのまま写し取るものになる確率は、おそらく高くなる。実際にそうなるかどうかは、見てみないとわからない。
なぜこうしたことは永遠に起きないかもしれないのか
Midjourneyで生成した画像
技術的に可能だからといって、実際に起きるとは限らない。
最もよくある理由は経済だ。可能だが、費用が法外にかかるということがある。2023年時点で、人類が最後に月面を歩いてから50年——1972年——が経っている。明らかに可能なのに、次の試みは2025年まで待たなければならない。月面着陸には経済的な基盤がなく、それを後押ししたのは強い政治的意志であり、それがなければ実現しなかった。
もう一つの理由は社会的なものかもしれない。人々や組織が、さまざまな理由からあるやり方を拒むことがある。
テキストからの画像生成という形の生成AIには、直接的な実用価値(ウェブサイトやその他のメディア向けの画像を作る)があり、同時に企業が自社の能力を示す絶好の実験場でもある。ChatGPTのような大規模言語モデルも同じだ。これが研究開発を促し、企業がこうしたシステムの構築と改良に多大な資源を投じる理由になっている。
折り紙にはそうした経済的インセンティブがない。それで稼ぐ人は少なく、折り紙を理解する人も、折り紙AIを企業の能力を示す良いデモにするには足りない。だから折り紙に特化した開発は、アカデミアか、熱心な愛好家が単独で行うものになるだろう。ニッチではあるが、計算折り紙は確かに存在し、研究している人もいる。たとえば、AIと折り紙の両方に興味を持つ博士課程の学生がいれば、その一人でこの研究方向全体を立ち上げられる可能性が高い。商品化がもう一つの道かもしれない。AI技術がどこにでもあり、安く、使いやすくなれば、新しい領域に応用するのに専門知識は要らなくなるかもしれない。そうした商品化された技術は最先端ではないが、明日の時代遅れの技術は、たいてい今日の最先端より進んでいる。
折り紙AIを開発しにくくするもう一つの理由は、訓練データの不足だ。機械学習は通常、大量のサンプルに依存する。Stable Diffusionは20億枚の画像で訓練されたが、この規模が可能なのは、説明文付きの画像をウェブから収集できるからだ。それらの画像はもともと別の用途で作られたものだ(このこと自体が論争を引き起こしてきた)。折り紙関連のデータはそこまで多くない。折ったモデルの単純な写真すら少なく、ましてや適切な説明が付いた折り図となればなおさらだ。とはいえ希望がないわけではない。既存のモデルの微調整には、はるかに少ない画像で済むことが多く、数枚で足りることもある。ただ、この道がどこまで行けるかは、見てみないとわからない。
まとめ
私の見立てはこうだ。さまざまな題材をさまざまなスタイルで扱い、高品質な折り紙デザインを端から端まで完成させるコンピュータソフトウェアは、まだかなり先にある。だが、テキスト記述を受け取り、限られた題材について折り畳み可能な折り図を出力する初歩的なシステムなら、今日の技術でも十分に作れる可能性が高い。本稿では、既存のツールでそうした仕組みを構築するためのロードマップを描き、さらに改良するために必要な手順を示した。ただし、技術的に可能であっても、AIベースの折り紙ツールの多くはすぐには登場しないかもしれないとも指摘した。同時に、高品質な生成AIモデルが登場したときに視覚芸術の世界を揺るがしたさまざまな論争は、折り紙の世界ではずっと弱いものになるだろうと考えている。
予測は難しい。新しく、非常に活発な分野ではなおさらだ。だから数年後にこの記事を読み返して、時の試練に耐えているかどうか確かめるのは面白いだろう。
- 啓発的なメールでのやり取りをしてくれたHans Dybkjærに感謝する。もともとは折り紙の分類をめぐる議論から始まったものだが、折り紙におけるAIというテーマにも同じように関係していると思う ↩