兆パラメータのコーディング agent に兆単位のトークンを供給する方法
Modal のエンジニアチームが、兆パラメータ級のコーディング agent に兆単位のトークンを供給する方法を解説する。推論基盤、トークンキャッシュ、スケジューリングまでを層ごとに分解する。
日本語
コピー
ソフトウェアが世界を飲み込み、エージェントがソフトウェアエンジニアリングを飲み込もうとしている。ソフトウェアエンジニアが理解すべきなのは、エージェントソフトウェア——今や彼らにとって最も重要なツール——だけではない。そのエージェントソフトウェアの知能の中核、つまり大規模生成言語モデルの推論がどう動いているかも理解すべきだ。エンジニアが自分のツールを理解し制御したいからという理由だけではなく、少なくとも推論がコンピュータの他のあらゆる用途よりも多くの計算資源を消費し、より大きな利益を生み出そうとしているからでもある。コーディングエージェントに推論を提供する上で核心となる事実は、相対性能と絶対性能の両方で極めて高い水準を達成しなければならないということだ。相対性能とは、使っているハードウェアのピークレート、いわゆる「光速」の大きな割合に到達すること。絶対性能とは、ピークレートそのものの桁が大きく、1リクエストあたりの処理量も大きいことだ。今日の Tensor Cores のような行列演算アクセラレータは毎秒petaFLOPの桁で動いている。ソフトウェア開発を自動化できるほど知能の高い大規模生成シーケンスモデルは数兆個の浮動小数点パラメータを持ち、1リクエストを処理するだけでも各パラメータに毎秒複数回アクセスしなければならない。こうした要求のため、経済的に成立するコーディングエージェント推論サービスは、ハードウェアとエンジニアリングのコストを薄められる規模——おおよそ数兆入力・出力トークンの規模——でしか今は成り立たない。私たちはそれを実現したので、やり方を共有したい。Modalではこの規模のコーディングエージェント推論サービスをいくつか運用しており、同じことをしている複数の顧客とも協業している。OpenRouter や Vercel AI Gateway のような推論ルーティングプラットフォーム経由で間接的に私たちのサービスを使うこともできるし、Shared Endpoints から直接使うこともできる。このブログでは、Moonshot AI の Kimi K2.6 にコーディングエージェント向けの推論を提供する際、推論性能をどう最適化したかを順を追って説明する。この分野の基準では、このモデルはすでに「古い」(文字通り数百日!)が、シーケンスモデリング、ハードウェア、スケーリングの基本原理は十分にゆっくりしか変わらないので、核心的な流れと多くの細部は、より新しいモデル——Kimi K3 のように知能とコストパフォーマンスでK2.6を置き換えたモデル——に対して私たちが行った作業と一致している。私たちの最適化により、推論レプリカの単一レプリカ性能は、ユーザーあたり2.8倍、レプリカ上のユーザー間で5.6倍向上した:
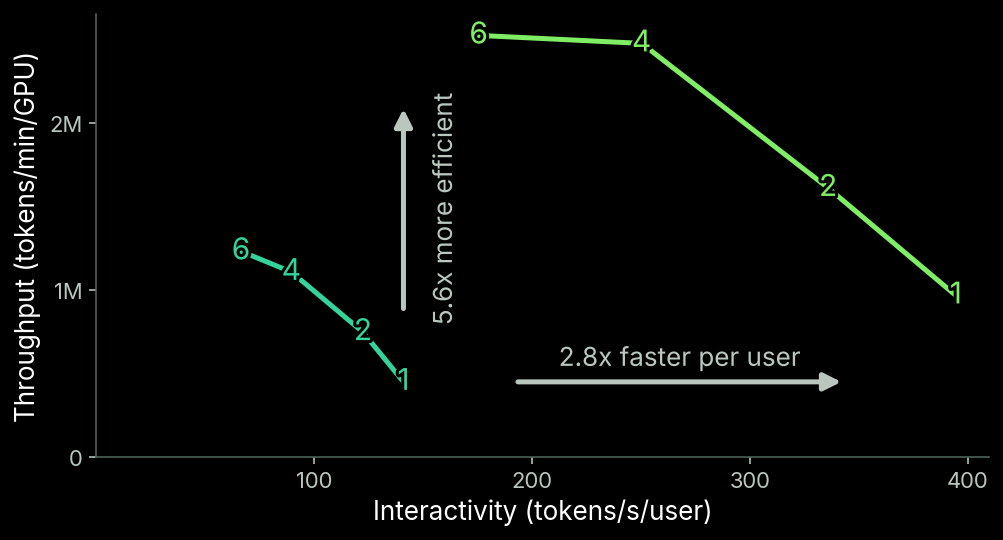
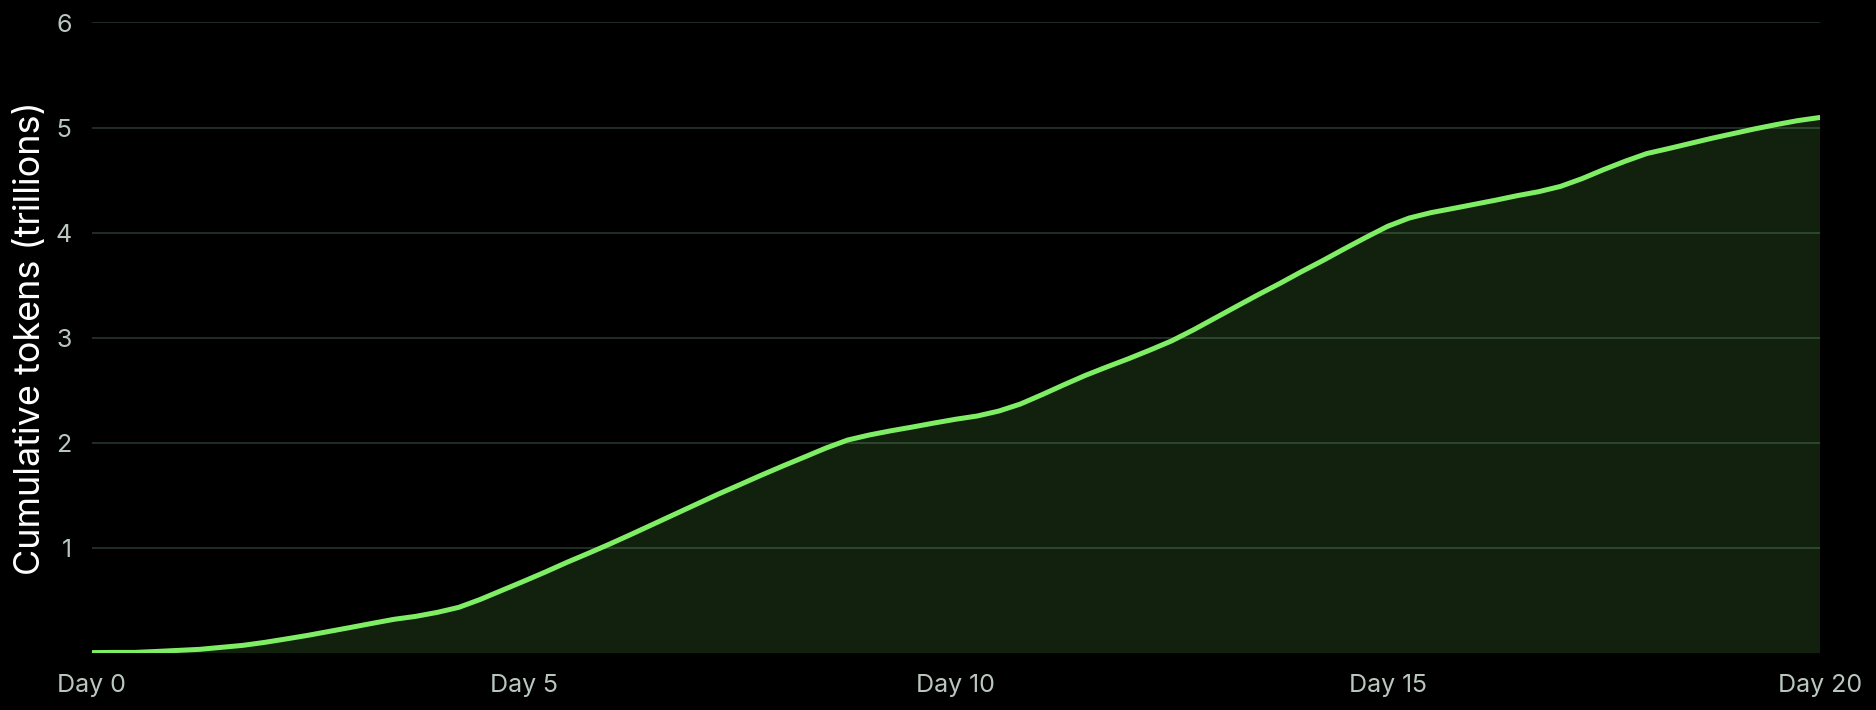
この図は、単一ユーザーの体験(ユーザーあたり毎秒デコードトークン数、つまり_インタラクティビティ_)をx軸に、システム全体のコストパフォーマンス(GPUあたり毎分総トークン数、つまりトークンスループット)をy軸に取り、各点に同時ユーザー数を注記している。もっと言えば、これは右側のUXで法外に高いサービスと、左側のUXで競争力のある価格のサービスとの差だ:その後、これらの単一コンテナレプリカをdeploymentとserviceにスケールした。あるserviceは1日あたり数千億トークンを処理し、累計で数兆に達している:
以下では、この性能エンジニアリングを普通のソフトウェアエンジニアにも読めるものにしたい。私たちと顧客がこれらのサービスをどう運用しているかを共有することで、同じこと——たとえばModal上で Dedicated Endpoint をデプロイする——助けになればと思う。
まずワークロードを理解する。
これを2つに分ける:各リクエストへの応答を推論するシーケンスモデルを理解することと、リクエストをまたぐワークロードの構造を理解することだ。
最先端のコーディングエージェントの背後には数兆パラメータのニューラルシーケンスモデルがあり、入力は並列に、出力は直列に推論する。
現代のコーディングエージェントは、Unicodeシーケンスの確率生成モデルによって駆動されている。これらのモデルは主に教師なしマスク付きシーケンス予測で事前学習され、その後主に出力ソフトウェアの正しさに対する強化学習で後学習される。コンパイラのパーサーと同じように、生の文字列ではなくトークン化されたシーケンスを扱うので、その入力と出力を_トークン_と呼ぶ。結局のところ出力トークンが何であるべきかを推測しているのだから、これを_推論_と呼ぶ。演繹の方が好みなら、データベースとオペレーティングシステムを使えばいい。今日の基盤となるシーケンスモデルは、アテンションと mixture-of-experts を組み合わせた_Transformerニューラルネットワーク_だ。これらのネットワークは、_シーケンス内の各トークン内部_の計算と、_シーケンス内のトークン間_の計算の両方を行う。_アテンション_は、トークンをまたぐ計算を指す広い言葉へと進化した。_mixture-of-experts_とは、動的にルーティングされるブロック疎な行列積のことで、トークンあたりの計算の大部分をこれが担う。これらの計算はネットワークの内部表現、つまり_隠れ_表現を反復的に更新する。これらのシーケンスモデルの内部で何が起きているかを深く知りたいなら、Anthropicの「A Mathematical Framework for Transformer Circuits」を読むといい(2021年の記事で、今なおこれを超えるものはない)。こうしたニューラルネットワークの_順伝播_を1回行うと、大量の内部状態が生まれると同時に、シーケンス内の各位置について次の(あるいは次のいくつかの)トークンの確率分布が得られる。自分の出力("auto")に基づいて予測(“regress”)しているので、これを_自己回帰_シーケンスモデリングと呼ぶ。クライアントのリクエストに応答するには、通常、複数の順伝播を次のようにつなげる:
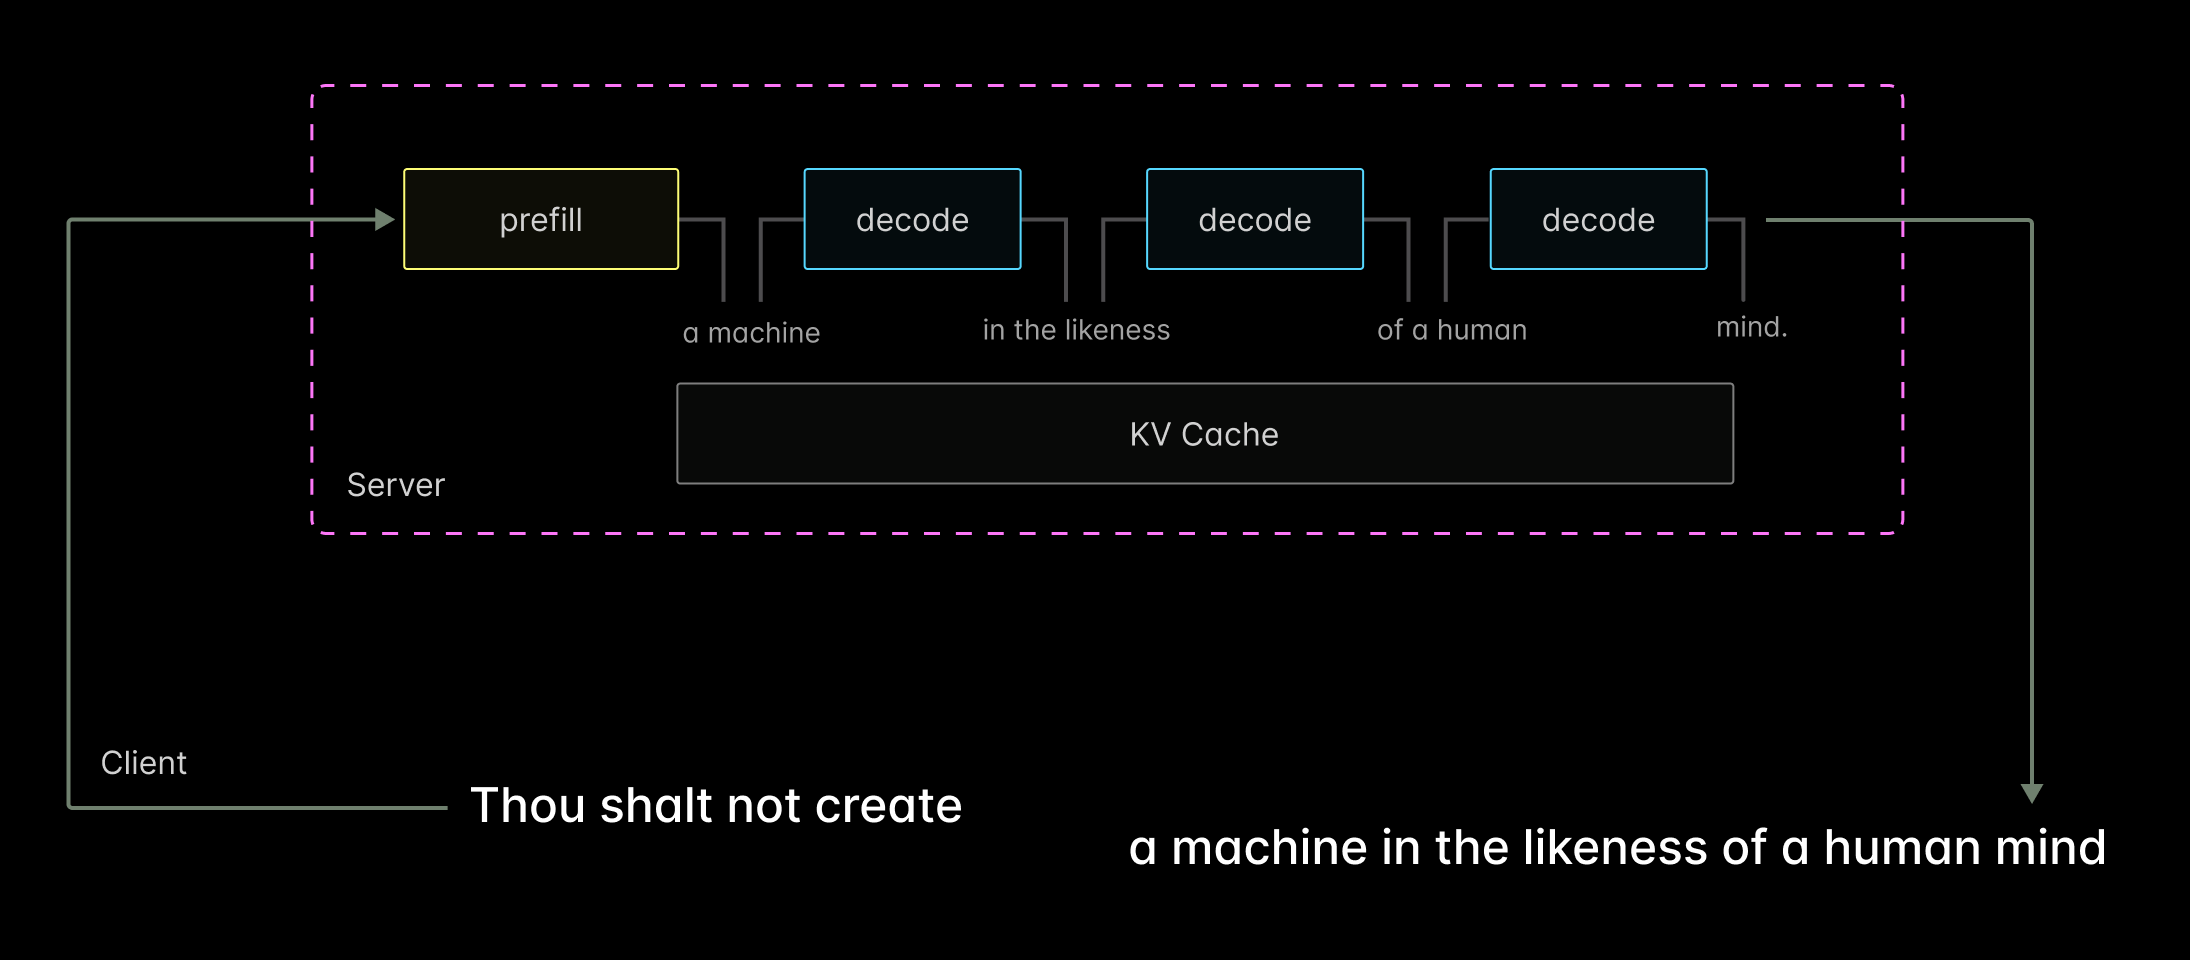
フォワードパスの計算コストは大きいので、できるだけ薄く均したい。トークンごとの計算コストの多くは、複数のシーケンスを _ バッチ処理 _ して薄めることで削減できる。トークンをまたいだ計算コストは、内部状態を _ キャッシュ _ することで薄める。歴史的な経緯でこれは _ key-value cache _(KV cache、あるいは単に _ KV _)と呼ばれているが、Kimi のような現代的なモデルには独立した key と value はもう存在しない。このあたりの「ナプキン裏の計算」については、Kipply の優れた「Transformer Inference Arithmetic」(2022 年執筆、いまだにこれを超えるものはない)を読んでほしい。フォワードパスがリクエストの入力トークンを処理するとき、これを _ prefill _ と呼ぶ。KV cache を「事前に埋める」からだ。フォワードパスが応答の出力トークンを生成するとき、これを _ decode _ と呼ぶ。モデルが持つ履歴状態の「エンコード」を、未来の予測へと「デコード」しているからだ。両方を兼ねるフォワードパスは? ええ、この用語体系は私たちも好きではない。prefill の性能は、1 リクエストの prefill を完了するまでのレイテンシ、つまり初回トークン時間(TTFT)で主に決まる。decode の性能は、その後の出力トークン生成レート、つまり毎秒出力トークン数(TPS)で主に決まる。どちらもクライアント側でもサーバー側でも測定でき、そこから生じる混乱は際限がない。本記事で扱う具体的なシーケンスモデルは Moonshot AI の Kimi K2.6 だ。このモデルの行列積は約 1 兆個の数値パラメータ(行列内の _ 重み _)で定義され、その大半は 4 ビット整数(INT4)で格納されている。しかし私たちはこのモデルを4 ビット浮動小数点数(FP4)でサービングする。4 ビットで表現できるのは 16 通りの値だけなので、テンソル内部のブロックごとに独立してスケーリングするマイクロスケーリング形式も必要になる。私たちが選んだのは NVFP4 マイクロスケーリング形式で、これは Blackwell Streaming Multiprocessor Architecture GPU(B200 や B300 など)の Tensor Core でネイティブにハードウェアサポートされており、petaFLOP/s オーダーの演算性能が出る。私たちは動的な GPU クラスタを運用しており、しかも今は計算資源の供給が逼迫しているため、デプロイは B200 と B300 の両方で動かせるようにしてある。以下の結果はすべて B200 GPU によるものだ。B300 でも本質的に同じだが、キャッシュに使える高帯域メモリ(HBM)が多いぶん、リクエストの並行度を高くできる。ベースには SGLang 推論エンジンを選んだ。エンジンにパッチを当てて性能を引き上げられる箇所がいくつか見つかった。私たちは SGLang プロジェクトのコントリビューターなので、これらのパッチはすべてアップストリーム済みだ。以下で順に説明し、リンクも示す。
ユーザー体験とコスト効率を最適化するには、リクエストをまたぐこうしたシーケンスの構造を理解しなければならない。
こうしたモデルをそのまま coding agent のトラフィックに当てると、結果は散々なものになる。
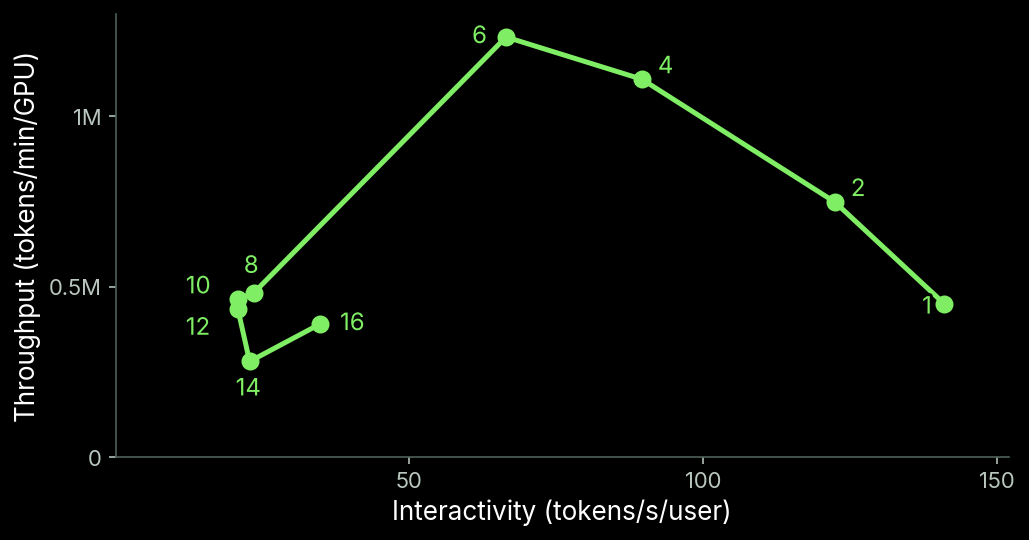
この図が示すのは、同時ユーザーが 6 を超えたあたりからスループットと対話性の両方が急速に崩れるということだ。しかもそのピークに達する前から、対話性はユーザーの期待を下回っており、システム効率も合格とは言えない。だから次にやるべきは、自分のコストを下げつつ対話性とスループットを上げ、ユーザーにより良い結果を届けることだ。そのためには「トークンが入って、トークンが出る」より深く、この負荷の中のシーケンスを理解する必要がある。単一の出力トークンのリクエストは「セッション」の中で生まれる。ユーザー、生成モデル、ツール呼び出しが繰り返し連なり、入力シーケンスが何層にも積み上がっていき、コンテキスト——そして価値——が時間とともに蓄積される。こうした意味構築、情報発見、理解形成の反復プロセスこそ、私たちの見るところではシーケンスのモデリングとシーケンス的行動の本質であり、だからこのパターンは「coding agent」をはるかに超えて生き残ると見ている。具体的には、セッションはおおよそ次のようになる。
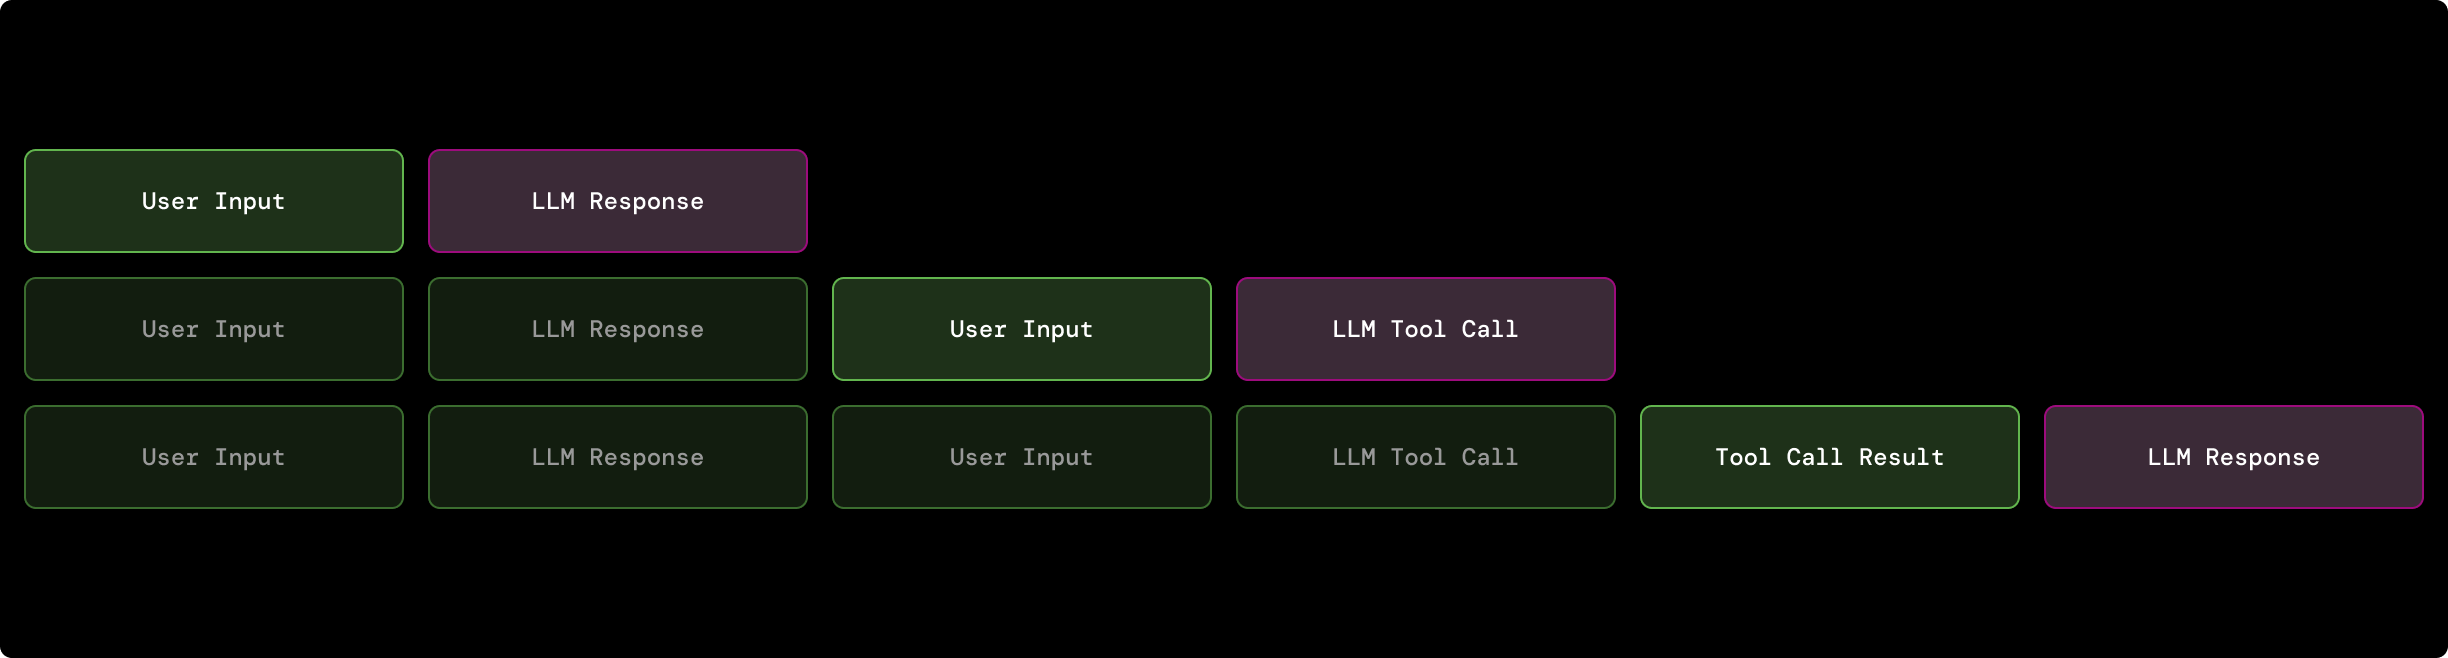
つまり、第 T ラウンドの入力シーケンス(緑)は、T までのセッション履歴全体(濃い緑)に新規部分(薄い緑)を加えたものだ。ここから 2 つの重要な帰結が出る。第一に、リクエストの入力シーケンスは出力シーケンス(図のピンク)に対して本質的に長い——第 T ラウンドの入力には T-1 個の過去の出力シーケンスが含まれ、T は数十に達する。私たちが最適化に用いている中核負荷、そして本番環境でサービングしている負荷では、この比率は 200:1 だ。リクエストはおよそ 100k 入力トークンを含み、およそ 500 出力トークンを生む。つまり処理されるトークンの大半は入力トークンだ(coding agent ソフトのトークン使用量を見ればわかる)。第二に、入力シーケンスは以前に処理した入力シーケンス——第 1 ラウンドから第 T-1 ラウンドまでのもの——と大きく重複する。つまり第 T ラウンドをサービングする過程で、第 1 ラウンドのトークンは T 回処理される。これがキャッシュを決定的に重要にする——線形に増える再計算を避けて労力を節約できる一方で、線形に増える状態を持ち込むことになり、それを管理しなければならず、それ自体の性能特性もある。このトレードオフをどう取るかが、本記事が扱う中核のエンジニアリング課題だ。 この負荷の全体像を踏まえて、最適化へと進む。
次に、単一レプリカを最適化する。
性能を最適化するには、まず動くシステムを組み上げ、ボトルネックを見つけ、そこを押し上げる。これを勝つまで繰り返す。最終的な目標はサービス全体の最適化だが、まずこの問題をより単純な二つに分解した。単一レプリカの最適化と、単一レプリカから複数レプリカへの拡張だ。さらに単一レプリカの性能問題を二つの子問題に分けた。まず対話性を最大化し、次に対話性を犠牲にせずスループットを最大化する。対話性は主にリクエスト遅延に効く。リクエスト遅延とスループットは_並行度_——同時に処理中であるリクエストの数——を介して結びついている。これは Little's Law を変形したものだ。
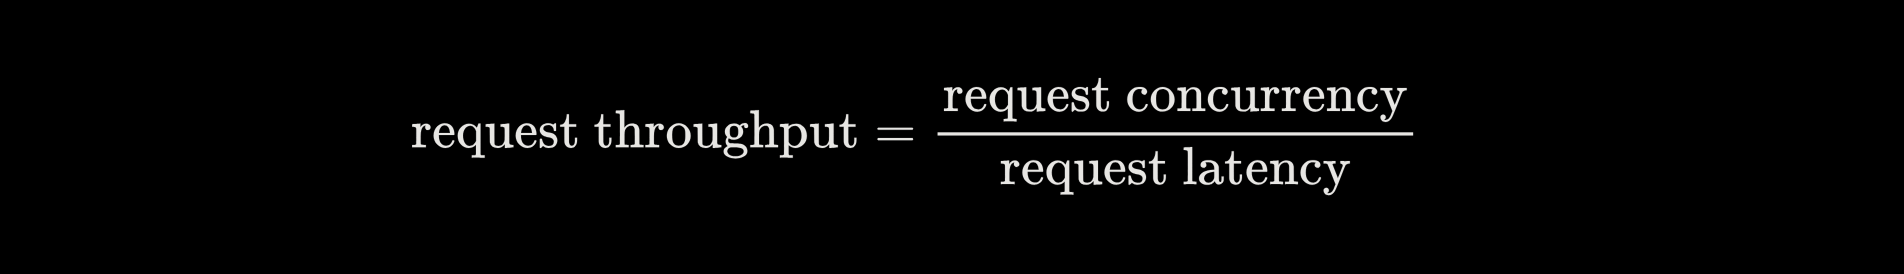
遅延、並行度、スループットのいずれについても、主要なボトルネックは GPU HBM から始まる。遅延の主要なボトルネックはデコード段階の HBM 帯域だ。これに対しては、行列積を GPU 間に並列化し(テンソル並列、TP)、自社開発の DFlash 投機的デコーディングを適用することで押し上げた。メモリロード一回あたりの計算量を増やすのである。たとえその計算が無駄になっても構わない。すると今度は並行度の側でボトルネックが生じる。HBM の_容量_に行き当たるのだ。どれだけの作業をキャッシュに残せるか、そしてキャッシュからのロードは結果を計算し直すより速い。これに対しては、HBM 内の中間結果を整理し、中間結果をより低い浮動小数点精度に量子化し、HiCache でキャッシュ階層を CPU RAM まで広げることで押し上げた。キャッシュ改善の指標としてはキャッシュヒット率(CHR)を使っている。ほとんどのコーディングエージェントのワークロードでは、CHR が 1 ナインから 2 ナインに届くのは十分現実的だ。
まず対話性の最大化から始めた。
対話性を高めるとは、ユーザー一人ひとりが体感するシステム性能を高めることだ。これを先に選んだ理由はいくつかある。第一に、そして最も単純な理由として、コーディングエージェントのユーザーは速いトークンを好み、速いトークンにはより多く払う用意があると分かったからだ。つまり高い対話性は、我々と顧客の双方が望むサービスを作る鍵になる。第二に、対話性は投機的デコーディングで改善するのにうってつけだ。これは学習ベースの単純な手法であり、性能の向上は計算量とデータとともに伸びる。機械学習で有名な「苦い教訓」が、ML システムの性能工学の場に戻ってきたのである。しかも訓練をスケールさせる方法は我々は知っている。対話性を振り切ることを選んだのは、運用上とスループット上の二つの副次的な利点ももたらす。この二つは、動的に自動スケールするクラスタを数千枚の GPUで運用している我々にとって特に重要だ。対話性を最大化したレプリカはより小さく、したがって扱いやすい。 複数のプロセッサをまとめて使うには、通信のためのインターコネクトが要る。Nvidia GPU で最も低遅延・高帯域のインターコネクトは NVLink だ。NVLink は「ドメイン」と呼ばれるプロセッサ群の内部で機能し、ドメインには大きさの上限がある。単一のホスト OS が支える NVLink ドメインは最大 8 枚の GPU まで。現在一般に利用できる最大の NVLink ドメインは 72 基のアクセラレータ(マルチノードの [IMEX ドメイン](https://docs.nvidia.com/multi-node-nvlink-systems/imex-guide/overview.html)にまたがる)だ。これより多くのアクセラレータを使うには、より遅いインターコネクト(IB/RoCE、あるいはもっと悪ければ普通のイーサネット)に切り替えるしかない。つまり対話性を最大化するなら、レプリカあたり 72 基を超えるアクセラレータは期待すべきではない。通信のオーバーヘッドが、単一リクエスト遅延の利得をほぼ確実に上回るからだ。とはいえ 72 基を_使い切らなければならない_わけではない。同じ NVFP4 の Kimi K2.6 モデルに対する SemiAnalysis の InferenceX ベンチマークの結果を見ると、複数のデプロイについて GPU あたりスループットが対話性に対してどう変わるかが示され、GPU 数も注記されている。
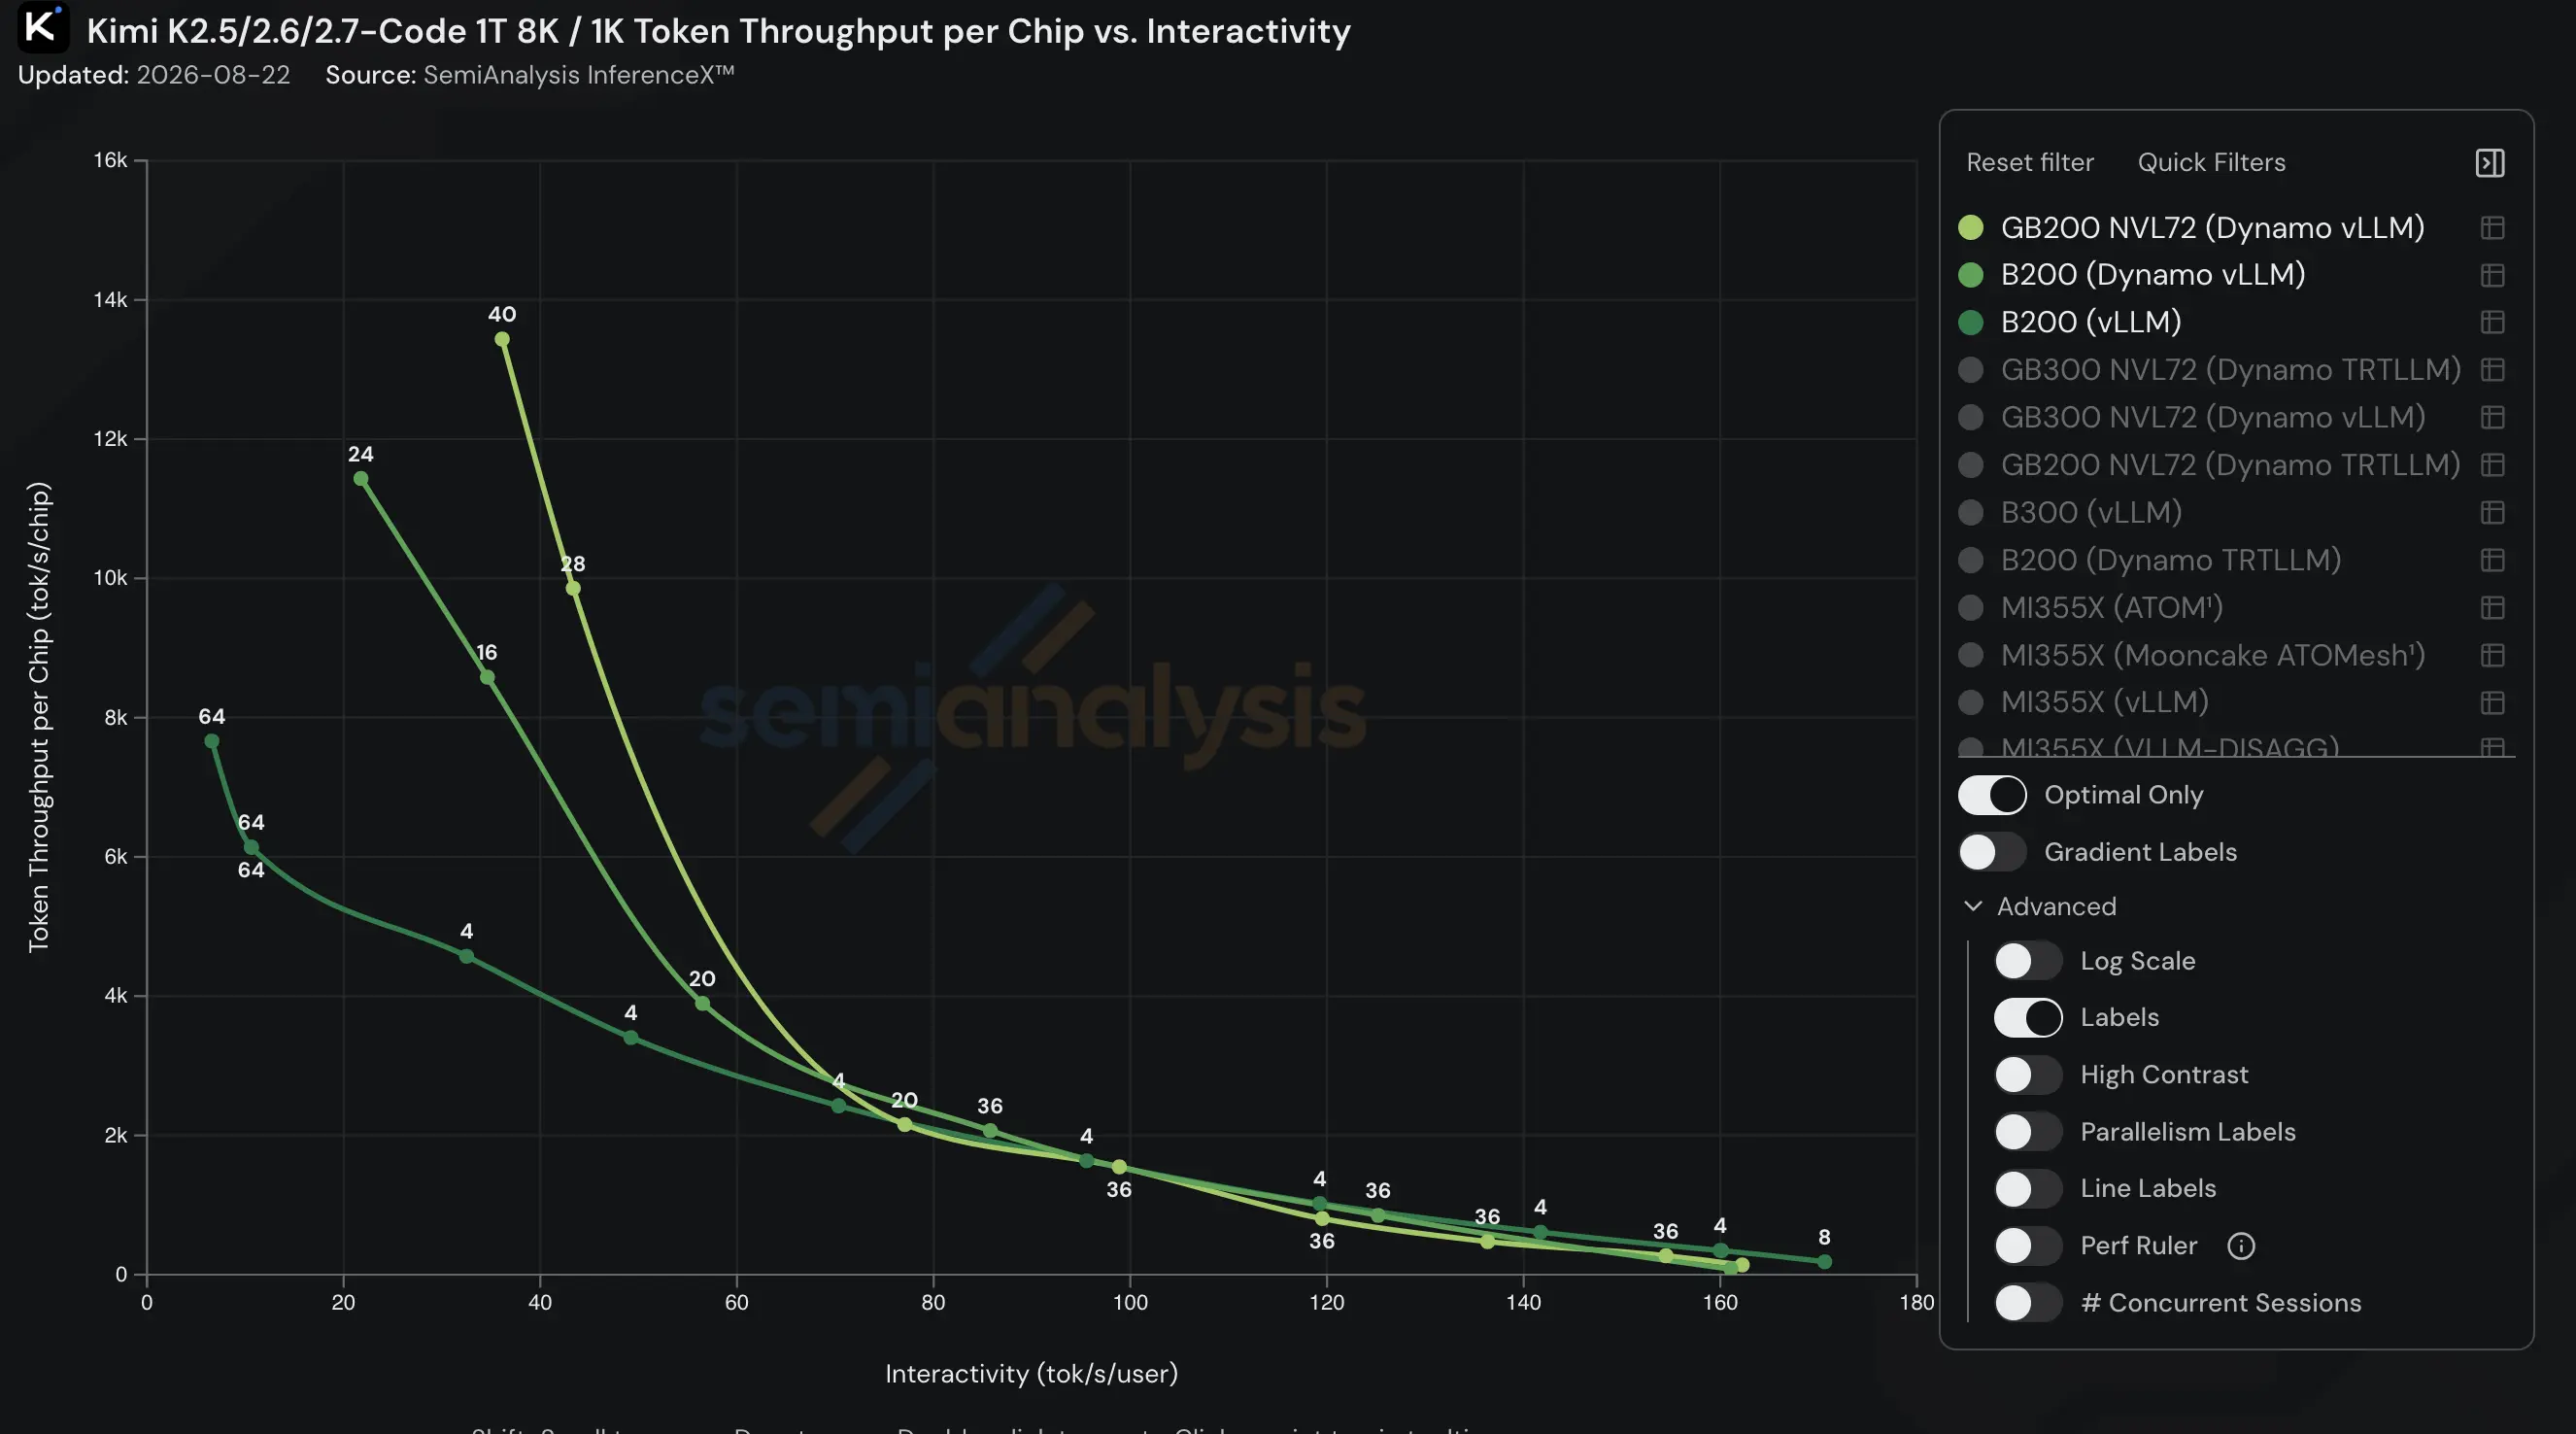
レプリカあたり 8 枚の GPU だけを使うデプロイが、最も高い対話性を示す。しかもその対話性は GPU あたりスループットが同等のまま達成されている。つまりより小さなドメインを選んでも、ピークスループットのコスト効率を(我々の対話性制約の下で)目に見えて犠牲にはしない。グラフを読みやすく保つため、我々自身のデプロイに最も近いものだけを少数選んだが、この傾向はより多くのアクセラレータ種別、より多くのモデルで成り立つ。InferenceX ベンチマークで自分で確認できる(こちら)。一般に、4 枚か 8 枚の GPU だけで、GPU あたりスループットを同等に保ったまま最高の対話性が得られ、より小さなレプリカを水平にスケールさせれば同じ総スループットになる。Modal のサーバーレスプラットフォームの中核が、このスケールを効率的かつ信頼できるものにしている。
これは運用上の大きな勝利だ。ユニットが小さく単純なほど、スケールさせやすい。8 枚の GPU なら単一のホスト OS カーネルで駆動できる。一方 NVL72 ドメインはそうしたサブシステムが九つ集まり、同一のアドレス空間を共有している(ええ、ぞっとするはずだ)。可用性は限られ、契約期間は長く融通が利かない。それに比べて 8 枚構成の Blackwell システムは十分に標準化されており、オンデマンド市場や spot 市場で調達できる。これにより変動する負荷への対応はるかに費用対効果が高い。1 枚、2 枚、4 枚の GPU のレプリカなら、8 枚差しの物理マシン一台に収められる。そのマシンにはもう一つのレプリカを起動するのに必要なリソース(モデルの重み、JIT 成果物)がすでに揃っている。もちろん、計算資源の供給とユーザー需要が変われば、この選択は喜んで見直す。
インタラクティビティを高めると、間接的にスループットも上がる。 個々のリクエストのレイテンシを下げれば、その分のリソースを新しいリクエストに回せる。これがスループットの間接的な押し上げにつながる。Agentic コーディングのワークロードは、1つのセッションの中ではほぼ「閉じたループ」だ。セッションはほとんど常に連鎖している——ユーザーが入力するトークン、ツール呼び出しの応答、モデルの出力。つまり、セッション内の次のリクエストが届くのは、ほぼ必ず前の応答を生成し終えてからしばらく経った後になる。その間、セッションの次のリクエストは潜伏状態にあり、推論システムの外にいる。ツール呼び出しなら数十ミリ秒から数秒、テールでは数分に達することもある。ユーザーの返信なら数秒から数分、テールでは数時間以上になることもある。この間、同じノードは別のリクエストを処理できる。負荷がアクティブな容量を埋め尽くすほど大きければ、ノードには常に処理すべきリクエストがある。容量がアクティブな負荷を十分に支えられるなら、リクエストには常に割り当て先のノードがある。どちらも高速なオートスケーリングシステムが保証している。リクエストルーティングの詳細は、マルチレプリカへの拡張の節で扱う。
カスタム投機的デコーディングで、インタラクティビティのボトルネックにおいて一度に少し多く処理する
インタラクティビティが測るのは、ユーザー1人あたり毎秒どれだけの出力トークンを得られるかだ。最も素朴に捉えるなら、Transformer のような自己回帰シーケンスモデルはトークンを1つずつ順番に生成する。ここでまた Amdahl の心を砕く法則が顔を出す。トークンを1つ生成するたびに、数十億バイト、場合によってはそれ以上のモデル重みと KV cache を GPU HBM からストリーミングマルチプロセッサの L1 キャッシュへ運ぶ必要があり、これは次のトークンの KV 状態と出力を実際に計算するよりもたいてい遅い。ボトルネックはメモリ帯域にある。並列化は確かに帯域を増やすが、それはトークンごとの計算には効いても、トークンをまたぐ計算にはあまり効かない——そして長いシーケンスでは、トークンをまたぐ計算こそがボトルネックになる。コーディング系 agent のワークロードがまさにその証拠だ。そこで発想を変え、投機的デコーディングでこのボトルネックを一段引き上げることにした。突き詰めれば、投機的デコーディングが取るトレードオフはプロセッサの投機実行と同じだ。操作間に直列依存があり、そのせいで演算帯域が余っているなら、その帯域を、最終的に使われないかもしれない操作の実行に回せる。使われる操作を高い確率で当てられれば、実効的な演算スループットは上がる。鍵は、できるだけ低いコストでその確率を引き上げることにある。自己回帰シーケンスモデルの推論に当てはめるなら、1回のイテレーションで余分に操作を走らせる「コツ」は、別のより高速な言語モデル(「投機モデル」または「ドラフトモデル」)に次の数トークンを推測させ、サービス対象のモデル(「ターゲットモデル」または「検証器」)にそれらを並列で検証させることだ。
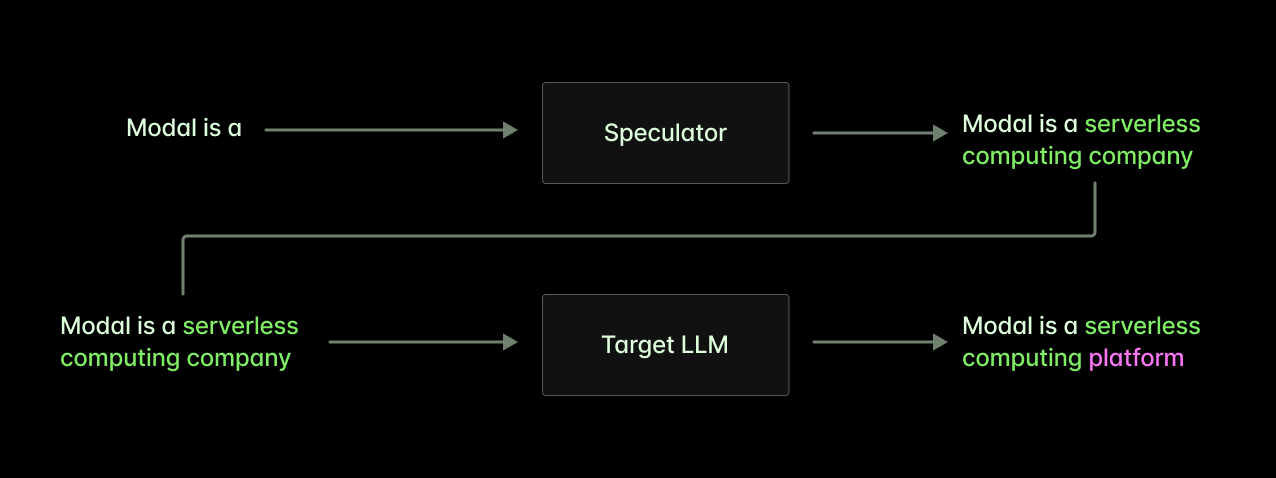
投機実行と同じく、この高速化はプログラムの振る舞いを変えない。つまりターゲットシーケンスモデルの確率分布を変えない。私たちがQwen 3.5 および 3.6 シリーズモデルの speculators を公開したブログ記事で述べたとおり、投機的デコーディングの効果は大きい——数十パーセントではなく、倍単位の改善だ。
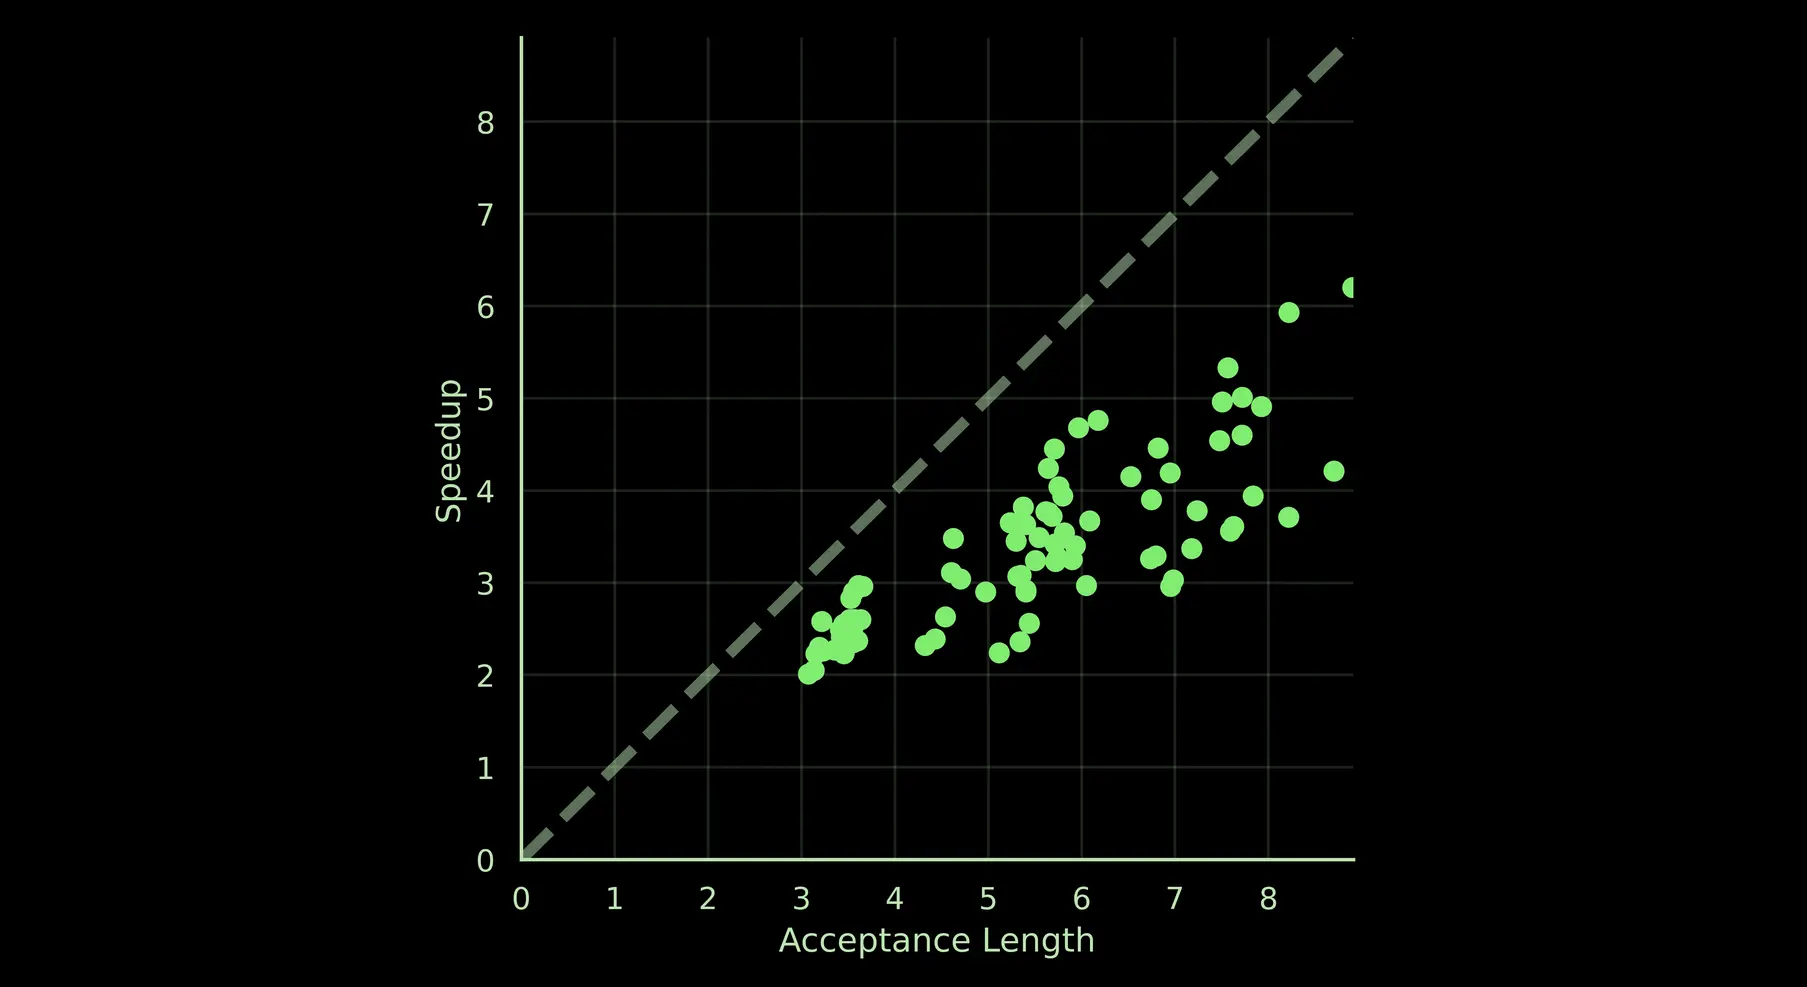
直感に反するが、平均的には、投機モデルに出力の次の4トークン、8トークン、さらにはそれ以上を予測させるのはかなり容易だ。特に coding agent のようなワークロードではそうなる。理由はおおむね2つある。ターゲットモデルが投機モデルにとって有利な条件を整えていること、そしてほとんどのトークンはターゲットモデルの知能のすべてを必要としないことだ。
投機モデルはターゲットモデルの計算結果を再利用できる。
まず、ターゲット言語モデルは順伝播の過程ですでにシーケンスにとって極めて有用な表現を生成している——各トークンの静的な embedding から始まり、モデルの各層がその表現を段階的に豊かにし、最後の「言語モデリングヘッド」層が表現を次のトークン上の分布に変える。さらに良いことに、これらの表現はすでに KV cache の中にある。DFlash のような最先端の投機アーキテクチャ(および DSpark などの派生案)は、これらの状態をそのまま入力として再利用する。だからこそ、ターゲットモデルより数桁小さく(そして数桁速く)できる——巨人の肩に乗り、巨人が次にどこへ向かいそうかを指し示すのだ。
トークン列は繰り返しが多く、情報密度が低い。
次の coding agent の出力例を見てほしい:
You're absolutely right! I should have read that file before I
"straight yeeted it to prod". Checking now.

Tool call: Read src/config.py L42-L96
最近のモデルを使ったことがある人なら、You’re absolutely の後に何が続くか予想できるだろう(wrong には決してならない)。しかもこの引用は以前のユーザー入力から来ているので、引用符が開いた時点で、続くトークンは高度に予測可能になる。
もう一段深く考えてみよう。このシーケンスをモデルの「chat template」と特殊制御トークンでフォーマットするとどうなるか:
 You're absolutely right! I should have read that file before I "straight yeeted it to prod". Checking now.

 functions.Read:0

 {"path":"src/config.py","line_start":42,"line_end":96}
このシーケンスには大量の構造があり、それを生成するのに高い知能は要らない。もちろん、構造の内部の細部は依然として正しさに影響するので、ターゲットモデルの能力は重要であり続ける!
となれば、ターゲットモデルの容量の大部分は、何ステップも先のトークンを予測できるよう、これらのトークンの表現を豊かにすることに使われている可能性が高い。次の数トークンが何かすでに分かっているなら、それらの表現は並列に計算できる。
これは奇策でも何でもない。並列と逐次の両方でフォワードパスを提供できることは、従来のリカレントニューラルネットワークに対する現代のシーケンスモデルの根本的な特性だ。「古典的な」Transformer も線形・ハイブリッドアテンションのモデルもこの性質を備えているので、長く生き残ると見てよい。
こうした理由もあって、私たちは投機的デコーディングに多大なリソースを投入しており、あなたにもそうすることを勧める。
カスタムドラフタはアクセプト長を大きく伸ばせる。
最速のドラフタは、対象モデルの全体的な振る舞いだけでなく、特定のデータセット上での振る舞いまで予測できる必要がある。ドラフタは小さく、モデリング容量に限りがある。その容量は本番環境で実際に現れるケースにだけ使うべきだ。ML に詳しい人向けに補足すると、ドラフタの損失は対象モデルに対する Kullback-Leibler ダイバージェンスであり、これによって分布全体をカバーするのではなく最頻値を狙うようになる。
ただしニューラルネットワーク全般の例に漏れず、私たちの実験では、強力なベースから出発してドラフタを特定のタスクに適応させる——つまりファインチューニングする——ほうが良いという結果が出ている。そこでまず汎用データの混合で Kimi K2.6 用の DFlash ドラフタを訓練し、次に対象モデルが出力したコードの軌跡でファインチューニングした。本番トラフィックを処理する段階では、対象モデルの出力を使ってこのドラフトモデルを継続的に訓練することもできる。
実トラフィックで動かすと問題が一つ出てきた。token を文字列に変換して再トークン化しても、それは恒等写像にはならない。トークン化自体がひどいハックだからだ。一方、HTTP リクエストログのような一般的なログの取り方は文字列を扱うもので、token は扱わない。そこで私たちは SGLang を改修し、sglext を通じて生の token id を出力できるようにし、この作業をアップストリームにコントリビュートした。
代表的な軌跡において、ファインチューニングはアクセプト長を1ステップあたり 5.00 token から 5.84 token に引き上げ、20% の追加高速化をもたらした。
テンソル並列は、最高のインタラクティビティを実現する最良の並列戦略だ。
遅いタスクに人手を足すとかえって遅くなるが、コンピュータにはこの弱点がない——仕事を並列化し、データを正しくシャーディングしていれば、の話だが。
シーケンスモデルの推論における主要な並列戦略は、仕事を次のように分割する。
- 単一リクエスト内で、モデルのフォワードパスをまたいで(prefill-decode 分離)、
- 1回のモデルフォワードパス内で、層をまたいで(パイプライン並列)、
- バッチ内で、シーケンスをまたいで(データ並列)、
- 単一シーケンス内で、token をまたいで(コンテキスト並列)、
- 単一のモデル層内で、行列積をまたいで(エキスパート並列)、そして
- 1回の行列積内で、行・列をまたいで(テンソル並列)。
これらのうち単一リクエスト内で仕事を分割するのはコンテキスト並列、エキスパート並列、テンソル並列だけで、したがってインタラクティビティを直接改善できる。テンソル並列(TP)は最も低い層の並列だ——その下は kernel 実行内部の並列で、それは legion の領域であり本記事の範囲外だ(この方面の取り組みは別の場所で共有している)。つまり TP は他の戦略と組み合わせると効果を発揮しやすく、最初のターゲットとして悪くない。
噛み砕くと、テンソル並列は行列積の入力を取り、出力を処理する仕事を複数の並列 worker に分割する。worker は処理に必要な行列データ、すなわちモデルの重みを分片して保持できる。詳しくは Megatron 論文を参照(2019年のものだが、いまだにこれを超えるものはない)。
この第一原理からの論証があるにもかかわらず、私たちは他のさまざまな並列戦略も検討した。理由は1)インタラクティビティは他の場所の最適化から間接的に影響を受ける、2)知らないことは知らないからだ。だが結論として Tensor Parallelism Is All You Need™、インタラクティビティは振り切れる。たとえばデータ並列アテンションでは、KV cache をシャーディングすることでより高い並行度を実現できたが、レイテンシは悪化した。悪化の度合いは、並行度が上がったにもかかわらず GPU あたりの全体スループットが落ちるほどだった。
並列戦略を選ぶときは、並列 worker の数も同時に決める必要がある。Kimi K2.6 は B200 GPU 上で動き、シーケンス長は数十万 token に達しうるため、実行可能な構成は4枚(TP4)と8枚(TP8)の2つだけだ。
まず粗い見積もりから。1枚の B200 は 180 GB の HBM を積み、Kimi K2.6 の重みは 595 GB ある(1兆を超えるパラメータ、重み1つにつき nybble 1つ)。重みを CPU メモリやディスクに溢れさせるとレイテンシが破壊されるので、TP1 も TP2 も成立しない。4枚か8枚の GPU で重みを分片して保持すると、KV に残るのはおよそ 125 GB か 845 GB になる。KV エントリは 576 要素、2バイトの BF16 形式で保存され、モデルは 61 層、各層に token ごとの KV エントリが1つあるので、1 token あたり約 72 KB = 576×2×61 バイトを占める。計算すると TP4 は約 50万 token 分の KV を収められ、TP8 は約 300万——ハードウェアが2倍でキャッシュ容量は6倍だ。
| 構成 | HBM 総量 | HBM から重みを引いた量 | GPU あたりの約 KV サイズ | 約 KV 容量 |
|---|---|---|---|---|
| TP1 | 180 GB | -415 GB | - | - |
| TP2 | 360 GB | -235 GB | - | - |
| TP4 | 720 GB | 125 GB | 31.3 GB | 0.45 Mtokens |
| TP8 | 1.44 TB | 845 GB | 105.6 GB | 3.0 Mtokens |
TP8 はかなり魅力的に見える。だが目標負荷、つまり我々の対話性目標と両立する並行度で測ると、TP8 が prefill だけ を走らせたときの GPU あたりスループットは、TP4 が prefill と decode を同時に走らせたときとほぼ同じだった。この比較はすでに TP8 に大きく有利な条件であり、それでも TP8 は勝てなかった。
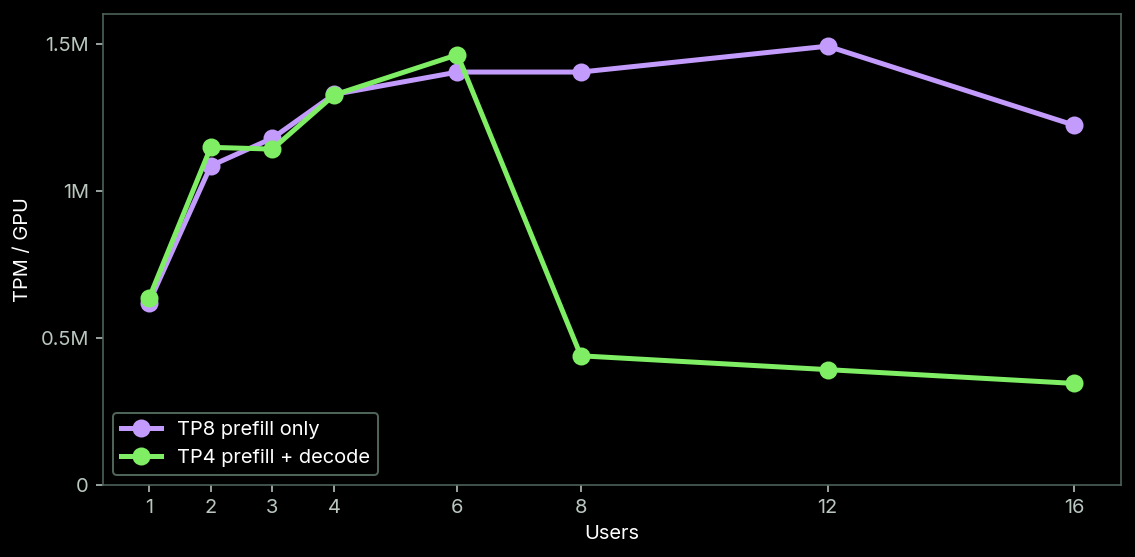
しかも TP4 を選ぶと、KV キャッシュ容量が極端に制約される。
そこで次は、この制約を緩和する各種の戦略に取り組んだ。
より良い KV キャッシュでスループット上の並行性のボトルネックを解消した。
1 リクエストあたりの最大入力が約 100k token、TP4 で動かす場合、1 レプリカでスケジュールできるのは 4 ユーザー分の会話が限界で、それを超えると対話性が崩壊する。これを超えるとキャッシュヒット率(CHR)が急落し、長い入力が再計算され、対話性とスループットが同時に崩れる。再計算は、これらの KV エントリを HBM からロードするよりはるかに遅い。そこで KV にもっと場所を空ける方法を考え始めた。
HBM の断捨離。
最も直接的な最適化は、無駄になっている HBM を見つけて KV cache に返すことだ。
SGLang の DFlash ドラフトモデルアーキテクチャの実装を調べたところ、実際に必要な量の 2 倍の HBM を消費していた。
具体的には、ドラフトモデルへの入力に使う対象モデルの中間結果を、まずポインタのリストとして集め、forward pass の最後に連続メモリへコピーしていた。これを、あらかじめ連続メモリを buffer として確保し、forward pass の途中で中間結果をそこへ書き込む形に書き換え、HBM のピーク使用量を半分に削った。しかも append ベースのロジックには手を入れず、ちょっとした Python の魔法で済ませている。変更はこの PRで SGLang 上流にマージ済みだ。
量子化で HBM を空ける。
場所を空ける 2 番目に簡単な方法は、より低精度の浮動小数点に全面的に切り替えることだ。
ただし投機的デコードや無駄の除去とは違い、精度を下げるのは無料ではない。モデルの出力が大きく変わりうるし、たいていはアプリケーションの効果にとって不利な方向に変わる。ブロック量子化の影響は、我々の LLM Engineer's Almanac にある可視化ツールで直感的に確認できる(例は下図。左がブロック量子化、右が元の結果)。
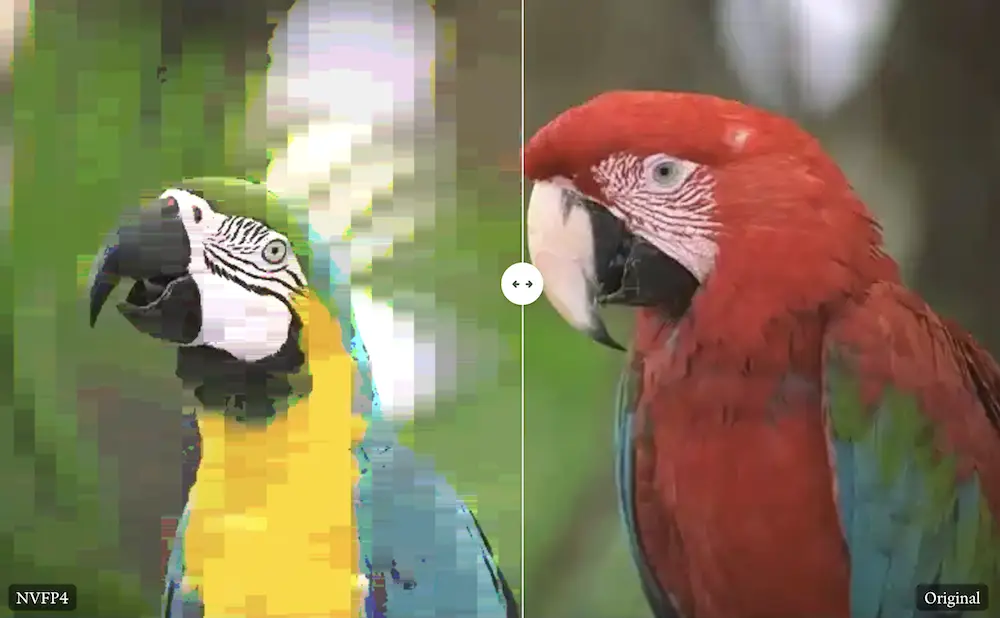
原理上は精度を落とすが対象アプリケーションの効果には影響しない変更を、確信を持って行えること。これは極めて重要であり、汎用のマルチテナントモデル API プロバイダーに対する、自社ホスト型カスタム推論アプリケーションの差別化要因でもある。
いつもどおり、投機的デコードのほうが簡単な類なので、ドラフトモデルの量子化は確実に得をする。モデルの目的とする出力、つまりデコード速度は、知能のように滑らかに劣化するわけではなく、drafter の正しさは性能以外でアプリケーションの効果に影響しない。我々はこの PRで DFlash speculator アーキテクチャの FP8 サポートを SGLang 上流にマージした。
だが、魅力的でもアプリケーションの効果に必ず影響する最適化もある。だからこそ我々は、推論サーバーのモデリング能力を評価する能力の構築に力を入れている(近いうちに続報を出す!)。Moonshot の Kimi Vendor Verifier のような取り組みも高く評価し、支持している。モデルの利用者が品質を継続的に評価できるようにするものだ。Evals、evals、evals!
我々の評価では、モデルの KV cache を BF16 から FP8 に量子化できることがわかった。これで token 単位の cache 容量が倍になる。さらに、ほとんどの expert matmul はすでに NVFP4 だ。現在ハードウェアがネイティブにサポートする最もコンパクトな形式である。だが、token ごとに必ず活性化する重要な「shared」expert はそうではない。shared expert を FP8 から NVFP4 に量子化できることがわかり、cache 用の HBM をさらに解放できる。我々の評価では、この 2 つの変更はいずれもモデル品質を目に見えて下げなかった(実行間の非決定性と比べて、の話だが)。
HiCache で KV cache 容量を拡張する
最後に、cache がもっと大きく、その代わり遅くなるとしたらどうか。
ここまでは KV を GPU HBM に置くことしか考えてこなかった。つまり入力シーケンスを処理するときの選択肢は、「GPU 上の超高速・超高価なストレージに置く」か「ゴミ箱に捨てる」かのどちらかだった。サービスすべき KV cache のサイズが HBM 容量を超えると、キャッシュヒット率(CHR)が下がり、レプリカの性能が急激に悪化する。
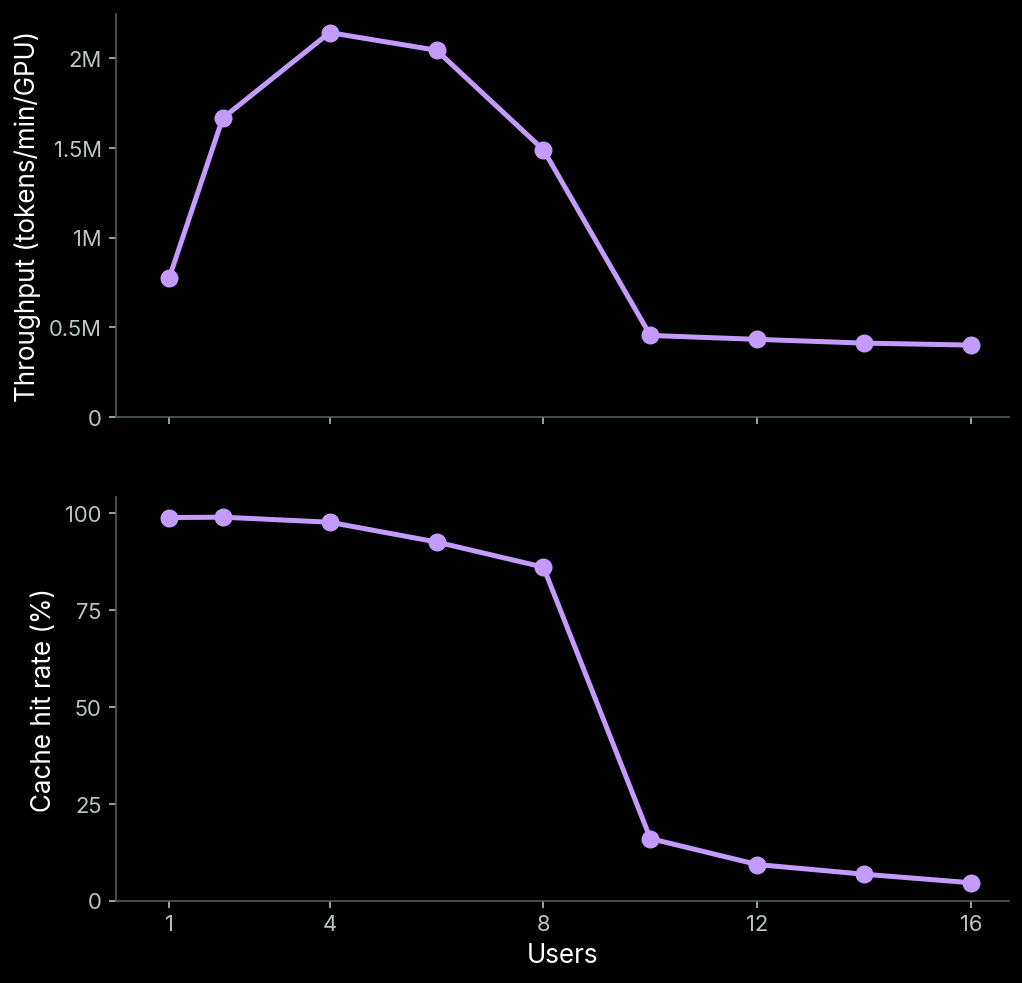
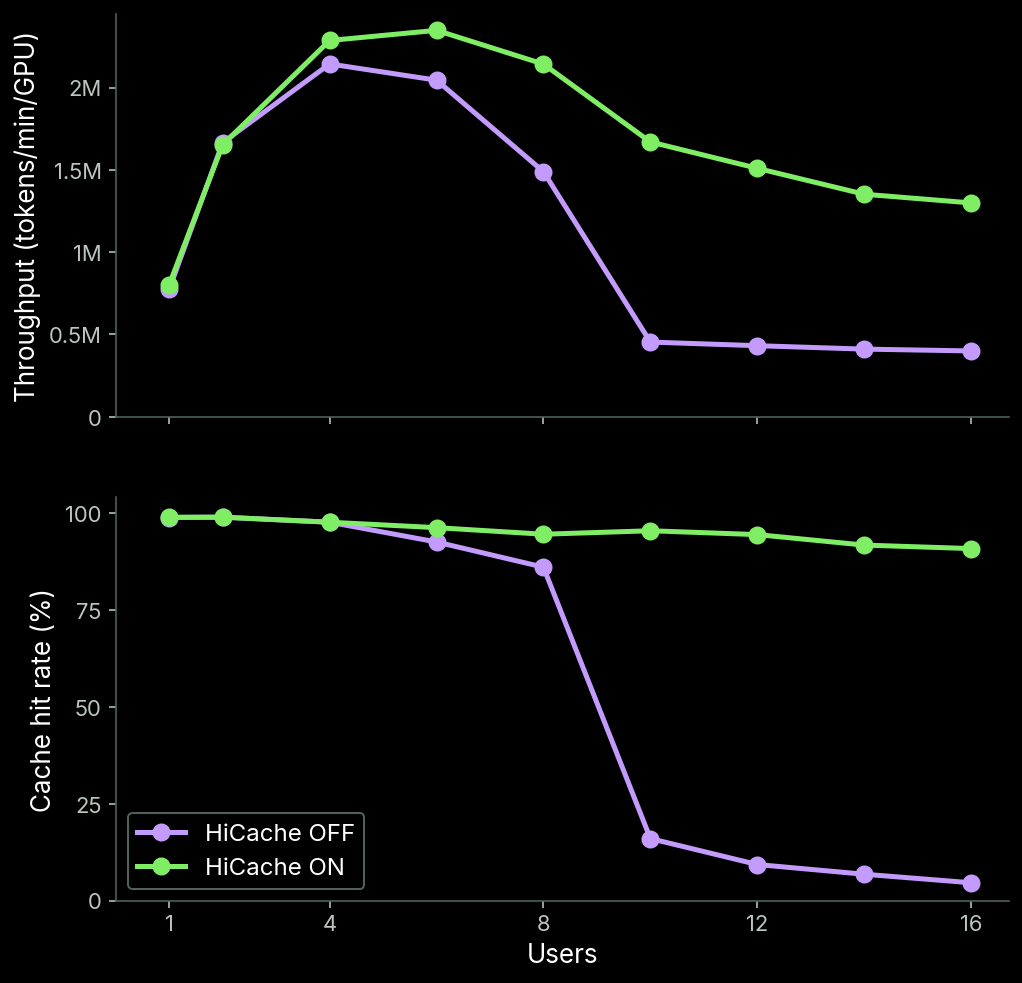
だからこそ、優れた cache は多層になっている。cache の層が増えるたびに、負荷が上がったときの CHR の低下がより緩やかな段になる。SGLang の HiCache は「L2」「L3」の cache 階層を追加して KV cache 容量を拡張し、KV をホストメモリ(L2)と分散ストレージ(L3)に置けるようにする。
上位の cache 階層ほど遅いままだ(そうでなければ、そもそも下位層として使っているはずだ!)。だから遅延を悪化させやすく、スループットも下げうる。CPU RAM ベースの L2 cache だけでも十分に効果はあった。とはいえ、基本的にこれを使うのは超過負荷の処理だけだ。
つまり HiCache がない場合、同時実行数がピーク性能を支えられる水準を超えた瞬間に性能が急速に劣化し、ピークでサービスを提供するなど到底試せない。HiCache があれば、単一レプリカの負荷が一時的にピークを超えても、レプリカの挙動はより安定する。
レプリカのリクエスト負荷が常に目標値と正確に一致するわけではない。理由は二つあり、一つは上流のユーザー/agent の挙動が不確実であること、もう一つはリクエストが各レプリカにどうルーティングされるかだ。これについては次で述べる。
最後に、多数のレプリカへのスケール。
単一レプリカの性能最適化が終わったところで、より大きなデプロイ規模へ拡張した。これだけ苦労したのだから、同時実行ユーザー 6 人では到底割に合わない。ざっくり言えば、Modal Server の背後で自動スケーリングする推論エンジンのレプリカプールを動かすという構成だ。
我々のコアプラットフォームの自動スケーリング基盤は、自動スケーリングの典型的な難所——いつスケールするか、リソースを確保し、ホスト環境を立ち上げ、レプリカを素早く起動し、障害から復旧し、可観測性を確保し、リソースを解放する——をすでに処理している。こうした難所は通常、システムを Kubernetes YAML のスパゲッティに絡め取ってしまう。だから我々の作業はほぼすべてルーティング層に集中した。
ルーティング自体は「難しくない」。ただしレプリカがステートを持つ場合を除けば、の話だ。そして KV cache はまさにレプリカにステートを持ち込む。幸いこれは良性のステートだ。一時的なキャッシュであり、アプリケーションの正しさはそれに依存しない。ミスしても再計算すればいい。だが再計算には性能コストがかかる。だからルーティングは性能最適化の重要な一部になる。
ルーティングをより注意深く見直すきっかけになった性能問題が二つ観測された。
- キュー内のリクエスト数、テールの TTFT(初回トークン遅延)、エンドツーエンド(e2e)遅延にスパイクが繰り返し発生した。
- 単一レプリカのスループットが期待を下回った。
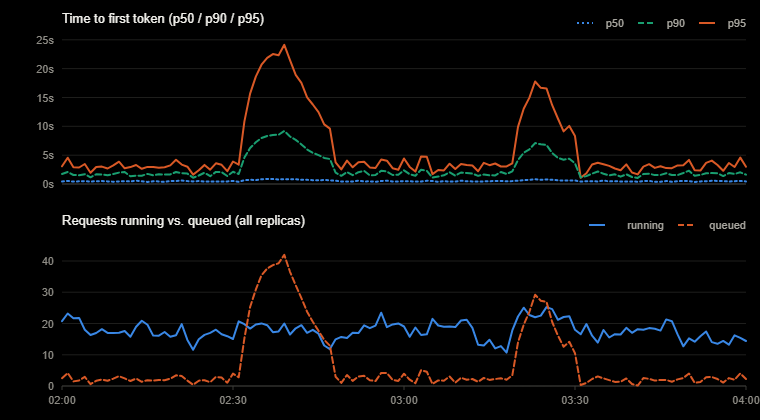
どちらの根本原因も「惜しいコールド prefill」だった。入力シーケンスが以前見たものと重なっているのに、結局 KV 全体を再計算してしまう。そして_その_根本原因は、当初のステートレスなルーティングアルゴリズムのリクエスト配置が非効率だったことにある。これにはセッション内の同時実行の影響も、ハッシュの運の悪さも効いている。
この作業を踏まえて、ルーティング層を更新し、ステートフルで KV cache を意識したルーティングアルゴリズムをサポートした。Modal Servers では kv_aware_routing 実験的オプションから利用できる。
@app.server(port=8000, experimental_options={"kv_aware_routing": True}
class Server:
 ...
まずはステートレスな「セッションアフィニティ」ルーティングから始めた。
デフォルトでは、Modal Serversはすべてのリクエストを一様ランダムにルーティングする。特定のリクエストを特定のコンテナに「貼り付ける」には、クライアントがヘッダー Modal-Session-Id を渡す。するとそれはハッシュ化され、おおよそ次のようにレプリカへマッピングされる。
図のようなリングハッシュそのものではなく、コンシステントハッシュを使っている。レプリカの数や識別子が変わったときの挙動が良くなるからだ。詳細はこのコード例を参照。
したがって Modal 上の推論サービスのコーディング agent クライアントは、同じ agent セッション内で session ID を生成して再利用し、リクエストを過去の入力をすでに見たレプリカへマッピングできる。そうすればそれらの入力の KV 表現がすでにキャッシュにある可能性が高く、性能が向上する——たいていは。
スケールでは「運の悪い」ハッシュは救えない。
同時実行ユーザー数が多く、同時セッション数の変動に対する許容度が高いなら、ステートレスで一様ランダムなセッションルーティングアルゴリズムはバランスを取るのにまずまず機能する。だが同時実行数が低く許容度が厳しい領域では問題がある。そして高インタラクティブなコーディング agent 推論はまさにその領域にある。
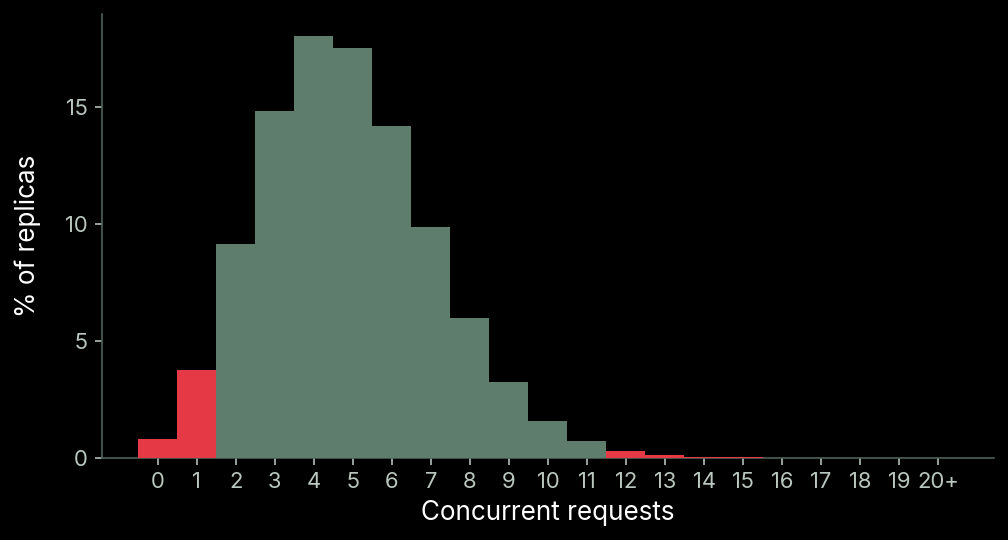
数学をざっと。一様ランダムなハッシュアルゴリズムを使うと、サーバーあたりのセッション数の分布は二項分布になる。ここで N は総セッション数、p はサーバー数の逆数だ。二項分布はすぐにポアソン分布へ収束し、その rate parameter は Np、 つまりセッション数をサーバー数で割った値になる。定常状態のダイナミクスに注目すれば、自動スケーリングのおかげでこれは固定値とみなせ、目標同時実行数に等しい。これは良い。だがポアソン分布の分散はこの固定の rate parameter に等しく、つまりレプリカごとのセッション数のばらつきは規模を大きくしても減らない。変わらず、そして予測可能なテール挙動をもたらす。
具体的に。レプリカあたりの目標同時実行数が 5 セッション、レプリカが 50 台、合計 250 セッションをサービスしているとしよう。一様ランダムなルーティングアルゴリズムでは、あるレプリカが 1 セッション以下しか割り当てられない確率は約 4% で、全体効率の低下として現れる。あるレプリカが少なくとも 12 セッションを割り当てられる確率は約 0.5% で、テール遅延として現れる。これらの確率は規模に依存しない。
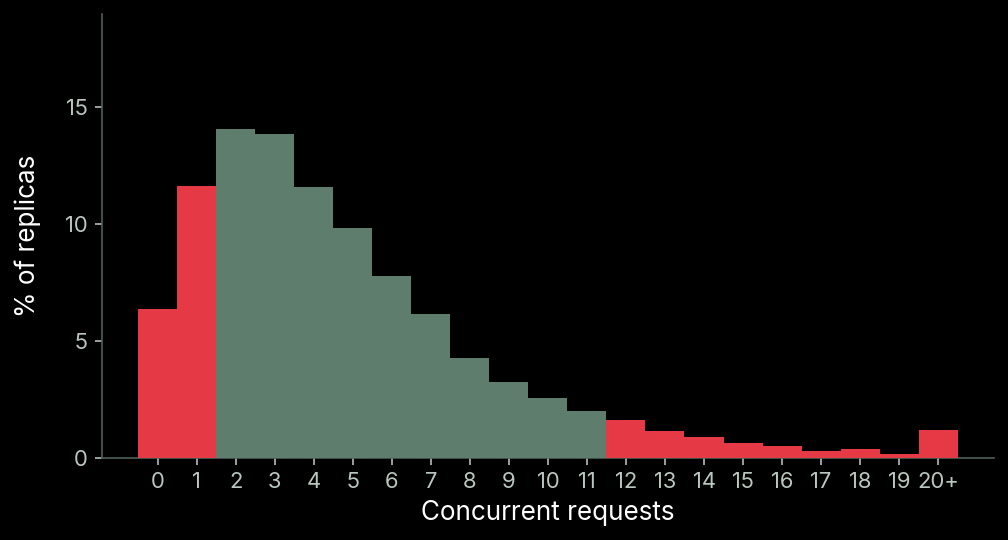
つまり、この種のルーティングアルゴリズムは、負荷のばらつきが許容範囲に収まっているときにしか成立しない。coding agent のワークロードは、そこには当てはまらない。
実態はモデルの予測よりさらに悪い。モデルから外れる要因(必ず存在する)が、同時実行数にさらなるばらつきを持ち込む。これは実際に観測されている。ばらつきはしばしば平均の数倍に達し、右の裾は極端に重く、ときに非常に高いレイテンシを引き起こす。以下はレプリカごとの負荷の実測値だ(対話性を高めるため、目標同時実行数を5リクエストに設定したデプロイでの結果)。
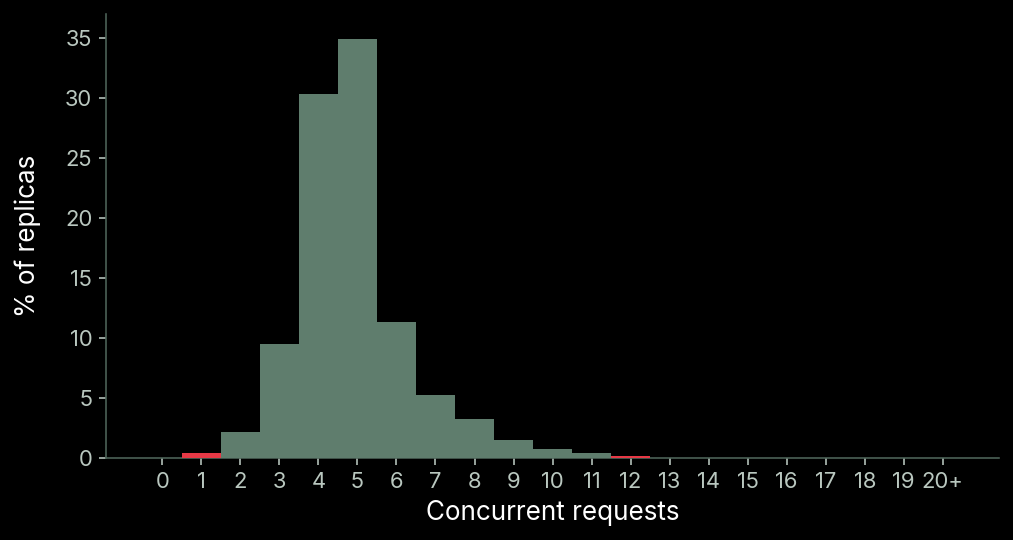
これこそが、私たちが観測した TTFT テールレイテンシとスループット不足の根本原因である。
coding agent のワークロードによりよく対応するため、ルーティングシステムを書き直した。
最終的なルーティングシステムは、ポアソン分布を大きく下回る負荷のばらつき(分散は平均の半分未満)を実現している。以下は負荷分布のサンプルで、これも目標同時実行数を5リクエストに設定したデプロイのものだ。
そのために、テールレイテンシと負荷の過分散の原因を一つずつ洗い出し、それぞれに対するルーティングアルゴリズムを追加した。
- セッションが複数のリクエストを同時に送り、割り当て先のレプリカを圧迫する。 対策は、こうした「thicc セッション」を複数のレプリカに分割すること。
- セッションごとの作業量が均一でない。 対策は、負荷を考慮したルーティング。これにより、前述の「運の悪いハッシュ」も同時に緩和される。
- スケールアップ時にセッションを移行しすぎていた。 対策は、新しいセッションを優先的に新しいレプリカへ割り当てること。
同時実行セッションを分割してホットレプリカ問題を解消する
過分散とテールレイテンシの最大の単一要因は、私たちのモデルが ID 付きセッションを「閉じたループ」、つまり各セッションで同時に1リクエストしかないとみなしていたことにある。この前提は崩れた。
私たちのシステムではセッション ID をクライアントが制御するため、同じセッション ID で複数のリクエストを同時に送ることを止められない。セッション ID が常に同じコンテナにマッピングされると、コンテナごとの同時実行リクエスト数に上限がなくなる。全体の負荷が増えていないのに、あるレプリカだけが「熱く」なって極端に高い負荷を抱える。
典型的なコーディングエージェントのセッションは、サブエージェントを伴う場合でも、同時実行リクエストが同じセッション ID を共有する必要はない。典型的なセッションは1ターンずつ進むからだ。ただし、複数の同時入力シーケンスが同じプレフィックスを共有する場合はある。コーディングエージェントのセッションが鎖状ではなく木状になるとき、たとえば /btw を使うときにこれが起きる。
以下は、複数のレプリカにおけるセッション ID ごとのリクエスト数のある時点のサンプルで、リクエスト数が最多のセッションを赤で示している。レプリカ6の最大のセッションは、目標負荷の何倍ものリクエストを同時に抱えている。これはまずい。
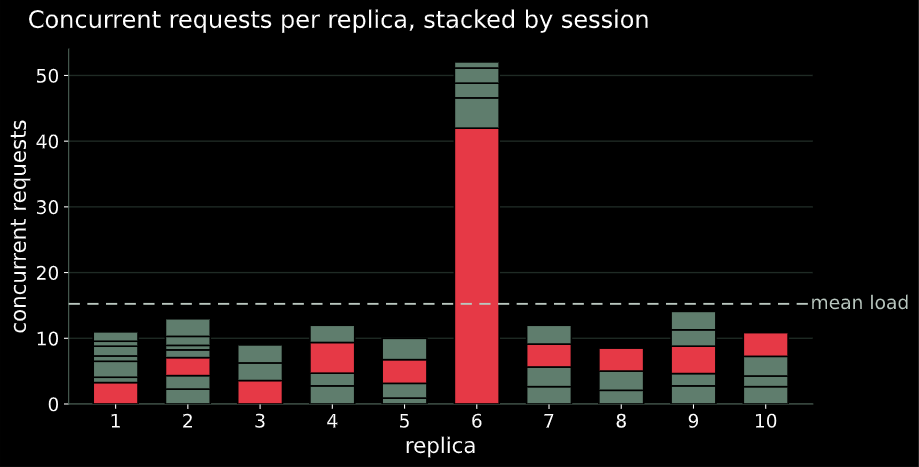
こうした「thicc セッション」が現れると、完全な局所性を保とうとするより、キャッシュの一部を複製して同時実行の作業を複数のレプリカに分散したほうが性能は悪化する。この問題に対処するため、ルーターは同時実行数の多いセッションを積極的に複数のコンテナへ分割する。つまり、セッションを割り当て先のレプリカへ送る前に、そのセッションの負荷がしきい値を超えていないか確認する。超えていれば、そのリクエストは別のレプリカへ送る。
きめ細かな負荷考慮型のセッション配置で、ルーティングの運とセッションの偏りを解消する
前述のとおり、一様ランダムなアルゴリズムには一定割合で「運の悪い」コンテナ/ユーザーが生じる。
さらに悪いことに、先ほどのモデルはリクエストの処理時間が負荷の固定関数だと仮定していた。しかし作業量が増えれば、処理中の作業をさばくのにかかる時間も長くなる。高負荷のサーバーではリクエストの処理に時間がかかり、その負荷が高い位置にとどまる時間も長くなる。裾はモデルが描くより厚くなる。
加えて、どのセッションも必要な作業量は同じだと仮定していた。だが coding agent のセッションには、数十万トークンを含むリクエストを伴う長いものもあれば、数千トークンしかない短いものもある。
これを避けるため、私たちはよりきめ細かな負荷シグナル、たとえば実行中の リクエスト 数(割り当て済みセッション数だけでなく)や KV 使用率に基づいて、新しいセッションをレプリカへ割り当てている。割り当て後も CHR を維持するために、セッションアフィニティは保つ。
スケールアップ時のキャッシュ移行を最小限にする。
負荷が上がっている間は、レプリカ数を増やす必要がある。既存のレプリカは処理中のセッションのキャッシュを温かい状態で保持しているので、それらのセッションは引き続きそこへルーティングしたい。
しかし rendezvous hashing では、コンテナ集合を変えると新規セッションだけでなく処理中のセッションも再バランスされる。とはいえ完全に無秩序になるわけではない。コンシステントハッシュ系のアルゴリズムを使う意味は、ターゲットを1つ追加したときに再ルーティングが必要なセッションが約 1/N で均衡する点にある。それでも一部のセッションは大量の KV 再計算を強いられ、その分遅くなる。
結局これは、また別の形の負荷考慮型ルーティングになる。とくに負荷上昇中は新しいセッションが絶えず作られるので、より多くの新規セッションを負荷の低いレプリカへマッピングすれば、それらは優先的に新しいレプリカへ流れる。新しいレプリカはまだ負荷をまったく蓄えていないからだ。新規セッションの生成速度と新レプリカの追加速度が噛み合わないときは、依然として何らかのバランス調整が必要になる。これも負荷を考慮して解決しており、今回はセッション/リクエストの割り当てだけでなく、セッションの 再割り当て に対して行っている。
デプロイして、あとは楽しむだけ。
これらのルーティング層の変更を入れたあと、マルチレプリカ構成の挙動は、シングルレプリカの結果から外挿して予想していたとおりになった。TTFT は明らかに安定し、デプロイ規模を広げても、レプリカあたりのスループットはシングルレプリカ時の性能にずっと近いままだった。
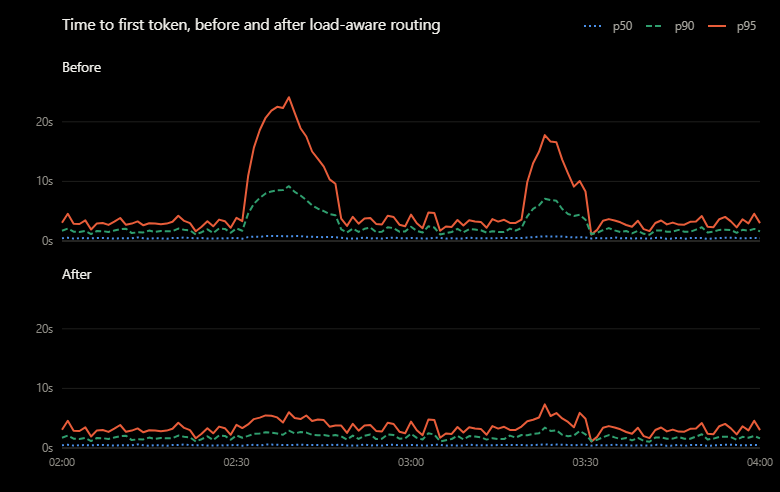
これらの最適化を組み合わせたことで、複数の Kimi K2.6 推論サービスを同時に動かせるようになり、規模は1日あたり数千億トークンに達した。インタラクティブ性とコスト効率は、私たちのベースラインや他の選択肢を大きく上回っている。
その後、この基本的な流れを複数のモデルに対して繰り返した。はるかに速く進んだのは、経験を積んだからであり、再利用できるツールとインフラを作ったからでもある。その一つが Moonshot の新しい Kimi K3 モデルだ。競争の激しい OpenRouter 市場で、私たちは何度も Kimi-K3 のトークントラフィックの大部分を引き受けてきた。この市場は、各推論サービスの品質に応じて需要を配分する。
「科学はときに嘘をつく。」
この作業を通じて、ベンチマークとワークロードを理解するために費やした時間は、サービス自体を最適化する時間とほぼ同じくらいだった。ベンチマークを取るのは難しい。
私たちが気にするほぼすべての指標は、システムと、そこに与えられるワークロードの組み合わせで決まる。データが変われば、システム側に何の変更もなくても観測結果は変わりうる。
最も直接的な方法は、常に同じデータでベンチマークを取り、そのデータを本番ワークロードと完全に一致させることだ。だが本番データは機密性が高く、アクセスは制限されている。しかも本番データ自体が、リクエスト間でも時間軸でも変動する。まともな性能エンジニアリングで肝心なのは、全体の平均ではなく、特定の状況下でシステムがどう振る舞うかを突き止めることだ。
だから私たちは、本番環境の日常的な振る舞いのパターンから外れた「制御された実験」を時々行いたくなる。一つは理論を組み立てるため、もう一つは性能介入の影響をはっきり切り分けて測定するためだ。たとえば前述のとおり、prefill-only モードで TP8 を動かし、私たちのシナリオでは TP4 に劣ることをはっきり示した。これは、自然な振る舞いを観察するだけでなく、制御された実験室環境で介入する科学者のやり方に近い。
データ依存性が顔を出した箇所はいくつかある。
- TPM / GPU は出力長に依存する。クローズドループのシナリオでは、「典型的」なリクエストの多くが、長いシーケンスを1本生成する間に処理し終わってしまうかもしれない。
- 投機的デコードの受理長は評価に使うデータに依存する。コードの受理長は散文のおよそ2倍だ。
- CHR は単一の軌跡に依存する。メッセージの事後編集のようなキャッシュに優しくないパターンがあると、キャッシュの改善がまったく効いていないように見えてしまう。
それから?
この仕事は、ある顧客の特定モデル向けにコーディングエージェントの負荷を最適化することから始まった。だが私たちはほかにも多種多様な推論負荷を手がけてきた。たとえばレイテンシとスループットの両方に敏感な analytical processing などだ(追って詳しく書く)。私たちは推論を本番環境にデプロイする世界有数の企業と緊密に協業し続けているし、あなたともぜひ組みたいと思っている。連絡はこちらから。
本文の性能に関する議論が汎用的であることからも明らかなように、この仕事はすぐに他の顧客の支援へと広がり、他のモデルの提供にも使われた。さらに、私たちの推論サービスと評価スタックに対する長期的な改善も促した。自社の eval プラットフォーム、新しいルーティングシステム、より良いベンチマーク手法などで、これらは近いうちに詳しく書く。
すでにお気づきかもしれないが、私たちは中核となる自動スケーリングのクラウドインフラプラットフォームをかなり気に入っている。本文中のより低レイヤのエンジニアリング上の選択の多くが実現可能なのは、これのおかげだ。
これがこの記事を書いた理由でもある。もし自分たちのプラットフォームが高性能推論の実行に最適だと本当に信じているなら、なぜ推論性能の「アルファ」を隠す必要があるだろう? これが私たちがオープンソースにこだわる理由でもある。推論エンジンでの作業をアップストリームに還元するだけでなく、Modal Auto Endpoints の土台となるコードと設定も公開している。今すぐ modal endpoint create で Kimi K2.6 の Dedicated Endpoint を立ち上げれば、私たちの設定を確認できる。自分の要件に合わせて書き換えてもいい。
ここまで読んでいるなら、推論性能の最前線に興味があり、さらに前に進める力もあるということだ。一緒にやるなら modal.jobs を見てほしい。推論に関心のあるシステムエンジニアも、推論分野の専門家も、ぜひ話をしたい。
謝辞
この仕事は、Moonshot AI のようなオープンウェイトモデルの提供元、SGLang のようなオープンソース推論エンジン、そして研究成果を公開して他者がその上で前に進めるようにしてくれる研究者とエンジニアのコミュニティ全体なしには成り立たなかった。