シャーディング設計はテーブルから始まらない
シャードグループはコロケーションの単位だ。いちばん重要なクエリとトランザクションが共有するキーを見つけ、そのキーを持つテーブルをすべて同じグループに入れる。
日本語
コピー
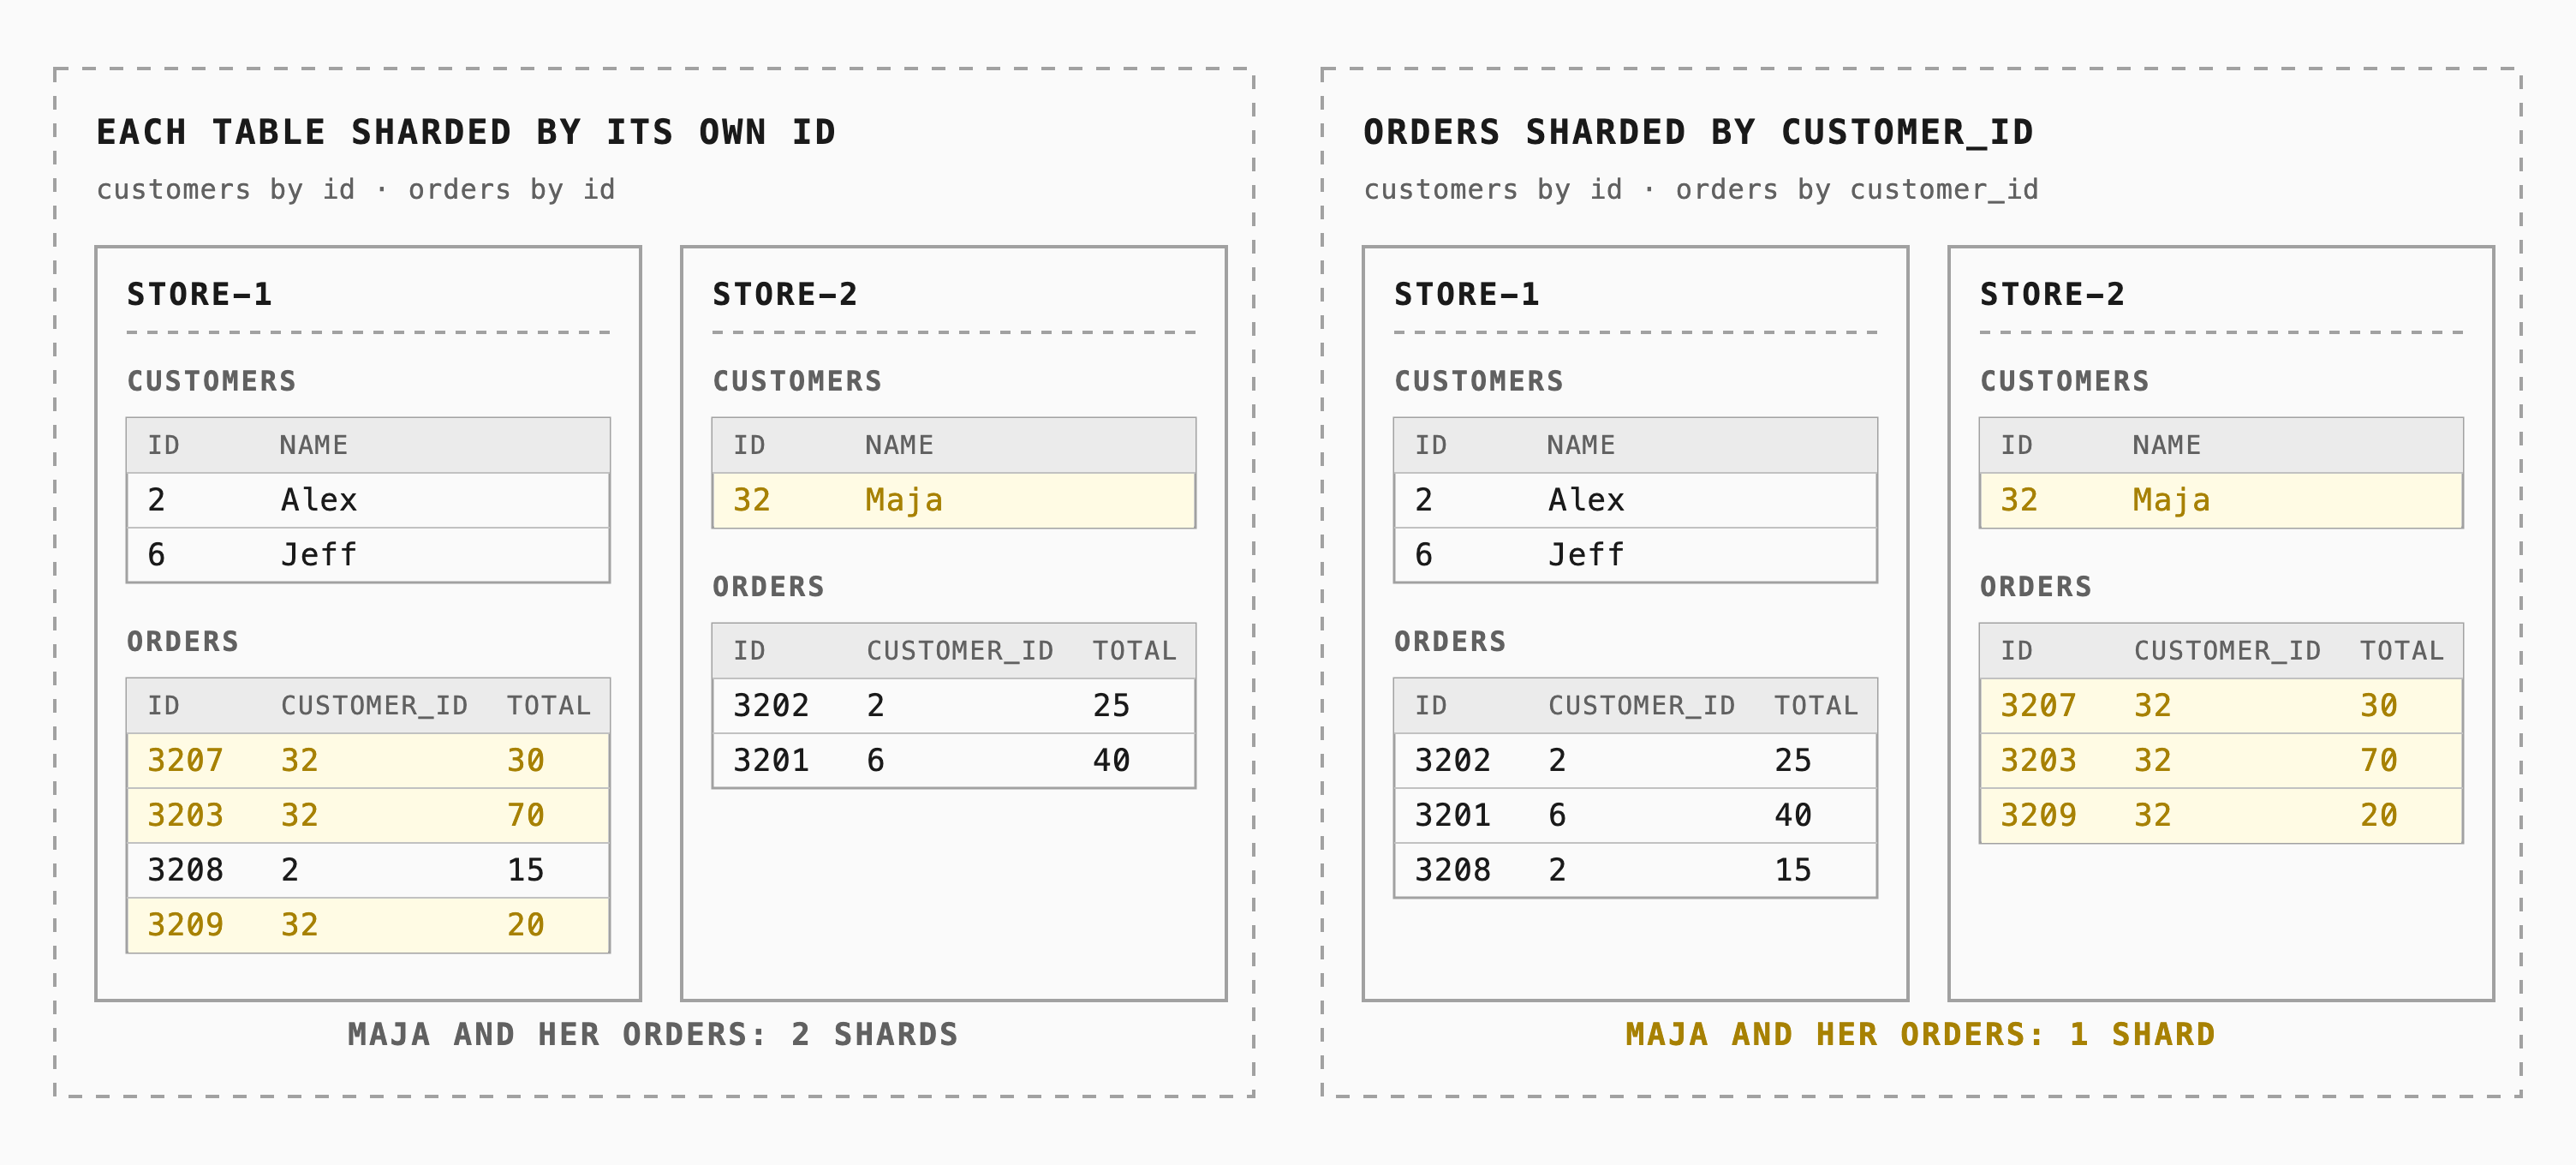
以前の記事 The lifecycle of a sharded Postgres query では、テーブルごとに自分の ID でシャーディングされていたため、ルーターが customers と orders を自分で join する必要があった。解決策は、orders を customer_id でシャーディングすることだ。ハッシュとマッピングの方法は customers と同じになる。Neki ではこれを「シャードグループ」(shard group)と呼ぶ。
シャーディングは、テーブルの行を複数の Postgres クラスタに分散させる。このクラスタをシャードと呼ぶ。各シャードはテーブルの行の一部を持つ。最高の性能を出すには、ほとんどのクエリが 1 つのシャードだけに触れるようにする。そうすれば Neki のルーターが複数のシャードにファンアウトして結果を集め、集計する必要がなくなる。やり方は、関連する行をすべて同じシャードに置き、join とトランザクションをローカルに留めることだ。
Neki にはこれを行う強力な手段がある。それがシャードグループだ。シャードグループは Neki におけるコロケーション(co-location)の単位である。2 つのテーブルが同じシャードグループに属し、それぞれのシャードキーを同じ方法でハッシュしていれば、同じキー値の行は必ず同じシャードに落ちる。
Neki への移行では、シャードグループをよく考える価値がある。どのクエリが 1 つのシャードに収まるかを決めるからだ。ただし、永久に続くものではないことは覚えておきたい。Reshard workflow を使えば、後からテーブルのシャードキーやシャード数を変更できる。クエリが変わっていくにつれて、たいていはそうしたくなるはずだ。この記事では前回の記事の storefront の例を引き継ぎ、その設計方法を説明する。
まずはデータトポロジーを見てほしい。storefront のシャーディング構成を余すところなく表したものだ。以前の記事 What is a data topology? を参照するとよい。
関連するテーブルをまとめる
{
  "shard_indexes": {
    "by_customer": { "type": "xxhash", "columns": ["customer_id"] }
  },
  "shard_groups": [
    {
      "uid": "customer_data",
      "default_shard_index": "by_customer",
      "key_ranges": [
        { "shard_uid": "store-1", "end": "80" },
        { "shard_uid": "store-2", "start": "80" }
      ]
    }
  ],
  "databases": {
    "store": {
      "default_shard_group": "customer_data",
      "schemas": {
        "public": {
          "tables": {
            "customers": { "primary_indexes": [{ "columns": ["id"] }] }
          }
        }
      }
    }
  }
}
customer_data のシャードグループには 2 つの重要な要素がある。
1 つ目は、デフォルトのシャードインデックスを定義していることだ。by_customer は、このシャードグループのテーブルに customer_id 列があることを示している。Neki はその列の値を取り出してハッシュする。xxhash はその数値(ここでは具体的な customer_id)を 64 ビットのキースペースにマッピングする。
2 つ目は、シャードグループの key_ranges がこのキースペースを物理的な Postgres クラスタ、つまり各シャードに分割していることだ。各シャードは 64 ビット空間の 1 区間を持つ。ここでは範囲を 2 つに分け、ハッシュによって行が store-1 に行くか store-2 に行くかが決まる。
これで、このシャードの組をデータベース内のテーブルに適用できる。store データベースに customers、orders、items、addresses というテーブルがあるとしよう。通常、customers の主キーは id で、他のテーブルは customer_id 列で顧客を参照する。
デフォルトのシャードインデックスはすでに customer_id 列をシャードキーとして使っているが、customers には特別な対応が必要だ。Neki ではデフォルトインデックスを継承しつつ、別の列 id に切り替えられる。こうすると、同じ顧客の注文、明細、住所がすべて同じシャードに収まる。単一の顧客や単一の注文に対する一般的なクエリとトランザクションは、シャードをまたがない。
これは速度だけの話ではない。1 つのシャードに収まるトランザクションは Postgres のセマンティクスをそのまま保てるが、2 つのシャードにまたがるトランザクションはそうはいかない。Neki は各シャードを個別にコミットするので、アトミックなコミットも共有スナップショットも存在しない。
参照テーブル
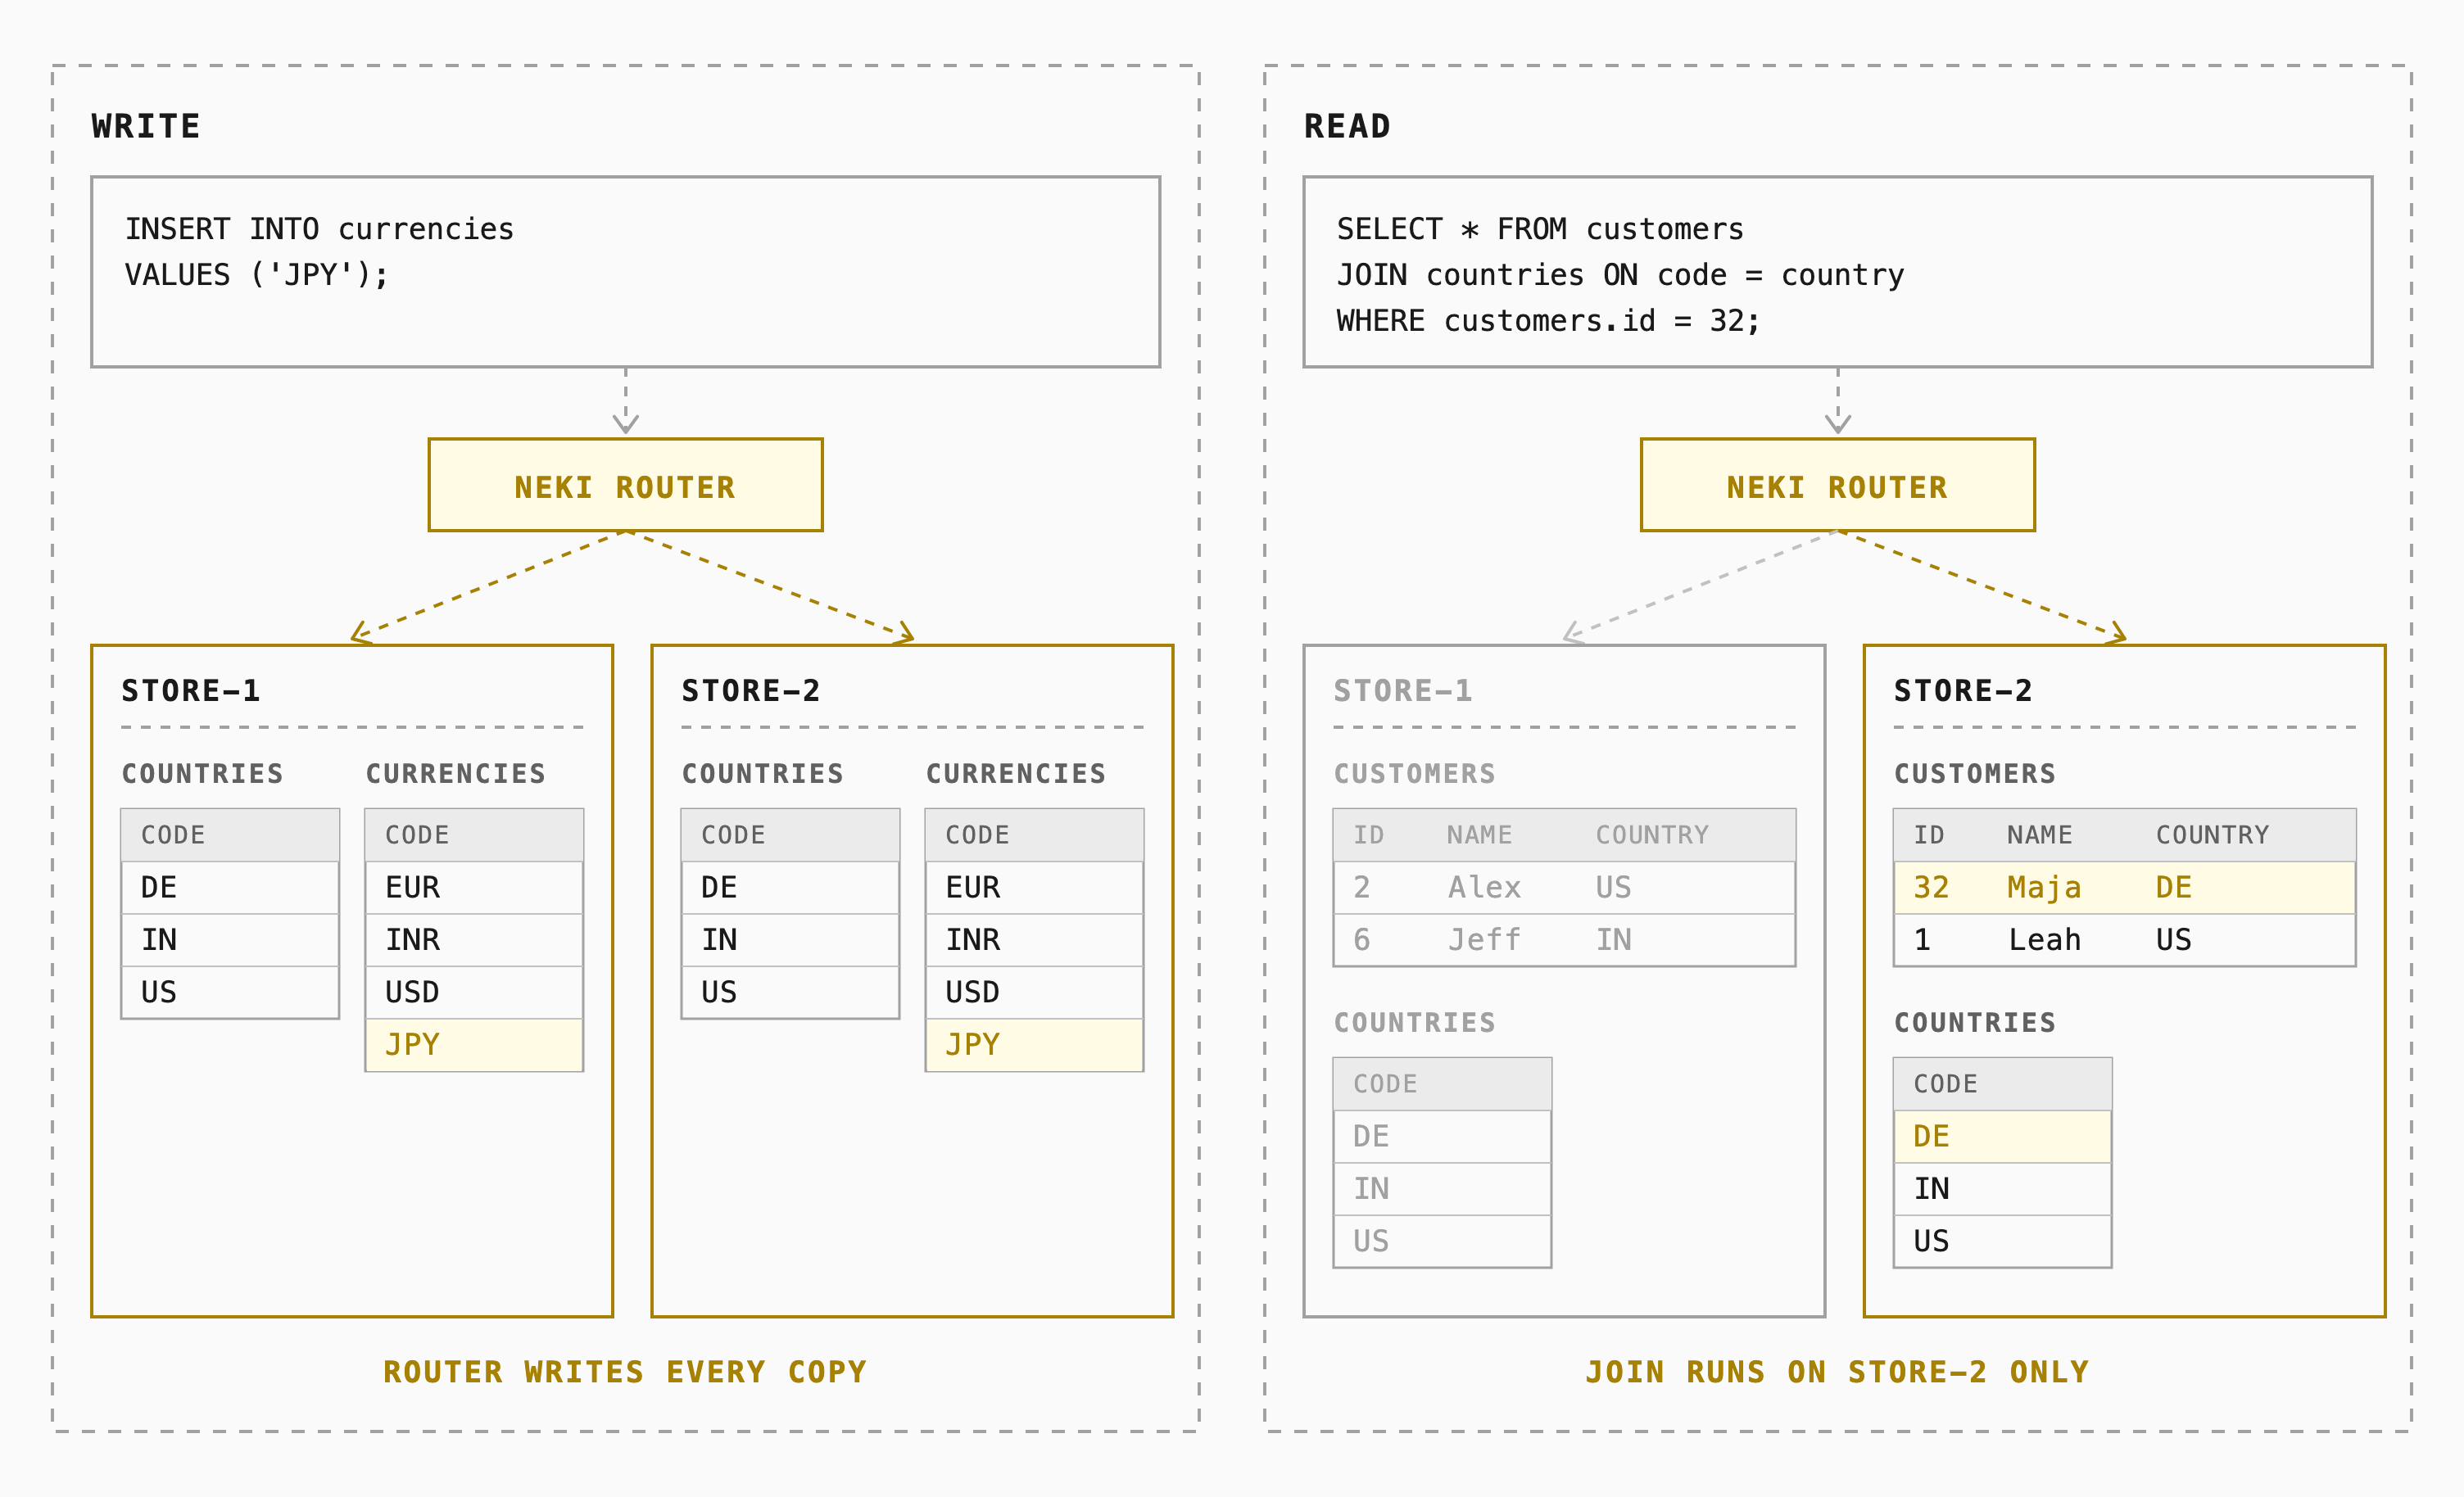
ルックアップテーブルのように、多くのクエリで使われるものの特定の顧客に属さないテーブルがある。たとえば countries、states、currencies、tax_rates などだ。こうしたテーブルを 2 つのシャードのどちらか一方に置いたり、3 つ目のシャードに置いたりすると、多くのクエリがシャードをまたぐことになる。
Neki では、こうしたテーブルを参照テーブルとして宣言できる。指定した各シャードグループで、すべてのシャードがそのテーブルの完全なコピーを保持する。初回のコピーは MoveTables ワークフローが読み込む。以降は Neki のルーターが insert、update、delete のたびにすべてのコピーへ送信し、同期を保つ。シャードテーブルと参照テーブルの join がシャードをまたぐことはない。
"reference_tables": {
  "countries":  { "shard_groups": ["customer_data"] },
  "currencies": { "shard_groups": ["customer_data"] }
}
シャーディング方式が異なるテーブル
ストアには商品カタログもあり、対応するテーブルは products、inventory、prices だ。これらのテーブルの自然キーは SKU なので、同じ SKU に関連する行をまとめて配置し、同じシャードを使い回したいところだ。次のコードスニペットは、データトポロジに新しいシャードグループを追加する。
"shard_indexes": {
  "by_customer": { "type": "xxhash", "columns": ["customer_id"] },
  "by_sku":      { "type": "xxhash", "columns": ["lower(sku)"] }
},
"shard_groups": [
  { "uid": "main", "key_ranges": [{ "shard_uid": "store-1" }] },
  {
    "uid": "customer_data",
    "default_shard_index": "by_customer",
    "key_ranges": [
      { "shard_uid": "store-1", "end": "80" },
      { "shard_uid": "store-2", "start": "80" }
    ]
  },
  {
    "uid": "catalog",
    "default_shard_index": "by_sku",
    "key_ranges": [
      { "shard_uid": "store-1", "end": "80" },
      { "shard_uid": "store-2", "start": "80" }
    ]
  }
]
main グループは、シーケンスやスキーマ情報などデータベースレベルのメタデータを置く単一シャードの置き場所だ。各データトポロジは、いずれかのシャードグループを権威シャードグループとして指定する。
この 2 つのシャードグループはシャードを共有する必要はない。今回のケースでは共有したほうが経済的なだけだ。顧客と注文が大きく増えれば、商品カタログに小さなシャードを 2 つ、顧客データに大きなシャードを 8 つ割り当てることもできる。後述するが、Neki ではシャードグループ内のシャードの分割とマージが簡単に行える。
シャードインデックス内の SQL 式
上の例では、by_sku は lower(sku) ではなく sku をハッシュする。これにより、大文字と小文字が混在した SKU を扱える。商品カタログが複数のサプライヤから集まる場合にはよくあることだ。AB-1042 と ab-1042 は同じシャードにマッピングされる。
もう 1 つのよくある例は、アプリケーションが注文 ID にストア ID を埋め込んでいるケースだ。これを "columns": ["left(order_id, 4)"] として指定できる。すると 4711-00093821 はストア 4711 にマッピングされ、同じストアの注文はすべて同じシャードに収まる。
xxhash 以外
xxhash は推奨のシャーディングアルゴリズムで、行を 64 ビットの keyspace 上に均等に分散する。
Neki は他に 2 つのインデックスタイプをサポートしている。あまり一般的ではないが、すでにこの方式でシャーディングしているアプリケーションもあり、この 2 つのタイプがあればそうしたアプリケーションをそのまま Neki へ移行できる。
1 つ目は range で、整数キーの範囲をそのままシャードにルーティングする。たとえば、地理的な位置に基づいてマーチャント ID を割り当てるシステムが考えられる。ここでは、マーチャント ID 0 から 10,000(16 進数で 0000 から 2710)が eu-1 に、ID 10,000 から 20,000(16 進数で 2710 から 4e20)が us-1 に入る。
"shard_indexes": {
  "by_merchant": { "type": "range", "columns": ["merchant_id"] }
},
"shard_groups": [{
  "uid": "merchants",
  "default_shard_index": "by_merchant",
  "key_ranges": [
    { "shard_uid": "eu-1", "start": "0000", "end": "2710" },
    { "shard_uid": "us-1", "start": "2710", "end": "4e20" }
  ]
}]
2 つ目は modulo で、シャーディングの教科書によく出てくるパターンだ。modulo は value % modulus を使って整数キーを固定数のバケットにマッピングする。位置は予測できるが、法を変更しただけでほぼすべての行が移動してしまう。そのため、ほとんどの大規模システムにはこの方式をおすすめしない。
"shard_indexes": {
  "by_region": { "type": "modulo", "columns": ["region_id"], "index_params": { "modulus": "4" } }
},
"shard_groups": [{
  "uid": "regions",
  "default_shard_index": "by_region",
  "key_ranges": [
    { "shard_uid": "store-1", "start": "00", "end": "02" },
    { "shard_uid": "store-2", "start": "02", "end": "04" }
  ]
}]
シャードキーを使わないクエリ
例に戻る。ある特定の注文について、カスタマーサポートがチケットを受け取ったとする。SELECT * FROM orders WHERE id = 84213; のようなクエリは、Neki が orders を customer_id でハッシュするため、すべてのシャードにファンアウトする。Neki はグローバルセカンダリインデックス(GSI)でこのクエリパターンをサポートする。
GSI は Neki が管理するルックアップテーブルだ。テーブルの 1 つまたは複数のカラムを、そのテーブルのシャードキーにマッピングする。今回の例では、データトポロジで次のように定義する。
"global_secondary_indexes": {
  "orders_id_idx": {
    "table": "orders_id_lookup",
    "owner_table": "orders",
    "columns": ["id"],
    "owner_sk_columns": ["customer_id"],
    "unique": true,
    "enabled": true
  }
}
このルックアップテーブルは通常の Postgres テーブルだ。order id に独自のシャードインデックスが必要で、さらにそのインデックスを参照するテーブルエントリも必要になる。
"shard_indexes": {
  "by_order_id": { "type": "xxhash", "columns": ["id"] }
},
"orders_id_lookup": { "primary_indexes": [{ "shard_index": "by_order_id" }] }
orders テーブルは GSI も指定している。これにより、orders 上の読み書きでその GSI が有効になる。
"orders": { "secondary_indexes": [{ "name": "orders_id_idx", "columns": ["id"] }] }これで id = 84213 は単一シャードの読み取り 2 回で済む。1 回目の読み取りでルックアップテーブルの行を取得し、そこから customer_id を得る。2 回目の読み取りで orders から実際の行を取得し、customer_id と注文 id も一緒に取る。
Neki は orders の行を書き込む同じリクエストの中でルックアップ行も書き込む。ここで orders はルックアップテーブルの owner だ。orders に対する DML 文だけがルックアップテーブルを変更する。
orders にすでにデータがある場合、GSI を有効にする前に、Neki が workflow でルックアップテーブルをバックフィルする。
データ配置の変更
Neki の workflow はデータの配置を変えられる。シャーディングされていないテーブルのシャーディング、シャード数の調整、シャードキーの変更に使える。
MoveTables workflowは外部 Postgres データベースを Neki にインポートし、インポート中にシャーディングできる。Reshard workflowはシャードキーの変更やシャード数の調整に使う。
まとめ
ここまでの概念をまとめると、今回の例の最終的なデータトポロジはおおよそ次のようになる。
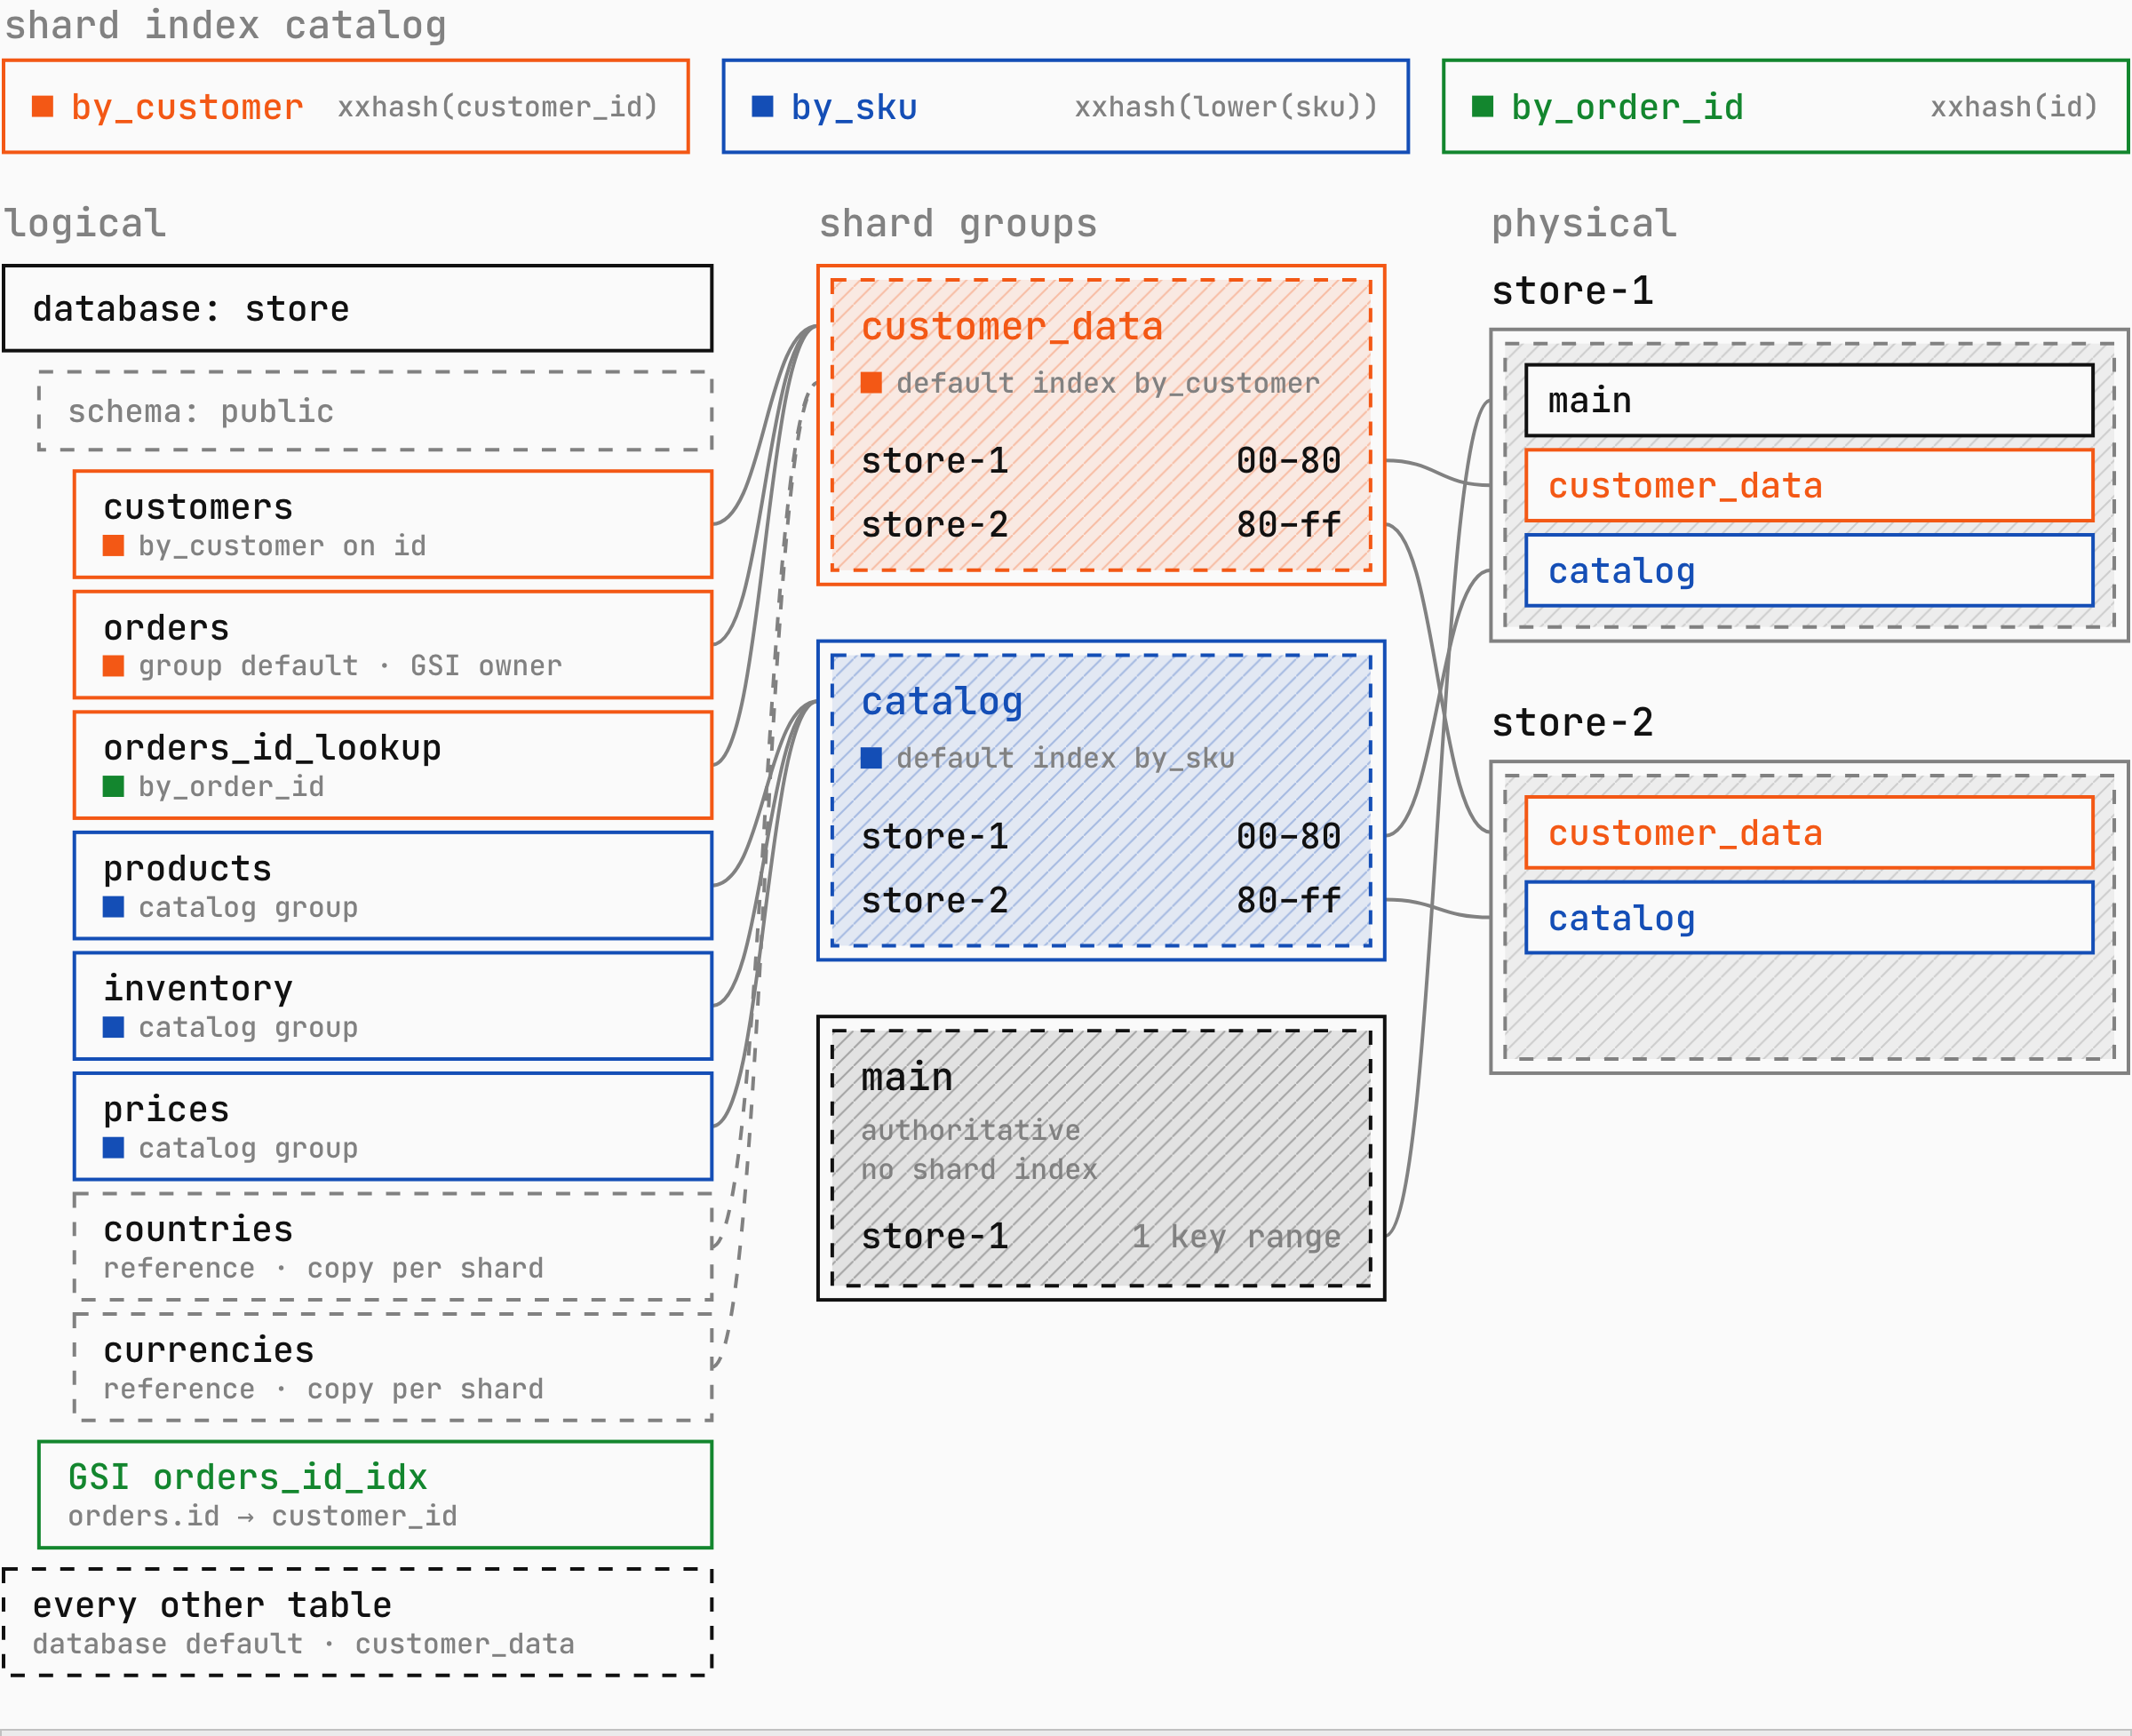
シャードグループはテーブルからではなくクエリから設計する。最も重要なクエリとトランザクションが共有するキーを見つけ、そのキーを持つテーブルをすべて同じグループに入れる。
シャードグループの設計を手伝ってほしい?
データの形とクエリパターンに合わせて優れたシャーディング戦略を見つけるのは簡単ではない。PlanetScale がお手伝いする。お使いの環境でツールを実行し、本番のスキーマとクエリログを調べて提案を出す。
データトポロジーの設計についてはお問い合わせを、今日から Neki を使いたい場合はPlanetScale アカウントの登録を。