分片设计不从你的表开始
分片组是共置单元。找出最繁忙的查询和事务共用的键,然后将携带该键的每张表放入同一个组。
中文
复制
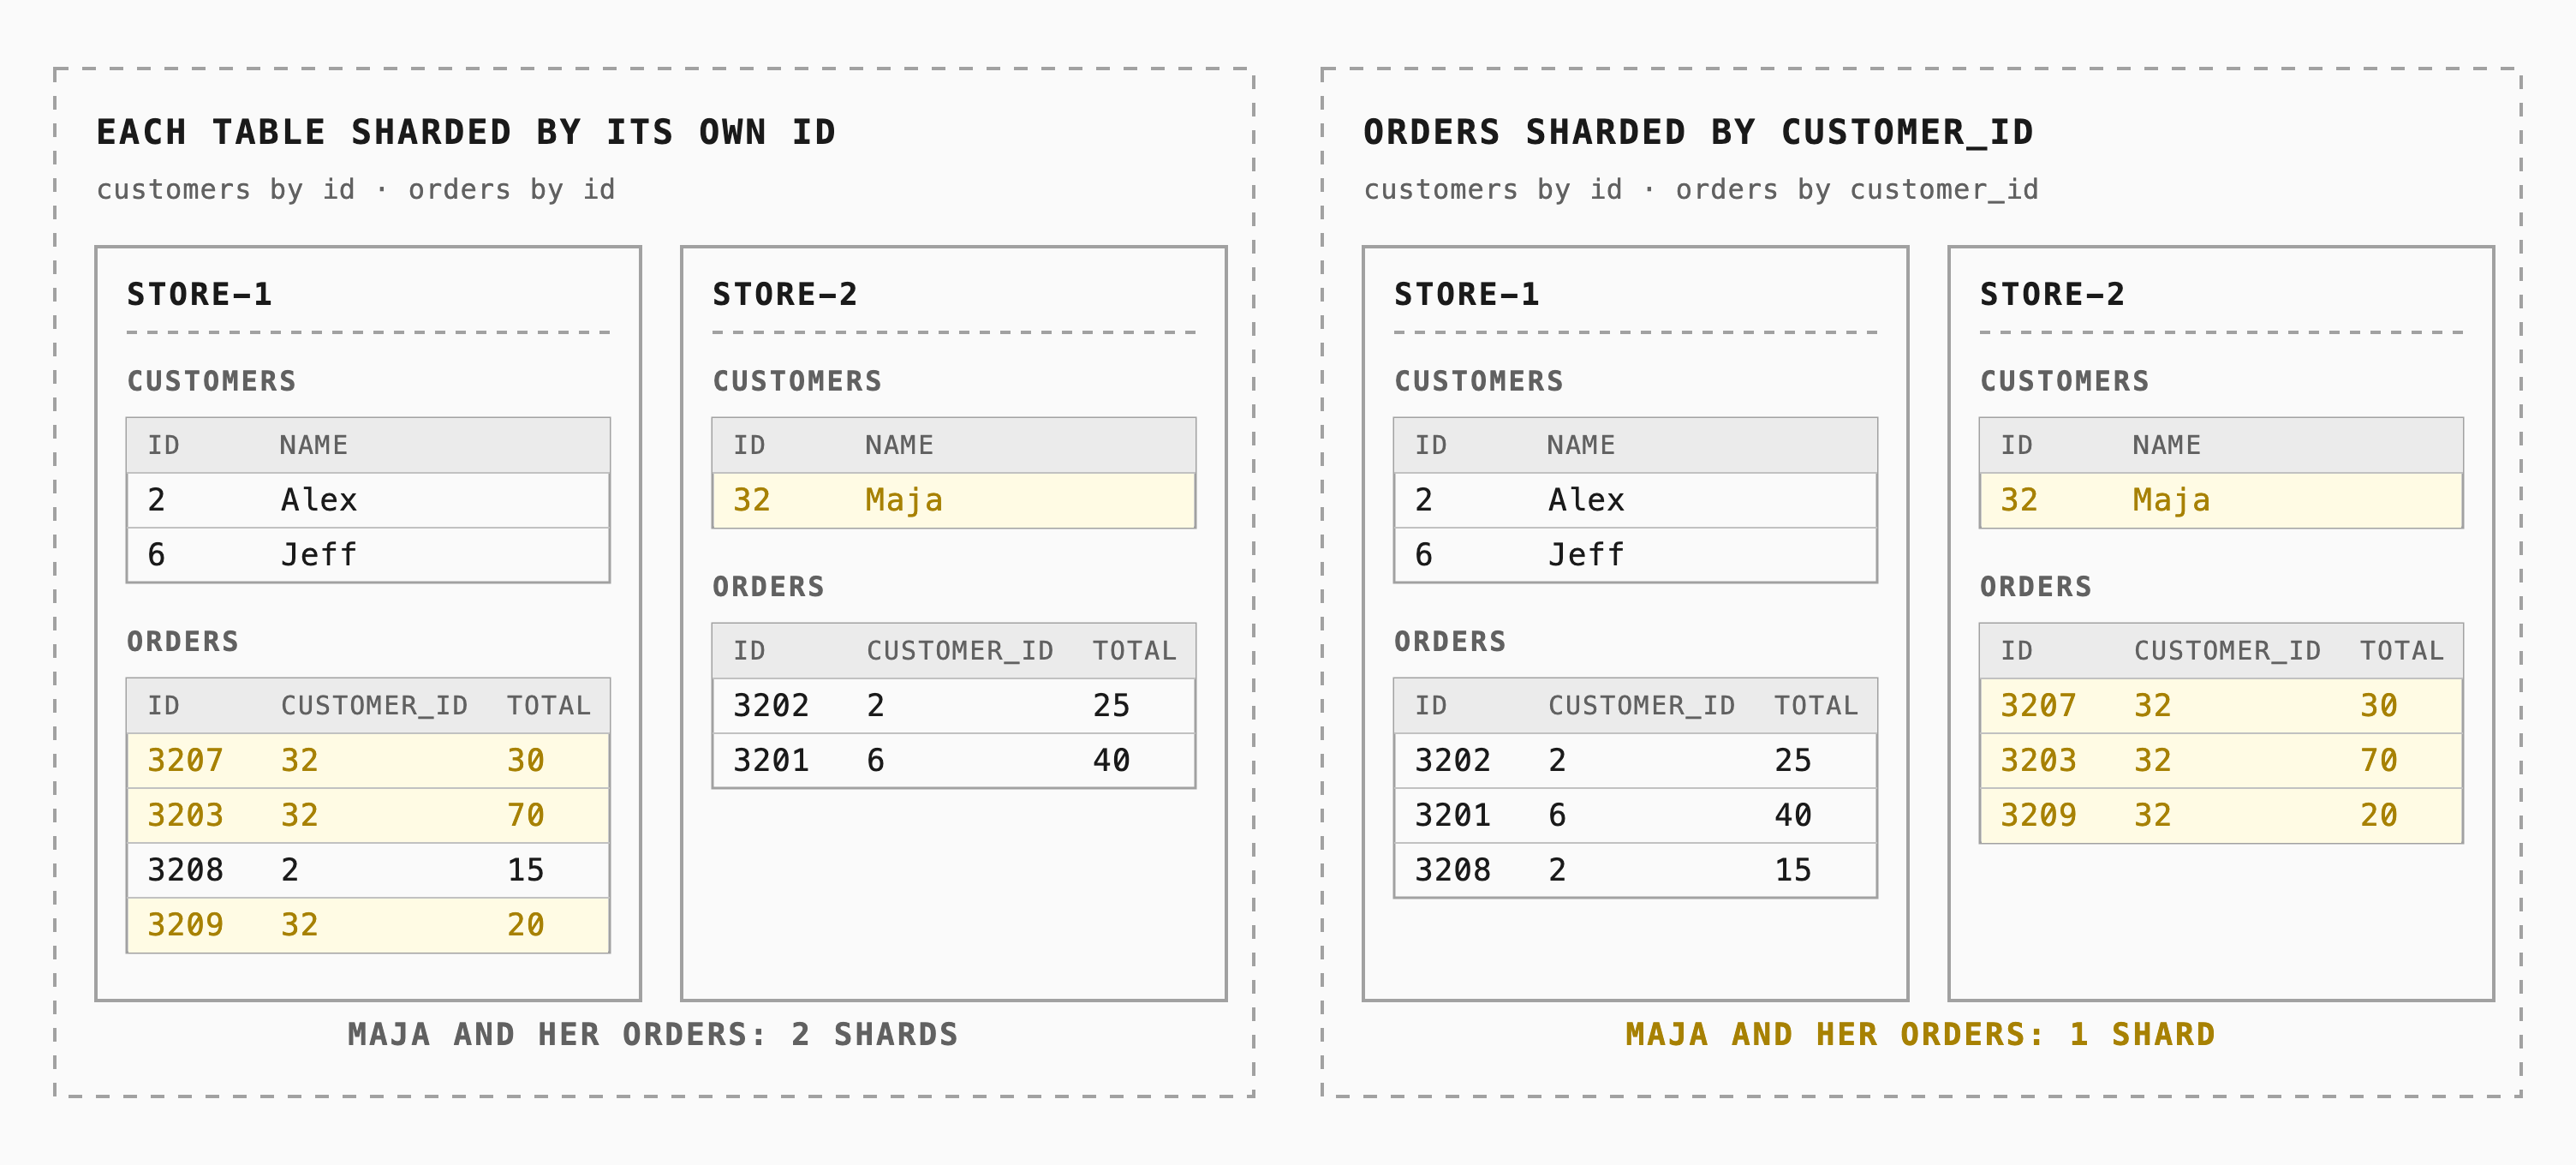
之前那篇 The lifecycle of a sharded Postgres query 里,路由器必须自己 join customers 和 orders,因为每张表都按自己的 ID 分片。解决办法是让 orders 按 customer_id 分片,哈希和映射方式与 customers 相同。在 Neki 里,这个办法叫“分片组”(shard group)。
分片把一张表的行分散到多个 Postgres 集群上,这些集群称为分片。每个分片持有一张表的一部分行。想要最佳性能,就得让大多数查询只碰一个分片。这样 Neki 的路由器就不必扇出到多个分片去收集和聚合结果。做法是把所有相关的行放在同一个分片上,让 join 和事务都留在本地。
Neki 提供了强大的手段来做这件事,就是分片组。分片组是 Neki 里共置(co-location)的单位。当两张表属于同一个分片组,并且用相同的方式哈希各自的分片键时,键值相同的行总会落到同一个分片上。
迁移到 Neki 时值得把分片组想清楚,因为它们决定了哪些查询能留在一个分片上。但要记住,它们不是永久的。Reshard workflow 允许你之后修改一张表的分片键或分片数量,随着查询的演变,你多半会需要这么做。本文沿用之前那篇文章里的 storefront 示例,讲一讲怎么设计它们。
先看一段数据拓扑,它完整描述了 storefront 的分片方案。你可能需要参考我们之前那篇 What is a data topology?。
把相关的表放在一起
{
  "shard_indexes": {
    "by_customer": { "type": "xxhash", "columns": ["customer_id"] }
  },
  "shard_groups": [
    {
      "uid": "customer_data",
      "default_shard_index": "by_customer",
      "key_ranges": [
        { "shard_uid": "store-1", "end": "80" },
        { "shard_uid": "store-2", "start": "80" }
      ]
    }
  ],
  "databases": {
    "store": {
      "default_shard_group": "customer_data",
      "schemas": {
        "public": {
          "tables": {
            "customers": { "primary_indexes": [{ "columns": ["id"] }] }
          }
        }
      }
    }
  }
}
customer_data 这个分片组有两个关键要素。
第一,它定义了一个默认分片索引。by_customer 说明这个分片组里的表有一个 customer_id 列。Neki 取出该列的值并做哈希。xxhash 把这个数字(在这里是一个具体的 customer_id)映射到 64 位 keyspace 中。
第二,分片组的 key_ranges 把这个 keyspace 切分到物理 Postgres 集群,也就是各个分片上。每个分片持有 64 位空间的一段。这里我们把范围一分为二,由哈希决定一行是去 store-1 还是 store-2。
现在可以把这组分片应用到数据库中的表上。假设 store 数据库里有 customers、orders、items 和 addresses 这几张表。通常 customers 的主键是 id,其他表则在 customer_id 列中引用客户。
默认分片索引已经把 customer_id 列用作分片键,但 customers 需要特殊处理。Neki 允许你继承默认索引,同时改用另一列 id。这样一来,同一个客户的所有订单、条目和地址都落在同一个分片上。针对单个客户或单笔订单的常见查询和事务都不会跨出分片。
这不只是速度问题。留在单个分片上的事务能保持完整的 Postgres 语义;跨两个分片的事务则不行:Neki 会分别提交每个分片,既没有原子提交,也没有共享快照。
参考表
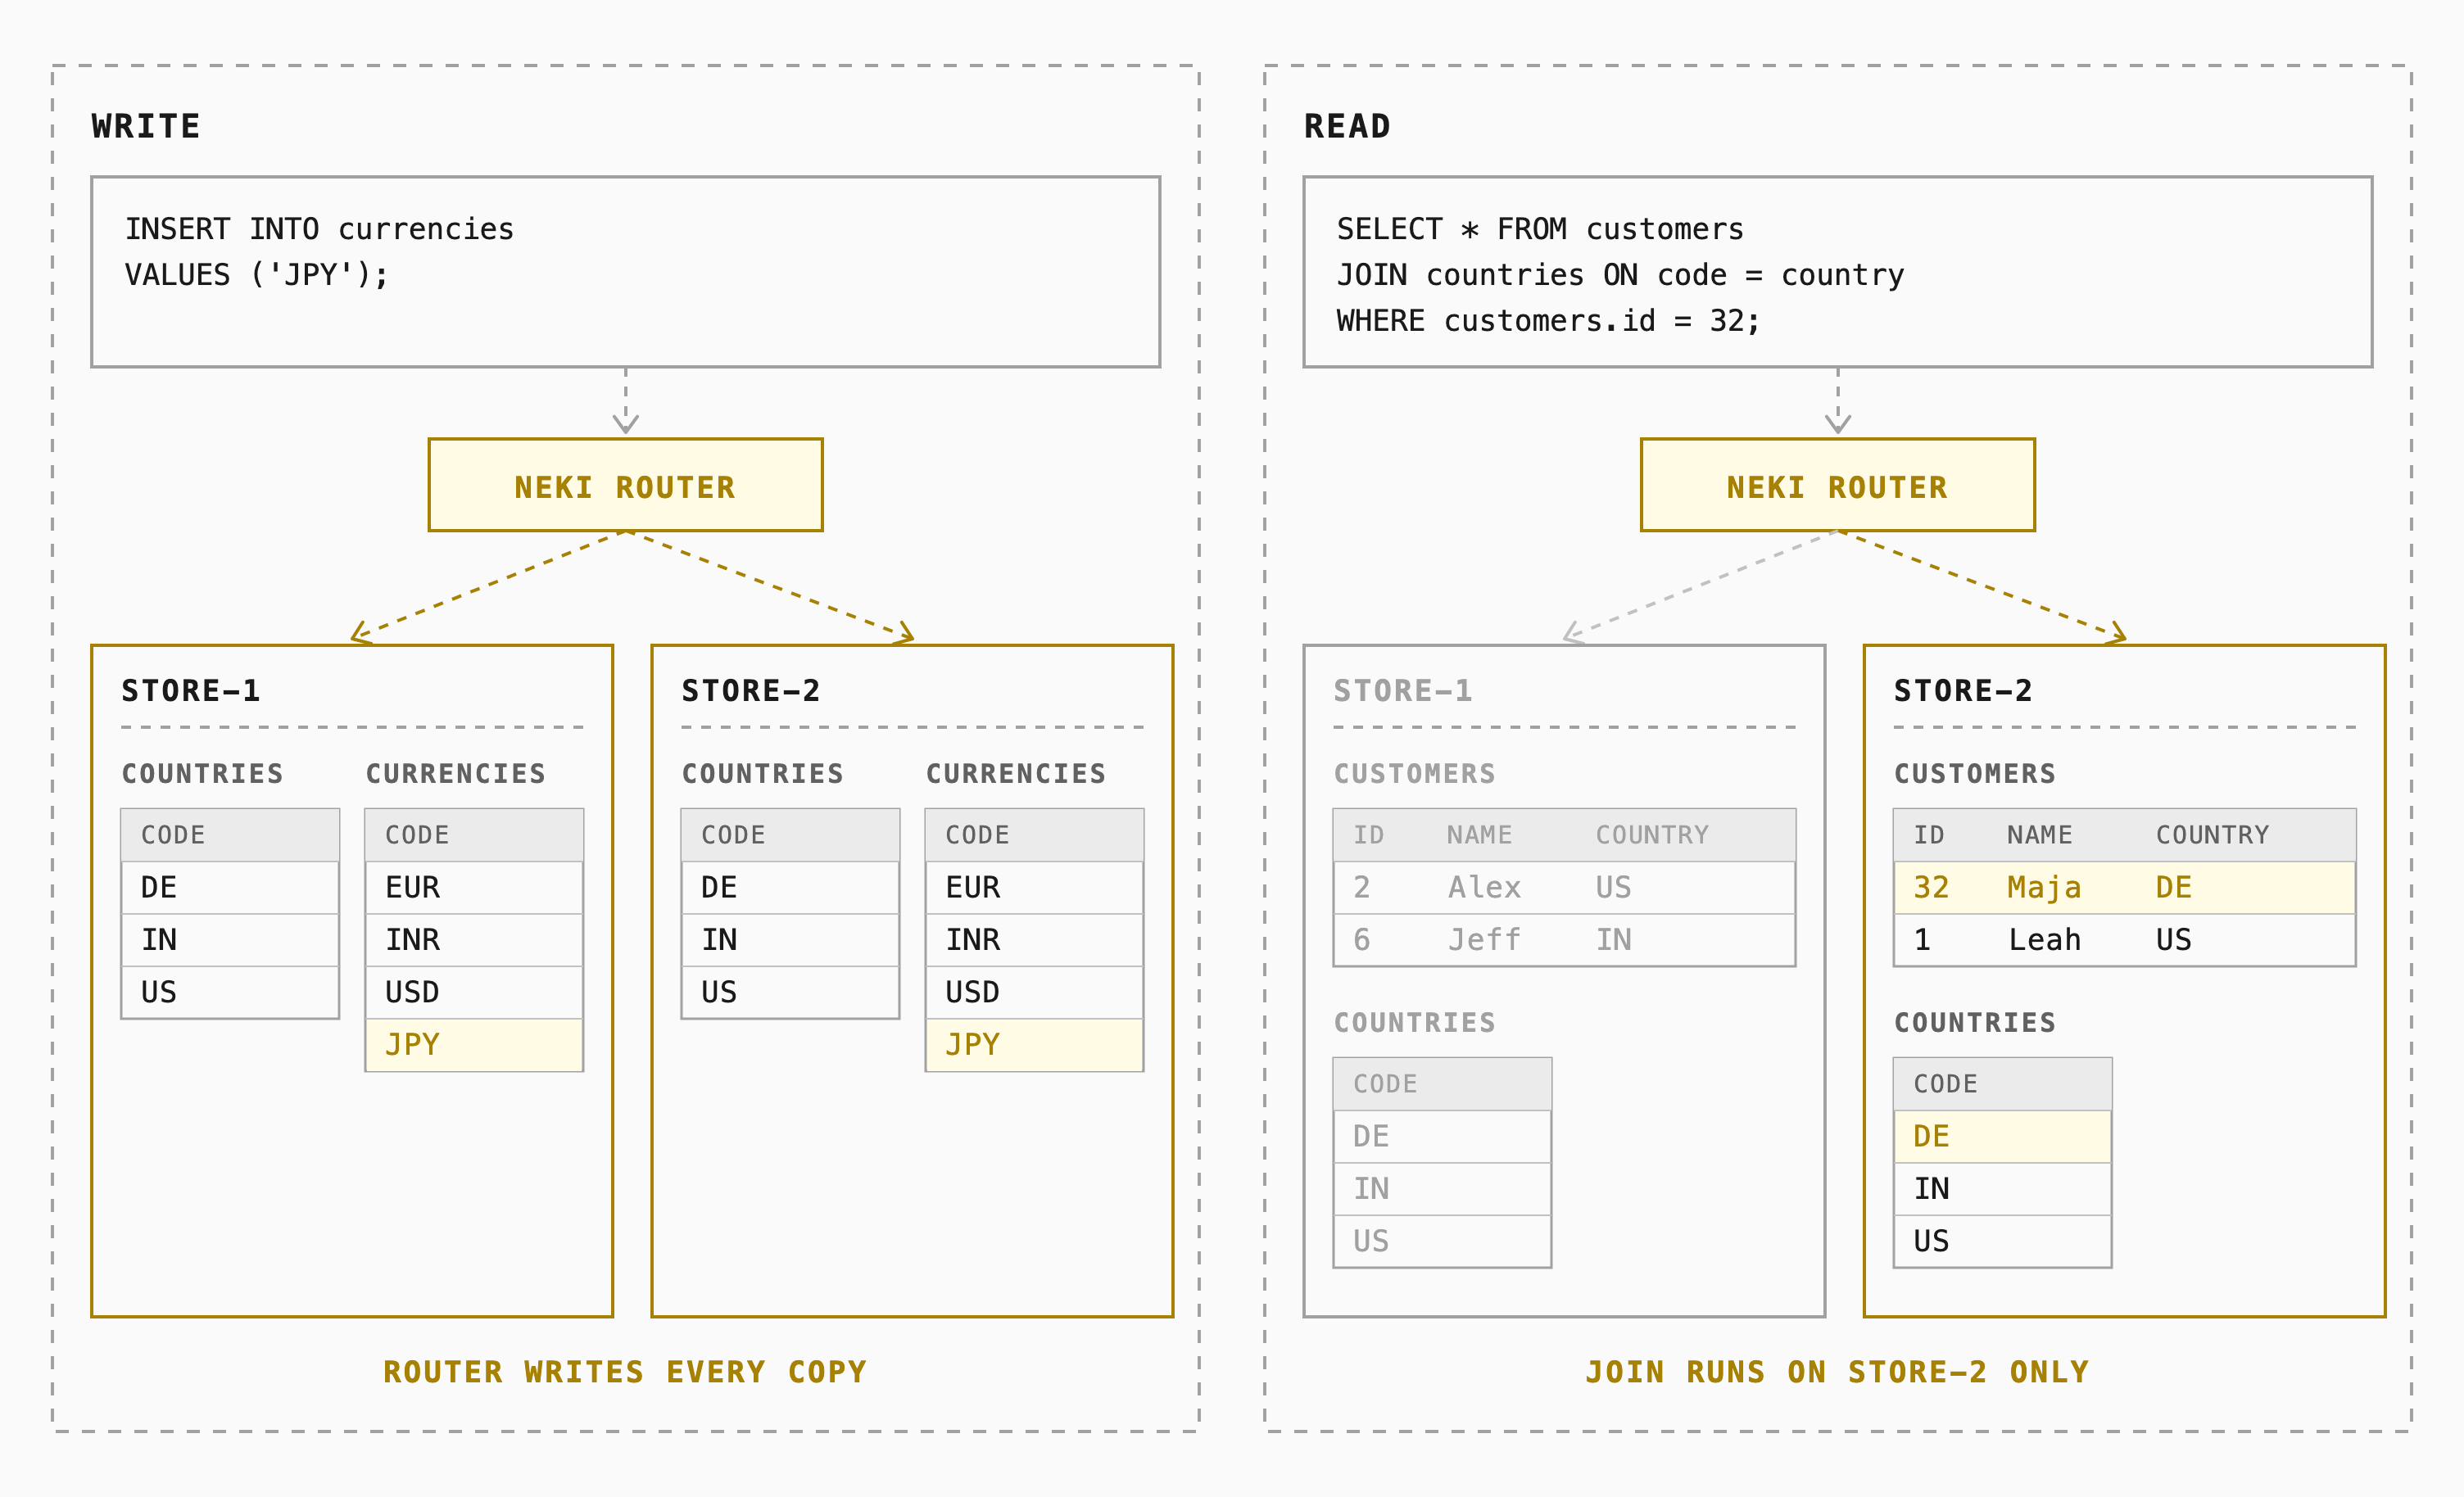
有些表(例如查找表)会出现在许多查询中,但并不属于某个特定客户,例如:countries、states、currencies 和 tax_rates。如果把这类表放在两个分片中的一个上,或放在第三个分片上,许多查询就会变成跨分片查询。
Neki 允许将这类表声明为参考表。在你列出的每个分片组中,每个分片都会保存该表的一份完整副本。MoveTables 工作流负责加载初始副本。之后,Neki 路由器会把每次插入、更新和删除都发送到所有副本,使它们保持同步。分片表与参考表之间的 join 永远不会跨出分片。
"reference_tables": {
  "countries":  { "shard_groups": ["customer_data"] },
  "currencies": { "shard_groups": ["customer_data"] }
}
分片方式不同的表
店面还有商品目录,对应的表包括 products、inventory 和 prices。这些表的自然键是 SKU,因此我们希望把与同一个 SKU 相关的所有行放在一起,同时也想复用同一批分片。下面的代码片段在数据拓扑中新增了一个分片组:
"shard_indexes": {
  "by_customer": { "type": "xxhash", "columns": ["customer_id"] },
  "by_sku":      { "type": "xxhash", "columns": ["lower(sku)"] }
},
"shard_groups": [
  { "uid": "main", "key_ranges": [{ "shard_uid": "store-1" }] },
  {
    "uid": "customer_data",
    "default_shard_index": "by_customer",
    "key_ranges": [
      { "shard_uid": "store-1", "end": "80" },
      { "shard_uid": "store-2", "start": "80" }
    ]
  },
  {
    "uid": "catalog",
    "default_shard_index": "by_sku",
    "key_ranges": [
      { "shard_uid": "store-1", "end": "80" },
      { "shard_uid": "store-2", "start": "80" }
    ]
  }
]
main 组是存放数据库级元数据的单分片位置,比如序列和 schema 信息。每个数据拓扑都会指定一个分片组作为权威分片组。
这两个分片组不必共用分片,只是在我们的场景下这样更经济。如果客户和订单数量大幅增长,我们可以给商品目录分配两个小分片,给客户数据分配八个大分片。后文会看到,Neki 让分片组内的分片拆分与合并变得很容易。
分片索引中的 SQL 表达式
在上面的例子里,by_sku 对 lower(sku) 做哈希,而不是对 sku。这样就能支持大小写混用的 SKU——商品目录来自不同供应商时经常出现这种情况。AB-1042 和 ab-1042 会映射到同一个分片。
另一个常见例子是应用把店铺 ID 编码进订单 ID。你可以把它指定为 "columns": ["left(order_id, 4)"]。这样 4711-00093821 就映射到店铺 4711,同一店铺的所有订单都落在同一个分片上。
xxhash 之外
xxhash 是推荐的分片算法,它把行均匀分布到 64 位 keyspace 上。
Neki 还支持另外两种索引类型。它们不太常见,但有些应用已经按这种方式分片,这两种类型让这些应用可以无缝迁移到 Neki。
第一种是 range,它把整数键区间直接路由到分片。例如,系统可以按地理位置分配商户 ID。这里,商户 ID 0 到 10,000(十六进制 0000 到 2710)进入 eu-1,ID 10,000 到 20,000(十六进制 2710 到 4e20)进入 us-1:
"shard_indexes": {
  "by_merchant": { "type": "range", "columns": ["merchant_id"] }
},
"shard_groups": [{
  "uid": "merchants",
  "default_shard_index": "by_merchant",
  "key_ranges": [
    { "shard_uid": "eu-1", "start": "0000", "end": "2710" },
    { "shard_uid": "us-1", "start": "2710", "end": "4e20" }
  ]
}]
第二种是 modulo,这是许多分片教材里都会讲到的模式。modulo 用 value % modulus 把整数键映射到固定数量的桶。位置可预测,但只要改动模数,几乎每一行都要挪位置。因此,对大多数规模化系统,我们不推荐这种方式。
"shard_indexes": {
  "by_region": { "type": "modulo", "columns": ["region_id"], "index_params": { "modulus": "4" } }
},
"shard_groups": [{
  "uid": "regions",
  "default_shard_index": "by_region",
  "key_ranges": [
    { "shard_uid": "store-1", "start": "00", "end": "02" },
    { "shard_uid": "store-2", "start": "02", "end": "04" }
  ]
}]
不带分片键的查询
在我们的例子中,假设客服收到一张关于某个具体订单的工单。像 SELECT * FROM orders WHERE id = 84213; 这样的查询会扇出到每一个分片,因为 Neki 对 orders 按 customer_id 做哈希。Neki 用全局二级索引(GSI)支持这种查询模式。
GSI 是一张由 Neki 维护的查找表。它把表的一列或多列映射到该表的分片键。在我们的例子里,在数据拓扑中这样定义:
"global_secondary_indexes": {
  "orders_id_idx": {
    "table": "orders_id_lookup",
    "owner_table": "orders",
    "columns": ["id"],
    "owner_sk_columns": ["customer_id"],
    "unique": true,
    "enabled": true
  }
}
这张查找表就是一张普通的 Postgres 表。它需要在 order id 上有自己的分片索引,还需要一条引用该索引的表条目:
"shard_indexes": {
  "by_order_id": { "type": "xxhash", "columns": ["id"] }
},
"orders_id_lookup": { "primary_indexes": [{ "shard_index": "by_order_id" }] }
orders 表同时指定了 GSI。这会为 orders 上的读写启用该 GSI:
"orders": { "secondary_indexes": [{ "name": "orders_id_idx", "columns": ["id"] }] }现在 id = 84213 只需两次单分片读取。第一次读取拿到查找表的行,从中得到 customer_id。第二次读取从 orders 取出真正的行,同时带上 customer_id 和订单 id。
Neki 在写入 orders 行的同一个请求里写入查找行。这里 orders 是查找表的 owner。只有针对 orders 的 DML 语句才会改动查找表。
如果 orders 中已经有数据,在你启用 GSI 之前,Neki 会用一个 workflow 回填查找表。
改变数据放置
Neki 的 workflow 可以改变数据存放的位置。用它给未分片的表做分片、调整分片数量,或者更换分片键。
MoveTables workflow 会把你的外部 Postgres 数据库导入 Neki,并可在导入过程中对其分片。Reshard workflow 则用于更换分片键或调整分片数量。
汇总
把上面这些概念放在一起,我们这个例子的最终数据拓扑大致如下:
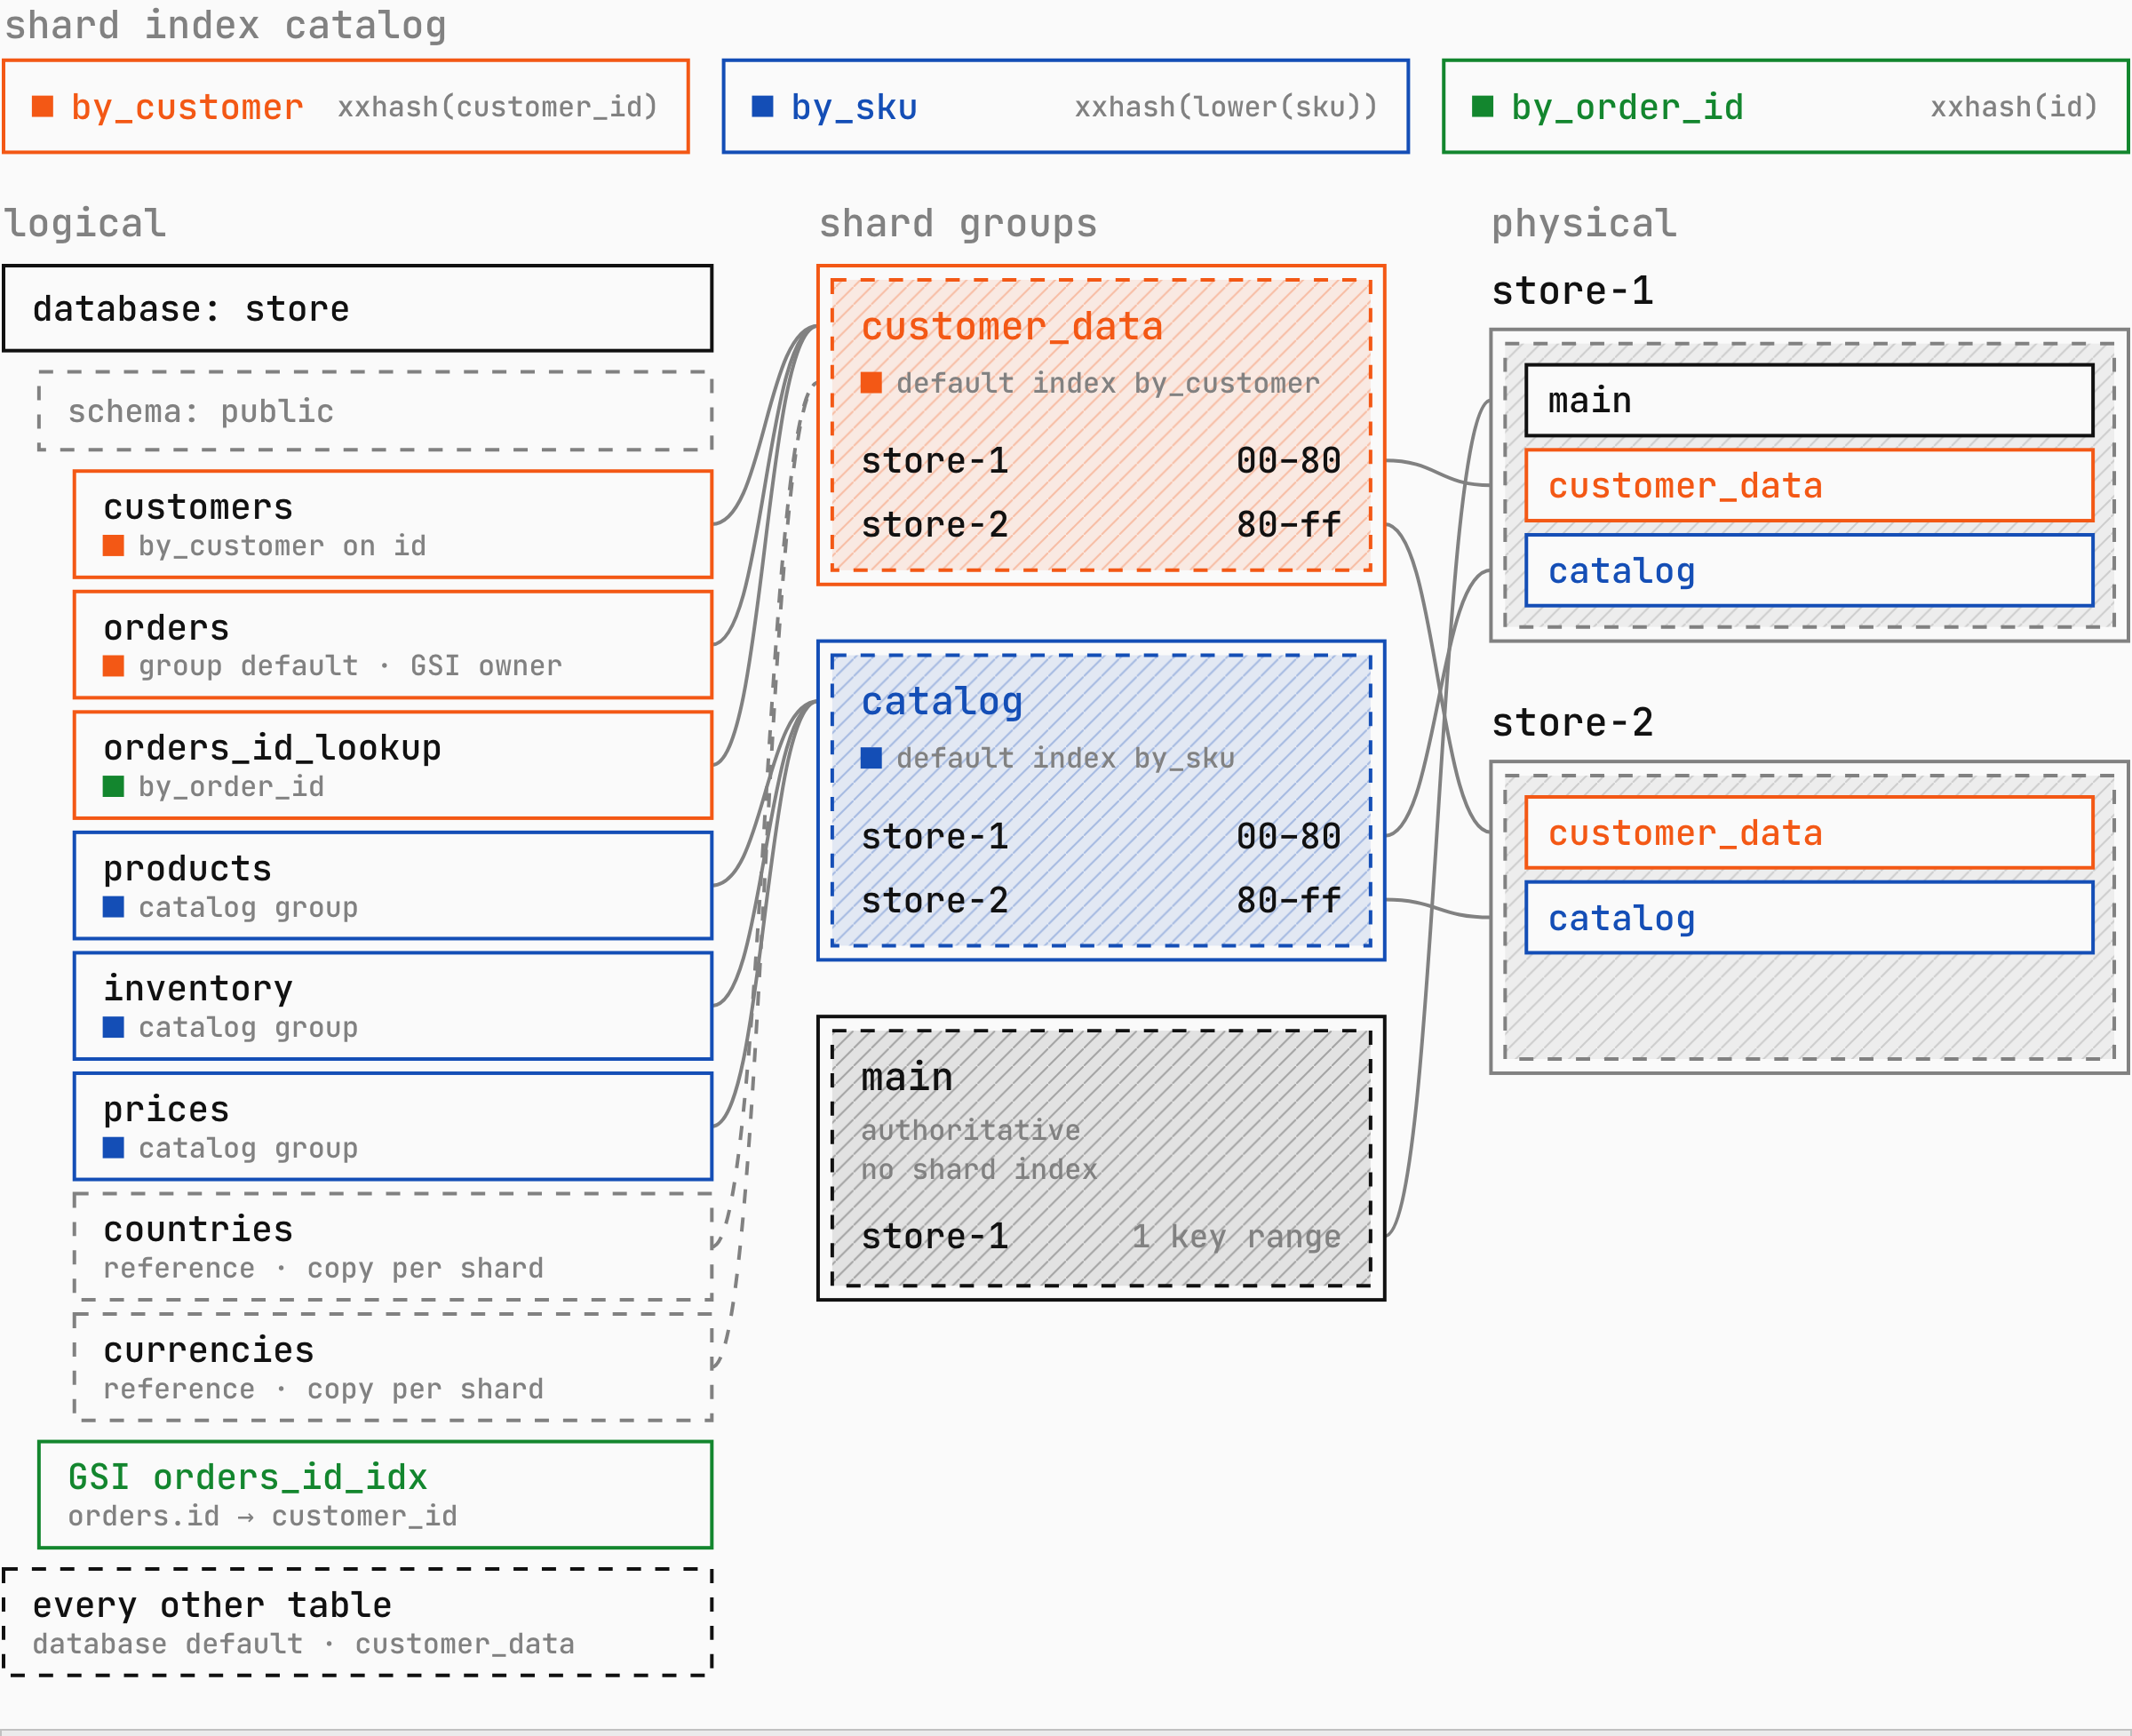
分片组的设计要从查询出发,而不是从表出发。找出最重要的查询和事务共用的那个键,再把所有带这个键的表放进同一个组。
需要帮忙设计分片组?
针对你的数据形态和查询模式,想找到一套好的分片策略并不容易。PlanetScale 可以帮你。我们提供一些工具,在你的环境里运行,检查线上 schema 和查询日志,然后给出建议。
联系我们,帮你设计数据拓扑;或者注册 PlanetScale 账号,今天就开始用 Neki。