Agent は人間ではないが、ほぼ人間と言える
Agent はすでに何百万人もの人々に代わってオンラインで行動しているが、Site が見ているのは User ではなく仲介者だ。Cloudflare はこの問題を分解し、アイデンティティ、評判、説明責任が欠けている三つの要素だと指摘した。
日本語
コピー
AI Agent はいまや何百万人もの代わりにウェブを操作している。Site にとって、Agent はさまざまな形をとりうる。タスクを実行する人間のユーザーと見分けがつかないこともあれば、大勢の User を代表する一人の訪問者のように見えることもある。これにより Site は、Agent の背後にいるユーザー(一人または複数)を識別し、サービスを提供し、責任を問う能力を失う。しかも問題が起きたときのコストは Site が負う。本稿の主張はこうだ。Site が Agent に開放するアクセス権を最大限にしたいなら、エコシステム全体が、Site と User の関係を維持するための新しい仕組みを育てる必要がある。セキュリティと不正対策の分野では、これには伝統的に三つの要素が要る。すなわちアイデンティティ、レピュテーション、アカウンタビリティであり、Site が三つの問いに答えられるようにする。操作者は自分が誰かについて正直に語っているか。この人物は信頼できるか。問題が起きたとき、誰が責任を負うのか。
「Personal AI Agent」(以下「Agent」)とは、人間(「User」)の指示を受けて、クラウド上のコンピュータやブラウザを操作して何らかの目標を達成する自動化プログラムである。通常は「Operator」がホスティングサービスやコンシューマー向け製品の一部として運用・保守する。Meta の Muse や OpenAI の dots がその例で、新しい製品も次々に登場している。Agent はオンライン上で User がなしうるあらゆる行動をとりうるが、人間を縛る制約は受けない。疲れることなく 24 時間動き続け、並行して行動し、誰も耐えないような摩擦にも耐える。ウェブの大部分は、Site がキャパシティをどう計画するかからどう収益を上げるかに至るまで、そうした制約の上に成り立っている。
根本的に、リモートでホストされる Agent は仲介者である。仲介者とは User と Site の間に位置するあらゆるものであり、Site が見るのは User ではなく仲介者になる。Agent は最新の種類の仲介者にすぎないが、仲介者自体は以前から存在した。クラウドブラウザ(ソフトウェアが User の代わりに操作するホスト型ブラウザ)やプロキシ(VPN を含め、User のトラフィックを転送するサービス)も同じく仲介者である。変わったのはトレンドだ。Agent のトラフィックは急速に伸びており、近い将来にはインターネット上の従来の人間による閲覧を追い越すかもしれない。これにより、今日 Site を運営する誰もが現実と向き合わされる。これまでは仲介者のトラフィックを一律にブロックし、User に仲介サービスの利用をやめるよう求めればよかった。トラフィックの大半が Agent 由来になれば、この手は通用しない。ブロックが現実的でなくなった時点で、Site の運営者に残るのは、仲介者がずっと引き起こしてきた問題そのものである。Site は User に関する直接の情報を失い、しかもその情報なしに仲介者を信頼すべきかどうかを決めなければならない。
本稿が扱うのは、ユーザーのデバイスの外でホストされる Agent である。ローカル Agent(OpenClaw など)、あるいはユーザー自身のブラウザやデバイス上で動く Agent は、本稿の主な対象外とする(後述の「オープンソースとローカル Agent について」を参照)。
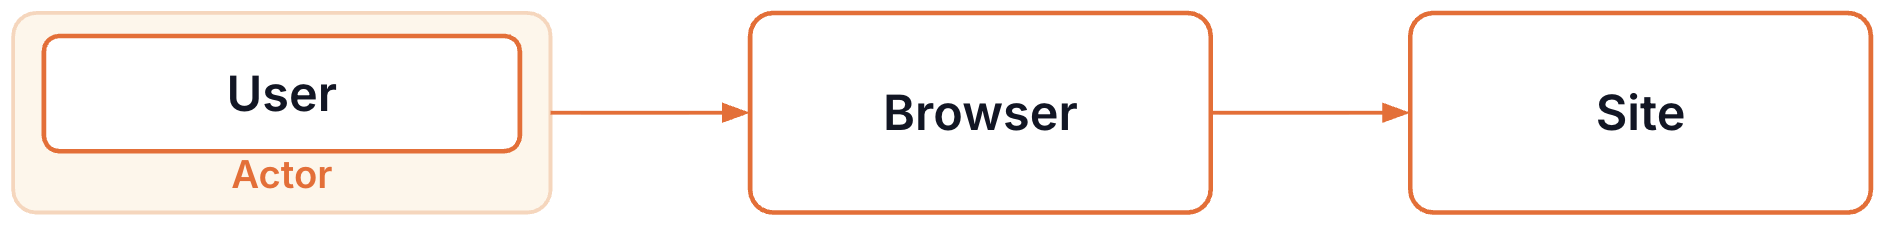
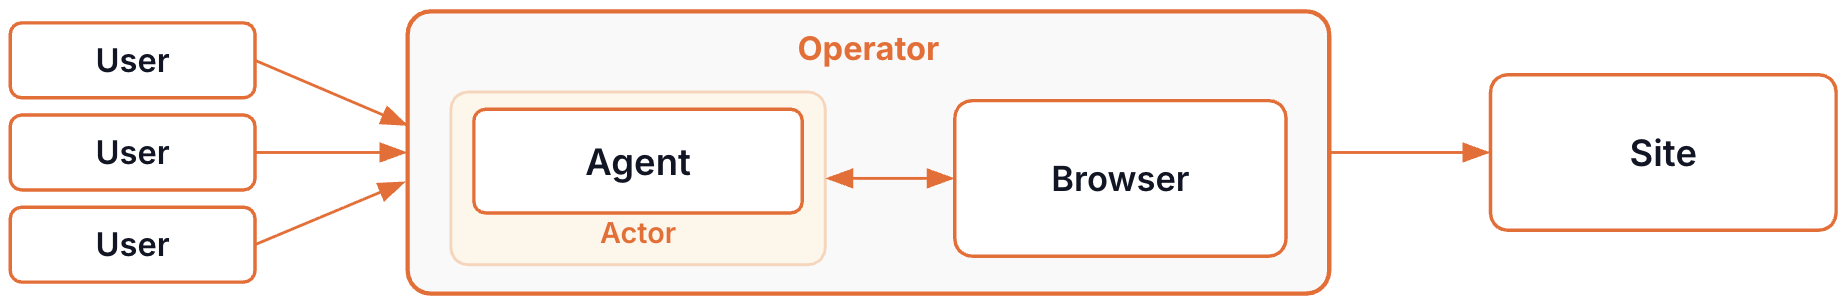
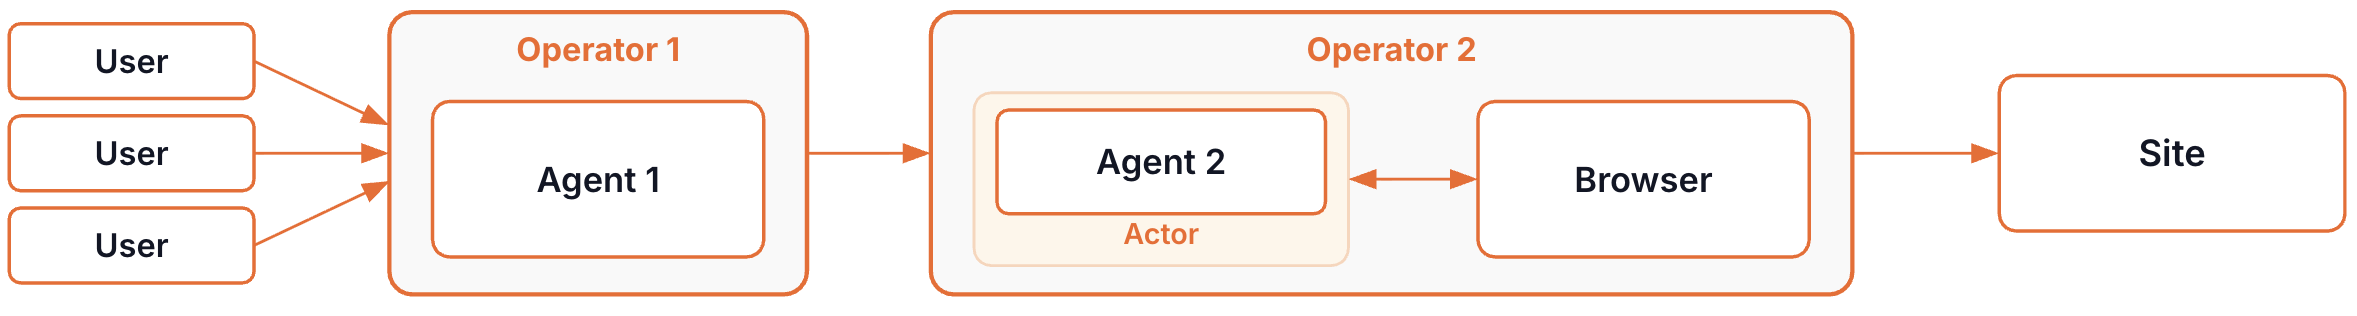
この記事はひとつの原則の上に成り立っている。
仲介の原則。User と Site の間の業務上の関係、および各当事者の安全責任は、仲介者が存在しても変わらない。
Site には新しいツールが必要だ。Agent を通じて行動する User を、その User が直接訪れたときと同じ効果で識別し、サービスを提供し、責任を問えるようにする。Agent とその背後にいる Operator もまた、識別可能で責任を追及できなければならない。Agent は User にはできないことをやってのけるからだ。Agent は人間のアクセスの規模をほぼ無制限に増幅するため、かつては無害だった行為でさえ新たなリスクをもたらす。
仲介の問題
Ezra の話をしよう。Ezra は自分の街で個人アシスタントをしている。一番の顧客は地元の CEO、Amy だが、Bob、Charlie、Debra の仕事も同時に請け負っている。彼らの代わりに走り回り、食料品を買い、予約を入れ、手続きを済ませ、航空券を手配する。Ezra は人混みに紛れていて、目立たない。
街角の雑貨店の店主は、以前は Amy と顔見知りだった。彼女が何を買うか知っていて、喜びそうな品を取っておいた。今では Ezra しか店に来ず、しかも一度に四人分の注文を抱えている。店主には、どの好みが誰のものか分からない。Ezra を締め出す気はない。彼女がもたらす売上は小さくないからだ。
やがて Bob が Ezra に iPhone の購入を頼んだ。一週間後、彼は店に電話をかけ、あの支払いは承認していないと主張した。iPhone は手元にあるままだ。店がこの紛争に勝つには、Bob が買うと望んだことを証明しなければならない。しかし店が会ったことのある相手は Ezra だけだ。
次に、Charlie が Ezra にパスワードの束を渡した。「自分のパスワードがどれか忘れたけど、この中にあるのは確かだ」。Ezra は辛抱強く、Charlie の銀行で一つずつ試した。銀行は攻撃が起きていると分かる。だが封じられるのは Ezra だけだ。Ezra を封じれば、Amy、Bob、Debra もまとめて封じることになる。
どの店も Ezra 本人に恨みがあるわけではない。問題は、Ezra しか見えず、彼女が誰の代わりに動いているのかが見えないことだ。Ezra を AI Agent に、店をウェブサイトに置き換えれば、それが今日のネットワークだ。
サイト運営者は、不正行為を防ぎ、自サイトから効果的に収益を得る、あるいは価値を引き出すために、十分な可視性を求めている。だが Ezra の例が示すとおり、その可視性は AI Agent の前で大きく失われる。以下に、サイト運営者が対応を迫られうる行為を挙げる。いずれも以前は解決策があったが、Agent を許可することで難しくなっている。
| 課題 | サイト所有者の目的 |
|---|---|
| アカウント共有 | 有料購読が濫用され、多数のユーザーに供されることのないよう、サイトは保証する必要がある。Agent 経由のアクセスでは、サイトに見えるのは一つのアカウントと一つのクライアントだけだ。 |
| コンプライアンスと違法活動 | サイトは法的要件を満たし、ユーザー情報を確認しなければならない。たとえば年齢や地域による制限を設けているサイトもある。Agent のアクセスを許すと、Agent はサイトのコンプライアンス基準を満たす保証を提供できない。 |
| 友好詐欺 | 友好詐欺とは、ユーザーが Agent による購入を認めた後、未承認だとしてチャージバックを起こすことだ。サイトは状況証拠で勝てるかもしれない。同じデバイス、同じ IP、同じ住所が、ユーザーの過去の異議なき購入履歴と一致すれば、裏付けになる。だが Agent の購入は Agent 自身のインフラから行われるため、そうした証拠は存在しない。サイトが勝訴しても、チャージバック自体にコストがかかる。サイトは詐欺対策としてチェックアウト行動の記録を保持する必要がある。記録を保持すれば、追加の検証に伴う全体的な摩擦を減らし、取引のチャージバック率を下げ、チェックアウト総額を伸ばすのに役立つ。 |
| 人間確認の意味喪失 | サイトは、自分が抱えるユーザーの種類を区別したい。CAPTCHA などの人間確認は、ブラウザを操作している実体が人間かどうかを検査する。Agent はそもそも人間であることを期待されていない。このシグナルを人間ユーザーにそのまま通す方式は、新しい情報を何も加えず、Agent の効率を下げるだけだ。 |
| なりすまし | サイトは、コンテンツへのアクセスを人間ユーザーに限定したり、特定のユーザーが何にアクセスできるかを制限したりしたい。Agent はしばしば住宅用 IP 上で、本物のブラウザを使い、人間のトラフィックに紛れ込み、自らを人間のトラフィックと区別しないよう意図的に振る舞う。攻撃者は有名な Agent の user agent 文字列をコピーし、同じ扱いを受けようとする。 |
| 本人確認の失効 | サイトは、機密性の高い操作やコンテンツへのアクセスを許す前に、ユーザー身元やその他の情報について追加の確認を求めることがある。ライブネス検出や KYC の身分証確認といった仕組みは、その場にいる人間が確認対象の本人であることを前提としている。Agent は決してその本人ではない。サイトは、Agent がそのまま通してくる確認結果を受け入れるか(これでは検査が弱まる)、Agent を拒否するか、検査そのものを取りやめるしかない。 |
| 行動の不正確さ | サイトは、比較的新しい、あるいは実験的な Agent の誤操作から身を守りたいことがある。Agent は間違える。商品を間違えて買い、日付を間違え、注文を重複させる。サイトは返金やカスタマーサポートでコストを負担し、顧客の好感を保つことはできても、どの Agent が信頼できるのか判断する手立てがない。 |
| ポリシーの回避 | サイトは身元に基づくポリシー(たとえば BAN、パートナーのみ許可、レート制限)を実施したい。だが Agent は常に身元を示すわけではなく、代理するユーザーの情報を伴わないことも多い。 |
| リソースの枯渇 | 無料サービスを提供するサイトやユーザーの参加に依存するサイトは、通常、ユーザー行動に上限があることを前提に設計されている。Agent は絶え間なくポーリングし(在庫確認や価格確認など)、高コストなエンドポイント(検索、在庫、サポートチャットなど)に頻繁にリクエストを送り、無料トライアルやプロモーションの枠を使い果たす。 |
| リスクベース認証の失効 | サイトは、デバイス、位置、行動がユーザーと一致することを前提とするリスクベース認証の仕組みを維持したい。Agent はクラウドインフラ上で動作し、毎回いつもと違うように見える。 |
| トラフィックの混在 | サイトは、自身とユーザーアカウントを濫用や詐欺から守りたい。あるユーザーが共有 Agent を悪用してクレデンシャルスタッフィング、スクレイピング、カードテスティングを行ったとき、サイトは濫用を検知できても、その Agent を BAN することしかできず、それは正当なユーザー全員を巻き込んで BAN することになる。 |
| 未承認のカード保有者 | サイトと決済事業者は、カード保有者を未承認の取引から守りつつ、チャージバックのコストやその他の詐欺関連コストを最小限に抑える必要がある。承認済みのユーザーがカードで購入を完了した場合、責任はカード保有者にある。カード保有者がカードを未承認のユーザーに渡した場合も、渡した責任はカード保有者が負う。Agent は承認済みユーザーの身元を持たないため、サイトはユーザーがその購入を認めているか判断できない。実際には、ユーザーがチャージバックを起こせば、金を出すのはサイトだ。 |
| 見返りのない消費 | コンテンツで収益を得るサイトは、誰がコンテンツにアクセスしているかを把握し制御できなければ、適切な収益モデルを当てはめられない。Agent はコンテンツ(記事、商品データ、レビュー)を読み取り、あるいは抽出し、別の場所でユーザーに答える。サイトはコンテンツ提供のコストを払いながら、アクセス一回、広告インプレッション一回、購入一件を得られない。 |
| ユーザーの帰属 | サイトは、同意したユーザーにパーソナライズ、レコメンド、ロイヤルティプログラムなどの付加機能を提供しており、ユーザーのセッションやデバイスに紐づく分析データに依存している。Agent のトラフィックは、多くのユーザーを一つのクライアントにまとめてしまうか、ユーザーセッションをまったく伴わずに現れる。 |
上のほぼすべての課題で、主なコストは Site が負担する。これは、中間者が存在するときの信頼の働き方に由来する。
私たちのビジョン
目指すのは、すべての User が Site にアクセスできる機会が以前と比べて下がらないインターネットだ。Agent が登場する前、Site はたいてい技術的な手段を一そろい使ってこれらのリスクを緩和できた。User のデバイス、セッション、履歴のフィンガープリントを取るといった手段だ。User は今でもプライベートブラウジングモードでネットを使える。Agent にも同じことができてしかるべきだ。ただし、Agent は追加の検証を経ずに銀行口座へログインする、というわけにはいかないだろう。
これは、Agent が人間のように振る舞うことや、すべての操作に人が立ち会うことを求めていない。求めているのは、Site が User の情報を取得したり提供を要求したりする手段を持ち、Agent の有無にかかわらず、該当する場面で責任を問えるようにすることだ。
試されてきた方法と、その限界
よく挙がる提案は、Agent が Site の CAPTCHA を User に渡して解かせるというものだ。これが証明するのは、その瞬間に人間がいたということ("human in the loop"、HITL)だけであり、それ以上ではない。HITL は主に、アラインメントの失敗による誤りを防ぐための仕組みだ。アラインメントは Operator と User の間の問題であり、これを解決しても上の課題の大半は解決しない。たとえば、Bob を他の誰かと区別することはできない(トラフィックの混在)。それ以外の時間に Agent が誰のために動いているのかも、まったく分からない。しかも、Agent の存在意義は摩擦の解消にあるのに、HITL は摩擦を呼び戻す。だから Operator には、User に代わってそれを外すか回避する動機が生まれる。
もうひとつのよくある提案は、厳しく限定したアクセス制御だ。Agent は User ができることは何でもできるように設計されるので、実際にはあらゆることをする権限を申請し、取得する。権限の範囲が「すべて」では、Site にとって何も語っていないのと同じだ。範囲を狭くしたところで、分かるのは Agent が何を許されているかだけで、Agent が誤ったときに誰が責任を負うかは分からない。Site が本当に答えを必要としているのは、まさにそこだ。
ネットワークに必要なもの
ネットワークに必要なのは、どの行為・操作が許されるかを Site と Agent が協力して判定できるツールとプロトコルであり、Site が Agent に選好とポリシーを伝えられる仕組みであり、しかもそれがすべての Site と Agent が無理なくサポートできる形で実現されることだ。幸い、これらの領域はいずれも作業がすでに進んでおり、その大半(すべてではないにせよ)は既存の標準を当てはめることで解決できる。
プロトコル
Agent と Site は、明確なプロトコルによって上の課題の一部を解決できる。たとえばMOLEは進行中の案で、ユーザー固有の識別子を使わずにレート制限を実現することを目指す。Site が暗黙の身元から離れ、明示的なプロトコルで同じ目的を達成するためのものだ。これは、プライバシーを保ったままネット上の支払いを可能にすることを狙うx402 プロトコルに似ている。私たちは、既存のプロトコルで他の課題を解決できないか、また既存の案で手が届かないところでは新しいプロトコルの設計を、積極的に探っている。
アイデンティティ
Agent のアイデンティティについては、Web Bot Auth(WBA)が第一の選択肢だ。WBA を使えば Agent がリクエストに署名でき、Agent が自身(ひいては Operator)を名乗るための安全な経路が得られる。ただし、多段の中間者を支える仕組みを定義する必要は残る。Agent A がブラウザ C の中で Agent B を使っているとき、Site はその事実を把握できなければならない。そうしてこそ Agent A のアクセスを正しく識別し制御できる。たとえば ポリシーの回避 を防ぐためだ。
セッション、アカウント、ユーザー固有の ID といった他の種類の識別情報も、場面によっては必要になる。私たちは関連する標準団体と協力し、こうした識別情報を伝える方法を探っている。
ユーザーに関わる識別の種類をいくつか見てみよう。結局のところ、アイデンティティは連続したスペクトルであり、ユーザーに関する情報を程度の差こそあれ交換するものだ。その際はデータ最小化の原則に従うのが望ましい。アイデンティティは「あなたは誰か?」に答える仕組みを与え、さらに次の二つの問いにもつながる。「本当に名乗った通りの人か?」そして「あなたを信頼できるか?」だ。
多くの場合、身元を特定する必要はない。Privacy Pass や MOLE のようなプライバシー保護型のアクセス制御は、「あなたは誰か」を問わずに「あなたを信頼できるか」に答える助けになる。Private Access Tokensは、ユーザーの身元を特定せずに信頼を築く初期の試みであり、MOLE はその後継にあたる。とはいえ、このスペクトル上で段階的に開示する必要がある場面もあり、おおむね次のように分類できる。
- 識別子なし。ユーザーは識別子を一切出さずにネット上で活動する。
- セッション。Site は、同じセッション内のリクエストを同じ Agent に紐づける手段を必要とする。これにより Site はセッション単位で評判を築き、それに応じて動ける。たとえばPoppyはまさにこの目的でセッション ID の概念を導入している。
- アカウント。Site は、セッションをまたぐリクエストを同じユーザーに帰属させる手段を必要とする。Operator や第三者がユーザーに割り当てる安定した識別子で、ユーザーとその Operator のアカウントが続く限り変わらないもの、たとえば同じ Agent が毎日同じ識別子で同じ Site を訪れる、といった形だ。これで実現できるユースケースのひとつは「あなたのサイトアカウントをあなたの Agent アカウントに紐づける」だ。
- 一意。Site によっては、第三者発行の、ユーザーごとに一意の識別子を要求することがある。その識別子は Operator、アカウント、Agent、セッションをまたいで変わらない。リスクの高い操作に有用で、高価なリソースへのアクセスを制限する必要がある Site や、厳格なコンプライアンス義務を負う Site にも適する。政府発行の身分証、第三者の本人確認、Proof of Humanのような分散型技術が、こうした識別を提供できる。
結局のところ、サイト側は「このリクエストの背後にいる主体は、今この操作を行う権限を持っているか」という問いにクライアントが答えられるよう、どの情報が必要なのかを自分で決めなければならない。多くの場合、その情報を伝えるプロトコルはすでに存在するか、開発が進んでいる。WBA は Agent のプラットフォーム上の身元を、MOLE はユーザーの評判を、OAuth はアカウントの身元を伝える、といった具合だ。
表明
身元に加えて、一部の操作には実在の本人に関する事実が要る。18 歳以上であることや、カード保有者であること(本人確認の失効、友好詐欺)などだ。こうした情報は通常、Operator が登録時に検証するか、すでに第三者によって把握されている。
この種の制限が付いた Site への Agent のアクセス、あるいは同じく制限付きの操作の実行を可能にするには、Site が情報を要求し、Operator または第三者がそれを提供できる仕組みが要る。
Site の Agent アクセスポリシー
現状、Agent は Site のルールを、何か試してその応答(たいていはブロックされたかどうか)を読み解くことで推測するしかない。双方にとって無駄で、行儀のよい Agent が悪意あるトラフィックのように見えてしまうこともある。Robots.txt はクローラーがどこにアクセスできるかを定めるが、Agent がどの操作を実行できるかを表すには十分でない。
Site には、Agent にどの操作を許すかを機械可読な形で公表する手段が要る。IETF は現在、関連する選好表現の仕組みを精力的に策定しており、中心は AI Preferences Working Group だ。ただしこのグループが扱うのは利用選好(学習、推論、検索など)の表現であり、ここで論じている、より広い範囲の選好表現の必要性に専念するグループはまだない。
オープンソースとローカル Agent について
「Intermediary」として動かない Agent(デバイス上の Agent や、OpenClaw のようなローカルでホストされる Agent など)は別種の問題を持ち込む。見た目は自動化プログラムそのもので、実際そうであり、評判を築く対象も責任を負わせる単一の主体も存在しない。
解決策はいろいろある。その一つが、こうした Agent に Unique ID の提示を求めることだ。ただ、これは Trusted Agent Delegation が当初扱おうとしていた主題ではない。
次のステップ
Site が直面しているこれらの問題は、断片化したベンダー独自の仕組みでは解決できない。必要なのは、オープンで相互運用可能、かつ現実の経験に根ざした標準だ。私たちはエコシステムの各社と協力を続けてきたし、今も続けている。主要な Operator、本人確認企業、決済事業者、加盟店、パブリッシャー、プロキシ事業者、クラウドブラウジング企業が対象で、運用上の要件を IETF などで進行中の作業に直接つなげることが目的だ。
重点は、稼働中のコードと、各ワーキンググループが策定中の新しい仕様との間の隔たりを埋めることにある。Web Bot Auth、AIPREFs、OAuth、WIMSE、MOLE などのワーキンググループや活動が関わる。そのために私たちは、WBA や MOLE といったオープンなプロトコルの共同執筆と改善に参加する一方、それらの実装を大規模に構築して展開している。
同時に、Trusted Agent Delegation(TAD)連合の設立を発表する。TAD の目的は、エコシステムの各関係者の代表を集め、本稿で提示した問題群全体について議論し、既存のプロトコルを洗い出し、必要ならより明確に定義した問題を IETF に提起して解決を委ねることにある。今後は IETF 期間中のサイドミーティングやワークショップを開き、議論を促す予定だ。
Agent や Agent ランタイムを構築している人、エッジやクラウドプラットフォームを運営している人、あるいはビジネス系・コンプライアンス系のアプリケーションやインフラを担当している人にも、ぜひ参加してほしい。参加方法はこのページに詳しい。
今すぐできること
私たちが目指すのは、オープンで相互運用可能な基盤であり、TAD はその第一歩だ。だが、新しいプロトコルが登場するのを待つ必要はない。可視性と制御は今すぐ取り戻せる。今週から、Cloudflare の顧客は三つの具体的な措置を取れる。
どの Agent がサイトにアクセスし、何をしているのかを見る。Security Analytics は Personal Assistant を独立したトラフィック分類として扱うようになり、サイトにアクセスする Agent ごとに、送信したリクエスト数、アクセスしたパス、発生したエラーを一覧にするコンポーネントを追加した。説明のつかなかった自動化トラフィックが、分析できるトラフィックになる。AI クローラーやボットがビジネス全体に与える影響、たとえば Operator ごとにどれだけのコンテンツを取得し、どれだけのトラフィックを返しているかは、Enterprise 版 Bot Management の顧客なら Business Insights で確認できる。
Agent ごとにアクセス権を設定する。AI Crawler and Agent access policies を使えば、ビジネスにつながる Agent を通し、つながらない Agent を制限できる。ある Agent にサイト全体へのアクセスを許すことも、広告を含むページだけでブロックすることも、完全にブロックすることもできる。Search と Training のポリシーは独立したまま維持される。
Agent とその背後のユーザーを対応づけ、それに基づいて行動する。Account Abuse Protection(早期アクセス)を使うサイトでは、ログインと登録のたびに、リクエストが個人の Agent から来たものか、来たならどの Agent かを表示するようになった。攻撃者が共有 Agent をあるアカウントで悪用している場合、そのアカウントだけを対象に緩和できる。WAF ルールでその Hashed User ID に一致させればよく、その Agent を他の正常なユーザーごとまとめてブロックする必要はない。これが、先に述べた トラフィックの混在(Traffic commingling)という難題への最初の具体的な答えだ。Agent の向こう側にいるユーザーを見て、それに応じて対応できるようになる。
これらはこの構想の最初の構成要素であり、すでに本番環境で稼働している。標準が成熟するにつれて、続くものも出てくるだろう。
Agent に対してより厳格な立場を取っている企業があれば、ぜひ話を聞かせてほしい。直面している問題をそのまま伝えてほしい。私たちが目指すのは、サイト所有者が可視性と制御権の両方を持ち、その制御の範囲内で Agent が合理的な範囲で最大限のアクセスを得られるインターネットだ。カスタマーサポートチームに連絡するか、crawlercontrols@cloudflare.com までメールを送ってほしい。