AIっぽさをなくす
RL-XAR はメタ最適化された評価基準を通じて LLM 審判を専門家による人間の文章へ再び選好させ、論文段落、ピューリッツァー小説の続き、Wikipedia において標準訓練を大幅に上回る。
日本語
コピー
AI システムは強化学習によって、検証可能なさまざまなタスクで人間を超える水準に達した。だが検証できないタスクでは依然として弱い。たとえば生成される文章の品質は低く、いわゆる AI slop にとどまる。本稿ではこの問題に取り組む新しい学習手法 RL-XAR(Reinforcement Learning from eXpert-Aligned Rubrics)を提案する。 仕組みは次のとおりだ。
- (1)まず最高品質の人間の文章サンプルを集める。次に
- (2)評価基準を学習させた LLM 判定器によって、こうした専門家のテキストがモデル生成物より高いスコアを得るようにする。そして
- (3)学習済みの評価基準で RL を実行する。 このプロセスを、評価基準のメタ最適化がこれ以上識別可能な差を見つけられなくなるまで繰り返す。 科学論文の節の執筆、ピューリッツァー賞小説の続きの執筆、高品質な Wikipedia ページでこの手法を検証したところ、複数の指標で標準的な学習を大きく上回った。
背景
大規模言語モデルは事前学習の際、初心者向けフォーラムの投稿から専門家の文章まで、さまざまな人間の習熟度を含むコーパス上で次に来る最も確率の高い token を予測する。そのため最尤事前学習は、文脈の品質を 再現する 続きを生成する方向に傾き、それを超えることはない。凡庸な文章を与えられれば、モデルは同じ調子で続けるのが最も自然であり、目的関数のどこにも生成を 専門家 の品質へ押し上げる力はない。人間のフィードバックによる強化学習(RLHF)はモデルをより高い水準へ導けるが、その効果は最適化する報酬次第であり、優れた文章を確実に見分ける報酬を構築するのは難しい。非専門家のアノテーターによる順位付けで報酬モデルを訓練すれば、そのアノテーターの上限をそのまま引き継ぐ。つまり、最も関心のある品質——専門家による、あるいは人間を超える文章——こそ、こうした報酬が最も認定できない品質なのだ。したがって専門家級の生成を前進させる鍵は、大規模な専門家の監督なしに専門家の品質を識別できる報酬シグナルにある。
標準的な LLM 判定の失敗
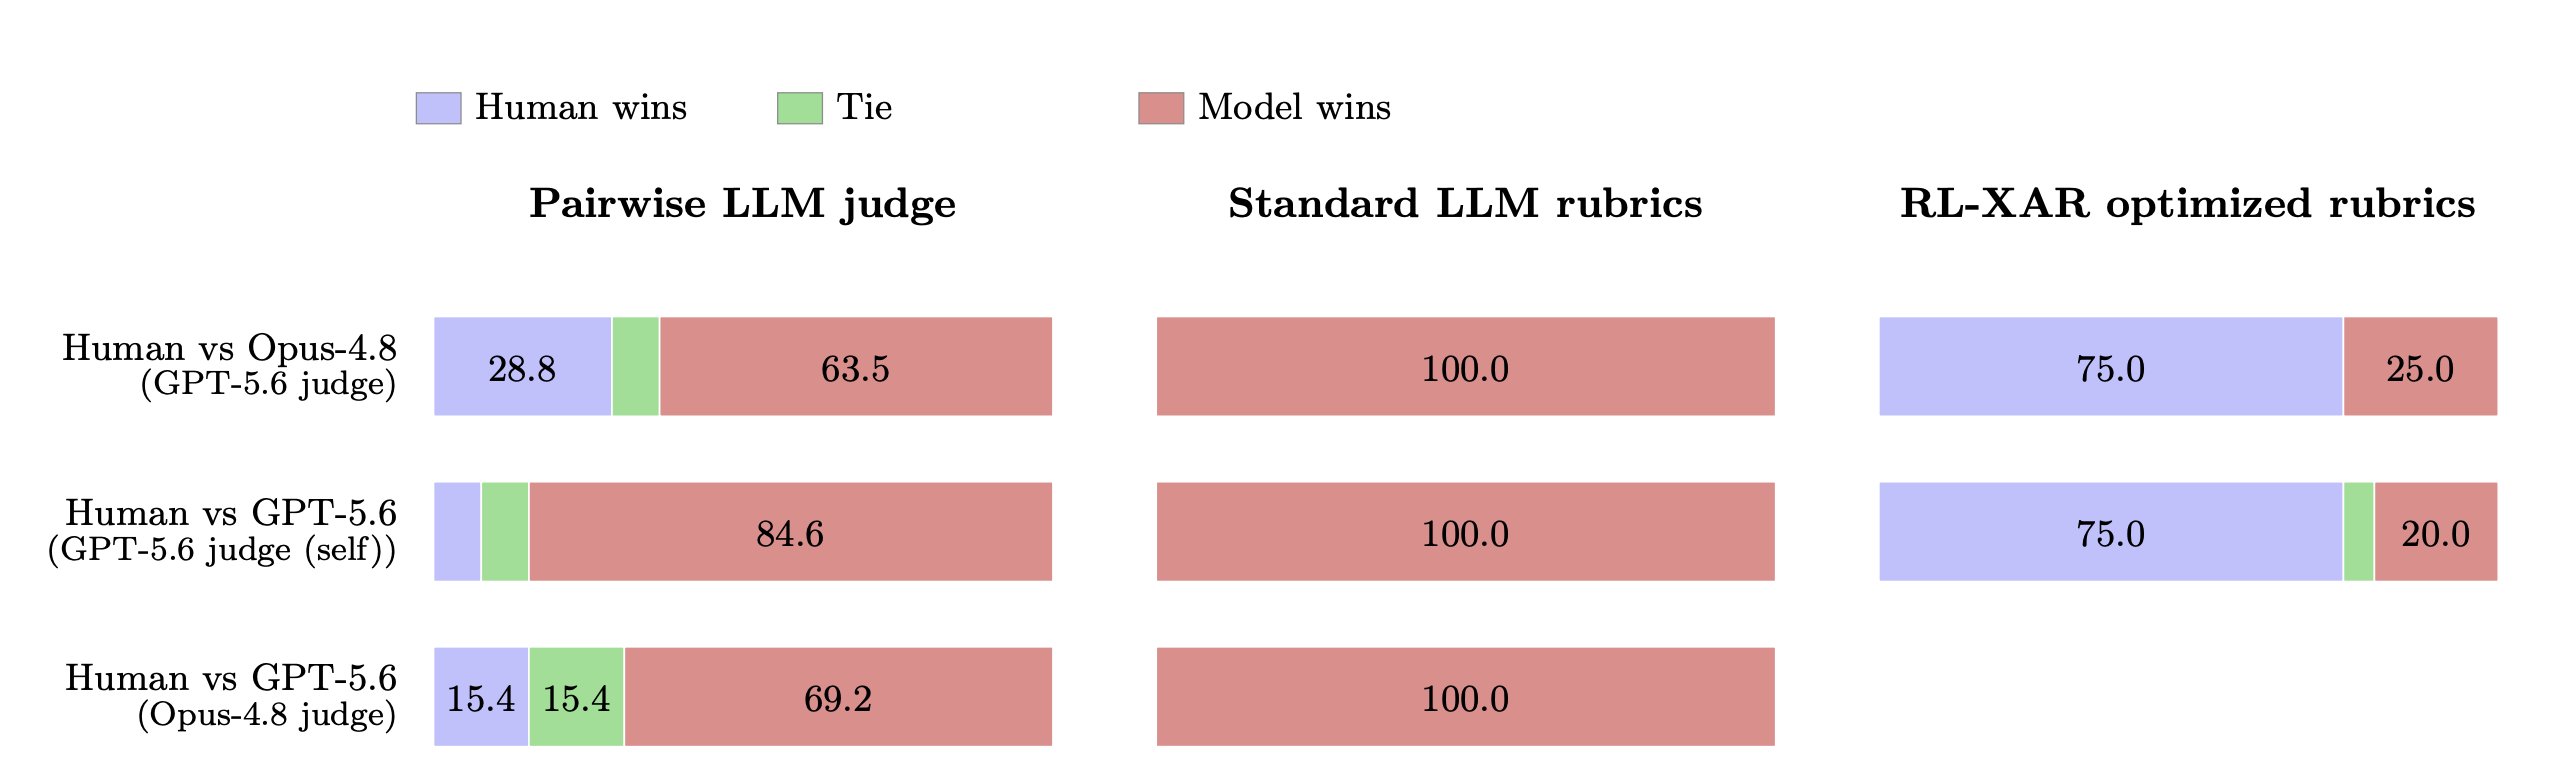
学習を成功させるには優れた採点が要る。 そこでまず、具体的なシナリオで報酬設計の問題を調べる。実際の学術論文のある節を書くという課題だ。 モデルには選んだ高品質な論文が渡されるが、そのうちの 1 節——たとえば要旨、導入、関連研究、結論——を 取り除いた 状態で渡され、欠けた節を論文の残りの部分に合うように、かつ元の節と同程度の長さで書かなければならない。取り除かれた人間の原文は、専門家が書いた自然な参照となり、この課題は公表済み文献から大規模に容易に収集できる。 言語モデルに文章の品質を判定させる標準的な方法を 2 つ検討する。候補を 2 つ与えてどちらが良いか尋ねる方法と、あらかじめ設計した評価基準で各候補を採点する方法だ。 優れた判定器なら、専門家である人間の文章をモデルの文章より上に置くはずだ。Opus-4.8 と GPT-5.6-sol を書き手および判定器として評価する(両者を交差比較する)。 わかったことは次のとおりだ。 直接的なペアワイズ判定器はモデルを好む。 よくあるプロトコルは、判定器に候補を 2 つ与えてどちらが良いか尋ねるもので、たとえば評価基準なしのプロンプト「どちらの版がより優れた節か? 段階的に推論し、その後決定せよ」を使う。位置バイアスを打ち消すため、各呼び出しは A/B の両順序で採点する。この判定器は多くの場合で モデル を専門家である人間より好み、その割合は書き手と判定器の設定に応じて 63.5%〜84.6% に達する。 標準的な評価基準でも差は表れない。 評価基準の構築には多くの方法があるが、GPT-5.6 にメタプロンプトを構築させ、ある節を欠いた論文が与えられたときにその節の判定専用の評価基準を生成させた。この評価基準に基づく判定に切り替えると、結果はさらに極端になり、モデルは 100% の場合でより高いスコアと評価された。
図:標準的な判定(左・中)はモデルを人間の専門家より上に置く。評価基準をメタ最適化して人間の専門家に揃えると、結果は反転する(右)。 LLM の採点器が AI スロップを人間より優れていると見なすなら、学習はスロップを増やすよう促すだけだ。 学術論文の節の執筆課題でわかったのは、標準的なペアワイズ LLM 判定や LLM が生成した評価基準が、GPT-5.6 や Opus-4.8 に高品質な人間の文章より高いスコアを付けることだ。我々の RL-XAR(eXpert Aligned Rubrics)手法は、高品質な人間が書いた節の訓練セットで評価基準をメタ最適化し、その結果得られる評価基準は結果を反転させ、テスト論文で人間の文章に高いスコアを付ける。
専門家に揃えた評価基準による強化学習(RL-XAR)
前節は、現在のシステムが人間の専門家の文章を判定する際に失敗することを示した。使っている LLM 採点器が AI スロップを人間より優れていると見なすなら、その採点器に合わせて学習すればスロップを増やすよう促すだけだ。人間の専門家の文章サンプルを大量に入手できる以上、当然こう問いたくなる。より優れた判定を学習すれば解決できるのではないか? 評価基準を学習する我々の手法は eXpert Aligned Rubrics(XAR)と呼び、やり方は単純だ。
- 平均を明らかに上回る/専門家級の人間の文章サンプルを見つけ、文脈と続きに分割する。
- 同じ文脈で複数のモデル続きを競合相手として生成する。これらはより劣って(つまりスロップとして)書かれていると想定する。
- 以上のデータが学習ペアを構成し、人間のほうが高いスコアを得るべきものとなる。この訓練データを使って評価基準の生成を学習し、人間とモデルのスコアの 差 を最大化する。 その後、この評価基準で強化学習を行いモデルをより上手く書けるように訓練する(RL-XAR)。以下の手順を反復する。
- XAR の評価基準を学習させ、上で述べた方法で人間と現在のモデルの差をできるだけ広げる。
- 学習した評価基準を使い、訓練セットで強化学習を行う。
- 評価基準の学習がもはや差を見つけられなくなるまで(つまり、モデルの出力から slop を識別できなくなるまで)ステップ 1 を繰り返す。
この発想は GAN と似ているところがある。
評価基準の学習:LLM は専門家の文章を識別できるか?
評価基準の学習にはさまざまな方法が考えられるが、我々の実験では次の単純なメタプロンプト最適化の手順を採用した。 出発点は一つの初期メタプロンプトで、これは例示的なコンテキストを与えられたとき、続きを評価するための評価基準を LLM に生成させるものだ。このメタプロンプトの質は、(小規模な)訓練セットにおける人間とモデルの差で測れる。
最適化は単純な改善ループを数ラウンド回す。各ラウンドでは、現在のメタプロンプト、それが訓練セットで達成した人間とモデルの差、そして判定を誤った具体例を最適化器 LLM に提示し、「表面的な痕跡ではなく、本当の文章品質を理由に」差を広げる修正案を出させる。メタプロンプトには長さの上限があるため、最適化器は新たな要求を積み増すのではなく、既存の基準を統合しなければならない。最適化が終わったら、各ラウンドの候補のうち最も成績の良かったものを残す。
予備的な実証研究
この方法が成立するかを確かめるため、前述の論文段落の執筆タスクで 7 ラウンドのメタプロンプト最適化を行った。使ったのは 52 個の(論文、段落)サンプルからなる小さなセットで、うち 8 本の論文を訓練に、5 本を検証に回した。評価基準の生成器、執筆モデル、そして最終的な評価基準ベースの判定器はいずれも Muse Spark 1.1 が担当し、メタ最適化器は Kimi-K2.6 が担当した。初期の評価基準の差は負、つまりモデルのほうが専門家の人間の文章より好まれるという結果だったが、メタ最適化を重ねるにつれて差は第 4 ラウンドで正に転じ、その後もわずかに上昇した。最適化は同時に、人間の文章の評価スコアを上げ(3.4 から 5.0)、モデルの文章のスコアを下げた(7.6 から 2.7)。 学習された評価基準は、ペアワイズ判定器と標準的な評価基準が抱えていた失敗を修復した。
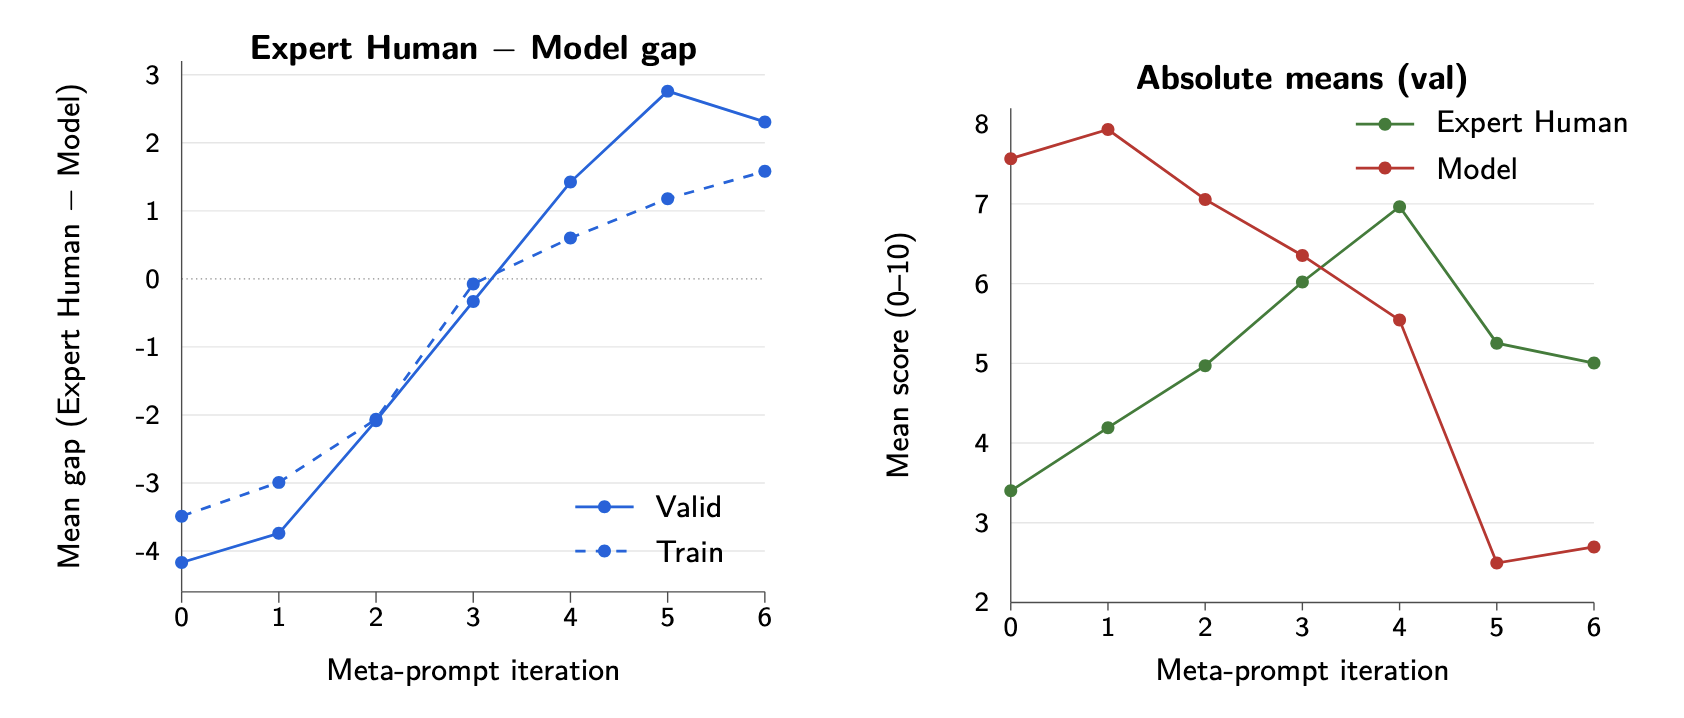
図:メタ評価基準の最適化。 左:train と valid の両分割における、専門家の人間とモデル(Muse Spark 1.1)の平均差の反復回数に対する変化。検証セットの差(実線)は -4.2 から +2.76 まで上昇し、第 4 反復でゼロを越え(つまり人間の平均がモデルより優れていると判定されるようになり)、第 5 反復でピークに達する。その推移は訓練セットの差(破線)とほぼ一致しており、モデルがホールドアウトした論文に汎化し、過学習していないことを示す。右:検証セットの絶対平均値——差は両端から同時に広がり、人間のスコアは上昇し(3.4 から 5.0)、モデルのスコアは下降する(7.6 から 2.7)。
学習された評価基準の分析
学習前の初期の評価基準は、論文の具体的な内容に注目しがちだった——特定の節が伝えるべき具体的な主張、手法、結果を名指しする——そのため、個々の論文に特化した網羅リストが延々と生成された。これには困った帰結がある。各節で「ミニ論文」を書くことが報われるのだ。そうした基準は、論文全体の材料をなぞって書き直す流暢な模倣を高く評価する一方、人間の原著がそうした細部を意図的に省いているという選択性を罰する。反復を重ねるうちに、最適化器は専門家の文章に誤って低い点を付ける指示を書き換えていく。人間の筋の通った省略を減点対象と見なす点、圧縮された要約を流暢さとして加点する点、表面的な磨きを力量と取り違える点を直していく。こうして学習された評価基準は、網羅の広さよりも、各節がそれぞれの役割を果たすこと(つまり論文全体の縮小版ではないこと)、規律ある取捨選択、簡潔さ、そしてその節の範囲に正確に関わる細部を評価するようになる。メタプロンプトには長さの上限があるため、これらの基準は最終的に、特定の論文に比較的依存しない安定した少数の指針へと収束し、要求を積み上げるのではなく、報いるものをより鋭く研ぐ方向に働く。
主要実験
論文の節の執筆
まず RL-XAR を科学論文の節の執筆に適用した。
タスク。 モデルにはある節が取り除かれた論文が与えられ、その節(要旨、導入、関連研究、結論のいずれか)を書かなければならない。この論文に最も適合し、各主張が論文の実際の内容に厳密に基づき、数字や結果や引用を捏造しないことが条件だ。 タスクのプロンプトには目標語数が示され、それは人間が書いたその節の長さに等しく、モデルはおよそ 以内に収めるよう求められる。
タスクデータ。 S2ORC コーパスから CS 論文を 561 本集め、各論文の 4 つの部分(要旨、導入、関連研究、結論)を順にホールドアウトして、2,243 個の(論文、節)訓練サンプルを構成した。各サンプルは論文の残りの部分をコンテキストとし、ホールドアウトした人間の節を専門家の参照とする。さらに重複のない 90 本の論文(360 サンプル)を検証用に確保した。
訓練。 Qwen3.5-27B に強化学習を行い、異なる系列の Qwen3.8-2.4T-A95B 判定モデルが学習された評価基準に沿って各生成を採点したものを報酬とした。評価基準のメタ最適化には Kimi-K2.6 を使用した。
RL-XAR ループ。 上述の方法に従い、外側の反復を 3 回実行した。(i) 現在のモデルに対して専門家と人間とモデルの差を最大化するよう評価基準をメタ最適化し、同時に (ii) それまでに集まった評価基準の集合に対してモデルを強化学習する。訓練は 2 回行い、前ラウンドのモデルが最初の 2 ラウンドの評価基準に対して依然として示す人間の文章との差に向けて失敗モードを再設定し、第 3 ラウンドの評価基準は再訓練による偏りを避けるためモデルの評価に用いる。
評価基準による評価。 単一の評価基準だけで訓練したモデルは、その基準を満たすことしか学ばない可能性がある。そこで、3 組すべてのメタ最適化評価基準で各ライターを評価し、正規化した人間スコアの最小値——つまり最も出来の悪い評価基準——で順位づけした。都合の良い基準だけを選ぶことはできない。評価には GPT-5.6 を評価基準の審査モデルとして使い、訓練時の審査モデルとは変えている。
RL-XAR は 27B モデルをこのリーダーボードの全ライターの首位に押し上げた。最強 checkpoint の最悪評価基準スコアは 9.60(人間=10)で、外部のフロンティアモデルをすべて上回る。これらの評価基準は依然として我々のモデルに有利に働く可能性があり(最初の 2 回のイテレーションで訓練している)、専門家の人間が書いた文章を完全に正確に測れてもいない。それでも性能向上は反映されていると考えている。
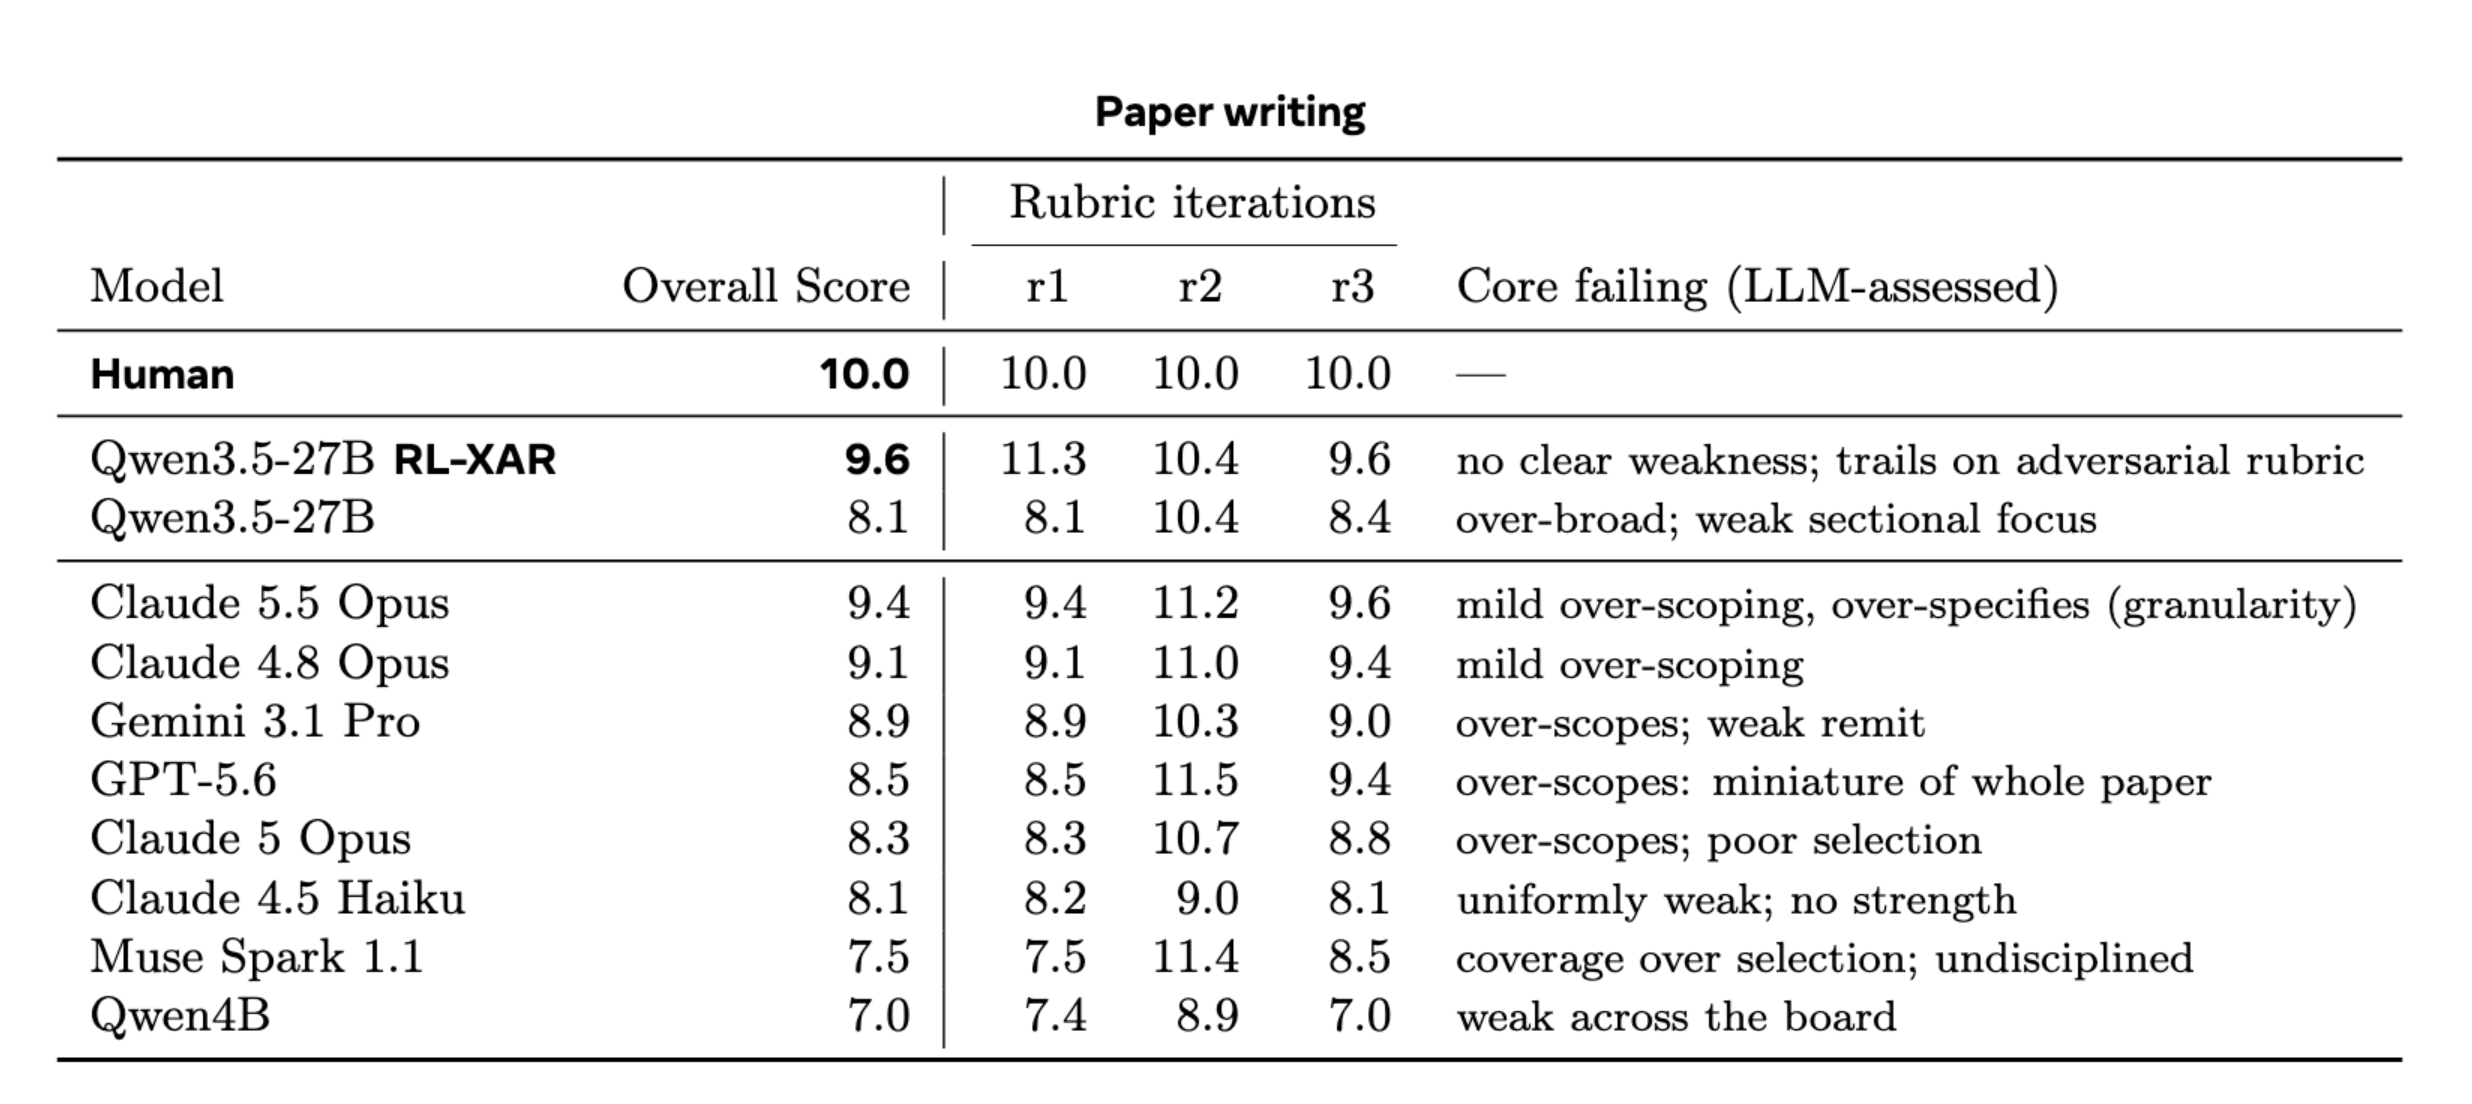
図:学術論文のセクション執筆におけるテスト性能。 総合スコアは、専門家が整合させた 3 ラウンドの評価基準を GPT-5.6 が審査したときの最小値で、人間のスコアで正規化している。これらの評価基準では、Qwen3.5-27B に対する RL-XAR 訓練は、直接のベースラインである Qwen3.5-27B や複数のフロンティアモデルを上回った。最後の列は Opus 4.8 による評価で、各モデルの評価基準スコアに基づく主要な失敗点を示す。
人間の専門家による評価 著者自身の論文を使って評価し、これらの自動指標の向上が実際に成り立つことを確認した——著者がこれらの論文の専門家であることは明らかだ。盲検の専門家による並列比較で、RL-XAR モデルとベースラインの Qwen3.5-27B を留出セクションで対戦させたところ、RL-XAR が書いた内容が 16 対 2 で好まれた(勝率 89%)。評価基準が測っている改善は、専門家の読者が実際により良いと考える文章に対応している。RL-XAR が勝った理由は、ベースラインがセクションの焦点を合わせるのが一般に苦手で、しばしば「ミニ論文」を書いてしまい、しかも不要な数値結果など余計な詳細を詰め込みすぎる点にあった。ただし、RL-XAR の生成が完璧だとも考えていない。より良い評価基準の最適化と審査モデルならさらに多くの欠陥を見つけられるはずで、それらは訓練の中で強化できる。つまり我々の手法で、ライターに Qwen3.5-27B、審査者に Qwen3.8-2.4T-A95B ではなくフロンティアモデルを使うということだ。
例を見る
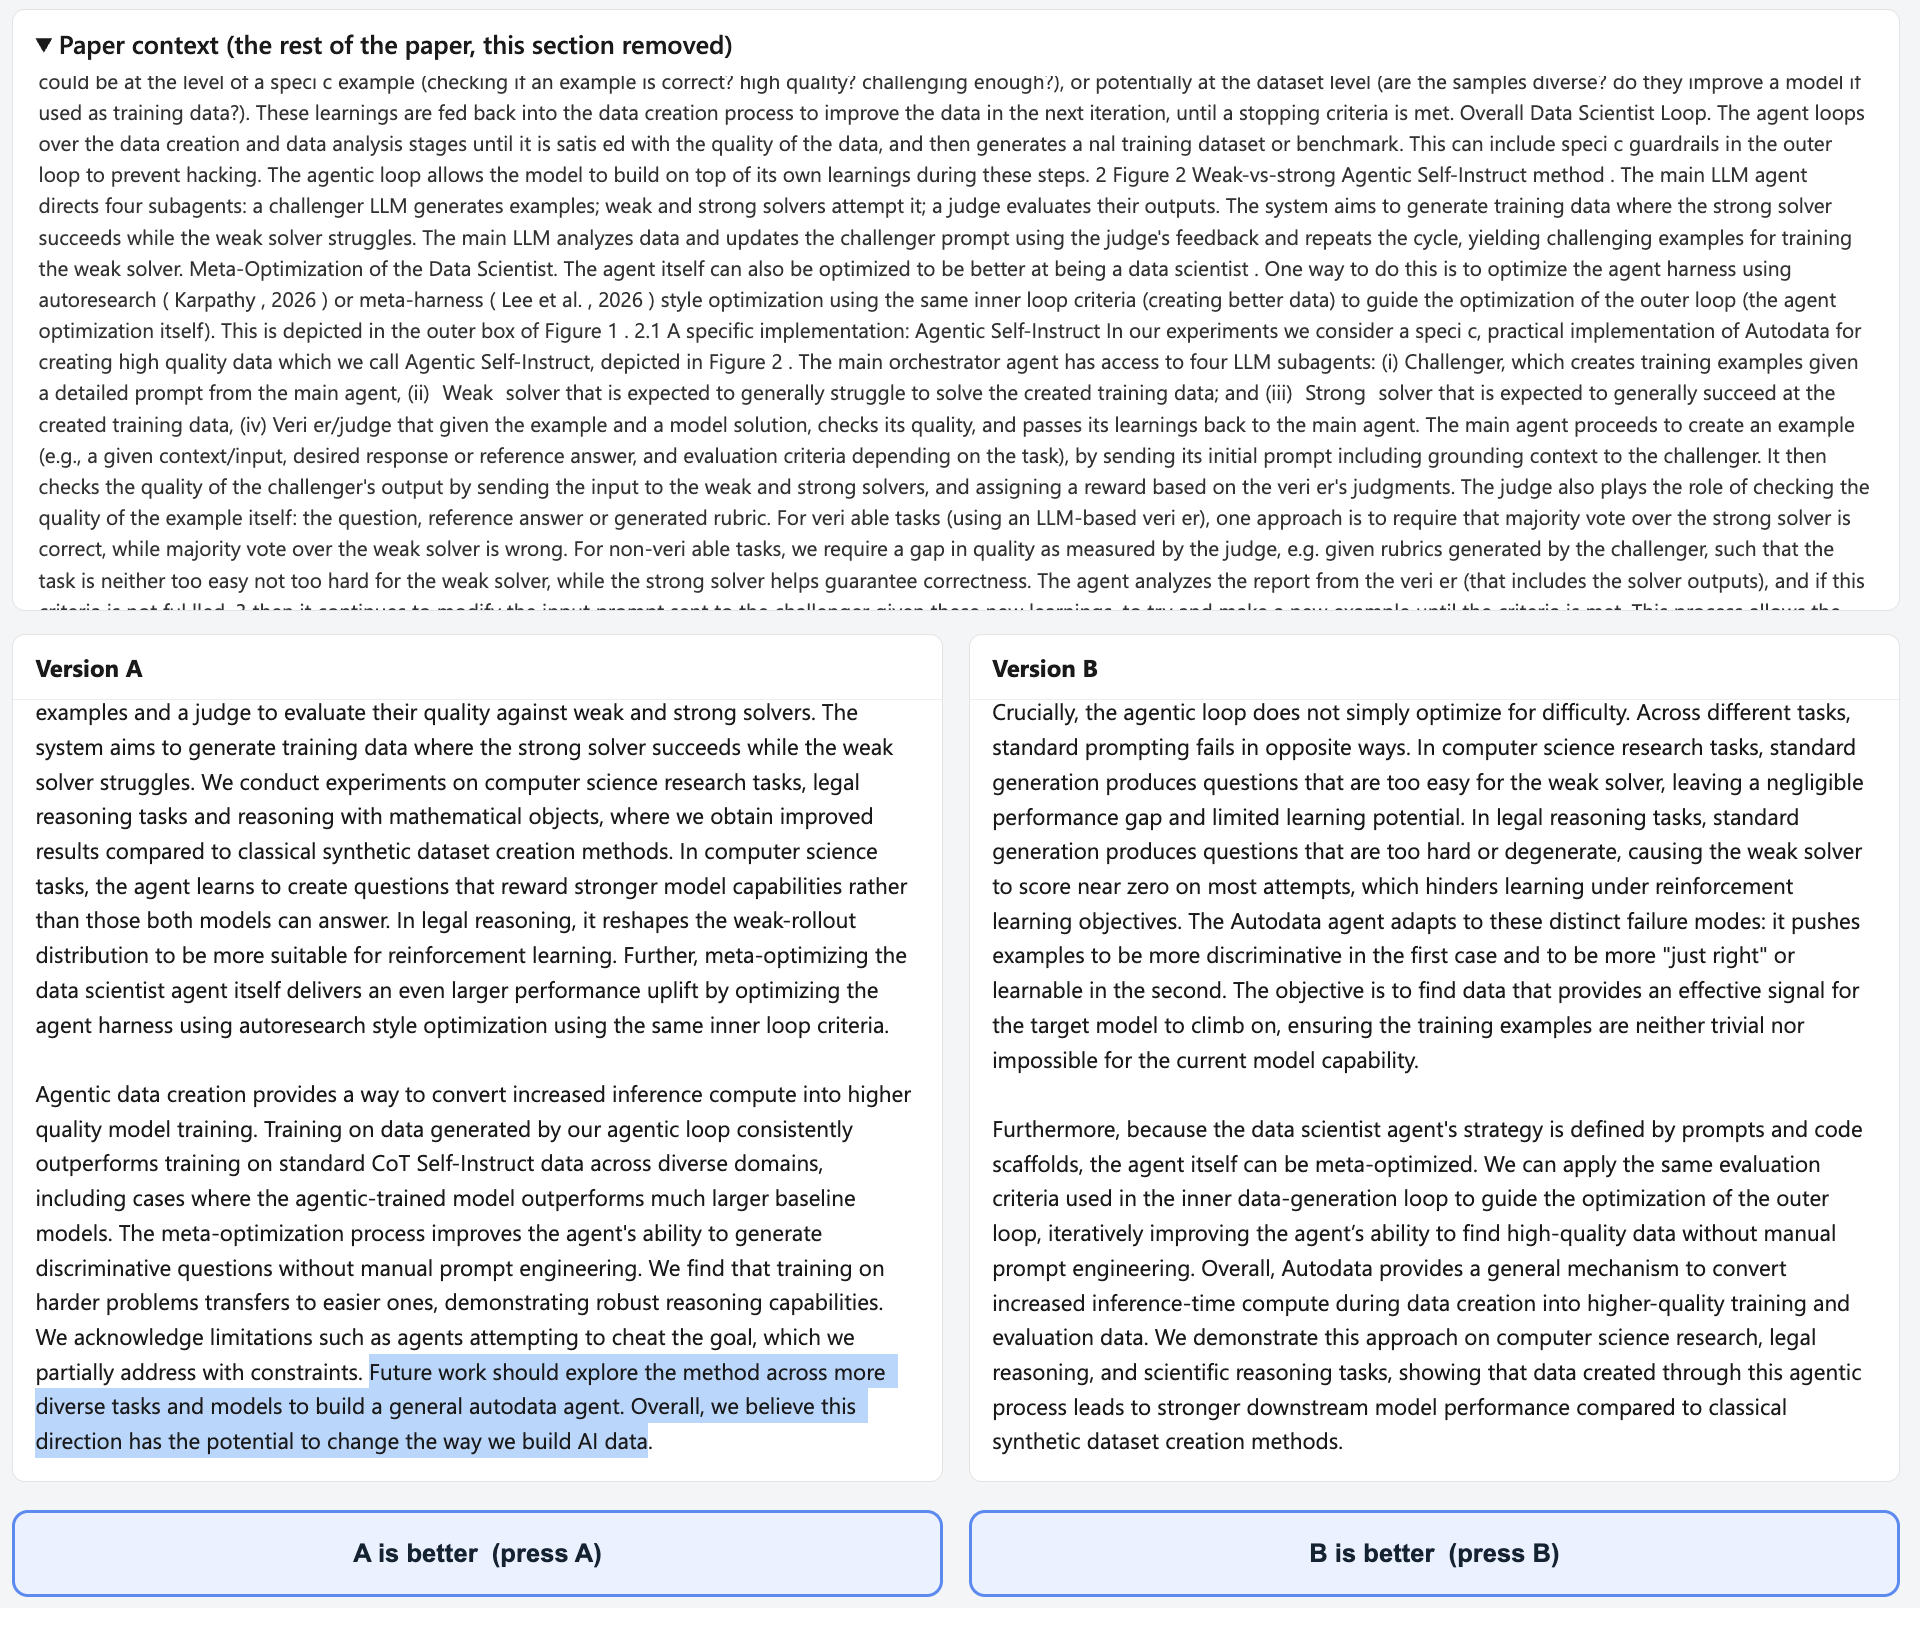
図:論文イントロダクション執筆の例(抜粋)。 ベースラインの Qwen3.5-27B(左)はイントロダクションで範囲が過大な「ミニ論文」を書きがちで、将来の課題まで含めてしまう。一方 RL-XAR(右)は範囲を適切に捉えている。
図:論文アブストラクト執筆の例。 ベースラインの Qwen3.5-27B(左)はアブストラクトに重要でない詳細を書きすぎる傾向がある。一方 RL-XAR(右)は範囲を適切に捉え、論文の残りの部分のスタイルに従っている。
ストーリー執筆
タスク。 モデルにはある場面の途中で途切れるまで物語が与えられ、途切れた箇所から正確に続きを書かなければならない——確立された語り口、散文のスタイル、視点、人物、場面、トーンに合わせること。要約したり、最初からやり直したり、見出しを付けたり、ジャンルを変えたりしてはならない。長さの目標(人間の続きの長さの 以内)が与えられる。
タスクデータ。 Project Gutenberg の中からパブリックドメインの書籍を選び、外部の人間による資格(例えばピューリッツァー賞やノーベル賞を受賞した著者)で品質をふるいにかけ、記憶を制限するため各著者のあまり読まれていない作品を優先した。さらに、温度 0 のプローブが参照テキストの 13-gram を 5% 超再現した場合、または 20 語以上の逐語的な連続断片が 1 段落でも存在する場合、そのサンプルはデータから除外した。訓練に 2,290 サンプル、検証に 310 サンプルを使った。各ペアは、文脈としての物語の前段と、専門家の参照としての著者本人による逐語的な続きからなる。評価基準のメタ最適化には別の 52 サンプルを使い、うち 20 を検証、60 を最終テストに残した。
訓練。 以前と同じレシピを踏襲した——Qwen3.5-27B に対する GRPO で、審査モデルは Qwen3.8-2.4T-A95B。今回は RL-XAR を 1 イテレーションだけ回した。使用した評価基準は meta-prompt が生成したもので、その meta-prompt は Kimi-K2.6 で最適化し、Muse Spark 1.1 の meta-prompt 評価基準生成器、ライター、審査モデルを備えている。
評価基準による評価。 同じ story 評価基準で評価したが、審査モデルを GPT-5.6 に替え、人間のスコアで正規化した値を報告する。 RL-XAR は Qwen3.5-27B を 2.8 から 8.2 に引き上げた——全ライターモデルの中で首位であり、あらゆるフロンティアモデルを上回る(次点は Claude 5 Opus の 6.8)。
人間による評価 これらの自動指標の向上は人間の評価でも確認した。盲検の並列比較で、RL-XAR モデルとベースラインの Qwen3.5-27B を留出したストーリー続きで同台させたところ、RL-XAR ライターが 19 対 1 で勝った(勝率 )。評価基準が測っている改善は、読者が実際により良いと考える文章に対応している。ベースラインは出来が悪く、物語のスタイルにうまく合わせられていなかった。顕著な特徴として、陳腐な表現や質の低い比喩にしばしば後退してしまう。例えば “the air hung over the table like a warm cloth” や “the wind rustled the leaves, sounding like a whisper of warning, or perhaps a laugh” などで、著者本人の作品には合っていない。
Wikipedia記事の執筆
タスク。 モデルには記事のタイトルと対象セクションの見出しのみが与えられ、本文は渡されない。ゼロからそのセクションを書き上げ、指定された目標長を満たさなければならない。他の2タスクと同様の設計である。
タスクデータ。 品質評価が Featured または Good の Wikipedia 記事を選び、ここでもマイナーなタイトルを優先し、前述と同じ記憶化処理を施した。訓練サンプル1,187件、検証サンプル162件を用意する。さらに、スコアリング基準のメタ最適化用に重複のない42件を使い、うち12件を検証、60件を最終テストに充てる。
訓練。 ストーリータスクとまったく同じレシピを使い、この設定向けにスコアリング基準を最適化した。
スコアリング基準の評価。 学習した Wikipedia スコアリング基準で結果を報告するが、判定モデルは独立した GPT-5.6 に差し替える。ここで RL-XAR は Qwen3.5-27B を2.7から4.0へ引き上げるにとどまった。伸びは小さく、モデルは人間の書き手やフロンティアの書き手には遠く及ばない(GPT-5.6 が7.9、Claude 5 Opus と Muse が7.2)。Wikipedia のセクション執筆は、この手法にとって3領域で最も難しい。一因は Qwen3.8-2.4T-A95B 判定モデルの能力不足で、次の節で分析する。
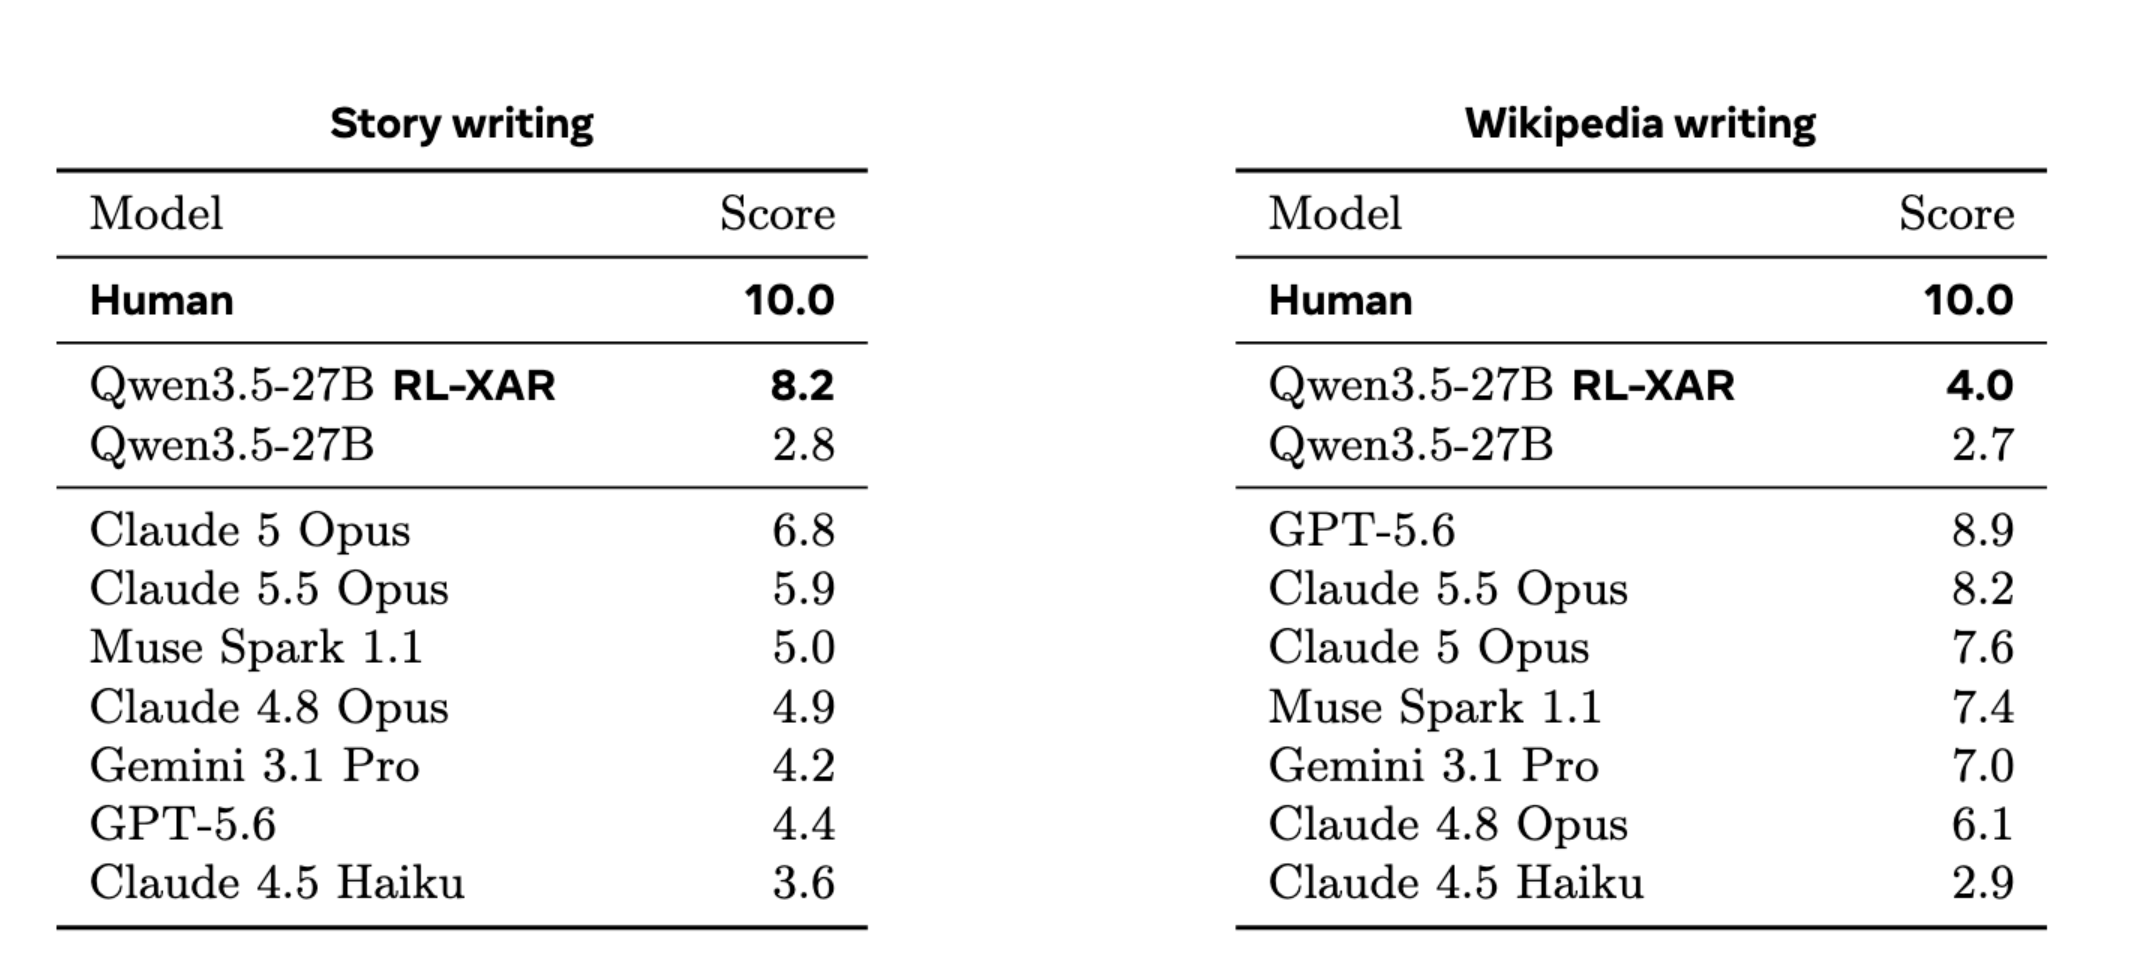
図:ストーリー続き(左)と Wikipedia セクション執筆(右)のテスト性能。 GPT-5.6 が判定し、人間で正規化したスコアリング基準スコアを報告する。どちらも RL-XAR の反復は1回のみで、ストーリー執筆(左)では報告スコアが大きく伸び、Wikipedia 執筆(右)では伸びは中程度だった。Wikipedia では、訓練に使ったモデルも Qwen3.8-2.4T-A95B 判定モデルも、評価者としては弱すぎてこれ以上の性能が出ないように見える。
分析・アブレーション・補足実験
判定モデルが重要。 ここまでの結果はスコアリング基準が重要だと示している。ここでは、そのスコアリング基準を評価する LLM 判定モデルの質も同じくらい重要だと示す。弱い判定モデルは、専門家の人間が書いた文章とモデルが書いた文章をそもそも区別できない。
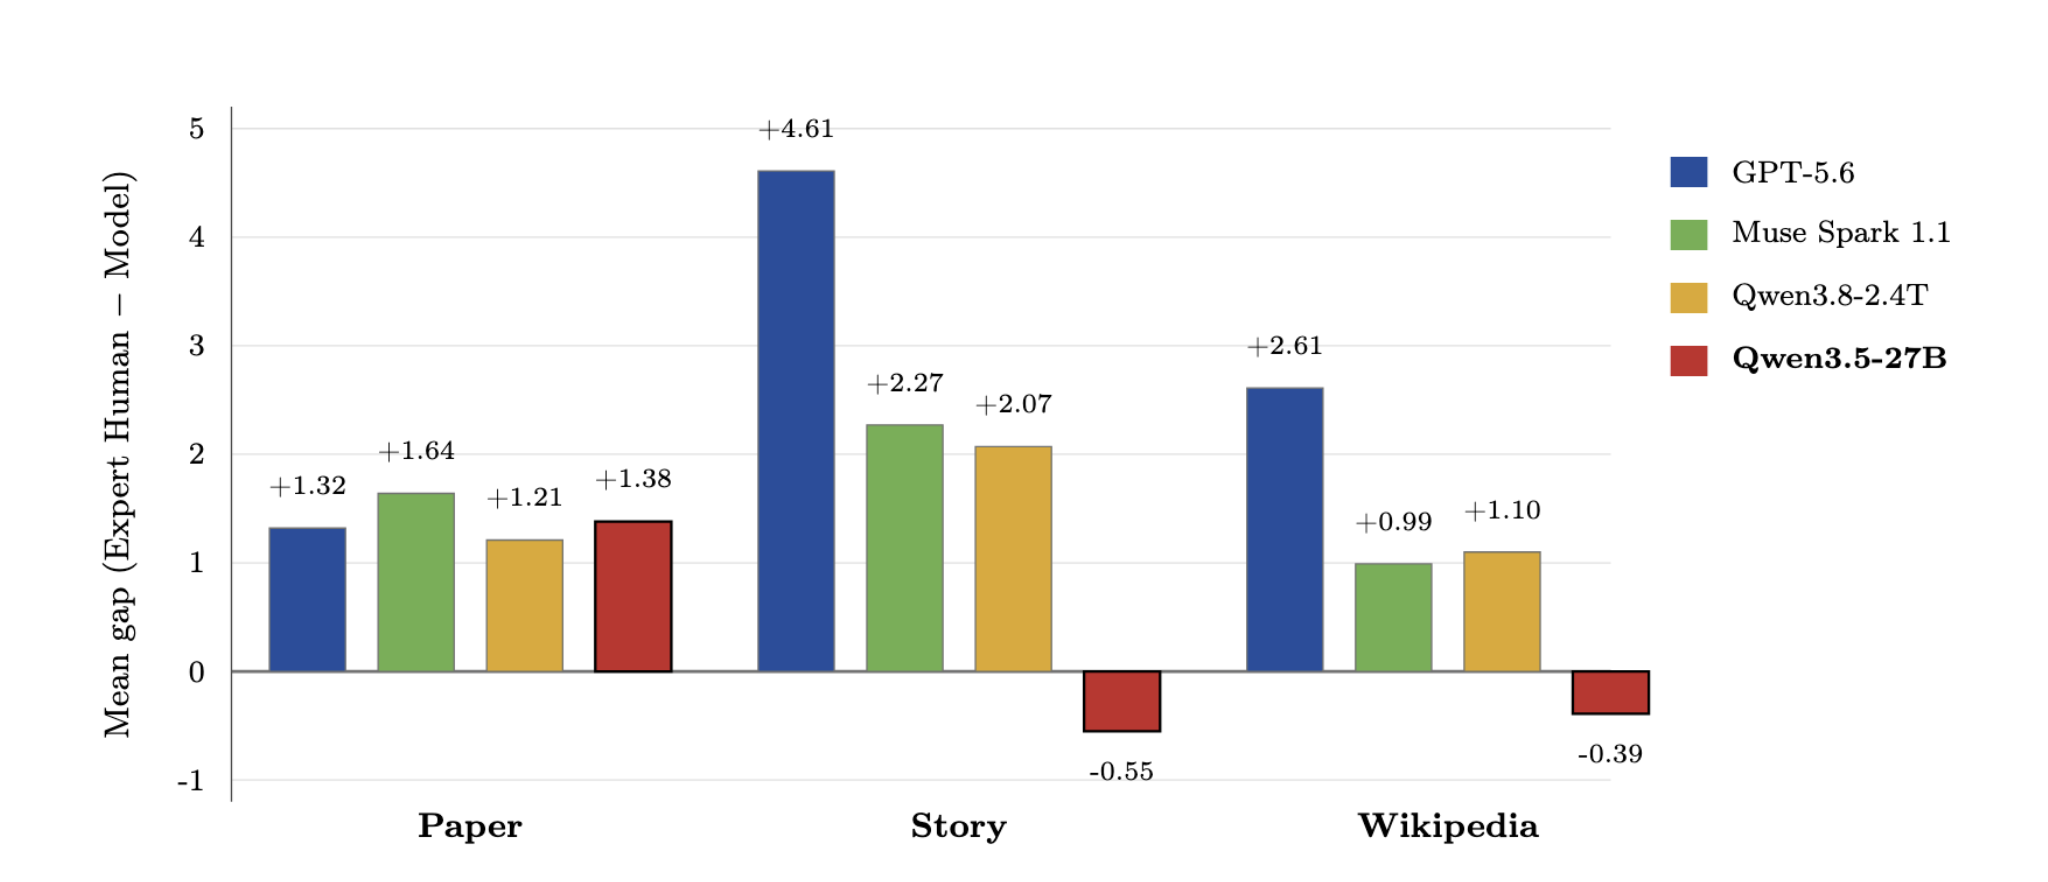
図:判定モデルの比較。XAR で最適化したスコアリング基準上での平均。 各判定モデルの人間–モデル平均ギャップ(書き手 = Muse Spark 1.1。正なら人間寄り)。判定モデルは能力の高い順に並べている。Story と Wikipedia では、Qwen3.5-27B(赤)だけが負の値を出し、モデルを人間の文章より上に順位づけた(story が -0.55、wiki が -0.39)。Paper では4つの判定モデルの結果が近く、いずれも人間寄りだった。弱い評価者にはこのギャップが見えない。
メタ最適化器が重要。 Muse Spark 1.1、Opus 5、Kimi K2.6 をスコアリング基準のメタ最適化器として比較し、それぞれ3つのランダムシードで平均し、Muse Spark 1.1 を論文セクションの書き手としたときの人間–モデル検証ギャップを報告する。Kimi と Opus は正のギャップを見つけられたが、Muse Spark 1.1 は苦戦した。より弱いモデルはさらに苦戦するだろう。 最後に、我々が使ったのは単純な反復精錬によるメタ最適化であり、他の手法はほかにも多くある。GEPA 最適化の一変種で予備実験も行ったが、報告した主要な結果を上回らなかった。こうした探索は今後の課題とする。
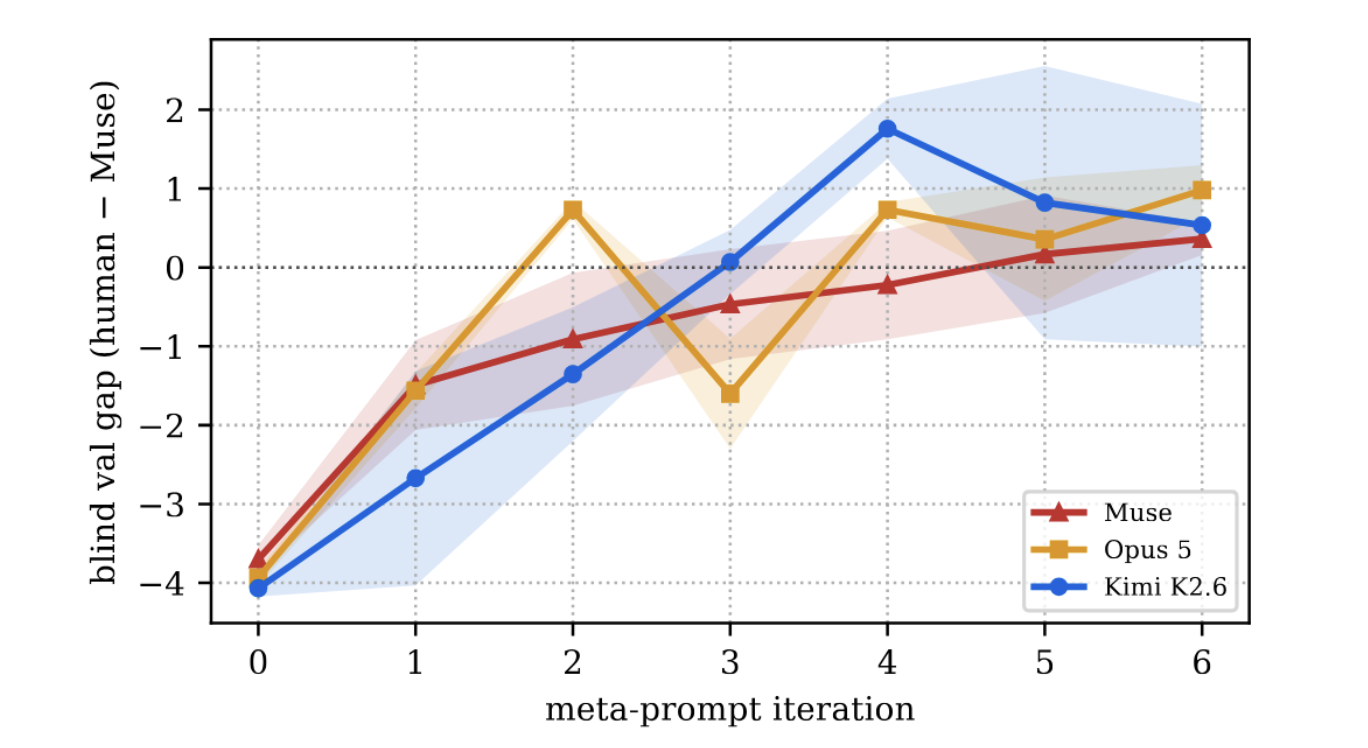
図:異なるスコアリング基準メタ最適化器。 各最適化器の平均(人間-モデル)ギャップ。3つのランダムシードで平均。
専門家の人間が重要。 スコアリング基準の最適化には、専門家の人間が書いたサンプルを使うことが重要だ。これは、人間の文章を低・中・高品質に評価した論文を使い、学習したスコアリング基準でそれらを評価することで検証した。人間と GPT-5.6 を比較すると、高品質の人間の書き手でギャップは +1.39、中品質で +0.95、低品質では +0.37 にとどまった。つまり、低品質の文章を強いモデルの書き手と戦わせても、有用なスコアリング基準や人間-モデルギャップはまず見つからない。また、学習したスコアリング基準が真の品質を測っているなら、より上手い人間の論文ほど人間-モデルギャップは大きく、弱い論文では小さくなるはずで、観察された結果はまさにこれに一致する。
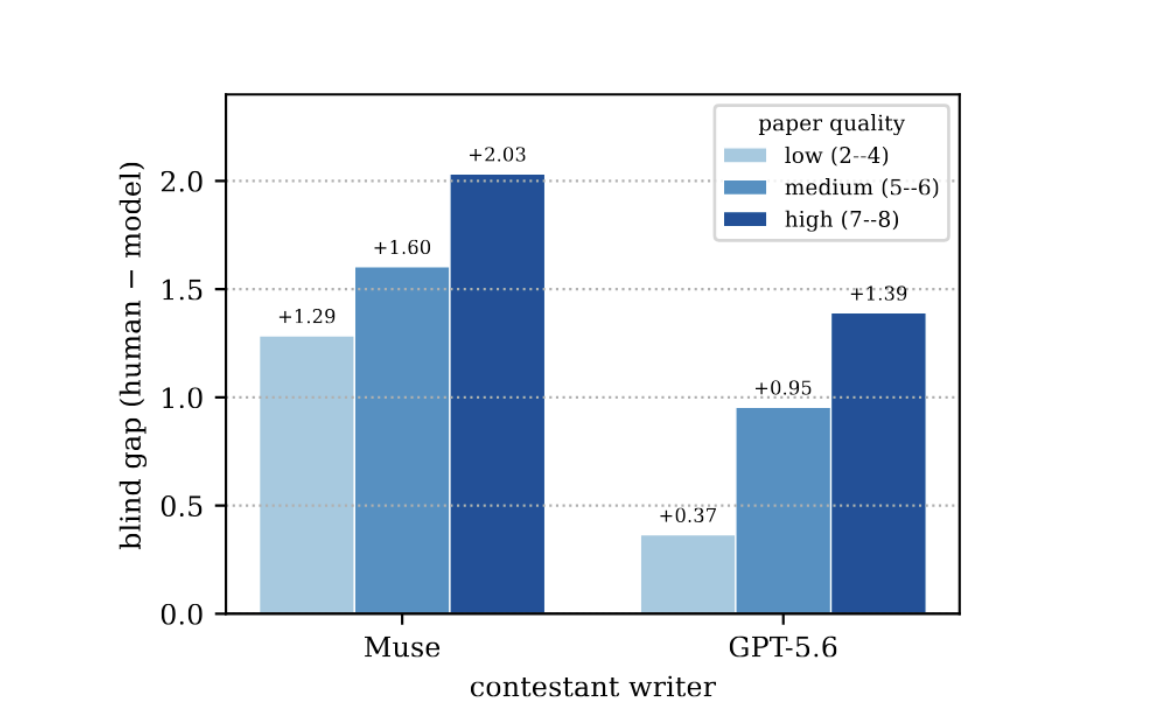
図:専門家の人間が重要。 論文の人間の執筆品質でビン分け(低/中/高、淡から濃へ)した人間-モデルギャップを、2つのモデル(Muse Spark 1.1 と GPT-5.6)と比較。学習したスコアリング基準が真の品質を測っているなら、より上手い人間の論文ほど人間-モデルギャップは大きく、弱い論文では縮まるはずで、観察された結果はまさにこれに一致する。
スコアリング基準は強い判定者間で汎化する。 2人の異なる判定者がどちらも十分に強ければ、一方の判定者向けにスコアリング基準を最適化しても、そのスコアリング基準はもう一方の判定者にも有効だと観察された。例として、以下に GPT-5.6 と Muse Spark 1.1 の判定者の場合を示す。
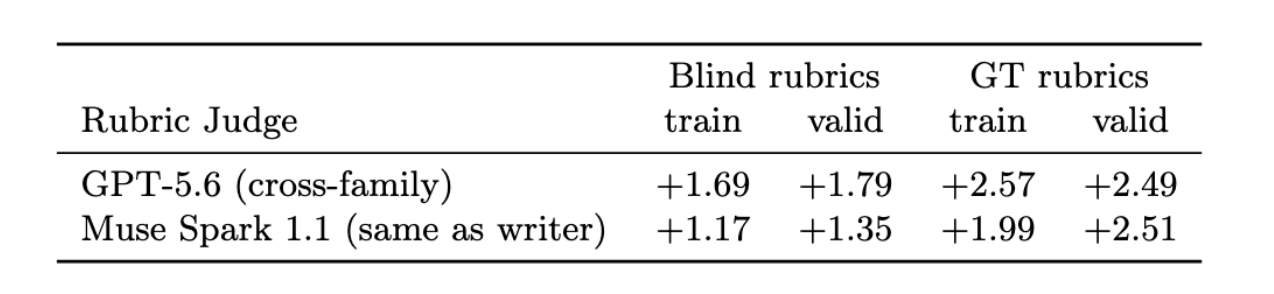
図:ルーブリックの評価者間での頑健性: 論文セクション執筆タスクにおける平均ギャップ(人間 − Muse Spark 1.1)を、異なる系統の GPT-5.6 評価者と Muse Spark 1.1 評価者で採点したもの。どの分割・変種でも、両評価者とも人間を選好する。Ground Truth(GT)ルーブリックは、メタプロンプトでルーブリックを生成する際に隠されたセクションを入力として与えて構築したもので、人間が書いた完成稿にスコアが偏る。そのため GT ルーブリックのスコアは全体に高くなる。
長さ制約とルーブリック
初期の実験で分かったのは、明示的な長さ制約を与えないと、標準的なモデルは論文セクションを書くときに長くしすぎる傾向があるということだった。隠された人間の原稿の2〜3倍に達することもある。こうなると、既存のルーブリックで高いスコアを取りやすくなる。他の指示追従の場面と同じ構図だ。そこで、人間の原稿と同程度の長さのセクションを書くよう求める、長さ制約付きのタスクに設計を変えた。強いモデルはこれをこなせるが、望ましくない副作用も見えた。長さの制約に大量の思考連鎖を費やすのだ(語数を数える、など)。
ルーブリックには反復が必要。
論文セクション執筆タスクでは、RL-XAR の学習の第1反復が3組のルーブリックで (11.0, 7.0, 8.4) という評価結果を出した。第1ラウンドのルーブリックは最適化されて高得点を取る一方、その代償として第2ラウンドのルーブリックは最適化されなかった。7.0 は Qwen3.5-27B の出発点である 10.4 を大きく下回る。第2ラウンドの学習で第2ラウンドのルーブリックの性能はベースラインモデル並みに戻り、同時に残り2組のルーブリックでも高得点を取った。
ルーブリックのオンライン学習。
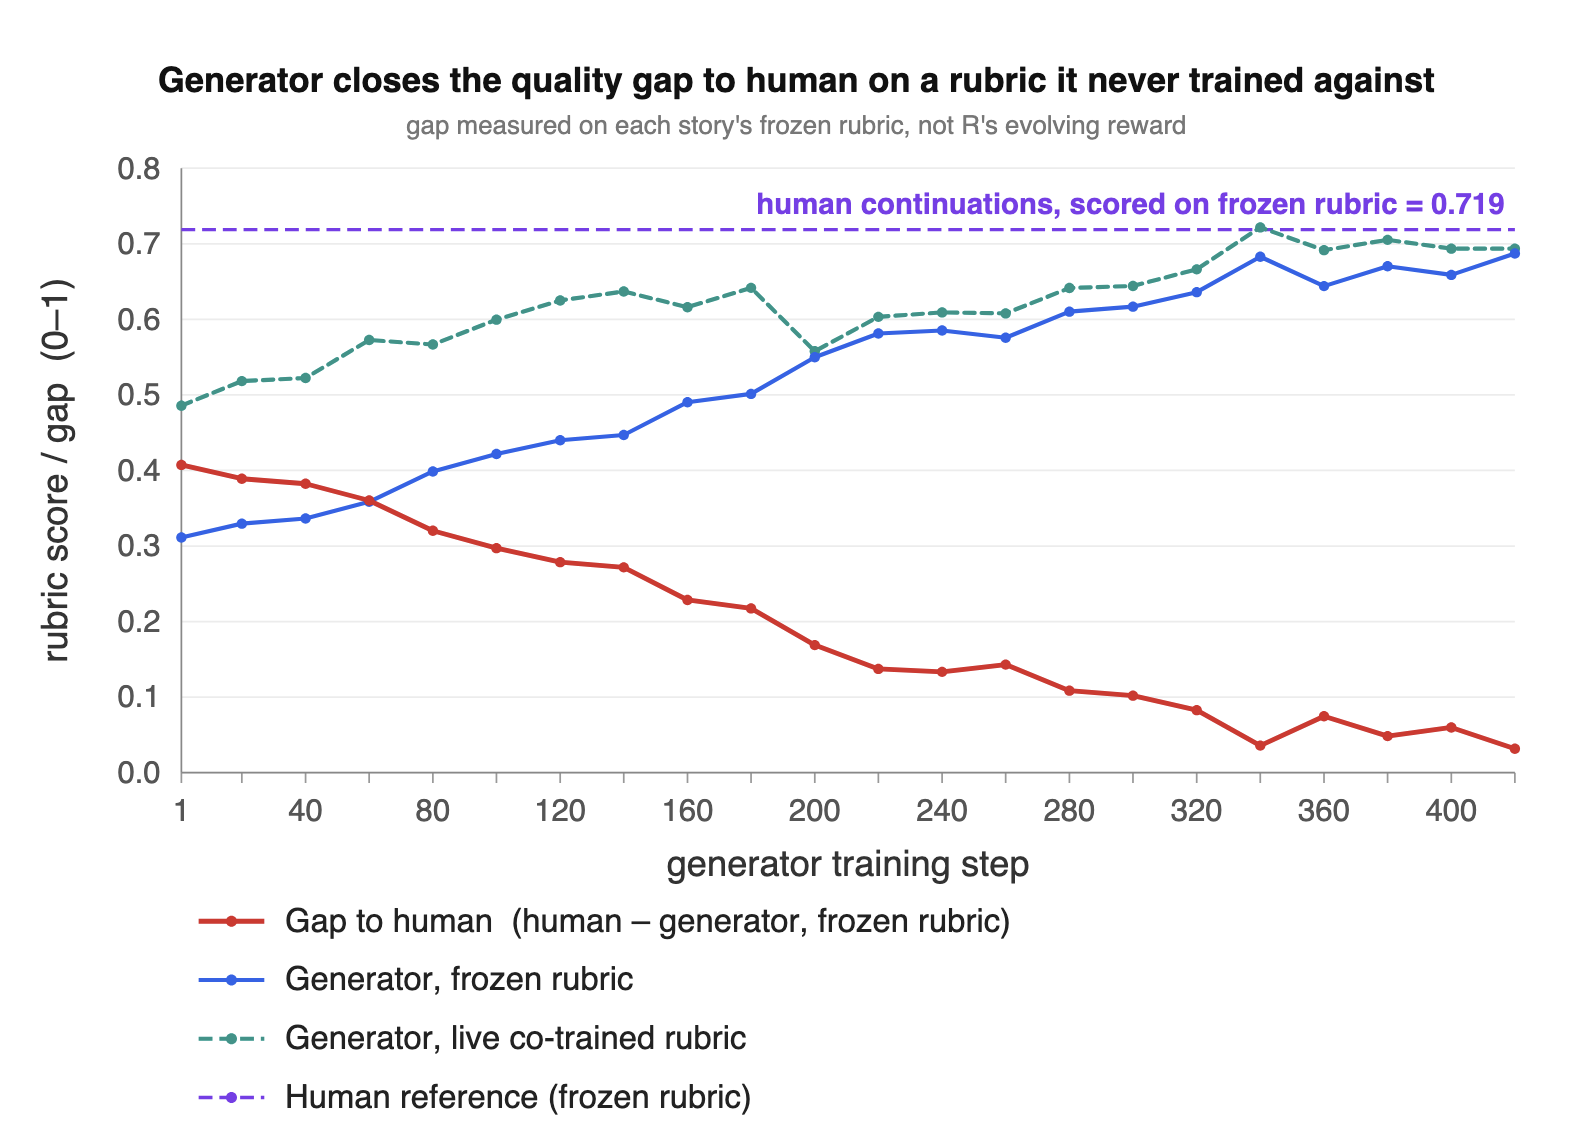
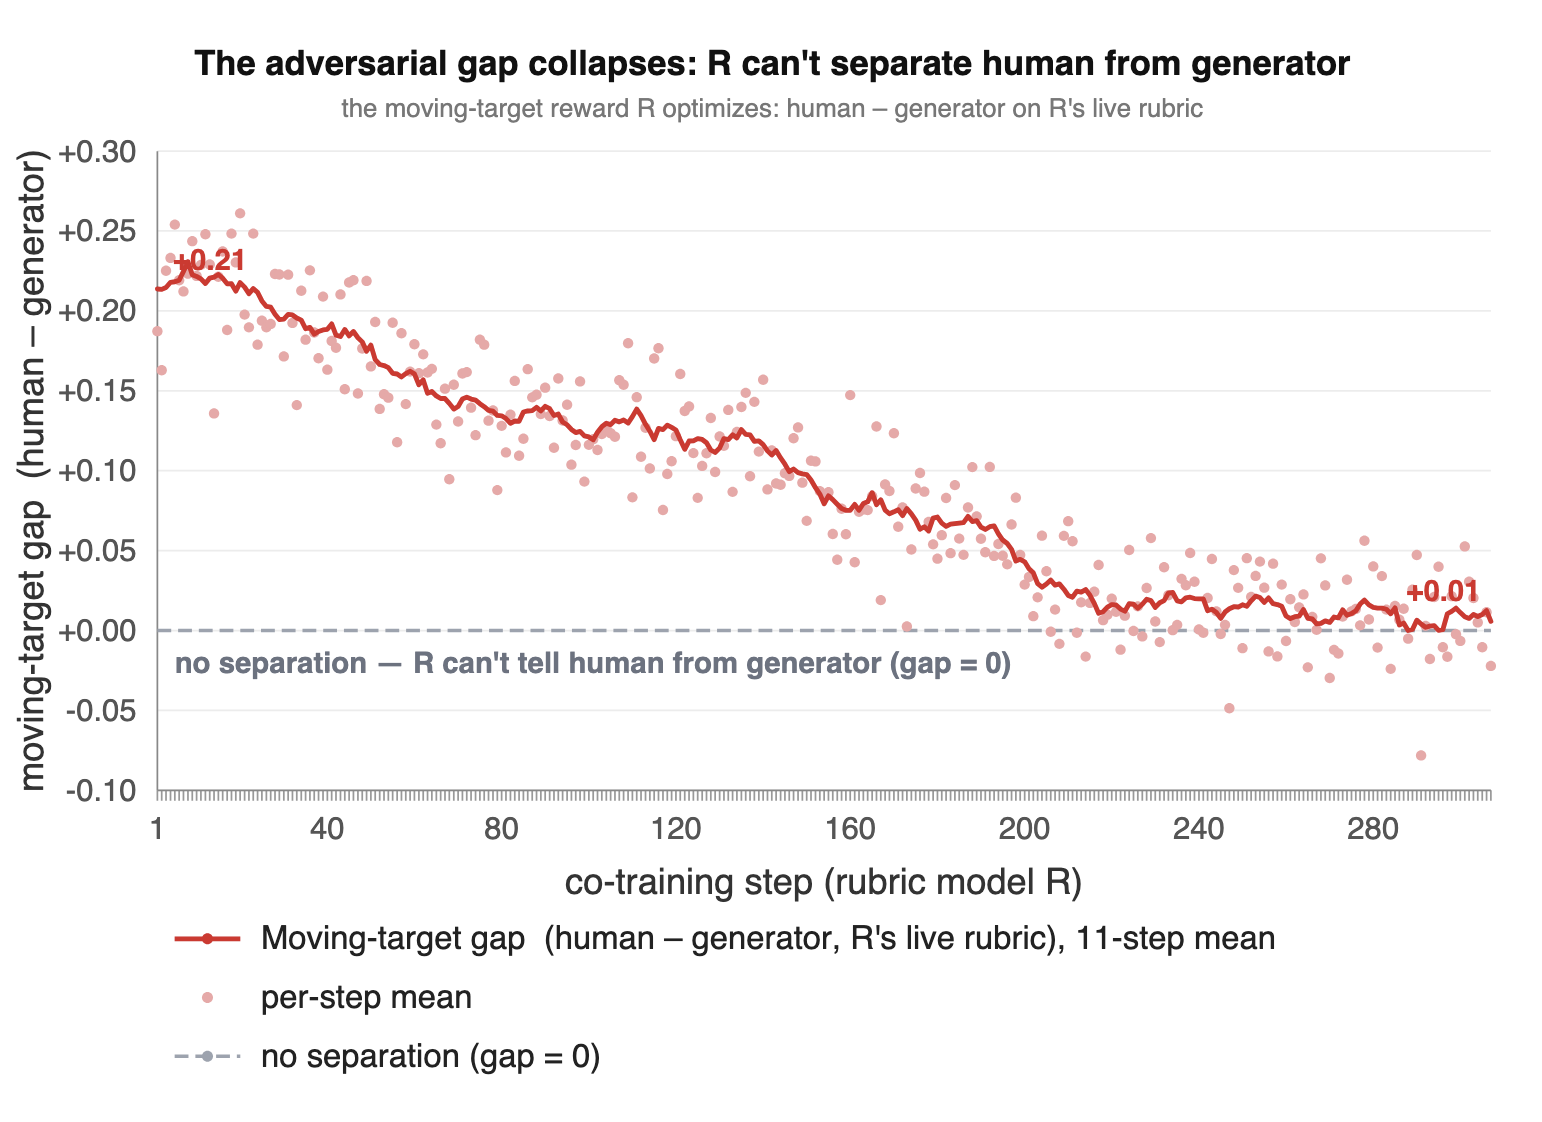
完全オンライン(協調学習)の目的関数も簡単に試した。書き手である生成器がルーブリックに対して最適化され、同時にルーブリック自体も GRPO で学習される(メタ最適化ではなく)。現在のポリシー下での人間—モデルギャップを最大化するのが狙いで、後者の報酬は正規化されたギャップから得る。続きの実験は今後に譲るが、ストーリータスクでのこの方向の初期結果は良好だった。以前の実験と同じ固定の(学習済み)ルーブリックでテストしたところ、スコアは 2.8(Qwen3.5-27B)から 6.0(オンライン RL-XAR)に上がった。
結論
私たちが提案するのは RL-XAR、すなわち Reinforcement Learning from eXpert-Aligned Rubrics だ。既存の専門家による人間の文章を、学習可能で専門家に整合した報酬へと変換し、それに基づいて最適化する手法である。鍵となるのはルーブリック生成器の最適化だ。専門家の人間テキストと現在のモデル生成とのギャップを最大化し、識別できるギャップがなくなるまで反復する。その後、生成されたルーブリックに対して標準的な RL で学習すれば、書き手の質が上がる。学術論文のセクション執筆、ピューリッツァー賞・ノーベル賞級の小説の続き、Wikipedia のセクション執筆という3領域で、RL-XAR はベースモデルを大きく上回った。AI が人間とよりよく意思疎通できるようになれば、すべての人が恩恵を受けるはずだ。
貢献者
Jason Weston、Ilia Kulikov、Swarnadeep Saha
詳細
完全な技術レポートを近く arXiv で公開する予定だ。
引用
完全な論文の公開前は、このブログを次のように引用できる:
@article{weston2026unslop,
 title = "Towards RL for Superhuman Text: Unslopping AI",
 author = {Weston, Jason and Kulikov, Ilia and Saha, Swarnadeep},
 year = "2026",
 month = "September",
 url = "https://facebookresearch.github.io/RAM/blogs/unslop/"
}
このサイトはオープンソースです。このページを改善する。