每个移动团队都该知道的 5 条 OTA 更新最佳实践
React Native 团队的 OTA 更新最佳实践:预览通道、指纹检测、expo-updates API、灰度发布与快速回滚。
中文
复制
每个移动开发者都经历过这样的时刻:生产环境出了 bug,修复已经写好,你盯着部署按钮,心里盘算着哪里还可能出问题。
OTA 更新改变了这个局面。它能把 JavaScript 和资源的改动直接推送到用户设备上,不用重新打包二进制、不用提交应用商店、不用等待。对 React Native 团队来说,这是手头最强大的工具之一。我们接触过的大多数团队都已经在顺利使用它:更新发出去,用户收到,应用照常运行。
但“能跑”和“我信得过”是两回事。那些一天发布多次却毫无压力的团队并没有什么魔法,他们只是围绕几个关键模式养成了习惯。他们知道如何在更新进入生产环境之前先测试它,知道哪些改动可以安全地走 OTA、哪些必须重新构建,知道在意外发生时如何控制影响范围,以及如何在几分钟内而不是几小时内完成回滚。
本文分享其中五个模式。不是理论建议,而是真实的工作流——让团队每天发布却不搞坏生产环境。
快速入门:OTA 更新是怎么工作的
如果你已经熟悉 Expo Update,可以跳过这一节。
Expo Update 让应用的 JavaScript bundle 和资源独立于原生代码进行更新。应用启动时会向服务器检查是否有新更新。如果有,它会在后台下载,并在下一次冷启动时应用。
更新通过 channels(构建指向的目标)和 runtime versions(确保 JavaScript 与原生二进制兼容)来组织。在 Expo Update 中,channel 在底层对应 branch,但你基本可以忽略 branch,直接使用 channel。
如果你需要让用户立刻看到修复,expo-updates 包可以让你按需检查和应用更新。
TL;DR:OTA 更新检查清单
如果你只是快速浏览,以下是重点:
✓ 使用 preview 和 production 两个 channel;发布到生产环境之前,务必先在 preview 构建上测试 ✓ 用 fingerprint 检测原生改动,判断何时需要更新应用版本 ✓ 分清哪些改动需要重新构建,哪些可以通过 OTA 更新 ✓ 用 expo-updates API 检测、下载并应用更新——让用户不必等到下次冷启动就能拿到修复 ✓ 使用灰度发布,并清楚如何回滚
下面逐条展开。
1. 先预览测试,再发布到生产环境
最简单的流程:预览 → 生产
多数团队都是从这里起步的,效果也不错。真正重要的只有两条通道:
-
Preview:供内部测试使用(通常指向 staging API、TestFlight/内部测试轨道)
-
Production:用户实际拿到的版本
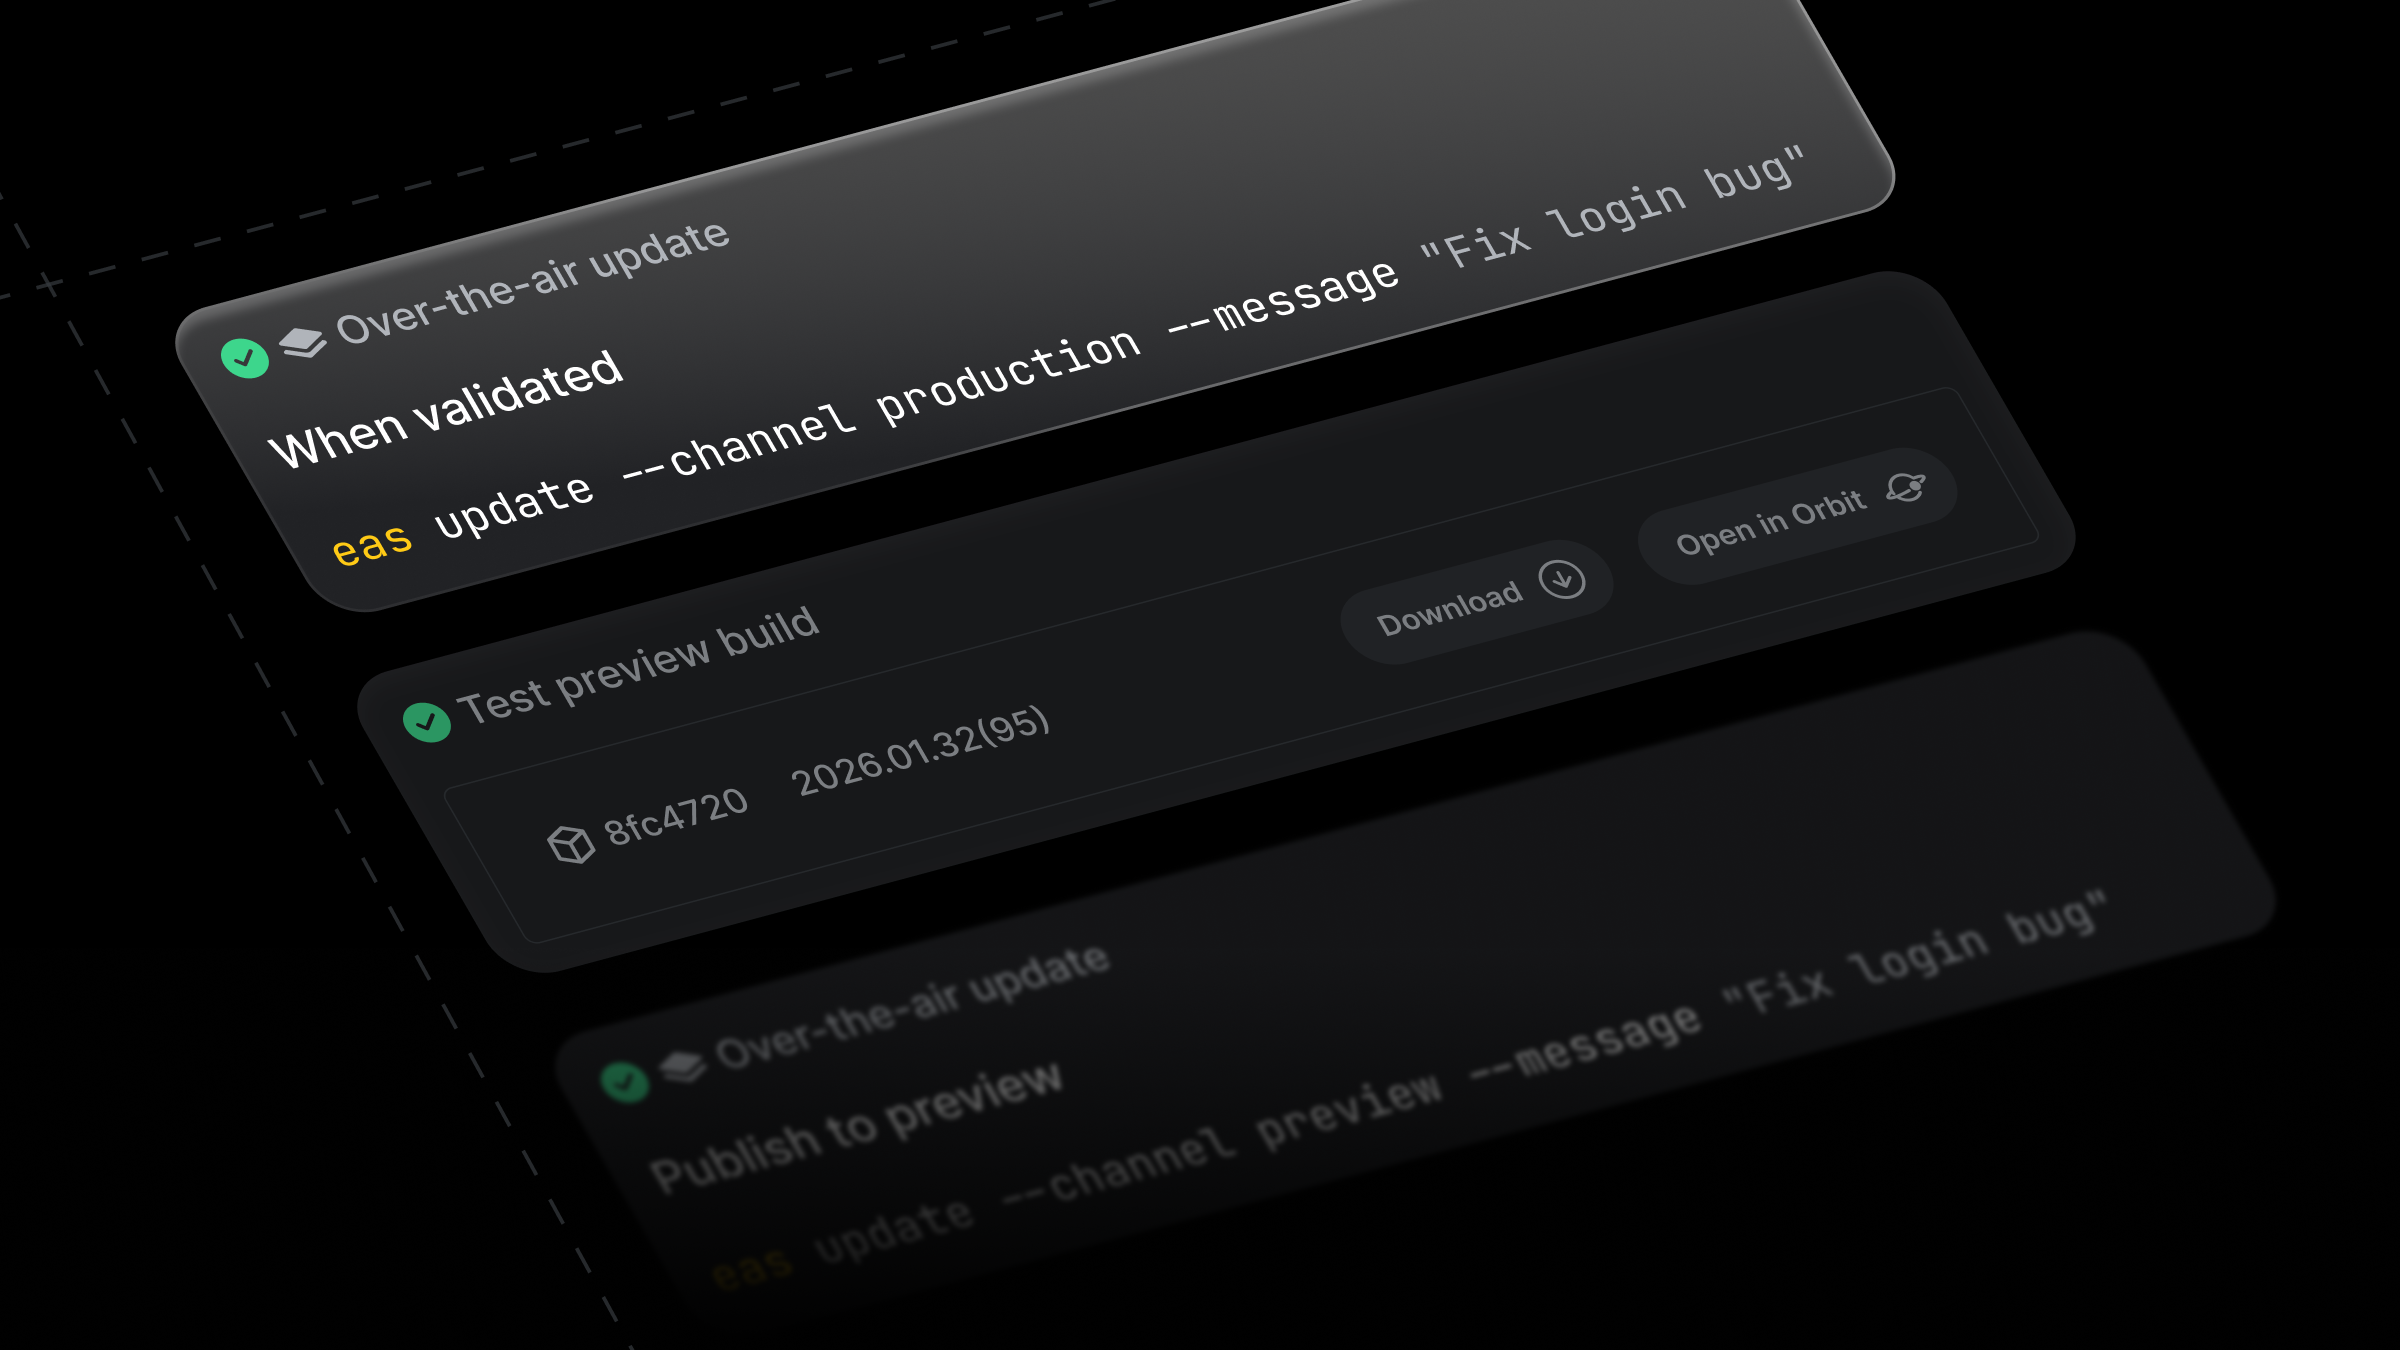
工作流很直接:
# Step 1: Publish to preview
eas update --channel preview --message "Fix login bug"

# Step 2: Test on a preview build (internal distribution or TestFlight)

# Step 3: When validated, publish to production
eas update --channel production --message "Fix login bug"
这样会把一个新的 bundle 发布到生产环境,而不是把测试通过的那个产物原样提升上去。这没什么问题——发布的是同一个 commit,出现实质性偏差的风险很低。会影响生产环境的大多数问题(环境变量、打包器的怪癖、资源文件问题)在预览测试阶段就会暴露出来。
为什么这在实践中重要
-
问题在触达用户之前就被拦下
-
预览构建可以指向 staging API,不影响生产环境
-
足够简单,能变成习惯
更进一步:staging 提升流程
有些团队想要多一层保证:用户拿到的必须是 QA 批准过的那个产物。“同一份代码”并不总是“同一个构建产物”,打包是另一个可能产生偏差的环节。
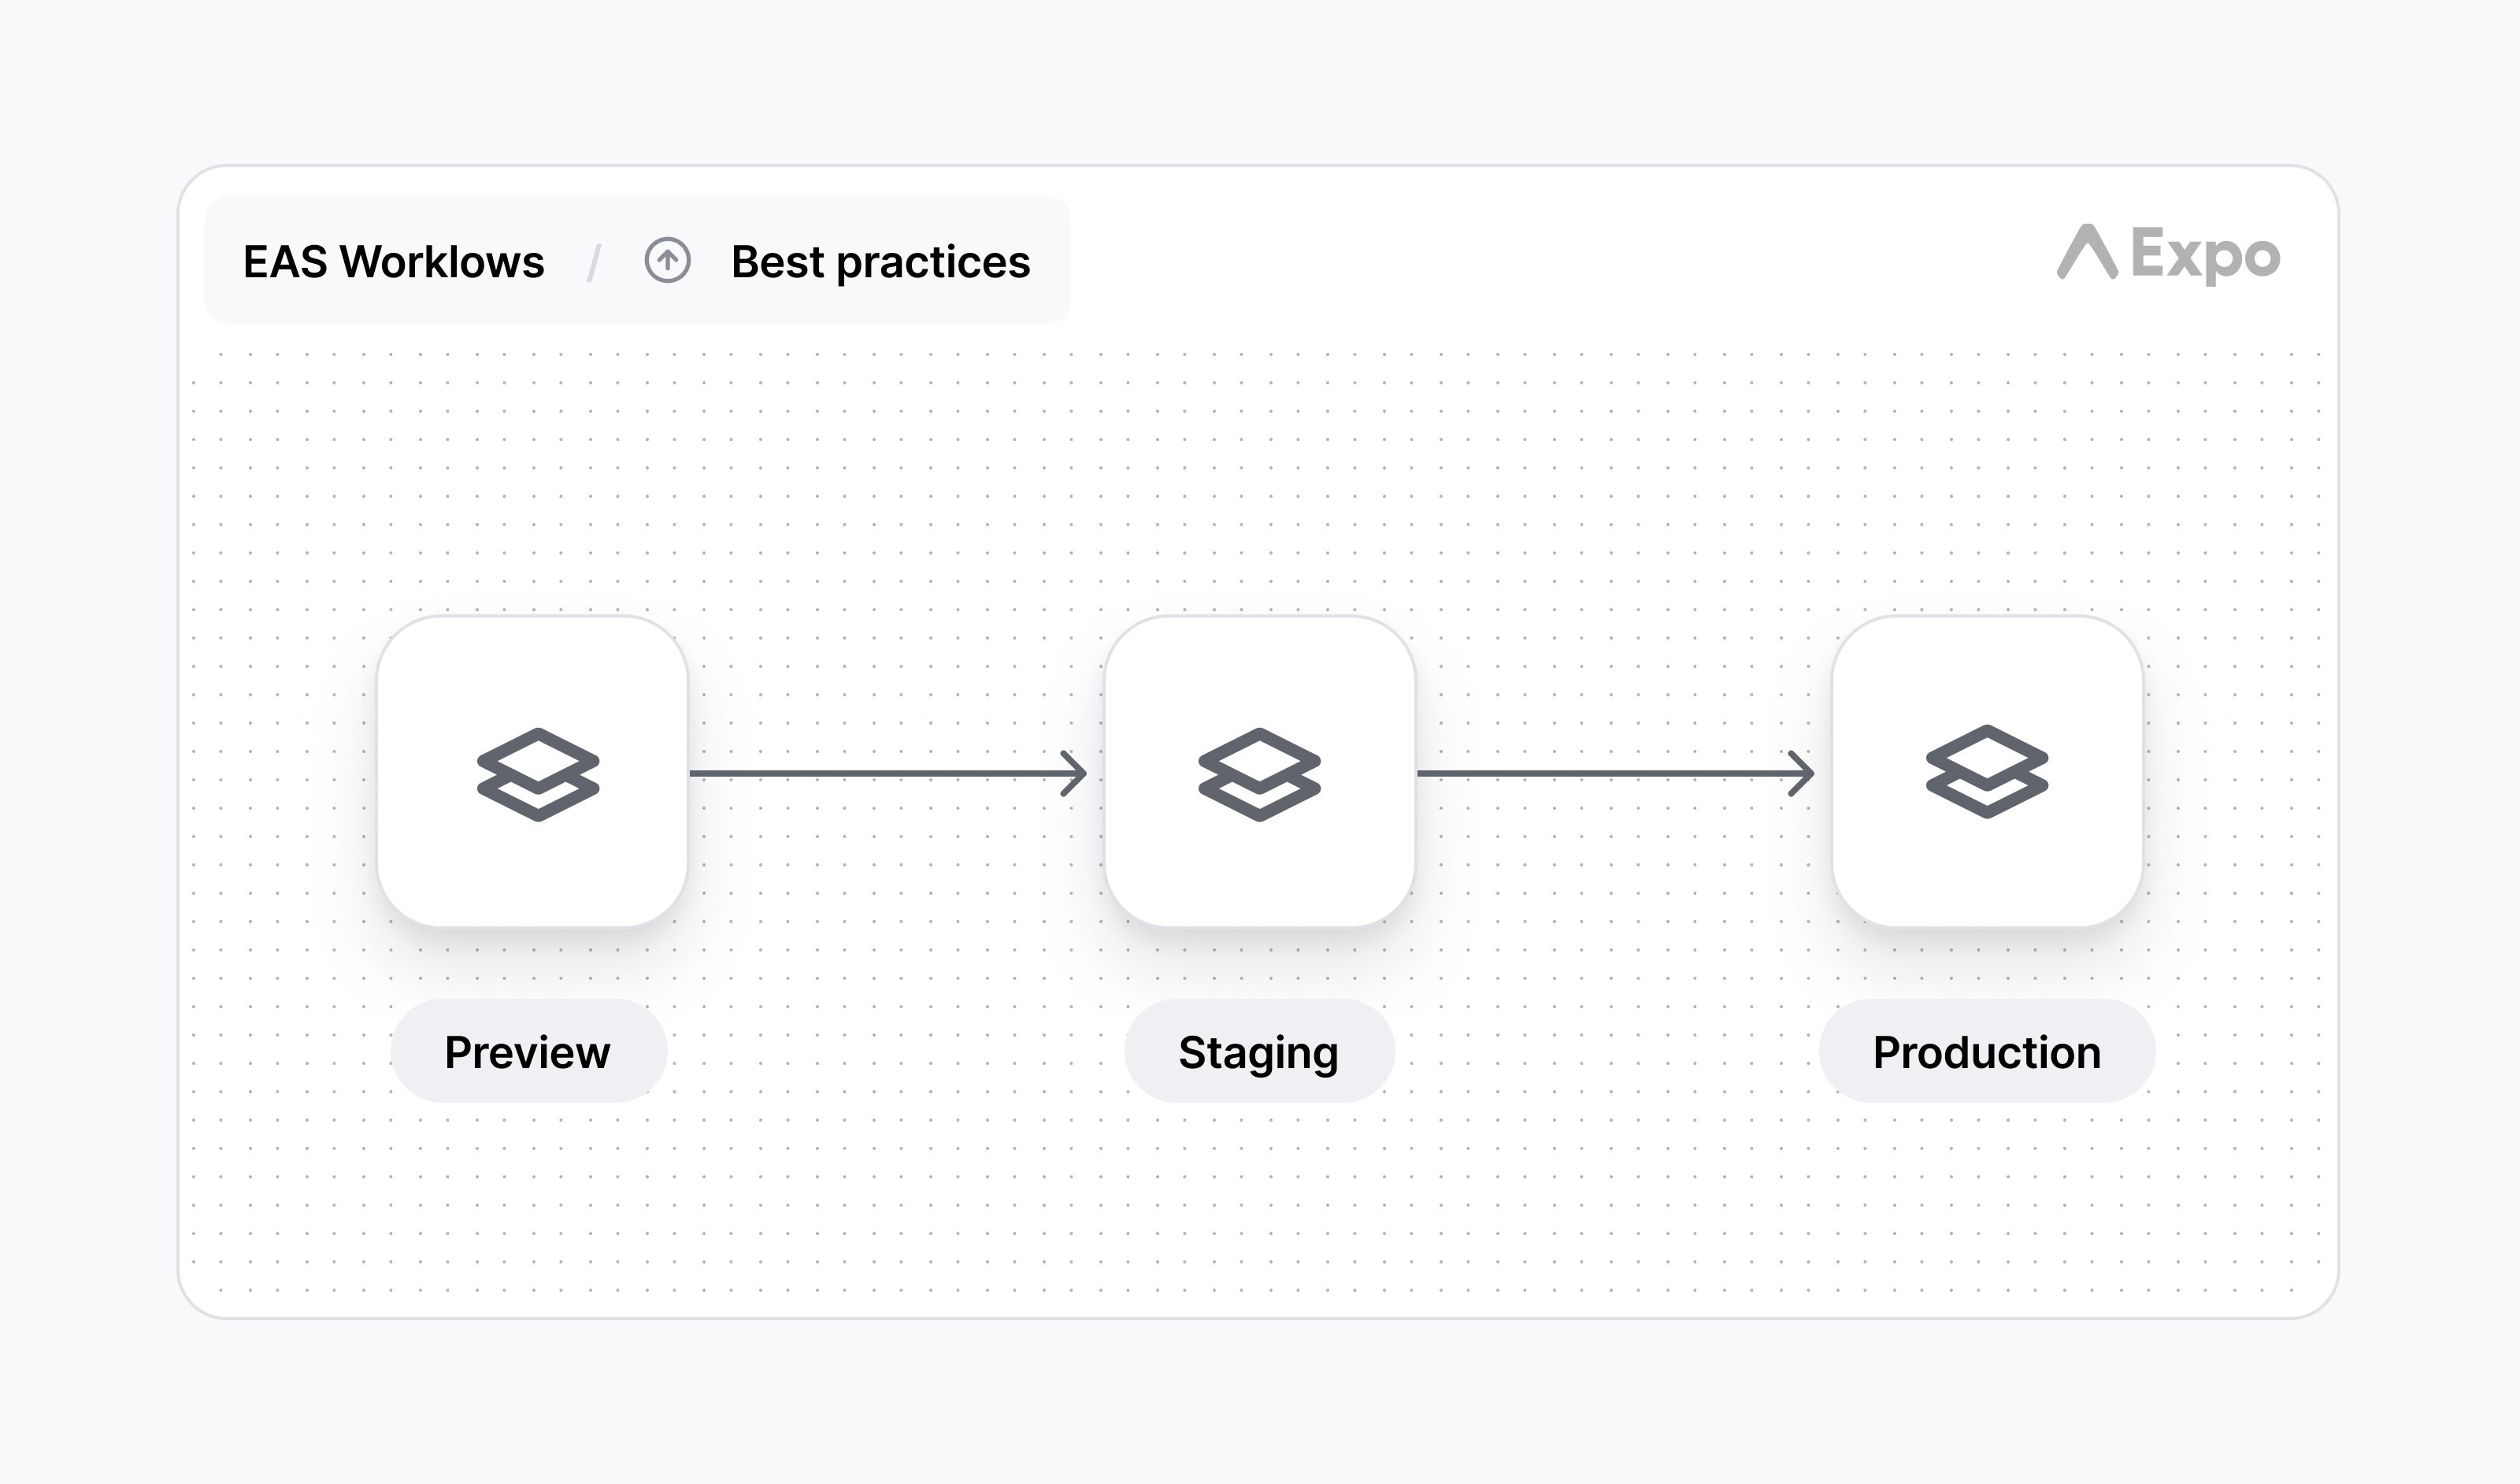
这需要第四套环境:一条 staging 通道,配置与生产环境完全一致(同样的 API 服务器、同样的功能开关),但只分发给内部测试人员。
# Step 1: Publish to staging
eas update --channel staging --message "Fix login bug"

# Step 2: QA tests on a staging build (identical config to production)

# Step 3: Promote the EXACT tested update to production
eas update:republish --channel staging --destination-channel production
什么情况下值得这么做:
-
对经过测试的产物有合规或审计要求
-
以前被打包环节的细微差异坑过
-
团队规模足够大,“再发布一次”本身就会带来协作风险
需要做的配置:
-
四个 app 变体:development、preview、staging、production
-
staging 必须与生产配置完全一致(API 端点、功能开关等)
对大多数刚起步的团队来说,简单的预览 → 生产流程就够了。等你确实需要那份额外保证时,再加上 staging 提升这一层。
2. 用 fingerprint 判断什么时候需要重新构建
问题所在: 并非所有依赖更新都只涉及 JavaScript。如果你推送了一个需要原生代码改动的 OTA 更新,而用户还在跑旧版本的二进制包,app 就会崩溃。
为什么这一点很重要: 运行时版本控制是你的兼容性防火墙。它决定了哪些二进制包能加载某次更新。生产环境中最常见的翻车原因?团队以为某个依赖只涉及 JS,实际上它改动了原生代码。
推荐做法:appVersion + fingerprint 检测
用 appVersion 作为你的运行时版本策略。这样运行时版本就和应用版本绑定(1.0.0、1.1.0 等),判断哪些构建能接收哪些更新就变得很简单。
{
  "expo": {
    "runtimeVersion": { "policy": "appVersion" }
  }
}
关键问题: 怎么知道什么时候该升应用版本?
这就要靠 fingerprint 了——它不是运行时策略,而是检测工具。Expo 的 fingerprint 会比较各次提交之间项目的原生部分(依赖、配置、原生代码)。fingerprint 变了,就说明原生代码变了,必须先出新构建,才能发 OTA 更新。
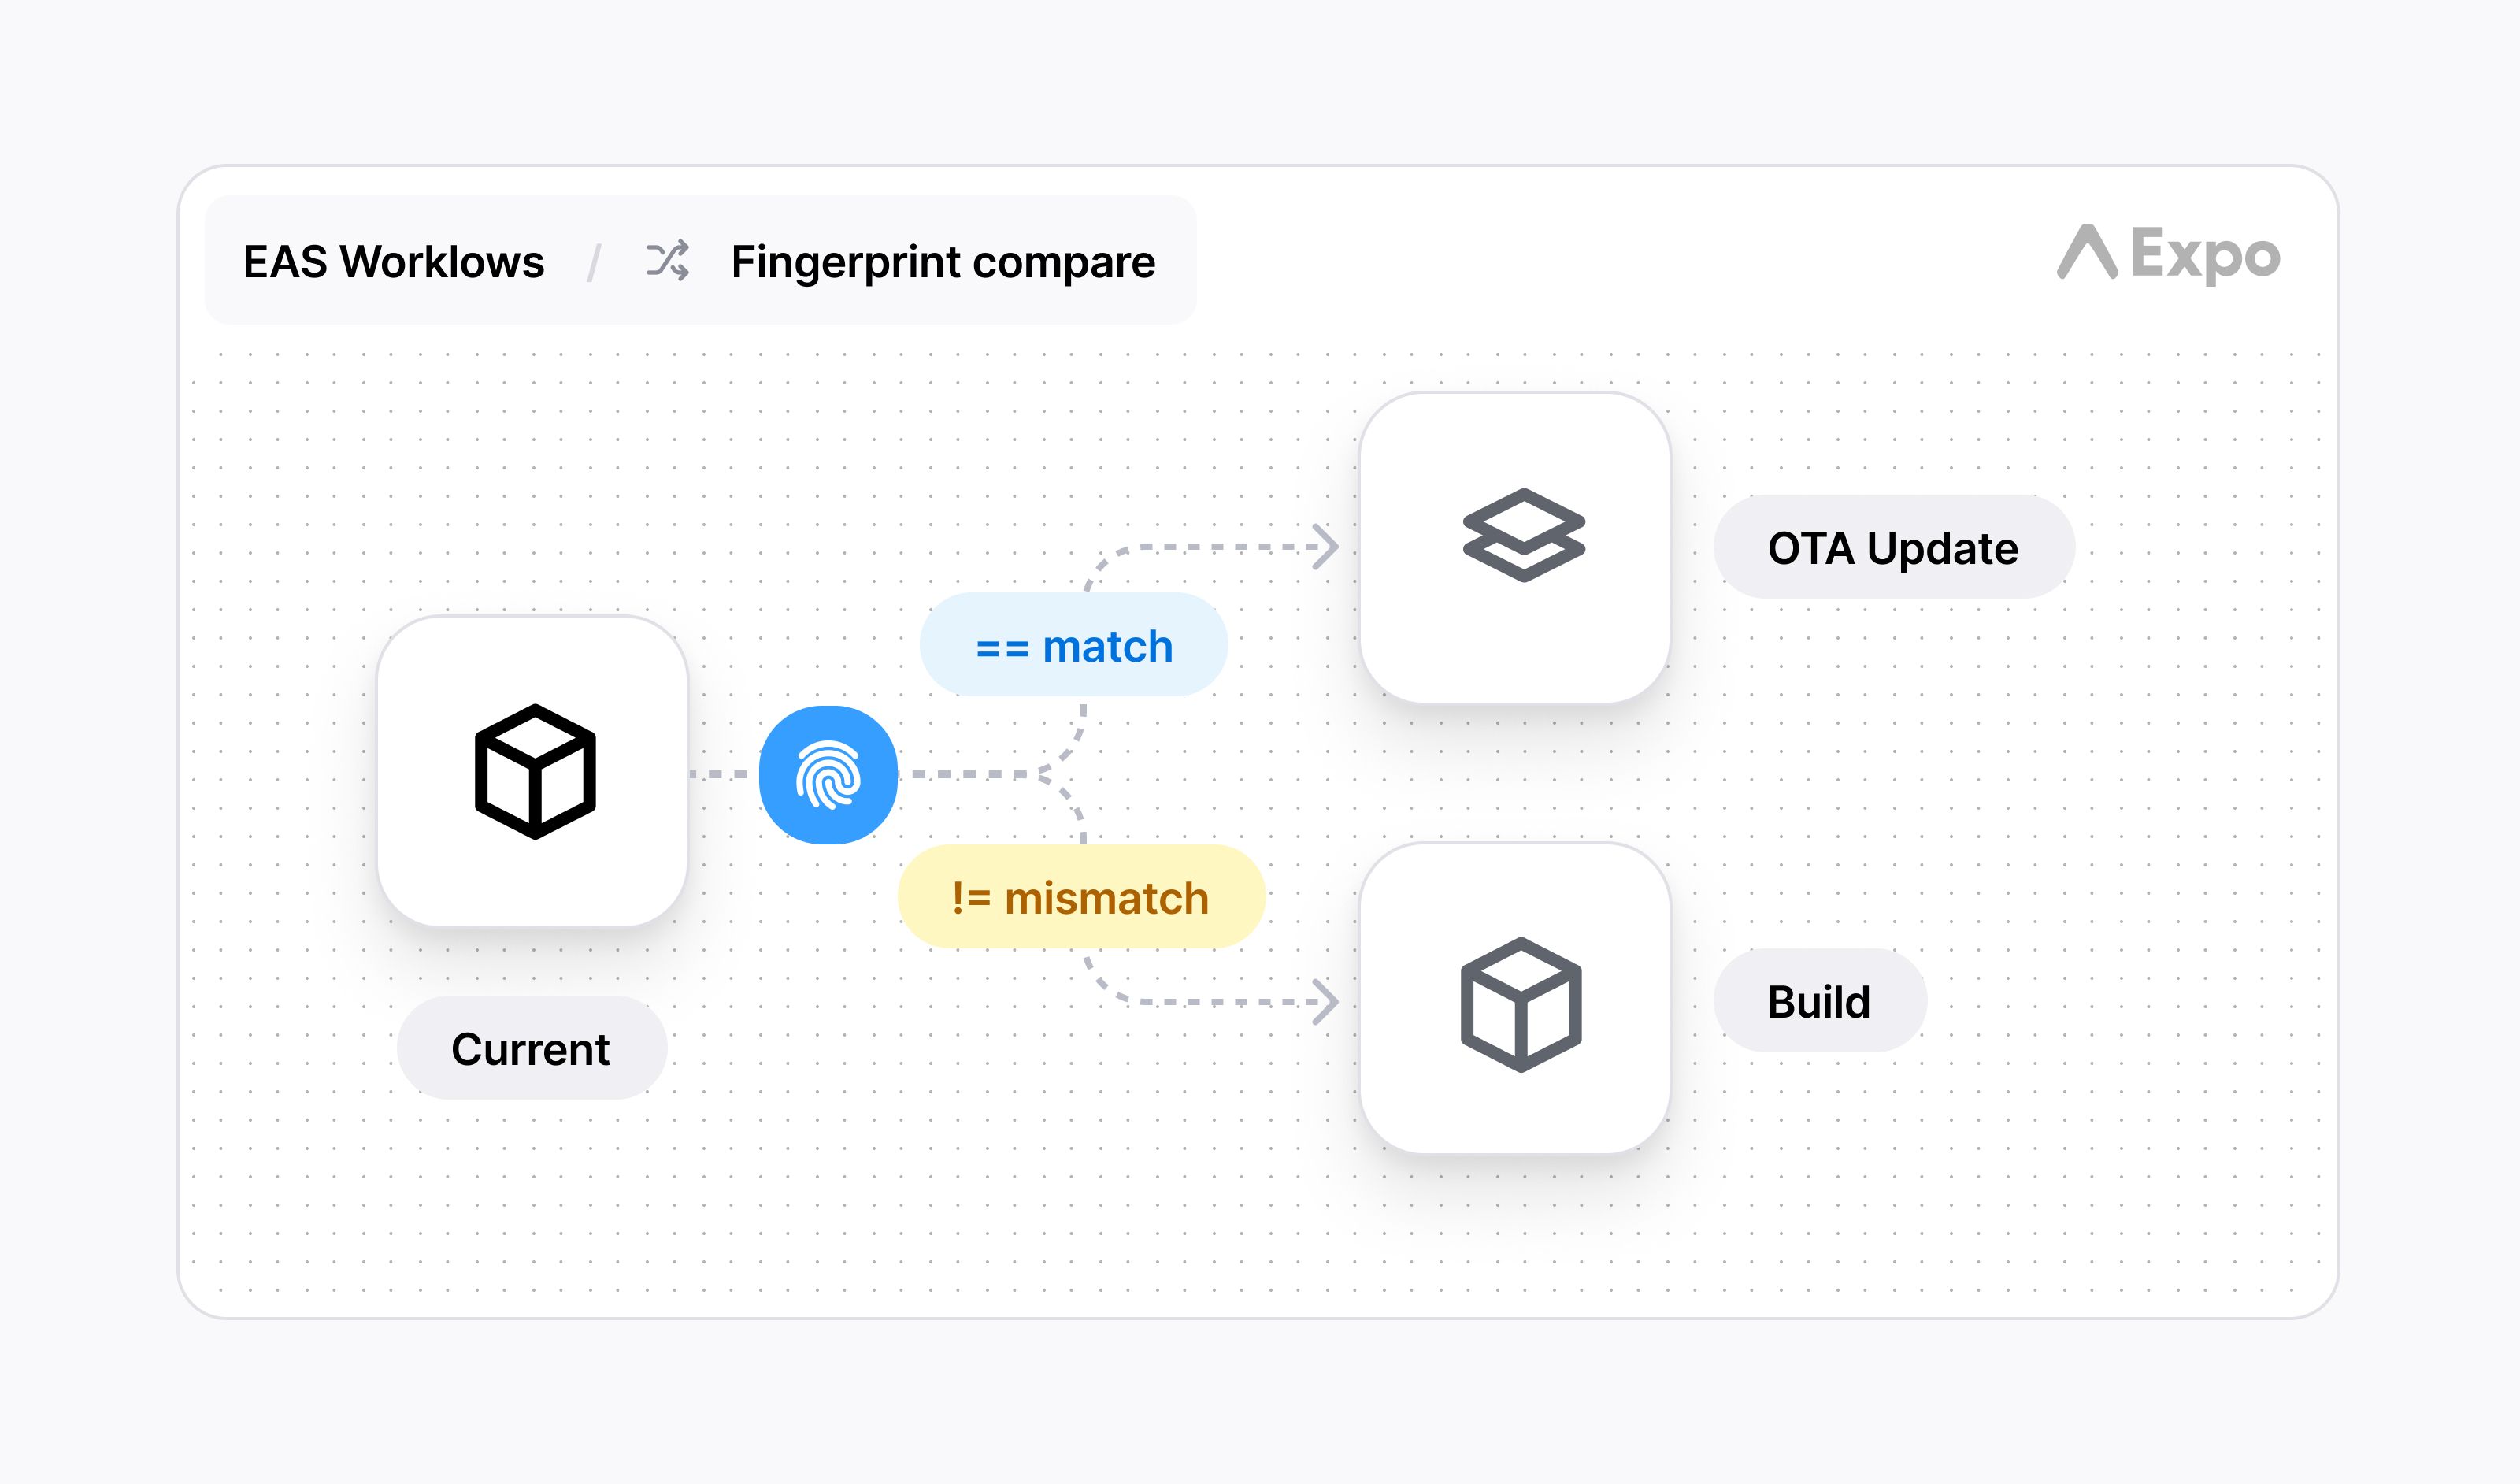
用 fingerprint 来把关 OTA 更新:
# Compare your local project's fingerprint against your production build
eas fingerprint:compare --build-id <BUILD-ID>
fingerprint 一致,就可以放心走 OTA 发布。不一致,就得先出新构建。
用 CI 自动化:
你可以在 CI 流水线里加一道 fingerprint 检查,自动判断某次改动能否作为 OTA 更新发布,还是需要新构建。这样就不用靠人猜,也不会让不兼容的更新流到用户手上。
真实案例: Hipcamp 用 fingerprint 自动检查改动是否适合走 OTA。fingerprint 一致就走 OTA 发布,不一致就等下一次构建。他们说:“这样省掉了人工检查,也避免了人为失误。”
什么时候该升应用版本:
-
更新了带原生代码的依赖
-
升级了 Expo SDK
-
改了 app.json 中影响原生配置的设置(图标、启动屏、entitlements、scheme 等)
-
修改了原生工程文件(ios/、android/ 目录)
fingerprint 工具能覆盖以上全部情况。把它纳入你的工作流,就不用再靠脑子记了。
3. 搞清楚哪些东西可以通过 OTA 更新
我们最常听到的问题:“我发了个更新,应用就崩了。我以为什么都能更新?”
为什么这在实践中很重要
-
它能防止“一厢情愿的 OTA”——团队推了改动,却悄悄依赖一个新的二进制包。
-
它让产品/工程团队能干净利落地做发布决策:“现在走 OTA”还是“走商店发布”。
更新可以包含:
-
JavaScript 代码和业务逻辑
-
UI 组件、样式和布局
-
图片、字体和其他资源
-
Bug 修复和文案改动
这些需要新的构建:
-
原生模块的安装或升级(包括带原生代码的 expo-* 包)
-
需要原生编译的配置改动(应用图标、启动屏、原生权限声明、config plugins)
-
新的原生权限(相机、定位、通知等)
-
Expo SDK 升级(即使你只用 managed workflow)
-
影响原生代码的 app.json 配置改动(scheme、associated domains、intent filters 等)
-
bare workflow 中原生项目文件的改动(ios/、android/ 目录)
-
React Native 本身的更新
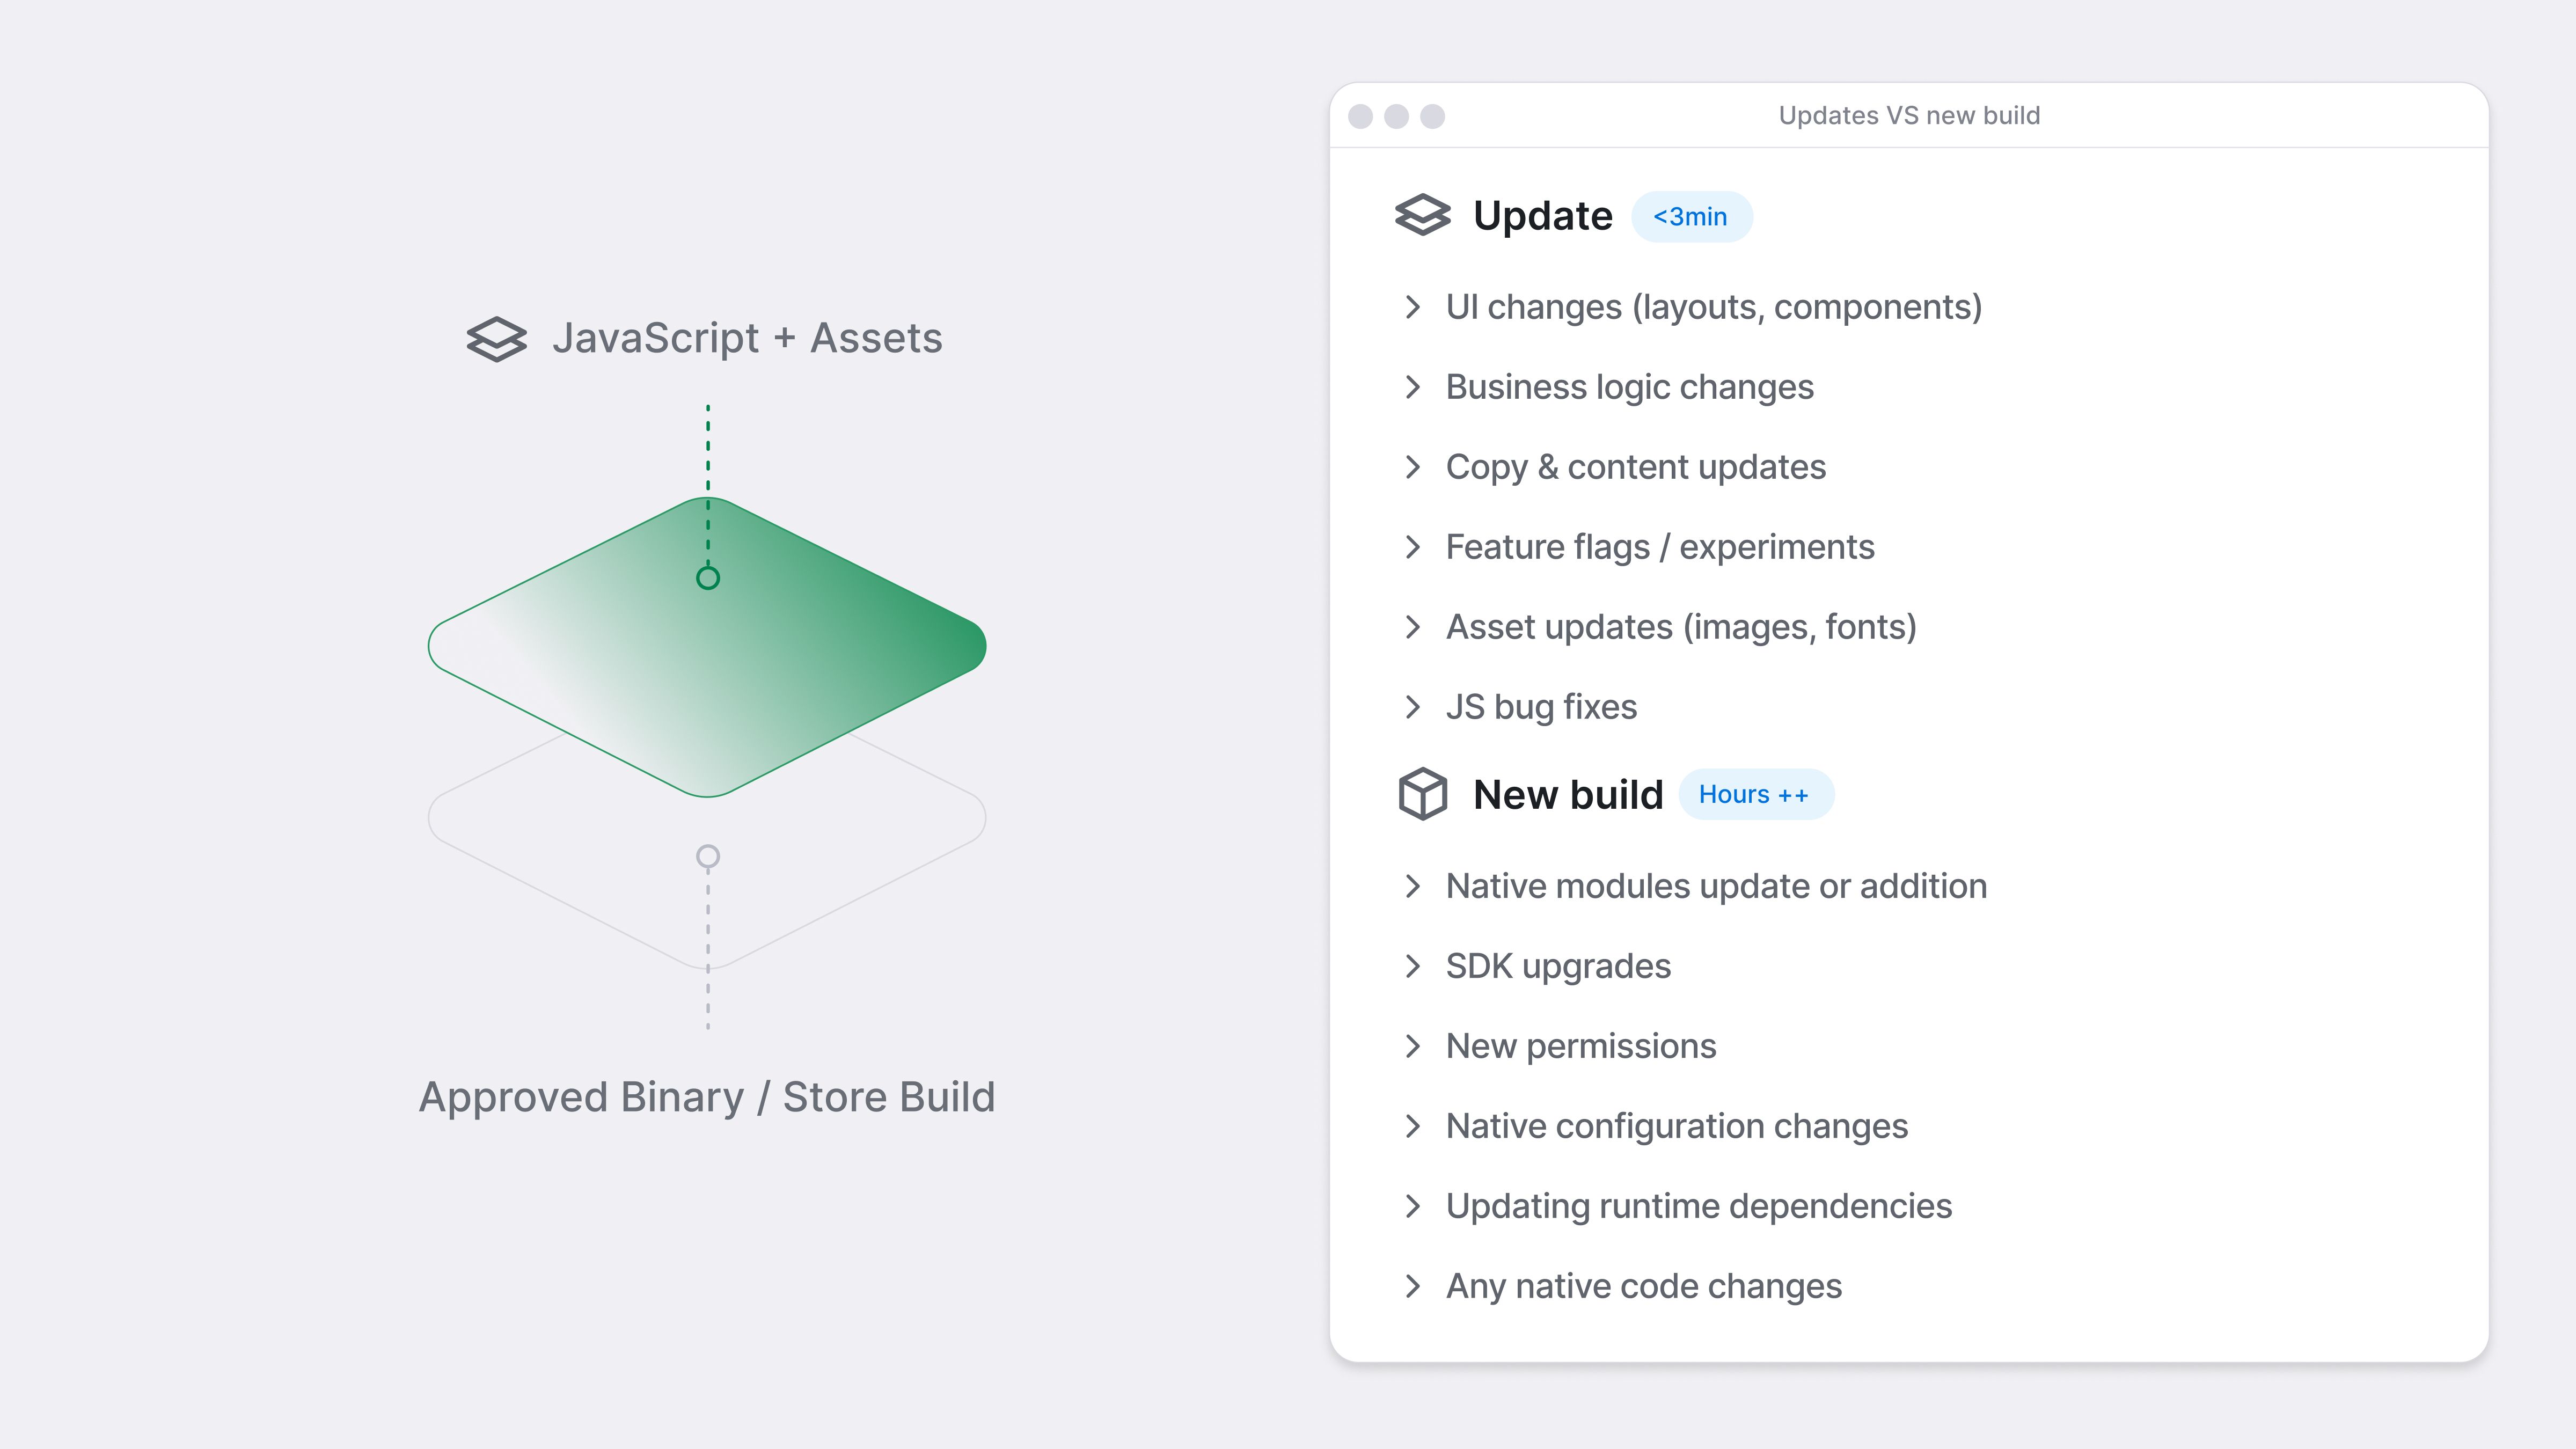
从技术角度看,只要是 JavaScript 或资源,就能通过 OTA 下发。一旦涉及原生代码,就需要新的构建。
让 fingerprint 替你判断
这些规则不必死记。Fingerprint 会自动检测原生改动,方法是把你项目的原生表面积与生产构建做对比。如果 fingerprint 匹配,就可以放心走 OTA。如果不匹配,就得先做一次新的构建。
用 EAS Workflows 自动化:
最好的方案是彻底消除猜测。用 EAS Workflows,你可以在每次 push 时跑一次 fingerprint 检查,并自动把改动路由到正确的路径:OTA 更新或新的构建。
# .eas/workflows/deploy.yml
# Android only version
name: Deploy to production

on:
  push:
    branches: ['main']

jobs:
  fingerprint:
    name: Check fingerprint
    type: fingerprint
    environment: production

  get_build:
    name: Check for existing build
    needs: [fingerprint]
    type: get-build
    params:
      fingerprint_hash: ${{ needs.fingerprint.outputs.android_fingerprint_hash }}
      profile: production

  build:
    name: Build (if native changed)
    needs: [get_build]
    if: ${{ !needs.get_build.outputs.build_id }}
    type: build
    params:
      platform: android
      profile: production

  update:
    name: OTA Update (if native unchanged)
    needs: [get_build]
    if: ${{ needs.get_build.outputs.build_id }}
    type: update
    params:
      channel: production
这个 workflow 会在每次 push 到 main 时检查 fingerprint。如果原生代码变了、又没有兼容的构建,它就触发一次新的构建。如果已经有兼容的构建,它就发布一次 OTA 更新。不用手动检查,不用猜,更新和 workflow 配合起来更好用。
关于合规:
两家商店都对 OTA 更新有规定,直接读原文很重要。以下是完整的商店政策:Apple 的 Developer Program License Agreement 和 Google Play 关于下载代码的政策。
4. 使用 expo-updates API 更快地交付更新
会发生什么: 用户在你发布 OTA 更新之后才安装你的应用。他们打开应用,更新在后台下载,但要等到下一次冷启动(强制退出再重新打开)才会生效。
这是默认行为,我们也推荐这么做——应用启动性能对留存至关重要。用户第一次启动时用的是内置 bundle,速度快;到第二次会话时他们就会拿到最新版本。
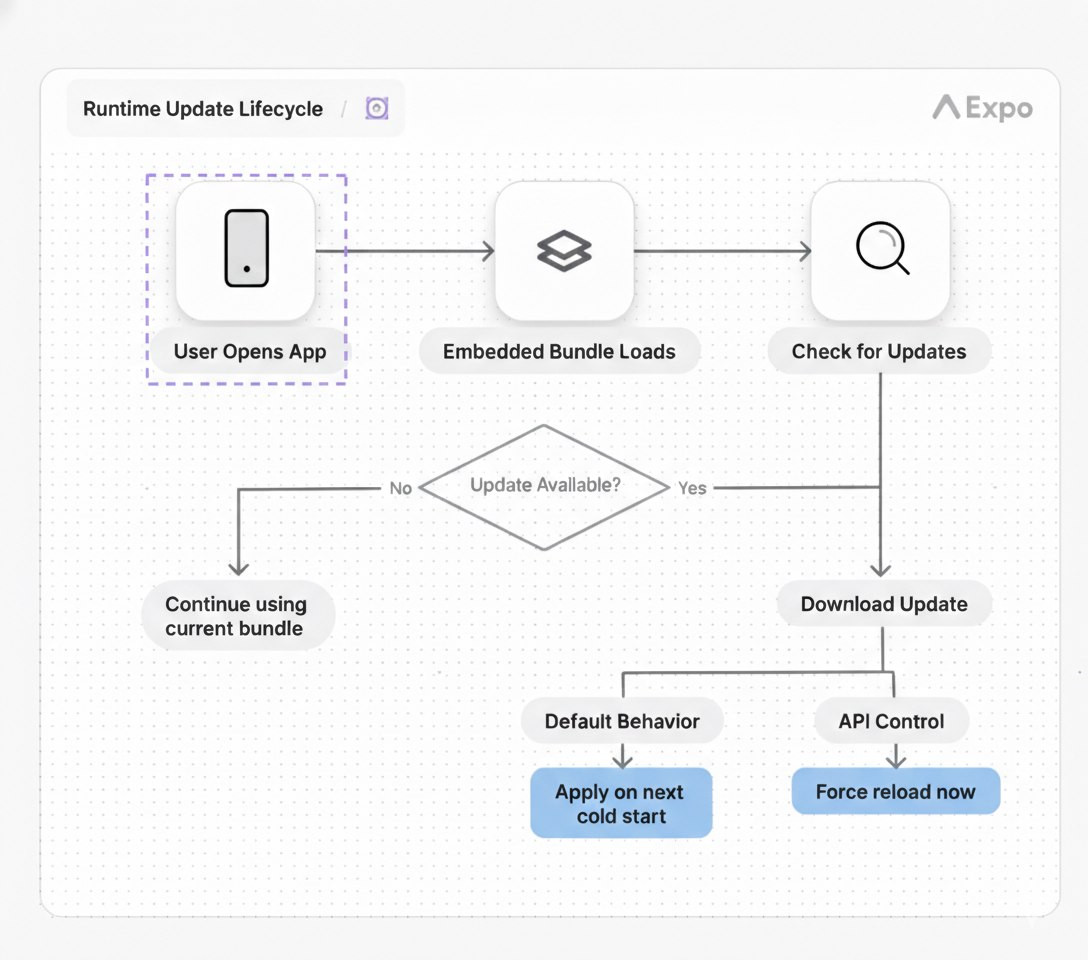
如果你需要更多控制,expo-updates API 可以检测、下载并应用更新,让用户拿到下一个更新的速度远快于等下一次冷启动。你可以查看更新检查和下载的进度,再根据更新的紧急程度、用户当前在做什么或其他因素决定何时应用——完全不需要冷启动。
基本用法:
import * as Updates from "expo-updates";

// Check if an update is available
const update = await Updates.checkForUpdateAsync();

if (update.isAvailable) {
  await Updates.fetchUpdateAsync();
  await Updates.reloadAsync(); // Restarts the app with new update
}
有一点需要知道: expo-updates 在设计上具备容错能力。如果应用离线或连不上更新服务器,它会继续使用已有的最新更新。应用不会崩溃——用户只是要等到恢复网络后才能拿到新更新。
处理关键更新与普通更新
如果你既发布关键修复,也发布常规更新,就需要一种区分二者的方式。简单地检查更新消息里有没有 [CRITICAL] 标记并不可靠——如果你先发布一个关键更新,再发布一个普通更新,用户检查时只会看到最新的那个(普通)更新。
正确的做法是把紧急程度与更新本身分开跟踪。Updates API Demo 展示了如何正确实现这一点,包括在存在更新的普通更新时如何检查关键更新。
注意事项:
-
不要在循环里反复检查/重载。 用一个标志位确保每个会话只检查一次。
-
强制更新时显示加载状态。 一个短暂的“正在更新……”界面,比突然重启要好。
-
绝不要因为网络阻塞应用启动。 如果更新检查超时,用户仍然应该能进入应用。
真实案例:
MTA 移动团队为 35 万日活用户提供关键交通类应用服务。生产环境一旦出 bug,90 秒内就能从乘客或员工那里收到反馈。遇到严重问题,他们用 expo-updates API 推送修复,立即生效,完全不需要冷启动。
“从第一条用户反馈算起,我们能在 90 秒内完成定位、打补丁并部署 OTA 修复,”他们告诉我们。阅读他们的完整故事 →
5. 使用灰度发布,并确保能回滚
缺失的安全阀: 即便有预发环境和测试,坏更新还是会溜进生产。问题在于你能否控制影响范围并快速恢复。
为什么这在实践中很重要
-
10% 灰度发布能把“全局故障”变成“小事故”
-
只有团队已经熟悉命令、手头备好正确的 ID,回滚才快得起来
灰度发布
先小范围放量,盯住遥测数据,再逐步扩大。
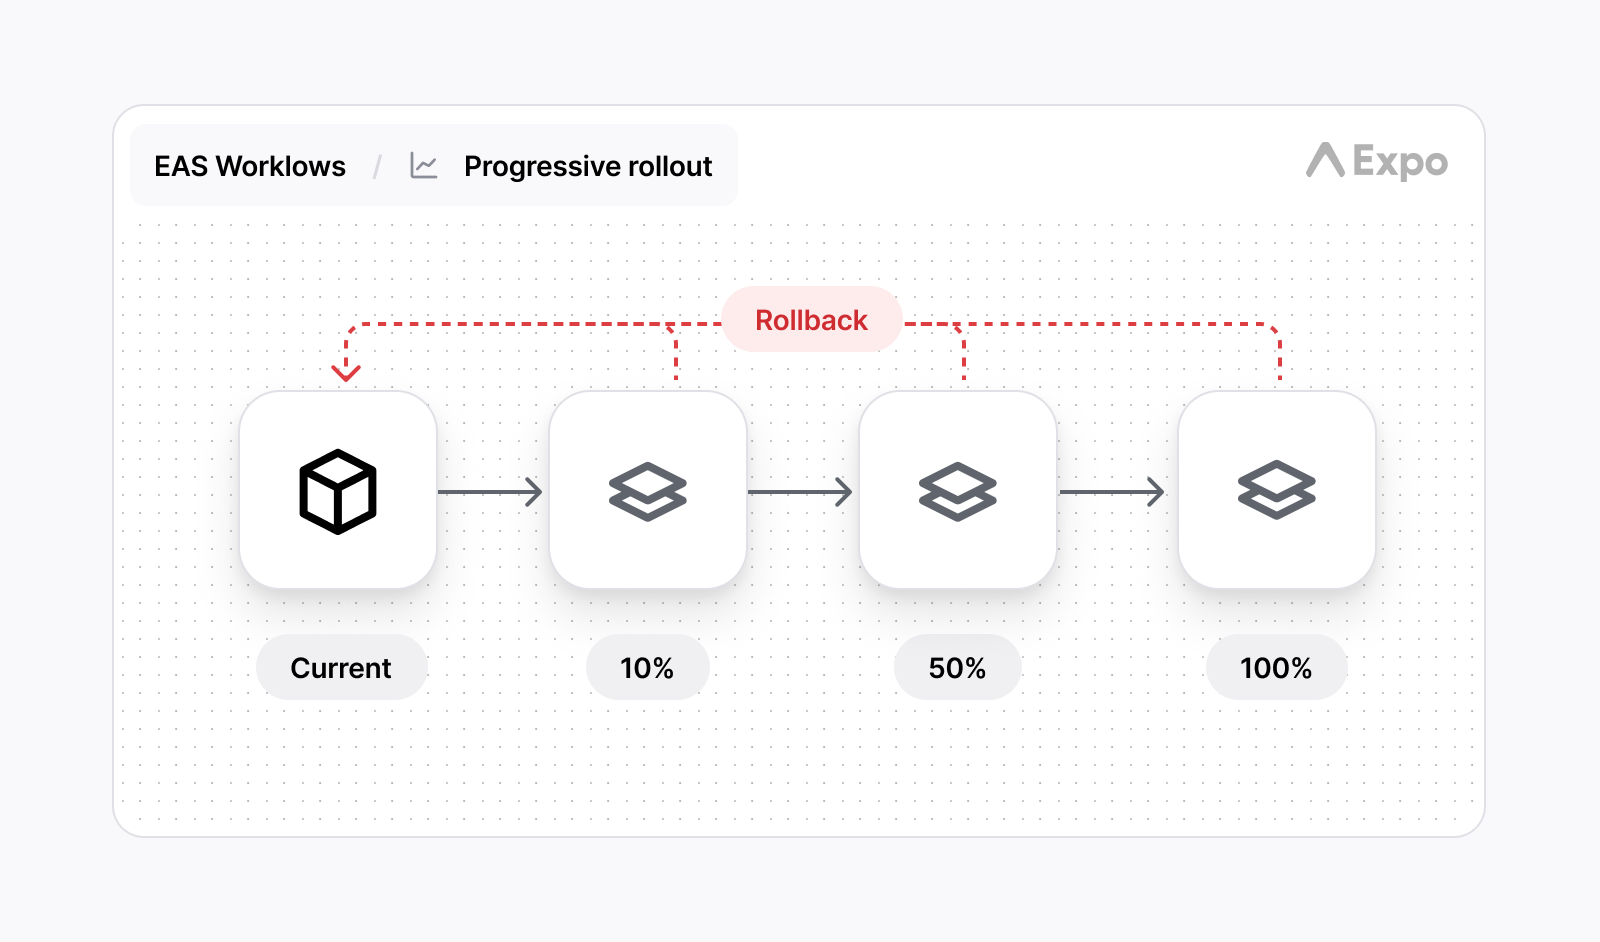
# Start with 10%
eas update --channel production --message "New checkout flow" --rollout-percentage 10
要提高该更新的发布比例:
# First, get your update group ID from the dashboard or from the publish output
# Then increase the rollout
eas update:edit <update-group-id> --rollout-percentage 50

# Then to 100%
eas update:edit <update-group-id> --rollout-percentage 100
要停止发布并回退:
# Interactive rollback (CLI will prompt for channel and options)
eas update:rollback
回滚
出了问题,你可以向前滚动——推一个修复版本,也可以回滚到上一个更新。如果你清楚修复方案,向前滚动通常更快:
# Fix the bug, publish new update
eas update --channel production --message "Fix crash in checkout"
但如果需要立即回退,就用回滚命令:
eas update:rollback回滚的一个好处: 如果用户已经装了上一个版本,就不必再下载额外更新。设备会缓存上一个更新,所以回滚很快。
常见坑: 事故发生时手边没有更新组 ID。把 Updates 控制台加进书签,并在发布说明里记录最后一个已知正常的组 ID。
进阶技巧: 建立监控,按更新组跟踪更新采用率和错误率。要在灰度还是 10% 的时候就发现问题,而不是等到 100%。
如果这周只做三件事
不必一次性全部落地。从这里开始:
1. 搭好预览和生产两个渠道
-
构建两个版本:一个指向
preview,一个指向production -
永远先发布到 preview,测试通过后再发布到 production
-
仅这一条就能避免大多数生产事故
2. 用 fingerprint 检测原生代码变更
-
在配置中设置
"runtimeVersion": { "policy": "appVersion" } -
发布前用
eas fingerprint:compare检查原生代码是否发生变化 -
如果 fingerprint 与生产构建一致,就走 OTA 发布;不一致就先创建新的构建。
3. 把灰度发布加入工作流
-
每次生产更新都从 10% 灰度开始
-
观察 30 分钟再放量到 100%
-
手边留好最近几个 update group ID,方便回滚
这三项改动会让你的部署更快也更安全。等它们变成肌肉记忆之后,再叠加其他模式。
整合起来
那些发布 OTA 更新最有底气的团队,遵循的模式都差不多:
-
发布到生产之前先在 preview 上测试
-
用 fingerprint 检测原生变更,知道什么时候该提升 app 版本号
-
清楚哪些东西能更新、哪些不能
-
需要精确控制更新时机时,就用 expo-updates API
-
使用灰度发布,并且知道怎么回滚
这些模式都不需要复杂的工具,也不需要大幅改动流程。它们只是一些小调整,随着时间不断累积:生产事故更少,迭代周期更快,对部署流水线更有信心。
目标不是完美部署,而是可恢复的部署。出问题时(一定会出),你要做的是控制影响范围,并在几分钟内修好,而不是几个小时。
想了解更多团队如何用 OTA 更新安排发布节奏,可以看我们这份部署模式完整指南。如果你想看这些模式的实际效果,可以读读 Hipcamp 如何从每月发布变成每日发布,或者 MTA 如何在 90 秒内发布关键交通更新。