逆向工程老式 Intel 8087 的正切算法:不止是 CORDIC
Ken Shirriff 拆解 Intel 8087 的 FPTAN 指令:它并不只用 CORDIC,角度很小时改用了一个简单的有理多项式近似,代价是误差与除法都要单独处理。
中文
复制
希望你还没看腻 8087,因为我又写了一篇关于 Intel 这块浮点芯片的文章。1
1980 年,Intel 推出了 8087,让 IBM PC 及其他系统上的浮点运算快了许多。
本文要考察的是这块芯片正切指令背后的算法。
三角函数有一类流行做法叫 CORDIC。
另一类做法是多项式逼近。8087 把两者结合起来,既拿到了高精度,也拿到了高性能。
相比 8086 微处理器,8087 带来的提速极为可观:算一次正切只要 90 微秒,而不是 13,000 微秒。2
通过研究 8087 的电路和微码,我可以解释正切指令背后的算法,这条指令叫 FPTAN。
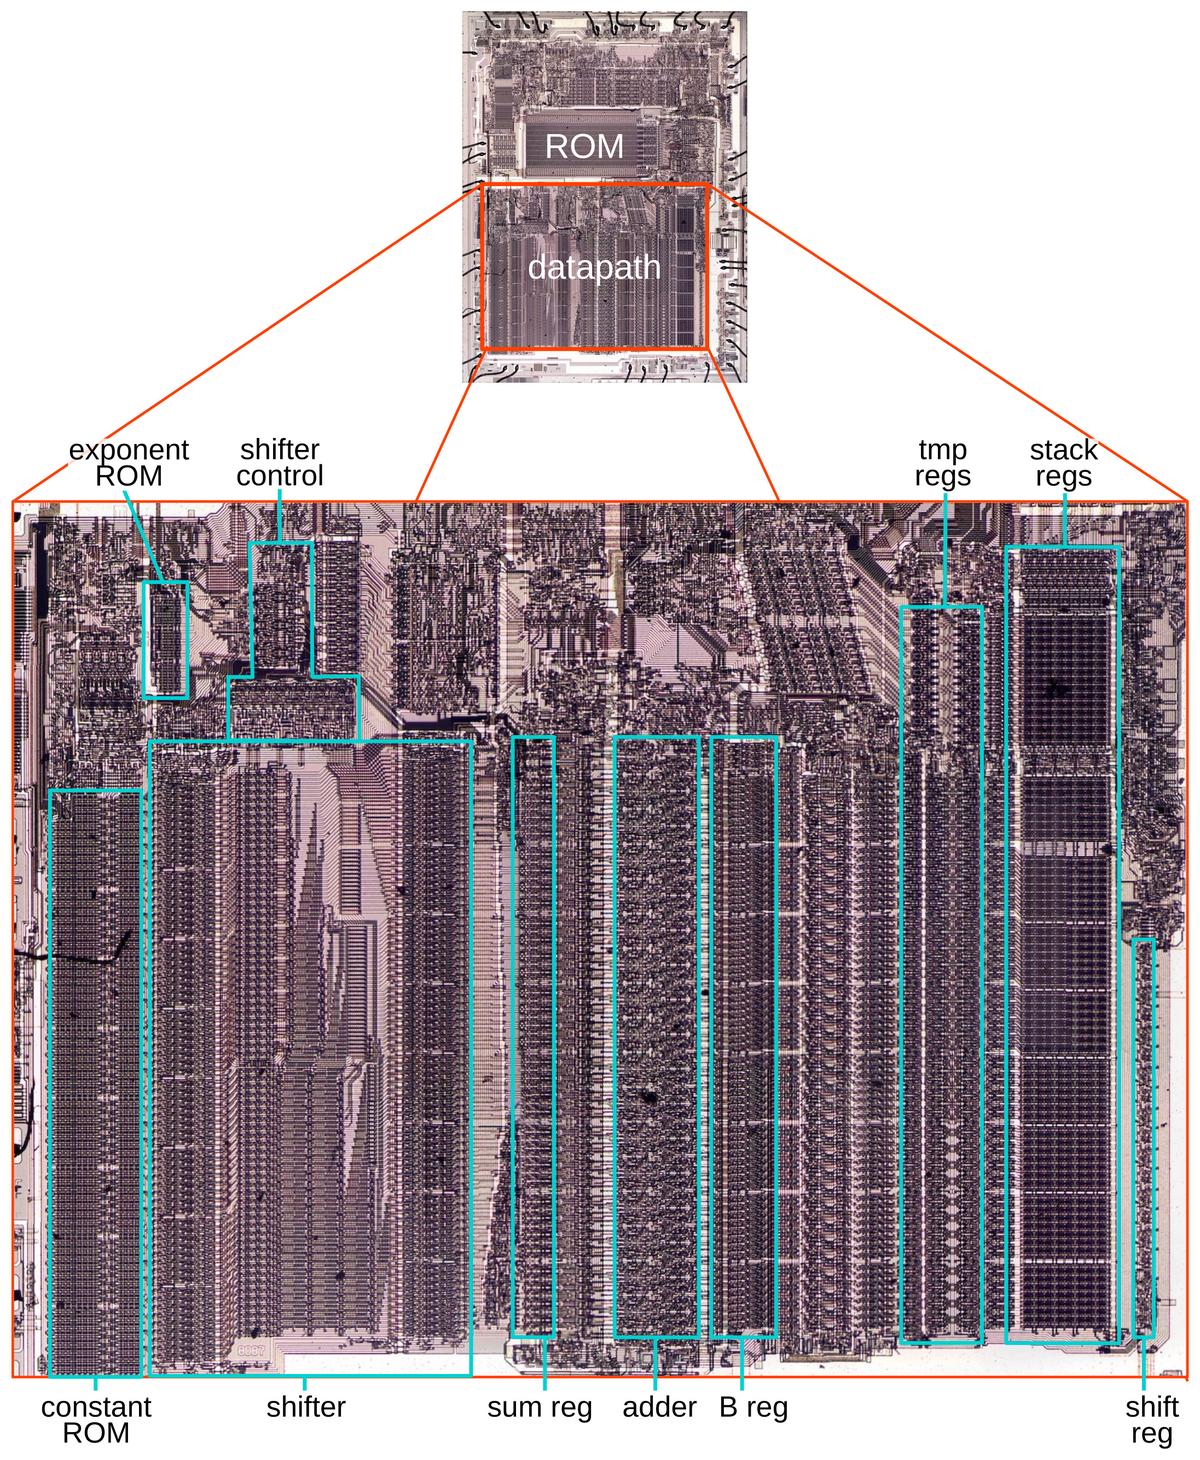
为了看清 8087 的电路,我用凿子撬开了一颗芯片的顶盖,再用显微镜拍出了高分辨率图像。
微码 ROM 是芯片中央那块巨大的矩形区域,里面存着控制整颗芯片的 1648 条微指令。
芯片下半部分(红框)是数据通路,也就是对 80 位数值做浮点计算的电路。3
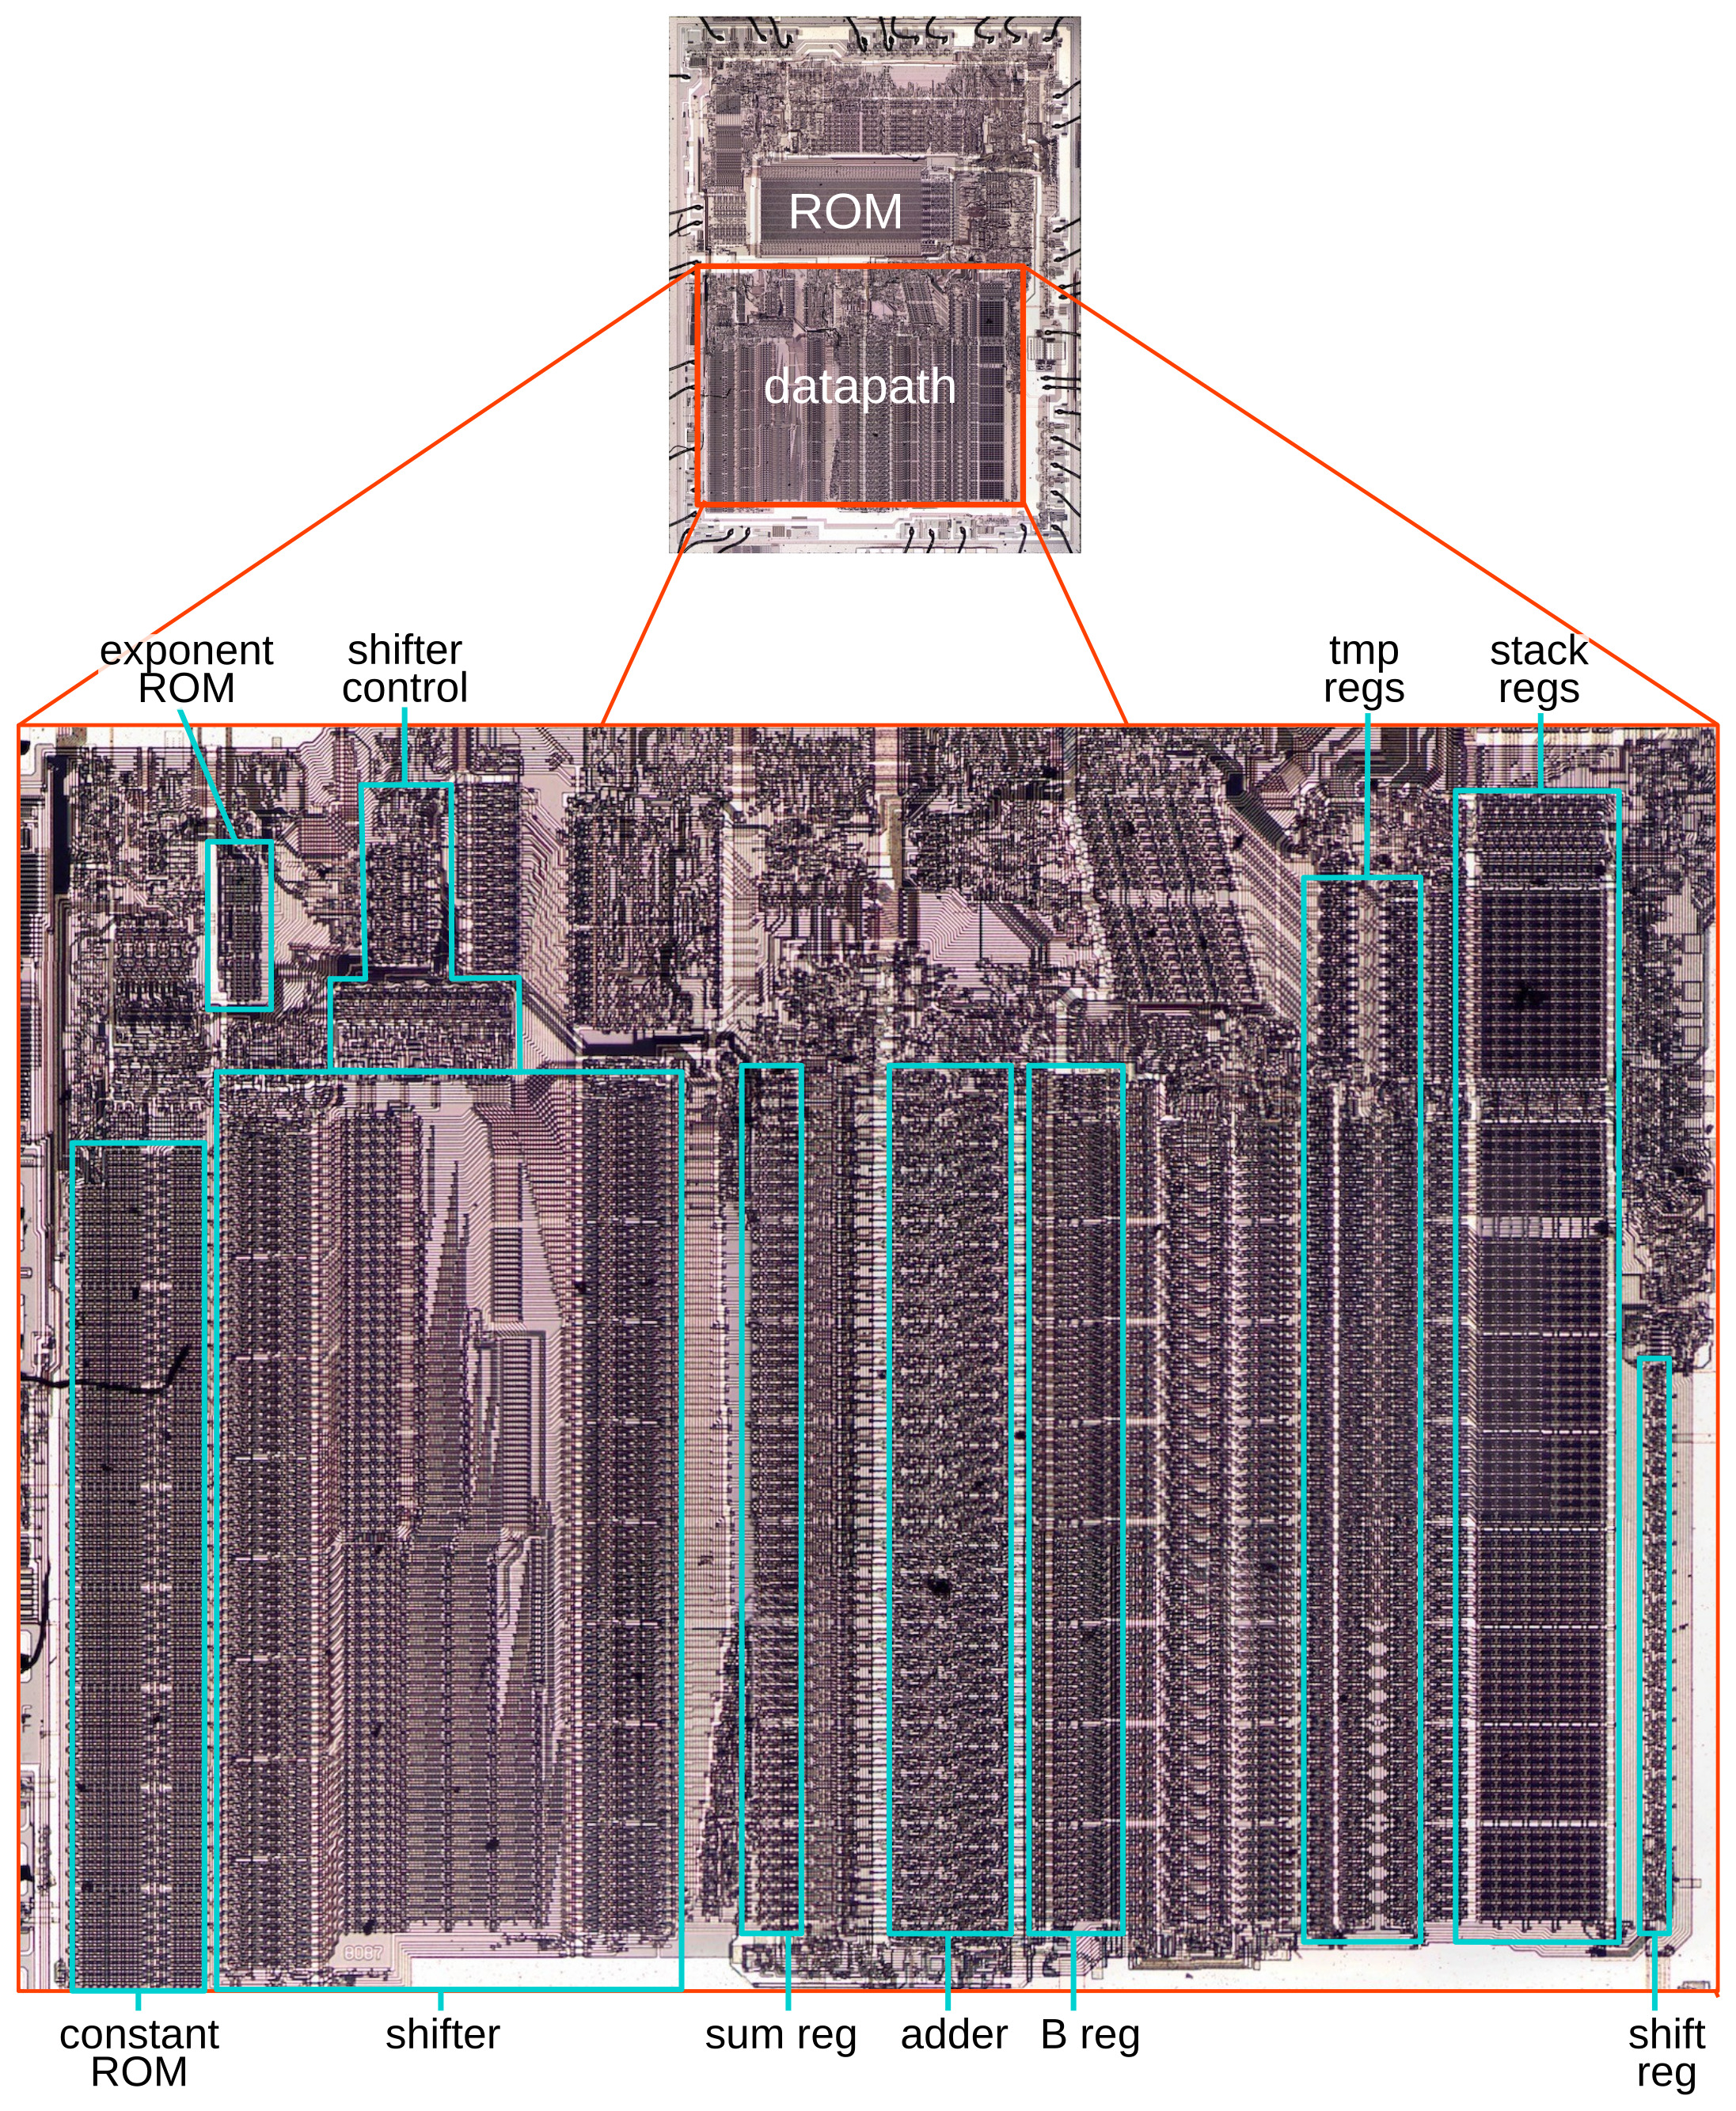 8087 数据通路的特写,展示了
FPTAN 用到的各个功能模块。点击这张图(或任何一张图)可查看大图。
放大数据通路,就能看到相关的功能单元。 指数 ROM 存放算法所需的固定指数值。 常量 ROM 存放各种常量,其中包括 CORDIC 算法用到的常量。 移位器是个大部件;它能把一个 64 位值左移或右移任意位数。 加法器是 8087 计算的核心;除了做加减法,它还被用在循环里完成乘法、除法和平方根。 B 寄存器存放加法器的一个输入,另一个输入则可以来自多个来源。和寄存器存放加法器的输出。 八个栈寄存器和若干临时寄存器存放浮点数。 最后,移位寄存器存放 CORDIC 计算所需的 16 个状态位。
CORDIC 算法
CORDIC 是一种巧妙的算法,能用简单的硬件快速计算超越函数:它只用到移位、加法指令和查表,不需要乘法或除法。 这个算法可以追溯到 1956 年,当时是为 B-58 Hustler 开发的——第一架能以 Mach 2 飞行的轰炸机。 这架飞机装的是模拟导航计算机,但模拟元件的精度有限。 工程师 Jack Volder 接到的任务,是设计一台数字计算机来取代模拟计算机。7 一个关键问题在于,模拟计算机可以借助一种叫 resolver 的机电装置轻松生成正弦和余弦。 但三角函数很难用数字方式产生,尤其是在那个晶体管还很慢的年代。
 一架 Convair B-58A Hustler,展出于德克萨斯州圣安东尼奥(详情)。
Jack Volder 想出了一种用简单硬件快速计算三角函数的方法。 他把这个算法——以及实现它的计算机——称为 CORDIC:“COordinate Rotation DIgital Computer”(坐标旋转数字计算机)。 CORDIC 把一个角度转换成一个向量,向量的坐标就给出所需的三角函数值。 诀窍在于把角度拆解成一系列特殊角度,这些角度能让向量旋转变得容易。 这些特殊角度预先算好、存进一张表,因此 CORDIC 计算可以很快完成,即使在 1950 年代的硬件上也是如此。 每一次 CORDIC 迭代都会多提供一位精度,所以算法收敛得很快。CORDIC 由此流行起来,包括用在科学计算器里——那些计算器用的是十进制 CORDIC,而不是二进制。
一些三角学
我会尽量少用数学,但这一节还是要简单说明一下 CORDIC 的工作原理。 下面的图回顾了三角函数与点的坐标之间的关系。 假设有一个角 θ,它对应单位圆上的一个点 (X, Y)。 基本公式是 X=cos θ、Y=sin θ、Y/X = tan θ。 因此,只要能确定坐标 (X, Y),就能确定三角函数的值。 如果这个点不在单位圆上,比如 (X', Y'),你仍然可以轻松求出 tan θ。(剧透一下:8087 就是这么做的。)但 sin θ 和 cos θ 就变得很麻烦。4
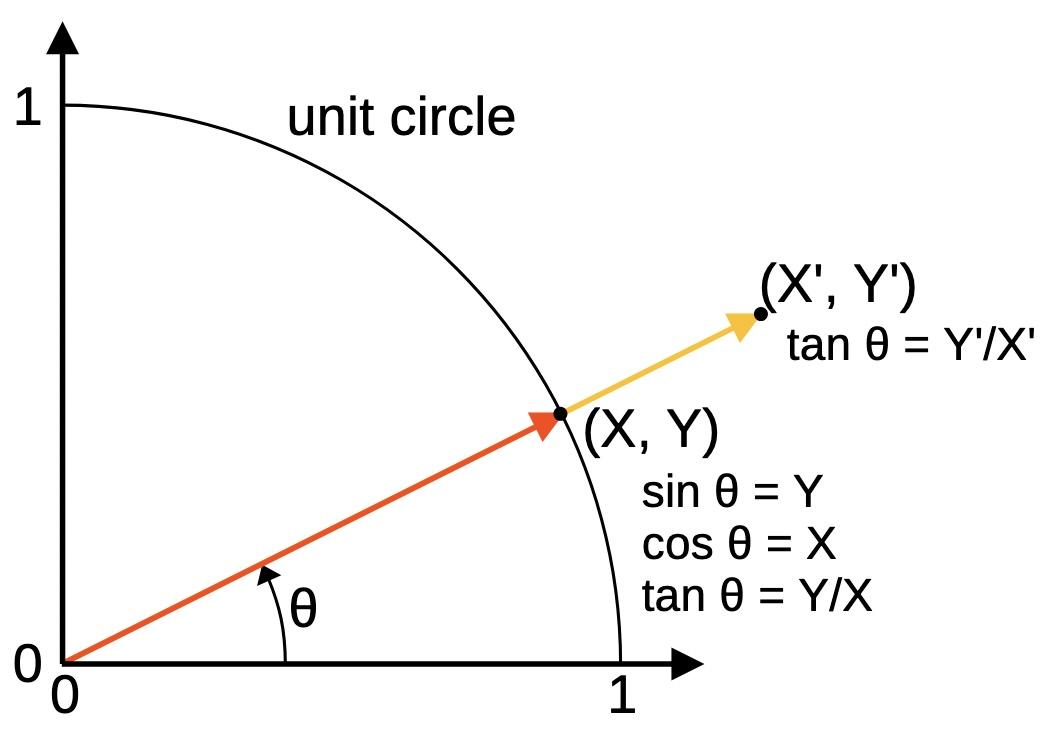 角度、X 与 Y 坐标以及三角函数之间的关系。
如果你接触过计算机图形学,多半见过旋转矩阵如何把点旋转一个角度。(不熟悉旋转矩阵的话,可以看这里,或者直接相信它能用。) 把点 (X, Y) 乘以旋转矩阵,就得到新点 (X', Y'),如下所示。
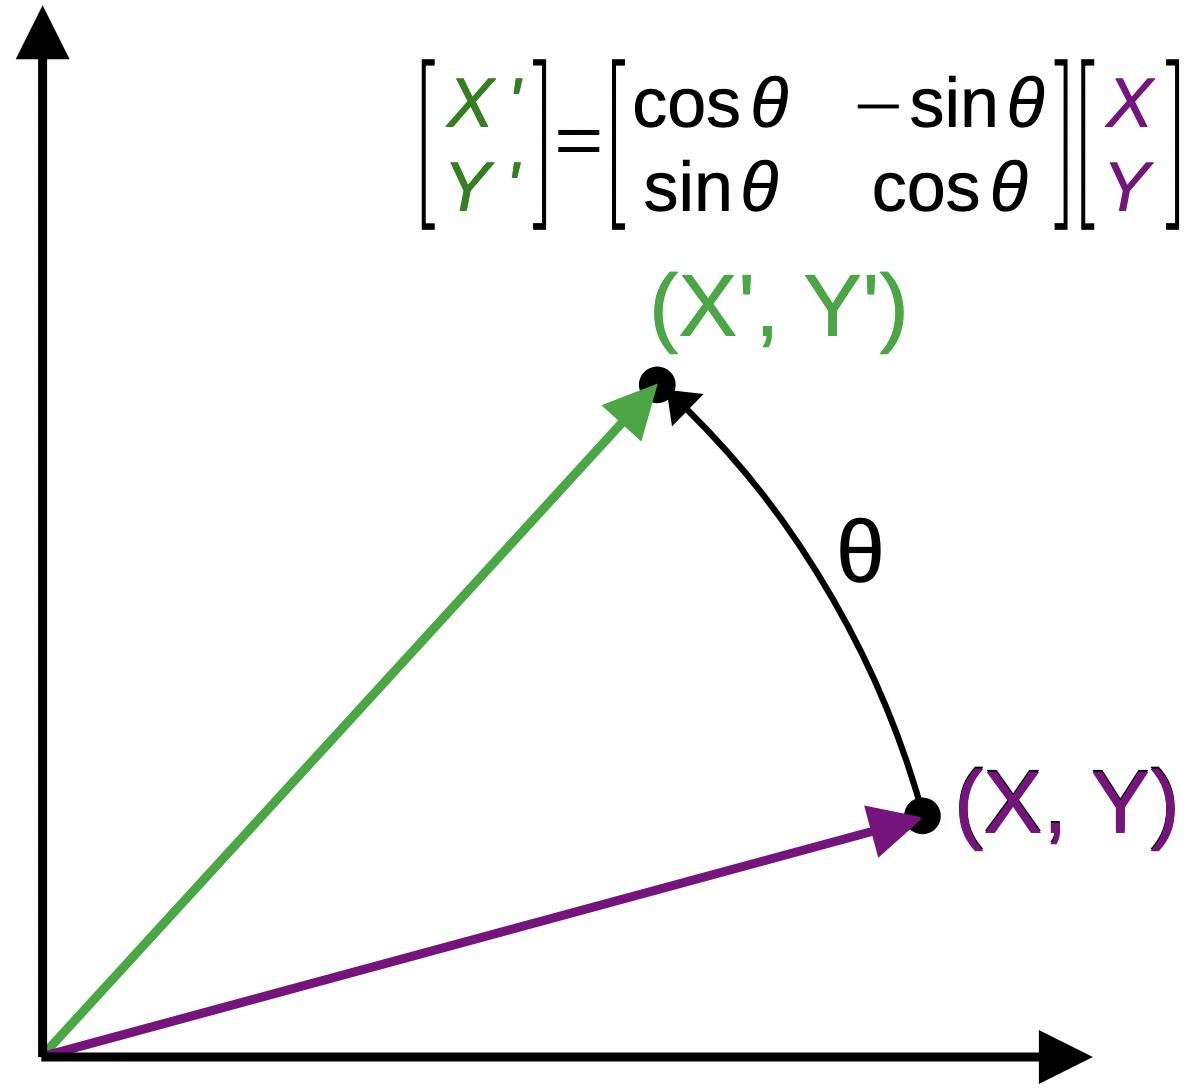 用旋转矩阵可以旋转一个点。
可惜的是,旋转矩阵(下面的矩阵 1)需要 sin 和 cos,看起来并不能帮我们解决这个问题。 不过,我们可以把矩阵除以 cos θ;这看起来更没用,因为矩阵 (2) 现在需要 tan,而它正是我们想求的东西。(而且向量的长度还会变大。) 但 CORDIC 的关键在于使用特殊角度 αn = arctan(2-n)。 把其中一个特殊角度代入矩阵,就得到矩阵 (3),它在硬件上很容易计算:乘以 2 的幂只需移位。
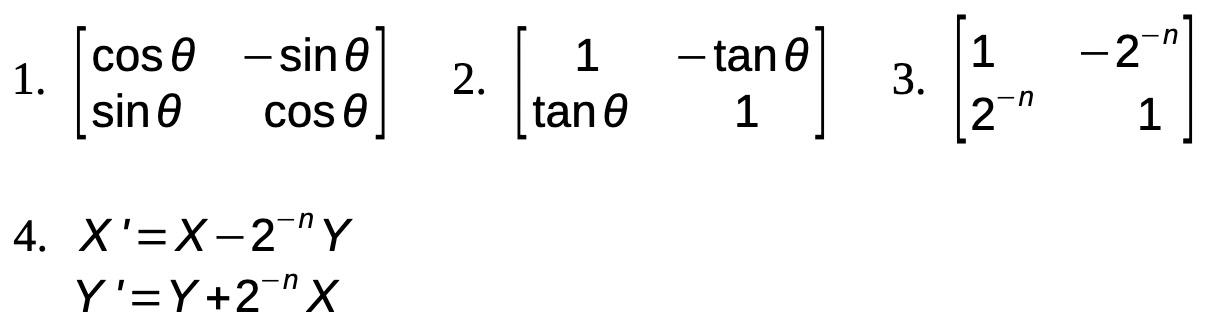 化简旋转矩阵。
把矩阵 (3) 作用于点 (X,Y),就得到公式 (4)。 这是 CORDIC 过程中的关键公式。 重要的是,这些公式在机器语言或硬件中计算起来又快又简单,因为只涉及加法、减法和二进制移位。
有了这些铺垫,就能看清 CORDIC 是怎么工作的了。 首先,把想要的目标角度拆成若干个特殊角度之和,使其总和等于目标角度。5 然后从单位向量 (1, 0) 出发,对每个特殊角度套用上面的旋转公式。结果就是位于目标角度上的点 (X, Y),于是所求的正切值就是 Y/X。6 由于特殊角度表是预先算好的,arctan 运算不会拖慢整个过程。 顺带一提,从第几项之后开始,特殊角度就趋近于 2-n, 也就是说每一步大约缩小一半。
总之,CORDIC 算法就是反复遍历一张存好的角度表。 如果表里的角度比目标角度小,就用目标角度减去它,得到新的目标角度,再套用上面那几步(移位、加、减)得到新的向量。 最后,原角度的正切值由 Y/X 给出。
有理多项式近似
CORDIC 的精度取决于用了多少项。16 项时精度约为 2-16,也就是 16 位精度。 要拿到 64 位精度,就得算 64 项(还要配一张 64 个特殊角度的表)。 为了更快出结果,8087 用 16 位的 CORDIC,把剩下的角度交给另一套算法。 (所谓剩下的角度,就是 CORDIC 各特殊角度之和与目标角度的差,非常小,约 2-16。)
对这部分剩余角度,8087 用的是 Padé 近似,也就是两个多项式的比值。 Padé 近似按多项式次数构成一整个家族。 8087 用的是一条简单的式子:3x/(3-x2)。8 这条近似虽然简单,但在小值上非常准,误差与 x4 成正比。 Since _x tmpA stores the argument in tmpA
#1040 stackPtr-- check whether there is space on the stack to push the result
#1041 stack overflow?
#1042 if tmp is null/special/overflow/divide, jump to #1022 to exit; exit if the argument is invalid or the stack overflows
#1043 if tmpA:tag is ZERO, jump to #1045; is the argument 0?
#1044 except:precision precision exception, except for 0
#1045 expconst 0x3ff0 test whether the exponent is >= -16
#1046 adder: tmpA:exp + 0 cin=1 argument exponent + 1
#1047 expConst -> Breg
#1048 adder: sumreg:frac - Breg cin=1 subtract -15
#1049 if adder is positive, jump to #1061 CORDIC; if the exponent is >= -16
#1050 expconst 0x3fff non-CORDIC path:
#1051 tmpA:exp -> Breg check the original exponent
#1052 expConst -> tmpB:frac compare with exponent 0
#1053 adder: tmpB:frac - Breg cin=1 subtract
#1054 sumreg:frac -> expConv 3fff - exp (i.e., -exp unbiased)
#1055 sumreg:frac -> shiftcount
#1056 if exponent[6:14] != 0, jump to #1082; if exp > -64, go to the rational approximation
#1057 high bits -> tmpB:frac otherwise return the original argument
#1058 expConst -> tmpB:sign,exp push 1 for X (denominator): the result is the original angle
#1059 tmpB -> st(0)
#1060 RNI
#1061 expconst 0x0010 CORDIC path
#1062 sumreg:frac -> loopcounter loopcounter = exp + 16
#1063 tmpA:frac -> tmpC tmpC = original angle
#1064 trig const -> Breg/rnd
#1065 adder: tmpC - Breg cin=1, roundmode subtract the first CORDIC angle
#1066 adder sign -> cordic, shl save the bit to the shift register
#1067 if adder is not positive, jump to #1079
#1068 sumreg:frac,rnd -> tmpC
#1069 adder: tmpA:exp + 0 cin=1 if the first angle was used, increment exp
#1070 sumreg:frac -> tmpA:exp
#1071 jump to #1079
#1072 shift tmpC L 0 bytes, 1 bit top of the CORDIC scan loop
#1073 shift L -> tmpC shift the angle left
#1074 trig const -> Breg/rnd
#1075 adder: tmpC - Breg cin=1, roundmode subtract the CORDIC angle
#1076 adder sign -> cordic, shl save the decision bit to the shift register
#1077 if adder is not positive, jump to #1079
#1078 sumreg:frac,rnd -> tmpC
#1079 if const latch is zero, jump to #1072 bottom of the CORDIC scan loop
#1080 tmpC -> tmpA:frac update tmpA, tmpB
#1081 expConst -> shiftcount 16 -> shiftcount (otherwise based on the exponent)
#1082 tmpA:frac -> tmpB:frac Padé approximation
#1083 tmpA:frac -> Breg tmpA = ang
#1084 call SQUARE to square the angle
#1085 shift sumreg:frac R count byte bit
#1086 shift R -> sumreg:frac shift twice to scale the squared value
#1087 shift sumreg:frac R count byte bit
#1088 shift R -> Breg Breg = ang^2
#1089 1.1 -> tmpB:frac 3 (exponent is 1)
#1090 adder: tmpB:frac - Breg cin=0
#1091 sumreg:frac -> tmpB:frac tmpB (X) = 3-ang^2
#1092 shift tmpA:frac R 0 bytes, 1 bit
#1093 shift R -> Breg/rnd
#1094 adder: tmpA:frac + Breg cin=0, roundmode ang + ang/2
#1095 sumreg:sign,frac,rnd -> tmpC tmpC (Y) = 3×ang and the corresponding exponent
#1096 expconst 0x3ff0 exponent -15
#1097 expConst -> Breg
#1098 adder: tmpA:exp - Breg cin=1

#1099 若加数位置无效则跳转至 #1118;指数过小时跳过
#1100 将 tmpC 右移 0 字节、1 位,CORDIC 伪乘法路径
#1101 #15 -> 循环计数器
#1102 将 R 移位至 tmpC
#1103 若 cordic[0] 为假则跳转至 #1113,CORDIC:若保存的判定位……
#1104 将 tmpC 右移循环计数位,把 tmpC(Y)送入移位器
#1105 tmpC -> Breg/rnd,将 tmpC 送入加法器
#1106 加法器:tmpB:frac + Breg,cin=0,舍入模式,tmpB(X)不移位,因为 tmpC 已缩放
#1107 sumreg:sign,frac,rnd -> tmpC,tmpC = tmpC + tmpB(隐含 >>n)
#1108 将 R 移位至 sumreg:frac,rnd,把旧的 tmpC 移位后送入 sumreg
#1109 将 sumreg:frac,rnd 右移循环计数位,再次右移,因为 tmpC 已缩放
#1110 将 R 移位至 Breg/rnd 并送入 B 寄存器
#1111 加法器:tmpB:frac - Breg,cin=1,舍入模式
#1112 sumreg:frac,rnd -> tmpB:frac,tmpB = tmpB - tmpC>>n
#1113 cordic 右移,移出移位寄存器位
#1114 将 tmpC 右移 0 字节、1 位,开始移位 tmpC(Y)
#1115 若 cordic==0 则跳转至 #1118,移位寄存器为空则完成
#1116 将 R 移位至 tmpC,将 tmpC(Y)右移
#1117 若常量锁存器不为零则跳转至 #1103,计数器为零则完成
#1118 expconst 0x3fff,CORDIC 完成
#1119 tmpB:frac -> sumreg:frac,测试 tmpB(X)的最高位
#1120 若寄存器第 63 位为 1 则跳转至 #1124,若置位,使用指数 0
#1121 expconst 0x3ffe,否则使用指数 -1 并
#1122 将 sumreg:frac 左移 0 字节、1 位,左移一位以规格化
#1123 将左移结果送入 tmpB:frac
#1124 expConst -> tmpB:sign,exp,将指数存入 tmpB
#1125 tmpC -> tmpA:frac,将 tmpC(Y)存入 tmpA
#1126 tmpC -> sumreg:frac,sign
#1127 若 sumreg[64] 为假则跳转至 #1132,测试溢出位
#1128 将 tmpC 右移 0 字节、1 位,若置位,通过右移规格化
#1129 将右移结果送入 tmpA:frac
#1130 加法器:tmpA:exp + 0,cin=1,将指数加 1
#1131 sumreg:frac -> tmpA:exp
#1132 tmpB -> st(0),将 tmpB 压入栈顶:X(分母)
#1133 stackPtr++
#1134 tmpA -> st(0),将 tmpA 存入 st(1):Y(分子)
#1135 stackPtr--
#1136 RNI,FPTAN 结束
FPTAN 微码从地址 #1039(十进制)开始。
微码首先把参数从栈顶移到 tmpA 寄存器。
如果栈顶为空,说明发生了栈下溢。如果栈上的下一个元素
(也就是将要存放结果的位置)不为空,说明发生了栈上溢。
无论哪种情况,微码都会抛出 "invalid" 异常并结束该指令。
8087 的一个奇特之处在于,只要结果不精确,它就会将结果标记为
"precision" 异常。(这种情况非常频繁,哪怕算的是 1/10 这样的值。)
8087 能精确计算的唯一正切值是 tan(0),因此其他所有输入
都会导致 precision 异常(#1044)。
接下来,测试参数的指数,执行流程由此分成三条路径。
如果指数小于等于 -64,参数就小到在系统精度范围内
正切值等于参数本身。13
这种情况下(#1057),原参数原样返回(同时压入分母 1),代码结束。
第二种情况是指数小于等于 -17。此时跳过
CORDIC 步骤,例程直接跳到有理逼近(#1082)。
CORDIC 伪除法
最有趣的是 CORDIC 路径(#1061),当指数介于 -1 和 -16 之间时走这条路径。
从概念上讲,代码执行 16 步 CORDIC,使用 16 个预先存储的角度。
不过代码经过了优化,对较小的输入会跳过较大的角度。
具体来说,循环计数器根据输入角度的指数来初始化(#1062)。
CORDIC 伪除法循环(#1061-#1080)逐个测试角度,减去那些不太大的角度。14
判定结果记录在一个 16 位移位寄存器中,位于芯片最右侧。 大概是因为那里的布局正好有未使用的空间。 由于移位寄存器是串行加载和卸载的,它不需要访问 内部小数总线,只需要两条线来移入和移出比特,因此移位 寄存器可以放在原本闲置的空间里。
代码经过优化,采用64位整数运算而非浮点运算。这使代码难以理解,因为其中的值更像是带有隐含指数的定点数。这些指数并不存储在任何地方,但可以通过分析算法来确定。就连ROM中的角度常量也没有显式指数。15 此外,为了保持精度,隐含指数在循环的每一步都会变化。粗略地说,循环每执行一轮,值就缩小为原来的二分之一,角度常量也随之相应缩小。如果这些值采用固定指数,最终会出现16个前导零,白白浪费精度。但通过每轮对数值进行缩放(左移),数字就能继续充分利用全部64位。换句话说,硬件执行的是快速整数运算,但在数学上,你可以把它看作带有指数的定点运算,只不过这些指数在芯片中并不实际存在。关于隐含指数在循环中如何变化,详见脚注中的表格16。
有理多项式近似
在CORDIC伪除法循环之后,微代码计算有理多项式近似(#1082)。小角度路径在此处重新汇入执行流。用于计算多项式近似的微代码有几个有趣的特点。最耗时的部分是SQUARE例程,它将一个定点数自乘。乘法比较复杂,我将在后续文章中详细介绍。但简而言之,8087使用Booth算法,每次乘两位(基数为4),因此速度是普通二进制乘法的两倍。执行移位和加法的循环由硬件实现,而非微代码。也就是说,一条微代码指令执行32次加法:硬件检测各位、执行相应的加法或减法、更新循环计数器,然后循环。为了提高性能,移位由专用移位器完成,而不是8087的通用移位器。
除平方外,多项式的计算用的是加法而非乘法。常数 3 并非来自常数 ROM,而是来自专用晶体管,它们把有效数的最高两位置位;这通常用来提供一个 NaN。(若隐含指数为 1,则对应 3。)减去平方后得到分子。分母则把角度右移(即除以 2)再与自身相加。这相当于乘以 3(严格说是乘以 1.5,但把隐含指数提到 1 就变成了 3)。用分子除以分母代价太高;于是分子和分母直接作为后续 CORDIC 步骤的初始 Y 和 X 值。
CORDIC 伪乘法
接下来是 CORDIC 循环,旋转施加到向量(#1100)上。旋转的施加顺序与第一步中计算它们的顺序相反:先施加最小的旋转以保证精度。移位寄存器逐位输出,指示该次旋转是否施加。一旦移位寄存器全为零,循环即停止。换句话说,较小的角度只经过循环几次,而不是完整的 16 次。
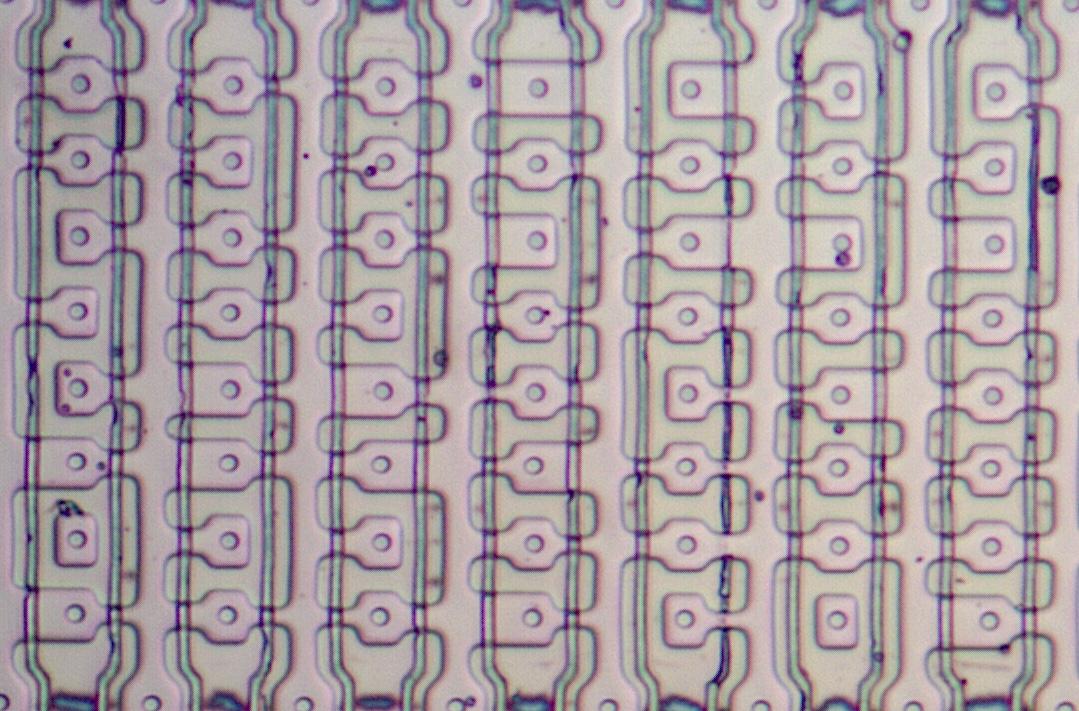 显微镜下的微码 ROM 特写。垂直多晶硅线与掺杂硅(粉色)相交处形成一个晶体管。8087 的 ROM 很不寻常:它使用四种晶体管尺寸,因此每个晶体管存储两位,密度是普通 ROM 的两倍。
旋转通过移位和加法(或减法)施加,但跟踪隐含指数有点棘手。由于向量起始时几乎水平,X 值约为 3,Y 值约为 2-16。随着向量旋转,X 大致保持为 3,而 Y 每次可能增大一倍。为了让每个数都获得最大精度,X 的指数(tmpB)为 1,而 Y 的指数(tmpC)从 -14 开始,每循环一次随着 Y 右移而加 1。(记住这些指数并不存储在任何地方,而是隐含的。)由于两个寄存器的(隐含)指数不同,相加前必须先移位。移位量并不直观;脚注中的表16或许有助于说明。
CORDIC 循环结束后,代码的最后一部分(#1118)对 X 和 Y 的值做规格化,生成指令返回的浮点数。注意此时它们还不是“真正的”浮点数,因此可能需要调整。具体来说,如果 X 没有前导 1,就左移一位;如果 Y 有两位前导数字,就右移一位。无论哪种情况,指数都要相应调整。X 和 Y 的值被压入栈(#1132),指令到此完成。
结论
就 8087 指令而言,FPTAN 指令相当慢,这是因为它本身复杂。文档给出的典型值是 450 个时钟周期。(耗时范围很大,视具体数值而定,可能在 30 到 540 个时钟周期之间。)对我考察的那个值(0.95)来说,33% 的时间花在 CORDIC 伪除法上,15% 花在有理多项式上(主要是平方运算),47% 花在 CORDIC 伪乘法上,还有 5% 是额外开销。
CORDIC 是计算三角函数的一种流行方法,但并非唯一选择,多项式等方法同样可行。8087 的特别之处在于它把 CORDIC 和有理多项式结合了起来。到了 Pentium,Intel 从 CORDIC 转向了多项式近似;Pentium 的快速乘法电路让多项式变得实用。如今 Intel 有 MKL(Math Kernel Library)和 Short Vector Math Library(SVML)这类库,提供针对 Intel 硬件深度优化的实现。据说这些库使用多项式近似,靠并行指令(SIMD)而非专用硬件来提升性能。有了这些库,x87 运算和 80 位浮点数基本已经过时。尽管如此,希望你喜欢这次对 8087 一个原始算法的剖析。
我打算继续逆向 8087 的微代码;想跟进进展,可以在 Bluesky(@righto.com)、Mastodon(@[email protected])或 RSS 上关注我。这项工作是和“Opcode Collective”的成员一起做的,尤其是 Smartest Blob 和 Gloriouscow,他们把 ROM 镜像转换成微代码数据,并对内容做了大量分析。更多内容见 GitHub 上的 8087 仓库。
AI 声明:尽管文中出现了破折号,本文写作过程中没有使用 AI(详情)。Opcode Collective 使用了一种机器学习算法对每个 ROM 单元进行分类,以提取微代码。
注释与参考文献
- 如果你想进一步了解 8087,以下是我此前写过的 8087 文章列表,由新到旧:
每个晶体管两位:Intel 8087 浮点芯片中的高密度 ROM
走进 Intel 8087 协处理器芯片的裸片,现代浮点运算的源头
↩ 2. Intel 的文档 给出了 8087 与在 8086 上模拟浮点运算的性能对比。 加速幅度因指令而异,但通常接近 100 倍。 这一加速让 8087 芯片在 CAD、电子表格等数值应用中极受欢迎。 ↩ 3. 在内部,8087 用 80 位保存浮点值:1 位符号, 15 位指数,64 位有效数。 不过,8087 还额外用了三个低位用于舍入,分别称为 Guard、Round 和 Sticky。这些位确保数值总是朝正确的方向舍入。 数据通路的某些部分还有额外的位用于符号或溢出:移位器宽 68 位,加法器宽 69 位。 大多数情况下,我会忽略这些额外的位,把数据通路称为 64 位宽。 ↩ 4. 要从 8087 的 X 和 Y 值计算 sin θ,常用公式 是 sin θ = Y/sqrt(X2+Y2);cos θ 类似。 ↩ 5. 这些特殊角(以度为单位)大约是 45°、26.6°、14°、7.1°、3.6°、1.8°、0.9°…… 你可能会想,把所有特殊角加起来是否总能收敛到 目标角 θ。 证明见这里。 注意 arctan(2-n) 会迅速趋近 2-n(以弧度计),所以它有点 像二进制分数表示,每次都把差距大致减半。 ↩ 6. 8087 中的 CORDIC 实现与 CORDIC 的典型用法有些不同,后者求的是 sin 和 cos。 在这种做法中,所有特殊角都会被用到,但每一步要么加上一个角,要么减去一个角, 最终收敛到目标角。 回想一下,由于矩阵在每一步都被 1/sin αi 缩放,最终 向量不再是单位向量。因此,cos 和 sin 并不对应 最终向量 (X, Y)。 诀窍在于,如果所有特殊角都被用到,总的缩放因子 最终是相同的,就是所有 cos αi 因子的乘积。 (旋转是正还是负无关紧要,因为 cos αi = cos -αi。) 于是,总的缩放因子可以预先算好,初始单位向量可以 按这个量预先缩放。 结果就是最终向量 (X, Y) 直接给出 (cos θ, sin θ),这正是我们 想要的。 关键在于,CORDIC 有两种做法:使用正角和负角, 或者使用或省略某些角。(前一种情况把每个角乘以 +1 或 -1,后一种情况 把每个角乘以 1 或 0。)大多数 CORDIC 实现采用 第一种做法,而 8087 采用第二种。 ↩ 7. CORDIC 的发明者 Jack Volder 写过一篇文章, The Birth of CORDIC,详细讲述了这段历史,还 附有 B-58 导航计算机的照片。 Volder 1959 年的原始文章是 The CORDIC Computing Technique 和 The CORDIC Trigonometric Computing Technique。
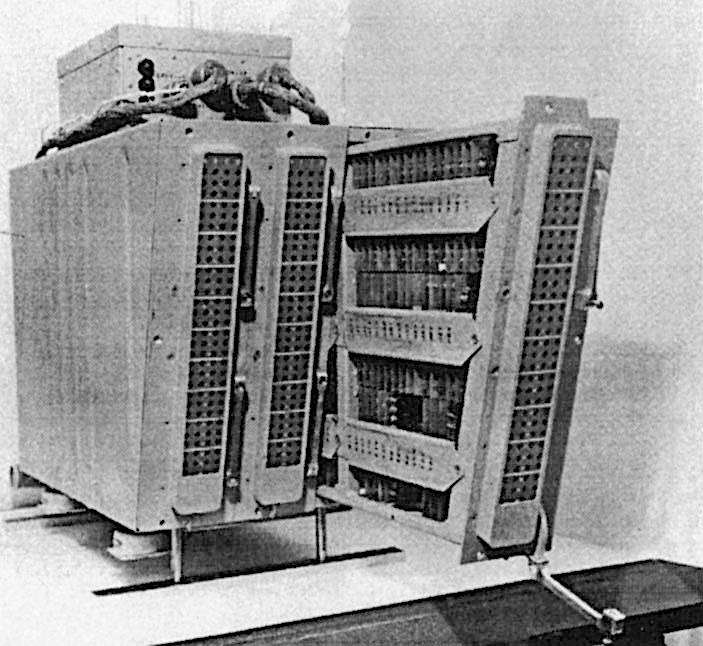 CORDIC-II 数字计算机系统。照片由 General Dynamics 拍摄,出自《The Birth of CORDIC》。
上图是用于 B-58 轰炸机的 CORDIC II 计算机。它是一台 30 位串行计算机,运行频率为 198.4 kHz,重达 134 磅。
它采用二极管-晶体管逻辑(DTL)门实现,使用了 2498 个晶体管和 4265 个二极管,并配有磁鼓存储器(顶部可见)用于存储,容量相当于 39 KB。
有意思的是,CORDIC 运算被实现为指令集中的基本指令,而不是子程序;一条 CORDIC 指令耗时 5 ms,与乘法或除法速度相同。 ↩
8. 这个 Padé 近似被称为 [1,2] 近似,因为分子是一阶多项式,分母是二阶多项式。
Padé 近似可以从 tan 的连分数展开推导出来。
参见 Constructing Padé Approximates。
顺便说一句,如果你学过微积分,可能会觉得泰勒级数是逼近函数的好方法。
可惜泰勒级数只适合在一点附近逼近函数,在一个区间上表现很差。
更好的做法是使用在区间上最小化最大误差的多项式,就像 Pentium 那样。 ↩
9. 8087 的算法在 Implementation of transcendental functions on a numerics processor 中有描述,作者是 Rafi Nave,他领导了 8087 的硬件设计。 ↩
10.
FPTAN 的有效参数范围文档中记为 _0
来源: righto.com← 返回首页