老式Intel 8087の正接アルゴリズムをリバースエンジニアリングする:CORDICだけではない
Ken ShirriffがIntel 8087のFPTAN命令を分解:CORDICだけでなく、角度が小さい場合は単純な有理多項式近似に切り替え、誤差と除算を個別に処理する代償がある。
日本語
コピー
8087 にはもう飽き飽きしているかもしれないが、また Intel の浮動小数点チップについて書いてしまった。1
1980 年、Intel は 8087 を発表し、IBM PC やその他のシステムでの浮動小数点演算を大幅に高速化した。
本稿で見ていくのは、このチップの正接命令の背後にあるアルゴリズムだ。
三角関数の計算には CORDIC と呼ばれる定番の手法がある。
もう一つは多項式近似だ。8087 はこの二つを組み合わせ、高い精度と高い性能を同時に手に入れた。
8086 マイクロプロセッサと比べたときの 8087 の高速化は目覚ましい。正接を 1 回計算するのに 13,000 マイクロ秒ではなく 90 マイクロ秒で済む。2
8087 の回路とマイクロコードを調べることで、正接命令の背後にあるアルゴリズムを説明できる。この命令は FPTAN と呼ばれている。
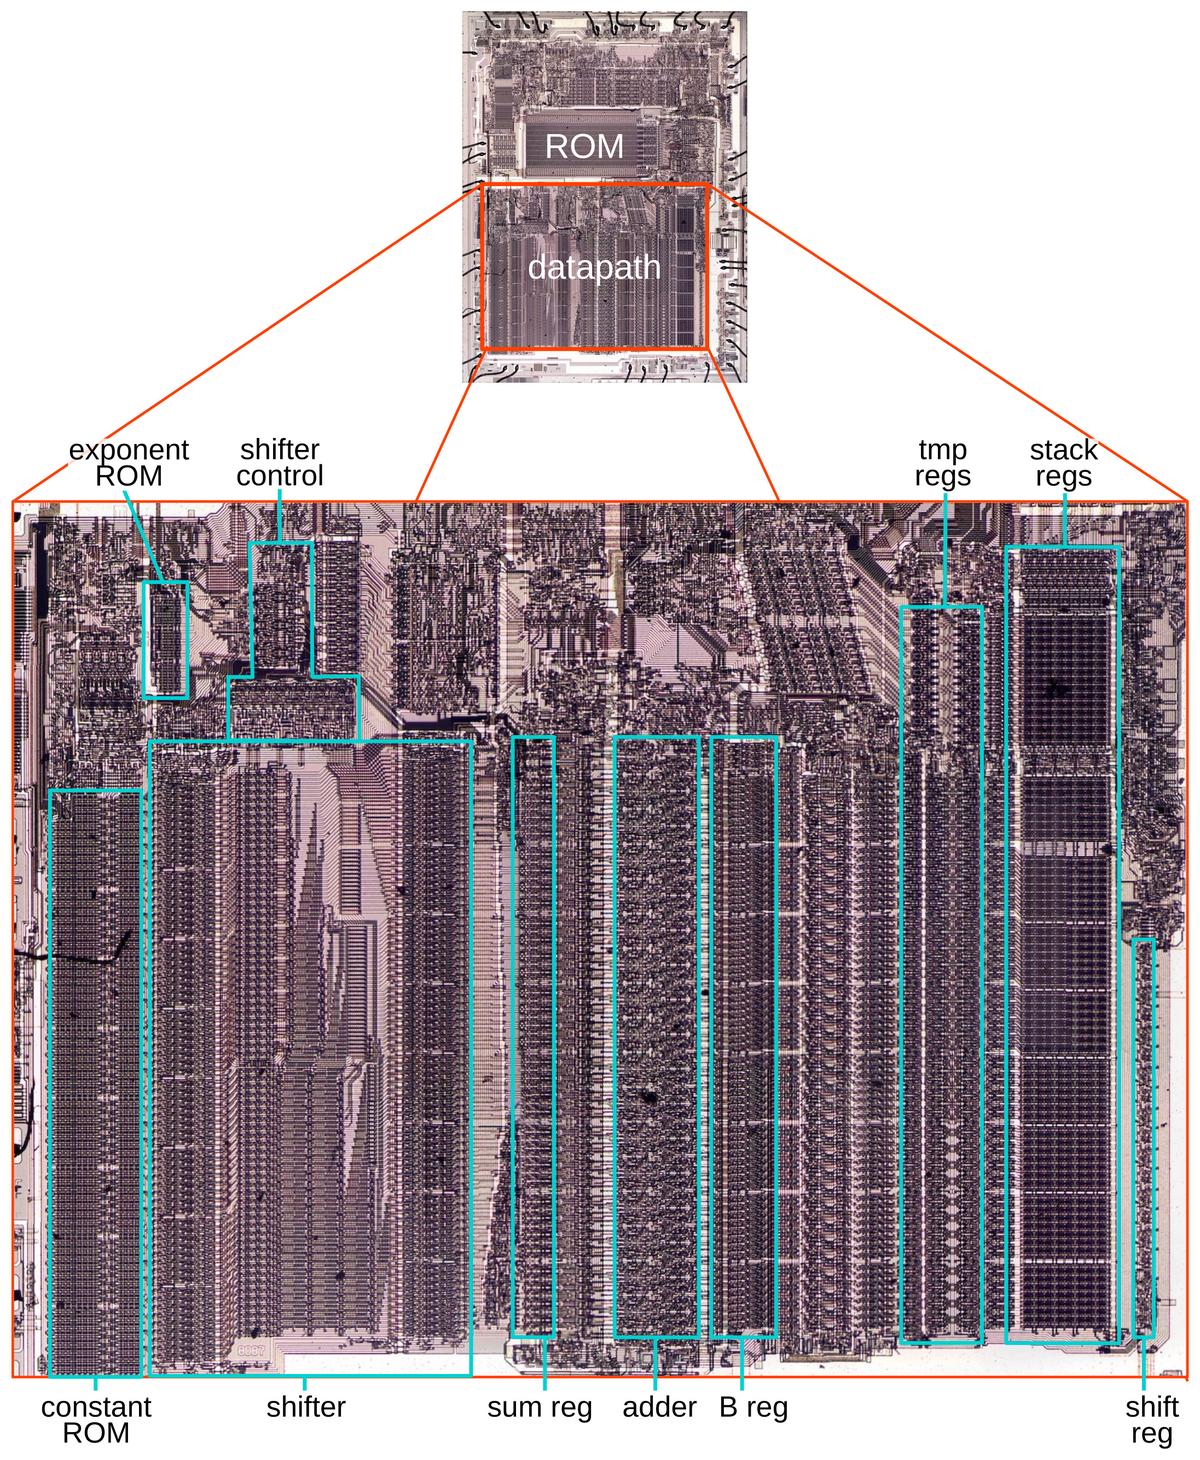
8087 の回路を見るために、チップの頂部を鑿でこじ開け、顕微鏡で高解像度の画像を撮影した。
マイクロコード ROM はチップ中央にある巨大な矩形領域で、チップ全体を制御する 1648 個のマイクロ命令が格納されている。
チップ下半分(赤枠)はデータパス、つまり 80 ビットの数値に対する浮動小数点計算を行う回路だ。3
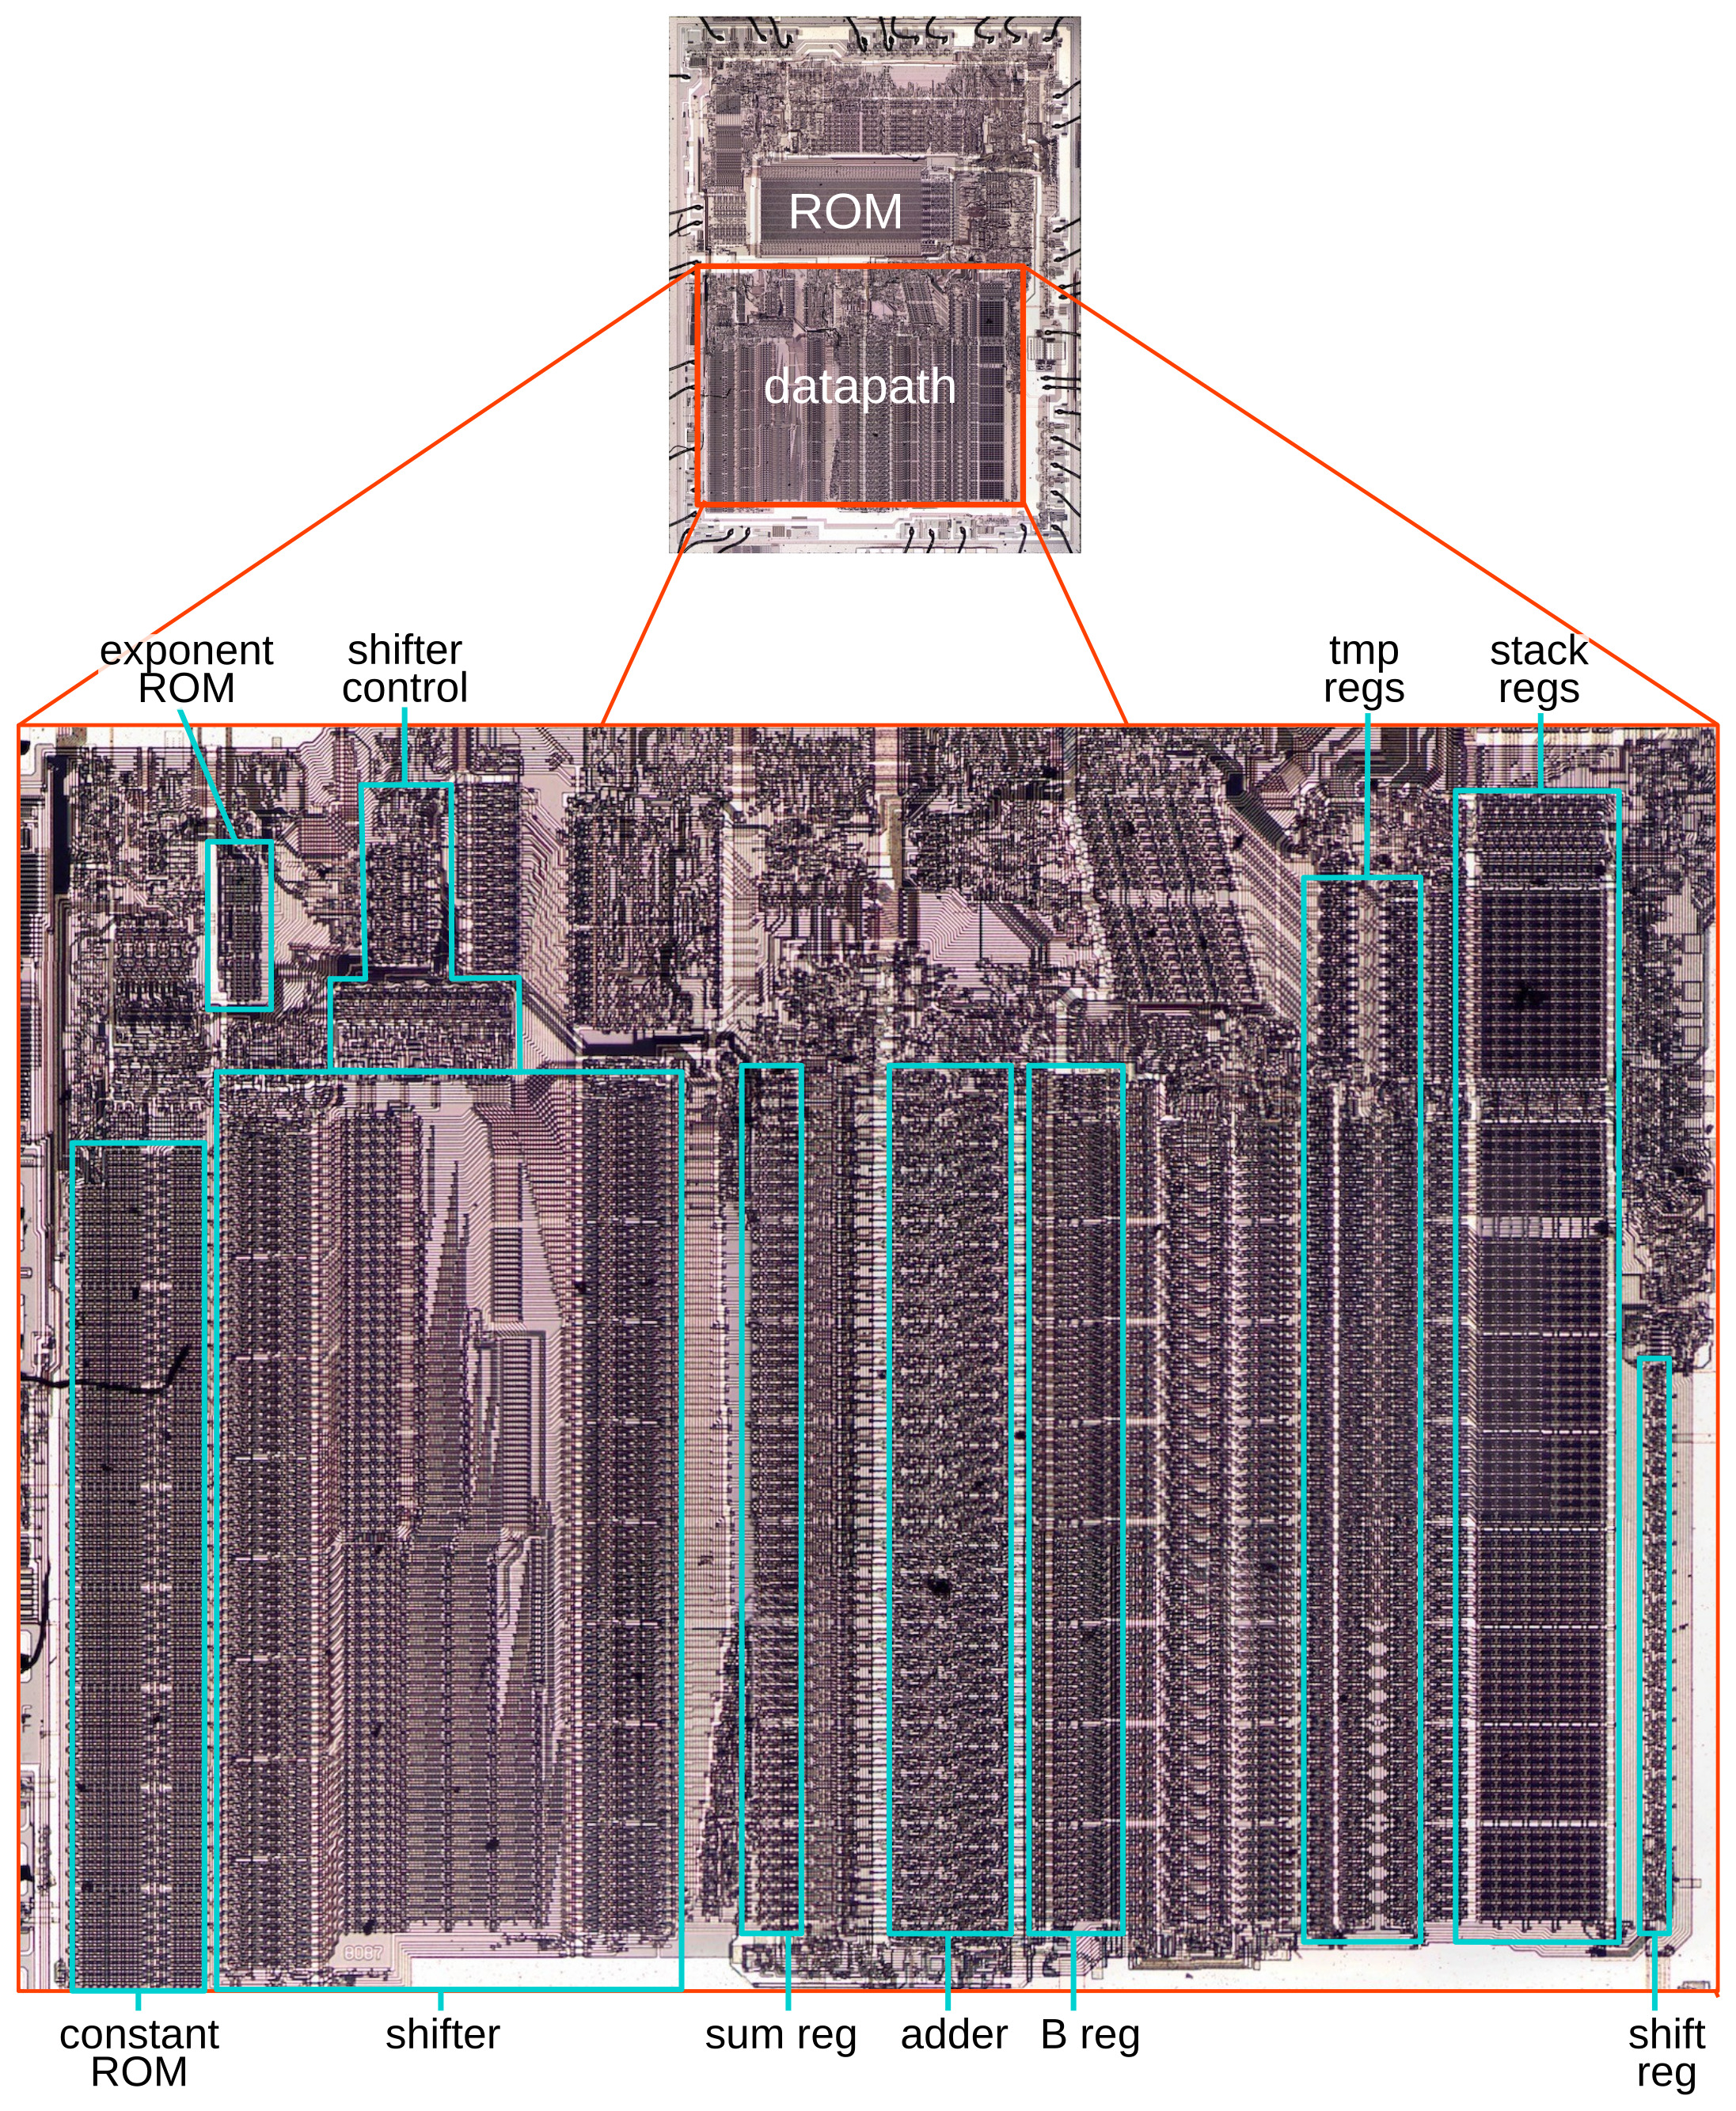 8087 のデータパスの拡大図。
FPTAN で使われる各機能ブロックを示している。この画像(または任意の画像)をクリックすると拡大表示できる。
データパスを拡大すると、関連する機能ユニットが見えてくる。 指数 ROM には、アルゴリズムに必要な固定の指数値が格納されている。 定数 ROM には各種の定数が格納されており、その中には CORDIC アルゴリズムで使う定数も含まれる。 シフタは大きな部品で、64 ビットの値を任意のビット数だけ左または右にシフトできる。 加算器は 8087 の計算の中心だ。加減算だけでなく、ループの中で乗算、除算、平方根の計算にも使われる。 B レジスタは加算器の一方の入力を持ち、もう一方の入力は複数のソースから来ることができる。和レジスタは加算器の出力を保持する。 8 個のスタックレジスタと若干の一時レジスタが浮動小数点数を保持する。 最後に、シフトレジスタが CORDIC 計算に必要な 16 ビットの状態を保持する。
CORDIC アルゴリズム
CORDIC は、超越関数を簡単なハードウェアで高速に計算できる巧妙なアルゴリズムだ。シフトと加算命令、そして表引きしか使わず、乗算も除算も必要としない。 このアルゴリズムは 1956 年にさかのぼる。当時、Mach 2 で飛べる最初の爆撃機である B-58 Hustler のために開発された。 この機体にはアナログ航法コンピュータが搭載されていたが、アナログ素子の精度には限界があった。 エンジニアの Jack Volder は、アナログコンピュータを置き換えるデジタルコンピュータを設計する任務を与えられた。7 一つの大きな問題は、アナログコンピュータなら resolver と呼ばれる電気機械装置を使って正弦と余弦を簡単に生成できることだった。 しかし三角関数をデジタルで生成するのは難しく、ましてやトランジスタがまだ遅かった時代にはなおさらだった。
[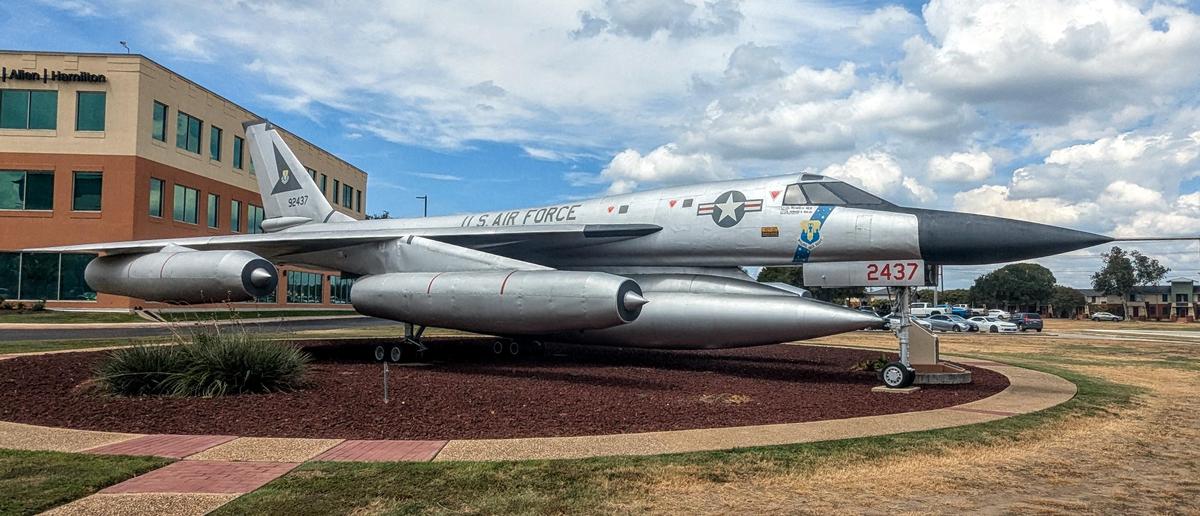 ](https://static.righto.com/images/8087-fptan/b58.jpg)テキサス州サンアントニオに展示されている Convair B-58A Hustler(詳細)。
Jack Volder は、三角関数を簡単なハードウェアで高速に計算する方法を考え出した。 彼はこのアルゴリズム、そしてそれを実装したコンピュータを CORDIC と名付けた。「COordinate Rotation DIgital Computer」(座標回転デジタル計算機)の略だ。 CORDIC は角度をベクトルに変換し、そのベクトルの座標が求める三角関数の値を与える。 鍵となるのは、角度を一連の特殊な角度に分解することだ。これらの角度を使えば、ベクトルの回転が容易になる。 特殊な角度はあらかじめ計算されて表に格納されているため、CORDIC の計算は 1950 年代のハードウェアでも高速に実行できる。 CORDIC の各反復は精度を 1 ビットずつ増やすので、アルゴリズムは速く収束する。こうして CORDIC は広まり、関数電卓にも使われた。それらの電卓は二進ではなく十進の CORDIC を使っていた。
三角関数の話
数学はなるべく少なく抑えるつもりだが、この節では CORDIC の仕組みを簡単に説明しておく。 以下の図は、三角関数と点の座標の関係を思い出させてくれる。 角度 θ があり、それが単位円上の点 (X, Y) に対応するとしよう。 基本の式は X=cos θ、Y=sin θ、Y/X = tan θ だ。 つまり座標 (X, Y) さえ決まれば、三角関数の値も決まる。 点が単位円上にない場合、例えば (X', Y') であっても、tan θ は簡単に求められる。(先に言ってしまうと、8087 はまさにそうしている。)だが sin θ と cos θ は厄介になる。4
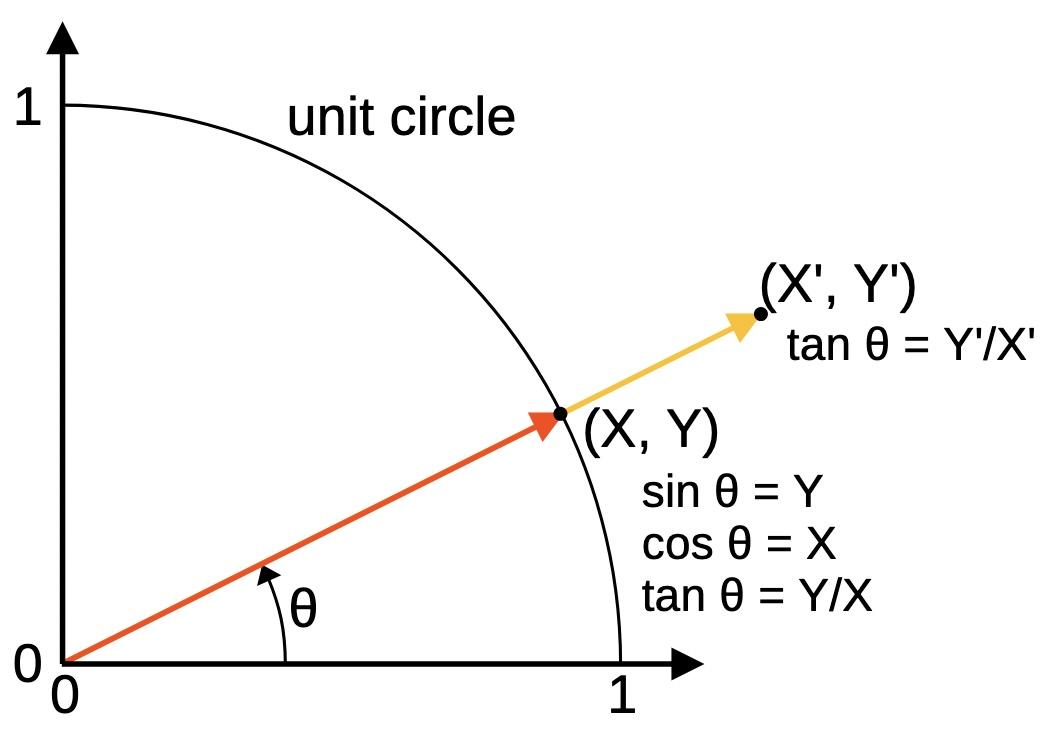 角度、X 座標と Y 座標、三角関数の関係。
コンピュータグラフィックスに触れたことがあれば、回転行列で点をある角度だけ回転させる方法をたいてい見たことがあるだろう。(回転行列に馴染みがなければこちらを見るか、動くと信じて先に進んでほしい。) 点 (X, Y) に回転行列を掛けると、次のように新しい点 (X', Y') が得られる。
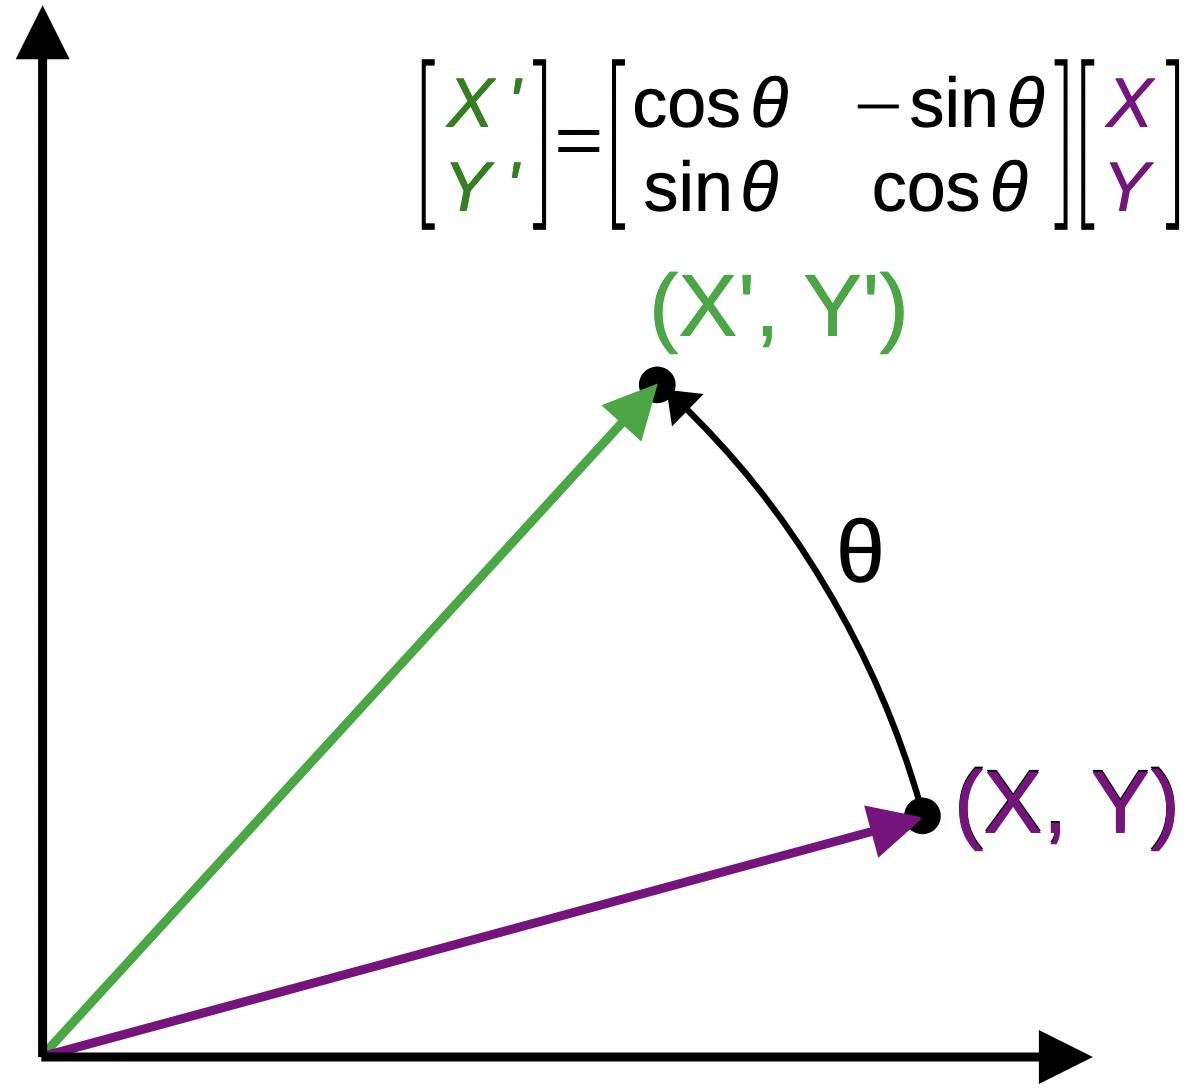 回転行列を使えば点を回転できる。
残念ながら、回転行列(下の行列 1)には sin と cos が必要で、これでは問題の解決には使えそうにない。 だが、行列を cos θ で割ることはできる。余計に役立たなそうに見える。行列 (2) には tan が必要になり、それはまさに求めたいものだからだ。(しかもベクトルの長さも大きくなる。) しかし CORDIC の要点は、特殊な角度 αn = arctan(2-n) を使うことにある。 特殊角度の一つを行列に代入すると行列 (3) が得られ、これはハードウェアで容易に計算できる。2 の冪の乗算はシフトするだけで済む。
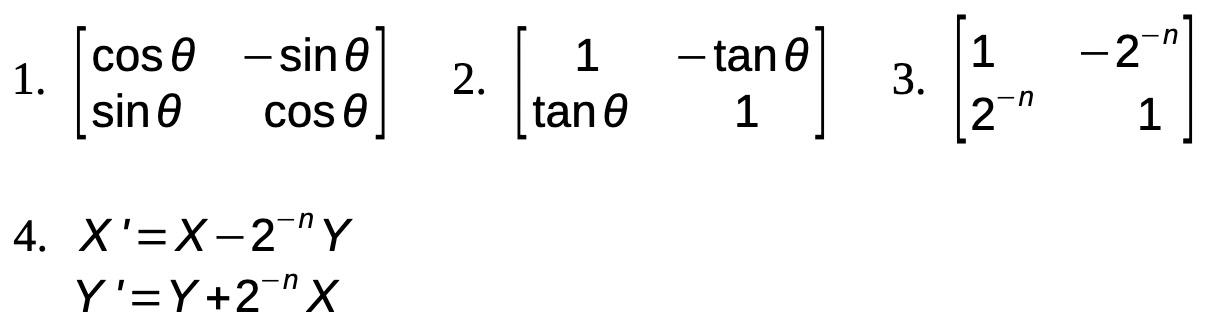 回転行列を簡略化する。
行列 (3) を点 (X,Y) に作用させると式 (4) が得られる。 これが CORDIC の手順における鍵となる式だ。 重要なのは、これらの式が機械語やハードウェアで高速かつ簡単に計算できることだ。加算、減算、二進シフトしか含まないからである。
ここまでくれば、CORDIC がどう動くかが見えてくる。 まず、目標とする角度をいくつかの特殊角度の和に分解し、その総和が目標角度と等しくなるようにする。5 次に単位ベクトル (1, 0) から出発し、各特殊角度について上の回転式を適用する。結果は目標角度上にある点 (X, Y) となり、求める正接は Y/X である。6 特殊角度の表はあらかじめ計算されているので、arctan の演算が全体を遅くすることはない。 ちなみに、何項目か以降では特殊角度は 2-n に近づく。 つまり各ステップでおよそ半分ずつ小さくなる。
要するに、CORDIC アルゴリズムは記憶した角度の表を反復して処理する。 記憶した角度が目標角度より小さければ、目標角度から記憶した角度を引いて新しい目標角度を得て、上記の演算(シフト、加算、減算)を適用して新しいベクトルを得る。 最終的に、元の角度の正接は Y/X で与えられる。
有理多項式近似
CORDIC の精度は使用する項数に依存する。16 項では精度は約 2-16、すなわち 16 ビットの精度である。 64 ビットの精度を得るには、64 項を計算しなければならない(64 個の特殊角度の表も必要)。 より速く結果を得るために、8087 は 16 ビットの CORDIC を使い、残りの角度には別のアルゴリズムを適用する。 (残りの角度とは、CORDIC の特殊角度の総和と目標角度との差であり、非常に小さい。約 2-16 である。)
残りの角度に対して、8087 は Padé 近似、すなわち 2 つの多項式の比を使う。 Padé 近似には多項式の次数に応じて一族全体が存在する。 8087 は単純な式 3x/(3-x2) を使う。8 この近似は単純だが、小さい値に対して非常に正確である。誤差は x4 に比例する。 _x tmpA は引数を tmpA に格納するので
#1040 stackPtr-- check whether there is space on the stack to push the result
#1041 stack overflow?
#1042 if tmp is null/special/overflow/divide, jump to #1022 to exit; exit if the argument is invalid or the stack overflows
#1043 if tmpA:tag is ZERO, jump to #1045; is the argument 0?
#1044 except:precision precision exception, except for 0
#1045 expconst 0x3ff0 test whether the exponent is >= -16
#1046 adder: tmpA:exp + 0 cin=1 argument exponent + 1
#1047 expConst -> Breg
#1048 adder: sumreg:frac - Breg cin=1 subtract -15
#1049 if adder is positive, jump to #1061 CORDIC; if the exponent is >= -16
#1050 expconst 0x3fff non-CORDIC path:
#1051 tmpA:exp -> Breg check the original exponent
#1052 expConst -> tmpB:frac compare with exponent 0
#1053 adder: tmpB:frac - Breg cin=1 subtract
#1054 sumreg:frac -> expConv 3fff - exp (i.e., -exp unbiased)
#1055 sumreg:frac -> shiftcount
#1056 if exponent[6:14] != 0, jump to #1082; if exp > -64, go to the rational approximation
#1057 high bits -> tmpB:frac otherwise return the original argument
#1058 expConst -> tmpB:sign,exp push 1 for X (denominator): the result is the original angle
#1059 tmpB -> st(0)
#1060 RNI
#1061 expconst 0x0010 CORDIC path
#1062 sumreg:frac -> loopcounter loopcounter = exp + 16
#1063 tmpA:frac -> tmpC tmpC = original angle
#1064 trig const -> Breg/rnd
#1065 adder: tmpC - Breg cin=1, roundmode subtract the first CORDIC angle
#1066 adder sign -> cordic, shl save the bit to the shift register
#1067 if adder is not positive, jump to #1079
#1068 sumreg:frac,rnd -> tmpC
#1069 adder: tmpA:exp + 0 cin=1 if the first angle was used, increment exp
#1070 sumreg:frac -> tmpA:exp
#1071 jump to #1079
#1072 shift tmpC L 0 bytes, 1 bit top of the CORDIC scan loop
#1073 shift L -> tmpC shift the angle left
#1074 trig const -> Breg/rnd
#1075 adder: tmpC - Breg cin=1, roundmode subtract the CORDIC angle
#1076 adder sign -> cordic, shl save the decision bit to the shift register
#1077 if adder is not positive, jump to #1079
#1078 sumreg:frac,rnd -> tmpC
#1079 if const latch is zero, jump to #1072 bottom of the CORDIC scan loop
#1080 tmpC -> tmpA:frac update tmpA, tmpB
#1081 expConst -> shiftcount 16 -> shiftcount (otherwise based on the exponent)
#1082 tmpA:frac -> tmpB:frac Padé approximation
#1083 tmpA:frac -> Breg tmpA = ang
#1084 call SQUARE to square the angle
#1085 shift sumreg:frac R count byte bit
#1086 shift R -> sumreg:frac shift twice to scale the squared value
#1087 shift sumreg:frac R count byte bit
#1088 shift R -> Breg Breg = ang^2
#1089 1.1 -> tmpB:frac 3 (exponent is 1)
#1090 adder: tmpB:frac - Breg cin=0
#1091 sumreg:frac -> tmpB:frac tmpB (X) = 3-ang^2
#1092 shift tmpA:frac R 0 bytes, 1 bit
#1093 shift R -> Breg/rnd
#1094 adder: tmpA:frac + Breg cin=0, roundmode ang + ang/2
#1095 sumreg:sign,frac,rnd -> tmpC tmpC (Y) = 3×ang and the corresponding exponent
#1096 expconst 0x3ff0 exponent -15
#1097 expConst -> Breg
#1098 adder: tmpA:exp - Breg cin=1

#1099 若加数位置无效则跳转至 #1118;指数过小时跳过
#1100 将 tmpC 右移 0 字节、1 位,CORDIC 伪乘法路径
#1101 #15 -> 循环计数器
#1102 将 R 移位至 tmpC
#1103 若 cordic[0] 为假则跳转至 #1113,CORDIC:若保存的判定位……
#1104 将 tmpC 右移循环计数位,把 tmpC(Y)送入移位器
#1105 tmpC -> Breg/rnd,将 tmpC 送入加法器
#1106 加法器:tmpB:frac + Breg,cin=0,舍入模式,tmpB(X)不移位,因为 tmpC 已缩放
#1107 sumreg:sign,frac,rnd -> tmpC,tmpC = tmpC + tmpB(隐含 >>n)
#1108 将 R 移位至 sumreg:frac,rnd,把旧的 tmpC 移位后送入 sumreg
#1109 将 sumreg:frac,rnd 右移循环计数位,再次右移,因为 tmpC 已缩放
#1110 将 R 移位至 Breg/rnd 并送入 B 寄存器
#1111 加法器:tmpB:frac - Breg,cin=1,舍入模式
#1112 sumreg:frac,rnd -> tmpB:frac,tmpB = tmpB - tmpC>>n
#1113 cordic 右移,移出移位寄存器位
#1114 将 tmpC 右移 0 字节、1 位,开始移位 tmpC(Y)
#1115 若 cordic==0 则跳转至 #1118,移位寄存器为空则完成
#1116 将 R 移位至 tmpC,将 tmpC(Y)右移
#1117 若常量锁存器不为零则跳转至 #1103,计数器为零则完成
#1118 expconst 0x3fff,CORDIC 完成
#1119 tmpB:frac -> sumreg:frac,测试 tmpB(X)的最高位
#1120 若寄存器第 63 位为 1 则跳转至 #1124,若置位,使用指数 0
#1121 expconst 0x3ffe,否则使用指数 -1 并
#1122 将 sumreg:frac 左移 0 字节、1 位,左移一位以规格化
#1123 将左移结果送入 tmpB:frac
#1124 expConst -> tmpB:sign,exp,将指数存入 tmpB
#1125 tmpC -> tmpA:frac,将 tmpC(Y)存入 tmpA
#1126 tmpC -> sumreg:frac,sign
#1127 若 sumreg[64] 为假则跳转至 #1132,测试溢出位
#1128 将 tmpC 右移 0 字节、1 位,若置位,通过右移规格化
#1129 将右移结果送入 tmpA:frac
#1130 加法器:tmpA:exp + 0,cin=1,将指数加 1
#1131 sumreg:frac -> tmpA:exp
#1132 tmpB -> st(0),将 tmpB 压入栈顶:X(分母)
#1133 stackPtr++
#1134 tmpA -> st(0),将 tmpA 存入 st(1):Y(分子)
#1135 stackPtr--
#1136 RNI,FPTAN 结束
FPTAN マイクロコードはアドレス #1039(十進)から始まる。
マイクロコードはまず引数をスタックトップから tmpA レジスタに移す。
スタックトップが空なら、スタックアンダーフローが発生している。スタック上の次の要素
(つまり結果を格納する位置)が空でなければ、スタックオーバーフローが発生している。
いずれの場合も、マイクロコードは "invalid" 例外を発生させ、この命令を終了する。
8087 の変わった点のひとつは、結果が正確でなければ必ず "precision" 例外を立てることだ。(1/10 のような値でも頻繁に起こる。)8087 が正確に計算できる正接は tan(0) だけで、それ以外の入力はすべて precision 例外になる(#1044)。
次に引数の指数を調べ、実行はここで三つの経路に分かれる。指数が -64 以下なら、引数はシステム精度の範囲で正接が引数自身に等しくなるほど小さい。13 この場合(#1057)、元の引数をそのまま返し(分母に 1 をプッシュする)、コードは終了する。二つ目は指数が -17 以下の場合。ここでは CORDIC のステップを飛ばし、ルーチンは有理近似へ直接ジャンプする(#1082)。
CORDIC 擬似除算
最も面白いのは CORDIC 経路(#1061)で、指数が -1 から -16 の間にあるときに通る。概念的には、コードは 16 個のあらかじめ格納された角度を使って 16 ステップの CORDIC を実行する。ただしコードは最適化されていて、小さい入力では大きい角度を飛ばす。具体的には、ループカウンタは入力角度の指数に応じて初期化される(#1062)。CORDIC 擬似除算ループ(#1061-#1080)は角度を一つずつ調べ、大きすぎないものを引いていく。14
判定結果はチップの最も右にある 16 ビットのシフトレジスタに記録される。おそらくそこのレイアウトにちょうど未使用のスペースがあったからだろう。シフトレジスタはシリアルにロード・アンロードされるため、内部の小数バスにアクセスする必要がなく、ビットを出し入れするのに 2 本の線があれば済む。だからシフトレジスタは本来遊んでいるスペースに置ける。
コードは浮動小数点ではなく 64 ビット整数演算を使うよう最適化されている。これがコードを分かりにくくしている。値は暗黙の指数を持つ固定小数点数のようなものだからだ。その指数はどこにも格納されていないが、アルゴリズムを分析すれば求められる。ROM 内の角度定数にも明示的な指数はない。15 さらに精度を保つため、暗黙の指数はループの各ステップで変化する。おおざっぱに言えば、ループが 1 周するごとに値は半分になり、角度定数もそれに合わせて小さくなる。値が固定指数なら、最終的に先頭に 16 個のゼロが並び、精度を無駄にすることになる。しかし毎回値をスケーリング(左シフト)することで、数値は 64 ビットを引き続き余すところなく使える。つまりハードウェアは高速な整数演算を実行しているが、数学的には指数付きの固定小数点演算と見なせる。ただしその指数はチップ上に実在しない。ループ中で暗黙の指数がどう変わるかは脚注の表を参照。16
有理多項式近似
CORDIC 擬似除算ループの後、マイクロコードは有理多項式近似を計算する(#1082)。小角度経路はここで実行フローに合流する。多項式近似を計算するマイクロコードにはいくつか興味深い特徴がある。最も時間がかかるのはSQUAREルーチンで、固定小数点数を自乗する。乗算は複雑なので、後の記事で詳しく扱う。手短に言えば、8087 は Booth のアルゴリズムを使い、一度に 2 ビット(基数 4)を掛けるので、通常の二進乗算の 2 倍速い。シフトと加算のループはマイクロコードではなくハードウェアで実装されている。つまり、1 命令のマイクロコードが 32 回の加算を実行する。ハードウェアが各ビットを検出し、対応する加算または減算を行い、ループカウンタを更新して、またループする。性能のため、シフトは 8087 の汎用シフタではなく専用のシフタで行われる。
自乗以外に、多項式の計算は乗算ではなく加算で行われる。定数 3 は定数 ROM からではなく、専用のトランジスタから来ている。それらは有効数の上位 2 ビットをセットする。通常は NaN を提供するために使われる。(暗黙の指数が 1 なら 3 に対応する。)自乗を引くと分子が得られる。分母は角度を右シフト(つまり 2 で割る)して自分自身に加える。これは 3 を掛けることに等しい(厳密には 1.5 倍だが、暗黙の指数を 1 に上げれば 3 になる)。分子を分母で割るのはコストが高すぎる。そこで分子と分母はそのまま後続の CORDIC ステップの初期 Y 値と X 値として使われる。
CORDIC 擬似乗算
次は CORDIC ループで、回転がベクトルに適用される(#1100)。回転は最初のステップで計算した順序とは逆に適用する。精度を保つため、最も小さい回転から先に適用する。シフトレジスタがビットを 1 つずつ出力し、その回転を適用するかどうかを示す。シフトレジスタがすべてゼロになるとループは止まる。つまり、小さい角度ではループを数回しか回らず、16 回全部は回らない。
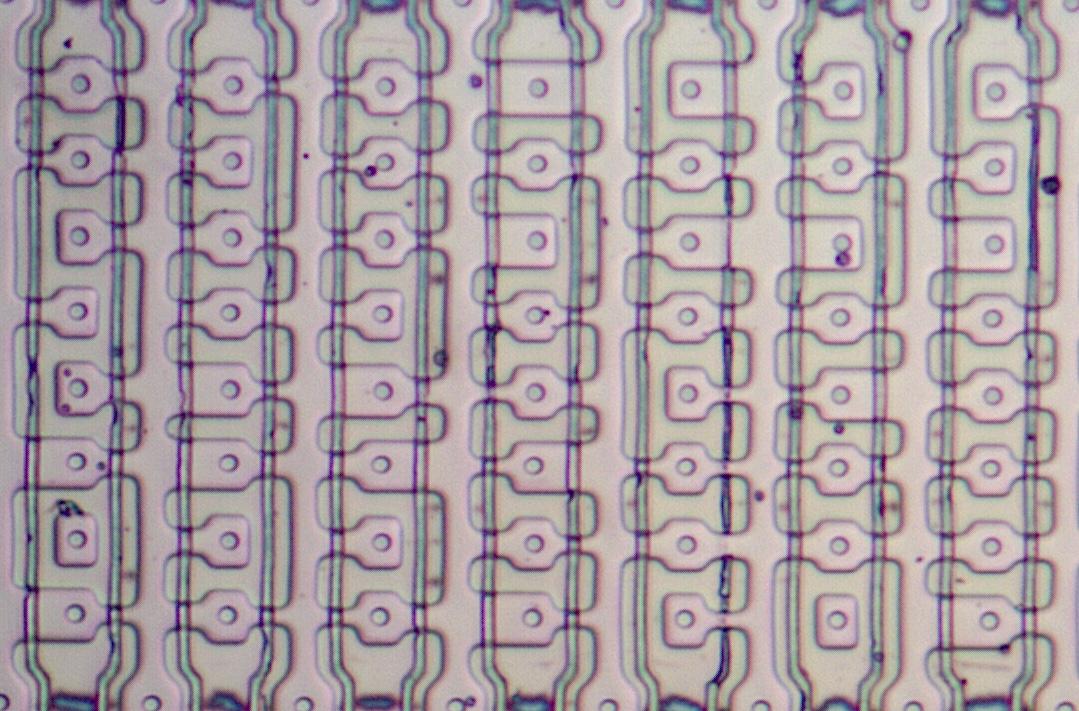 顕微鏡下のマイクロコード ROM のクローズアップ。垂直なポリシリコン線とドープされたシリコン(ピンク)が交わる点が 1 個のトランジスタを形成する。8087 の ROM は珍しく、4 種類のトランジスタサイズを使うので 1 個のトランジスタが 2 ビットを記憶し、通常の ROM の 2 倍の密度になる。
回転はシフトと加算(または減算)で適用されるが、暗黙の指数を追うのが少し厄介だ。ベクトルはほぼ水平から始まるので、X 値は約 3、Y 値は約 2-16 である。ベクトルが回転するにつれて X はほぼ 3 のままだが、Y は 1 回ごとに倍になりうる。各数が最大の精度を得るように、X の指数(tmpB)は 1、Y の指数(tmpC)は -14 から始まり、ループごとに Y を右シフトするのに合わせて 1 ずつ増える。(これらの指数はどこにも格納されておらず、暗黙であることを思い出してほしい。)二つのレジスタの(暗黙の)指数が異なるため、加算の前にシフトが必要になる。シフト量は直感的ではない。脚注の表16が理解の助けになるだろう。
CORDIC のループが終わると、コードの最後の部分(#1118)が X と Y の値を正規化し、命令が返す浮動小数点数を生成する。この時点ではまだ「本物の」浮動小数点数ではないため、調整が必要になることがある。具体的には、X に先頭の 1 がなければ 1 ビット左シフトし、Y に先頭の数字が 2 桁あれば 1 ビット右シフトする。どちらの場合も指数をそれに合わせて調整する。X と Y の値はスタックにプッシュされ(#1132)、命令はここで完了する。
結論
8087 の命令の中では、FPTAN はかなり遅い。命令自体が複雑だからだ。ドキュメントに記載されている典型値は 450 クロックサイクル。(所要時間の幅は大きく、値によって 30 から 540 クロックサイクルの間で変動する。)私が調べた値(0.95)では、33% の時間が CORDIC の擬似除算に、15% が有理多項式に(主に二乗演算)、47% が CORDIC の擬似乗算に、残りの 5% がオーバーヘッドに費やされていた。
CORDIC は三角関数を計算する一般的な手法だが、唯一の選択肢ではない。多項式などの方法でも同じことができる。8087 が特殊なのは、CORDIC と有理多項式を組み合わせている点だ。Pentium の時代になると、Intel は CORDIC から多項式近似へと舵を切った。Pentium の高速乗算回路が多項式を実用的にしたのだ。現在の Intel には MKL(Math Kernel Library)や Short Vector Math Library(SVML)といったライブラリがあり、Intel ハードウェア向けに深く最適化された実装を提供している。これらのライブラリは多項式近似を使い、専用ハードウェアではなく並列命令(SIMD)で性能を引き上げていると言われている。こうしたライブラリの登場で、x87 演算と 80 ビット浮動小数点数はほぼ過去のものになった。それでも、8087 の原始的なアルゴリズムを今回解剖できたことを楽しんでもらえたなら幸いだ。
私は 8087 のマイクロコードのリバースエンジニアリングを続けるつもりだ。進捗を追いたければ、Bluesky(@righto.com)、Mastodon(@[email protected])、または RSS でフォローしてほしい。この作業は「Opcode Collective」のメンバー、特に Smartest Blob と Gloriouscow とともに行った。彼らは ROM イメージをマイクロコードデータに変換し、内容を大量に分析してくれた。詳細は GitHub の 8087 リポジトリにある。
AI に関する表明:本文にダッシュが出てくるが、執筆に AI は使っていない(詳細)。Opcode Collective はマイクロコードを抽出するため、機械学習アルゴリズムで各 ROM セルを分類している。
注釈と参考文献
- 8087 についてもっと知りたいなら、私がこれまでに書いた 8087 の記事を新しい順に挙げておく:
Intel 8087 浮動小数点チップのマイクロコード:scale 命令
Intel 8087 浮動小数点チップ内部のマイクロコード:レジスタ交換
Intel 8087 浮動小数点チップのマイクロコードにおける条件
Intel 8087 浮動小数点チップのスタック回路のリバースエンジニアリング
1 トランジスタあたり 2 ビット:Intel 8087 浮動小数点チップの高密度 ROM
Intel 8087 コプロセッサのダイへようこそ、現代の浮動小数点演算の源流
↩ 2. Intel のドキュメントには、8087 と 8086 上で浮動小数点演算をエミュレートした場合の性能比較が載っている。 高速化の度合いは命令によって異なるが、概ね 100 倍近くになる。 この高速化のおかげで 8087 チップは CAD や表計算など数値計算を伴うアプリケーションで非常に人気となった。 ↩ 3. 内部的に、8087 は浮動小数点値を 80 ビットで保持する:符号 1 ビット、 指数 15 ビット、仮数 64 ビット。 ただし 8087 は丸め用に下位 3 ビットを追加で使い、それぞれ Guard、Round、Sticky と呼ぶ。これらのビットが、値が常に正しい方向へ丸められることを保証する。 データパスの一部には符号やオーバーフロー用の追加ビットもある。シフタは 68 ビット幅、加算器は 69 ビット幅だ。 多くの場合、これらの追加ビットは無視し、データパスを 64 ビット幅と呼ぶことにする。 ↩ 4. 8087 の X と Y の値から sin θ を計算するには、よく sin θ = Y/sqrt(X2+Y2) という式を使う。cos θ も同様だ。 ↩ 5. これらの特殊角(度数法)はおよそ 45°、26.6°、14°、7.1°、3.6°、1.8°、0.9°…… すべての特殊角を足し合わせれば常に目標角 θ に 収束するのかと疑問に思うかもしれない。 証明はこちら。 なお arctan(2-n) は(ラジアンで)急速に 2-n に近づくので、これはどちらかといえば 二進小数による表現に似ており、毎回差をおよそ半分にしていく。 ↩ 6. 8087 の CORDIC 実装は、sin と cos を求める CORDIC の典型的な使い方とは少し異なる。 典型的な方法では、すべての特殊角を使うが、各ステップで角を足すか引くかのどちらかを行い、 最終的に目標角へ収束させる。 各ステップで行列が 1/sin αi でスケーリングされるため、最終的な ベクトルはもはや単位ベクトルではないことを思い出してほしい。したがって cos と sin は 最終ベクトル (X, Y) には対応しない。 コツは、すべての特殊角を使えば、総スケーリング係数が 最終的に同じ、つまりすべての cos αi 因子の積になることだ。 (回転が正でも負でも関係ない。なぜなら cos αi = cos -αi だからだ。) そこで総スケーリング係数をあらかじめ計算しておき、初期単位ベクトルを その分だけ前もってスケーリングしておく。 その結果、最終ベクトル (X, Y) が直接 (cos θ, sin θ) を与え、これがまさに 求めたいものになる。 要は、CORDIC には 2 通りのやり方がある。正の角と負の角を使うか、 ある角を使うか省略するかだ。(前者は各角に +1 か -1 を掛け、後者は 各角に 1 か 0 を掛ける。)ほとんどの CORDIC 実装は 前者を採るが、8087 は後者を採る。 ↩ 7. CORDIC の発明者 Jack Volder は The Birth of CORDIC という記事を書き、この歴史を詳しく語っている。B-58 航法コンピュータの写真も 添えられている。 Volder の 1959 年の原論文は The CORDIC Computing Technique と The CORDIC Trigonometric Computing Technique だ。
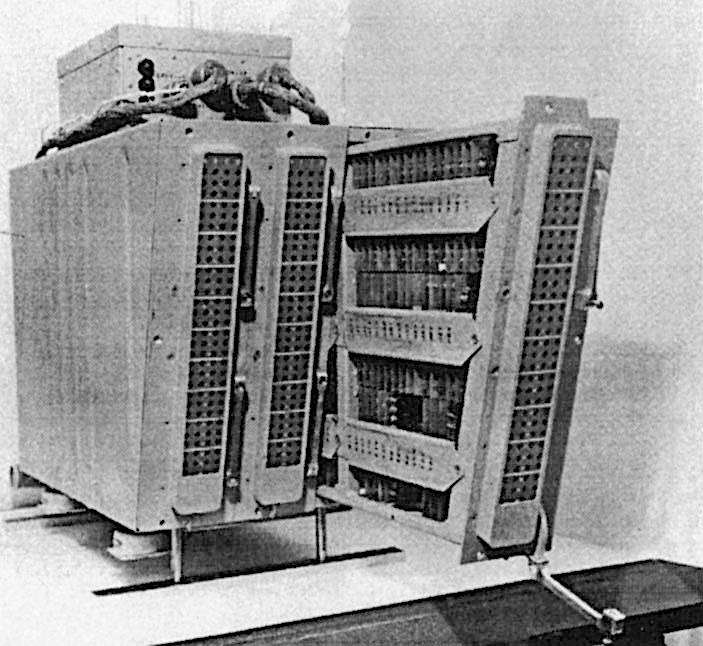 CORDIC-II デジタルコンピュータシステム。写真提供:General Dynamics、『The Birth of CORDIC』より。
上の写真は B-58 爆撃機に搭載された CORDIC II コンピュータだ。30 ビットのシリアルマシンで、動作周波数は 198.4 kHz、重量は 134 ポンド。
ダイオード・トランジスタ・ロジック(DTL)ゲートで構成され、2498 個のトランジスタと 4265 個のダイオードを使用。記憶装置には磁気ドラム(上部に見える)を備え、容量は 39 KB 相当。
興味深いのは、CORDIC 演算がサブルーチンではなく命令セットの基本命令として実装されている点だ。CORDIC 命令は 1 回 5 ms で、乗算や除算と同じ速度で済む。 ↩
8. この Padé 近似は [1,2] 近似と呼ばれる。分子が一次多項式、分母が二次多項式だからだ。
Padé 近似は tan の連分数展開から導ける。
詳しくは Constructing Padé Approximates を参照。
ちなみに、微積分を学んだ人なら、テイラー級数が関数近似の優れた方法だと習ったかもしれない。
だがテイラー級数が得意なのはある一点の周辺だけで、区間全体では精度がひどく悪い。
区間上の最大誤差を最小化する多項式を使うほうがよい。Pentium がそうしている。 ↩
9. 8087 のアルゴリズムは Implementation of transcendental functions on a numerics processor に記述されている。著者は Rafi Nave で、8087 のハードウェア設計を率いた人物だ。 ↩
10.
FPTAN の有効な引数範囲はドキュメントでは _0 と記載されている