构建 Vault:给自托管 AI agent 的双屏终端
一块 ESP32-S3 加两块屏。OLED 显示实时状态、电子纸显示可读结果,推理留在机器上。作者记录了选硬件的三条约束、四个模式,以及那些「电气上安静」的失败,包括被 3.3V 轨烧掉的两块 OLED、违反协议的 I²C 绕行,以及 sizeof 用错缓冲区导致每次远程命令重启。
中文
复制
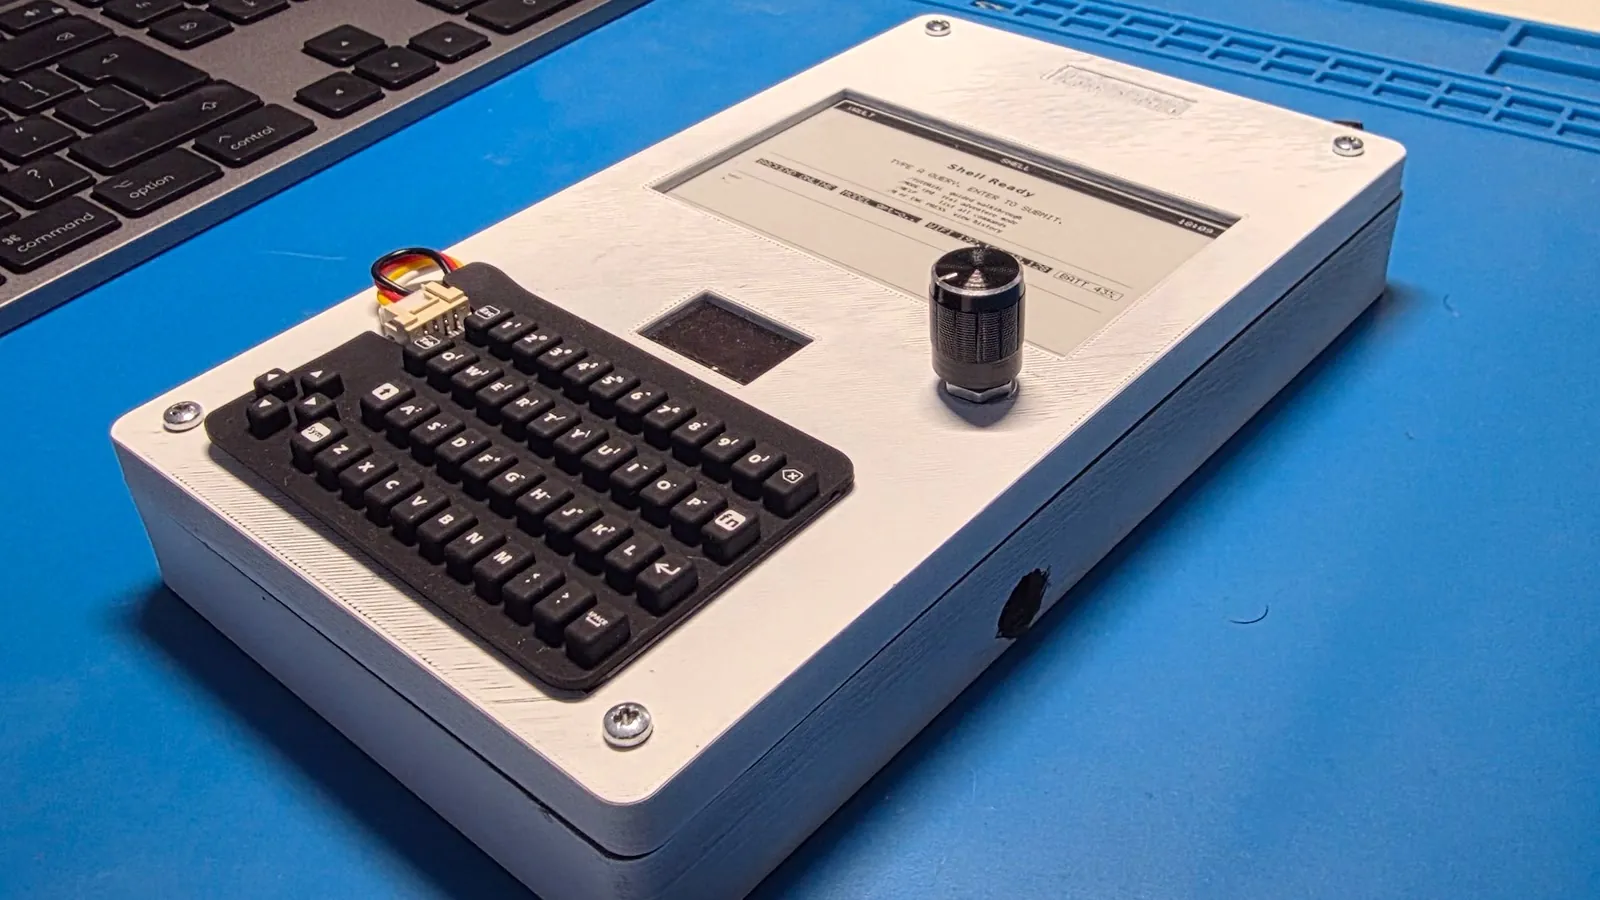
我在一个小到能用双拇指打字的键盘上输入任务:check disk space。
Vault 的电子墨水内容屏、OLED 状态屏、键盘和旋转编码器。
字符显示在一块 128×64 的 OLED 上。我按下 Enter。一个 worker 启动,4.26 英寸的电子墨水屏缓慢地完整刷新一次,显示一张静态的 Thinking... 卡片,随后 OLED 开始显示一个运行中的 OC THINK 计时器。在我网络的另一台电脑上,一个 OpenClaw agent 执行命令,并把输出整理成一份简短报告。等待期间计时器不断走动。结果就绪后,电子墨水屏再次闪烁,用答案替换掉那张卡片。较长的答案可以用旋钮翻页。就算我把这块屏的电源切断,最后一页依然可见。
这一连串动作正是 Vault 的意义所在。它是一台手持终端,配有键盘、旋转编码器、两块显示屏、一颗 ESP32-S3 和一枚 18650 电池。它是 shell,是 LLM 客户端,是自托管 agent 的前端,也是文字 RPG。它不是一台微型 Linux 电脑,也不会在单片机上跑 gpt-oss-120b。模型和 agent 运行在我局域网中的一台主机上;这台手持设备是摆在它们面前、刻意受限的仪器。
我做它,是因为许多主流 AI 界面都收敛成了同一个东西:一块发光的通用屏幕里的一个聊天气泡。我想知道,如果界面围绕阅读而非流式输出来设计,围绕一项任务而非一个 app 来设计,会发生什么。
答案是把 Vault 建立在两种显示节奏之上:OLED 追踪实时活动,电子墨水屏承载结果。
选硬件之前的三条约束
我从三条规则开始:
- 文本就是界面。 提交任务、理解结果,不需要触摸屏、app 网格或位图装饰。
- 实时状态和持久内容是两个不同的活儿。 不该把它们硬塞到同一块屏上。
- 推理不放在手持设备上。 设备应当保持响应、保持边界清晰,而模型、agent 和后端始终可替换。
这些约束决定了最终的技术栈:
| 部件 | 原型选型 | 职责 |
|---|---|---|
| MCU | ESP32-S3,双核最高 240 MHz | 输入、状态机、渲染、Wi-Fi |
| 实时显示 | SSD1306 OLED,128×64,事件驱动重绘 | 按键、模式、进度、翻页提示 |
| 内容显示 | Waveshare 4.26 英寸电子纸,800×480 | 助手、agent 与游戏输出 |
| 输入 | M5Stack CardKB 与 KY-040 编码器 | 输入文本与翻页 |
| 供电 | 18650 → TP4056 充电 → 3.3 V 升降压 | 单节电池供电 |
| 固件 | Arduino on FreeRTOS,1.45 MB flash 镜像 | 不运行通用操作系统 |
从第一块能点亮的屏幕到发布快照,共用了 67 天、131 次提交。公开发布的版本是整理并压缩后的快照。
界面有两套时钟
Vault 的两块屏幕服务于交互的不同环节,刷新速度的差异决定了各自的使用方式。
OLED 是快表面。它在输入和状态变化时重绘,显示当前模式、输入缓冲区、连接状态、主机工作时的计时器,以及回复跨多页时的提示,比如 READ 1/3 ENC>NEXT。
电子纸是慢表面。在这个版本里,全刷大约要三到四秒。局刷约 600 毫秒,代价是残影会逐渐累积。所以它不适合光标和动画,但很适合粗粒度的阶段切换和已经完成的内容。
两块屏幕的分工可以这样概括:交互频率上的事件交给 OLED,阶段变化和结果交给电子纸。
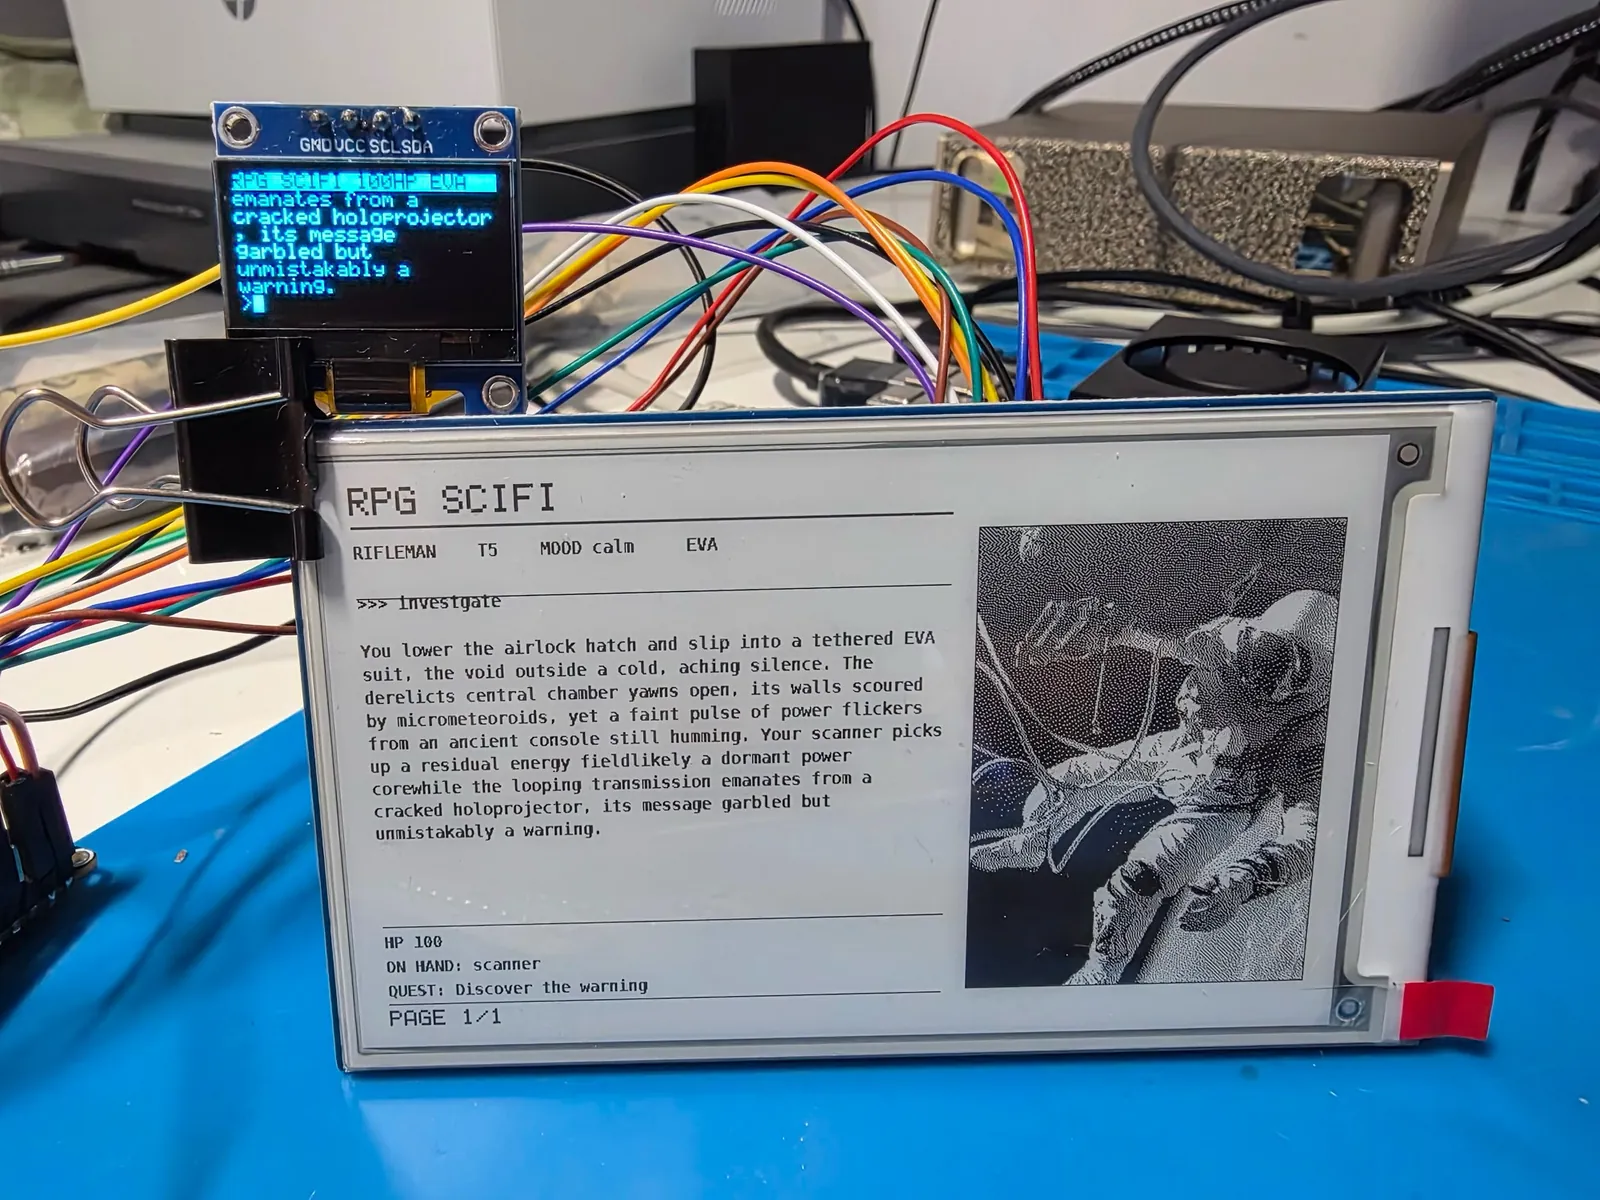
两块表面:OLED 承载实时状态,电子纸承载可阅读的结果。
对于 assist 和 control 请求,候选发布版 8(RC8,本原型所用的固件版本)会为静态的 Thinking... 状态做一次电子纸全刷,为第一页结果再做一次。连续的 RPG 回合可能使用结果局刷。在这些缓慢的切换之间,移动的计时器由 OLED 承担。翻页使用局刷,驱动在六次局刷后强制全刷一次,以清除累积的残影。为避免不必要的闪烁,固件会为每张电子纸图像计算一个轻量的 32 位指纹。如果它与上一张显示的图像一致,就跳过传输和刷新。
固件负责阅读排版。普通输出按每行 92 个字符自动换行,每页 19 行,遍历文本时不动态分配内存。旋转编码器用来翻页;如果回复有多页,按下编码器就退出阅读模式。RPG 界面的文本列更窄,因为面板另一侧要留给抖动渲染的场景。
电子墨水屏的 UI 不只是把终端内容倒上去。一套小型设计系统定义了五种文本样式、4 像素间距 token、共享分隔线、状态块与页脚,以及固定的 50% 抖动。在这种每次刷新都看得见的屏幕上,一致性很重要。
电子墨水屏刷新慢,这解释了一个在浏览器里会显得奇怪的选择:Vault 不会把模型 token 流式输出到电子墨水屏上。流式输出适合重绘成本低的屏幕。每来一个 token 或工具事件就刷新这块屏,会导致持续闪烁、残影和无谓的刷新。目前的原型仍然会闪两次,一次是阶段卡片,一次是结果,但绝不会为每个 token 或工具事件刷新。如果我只追求延迟,待处理期间我会让上一页电子墨水屏内容保持不动。我保留了静态卡片,因为它让粗略的阶段在远处也能看清。
这个区分不限于硬件。很多 AI 产品把两种信息混在同一条流里:
- 运行状态: 正在监听、正在搜索、正在调用工具、正在重试;
- 产物: 用户真正想要的回答、计划、补丁或报告。
Vault 把运行状态和用户真正想要的产物分开。状态通道可以随任务推进不断更新;完成后的回答、计划、补丁或报告则保持稳定,供人阅读和审阅。
别让模型直接碰硬件
ESP32 从不直接说模型厂商的协议。它通过 HTTP 把紧凑的 JSON 发给局域网内一台小型 Python 服务器。服务器只用标准库,有三条相关的分发路径:
/chat把一段对话发给兼容 OpenAI 的模型端点;/claw通常触发一轮 OpenClaw agent,返回它的最终回复;如果成功但回复为空,会重试一次;/rpg/*把确定性的会话状态和模型生成的叙述结合起来。
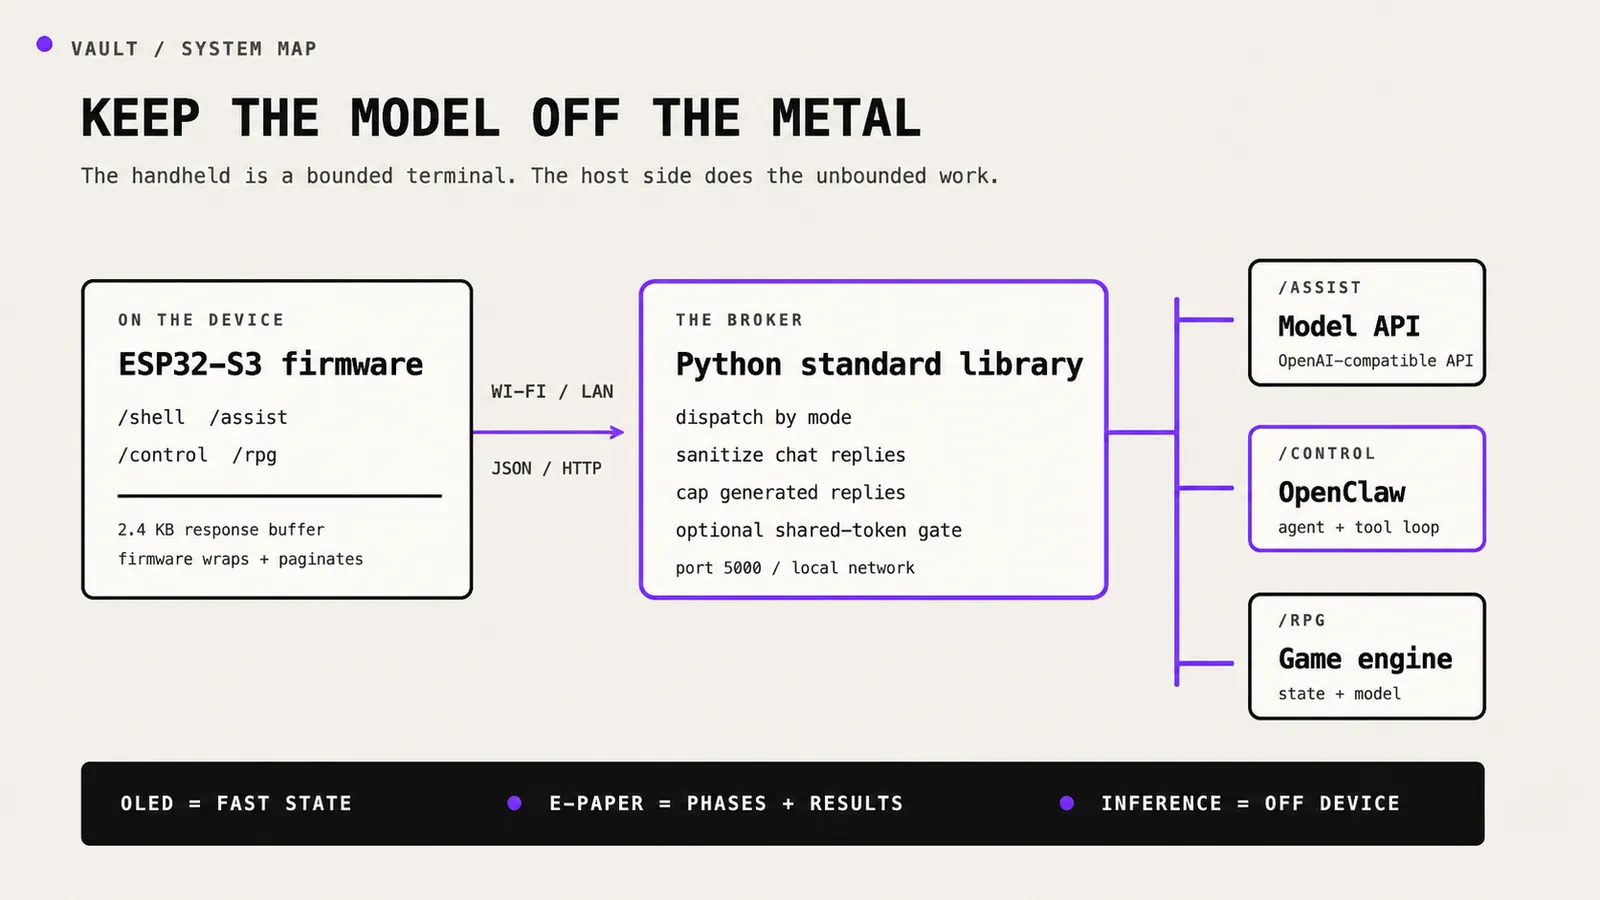
Vault 通过局域网与一个 Python broker 通信,由后者将请求分发到模型端点、OpenClaw agent 或 RPG 引擎。
生成的聊天、agent 和 RPG 回合回复上限为 1,500–2,000 个字符。/chat 路径会去除基础 Markdown。OpenClaw 和 RPG 的响应基本原样到达 Vault,包括下方可见的 Markdown 标题和代码围栏:
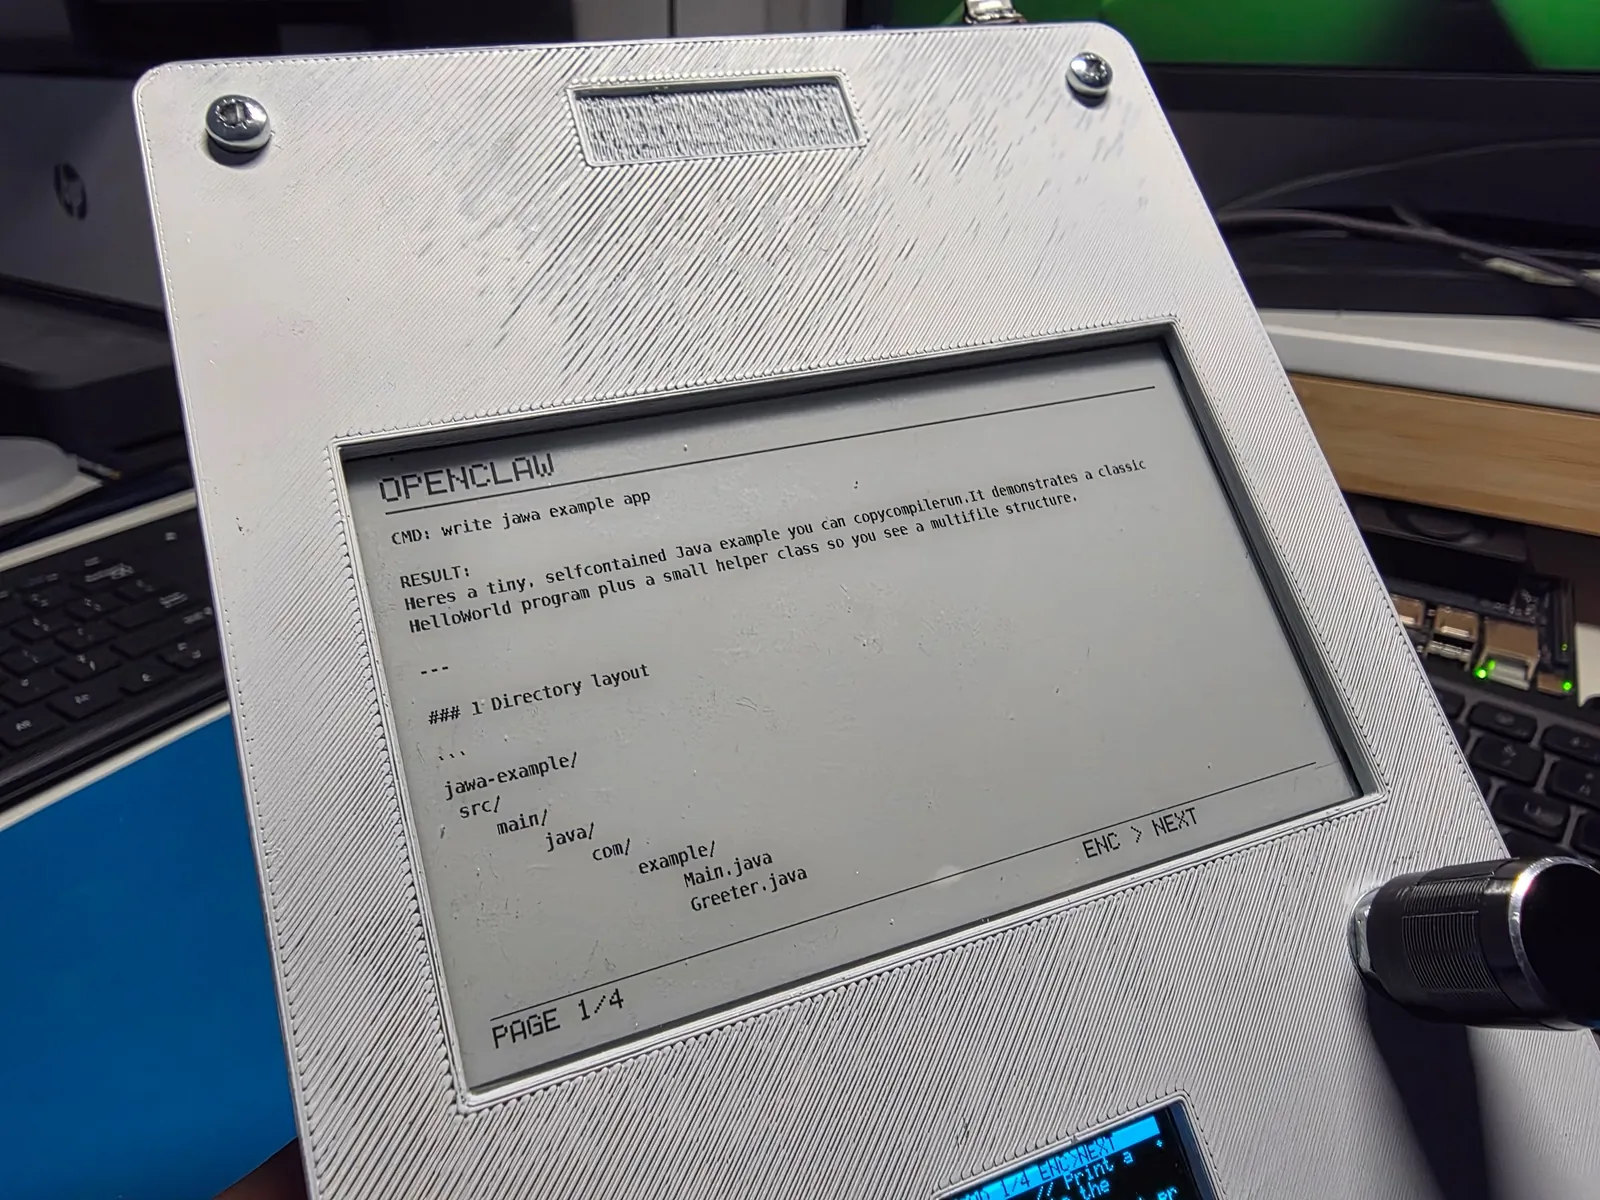
OpenClaw 结果:“write a Java example app”,在 Vault 上分页显示为四页电子纸。
HTTPClient 首先收到一个动态响应字符串;解析后的回复再被复制进 2.4 KB 的静态固件缓冲区,用于换行和分页。模型、agent 和 RPG 请求运行在 FreeRTOS worker 上,不过电子纸刷新和同步健康检查仍可能暂停主循环。
会议演示时,我在一台 NVIDIA DGX Spark 上使用 gpt-oss-120b,并通过 NVIDIA TensorRT-LLM 在本地提供服务。客户端和推理服务器期望的 OpenAI 风格请求格式不一致,于是用 LiteLLM proxy 做了适配。同一个 broker 也可以指向其他 OpenAI 兼容服务器和托管 API,但这次演示中模型推理始终留在我的局域网内。
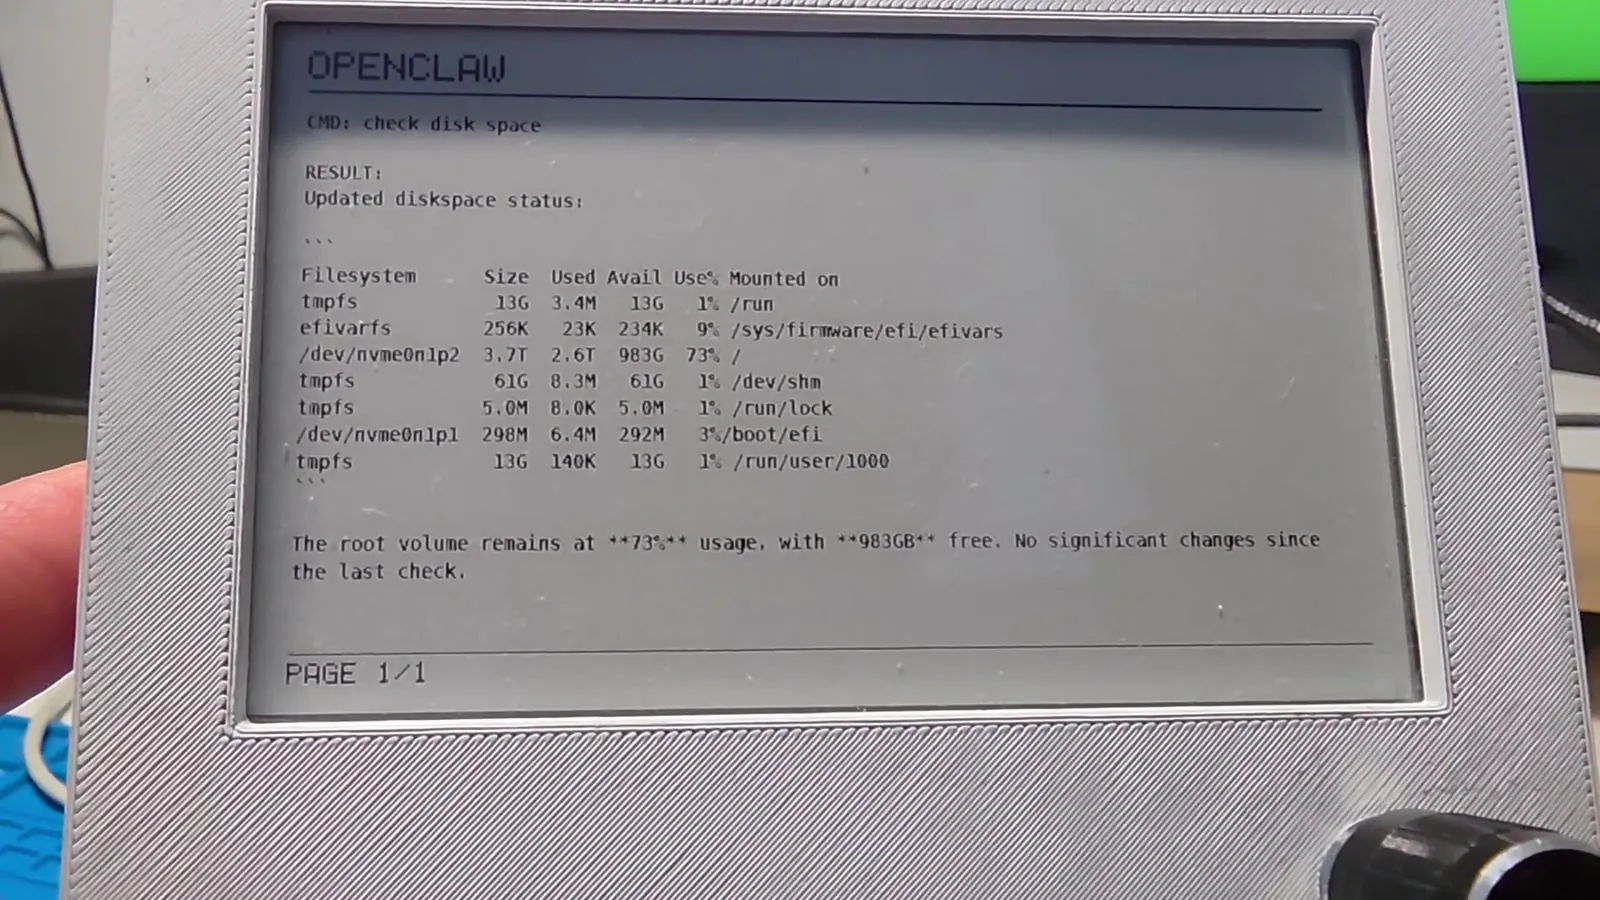
一次 OpenClaw 磁盘空间检查,渲染在 Vault 的电子纸屏幕上。
这里的“本地”指的是推理托管在局域网内,而不是手持设备上。微控制器拿到的是有上限的最终回复缓冲区、简单的固件,以及一个大体上响应流畅的 UI。主机则可以更换模型、运行时或 agent,无需重新刷写设备。
在控制模式下,后端目前会等待 OpenClaw 回合结束,再返回最终 payload。agent 可以在主机上规划并调用工具,但 Vault 还不会把每个工具事件流式传到面板上。请求执行期间,OLED 显示计时器。agent 返回最终回复后,Vault 将其显示在电子纸上。未来若改用 job-ID 传输,就能在不保持单个 HTTP 请求打开的情况下暴露进度和取消操作。
这是那段 29 秒的设备演示,展示了 Vault 提交一个 OpenClaw 任务、在实时 OLED 上等待,并把结果落到电子纸上的过程:
你的浏览器不支持 video 标签。
四种模式,一套硬件
shell 仍然是固件的核心。一条斜杠命令决定自由文本被路由到哪里:
| 模式 | 路由 | 电子纸上显示什么 |
|---|---|---|
/shell | 本地命令或经代理的远程命令 | 历史与诊断信息 |
/assist | OpenAI 兼容的 chat | 模型回复 |
/control | OpenClaw agent | agent 的最终结果 |
/rpg | 有状态的游戏引擎加 LLM | 叙事、位置和游戏状态 |
InputManager 把 CardKB、编码器和 USB 串口合并成一条事件流。上层不需要知道某一行来自物理键盘还是串口控制台。这个抽象比我预想的更有价值,因为它让固件的其余部分不必理会物理输入的各种怪毛病,包括外设掉线、编码器信号重复以及启动延迟。
故障大多是电气问题,而且悄无声息
架构很快就定下来了。物理系统花的时间长得多,教给我的是:别信一张没上过工作台的原理图。
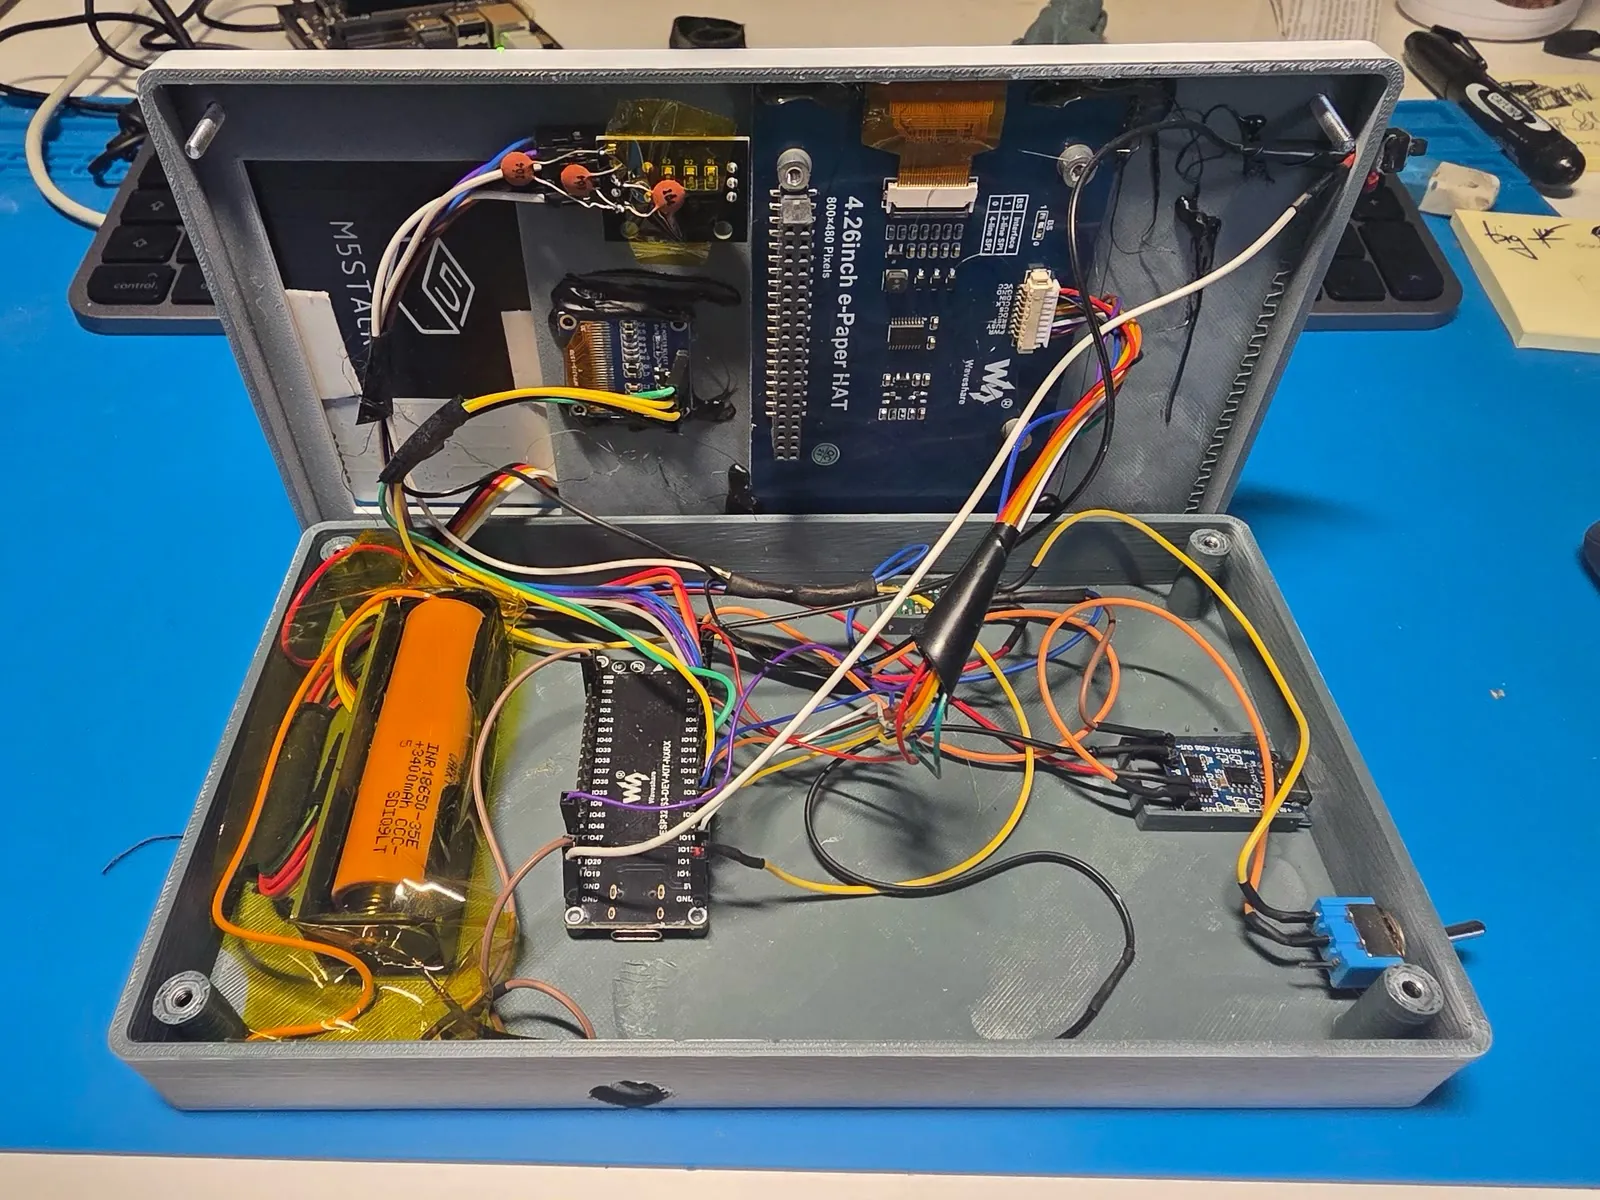
原型内部:ESP32-S3、电池、接线、显示板、键盘和编码器。
这个 I²C 变通做法违反了协议
开发板没有外部 I²C 上拉电阻,硬件 Wire 通路无法稳定地 ACK OLED 或键盘。针对这个点对点原型,我写了两条软件总线。SCL 和 SDA 被主动拉高拉低,采样 ACK 和传入数据时释放 SDA。OLED 总线用 3 μs 的半位延迟;较慢的 CardKB 用 10 μs。
这让这台机器在没加电阻的情况下稳定运行,但它不是通用的 I²C 建议。推挽信号违反 I²C 的开漏电气模型,不适合共享总线或多主总线,也不适合任何可能把某条线拉低的设备。面向生产的修法是加上正规的上拉电阻和一条常规总线。软件实现只是在短距离、单主连接的场景下隔离真实故障的务实手段。
一条“3.3 V”升压轨烧掉了两块 OLED
最初我用一颗 Pololu U3V16F3 升压稳压器给显示屏供电,输出设为 3.3 V。单节电池充满后电压会高于这个目标值,而这颗稳压器会把更高的输入电压直接放行。于是 OLED 拿到的供电电压约为 3.8 V,超过了 SSD1306 控制器正常工作时推荐的 VDD 上限 3.3 V。在这种持续过压下,两个模块先后损坏。把供电换成升降压级后,无论电池放电到哪个阶段,这条轨都稳住了。
SPI 初始化成功,屏幕却一片空白
e-paper 驱动初始化完成,BUSY 线也正常,但屏幕上什么都没有。在这块板子的配置下,GPIO 13 是一个 SPI2 IO_MUX MISO 引脚,即使我用 MISO = -1 初始化 SPI,它仍然表现得像是归那个功能所有。而我把它分配给了显示屏的 data/command 线。把这条线改到 GPIO 17,屏幕立刻恢复正常。
我把这当作一次观察到的板子与核心之间的交互,而不是关于所有 ESP32-S3 设计的普遍规律。教训是:当外设在初始化看起来成功之后仍然不工作时,先检查引脚矩阵的归属是否还在影响你分配的那个引脚。
sizeof 用错缓冲区,每条远程命令都会重启设备
有一条远程命令路径分配了 char resp[256],然后带着 sizeof(_respScratch) 传给一个轮询函数,其中 _respScratch 是一个 2400 字节的成员。被调用方信任了这个长度,写越过了栈上的缓冲区。结果每一条非本地 shell 命令都能把设备重启。
修复只有一行——复用那个大成员——但这个故障代价很高,因为它藏在看起来完全合法的类型和 API 后面。硬件调试和 agent 调试有一个同样令人难受的性质:可观测性往往在系统跨越边界的地方下降。真正管用的修复,都是那些让边界变明确、让故障变可见的修复。
这个 RPG 让我明白“LLM 原生”应该是什么意思
这个 RPG 最初是 Vault 最长工作流的试验场:长文本、分页、存档,以及 1-bit 美术。它最终成了最清楚的例子,说明模型应该在什么地方接管系统,以及不该在什么地方接管。
Python 持有持久化的游戏状态和规则。LLM 生成叙事,以及关于世界和玩家的紧凑结构化建议;引擎负责解析、校验、约束,并决定哪些内容可以固化下来。模型可以带来意外,但不会因此变成一个概率数据库,也不会成为唯一的事实来源。
这种职责划分并不限于 RPG:让模型做模型擅长的事,再用确定性软件把结果包起来。让它去写、去刻画、去连接、去制造变化。状态、规则和校验留在代码里。
通道分离带来了可用的降级方案
串口输入和独立的显示通路提供了基本的兜底。e-paper 显示屏挂了,回复仍可通过 OLED 回滚显示和 USB 串口获取。OLED 或 CardKB 挂了,我还能用 USB 串口。离线时,本地诊断依然可用。
编码器仍是翻动 e-paper 页面的唯一手段,所以它一旦失效,阅读视图就会退化。这些通路算不上正式的容错设计,但能让我在某个组件不可用时继续调试原型。
局域网不是安全边界
原型 broker 绑定到主机的所有网络接口(0.0.0.0),使用明文 HTTP,并暴露了一个由 shell 支撑的远程命令路由。不启用 VAULT_TOKEN 时,任何能访问到 broker 的客户端都能执行命令。即便启用了 token,明文 HTTP 仍然无法提供应用层传输保护。
这台服务器绝不能暴露在公网上。产品化版本会强制要求认证,用白名单命令 API 取代 shell 路由,加上 TLS 或安全隧道,把服务在网络中隔离,并给 agent 一个真正沙箱化的宿主环境。
接下来我会做什么
RC8 是这台手工焊接原型所用的固件版本,不是成品。目前的限制有:
- chat 和 RPG 客户端请求 60 秒超时,agent 请求约 65 秒超时,而后端模型调用可能跑满 120 秒;
- MCU 缓冲的是已完成的响应,而不是接收可续传的任务;
- 服务端的限制按 Python 字符计数,而 MCU 最终的缓冲区按字节计数,所以多字节文本需要按字节组帧;
- e-paper 局部刷新用延迟换来了残影,需要定期全刷;
- 主板仍停留在原理图和布线阶段,未包含在公开发布中;外壳的装配还需要验证。
- 续航需要在真实负载下实测,而不是根据元件数据手册估算。
下一版传输层会立即返回 job ID,向 OLED 暴露有界的进度事件,支持取消,并把最终产物单独送到电子墨水屏。这样一来,双时钟接口就能一路贯穿整个协议。
用了两个月之后,最有价值的成果不是外壳,甚至也不是 agent 集成,而是一条可以带到其他 AI 产品里的规则:状态该流动,结果该沉淀。
手机或网页应用可以用面板而非物理屏幕来实现这一点。架构依然成立:把短暂的机器活动与持久的用户价值分开,把无界的模型工作放在 broker 后面,让模型去处理系统中那些受益于语言而非精确性的部分。
Vault 的能力刻意弱于手机。正因如此,它用起来像一件仪器,而不是又一个 app。
Vault 以 MIT 许可证开源。固件、Python 后端、OpenSCAD 外壳、STL 文件和图像流水线都可以在 GitHub 上查看。本文配合 AI Engineer World's Fair 2026 的演讲《OpenClaw in Your Hand: Building a Physical AI Terminal》。