深入 Expo Modules 2.0 的新 JNI 层
Kolibri 是 Expo Modules 2.0 在 Android 上的 JNI 库。它把安全封装做成可选的,让 C++ 指针直接传进 Kotlin,并让 JS 数据走共享二进制缓冲区。
中文
复制
Kolibri 是 Expo Modules 2.0 在 Android 上的 JNI 库。调用 C++ 对象比用 fbjni 快最多 51 倍。JS 对象传到 Kotlin 快 3 到 5 倍,因为 Kolibri 用二进制缓冲区传递它们,而不是通过 JNI 逐个构建。
在 Expo Modules 2.0 的早期预览 里,我们展示了在 iOS 上编写原生模块的新方式,并提到 Android 版本仍在开发中。本文介绍 Kolibri,它是 Expo Modules 2.0 在 Android 上使用的 JNI 库,我们构建它是为了取代 fbjni。
概要
在 Android 上,Kotlin 与 C++ 之间的每次调用中,JNI 都是最慢的一环,而 fbjni 这类封装会让每次调用更慢,因为它们添加的每一项安全特性都要在每次调用时付出时间代价。Kolibri 是 Expo Modules 2.0 底层的 JNI 库,它贴近原生 JNI,并允许你在不需要的地方关掉这些特性。对于不会抛异常的方法,它跳过异常检查;它把 JNIEnv 作为参数传入,而不是去查找它。对于混合对象,Kotlin 编译器插件把 C++ 指针直接传进原生代码,作用域则一次性释放与某个 JS 运行时绑定的所有内容。Kolibri 不再通过一次次 JNI 调用构建 Java 对象,而是在共享二进制缓冲区中把 JS 数据传给 Kotlin。结果是:从 C++ 调用 Java 与原生 JNI 一样快,调用 C++ 对象比用 fbjni 快 28 到 51 倍,JS 对象通过二进制缓冲区到达 Kotlin 比逐次 JNI 调用构建快 3 到 5 倍。
Kolibri 由三部分组成:一个只依赖 <jni.h> 的 C++ 库、一个小型 Kotlin 运行时,以及一个在编译期消除 JNI 样板代码的 Kotlin 编译器插件。在讲它的工作原理之前,需要先介绍几个概念。如果你已经了解 JNI 和 fbjni,可以直接跳到为什么我们自己造一个。
什么是 JNI?
Java Native Interface(JNI)是原生代码与 Java 虚拟机通信的方式。在 C 或 C++ 中,你可以用它调用 Java 方法、创建 Java 对象、读写对象字段,以及改变 VM 的状态。它也让 Kotlin 和 Java 代码可以调用用 C++ 编写的函数。
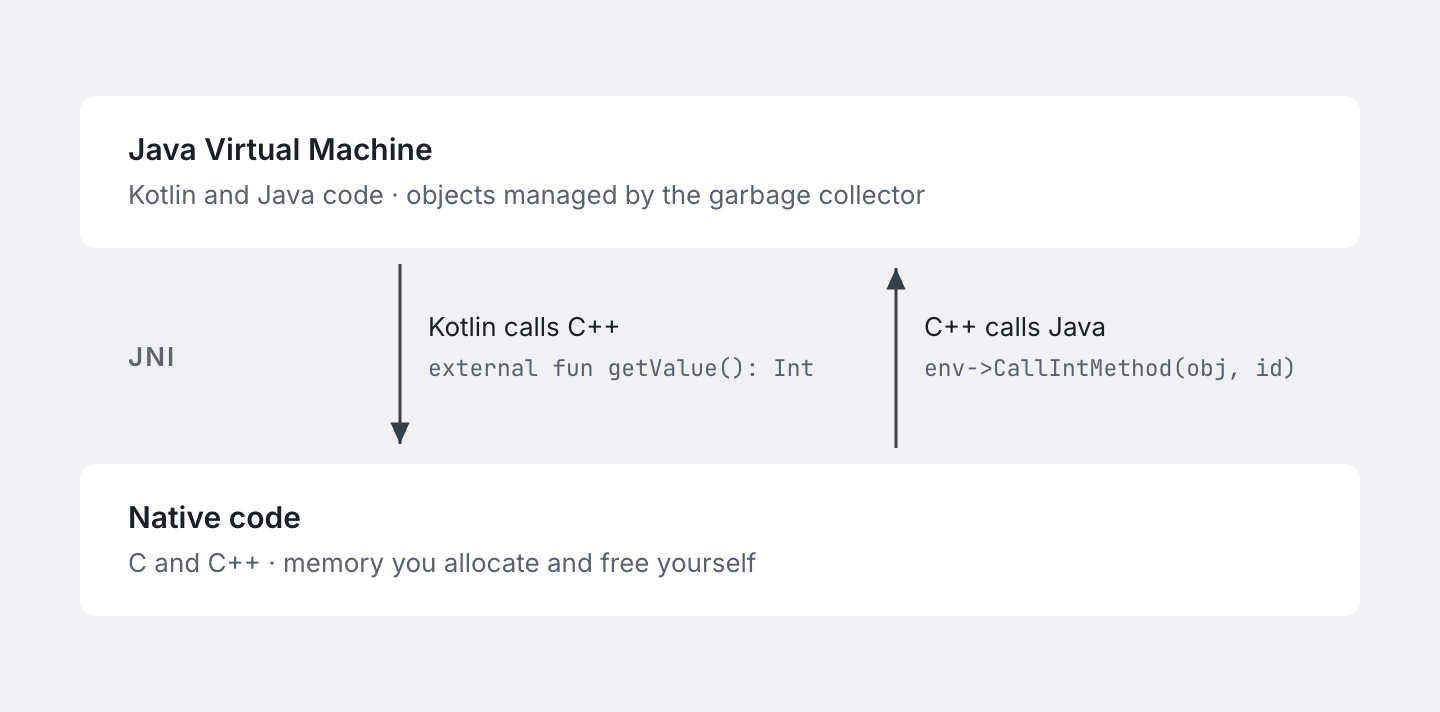
JNI 历史悠久,设计时的首要目标是安全,而非速度。在 Kotlin 与 C++ 之间的一次典型调用中,JNI 这一段是最慢的环节。在 Android 上没有别的选择:C++ 要与 Java 通信,就得走 JNI。
下面是用原生 JNI 写一次方法调用的样子。它向一个 Java List 询问其大小:
jclass listClass = env->FindClass("java/util/List");
jmethodID sizeMethod = env->GetMethodID(listClass, "size", "()I");
jint size = env->CallIntMethod(list, sizeMethod);
if (env->ExceptionCheck()) {
  // A Java exception is pending. Handle it before the next JNI call.
}
env->DeleteLocalRef(listClass);
按名称和字符串签名查找方法,调用后检查异常,最后还要清理一个引用。
JNI 引用
C++ 不是托管语言:内存由你分配,也由你释放。Java 是托管语言:垃圾回收器决定一个对象何时不再需要。当 C++ 想持有一个 Java 对象时,两套模型必须在某处对接,JNI 用引用来完成这件事。
JNI 引用是一个垃圾回收器能够识别的句柄。引用存活期间,它背后的 Java 对象无法被回收,会被固定在原地。正因如此,从 C++ 使用这个对象才是安全的。代价也在这里:你创建的每一个引用,迟早都得删除,而在真实代码里,引用的数量非常多。
JNI 的引用主要有两种。局部引用是默认得到的:原生方法的每个参数、JNI 函数返回的几乎每个对象,都是局部引用。局部引用只在当前这次原生方法调用期间有效,而且只在创建它的线程上有效。全局引用则需要你自己用 NewGlobalRef 创建,用于在调用返回后继续持有对象,或在另一个线程上使用它。
fbjni 与 jni-bind
封装库让 JNI 更好用。最流行的两个是 Meta 的 fbjni 和 Google 的 jni-bind。两者主要都是为安全而设计的:它们替你管理引用,所有东西都会自动清理。
两者的思路不同。jni-bind 更简单,专注于从 C++ 调用 Java。fbjni 更全面,它也处理反方向的调用,即从 Java 进入 C++,并且引入了混合对象:同时存在于边界两侧的对象,一个 Java 部分和一个 C++ 部分协同工作。这些我们后面再讲。
在 React Native 生态中,fbjni 是默认之选。它随 React Native 一同发布,TurboModules 在用,生态中许多其他库也在用。
为什么要自己造一个
Kolibri 保留了安全网,但允许你把它摘掉。实际编写 Kolibri 代码有两种方式,二者可以很好地共存:
- 你清楚自己在做什么。 你主动关闭安全特性:没有自动内存管理,没有异常检查。清理工作全由你负责,换来的是 JNI 允许的最快代码。
- 你想要安全网。 你得到和 fbjni 一样的东西:托管引用、自动异常检查等等。
真实代码两种都需要。有些路径很热,必须尽可能快;另一些路径很棘手,性能没那么重要,你希望泄漏风险越小越好。fbjni 是个好库,但在裸 JNI 和 fbjni 之间来回切换并不顺畅。你最后总是在绕开这个库,因为它当初就不是为这种用法设计的。Kolibri 则是为此设计的。
以引用为例。Kolibri 有一个 Ref 类,它持有一个 JNI 引用,并在 Ref 销毁时删除该引用。在 C++ 里描述一个 Java 类时就会用到它:
using namespace expo::kolibri;

struct JGreeter : JavaClass<JGreeter> {
  static constexpr std::string_view descriptor = "com/example/Greeter";

  static constexpr Method<"greet", Ref<jstring>(jstring)> greet{};
};

// `greeter` and `name` come from Java, as arguments of a native method.
// Java owns them, so there is nothing to manage on the C++ side.
std::string greetFromJava(JNIEnv* env, jobject greeter, jstring name) {
  // The result is a Ref, so its local reference is deleted at the end of the scope.
  Ref<jstring> greeting = JGreeter::greet(env, greeter, name);
  return greeting.toStdString(env);
}
调用 greet 时,你不必把 greeter 或 name 包进 Ref。Kolibri 直接接受原样的 JNI 引用。这是最常见的情况:参数来自 Java,或者引用会由别处释放,你不想让 C++ 管理它们,只想把它们传下去,也不想浪费时间在它们外面套一层包装。Kolibri 与这种模式配合得很好,许多类似的模式也一样。
Kolibri 的不同之处
Kolibri 用 C++20 编写,API 建立在现代 C++ 特性之上。再加上一个 Kotlin 编译器插件,它能做到其他库做不到的事。
跳过异常检查
在裸 JNI 的例子里,调用 Java 之后紧跟着 ExceptionCheck()。Java 方法抛出异常时,JNI 不会在 C++ 里抛异常,而是把异常挂起,你必须在调用之后自己去查。这个检查本身就是一次 JNI 调用,同样要花时间。默认情况下,Kolibri 在每次调用之后都做这个检查,并把挂起的 Java 异常作为 C++ 异常重新抛出。
很多 Java 方法根本不会抛异常,这一点你心里有数。Kolibri 让你把这件事写出来。它用两个模板参数描述一个 Java 方法:方法名(字符串)和签名(一个普通的 C++ 函数类型)。在函数类型里加上 noexcept,签名就表示这个方法不抛异常。Kolibri 是这样描述 java.util.Iterator 的:
struct JIterator : JavaClass<JIterator> {
  static constexpr std::string_view descriptor = "java/util/Iterator";

  static constexpr Method<"hasNext", jboolean() noexcept> hasNext{};
  static constexpr Method<"next", Ref<>()> next{};
};
hasNext() 不抛异常,所以它的异常检查在编译期就被去掉了。next() 会抛异常,检查保留。Java 标准库里很多方法都适用这一套。只有对确实不会抛异常的方法才安全,但既然你确定,就没必要为这个检查付出代价。
这个检查并不便宜。在我们的基准测试里,它给一次 ArrayList.size() 调用增加了约 24 ns,而不带检查时这次调用耗时 97 ns。相当于整个调用的四分之一。
显式传入 JNIEnv
每个 JNI 操作都要经过一个 JNIEnv,也就是用来和 VM 交互的句柄。它属于某个线程,所以用之前必须先拿到正确的那一个。
在 fbjni 里这是自动的。函数需要 env 时,会自己取当前的 env。这很方便,但代价是每次 fbjni 调用都要多做一点工作去找 env。
带作用域的混合对象
Kolibri 对混合对象有自己的做法,叫 NativeObject。概念和 fbjni 一样:一个 Java 对象和它对应的 C++ 对象,两者可以互相通信。区别在于如何释放:Kolibri 引入了作用域的概念。
作用域是一组共享生命周期的对象。创建 C++ 对象时,你可以把它绑定到一个作用域:当前作用域,或者你选定的任意一个。作用域失效时,Kolibri 会通知绑定到它的每个对象,各自释放依赖该作用域的资源。
这对 Expo Modules 很重要,因为我们在那里就是这么用混合对象的。它们让 Kotlin 能访问 JS 对象。于是就有了三方:状态存在 JS 里,Kotlin 代码想操作它,C++ 把两边粘起来。C++ 对象持有 JS 对象,同时是某个 Kotlin 对象的原生部分。两者绑定在一起,所以 Kotlin 对象被释放时,它的 C++ 部分也随之释放,JS 对象一并释放。
不过,很多情况下是 JS 侧先消失。比如一次页面重载就会销毁整个 JS 运行时和其中的所有 JS 对象,而指向它们的 Kotlin 对象还在等着垃圾回收。
我们不能留下任何残留。如果运行时销毁后 C++ 对象仍持有它的 JS 对象,就等于持有了一个已经失效的引用。之后 Kotlin 对象被垃圾回收时,C++ 对象会去清理一个早已释放的 JS 值,这是典型的 use-after-free。所以,凡是与运行时绑定的东西,都必须在运行时消失时一并释放。
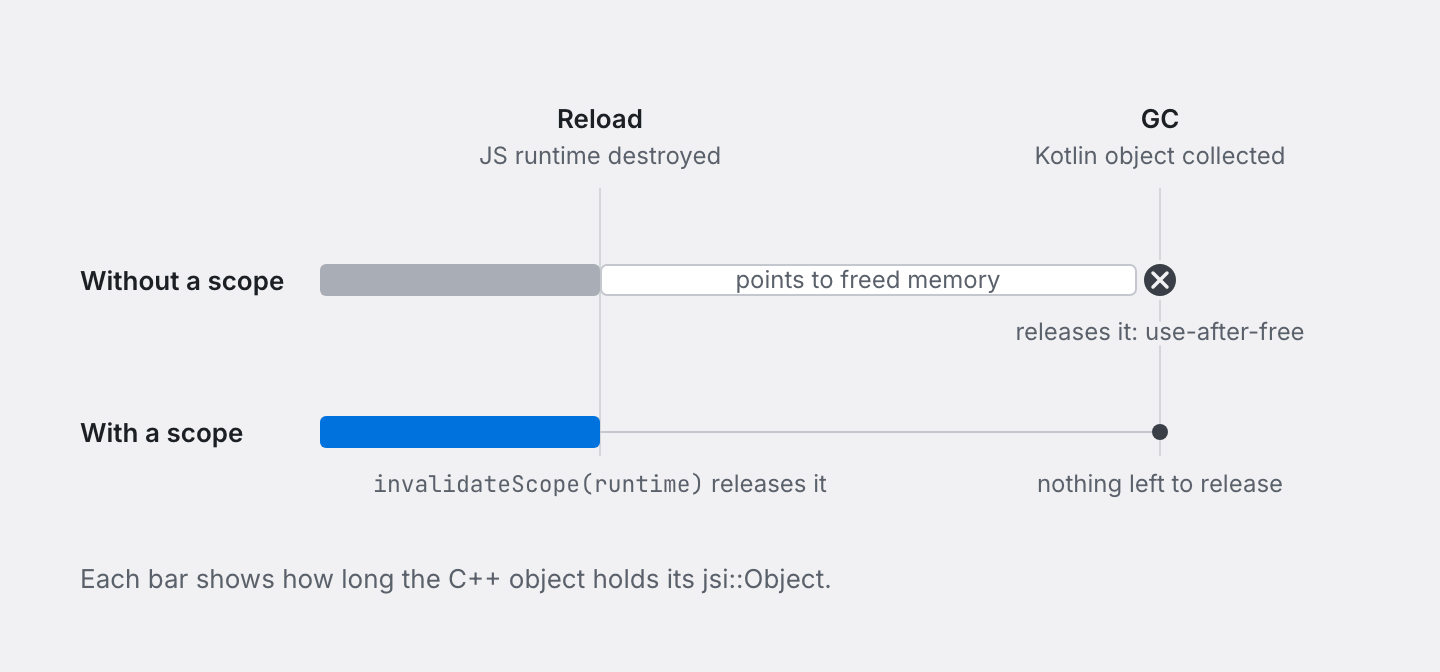
作用域就是为此而生的。我们把每个混合对象绑定到它所属的 JS 运行时,运行时销毁时就使该作用域失效。下面是我们在 Expo Modules 2.0 中使用的类的简化版本:
class JavaScriptObject : public kolibri::ScopedNativeObject<JavaScriptObject> {
public:
  JavaScriptObject(jsi::Runtime* runtime, jsi::Object object)
    : runtime_(runtime), object_(std::move(object)) {
    bindToScope(runtime_);
  }

  // Called when the scope is invalidated.
  void onScopeInvalidated() { object_.reset(); }

private:
  jsi::Runtime* runtime_;
  std::optional<jsi::Object> object_;
};

// When the JS runtime is torn down:
kolibri::invalidateScope(runtime);
Kolibri 的混合对象从一开始就围绕这一机制构建,因此比 fbjni 里要简单得多。
调用混合对象更快
在 Kolibri 中,调用混合对象也更快。原因要从它们的工作方式说起。
在 C++ 里创建对象,拿到一个指向它的指针。这个指针被传给 Java,保存在 Java 对象的一个字段里:一个普通的 long,一个表示地址的数字。Java 对象拥有这个 C++ 对象。
现在假设你在 Java 对象上调用方法 x,而 x 绑定到了一个 C++ 方法。JNI 把 native 方法绑定到普通函数上,没有 this。所以 C++ 侧必须想办法找到这个对象。办法是现成的:指针就在 Java 对象里。在 fbjni 的经典混合对象中,取到这个指针还要再经过五次 JNI 调用:三次字段读取,依次进行,外加两次调用,用来删除前两次读取产生的局部引用。然后指针被转换回 C++ 类型。
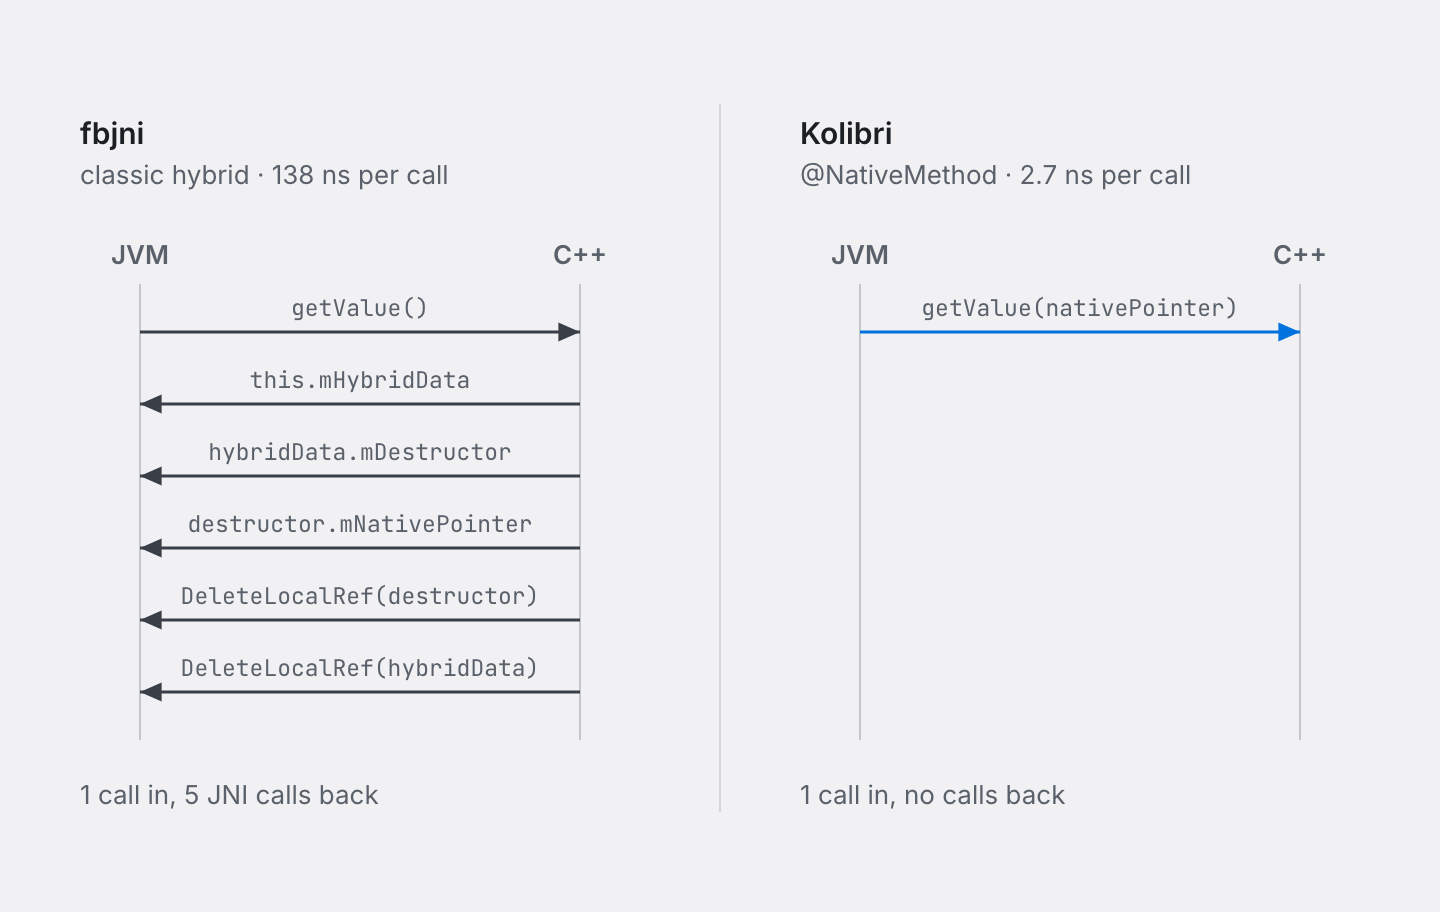
Kolibri 通过 Kotlin 编译器插件跳过这些调用。这与 SDK 56 中 Expo Modules 移除反射属于同一类构建期改写。你写的代码与使用 fbjni 时别无二致:在 Kotlin 类上定义一个 external 方法,再用 @NativeMethod 标注它:
class JavaScriptObject(pointer: NativePointer) : NativeObject(pointer) {
  @NativeMethod
  external fun hasProperty(name: String): Boolean
}
插件在底层改写这个方法,让指针作为第一个参数传给 C++:
// The equivalent of what the compiler emits:
fun hasProperty(name: String): Boolean = hasProperty(nativePointer, name)

private external fun hasProperty(pointer: Long, name: String): Boolean
C++ 侧直接注册成员函数,Kolibri 将指针转回对象,全程不经过 JNI 调用:
kolibri::registerNative<JavaScriptObject>(env)
  .method<&JavaScriptObject::hasProperty>("hasProperty")
  .commit();
参数也是同样的道理。对于本身就是 NativeObject 的参数,用 @AsNativePointer 标注后,其指针便以同样的方式跨过边界。
在我们的基准测试中,调用一个混合对象从 fbjni 的 76–138 ns 降至 2.7 ns。
用二进制格式传递数据
Kolibri 并不只服务于 C++ 和 Kotlin 之间的通信。它的主要任务是支撑 Expo Modules 2.0,而那里的数据来自 JS。因此必须审视整条路径。
以一个 JS 对象为例。它是一个键值存储,到了 Kotlin 侧就变成一个 map。常规做法是在 C++ 里构建这个 map:对每个键和每个值,都通过 JNI 创建对应的 Java 对象。TurboModules 和 Expo Modules 1.0 就是这么做的。这能跑通,但会产生大量 JNI 调用,而正如本文通篇所示,JNI 正是调用中最慢的一环。
我们问自己:真的需要这么多次调用吗?于是对替代方案做了基准测试:不同的格式,以及不同的数据传递方式。最终我们选择了放在直接字节缓冲区里的二进制格式。直接 ByteBuffer 是一个指向原生内存的 Java 对象,因此 C++ 和 Kotlin 操作的是同一份字节。
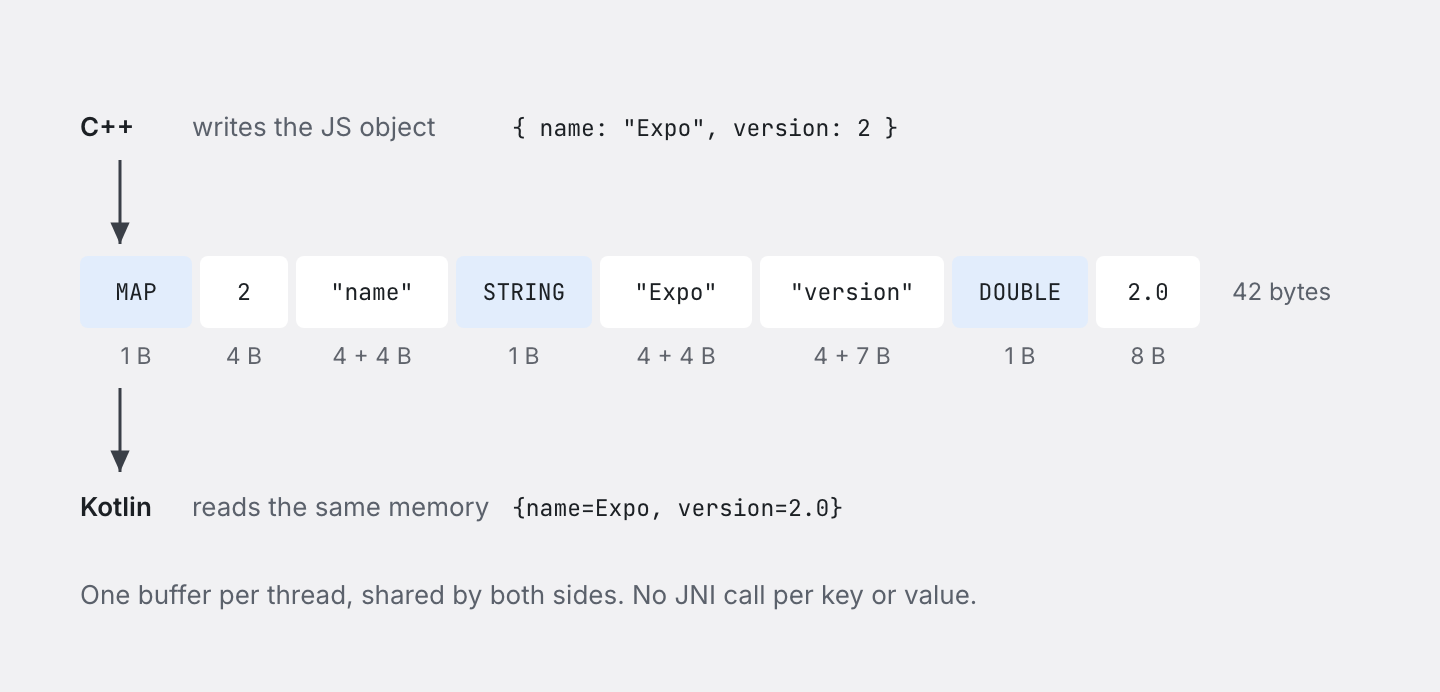
Kolibri 为此提供了基础原语。每个线程分配一个缓冲区,在 C++ 中分配,再通过 BinaryBuffer.shared() 以直接 ByteBuffer 的形式暴露给 Kotlin。Kolibri 还定义了二进制格式:布尔值、数字、字符串、列表、map 和字节数组都带标签,另有一个标签供使用方定义自己的 schema。两侧读写该格式的代码也一并提供。
Expo Modules 2.0 在 C++ 中把 JS 对象写入缓冲区的做法如下(略有简化):
jsi::Array names = object.getPropertyNames(rt);
size_t size = names.size(rt);

out.writeTag(Tag::MAP);
out.write(static_cast<int32_t>(size));
for (size_t i = 0; i < size; i++) {
  jsi::String key = names.getValueAtIndex(rt, i).getString(rt);
  writeJsiString(rt, key, out);
  encodeToBufferDynamic(rt, object.getProperty(rt, key), out);
}
Kotlin 从同一块内存读回来的做法如下:
fun readDynamicMap(buffer: BinaryBuffer): HashMap<String, Any?> {
  val count = buffer.getMapSize()
  val map = HashMap<String, Any?>(count * 4 / 3 + 1)
  repeat(count) {
    map[buffer.getString()] = readDynamic(buffer)
  }
  return map
}
两个循环都没有发起 JNI 调用。为了看清这省下了什么,我们测量了一次从 JS 调用 Kotlin 函数的过程:该函数接收一个参数,返回一个 Int。参数用两种方式传入:
- 用 JNI 构建为 Java 对象: C++ 通过 JNI 为每个值创建一个 Java 对象:每个数字一个
Double,每个布尔值一个Boolean,每个字符串一个String,每个数组一个ArrayList,每个对象一个HashMap。每次add和put都是一次额外的 JNI 调用。 - 写入二进制缓冲区: C++ 把参数写入缓冲区,Kotlin 从缓冲区读取并构建同样的 Java 对象,全程没有 JNI 调用。
两种方式传给 Kotlin 函数的值相同,结果也以同样的方式返回,唯一的差别是参数如何到达 Kotlin。我们测量了字符串、对象和数组。每个数字都是整次调用的耗时,从 JS 到 Kotlin 再返回:
| JS 参数 | 用 JNI 构建为 Java 对象 | 写入二进制缓冲区 | 加速比 |
|---|---|---|---|
| 一个 16 字符的字符串 | 0.31 µs | 0.20 µs | 1.5× |
| 一个含 4 个字段的对象 | 2.14 µs | 0.71 µs | 3.0× |
| 一个含 12 个字段的对象 | 5.68 µs | 1.71 µs | 3.3× |
| 一个含 48 个值的嵌套对象 | 27.8 µs | 5.8 µs | 4.8× |
| 一个含 100 个 4 字段对象的数组 | 211 µs | 52 µs | 4.0× |
| 一个含 100 个混合值的数组 | 23.9 µs | 2.7 µs | 8.8× |
| 一个含 100 个数字的数组 | 27.7 µs | 2.2 µs | 12.4× |
| 一个含 1,000 个数字的数组 | 272 µs | 21 µs | 13.0× |
这就是 Expo Modules 2.0 传递数据所用的格式,下一篇我们会更详细地看它的工作原理。
性能
为了看清这一切带来了什么,我们在两个方向上把 Kolibri 与裸 JNI 和 fbjni 做了基准测试:C++ 调用 Java,以及 Kotlin 调用 C++ 对象。三种方式在相同的对象上做同样的工作,并且都像真实代码那样,在开头一次性查找类、方法和字段。裸 JNI 作为基线。
我们在 Apple M3 Pro 上运行了全部测试,JDK 17。对于从 C++ 调用 Java,每个数字是 10 轮、每轮 200 万次调用的单次调用耗时中位数,且已排除预热阶段。该基准测试跑了三次(方法调用表跑了六次),取各次运行的中位数。从 Kotlin 调用 C++ 的部分用 JMH 测量。这是桌面 JVM,不是 Android 设备,手机上的绝对耗时会有差异。
从 Kotlin 调用 C++ 对象
差异最大的地方就在这里。每个基准测试都会调用一个混合对象上的方法,该方法返回一个存放在 C++ 部分的值。
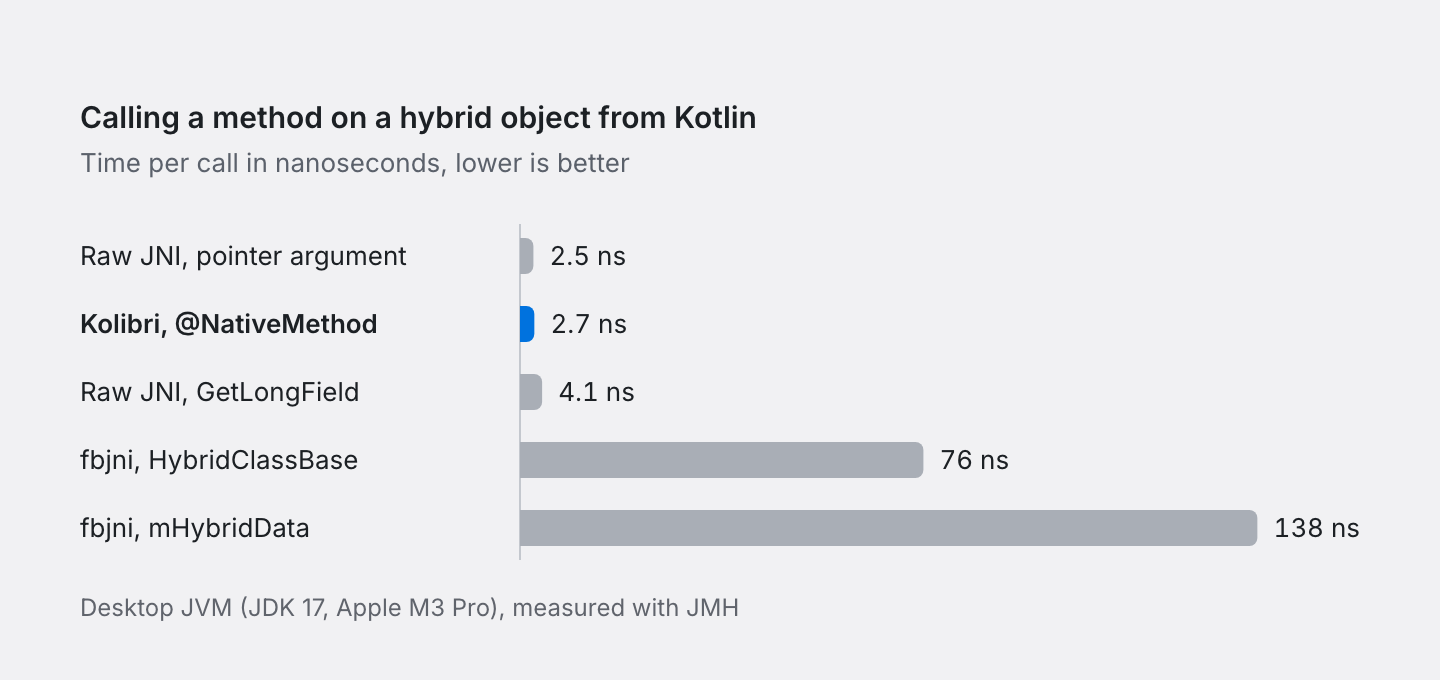
表中第二列还会把另一个混合对象作为参数传入,因此 C++ 侧需要查找两个对象。
| C++ 侧如何找到对象 | 一个对象 | 两个对象 |
|---|---|---|
| raw JNI,指针作为参数传入 | 2.5 ns | 2.5 ns |
| Kolibri,@NativeMethod | 2.7 ns | 2.7 ns |
| raw JNI,用 GetLongField 读取指针 | 4.1 ns | 6.6 ns |
| fbjni,HybridClassBase | 76 ns | 143 ns |
| fbjni,经典的 mHybridData | 138 ns | 272 ns |
借助编译器插件,调用 Kolibri 对象的开销与手写 raw JNI 传指针基本相当,比通过 fbjni 做同样的调用快 28 到 51 倍。为了找到 C++ 对象,fbjni 的 cthis() 要读取两到三个字段。除最后一个之外,这些字段都持有 Java 对象,因此每次读取都会创建一个局部引用,之后还得再删掉。较新的 HybridClassBase 写法少一次读取、少一次删除,于是 JNI 调用从五次降到三次,速度约为经典写法的两倍。
传指针也比手动用 GetLongField 读取更快,不过在桌面 JVM 上差距更小:2.7 ns 对 4.1 ns。
调用本身也更便宜。一个带两个 int 参数、不带对象的静态 native 方法,用 raw JNI 和 Kolibri 都是 2.2 ns,用 fbjni 则是 9.6 ns。
从 C++ 调用 Java
| 调用 | 原生 JNI | Kolibri | fbjni | Kolibri 对比 fbjni |
|---|---|---|---|---|
| ArrayList.size() | 98 ns | 96 ns | 134 ns | −29% |
| ArrayList.get(i) | 142 ns | 140 ns | 160 ns | −12% |
| HashMap.put("key", value) | 240 ns | 241 ns | 302 ns | −20% |
| Integer.MAX_VALUE(读取静态字段) | 25 ns | 25 ns | 31 ns | −18% |
在这些场景下,Kolibri 和原生 JNI 一样快:每一行的差距都在 2% 左右,落在基准测试的噪声范围内。原生 JNI 代码需要手动检查异常、手动删除局部引用,Kolibri 替你完成同样的工作,不额外付出代价。
与 fbjni 差距最大的是 size()。这个方法在 Kolibri 里标记为 noexcept,因此完全不做异常检查,而 fbjni 仍然会检查一次。为了单独测量这次检查的开销,我们又把检查加回去调用了 size()。原生 JNI 从 97 ns 变成 121 ns,Kolibri 从带 noexcept 的 96 ns 变成不带它的 121 ns。而始终做检查的 fbjni 需要 134 ns。
其余日常操作的差距也差不多:
| 操作 | 原生 JNI | Kolibri | fbjni |
|---|---|---|---|
| 静态方法调用(Integer.valueOf) | 144 ns | 140 ns | 164 ns |
| 构造函数(new,一个 int 参数) | 163 ns | 170 ns | 159 ns |
| 带四个 int 参数的方法 | 125 ns | 126 ns | 132 ns |
| 读取 int 字段 | 2.1 ns | 2.1 ns | 7.4 ns |
| 写入 int 字段 | 26 ns | 26 ns | 31 ns |
| 创建并删除局部引用 | 55 ns | 53 ns | 96 ns |
| 创建并删除全局引用 | 78 ns | 82 ns | 120 ns |
| 把 int[256] 复制进 std::vector | 115 ns | 113 ns | 136 ns |
| 查找当前 JNIEnv | 3.2 ns | 1.6 ns | 5.6 ns |
除了 JNIEnv 查找这一行 Kolibri 更快之外,其余每一行 Kolibri 与原生 JNI 的差距都在 5% 左右。fbjni 除了构造函数与原生 JNI 持平之外,其余各项都更慢。
为什么不改进 fbjni?
Kolibri 是为我们的用例量身定做的,不是通用 JNI 库。它只包含我们需要的东西,API 刻意保持精简。fbjni 覆盖的范围大得多,其中大部分我们并不需要。比如 Kolibri 几乎没有为 java.lang 类提供封装,需要的话得自己写。
要让 fbjni 达到同样的效果,就意味着对库做大改。Kolibri 覆盖了与 fbjni 相同的范围,但针对同一个问题走了另一条路。
取舍
Kolibri 并非没有代价。React Native 已经自带 fbjni,所以基于 fbjni 的代码不需要额外付出任何代价:不用引入新库,也不会增加应用体积。而 Kolibri 是你应用里多出来的一个库,也是我们要多维护的一个库。
不过这个代价比看上去要小。要让 fbjni 达到我们需要的速度,我们得在很多地方绕开它。那同样是一大堆额外的代码,体积最后大概也差不多。归根结底,我们认为这个取舍是值得的。
接下来
Kolibri 是基础。下一篇我们会讲 Expo Modules 2.0 如何构建在它之上,以及其余的提速来自哪里。
如果你为 Android 编写原生模块,欢迎到 Expo Discord 的 #creating-expo-modules 频道聊聊你的看法。