AI ラボは歴史研究への資金提供を始めるべきだ
歴史家 Benjamin Breen は、AI ラボが歴史研究に資金を出すべきだと主張する。GPT-6 Sol と Opus 5.5 はすでに第二次大戦のドイツ暗号を解き、ニュートンの錬金術訳の出典を辿り、未解決の歴史問題まで解いている。
日本語
コピー
AI が歴史研究を支援する際の落とし穴と活用例については以前書いたが、2024–25 年以降、状況は明らかに変わった。今週は GPT-6 Sol と Opus 5.5 がぶつかり合うようにリリースされたので、これを機に初期の結果をいくつか共有したい。文献の文字起こしのような「研究助手」的作業だけでなく、現存する歴史学上の問題を実際に解かせてみた結果だ。
一言でまとめると、歴史家が協働グループを組み、現在のフロンティアモデルを組み合わせて使えば、歴史的知識と解釈の両面で大きな進展が生まれる、ということだ。その多くはかなり意義深いものになり得ると思う。ほんの昨年まで、これは不可能だった。AI ラボ、歴史研究者、助成機関は、こうした協働を積極的に後押しし始めるべきだ。
取り組みどころを見極める
数学の分野で見られたように、これらのモデルが最も力を発揮するのは、LLM が必ず「可解」と呼ぶタイプの問題に直面したときだ。言い換えれば:
• その分野の専門家が、解くべき問題をすでに特定しているか?
• その問題に答えるために必要なデータは、完全にデジタル化され、入手可能か?
• その問題は、フロンティア AI モデルの「スパイク状」の能力——多言語推論、高等数学、あるいは大規模データセットや学際的なサブフィールドをまたいだ自律的研究——に合致するか?
• カスタムコードを書いて解くのに向いているか?
• そして最も重要なこと:考えられる解答が、明確に証明または反証できるか?(最後の点こそ、推論モデルが数学で大いに活躍し、人文学ではそうではない決定的な理由の一つだと私は考えている)。
これらの要因は、フロンティア AI が助けになれる歴史学の「未解決問題」がかなり限られていることを意味する:
- 暗号学と解読に関わるものすべて(例として、Astra が 1941 年のドイツ軍通信を解読した件や第一次大戦のドイツ軍無線暗号、この分野での Daniel Bourdeau の仕事、あるいは私自身が GPT-6 Astra を使ってエリザベス朝の神秘思想家 John Dee の暗号魔術書 Liber Loagaeth の正体を突き止めようとした試みを参照)。
- 翻訳と翻案を通じたテキストの変遷を追うこと。 一例として、私は GPT-6 Astra を使い、Isaac Newton がフランス語の錬金術テキストからラテン語へ自由に訳した一節の出典を特定した。これは_どうやら_これまで誰もやっていなかったようだ。1
- 散在する、あるいはマイナーなサブフィールドにしか見られない既存の発見、まだ学術研究に取り込まれていない発見の間につながりを築くこと。
最後の項目は、これらのツールが歴史研究者にもたらす最も影響力のある新しい方法になるかもしれない。たとえば、あの記録——Astra が 1941 年 7 月 10 日の未解読の Enigma 暗号電文を解読した——を読めばわかるが、本当の突破口は解読そのものとは何の関係もなく、_そのとき入手可能だった情報の全体範囲に気づいたこと_にあった。歴史暗号学の研究者 Frode Weierud はこう書いている:
我々はまだ GPT–6 Astra のログを分析し、この解読が一体どうやって成し遂げられたのかを突き止めようとしている。そして驚くべき細部が次々と見つかっている。2026 年 7 月、私は 1941 年の暗号電文一覧を載せたあのウェブページに次の告知を出した:注:2026 年 7 月、ドイツ連邦公文書館の調査により、いくつかの 無線電報文書群が発見された。暗号化されたものも平文のものも含まれる。そのうちの一 群は親衛隊「髑髏」師団の後方司令部、すなわち Nachschubführer からのものだった。これらの電文の多くは Ib (Quartiermeister)局宛てで、この一覧にある電文と完全に同一である。 別のものは新たに発見されたが、おそらく関連する。これらの新電文は太字で 1941 年の暗号電文一覧に追加され、電文番号の後に NF(Nachschubführer)と 付記されている。これはこれらの番号が NF 番号体系に属することを示す。NF 電文はすべて発信電文であり、したがってその電文 番号は青色で表示されている。どうやら GPT–6 Astra は、ドイツ連邦公文書館所蔵の無線電報文書群に関するこの注記を見つけたらしい。
この注記が興味深いのは、一流の人間の専門家であっても、GPT-6 Astra がこれらの断片的な情報を集め、それによって解法を見つけ出す際に一体何をしたのか、完全には把握できていない点だ。Weierud はこう書いている:
GPT–6 Astra が言及した文書番号 RS 3–3/20a と RS 3–3/63b は正しいが、これらは Crypto Cellar Research のウェブサイトにはない。GPT–6 Astra はある私蔵コレクションに言及しているが、それが一体何なのか、連邦公文書館のデジタル化された所蔵資料にうまくアクセスしたのか、それとも別の場所でこれらの文書を見つけたのかは、今のところ不明である。
あの Hugging Face の件とまったく同じだ。モデルが問題を可解と判断した瞬間、どこまでも粘り強く、可能な解法を自分の能力の限界まで押し進める。そしてその辿った道筋は、人間の専門家にはなかなか追えないことが多い。
今、何ができるか
前述のとおり、私は GPT-6 Astra を使って John Dee の暗号手稿 Liber Loagaeth の「解読」を試みた。Dee は私が最も好きな歴史上の人物の一人で、知らない人は彼のウィキペディアのページを見てほしい——その経歴は奇想天外で、語り尽くせないほどだ。『テンペスト』の魔術師 Prospero や、Christopher Marlowe の『フォースタス博士』で悪魔と契約する Faust のモデルになったと言われている。
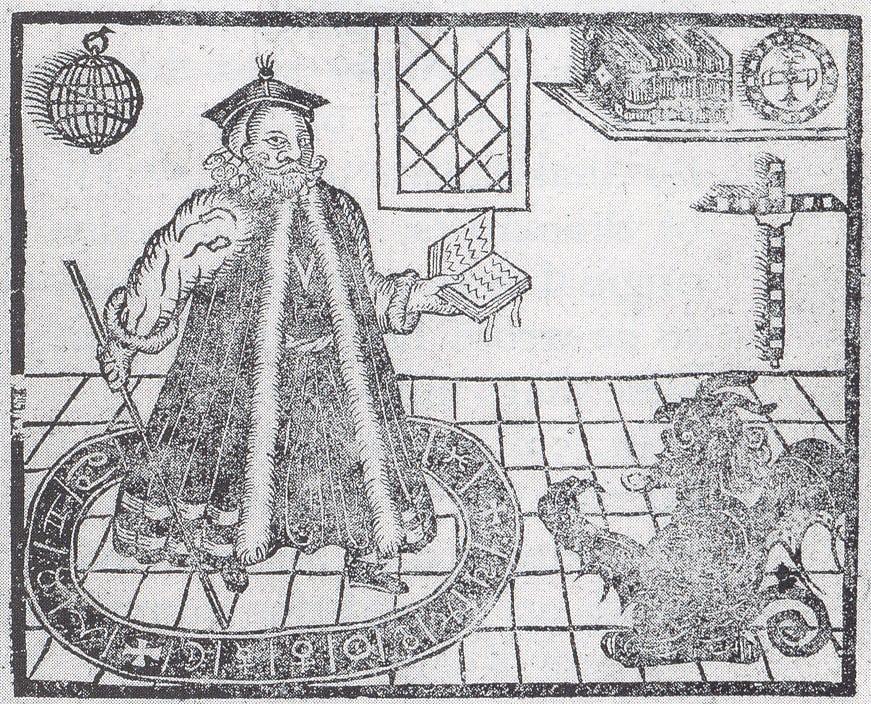
Marlowe《フォースタス博士》1620年版の扉絵木版画。Deeは自分が天使と話していると信じていた——悪魔ではなく。
Deeの生涯はそれ自体かなり奇妙だが、その中でも最も奇妙なのは、「水晶占い師(scryer)」Edward Kelleyと協力して、いわゆる「神秘の書」——「天使の言語」で書かれたもの——を記録した時期だろう(DeeはKelleyが実際には預言者であり、暗号で書かれた新たな神の啓示を受け取っていると信じていた)。この書物の完全な転写はこちらで読める。
Astraの結論はこうだ。このいわゆる暗号文書はまったく暗号化されていない——ほぼ全体が無意味な音節の羅列である。Kelleyが明らかに詐欺師だったことを考えれば、この判断は筋が通る。Astraは分析結果をレポートにまとめた。
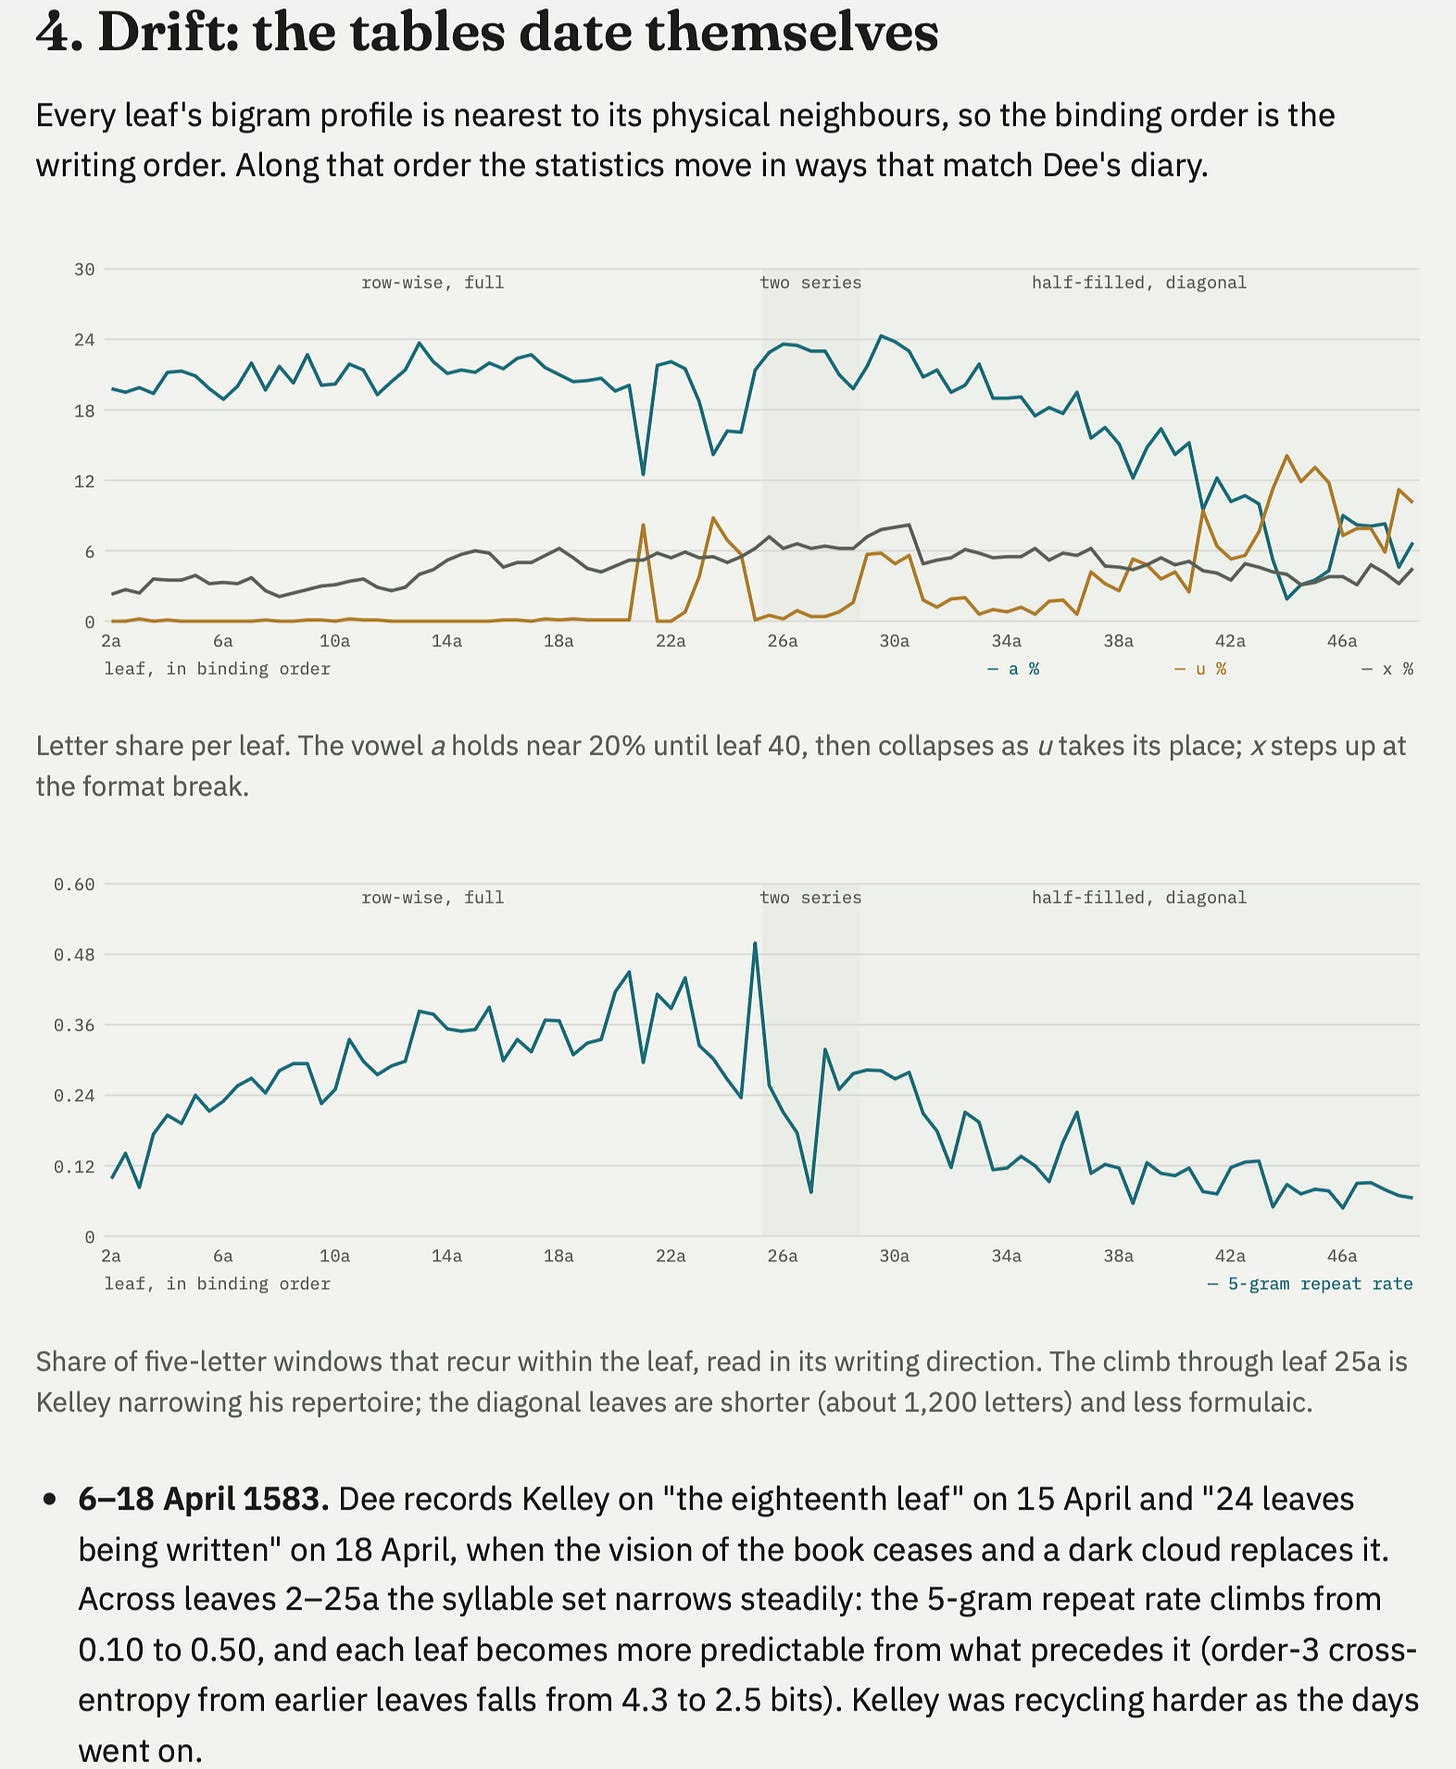
とはいえ、モデルの分析からは実際にいくつか興味深いことが出てきた。たとえば、テキスト中での文字の出現頻度に関する数学的分析を、John Deeの日記の記述と突き合わせ、Kelleyが特定の日付以降どんどん手を抜くようになり、同じ内容を繰り返すことが増えていったという結論を導き出した。
Astraはまた、この一見でたらめな内容の中に、実際に意味が符号化された箇所を一つ見つけた。そこにはBornogoへの言及がある——「John Dee映画宇宙」とでも呼ぶべき独自の神話体系において、Bornogoは天使の一人である。
これはJohn Dee研究における画期的な発見か? 違う。そして認めておくべきだが、たとえこうしたニッチな歴史の一分野で本物の突破口が開いたとしても、Navier-Stokes問題の解決とはとても比べものにならない。
しかし——こうした事例は、専門家の歴史的知識に最先端モデルと大量の計算資源を組み合わせれば、予想外の結果が生まれ得ることを確かに示していると私は思う。
三つの短いケーススタディ
当初、私はAstraとOpus 5.5を第二次大戦や第一次大戦の暗号化された通信をもっと見つけて解読させることに投入したが、どうやらこの分野の低い果実はすでに摘み尽くされているようだった——何も見つけられなかった(ただ、ドイツ軍の部隊名簿を漁り、人名らしきものを拾い出して照合していく様子はなかなか面白かった)。
ダーウィンのサルの尾
自分の専門分野——科学史と医学史——に戻ると、結果は改善し始めた。この記事を書いている時点で、GPT-6はCharles Darwinの著作を読み通し、自然選択に関する材料をどこから集めたかに言及している箇所を検索している。目的は、Darwinとその情報提供者との間の知識の連鎖における、まだ発見されていない環を見つけることだ。興味深いのは、このアイデアをGPT-6自身が提案したことである。とはいえ、専門研究者としての私の直感ともよく合っている。この資料を使って何が研究プロジェクトとして価値があるか(潜在的成果からすれば、研究論文と博士論文の間あたり)という感覚だ。これまでAIモデルにはこの能力が欠けていると私には思えた——この規模で、しかも取り組む価値のある歴史研究プロジェクトを自力で構想する力が。彼らが得意だったのは、たとえばデータ可視化のほうだ。
以下はモデルの推論過程の一例で、Darwinのとあるノートに記されたカンガルーの喉の記述を追い続けるべきか検討している場面である!
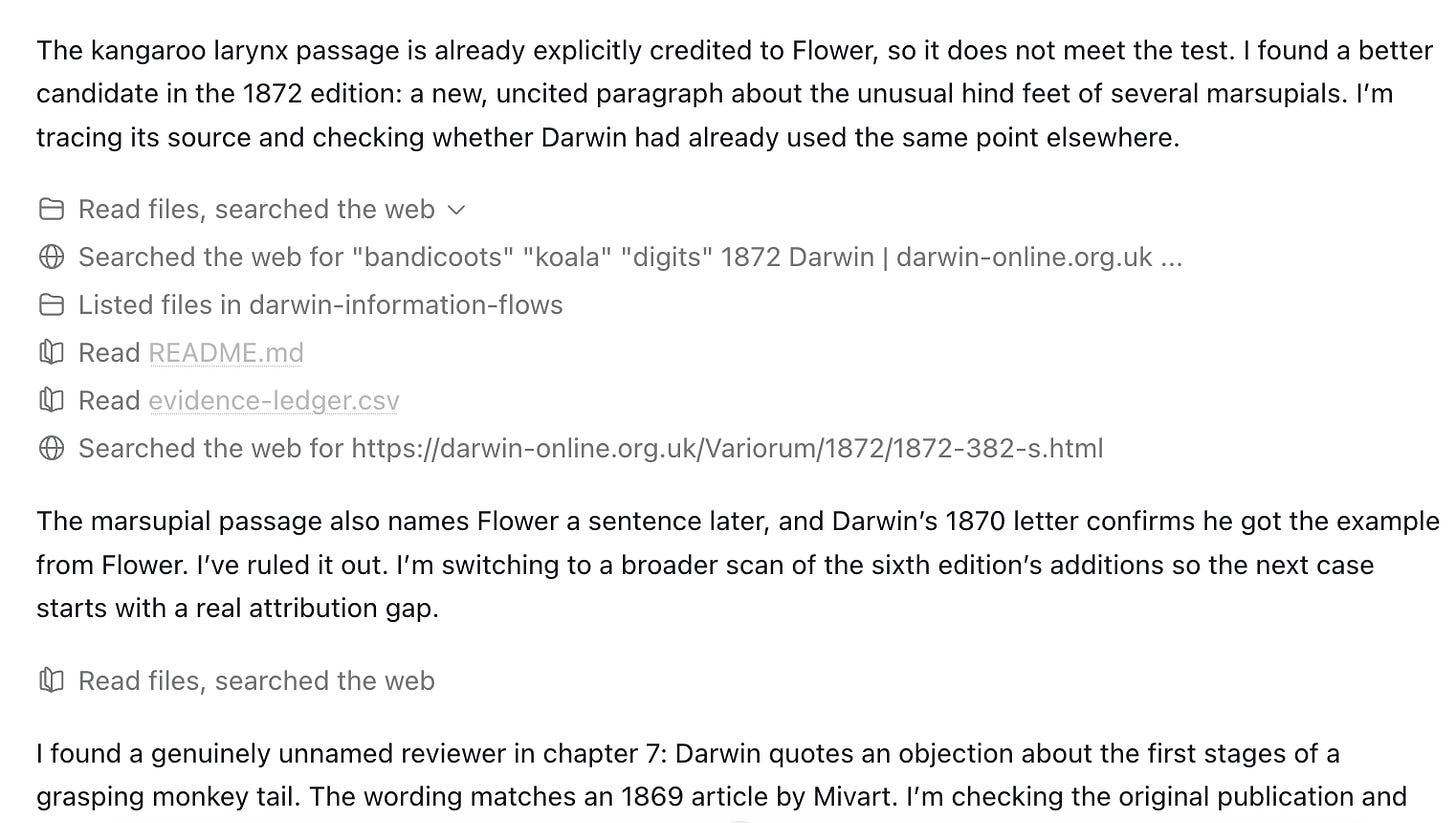
GPT-6 Solはバンディクートを諦め、「把握型のサルの尾の初期段階に対する異論」の研究へと向かう。
この作業はまだ進行中で、決定的と呼べる発見はまだ出ていない。だが、歴史研究者とアーキビスト——優れたDarwin Correspondence Projectを支えるチーム——の極めて忍耐強く協力的な仕事が、いかに新しい研究手法の土台になり得るかを示す好例だと思う。Darwinのノートや書簡に登場する_名前のある_人物への言及を人間が追跡してきたことはもちろんあるし、今もそうしている。だが言語モデルの多言語性を考えると、特に誰一人として全体を読み通せないような超大規模な一次資料群において、新たな関連性を見つけられるのではないかと私は睨んでいる。
錬金術知識の伝播を追う
もう一つの有力な候補はSamuel Hartlibの文書だ。自らを「情報人(intelligencer)」と称した彼は、Royal Societyの初期に影響力を持った成員であり、近世科学ネットワークの要となる人物でもあった。これらの文書は完全にデジタル化されており、多言語にわたり、幅広い学問領域と思想圏にまたがっている。つまり最先端モデルにとって極めて扱いやすい素材なのだ。
Opus 5.5はHartlibのアーカイブから5,000点以上の一次資料ファイルをダウンロードし、サブエージェントを生成してGoogle Booksやその他のアーカイブサイトを漁らせ、Hartlibの出所不明の情報を言語をまたいで照合した。狙いは、Hartlibが匿名または無名の情報源から重要な科学情報を得た瞬間を特定し、その人物を突き止めることだった。
これを書いている時点でOpusはまだこの作業を続けているが、暫定レポートはすでにまとまっている(こちら)。私の見るところ、主要な発見は本物であり、意味がある。決して大事件ではないが、自分なら一週間かけて調べるだろうと思える類の成果だ。
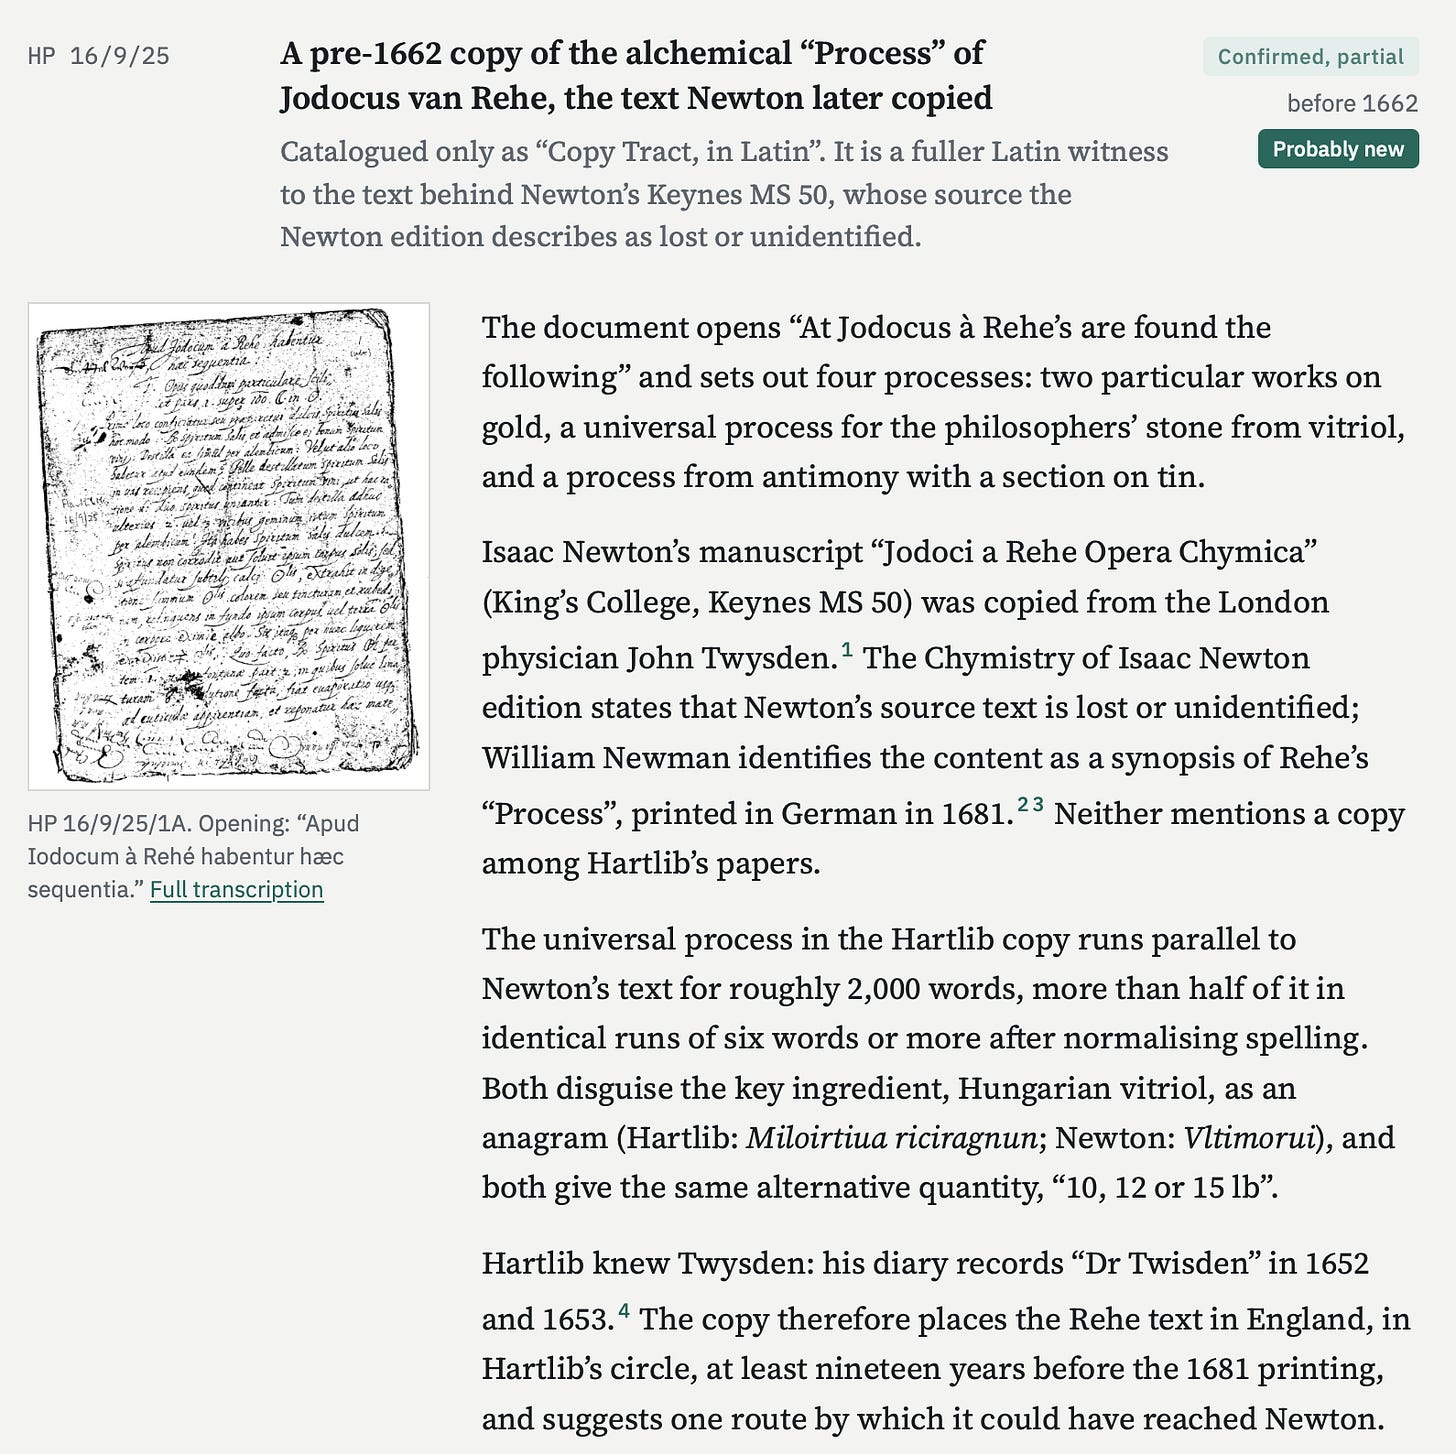
アナグラムに関する部分に気づいただろうか? ここがまさにこれらのモデルの推論・数学能力が生きる場面だ。Opus 5.5は、NewtonとHartlibが重要な成分——ハンガリー産硫酸(Hungarian vitriol)——に対して_異なる_アナグラム/コードを使っていることに気づいた。こうした暗号言語は近世錬金術ではよくあるものだが、私自身は絶対に気づかなかっただろう。Opusはこう説明している。
ニュートンのほうは、まさに本物のアナグラムだ。「Vltimorui」は vitriolum(v-i-t-r-i-o-l-u-m)の文字を過不足なく並べ替えたものになっている。ニュートン全集の編者もそう判断した。ハートリブのほうは、どちらかといえば逆さ書きで、しかもその逆さ書きすら完全には整っていない。 Miloirtiua riciragnun の2語を1文字ずつ逆にすると、こうなる。Miloirtiua → auitriolim で uitriolum(すなわち vitriolum)に近い。riciragnun → nungaricir で ungaricum に近い。
かなり無理のある解釈だと思うが、これで問題はさらに整理された。17世紀の読者にこの箇所を説明するために当時書かれた、具体的な欄外注が示されたからだ。
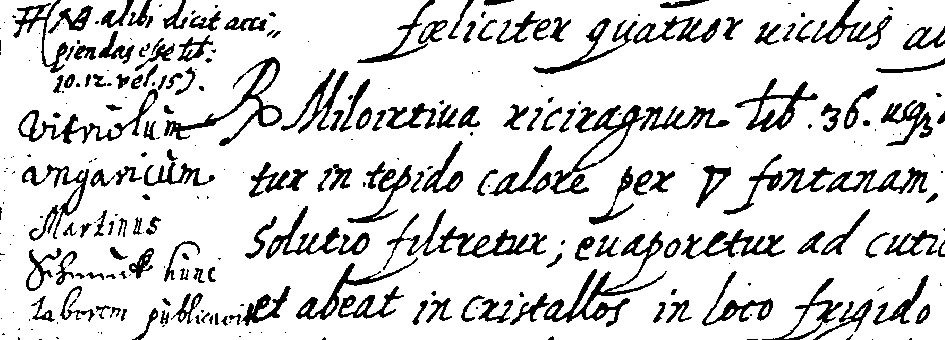
左の欄外に「vitriolum angaricum」と走り書きされているのが見える
つまり Opus がここで見つけたのは、重要な錬金術原料のアナグラムだけではない。さらに重要なのは、ニュートンもハートリブもそれにアナグラムを使っていて、両者に対応関係があるという点だ。二人が記した使用量が一致し、テキスト間にほかの符合もあることを考え合わせれば、ハートリブの手稿こそニュートンが参照したものだと強く主張できる、と私には思える。
私の知る限り、これは新発見だ。ニュートンの歴史的な位置づけを考えれば、発表に値するかもしれない。同じやり方で見つかる別の事例で肉付けできれば、なおさらだ。
近世の暗号書簡を解読する
最後の事例。これを書いているまさにその最中に、Opus 5.5 が16世紀スペイン語の書簡2通を部分的に解読した。使われていたのは皇帝カール5世の暗号だ。
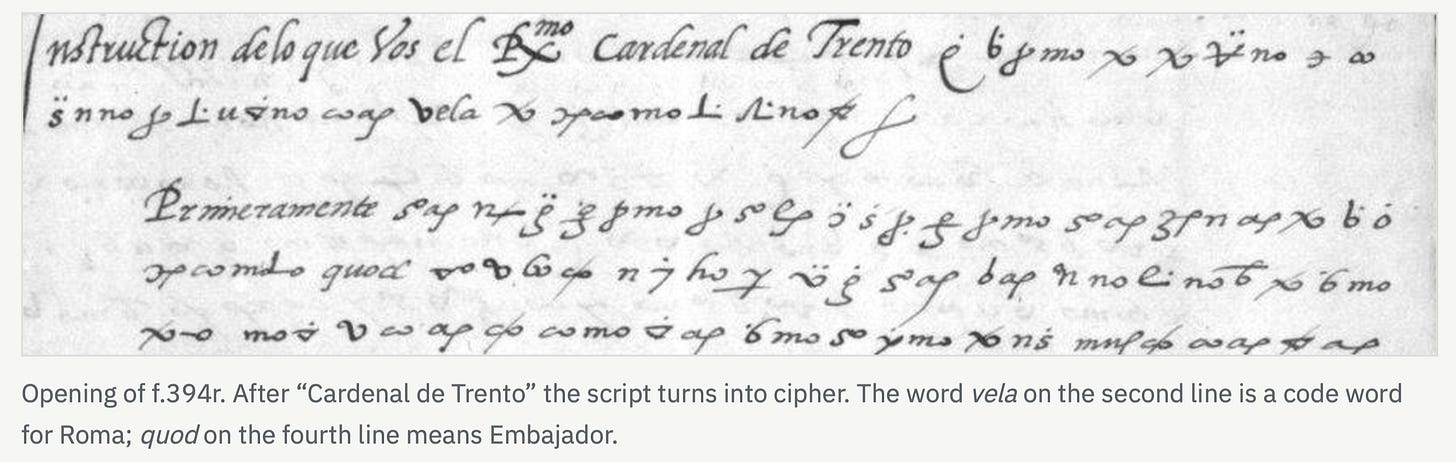
何が問題かって、どちらもすでに解読済みなのだ。1通は書かれた当時、1530年代にすでに復号され、平文が暗号ページの数ページ後にそのまま残っている。もう1通は、Google Books を少し漁ったところ、1916年に解読されていた。
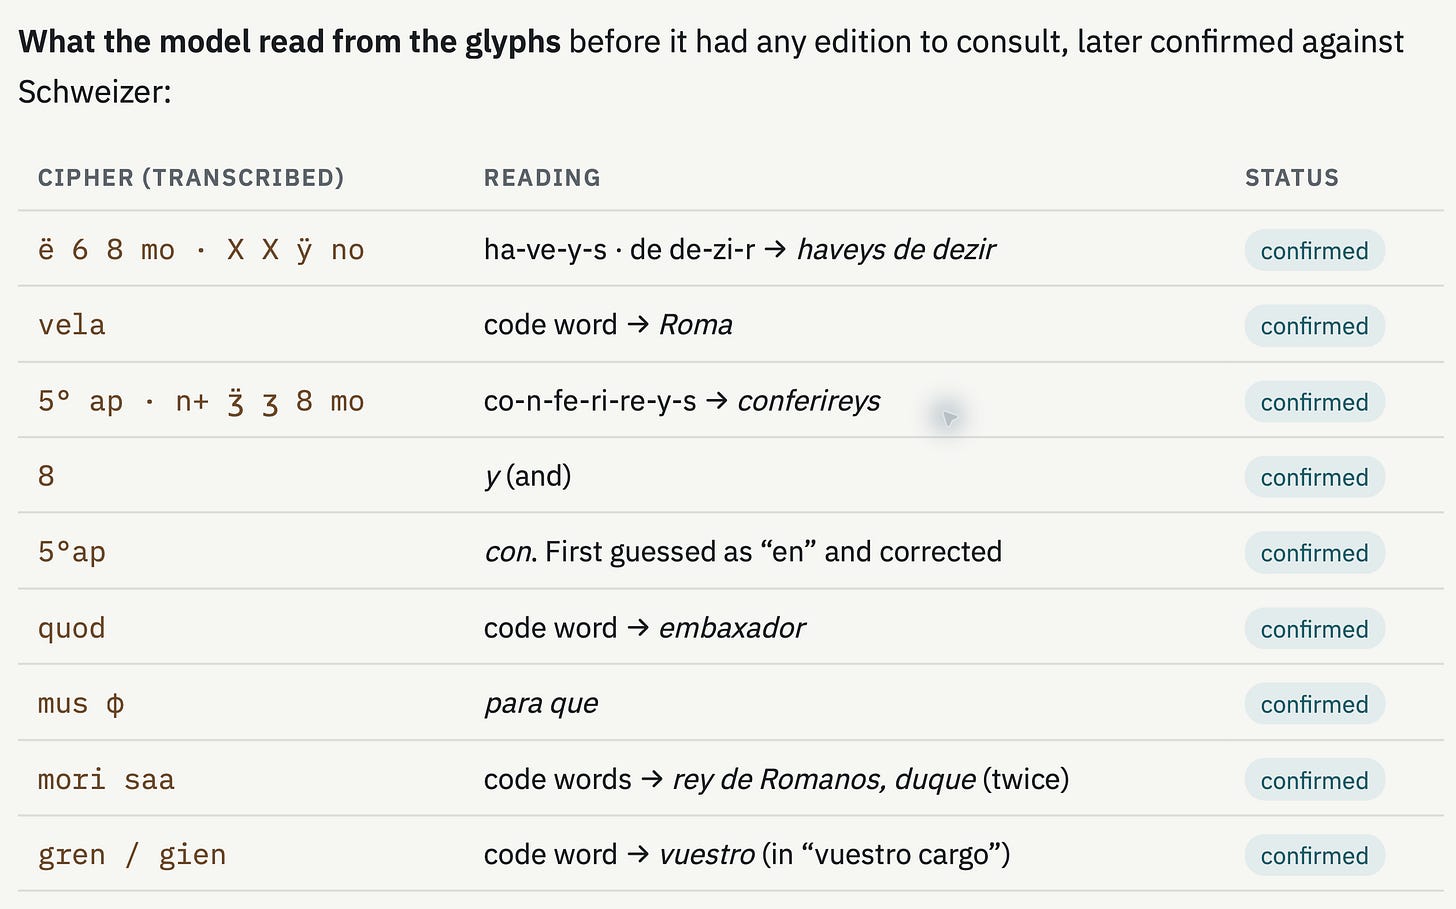
これは専門知識と「机上の裏取り」がいかに重要かをよく示している。私は歴史暗号学についてはまったくの素人で、慎重な研究者が100年以上前にやり終えた仕事を、そのまま何時間もかけて繰り返しかねなかった。同時にこれは、Opus 5.5 にこの種の作業が本当にできるかを確かめる絶好のテストケースでもある。1916年の「ゴールドスタンダード」の平文が見つかった後、自分の読みが正しいと検証できたからだ。以下は Opus が作った図と、この作業のために立ち上げた説明付きのサイト。
ここでもう一度触れておきたい。Daniel Bourdeau は非常に優れたサイトを運営していて、歴史暗号学の未解決問題を集め、自分がこれらのモデルで解こうとした試みを記録している。こういうことをするには、格好の手引きになる。
次にやるべきこと
明らかな次の一手は、私のような人間が毎週 Codex と Claude Code の枠を使い果たしながら、こんな場当たり的なやり方でつつき回すことではない。歴史家、アーキビスト、その他の研究者が協力して研究と情報を共有する、体系的な取り組みであるべきだ。そろそろ各 AI ラボと財団が、この仕事に資金を出し、支援を始める時期だと思う。
なぜか。フロンティアモデルが今できることの多くは、_公開された一次資料にアクセスできるからこそ_成り立っている。たとえば Enigma の解読で成果を出せるのは、大勢のボランティアが資料を転記してオンラインに公開し、何を問うべきか、問いとは何かを大勢が協力して突き止めてきたからだ。
現状では、歴史研究やアーカイブ、関連分野(考古学など)で得られる成果は、数学で見られるものよりはるかに散発的で限定的だろう。どの問題が解けるとモデルが判断するかにもよるし、数学の証明と歴史的知識の積み上がり方は根本的に違う。それでも、この分野を本当の突破口に導く鍵となる取り組みが3つあると思う。
- 図書館とアーカイブが機関をまたいで協力し、入手困難な歴史手稿をデジタル化して無料公開する。 私のテストでは、ボトルネックは何度も_アーカイブ資料へのアクセス_だった。資料はしばしばデジタル化済みだが、特権的なアクセス権がなければ手に入らない。制限を緩めれば大きく改善するが、それ以上に重要なのは、前近代の歴史手稿の大半が今なおデジタル化されていないという事実だ。これは十分に解決可能な問題で、必要なのは機関レベルの意思と資金だけだ。
- 歴史家に無料の API アクセス/計算資源を提供する。 私が間違っているかもしれないが、中規模から大規模な計算資源(数百から数千エージェント規模)を進行中の歴史的問題に投入したら何が起きるか、誰も本当には知らないと思う。
- 歴史家が結束して、数学者のように「千年問題」を定める。 ここは誤解のないように言っておく。歴史学の大きな論争は、「問題を解く」とか「定理を反証する」といったこととはほとんど関係がない。繰り返すが、この点で歴史は数学や物理と根本的に違う。歴史家が熱を上げ、生涯をかけて取り組むのは、解釈や主観的な分析の問題で、単一の「解答」など存在しない。だが——十分な注目と資源を注げば解ける見込みのある、本物の謎も確かにある。John Dee の Liber Loagaeth はその一つだ。AI が見つけたあの短い一節より意味のある情報が、本当に符号化されているのか。その可能性は十分ある。今はまだ分かっていないだけだ。有名な Voynich 手稿もそうかもしれない。ただし個人的には、あれに意味情報はほとんど含まれていないと思う(私の説では、書写狂の近世の人物が書いたものだ)。ほかにも Linear A があり、未解読の歴史的一次資料は山ほどある……。
これは面白い。そこで、歴史を研究する友人や同僚にメールを送り、非公式な調査をすることにした。歴史学のなかで、こうした手法が最も向いている「未解決問題」は何だと思うか、というものだ。集まったリストはウェブ上の一覧として公開する予定なので、参加したい人は連絡してほしい:
メールを送る
もちろん、こうしたモデルは歴史的な暗号解読にもさらなる進展をもたらすだろう。だが私が本当に気にしているのは、この汎用的なスキルが、ほかにどんな_追加の_歴史的知識の形態を明らかにできるかという点だ。言い換えれば、実際の暗号学の_周辺_にある問題空間である。
個人的な推測だが、史料、引用(これまで見つかっていなかった歴史的な剽窃事例を含む)、そして言語やジャンルをまたぐ影響関係といった問題こそ、フロンティアモデルが最終的に最も役立つ領域になるだろう。
しかし、まさにここでこそ、歴史家やアーキビストの専門知を結集し、AI研究者の意見を直接聞くことが最も役立つ。歴史的知識の枝はあまりに多く、あまりに人里離れた方向へ伸びている。一人で本当に問うべき問いを知ることなど、不可能だ。
たとえば、GPT-6 Pro はこの数時間ずっと、17世紀のサンスクリット天文学のテキスト(天文学者 Bhāskara の Karaṇakesarī[https://journals.library.ualberta.ca/hssa/index.php/hssa/article/view/3])を読み込み、Bhāskara が日食をモデル化するために使ったアルゴリズムを再構築しようとしている。
これは歴史学的に本当に役に立つのか? 私には_まったくわからない_。
そして、これこそが、これらのツールを面白いと私が思う理由だ。それが私たちの生活にもたらす、もっともな社会的懸念や実存的不安は別として。
AIが文章を書くため、あるいは独創的な思考の代わりに使われれば、有害な認知の外注を確かに助長する。だが、研究上の問いを、一個人が知りうる範囲の外へ広げるために使われるとき、それは別のことをする。少なくとも私には、思考を広げ、好奇心を刺激するものに思える。それがどこへ向かうのか、見てみる価値はあると思う。
週刊リンク
• 今月初めに発表された80件のCosmos Institute 助成のうち、幸運にも一つをいただいた。オックスフォード大学の博士課程学生 Nathan Davies と組み、Humanity's First Exam プロジェクトを進める。これは歴史的文書と問題を集めたコーパスで、人間の自律性と、人間と機械の関係を主題とし、AIモデルがこのテーマについてどう推論するかを評価するために使う。特に注目しているのは、モデルが人間の既存の見解の全体像を捉えられていない領域だ(つまり、すべてのAIモデルがある中央値的な答えに収束する一方、人間はずっと大きな分散を示す話題。人間が自分たちの歴史、意識、経験をどう理解すべきかをLLMに尋ねることにますます依存するようになるにつれ、この「認識論的な平坦化」は記録しておく価値がますます高まっていると思う)。(プロトタイプコードの Github)
• 前近代の児童書は本当に笑える:「そしてレンズは人のライフサイクルへと焦点を移す。赤ん坊は鷲に救われ、富を得ようと志す。4コマ目には、彼は裕福な紳士になっている——だがもちろん、死は誰も見逃さない。『おお、人よ!』最後のコマは嘆く、『今やお前はただの塵……』」(Public Domain Review)
どの未解決の「歴史の謎」、あるいはその他の歴史的問題がフロンティアモデルにとって「解ける」ものだと思うか、コメント欄でぜひ聞かせてほしい。すでに似た試みをした人がいれば、その結果もぜひ共有してほしい。
1数学研究と同様に、らしい はここで重要な限定詞だ——二次文献は検索したが、この関連性がすでに発表済み、あるいは未発表の研究で指摘されていて、私が見つけられていないだけという可能性は十分にある。