単語の86%を知っていても、台詞は38%しか分からない
アニメでよく出る500語を覚えるとカバー率は85.9%。ところが3,000行の台詞で一度に理解できるのは38.4%だけだった。8作品の字幕データで、その差がどこから来るのかを測った。
日本語
コピー
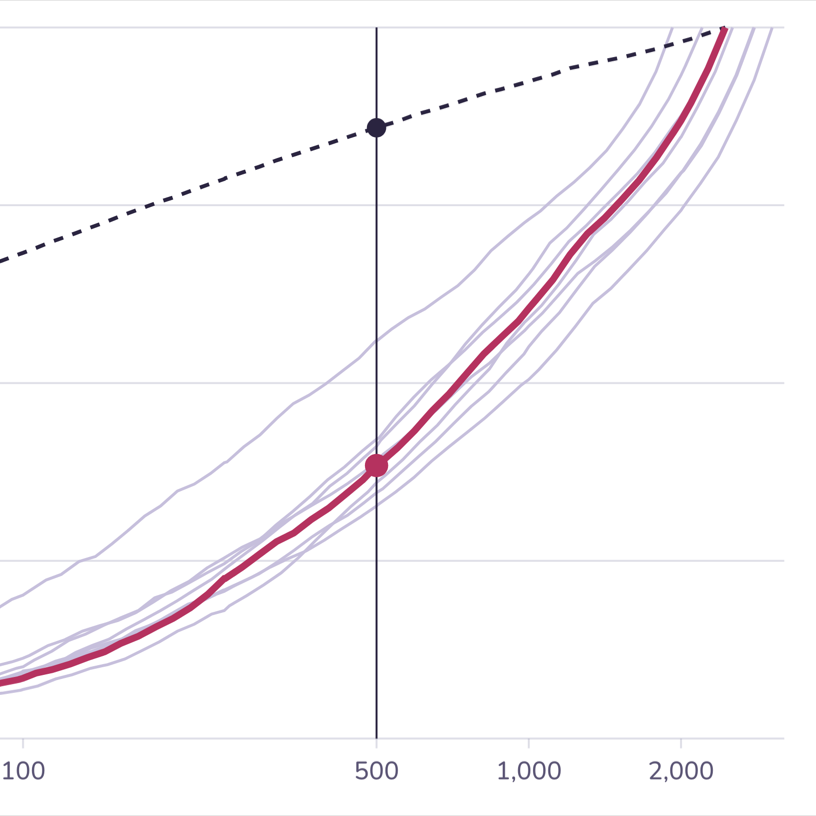
『葬送のフリーレン』を見たいと思って、作中で最もよく出る単語500語を覚えたとする。カバー率を計算するツールは、セリフに出てくる単語の85.9%を覚えたと告げる。
お茶を入れて再生ボタンを押す。耳に入ってくるのは、たとえば次の3つだ。
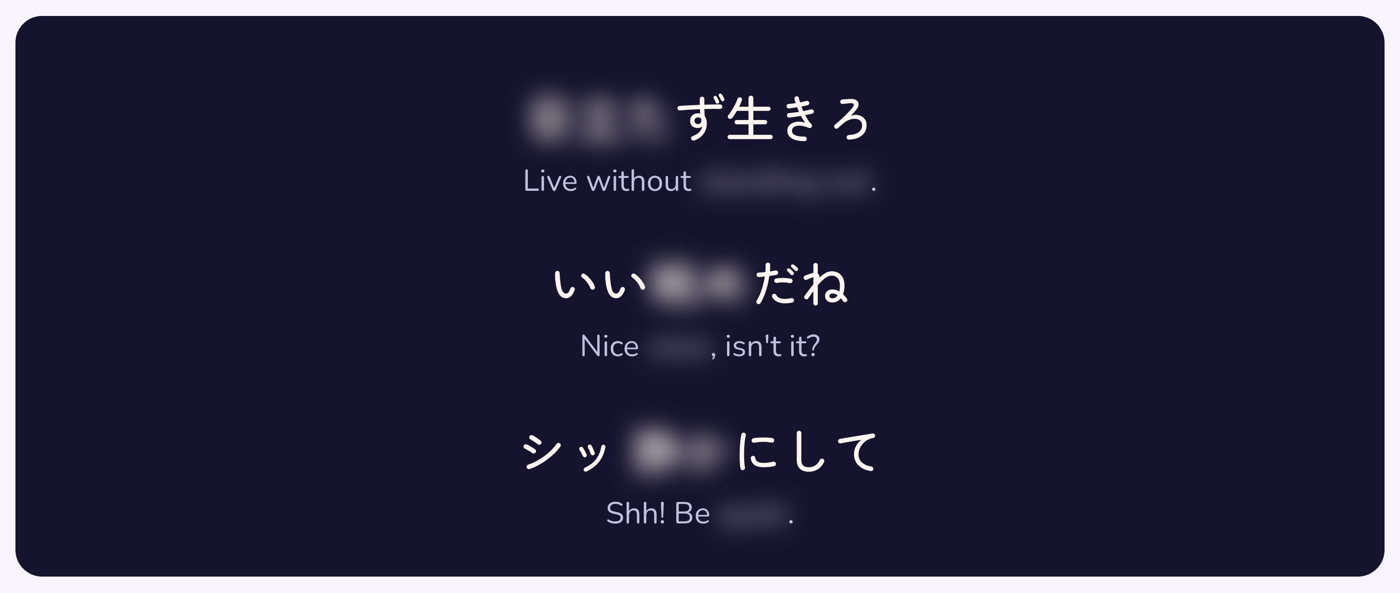
単語を調べるために3回目に手を止めたころには、お茶は冷めている。その500語を覚えれば、最初の3,000行のうち1,151行はすべての単語がわかる。38.4%だ。残りの1,849行には、知らない単語が少なくとも1つ含まれている。
どちらの数字も正しい
学習サイトがよく示すのはカバー率だ。話された単語のうちどれだけを知っているかの割合なので、1000回出てくる助詞は1000回分として数えられる。Frieren のリストの最上位は「の」(of、's)や「は」(主題を表す助詞)といった文法要素ばかりで、上位100語だけでカバー率は68.3%になる。理解できる行は8.5%にとどまる。
同じ500語を3つの数字で表すとこうなる。
| 測っているもの | Frieren の最初の3,000行 |
|---|---|
| 知っている単語 | 2,448語の異なり語のうち500語(20.4%) |
| カバー率(繰り返しを含む) | 85.9% |
| 理解できる行(すべての単語を知っている) | 38.4% |
manga-kotobaはこの方法でカバー率の表を作っている。jpdbとjitenもカバー率を表示するが、ヘルプページに正確な計算式は書かれていない。
カバー率と行数の差は行の長さから生じる。Frierenの1行は平均7語だ。理解するには7語すべてを知っている必要がある。カバー率85.9%なら、1行全体を知っている確率は約35%。0.859を7回掛けた値だ。実測した38.4%に近い。
好きな作品で試してみる
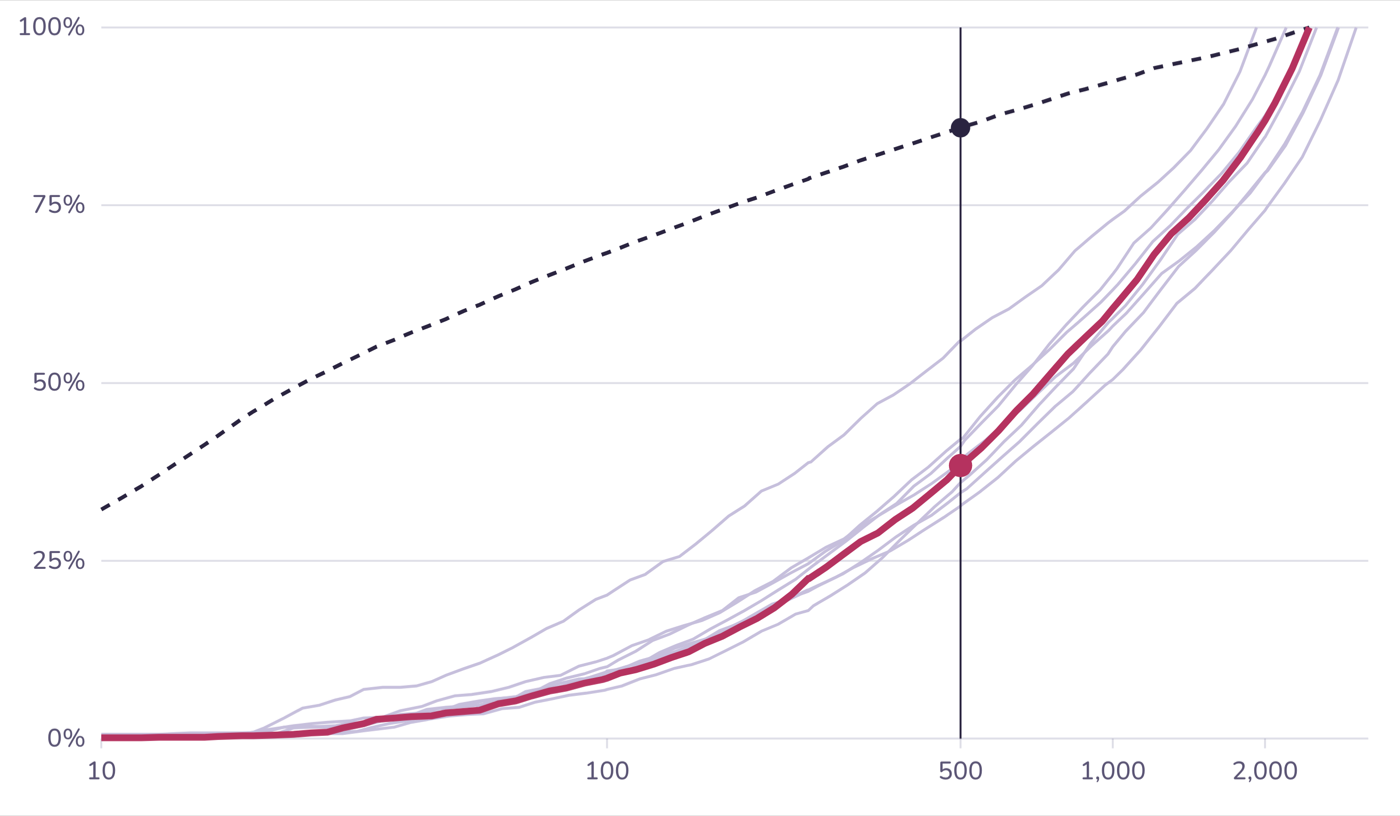
太線は、選んだ作品で理解できた行。破線はその作品でのカバー率。淡い線は、ほかの7作品で理解できた行。各曲線は、その作品で最も頻出する語から順に覚えていくと仮定して引いた。
8作品すべてにこの差がある。Serial Experiments Lain は最少の1,191語でカバー率95%に達する。それでも、理解できるのは行の77.5%にとどまる。
作品によって必要な語数は大きく違う
8作品のうち必要語数が最も少ないのは Serial Experiments Lain で、約400語で行の半分に届く。Jujutsu Kaisen は980語必要だ。
| 作品 | 行数 | 話数 | 異なり語数 | 500語でのカバー率 | 500語で理解できる行 | 行の半分に必要な語数 |
|---|---|---|---|---|---|---|
| Serial Experiments Lain | 2,034 | 13 | 1,924 | 88.0% | 55.9% | 401 |
| Dororo | 3,000 | 13 | 2,431 | 85.2% | 42.1% | 633 |
| Chainsaw Man | 2,849 | 12 | 2,203 | 86.3% | 41.1% | 647 |
| Frieren | 3,000 | 12 | 2,448 | 85.9% | 38.4% | 730 |
| Mob Psycho 100 | 3,000 | 8 | 2,795 | 82.4% | 39.1% | 749 |
| Death Note | 3,000 | 11 | 2,529 | 86.6% | 36.0% | 782 |
| Hunter x Hunter (2011) | 3,000 | 12 | 2,785 | 82.3% | 34.6% | 862 |
| Jujutsu Kaisen | 3,000 | 10 | 3,028 | 81.5% | 32.7% | 980 |
話数の多い長い作品が難しく見えないよう、どの作品も3,000行で打ち切った。後半で難しくなる作品は、ここでは実際より易しく見えている。
理解できなかった行の多くは、あと1語で届く
Frieren に戻ろう。理解できなかった行は1,849行。そのうち1,042行、全体の56.4%は1語だけ足りない。全作品でこの数字は50.2%から63.9%の間に収まる。
こちらは約束の報酬です
500語から1,000語に増やすと、カバー率が示す以上に効果がある。新しい語は頻度が低いので、カバー率は6.5ポイントしか上がらない。一方、理解できる行は22.1ポイント増える。新しい語1つが、その行を理解するのに足りなかった最後の1語であることが多いからだ。
この1語の穴は、わずかな語では埋まらない。1,042行に足りない語は、合わせて804種類ある。1語で得られるのは最大4行で、後悔、約束、収集といった語だ。
一般的な日本語の頻出2,000語では、せいぜい38%の行しかカバーできない
大まかな比較として、wordfreq のリストから一般的な日本語の頻出2,000語を試してみた。カバーできたのは23.4%から37.6%の行だった。次に、各作品ごとの頻出2,000語を試したところ、74.3%から93.3%の行をカバーした。Serial Experiments Lain は異なる語が2,000語未満しかないため、この2つ目の範囲には入らない。
作品の頻出語は風変わりなこともある。Frieren のリストの304番は生臭坊主、つまり戒律を守らない坊主のことで、作中で登場人物たちが Heiter をそう呼び続ける。21番は「魔法」で、「私」より4つ上に位置する。
前半のエピソードから作ったリストでも、後半で3分の2はこなせる
あるシーズンで作品の頻出語を覚え、そのまま次のシーズンに進むとしよう。これに近い検証を、行数が十分にある4作品で行った。最初の3,000行からリストを作り、続く3,000行で試した。Frieren の続く3,000行では、古いリストは22.3%しかカバーしないのに対し、その行自体から作ったリストは33.0%をカバーする。試験という語は最初の3,000行では1回しか出てこないが、その後は51回出てくる。登場人物たちが後に魔法使いの試験を受けるからだ。これらの作品全体で、落ち込みは5.5から14.0ポイントだった。
複数の意味を持つ語が、この数字を高くしすぎている
多くの語には複数の意味があり、言語学ではこれを多義性と呼ぶ。その行で使われている意味がどれであっても、その語を知っていれば既知と数えた。500語の時点では、Frieren の次の2行もどちらも理解済みになる。「手が震えています」と「手に取るように分かる」だ。1行目で「手」を完璧に知っていても、2行目ではつまずく。逐語訳は「手に取るように」、つまり「手で取るかのように」という意味になる。この問題が何行あるかは測っていない。この点だけをとっても、理解できる行の数字は高すぎる。
方法
手順
- 歌、書式タグ、括弧内のもの、音符を除いて字幕をきれいにする。テキストを文単位の行に分割する。重複する行を削除する。
- 無料の日本語トークナイザーである Sudachi で、すべての行を単語に分割する。SudachiPy 0.6.11 と SudachiDict-core 20260428 を split mode C で使った。Python のバージョンは 3.13.7 だった。各語は辞書形を使うので、行った と 行く は1語として数える。
- 句読点、数字、Sudachi が固有名詞とタグ付けしたものは飛ばす。
- シッやハハッのようなフィラーは飛ばす。音がフィラーとして数えられるのは、Sudachi が間投詞、副詞、名詞のいずれかとタグ付けした場合だけだ。タグが異なる文法上の語尾 ん は引き続き数える。助詞やうんのような日常的な返事も単語として数える。
- 単語が残らない行は捨て、エピソード順に並べ、最初の3,000行を残す。
- 各語の出現回数を数え、順位をつける。同数の場合はアルファベット順で決める。
- 上位 N 語を既知として扱う。カバー率は、既知の語の出現回数をすべての語の出現回数で割ったもの。理解できる行は、すべての語が既知である行の割合とする。
すべてを29行のPythonで
# pip install sudachipy sudachidict_core
# lines.txt: one subtitle line per row, in episode order, songs and repeats removed
# fillers.txt: your own list of sounds not to count, one per row
from collections import Counter
from sudachipy import Dictionary, SplitMode
import re

tok = Dictionary().create()
fillers = set(open("fillers.txt", encoding="utf-8").read().split())

def words(line):
 out = []
 for m in tok.tokenize(line, SplitMode.C):
 pos = m.part_of_speech()
 if pos[0] in ("補助記号", "空白", "記号"): continue # punctuation
 if pos[1] in ("固有名詞", "数詞"): continue # names, numbers
 if not re.search(r"[0-9A-Za-zぁ-ヿ一-鿿々]", m.surface()): continue
 if m.surface() in fillers and pos[0] in ("感動詞", "副詞", "名詞"): continue
 out.append(m.dictionary_form())
 return out

lines = [words(l.strip()) for l in open("lines.txt", encoding="utf-8")]
lines = [l for l in lines if l][:3000] # the first 3,000 lines with a real word
count = Counter(w for line in lines for w in line)
known = {w for w, _ in sorted(count.items(), key=lambda x: (-x[1], x[0]))[:500]}

coverage = sum(n for w, n in count.items() if w in known) / sum(count.values())
understood = sum(all(w in known for w in line) for line in lines) / len(lines)
print(f"coverage: {coverage:.1%} lines understood: {understood:.1%}")
Frierenのセリフで実行すると、85.9%と38.4%が出力される。未処理の字幕ファイルは保存していない。自分の字幕とフィラーリストを使えば、数値は多少変わるはずだ。
数値のすべて
各セルは、その語数の既知語におけるカバー率と、理解できるセリフの割合を示す。
| 作品 | 100語 | 250語 | 500語 | 1,000語 | 2,000語 |
|---|---|---|---|---|---|
| Serial Experiments Lain | 70.8% / 20.2% | 81.4% / 38.8% | 88.0% / 55.9% | 93.7% / 73.0% | n/a |
| Dororo | 64.5% / 10.1% | 76.6% / 24.6% | 85.2% / 42.1% | 92.0% / 63.1% | 97.8% / 87.6% |
| Chainsaw Man | 66.0% / 9.4% | 78.4% / 23.8% | 86.3% / 41.1% | 93.2% / 65.3% | 98.9% / 93.3% |
| Frieren | 68.3% / 8.5% | 78.7% / 22.5% | 85.9% / 38.4% | 92.4% / 60.5% | 98.0% / 86.9% |
| Mob Psycho 100 | 64.7% / 11.3% | 75.1% / 25.4% | 82.4% / 39.1% | 89.5% / 58.0% | 95.8% / 79.5% |
| Death Note | 67.3% / 6.9% | 78.9% / 18.0% | 86.6% / 36.0% | 93.0% / 59.1% | 98.0% / 84.6% |
| Hunter x Hunter (2011) | 63.0% / 9.0% | 74.0% / 20.9% | 82.3% / 34.6% | 89.9% / 55.1% | 96.3% / 79.6% |
| Jujutsu Kaisen | 63.7% / 9.5% | 74.3% / 20.7% | 81.5% / 32.7% | 88.4% / 50.5% | 94.8% / 74.3% |
理解できるセリフの割合を一定の水準まで引き上げるのに必要な既知語数:
| 作品 | セリフの25% | 50% | 75% | 90% |
|---|---|---|---|---|
| Serial Experiments Lain | 130 | 401 | 1,082 | 1,686 |
| Dororo | 254 | 633 | 1,429 | 2,101 |
| Chainsaw Man | 263 | 647 | 1,313 | 1,893 |
| Frieren | 283 | 730 | 1,491 | 2,111 |
| Mob Psycho 100 | 241 | 749 | 1,775 | 2,458 |
| Death Note | 345 | 782 | 1,545 | 2,200 |
| Hunter x Hunter (2011) | 320 | 862 | 1,768 | 2,446 |
| Jujutsu Kaisen | 328 | 980 | 2,032 | 2,695 |
この結果が狂い得る要因
- 「理解できる」は、すべての語を知っているという意味でしかない。文法、漢字の読み、話す速さ、文脈は考慮していない。
- その作品で最も頻出する語を正確に知っていて、しかも一つも忘れていない、という前提を置いている。代わりに別の語を知っていたり、いくつか忘れていたりすれば、数値は下がる。視聴前にその作品の単語リストを用意する必要もある。
- 同じセリフは1回としか数えない。実際の視聴では「うん」のような決まり文句を何度も耳にするので、理解できるセリフの割合は上がるだろう。これは測定していない。
- セリフは各作品の最初のエピソードから、1話も飛ばさずに取っている。Chainsaw Man と Serial Experiments Lain は3,000行未満なので、全話を使った。行数が少ないほどスコアは高くなる。500語時点で、他の作品をLainの長さに切り詰めると最大4.8ポイント高くなる。Serial Experiments Lainの字幕は品質が低いため、数値の信頼性も低い。
- 字幕ファイルには、わずかに表現の違う同一セリフの繰り返しがあり、完全一致の重複しか除去していない。近い重複も除くと、500語時点の理解率は最大2.2ポイント変わる。
- 何をフィラーとみなすかは判断の問題だ。フィラーを語として数えると、500語時点の理解率は最大2.7ポイント変わる。数えるセリフがずれるため、変化は両方向に起こる。
- 語形を聞こえたままに数え、「行った」と「行く」を別々に扱うと、500語時点の理解率は5.3〜7.7ポイント下がる。
- 語は意味がいくつあっても1語としか数えないため、カバー率も理解できる行数も高めに出る。各行がどの意味で使われているかは数えていない。部分的な検証として、Sudachi が付与する品詞ごとに語を別々に数えたところ、500語時点で理解できる行数が1.2〜2.5ポイント下がった。この検証で捉えられるのは、名詞と動詞の違いのようなものだけだ。
- Sudachi は間違えることもある。語を断片に切り分けてしまうことがあり、一部の固有名詞を普通の語として扱うこともある。フリーレン(Frieren)は彼女自身のリストで31位に入っている。Sudachi が未知語と判定した語をすべて既知として数えても、500語時点で上がるのは最大0.6ポイントだ。
learnfromxは、アニメで日本語を学べる単語カードアプリだ。カードは、新しい単語をひとつだけ除いてすべて理解できるセリフから作られている。だからこそ、私たちはセリフを数え始めた。上の数字は、単語にいくつ意味があっても、それぞれ一度だけ数えている。アプリではそうはいかない。あれを「that」として知っていても、誰かが「あれ?」と言ったときには役に立たない。これは別々のカードになる。まだすべての単語を拾えているわけではなく、対応を進めている。アーリーアクセス中に提供している作品は Hunter x Hunter の1本だけだ。