认识 86% 的词,却只听得懂 38% 的台词
背下一部动画里最常见的 500 个词,覆盖率是 85.9%,可三千句台词里能一次听懂的只有 38.4%。八部番剧的字幕数据说明这个差距从哪来。
中文
复制
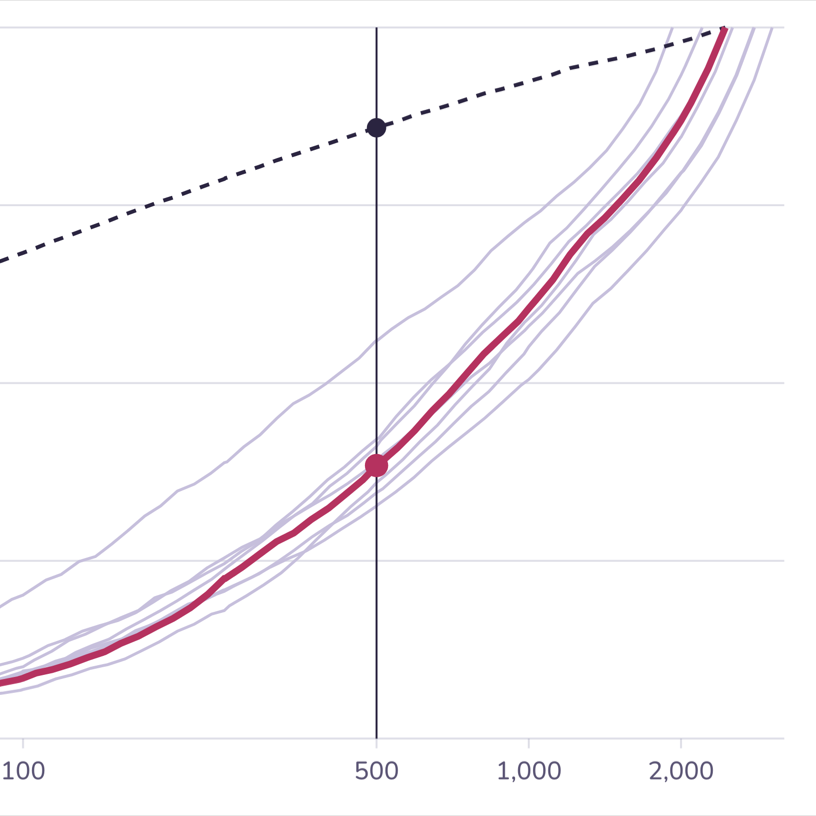
假设你想看《葬送的芙莉莲》,于是先学了剧中最常见的 500 个词。一个覆盖率计算器显示,你现在已经认识剧中 85.9% 的词了。
你泡好茶,按下播放键。下面这三句,都是你听到的。
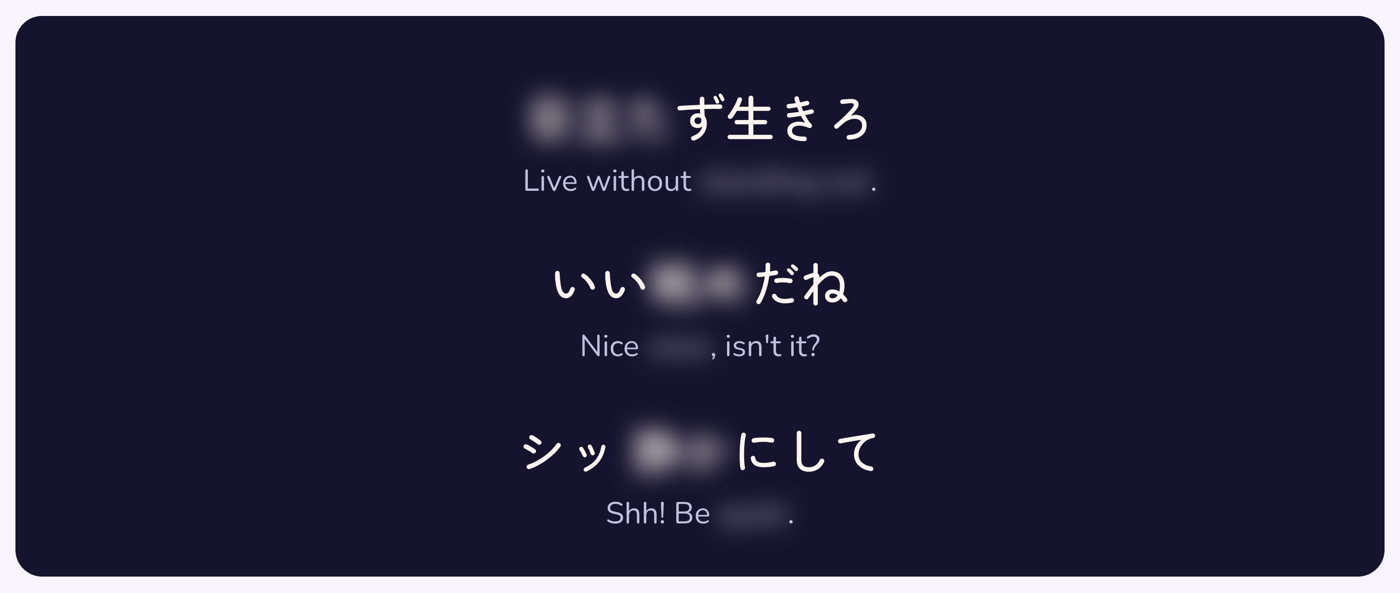
你第三次停下来查词的时候,茶已经凉了。掌握这 500 个词,前 3,000 句台词里有 1,151 句你每个词都认识,占 38.4%。剩下 1,849 句,每句至少有一个词你不认识。
两个数字都是真的
覆盖率是大多数学习网站引用的数字。它指的是你认识的词在全部词次中占的比例,所以一个助词出现一千次就计一千次。《葬送的芙莉莲》的词表最靠前的全是 の(的)、は(主题标记)这类语法成分,光前 100 个词就能给你 68.3% 的覆盖率。但你能听懂的只有 8.5% 的台词。
同样这 500 个词,可以用三个数字来描述。
| 衡量的对象 | 《葬送的芙莉莲》前 3,000 句 |
|---|---|
| 认识的词 | 2,448 个不同词中的 500 个(20.4%) |
| 覆盖率(含重复) | 85.9% |
| 听懂的台词(每个词都认识) | 38.4% |
manga-kotoba 的覆盖率表就是这么算的。jpdb 和 jiten 也给出覆盖率数字,不过它们的帮助页面没有写明具体公式。
覆盖率和台词数之间的差距来自每句的长度。这部剧平均每句 7 个词,七个词全认识才算听懂这一句。覆盖率 85.9% 时,听懂一整句的概率约为 35%,也就是 0.859 自乘七次。这个结果和我们实测的 38.4% 很接近。
拿你喜欢的剧试试
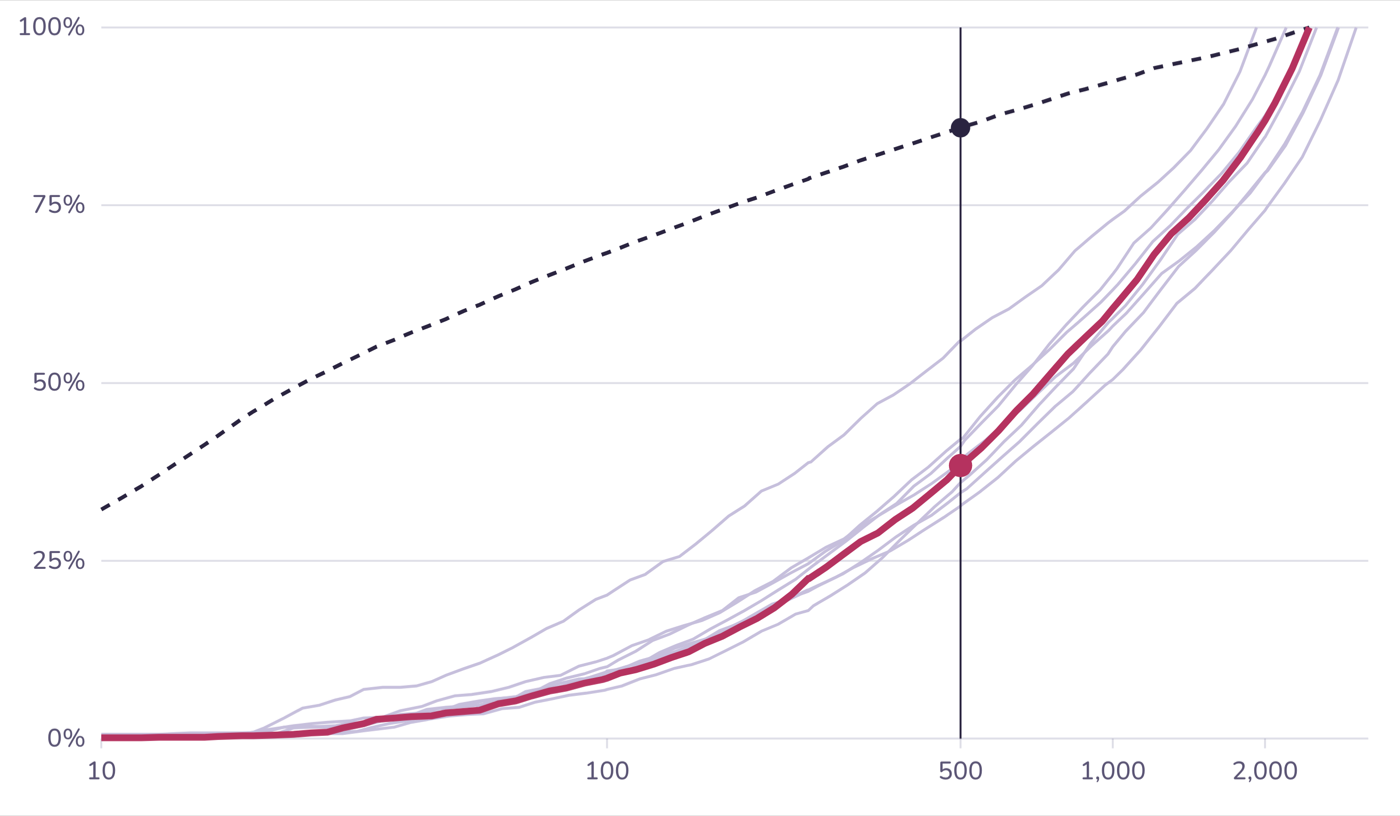
粗线是在该剧里能听懂的台词,虚线是该剧的字幕覆盖率,浅色线是在另外七部剧里能听懂的台词。每条曲线都假设你先学该剧最常用的词。
八部剧都有这个缺口。Serial Experiments Lain 用 1,191 个词就达到 95% 的覆盖率,是八部里最少的。即便如此,你也只能跟上 77.5% 的台词。
有些剧需要的词远少于其他剧
八部剧里 Serial Experiments Lain 需要的词最少,大约 400 个就能听懂一半台词。Jujutsu Kaisen 需要 980 个。
| 剧集 | 台词数 | 集数 | 不同词数 | 500 词时覆盖率 | 500 词时听懂的台词 | 听懂一半台词所需词数 |
|---|---|---|---|---|---|---|
| Serial Experiments Lain | 2,034 | 13 | 1,924 | 88.0% | 55.9% | 401 |
| Dororo | 3,000 | 13 | 2,431 | 85.2% | 42.1% | 633 |
| Chainsaw Man | 2,849 | 12 | 2,203 | 86.3% | 41.1% | 647 |
| Frieren | 3,000 | 12 | 2,448 | 85.9% | 38.4% | 730 |
| Mob Psycho 100 | 3,000 | 8 | 2,795 | 82.4% | 39.1% | 749 |
| Death Note | 3,000 | 11 | 2,529 | 86.6% | 36.0% | 782 |
| Hunter x Hunter (2011) | 3,000 | 12 | 2,785 | 82.3% | 34.6% | 862 |
| Jujutsu Kaisen | 3,000 | 10 | 3,028 | 81.5% | 32.7% | 980 |
每部剧都截取到 3,000 句台词,免得集数多的长剧显得更难。如果一部剧越往后越难,它在这里看起来会比实际容易。
听不懂的台词里,很多只差一个词
回到 Frieren。你漏掉了 1,849 句台词。其中 1,042 句只缺一个词,占 56.4%。八部剧里这个比例从 50.2% 到 63.9% 不等。
こちらは約束の報酬です(这是我们承诺的报酬)
从 500 词增加到 1,000 词,带来的帮助远大于覆盖率显示的程度。覆盖率只涨 6.5 个百分点,因为这些新词不常出现。听懂的台词涨 22.1 个百分点,因为一个新词往往就是听懂一句台词所缺的最后一个词。
这些一词之差的缺口没法靠几个词补上。那 1,042 句台词合计缺 804 个不同的词。单个词最多帮你多听懂 4 句台词,比如 後悔(后悔)、約束(约定)和 収集(收集)这样的词。
掌握 2,000 个日语常用词,最多只能听懂 38% 的台词
做个粗略对比。我们用 wordfreq 词表里 2,000 个最常用的普通日语词试了一遍,能听懂的台词占 23.4% 到 37.6%。接着换成每部剧自己的前 2,000 个高频词,比例升到 74.3% 到 93.3%。Serial Experiments Lain 全剧的不同单词不到 2,000 个,所以不在后一个区间里。
一部剧的高频词可能很冷门。《葬送的芙莉莲》词表第 304 位是 生臭坊主,指不守戒律的和尚,正是剧中角色一直用来称呼海塔的词。第 21 位是 魔法,比 私(我)还靠前四位。
用前几集建好的词表,后面仍能覆盖三分之二
假设你用一季的台词学了一部剧的高频词,然后接着看下一季。我们在台词量足够的四部剧上做了接近这个场景的测试。用前 3,000 句台词建词表,再拿它测接下来的 3,000 句。在《芙莉莲》的后 3,000 句里,旧词表覆盖 22.3%,而用这 3,000 句本身建的词表覆盖 33.0%。試験(考试)在前 3,000 句里只出现 1 次,之后出现 51 次,因为角色后面要参加魔法师考试。四部剧的降幅在 5.5 到 14.0 个百分点之间。
一词多义让这些数字偏高
很多词有多个义项,语言学家称之为多义现象。我们统计时,一句台词用的是哪个义项,就算你认识这个词。认识 500 个词时,《芙莉莲》里这两句都算听懂了,手が震えています(我的手在发抖)和 手に取るように分かる(了如指掌)。你可能从第一句起就把 手(手)认得清清楚楚,到第二句照样一头雾水。逐字直译,它的意思是“像拿在手里一样”。有多少句存在这个问题,我们没有统计。单凭这一点,听懂的台词比例就是偏高的。
统计方法
流程
- 清洗字幕。去掉歌词、格式标签、方括号里的内容和音符,把文本切成句子长度的片段,删除重复的句子。
- 用免费的日语分词器 Sudachi 把每一句切成词。我们用的是 SudachiPy 0.6.11 配 SudachiDict-core 20260428,split 模式 C,Python 版本 3.13.7。每个词取词典形,所以 行った(去了)和 行く(去)算同一个词。
- 跳过标点、数字,以及 Sudachi 标注为专有名词的内容。
- 跳过 シッ(嘘)、ハハッ(哈哈)这类填充词。只有 Sudachi 标注为感叹词、副词或名词的声音才算填充词。语法词尾 ん 的标注不同,仍然计入。助词和 うん(嗯)这类日常应答也算词。
- 丢掉切完没有剩余词的句子,按集数排序,保留前 3,000 句。
- 统计每个词的出现次数并排名,次数相同按字母顺序排列。
- 把前 N 个词视为已掌握。覆盖率 = 已掌握词的出现次数 ÷ 全部词的出现次数。听懂台词的比例,指每个词都认识的句子所占的百分比。
全部逻辑,29 行 Python
# pip install sudachipy sudachidict_core
# lines.txt: one subtitle line per row, in episode order, songs and repeats removed
# fillers.txt: your own list of sounds not to count, one per row
from collections import Counter
from sudachipy import Dictionary, SplitMode
import re

tok = Dictionary().create()
fillers = set(open("fillers.txt", encoding="utf-8").read().split())

def words(line):
 out = []
 for m in tok.tokenize(line, SplitMode.C):
 pos = m.part_of_speech()
 if pos[0] in ("補助記号", "空白", "記号"): continue # punctuation
 if pos[1] in ("固有名詞", "数詞"): continue # names, numbers
 if not re.search(r"[0-9A-Za-zぁ-ヿ一-鿿々]", m.surface()): continue
 if m.surface() in fillers and pos[0] in ("感動詞", "副詞", "名詞"): continue
 out.append(m.dictionary_form())
 return out

lines = [words(l.strip()) for l in open("lines.txt", encoding="utf-8")]
lines = [l for l in lines if l][:3000] # the first 3,000 lines with a real word
count = Counter(w for line in lines for w in line)
known = {w for w, _ in sorted(count.items(), key=lambda x: (-x[1], x[0]))[:500]}

coverage = sum(n for w, n in count.items() if w in known) / sum(count.values())
understood = sum(all(w in known for w in line) for line in lines) / len(lines)
print(f"coverage: {coverage:.1%} lines understood: {understood:.1%}")
拿我们自己的《葬送的芙莉莲》台词跑一遍,输出 85.9% 和 38.4%。我们没有保留未经处理的字幕文件。换成你自己的字幕和填充词表,数字会略有不同。
全部数字
每个单元格先给出覆盖率,再给出在该已知词数下能听懂的台词比例。
| 剧集 | 100 词 | 250 词 | 500 词 | 1,000 词 | 2,000 词 |
|---|---|---|---|---|---|
| Serial Experiments Lain | 70.8% / 20.2% | 81.4% / 38.8% | 88.0% / 55.9% | 93.7% / 73.0% | n/a |
| Dororo | 64.5% / 10.1% | 76.6% / 24.6% | 85.2% / 42.1% | 92.0% / 63.1% | 97.8% / 87.6% |
| Chainsaw Man | 66.0% / 9.4% | 78.4% / 23.8% | 86.3% / 41.1% | 93.2% / 65.3% | 98.9% / 93.3% |
| Frieren | 68.3% / 8.5% | 78.7% / 22.5% | 85.9% / 38.4% | 92.4% / 60.5% | 98.0% / 86.9% |
| Mob Psycho 100 | 64.7% / 11.3% | 75.1% / 25.4% | 82.4% / 39.1% | 89.5% / 58.0% | 95.8% / 79.5% |
| Death Note | 67.3% / 6.9% | 78.9% / 18.0% | 86.6% / 36.0% | 93.0% / 59.1% | 98.0% / 84.6% |
| Hunter x Hunter (2011) | 63.0% / 9.0% | 74.0% / 20.9% | 82.3% / 34.6% | 89.9% / 55.1% | 96.3% / 79.6% |
| Jujutsu Kaisen | 63.7% / 9.5% | 74.3% / 20.7% | 81.5% / 32.7% | 88.4% / 50.5% | 94.8% / 74.3% |
要达到指定台词理解比例所需的已知词数
| 剧集 | 25% 的台词 | 50% | 75% | 90% |
|---|---|---|---|---|
| Serial Experiments Lain | 130 | 401 | 1,082 | 1,686 |
| Dororo | 254 | 633 | 1,429 | 2,101 |
| Chainsaw Man | 263 | 647 | 1,313 | 1,893 |
| Frieren | 283 | 730 | 1,491 | 2,111 |
| Mob Psycho 100 | 241 | 749 | 1,775 | 2,458 |
| Death Note | 345 | 782 | 1,545 | 2,200 |
| Hunter x Hunter (2011) | 320 | 862 | 1,768 | 2,446 |
| Jujutsu Kaisen | 328 | 980 | 2,032 | 2,695 |
哪些因素会让结果不准
- “听懂”指每个词都认识。它不考虑语法、汉字读音、语速和上下文。
- 我们假设你恰好认识剧中最常见的那些词,而且一个都没忘。如果你认识的是别的词,或者忘了一些,这些数字会更低。而且你得在看之前先拿到一份该剧的词表。
- 每句不同的台词只计一次。实际看剧时,像 うん(嗯)这样的套话会反复出现,这很可能提高能听懂的台词比例。我们没有测量这一点。
- 台词取自各剧最早的若干集,没有跳集。Chainsaw Man 和 Serial Experiments Lain 的台词不足 3,000 句,所以用了它们的全部台词。台词越少,得分越高。在 500 词时,其他剧集截到 Lain 的长度后,得分最多高出 4.8 个百分点。Serial Experiments Lain 的字幕质量较低,因此它的数字可靠性也更差。
- 有些字幕文件会用略微不同的措辞重复同一句台词,我们只删除了完全重复的。把近似重复的也删掉,500 词时能听懂的台词比例最多变化 2.2 个百分点。
- 什么算填充词是个判断问题。如果把填充词也算作词,500 词时能听懂的台词比例最多相差 2.7 个百分点。变化是双向的,因为我们计入的台词会随之改变。
- 按实际听到的形式计数,即 行った 和 行く 分开计,500 词时能听懂的台词比例会下降 5.3 到 7.7 个百分点。
- 一个词无论有几个义项都只算一次,这会让词汇覆盖率和“听懂的台词”都偏高。我们无法统计每一句用的是哪个义项。作为部分检验,我们按 Sudachi 给出的每个词性分别计数,在 500 词时“听懂的台词”下降了 1.2 到 2.5 个百分点。这种检验只能捕捉名词与动词之类的差异。
- Sudachi 会出错。它有时会把一个词切成碎片,还会把一些名字当作普通词处理,フリーレン(Frieren)在她自己的词表上排第 31 位。把 Sudachi 不认识的每个词都算作已知词,在 500 词时最多只增加 0.6 个百分点。
learnfromx 是一款用动画教日语的闪卡应用。每张卡片配一句台词,台词里除了那一个新词,其他你都认识,这也是我们开始统计台词数的原因。上面的数字对每个词只计一次,不管它有几个义项。放到应用里这样行不通。知道 あれ 是“那个”,碰上有人说 あれ?(咦?)也帮不上忙。这是两张独立的卡片。目前还没能覆盖所有这类词,我们正在改进。抢先体验期间只提供一部作品,Hunter x Hunter。
来源: learnfromx← 返回首页