Anthropic のソースコード管理システムを再設計する
Anthropic の 1 日あたりのマージ回数が 10 倍以上に増えたため、チームは 5 か月で git ベースの構成を自社開発のバージョン管理システム Scion に置き換え、どの操作がどれだけ速くなったかを数字で示した。
日本語
コピー
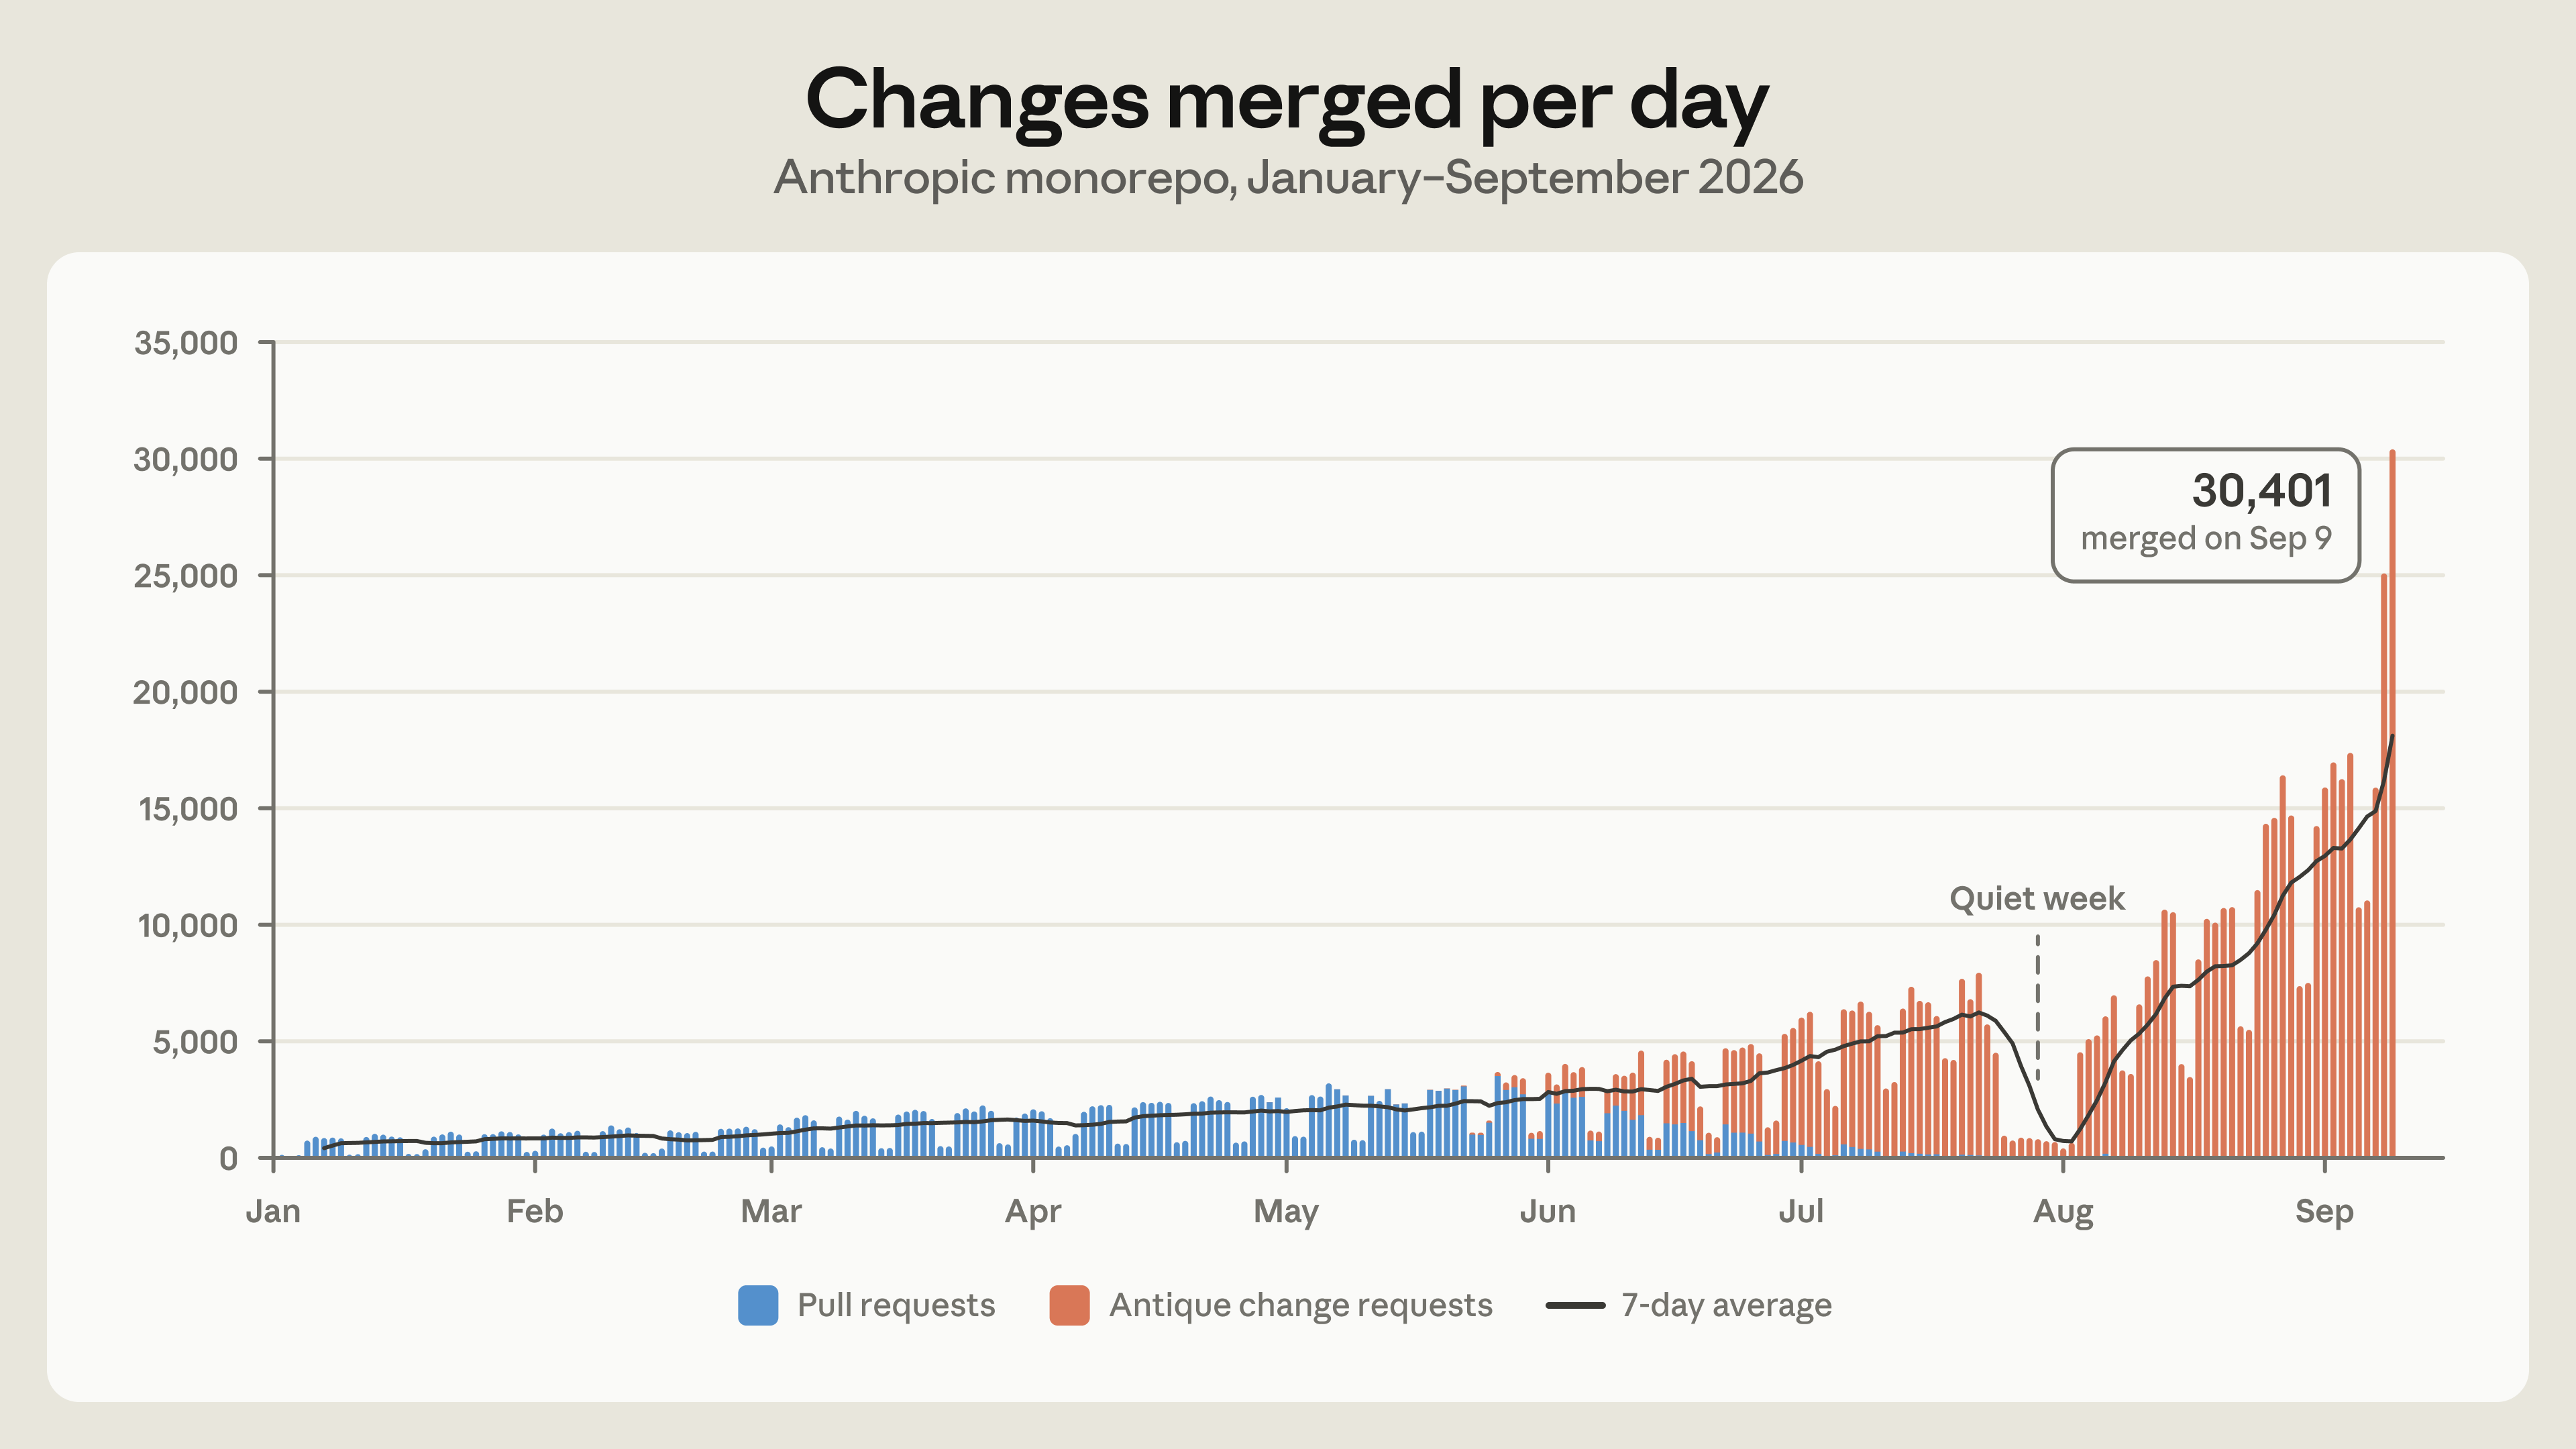
1 日あたりのマージ数が 10 倍以上に増えるにつれ、ソースコード管理は開発における最大のボトルネックになった。ここでは、5 か月で自社製のバージョン管理システムへ移行した経緯を共有する。
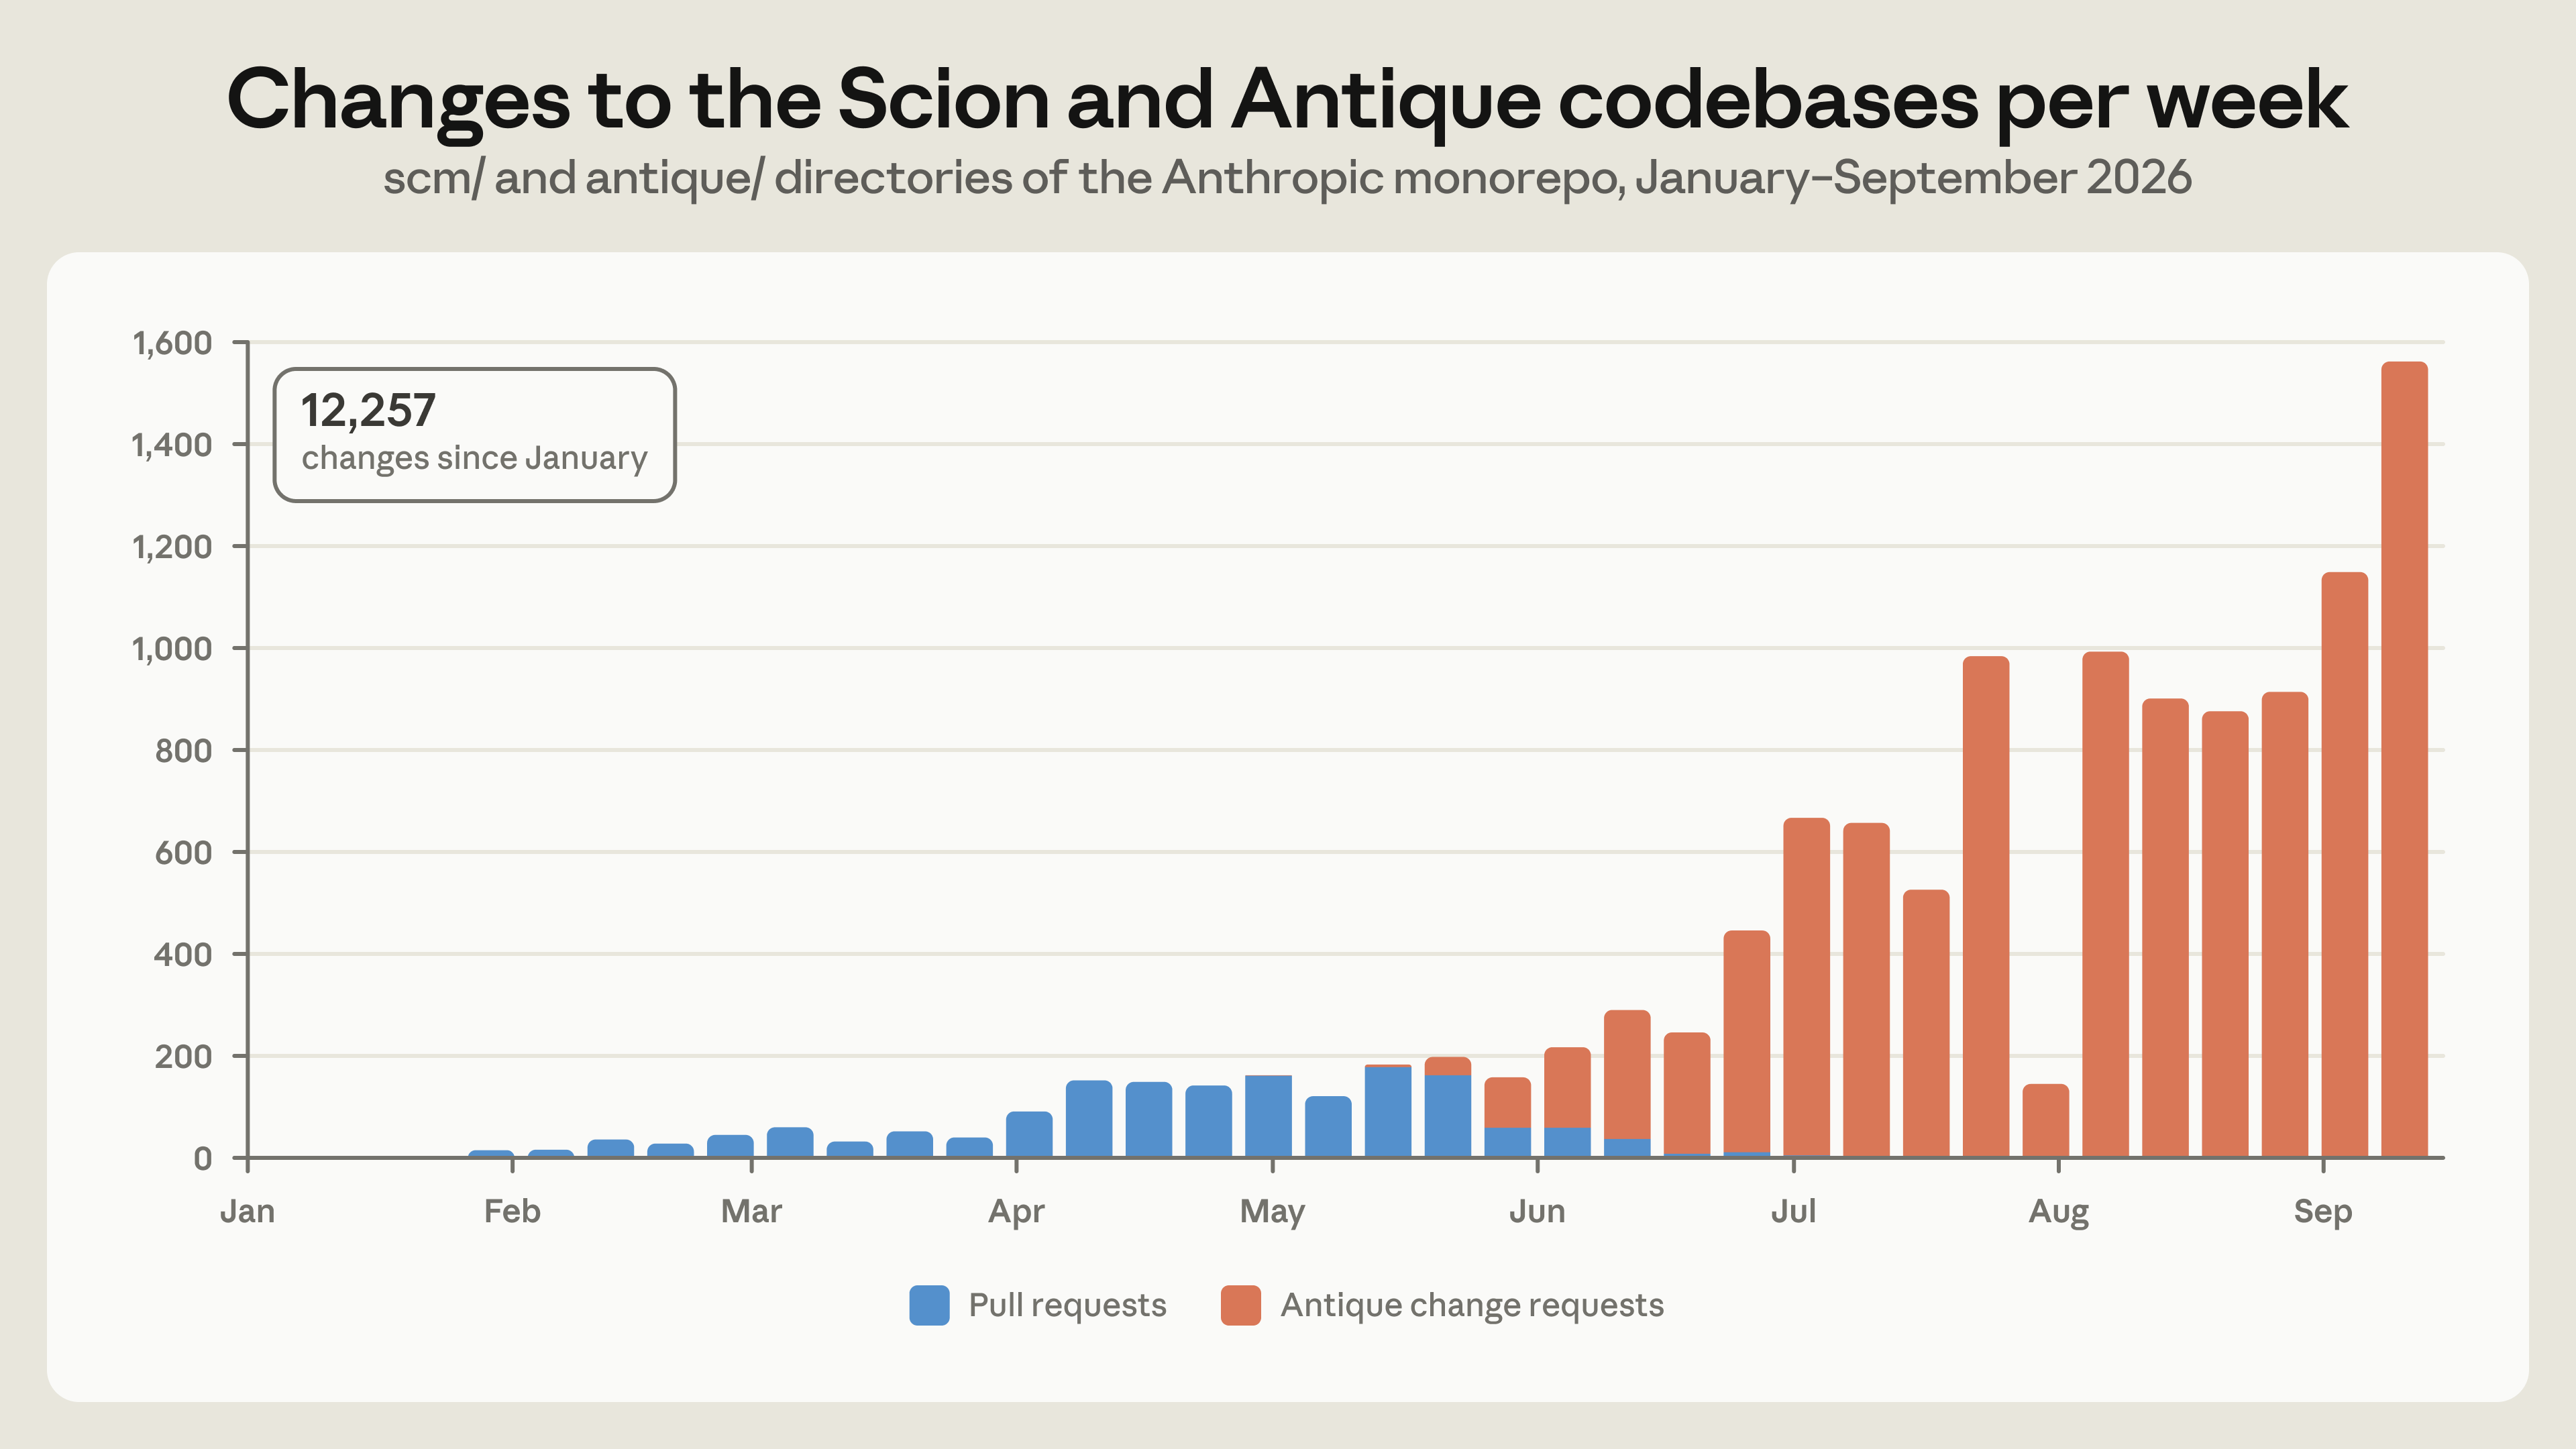
Anthropic では、コードを書くこと自体はもはやシステム構築や研究を進めるうえでのボトルネックではない。Claude は研究サイクルを自律的に回し、複雑なプログラムをマイクロ最適化し、新しいサービスをゼロから立ち上げる。その速度と規模はこれまでに見たことがないものだ。今のボトルネックは、人間の規模を前提に作られた開発者インフラ一式、つまりソースコード管理、ビルド、CI にある。2026 年 5 月、Anthropic は 1 日あたり平均約 2,500 件のコード変更をマージしていた。9 月には 1 日 30,000 件を超えている。この増加ペースが近いうちに落ち着くとは考えていない。コードをマージしたいという潜在的な需要はほぼ無限にあり、ボトルネックをひとつ解消するたびに、コードの産出量はすぐにまた一段上がる。
こうした成長を支えるため、私たちは社内バージョン管理システム Scion を自作し、5か月かけて monorepo を git から完全に移行した。同じ時期に、コードレビュー UI(Antique)、コード検索、本格的なソースコード管理向け IAM システム、レビュー済みコードを大量に管理・マージする新しい仕組みなども作り、稼働させている。本記事は Scion そのものをどう作ったかに絞る。面白い事例だ。Claude のコーディング能力が、私たちをこの状況に追い込んだ原因であり、同時に、高品質でスケールするシステムを素早く組み上げて対処できた理由でもある。
monorepo の成長
何をしたかを述べる前に、私たちの負荷がいかに特殊かを説明しておきたい。当然ながら、Anthropic が Claude でソフトウェアを書く度合いは他のほぼどの企業よりも大きい。だから「人間規模を前提に設計されたツールが悲鳴を上げ始める」地点に最初にぶつかるのは、たいてい私たちだ。バージョン管理はその一例にすぎない。多くの組織が近いうちに同じ問題に直面するとは思わないが、AI コーディングツールを使う他の開発者も、同じ圧力点にそう遠くなく突き当たるだろう。何をして何を学んだかを共有したいと思ったのはそのためだ。
Git は分散型システムだ。各 clone は完全で自己完結したリポジトリであり、diff の計算、履歴や blame の参照、任意バージョンのチェックアウトをすべてオフラインで行える。ほとんどのリポジトリにとってこれは正しい設計であり、git が標準になった大きな理由でもある。
私たちの monorepo が成長するにつれ、この設計の想定範囲からどんどん外れていった。main の履歴だけで 100 GB 近く、_圧縮後_の作業コピーでも 25 GB を超える。CI のために毎日実行されるチェックアウトは 2500 万回規模で、開発者環境、agent サンドボックス、研究タスクは含まれていない。素朴に全量を取得すれば、1 日あたり 600 PB 以上の git トラフィックになる。
Git にはリポジトリの一部だけを扱う手段がある。shallow clone、sparse checkout、promisor remote などだ。それ以外にも、大規模 monorepo には定番の回避策がある。社内 git mirror や、blob ストレージに置いたリポジトリのスナップショット(seed)だ。私たちはこれらをすべて使った。ピーク時には負荷をさばくために数百の社内 git mirror を動かしていた。これで時間は稼げたが、マージ頻度が上がるにつれて運用がどんどん難しくなった。seed は更新のたびに main の先端から遠ざかり、diff や blame のような履歴依存の操作を部分クローン上で正しく動かすには、ますます手間がかかるようになった。
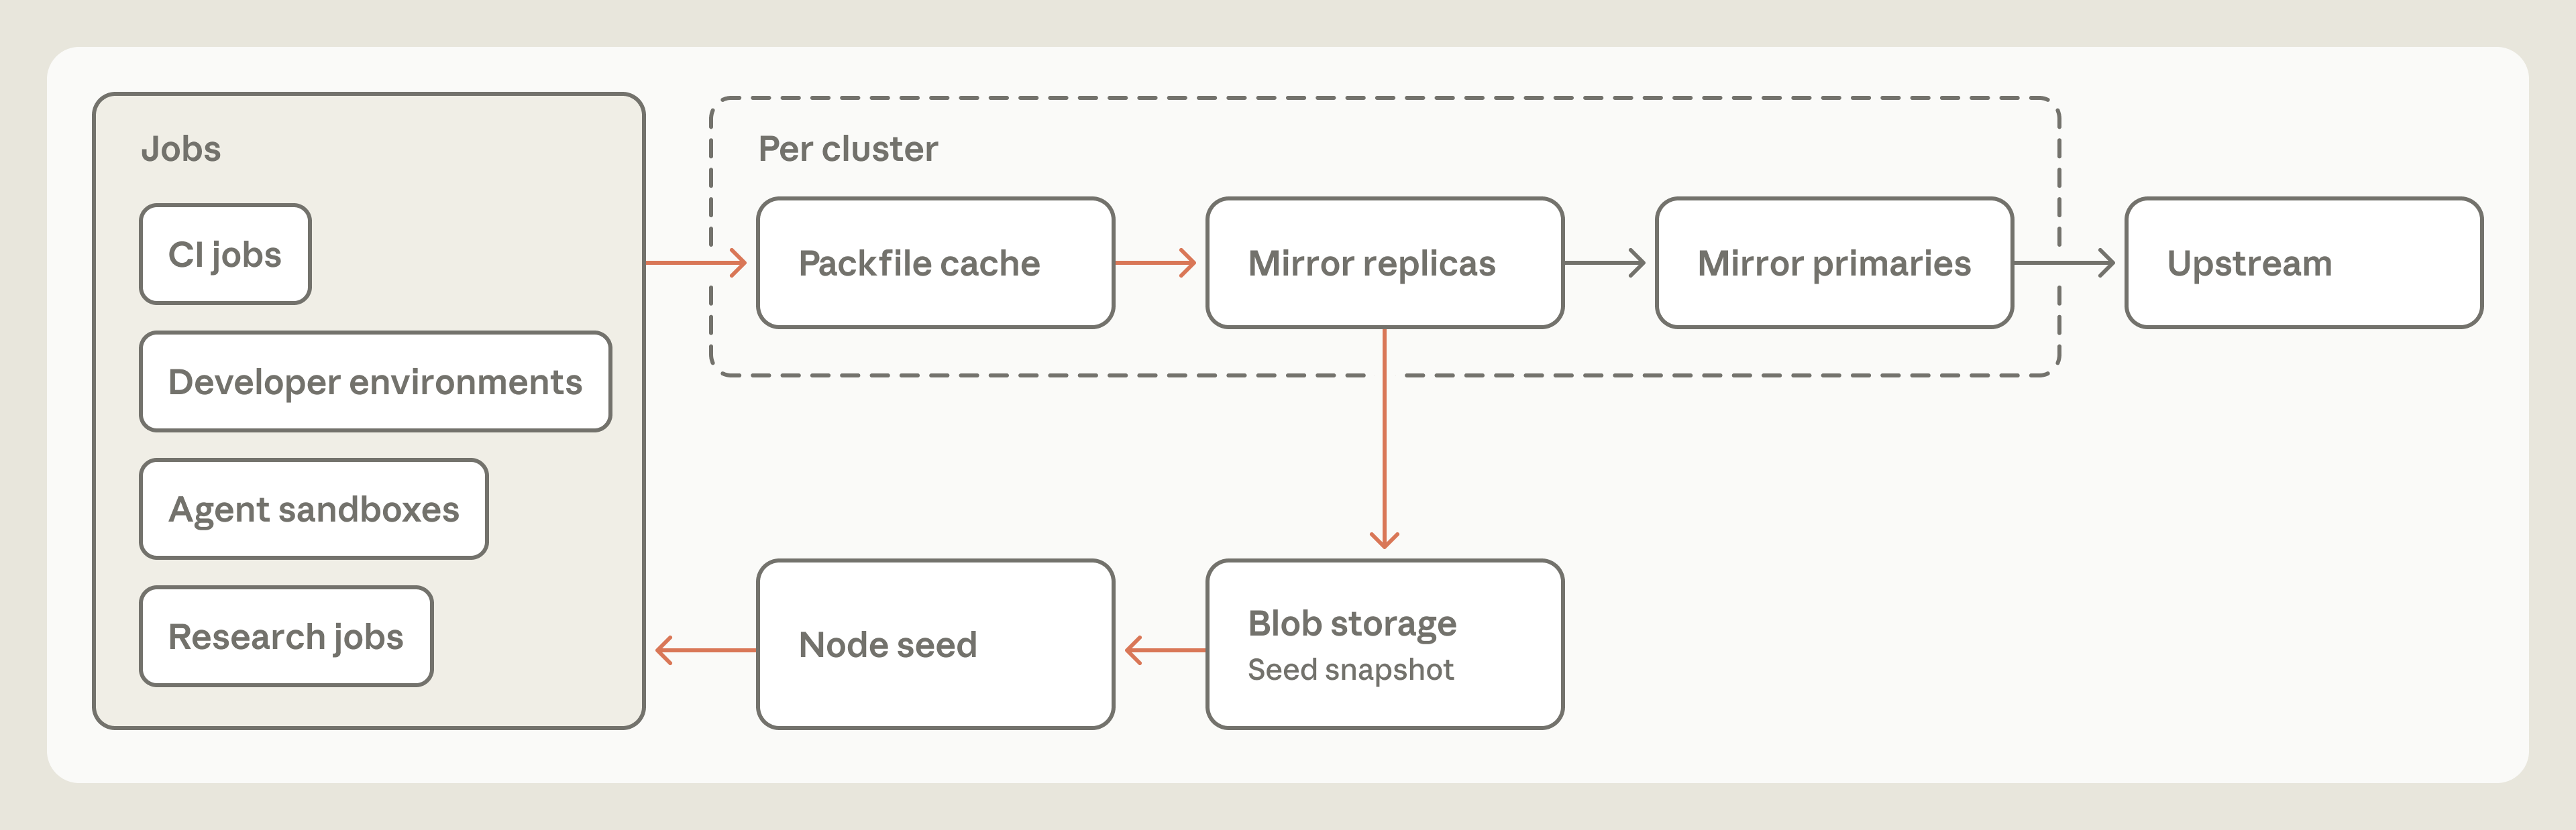
一歩引いて見ると、私たちはほとんどの企業と同じように git を集中型システムとして使っている。権威あるコピーは一つだけだ。だが私たちのクライアントはほぼすべて agent と job であり、それらは定義上つねにオンラインだ。git が分散・オフラインの場面で力を発揮するその特性こそ、リポジトリが大きくなるにつれて私たちの拡張性を足枷にしていた。そこで考えた。agent がつねにオンラインであるという事実を最初からソース管理の設計に織り込んだら、それはどんな形になるだろうか。
agent 規模のソース管理の原則
agentic coding の文脈では、ソフトウェア開発の進め方に関する多くの前提が変わりつつある。Scion を作るにあたって私たちはその変化を受け入れ、そのおかげでいくつかの核心的な原則において git とは根本的に異なるやり方を取れた。超大規模 monorepo 向けのソース管理には先例があり、とりわけ Google の Piper と Meta の Sapling がある。だから Scion を作る際には、彼らが苦労して得た知見を借りられた。私たちの原則はこうだ。
クライアントはつねにオンライン。 git はクライアントがオフラインで作業し、リポジトリの完全なコピーを持つことを前提にしている。私たちのクライアントはほぼすべて agent と job なので、Scion のクライアントとプロトコルはつねに到達可能なサーバーを中心に設計し、クライアントは必要になったときにデータを取りに行く。
クライアントとサーバーは非対称。 git では、どのクライアントも完全なサーバーとして振る舞える。Scion では、ファイル履歴や blame の問い合わせに答え、commit を作り、merge や rebase を実行するのはサーバーだ。クライアントは有界のローカルオブジェクトキャッシュを保ち、作業コピーのファイルをディスクに書き出し、ファイルシステムの変更を監視し、サーバー操作を扱いやすい形でユーザーに提供する。自分で計算できることはほとんどないが、その代わりにローカルで必要なデータ量がはるかに小さくなる。
完全なソース管理サービスは、多くの新しいアプリケーションを支えられる。 git では、CI job やツールがリポジトリのある問い、たとえばある行を最後に変えたのは誰か、二つの commit の関係は何か、を調べようとすれば、ローカルにリポジトリのコピーを維持するか、ベンダー固有の API が答えてくれることを当てにするしかない。Scion では、クライアントが使うソース管理の問い合わせはすべて API として公開されているので、多くの場合 job にローカルリポジトリは要らない。私たちの自動 bisect や revert のパイプラインなど、多くの社内ツールは、この安価でプログラム可能なソース管理へのアクセスがなければ、規模の面で到底成り立たなかった。
どのコンポーネントも水平にスケールできなければならない。 ピーク時には数百の git ミラーを動かしており、容量はぎりぎりだった。リポジトリのサイズがミラーのディスクやメモリの上限を超えると、このやり方はもう拡張できない。Scion ではリポジトリのデータは分散され、各コンポーネントが独立にスケールする。どこにもリポジトリの完全な実体化コピーは存在しない。サーバー上にもない。packfile(git がオブジェクトをまとめる圧縮ファイル)に相当するものがないので、リポジトリのメンテナンスも不要だ。
commit は安価で、増分的で、ロックフリーでなければならない。 git ではローカルで commit し、それを push して共有する。Scion では commit、rebase、merge のすべてがサーバー上で起きるので push すべきものは何もないが、その代わりこれらの操作の一つひとつが十分速くなければならない。commit を一つ作り、その下流のデータ構造を更新するコストは、変更の大きさに比例して増えるべきであって、リポジトリ全体の規模に比例してはいけない。そうでなければサーバーがもたない。Scion の開発フローでは ref(commit を指すポインタ。ブランチやタグなど)の使用を推奨していない。main ref やリリースブランチは例外だ。すべてのサーバーが合意しなければならない_グローバル_な状態は、いずれ破綻する拡張性の問題だからだ。
作業コピーは任意であり、本質的に疎である。 私たちの monorepo は大きすぎ、さらに CI が 1 日に数千万回チェックアウトするので、避けられるならチェックアウトは避けたい。Scion では、ある commit とその merge base の間の diff が必要な CI タスクは、サーバーに直接要求できる。書き込みも同じだ。多くの書き込み負荷もチェックアウトを飛ばし、API だけで完結できる。Scion のプロトコルは疎なチェックアウトと仮想化されたチェックアウトを前提に設計されている。前者はクライアントが要求したディレクトリだけを含み、後者はファイルを必要に応じて実体化する。だからタスクが本当にファイルをディスクに必要とするとき、クライアントは実際に読む分だけのコストを払う。
Scion の仕組み
これらの原則が Scion の構築でどう実を結んだかを知ると役に立つ。この知見は他のソース管理システムにも、より広く言えばソフトウェア開発サイクルの他の段階にも当てはまる。
データ構造
Scion では、作業の単位は「changeset」、すなわち先行書き込みログの 1 レコードだ。changeset が格納する内容は、おおむね git の 1 commit に相当する。ただし git commit が tree へのポインタを格納するのに対し、changeset は最初の親に対して変化したファイルのリスト、1 および blob ストア内の圧縮されたファイル内容への内容アドレス指定ポインタを格納する。changeset はサーバー側で作られ、どこからでも使え、即座に利用できる。
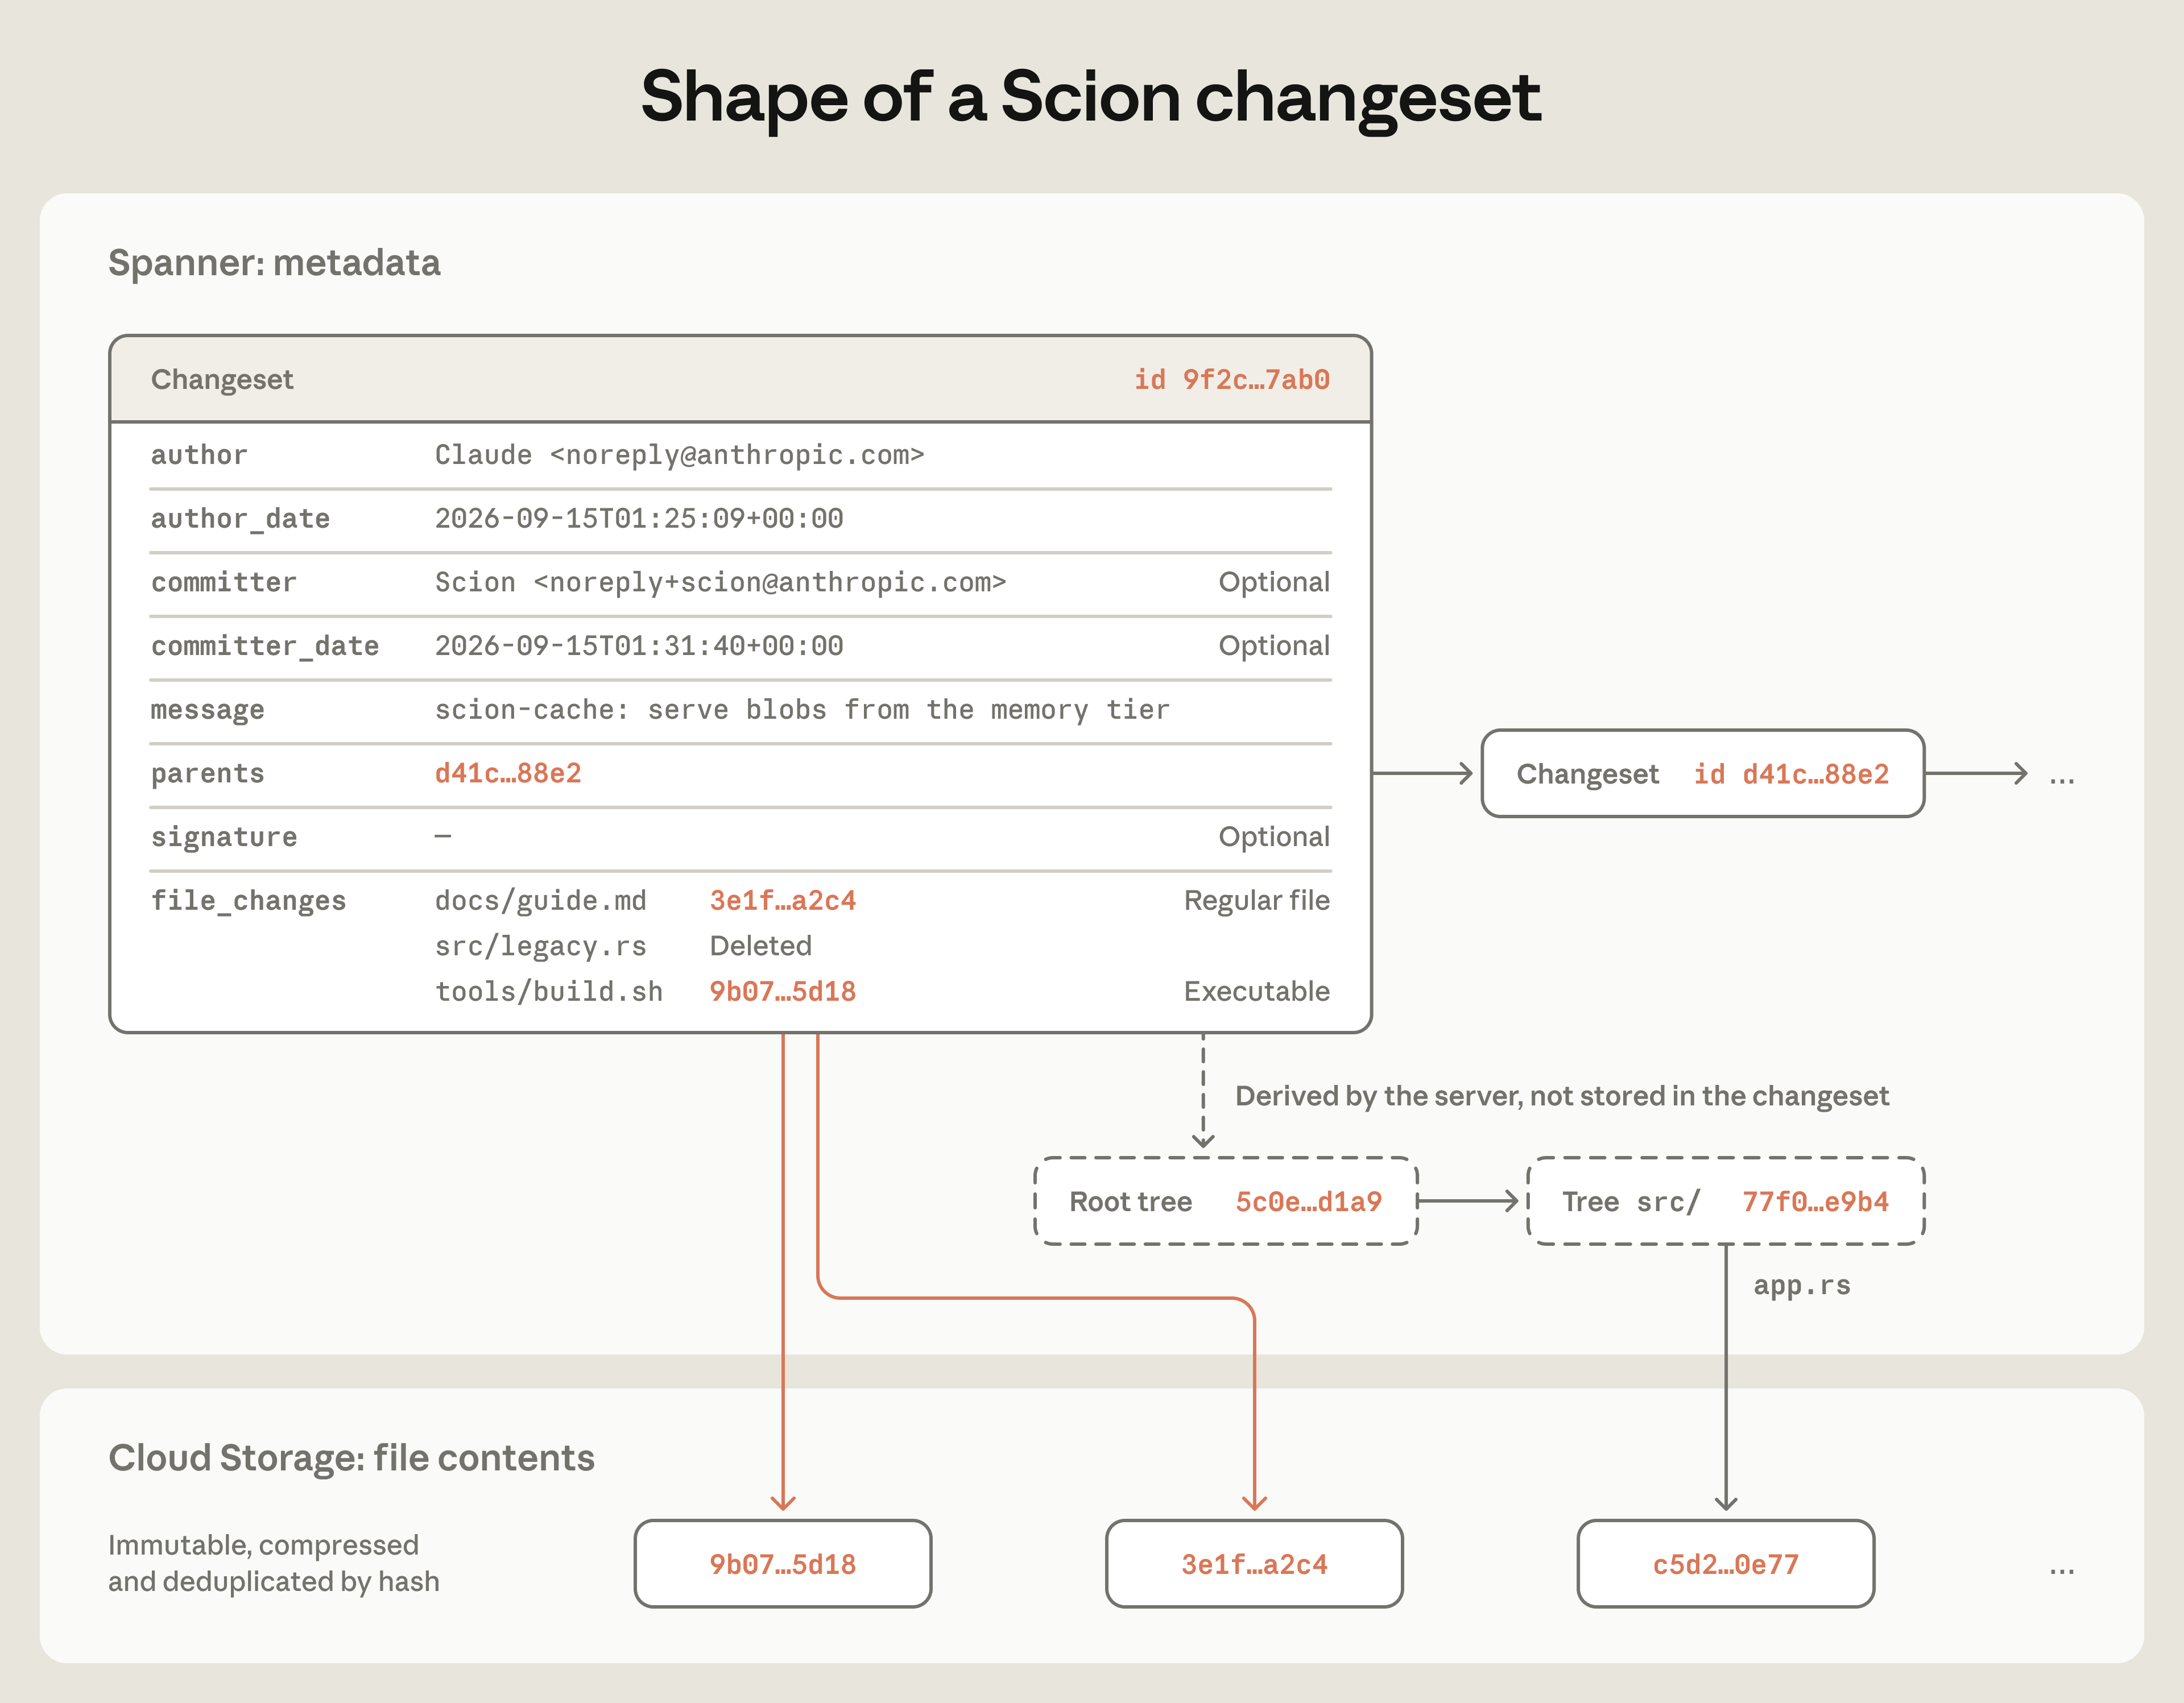
この構造により、changeset を極めて高いスループットで受信できる。packfile を受け取る必要がなく、ロックやサーバー間の調整もなく、ref を動かす必要もないからだ。Scion は技術的には ref をサポートしているが、commit の作成にも取得にも ref は関与しない。したがって ref の移動は Spanner の単一行に対する compare-and-swap にすぎず、changeset の作成とは互いに独立している。
changeset は変更内容しか記録しないため、それだけでは「ある行を最後に編集したのは誰か」「あるファイルに影響した commit はどれか」といった問いに素早く答えることはできない。こうした問いに答えるため、Scion は changeset を基に追加のデータ構造を構築する。file blame とパス履歴のための専用構造、commit graph のための skip list などだ。changeset に直接属さない部分をまとめて「derived data」と呼び、共通の仕組みで一括して計算する。各 derived data は再帰的に定義されるため、ある changeset における値は親 changeset の値から計算される。
この仕組みには利点が三つある。第一に、新しいデータ構造によってある操作を高速化できる場合、新しい derived data 型を簡単に追加できる。第二に、型ごとに即時計算か遅延計算を選べるため、不要なデータを実体化せずに済む。第三に、クライアントはこれらのデータ構造の内部詳細を見ることができないため、クライアントを変更せずに最適化できる。システムの成長に伴い、我々はこれまで何度も新しい derived data 型を追加してきた。たとえば copy detection やパスベースのファイル検索のための新しいインデックスなどだ。
Scion のスケーリング
小規模な Scion サーバー群だけで、changeset の取得、diff の計算、merge base の探索、blob の取得など、クライアントが必要とするあらゆる操作に source control API を提供できる。source control のデータはすべて内容アドレス指定であるため、一度保存されたデータは変化しない。どのサーバーも他のサーバーに確認することなくそのままキャッシュできる。したがってこれらのサーバーは水平にスケールし、調整はほとんど不要だ。実質的には大規模なキャッシュであり、同時に derived data をその場で計算し、結果を Spanner に書き戻すこともできる。
Scion の多くの利用者は、もはや各自でローカルリポジトリを維持する必要がない。従来、リポジトリを取得して維持することは、CI ジョブやバージョン管理に問い合わせるツールにとって重い保守負担だった。特に commit の祖先関係や blame を扱うクエリではそうだ。移行の初期段階では、自前のクライアント、リポジトリ形式、プロトコルが揃う前だったため、Scion はこうした「メタデータ」クエリに答えることだけを担っていた。ファイル内容の取得と作業コピーの生成ははるかにデータ量の多い操作であり、別途設計する必要があった。
Scion の scn クライアントは、いくつかの重要な点で git の fetch プロトコルから外れており、そのことが高度にスケーラブルなアーキテクチャに適している。必要な CPU は git サーバーよりはるかに少ない。Scion のネゴシエーションは、クライアントが何を持っているかをサーバーに伝えるのではなく、クライアントが欲しい tree と blob だけを対象に進む。ルート tree から始めて、クライアントはローカルストレージで欠けている tree を確認して再帰的に要求し、次に blob についても同じことを繰り返す。各リクエストは決して変化しない具体的なオブジェクトを対象とするため、どのキャッシュでも応答でき、アーキテクチャ全体は従来の多段キャッシュとよく似ている。数 GB の packfile レスポンスが存在しないため、この処理は効率的で、途中から再開できる。sparse checkout や仮想 checkout にも特別な対応は不要だ。クライアントは欲しくない tree をそもそも要求しないからである。
クラスタ内では、クライアントはソケットを通じてデーモン scion-daemon と通信し、デーモンがノード全体のためにオブジェクトを保存する。我々のノードのほとんどは monorepo にアクセスする必要があり、同じノード上のタスクは大部分で同じオブジェクトを再利用する。各デーモンは定期的に更新されるスナップショットから起動し、その後は同じリージョン内の tree と blob のキャッシュサーバー、すなわち scion-cache とのみ通信する。キャッシュサーバーは、デーモンが消費するディスク形式のままオブジェクトをメモリから直接ストリーミングするため、クライアントに欠けているオブジェクトを計算したり差分圧縮したりする時間は不要だ。キャッシュにオブジェクトがない場合、権威である scion-servers に要求し、後者が Spanner やクラウドストレージからオンデマンドで読み出す。
scion-daemon、scion-cache、scion-server はこのプロトコル上でまったく同じ RPC に応答するため、クライアントはキャッシュのトポロジーを知る必要がない。理論上はどの層も別の層と通信できるが、障害ドメインを分離するため、我々は層を厳格に強制している。避けたいのは、あるリージョンの scion-cache の障害が上流の scion-server を圧迫し、システム全体を巻き込んで倒す事態だ。
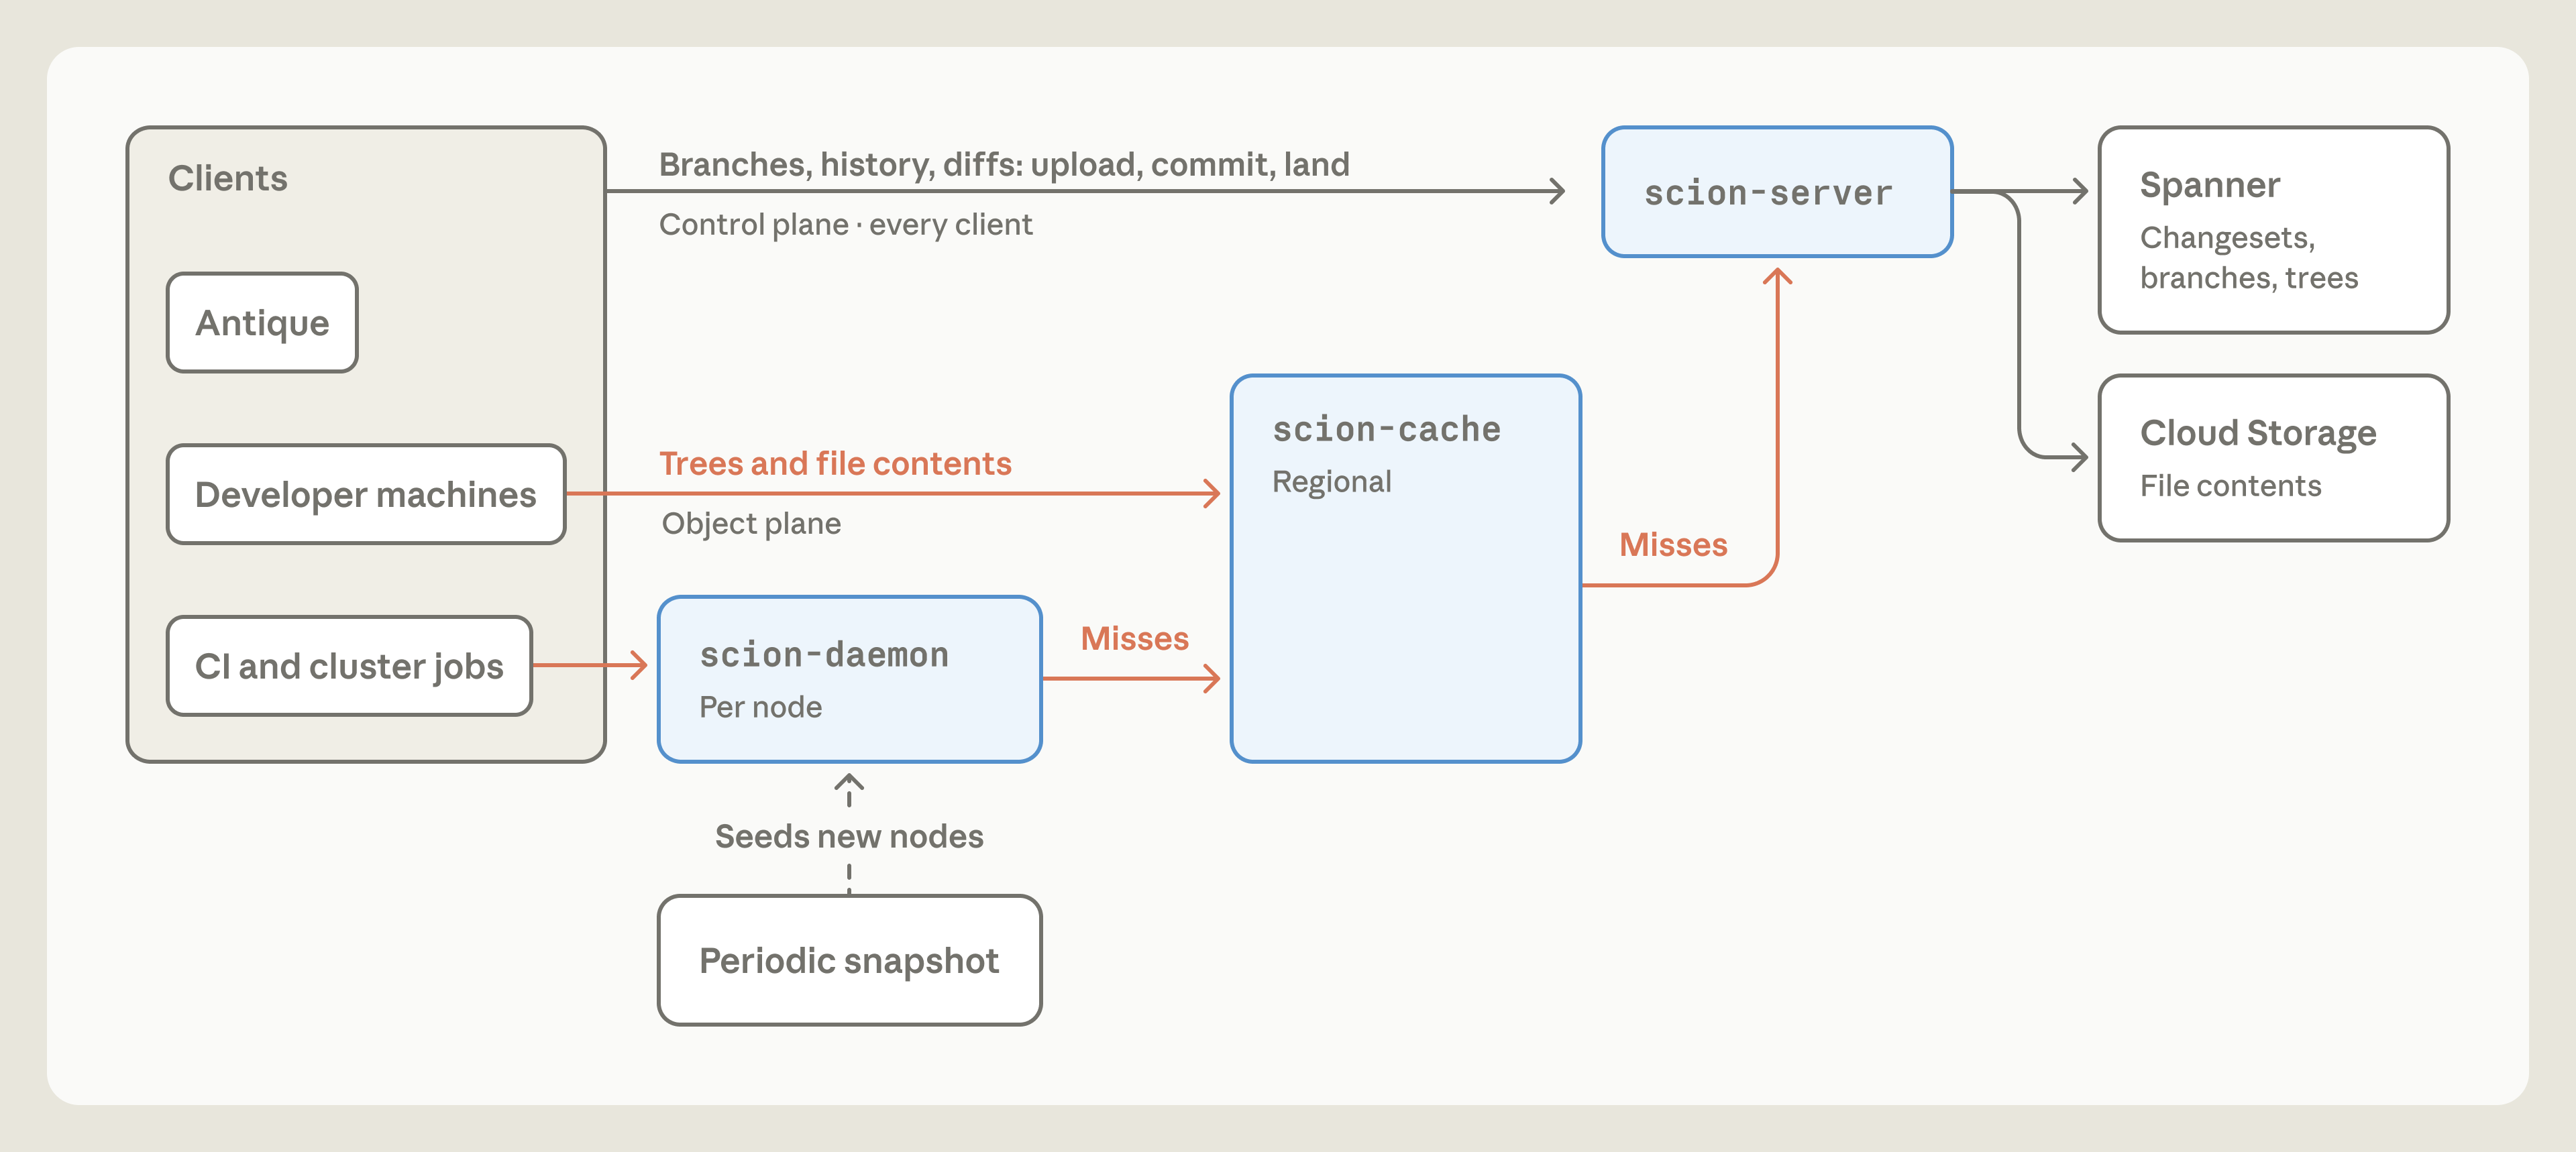
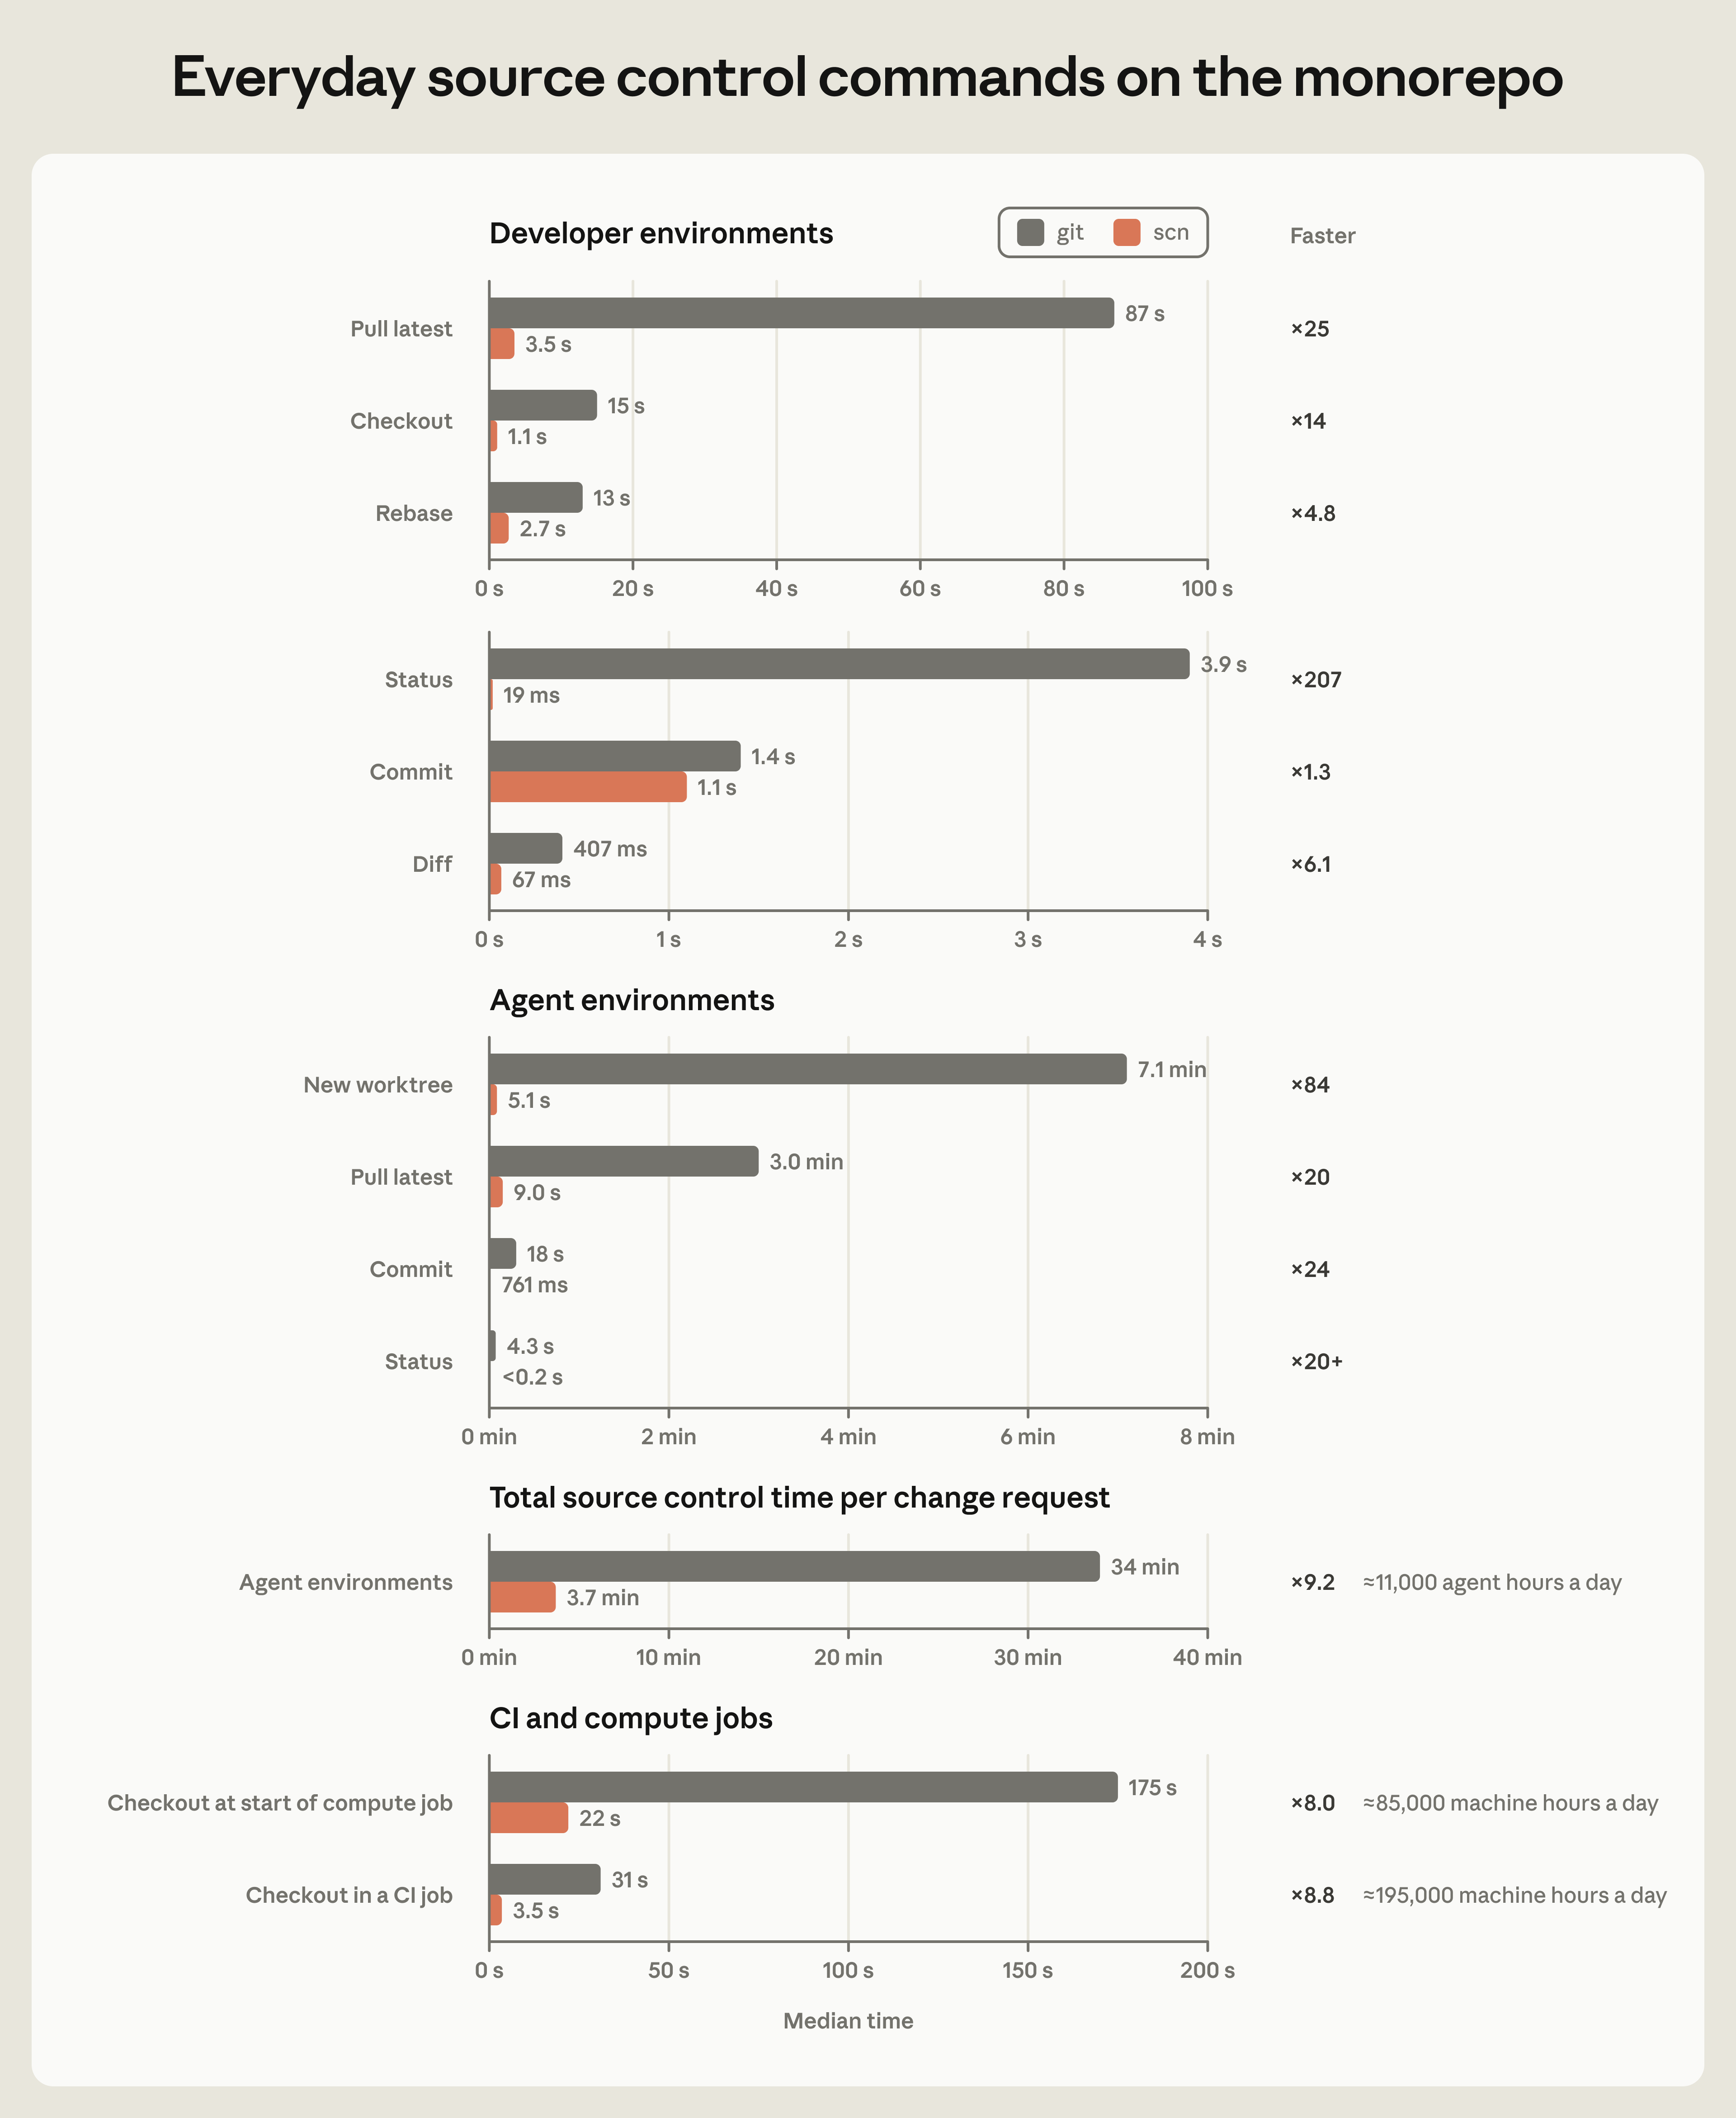
このシステムはどの層でもキャッシュヒット率99%以上を維持し、長期間存続する状態を持たないため、スケールが必要になった際の拡張が容易だ。CPUとメモリの要件で見ると、私たちのScionインフラのフットプリントは以前のgitミラーインフラより200倍小さい。CIと研究ジョブのコードチェックアウトは2桁速くなり(数分から数秒へ)、クラスタ全体でかなりの容量が解放された。CIだけでCPU容量が25%改善している。クライアントもキャッシュもリポジトリのメンテナンスを必要としないため、ジョブのライフサイクル管理はずっとシンプルになった。
Scionを構築して分かったこと
私たちがScionの構築を始めたのは、Claude Mythos PreviewとClaude Tagが社内で使えるようになった時期とほぼ重なる。この2つのリリースはScionへの需要を押し上げると同時に、私たちの開発速度を大きく引き上げた。
象徴的な例がひとつある。今年の初め、gitからScionへの取り込みパイプラインの最初のプロトタイプは、ほぼ手書きで仕上げた。悪くない出来だと思っていた——Claude Mythos Previewの初期の社内スナップショットを手に入れるまでは。追加の指示を一切与えずに全部書き直させたところ、取り込み順序とデータ構造に関する暗黙の不変条件をすべて保ったまま、メモリ使用量が20分の1、速度が4倍のバージョンが出てきた。
Scion の構築と運用を通じて、私たちはいくつかの知見を得た。agent 規模のソフトウェア開発がどんな姿になるかについて、これらは興味深い示唆を与えてくれる。
少人数チームによる高速開発は、ますます当たり前になる。 7 人のチームが Scion と Antique(私たちのコードレビューツール。これだけでブログが一本書ける)を同時に作り、さらに 6 つの関連システムも抱え、5 か月でそれらへの全面移行を完了した。その間、1 日あたりのマージ量は 10 倍に増えた。かつてなら、これほどのソースコード管理システムを開発・展開するには、はるかに多くのエンジニアを投入し、何年もかけて段階的に移行する必要があった。こうした速くしなやかな移行は、今後ますます一般的になると私たちは考えている。
エンジニアの価値は下がっていない。ただし仕事の中身は変わりつつある。 このシステムに関わったエンジニアは皆、コードを_書く_という点では Claude のほうが自分より優れていると認めている。それでもエンジニアは代替不能なものを提供している。システム間をつなぐ高レイヤーのコンポーネントへの理解と、設計上のトレードオフを見極める判断力だ。何を解決したいのか、どの規模まで到達する必要があるのかを踏まえた、根拠ある選択である。多くの場面で、エンジニアの役割は Claude に「ノー」と言うことだと気づいた。agent は、本来許されるべきでないパターンに合わせようとして、システムの中核的な制約を破ることがある。これは移行の過程で特に頻繁に起きた。たとえば複数のシステムが、ある変更がいつ main に入ったかを調べるのに、コードレビューツールに問い合わせるのではなく、commit log を線形に読んで力ずくで探そうとした。Anthropic は敵対的レビューも多用しており、これは多くの面で極めて有効だが、視野が狭くなりがちでもある。そこで熟練したエンジニアが Claude を導き、仮定上の懸念に対処しようとしてシステムの一部を過剰設計しないようにする必要がある。実際、あるレビューでは別の内部サービスを信頼することに過度に警戒し、その結果 Claude が余分な検証と複雑さを追加してしまった。チームのメンバーは今もすべての変更リクエストをレビューしているが、見ているのは変更の_意図_であり、コードを一行ずつ読んでいるわけではない。
そのおかげで最適化と品質を大きく改善できた。 Claude が私たち自身よりはるかに速く大量のコードを書けることを活かし、Scion は私たちがテストした中でも最もテストが充実し、防御が堅牢なコードベースの一つになった。これほど厳しいスケジュールの中でも、遭遇した非自明なインフラおよびソース管理のやり取りのすべてに閉じたシミュレーションを用意し、ファジングや細かいレート制限も実装した。Claude はさらに重要な最適化ポイントも見つけた。たとえば祖先クエリのアルゴリズム最適化で、私たちはインデックスを一つ見落としていた。こうした作業を専門家がやれば数日から数週間の分析とチューニングが必要になる……そして翌日には、Claude はそれをすべてやり直した。
私たちは新しい monorepo セキュリティの土台を築いた。 巨大な monorepo でセキュリティ、保安、コンプライアンスを管理するのは、その体量と規模を管理するのと同じくらい重要だ。私たちは Scion の設計に最初からこれらを織り込んだ。リポジトリに対する細粒度のアクセス制御をサポートし、権限を個々のディレクトリにまで適用できるため、最も機微なコードを守りながら monorepo の利点を手放さずに済む。さらに、私たちが構築したコードレビューツールは、承認に対して複雑な意味的制約を表現できる。コメントだけを変えるような単純な変更と、機微なロジックの変更を区別できるので、人間のレビュアーは影響の最も大きい変更に集中できる。
運用レベルはもう一段上がる。 私たちのチームは Claude Tag を多用しており、これがシステムのあらゆるコンポーネントの監視を助けてくれる。たとえば Slack チャンネルをいくつか作り、Claude に特定のコンポーネントの健全性だけを監視させ、それ以外は何もしないようにしている。私たちはこれらの Claude を「superfan」と呼んでいる。scion-daemon superfan、scion-cache superfan、Antique merge queue superfan などなど。彼らは私たちのテレメトリとログにアクセスでき、グラフを更新して異常を探す以外にやることがない、経験豊富なエンジニアのように振る舞う。私たちのシステムには従来型のアラートもすべて備わっているが、superfan は微妙で新種の問題を見つけ出せる。比べてみると従来型のアラートはあまりに貧弱だ。
私たちは自分の前提を根本から見直している。 このプロジェクトは、人間の規模を前提に設計された他のワークフローを真剣に見つめ直すきっかけになった。たとえば、まともな merge queue は agent の規模ではあまり筋が通らない。何百、何千もの変更がテスト実行中にマージされうるとき、CI とは一体何なのか。私たちは業界標準の merge queue が使うリポジトリ全体のグローバルロックをうまく再現できず、マージ後・デプロイ前の自動テストに舵を切った。並行する変更が衝突しうるのは確かだが、Claude がその衝突を修正する速度は、たいてい人間がそれに気づく速度より速い。
より広いエコシステムへの貢献
私たちの見方では、Scion は規模の難題に対する答えのひとつにすぎない。その難題は、能力を増し続ける AI agent によってますます際立ってきている。私たちがこれらの詳細を共有するのは、同様の課題に取り組むチームの一例としてであり、私たちのやり方や考え方がすべての状況に当てはまるとは思っていない。
Scion は決して git の汎用代替ではない。ここで述べた概念は、真に超大規模な monorepo でしか意味を持たない。数万人のエンジニアがいるか、大量のコードを書く agent の群れがいるか、そのどちらかだ。しかも Anthropic の状況は特殊で、内部用途で token を消費する私たちの能力は、他のどの企業が現実に進んで払う額をはるかに超えている。そうしているのは、自分たちのソフトウェア開発のニーズを満たすためであり、同時に Claude の能力を試すためでもある。
実際問題として、Scion を他の組織に広く役立つ形にするのは難しい。git とかけ離れているということは、企業が開発ライフサイクルのあらゆる段階を移行する必要があり、独自のコードレビュー、コード検索、CI も要るということだ。私たちの内部ではこれらのコンポーネントは高度にカスタマイズされており、他の組織が採用するのは難しい。すべての人の機嫌を取ろうとする公開版を作っても、実際には大して役に立たないのではないかと私たちは危惧している。
とはいえ、この種の問題は今後 6 か月から 12 か月でより一般的になると私たちは予想しており、git を使うすべての企業がそれぞれ似た課題に直面するのは、エンジニアリングリソースの無駄遣いだ。だからこそ最も影響が大きいのは、私たちの考え方を共有し、他の開発者が全体モデルから離れることなく Scion で最も成功した部分を git に応用できるようにすることだと考えている。git サーバーは git クライアントと同じように動く必要はない。大幅なスケーラビリティの向上をもたらす新しいサーバーアーキテクチャはすでに存在する。git プラットフォームは Scion のような包括的なサーバー側 RPC を提供できるし、各 forge 間で標準化された形で提供して、git クライアントがそれと通信することを学ぶようにもできる。ネゴシエーションプロトコルも今日とまったく同じである必要はなく、git の各種 sparse 機能や shallow 機能もうまく組み合わせられる。
最後に、Git コミュニティがこの 20 年近くにわたってこのプラットフォームを拡張し、何百万人もの開発者を支えてきたことに感謝したい。それに比べれば私たちの貢献はずっと限られている。agentic なソフトウェア開発がこうしたシステムとどう関わるかについての初期的な観察を共有し、GitHub、GitLab、そしてオープンソースコミュニティとともに、開発者の変化し続けるニーズを支えていく。ソフトウェア開発ライフサイクルが AI の指数関数的な発展と交わる今、私たちはみな同じ船に乗っている。