壊れたリリース名がデータベースを過負荷にした仕組み
展開されていない環境変数が 13,595 件のビルドを同じ release に、4,400 万行を同じインデックスに送り込んでいた。1 回の検索でスキャンできるデータ量を制限したところ、データベースの CPU 使用率は 76%から 19%に低下し、シンボリケーションのタイムアウトは 98%減少した。
日本語
コピー
TL;DR 名前の問題を抱えたリリースがいくつか積み上がり、数千万行のデータをため込んでいた。そこに上限のないクエリが全件をスキャンしようとしていた。1 回のクエリが扱う作業量に上限を設けたところ、データベースの CPU 使用率は 76%から 19%に下がり、シンボリケーションのタイムアウトは 98%減った。それ以前は、より大きなハードウェアに替えてもこの 2 つの問題は解決しなかった。
Sentry が source map を見つける仕組み
JavaScript のエラーが Sentry に届くと、スタックトレースが指しているのは圧縮後のコードだ。Sentry はそのビルドでアップロードされた source map を見つけ、元のファイルと行番号を表示する。
Source map は artifact bundle としてアップロードされる。正しい bundle を見つける方法は 2 つある。
- debug ID による方法。最近のビルドツールは各ファイルに一意の ID を付けるため、検索は正確になる。
- release と URL による方法。古い設定では、release 名とファイルの URL を組み合わせて照合する。検索を速くするために URL インデックスを維持しており、bundle 内のファイル 1 つにつき 1 行が対応する。
Symbolicator は私たちが公開しているシンボリケーションサービスで、イベントの処理時にこの検索を行う。使われ続けている bundle は「最終使用」日時が更新され、約 90 日間使われていない bundle は削除される。
これらはすべて、ファイル専用の Postgres 14 データベースに格納されている。URL インデックスはこの中で最大のテーブルで、他のテーブルを大きく引き離している。
問題を抱えたデータベース
このデータベースは以前から調子が悪かった。負荷とストレージは増え続け、定期的に誰かが叩き起こされていた。10 月初めにはインシデントを起こし、米国リージョンの顧客でシンボリケーションの遅延が急増した。このデータベースが起こした数々の問題の中でも、直近のものだ。
より大きなインスタンスやインデックスの追加といった、いつものデータベース向けの手はすでに試していた。それでも負荷とストレージは増え続け、追加したインデックスはストレージをさらに悪化させた。インデックスが増えるほど、書き込み、保守、削除の対象が増えるからだ。そこで私は根本まで追いかけ、Sentry 自身がこのデータをどう保存し、どうクエリしているのかを見ることにした。
調査
私はこれらのシステムの専門家ではないので、Claude とペアを組んで調査した。Claude がコードを読み、クエリ案を出し、わかったことを記録し、私はすべての操作を自分でリードレプリカ上で実行した。その後、これらのシステムに詳しいエンジニアと一緒に結論をレビューした。最初のプロンプトは単純なものだった。「このデータベースにおける artifact bundle のレイアウトを調べ、artifact が最も多いリリースを特定してほしい」と頼んだ。何時間かやり取りするうちに、全体像が見えてきた。
この進め方がうまくいった理由はいくつかある。
- クエリは一度に 1 本だけ。 モデルがクエリを 1 本提案し、私が実行して結果を貼り返す。次の一手は返ってきた内容で決まる。最初から完全な計画を求めるより遅いが、各ステップが推測ではなく実際のデータに基づく。
- 記録を途切れさせない。 タイムライン、発見、行き止まりを専用のドキュメントに残しておけば、同僚(と agent)が進捗を追える。
- ガードレールは常に人間が握る。 モデルにデータベースへの直接アクセスは与えない。重い読み取りはすべてリードレプリカ上で実行する。
- 出典を求める。 すべてのタイムスタンプと数値は、グラフ、クエリ結果、pull request のいずれかに遡れなければならない。これによっていくつもの誤りを、広がる前に捕まえられた。
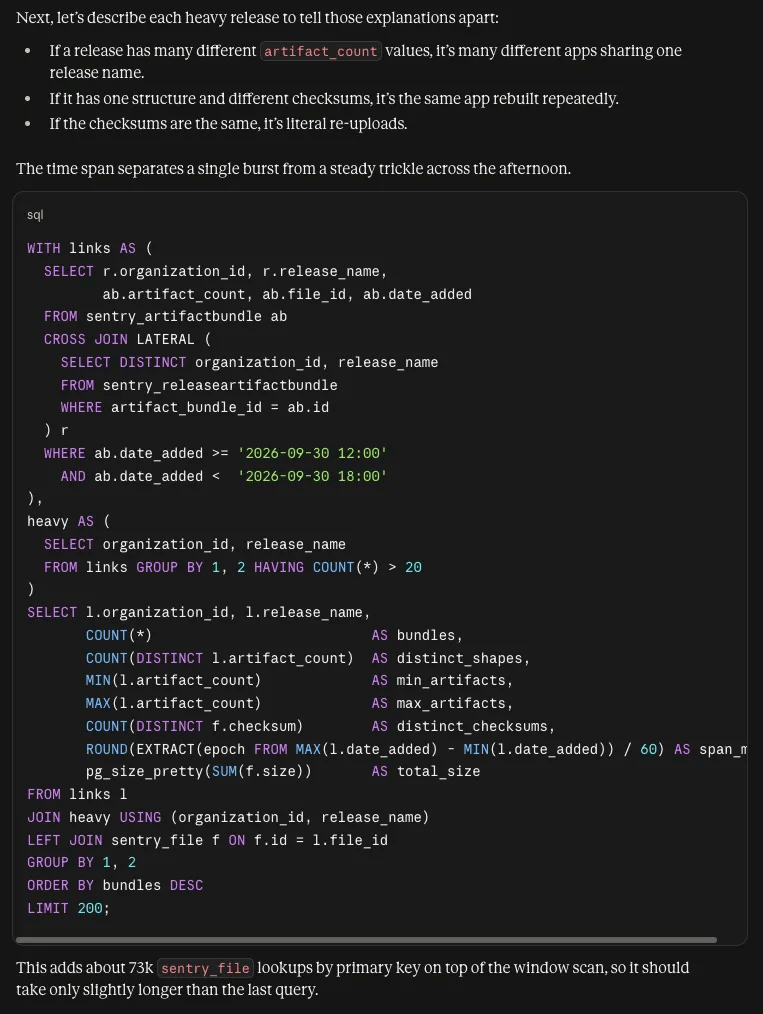
疑わしい release が一部、負荷の割合を過大に占めていることがわかった。中でも最悪のものは、query-killer のログに繰り返し出てきたため、チームメイトがすでに見つけて検索対象から外していた。名前は、文字どおり VERCEL_GIT_COMMIT_SHA だった。どうにも頭の中だけでは全体がどう組み合わさっているのか整理できなかったので、Claude に可視化してもらうことにした。
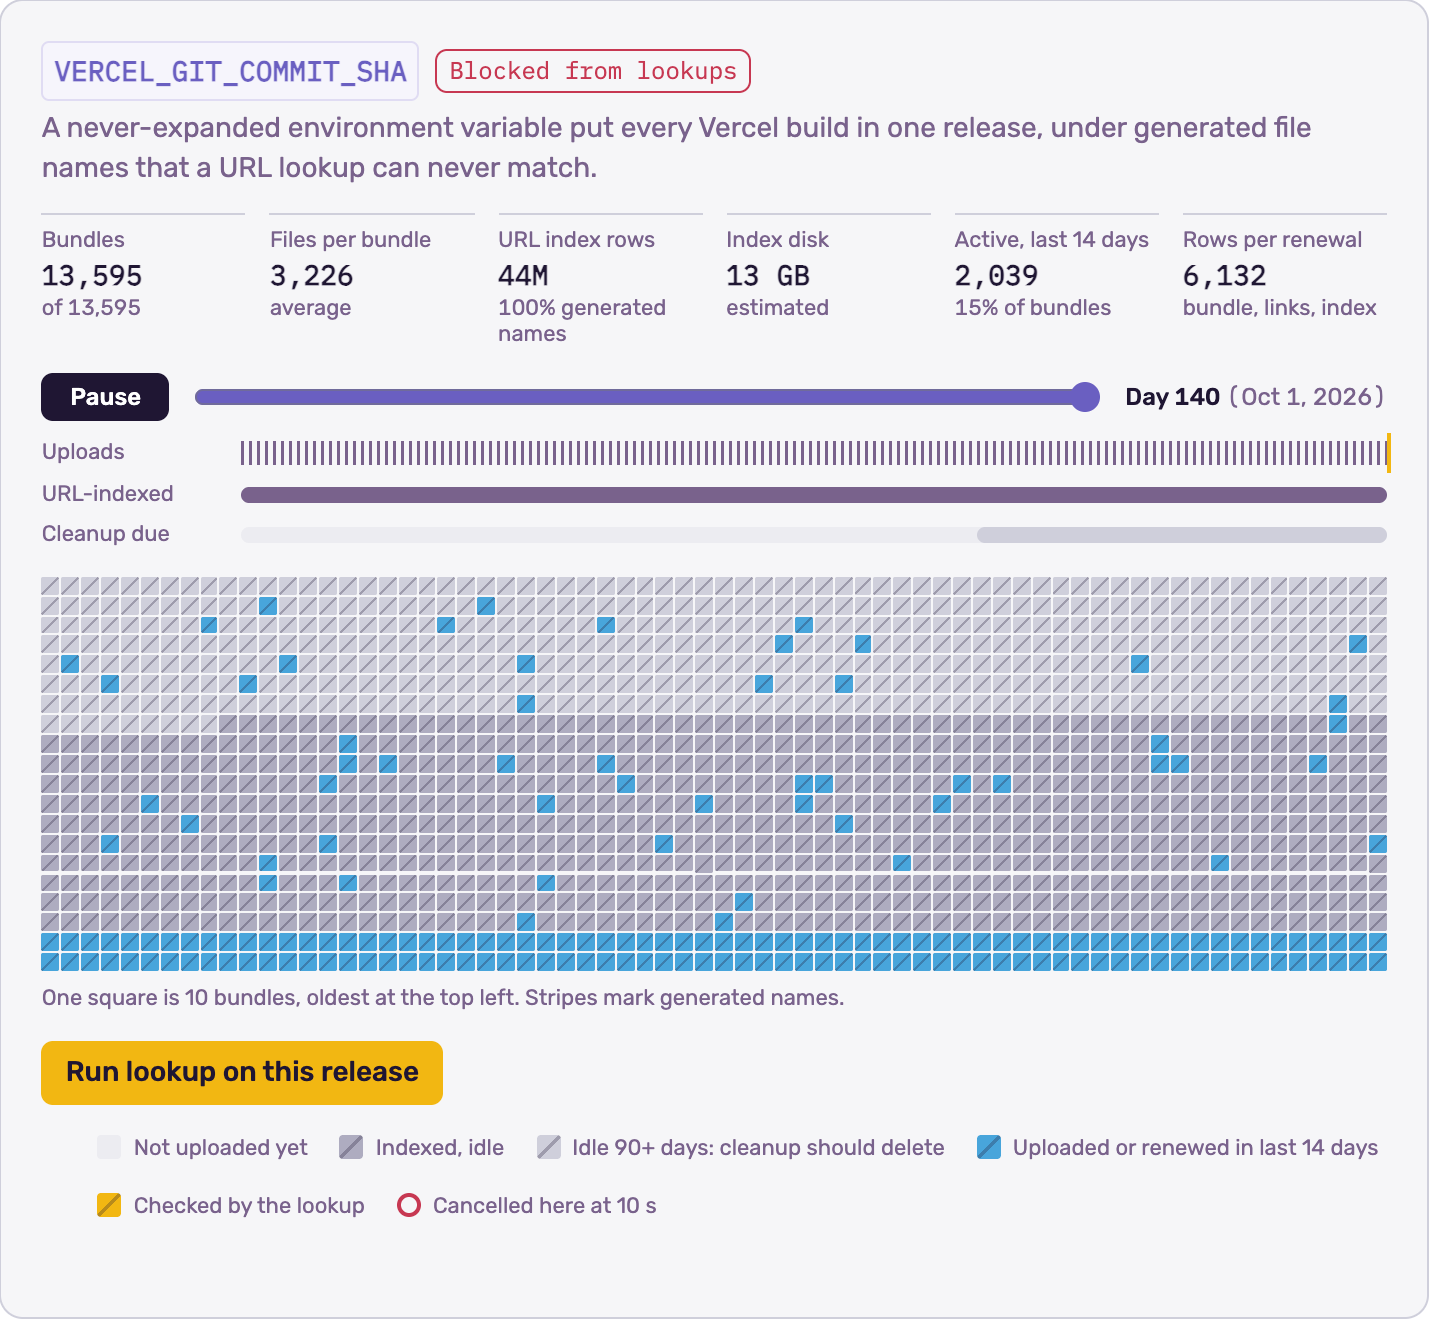
ある顧客のビルド設定で環境変数が参照されていたが、展開されることはなかった。本来ならデプロイごとに commit に応じた release が生成されるはずが、すべてのビルドが同じ release に落ちる。しかもそれがずっと続く。さらに悪いことに、パッケージ後のファイルは生成されたファイル名を使っているため、URL 検索がまったく噛み合わない。
注意 これは Vercel のバグでも、私たちの Vercel 連携のバグでもない。この文字列はプロジェクト自身のビルド設定に由来する。CI サービス事業者の環境変数ならどこでも起こりうる。release 名が
undefinedのようになっている同じケースも見ている。
この名前の release を持つ組織は 200 以上ある。最も深刻なものの中身は次のとおり。
- 13,595 個の bundle(うち 2,039 個がアクティブ)
- bundle あたり 3,226 ファイル
- 4,400 万行の URL インデックス。中身は生成されたファイル名ばかり
- このインデックスだけでディスクを 13 GB 消費
- bundle を更新するたびに 6,000 行以上を書き直す
この release に対する URL 検索は、キャッシュにヒットしないと 7.4 分かかり、全データがメモリ上にあっても 53 秒かかる。通常、30 秒を超えるクエリは打ち切っており、インシデント対応中はそのしきい値を 10 秒まで下げていた。つまりこのクエリは最後まで走らない。しかも Symbolicator がさらに 2 回リトライする。
掘り下げていくと、奇妙なクエリや使われていないインデックスなど、小さな問題もいくつか出てきた。ここで私は調査から修正に軸足を移した。
修正
効果の大きい順に、以下の変更を入れた。
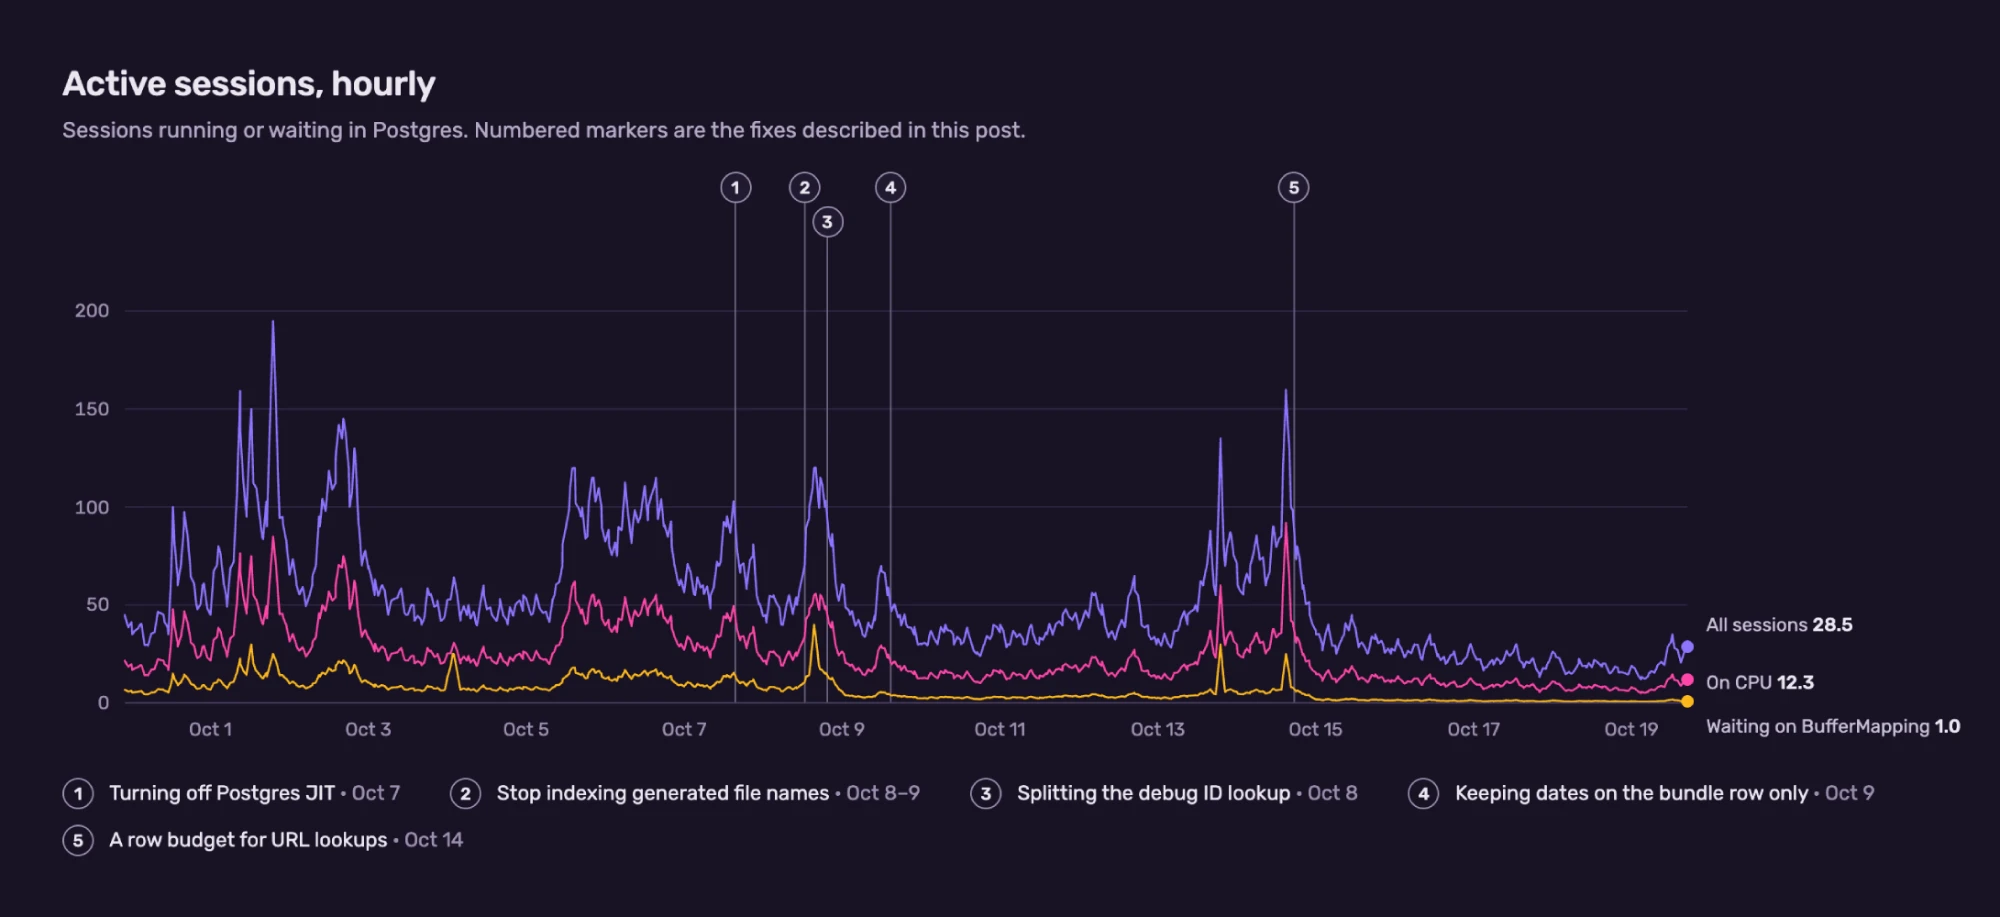
URL 検索に走査行数の上限を設ける(10 月 14 日)
1 回の URL 検索がスキャンする URL インデックスの行数に 1,000,000 行の上限を設けた。巨大な release への検索は、打ち切られてリトライされるまで走り続けるのではなく、途中で止まるようになった。ミスした結果はキャッシュし、同じ処理を繰り返さないようにした。
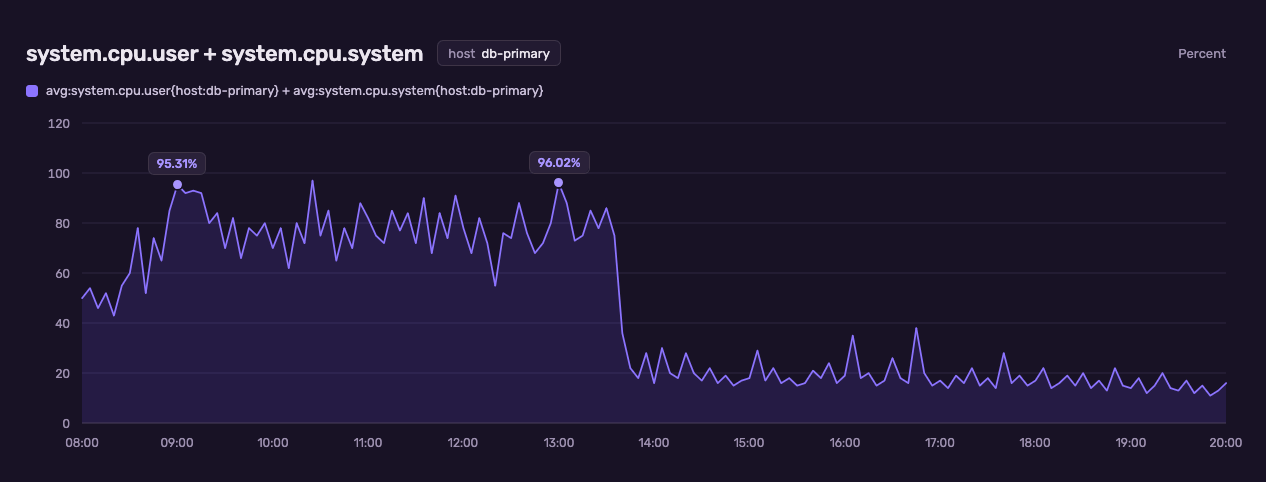
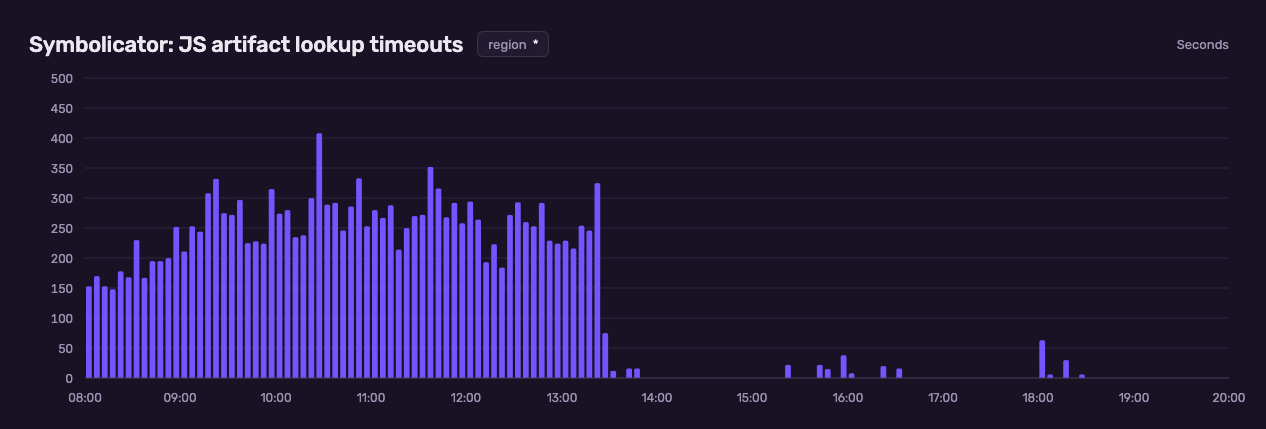
修正後、URL 検索の約 0.5% がこの上限に達する。このわずかな検索が、プライマリデータベースホストの CPU のおよそ 4 分の 3 を食っていた。上限が効き始めてから、最も負荷の高いホストの CPU 使用率は 76% から 19% に下がった。Symbolicator から Sentry へのタイムアウトは、絶え間なく発生する状態から散発的な発生に変わった。
debug ID 検索の分割(10 月 8 日)
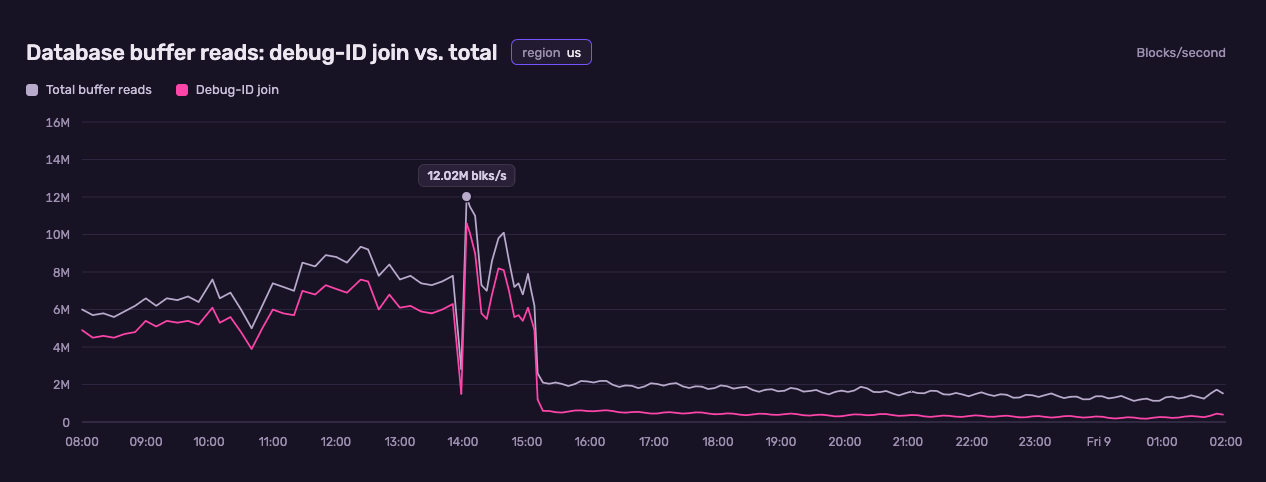
bundle、project、release、debug ID の各テーブルをまたぐ join が、クエリプランの変化をきっかけに大幅に重くなった。そこで debug ID を起点とする単一テーブルへのクエリ 3 本に置き換え、クエリプランナがまずい実行プランを選ばないようにした。
日付は bundle の行だけに持たせる(10 月 9 日)
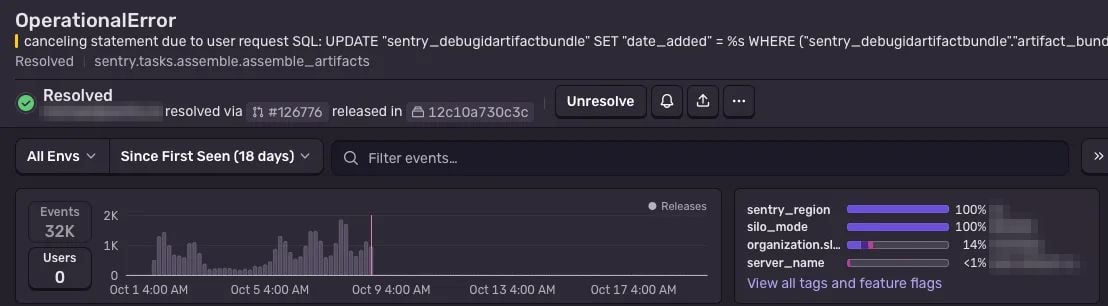
以前は、既存の bundle を再アップロードすると、その bundle に属するすべての debug ID と URL インデックスの行で日付が書き換わっていた。この更新はきわめて遅く、クエリのタイムアウトでキャンセルされることがあった。キャンセルされるとアップロード自体も失敗した。現在は bundle の行の日付だけが変わり、この更新がキャンセルされてもアップロードは完了する。
修正前の 18 日間で、このエラーに当たったアップロードは約 32,000 件。修正後は一度もない。これらのテーブルに毎日発生するデッドタプルは 1 億 1,000 万〜2 億 1,000 万行減った。
生成されたファイル名をインデックスしない(10 月 8 日〜9 日)
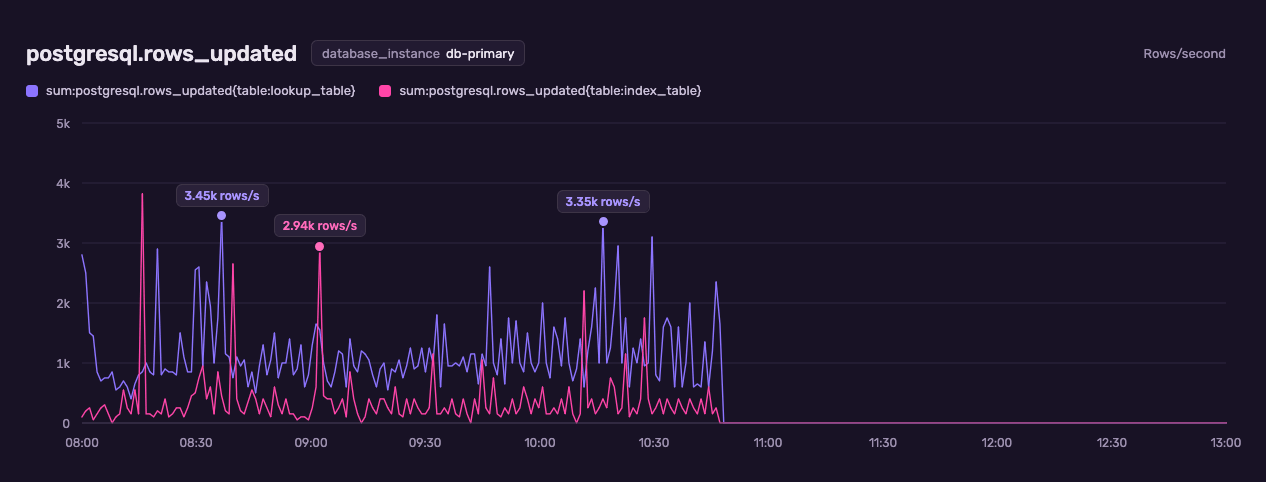
自分自身の debug ID を名前にしたファイルは、URL 検索に一致しようがない。それでも以前は URL インデックスに書き込んでいた。こうしたファイルはインデックスの総行数の約 3 分の 1 を占めていたため、書き込みをやめた。両リージョンとも URL インデックスの書き込み量は約 35%減り、米国だけでも 1 日あたり約 1 億 7,000 万行が消えた。
Postgres の JIT を止める(10 月 7 日)
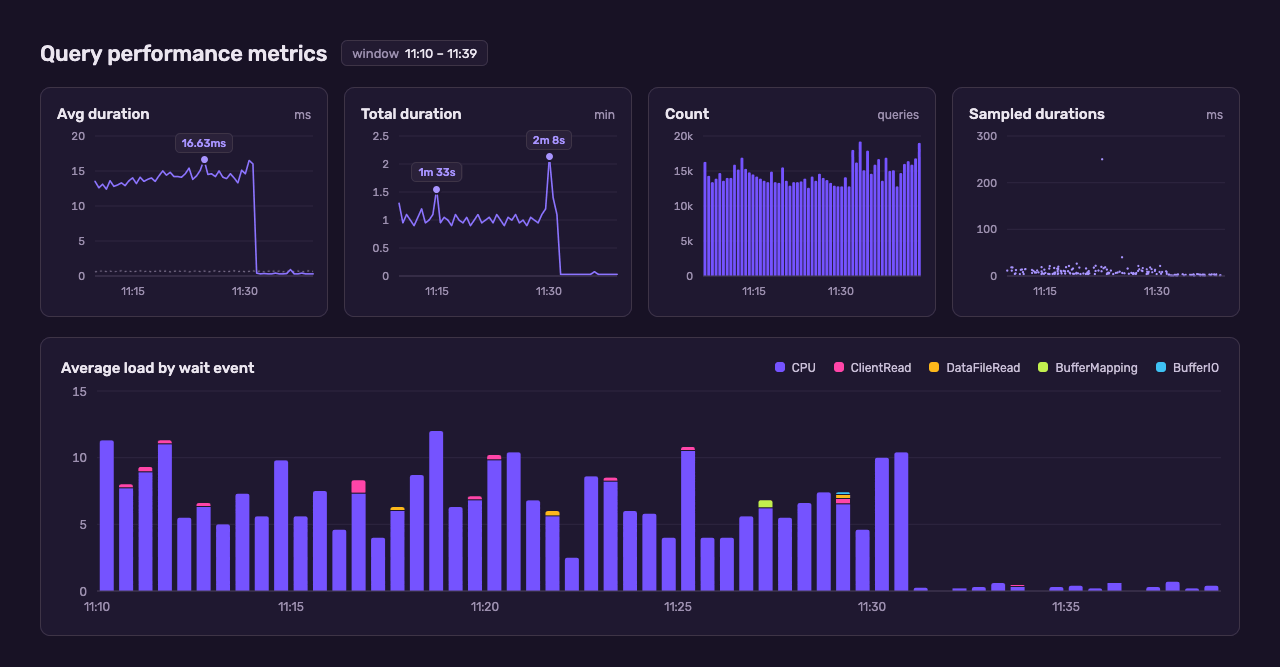
Postgres は実行前にコストの高いクエリをマシンコードへコンパイルできる。ジャストインタイム(JIT)コンパイルと呼ばれる仕組みで、デフォルトではクエリの推定コストが 100,000 を超えるとこれが走る。古い release ファイル検索のひとつでは、コンパイルにかかる時間が毎回、コンパイルで節約できる時間を上回っていた。
データベース設定で JIT を恒久的に無効化したところ、1 回の呼び出しあたりのレイテンシは 14.5 ms から 0.12 ms に下がり、ビジー状態のデータベースセッション数は約 7.5 から 0.06 に減った。
結果
最も負荷の高いデータベースホストでは、平日朝のピーク時のアクティブセッション数が 104 から 24 に減った(−77%)。それでいて処理したクエリ数は 10%増えている。1 時間あたりにタイムアウトする Symbolicator のクエリは 3,250 件から 80 件に減った(−98%)。
学んだこと
- 顧客データがシステム負荷に与える影響は、想定をはるかに超えることがある。 テーブルは、1 つのリリースに含まれるビルド数が妥当な範囲であることを前提に設計していた。名前に問題を抱えたごく少数のリリースが、大量のデータを蓄積してしまった。境界のないクエリが 1 本あり、それが全データをスキャンしようとしていた。
- 成功し得ない操作はリトライしない。 Postgres はそうしたクエリを淡々と実行し、タイムアウトは淡々と打ち切り、Symbolicator は淡々とリトライする。負荷はそのまま倍々に膨らんでいく。
- 上限はあったほうがいい。 リクエストあたりの作業量に上限を設けることで、マシンを増やしても解決しなかった問題が解決した。上限に引っかかったリリースはもともとタイムアウトで失敗していたのだから、失うものは何もない。
自分の release 名を確認しよう
デプロイしている継続的インテグレーション(CI)が環境変数で release を設定しているなら、ちょっと覗いてみる価値がある。
- Sentry の Releases ページを開いて名前を確認する(agent に Sentry MCP で調べさせてもいい)
- 変数名そのものが release 名になっている(たとえば
VERCEL_GIT_COMMIT_SHA)とか、undefinedになっている release があれば、ビルドが commit ではなく変数名や空値を渡している。 - その変数が Sentry に渡る前に、ビルド内で設定・展開されていることを確かめよう。source map のマッチ率が上がるし、こちらのデータベースも助かる。
こちら側も修正済みだ。11.9.0 以降、Sentry JavaScript SDK は値が自身の名前と等しい commit 変数を無視するので、アップグレードするのも有効だ。