一个损坏的发布名称如何导致我们的数据库过载
一个未展开的环境变量让 13,595 个构建进入同一个 release、4,400 万行进入同一个索引;限制单次查找可扫描的数据量后,数据库 CPU 占用从 76% 降至 19%,符号化超时减少了 98%。
中文
复制
TL;DR 有几个名称有问题的 release 积压了数千万行数据,而一次没有上限的查询一直在试图扫描全部数据。限制单次查询的工作量后,数据库 CPU 从 76% 降到 19%,符号化超时减少了 98%。在此之前,换用更大的硬件也没能解决这两个问题。
Sentry 如何找到你的 source map
当 JavaScript 错误到达 Sentry 时,堆栈跟踪指向的是压缩后的代码。Sentry 会找到为该次构建上传的 source map,从而向你展示原始文件和行号。
Source map 以 artifact bundle 的形式上传。找到正确 bundle 的方式有两种。
- 按 debug ID。现代构建工具会给每个文件打上唯一 ID,因此查找是精确的。
- 按 release 和 URL。较旧的配置用 release 名称加上文件 URL 来匹配。我们维护了一个 URL 索引来加速查找,每个 bundle 中的每个文件对应一行。
Symbolicator 是我们的开源符号化服务,它在处理事件时执行查找。仍在使用的 bundle 会更新“最后使用”日期,约 90 天无人使用的 bundle 会被清理。
这一切都存放在一个专用于文件的 Postgres 14 数据库中。URL 索引是其中最大的表,远超其他表。
有问题的数据库
这个数据库出问题已经有一段时间了。负载和存储持续增长,隔三差五就有人被它叫醒。十月初,它引发了一次事故,导致我们美国区域客户的符号化延迟飙升,这是该数据库一长串问题中最近的一次。
我们已经试过常规的数据库手段,更大的实例和更多的索引。但负载和存储照样增长,多出来的索引还让存储更糟,因为每个索引都意味着更多要写入、维护和清理的数据。所以我决定直接追到源头,看看 Sentry 自己是如何存储和查询这些数据的。
排查问题
我不是这些系统的专家,所以和 Claude 结对排查。它阅读代码、提出查询建议、记录我们了解到的东西,而我则在只读副本上亲自运行所有操作。之后我再和更熟悉这些系统的工程师一起复核结论。我从一个简单的提示开始:「帮我调查这个数据库中 artifact bundle 的布局,找出 artifact 最多的那些 release」。来回折腾了几个小时后,事情开始变得清晰起来。
这套做法能奏效,原因有几点。
- 一次只跑一个查询。 模型提出一条查询,我执行后把结果贴回去,下一步取决于返回了什么。这比一开始就要一份完整计划要慢,但每一步都建立在真实数据上,而不是猜测。
- 保持连续记录。 用一个专门的文档记录时间线、发现和死胡同,让同事(以及 agent)有地方跟进进展。
- 护栏始终由人掌握。 模型不能直接访问数据库。开销大的读取都跑在只读副本上。
- 要求给出出处。 每个时间戳和数字都必须能追溯到某张图、某次查询结果或某个 pull request。这在错误扩散之前就抓住了好几处。
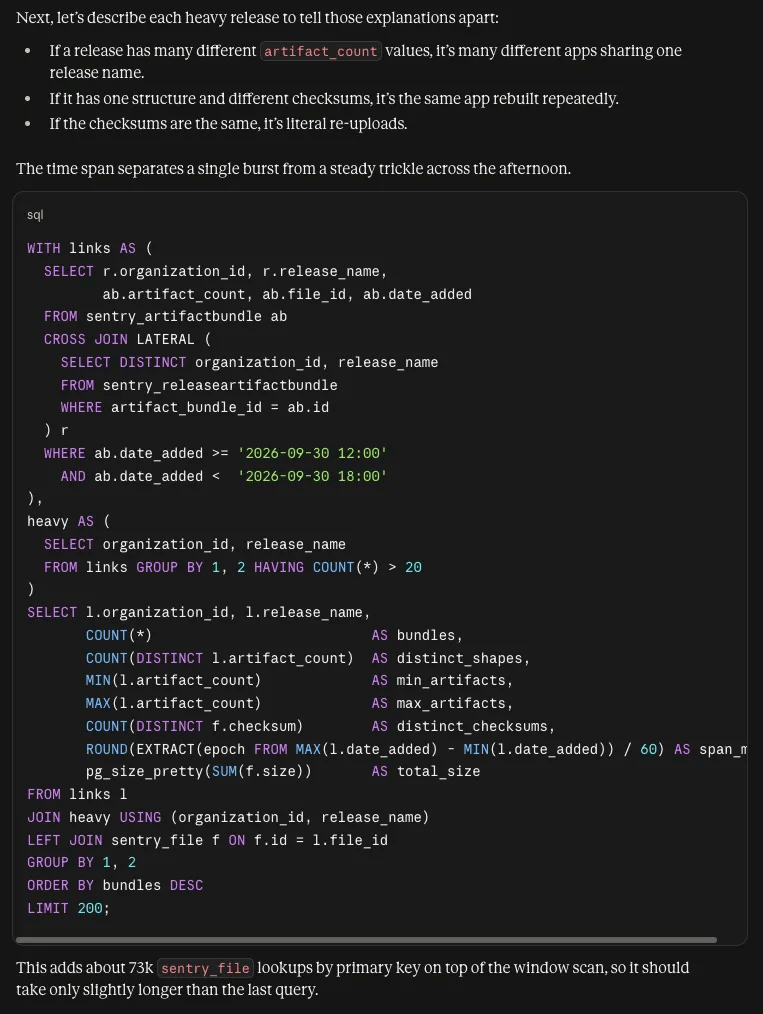
我们发现有些可疑的 release 造成了过大的负载占比。其中最严重的一个,队友早就发现并把它从查询中屏蔽掉了(它反复出现在我们的 query-killer 日志里)。它的名字,毫不夸张,就叫 VERCEL_GIT_COMMIT_SHA。我一时很难在脑子里理清这些部分是怎么拼到一起的,于是让 Claude 做了一些可视化来帮我。
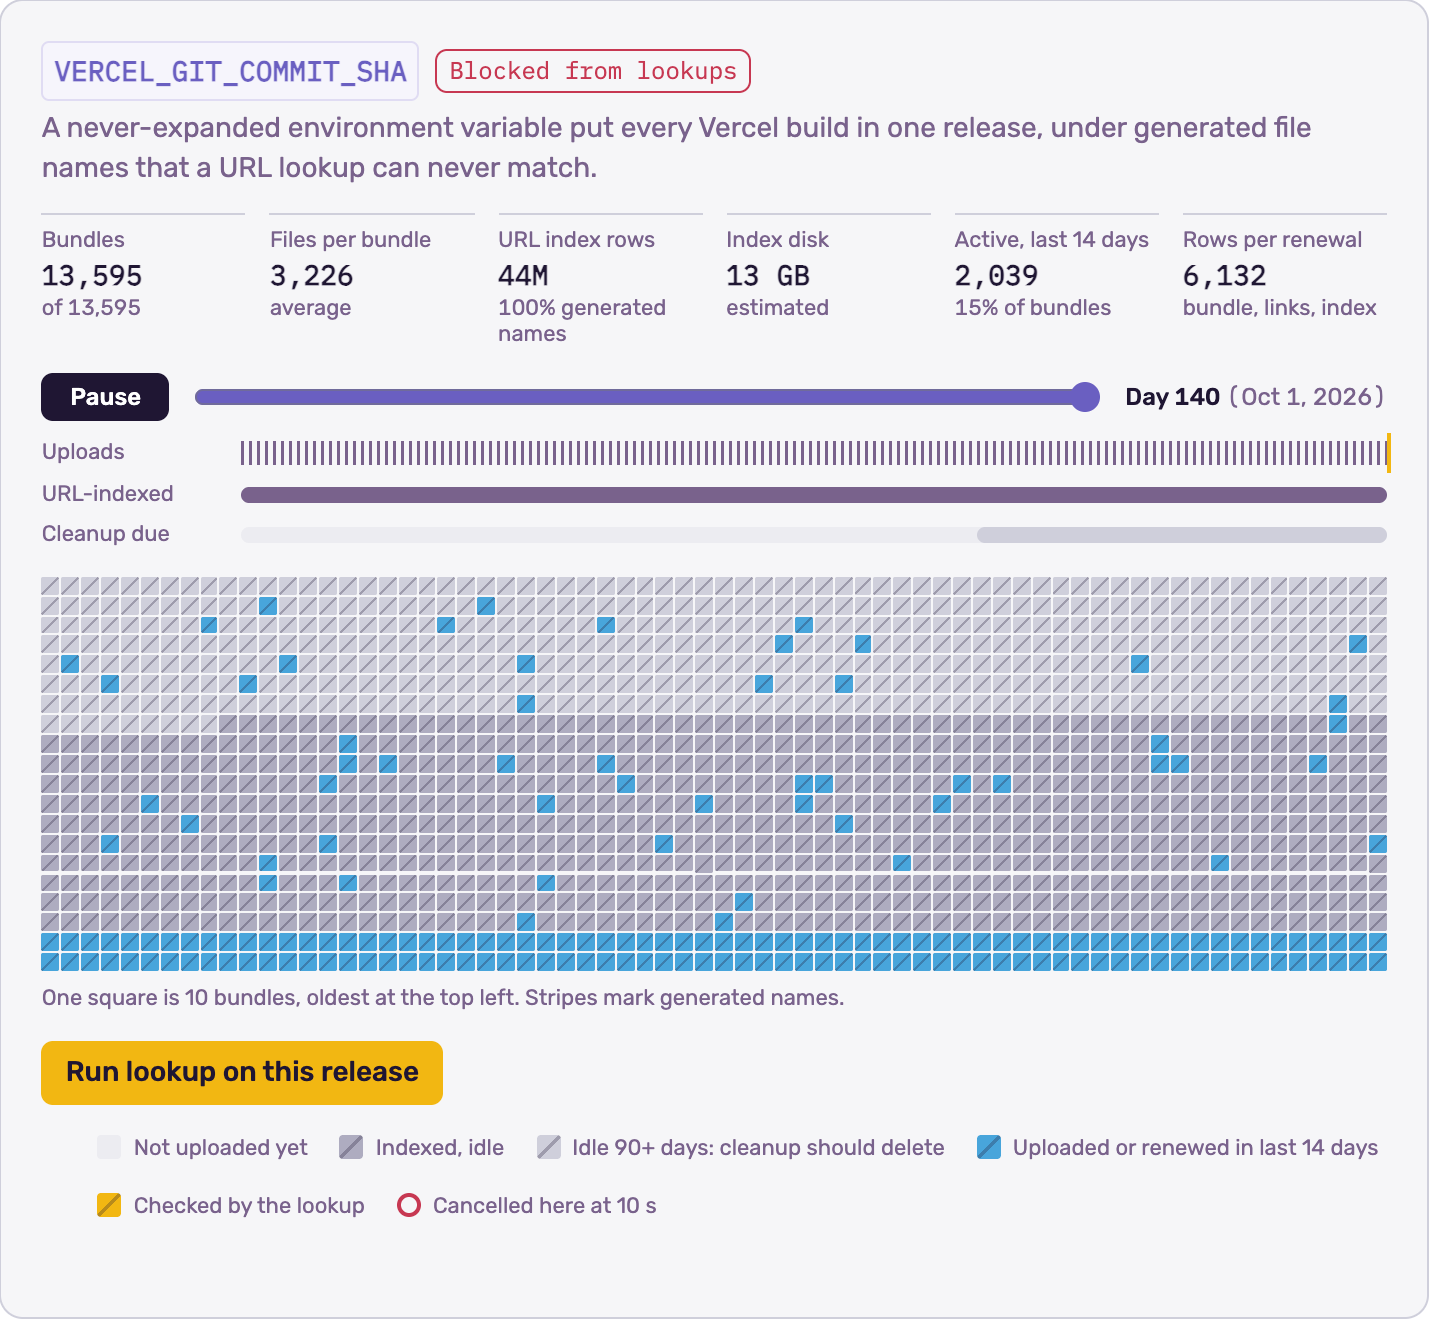
在某个客户的构建配置里,引用了一个环境变量,却从未被展开。于是每次部署本该按 commit 生成各自的 release,结果所有构建都落进了同一个 release,永远如此。更糟的是,打包后的文件用的是生成出来的文件名,URL 查找根本对不上。
注意 这不是 Vercel 的 bug,也不是我们 Vercel 集成的 bug。这个字符串来自项目自己的构建配置。任何 CI 服务商的环境变量都可能出现这种情况。我们也见过 release 名字形如
undefined的同样情况。
有 200 多个组织存在一个叫这个名字的 release。最严重的一个包含以下内容。
- 13,595 个 bundle(其中 2,039 个活跃)
- 每个 bundle 有 3,226 个文件
- 4,400 万行 URL 索引,全是生成出来的文件名
- 仅这个索引就占用 13 GB 磁盘
- 每次 bundle 续期都要重写 6,000 多行
对这个 release 做一次 URL 查找,未命中缓存时要 7.4 分钟,全部数据已在内存中时也要 53 秒。我们通常会取消运行超过 30 秒的查询,事故期间还把这个阈值降到了 10 秒,所以这个查询永远跑不完。然后 Symbolicator 还会再重试两次。
继续深挖之后,我们还翻出了一堆较小的问题,比如奇怪的查询和没被用到的索引。到这一步,我从排查转向了修复。
修复问题
下面这些改动影响最大,按效果排序。
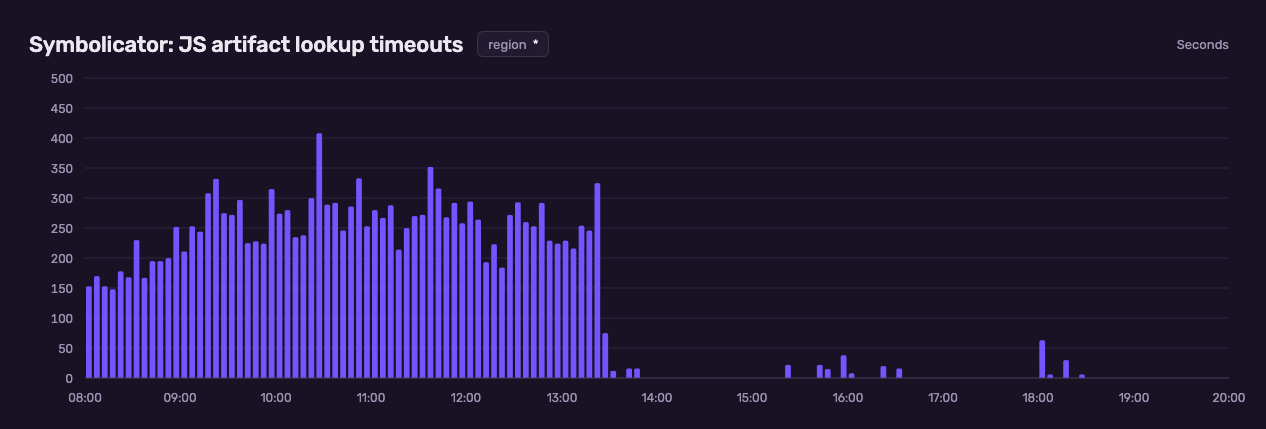
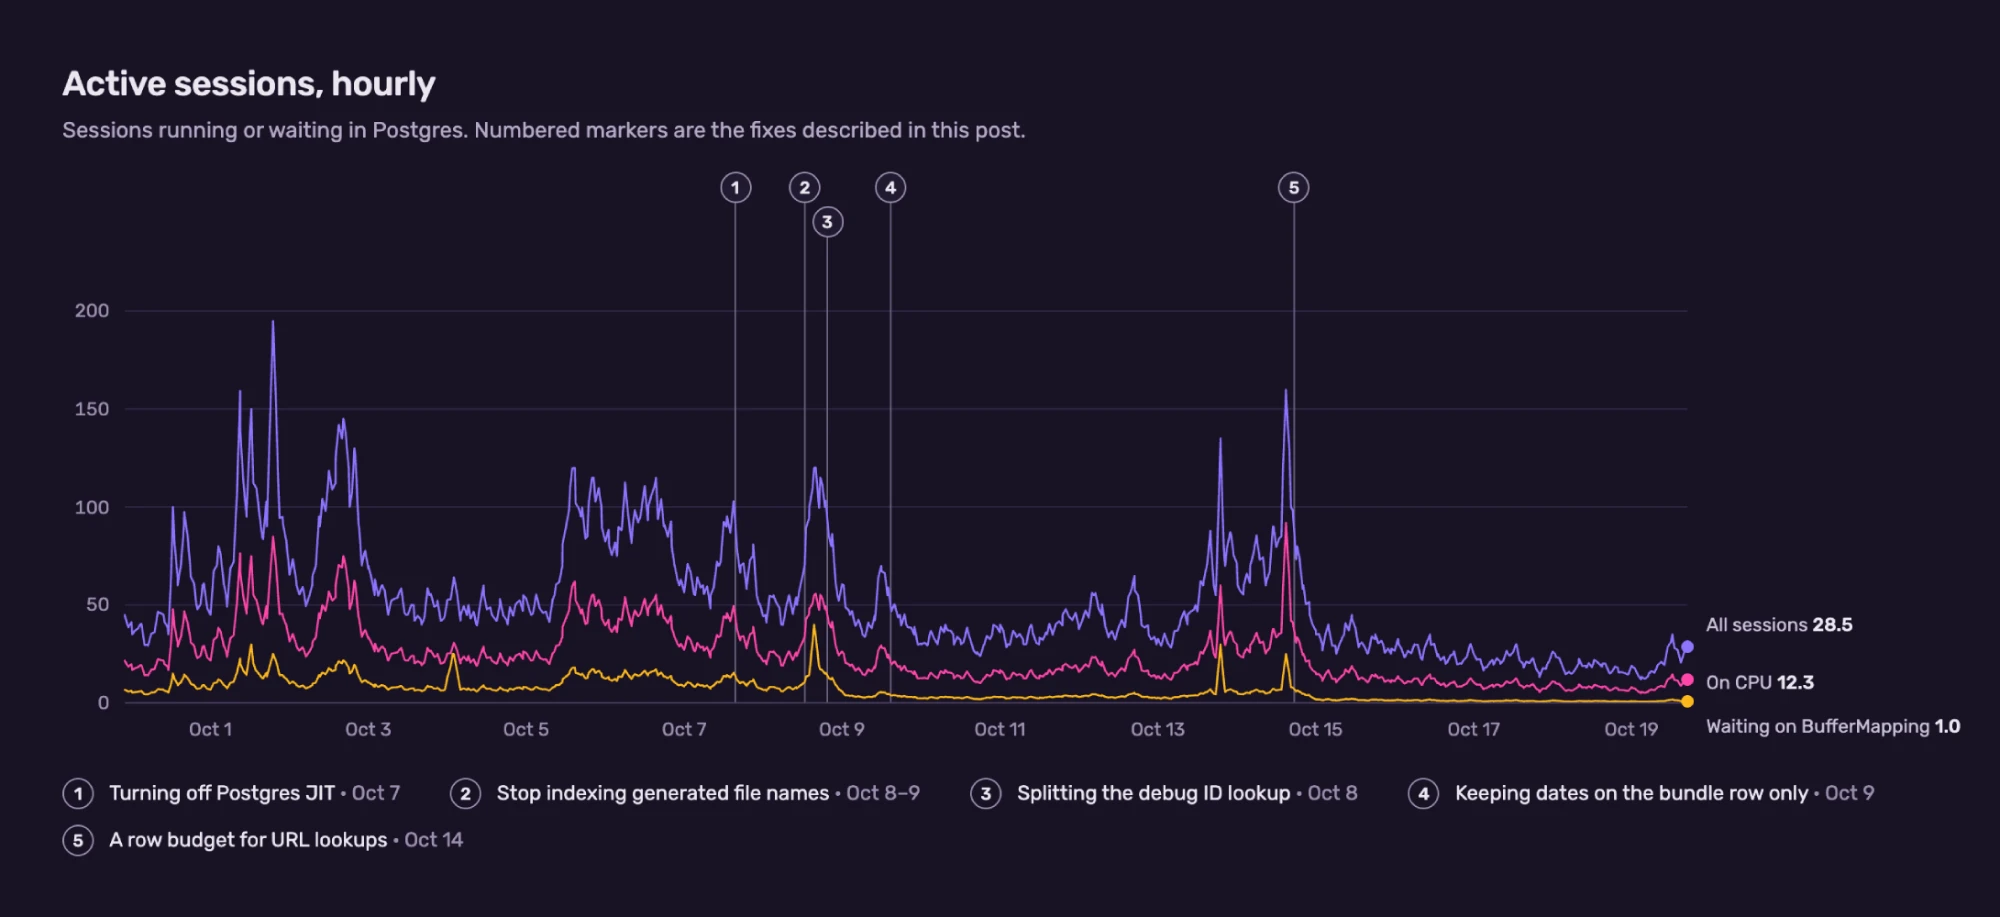
给 URL 查找加行数预算(10 月 14 日)
我们把单次 URL 查找扫描的 URL 索引行数上限设为 1,000,000 行。针对超大 release 的查找现在会提前停止,而不是一直跑到被杀掉再重试。未命中的结果会被缓存,避免重复做同样的工作。
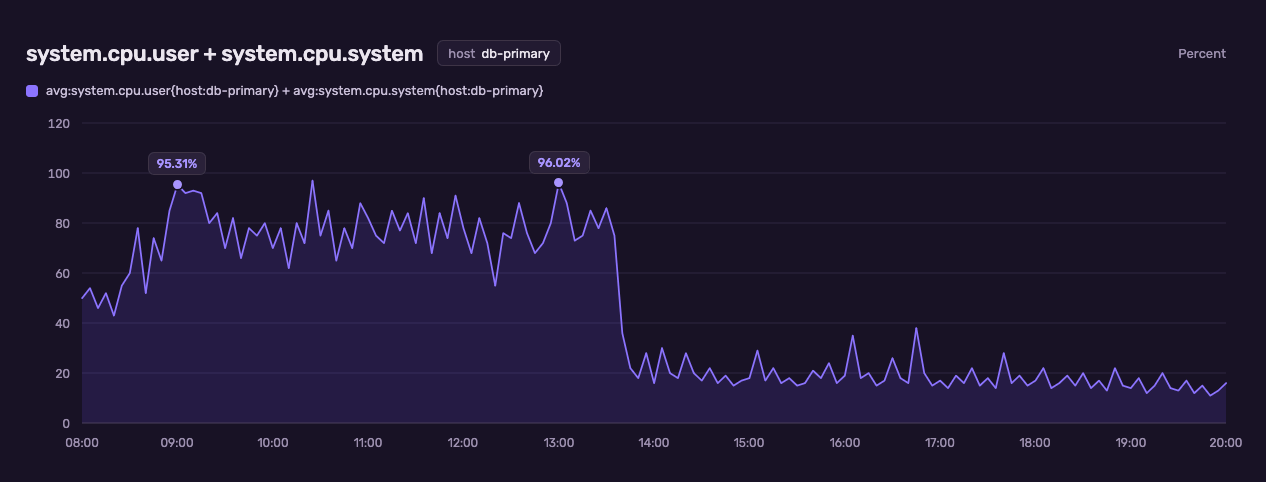
修复上线后,约 0.5% 的 URL 查找会触到这个上限。就是这少量查找,占用了主数据库主机大约四分之三的 CPU。预算生效后,最繁忙主机上的 CPU 使用率从 76% 降到 19%。Symbolicator 发往 Sentry 的超时从持续不断变成偶发。
拆分 debug ID 查询(10 月 8 日)
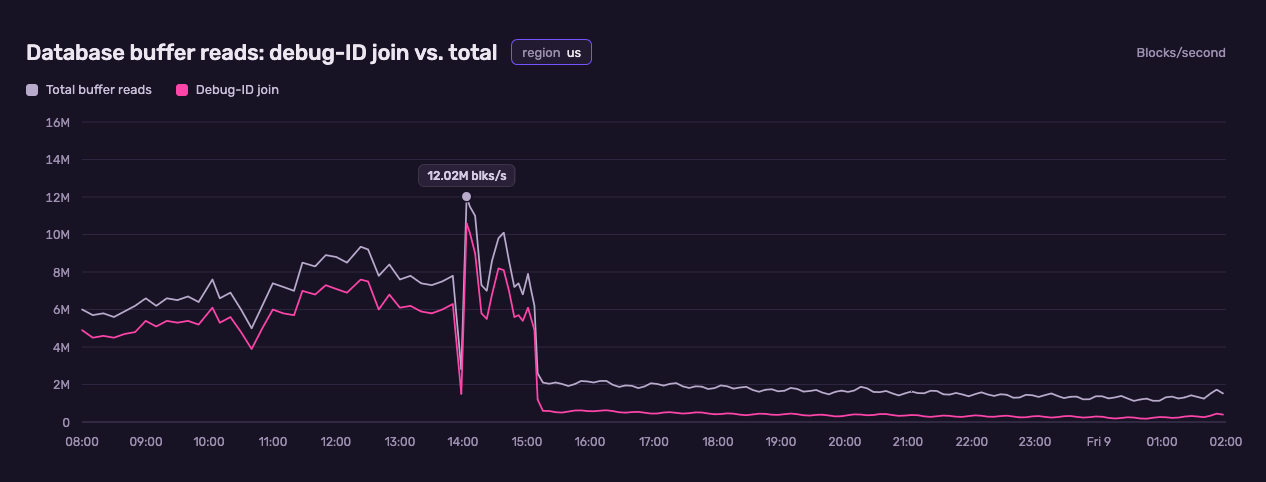
bundle、project、release 和 debug ID 这几张表之间的一个 join,在查询计划变化之后开销大了很多。我们把它换成了三个从 debug ID 出发的单表查询,这样查询规划器就不会再选到糟糕的执行计划。
日期只保留在 bundle 行上(10 月 9 日)
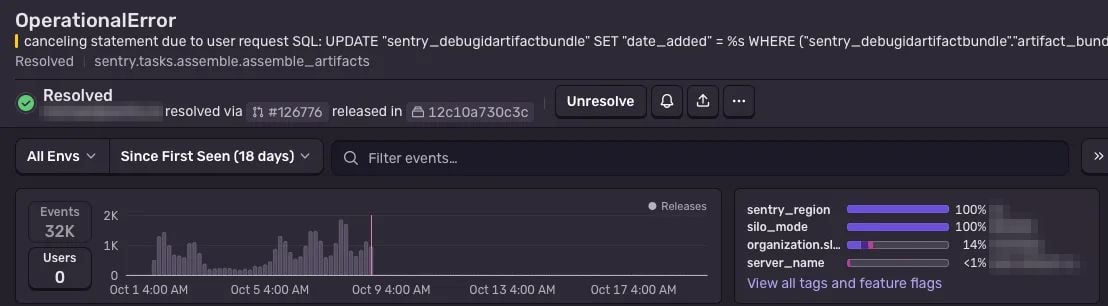
以前重新上传一个已有的 bundle,会把它名下每一行 debug ID 和 URL 索引的日期都重写一遍。这个更新跑得很慢,慢到查询超时可能把它取消。一旦被取消,整个上传也就跟着失败了。现在只有 bundle 那一行的日期会变,而且即使这个更新被取消,上传照样能完成。
修复之前,18 天里上传一共撞上这个错误约 32,000 次。之后一次都没有。现在这些表每天少产生 1.1 亿到 2.1 亿行死行。
停止索引生成的文件名(10 月 8 日至 9 日)
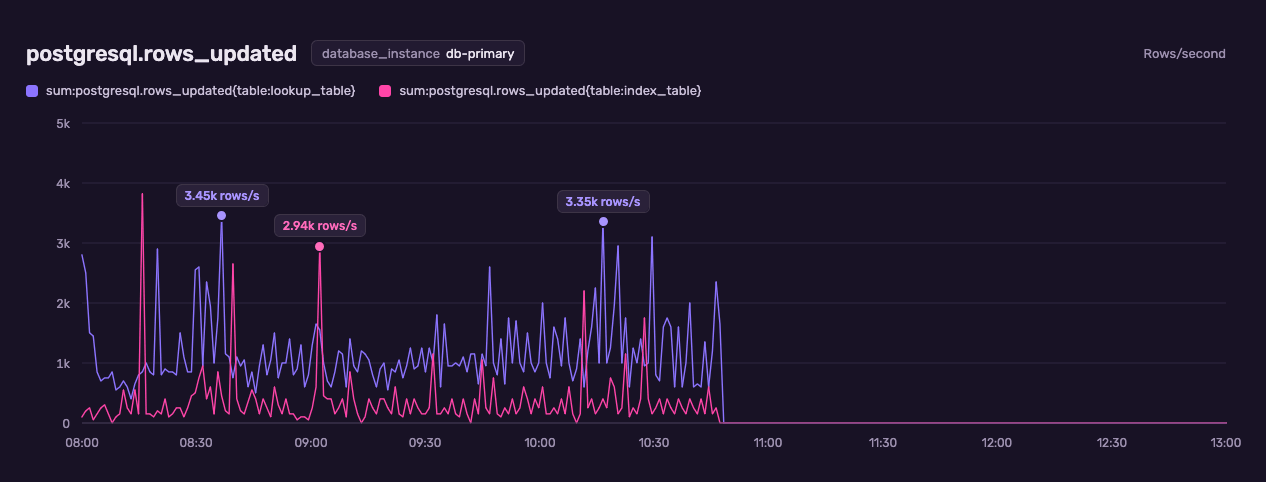
以自身 debug ID 命名的文件永远不可能匹配 URL 查询,但我们之前还是把它们写进了 URL 索引。这类文件约占索引总行数的三分之一,于是我们不再写入。两个区域的 URL 索引写入量都下降了约 35%,仅美国每天就少了约 1.7 亿行。
关闭 Postgres JIT(10 月 7 日)
Postgres 可以在执行前把开销大的查询编译成机器码,这叫作即时(JIT)编译。默认情况下,只要查询的估算开销超过 100,000,它就会这么做。对于我们某个旧版发布文件查询,编译花的时间每次都超过它省下的时间。
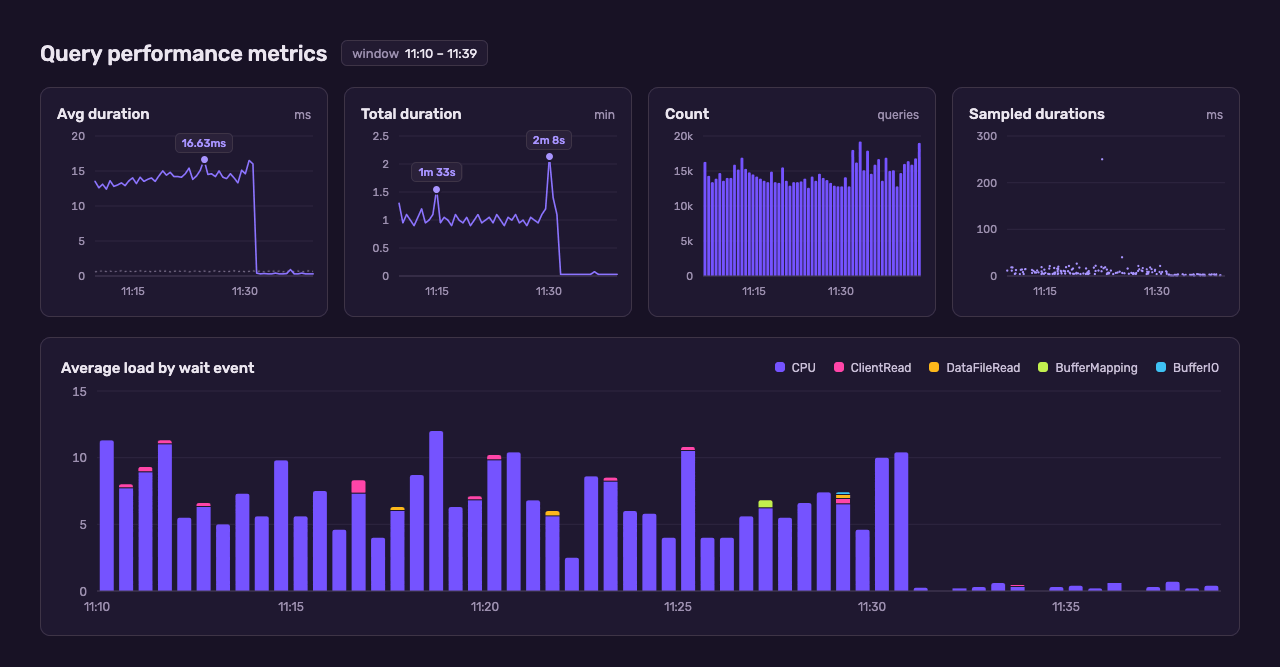
现在数据库配置中已永久关闭 JIT,单次调用延迟从 14.5 ms 降到 0.12 ms,繁忙的数据库会话数从约 7.5 降到 0.06。
结果
在最繁忙的数据库主机上,工作日早高峰的活跃会话数从 104 降到 24(−77%),同时处理的查询量还多了 10%。每小时超时的 Symbolicator 查询从 3,250 次降到 80 次(−98%)。
经验教训
- 客户数据对系统负载的影响可能远超预期。 我们的表是按每次发布包含合理数量构建来设计的。少数几个名称有问题的发布积累了海量数据。我们有一条没有边界限制的查询,试图扫描全部数据。
- 永远不可能成功的操作就不要重试。 Postgres 会照常执行这些查询,超时机制会照常把它们杀掉,Symbolicator 会照常重试,负载就这样成倍放大。
- 限制是好事。 给每个请求的工作量设上限,解决了加机器解决不了的问题。触发上限的那些发布本来就在超时失败,所以它们没有任何损失。
检查你自己的 release 名称
如果你部署的持续集成(CI)系统通过环境变量设置 release,值得快速看一眼。
- 打开 Sentry 的 Releases 页面查看名称(或者直接让你的 agent 用 Sentry MCP 去查)
- 如果你看到某个 release 以变量名命名(比如
VERCEL_GIT_COMMIT_SHA),或者叫undefined,说明你的构建传过去的是变量名或空值,而不是 commit。 - 确认这个变量在传给 Sentry 之前已经在构建中设置并展开。这样你的 source map 匹配率会更高,我们的数据库也会感谢你。
我们这边也已经修好了。从 11.9.0 开始,Sentry JavaScript SDK 会忽略值等于自身名称的 commit 变量,所以升级也有帮助。