Claude Code チームはどのようにコードレビューを行っているか
エージェントが生成するコードの量がこれほど多いとき、どうやってコードレビューを行うのか?Claude Code チームでは、高いカバレッジと深いレビューを実現した後、ロールバックやインシデントを増やさない最小限の人手レビュー時間を見つけるための最適化を始めました。
日本語
コピー
以前も触れたとおり、Claude Code 自身のコードのおよそ90%は Claude が書いている。では、これだけの生産速度で、どうやってコードをレビューしているのか。今でもコードを読む人はいるのか。問題が起きたとき、誰が責任を取るのか。
この記事では、Claude Code チームのコードレビューの流れと、それがどう変わってきたかを書く。6月から9月にかけて、Claude Code のコードベースにマージされた pull request の数は2倍以上に増え、その一方でロールバックが必要になった割合は40%以上減った。
レビューをやめたわけではない。ただ、読む作業の大半を機械に任せ、最適化の対象を人の時間と注意力に置き、ロールバックを素早く簡単にできるようにするために多くの労力を割いた。
コードレビューの目的を考え直す
agent がコードを書くと、変更の数は急速に増える。Anthropic の monorepo では、日々マージされる変更が今年5月の約2,500件から9月には30,000件超に増えた。
Claude Code は独自のリポジトリを持ち、monorepo の中にはないが、同じように大きな負荷がかかっている。この速度でデリバリーしていると、行単位の人手によるレビューは、不可能ではないにせよ極めて難しい。
コードレビューには2つの役割がある。
- コードが本番に出る前に問題を見つけて直す
- チーム内で共有されるコンテキストとコードベースへの理解を育てる
この記事では主に1つ目、問題の発見と修正について扱う。2つ目は終盤で触れる。
「このコードを読んだ人はいるか」という問いでは、「この変更で何が起きうるか、どのチェック——自動か手動か——がそれを捕まえるのに適しているか」には正確に答えられない。
問いを変えると、レビューが行われるタイミングも変わる。以前のレビューはゴール直前の関門だった。コードを書き、PR を開き、同僚が見に来るのを待つ。
今はレビューが常時行われ、執筆中のスペルチェックに近い。ほとんどの変更は、人に見てくれと頼む前に、少なくとも一度は Claude がレビューして修正済みだ。これで定型的なミスの大半は止まり、チームの注意力はより高次の問題や検討に残せる。
希少な資源は人の時間と注意力
人の時間と注意力は、人にしか解けない問題に残したい。それ以外は自動チェックに任せる。今の変更速度では、人がやることは驚くほど多く、チームはほぼ毎日、これまでにない新しい課題に直面している。
人の時間にはレビューコストの両端が含まれる。レビューに費やす時間と、壊れたコードが引き起こした問題の修正に費やす時間だ。後者に移っただけなら、前者を削っても意味はない。
だから目標はこうだ。Claude Code の各リポジトリ(CLI、デスクトップアプリと Web アプリ、モバイルアプリ)の pull request の大半が、最大でも1人——著者本人でもよい——の参加だけでマージでき、しかもロールバックやインシデントが増えないこと。人の時間を測るために、PR ごとの人手による承認数(中央値と95パーセンタイル)、人手によるコメント数、PR が誰かの対応を待つ時間を追跡している。ロールバック率とインシデント率はガードレールだ。これらが上がれば、人の時間は節約できておらず、場所を移しただけということになる。
1つの変更のライフサイクル
典型的な変更は、エンジニアのノート PC(あるいは Slack 上の Claude セッション)から始まり、何層ものコードレビューを通っていく。
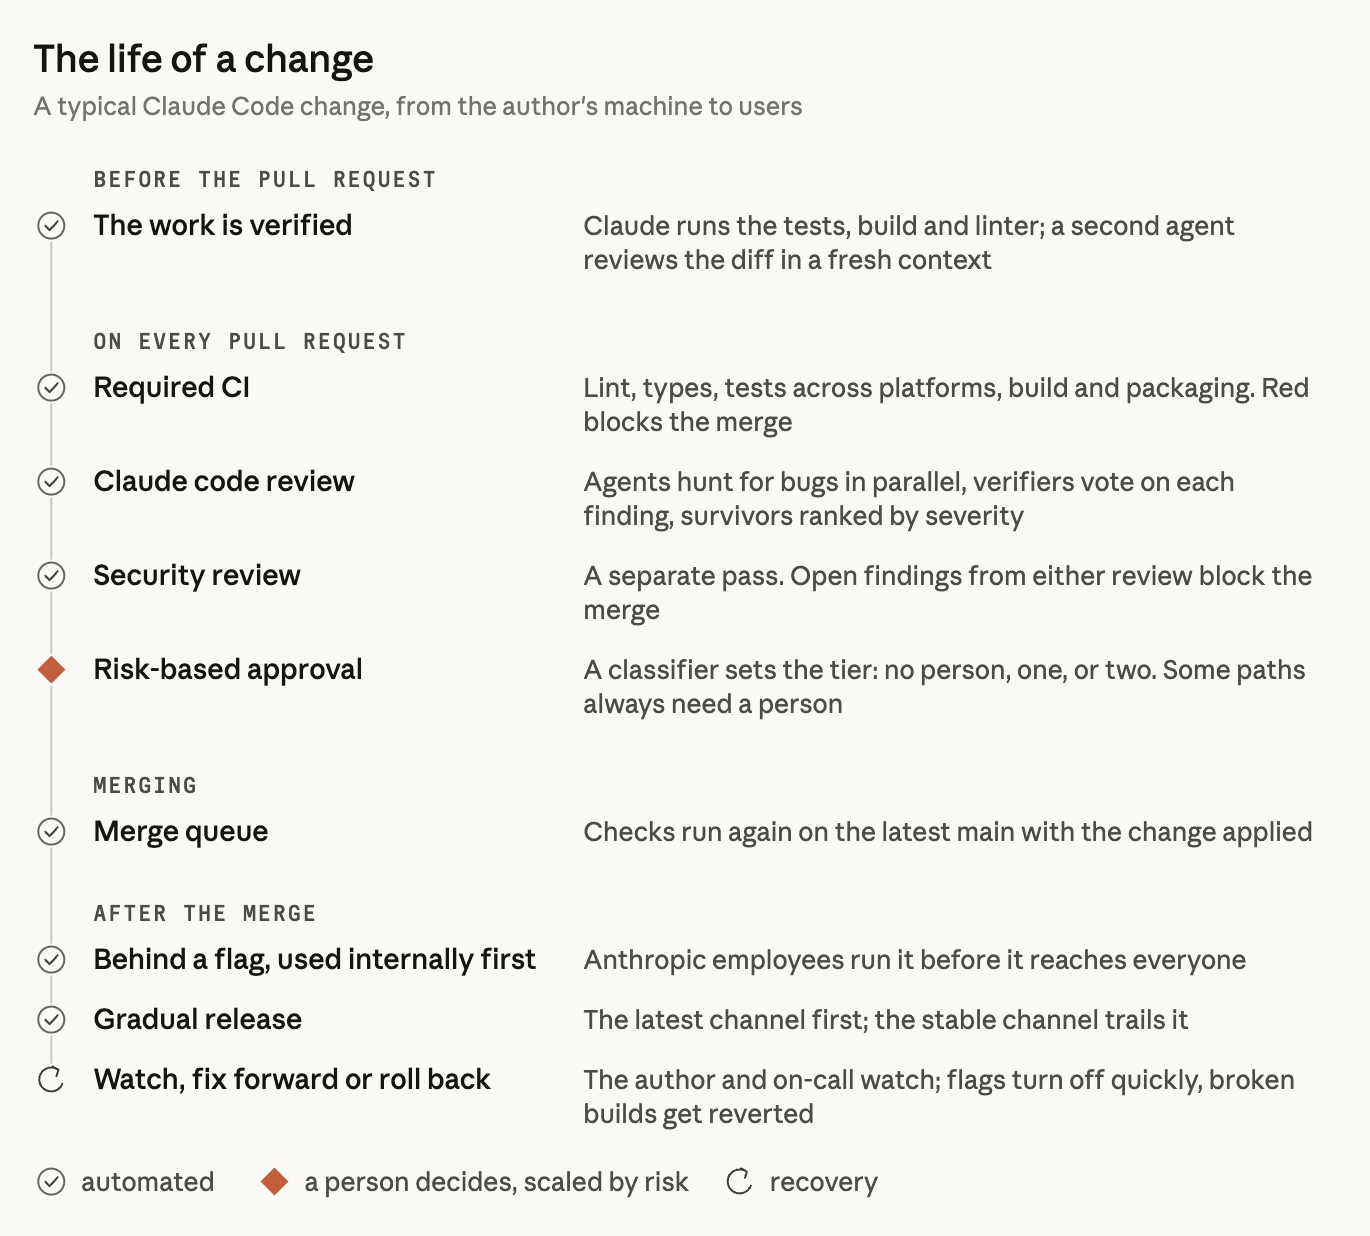
レイヤーごとに分解する
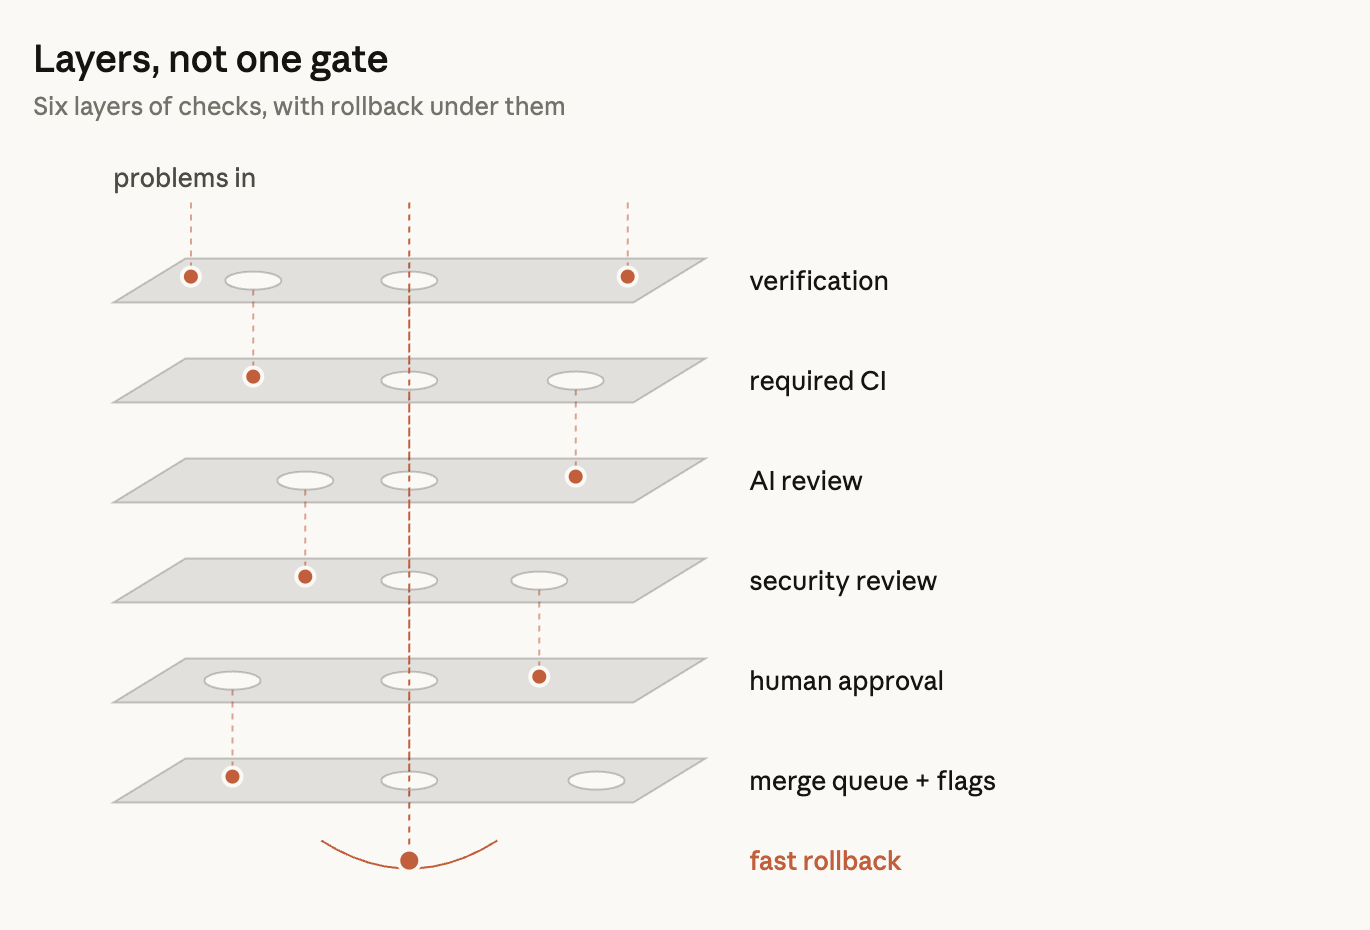
1. まず自分で検証し、それから人に見せる
現在、レビューの大半は PR を作る前に済んでいる。Claude には実際に動かせるもの——テスト、ビルド、あるいはデザイン案と突き合わせるためのスクリーンショット——を渡し、口で「できました」と言うのではなく、出力を示すよう求めている。その後、新しいコンテキストを持つ subagent が diff をレビューする。どちらの習慣もベストプラクティスガイドから来ている。
PR を開く前に、社内製の skill をいくつか走らせる人も多い。バグを探すもの、diff を削るもの、振る舞いをエンドツーエンドで確認するものだ。UI の変更はデザイン仕様と照らし合わせる工程も通す。
Claude Code の作者である Boris Cherny は、Claude に自分の仕事を検証する手段を与えることがおそらく最も重要なことであり、良い結果を出す鍵だと語っている。これで最終的な結果が二倍から三倍良くなると見積もり、こう書いている。「検証の方法は領域によって違う。bash コマンドを一本走らせるだけかもしれないし、テストスイートを回すことかもしれないし、ブラウザやモバイルシミュレータでアプリを一通り触ることかもしれない。」
自動レビューが同じ問題を繰り返し指摘するときは、根本から直す。 skill を変える、lint ルールを足す、あるいは次のような指針となるファイルを更新する。
CLAUDE.mdはこのプロジェクトが何なのかを Claude に伝える。技術スタック、規約、目標と非目標。レビューのたびに読み込まれるので、大きなコードベースではごく短く書き、残りはここから他のドキュメントへ参照させる。レビュアーは、そこに書かれた規約に反するコードや、中の一行を古くしてしまう変更も指摘する。REVIEW.mdはコードオーナーが書き、自分が担当するコードのどこが重要かをレビュアーに伝える。レビュアーが本当にそれに従っているかは別途確認している。うまく書けているものはどれも短い。このリポジトリで「壊れる」とはどういうことかを示し(ドキュメントのリポジトリなら「嘘を書いている」、設定のリポジトリなら「リクエストを誤った経路に流している」)、些末な指摘の数に上限を設け、飛ばすべきパスを列挙し、名前からの推測ではなくファイルと行番号を根拠として求める。要約は件数から始め、直すものがなければ直すものはないとそのまま書くよう求めるものでもある。
2. すべての pull request を AI レビューに通す
どの pull request も、人が見る前にまず Claude のレビューを通る。リポジトリ全体と PR が掲げる意図に照らして diff を読み、こう問いかける。この変更は解こうとしている問題を解決しているか。システムの設計に合っているか。何か他のものを壊していないか。
バグ修正のときは根本原因を探しに行く。公開版の Code Review for Claude Code は Team と Enterprise プランで一般提供を開始しており、/code-review はより軽量な版をローカルで動かす。
リサーチプレビューを公開したとき、社内の PR で実質的なレビューコメントが付く割合は 16% から 54% に上がった。1,000 行を超える PR はほぼ確実に問題が見つかり、小さな PR はほとんどそのまま通る。管理者はリポジトリごとに Quick、Standard、Deep を設定できる。バグを見逃すコストがレビューに余分にかかる時間を上回るなら、Deep を有効にする価値がある。
見つかった問題は他の agent が検証してから人に渡す。 複数の agent が同時にバグを探し、別の agent 群が各指摘に投票して、十分な数の agent が確かだと判断したものだけが公開される。スタイルや診断メッセージ、片付けだけに関する指摘は捨てる。これらのフィルタルールは、残す前に自分たちの PR で A/B テストした。残ったものは行内コメントとして重要度順に並ぶ。それぞれ Important、Nit、Pre-existing のいずれかが付くので、その PR が持ち込んでいないバグが作者の責任に見えることはない。
どの指摘にも対応が要る。 直すか、理由を書いてスレッドを解決済みにするかのどちらかだ。たいていは agent が一晩のうちに修正を終え、作者が戻ってきたときには PR がもう一周している。
3. マージを止めるセキュリティレビュー
セキュリティにも専用の自動レビューがある。バグレビューかセキュリティレビューのどちらかに未クローズの指摘が一件でも残っていれば、PR はマージできない。直すか、短い理由を添えてスレッドを閉じるかだ。誤検知はこうして消す。後続のコミットで問題が直れば、その指摘は自動的に消える。オープンソースの security review GitHub Action や /security-review コマンドでも同じことができる。設定方法は automated security reviews in Claude Code を参照。
4. マージを止める自動チェック
いつもの一式だ。lint、型チェック、各プラットフォームでのテスト、ビルド。(これほどの規模の CI をどう組むかは記事に書いた。)典型的な CLI の pull request は、人が見る前に何十ものチェックを走らせることになる。PR テンプレートは、変更をどうテストしたか、どうロールバックするかの記入を求める。Claude が記入を手伝うことはできるが、変更を出した人がそれに署名する責任を負う。
5. リスクに応じた段階的な人の承認
ドキュメントの修正と自動アップデータの修正ではリスクが違うのだから、レビューの仕方も変わる。
| リスク | 例 | 人の承認 |
|---|---|---|
| 低 | ドキュメント、文言、社内専用の機能、フラグの裏に隠れた段階的な変更 | 自動レビューとセキュリティチェックが通れば、人の承認は不要 |
| 中 | 通常の製品変更、およびキャッシュ、自動アップデータ、システムプロンプトなど敏感な領域の変更 | 1 人 |
| 高 | 最もリスクの高いコード、および常に 2 人の承認を要するパスの小さな集合 | 2 人 |
格付けは変更内容そのもので決まり、書いた人では変わらない。 分類器が変更内容を読み、リスクレベルを判定する。2つ目の分類器は、レベル上は不要と出ていても、その変更に別の人の関与が要るかどうかを判断する。常に人手の承認が必要な経路もある。オーナーが機密と指定したものすべてと、すべての CI workflow ファイルだ。
軽量な経路を通れるのは信頼された作者だけ。 リポジトリの信頼リストに載っている作者だけが軽量な経路を使える。リストの中心はそのリポジトリを担当するチームだ。それ以外は全員、2人目の承認が要る。agent の承認は人の承認として決して数えない。自動レビューは低リスクの変更を通過させられるが、人が必要な枠を埋めることはできない。
変更を起こした者が責任を負う。 agent が書いた PR では、agent に指示した人が必要なレビュー担当者の1人とみなす。自分でそのコードを書いた場合と変わらない。
1回の承認がカバーするのは特定の commit 1つだけ。 その後、システムが保証できない新しい commit が来た場合——agent が push したものや、手動でコンフリクトを解消したマージなど——は、承認を取り直さなければならない。
6. マージキュー、フィーチャーフラグ、段階的リリース
マージキューは変更を main に適用し、すべてのチェックをやり直す。だから単独では通る2つの PR が合わさって main を壊すことはない。新しい挙動はたいていフィーチャーフラグの裏に隠し、Anthropic の社員だけに開放する。自分たちでヘビーに使うことで、ユーザーより先にリグレッションが見つかることが多い。公開リリースはまず latest チャネル、続いて stable チャネルへと進む。
7. 素早く見つけ、素早く戻す
すり抜けるバグは必ずある。最後の砦は、できるだけ早く捕まえることだ。フィーチャーフラグはデプロイせずに切れる。Claude Code には週替わりの on-call がいて、インシデントの振り返りでは、どの層が止めるべきだったのかを問う。
まずいマージを見つけたとき、頼りになるのは依然として作者と on-call、そして revert とインシデントボードだ。数字が動いたら承認を自動で厳しくする、といったサーキットブレーカーはまだない。エンジニアたちは、より多くのコードを人手なしマージへ移す前に、それを用意しておきたいと考えている。
同僚の1人はこう言った。速度を落とせば確かにエラー率は下がるが、それは主に、やることを減らしているからだ、と。私たちはむしろ、問題を見つけて直すほうを速くしたい。
reviewer をどう良くしていくか
私たちのコードレビューの仕組みは、ループを回しながら改善を続けている。
今ではあらゆるインシデントが eval になる。 チームは過去にインシデントを引き起こした PR を、その fix-forward と revert ごと集めた。そのコードに詳しいエンジニアに、各バグとその在処を確認してもらう。レビュアーはこの集合を毎日回している。
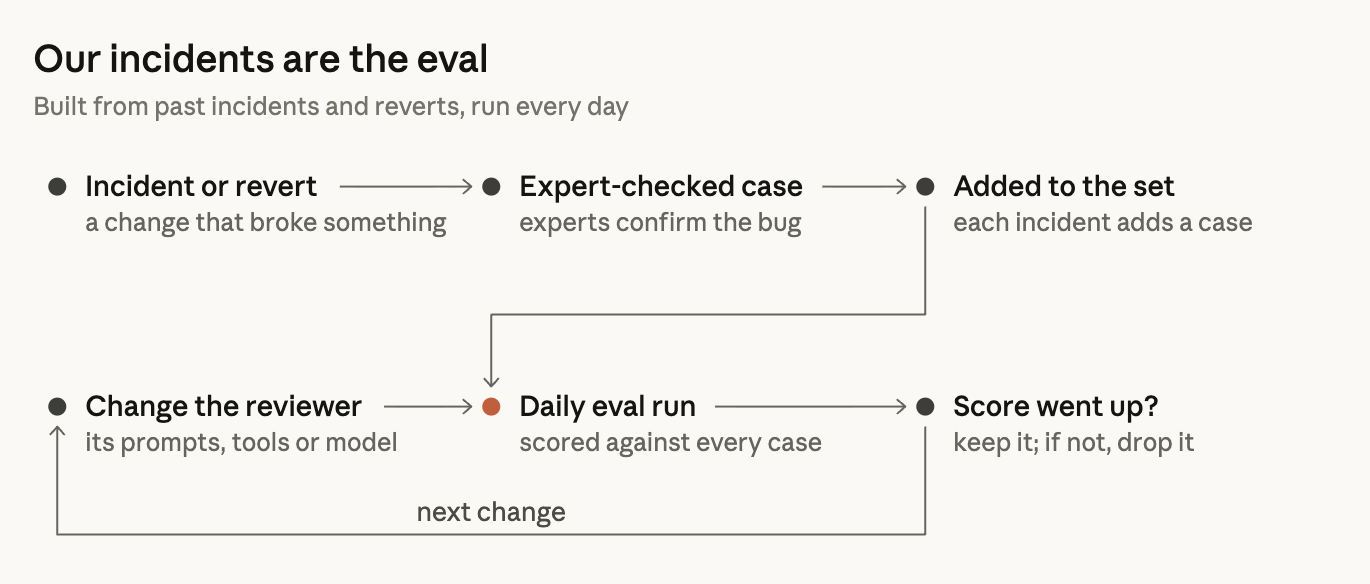
ノイズは、人がレビューコメントにどう反応するかで測る。 バグをたくさん拾うのは簡単だ。バグでないものへの誤検知を大量に出しても気にしなければいい。だからそこには制約が要る。レビュアーが残したコメントを、PR 作者の対応ごとに分類した。修正した、これは間違いだと指摘した、意図的なものだと説明した、重要でないと判断した、の四つだ。さらにレビュアーには既知のクリーンな PR を走らせ、「有害な変更を招く」問題を報告する頻度を数える。優先順位はこう書いた。まず本物のバグを捕まえること、レビュー回数の削減はその次だ。
作者が agent だと、ノイズのコストはもっと高い。人は数秒であら探しの指摘を片付けられる。agent は直しに行く。コミットが一つ増え、レビューがもう一巡増える。
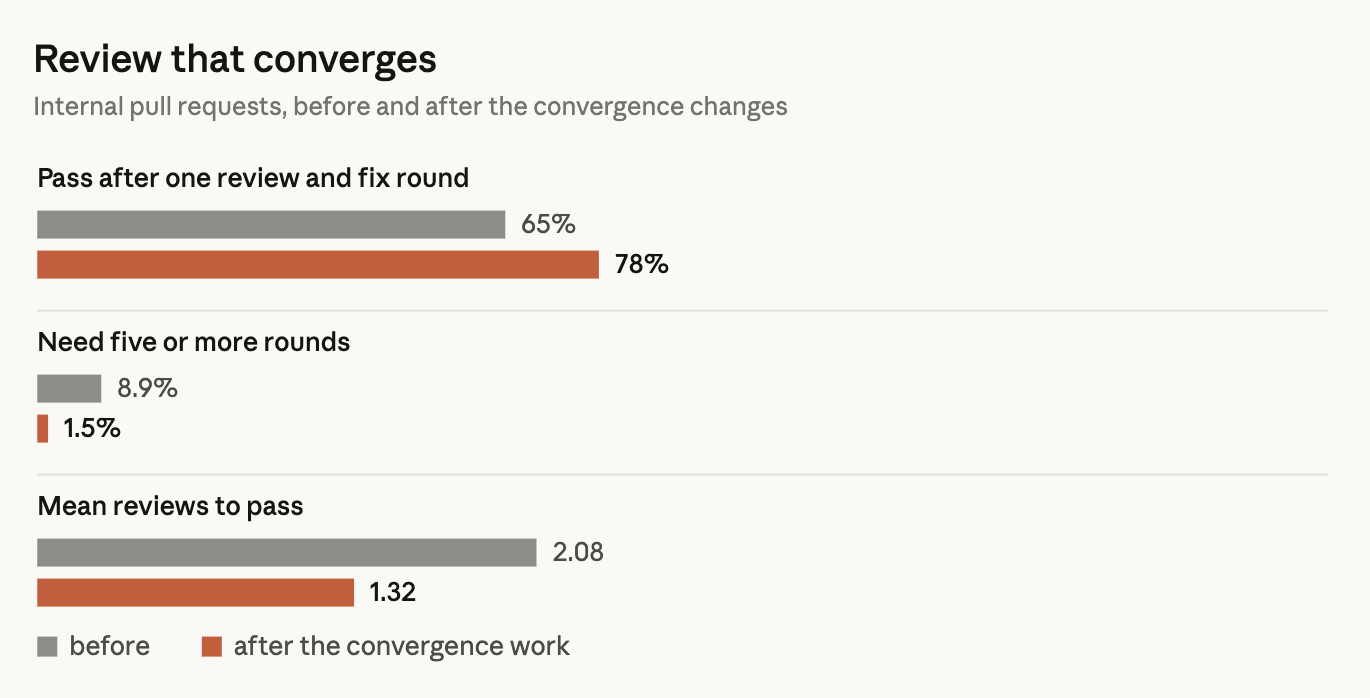
レビューは収束しなければならない。 agent の作者と agent のレビュアーは、際限なくお互いを忙しくさせ続けられる。ある CLI の PR は一晩で五十数回のレビューと修正を繰り返し、最後は作者が止めに入った。
レビュアーが繰り返し指摘した箇所に git blame をかけたところ、約 59% はレビュアーの初回時点ですでに存在していたコードだった。レビュアーが新しいバグを見つけていることはほとんどなく、毎回いくつかの古いバグを見つけ直しているだけだ。
この問題はこちら側で深刻にしてしまった。毎回は必ず何か新しいものが見つかるので、何巡も回すのが既定になっていた。リスクの高い変更ならそれだけの価値があるかもしれないが、すべての PR にあるわけではない。チームはいま、通過に必要な回数と再現率を並べて追跡し、再レビューのやり方を変えた。
- 回数の上限。 三巡したら、レビュアーは作者に一歩引いて方針を考え直すよう促す。
- diff だけを見る再レビューを、最初の数巡のあとに使う。
- バグのカテゴリを示す。 作者は一行だけ直すのではなく、同種の箇所をすべて直す。
- すでに出した指摘は繰り返さない。
レビュー agent は毎晩、既存のコードにも一通り走らせている。古いバグが別の場所で表に出る前に捕まえるためだ。
人間が依然として関わる領域
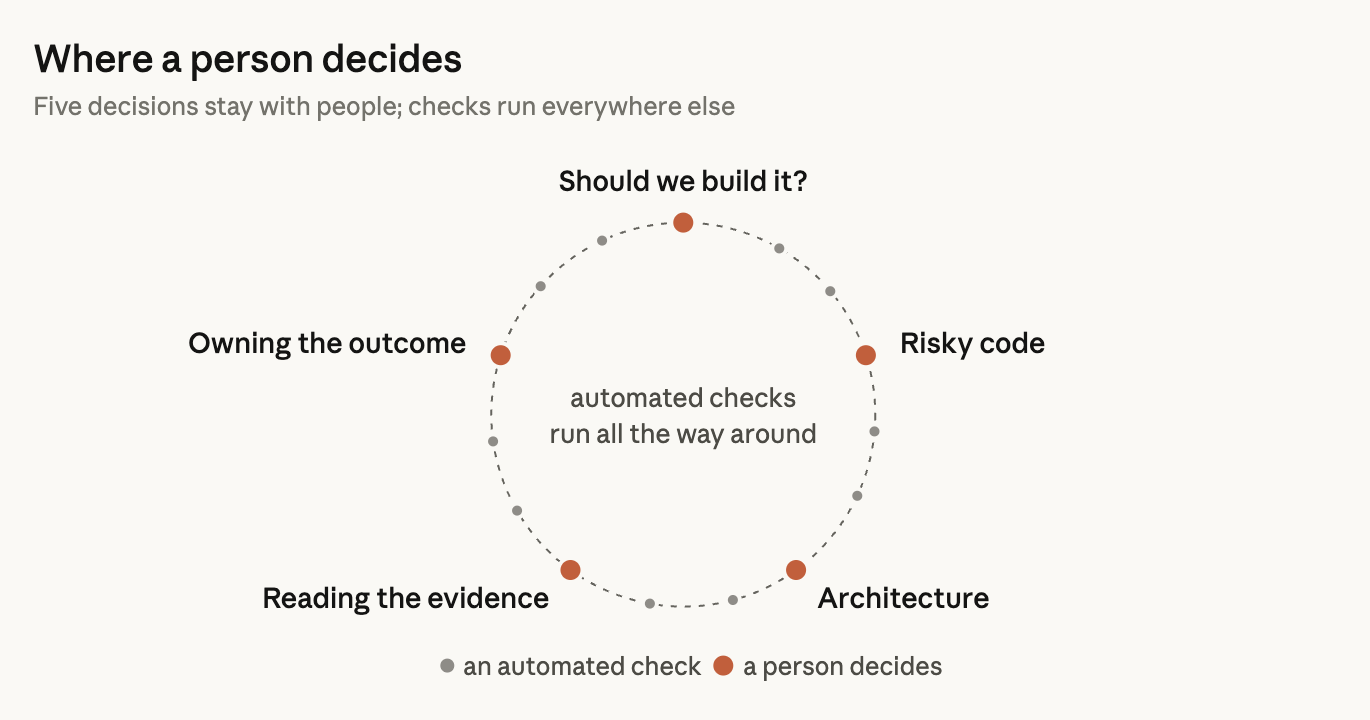
熟練エンジニアをディープワークから引き剥がし、定型的なミスを1つ捕まえるだけのコストは、レビューの自動化に比べてはるかに高い。Anthropic では、作業の中心は diff を1行ずつ読むことから、機械が苦手とする判断へと移った。
- そもそもやるべきことなのか。 方向性、テイスト、スコープ。あるチームはレビューのボトルネックは解消したと主張しているが、チーム外からの変更については人間によるレビューを残している。「これは本当にやるべきことなのか」と誰かが問えるようにするためだ。
- リスクの高いコード。 課金、自動アップデーター、CI ワークフローなど。
- アーキテクチャ。 他の人がそのまま真似するパターン。
- 証拠を読む。 テストの出力、実行したコマンド、返ってきた内容、スクリーンショット、レビュー担当者の指摘。これらのチェックが何を見落とすか説明できないなら、素早く承認するのではなく、本物のレビューを要求すること。
- 結果に責任を持つ。 本番に出た変更の1行1行には、誰が打ったかにかかわらず、責任を負う人が必要だ。
チームでコンテキストを共有する
コードレビューの2つ目の役割は、コードベースに対するチームの理解を広げていくことだった。同僚の diff を読んで、何が変わったのか、各部分がどう組み合わさっているのかを知る。だが、読む作業の大半を機械に任せてしまったら、人はどうやってコードに詳しくなるのか。
このために正式なプロセスを決めたわけではない。チームの誰も Claude Code の完全なモデルを頭に持っておらず、必要としている人もいない。コードベースのある部分を理解したくなったら、その部分について Claude に解説を書いてもらう。数分で手に入り、しかもコードの今の姿を反映している。
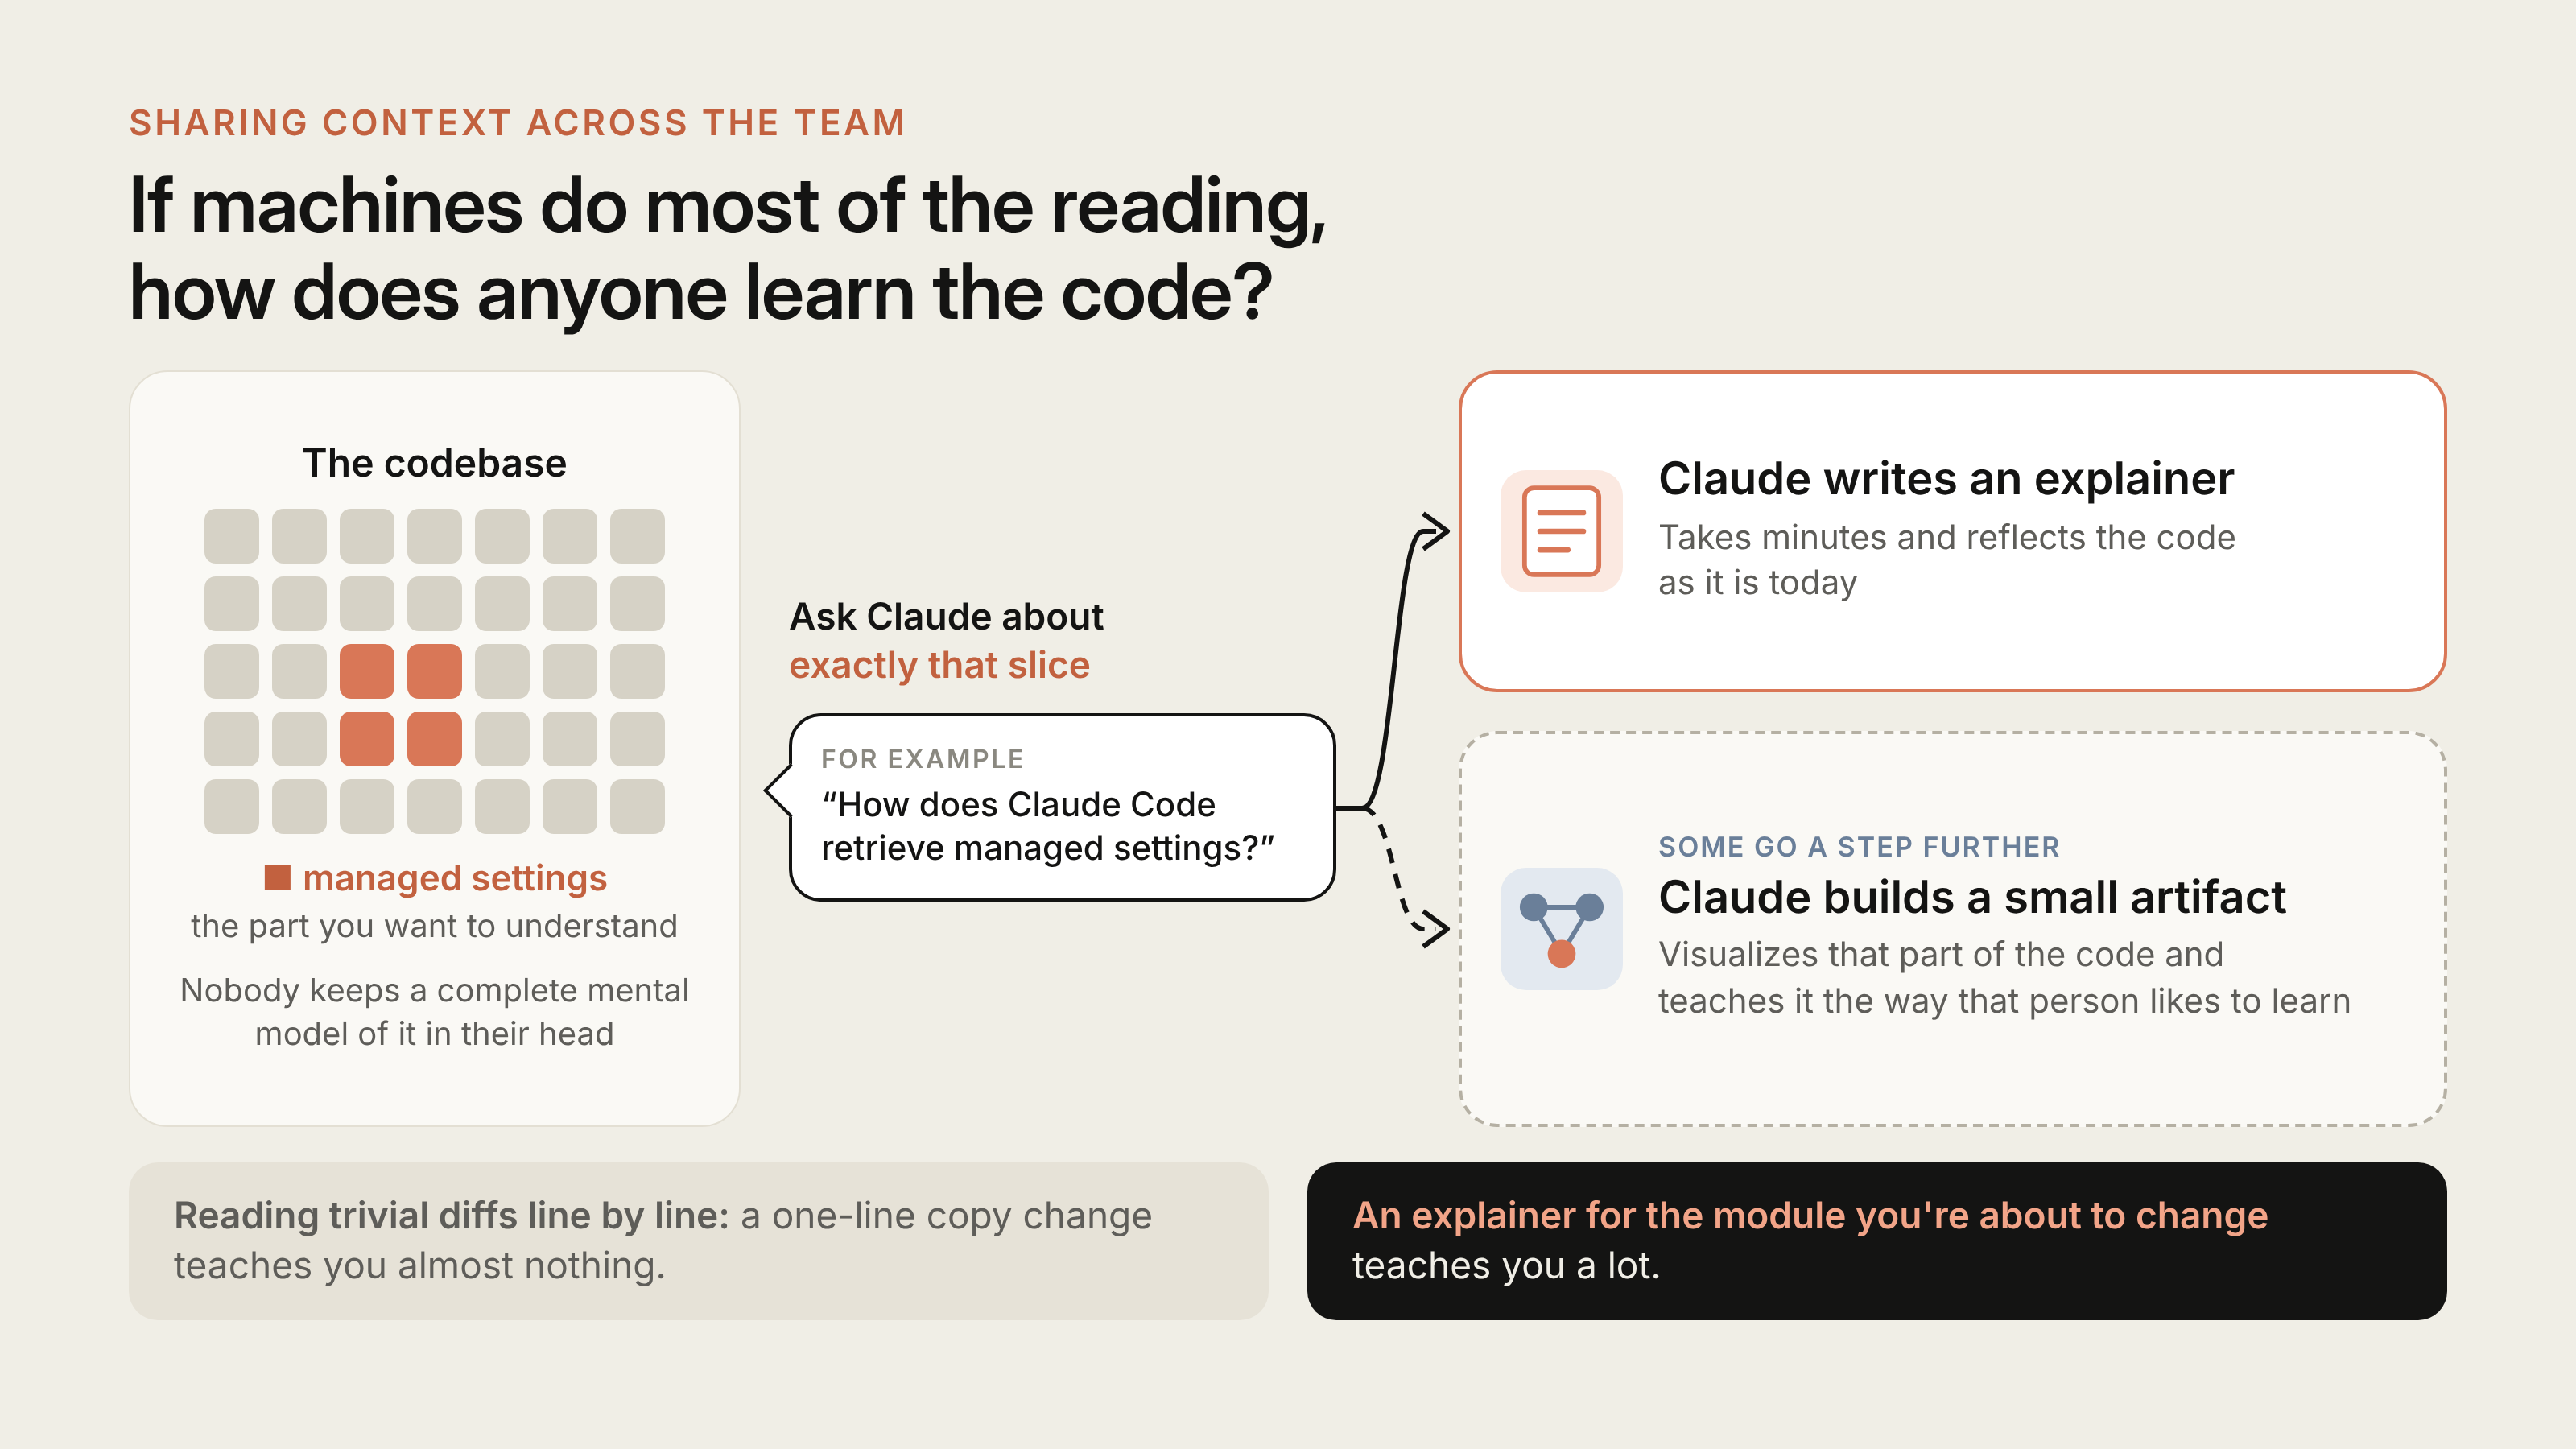
私たちの中には、さらに進んで Claude に小さなツールを作らせ、コードのその部分を可視化し、自分が好む学習スタイルで説明させる人もいる。
人の注意力を本当に大事なところに使うなら、取るに足らない diff を一行ずつ読むよりはるかに良い。文言を一行変えても、ほとんど学べることはない。これから変更するモジュールについての解説をもらえば、多くを学べる。公開 Slack チャンネルで仕事をする文化も助けになる。他の人が何をしているかは、見ているうちに自然と分かる。
「マージした人が責任を持つ」
小さめの変更や中程度の変更をマージした後に問題が起きたら、チームの慣習では通常その人が直す。これがつらくならない理由はいくつかある:
- 変更がどれも小さいので、レビューもデバッグもロールバックも簡単だ。
- すべて巻き戻せる。 フィーチャーフラグ、ロールバック、段階的リリースがあれば、ほとんどの誤りは数分で取り消せる。
- 影響範囲がハードルの高さを決める。 コストの高いコードには、関わる人もチェックも増える。
- リグレッションはすぐ露呈する。 テレメトリと社内利用で見つかる。
- これは責任追及ではない。 直す側が責任を持つというのは、その人が最も文脈を理解しているという意味だ。インシデントの振り返りが見るのはシステムであって、個人ではない。
責任は分担もされる。チームの多くの人が公開チャンネルで作業しているので、誰が何をしているかは誰にでも見え、会話に加わることも、Claude に足りない部分を埋めさせることもできる。フィードバックはそのコードを所有していない人からも届く。品質を高い水準に保ちながら、すべての行にゲートを設けずに済んでいるのは、この開放性によるところが大きい。
方向転換するとき
Agent のおかげで物事を始めるのは安く済む。だからこそ、そもそもマージすべきでない仕事もある。たいていはチャンネルで誰かが理由を尋ねたり、以前の判断を指摘したり、もっと簡単な道を提案したりして、作者がその PR を閉じるか作り直す。
コードを書くのが速いので、PR を閉じても損失には感じない。コツは、PR が完成してからブロックするコメントを残すのではなく、スレッドの早い段階で別の方向性を出すことだ。
チームでこの流れを導入するには
やるべきことのほとんどは、今日すでに手元にある。
PR を出す前に
- agent が自分で実行できるチェックを短い
CLAUDE.mdにまとめ、フォーマットと linter を走らせる hook も加える。 - ローカルで
/code-reviewと/security-reviewを実行するか、まっさらなコンテキストのサブ agent にレビューさせる。 REVIEW.mdを追加し、繰り返し出てくるレビュー指摘をそこへ移す。
pull request ごとに
- CI の通過を必須にし、PR テンプレートに「テスト」「リスク」「ロールバック方法」を入れる。
- まず 1 つのリポジトリで AI レビュアー(Claude Code の Code Review、または Claude Code GitHub Action)を導入し、数週間かけて
REVIEW.mdを調整してから徐々に広げる。 - 自動セキュリティレビューを加え、マージ前にすべてのレビュースレッドを解決することを必須にする。
- レビューの深さはリスクに合わせる。定型の変更はさっと目を通し、バグを見逃すと高くつく箇所は深く見る(Code Review の Quick、Standard、Deep)。
- レビューの回数を制限する。最初の数回を過ぎたら、追加された diff だけを再レビューする。
承認
- リスクレベルを明文化し、作者ではなく変更そのものに応じて格付けする。最初は厳しめに始め、根拠が揃ってから緩める。
- 信頼できる作者には、より軽い承認経路を残す。
- CODEOWNERS とブランチ保護を使い、認証、課金、CI とリリースの流れ、インストーラーは常に人間の承認を必要とする。
- ボットの承認が必須の人間の承認の代わりになることは決してない。新しいコミットが積まれたら既存の承認は取り消す。
マージとその後
- merge queue、フィーチャーフラグ、社内先行利用、段階的リリース、そしてワンステップのロールバックを使う。
- インシデントとロールバックを eval セットに変え、レビュアーの prompt、ツール、モデルが変わるたびに再評価する。
- 人間が費やした時間を測り、ロールバック率とインシデント率をガードレール指標にする。
これから
Code Review のリリース告知では、pull request の承認は依然として人間が判断するとしている。製品が提供するのは指摘であって、承認ではない。私たち自身のリポジトリはさらに進んでいて、どの低リスクな変更を自動チェックだけでマージできるかをリポジトリの所有者が決めており、その線引きは今も動き続けている。
レビューが問題を見逃したときは、そのときモデルに何が欠けていたのかを問い、修正を CLAUDE.md、skill、あるいは新しいチェックとして書き加える。目標は変わっていない。変更あたりの人間の時間を減らし、ロールバックは以前より増やさないことだ。
チームで agent に pull request を出させているなら、知りたい。どのチェックを自動化し、どこに今も人間が必要で、私たちのどこが間違っていると思うか。
レビューしてくれた Emma Webb、Michael Segner、Amie Rotherham に感謝する。