コード実行で AI エージェントのコストを下げ、精度を上げる
Datadog Code Execution が一般提供に。AI エージェントはサンドボックスの JavaScript で複数の API を並行して叩け、ステップごとにモデルと往復する必要がなくなる。トークンも呼び出しも節約できる。
日本語
コピー
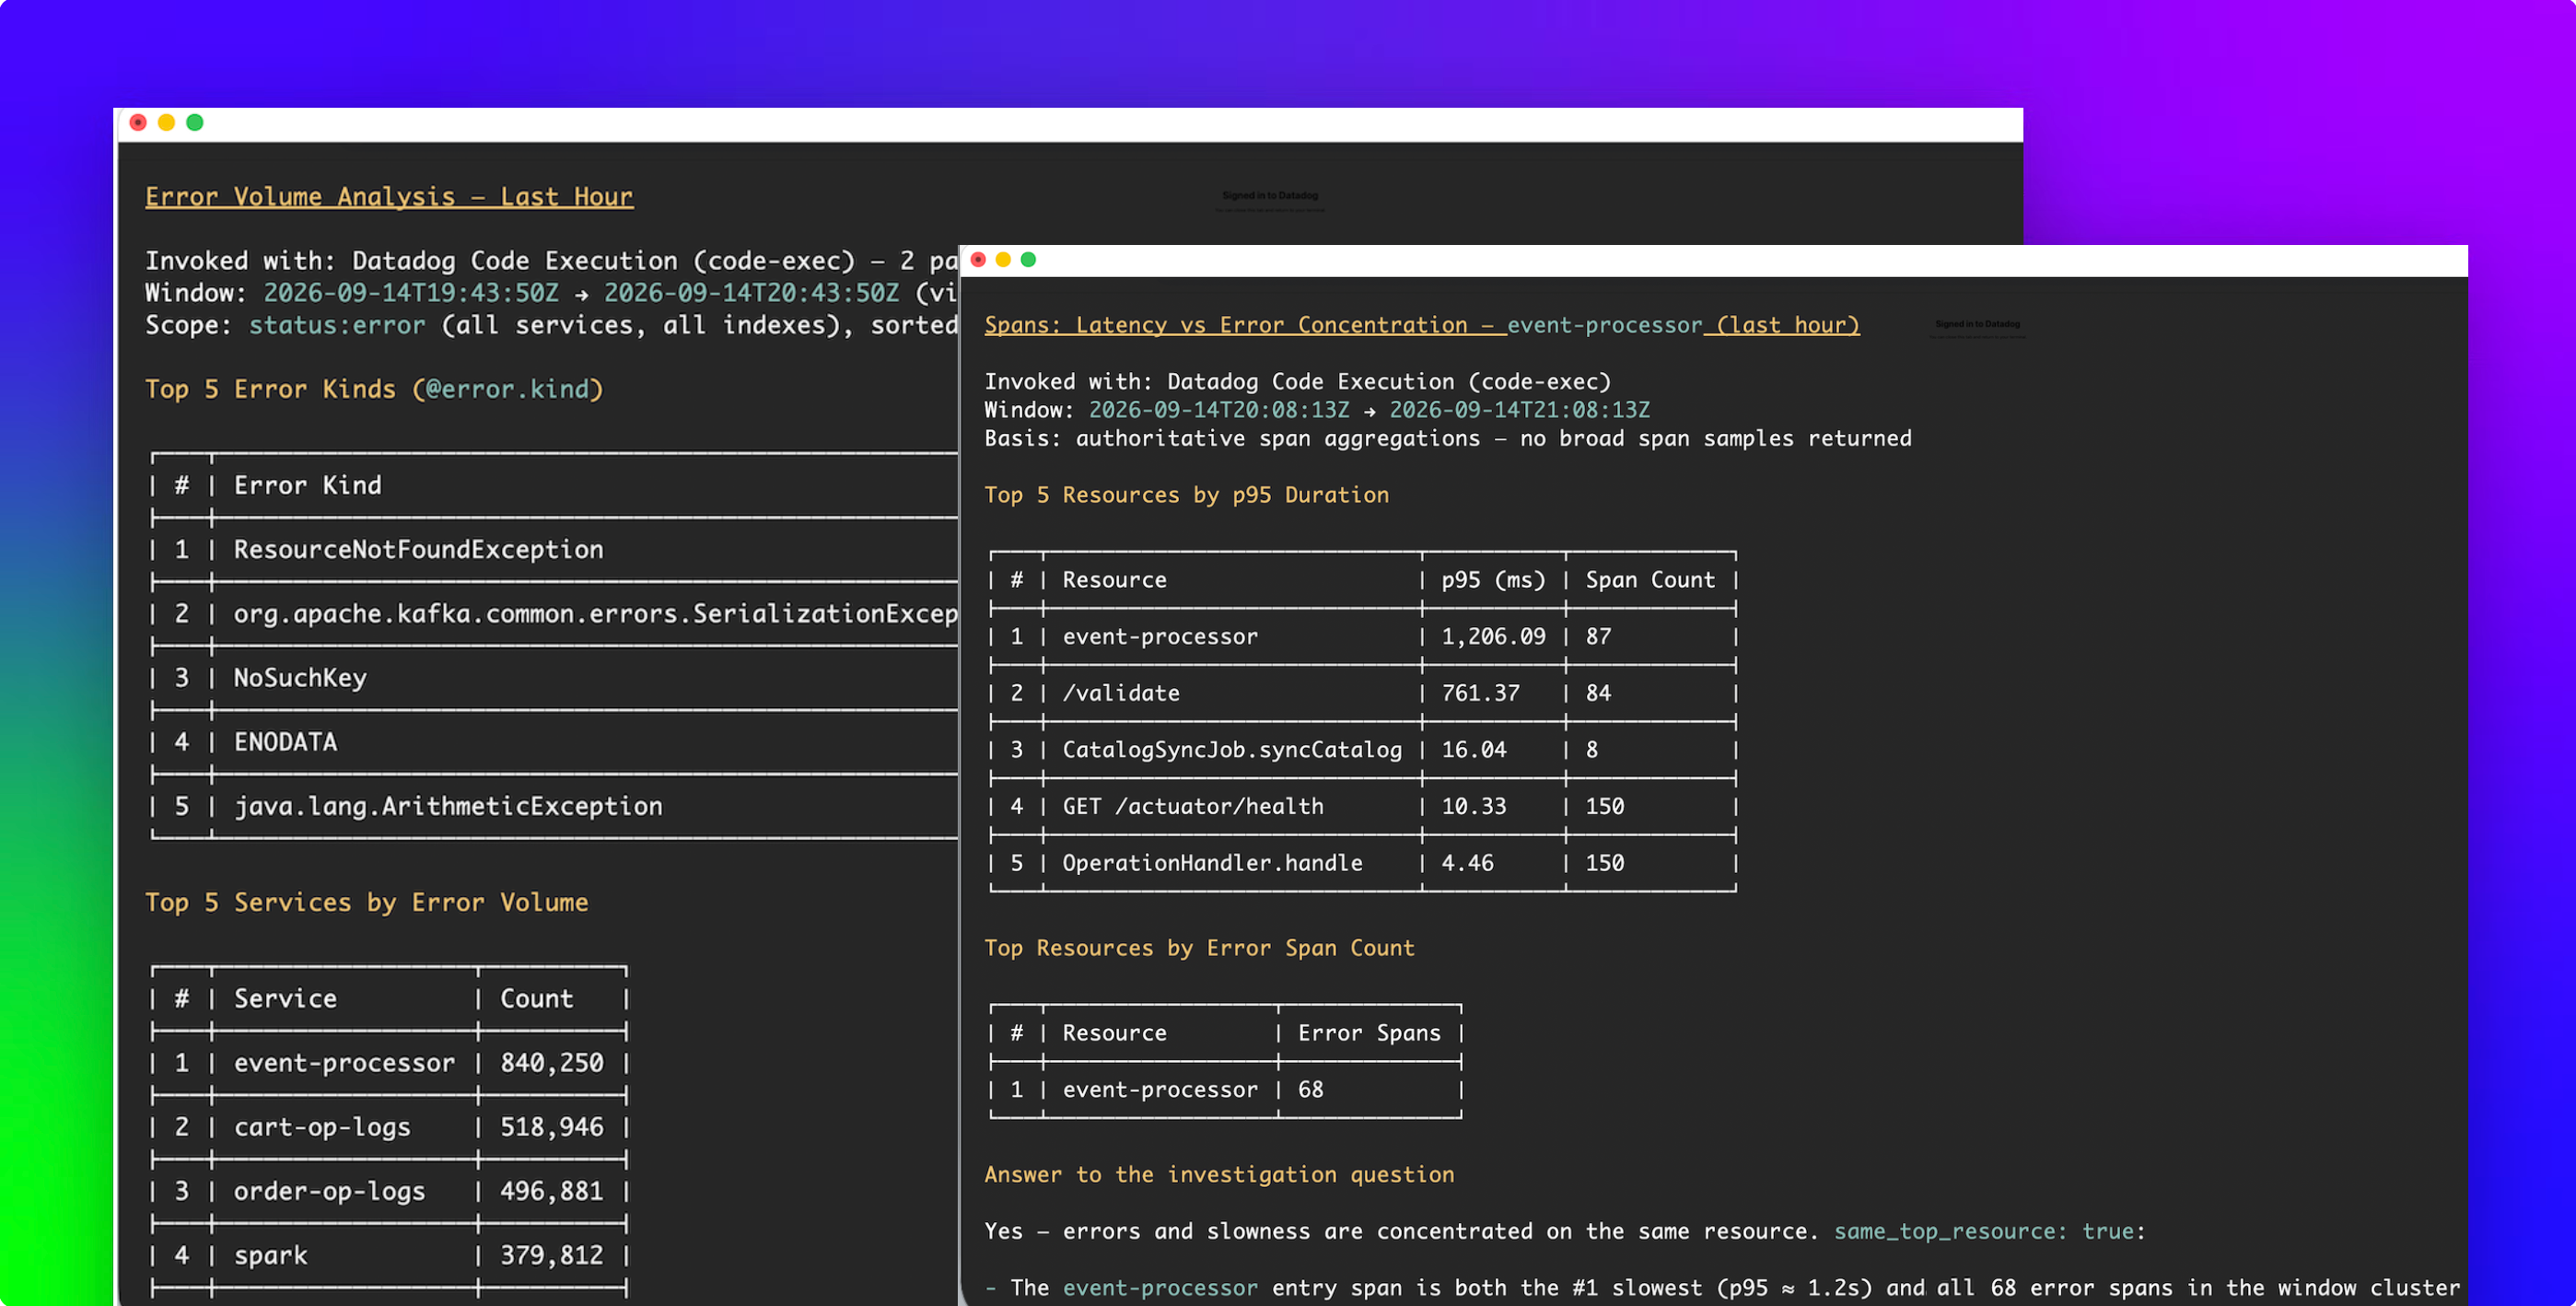
従来の MCP ツールでは、各ステップでモデルとのやり取りが発生する。ツールを選び、返ってきた結果を見て、次に何を呼ぶか決め、新しい結果をまた会話に積み込む。的を絞ったクエリを1回投げるなら問題ないが、複数のシグナルをまたぐ調査では効率が悪い。モデルはコンテキストを、結果そのものではなく、ツールのスキーマや生のレスポンス、呼び出しの間の段取りに費やしてしまう。
Datadog Code Executionは一般提供が始まり、AI agent が Datadog MCP Server を通じて可観測性データをプログラムから調査できるようになった。サンドボックス化された JavaScript 環境で、agent は複数の Datadog API をクエリし、互いに依存しないタスクを並列実行し、結果に応じて分岐し、データを結合し、問いに答えるのに必要な証拠だけを返せる。モデルに返る証拠が絞り込まれる分、Code Execution は回答の精度を上げながら、AI agent を動かすコストを下げる。
本記事では次のことを扱う。
- 複数シグナルにまたがる調査ロジックをコードの中に保つ
- token とツール呼び出しのオーバーヘッドを減らしつつ、より正確な回答を得る
- 認証情報を渡さずに生成コードを実行する
- Code Execution をセットアップする
複数シグナルにまたがる調査ロジックをコードの中に保つ
Datadog MCP Server を使えば、AI agent はログ、メトリクス、トレース、モニター、ダッシュボードなど Datadog のデータをクエリするツールを利用できる。従来の MCP ツールは、agent の背後にあるモデルに明確で境界のはっきりしたアクションを提供するもので、的を絞った問いに対しては今も最短経路だ。しかし調査が複数のデータソースにまたがると、agent は複数のツールを呼び、次の一手を決めるために毎回の結果をモデルに送り返す必要が出てくる。Code Execution は、こうした中間作業をコードの中へ移す。
Code Execution は、小さな MCP インターフェースとプログラマブルな実行環境を組み合わせたものだ。agent は execute_code と search_datadog_sdk という2つの MCP ツールを通じて Code Execution とやり取りし、Datadog の API 全体を探索・クエリする。実行環境の中では、制御フローも中間データも、ツール呼び出しを1つずつ会話に通すのではなく、コードの中にとどまる。
サンドボックス内で agent は、互いに依存しないクエリを並列で走らせ、前の結果を使って次のクエリを決め、異なる API からのレスポンスを正規化し、共通のフィールドで関連付けることができる。会話に結果を返す前に、巨大なレスポンスをフィルタリングしたり集約したりすることもできる。利用できる API 操作は Datadog TypeScript client SDK に基づいているため、生成されるコードは他の Datadog 連携と同じクライアントとリクエスト構造を使う。各 API 操作は個別に型付けされ、必要な権限の範囲内に制約される。agent はそれらを通常の制御フローで組み合わせる。
たとえば agent は次のスクリプトを生成して実行し、同じ 1 時間のウィンドウ内でエラーが出たログと span を照会できる。コードは 2 つのクエリを並列に実行し、結果を service ごとにグループ化して突き合わせ、両方の結果セットに現れた service だけを返す:
1import { client, v2 } from "@datadog/datadog-api-client";2
3// Create clients for the two Datadog APIs we want to compare.4// Authentication stays outside the sandbox; the MCP service applies the caller's permissions.5const config = client.createConfiguration();6const logs = new v2.LogsApi(config);7const spans = new v2.SpansApi(config);8
9// Give both queries the same one-hour window so their counts are comparable.10const from = dd.time.hoursAgo(1);11const to = dd.time.now();12
13// Find the services producing the most errors in logs and traces. The queries14// run together, so neither result needs a separate round-trip through the model.15const [logErrors, spanErrors] = await Promise.all([16 logs.aggregateLogs({ body: {17 filter: { query: "status:error", from, to },18 compute: [{ aggregation: "count" }],19 groupBy: [{20 facet: "service",21 limit: 25,22 sort: { aggregation: "count", order: "desc", type: "measure" },23 }]24 }}),25 spans.aggregateSpans({ body: {26 data: { type: "aggregate_request", attributes: {27 filter: { query: "status:error", from, to },28 compute: [{ aggregation: "count", metric: "*" }],29 group_by: [{30 facet: "service",31 limit: 25,32 sort: {33 aggregation: "count",34 metric: "*",35 order: "desc",36 type: "measure",37 },38 }]39 }}40 }}),41]);42
43// Index the log counts by service, then join them to the span results.44const logsByService = new Map(45 (logErrors.data?.buckets ?? []).map(46 bucket => [bucket.by?.service, bucket.computes?.c0]47 )48);49
50// Return only the overlap instead of sending both raw responses to the model.51return (spanErrors.data ?? [])52 .map(bucket => ({53 service: bucket.attributes?.by?.service,54 errorSpans: bucket.attributes?.compute?.c0,55 errorLogs: logsByService.get(bucket.attributes?.by?.service) ?? 0,56 }))57 .filter(service => service.errorLogs > 0)58 .slice(0, 5);
この例では、各 API がそれぞれ上位 25 件の service を返せるが、モデルのコンテキストに戻るのは両方の結果セットに共通する 5 件だけだ。Code Execution がなければ、モデルは 2 つの結果セットを受け取り、会話の中でこの join を行う必要がある。
回答はより正確に、コストはより少なく
Code Execution が調査の質とコストに与える影響を測るため、Datadog のコアツールセットと比較した。比較は 25 件のオブザーバビリティタスクを対象とし、メトリクス、ログ、トレース、Datadog Error Tracking、および複数のデータソースにまたがる調査を含む。各タスクは GPT-5.6 Terra、GPT-5.6 Sol、Claude Sonnet 5、Claude Opus 4.8 でそれぞれ 3 回実行し、最終回答の正確性を採点した。
テストしたすべてのモデルで Code Execution は回答の正確率を改善し、その幅は 7.7 ポイントから 21.8 ポイントに及んだ:
| モデル | コアツールセット | Code Execution ツールセット | 変化 |
|---|---|---|---|
| GPT-5.6 Terra | 77.6% | 85.3% | +7.7 pp |
| GPT-5.6 Sol | 74.4% | 94.0% | +19.6 pp |
| Claude Sonnet 5 | 66.7% | 88.5% | +21.8 pp |
| Claude Opus 4.8 | 77.5% | 90.6% | +13.1 pp |
モデルのコストは token 使用量に依存するため、モデルに送るコンテキストを減らせば 1 回の調査のコストも下がる。4 モデルの平均では、Code Execution は入力 token を 73.2% 削減し、ツール呼び出し回数を 39.6% 減らした:
| 項目 | コアツールセット | Code Execution ツールセット | 変化 |
|---|---|---|---|
| 回答正確率 | 74.1% | 89.6% | +15.6 pp |
| 入力 token | 159.4k | 42.8k | -73.2% |
| ツール呼び出し | 4.08 | 2.47 | -39.6% |
注意: コアツールセットと Code Execution ツールセットの列の数値は四捨五入されている。変化の列の数値は四捨五入前の元の値から計算した。
生成されたコードを実行しても、認証情報を渡す必要はない
モデルに本番環境のオブザーバビリティデータ向けのコードを生成させるには、明確なセキュリティ境界が要る。Code Execution はコードの実行と認証をこの境界の両側に分ける。
生成された JavaScript コードは隔離されたサンドボックスで動作し、呼び出し元の認証情報にはアクセスできない。コードが dd.* メソッドを呼び出すと、信頼された MCP サービスが呼び出し元に代わってリクエストを発行し、その既存の Datadog 権限と Code Execution ポリシーを適用して、レスポンスをサニタイズしてからサンドボックスに返す。コードは返されたデータを処理できるが、そのデータを取得するための認証情報には一切触れられない。
Code Execution をセットアップする
Code Execution を使い始めるには、Datadog MCP Server を AI クライアントに接続し、code-exec ツールセットを有効化する。
Code Execution を有効にしたら、複数のオブザーバビリティデータを突き合わせる必要がある質問を agent に投げてみよう。たとえば「昨夜のデプロイ後にエラー率が変化した service を特定し、それに伴って変化した trace パターンを示して」といった具合だ。agent は Code Execution で関連データを集め、突き合わせ、回答の根拠を示せる。
より少ないモデルコンテキストで、Datadog のクロスドメイン調査を始める
Code Execution は AI agent が Datadog MCP Server を通じて多段階のオブザーバビリティ調査を行うのを助けつつ、中間のロジックとデータをサンドボックス内にとどめる。モデルを経由する中間コンテキストとツール呼び出し回数を減らすことで、Code Execution は AI agent の運用コストを下げながら、より正確な回答を導く。詳しくは Code Execution のドキュメント、ツールセット設定ガイド、MCP Server のドキュメントを参照。