用代码执行降低 AI agent 的成本并提高准确率
Datadog Code Execution 正式可用:让 AI agent 在沙箱 JavaScript 里并行查多个 API,而不是每一步都和模型来回一次。省 token 与工具调用,答案也更准。
中文
复制
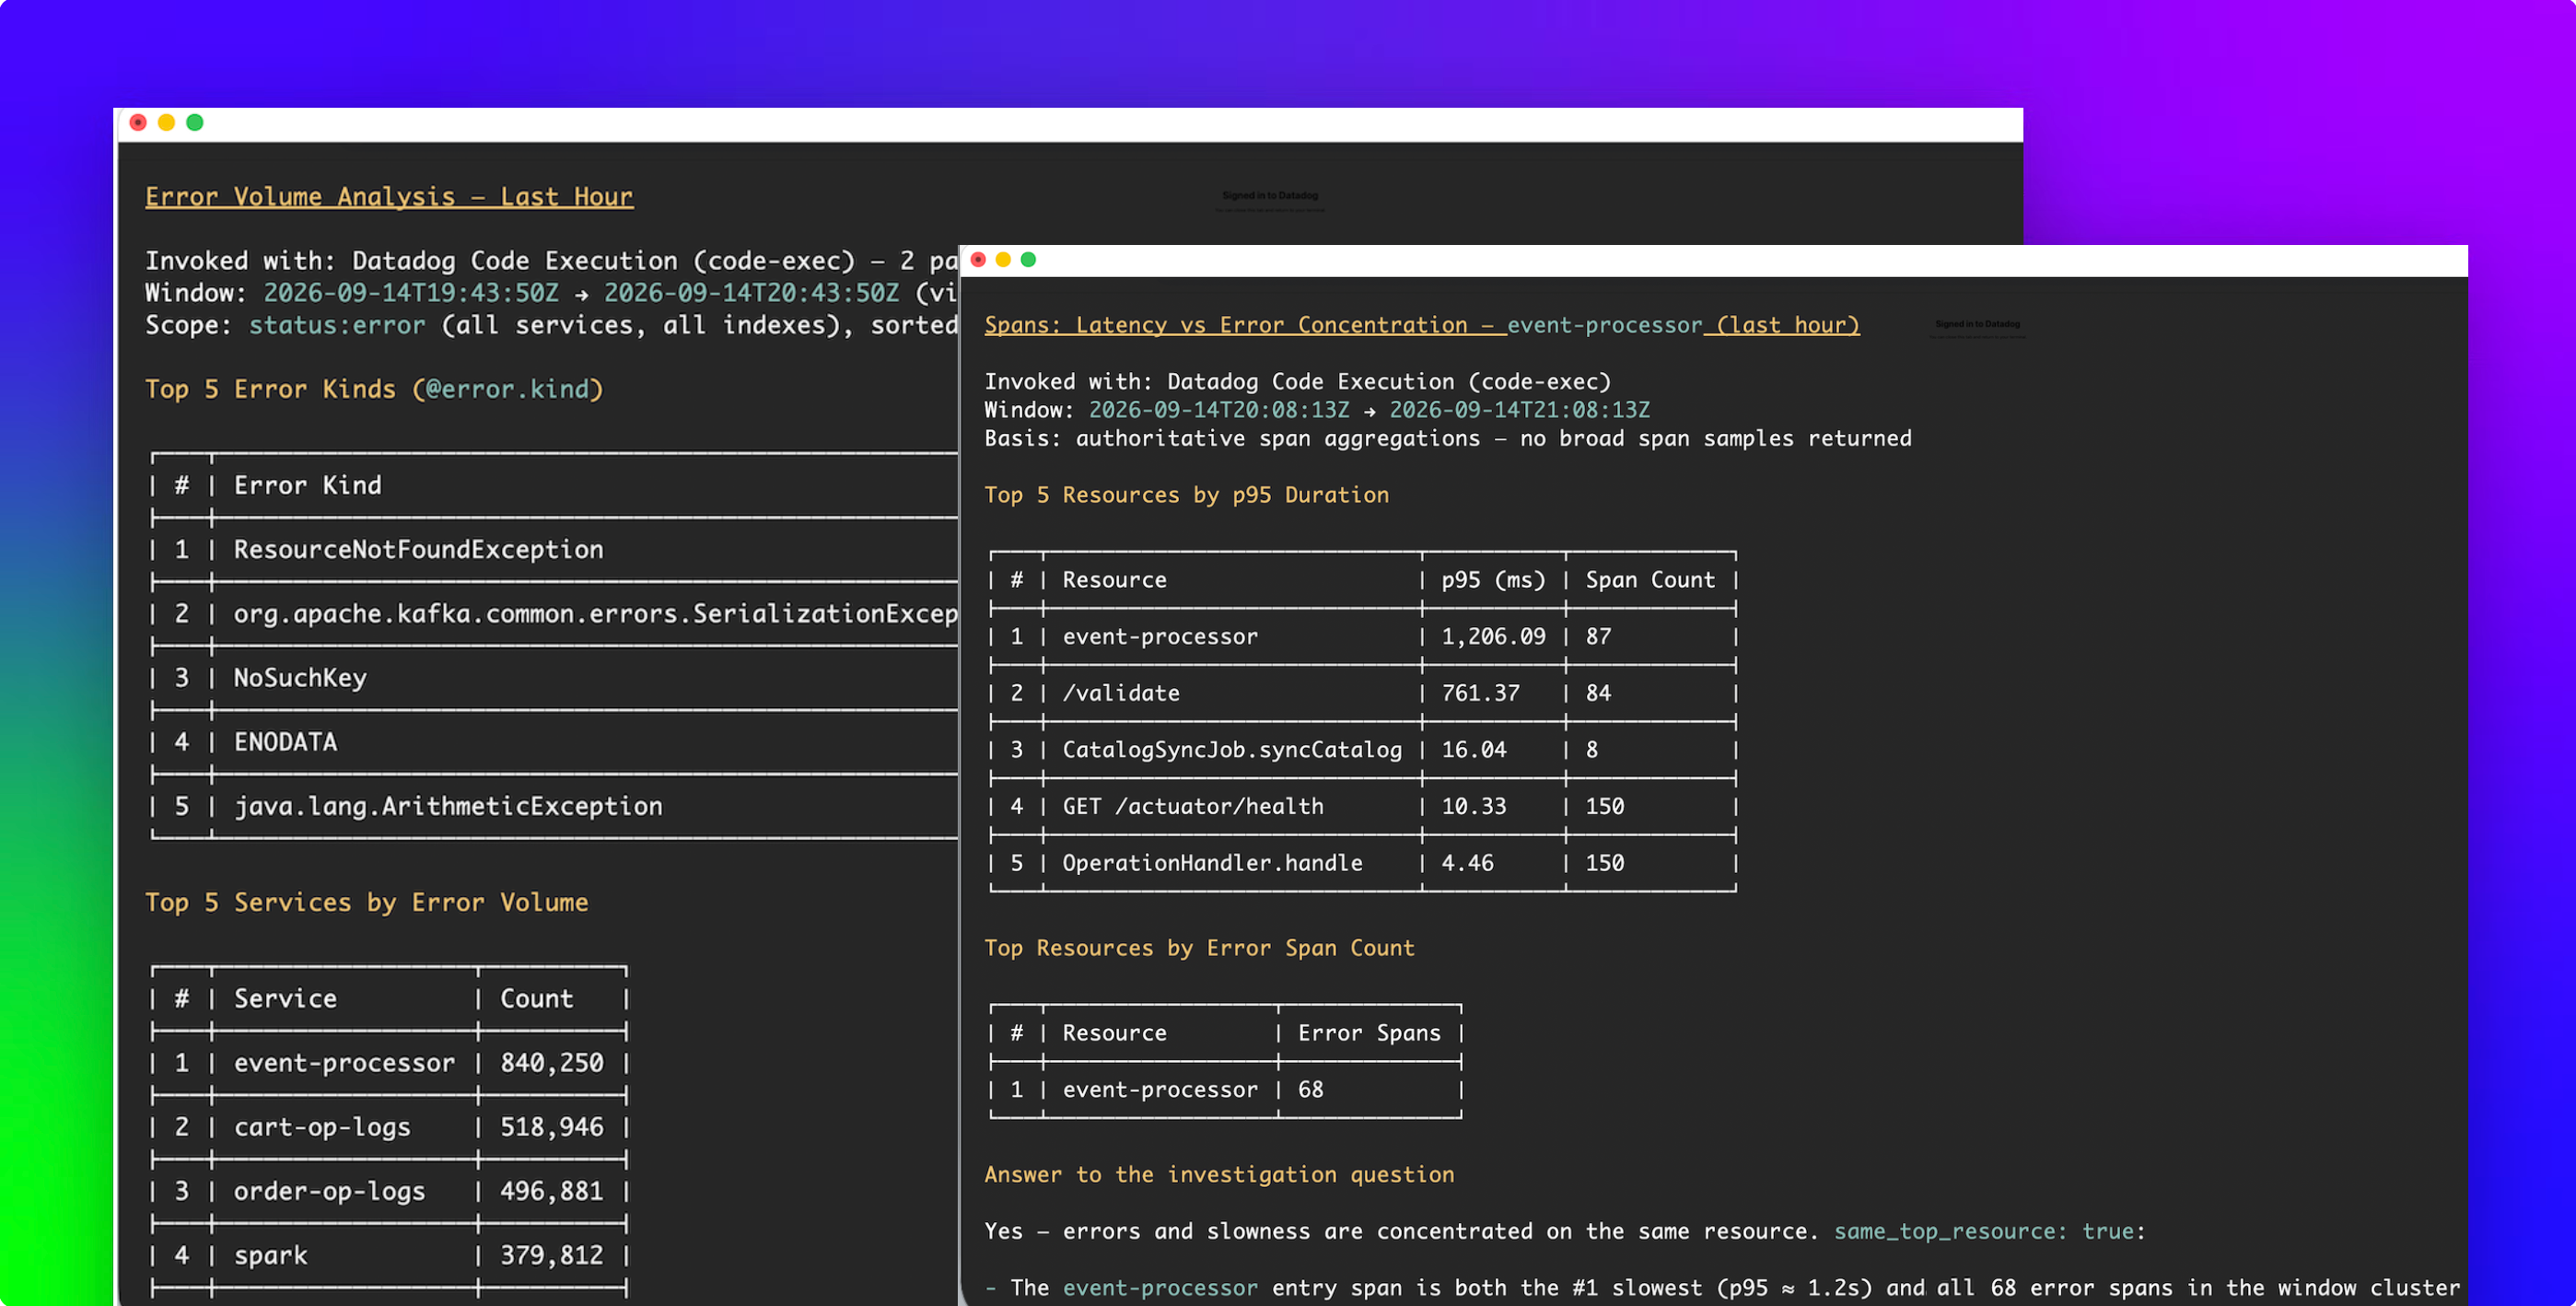
用传统的 MCP 工具,每一步都要和模型来回一次:选工具、看返回、决定下一步调什么、再把新结果塞进对话。做一次聚焦的查询没问题,但在多信号排查里就很低效。模型把上下文花在了工具 schema、原始响应和调用之间的中间步骤上,而不是花在结果上。
Datadog Code Execution,现已正式可用,它让 AI agent 可以通过 Datadog MCP Server 以可编程的方式排查可观测性数据。在沙箱化的 JavaScript 环境里,agent 可以查询多个 Datadog API,并行执行互不依赖的任务,根据结果分支,拼接数据,最后只返回回答问题所需的证据。返回给模型的证据更聚焦,Code Execution 因此能提高答案准确率,同时降低运行 AI agent 的成本。
本文将介绍如何:
- 将多信号调查逻辑保留在代码中
- 在减少 token 和工具调用开销的同时获得更准确的答案
- 无需交出凭据即可运行生成的代码
- 设置 Code Execution
将多信号调查逻辑保留在代码中
Datadog MCP Server 让 AI agent 能够使用查询日志、指标、链路追踪、监控器、仪表盘及其他 Datadog 数据的工具。传统 MCP 工具为 agent 背后的模型提供清晰、边界明确的动作,对于聚焦的问题仍是最短路径。但如果一次调查横跨多个数据源,agent 可能需要调用多个工具,并把每个结果都送回模型,才能决定下一步。Code Execution 把这类中间工作移入代码。
Code Execution 将一个小型 MCP 接口与可编程的执行环境结合起来。agent 通过两个 MCP 工具 execute_code 和 search_datadog_sdk 与 Code Execution 交互,从而在 Datadog 的整个 API 面上进行探索和查询。在执行环境中,控制流和中间数据都留在代码里,而不是以一次一个工具调用的方式穿过对话。
在沙箱内,agent 可以并行运行互不依赖的查询,用前一个结果决定下一个查询,把来自不同 API 的响应归一化,再按共同字段做关联。它还可以在把任何结果返回对话之前,先对庞大的响应做过滤或聚合。可用的 API 操作基于 Datadog TypeScript client SDK,因此生成的代码使用与其他 Datadog 集成相同的客户端和请求结构。每个 API 操作都单独有类型,并受其所需权限的约束。agent 用普通的控制流把它们组合起来。
例如,agent 可以生成并运行下面这段脚本,查询同一 1 小时窗口内出现错误的日志和 span。代码并行执行两个查询,按 service 对结果分组,做关联,只返回同时出现在两个结果集中的 service:
1import { client, v2 } from "@datadog/datadog-api-client";2
3// Create clients for the two Datadog APIs we want to compare.4// Authentication stays outside the sandbox; the MCP service applies the caller's permissions.5const config = client.createConfiguration();6const logs = new v2.LogsApi(config);7const spans = new v2.SpansApi(config);8
9// Give both queries the same one-hour window so their counts are comparable.10const from = dd.time.hoursAgo(1);11const to = dd.time.now();12
13// Find the services producing the most errors in logs and traces. The queries14// run together, so neither result needs a separate round-trip through the model.15const [logErrors, spanErrors] = await Promise.all([16 logs.aggregateLogs({ body: {17 filter: { query: "status:error", from, to },18 compute: [{ aggregation: "count" }],19 groupBy: [{20 facet: "service",21 limit: 25,22 sort: { aggregation: "count", order: "desc", type: "measure" },23 }]24 }}),25 spans.aggregateSpans({ body: {26 data: { type: "aggregate_request", attributes: {27 filter: { query: "status:error", from, to },28 compute: [{ aggregation: "count", metric: "*" }],29 group_by: [{30 facet: "service",31 limit: 25,32 sort: {33 aggregation: "count",34 metric: "*",35 order: "desc",36 type: "measure",37 },38 }]39 }}40 }}),41]);42
43// Index the log counts by service, then join them to the span results.44const logsByService = new Map(45 (logErrors.data?.buckets ?? []).map(46 bucket => [bucket.by?.service, bucket.computes?.c0]47 )48);49
50// Return only the overlap instead of sending both raw responses to the model.51return (spanErrors.data ?? [])52 .map(bucket => ({53 service: bucket.attributes?.by?.service,54 errorSpans: bucket.attributes?.compute?.c0,55 errorLogs: logsByService.get(bucket.attributes?.by?.service) ?? 0,56 }))57 .filter(service => service.errorLogs > 0)58 .slice(0, 5);
在这个示例中,每个 API 都可以返回自己排名前 25 的服务,但只有同时出现在两个结果集中的那 5 个服务会回到模型的上下文中。如果没有 Code Execution,模型就必须接收两个结果集,并在对话中完成这次 join。
答案更准,花费更少
为了衡量 Code Execution 对排查质量和成本的影响,我们把它和 Datadog 的核心工具集做了对比。对比覆盖了 25 个可观测性任务,涉及指标、日志、链路追踪、Datadog Error Tracking,以及需要跨多个数据源的排查。每个任务我们用 GPT-5.6 Terra、GPT-5.6 Sol、Claude Sonnet 5 和 Claude Opus 4.8 各跑三次,然后对最终答案的正确性打分。
在我们测试的每一个模型上,Code Execution 都提升了答案正确率,提升幅度从 7.7 个百分点到 21.8 个百分点不等:
| 模型 | 核心工具集 | Code Execution 工具集 | 变化 |
|---|---|---|---|
| GPT-5.6 Terra | 77.6% | 85.3% | +7.7 pp |
| GPT-5.6 Sol | 74.4% | 94.0% | +19.6 pp |
| Claude Sonnet 5 | 66.7% | 88.5% | +21.8 pp |
| Claude Opus 4.8 | 77.5% | 90.6% | +13.1 pp |
模型成本取决于 token 用量,因此减少发送给模型的上下文就能降低一次排查的成本。四个模型的平均结果显示,Code Execution 少用了 73.2% 的输入 token,工具调用次数少了 39.6%:
| 类别 | 核心工具集 | Code Execution 工具集 | 变化 |
|---|---|---|---|
| 答案正确率 | 74.1% | 89.6% | +15.6 pp |
| 输入 token | 159.4k | 42.8k | -73.2% |
| 工具调用 | 4.08 | 2.47 | -39.6% |
注意: 核心工具集和 Code Execution 工具集两列中的数值经过四舍五入。变化一列的数值由未四舍五入的原始值计算得出。
运行生成的代码,不必交出你的凭证
让模型针对生产环境的可观测性数据生成代码,需要一条清晰的安全边界。Code Execution 把代码执行和身份认证放在这条边界的两侧。
生成的 JavaScript 代码运行在隔离沙箱中,无法访问调用方的凭据。当代码调用 dd.* 方法时,由可信的 MCP 服务代表调用方发起请求,执行其现有的 Datadog 权限和 Code Execution 策略,对响应进行净化处理后返回沙箱。代码可以处理返回的数据,但全程接触不到用于获取这些数据的凭据。
设置 Code Execution
要开始使用 Code Execution,请将 Datadog MCP Server 连接到你的 AI 客户端并启用 code-exec 工具集。
启用 Code Execution 后,向你的 agent 提一个需要关联多种可观测性数据的问题。例如:“找出昨晚部署后错误率发生变化的服务,然后展示随之变化的 trace 模式。”agent 可以用 Code Execution 收集相关数据、进行关联,并给出答案背后的证据。
用更少的模型上下文,开始在 Datadog 中跨域排查
Code Execution 帮助 AI agent 借助 Datadog MCP Server 执行多步可观测性排查,同时将中间逻辑和数据留在沙箱内。通过减少经过模型的中间上下文和工具调用次数,Code Execution 可以降低运行 AI agent 的成本,同时帮助它们给出更准确的答案。了解更多,请参阅 Code Execution 文档、工具集配置指南和 MCP Server 文档。