earcut より速い:地図ポリゴン 374 万個を 489 ミリ秒で三角形分割する
earstrip は耳切り法でエンジンの制約付き Delaunay 三角分割を置き換え、ワルシャワ周辺の 374 万ポリゴンの処理を 2.93 秒から 489 ミリ秒に縮めた。着想ごとに 1 コミットずつ作り直し、各節の末尾にその変更で何ミリ秒減ったかを示している。
日本語
コピー
地図エンジンから多角形の三角形分割処理を切り出し、小さなライブラリにしました。名前は earstrip で、ISC ライセンスで公開しており、earcut と同じライセンスです。C++ のヘッダファイル 1 本だけの構成で、ほかに npm で配布している WebAssembly ビルドがあり、引数は earcut と同じです。C++ では earcut.hpp より 14% 速く、ブラウザでは earcut.js より 1.4〜2.1 倍速いという結果が出ています。比較は記事の末尾に置きました。この記事では、どうやってそれを実現したのかを説明します。
GPU が描くのは三角形の塗りつぶしだけで、それ以外は何もしません。ところが地図にあるのはほとんどが多角形です。建物、公園、駐車場、路面電車の線路 2 本に挟まれたあの草の帯もそうです。以下はワルシャワの Śródmieście の街区をいくつか、私たちのレンダラが地図ファイルから読み取ったままの形で輪郭として示したものです。
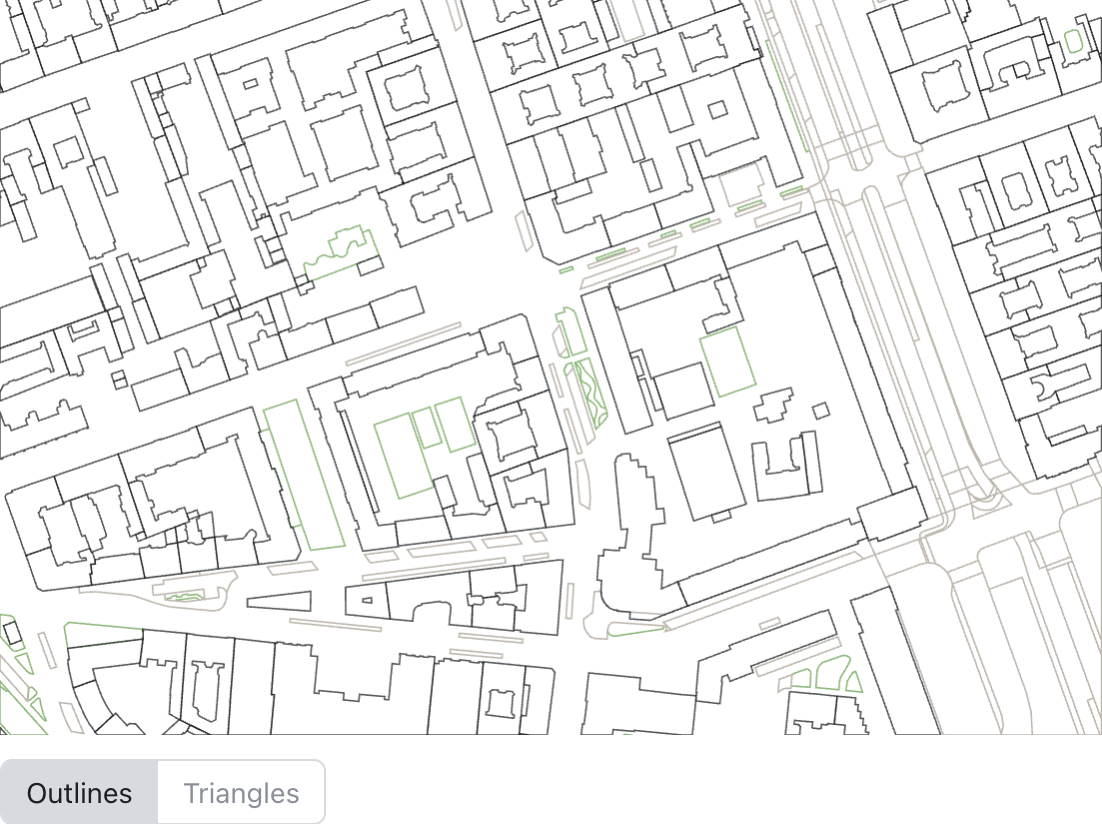
どの輪郭も、まず三角形に分割しなければ中身を塗ることはできない。このブロックには 331 個のポリゴンと 5,151 個の頂点があり、最終的に 4,514 個の三角形になる。
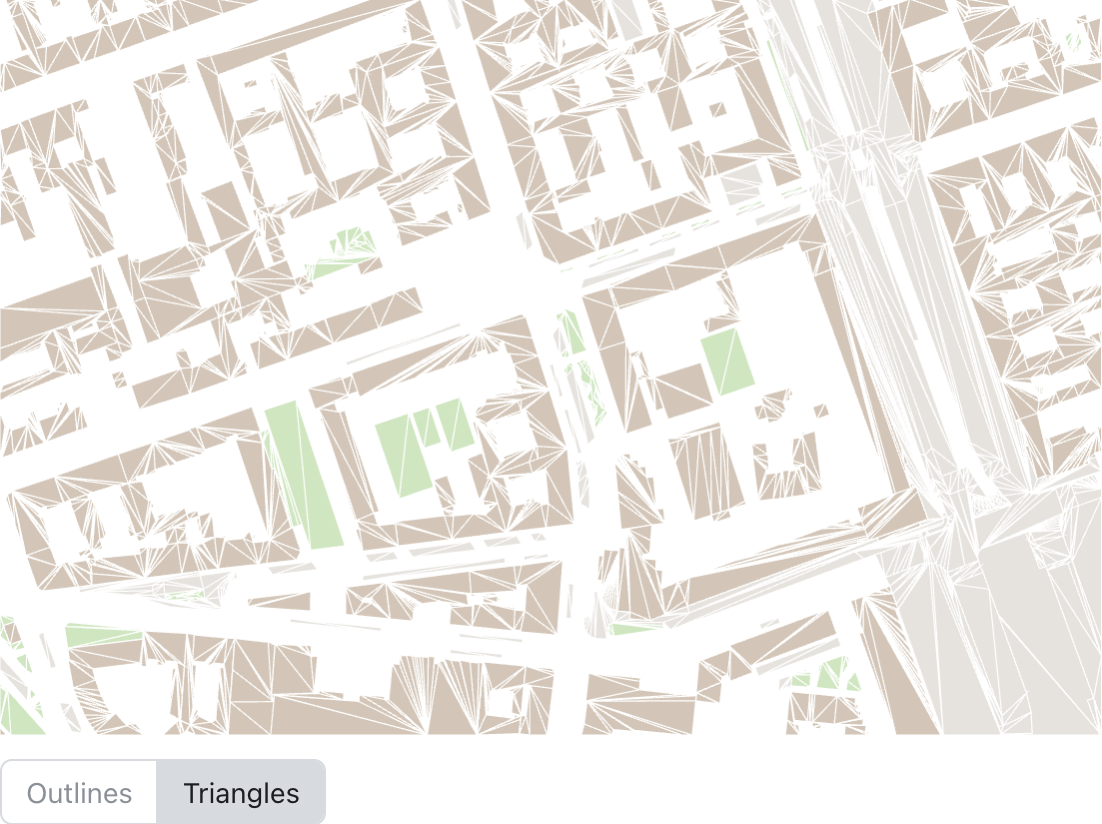
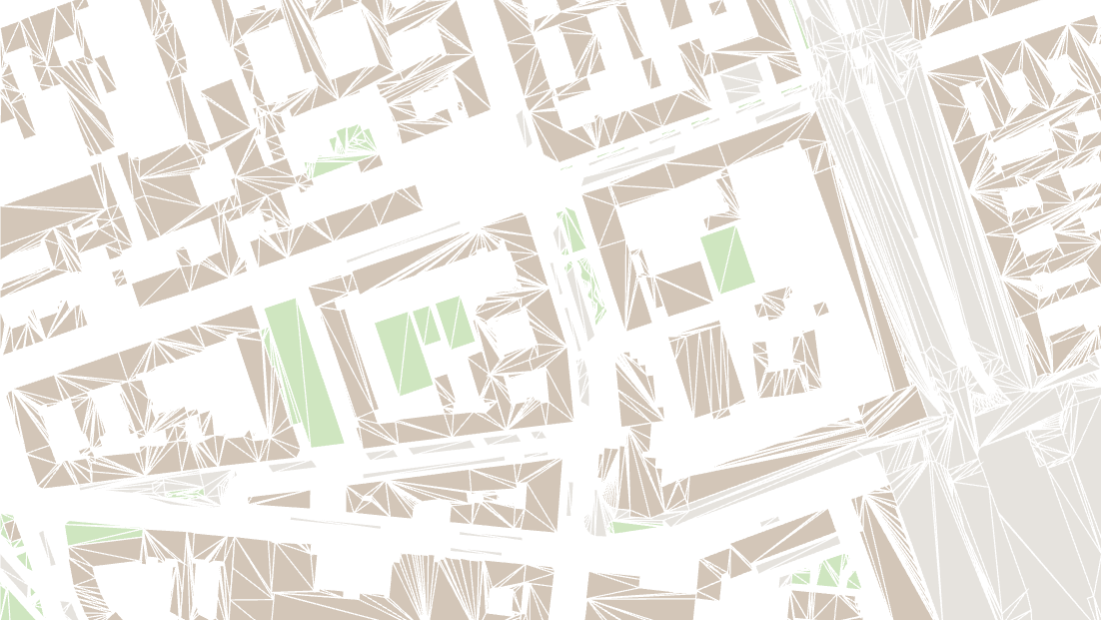
マゾフシェ県(ワルシャワ周辺)のオフラインマップ、ズームレベル 13 には 3,740,425 個のポリゴンがある。M4 Pro の 1 コア上で、我々のエンジンの制約付き Delaunay 三角分割器は、それらをすべて分割するのに 2.93 秒かかっていた。今年 10 月、私はこれを耳切り法に置き換えた。この記事を書くにあたって、耳切り法をアイデアごとに一から組み直し、アイデアごとに 1 コミットを対応させ、同じ 370 万ポリゴンで各コミットの時間を計測した。だから以下の各節の末尾には数字が 1 つずつ載っている。
Delaunay
点集合の三角分割は、任意の三角形の 3 頂点が定める円の内側に点が 1 つも入らないとき、Delaunay 三角分割である。辺を共有する 2 つの三角形を見るだけで、この規則がどう働くかがわかる。
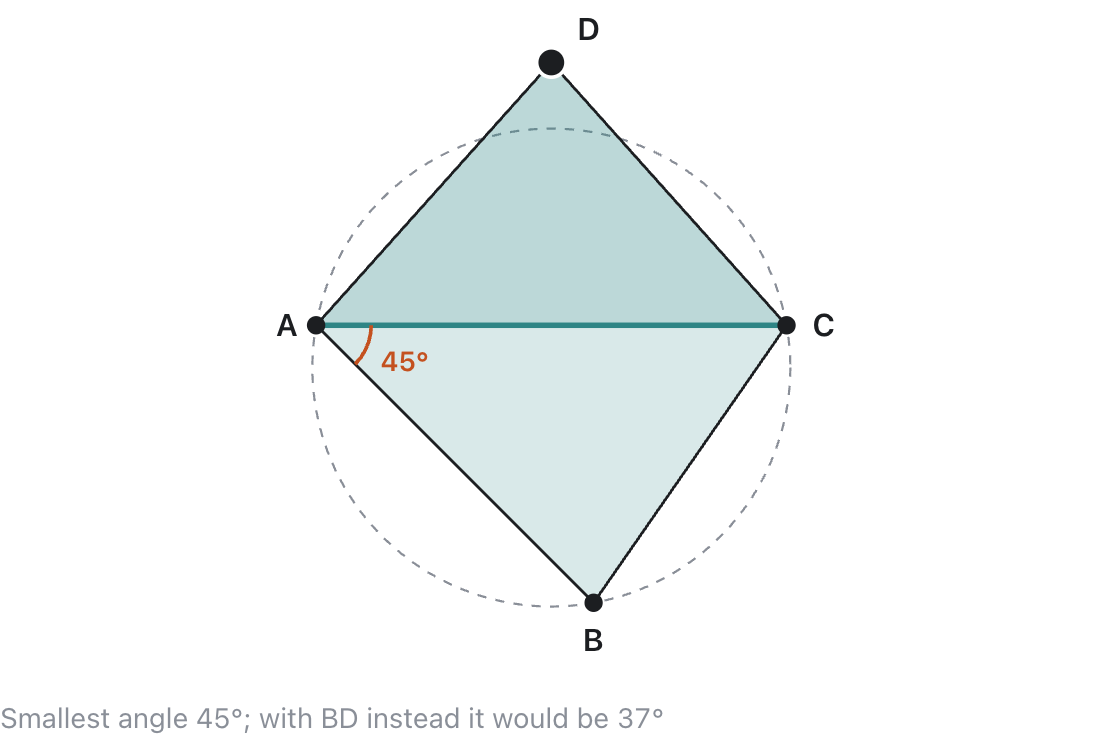
D が A、B、C を通る破線の円の外にあるとき、共有辺は AC になる。D を円の内側へ押し込むと辺は BD に反転し、引き戻すとまた元に戻る。反転のたびに局所的な修正が起きる。どの辺も反転したがらない三角分割こそが Delaunay 三角分割だ。同じ点集合を三角分割するあらゆる方法の中で、最小角が最大になる。オレンジの弧は 2 つの三角形の最小角を示し、図の下の文はもう一方の対角線を選んだ場合の結果を述べている。D をどこに置いても、円規則が選ぶ辺のほうが優れている。
「制約付き」とは、多角形自身の辺を三角分割の中に残さなければならないという意味だ。円規則が反転させたがっても、それは許されない。この三角分割器は頂点を 1 つずつ挿入する。新しい点ごとに、まず構築済みの三角形の間をたどってその点が入る三角形を見つけ、それを分割し、新点の周りで辺を反転させて円規則が再び成り立つまで続ける。さらに多角形の辺を強制的に組み込み、最後に多角形の内部かつ穴の外側にある三角形だけを残す。
三角形をまたいで補間したり、その上でシミュレーションを走らせたりするなら、形のよい三角形は重要だ。単色塗りつぶしには関係ない。GPU は針のように細い三角形も太った三角形も同じ精度で塗りつぶす。ところが作業量の大半は、ほとんど分割を必要としない多角形に費やされる。マゾフシェの多角形のうち 180 万個、ほぼ半数は頂点が 4 つ以下だ。三角形に切る必要すらない。凸四角形は三角形 2 つでしかない。それなのに Delaunay のコードはこうした多角形に 419 ms を費やし、1 つ 1 つ三角分割をゼロから構築している。
耳
多角形の耳とは、直線の一太刀で切り落とせる角のことだ。連続する 3 頂点 a、b、c を取る。b の角が凸で、多角形の残りの部分が三角形 abc に食い込んでいなければ、その三角形は耳だ。切り落とせば、頂点が 1 つ減った多角形が残る。1975 年、Gary Meisters は、頂点数が 3 より大きい単純多角形には互いに重ならない耳が少なくとも 2 つあることを証明した。だから次に切る耳は必ずあり、n 頂点の多角形は最終的に n − 2 個の三角形に分解される。
これは上の街区から選んだ建物のひとつだ。
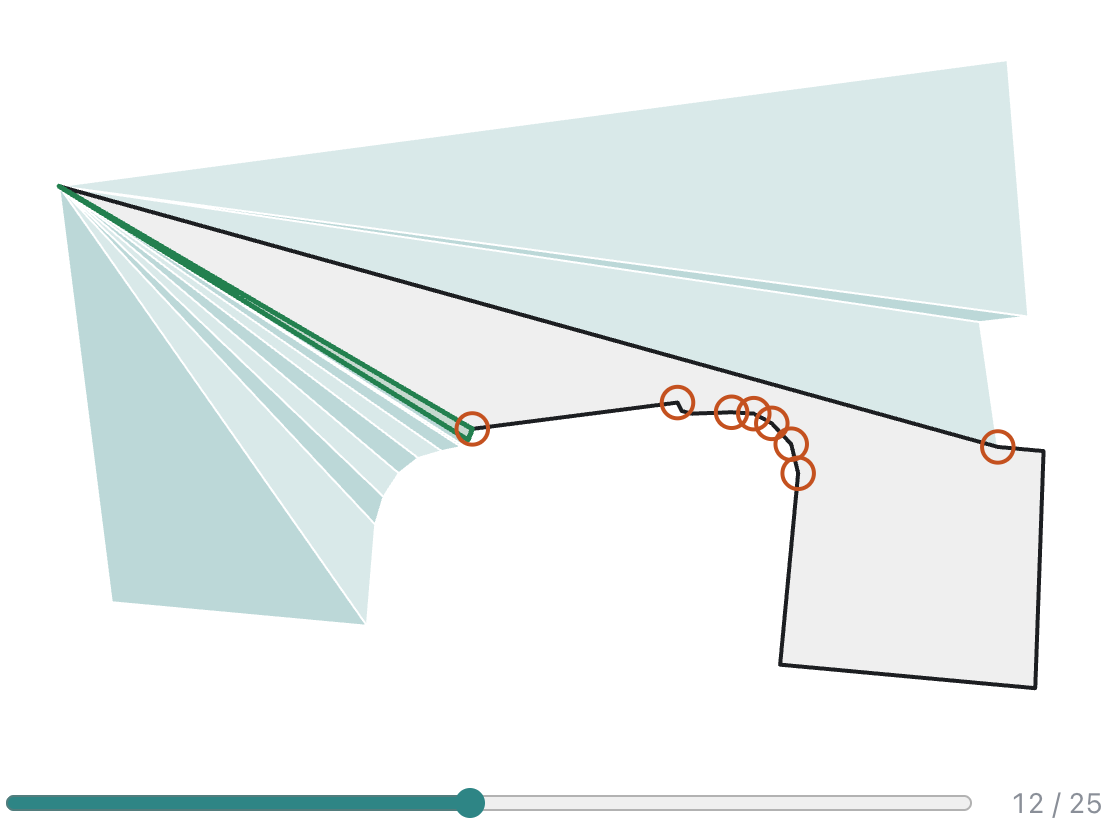
次に切り落とされる耳が緑の三角形だ。アルゴリズムが答える問いはひとつだけ、「この角は耳か?」である。最も単純な版では、その角を調べ、続いて境界上の他のすべての頂点を調べる。cross はどの幾何コードベースにも見られる 2×2 行列式で、c が a から b への直線の左側にあるとき正になる。だから反時計回りの境界では、cross(a, b, c) が正ならその角は凸だ:
static double cross(double ax, double ay, double bx,
                    double by, double cx, double cy)
{
    return (bx - ax) * (cy - ay) - (by - ay) * (cx - ax);
}

bool isEar(uint32_t v) const
{
    const Node &b = _nodes[v];
    const Node &a = _nodes[b.prev], &c = _nodes[b.next];
    if (cross(a, b, c) <= 0)
        return false; // turns the wrong way, or not at all
    for (uint32_t w = c.next; w != b.prev;
         w = _nodes[w].next) {
        const Node &p = _nodes[w];
        if (cross(a.x, a.y, b.x, b.y, p.x, p.y) < 0 ||
            cross(b.x, b.y, c.x, c.y, p.x, p.y) < 0 ||
            cross(c.x, c.y, a.x, a.y, p.x, p.y) < 0)
            continue; // outside the triangle
        if (!samePos(p, a) && !samePos(p, b) &&
            !samePos(p, c))
            return false;
    }
    return true;
}
三角形の辺上に乗る点は内部として扱う。耳が境界の残りの部分に触れていると、切り落としたときに自己接触する多角形が残ってしまうからだ。例外は a、b、c のいずれかと同じ位置にある点だけで、これは輪郭がひとつの頂点で自分自身に接している場合に起こる。穴があるとよくある。
穴
耳切り法は閉じた境界をひとつしか扱わないが、マゾフシェの多角形には 11,345 個の穴がある。中庭や林間の空き地のようなものだ。対処法は各穴を切り開き、橋で外環に縫い付ける。橋とは穴の頂点から境界の頂点へ引く辺で、行きと帰りに一度ずつ通る。これで境界は外側を一周し、橋を渡り、穴を逆回りに一周して戻ってくる。橋の 2 つの複製の間には面積がないので、多角形そのものは変わらず、単一の環になっただけだ。
橋は何とも交差してはいけない。David Eberly の耳切り法の記事に、橋を見つける巧みな方法がある。穴の最も右にある頂点 m を取り、右へレイを飛ばす。レイが最初に当たる辺を I とすると、その辺にはさらに右にある端点 P がある。三角形 m、I、P の内部に境界の頂点がなければ、橋 m–P は安全だ。
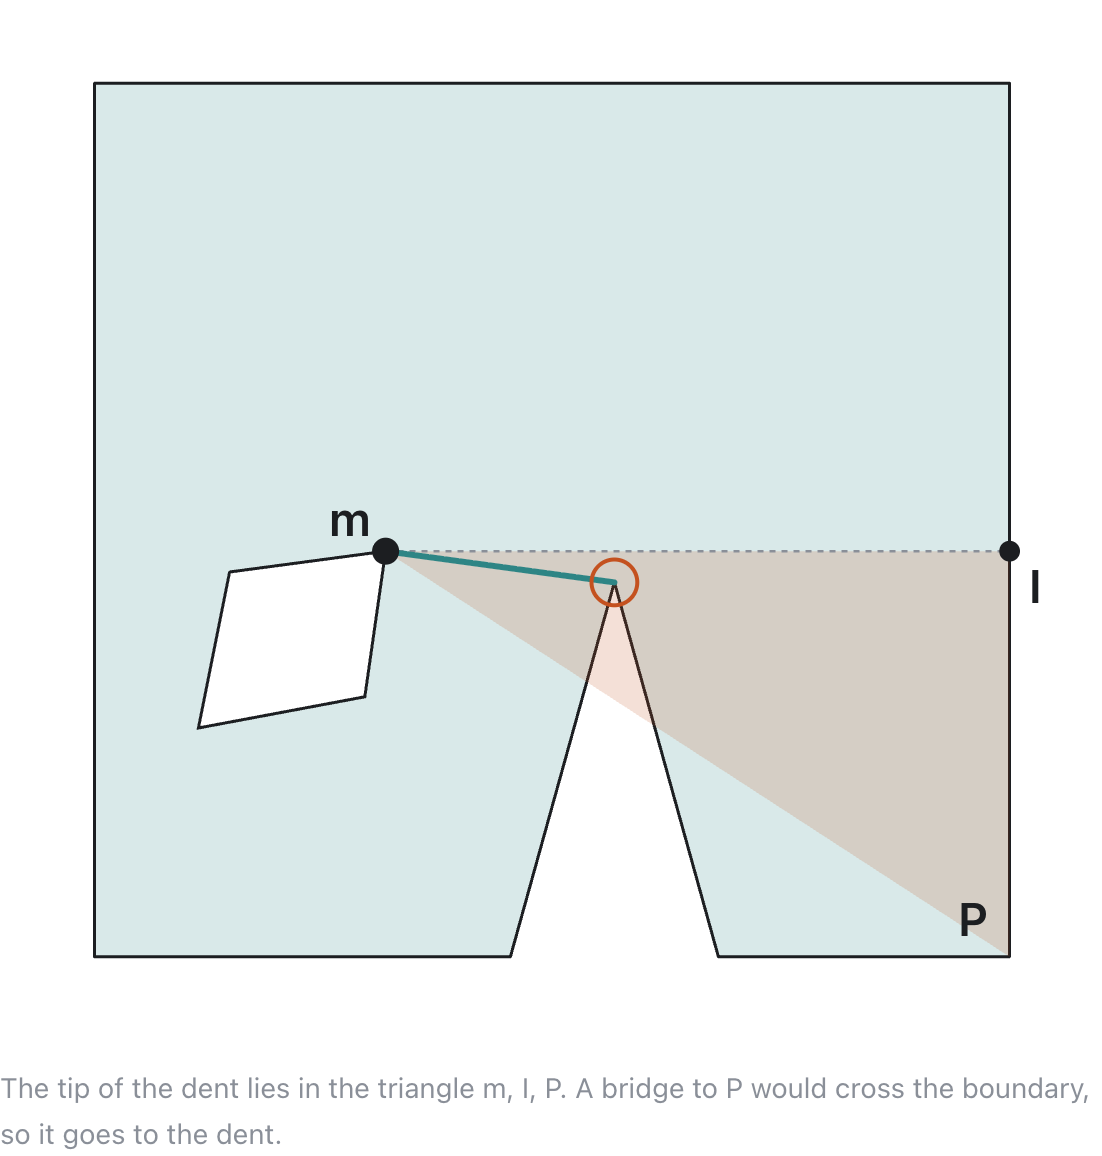
三角形の上側は空で、橋渡しは P につながる。下側では、切り欠きの先端が三角形の内側に入り、橋渡しの接続先がその切り欠きに変わる。三角形の内側に切り欠きが複数ある場合、Eberly は角度上もっともレイに近いものを選ぶ。穴の橋渡しはもっとも右側から始まるため、より左にある穴はすでに境界へ取り込まれた穴へ橋渡しできる。
地図データには、それ特有の状況がさらに二つある。座標はタイルグリッド上の整数で、グリッド線に沿って進むレイは頂点をちょうど通過し続ける。交点テストはそうした頂点をそのまま飛び越えてしまい、最初のバージョンはまさにこの点で誤った。もう一つ、地図の作成者は外周の一点だけで接する中庭をよく描く。こうした穴に橋渡しは要らない。二つの環は共有する頂点ですでにつながっている。
素朴なクリッパー(−1,812 ms)
穴の橋渡しが済むと、最初の完全版は境界を一周し、各角を上の isEar テストで判定して、耳が見つかるたびに切り落とし、各三角形を三つのインデックスとして書き出した。マゾフシェのポリゴンで 1.12 秒、Delaunay より 2.6 倍速い。次の図はポリゴンの大きさごとに一回あたりの時間を分解したものだ。
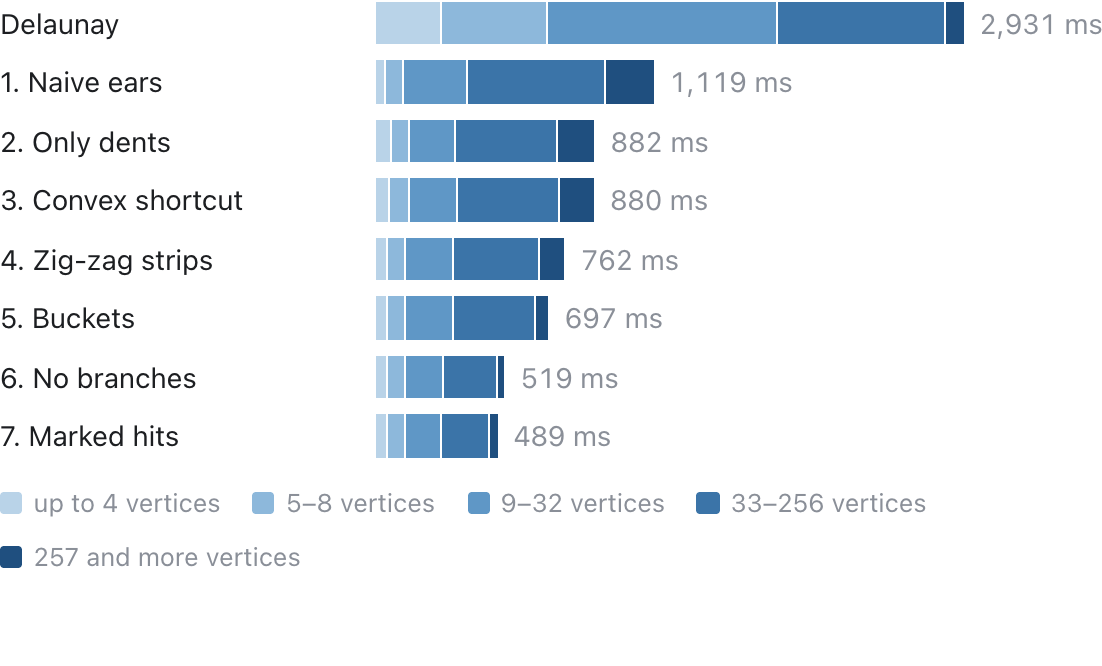
素朴な行は、最後のサイズ帯を除くすべてのサイズ帯で Delaunay より短い。最大の 1,123 個のポリゴンは 257 個以上の頂点を持ち、クリッピングに 199 ms かかるのに対し、Delaunay なら 90 ms だ。ここでは耳テストのたびに数百個の頂点を走査する必要があり、1 つのポリゴンには数百回のテストが必要になる。つまりコストは規模の二乗で増える。本稿の残りは、耳テストを安くし、かつ使う回数自体を減らす方法についてだ。
凹点だけをテストする(−237 ms)
まず、どの頂点が本当に凸角を耳にできないようにするのかを見てみよう。その三角形の中に入り込んでいる頂点があるとして、角そのものに最も近いものを取る。その頂点の 2 本の辺は三角形の辺を横切れないので、どちらの辺も角から遠ざかる向きに伸び、ポリゴンは角の側からその頂点を回り込む。これがその頂点を凹頂点、すなわち凹点にする。したがって三角形の中に何かがあるなら、その中には必ず凹点があり、テストは凹点だけを調べればよい。
エンジンは凹点のリストを保持している。ある凹点の隣を切り取ってその点が凸になったら、リストから外れる。凸角が凹点になることはないので、このリストは短くなる一方だ。テストはこうなる:
bool isEar(uint32_t v) const
{
    const Node &b = _nodes[v];
    if (b.reflex)
        return false;
    const Node &a = _nodes[b.prev], &c = _nodes[b.next];
    for (uint32_t i = 0; i < _live; ++i) {
        const Item &p = _items[i]; // a dent
        if (p.node == b.prev || p.node == b.next)
            continue;
        if (cross(a.x, a.y, b.x, b.y, p.x, p.y) < 0 ||
            cross(b.x, b.y, c.x, c.y, p.x, p.y) < 0 ||
            cross(c.x, c.y, a.x, a.y, p.x, p.y) < 0)
            continue;
        if ((p.x != a.x || p.y != a.y) &&
            (p.x != b.x || p.y != b.y) &&
            (p.x != c.x || p.y != c.y))
            return false;
    }
    return true;
}
この 2,810 万回の耳テストは、3.53 億個ではなく 1.85 億個の点を調べればよくなり、合計時間は 882 ms に下がった。建物の輪郭には凹点が多いため、期待したほどではない。アーチのある建物では、27 個の頂点のうち 15 個が凹点だ。一方、最小のポリゴンはむしろ遅くなり、34 ms から 54 ms に増えた。三角形や四角形では、角を凹点とそれ以外に分ける手間が、走査を 1 回省く利益を上回る。
凸ポリゴンのテストを飛ばす(−2 ms)
凹点のないポリゴンは凸であり、凸ポリゴンの角はすべて耳なので、テストなしで切り取れる。この判定には注意が要る。「すべての角が左に曲がる」だけでは足りない:
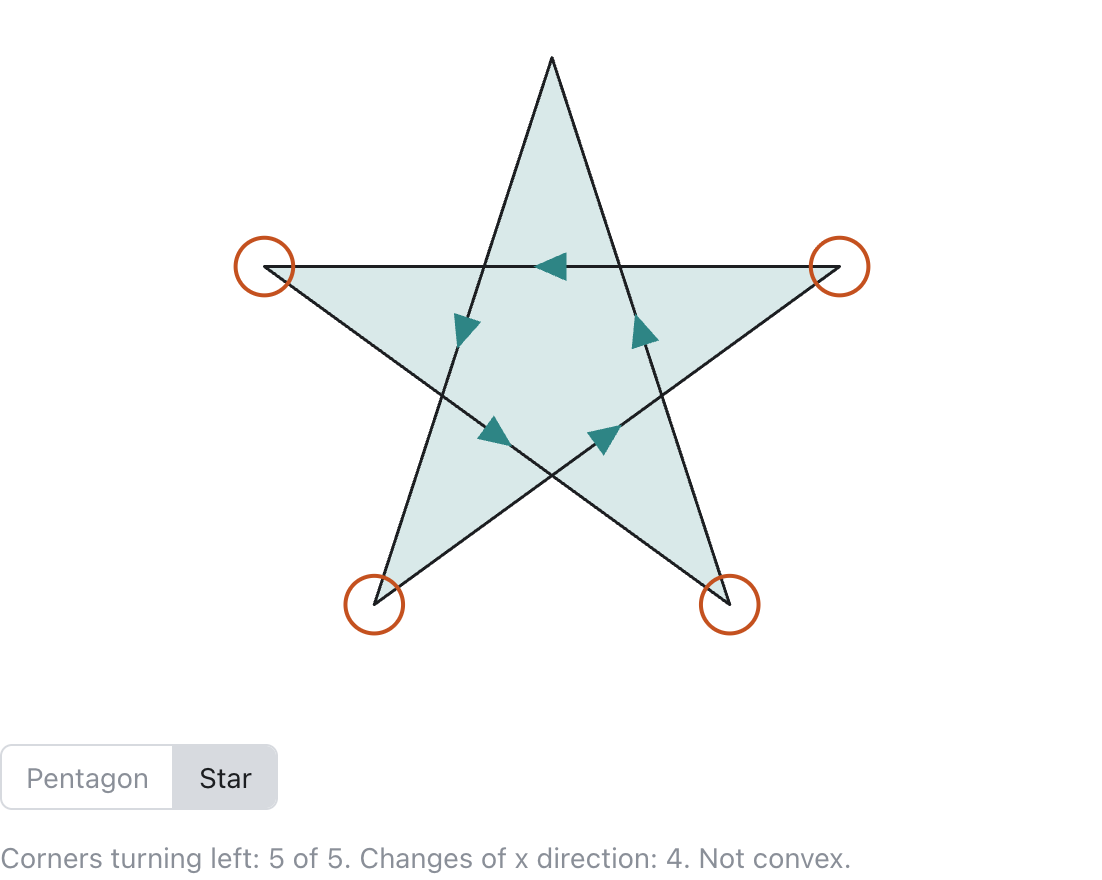
五芒星の 5 つの角はすべて左に曲がる。自身の中心を 2 回まわっているからだ。エンジンはさらに条件を 1 つ加えた。凸環を一周すると、底辺の向きは右、頂辺の向きは左になる。つまり x 方向が変わるのはちょうど 2 回、最も左と最も右の点でだ。五角形は通過する。五芒星は円の付いた角で 4 回向きを変えるので、通常の耳テストに回される。どちらのカウントも凹角を記録する同じループから出ているため、この検査のコストはほぼゼロだ。三角形と四角形はそのループの前に独自の近道を通る。
この近道は 2810 万回の耳テストのうち 440 万回を省くが、省かれるのは最も安いテストだ。凹角のない環には走査するものがほとんどない。これだけでは総時間はほぼ変わらず、880 ms。ただし頂点数が 4 以下の多角形では凹角のコストの一部が戻り、54 ms から 48 ms に短縮された。より重要なのは次の段階で、ここで凸環をストリップに変換する。
ストリップを書く(−118 ms)
現状では三角形 1 つにつきインデックスを 3 つ使う。GPU は triangle strip も描画できる。新しいインデックスを 1 つ加えるたびに、それと直前の 2 つのインデックスで三角形が 1 つ増える。凸環は折り返しながら進むだけで strip として書き出せる。
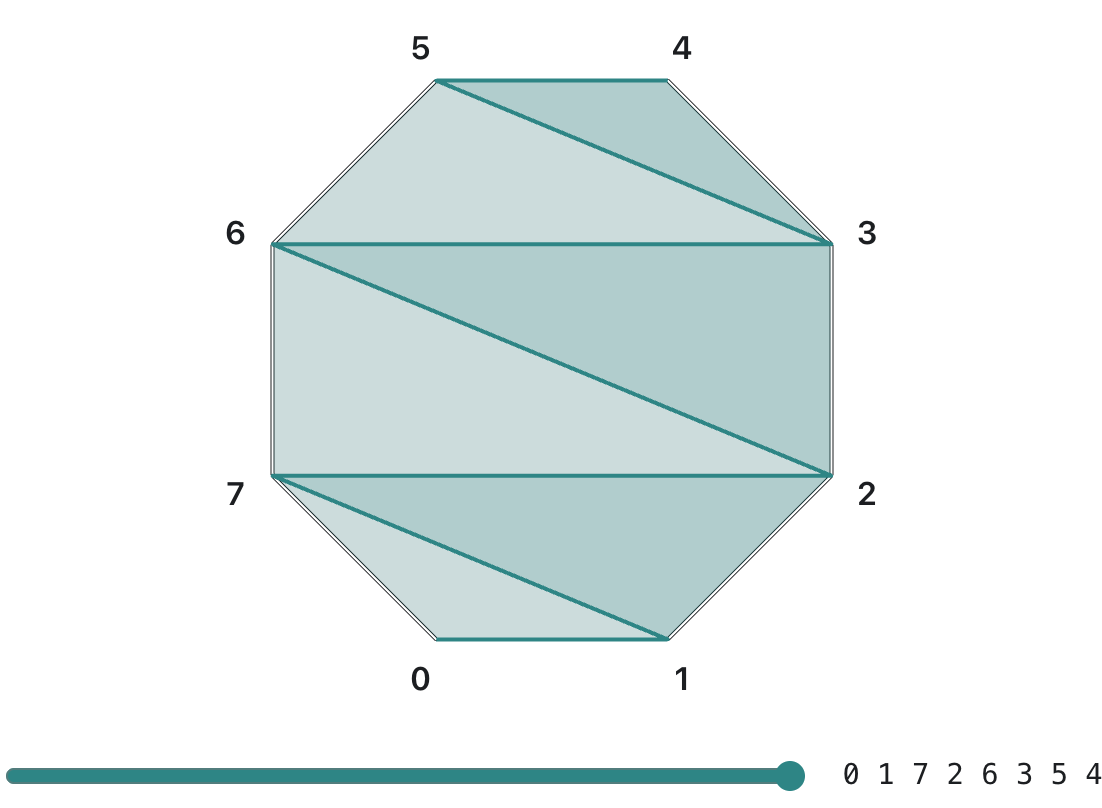
耳切り法でもストリップを生成できる。耳を 1 つ切り落とすと、隣り合う 2 つの角の挟角が鋭くなるので、次の耳の有力候補になる。その片方を切れば、ストリップをさらに 1 インデックス延ばせる。エンジンはまずこの 2 つを試し、両端を交互に行き来しながら耳が尽きるまで続ける。コード上では、切った頂点の隣接頂点が a と b にあたる:
// The next ear alternates between the ends of the cut.
while (true) {
    if (sideA) {
        const uint32_t z = n[a].prev;
        _strips.push_back(n[z].index);
        unlink(a);
        a = z;
    } else {
        const uint32_t z = n[b].next;
        _strips.push_back(n[z].index);
        unlink(b);
        b = z;
    }
    count--;
    sideA = !sideA;
    if (count < 3 || !isEar(sideA ? a : b))
        break;
}
次の角が耳でなければストリップは終わり、走査は止まった位置から再開する。2150 万個の三角形は、6450 万個ではなく 3580 万個のインデックスで書けるようになった。耳の判定回数は減っていない。素朴な走査も元々、切り終えた次の角から続けていたうえ、各ストリップが最後に失敗する判定を 1 回余分に払うため、判定回数は 2370 万から 2500 万に増えた。それでも総時間は 762 ms に下がり、最大のポリゴンは 146 ms から 103 ms になった。
凹点をバケットに分ける(−65 ms)
森や湖は数千頂点、数百の凹点を持ちうるが、耳の判定は毎回それを全部読み直していた。ポリゴンの凹点が 32 個を超えると、エンジンはバウンディングボックスの長い辺に沿って凹点をバケットに振り分ける。1 バケットあたりおよそ 2 個になる。耳の判定は、三角形がまたぐバケットだけを見る。凹点が凸になって消えるとインデックスが古くなるので、半分以上が消えた時点で一度作り直す。
走査する点数は 1.81 億から 1.01 億に減り、そのほとんどは大きなポリゴンによるものだった。257 頂点以上のポリゴンは 103 ms から 57 ms になった。合計 697 ms。
分岐なしのカウント(−178 ms)
凹点判定のループは、三角形の内側に入る凹点が最初に見つかった時点で抜ける。ほとんどの場合、内側には 1 個もない。つまり全凹点を読み切ってから「はい」と答える。この場合、早期脱出には何の利点もなく、点ごとの 3 回の比較は、CPU が予測しなければならない分岐になる。そこでエンジンはまず、三角形内の凹点数を数えるだけの、分岐が一切ない処理を走らせる:
const double abx = b.x - a.x, aby = b.y - a.y;
const double bcx = c.x - b.x, bcy = c.y - b.y;
const double cax = a.x - c.x, cay = a.y - c.y;
uint32_t hits = 0;
for (uint32_t i = begin; i < end; ++i) {
    const Item &p = items[i];
    const double side = std::min(
        std::min(abx * (p.y - a.y) - aby * (p.x - a.x),
                 bcx * (p.y - b.y) - bcy * (p.x - b.x)),
        cax * (p.y - c.y) - cay * (p.x - c.x));
    hits += (uint32_t)(side >= 0) & (uint32_t)(p.node != ia)
          & (uint32_t)(p.node != ic);
}
if (hits == 0)
    return true;
3 つの行列式の最小値が非負であることと、その点が閉三角形の内側にあることは同値だ。カウントが 0 でないときにだけ、以前の厳密なループを回して、ちょうど角の上に乗っている凹点を除外する。バケット版もバウンディングボックスの判定で同じことをするが、64 点をまとめて 1 つのビットマスクに読み込む。総時間は 519 ms まで下がり、中規模で最も効果が出た。33〜256 頂点のポリゴンが 327 ms から 216 ms になった。
印を付けた凹点だけを判定する(−30 ms)
カウントが 0 でないとき、厳密なループは全凹点を読み直していた。どの凹点が内側にあったかは最初のパスですでに分かっているのに。バケット版はその情報をビットマスクに保持している。短いリスト(凹点が最大 32 個)でも同じことができる。最初のパスで凹点が当たるたびにカウントではなくビットを立て、厳密な判定はその凹点だけを見る:
    hits |= ((uint32_t)(side >= 0) & (uint32_t)(p.node != ia)
             & (uint32_t)(p.node != ic)) << (i - begin);
}
while (hits) {
    const Item &p = items[begin + lowestBit(hits)];
    hits &= hits - 1;
    // the exact test from before
}
読み込む点数は 1.28 億から 1.2 億に減った。これが最後のステップであり、earstrip の公開版そのもののコードでもある。489 ms で、同じポリゴンでの Delaunay と比べて 6.0 倍速い。
耳が存在しないとき
Meisters の定理が前提にしているのは単純多角形だ。地図データはタイルのグリッドに丸められ、その丸めが単純多角形を壊すことがある。下の図は Warszawa Śródmieście の輪郭(上の街区から 1 km も離れていない駅)を、異なる大きさのグリッドに丸めたものだ。オレンジの円は、隣接する頂点と同じ点に落ちてしまった頂点を示している:
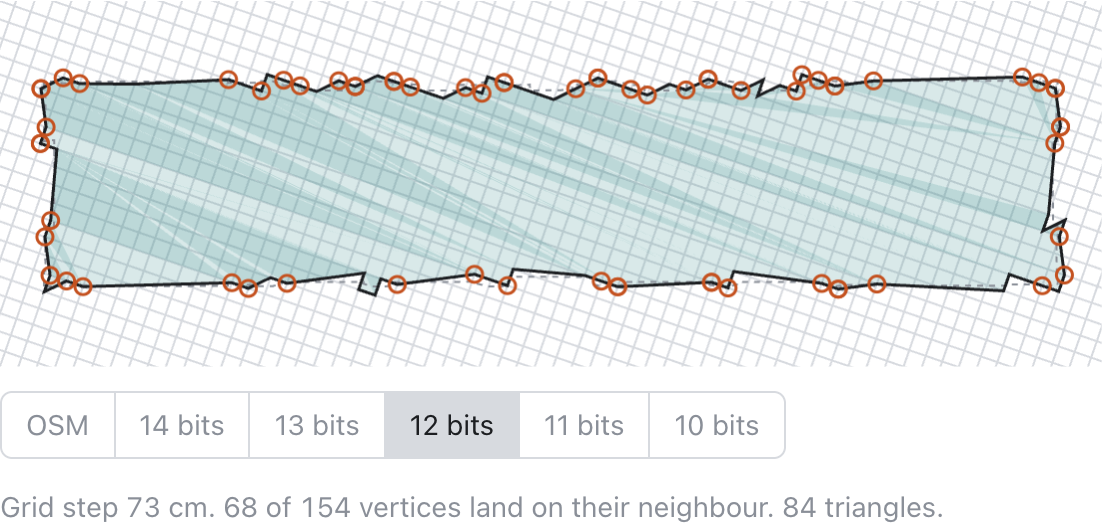
地図ファイルのタイルは 1 辺が 14 ビットのとき、グリッド 1 ステップは 18 センチになる。この精度でも 154 個の頂点のうち 31 個は隣の頂点と統合される。製図者は数センチしか離れていない位置に点を置くことが多く、それでも輪郭は保たれるからだ。12 ビットにすると頂点の半分近くが統合されるが、クリッパーはまだ結果を切り出せる。11 ビットでは、丸めた輪郭がどこかで自己接触し、耳がまったく残らなくなる。10 ビットではなぜかまた通る。
クリッパーが境界を一周しても耳を見つけられないときは、面積を持たない角の点を捨てて、もう一度たどる。それでも失敗すれば諦め、エンジンが Delaunay のコードでその多角形を三角形分割する。このコードはそのために残してある。マゾフシェのデータでは 76 個の多角形がここまで来た。いずれも、反対側の端で最後に変更が入る前に作られた地図に由来する。いまの地図生成器は GEOS の snap rounding で各多角形を最終グリッドに丸め、耳切りで切れるかどうかを検査している。マゾフシェの地図を作り直したところ、この手順で 273 個の多角形が直り、ファイル内のすべての多角形を耳切りで切れるようになった。
Delaunay にはもうひとつ仕事がある。穴ごとに橋渡しが必要で、橋渡しを 1 本見つけるには境界全体を走査する。つまり穴が数千個ある多角形は、数千回の走査という代償を払うことになる。世界地図には 11,675 個の穴を持つ多角形が 1 つあり、耳切りでは 606 ms かかるところを Delaunay なら 17 ms で済む。エンジンは現在、穴が 128 個以上ある多角形をすべて Delaunay に回している。マゾフシェのデータでは該当が 2 つ。
このライブラリは 2 つのフォールバックをどちらも内部に抱えている。耳が尽きたとき、耳の残した三角形が誤った面積を覆ったとき、環の数が 128 を超えたとき、earstrip は環の辺を制約とした Delaunay 三角形分割で多角形を覆う。C++ の run() と JavaScript の lastStatus() を見れば、その多角形がどちらの経路を通ったかがわかる。世界地図タイルの 56,472 個の多角形(最大のものは 11,675 個の穴を持つ)で、earstrip は 459 ms、earcut.hpp は 2,892 ms だった。耳切りで正確に切れないズームレベル 13 の多角形では、earcut の三角形は環の偶奇塗りつぶしと平均 31% のピクセルで食い違う。earstrip は 0.15% だ。
ブラウザ側
新しいクリッパーをアプリに入れる前に、earcut と比べた。MapLibre と Mapbox GL が背後で使っている耳切り法のクリッパーで、使ったのは C++ 版の earcut.hpp 3.2.4 だ。ネイティブ環境では差は小さく、ここで打ち切ってもよかった。だが我々が作っているのは Web レンダラーで、動かすのは同じ C++ エンジンを WebAssembly にコンパイルしたものだ。そこでブラウザ側の比較も続けた。両方のクリッパーを WebAssembly にコンパイルし、さらに earcut.js 3.2.4、つまり現在の Web 地図が使っている JavaScript の原版も加えた。そのためにクリッパーをエンジンから切り離し、earstrip とした。テストセットの全 580 万個の多角形で、earstrip が書き出したストリップはエンジンと完全に一致した。リポジトリにはこれらの多角形と、この節の各数値の根拠となるコードが入っている。ネイティブのベンチマークは上の図と同じもので、下表のネイティブ行は earcut.hpp に対して最後に測った結果だ。WebAssembly ビルドはすべて、ズームレベル 13 と 9 の全 440 万個の多角形で、対応するネイティブ版とまったく同じ三角形を生成した。下表はズームレベル 13 の 374 万個の多角形をミリ秒で測ったもの。7 回のうち最速、シングルスレッド、Node の V8 と Bun の JavaScriptCore。
| earstrip | earcut | |
|---|---|---|
| ネイティブ C++ | 489 | 557 |
| WebAssembly、ループはモジュール内、V8 / JSC | 601 / 566 | 930 / 843 |
| WebAssembly、多角形ごとに JS から 1 回呼び出し、V8 / JSC | 688 / 688 | 1,007 / 950 |
| npm パッケージ、多角形ごとに 1 回呼び出し、V8 / JSC | 766 / 807 | 1,103 / 1,290 |
| npm パッケージ、直接呼び出し、全多角形を 1 回で、V8 / JSC | 635 / 619 |
ネイティブ環境では earcut.hpp は earstrip より 14% 遅い。WebAssembly にコンパイルして V8 で動かすと、earstrip は 23% 遅くなり、earcut.hpp は 67% 遅くなる。そのほとんどが耳を探すメインループで費やされる。アロケータの問題ではない。mimalloc と emmalloc でビルドしても時間は変わらなかった。それ以上は追っていない。V8 では、WebAssembly 版の earcut.hpp は結局 earcut.js より 19% 速いだけであり、多角形ごとに JavaScript から個別に呼び出すと 10% しか速くない。
npm パッケージの行こそが、Web ページが実際に受け取る結果だ。earcut の列は earcut.js を指す。earcut の代わりに呼び出す関数は JavaScript の数値として座標を受け取り、毎回新しい三角形インデックスの配列を返す。V8 では earcut.js より 1.4 倍、JavaScriptCore では 1.6 倍速い。モジュール内のループで失っている時間のおよそ半分は座標のコピーとストリップからリストへの変換に、残りはポリゴンごとに 1 回の WebAssembly 呼び出しに費やされている。直接呼び出せばこれらはすべて不要になる。ポリゴンはそのままモジュールのメモリに書き込まれ、WebGL 2 や WebGPU で使えるストリップのインデックスバッファが返る。earcut.js より 1.7 倍、2.1 倍速い。
上の考え方の一部は earcut も使っている。earcut も「耳を妨げられるのは凹みだけ」という点に依拠しているが、この検査は最後に回し、バウンディングボックスと三角形のテストを通った頂点すべてについて調べる。凹みのリストは持たない。頂点が 80 個を超えると、頂点を z-order で並べ、三角形のバウンディングボックスが覆う曲線の区間だけを走査する。これがバケットの役割を果たす。earcut にないのは、凸ポリゴンの近道、ストリップ、分岐のないカウントだ。三角形ごとにインデックスを 3 つ書き、内側に入る点が最初に見つかった時点で止める。
earstrip は GitHub と npm で公開している。本記事で使ったポリゴンと、手元のマシンで earcut と計時を比較するコードも同梱している。