ガベージコレクションが要らない言語にガベージコレクタを書いた
Rust はガベージコレクションを不要にするために生まれた言語だが、Clayton Ramsey はそれでも循環参照を回収する並行ガベージコレクタを書いた。Drop、ビジター trait、収集タグで実装し、見つけられる限りの Rust コレクタとベンチマークで比べている。
日本語
コピー
言語はどんどん Rust に似てきている。いわゆる「蟹化」だ。では Rust がどんどん Java に似てきたら、何と呼べばいい?コーヒー化?
この夏、私はたっぷり時間を持て余していた。猛暑のさなか、部屋にこもって、メモリ安全をうたう言語が吐き出す core dump を眺めるほど気楽な暇つぶしがあるだろうか。私はガベージコレクタを書いた。簡単に言えば、別のもっと面白いソフトウェアのためにメモリ割り当てを管理するソフトウェアだ。面白いのは、それを Rust で書き、しかも Rust のために書いたことだ。この言語はガベージコレクションの撲滅を設計目標に掲げていて、ガベージコレクタがまともに動くための仕組みをほとんど用意していない。それだけでなく、かなりの妥協をしつつも、このガベージコレクタをきちんと動くところまで持っていった。詳細は後述する。
長文を読むのが嫌い、実装の過程には興味がない、あるいは最終成果の宣伝だけ欲しいという人は、GitHub のソースを直接見てほしい。crates.ioからも直接ダウンロードできる。
背景
Rust とその標準ライブラリの細部に詳しいなら、この節は飛ばしてよい。
Rust のメモリモデルの核となる基礎はアフィン型と借用チェッカだ。ある値は同時に一つの識別子にしか束縛できず、借用(つまり参照)は、その指し示す対象を束縛しているスコープより長生きできない。
たとえば、次のコードは不正だ:
let x = vec![1, 2, 3];
let y = x;
println!("{x:?}"); // compile error - x has already been moved
たいていは、ある束縛に対して借用を行うことで回避する。上の例なら y = &x と書き換える。だが、ヒープに割り当てたある値を共有したいのに、どの束縛が最も長生きするか分からない、という場面はよくある。この問題の解法が、ガベージコレクションによる共有所有権だ。
Rust の標準ライブラリは単純な参照カウント方式のガベージコレクタを二つ提供している。シングルスレッド向けのRcと、そのアトミックカウント版のArcだ。どちらもヒープ割り当てごとに参照カウントを保持する。ほとんどの場合これで十分だが、循環参照は扱えない。内部可変性と組み合わせれば、反例を挙げるのはたやすい。
use std::{cell::OnceCell, rc::Rc};
struct Foo(OnceCell<Rc<Foo>>);

let x = Rc::new(Foo(OnceCell::new()));
x.0.set(Rc::clone(&x));
// My foo has a reference to itself. It can never be freed!
ガベージコレクタを書いて金を稼ぐ人がいるのも無理はない。参照カウントで足りるなら、Oracle の人たちはとうに職を失っているはずだ。
作戦
作りたいのは Gc というデータ構造で、API は Rc や Arc に近く、ほとんどどんなデータ型でも格納でき、しかも循環参照を検出して回収できるものだ。
手元にある武器は次のとおり:
-
Drop:Rust ではコピーできないデータ型はすべてDropトレイトを実装でき、drop されるときにコードを実行させられる。今回の用途では、GcにDropを実装し、それによってある割り当てがいつ到達不能になったかを推測できる。 -
トレイト:トレイトを一つ定義し(ここでは
Collectableと呼ぶ)、Gcに入れるための必須条件にできる。明らかな代償はある(dumpsterの上流のライブラリはこれを実装できない)が、必要な悪だ。
とはいえ、道具が強くても相手は手強い:
-
ムーブは検出できない。Rust で値がムーブされても、値の内部からそれを察知する手段はない。
OnMoveのようなトレイトがあり、ムーブのたびに関数を呼べたなら、Gcが別のGcにムーブされて根を失った時点を検出でき、簡単なマーク・アンド・スイープの回収器が書けるだろう。だがその道を進むのは、C++のコピーコンストラクタを再発明するだけのことだ。 -
可変長データ。私はつい出来心で、
Gcに?Sized型を格納できるようにしてしまった。ライブラリの利用者にとっては柔軟性が増す(Gc<[T]>のようなものをサポートできる)。 -
型消去。典型的な Rust プログラムでは、ジェネリクスは単相化で実現され、実行時には型情報が一切残らない。文脈がなければ、割り当ての後始末はさらに難しくなる。
この二つの比較的単純な道具があれば、ほとんどどんな内部データ型でも扱える回収器を作るには十分だ。
私のやり方
ある Gc が到達可能かどうかを判定したいが、スタックを実際に走査することはできない。まずいくつか定義を置く。グラフ理論の言葉で書く。
-
割り当てグラフ は有向グラフで、入次数がゼロの根ノード を一つ含む。
-
割り当てグラフのノード は、 から への経路がグラフに存在するとき、かつそのときに限り到達可能と呼ばれる。
これらの定義がなぜ役に立つかは、すぐに分かるはずだ。各ノードを一回の割り当てと考え、Gc を介して間接的に参照されていないデータはすべて、根ノードの架空の割り当てに属するとみなす。さらに、各 Gc は二つの割り当てを結ぶ辺の役割を果たす。ある割り当てがグラフ理論の意味で到達可能なら、プログラムがまだそこにアクセスする可能性がある。そうでなければ、その割り当てを解放するのは安全だ。ノードの入次数は、対応する割り当ての参照カウントにちょうど等しいことに注意してほしい。
以下が、あるノード が到達可能かを判定する方法の概略だ。
-
、すなわち のすべての子孫からなる集合を求める。 の部分グラフ を作る。頂点集合は とし、 内のノードを結ぶ辺はすべて残す。
-
ノード集合 を求める。各 は、 における入次数が における入次数と等しくないものとする。
-
各 について、それ自身とその子孫を到達可能としてマークする。
-
は、到達可能としてマークされているとき、かつそのときに限り到達可能である。
擬似コードのほうがよければ、回りくどい実装を置いておく。
def is_accessible(n):
    counts = {n: n.indegree()}
    for (_, m) in n.edges():
        dfs(m, counts)

    reachable = set()
    for (a, count) in counts:
        if count != 0:
            mark(a, reachable)

    return n in reachable


def dfs(n, counts):
    if n not in counts.keys():
        counts[n] = n.indegree()
        for (_, m) in n.edges():
            dfs(m, counts)

    counts[n] -= 1


def mark(a, reachable):
    if a not in reachable:
        reachable.add(a)
        for (_, b) in a.edges():
            mark(b, reachable)
is_accessible の実行時間が であることはすぐに分かる。
ひと手間多い参照カウント
シングルスレッド版の Gc は、細部にいくつか変更を加えた以外は、おおむね Rc と同じ振る舞いをする。
まず、Gc と、それが指すアロケーション GcBox を定義する。
pub struct Gc<T: ?Sized> {
    ptr: NonNull<GcBox<T>>
}

#[repr(C)]
struct GcBox<T: ?Sized> {
    ref_count: Cell<usize>,
    value: T
}次に、Gc の Drop の挙動にフックして、仕組み全体を動かす。
impl<T: ?Sized> Drop for Gc<T> {
    fn drop(&mut self) {
        let box_ref = unsafe { self.ptr.as_ref() };
        match box_ref.ref_count.get() {
            0 => (),
            n => {
                box_ref.ref_count.set(n - 1);
                if n == 1 || !is_accessible(box_ref) {
                    box_ref.ref_count.set(0);
                    unsafe {
                        drop_in_place(addr_of_mut!(ptr.as_mut().value));
                        dealloc(ptr.as_ptr().cast(), Layout::for_value(ptr.as_ref()));
                    }
                }
            }
        }
    }
}
自分では賢いと思ったので、アロケーションが破棄されるときに参照カウントを番兵値 0 に設定することにした(二重解放を誤って引き起こさないように)。
しかし、このコードには問題がある。is_accessible は一体どうやって実装すればいいのか。
trait の小技
is_accessible の擬似コードは、あるノードから出る辺の集合にアクセスできることを前提にしている。これがなかなか厄介だ。C で書くなら、ヒープ上のアロケーションを走査して、他のアロケーションを指していそうなポインタを探すことになる。だが Rust なら、ガベージコレクト対象の型それぞれに小さな制約を課すことで、もっと正確にできる。
ガベージコレクタだけでは足りず、Java の visitor パターンまで持ち込んだ。ガベージコレクト対象の値はすべて Collectable trait を実装し、その trait が Visitor の一部を自分自身のガベージコレクト対象フィールドへ転送する。
pub struct Gc<T: Collectable + ?Sized> {
   // same as before ...
}

pub trait Collectable {
    fn accept<V: Visitor>(&self, visitor: &mut V);
}

pub trait Visitor {
    fn visit_gc<T: Collectable + ?Sized>(&mut self, gc: &Gc<T>);
}たとえば配列なら、accept を各要素へ転送すればよい。
impl<T: Collectable> Collectable for [T] {
    fn accept<V: Visitor>(&self, visitor: &mut V) {
        self.iter().for_each(|elem| elem.accept(visitor));
    }
}
これで、あるアロケーションに visitor を適用するだけで、外へ向かう辺を見つけられる。結局 visitor は 2 つ書いた。ひとつは dfs のステップ用、もうひとつは mark のステップ用だ。
Collectable に object safety を持たせたかったが、それには Visitor も object safe である必要がある。そうなると、どのガベージコレクタも Gc<dyn Collectable> へ強制変換できることになり、それができるのは nightly だけなので、stable の crate としては書けない。
まとめて drop
上の Drop の実装をざっと見れば、is_accessible の呼び出しにかかる時間が、存在する Gc の総数に対して線形だとわかる。このまま書いた drop が線形時間だと思うのも無理はない。だが drop_in_place の呼び出しは、別の Gc を巻き込んで drop することがあり、そうなるとクリーンアップ時間は二乗になる。受け入れられない。特に、最初の is_accessible の呼び出しが実はすべての仕事を終えている。最初のオブジェクトから到達可能なアロケーションがどれかを、すでに判定済みなのだ。解放される元のアロケーションが到達不能なら、それが参照するアロケーションも必ず到達不能である。
マーク段階の時間は、ごく簡単な方法で節約できる。参照グラフをもう一度たどり、破棄予定のアロケーションのポインタと、それが実装する drop を記録しておく。到達不能なアロケーションをすべて見つけ終えてから、まとめて drop する。
残る問題はひとつだけ。drop される値が持つ Gc も、自分が指すオブジェクトの参照カウントを書き換えうる。これは未定義動作を招くし、もっと悪ければコードを遅くする。幸い、計算機科学の問題はすべて状態を足すか間接参照を一段挟むかで解決できる。今回は状態を足すほうを選んだ。COLLECTING という thread-local の値を作る。
まとめて drop するときは、COLLECTING を true に設定する。以降、Gc に対して drop を呼ぶと、COLLECTING の状態を確認する。COLLECTING が true なら、Gc は drop されるときに何もしない(参照カウントにも触らない)。まだ到達可能なアロケーションへ向かう出辺を処理するために、最終クリーンアップの前にもう一度走査を足し、これらの出辺だけを扱う。
現在のコードがどんな形か、ざっと見てみよう。
thread_local! {
    static COLLECTING: Cell<bool> = Cell::new(false);
}

impl<T: Collectable + ?Sized> Drop for Gc<T> {
    fn drop(&mut self) {
        if COLLECTING.with(Cell::get) { return; }
        let box_ref = unsafe { self.ptr.as_ref() };
        match box_ref.ref_count.get() {
            0 => (),
            1 => {
                box_ref.ref_count.set(0);
                unsafe {
                    drop_in_place(addr_of_mut!(ptr.as_mut().value));
                    dealloc(ptr.as_ptr().cast(), Layout::for_value(ptr.as_ref()));
                }
            }
            n => {
                box_ref.ref_count.set(n - 1);
                unsafe { collect(self.ptr) };
            }
        }
    }
}
collect がこれから書く関数で、アロケーションが到達可能かを調べ、必要ならまとめてクリーンアップを実行する。ただ、collect を実装する前に問題がひとつある。擬似コードは、各アロケーションをキーとして counts に格納でき、かつそのアロケーションの隣接ノードにもアクセスできることを前提にしている。つまり、少しだけ型消去をしないと目的を果たせない。細部は省くが、必要なのは次の 2 つだ。
-
アロケーションへのポインタをキーとしてハッシュテーブルに格納する。
-
型情報を使って、格納したポインタを復元し、操作できるようにする。
Rust の制約により、この 2 つは実際には両立しない。ポインタ内の生データを比較するのは未定義動作になる(provenance の問題)。だからポインタを消去してからハッシュテーブルのキーにはできない。かといって、アロケーションの先頭バイトを指すポインタを直接取ることもできない。アロケーションが ?Sized かもしれないからだ。
そこで私の実装には、消去済みポインタが 2 種類ある。比較用のシンポインタと、任意の型へのポインタを復元するためのファットポインタだ。
struct AllocationId(NonNull<Cell<usize>>); // used as a key in hash-maps
struct ErasedPtr([usize; 2]); // used as a reconstructible pointer to the allocationこうしておけば、アロケーションの型情報を必要とする関数(dfs や mark など)は、関数ポインタとして不透明に保持でき、呼び出し時に型情報を使って渡された ErasedPtr を「再水和」できる。
これを使った dfs の実装例を挙げる。
unsafe fn dfs<T: Collectable + ?Sized>(
    ptr: ErasedPtr,
    counts: &mut HashMap<AllocationId, usize>
) {
    struct DfsVisitor<'a> {
       counts: &'a mut HashMap<AllocationId, usize>,
    }

    impl Visitor for DfsVisitor<'_> {
        fn visit_gc<U>(&mut self, gc: &Gc<U>) {
            let id = AllocationId::new(gc.ptr);

            if counts.insert(id, unsafe { gc.ptr.as_ref().ref_count.get() }) {
                (**gc).accept(self);
            }

            *counts.get_mut(&id).unwrap() -= 1;
        }
    }
    // pretend that `specify` converts the pointer back into NonNull<T>
    let specified = ptr.specify::<T>();
    specified.as_ref().accept(&mut DfsVisitor { counts });
}
collect の実装はここには載せない。長いし、クリーンアップアルゴリズムの最終版ですらない。だが動くことは請け合う。歯を食いしばり頭をかきむしった末に、これでようやくまとめて drop を実装でき、Gc に対する drop() の呼び出しが線形時間の操作になった。
償却
何だって?参照の操作を 時間で終わらせたい?最近のプログラマはどうしてこうも注文が多いのか。
ありがたいことに、ガベージコレクションを平均的に 時間で終わらせるのはそれほど難しくない。collect を直接呼ぶ代わりに、このアロケーション(すでに到達不能かもしれない)を「ダーティ」なアロケーションの集合に放り込む。私のコードではこの集合を dumpster と呼んでいる。その後、 回アロケーションを捨てるたびに dumpster 全体を走査し、 時間ですべて回収する。すべてのアロケーションをならしてみれば、これは技術的には だ。配列ベースのリストを便利にし、2008 年の金融危機も引き起こした、あの会計マジックのおかげである。
手間を省くため、あるアロケーションにアクセスしたとき(デリファレンスやクローンなど)、そのアロケーションをダーティ集合から取り出せる。アクセス可能であることがたった今証明されたからだ。
並行化はできているのか?
ここまで説明してきたガベージコレクタはすべてシングルスレッドで、スレッドローカルなガベージ値しか保持できない。書く価値のあるコードはいずれ並行になるそうなので、もっとうまくやる必要がある。ありがたいことに、一度に 1 つのスレッドだけが回収を行う限り、このアルゴリズムはほとんど手を加えずに並行実行できる。
ただし、回収を行うスレッドが 1 つだけでも、厄介な並行性の問題にぶつかることがある。アロケーションが 2 つ、 と あり、さらに架空の「ルート」アロケーション があるとしよう。 は からのみアクセスでき、 は からのみアクセスできる。
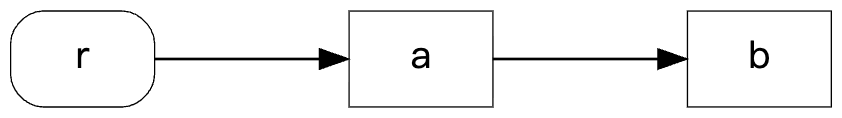
ここで、 から深さ優先探索を実行する場合を考える。まず、 が counts 内で未計上の参照を 1 つ持つことを記録する。続いて、 の子ノードの 1 つである の確認に移る。
しかし、 の参照カウントを記録してから を検査するまでの間に、別の悪意あるスレッドが を書き換え、 から への逆参照を追加した。
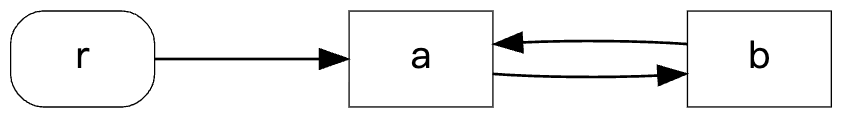
次に、深さ優先探索は に戻り、未計上の参照カウントをデクリメントして、 と を指すすべての被参照が完全に計上済み(つまり到達不能)であると判断する。そこでガベージコレクタは と の割り当てを安心して破棄するが、ヒープを指すぶら下がり参照が残り、use-after-free やその他の厄介なメモリエラーを引き起こすおそれがある。
並行性の問題を解決する
この並行性の問題を解決する最も簡単な方法は、Gc が関わるすべての操作をひとつの大きなロックで包み、どの操作も同じグローバルミューテックスを取得するよう強制することだ。そうすれば並行性のバグは完全に消える。ただし、あまりにも遅い。
できれば、全割り当てのごく一部にだけ相互排他を効かせたい。そこでまず並行性の問題そのものを見直すと、別のスレッドがこちらが部分グラフ を操作している最中にそれを変更したときにだけ、実際に誤った結果になることがわかる。解決策はなかなか巧妙で、各 Gc に特別な番号を付ける。これを収集タグ(collecting tag)と呼ぶ。
まず、COLLECTING_TAG というグローバルなアトミック整数を追加する。
static COLLECTING_TAG: AtomicUsize = AtomicUsize::new(0);新しい Gc を作成またはクローンするたびに、COLLECTING_TAG の現在値でタグ付けする。
// this new `Gc` type is intended to be `Sync`.

pub struct Gc<T: Collectable + Send + Sync + ?Sized> {
    ptr: NonNull<GcBox<T>>,
    tag: AtomicUsize,
}

impl <T: Collectable + Send + Sync + ?Sized> Gc<T> {
    pub fn new(x: T) -> Gc<T> {
        // (other bookkeeping hidden)

        Gc {
            ptr: /* initialization of GcBox<T> */,
            tag: COLLECTING_TAG.load(Ordering::Relaxed),
        }
    }
}次に、収集処理の開始時に、dfs を呼び出す前に COLLECTING_TAG の値をインクリメントする。
fn collect() {
    COLLECTING_TAG.fetch_add(1, Ordering::Relaxed);
    // carry on with DFS and such
}最後に、dfs の処理中に Gc に出会うたびにそのタグを確認する。タグが COLLECTING_TAG の現在値と等しければ、その Gc は dfs の開始後に作成されたものだ。その場合、この Gc を見つけた位置は必ず到達可能なので、到達可能としてマークしてよい。不測の事態で同じ辺を重複して訪れないよう、訪れた辺のタグはすべて COLLECTING_TAG の値に更新しておく。
先ほどの誤った例に戻り、この変更でどう修正されるかを見よう。参照グラフは同じで、 が を指し、 が を指している。どの Gc にもタグが必要なので、すべてタグは 0 だと仮定する。
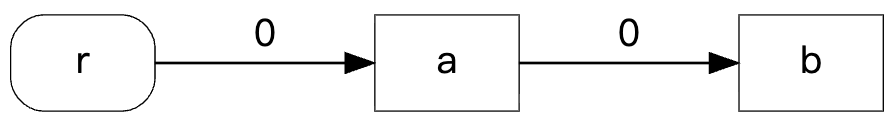
次に、dfs が始まると COLLECTING_TAG が 1 にインクリメントされる。したがって、悪意のあるスレッドが新たに作成する参照は 1 としてマークされなければならない。
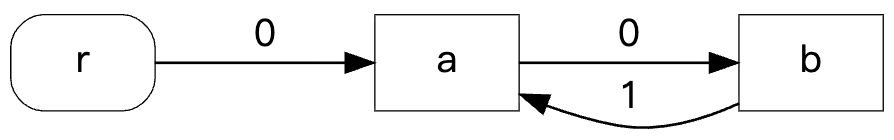
ここで dfs が を経由して を指す辺をたどると、その参照には 1 が付いている。したがって と はどちらも到達可能なままにしておく必要があり、ここで意図しない早期解放は起きない。
ムーブインとムーブアウト
ポインタに印を付けておけば並行性のバグはすべて防げる、そう期待したくなるかもしれない。残念ながら、そうはいかない。理由を説明するために、まず例を一つ見てみよう。
まず、自分自身を指すオプショナル参照を二つ持つ というアロケーションを考える。
struct X {
    x1: Mutex<Option<Gc<X>>>,
    x2: Mutex<Option<Gc<X>>>,
}
例の冒頭では、 の内部で一方の Gc だけが自分自身を指しており、Gc を格納できるもう一方のスロットは空だ。 はルートのアロケーション から直接たどれる。既存の参照はどれも 0 が付いている。わかりやすいように、 のうち最初のスロットを表す矢印は実線で、二つ目のスロットは破線で描いてある。
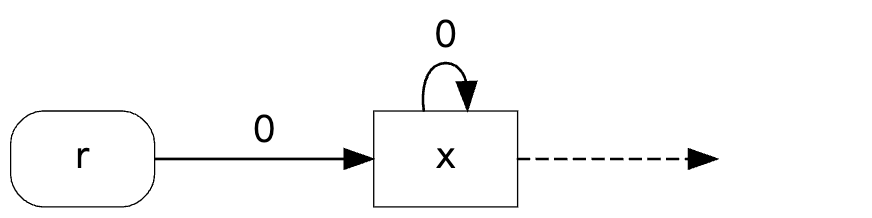
では、 から dfs の実行を始めよう。
-
COLLECTING_TAGを 1 インクリメントする。 -
dfsは、開始時点で に未計上の参照がまだ 2 つあることを記録する。 -
dfsは の最初のスロットにアクセスし、そのスロットに現在存在する self 参照にマークを付ける。この時点で、 に残る未計上の参照は 1 つだ。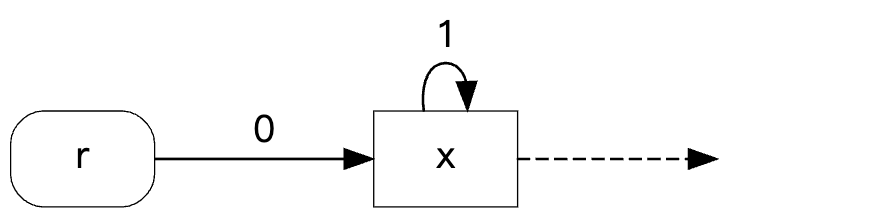
-
悪意あるスレッドが割り込み、まず
Gcを の第 1 スロットから へ移し、次に元々 と を結んでいたGcを の第 2 スロットへ移す。fn do_evil(r_to_x: Gc<X>) { let z = std::mem::take(&mut *r_to_x.x1.lock().unwrap()); *z.x2.lock().unwrap() = r_to_x; }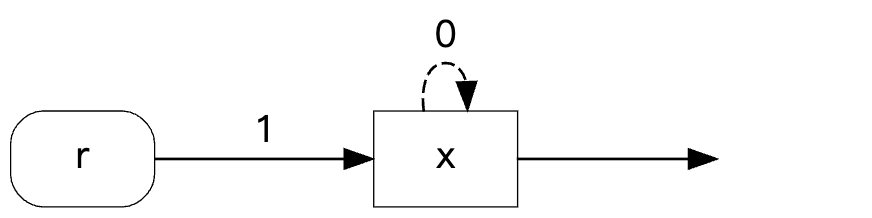
-
dfsは実行を続け、今度は の 2 番目のスロットにアクセスする。そこにも を指す参照があるので、未計上の参照数を 0 に減らす。 -
dfsは、 の祖先の中に未計上の参照を持つオブジェクトを見つけられず、 を解放した。しかし、 にはまだアクセスできる!
この問題にはしばらく悩まされた。ある割り当てを指す Gc を他のスレッドが入れ替え続ければ、こちらの探索をいくらでも欺けてしまうように見えた。だが、手はある。以前、Gc ごとにタグを付ける方法がうまくいったのだから、今度は割り当てごとにタグを付けてみる。
#[repr(C)]
struct GcBox<T: Collectable + Send + Sync + ?Sized> {
    ref_count: AtomicUsize,
    tag: AtomicUsize,
    value: T
}以降、Gc をデリファレンスするたびに、その割り当てのタグを COLLECTING_TAG の現在値へ更新する。
impl<T: Collectable + Send + Sync + ?Sized> std::ops::Deref for GcBox<T> {
    type Target = T;

    fn deref(&self) -> &Self::Target {
        let box_ref: &GcBox<T> = unsafe { self.ptr.as_ref() };
        box_ref.tag.store(COLLECTING_TAG.load(Ordering::Acquire), Ordering::Release);
        &box_ref.value
    }
}
dfs がある割り当てのタグが COLLECTING_TAG に等しいのを観測した時点で、その割り当てはアクセス済み、つまり到達可能だとわかる。上の例で参照を付け替えるには、悪意あるスレッドが Gc をデリファレンスしなければならず、その時点で探索に知られてしまう。早期解放は防げる。
実のところ、これだけで、並行実行の下でも dfs が割り当てを到達不能と誤って判定することは決してない、と証明できる。記事がかなり長くなったので、証明は概略だけ示す。
定理:dfs は割り当てを到達不能と誤って判定しない。
証明:
-
dfsがdfsの開始後に生成されたGcに出会ったなら、その参照先は到達可能だとわかる。 -
(1) より、
dfsがある割り当て を到達不能と判定したなら、そのとき訪問したのは を指すGcだけであり、それらのGcはdfsの開始前から存在していたことになる。 -
(2) を一般化する。
dfsがある割り当て を到達不能と判定したなら、そのとき訪問したのは を指すGcだけであり、それらのGcは の参照カウントを記録した時点で存在していたことになる。 -
Gcがルート割り当て から他の割り当てを指すとき、dfsはそれを訪問しない。 -
ある割り当てを到達不能と判定するには、
dfsは参照カウントを記録した時点でその割り当てを指していたすべてのGcを訪問していなければならない。 -
(4) と (5) より、 が到達不能と判定されたなら、ある時点で を に接続していた
Gcは、必ず別のノード( ではない)を に接続するために移動済みでなければならない。 -
(6) より、 から を指す
Gcに対して借用を行い、その存続区間がdfsの への最初のアクセスと への最後のアクセスとの間に収まるようなライフタイム'xは存在しない。 -
dfsの直前で最後に へムーブされたGcは、そのムーブの時点で、 から を指すGcに対する別の借用が存在していたはずである。その借用のライフタイムを'yとする。 -
'yは最後のムーブより長く続くので、'yはいくらでも延長できる。dfsが を指すすべてのGcを訪問し終えた後まで延長してもよい。 -
(7) より、
'yはdfsが に最初にアクセスする前にはまだ存在していない。したがって、 が誤って到達不能と判定されたなら、 を指すGcがデリファレンスされ、ライフタイム'yの借用が生じていたはずである。 -
dfsが を指すGcに最後にアクセスする前に、 を指すGcがデリファレンスされたなら、dfsは のタグが変わったことを観測する。よって、ある割り当てが誤って到達不能と判定されたなら、その割り当てはかつて到達可能とタグ付けされていたはずである。したがってdfsは割り当てを到達不能と誤って判定したことがない。QED。
かなり粗い証明だが、注意深い読者なら細部は自分で埋められるはずだ。補完側の証明、つまり dfs が割り当てを到達可能と誤って判定することは決してない、という証明は、そうした注意深い読者に任せる。
もう一つ気に入っているのは、この方式の正しさがすべて Rust の借用チェックの意味論に支えられている点だ。おかげで全体がしっくりくる。
決め手は弱参照
並行性に起因するメモリ安全性の問題には、もう一つ源がある。参照カウントが 0 になって解放された割り当てでも、グローバルな dumpster に入れられていたために、別のスレッドからアクセスされうる。他のすべてのスレッドのメモリからその割り当てへの参照を消し終えたことは保証できないので、手詰まりに見える。
計算機科学の問題は、状態を少し足せばたいてい解決する。Rc のアイデアを借りて自由に拡張し、各割り当てに「弱い」参照カウントを付けて、ゴミ箱やクリーンアップスレッドから参照されている回数を数える。元の参照カウントは強いカウントと呼ぶことにする。
#[repr(C)]
struct GcBox<T: Collectable + Send + Sync + ?Sized> {
    strong: AtomicUsize,
    weak: AtomicUsize,
    tag: AtomicUsize,
    value: T,
}
こうすると、ある Gc を指す最後の強い参照を破棄するとき、まずその弱い参照カウントが非ゼロかどうかを調べ、非ゼロのときだけ解放する。そうでなければクリーンアップスレッドに任せる。
割り当てがゴミ箱から取り出され、クリーンアップ処理を実行するスレッドがまさにそれを破棄しようとするとき、そのスレッドはこの割り当ての弱いカウントをデクリメントし、弱いカウントと強いカウントがともに 0 になったかを調べる。どちらも 0 なら、そのスレッドは安全にこの割り当てを破棄できる。
デッドロック!
Gc<Mutex<()>> を作り、その Mutex がロックされた状態で、それを指す Gc を drop する状況を考えてみよう。
let gc1 = Gc::new(Mutex::new(()));
let gc2 = gc1.clone();

let guard = gc1.lock()?;
drop(gc2); // suppose this triggers a cleanup
drop(guard);参照グラフをたどると、dfs のアクセサはこのミューテックスにアクセスし、ロックを取得してから先へ進もうとする。しかし、この割り当てを引き起こしたスレッドはまだミューテックスの guard を保持している。その結果、スレッドは悲惨なデッドロックに陥る。幸いなことに、ミューテックスの guard を保持している割り当ては必ずまだ到達可能であることが分かっている(Mutex の優れた API のおかげだ)。つまり、ミューテックスの取得に失敗した時点で、その割り当てが到達可能であることは即座に証明される。
これを利用して、回収可能な型へのアクセスを失敗しうる操作に変え、ロックの取得失敗がそのままアクセスの失敗になるようにする。
pub trait Collectable {
    fn accept<V: Visitor>(&self, visitor: &mut V) -> Result<(), ()>;
}

pub trait Visitor {
    fn visit_gc<T: Collectable + ?Sized>(&mut self, gc: &Gc<T>) -> Result<(), ()>;
}

impl<T: Collectable + ?Sized> Collectable for Mutex<T> {
    fn accept<V: Visitor>(&self, visitor: &mut V) -> Result<(), ()> {
        // pretend poison errors don't exist
        self.try_lock().map_err(|_| ())?.accept(visitor);
        Ok(())
    }
}
ゴミ箱を共有しよう
(かなり長い)この記事をここまで読むとは。せっかくなので、私が描いた図を眺めていってほしい。
このガベージコレクタを実装するうえで、並行性能の最大のボトルネックのひとつは、Gc を捨てるたびに唯一のグローバルなゴミ箱へアクセスしなければならないことだった。Mutex<HashMap> を使っているなら、これで並列性がほぼ丸ごと消え去り、高い金を出して 16 コアのマシンを買ったのは何のためだったのかと疑いたくなる。
だから、まともな人間なら並行ハッシュテーブルに手を伸ばす。Rust の実装は数多くある。私は chashmap を試し、珍しい panic バグ のせいで諦めた。次に dashmap を試した。動きはするが、スレッド数が増えると遅すぎた。
根本にあるのは、どんなデータ構造でも並行に更新するのは遅いという事実だ。シャードロックを凝らした、いわゆる「並行」データ構造とて同じで、競合のコストは必ず乗る。並行化が遅いなら、いっそ並行にしなければいい。スレッドごとに自分のゴミ箱を持たせ、グローバルに「掃除待ちの割り当て」の集合をひとつ維持する。これをゴミ収集車と呼ぶことにした。ある割り当てがダーティとマークされるたび、何らかのヒューリスティックで現在のスレッドのゴミ箱が満杯かどうかを判定し、満杯ならそのスレッドのゴミ箱にある割り当てをすべてゴミ収集車へ移す。全体の流れの擬似コードは以下のとおり。
dumpster = set() # local to this thread
garbage_truck = mutex(set()) # global to all threads

def mark_dirty(allocation):
    dumpster.add(allocation)
    if is_full(dumpster):
        garbage_truck.lock()
        for trash_bag in dumpster:
            garbage_truck.add(trash_bag)
        garbage_truck.unlock()
        dumpster = set()
is_full が true を返す頻度が十分低ければ、ゴミ収集車で競合はほとんど起きない。並行のコストは大きく下がり、性能面の見返りはかなりのものになる。
で、実際どれくらい速いのか
ひと言でいえば、このガベージコレクタはかなり速い。
最終的に、大きく分けて 2 つの実装を作った。ひとつはスレッドローカルで、並行まわりの面倒をすべて省いたもの。もうひとつはスレッドセーフで、機能はひととおり揃う代わりに性能をいくらか犠牲にする。API は once_cell から借りていて、前者は crate の unsync モジュール、後者は sync にある。
次に、見つけられる限りのガベージコレクタを集めて比較した。選定基準は、API が dumpster に似ていること、crates.io で公開されていること、そして実際に動くこと。
| 名前 | 並行対応? | dumpster に似ている? |
|---|---|---|
dumpster(unsync) | ❌ | ✅ |
dumpster(sync) | ✅ | ✅ |
Rc | ❌ | ✅ |
Arc | ✅ | ✅ |
bacon-rajan-cc | ❌ | ✅ |
cactusref | ❌ | ❌ |
elise | ✅ | ❌ |
gc | ❌ | ✅ |
gcmodule | 対応するが API が異なる | ✅ |
rcgc | ❌ | ❌ |
shredder | ✅ | ✅ |
API が dumpster に似ていないものは除外した。ベンチマークの枠組みを組むのが面倒すぎたためだ。手抜きだと思うなら、自分で測ってみてほしい。Rc と Arc も加えた。循環参照は回収しないが、ガベージコレクタの性能の下限を示すベースラインとしては悪くない。調べていく中で、bacon-rajan-cc は自発的に回収を行わないこともわかったので、公平を期すために dumpster の各ガベージコレクタに自動回収をしない版を用意し、「manual」と付けた。最後に、gcmodule は非常に大きな回収負荷に直面するとスタックオーバーフローを起こし、ときにはセグメンテーション違反にもなるので、ベンチマークから外した。
ベンチマークは思いつく限り最も単純な方法にした。多数の割り当てオブジェクトがループの中でランダムに互いへの参照を追加・削除し、そのあいだ絶えず割り当てを捨てては新しく作る。ランダムなノイズを打ち消すため、各ガベージコレクタで 100 ラウンド、1 ラウンドあたり 100 万回の操作を回した。1 回の操作は参照の追加か削除のどちらかだ。
まず、すべてのガベージコレクタでベンチマークを 1 回走らせ、純粋なシングルスレッド性能を測った。以下のバイオリン図がその結果で、実行時間と出現頻度の関係を表している。
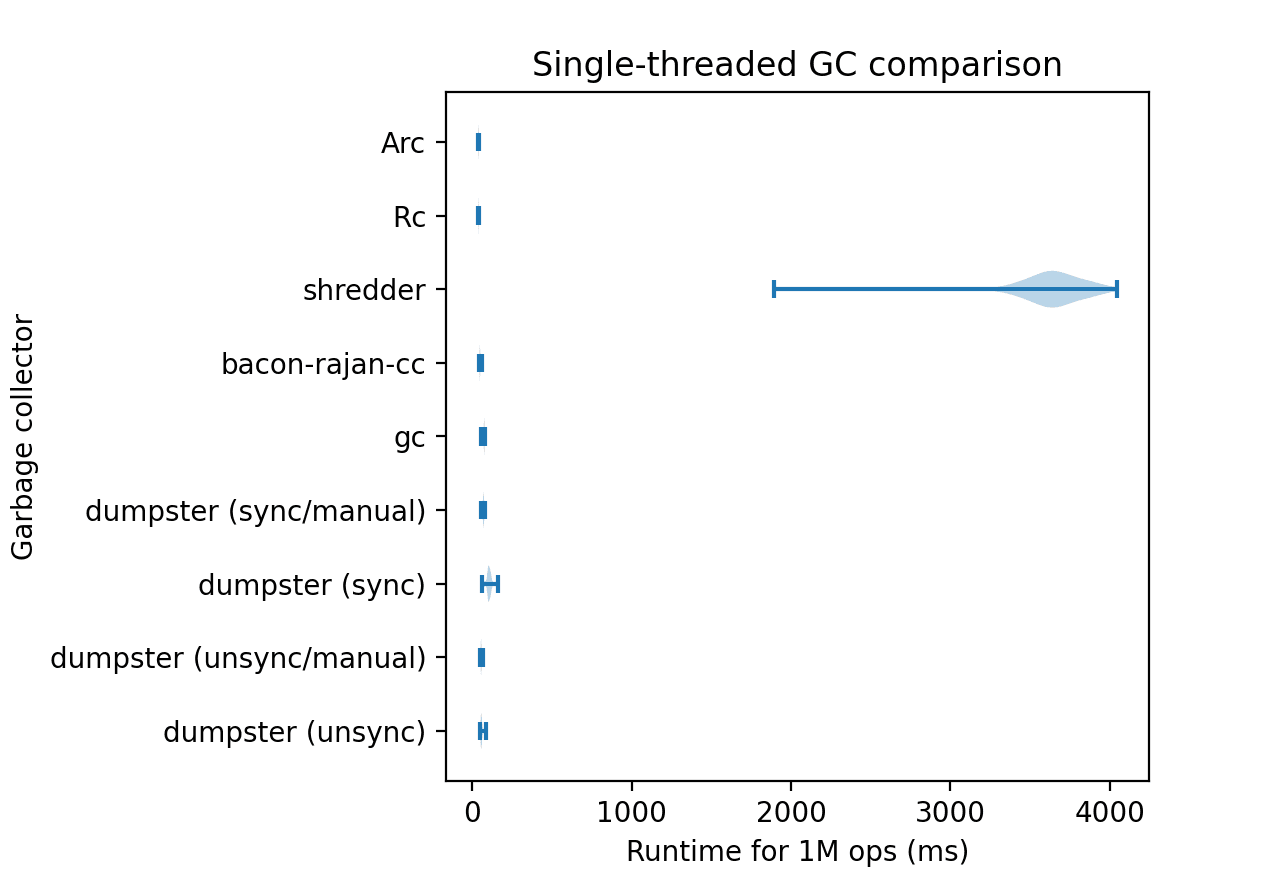
この図から読み取れるのは、shredder が遅いということだけだ。もっと細かく見たいなら、shredder をリストから外して、何が見えるか確かめてみよう。
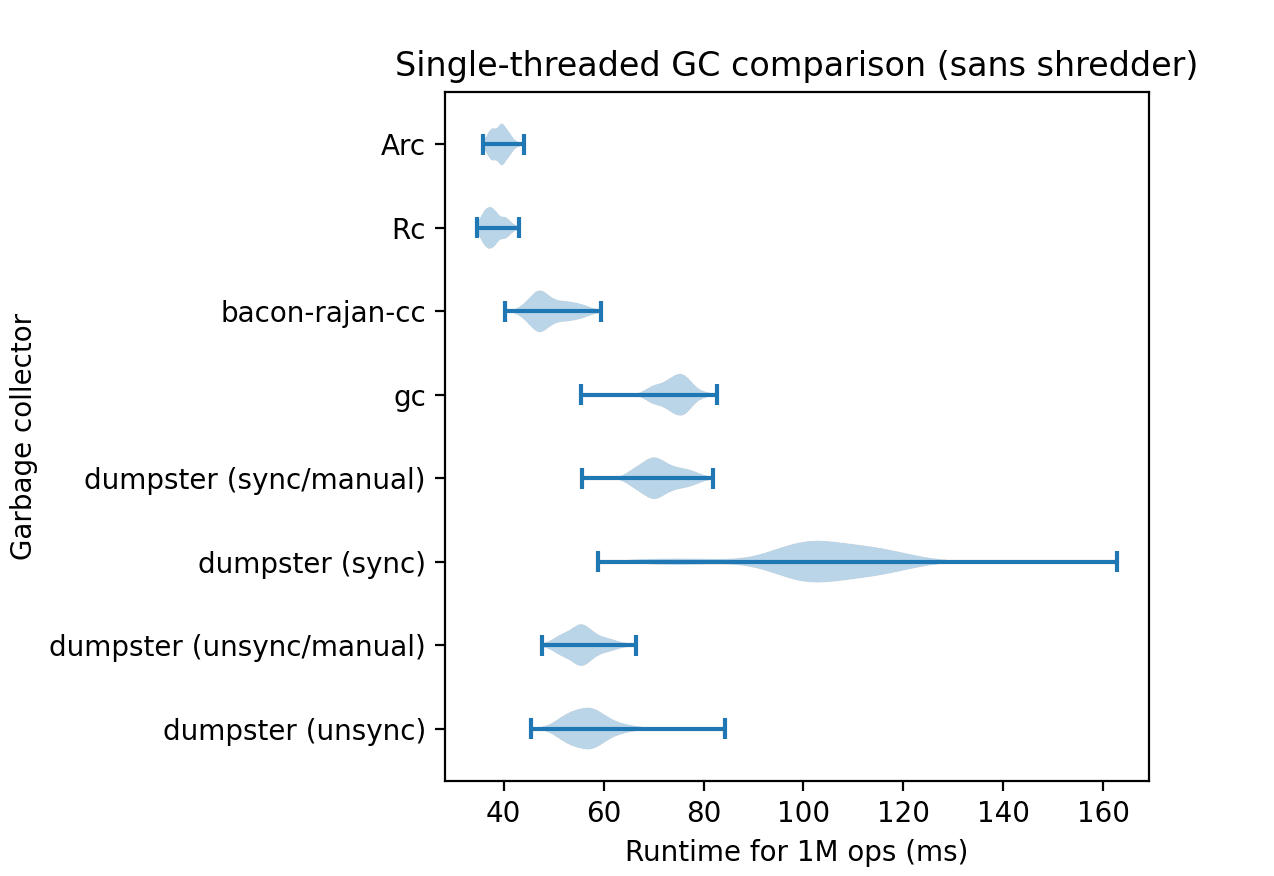
dumpster の unsync 実装はまずまずの出来で、循環検出を行わないアロケータと bacon-rajan-cc にだけ劣っている。bacon-rajan-cc のオーバーヘッドは小さく、性能はかなり良い。
並行版ガベージコレクタはシングルスレッド版よりずっと遅い。理由は主に二つあると思う。一つは、アロケーションをスレッドローカルの dumpster からグローバルなゴミ収集車へ移すのに時間がかかること。もう一つは、並行環境では dfs の操作で、あるアロケーションが現在持つ子オブジェクトの集合を記録しなければならず、並行バグを避けるために通常は専用のヒープ確保構造に置く必要があることだ。一つ目の問題による損失は完全に緩和できるが、二つ目は厄介だ。
自動トリガーによる回収を使ったときに並行版が明らかに遅くなるのは、おそらくテストフレームワークのせいだろう。現状ではすべてのテストを一つのループで回しているため、シングルスレッドのベンチマークがマルチスレッドのベンチマークの直後に走り、後者が残したゴミの掃除を強いられることがある。
ともあれ、次はマルチスレッドベンチマークの結果を見ていく。
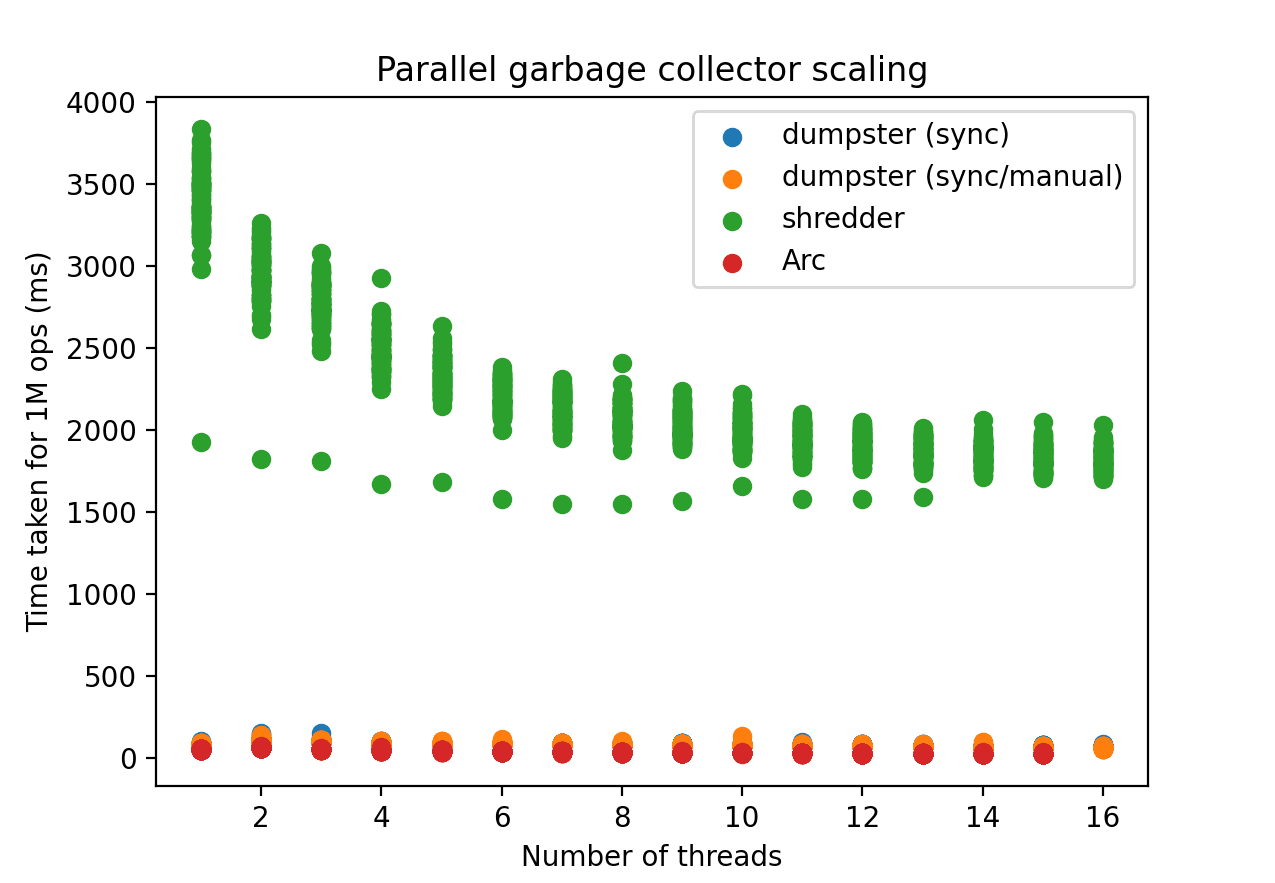
並行ガベージコレクタとして比較テストに使えるのは shredder しかなく、競争相手にはなりそうにない。
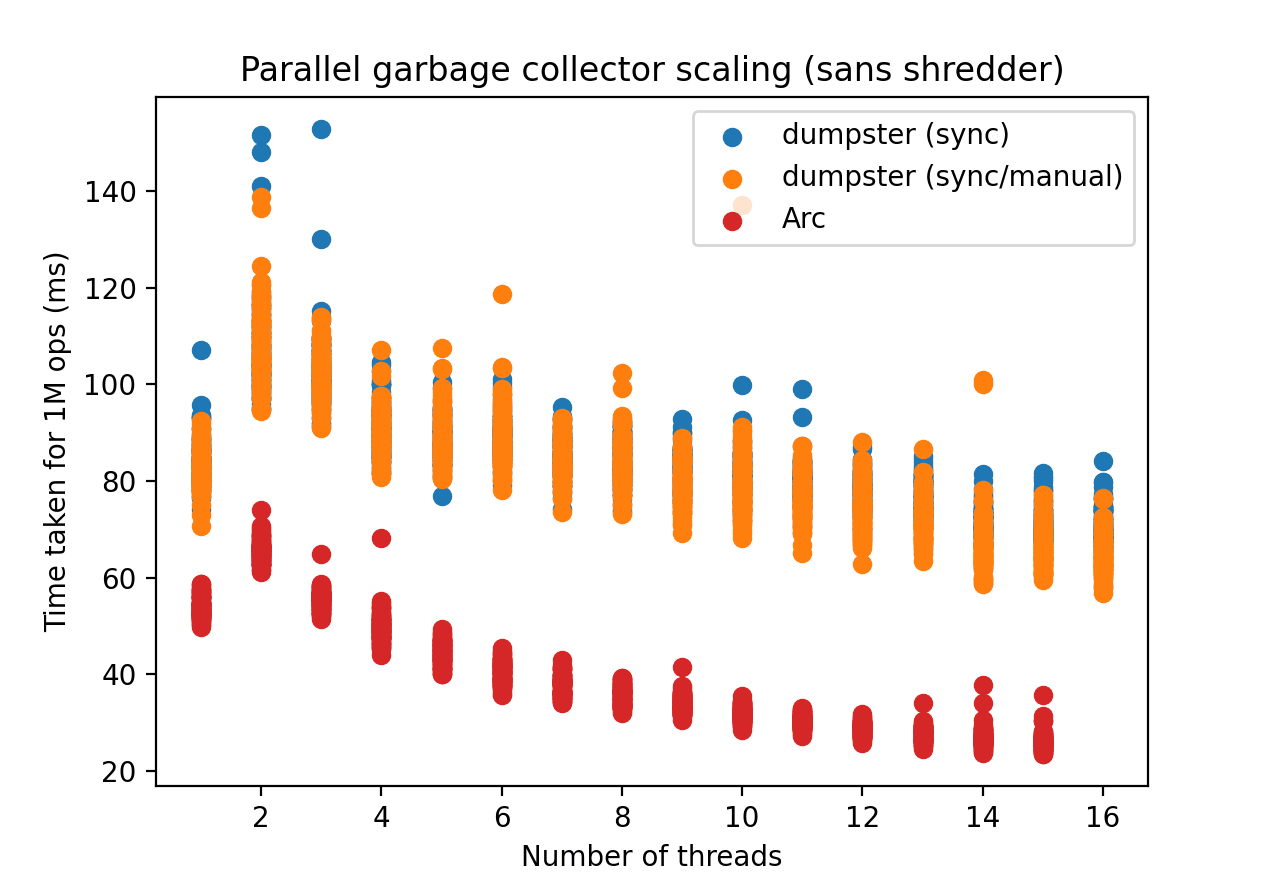
dumpster はスレッド数を増やしても期待したほど滑らかにはスケールしなかった。それでもスレッド数に応じて性能が上がるのは確かで、そこは安心した。唯一の例外はシングルスレッドから 2 スレッドに移る段階だ。Arc と比べて 3 倍遅いだけなら上出来だと思う。ましてこのプロジェクトで一円ももらっていないのだから。並行処理における高性能計算の専門家ではないので、これ以上の最適化は手当たり次第に試して効果を見るくらいしかない。この方式を賢く最適化するアイデアがあれば教えてほしい。メールアドレスは「About」ページにある。
エピローグ
この数か月、Rust 向けのガベージコレクタをゼロから書いてきた。自分で設計したそこそこ新しめのアルゴリズムを実装し、シングルスレッドでもマルチスレッドでも動くようにして、実際にかなり良い性能が出ることを示した。
このクレートの実装はすでに crates.io で公開していて、誰でもダウンロードできる。ライセンスは GNU GPLv3 だ。
Wisha、Charlie、Shreyas には感謝している。この記事をレビューしてくれたり、ひどい質問に答えてくれたり、2 か月近くこの話を延々と聞かされ続けてくれた。
追記
作業中に面白いと思ったものの、本文のどこにも収まらなかった話をまとめてここに置いておく。
ひどいグッドアイデアに捧ぐ
本文で見た最終的な洗練された設計は、最初に考えていたものとはかなり違う。特に、並行処理に関する当初のアイデアはほぼすべてうまくいかなかった。手短に並べておく。
-
割り当てごとの参照カウントをすべて
Mutexで包み、dfsの実行中はそれを保持する -
Gcの空間を節約するために、別途usizeを丸ごと持たず最下位ビットだけを立てる -
すべてを動的ディスパッチにして、真の Java 風オブジェクトを手に入れる
-
割り当てのクリーンアップをスレッドごとにローカルで行う
-
割り当てを直接ドロップせず、参照カウントを巧みに減らす
nightly 機能の裏技
Rc は他のポインタ型と比べてどこか「特権的」だ。Rust コンパイラの nightly 機能を使えるのに、stable のプロジェクトからも使える。dumpster にはそんな待遇はない。
自分のガベージコレクタすべてに CoerceUnsized を無条件で実装したかったが、stable ではどうやっても無理だった。
同じく、strict provenance が入るまで、stable のクレートにはファットポインタのアドレス部分を操作する手段が実質なかった。つまり、最下位ビットのマーキングで空間最適化の目処が立ったとしても、nightly 機能に阻まれて使えないということだ。
Gc<dyn T> へのもう一つの道
Gc を unsized 型に強制変換できなければ、Collectable を object safe にはできない。accept の関数シグネチャが Visitor も object-safe であることを要求し、その結果 visit の操作も object-safe でなければならなくなるからだ。
だが、少し違うやり方を思いついた。Visitor を具体的な型にすれば、Collectable は自然と object-safe になる。代償として、現在の 5 つの visitor 実装をすべて 1 つの構造体に詰め込むことになり、便利な型安全性の多くを失い、実行時オーバーヘッドも小さくない。いい案とは思えない。
Miri のルール
cargo miri がなければ、このプロジェクトはまず完成しなかった。まだ知らないなら今すぐダウンロードして、自分の Rust プロジェクトすべてで走らせてみてほしい。unsafe コードのデバッグにはあまりに便利で、他の言語にもこんなツールがあればいいのにと思う。C で言えば valgrind はお粗末な代替品にすぎない。
テストとデバッグ
最初は手書きのテストがいくつかあるだけだった。最初に問題が起きた参照グラフはこんな形をしていた。
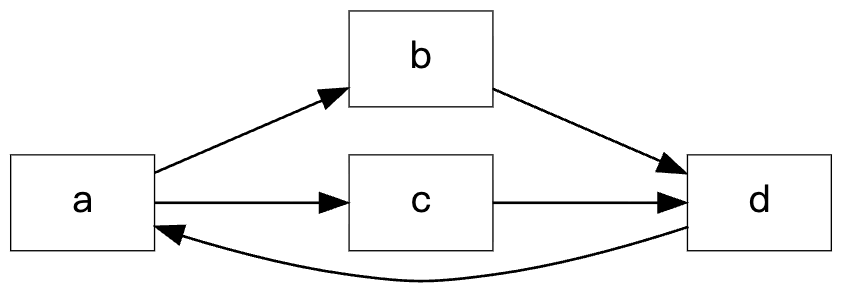
しかし、複数の環を持つ単純なグラフを片付けたあとは、新しいテストを思いつくのが難しくなった。そこで fuzzing に切り替えた。ベンチマークを走らせるときと同じ要領で参照をランダムに生成し、それが正しくクリーンアップされるかを見る。
ところが、fuzzing が出す結果のデバッグは悲惨そのものだった。問題の発生源を突き止める作業はひどくつらく、最終的には(粗削りな)ツールをいくつか作って、この作業を少しでも楽にせざるを得なかった。最終的に落ち着いたやり方はこうだ。テスト実行中の決まった時点で参照グラフを出力し、それを可視化して、どこで壊れたのかを大まかに推測する。だが並行実装を書いている最中は、出力そのものがプログラムの実行挙動を変えかねない。それに、問題の在りかが常に明らかなわけでもない。数千回の操作を終えたあとにようやく現れるバグに遭遇したことがある。そのとき生成された参照グラフはこうだった。
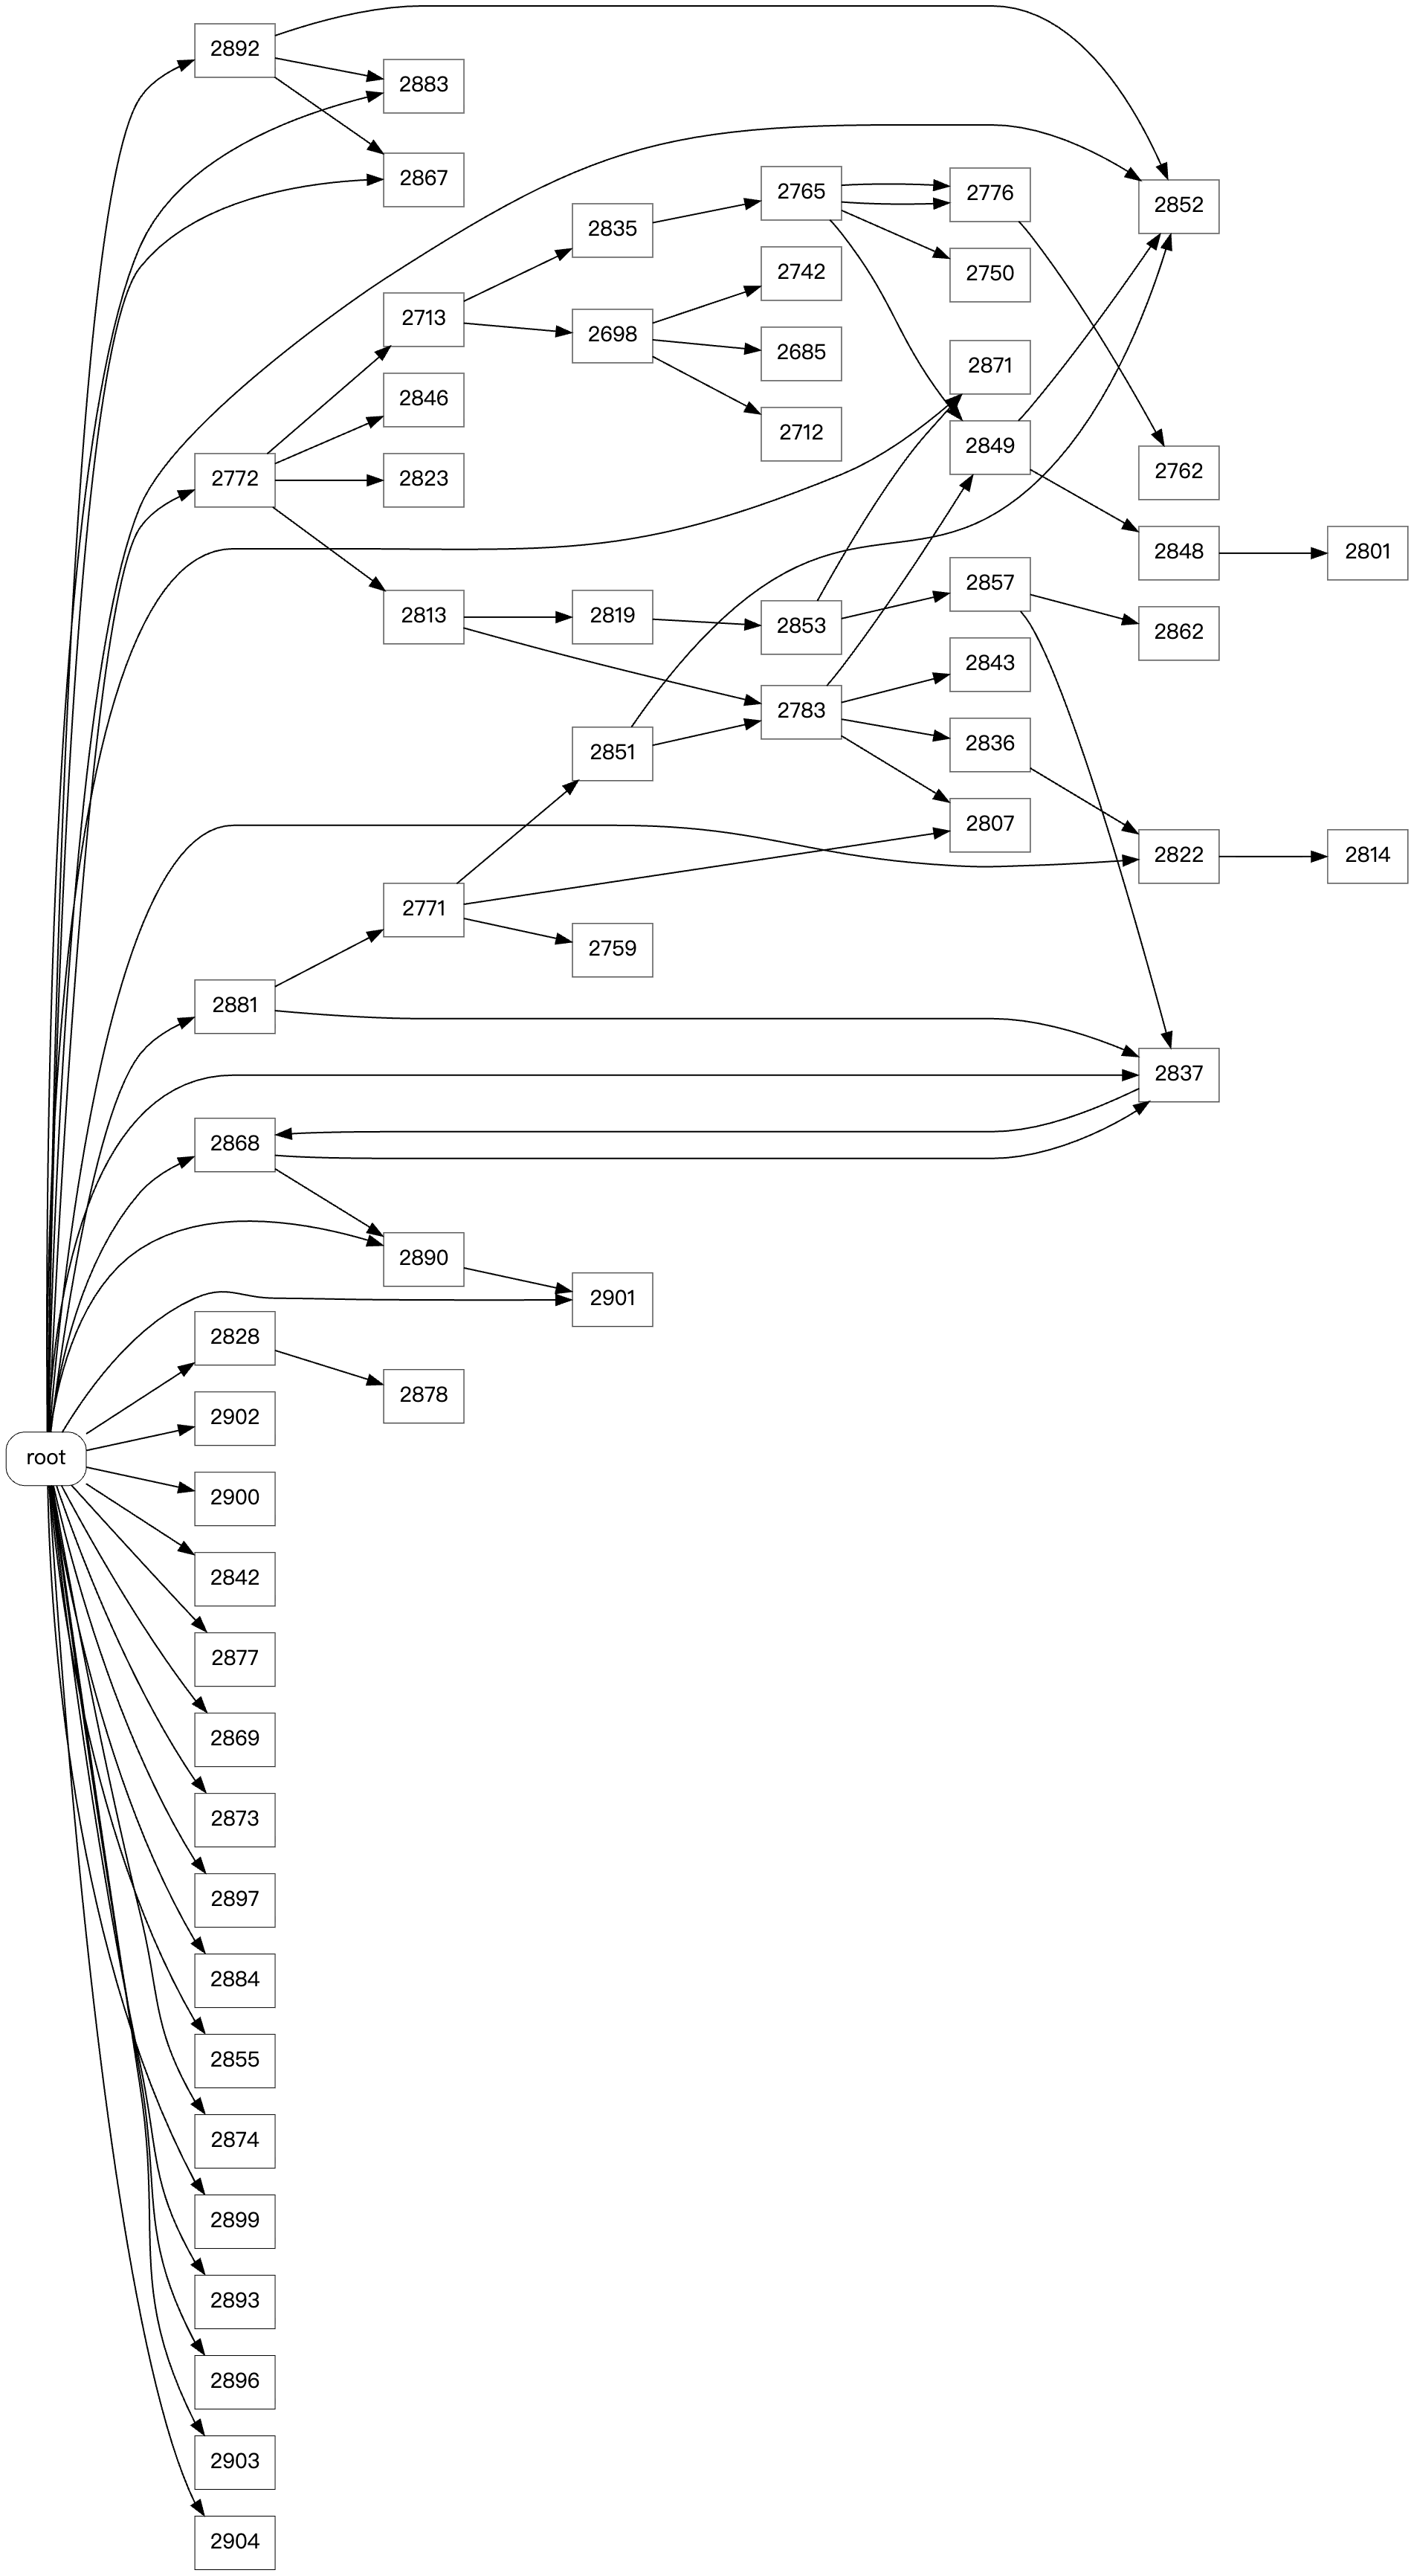
上の図は、私のガベージコレクタをファジングした結果である。使用した手法はベンチマークの場合と同じだ。