我给一门不需要垃圾回收的语言写了个垃圾回收器
Rust 的设计目标就是让垃圾回收不再必要,Clayton Ramsey 却给它写了一个能回收循环引用的并发垃圾回收器,用 Drop、访问者 trait 和收集标签绕开引用计数的死角,再拿它和能找到的所有 Rust 收集器比了一轮基准测试。
中文
复制
语言演化得越来越像 Rust,人称“蟹化”。那 Rust 演化得越来越像 Java,又该叫什么?咖啡化?
这个夏天,我有大把时间要打发。还有什么比在炎炎盛夏窝在屋里、盯着一个号称内存安全的语言吐出的 core dump 更惬意的消遣呢?我写了一个垃圾回收器,简单说,就是一段为另一段更有意思的软件管理内存分配的软件。有意思的地方在于,我用 Rust 写它,也是为 Rust 写的。这门语言的设计目标就是消灭垃圾回收,而且几乎没提供什么让垃圾回收正常工作的设施。不仅如此,我还让这个垃圾回收器在相当少的妥协下正常工作,具体细节下面再讲。
如果你不爱读长文,不关心实现过程,或者只想要最终成果的宣传,可以直接看 GitHub 上的源码。也可以从 crates.io 直接下载。
背景
如果你熟悉 Rust 及其标准库的细节,这一节可以跳过。
Rust 内存模型的核心基础是仿射类型和借用检查器。一个值同一时间只能绑定到一个标识符,而借用(也就是引用)不能比绑定其指称对象的那个作用域活得更久。
例如,下面这段代码是非法的:
let x = vec![1, 2, 3];
let y = x;
println!("{x:?}"); // compile error - x has already been moved
通常我们的绕法是针对某个绑定做借用,比如把上例改成 y = &x。但我们经常需要共享某个堆分配的值,又不知道哪个绑定会活得最久。这个问题的解法是通过垃圾回收实现共享所有权。
Rust 标准库提供了两个简单的引用计数垃圾回收器:单线程的 Rc,以及它的原子计数版本 Arc。它们的做法是在每个堆分配中维护一个引用计数。大多数情况下这很好用,但它们处理不了循环引用。再配合内部可变性,想反驳它们轻而易举。
use std::{cell::OnceCell, rc::Rc};
struct Foo(OnceCell<Rc<Foo>>);

let x = Rc::new(Foo(OnceCell::new()));
x.0.set(Rc::clone(&x));
// My foo has a reference to itself. It can never be freed!
难怪真有人靠写垃圾回收器挣钱。要是引用计数就够用,Oracle 那帮人早该失业了。
作战计划
我们想造一个 Gc 数据结构,API 与 Rc 和 Arc 相近,能装下几乎任何数据类型,同时还能检测并回收循环引用。
手头有几件武器:
-
Drop:Rust 里每个不可复制的数据类型都能实现Droptrait,保证它被 drop 时执行一段代码。在我们的场景里,可以给Gc实现Drop,借此推断某块分配何时变得不可达。 -
Trait:我们可以定义一个 trait(这里叫它
Collectable),作为放进Gc的强制要求。这么做有明显代价(dumpster上游的库没法实现它),但这是必要的恶。
不过,工具再强,对手也不弱:
-
移动无法检测。值在 Rust 里被移动时,从值内部没有任何办法察觉。假如有个类似
OnMove的 trait,能在每次移动时调用一个函数,我们就能用它检测Gc何时被移进另一个Gc、从而失去根,进而写出一个简单的标记-清除回收器。可照这个路子走下去,无非是把 C++ 的拷贝构造函数重新发明一遍。 -
变长数据。我一时糊涂,让
Gc能存?Sized类型。这对库的使用者更灵活(比如支持Gc<[T]>这类东西)。 -
类型擦除。典型的 Rust 程序里,泛型靠单态化实现,运行时不留任何类型信息。没有上下文,清理一块分配就更难。
有了这两件相对简单的工具,就足以造出一个几乎能处理任何内部数据类型的回收器。
我的做法
我们需要判断一个 Gc 是否可达,又不能真的去扫描栈。先给几个定义,用图论的语言来说。
-
分配图 是一个有向图,包含一个入度为零的根节点 。
-
当且仅当图中存在一条从 到 的路径时,分配图中的节点 才被称为可达的。
这些定义为什么对我们有用,应该不难看出来。可以把每个节点想象成一次分配,并假定所有未经 Gc 间接引用的数据都属于根节点的一次虚构分配。此外,每个 Gc 充当连接两次分配的边。如果一次分配在图论意义上是可达的,程序就仍有可能访问到它;反之,释放这次分配就是安全的。注意,节点的入度恰好等于其对应分配的引用计数。
下面大致勾勒我们判断某个节点 是否可达的方法。
-
求出 ,即 所有后代构成的集合。构造 的子图 ,其顶点集为 ,并保留连接 中节点的所有边。
-
求出节点集合 ,其中每个 在 中的入度不等于它在 中的入度。
-
对每个 ,将它及其后代标记为可达。
-
当且仅当 被标记为可达时,它是可达的。
如果你更喜欢伪代码,这里有一个绕来绕去的实现。
def is_accessible(n):
    counts = {n: n.indegree()}
    for (_, m) in n.edges():
        dfs(m, counts)

    reachable = set()
    for (a, count) in counts:
        if count != 0:
            mark(a, reachable)

    return n in reachable


def dfs(n, counts):
    if n not in counts.keys():
        counts[n] = n.indegree()
        for (_, m) in n.edges():
            dfs(m, counts)

    counts[n] -= 1


def mark(a, reachable):
    if a not in reachable:
        reachable.add(a)
        for (_, b) in a.edges():
mark(b, reachable)不难看出,is_accessible 的运行时间为 。
多绕几步的引用计数
我们的单线程 Gc 行为与 Rc 大体相同,只是有些细节做了改动。
首先,我们定义一个 Gc 以及它所指向的分配 GcBox。
pub struct Gc<T: ?Sized> {
    ptr: NonNull<GcBox<T>>
}

#[repr(C)]
struct GcBox<T: ?Sized> {
    ref_count: Cell<usize>,
    value: T
}
然后,我们可以挂接到 Gc 的 Drop 行为上,让整套机制运转起来。
impl<T: ?Sized> Drop for Gc<T> {
    fn drop(&mut self) {
        let box_ref = unsafe { self.ptr.as_ref() };
        match box_ref.ref_count.get() {
            0 => (),
            n => {
                box_ref.ref_count.set(n - 1);
                if n == 1 || !is_accessible(box_ref) {
                    box_ref.ref_count.set(0);
                    unsafe {
                        drop_in_place(addr_of_mut!(ptr.as_mut().value));
                        dealloc(ptr.as_ptr().cast(), Layout::for_value(ptr.as_ref()));
                    }
                }
            }
        }
    }
}
我自认为很聪明,决定在分配被清理时把引用计数设为哨兵值 0(以防误触发双重释放)。
然而这段代码有个问题,我们到底该怎么实现 is_accessible?
trait 小把戏
is_accessible 的伪代码要求我们能访问从某个节点出发的边集。这件事相当难办。如果用 C 写,我们会扫描堆上的分配,寻找看起来像是指向其他分配的指针的数据。不过在 Rust 里,我们可以给每个被垃圾回收的类型加一条小约束,从而精确得多。
垃圾回收器还不够,我们又把 Java 的 visitor 模式搬了过来。每个被垃圾回收的值都必须实现 Collectable trait,由它把一部分 Visitor 转发给自身各个被垃圾回收的字段。
pub struct Gc<T: Collectable + ?Sized> {
   // same as before ...
}

pub trait Collectable {
    fn accept<V: Visitor>(&self, visitor: &mut V);
}

pub trait Visitor {
    fn visit_gc<T: Collectable + ?Sized>(&mut self, gc: &Gc<T>);
}
比如数组可以这样实现:把 accept 转发给每个元素。
impl<T: Collectable> Collectable for [T] {
    fn accept<V: Visitor>(&self, visitor: &mut V) {
        self.iter().for_each(|elem| elem.accept(visitor));
    }
}
现在只要对某个分配对象施加一个 visitor,就能找出它指向外部的边。我最后写了两个 visitor:一个给 dfs 步骤用,一个给 mark 步骤用。
我本想给 Collectable 加上 object safety,但那要求 Visitor 也是 object safe 的。这样一来,每个垃圾回收器都能被强制转换成 Gc<dyn Collectable>,而这只有在 nightly 上才做得到,稳定版 crate 就写不出来了。
批量 drop
粗略看一下上面 Drop 的实现就能发现,is_accessible 的调用耗时与现存 Gc 的总数成线性关系。你要是以为照这样写出来的 drop 是线性时间,那也情有可原。但 drop_in_place 的调用还可能顺带 drop 掉另一个 Gc,清理时间就变成了平方级。这不能接受,尤其是第一次调用 is_accessible 其实已经把活全干完了,它已经判断出哪些分配对象能从最初那个对象到达。既然被释放的原始分配对象不可达,它引用的任何分配对象也必然不可达。
标记阶段的时间可以用一个很简单的办法省下来:再遍历一遍引用图,记下每个待销毁分配对象的指针,以及它实现的 drop。等所有不可达的分配对象都找齐,再一口气把它们全部 drop 掉。
不过还剩最后一个问题:被 drop 的值所拥有的每个 Gc,自己也可能去改动其指向对象的引用计数,这会引发未定义行为,或者更糟,让代码变慢。好在计算机科学里的所有问题都能靠加状态或加一层间接来解决。这次我们选择加状态:创建一个 thread-local 值,叫 COLLECTING。
做批量 drop 时,我们把 COLLECTING 设为 true。之后在 Gc 上调用 drop 时,它会检查 COLLECTING 的状态。如果 COLLECTING 为 true,那么 Gc 在被 drop 时什么都不做(连引用计数都不动)。为了处理指向仍可访问分配的出边,我们在最终清理之前再加一次遍历,专门处理这些出边。
下面大致看一下现在的代码长什么样。
thread_local! {
    static COLLECTING: Cell<bool> = Cell::new(false);
}

impl<T: Collectable + ?Sized> Drop for Gc<T> {
    fn drop(&mut self) {
        if COLLECTING.with(Cell::get) { return; }
        let box_ref = unsafe { self.ptr.as_ref() };
        match box_ref.ref_count.get() {
            0 => (),
            1 => {
                box_ref.ref_count.set(0);
                unsafe {
                    drop_in_place(addr_of_mut!(ptr.as_mut().value));
                    dealloc(ptr.as_ptr().cast(), Layout::for_value(ptr.as_ref()));
                }
            }
            n => {
                box_ref.ref_count.set(n - 1);
                unsafe { collect(self.ptr) };
            }
        }
    }
}
collect 就是我们要写的函数,用来检查分配是否可访问,并在需要时执行批量清理。不过在实现 collect 之前还有一个问题:我们的伪代码要求能把每个分配作为键存进 counts,同时还要能访问该分配的邻居。这意味着我们得用一点类型擦除才能达到目的。细节不展开,总之我们需要做到两件事:
-
把指向分配的指针作为键存进哈希表。
-
借助类型信息还原出存下来的指针,从而能对它进行操作。
受 Rust 的限制,这两件事实际上是互斥的。比较指针中的原始数据属于未定义行为(源于 provenance 问题),所以我们没法先擦除指针再拿它当哈希表的键。但也不能直接取指向分配首字节的指针,因为我们的分配可能是 ?Sized。
因此,我的实现里其实有两种不同的擦除指针:一种瘦指针,用于比较;一种胖指针,用于还原出指向任意类型的指针。
struct AllocationId(NonNull<Cell<usize>>); // used as a key in hash-maps
struct ErasedPtr([usize; 2]); // used as a reconstructible pointer to the allocation
这样一来,所有需要知道分配类型信息的函数(比如 dfs 和 mark)都可以作为函数指针不透明地存起来,调用时再用类型信息把传进来的 ErasedPtr“重新水化”。
下面给出一个用它实现 dfs 的例子。
unsafe fn dfs<T: Collectable + ?Sized>(
    ptr: ErasedPtr,
    counts: &mut HashMap<AllocationId, usize>
) {
    struct DfsVisitor<'a> {
       counts: &'a mut HashMap<AllocationId, usize>,
    }

    impl Visitor for DfsVisitor<'_> {
        fn visit_gc<U>(&mut self, gc: &Gc<U>) {
            let id = AllocationId::new(gc.ptr);

            if counts.insert(id, unsafe { gc.ptr.as_ref().ref_count.get() }) {
                (**gc).accept(self);
            }

            *counts.get_mut(&id).unwrap() -= 1;
        }
    }
    // pretend that `specify` converts the pointer back into NonNull<T>
    let specified = ptr.specify::<T>();
    specified.as_ref().accept(&mut DfsVisitor { counts });
}
collect 的实现我就不放在这里了,它很长,而且甚至不是清理算法的最终版本,但你可以相信它是能跑的。在经历了一番咬牙切齿、抓耳挠腮之后,这终于足以实现批量 drop,让在 Gc 上调用 drop() 变成线性时间的操作。
摊销
你说什么?你需要你的引用操作在 时间内完成?现在的程序员怎么都这么挑剔?
好在让我们的垃圾回收工作在平均情况下以 时间结束并不太难。我们不直接调用 collect,而是把这次分配(它可能已经不可访问)丢进一组“脏”分配里。在我的代码里,这个集合叫 dumpster。之后,每丢弃 次分配,我们就遍历整个 dumpster,用 时间把它们全部回收。把所有分配摊开来看,这在技术上是 ,靠的正是那套让数组实现的列表变得好用、也引发了 2008 年金融危机的记账魔法。
为了省点事,每当某个分配被访问(比如解引用或克隆),我们就可以把它从那个脏集合里拽出来,因为它刚刚被证明是可访问的。
我们并发了吗?
到目前为止,我给你勾勒的垃圾回收器都是单线程的,只能存放线程局部的垃圾回收值。我听说所有值得写的代码最终都是并发的,所以我们得做得更好。幸运的是,只要同一时间只有一个线程在回收,这个算法几乎不用费什么力气就能并发运行。
不过,即使只有一个线程在回收,我们仍可能撞上一些棘手的并发问题。设想我们有 2 个分配, 和 ,再加上一个想象中的“根”分配 ,其中 只能从 访问, 只能从 访问。
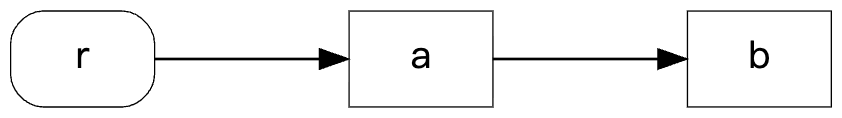
现在,考虑从 开始执行深度优先搜索。首先,我们记录 在 counts 中有 1 个未计入的引用。接着,我们转而查看 ,因为它是 的子节点之一。
然而,就在我们记录 的引用计数与检查 之间,另一个恶意线程修改了 ,添加了一条从 指向 的反向引用。
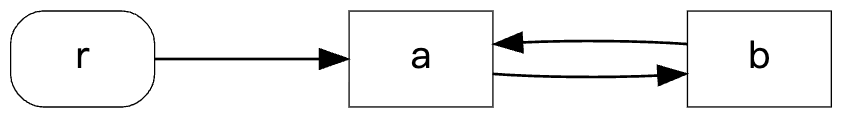
随后,深度优先搜索会回到 ,递减未计入的引用计数,并认定所有指向 和 的入引用都已完全计入(因此不可访问)。于是垃圾回收器会心安理得地销毁 和 的分配,留下一个指向堆的悬垂引用,可能引发 use-after-free 或其他棘手的内存错误。
解决并发问题
解决这个并发问题最简单的办法,就是把所有涉及 Gc 的操作都套上一把大锁,强制每个操作获取同一个全局互斥锁,这样并发 bug 就彻底不会出现了。但这样做慢得离谱。
如果可能的话,我们希望只在全部分配中的一小部分上实现互斥。为此,先仔细看看并发问题本身:可以看到,只有在另一个线程于我们操作子图 的同时修改它时,才会真正得到错误的结果。解决办法相当巧妙,给每个 Gc 打上一个特殊的编号,我称之为收集标签(collecting tag)。
首先,添加一个全局原子整数,名为 COLLECTING_TAG。
static COLLECTING_TAG: AtomicUsize = AtomicUsize::new(0);每当我们创建或克隆一个新的 Gc 时,就用 COLLECTING_TAG 的当前值给它做标注。
// this new `Gc` type is intended to be `Sync`.

pub struct Gc<T: Collectable + Send + Sync + ?Sized> {
    ptr: NonNull<GcBox<T>>,
    tag: AtomicUsize,
}

impl <T: Collectable + Send + Sync + ?Sized> Gc<T> {
    pub fn new(x: T) -> Gc<T> {
        // (other bookkeeping hidden)

        Gc {
            ptr: /* initialization of GcBox<T> */,
            tag: COLLECTING_TAG.load(Ordering::Relaxed),
        }
    }
}
接着,在收集过程开始时,在调用 dfs 之前先把 COLLECTING_TAG 的值加一。
fn collect() {
    COLLECTING_TAG.fetch_add(1, Ordering::Relaxed);
    // carry on with DFS and such
}
最后,在 dfs 过程中每遇到一个 Gc,就检查它的标签。如果标签等于 COLLECTING_TAG 的当前值,说明这个 Gc 是在 dfs 开始之后才创建的。若是如此,那么我们发现这个 Gc 的位置必定是可访问的,可以把它标记为可访问。为了防止因各种意外而重复访问同一条边,我们还会把访问过的每条边的标签更新为 COLLECTING_TAG 的值。
回到前面那个出错的例子,看看这一改动是如何修复它的。还是那张引用图: 指向 , 指向 。既然每个 Gc 都必须带标签,就假设它们的标签都是 0。
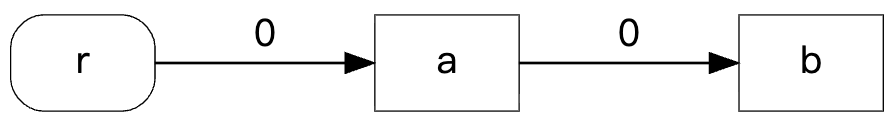
接下来,当 dfs 开始时,COLLECTING_TAG 会递增到 1。因此,恶意线程新建的引用必须被标记为 1。
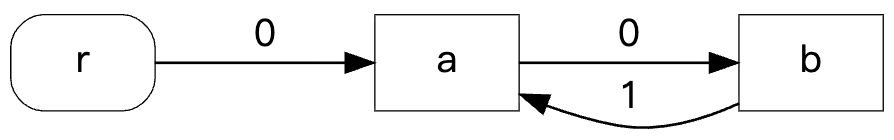
现在,当 dfs 访问从 指向 的边时,它看到该引用被标记为 1,因此 和 都必须保持可访问,这里不会发生意外的提前释放。
移入与移出
我们或许会希望,给指针打上标记就足以杜绝所有并发 bug。遗憾的是,这还不够。为了说明原因,我们先从一个例子讲起。
首先,设想有一个名为 的分配,其中包含两个指向自身的可选引用。
struct X {
    x1: Mutex<Option<Gc<X>>>,
    x2: Mutex<Option<Gc<X>>>,
}
在示例开始时, 内部只有一个 Gc 指向自身,另一个可以存放 Gc 的槽位则为空。 可以直接从根分配 访问,所有现有引用都标记为 0。为清晰起见,我把 中代表第一个槽位的箭头画成实线,第二个槽位画成虚线。
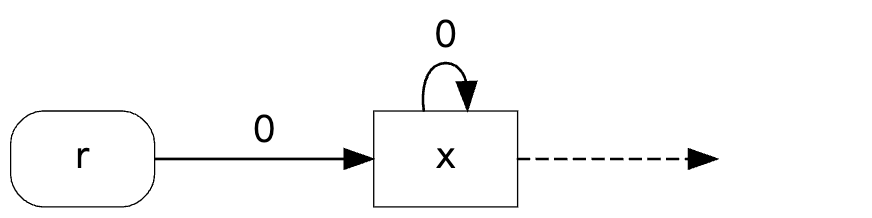
现在,让我们从 开始执行 dfs。
-
将
COLLECTING_TAG自增到 1。 -
dfs记录下 在开始时还有 2 个未被计入的引用。 -
dfs访问 的第一个槽位,并给该槽位中当前存在的 self 引用打上标记。此时 还剩 1 个未被计入的引用。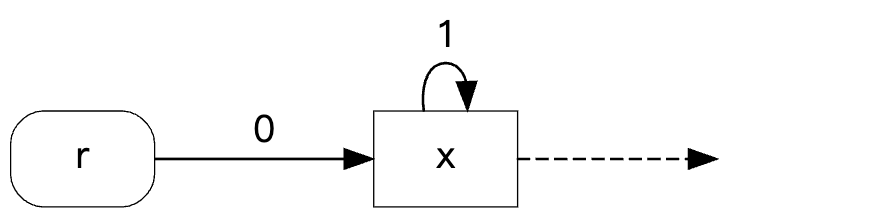
-
一个恶意线程介入,先将
Gc从 的第一个槽位移至 ,再将原本连接 与 的Gc移入 的第二个槽位。fn do_evil(r_to_x: Gc<X>) { let z = std::mem::take(&mut *r_to_x.x1.lock().unwrap()); *z.x2.lock().unwrap() = r_to_x; }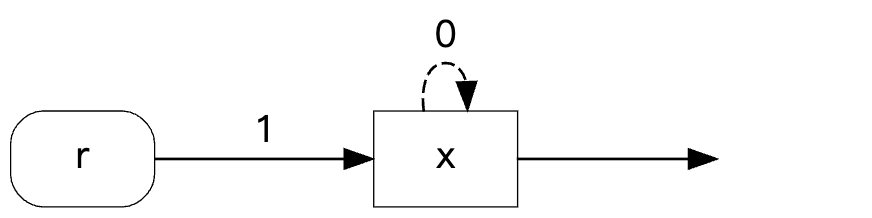
-
dfs继续执行,这次访问 中的第二个槽位。看到又一个指向 的引用,我们把未计入的引用数减到 0。 -
dfs没有找到 的祖先中存在未计入引用的对象,于是我们释放了 。然而, 仍然可以访问!
这个问题卡了我好一阵子。看起来根本没法阻止其他线程把指向某个分配的每个 Gc 都来回调换,从而骗过我们的搜索。好在总有出路。既然之前给每个 Gc 打标签的办法奏效了,这次我们就试着给每个分配打标签。
#[repr(C)]
struct GcBox<T: Collectable + Send + Sync + ?Sized> {
    ref_count: AtomicUsize,
    tag: AtomicUsize,
    value: T
}
接下来,每次解引用一个 Gc 时,我们都把分配中的标签更新为 COLLECTING_TAG 的当前值。
impl<T: Collectable + Send + Sync + ?Sized> std::ops::Deref for GcBox<T> {
    type Target = T;

    fn deref(&self) -> &Self::Target {
        let box_ref: &GcBox<T> = unsafe { self.ptr.as_ref() };
        box_ref.tag.store(COLLECTING_TAG.load(Ordering::Acquire), Ordering::Release);
        &box_ref.value
    }
}
只要 dfs 观察到某个分配上的标签等于 COLLECTING_TAG,就说明该分配被访问过,因而可以访问。要想在上面的例子里把引用挪来挪去,恶意线程就必须解引用一个 Gc,这会让搜索得知,从而阻止提前释放。
事实上,这足以证明:即使在并发执行下,dfs 也绝不会错误地把某个分配标记为不可访问。这篇博客已经相当长了,所以我只给出证明的大致轮廓。
定理:dfs 绝不会错误地把某个分配标记为不可访问。
证明:
-
如果
dfs遇到一个在dfs开始之后创建的Gc,它就知道所指对象是可访问的。 -
由 (1) 可知,如果
dfs把某个分配 标记为不可访问,那它一定只访问过指向 的Gc,且这些Gc在dfs开始之前就已存在。 -
把 (2) 的结论放宽:如果
dfs把某个分配 标记为不可访问,那它一定只访问过指向 的Gc,且这些Gc在记录 的引用计数时就已存在。 -
当
Gc从根分配 指向其他分配时,dfs绝不会访问它。 -
要把某个分配标记为不可访问,
dfs必须访问在记录其引用计数的那一刻指向该分配的每一个Gc。 -
由 (4) 和 (5) 可知,如果 被标记为不可访问,那么任何曾在某个时刻把 连接到 的
Gc,必定已被移动去把另一个节点(而非 )连接到 。 -
由 (6) 可知,不存在这样的生命周期
'x,它针对一个从 指向 的Gc做借用,并且其存续区间落在dfs首次访问 与最后一次访问 之间。 -
在
dfs之前最后一个移入 的Gc,其移动发生时必定存在另一个借用,借用的对象是一个从 指向 的Gc。设该借用的生命周期为'y。 -
由于
'y比最后一次移动持续得更久,'y可以被延长到任意长,甚至可以延长到dfs访问完所有指向 的Gc之后。 -
由 (7) 可知,
'y在dfs首次访问 之前必定尚不存在。因此,如果 被错误地标记为不可访问,那么必定有某个指向 的Gc被解引用,从而产生了一个生命周期为'y的借用。 -
如果某个指向 的
Gc在dfs最后一次访问指向 的Gc之前被解引用,那么dfs就会观察到 的标签已经改变。因此,如果某个分配被错误地标记为不可访问,那它必定曾被标记为可访问。所以dfs从未把任何分配错误地标记为不可访问。QED。
这个证明相当粗略,但细心的读者应该能自行补全细节。至于与之互补的那个证明,即 dfs 永远不会把某个分配错误地标记为可访问,我留给这些细心的读者去完成。
我还觉得挺酷的一点是,这套方案之所以正确,全部机制都依托于 Rust 的借用检查语义。这让整套东西显得融洽自然。
起决定作用的是弱引用
并发导致的内存安全问题还有一个来源。如果一个分配因为引用计数归零而被释放,它仍可能被另一个线程访问,因为它曾被存进全局 dumpster。我们无法保证已经清除了其他所有线程内存中对这个分配的全部引用,所以看起来我们无计可施了。
计算机科学里没有什么问题是多加一点状态解决不了的。借鉴 Rc 的思路并加以自由发挥:我们给每个分配附加一个“弱”引用计数,记录它被垃圾箱或清理线程引用的次数。原来的引用计数则改名为强计数。
#[repr(C)]
struct GcBox<T: Collectable + Send + Sync + ?Sized> {
    strong: AtomicUsize,
    weak: AtomicUsize,
    tag: AtomicUsize,
    value: T,
}
这样一来,在丢弃指向某个 Gc 的最后一个强引用时,我们先检查它的弱引用计数是否非零,只有非零才能释放。否则,就交给清理线程处理。
每当某个分配被移出垃圾箱、即将由运行清理流程的线程丢弃时,该线程会递减这个分配的弱计数,并检查弱计数与强计数是否都已归零。若都归零,该线程便可以安全地销毁这个分配。
死锁!
设想我们要创建一个 Gc<Mutex<()>>,然后在 Mutex 处于锁定状态时丢弃一个指向它的 Gc。
let gc1 = Gc::new(Mutex::new(()));
let gc2 = gc1.clone();

let guard = gc1.lock()?;
drop(gc2); // suppose this triggers a cleanup
drop(guard);遍历引用图时,dfs 的访问器会尝试访问这个互斥锁、将其锁定,然后继续往下走。但触发这次分配的那个线程仍持有该互斥锁的 guard,于是线程会灾难性地死锁。幸运的是,我们知道任何持有互斥锁 guard 的分配必然仍可访问(这要归功于 Mutex 出色的 API),因此可以确定:一旦获取互斥锁失败,就立刻证明了该分配可访问。
利用这一点,我们把访问可回收类型改成可失败的操作,并让获取锁失败同时导致访问失败。
pub trait Collectable {
    fn accept<V: Visitor>(&self, visitor: &mut V) -> Result<(), ()>;
}

pub trait Visitor {
    fn visit_gc<T: Collectable + ?Sized>(&mut self, gc: &Gc<T>) -> Result<(), ()>;
}

impl<T: Collectable + ?Sized> Collectable for Mutex<T> {
    fn accept<V: Visitor>(&self, visitor: &mut V) -> Result<(), ()> {
        // pretend poison errors don't exist
        self.try_lock().map_err(|_| ())?.accept(visitor);
        Ok(())
    }
}
共享你的垃圾箱
你居然读到了这篇(确实相当长的)文章的这里。欣赏一下我亲手画的图吧。
实现这个垃圾回收器时,并发性能最大的瓶颈之一,是每次丢弃一个 Gc 都要访问那唯一的全局垃圾箱。如果用的是 Mutex<HashMap>,这几乎会抹掉整个系统的并行性,让你怀疑自己花那么多钱买 16 核机器到底图什么。
所以,任何头脑正常的人都会倾向于用并发哈希表。Rust 的实现有很多,我试过 chashmap,因为一个罕见的 panic bug 放弃了;后来又试了 dashmap,能用,但线程数一多就太慢。
问题的根源在于,并发地更新任何数据结构都慢。即便是那些用分片锁玩出花样的所谓“并发”数据结构也一样,总归有争用的开销。对付并发变慢最好的办法,就是干脆别并发。我们可以让每个线程拥有自己的垃圾箱,再维护一个全局的待清理分配集合,我把它叫作垃圾车。每当另一个分配被标记为脏,我们就按某种启发式判断当前线程的垃圾箱是否已满,满了就把这个线程垃圾箱里的所有分配转移到垃圾车上。整个流程的伪代码在下面。
dumpster = set() # local to this thread
garbage_truck = mutex(set()) # global to all threads

def mark_dirty(allocation):
    dumpster.add(allocation)
    if is_full(dumpster):
        garbage_truck.lock()
        for trash_bag in dumpster:
            garbage_truck.add(trash_bag)
        garbage_truck.unlock()
        dumpster = set()
如果 is_full 返回 true 的频率足够低,垃圾车上就几乎不会有争用。这样并发开销大幅降低,性能上的回报也相当可观。
好,那它到底有多快?
简而言之,这个垃圾回收器跑得相当快。
最终我做了两个不同的垃圾回收器实现。一个是线程局部的,省掉了所有并发上的麻烦;另一个是线程安全的,功能一应俱全,代价是损失一些性能。借用 once_cell 的 API,前者位于 crate 的 unsync 模块,后者位于 sync。
接下来,我把能找到的垃圾回收器都收集起来做对比。筛选标准是 API 与 dumpster 相似、发布在 crates.io 上,并且确实能跑起来。
| 名称 | 支持并发? | 与 dumpster 类似? |
|---|---|---|
dumpster(unsync) | ❌ | ✅ |
dumpster(sync) | ✅ | ✅ |
Rc | ❌ | ✅ |
Arc | ✅ | ✅ |
bacon-rajan-cc | ❌ | ✅ |
cactusref | ❌ | ❌ |
elise | ✅ | ❌ |
gc | ❌ | ✅ |
gcmodule | 支持,但 API 不同 | ✅ |
rcgc | ❌ | ❌ |
shredder | ✅ | ✅ |
API 与 dumpster 不相似的,我没有纳入,因为给它们搭一套基准测试框架实在太麻烦。如果你觉得这算偷懒,大可以自己去测。我还把 Rc 和 Arc 加了进来,虽然它们不回收循环引用,但作为垃圾回收器性能下限的基线还算合适。调研过程中我还发现,bacon-rajan-cc 不会主动触发回收,所以为了公平竞争,我给 dumpster 的每个垃圾回收器都加了一个不自动触发回收的版本,标记为“manual”。最后,gcmodule 在面对极大的回收负载时会直接栈溢出,有时还会段错误,所以我把它从基准测试里剔除了。
基准测试我选了能想到的最简单的做法:让一堆分配对象在循环中随机地互相添加和删除引用,同时不断丢弃和创建新的分配。为了抵消随机噪声,每个垃圾回收器都跑 100 轮,每轮 100 万次操作。每次操作要么是创建一个引用,要么是删除一个引用。
首先,我对所有垃圾回收器跑了一轮基准测试,测量纯单线程性能。下面的小提琴图展示了结果,反映的是运行时间与出现频率的关系。
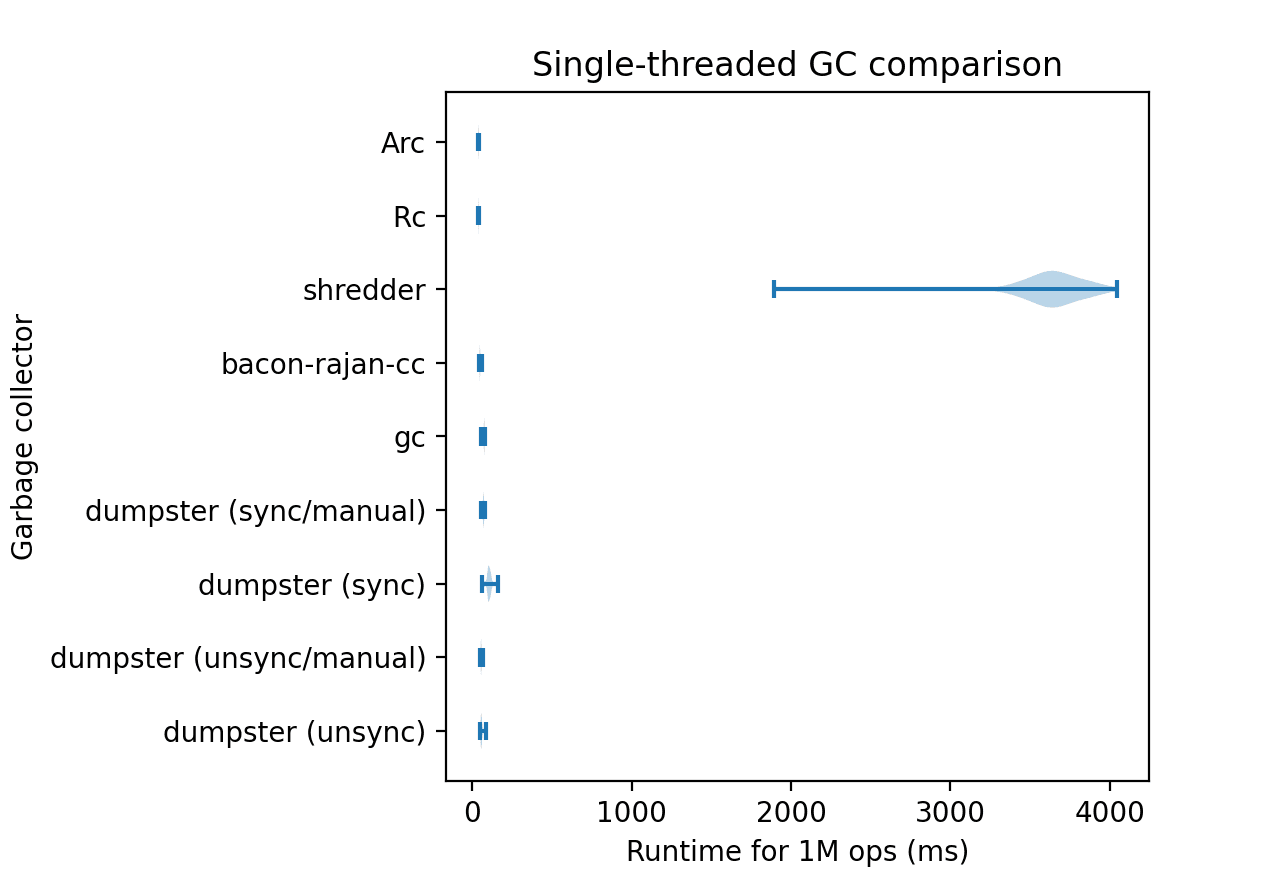
这张图除了说明 shredder 很慢之外,看不出别的。想看得更细,把 shredder 从列表里去掉,再看看能发现什么。
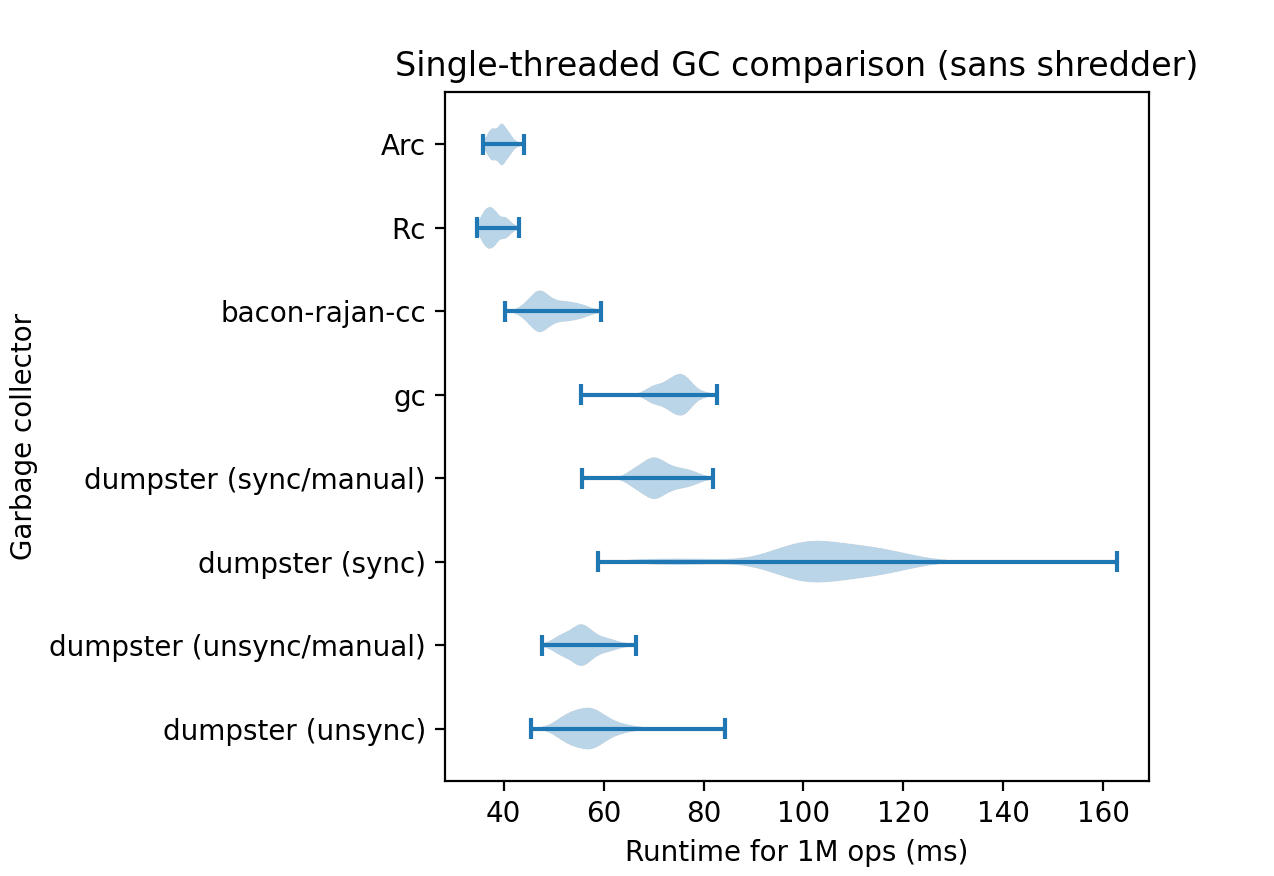
dumpster 的 unsync 实现表现尚可,只输给了不检测循环的分配器和 bacon-rajan-cc。bacon-rajan-cc 开销很小,性能相当不错。
并发版垃圾回收器比单线程版慢得多,我认为主要有两个原因。第一,把分配从线程本地的 dumpster 搬到全局的垃圾车需要花一些时间。第二,并发环境下的 dfs 操作必须记录某个分配当前的子对象集合,通常要放在一个单独堆分配的结构里,以防止某些并发 bug。第一个问题带来的损失完全可以缓解,第二个就难处理了。
至于使用自动触发回收时并发版为什么明显更慢,我猜这是我的测试框架造成的。目前它在一个循环里跑所有测试,所以单线程基准可能紧跟在多线程基准之后运行,被迫清理掉后者留下的一些垃圾。
无论如何,接下来看多线程基准的结果。
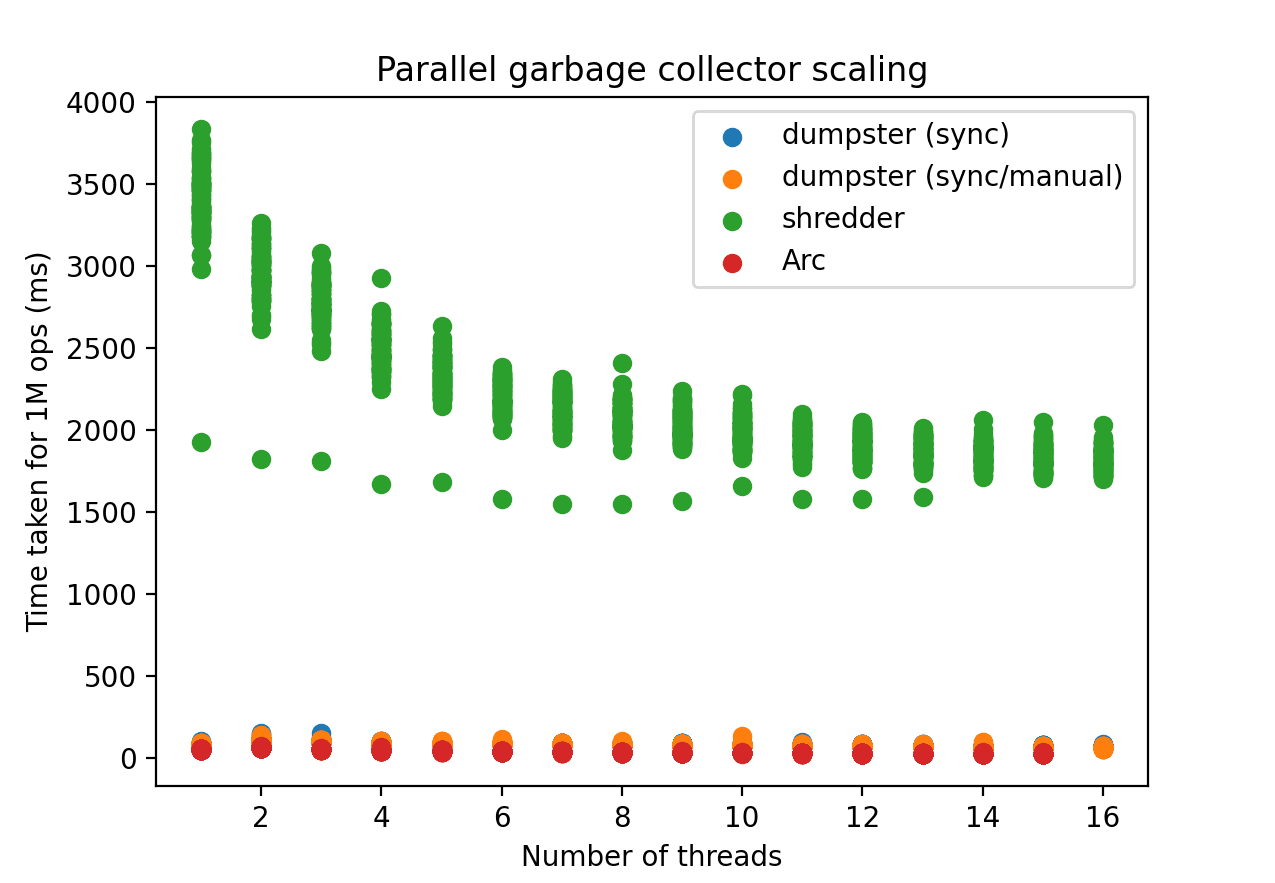
我能拿来对比测试的另一个并发垃圾回收器只有 shredder,看起来它算不上什么竞争对手。
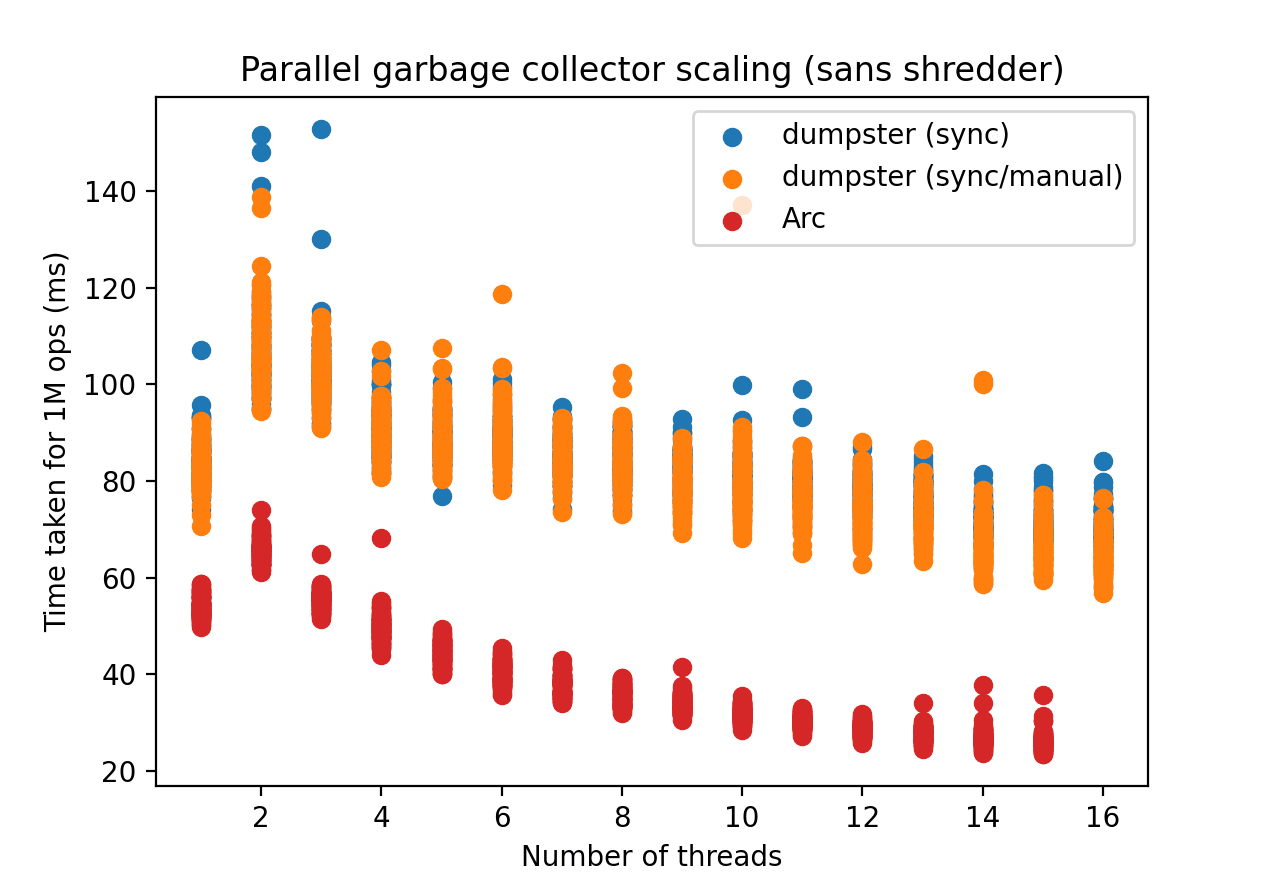
dumpster 在随线程数扩展时并不像我期望的那样平滑,但性能确实会随线程数提升,这一点让人松了口气,只有从单线程跳到双线程那一步例外。我觉得只比 Arc 慢 3 倍已经算是不错的成绩了,尤其考虑到这个项目我没拿到一分钱。我在并发场景下的高性能计算方面算不上专家,所以想进一步优化,多半只能靠瞎试各种办法、看看有没有效果。如果有人对如何优化这个方案有聪明的想法,欢迎告诉我!我的邮箱在“About”页面。
尾声
过去几个月里,我从零开始为 Rust 写了一个垃圾回收器。我实现了一个自己设计的、还算新颖的算法,让它在单线程和多线程环境下都能工作,并证明它实际上性能相当不错。
这个 crate 的实现现在已经发布到 crates.io,任何人都可以下载。它采用 GNU GPLv3 许可证。
特别感谢 Wisha、Charlie 和 Shreyas 审阅这篇文章、回答我那些糟糕的问题,并忍受我连续将近两个月不停地念叨这件事。
附言
有几件事我在过程中觉得挺有意思,但在上面的正文里找不到合适的位置,就都杂糅在这里了。
致糟糕的好点子
你在本文中看到的最终打磨好的方案,其实和我最初的想法相去甚远。尤其是,我最初关于处理并发的几乎所有想法都没能奏效。下面把它们快速列一遍:
-
给每一个分配的引用计数都套一个
Mutex,并在执行dfs期间持有它们 -
在
Gc中节省空间,只标记最低位,而不是额外加一个完整的usize -
让所有东西都启用动态分发,这样我们就能拥有真正的 Java 式对象
-
在每个线程上本地清理分配
-
避免直接丢弃分配,改为巧妙地递减它们的引用计数
夜间特性的特殊待遇
Rc 和其他指针类型多少有点“特权”:它们能使用 Rust 编译器的 nightly 特性,同时还能被 stable 项目使用。dumpster 就没有这种待遇。
我想为我的所有垃圾回收器无条件实现 CoerceUnsized,但在 stable 上根本做不到。
同样,在 strict provenance 落地之前,stable crate 实际上没有办法操作胖指针的地址部分。也就是说,即使我通过低位标记找到了某种空间优化,也用不了,因为它被 nightly 特性挡住了。
通往 Gc<dyn T> 的另一条路
如果不能把 Gc 强制转换成 unsized 类型,我就没法让 Collectable 成为 object safe,因为 accept 的函数签名要求 Visitor 也必须是 object-safe,进而要求 visit 操作也必须是 object-safe。
不过我想到了一个稍有不同的做法。我们可以把 Visitor 做成一个具体的类型,这样 Collectable 就自然是 object-safe 了。代价是我得把目前 5 个 visitor 实现都塞进同一个结构体里,这会丢掉不少好用的类型安全特性,还会带来不小的运行时开销。我不太喜欢这个主意。
Miri 的规矩
如果没有 cargo miri,这个项目我多半完不成。你要是还没听说过它,现在就去下载,然后拿它跑一遍你所有的 Rust 项目。调试 unsafe 代码它实在太好用了,我甚至希望别的语言也有这样的工具。用 C 的时候,valgrind 只能算个蹩脚的替代品。
测试与调试
一开始我只有几个手写的测试。我遇到的第一个出问题的引用图长这样:
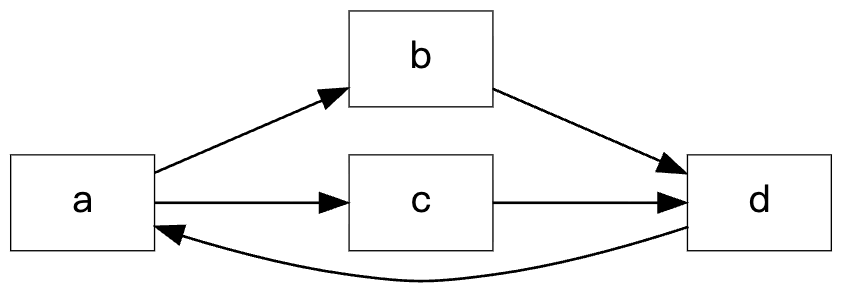
不过,在搞定带多个环的简单图之后,我就很难再想出新的测试了。于是我改用 fuzzing,思路和跑 benchmark 时一样,随机生成引用,再看它们能不能被正确清理掉。
但调试那些模糊测试跑出来的结果简直是灾难。定位问题源头的体验极差,我最后不得不做了一些(粗糙的)工具来让这个过程好受一点。最终我定下来的做法是:在测试运行的选定时刻把引用图打印出来,再做可视化,以此大致猜出哪里出了问题。可是在写并发实现时,打印本身就可能改变程序的执行行为。不止如此,问题出在哪也并不总是显而易见。我遇到过一个 bug,只有在完成数千次操作之后才会出现,产生的引用图长这样:
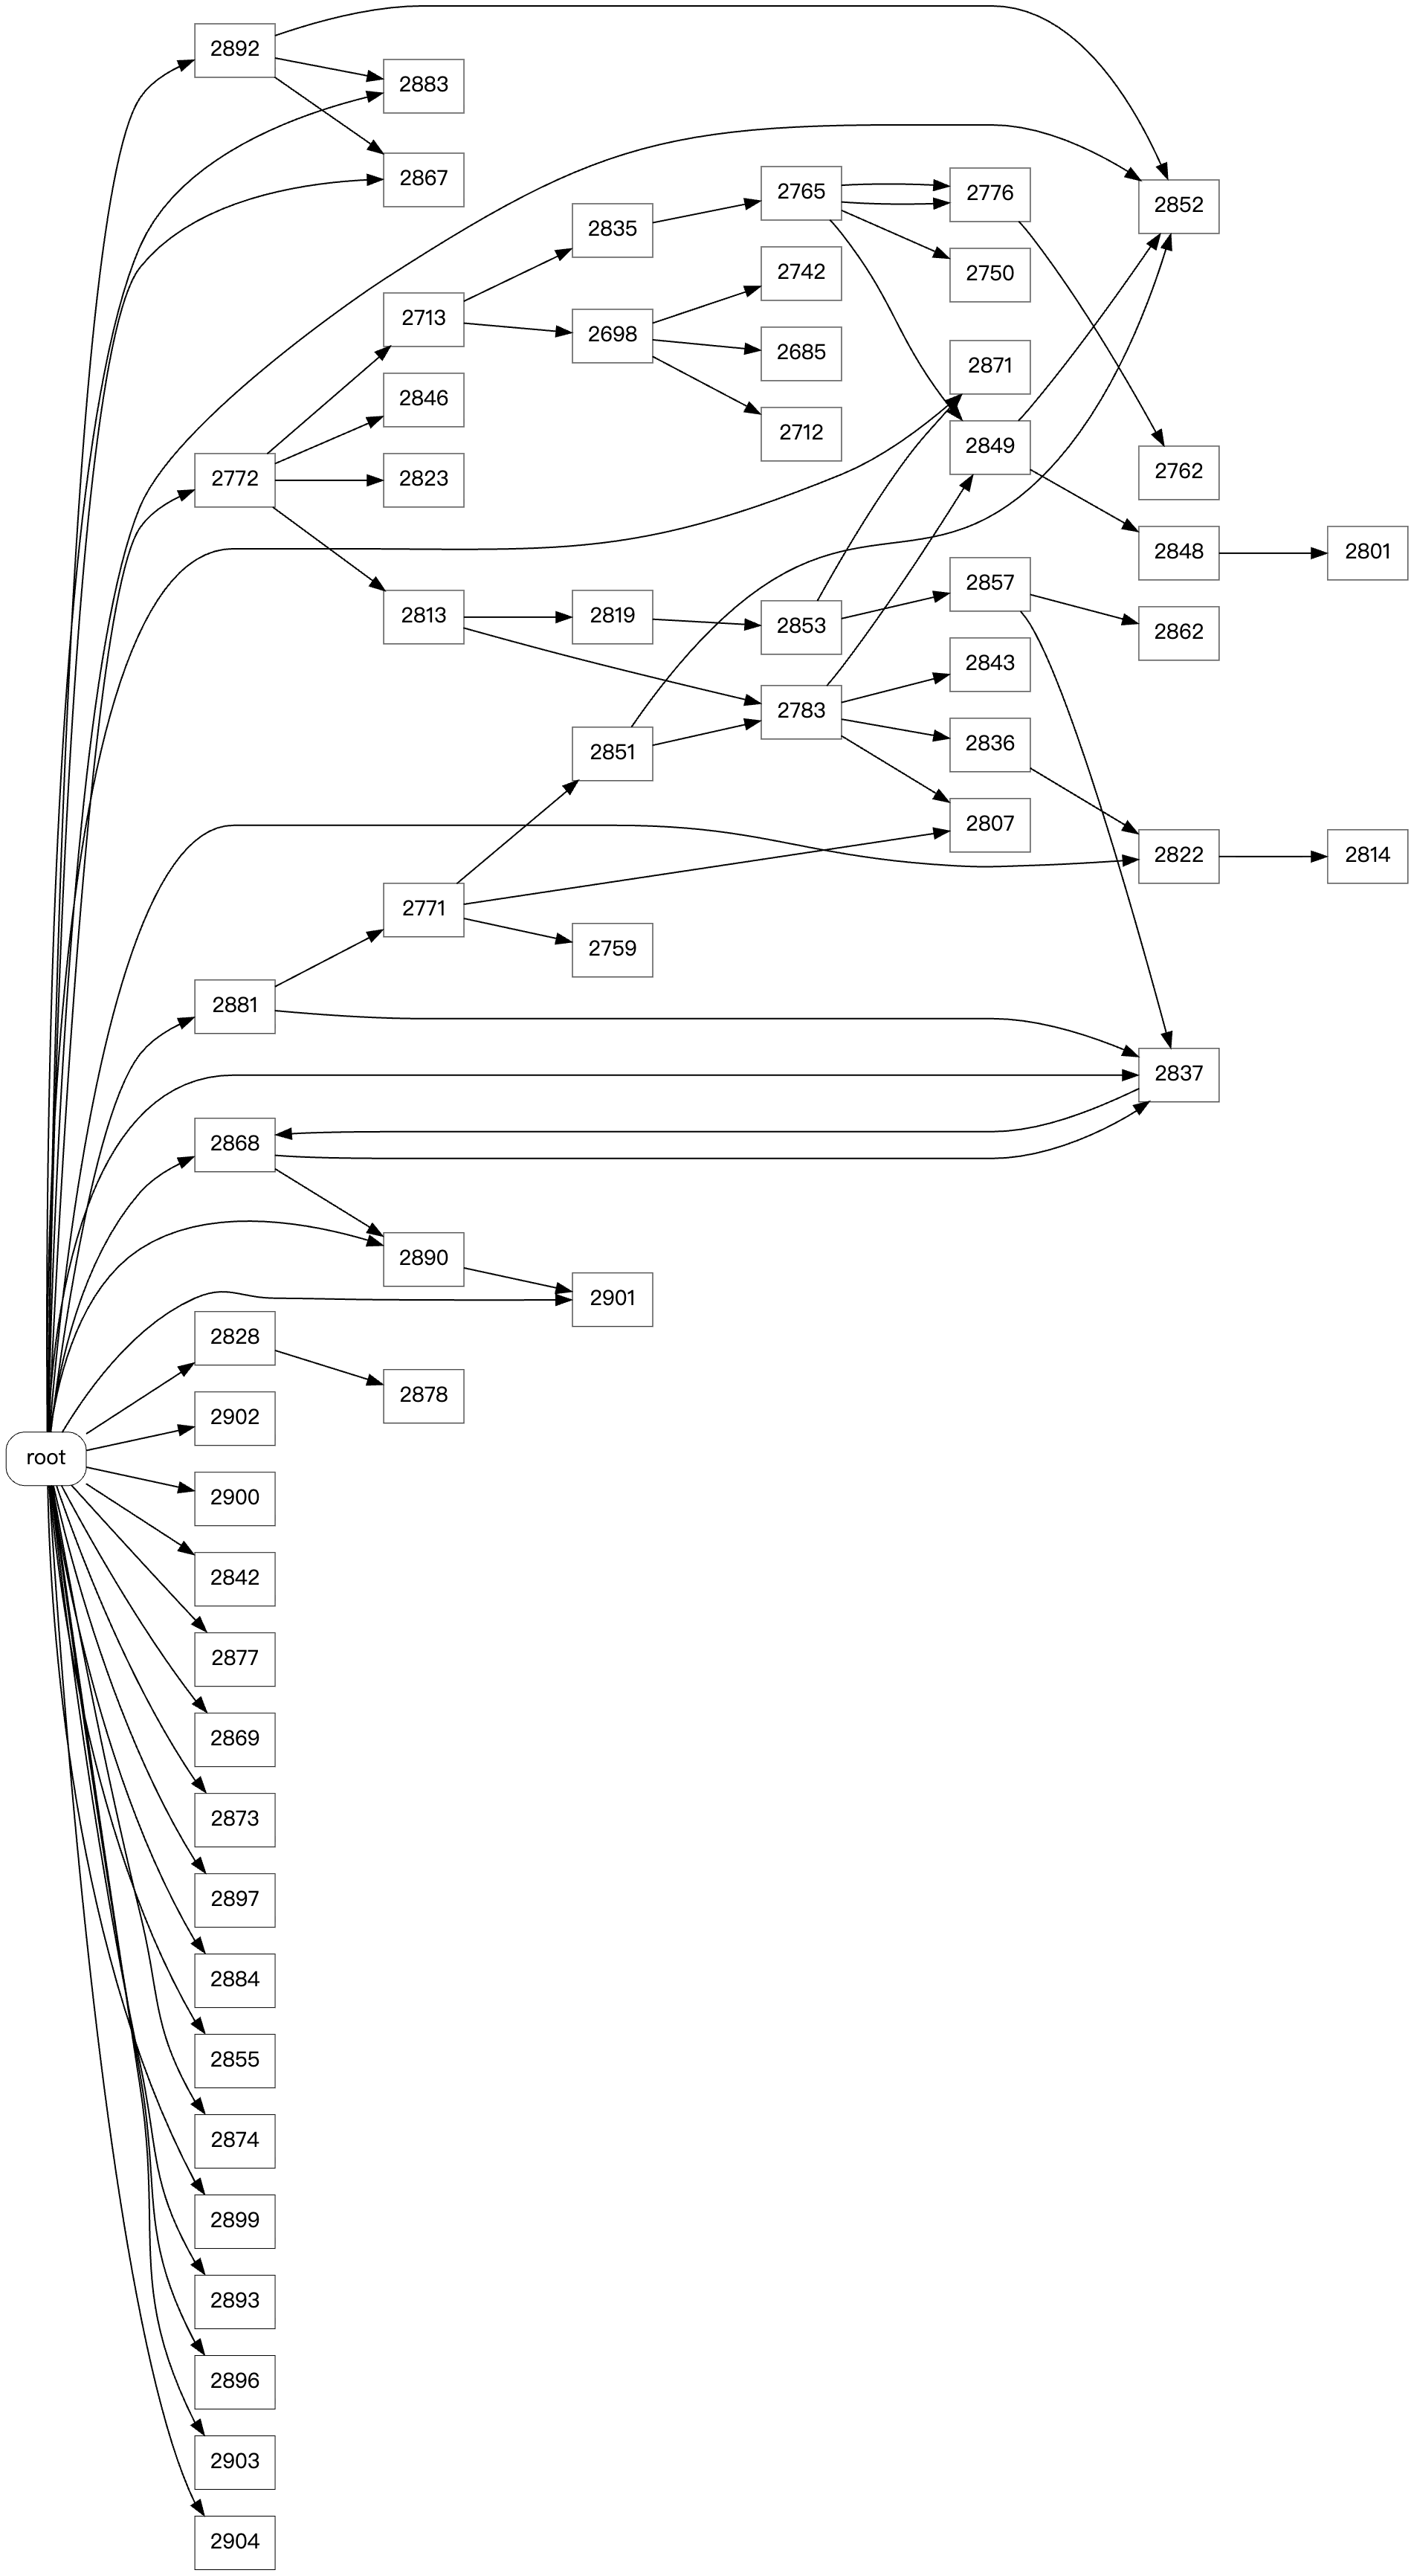
上图展示的是对我的垃圾回收器进行模糊测试的结果,所用方法与我的基准测试相同。