LLM に React を書かせずに生成 UI を届ける方法
Zoominfo のエンジニア Dinesh Keerthipati が、生成 UI の現実的な作り方を語る。LLM に React を書かせず、既存コンポーネントを選ばせて組み合わせ、検証や権限はアプリ側に残す。
日本語
コピー
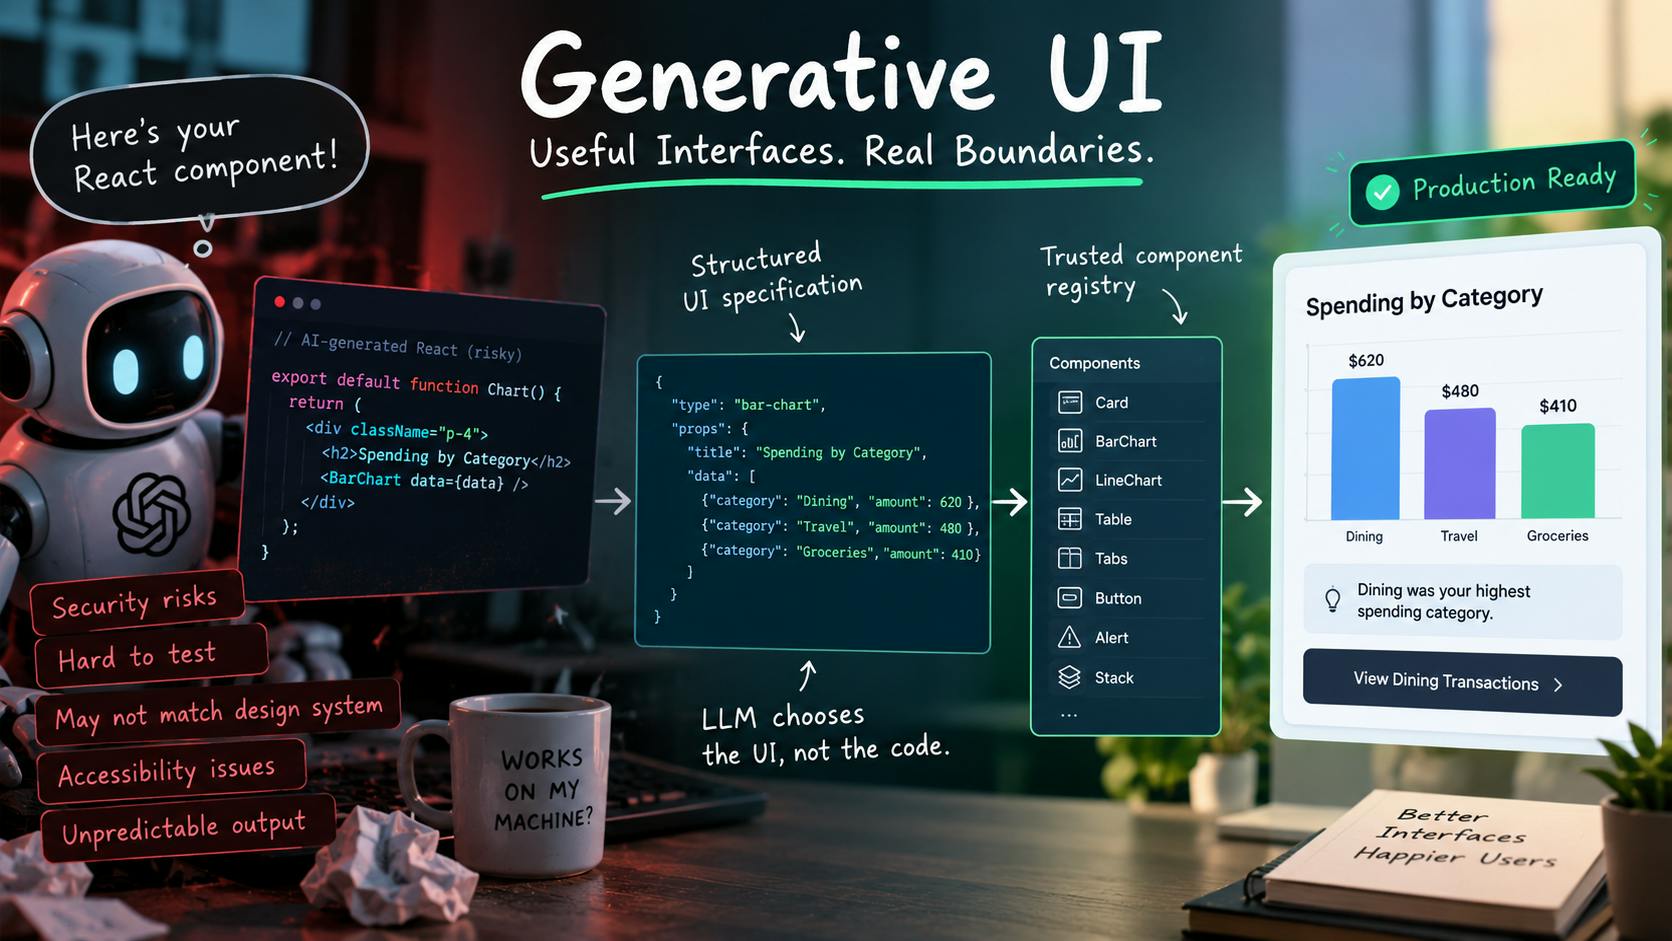
生成UIという言葉を初めて聞いたとき、私が理解したのはこういうものだった。LLMにプロンプトを渡すと、その場でReactコンポーネントを生成してくれる。これに興味を持ったのは、すべてのユーザーに同じUIを見せる必要がなくなる道筋を示してくれたからだ。たとえそのUIが、ユーザーがやりたいことに必ずしも最適でなくても。生成UIなら、同じデータをユーザーの意図に応じて違う形で提示できる。あるユーザーにはシンプルなテキストの回答で十分かもしれないが、別のユーザーには同じデータをグラフや表、インタラクティブな画面で見たほうが理解しやすいかもしれない。ただ、LLMにReactコンポーネントをその場で直接生成させることを考えれば考えるほど、問題点が目につくようになった。テストは難しくなる。モデルが毎回同じ構造やフォーマットを生成するとは期待できないからだ。さらにセキュリティ、アクセシビリティ、テーマ、信頼性、そしてアプリケーションのデザインシステムとの一貫性も気にかかる。生成されたコンポーネントが技術的には動いても、その振る舞いがプロダクトの想定から外れているかもしれない。生成UIを実装する現実的な方法は、モデルに任意のReactコンポーネントを直接生成させるのではなく、アプリケーションにすでにある信頼済みのコンポーネントを使わせることだ。
モデルにUIを実装させるのではなく、組み合わせさせる
アプリケーションにすでにこういうコンポーネントがあるとしよう。
Card
BarChart
LineChart
Table
Tabs
Button
Alert
Stack
LLMにJSXを書かせる代わりに、モデルは何を表示したいかを記述した構造化データを生成できる。たとえばこうだ。
{
 "type": "bar-chart",
 "props": {
 "title": "Spending by Category",
 "data": [
 { "category": "Dining", "amount": 620 },
 { "category": "Travel", "amount": 480 },
 { "category": "Groceries", "amount": 410 }
 ]
 }
}
アプリケーションはこのレスポンスを信頼済みのReactコンポーネントにマッピングできる。
const componentRegistry = {
 "bar-chart": BarChart,
 table: Table,
 card: Card
};
簡単なレンダラーならこうなる。
function GenerativeUI({ element }: { element: UIElement }) {
 const Component = componentRegistry[element.type];

 if (!Component) {
 return ;
 }

 return ;
}
どんなUIが役に立つかはモデルが決め、コンポーネントの実装方法はアプリが握り続ける。この境界のほうがはるかに安全だと私は考えている。モデルは画面に何が必要かを決められるが、使えるブロックはアプリが管理する。
既製コンポーネントを使うことは、UIが死んでいることを意味しない
このやり方には懸念がある。制約が強すぎるように聞こえるのだ。モデルが既製コンポーネントしか使えないなら、それはUIを生成していると言えるのか。私は言えると思う。モデルは用意された画面から1つ選ぶ必要はなく、既製コンポーネントを新しい構造に組み合わせられる。たとえばこうだ。
Card
 ├── Spending summary
 ├── Bar chart
 └── View transactions action
あるいはこうだ。
Stack
 ├── SummaryCard
 ├── CategoryBreakdown
 └── TransactionTable
レイアウト自体は動的なままでいられる。このリクエストにはグラフ、あのリクエストには表、とモデルが判断できるし、より複雑な回答のために複数のコンポーネントを組み合わせることもできる。私の考えでは、やってはいけないのは新しいグラフの実装をゼロから作ることや、任意のJavaScriptを生成してアプリ内で直接動かすことだ。これでモデルに柔軟性を与えつつ、UIシステムの制御は手放さずに済む。
すべての回答がグラフになるべきではない
生成UIは、AIの回答をすべて可視化された画面に変えることではない。ユーザーがこう尋ねたとしよう。
今月いちばん大きい取引は?
答えがこれなら、
今月いちばん大きい取引は Example Airlines の $1,240 です。
プレーンテキストで十分だろう。グラフを足しても複雑さが増すだけで、得られる価値は限られている。だがユーザーがこう尋ねたらどうか。
今月はどのカテゴリにいちばん使った?
こちらのほうが視覚的な比較が役に立つ。棒グラフのほうが、文章よりも速く答えを伝えられるかもしれない。だから目指すべきはこうではない。
AI response
 ↓
Generate visual UI
もっとこうに近い。
Understand user intent
 ↓
Choose useful representation
 ↓
Text / Table / Chart / Form / Composite UI
最適なUIは、ユーザーが何を理解したいのか、何をしたいのかによって変わる。
生成する前に、まず明確にする
この質問を見てほしい。
今月、お金をいちばん使ったのはどこ?
この質問は曖昧だ。ユーザーが指しているのは、
- カテゴリ別か?
- 店舗別か?
- それとも単体でいちばん大きい取引か?
モデルは勝手に仮定して、きれいなグラフを生成できる。だが仮定が間違っていれば、画面は役に立つように見えて、実際には間違った問いに答えていることになる。もっと良いのは、まず文脈を尋ねることだと思う。たとえばこうだ。
Do you mean:

• Spending by category
• Spending by merchant
• Your largest individual transaction
ユーザーが明確にした後なら、システムにはより適切な提示方法を選ぶだけの情報がある。これは Generative UI のかなり重要な部分だと私は考えている。会話を置き換えるのではなく、会話を活かしてより良いUIの判断をするのだ。
モデルは提示方法をどう選ぶべきか
ここでLLMに無限の自由を与えるべきだとも思わない。プロダクションアプリはルールと許可されたパターンを定義できる。たとえばこうだ。
Single fact
 ↓
Text

Exact values across multiple items
 ↓
Table

Category comparison
 ↓
Bar chart

Trend over time
 ↓
Line chart
モデルはこれらのルールとユーザーの意図を組み合わせて、いちばん役に立つ提示方法を選べる。たとえばこうだ。
"Compare my spending categories"
 ↓
Bar chart

"Give me the exact amount for each category"
 ↓
Table

"Show the biggest categories and explain the change"
 ↓
Summary + Chart + Explanation
これでモデルに一定の自由を与えつつ、出力をアプリが想定できる範囲に収められる。
デザインシステム全体を露出させない
実際のアプリには何百ものコンポーネントがあるかもしれない。モデルがそのすべてにアクセスする必要はないと私は考える。AI生成の体験に適した、絞り込んだコンポーネント群だけを露出させる。たとえばこうだ。
Card
Table
BarChart
LineChart
Tabs
Alert
Button
Form
Stack
金融アプリならドメイン固有のコンポーネントも露出させられる。
TransactionTable
SpendingSummary
CategoryBreakdown
AccountCard
食事プランニングアプリならこうだ。
MealPlan
RecipeCard
ShoppingList
NutritionSummary
コンポーネントカタログが小さければ、システム全体を把握しやすく、検証もしやすい。モデルが、生成体験に使うはずのないコンポーネントを選んでしまう確率も下がる。モデルには有用なUIを作るのに十分なビルディングブロックを与えるべきだが、内部のデザインシステム全体を渡す必要はない。
モデルの出力は信頼できない入力として扱う
モデルが構造化されたUI記述しか出力しないとしても、それをそのままレンダリングすることはしない。出力には検証が必要だ。たとえば:
const result = uiSchema.safeParse(modelOutput);

if (!result.success) {
 return fallbackResponse;
}
モデルがサポートしていないコンポーネントを要求してきたら、アプリは安全に失敗すべきだ。
const Component = componentRegistry[element.type];

if (!Component) {
 return ;
}
フォールバックはプレーンテキストでもいいし、エラー表示でも、サポート済みのコンポーネントで再試行するのでもいい。重要なのは、モデルの出力をデータとして扱い、信頼できるアプリケーションコードとは見なさないことだ。そうすれば、アプリが安全境界として機能し続ける。モデルはUIや操作を提案できるが、通常のアプリ権限と検証は引き続き有効でなければならない。
すべてのユーザー操作がモデルの再呼び出しを必要とするわけではない
生成されたUIがこうなっているとしよう:
Spending by Category

Dining $620
Travel $480
Groceries $410

[View Dining Transactions]
[Explain Dining Increase]
この2つの操作は画面上では似て見えるが、扱いを同じにする必要は必ずしもない。ユーザーがクリックしたのが餐饮取引を表示なら、アプリは何をすべきかすでに分かっている。現在のデータをフィルタするか、普通のAPIリクエストを送ればいい。
function viewDiningTransactions() {
 filterTransactions({
 category: "Dining"
 });
}
これをLLMに任せる理由はどこにもない。だがユーザーがクリックしたのが餐饮支出の増加を説明なら、これは解釈が必要だ。こういうときこそモデルを呼び直す合理的な理由がある。
function handleAction(action: Action) {
 if (action.type === "view-transactions") {
 filterTransactions(action.category);
 return;
 }

 if (action.type === "explain-spending") {
 sendToAgent(action);
 }
}
ここからシンプルなルールが導ける:
LLMは知性が必要なときに使う。UIがAI生成だからという理由で使うのではない。
決定的な操作は決定的なままにしておくべきだ。アプリはテストしやすくなり、通常のUI操作に不要なモデル呼び出しを混ぜ込むことも避けられる。
このアーキテクチャから始めるなら
まとめると、私はこういうアーキテクチャから始める:
User
 ↓
LLM / Agent
 ↓
Understand intent
 ↓
Structured UI Spec
 ↓
Schema validation
 ↓
Component Registry
 ↓
Trusted React UI
モデルはこんなものを返してくるかもしれない:
{
 "elements": [
 {
 "type": "text",
 "content": "Dining was your highest spending category."
 },
 {
 "type": "bar-chart",
 "props": {
 "title": "Spending by Category",
 "data": [
 { "category": "Dining", "amount": 620 },
 { "category": "Travel", "amount": 480 },
 { "category": "Groceries", "amount": 410 }
 ]
 }
 }
 ]
}
アプリはこの構造を検証し、サポート済みのコンポーネントだけをレンダリングする。私に言わせれば、これもGenerative UIだ。モデルは次にどんな体験が現れるべきかを決めるが、フロントエンドアーキテクチャを迂回してはいない。
難しいのはReactのレンダリングではない
実際にReactでレンダリングする部分は、おそらく最も簡単な工程のひとつだ。:
{
 "type": "bar-chart"
}
を:
にマッピングするのは難しくない。難しい問題はすべて境界で起きる。モデルが存在しないコンポーネントを要求したら? propsがschemaに合わなかったら? ユーザーに操作の権限がなかったら? 選ばれた可視化が有効だが誤解を招くものだったら? 異なる生成の組み合わせをどうテストする? アクセシビリティをどう保証する? コンポーネントが進化し続けるなかで、UI schemaのバージョンはどう管理する? どのコンポーネントをモデルに開放すべきかはどう決める? ここがGenerative UIを面白いと感じる理由だ。LLMにReactを書かせるだけの話ではなく、確率モデルと決定的なフロントエンドシステムのあいだの、まったく新しい相互作用なのだ。
私の考えが最終的に落ち着いた先
Generative UIに対する私の最初の理解は単純だった:
LLMにpromptを与え、その場でReactコンポーネントを生成させる。
ユーザーに合わせてインターフェースが動的に適応するというアイデアは今でも好きだが、コンポーネントを無制限に生成することが本番環境の適切な境界だとは思わない。むしろ、ユーザーがどんな体験を必要としているかはモデルに決めさせ、実際のコンポーネント、検証、権限、アクセシビリティ、実行はアプリが握るほうがいい。モデルはフロントエンドを置き換えているのではなく、ユーザーが次にどんなフロントエンド体験を必要としているかを判断する手助けをしている。私に言わせれば、これはLLMにReactを書かせるだけよりずっと面白い。