我怎么交付生成式 UI(而不让 LLM 写 React)
Zoominfo 工程师 Dinesh Keerthipati 讲他怎么交付生成式 UI:不让 LLM 直接写 React,而是让它从已有组件里挑选与组合,把校验、权限与无障碍留在应用侧。
中文
复制
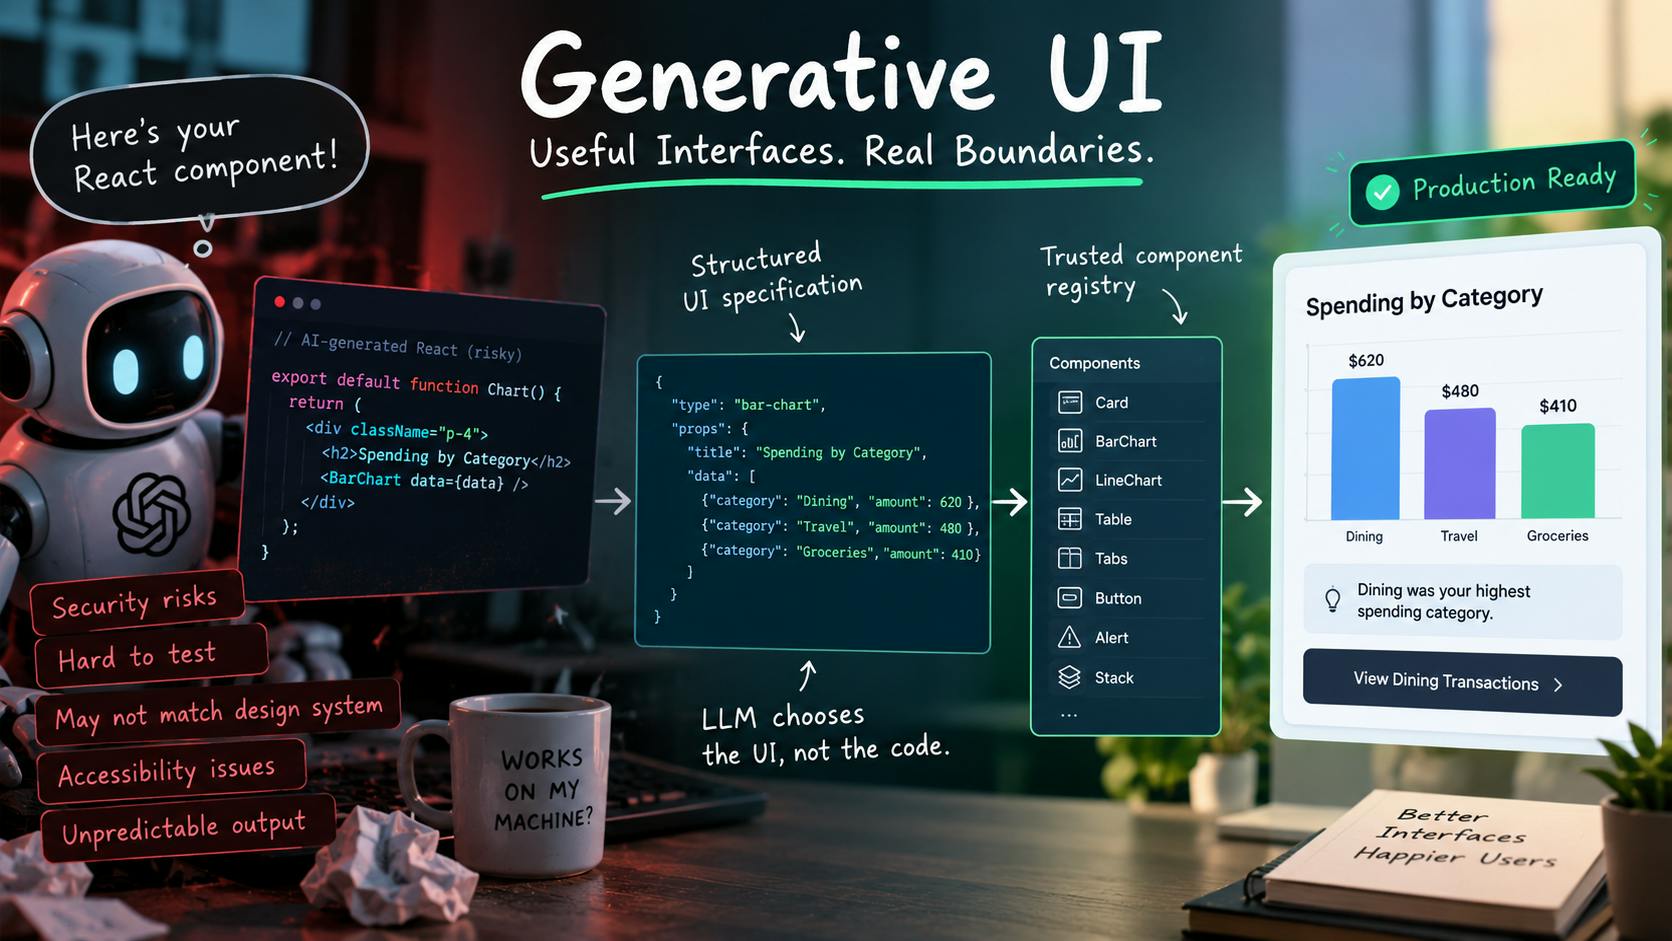
第一次听说生成式 UI 时,我的理解是:你给 LLM 一个提示,它就能即时生成 React 组件。这让我对生成式 UI 产生了兴趣,因为它提供了一条途径,让我们不再向每个用户展示同样的 UI——哪怕那套 UI 未必最适合他们想做的事。有了生成式 UI,同一份数据可以根据用户的意图以不同方式呈现。一个用户可能只需要一段简单的文字回答,而另一个用户可能用图表、表格或交互界面来理解同一份数据会更好。但我越是琢磨让 LLM 直接即时生成 React 组件这件事,看到的问题就越多。测试变得更难,因为我们不能指望模型每次都生成相同的结构或格式。此外还有安全、无障碍、主题、可靠性,以及与应用程序设计系统一致性方面的顾虑。即便生成的组件在技术上能跑通,它的行为方式也可能不符合产品的预期。实现生成式 UI 的一种务实做法,是让模型使用应用程序中已有的可信组件,而不是直接生成任意的 React 组件。
让模型组合 UI,而不是实现 UI
设想一个应用程序已经有这样的组件:
Card
BarChart
LineChart
Table
Tabs
Button
Alert
Stack
与其让 LLM 编写 JSX,模型可以生成一份结构化描述,说明它想展示什么。例如:
{
 "type": "bar-chart",
 "props": {
 "title": "Spending by Category",
 "data": [
 { "category": "Dining", "amount": 620 },
 { "category": "Travel", "amount": 480 },
 { "category": "Groceries", "amount": 410 }
 ]
 }
}
应用程序随后可以把这份响应映射到一个可信的 React 组件。
const componentRegistry = {
 "bar-chart": BarChart,
 table: Table,
 card: Card
};
一个简单的渲染器可以长这样:
function GenerativeUI({ element }: { element: UIElement }) {
 const Component = componentRegistry[element.type];

 if (!Component) {
 return ;
 }

 return ;
}
模型决定什么样的 UI 有用,组件怎么实现仍由应用说了算。在我看来,这条边界安全得多。模型可以决定界面需要什么,但能用哪些积木块,仍然由应用控制。
用现成组件,不等于 UI 是死的
这种做法有一个顾虑:听起来限制太死。如果模型只能用现成组件,那还算是在生成 UI 吗?我认为算。模型不必从预置屏幕里挑一个,它可以把现成组件组合成新的结构。比如:
Card
 ├── Spending summary
 ├── Bar chart
 └── View transactions action
或者:
Stack
 ├── SummaryCard
 ├── CategoryBreakdown
 └── TransactionTable
布局本身依然可以是动态的。模型可以判断这个请求该配图表、那个请求该配表格,也可以为更复杂的回答组合多个组件。在我看来,它不该做的是凭空造一套新的图表实现,或者生成任意 JavaScript 直接在应用里跑。这样既给了模型灵活性,又没有交出 UI 系统的控制权。
不是每个回答都该变成图表
生成式 UI 不该意味着把每个 AI 回答都变成可视化界面。假设用户问:
我这个月最大的一笔交易是什么?
如果答案就是:
你最大的一笔交易是 $1,240,在 Example Airlines。
那纯文本大概就够了。加个图表只会增加复杂度,价值却有限。但如果用户问的是:
我这个月哪几类花得最多?
那可视化对比就更有用。柱状图可能比一段文字更快把答案说清楚。所以目标不该是:
AI response
 ↓
Generate visual UI
而应该更接近:
Understand user intent
 ↓
Choose useful representation
 ↓
Text / Table / Chart / Form / Composite UI
最好的 UI 取决于用户想弄明白什么、想做什么。
先澄清,再生成
看这个问题:
我这个月钱花在哪儿最多?
这个问题有歧义。用户指的是:
- 按类别?
- 按商家?
- 还是单笔最大的那笔交易?
模型可以自行假设,然后生成一张漂亮的图表。但如果假设错了,界面看起来有用,回答的却是错误的问题。我觉得更好的做法是先追问更多上下文。例如:
Do you mean:

• Spending by category
• Spending by merchant
• Your largest individual transaction
用户澄清之后,系统就有足够的信息去选择更合适的呈现方式。在我看来,这是 Generative UI 很重要的一部分。它不应该取代对话,而应该借助对话做出更好的 UI 决策。
模型该如何选择呈现方式?
我也不认为 LLM 在这里应该拥有无限的自由。生产应用可以定义规则和允许的模式。例如:
Single fact
 ↓
Text

Exact values across multiple items
 ↓
Table

Category comparison
 ↓
Bar chart

Trend over time
 ↓
Line chart
模型可以结合这些规则和用户意图,选择最有用的呈现方式。例如:
"Compare my spending categories"
 ↓
Bar chart

"Give me the exact amount for each category"
 ↓
Table

"Show the biggest categories and explain the change"
 ↓
Summary + Chart + Explanation
这样既给了模型一定的自由,又能把输出限制在可预期的应用边界之内。
不要暴露整个设计系统
真实应用可能有几百个组件。我不认为模型需要访问全部组件。我会只暴露一组经过筛选、适合 AI 生成体验的组件。例如:
Card
Table
BarChart
LineChart
Tabs
Alert
Button
Form
Stack
金融应用还可以暴露领域特定的组件:
TransactionTable
SpendingSummary
CategoryBreakdown
AccountCard
膳食规划应用可以暴露:
MealPlan
RecipeCard
ShoppingList
NutritionSummary
更小的组件目录让系统更容易推理和验证,也降低了模型选中那些本不打算用于生成体验的组件的概率。模型应该拿到足够多的构建块来做出有用的界面,但不必拿到整个内部设计系统。
模型输出应当作不可信输入处理
即使模型只产出结构化的 UI 描述,我也不会直接渲染。输出仍然需要校验。例如:
const result = uiSchema.safeParse(modelOutput);

if (!result.success) {
 return fallbackResponse;
}
如果模型请求了不支持的组件,应用应当安全失败。
const Component = componentRegistry[element.type];

if (!Component) {
 return ;
}
兜底方案可以是纯文本、错误提示,或者用受支持的组件再试一次。关键在于,模型输出应当被当作数据,而不是可信的应用代码。这也让应用继续充当安全边界。模型可以建议 UI 或操作,但正常的应用权限和校验依然要生效。
并非每次用户操作都需要再次调用模型
假设生成的 UI 长这样:
Spending by Category

Dining $620
Travel $480
Groceries $410

[View Dining Transactions]
[Explain Dining Increase]
这两个操作在界面上看起来差不多,但处理方式未必应该一样。如果用户点击的是:查看餐饮交易,应用已经知道该做什么。它可以筛选当前数据,或者发一个普通的 API 请求。
function viewDiningTransactions() {
 filterTransactions({
 category: "Dining"
 });
}
没有任何理由把这件事再交给 LLM。但如果用户点击的是:解释餐饮支出增长,这就需要解读了。这才是重新调用模型的合理理由。
function handleAction(action: Action) {
 if (action.type === "view-transactions") {
 filterTransactions(action.category);
 return;
 }

 if (action.type === "explain-spending") {
 sendToAgent(action);
 }
}
由此得到一条简单的规则:
需要智能的时候才用 LLM,而不是因为 UI 是 AI 生成的就要用。
确定性操作就该保持确定性。这样应用更容易测试,也避免在正常的 UI 交互中掺入不必要的模型调用。
我会从这套架构开始
把这些放在一起,我会从这样一套架构开始:
User
 ↓
LLM / Agent
 ↓
Understand intent
 ↓
Structured UI Spec
 ↓
Schema validation
 ↓
Component Registry
 ↓
Trusted React UI
模型可能返回类似这样的东西:
{
 "elements": [
 {
 "type": "text",
 "content": "Dining was your highest spending category."
 },
 {
 "type": "bar-chart",
 "props": {
 "title": "Spending by Category",
 "data": [
 { "category": "Dining", "amount": 620 },
 { "category": "Travel", "amount": 480 },
 { "category": "Groceries", "amount": 410 }
 ]
 }
 }
 ]
}
应用校验这个结构,只渲染受支持的组件。在我看来,这仍然算 Generative UI。模型决定接下来该出现什么样的体验,但它没有绕开前端架构。
难的部分不是渲染 React
真正用 React 渲染,大概是最简单的环节之一。把:
{
 "type": "bar-chart"
}
映射成:
没什么难度。更难的问题都出在边界上。模型请求了一个不存在的组件怎么办?props 不符合 schema 怎么办?用户没有权限执行某个操作怎么办?选中的可视化有效但会误导人怎么办?怎么测试不同的生成组合?怎么保证无障碍?组件不断演进时,UI schema 怎么管理版本?怎么决定哪些组件应该开放给模型?这些才是我觉得 Generative UI 有意思的地方。它不只是让 LLM 生成 React,而是概率模型与确定性前端系统之间的一种全新互动。
我的思考最终落到了哪里
我最初对 Generative UI 的理解很简单:
给 LLM 一个 prompt,让它即时生成 React 组件。
让界面动态适应用户这个想法我依然喜欢,但我不认为无限制地生成组件是合适的生产边界。我更愿意让模型决定用户需要什么样的体验,而由应用来掌控实际的组件、校验、权限、无障碍和运行。模型不是在取代前端,它是在帮忙判断用户接下来需要什么样的前端体验。在我看来,这比单纯让 LLM 写 React 有意思得多。
来源: HackerNoon← 返回首页