Shopify がオープンモデルをタスクの専門家に育てる方法
Shopify の Sidekick は最もトークンを消費する作業を自社でポストトレーニングしたオープンモデルに任せている。GraphQL サブエージェントを調整済みの Nemotron 3.5 Lightning に置き換えたところ、スコアはフロンティアモデルをわずかに上回り、7 倍速く、コストは約 9 割削減された。
日本語
コピー
Sidekick は Shopify の AI コマースアシスタントだ。フロンティアモデルの上で動いており、そのモデルが加盟店と対話し、タスクを計画し、ツールを呼び出す。ゴールがはっきりした作業では、タスクをサブエージェントに委ねる。そのうちいくつかは、単一タスク向けにポストトレーニングした自社のオープンモデルで動いている。
GraphQL サブエージェントを例に取る。加盟店が「在庫切れが近い商品はどれ?」と尋ねると、Shopify の API schema を読み、ドキュメントを検索し、クエリを書いて実行し、結果を返す。この種の作業はコンテキストの消費が大きい。サブエージェントが 1 トークン出力するたびに約 40 トークンを読み込むことになり、フロンティアモデルの API はトークンごとに課金される。
このサブエージェント向けに NVIDIA Nemotron 3.5 Lightning をポストトレーニングし、タスク特化モデルを作った。このタスクでのスコアはフロンティアモデルをわずかに上回り、応答は 7 倍速く、提供コストは約 90% 低い。しかもポストトレーニング後の重みは Shopify の手元にあり、自社の GPU でデプロイでき、変更のタイミングも自分たちで決められる。
これらのモデルを構築するループは、Sidekick の継続学習ループそのものだ。違うのはハードウェア側の工夫がひとつ加わった点だけだ。
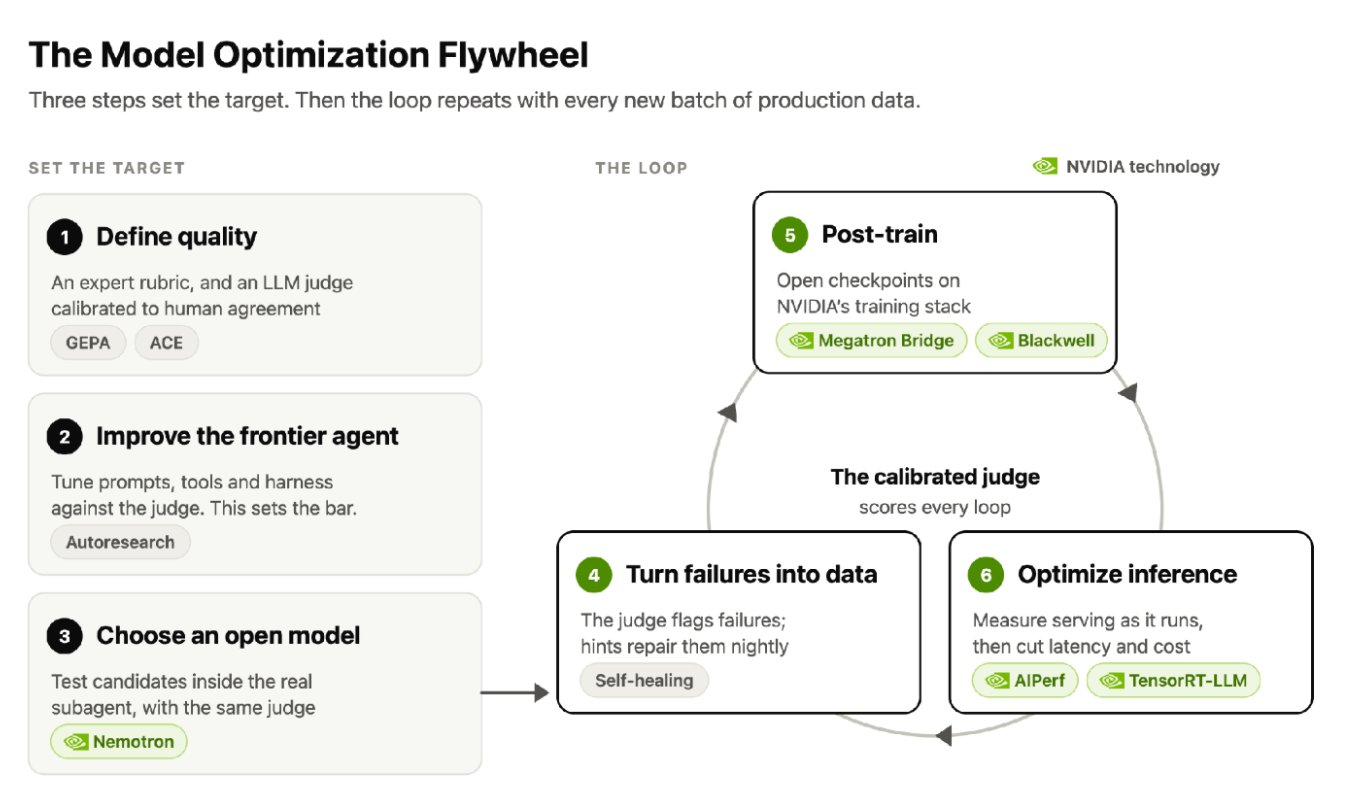
タスクの専門家は全員、同じ手順を踏む。
品質を定義する
プロダクトの専門家が要件を採点基準のセットに落とし込む。GraphQL の場合、基準は完全性、実行状況、応答品質をカバーする。同じ会話群に対して 2 人の専門家の判断がどれだけ一致するかで、ベースラインを定める。さらに GEPA と ACE のオプティマイザで LLM judge を調整し、ホールドアウトした人手アノテーションと一致するまで仕上げる。以降、この judge があらゆるエージェントの変更、あらゆる候補モデル、あらゆる学習実行を採点する。
フロンティアのエージェントを限界まで追い込む
オープンモデルが登場する前に、エージェントのフロンティアモデル版を可能な限り限界まで追い込む。autoresearch のループは一度に 1 カ所だけ小さな変更を提案する。プロンプト、ツールの説明、制御フローのいずれかで、judge のスコアが上がったときだけ採用する。改良後のエージェントが、オープンモデルが越えなければならない基準になる。
オープンモデルを選ぶ
事前学習はしない。NVIDIA Nemotron のようなオープンモデルを実際のサブエージェントに組み込み、ツールも judge も本番と同じ構成でテストする。そのうえで初期品質、サービング速度、NVIDIA Megatron Bridge でのサポート状況を総合的に比較検討する。学習に使っているのは Megatron Bridge そのものだ。GraphQL では Nemotron 3.5 Lightning を選んだ。300 億パラメータのうちトークンごとに 30 億を活性化する MoE モデルである。
推論を最適化する
サービング性能は最初から測る。本番に載せられないほど遅いモデルは、ポストトレーニングに取り組む価値がないからだ。各ワークロードは NVIDIA AIPerf でベンチマークする。NVIDIA Dynamo に含まれるオープンソースの負荷テストツールで、合成テキストで本番トラフィックを再生し、顧客データには触れない。Shopify はリアルタイム応答の再生への対応を貢献しており、マルチターンのテストでも本番と同じようにサーバーのプレフィックスキャッシュをヒットさせられる。
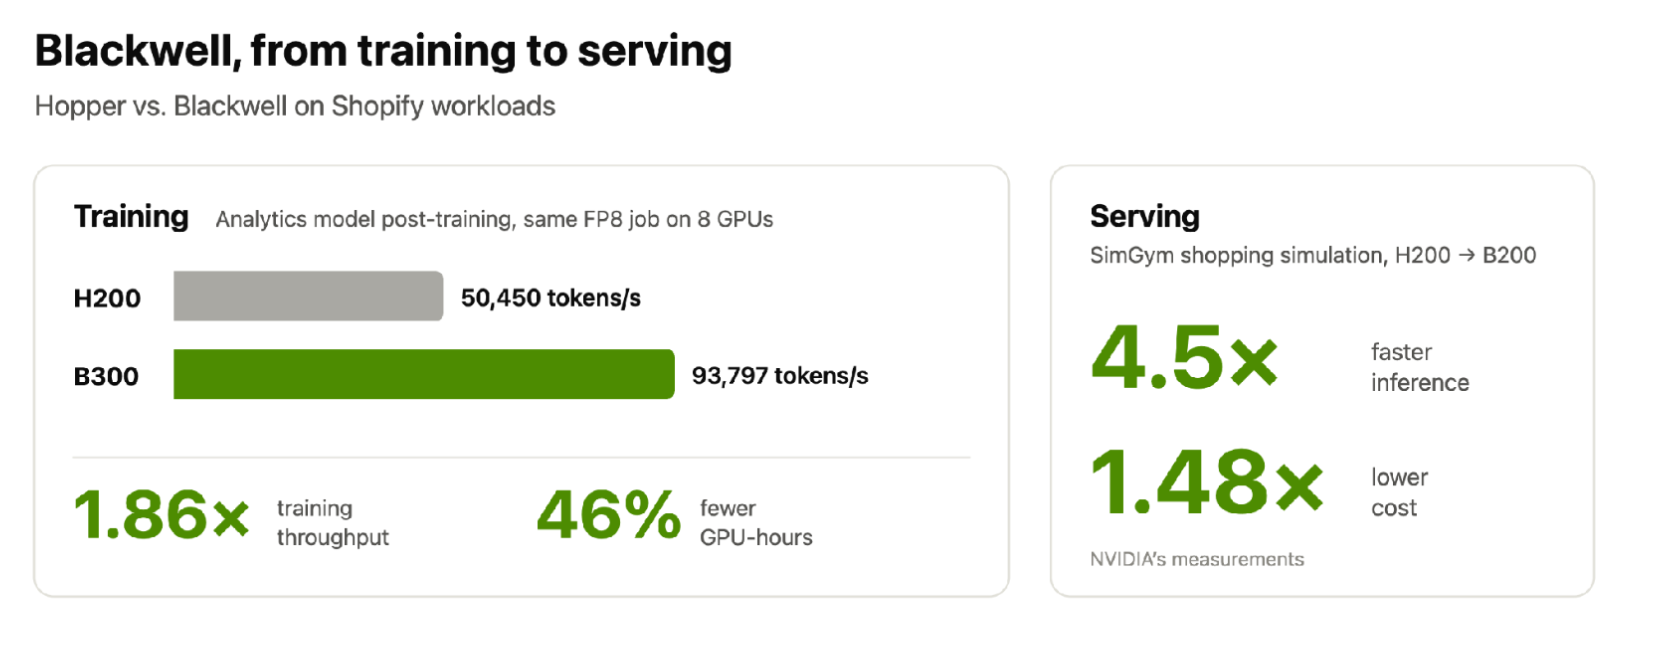
この測定結果が、どのサービングスタックを選ぶかを決める。Buyer Profile はバッチ処理のタスクで、AIPerf で vLLM、SGLang、NVIDIA TensorRT-LLM を比較したところ、GPU あたりの処理量が最も多かったのは TensorRT-LLM だった。NVIDIA の測定では、ショッピングシミュレータの SimGym が Blackwell B200 上で H200 上の 4.5 倍高速、コストは 1.48 分の 1 になる。
失敗を学習データに変える
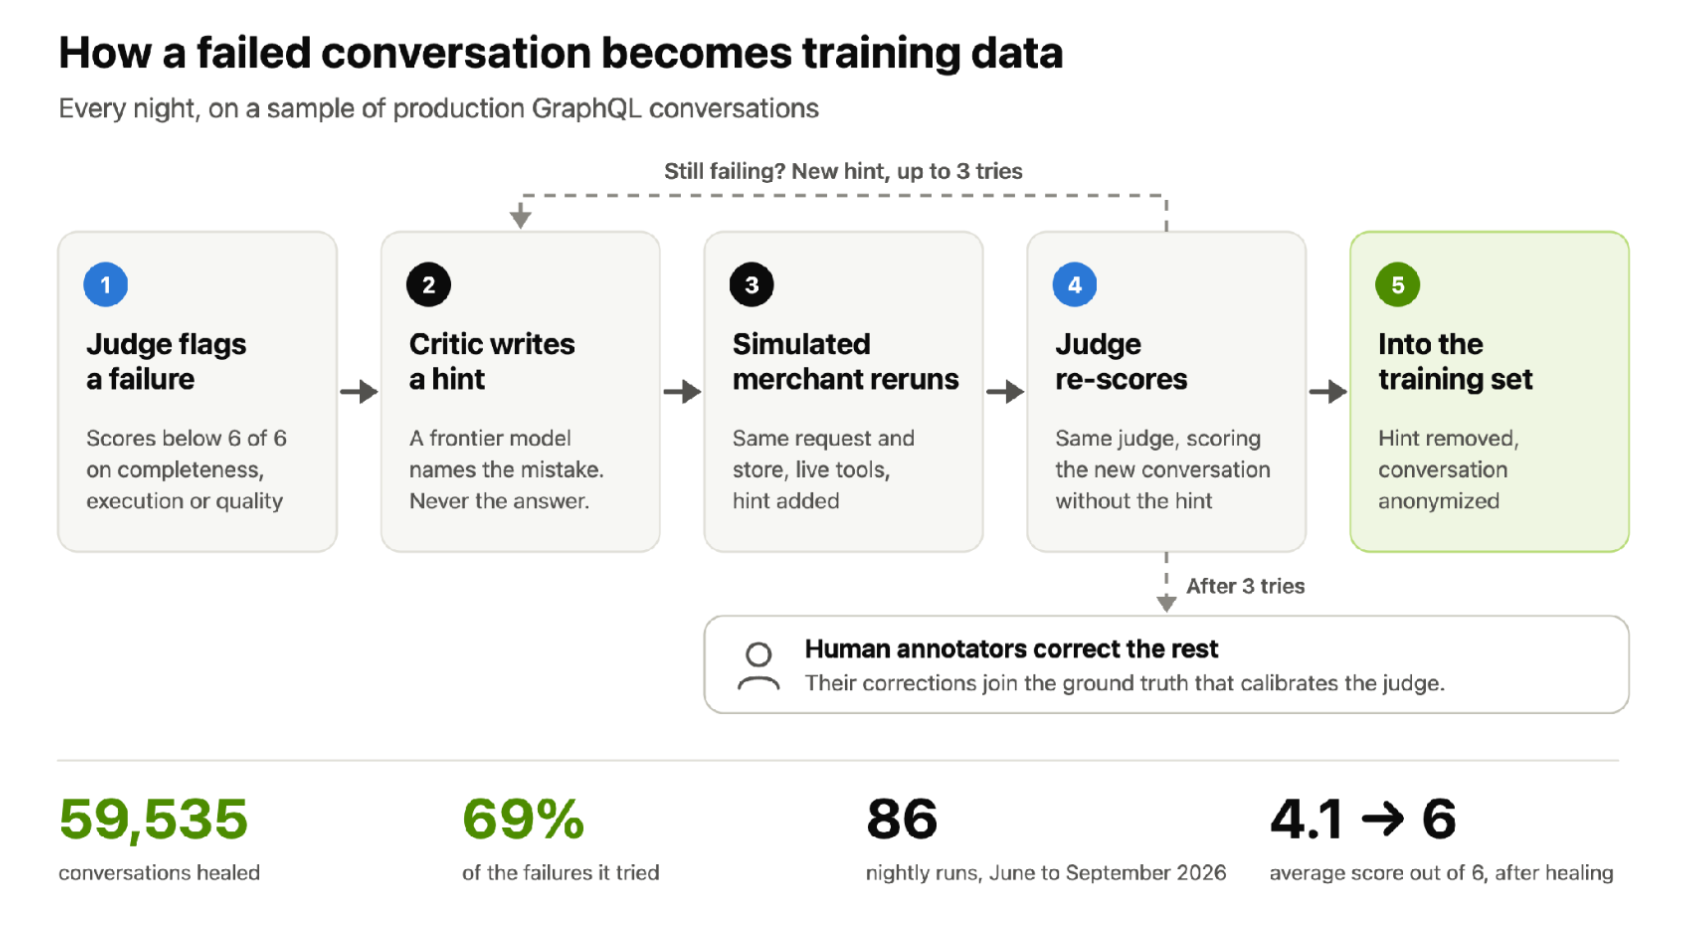
毎晩、judge が本番環境の GraphQL 会話をサンプリングして採点し、完璧でないものを自己修復フローに回す。critic として動くフロンティアモデルはプロンプトだけを書き、答えは書かない。そのプロンプトを模擬の加盟店に持たせ、同じ店舗に対して同じリクエストを再実行させる。judge が再実行を合格と判定すれば、プロンプトを削除し、会話を匿名化してから訓練データに加える。不合格なら critic がもう一度試す。最大 3 回まで。
直近の夜間実行 86 回で、自己修復は GraphQL 会話 59,535 件を修正した。これは処理を試みた失敗ケースの 69% にあたる。残りは人手のアノテーターが直し、その修正は judge のキャリブレーションに使う ground truth に取り込まれる。
Blackwell でのポストトレーニング
ポストトレーニングには NVIDIA Megatron Bridge を使う。標準的な Hugging Face checkpoint を NVIDIA の Megatron Core 訓練ライブラリに接続でき、モデルを書き直す必要はない。Nebius 上でノードをまたいでスケールするときも、変えるのは設定だけでコードは触らない。Blackwell はループの各周回を安くする。Analytics モデルの同一の FP8 ポストトレーニングジョブで、B300 8 基の訓練速度は H200 8 基の 1.86 倍、GPU 時間は 46% 少なかった。その後 judge が新しい checkpoint を採点し、ループがまた始まる。
GraphQL での実験結果
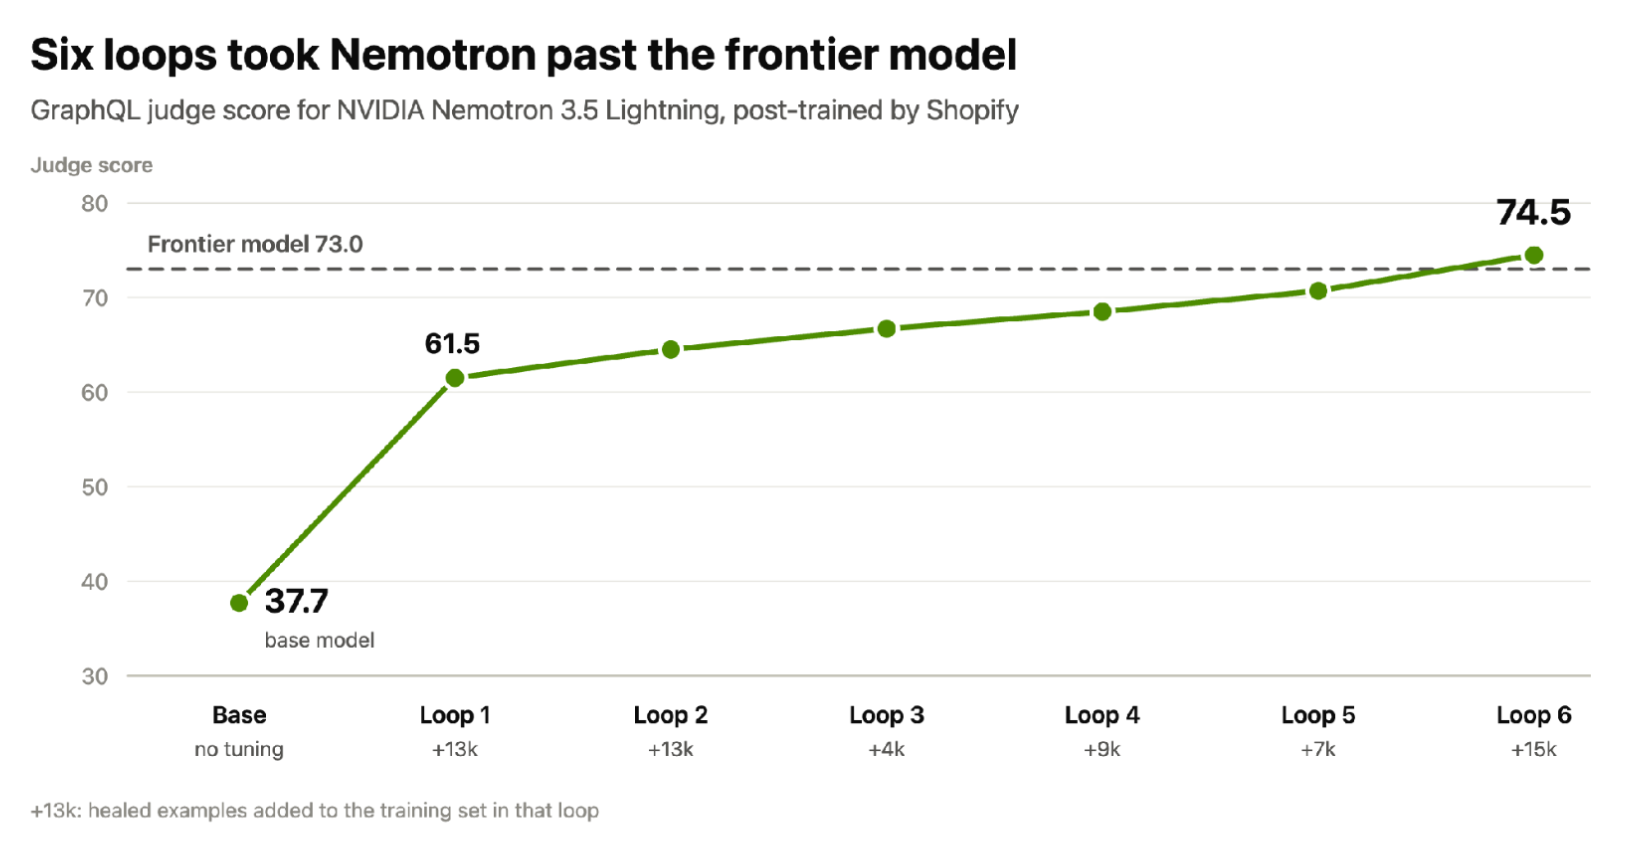
Nemotron 3.5 Lightning をそのまま使うと、私たちの GraphQL 評価では 37.7 点だった。フロンティアモデルは 73 点。1 回目のループで 61.5 点まで上がり、6 回のループで 61,000 件のサンプルを修正したあと、ポストトレーニングしたモデルは 74.5 点に達した。
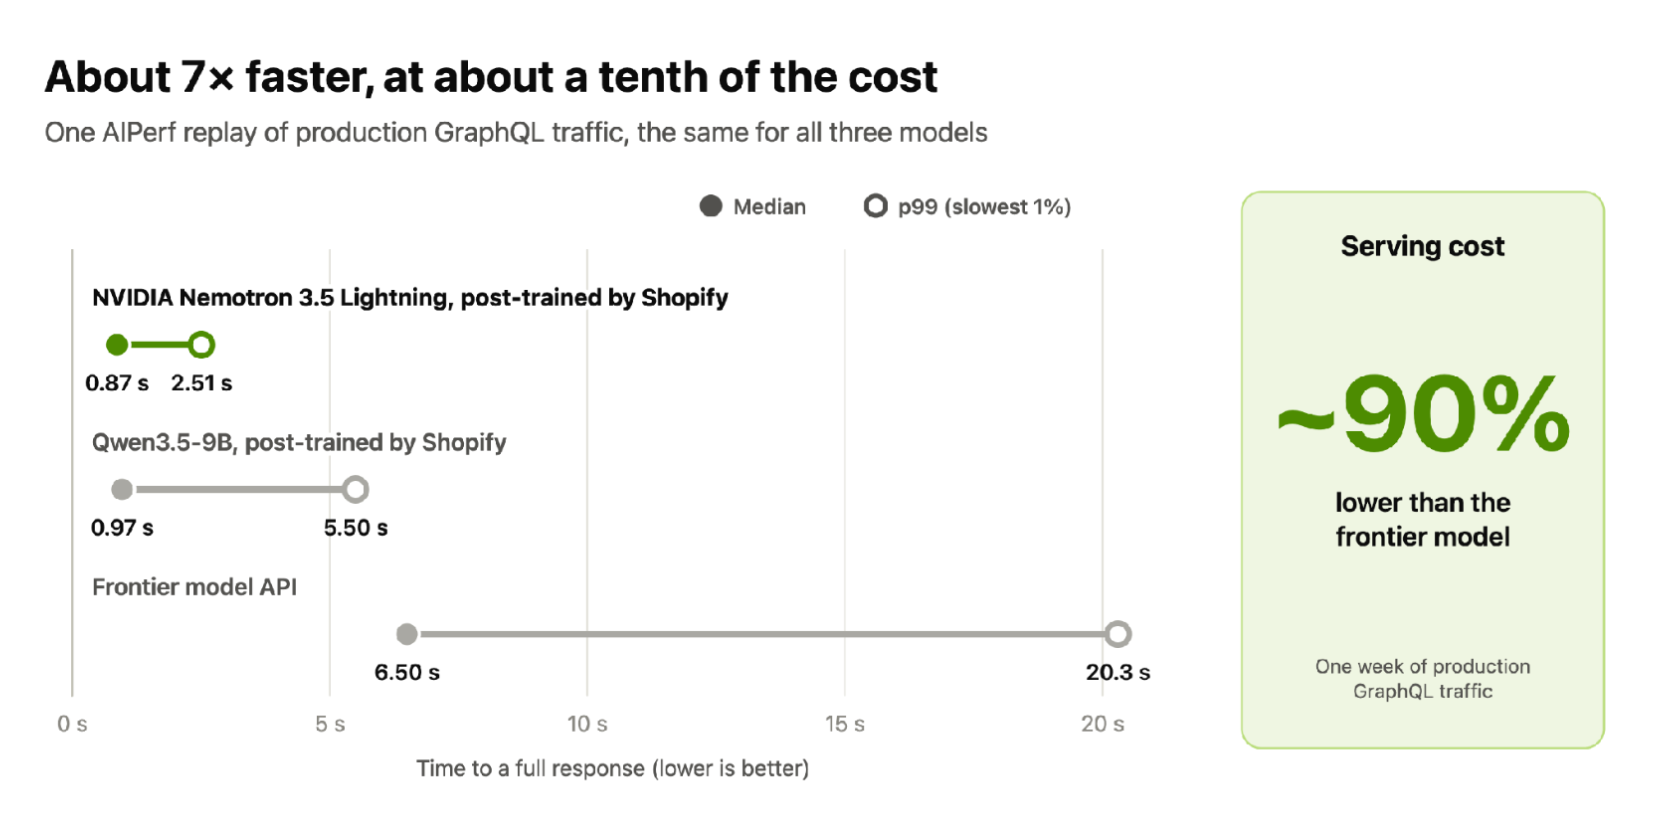
ポストトレーニング済みモデルは速度面でも大きく上回る。AIPerf で本番の GraphQL トラフィックを再生したところ、ポストトレーニング済みの Nemotron が完全なレスポンスを返すまでの中央値は 0.87 秒、フロンティアモデルの API は 6.50 秒だった。最も遅い 1% のリクエストでも 8 倍速い。同程度の規模の別のポストトレーニング済みオープンモデルにも勝っている。中央値はほぼ並ぶが、p99 では 2 倍以上の差をつけた。
このトラフィックにおけるサービングコストはフロンティアモデルより約 90% 低い。ポストトレーニング済みモデル全体で見ると、セルフホストはフロンティアモデルの料金体系と比べてサービングコストを 90〜98% 削減できる。
フロンティアの知能、専門家の効率
フロンティアモデルには得意な仕事を残す。加盟店と対話し、何を呼び出すかを決めることだ。大量のトークンを消費する専門的な処理は自前のオープンモデルに任せる。フライホイールは回るたびに積み上がっていく。人手による修正が judge の精度を上げ、本番トラフィックが訓練データを増やし、NVIDIA ハードウェアとソフトウェアの各世代が次のサイクルをより速く、より安くする。
NVIDIA の Megatron Bridge、AIPerf、TensorRT-LLM、Nemotron の各チーム、CentML チーム(現 NVIDIA)、そして Nebius に感謝する。本稿は NVIDIA GTC Berlin 2026 での講演を再構成したもの。