Shopify 如何把开源模型练成任务专家
Shopify 的 Sidekick 把最费 token 的活交给自己后训练的开源模型,GraphQL 子代理换上调过的 Nemotron 3.5 Lightning 后,判分略超前沿模型,快 7 倍、成本低约九成。
中文
复制
Sidekick 是 Shopify 的 AI 电商助手,它运行在一个前沿模型上,由这个模型与商家对话、规划任务并调用工具。遇到目标明确的工作,它会把任务交给子代理,其中几个子代理运行的是我们针对单一任务后训练的开源模型。
以 GraphQL 子代理为例。商家问“哪些商品快断货了?”,它会读取 Shopify 的 API schema、检索文档、编写并执行查询,然后返回结果。这类工作的上下文开销很大:子代理每写出一个 token,大约要读入 40 个 token,而前沿模型的 API 对每一个 token 都收费。
针对这个子代理,我们后训练了 NVIDIA Nemotron 3.5 Lightning,做出了一个任务专家模型。在这项任务上,它的得分略高于前沿模型,响应速度快 7 倍,服务成本低约 90%。而且后训练后的权重掌握在 Shopify 手里,我们可以用自己的 GPU 部署,变更时机也由自己决定。
构建这些模型的循环,就是 Sidekick 的持续学习循环,只是多了一处硬件上的改动。
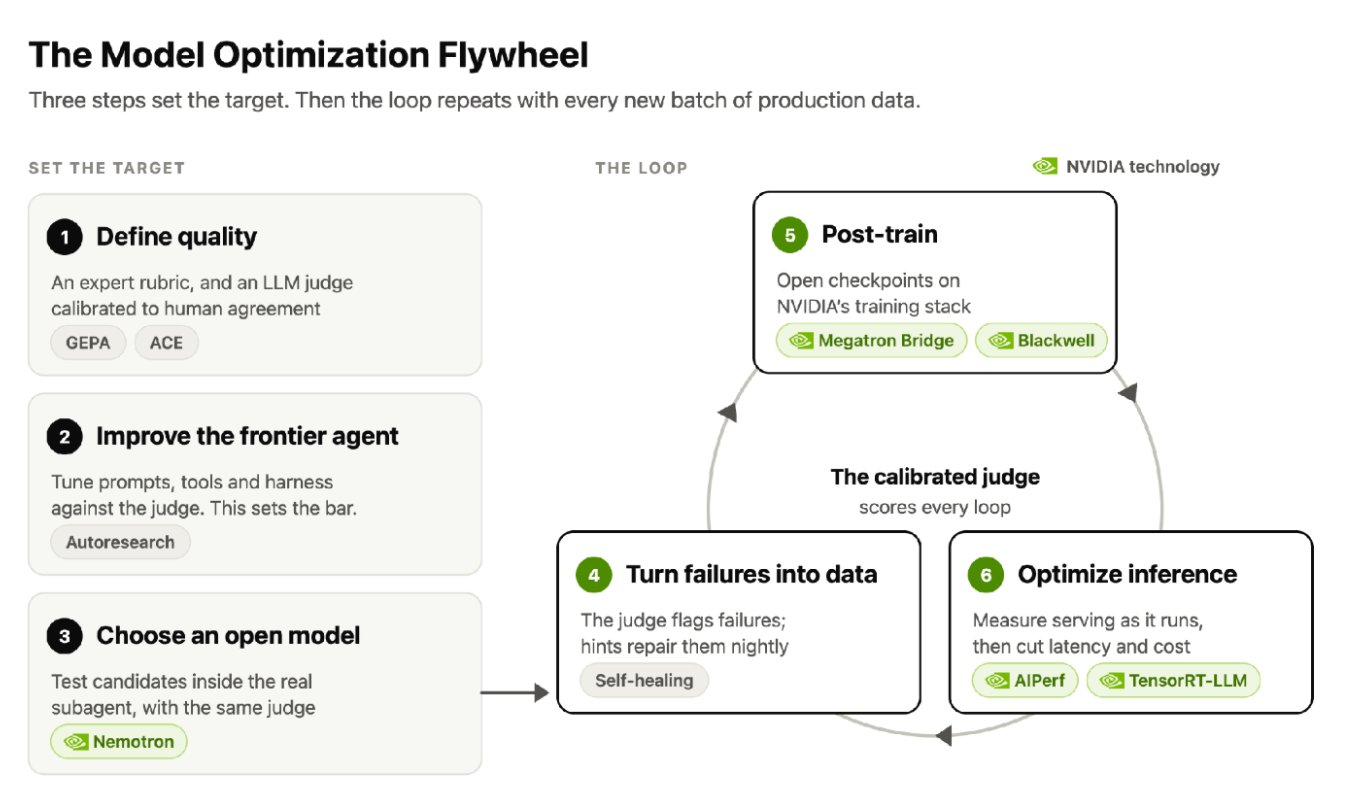
每个任务专家都要走同样的几步:
定义质量
产品专家把需求转化为一套评分标准。以 GraphQL 为例,标准覆盖完整性、执行情况和响应质量。两位专家对同一批对话的判断有多一致,就以此定下基准线;我们再用 GEPA 和 ACE 优化器调校一个 LLM 评判器,直到它与留出的人工标注同样吻合。此后,评判器为每一次 agent 改动、每一个候选模型、每一次训练运行打分。
把前沿 agent 推到极限
在开源模型登场之前,我们先把 agent 的前沿模型版本尽可能推到极限。autoresearch 循环每次只提出一处小改动,改提示词、工具描述或控制流,只有评判器分数提高才保留。改进后的 agent 就是开源模型必须越过的标杆。
选一个开源模型
我们不做预训练。我们把 NVIDIA Nemotron 这类开源模型放进真实的子代理里测试,工具和评判器都和生产一致,再综合权衡初始质量、服务速度和 NVIDIA Megatron Bridge 中的支持情况——我们正是用 Megatron Bridge 训练的。GraphQL 上我们选了 Nemotron 3.5 Lightning:一个混合专家模型,300 亿参数中每个 token 激活 30 亿。
优化推理
我们从一开始就测服务性能,因为一个慢到无法上生产的模型不值得做后训练。每个负载都用 NVIDIA AIPerf 跑基准测试。这是 NVIDIA Dynamo 里的开源压测工具,用合成文本回放生产流量,不碰客户数据。Shopify 贡献了对真实响应回放的支持,多轮测试因此能像生产环境一样命中服务器的前缀缓存。
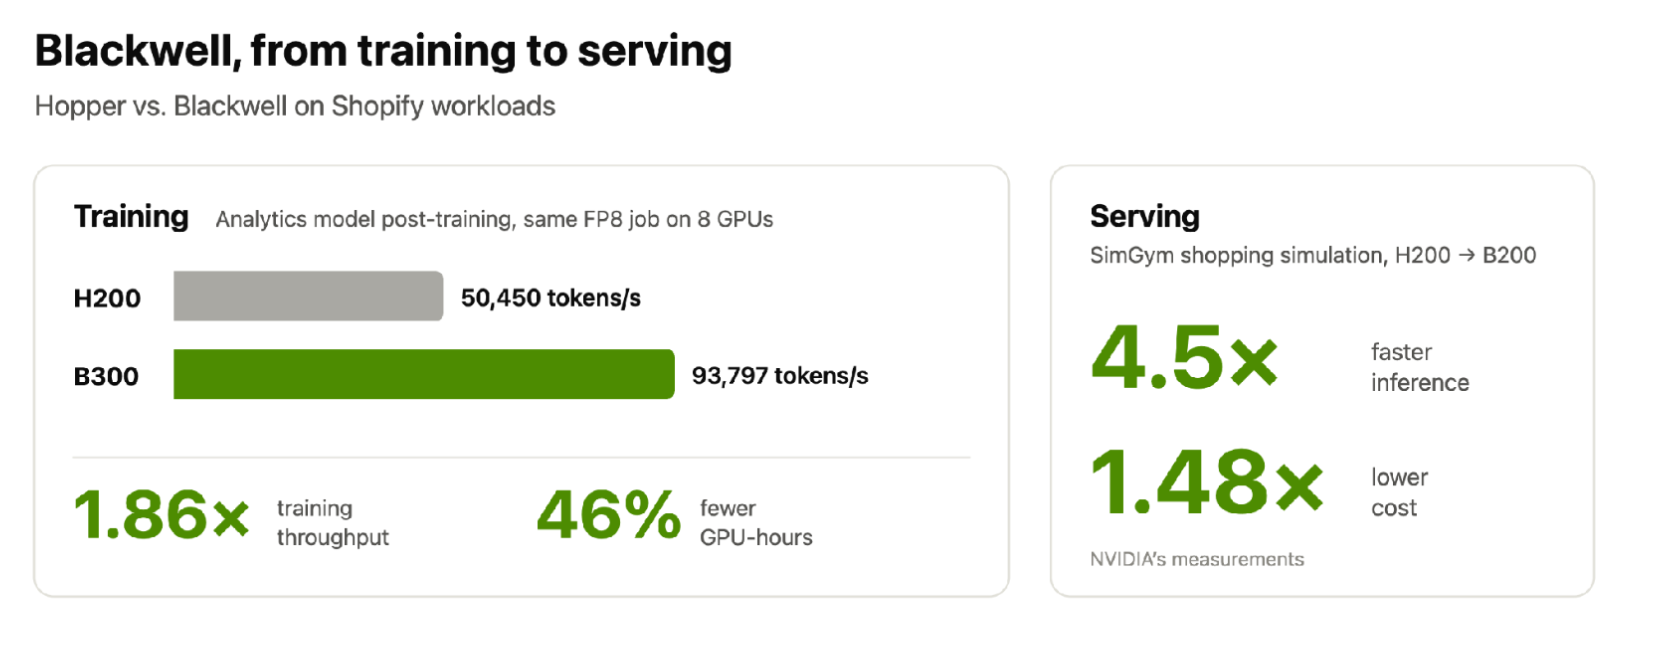
这些测量结果决定我们选哪套服务栈。Buyer Profile 是个批处理任务,AIPerf 对比了 vLLM、SGLang 和 NVIDIA TensorRT-LLM,TensorRT-LLM 每块 GPU 干的活最多。在 NVIDIA 的测量中,SimGym(我们的购物模拟器)在 Blackwell B200 上比在 H200 上快 4.5 倍,成本只有 H200 的 1/1.48。
把失败变成训练数据
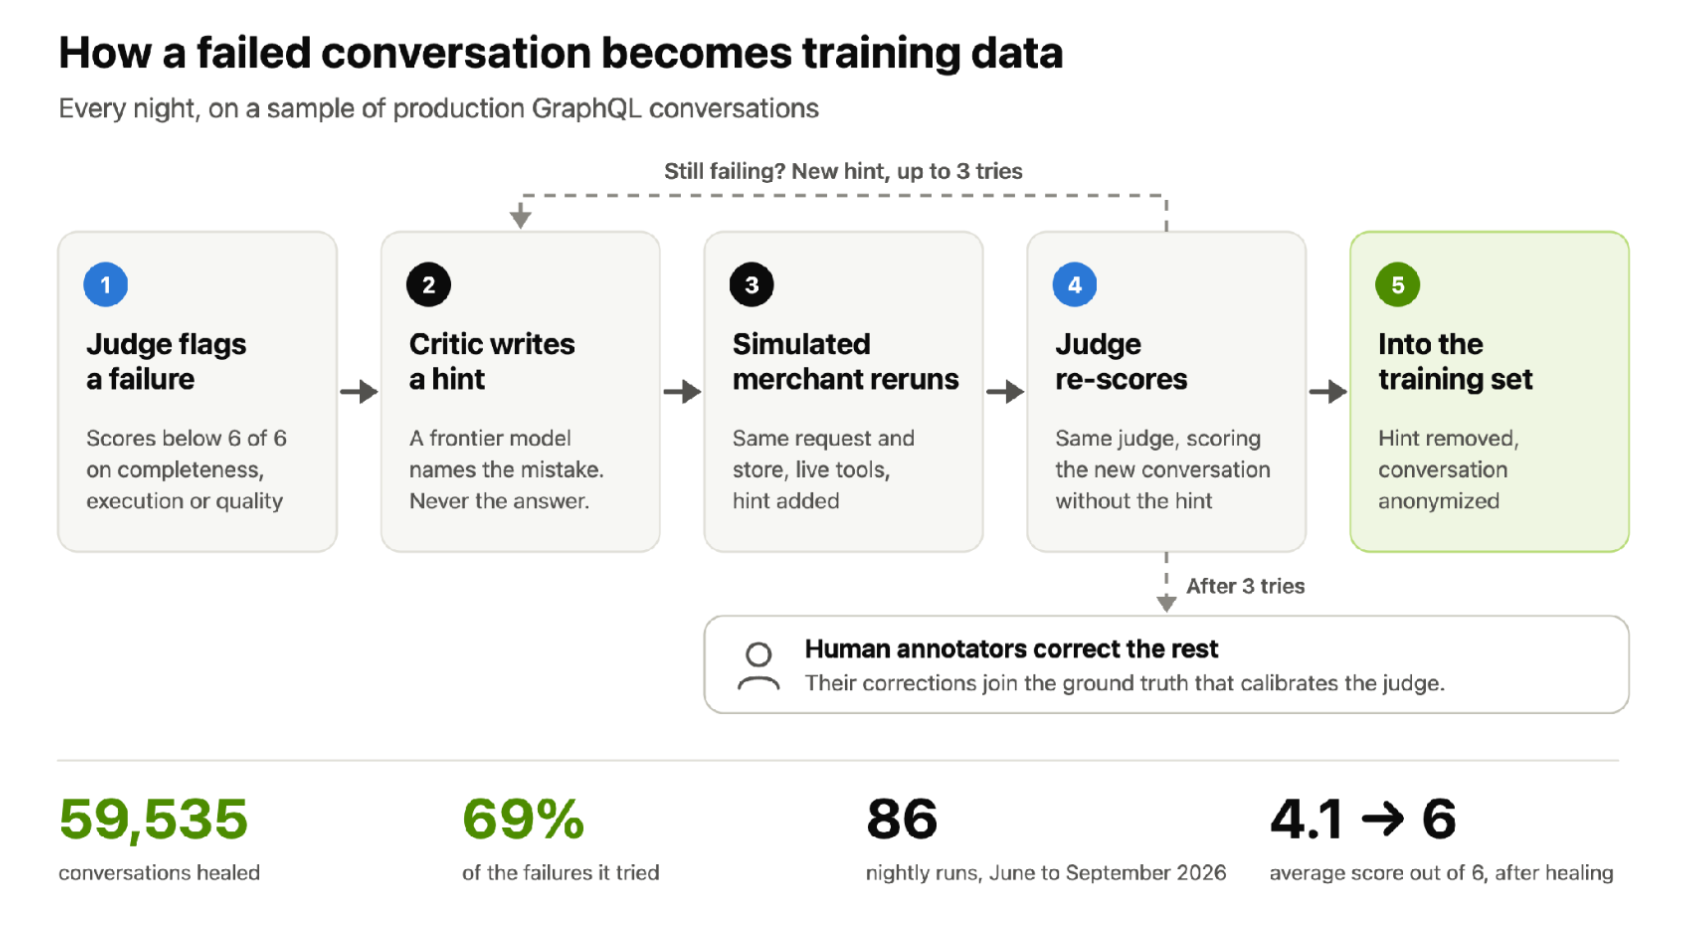
每晚,评判器会对生产环境中的 GraphQL 对话抽样打分,凡是不够完美的都交给自愈流程处理。作为 critic 的前沿模型只写提示,不写答案,再由一个模拟商家带着这条提示,对同一家店铺重跑该请求。如果评判器判定重跑通过,我们就删掉提示、对对话做匿名化处理,然后加入训练集。如果不通过,critic 再试一次,最多三次。
在近期的 86 次夜间运行中,自愈修复了 59,535 条 GraphQL 对话,占它尝试处理的失败案例的 69%。其余由人工标注员修正,这些修正会并入用于校准评判器用的 ground truth。
在 Blackwell 上做后训练
我们用 NVIDIA Megatron Bridge 做后训练。它能把标准的 Hugging Face checkpoint 接入 NVIDIA 的 Megatron Core 训练库,无需重写模型;在 Nebius 上跨节点扩展时,只需改配置,不用改代码。Blackwell 让每一轮循环都更便宜:在 Analytics 模型同一个 FP8 后训练任务上,八块 B300 的训练速度是八块 H200 的 1.86 倍,GPU 小时数少用 46%。随后评判器给新的 checkpoint 打分,循环重新开始。
GraphQL 上的实验结果
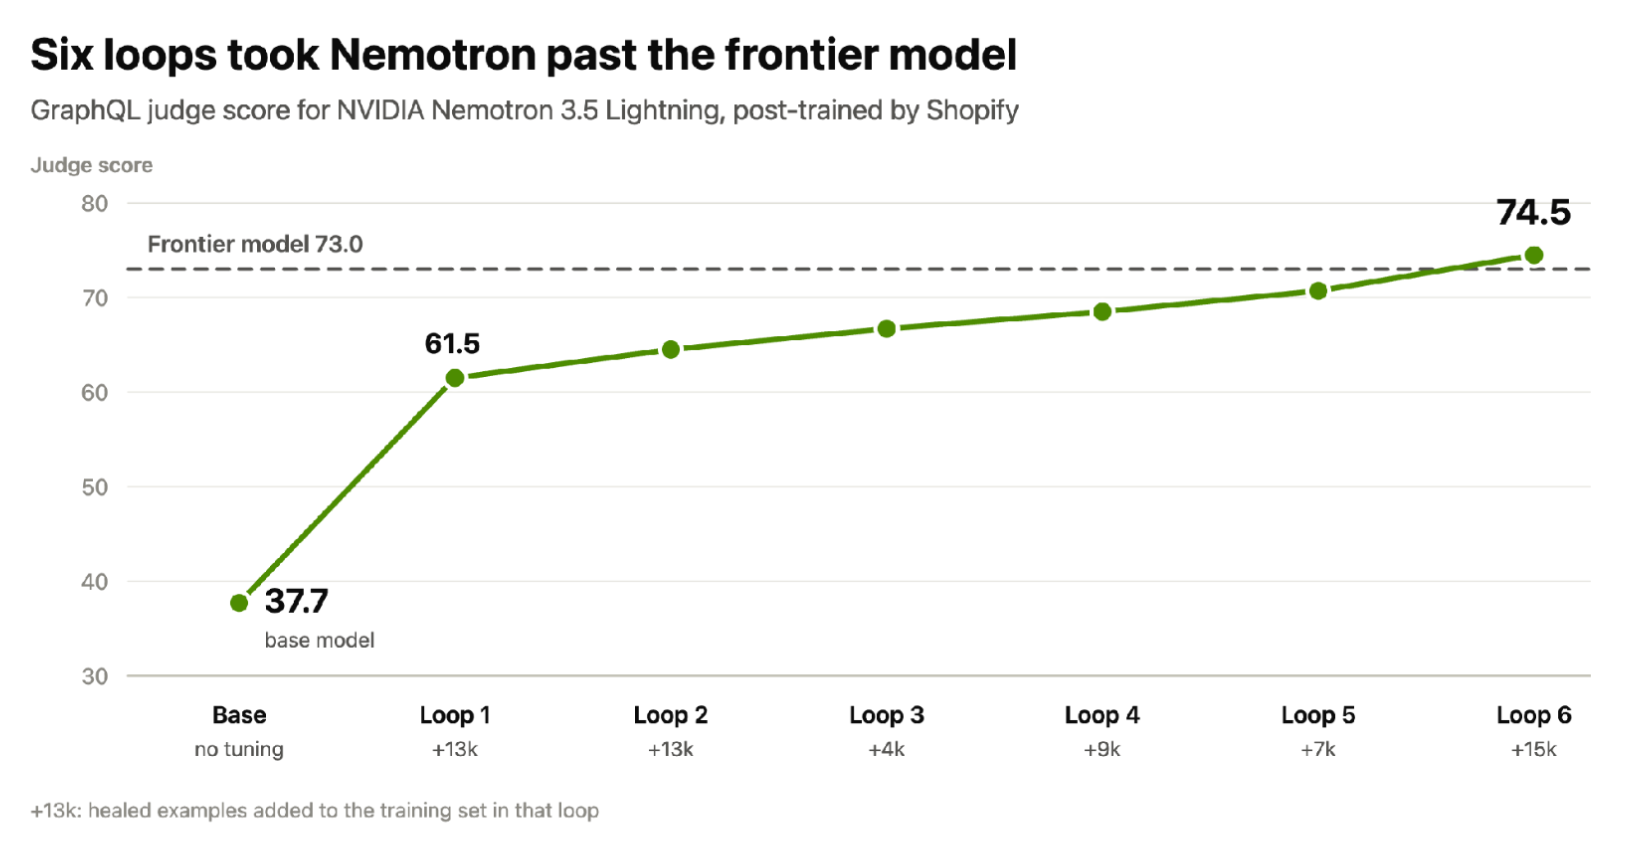
Nemotron 3.5 Lightning 开箱即用时,在我们的 GraphQL 评测中得分 37.7;前沿模型得分 73。第一轮循环把它提升到 61.5;经过六轮循环、修复了 61,000 条样本之后,后训练模型得分 74.5。
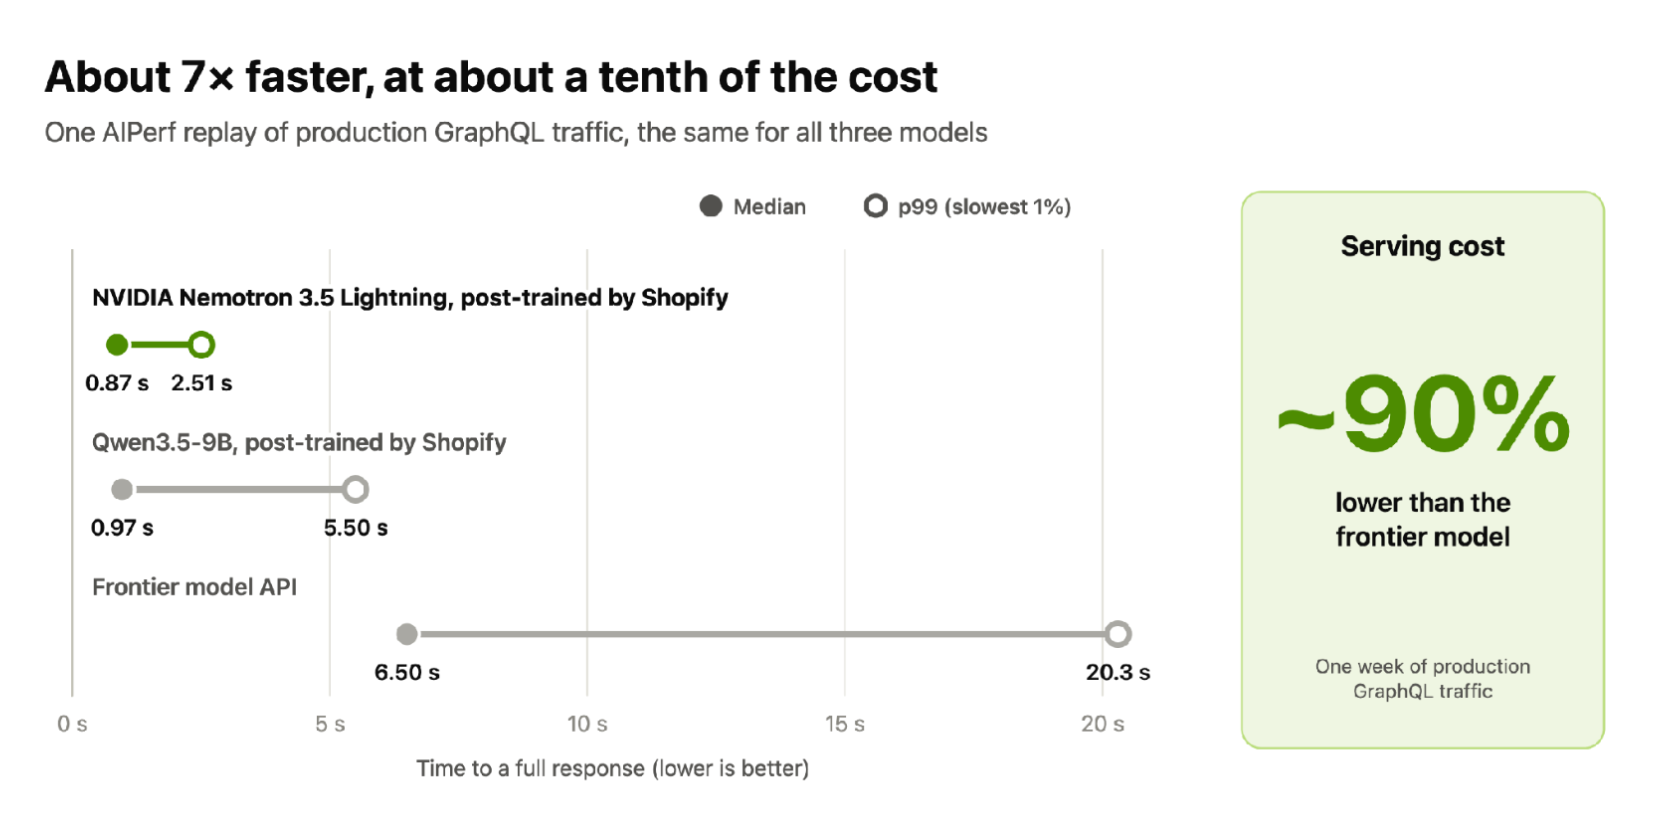
后训练模型的速度也快得多。用 AIPerf 回放生产环境的 GraphQL 流量,后训练的 Nemotron 返回完整响应的中位耗时是 0.87 秒,前沿模型的 API 则是 6.50 秒;最慢的 1% 请求也快了 8 倍。它还胜过另一个规模相当的后训练开源模型,中位耗时接近,但对方的 p99 慢了一倍多。
在这份流量上,服务成本比前沿模型低约 90%。在我们所有后训练模型上,自托管相比前沿模型的定价能把服务成本降低 90–98%。
前沿的智能,专家的效率
前沿模型保留它最擅长的工作:与商家对话,决定调用什么。消耗大量 token 的专家型工作交给自有的开源模型,飞轮的每一圈都在累积:人工纠正让评判器更准,生产流量扩充训练集,每一代 NVIDIA 硬件和软件都让下一轮跑得更快、更便宜。
感谢 NVIDIA 的 Megatron Bridge、AIPerf、TensorRT-LLM 和 Nemotron 团队,CentML 团队(现已并入 NVIDIA),以及 Nebius。改编自我们在 NVIDIA GTC Berlin 2026 的演讲。