バグを患者に、コーディングエージェントを医療チームに見立てた5か月
Cockroach Labs は、IBM Db2 移行サポートを2日足らずで提供した AI コーディングの「教育病院」MOLT Sinai をどう作ったのか。
日本語
コピー
4月のある水曜の夕方から金曜の午後にかけて、MOLT——Cockroach Labs がデータベースを CockroachDB へ移行するためのツール——に IBM Db2 をソースとして移行する機能が加わった。
Db2 は最も早く商用化されたリレーショナルデータベースのひとつで、SQL 方言は豊か、型システムは複雑、独自のネイティブ wire protocol も持つ。これを MOLT で扱うには、新しい schema converter、新しい Fetch パス(行を取り出して CockroachDB に書き込む)、新しい Verify パス(データ投入後に突き合わせる)、vendored した ANTLR grammar、CI 用の Docker イメージ、そして1万行を超えるテスト fixture を書く必要があった。2024年に MOLT へ Oracle 対応を加えたとき、同じ規模の作業に9か月かかり、エンジニアリング工数はおよそ16万ドルだった。
Db2 は2日かからなかった。人間が書いたコードは一行もない。token の請求額は4172ドル。164倍速く、38倍安い。
すべてはひとつの GitHub issue から始まった。要求はいたってシンプルに書かれていた。
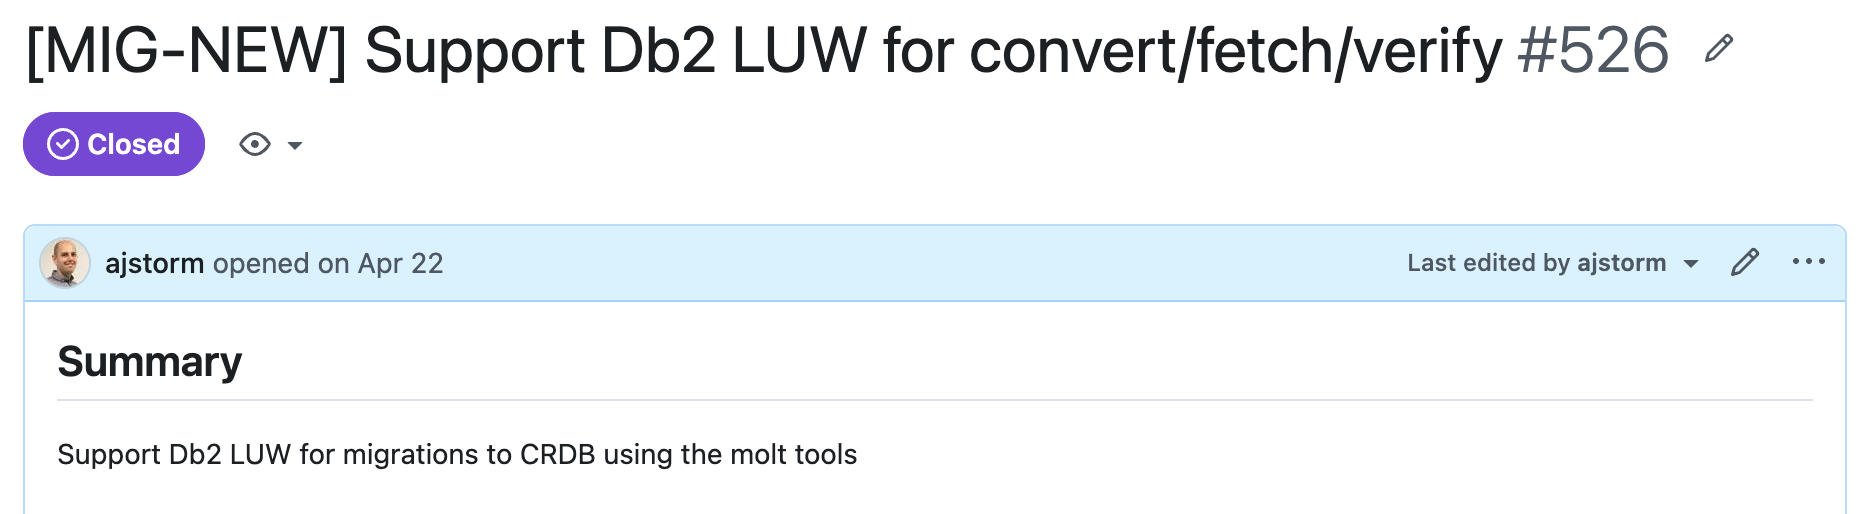
それを planning agent が読み、全体は大きすぎて一度には扱えないと判断して、15の子 issue に分解し、明確な依存グラフを引いた。まず基盤、次に型システム、続いて行イテレータ、そして Fetch、Verify、Convert、CI、最後にテストデータ。このうち2つの子 issue は、それぞれの作業分解のなかでなお大きすぎると判定され、もう一度分割された。作業を進めるうちに、agents は自分たちの作業に対する issue をさらに1ダースほど立てた。fixture の穴、型マッピングのバグ、isolation level の修正。親 issue が閉じるまでに、その下には32の子 issue が開かれ、27の pull request がマージされ、reviewer が作業を差し戻した回数は55回、9つの issue がエスカレーションされ、うち2つは人間にまで上がった。PostgreSQL(最もテストが厚い方言)を基準に測って、テストカバレッジは同等だった。
だが、これはどうやって起きたのか。何がこれを動かし、さらに重要なことに、何が最終的な成果物の品質を十分に高く保証しているのか。Db2 対応の issue を立てる前に、私たちはまずコードを書く病院、MOLT Sinai を建てていた。MOLT は CockroachDB 移行ツール群の名前で、パイプライン全体を病院としてモデル化すると決めた瞬間、MOLT Sinai という混成語はあまりに魅力的で断れなかった。Mount Sinai は Toronto と New York の両方にある有名な教育病院で、そこは私たちが住む街でもある。名前はこうして決まり、語彙もそうなった。Issue は患者。マージは退院。責任者は Chiefs of Medicine。
エージェントが大量のコードを高速に書くこと自体は、この話に固有ではない。ソフトウェア工場は業界全体に広がりつつある(たとえば OpenAI のこれ)。私たちの場合に独特なのは、これらのエージェントと main ブランチの間に何を置いたか、なぜそれを病院の形にしたか、そして5か月にわたって実務で使ってみて何が起きたかだ。
なぜ教育病院を作ったのか
コーディングエージェントの問題は、コードを書く能力は十分にあっても、プロダクション品質のコード——十分にテストされ、保守でき、想定範囲を超えないコード——を安心して任せるのは難しいという点にある。エージェントの運用コストは比較的安いが、そのコードが最終的に顧客の手に渡ることを思うと、安さは慰めにならない。私たちはエージェントが遅く走るほうを選ぶ(10倍遅くても)。顧客が CockroachDB へ移行する途中で誤ったデータを書き込まれるよりはるかにましだからだ。速度は重要だが、品質はそれ以上に重要だ。
この1年、自動化されたエージェントコーディングの試みがいくつか現れた。その多くはスループットを最適化目標にしている。たとえば Gas Town は同じコードベースに対して多数のエージェントを並列で走らせ、マージ処理層で衝突を片付ける。ボトルネックがコードを書く速さにあるなら、これは良い設計だ。Cursor のこの実験では、SQLite を再構築する速さが速すぎて、変更量を扱うためのバージョン管理システムを自作せざるを得なくなった。面白い実験だが、高品質なデータベースコードをユーザーの手に届けるために設計されたものでは明らかにない。初期のエージェント自動化実験の大半では、速度こそが主な動機だった。
私たちの動機は違う。私たちが作っているのは分散 SQL データベースと、そのデータベースへワークロードを移行するツール群だ。移行ツールの隠れたバグは、データがデータベースに入る途中でそれを破壊しかねない。正確さを第一とするはずのデータベースなのに、だ。だから私たちが気にするのは「1時間に何本の PR が出せるか」ではなく、「それらの PR のうち、自分たちがマージしていたら恥ずかしいと思うものはどれくらいか」だ。問いをこう置き換えると話は明快になる。スループットを最適化目標にしたエージェント群は、適切なモデルではない。
そこで私たちはモデルを探した。長期間にわたってリスクの高い作業を扱い、働き手の力量はまちまちで、引き継ぎは必須、セカンドオピニオンも必須、しかも引き継ぎがずさんだと何が起きるかについて既存の文献がある——そんなモデルだ。探し回った末に、行き着いたのは教育病院だった。
この比喩から、次の役割が生まれる:
| 役割 | やること |
|---|---|
| トリアージ看護師 | 入ってきた issue を読み、深刻度と複雑度を見極め、受け入れるか突き返すかを決める。 |
| 研修医 | 検査する。バグを再現し、コードを読み、治療方針を書き出す。その後、コードを書いて実装する。 |
| 担当医(レビュー) | 別インスタンスの agent。プロンプトは修正ではなく審査に寄せてある。まず方針を承認し、次にコードを承認する。 |
| 退院看護師 | マージ前に、病院の全工程が終わったことを確認する。 |
| 院長 | 人間。agent チームだけで解決できない問題が起きたときだけ呼ばれる。 |
この核の周りに、病院で(あるいは『The Pitt』を見ていて)おなじみの役どころがいくつかある。ラウンド看護師は30分ごとに見回り、詰まっている患者を探す。感染管理 agent は main が落ちたとき、建物内の全ワークフローを封鎖できる。安全部門は毎週手順の振り返りを書き、インシデント後の振り返り会を開く。研究部門は新しい仕事を持ち込む。
この仕組みが swarm より安いとも、単一 agent より単純だとも言うつもりはない。ただ、出てくるものの質はどちらよりも高い。データベースの仕事なら、この質には金を払うだろう。以下で見るように、教育病院につきものの面倒さ(官僚主義、待ち時間、コスト)も付いてくるが、その代価は払う価値があると考えている。
どう組み上げるか
病院内のすべては GitHub Actions 上で動く。各患者の状態はその issue の label に、そして病院が患者ごとの進捗を追うために作った一時ファイルに保存される。
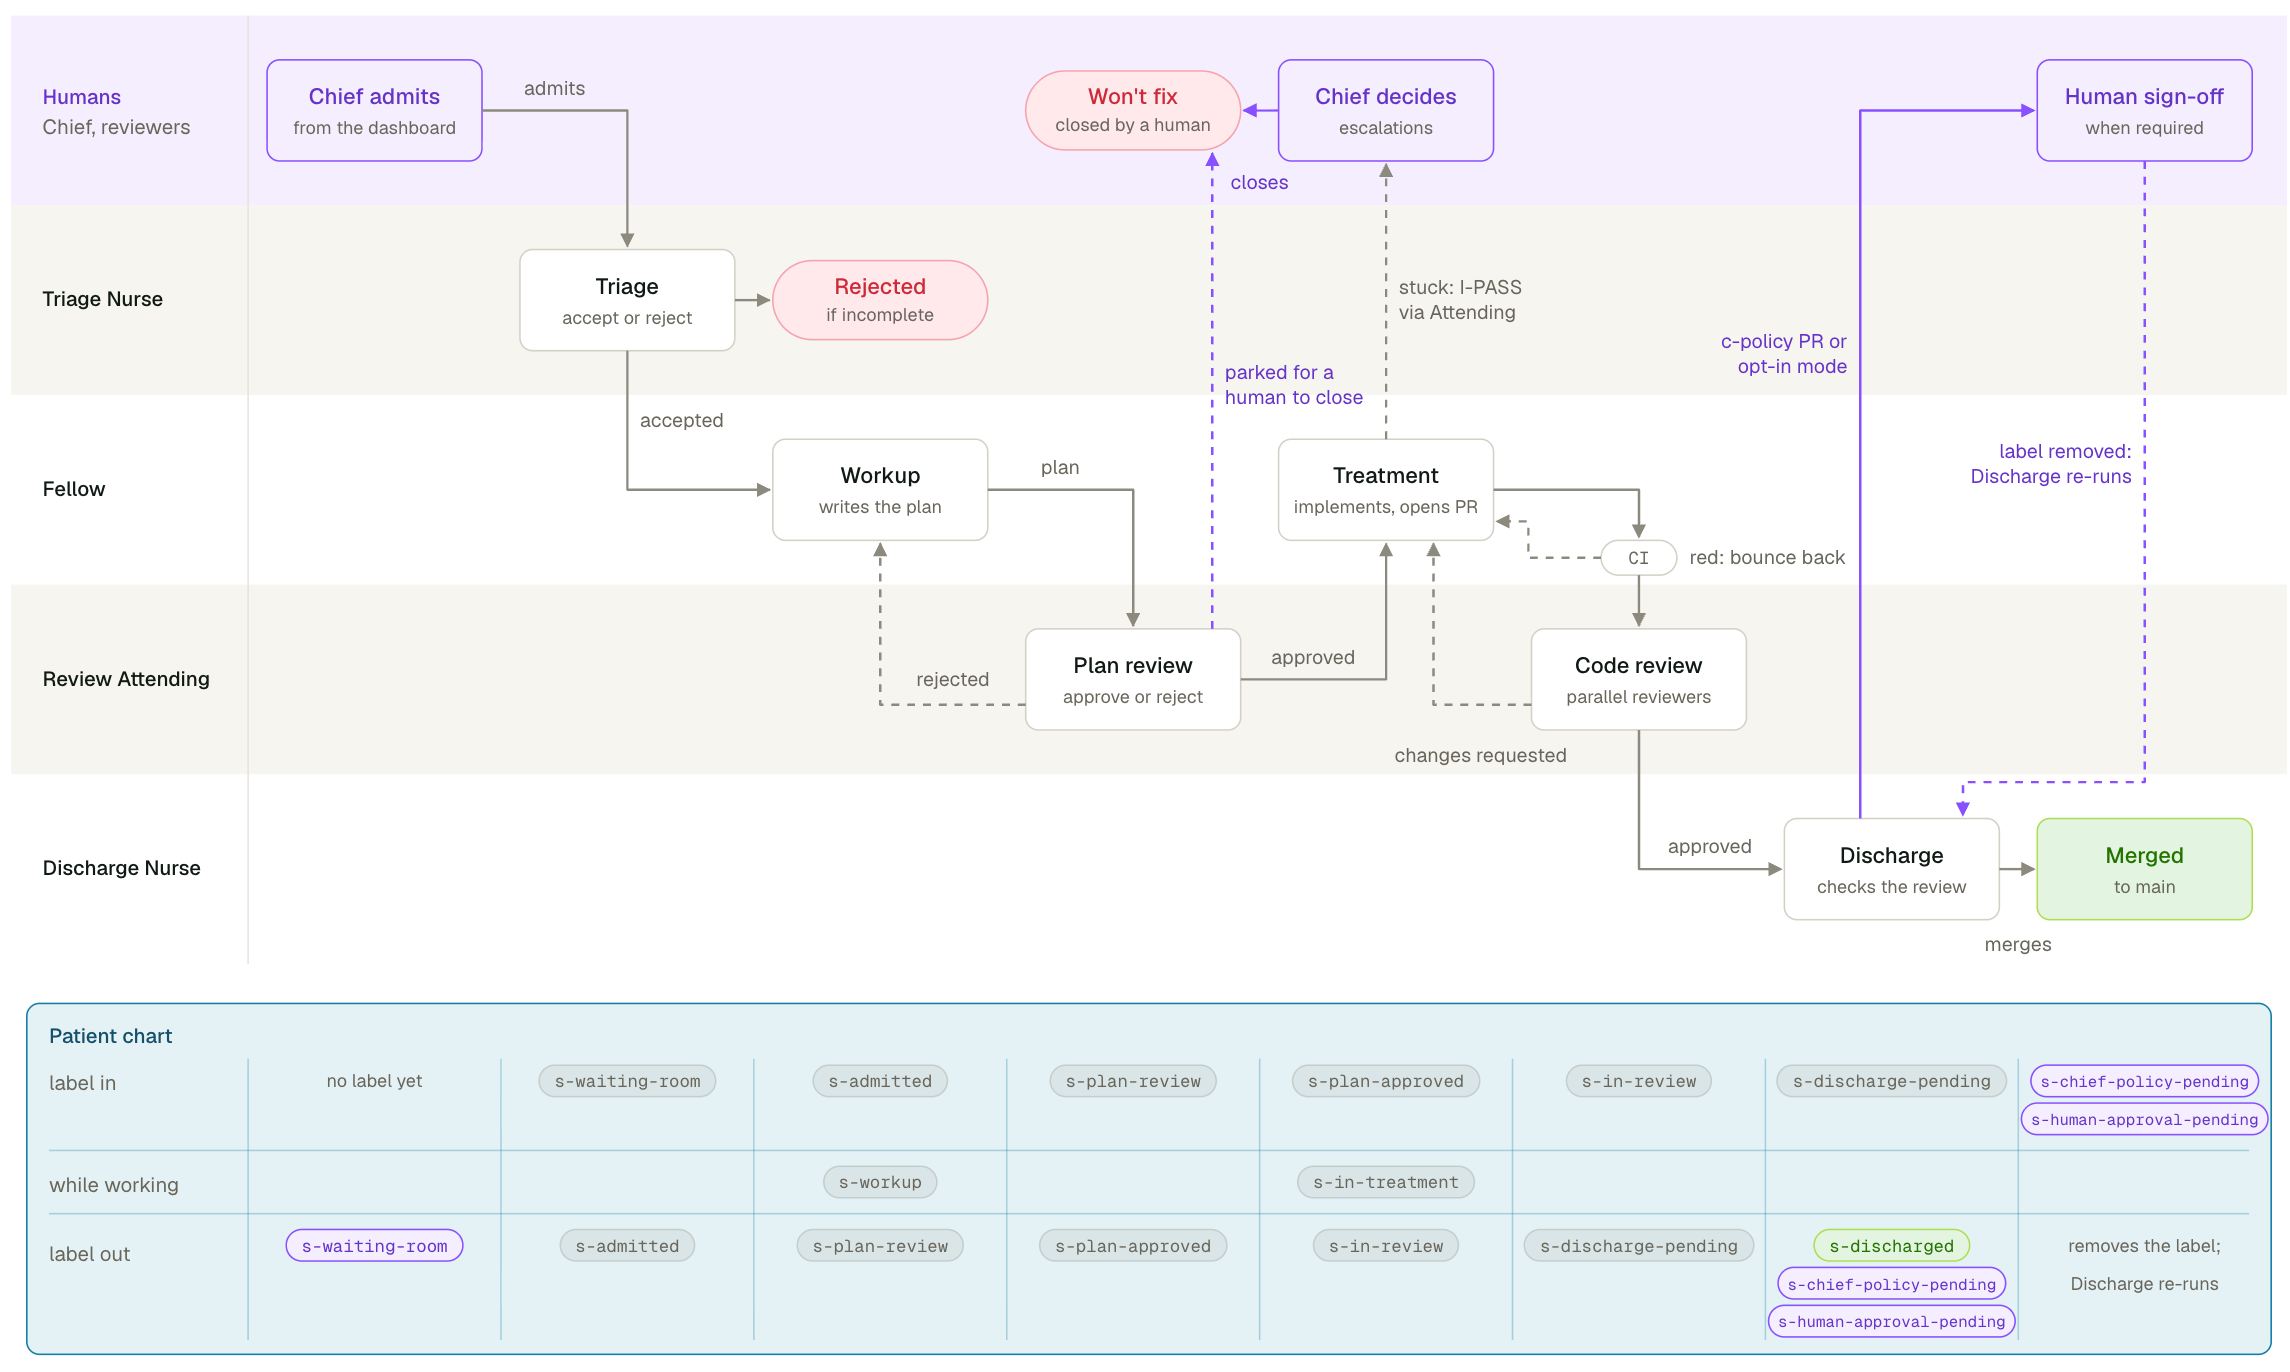
各段階は GitHub workflow で、その「label in」が issue に付くと起動する。agent が仕事を終えると「label out」を書き、そのラベルが次段階の「label in」になる。点線の矢印は差し戻しを表す。方針が却下されれば workup に戻り、CI が赤くなるか修正要求が出れば treatment に戻り、段階が詰まれば Chief へエスカレーションされる。
図に描かれていないもの:4つの部門が独自のスケジュールでこの流れの外側で動いている。Charge Nurse は停滞した段階を再実行し、Infection Control は main が落ちたとき病院を封鎖し、Research と Safety 部門は新しい issue とポリシー PR を提出する。これらは他のどの患者とも同じように、Chief を通って流れに入る。
ラベルが付くと GitHub workflow が起動し、特定の役割の prompt を読み込み、agent に病院の従業員の誰かを演じさせる。仕事を終えると、agent はその issue のカルテを保管するファイルに構造化された記録を追記し、次の段階のラベルを付ける。この記録には <!-- SINAI:TREATMENT_PLAN --> のようなセンチネルマーカーが付いていて、後続の agent がそれを見つけてパースできる。
いくつかの基本的な病院のルールが skill に書き込まれていて、安全策の大部分を担っている:
方針なしにコードを書かない。レビューなしに方針と認めない。 Fellow は何かを直す前に、まず問題を再現し、鑑別診断(病院の用語でそう呼んでいる)を行い、範囲を絞り込む的を絞った調査を走らせ、治療方針を出す。診断、変更するファイル、追加するテスト、リスク、未解決の問い。Review Attending——別インスタンスの agent で、修正ではなく穴探しに重心を置いた prompt で動く——がその方針を読み、承認するか却下する。treatment が始まるのはそれからだ。この関門を入れたのは、間違った修正を自信満々に実装する agent が、立ち止まって方針を確認する agent よりはるかに多くの時間と token を浪費するからだ。
即興でやらない。 treatment の途中で範囲が変わったら、Fellow は手を止め、改訂した方針を出し、plan review に戻る。skill ファイルの指示はわずか2語:「Don't improvise.」
近道をしない。とりわけテストで。 agent はテストを通すためにそれを無効化したり、スキップしたり、弱めたり、書き換えたりしてはならない。テストが失敗したら、反証できない限りテストが正しい。agent が本当にテストのほうが間違っていると考えるなら、テストの変更は単独の commit にし、理由を単独で説明し、修正とは分けてレビューする。同様に、通ってはいるが実際には変更をカバーしていないテストは、テストがないより悪い。コードレビューはすべて、その変更を無効化し、新しいテストがすべて失敗することを確認するところから始まる。失敗しないなら、範囲外か、間違っているかのどちらかだ。
絶対に無茶をしない。 Fellow が詰まったときは、押し通そうとはせず、I-PASS ハンドオフ(Illness severity、Patient summary、Action list、Situation awareness、Synthesis)を書く。この構造化フォーマットは教育病院からそのまま借りてきたもので、その後 Attending へエスカレーションする。引き継いだ agent は、作業を始める前にハンドオフの内容をどう理解したかを先に書き出さなければならない。病院の I-PASS に関する研究によれば、医師と看護師が患者情報を標準化された方法で記録すると、引き継ぎ時の有害事象を50%減らせる。我々の agent も同じ手順に従っている。
Discharge Nurse が監査するのはレビューだ。 マージ前の最後の関門は、コードを再レビューすることではなく、レビュー自体が規約どおりに行われたかを検証することにある。承認が存在するか、レビューのテンプレートが埋まっているか、未解決のスレッドが残っていないか、CI がすべてグリーンか、コミット履歴がクリーンか。Discharge Nurse は自分が何を確認したかのチェックリストを貼り出し、一つでもチェックが入らなければ discharge は失敗に終わる。その項目は未チェックのまま、理由が添えられる。このルールがあるのは、agent に制御を渡す以上、指示どおりに動いてほしいからだ。そして時には、動いていない。
まず先例を調べ、それから Chief の手を煩わせる。 人間の Chief が下した一般化可能な判断はすべて、追記専用の先例ログに記録される。エスカレーションしたい agent はまずこのログを読む。該当する先例があれば、エスカレーションせず先例に従い、それを引用する。先例を作れるのは人間だけだ。5か月分の運用で、agent が Chief にエスカレーションする回数は減った。
実際の成果
MOLT Sinai を作り始めたとき、MOLT ツールを開発するリポジトリのミラーを一つ用意した。このミラーがやがて、病院モデルが機能するかを検証する実験場になった。4月21日から9月11日までにこのリポジトリで起きたことは次のとおり:
| マージされた Treatment PR | 1,238 |
| クローズされた issue | 1,322 |
| agent が提出し、別の agent が対応した issue | 1,299 |
| マージ後にロールバックされた PR | 7 |
| 人間の Chief に到達した issue | 92 |
| PR サイズの中央値 | 追加 527 行 |
5か月足らずで、病院のパイプラインは100万行を優に超えるコードを生み出した。しかもどの変更も、agent が安心してレビューできる大きさに分割されていた。
上の表の奇妙な数字に気づいたかもしれない。1299 だ。リポジトリに提出された issue のほぼ半分は、病院が自分のために作ったものだった。分解で生まれたサブタスク、Fellow が計画の外で拾い上げたフォローアップ、研究部が提案した案、安全部の是正措置。パイプラインは自分でやるべきことのキューを生成する。何を実際に進めるかを決めるのは人間だが、2か月目には、人間はもはや作業の主な供給源ではなくなっていた。
Db2 対応は病院に投入した最初の大型機能だったが、それはあくまで実験にすぎなかった。自律運用の最初の1週間を終えたあと、私たちは「人間承認モード」を有効にし、すべてのマージに人間の目を通すことを必須にした。このモードによって初めて、コード品質が顧客に届けられる水準にあると確信できた。この安全策を敷いたうえで、私たちは病院がまさにそのために作られたものに着手した。Migration Assistant——AI ベースのツールで、Postgres から CockroachDB への移行を最初から最後まで導く。schema 変換、データのロードと検証、定型的な変換まで含む。Migration Assistant は現在 Postgres 移行のプレビュー段階にあり、ほぼすべてを病院の作業者が書いた。
コスト
MOLT Sinai が4月に動き始めて以来、患者1人あたり(つまり GitHub issue 1件あたり)のコストは平均で 84 をわずかに超える程度だった。issue は通常、病院に1日から2日留まる。時間の大半は人間のレビュー待ちに消える。LLM モデルに関して言えば、病院はモデルの進歩に合わせて進化してきた。
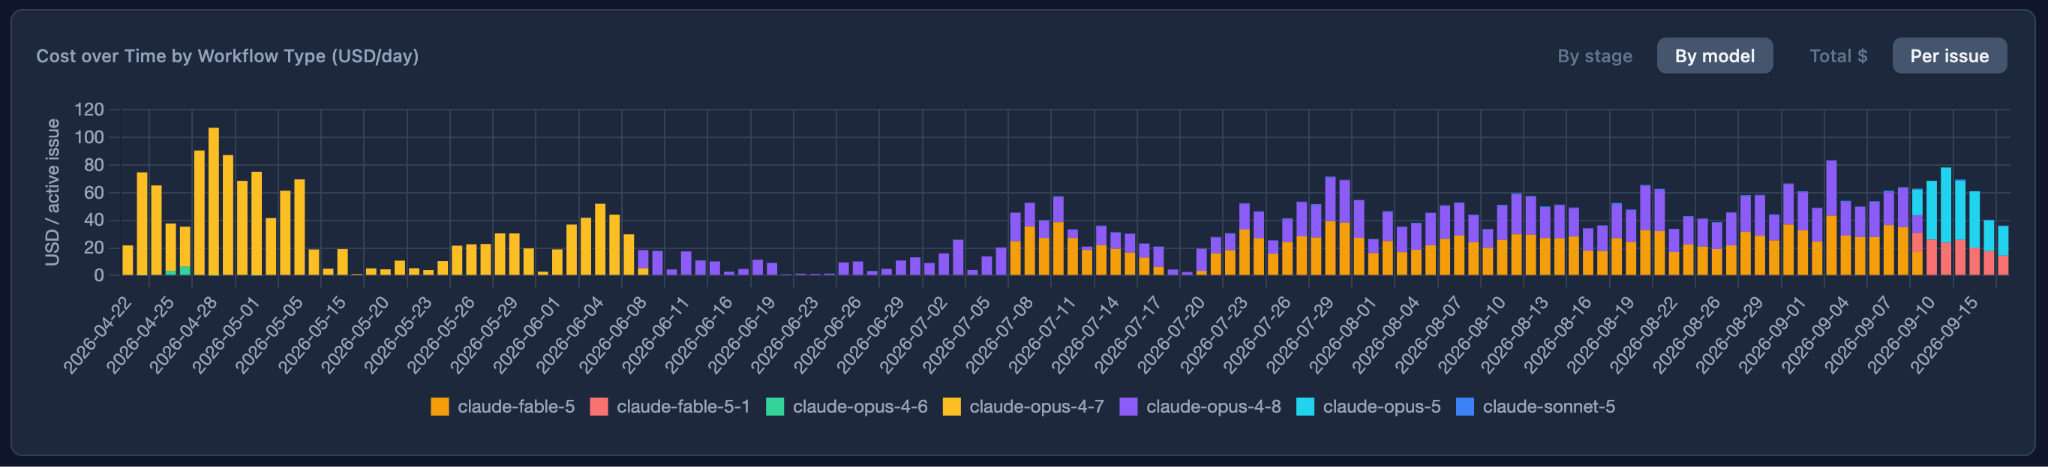
当初はパイプラインのどの段階も Opus モデルで動かしていた。Fable を導入してからは、Fable が計画を立て、その Fable が生成した計画が実装段階でどのモデルを使うかを選ぶ。実装段階で Sonnet や Opus が行き詰まれば、Fable モデルにエスカレーションできる。これでコストを抑えつつ、必要なときにはより高価な(そして強力な)モデルを使える。
上のグラフが示すとおり、モデルを切り替えるたびに、コストを最適化するための agent スキルの調整作業が発生する。数週間ごとに最適化のラウンドを回しており、グラフが上下する理由の一つはこれだ。他にも理由はある。ある期間の作業構成(UI タスクはコストが高い。agent がスクリーンショットやその他の視覚データを扱わなければならないため)や、CI 環境のいくつかの癖などだが、こうした細部は入門ブログで掘り下げるには些末すぎる。
病院が自分自身を建てた
MOLT Sinai を作ったとき、最初のワークフロー、スキル、プロンプトの一式をミラーリポジトリに直接書き込んだ。ほどなくして、自分たちが作ったものに価値があると気づき、社内の他の人間もこれを活用したいはずだと踏んだ。そのために私たちは「Sinai」のコード(本当の病院パイプライン)を MOLT Sinai リポジトリ(病院パイプラインの最初の利用者)から切り離し、別のリポジトリに移した。病院モデルを活用したい者は、それを自分のリポジトリに組み込めばいい。現在、Sinai リポジトリにはおよそ 1,570 のコミットがある。そのうち約 1,340——85%——はパイプライン自身が行ったものだ。
これは計画していたことではない。フレームワークにバグがあれば、他の問題とまったく同じように病院に送り込んだ。30分ごとに回診する Charge Nurse ワークフローが存在するのは、ある agent が GitHub Actions の label イベントで競合状態にぶつかり、issue を立て、別の agent が修正を設計してリリースしたからだ。これが病院モデルを素早く進化させる最も楽な方法でもあり、ほぼすべての患者が退院するにつれて、病院モデルはより堅牢に、より効率的に、より使いやすくなった。
現在、Sinai モデルは Cockroach Labs の 4 つのリポジトリで稼働しており、さらに数個のリポジトリが今後数か月以内に導入される予定だ。
指示がレガシーコードになった
各 agent の役割は skill ファイルで定義される。Markdown の文書で、手順、ルール、テンプレート、禁止事項が書かれている。書き方は知識ベースによくあるやり方と同じだ——問題が起きるたびにルールを 1 行足す。
7 月、私たちはこれらのファイルを監査した。25 個の skill ファイル、10 万字を少し超える量。そのうち約 2.3 万字——23%——が、gate、コマンド、テンプレート、sentinel を一切変えずに削除できると判定された。最も多かったパターンは、同じルールが複数箇所で言い換えられて繰り返されているものだ。70 箇所、合計 6000 字。あるファイルは内容の 47% が冗長だった。
この冗長は実際に金と時間を食っている。病院の worker は複数の skill を同時に読み込む。Discharge Nurse は実行のたびに約 21,800 字、およそ 29,000 token の指示を読み込む。しかも、それが検査すべき PR の 1 行も読まないうちに。基盤 skill である hospital-protocol は 15 個の agent すべてが読み込むので、ここでの冗長のコストが最も大きい。
これは MOLT Sinai 固有の問題ではないと考えている。私たちの prompt はコードと同じように腐った。ルールは増える一方で減らず、ファイルは誰も最初から最後まで読めない長さになった。気づいたのは token の請求書のおかげだ。今のところこれを検出する linter はないが、おそらく近いうちに作る。
学んだこと
MOLT Sinai(および Sinai モデル)と 5 か月働いて、多くのことを学んだ。以下はそのうち面白い部分だ。
うまくいったこと
**モデルは期待以上にできる。**各役割の skill ファイルの冒頭に、その役割を位置づける数行がある。これが最も価値があるとわかった。Fellow の冒頭はこうだ。「あなたは Fellow であり、入院患者(GitHub issue)に対して診断検査を行っている。あなたの職務は徹底的に調査し、別の Fellow が実行できる書面による治療計画を出すことである。」Review Attending の冒頭はこうだ。「あなたは、この症例を治療している Fellow とは別の agent インスタンスである。あなたの職務は、bug、セキュリティ問題、リグレッションリスク、承認済み計画からの逸脱を見つけることである。」これが土台になるのは、基盤の LLM が、教育病院がどう動くか、鑑別診断とは何か、引き継ぎに決まった構造が必要な理由、セカンドオピニオンが何を意味するかを非常によく知っているからだ。LLM に役割を演じろと言えば、それは非常にうまく演じる。例えば、ある Review Attending は、すでに何度も review を経た PR で docstring の欠陥を 1 行見つけたが、自分の権限で PR を差し戻して書き直させることを拒み、こう書いた——「患者がすでに疲弊しているときに、docstring の修正 1 つだけで一方的に症例を Fellow に戻すのではなく、判断をあなたに委ねる」。別の例では、ある Attending が、Chief がすでに裁定した issue を再分割すべきか決めようとして、こう書いた。「Chief が所有する決定は、その結果が前提を反証したなら、それを迂回して独自に動くのではなく、所有者に返すべきである。」これらの文はどれも skill ファイルに直接書かれていない。agent が役割を演じているからこそ、自分で書いたものだ。
**コードを書く前に計画を審査する。**審査済みの計画が却下される割合は 10% 未満だが、いったん却下されれば、それはシステム全体で最も価値の高い審査になる。手戻りをできるだけ早い段階に移せるからだ。例を挙げる。収集したログから顧客の hostname とデータベース名を除去するテレメトリ修正で、計画審査の時点で小さな見落としが見つかり、情報がまだ漏れる可能性があった。計画審査で捕まえなければ、コードレビューではほぼ発見できず、そのまま出荷されるか、別 issue を立てて解決するしかなかった。計画段階で bug を捕まえれば、後で積み上がる作業を省ける。
**分割し、厳しい上限を設ける。**workup が変更を 1,000 行(テスト含む)超と見積もれば、Fellow はそれを依存グラフ付きの子 issue に分割しなければならない。それ自体が 1,000 行を超える子 issue は、さらに分割する。この上限は、各変更を、レビュアーが——agent であれ人であれ——全体を頭に収められる程度に小さく保つためにある。Db2 の sprint では、1 回の admission から 32 個の issue が分割された。数万行のコードを 1 人の agent(または人)が説得力をもってレビューし切ることは不可能なので、病院のやり方は作業を分割し、レビューしやすくする。
**記録する。**各病院 issue は、それが生み出したすべてを記録する。workup 計画、Fellow がコードに触る前に書いた再現テストとその失敗出力の全文、治療計画とそのすべての改訂、各 I-PASS 引き継ぎ、各レビュー結論とその理由、各段階の臨床記録(モデル、token 数、所要時間、コストを含む)。記録は対になる archive ブランチに置き、コードと一緒にマージする。こうして PR diff にはコードだけが残り、レビューしやすくなる。5 か月後、issue スレッドだけで、1,238 個の PR のどれがなぜマージされたかを容易に再現できる。セキュリティ部門の週次レビューが成り立っているのも、この記録の筋道があってこそだ。記録を徹底して残すことは、病院という比喩がもたらした最も強力なものの 1 つだとわかった。
変更した点と、まだ変更が必要な点
モデルは時にやりすぎる。 役割分担を機能させたプロンプトが、彼らを官僚的にした。ある Fellow がとある issue に対して立てた計画は「close as duplicate。修正は PR #691 で既にマージ済み」というものだった。計画レビューはこの判断を正しいと認めつつ、それでもエスカレーションした。理由は「review-attending-plan-protocol に記録された三つの結果(APPROVE / REJECT / ESCALATE)に『close as duplicate』が含まれていない」からだ。確認済みの重複 issue が人の手を必要としたのだ(この問題は後に解決済み)。一行の UI コピー変更——サブタイトルの「Validating」を「Verifying」に変えるだけ——に五回の手戻りが発生し、Chief まで巻き込んで、低リスクの PR を不安定な CI がグリーンになる前にマージできるかが議論された(agent は CI が赤いままマージしようとすることが多く、失敗の原因は自分たちではないと主張する)。コードレビューが PR を止めたが、コードの欠陥は一切なく、PR 説明文の小さなタイポだけが理由だった。レビュアーが非ブロッキングの些細な指摘を残すと、パイプラインはそれを追跡する新しい issue を立てる傾向があった(これも後に修正済み)。小さなコメントが新しい患者を生んでいたわけだ。いくつかは既に対処したが、品質を最優先し、自らのルールを厳格に守るシステムの代償であるものもある。
レビューにはサーキットブレーカーが必要だ。 Issue 1777 は緊急とされ、修正は一行——あるコードパスで既存の関数を呼び出すだけで、同種の他の三つのパスと同じことをするだけだった。それが二日と十一回の手戻りを要した。まずコメント規約の問題、次に PR 説明文の不正確な記述、続いて計画からの小さな逸脱、さらにテスト品質、二度の rebase、二度のワークフロー失敗、そして人手による承認ゲート。三回を超える手戻りは Safety review をトリガーするが、ある Safety review の期間中、三つの複雑な issue がそれぞれ九回、九回、七回の手戻りを起こし、その間に病院が費やした約 1,046 を食いつぶした。同じ safety review は、コードレビュープロセスに「計測可能な非収束のサーキットブレーカー」がなく、収束しないループは「エスカレーションが遅すぎるか、まったくされない」ことも記録していた。そこで提案された修正は最近マージされた——今では、PR が四回連続で手戻りし、かつ各回で新たなブロッキング問題が露呈した場合、あるいは実質的な手戻りが累計六回に達した場合、レビュアーは Attending に引き継がなければならない。マージされてまだ日が浅く、効果を示す十分なデータはないが、初期の兆候は良好に見える。
この病院は生産性が高いが、それが常に良いとは限らない。 自分で仕事を見つけるのが得意なのだ。前述のとおり、issue のほぼ半分は agent が提出したものだ。Research Department はコードベースを調査して新機能を提案する役割で、当初は三時間ごとに実行され、その産出する issue の数は私たちが採否を一つずつ審査しきれないほどだった。まず一日一回に制限し、その後、審査待ちの提案数の上限を十件に設定した。問題は、それが見つけてくる issue の多くが実際に価値を持つことだ。コードベースのとある問題を対話的な Claude セッションで扱っていると、この病院が数週間(あるいは数か月)前に提出したのと同じ issue を指し示すことがよくある。とはいえ、それらすべてを進めるのは費用も時間もかかり、価値も疑わしい。川から金を淘ぐのが常に最も難しい部分であり、私たちはまだそれを解決できていない。
私たちは、本当には教えていない teaching hospital を作ってしまった。 MOLT Sinai は、経験豊富なエンジニア二人(業界経験を合わせて 40 年以上)が作るものと完全に一致している。モデルは極めて強力で、私たちが寝ている間に issue の束を処理し、翌朝にはすぐレビューできる。そして素早く病院にさらに多くの issue を詰め込み、日中に会議をしている間に解決させ、退勤前に審査して通せる。今では、一日中会議をしていても、質の高いマージ済み PR が 10 本得られる。しかし、スケジュールが埋まっておらず、数十年の経験がもたらすソフトウェアエンジニアリングの判断力も持たず、それでも本気でより強いエンジニアになる方法を学びたい新卒はどうか? このモデルは彼らに機能するのか? 端的に言えば、彼らのニーズを完全には満たしていない。私たちは現在この病院を改良し、人がトリアージ済みの issue を引き継ぎ、自分で計画を立て、それを病院の agent にレビューさせることを可能にしようとしている。レビューの過程で、彼らは自分の決定を弁護し、より包括的な別の案がないかを問い詰められる必要がある。同様に、レビュー済みの計画を受け取ったとき、人は自分でコードを書くことも選べる(小さな修正なら手書きで、あるいは対話的な LLM コーディングセッションを利用して)。そうすることで、コードベースをどう進むか、実装上のトレードオフをその場でどう判断するかを学び、その後のコードレビューで評価される。私たちは未来のソフトウェアエンジニアを育てる必要があり、十年後に agentic coding の世界がどうなっていようと、優れた判断力と批判的思考を持つ人は依然として必要だ。
今後の予定
私たちは病院内の各 agent の効率、速度、正確性を高めることに取り組む一方で、病院をより経験の浅いエンジニアにとって魅力的で、教育的で、スキルを鍛えられるものにする方法も模索している。さらに、IBM Db2 サポートが正しいかどうかを確認している——初期のテストでは、病院が書いたコードを一切レビューしていなかった。最後に、少なくとも一部のカテゴリの問題については、病院を完全自律モードに戻すには何が必要かを確かめる一連の実験を行っている。上記の課題の一つでも一緒に取り組みたい方は、ご連絡ください。