集合データチェックをAI対話に変換
Te Papa の収蔵品データ担当が、四半期ごとのデータチェック結果を AI が読みやすい Markdown レポートにし、各部署が Copilot に自分の仕事に引きつけて質問できるようにした。
日本語
コピー
Digital Collections チームの一員として、コレクションデータマネージャーの Gareth Watkins は博物館の各部門の kaimahi を支援し、EMu(Te Papa のコレクション管理システム)における情報の正確性を維持している。100万点を超えるコレクション、taonga、自然史標本の記録と管理をこのシステムが支えられるようにするのが役割だ。本記事では、kaimahi がコレクションデータについて質問し、自分の仕事に最も関連する情報を見つけられるようにするための、AI に優しいレポートをどう作ったかを紹介する。
以前のブログ記事では、Te Papa のコレクション情報を良好な状態に保つために2024年4月に導入した四半期ごとのコレクションデータチェックについて書いた。現在チェック項目は90を超え、登録、保管場所、物品分類、分類学、画像、出版といった領域をカバーしている。
四半期ごとに、これらのデータチェックは大量の有用な情報を生み出す。難しいのは、kaimahi がその数字の意味を理解し、自分の仕事に最も関連する結果を見つけられるようにすることだ。コレクション管理者、キュレーター、経営層がそれぞれ気にする問いは同じではない。
結果をもっと役立つものにするため、最近、Microsoft Copilot にアップロードできる AI に優しいプレーンテキストのレポートを設計した。Copilot は Te Papa が管理する Microsoft 環境上で動いている。これにより kaimahi は、あらかじめ決められた単一の視点からデータを見るのではなく、自分の仕事に関連する問いを立てて四半期の結果を掘り下げられるようになった。
背景情報をファイルに書き込む
AI モデルに背景を与えるため、レポートには最新の結果、傾向を識別するための過去四半期のデータ、各チェック項目の説明、そして Te Papa の《意向声明》のようなより広い情報を含めた。
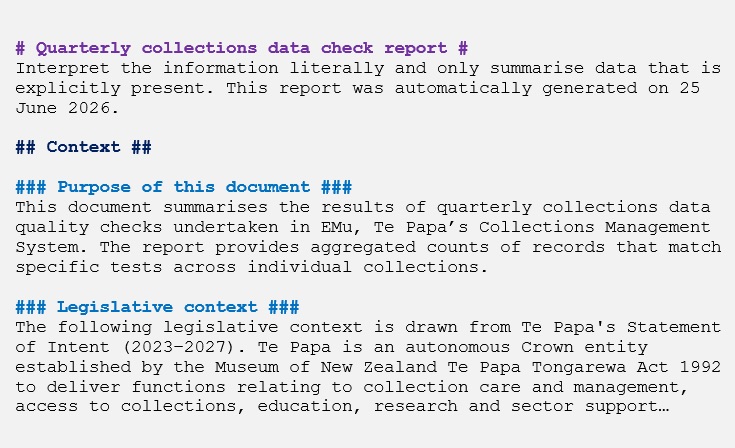
こうした背景情報は、モデルが数字を理解するために不可欠だ。改善の機会を示すチェック項目もあれば、コレクションの規模や性質によって自然に大きな数字になるものもある。
レポートはモデルに対し、提供された情報だけを使うこと、馴染みのないチェック項目を説明すること、結果の原因をでっち上げないこと、答えられない問いには正直にそう言うことを明確に求めている。
レポートはまた、結果を Ngā Tikanga Whakahaere Kohinga Taonga a Te Papa /《コレクションのケアと実践の枠組み》に対応づけている。この枠組みは登録、保管、保存、アクセスを含む15の領域の基準を定めている。
これにより議論は「このチェックに該当する記録は何件あるか?」から「これは登録、リスク、デジタルアクセス、監査、あるいはコレクションのケアにとって何を意味するか?」へと移る。
人と機械の両方のために設計する
レポートは Python で生成し、Markdown 形式のテキストファイルとして保存する。Markdown は基本的な見出し、リスト、表でテキストを整理するので、AI モデルが解析しやすく、人にとっても読みやすい。
レポートを人にとって読みやすい状態に保つことは特に重要だ。Te Papa で AI ツールを使う際、AI が生成した内容を人が確認することは中核的な要件だからである。以下は Markdown の表の例だ。
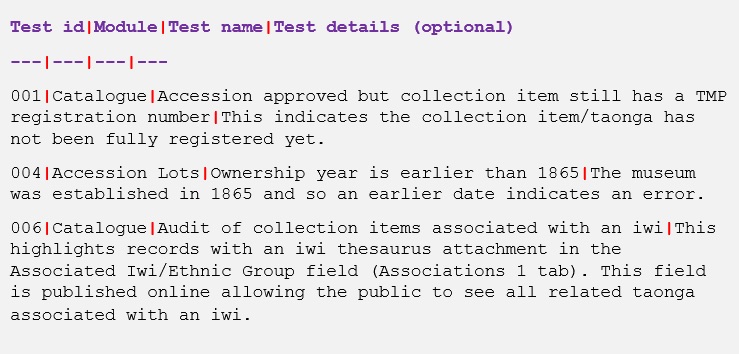
レポートに含まれるのは記録と問題の集計件数だけで、個々のコレクションや taonga の詳細情報、現在の所在、評価額その他の機微な情報は含まない。
集計にすることで、ファイルはモデルのコンテキストウィンドウ——AI が一度の会話で考慮できる情報量——に楽に収まる大きさにもなる。
Kaimahi は何を尋ねられるか?
このレポート方式の真の利点は、AI モデルが質問者の具体的な問いとニーズに合わせて回答を調整できることにある。
導入のプロンプトは例えばこうだ。
キュレーター向けに:「私は Art コレクションを担当するキュレーターです。私のコレクションに最も関連する結果を、過去四半期と比べた顕著な変化も含めて説明してください。」
経営層向けのブリーフィングに:「経営層向けの簡潔なブリーフィングを用意してください。進展、新たに生じたリスク、デジタルアクセス、的を絞った投資が変化をもたらしうる領域に焦点を当ててください。」
全体像をつかむには:「今四半期の結果で最も重要なパターンを要約し、時間の経過に伴う顕著な変化を示してください。」
その後 kaimahi は追加で質問したり、別の読者向けに回答を調整したり、インフォグラフィックのような別の出力形式を求めたりできる。
インフォグラフィック
視覚的な要約は結果を伝えるのにうってつけだが、細心の注意が要る。例えば、コレクション分類ごとに展示中の実物の点数を示すインフォグラフィックを Copilot に作らせてみた。
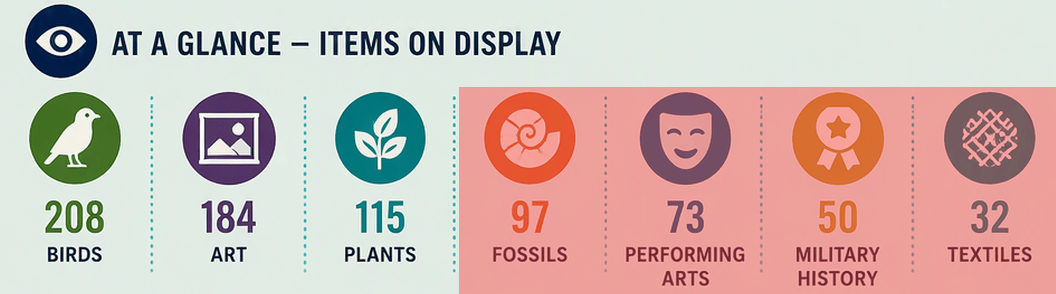
数字はあくまで例
鳥、芸術、植物の部分の数字は正確だったが、図には表演芸術、軍事史、テキスタイルも現れた。これらの名称は元のレポートにはなく、当館のコレクション管理システムにおける有効なコレクション名でもない。該当するコレクションは実際には歴史、Taonga Māori、太平洋文化、写真といったコレクション分類に分散している。 では、これらのコレクション名と数字はどこから来たのか。 Copilot に結果を説明するよう求めると、画像生成は副次的な手順であり、自分が知覚した空白を、もっともらしい内容で埋めたと答えた。 よりうまくいくインフォグラフィックの作り方は、工程を2段階に分けることだと分かった。まず AI にインフォグラフィックの要点と数字を洗い出させ、次に生成画像に含めるべき正確なテキストと数字を盛り込んだ新しいプロンプトを作る。 ここでの重要な教訓は、AI が生成した結果を疑う習慣をつけ、モデルに情報源を示させるか、使った計算過程を開示させることだと思う。
疑問を突きつけ、突き合わせ、検証する
振り返って突き合わせと人の手による検証を検討してみると、承認済みの別のAIモデルが、AI生成コンテンツの一次チェックに役立つことに気づいた。 インフォグラフィックの例では、2つ目のモデル(ChatGPT経由)が、元のレポートに裏付けのない収蔵品名や数字をすぐに洗い出した。とはいえ、2つのAIモデルが一致したからといって、それが正しい証拠にはならない。同じ誤りを同時に見落としたり、繰り返したりしている可能性があるからだ。結局のところ、人の手による検証は依然として欠かせない。とりわけ、その結果が収蔵品の保存やアクセスに関わる活動に影響しうる場合はなおさらだ。 私が設計したこのAIフレンドリーなレポートでは、AIが収蔵品について判断を下すことも、収蔵品の専門家の知識を置き換えることもない。AIの役割は、すでに存在する情報をkaimahiが閲覧し、比較し、伝えるのを助けることだ。ここでのAIの価値は、AIが私たちより多くを知っていることにあるのではなく、すでにある情報と関わるための実用的な新しい手段を提供してくれることにある。