新モデルの日:両方をテストした
Anthropic の Opus 5.5 と同じ日の午後、OpenAI が GPT-6 Sol と Luna を発表。26 件の CAD タスクで実測すると、Opus 5.5 はコスト4割減・3倍速だった。
日本語
コピー
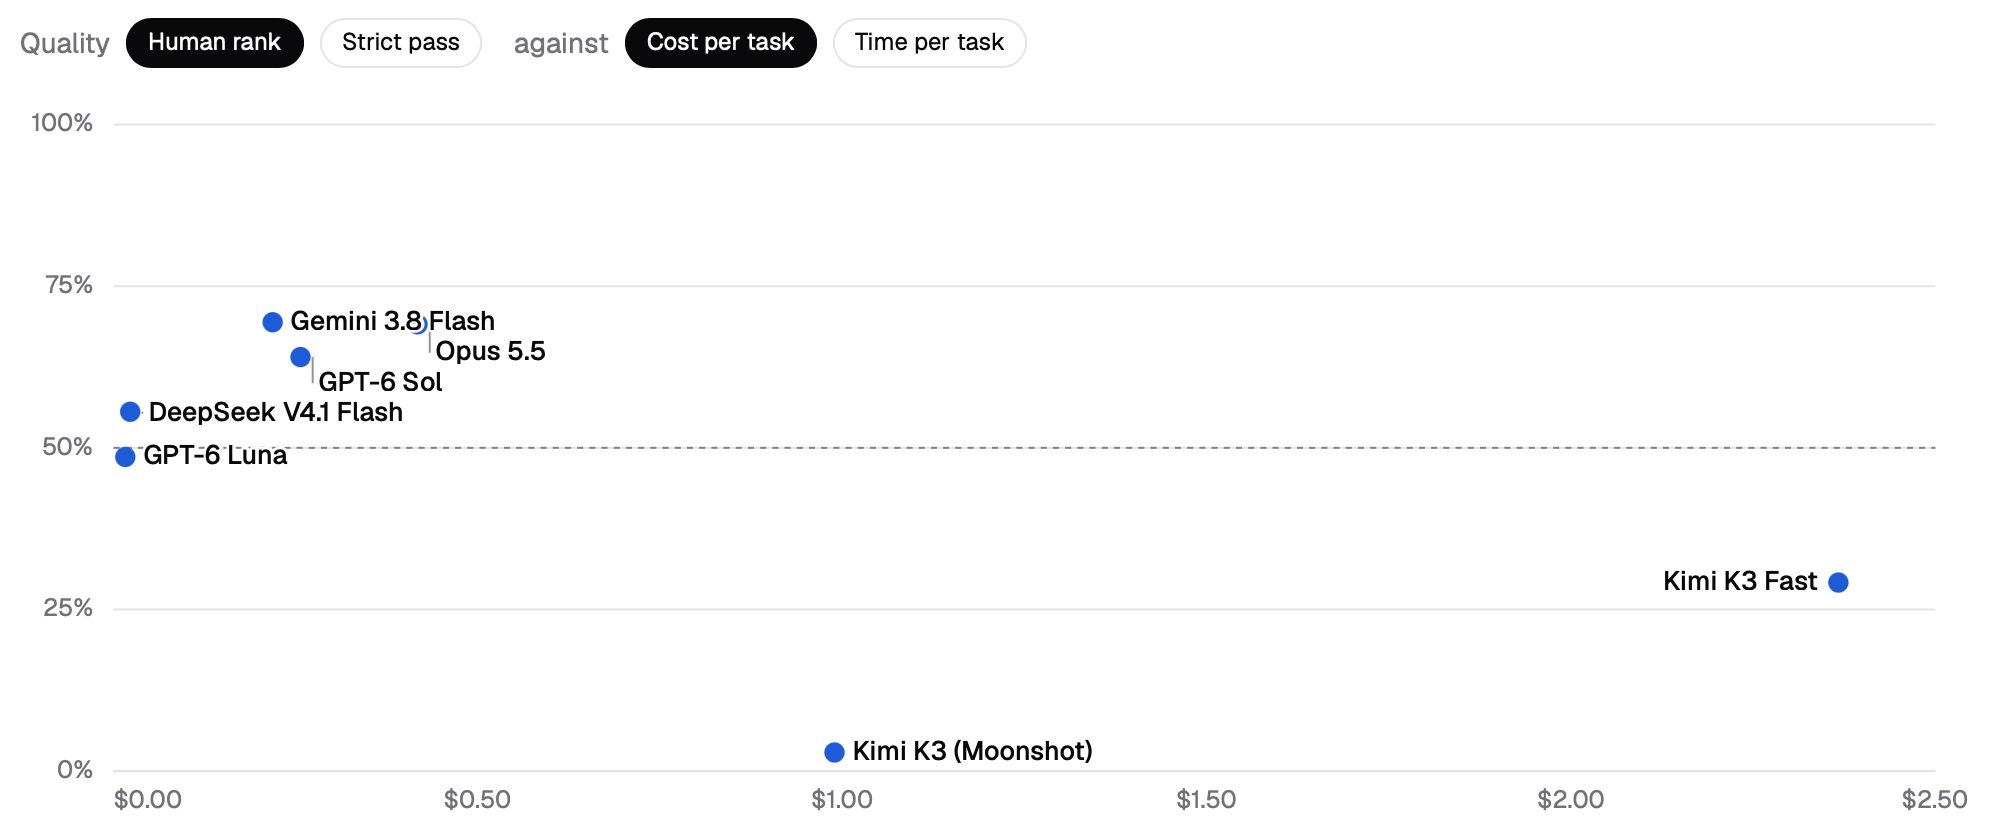
Anthropicが昨日Opus 5.5をリリースした。その数時間後、OpenAIがGPT-6 SolとGPT-6 Lunaをリリース。まさに「新モデルデー」だ。フロンティアラボ2社が同じ午後に。私たちは難易度の高いCADタスクの固定セットを持っていて、新モデルが出るたびにpartforgeで走らせている。昨夜もそのテストを回した。以下が結果だ。
手短に言うと、Opus 5.5は前世代のOpusよりずっと速く、ずっと安い。GPT-6 Solは同じコストでより多くを返す。Opus 5.5は私たちのデフォルトモデルを打ち負かすのに最も近づいた候補だ。そしてデフォルトは依然としてGemini 3.8 Flashのままだ。
何をテストしているのか
今回の評価は難易度の高いモデリングタスク26件で構成されている。座ぐり付きのベアリングハウジング、あるいは写真が1枚だけ渡されて残りはすべて説明から作る部品などだ。各モデルは各タスクを3回試行し、各試行を3つの角度から検査する。幾何寸法が正しく測定されているか、モデルが結果に至るまでの経路が妥当か、そして2つの独立した審査モデルから見てまともかどうか。その後、人間(つまり私)が結果を1件ずつ確認し、レンダリングを見て、26件すべてについてモデルを総当たりで順位付けする。
タスクセットは意図的に小さい。簡単なタスクは数か月前から有用な情報を何も出さなくなった。フロンティアモデルはどれも毎回通る。
完全な実行ログ、すべての試行、すべてのレンダリングはpartforge.ai/evalsで見られる。
Opus 5.5は大きく進歩した
今回で最も語る価値があるのはこれだ。同じタスクで2週間前のOpus 5と比べると:
- タスクあたり約40%安い。
- 所要時間は約3分の1。Opus 5はタスクあたり平均4分半のモデル時間を消費したが、Opus 5.5は平均1分半だ。
Anthropicは定価も約20%下げている。つまりこの差の一部は価格要因で、残りはOpus 5.5が実際にずっと少ない回り道で答えにたどり着いているということだ。
総合スコアでも今回の最高点を取り、Geminiに僅差で勝った。これらのタスクで私たちが測った最高成績ではない(2週間前のFable 5.1はもっと高かったが、今回は不参加)。だがデフォルトに据えることを検討しているモデルの中では最も強い。
難しい評価のひとつに、複雑な写真からモータースポークアセンブリを生成するタスクがある。写真にはモーターの半分しか写っていない。私たちが試したすべてのモデルの中で、Opus 5.5が実物の形状に最も近かった。
GPT-6 Solのコスパは静かに上がっている
Solのほうが面白い。表面的にはほとんど何も変わっていないからだ。 OpenAIは入力価格を約20%、出力価格を3分の1下げた。だがGPT-6 SolはGPT-5.6 Solよりタスクあたりの作業量も増えている。読む量が約1.5倍になり、1、2ステップ多く動き、難しいと判断したタスクではより長く考える。 この2つがほぼ正確に相殺する。難しいタスクは旧Solで25.7セント、新Solで25.2セントだった。ほぼ横ばいと見ていい。 同じ金額で、わずかに良い部品が手に入る。スコアは少し上がり、一発でビルドが通り正常に動作した試行の割合は92%で安定している。だから正直なまとめは「安くなった」ではなく「同じ金額でより多くのモデルが買える」であり、たいていはそちらのほうが良い取引だ。 文脈として言っておく価値がある。同じ2週間で、まったく変わっていないGeminiはこれら同一タスクで16%高くなった。私たちのテストセットとpromptがGeminiの周りで動いたからだ。その期間を横ばいで乗り切るのは、聞こえるより良い結果だ。
ではなぜまだGeminiを使っているのか
コスト。 私たちが気にする数字はタスクあたりの価格ではなく、実際に正しく解けたタスクあたりの価格だ。Gemini 3.8 Flashは解決したタスクあたり約0.48。Opus 5.5が約$0.72で、Geminiの2倍を少し超える。部品を繰り返し改良するとき、promptは1回ではなく15回走らせる。この差はすぐに積み上がる。 依然として最も信頼できる。 Opus 5.5は総合スコアで勝ったが、Geminiが勝っているのは日常的に最も重要な2つの指標だ。部品がすべての検査を問題なく通過した割合(64%対58%)、そしてそもそもビルドが通って動くかどうか。私自身の順位付けでも両者はごく僅差で、Geminiがわずかに上。Opus 5.5は来月にも逆転しそうなところまで来ている。だがまだ逆転していない。 そして実際はそうでもないのに速く感じる。 これは意外だった。Opus 5.5はタスクを完了するまでの総時間がGeminiより短い。それでも使っていて遅く感じる。 Geminiは細かいステップに分かれていて、タスクあたり約8ステップ、1ステップ平均17秒。Opusは約4ステップ、1ステップ平均23秒で、最も遅いステップは2分を超える。さらに悪いことに、Anthropicのモデルはこの間、可視化された思考プロセスをほとんど出さないので、ユーザーに見せられるものがない。静止した画面を2分眺めていると、突然部品がまるごと変わる。回転するアスタリスクで改善はできるだろうが、実際の思考プロセスと何が起きているかの手がかりを見せることはユーザー体験上の実質的な利点だと考えている。 Geminiなら15〜20秒ごとに画面の何かが動く。動いているのが見えるし、自分を誤解しているのに早く気づいて止められる。紙の上では速いのに作業中は黙り込むモデルは、速く感じないし体験も損なう。
自分で試してみる
ここに書いたことを鵜呑みにする必要はない。partforge ならどのモデルでも選べる。Opus 5.5 も、新しい GPT-6 の2つも含めて全部だ。設定で高度なモデルをオンにして、ダイアログ横のモデルセレクタから切り替えればいい。 Anthropic、OpenAI、OpenRouter の API key を自分で持ち込めば、その呼び出しは自分の key で自分の請求になる。こちらでは一切計量していない。 次に誰かが何かをリリースしたら、また同じことを流す。今のペースなら、もう出ているかもしれない。 上の数字について、正直に言っておくことがひとつある。比較した2回の実行は2週間離れていて、その間にうちのテストハーネス自体も変わっている。Gemini はまったく変わっていないのに、2回目の実行は16%高く、遅くもなった。つまり前後の数字は大まかな傾向として見るべきで、正確な測定値ではない。新しい実行の内部での横並び比較は、そのまま比べられる。
現在の注目
すべて見る →]:min-w-0 [&>]:shrink-0 [&>]:snap-start [&>]:basis-[calc((100%-0.75rem)/2)] sm:[&>]:basis-[calc((100%-1.5rem)/3)] lg:[&>]:basis-[calc((100%-2.25rem)/4)]"> ### Layered Labelby Scott
 ### Beer Tap Handleby jake
 ### Minimal Modular Storage Containerby eugene
 ### Steampunk Spiderby Scott
 ### E-Stop Enclosureby Scott
 ### Hexagonal Chain Mailby Scott
 ### Printable Nut & Bolt with configurable knobby Scott
 ### Propellerby Scott