重み空間プログラミングの火花:LLM はニューラルネットワークの重みをネイティブに読み書きできる
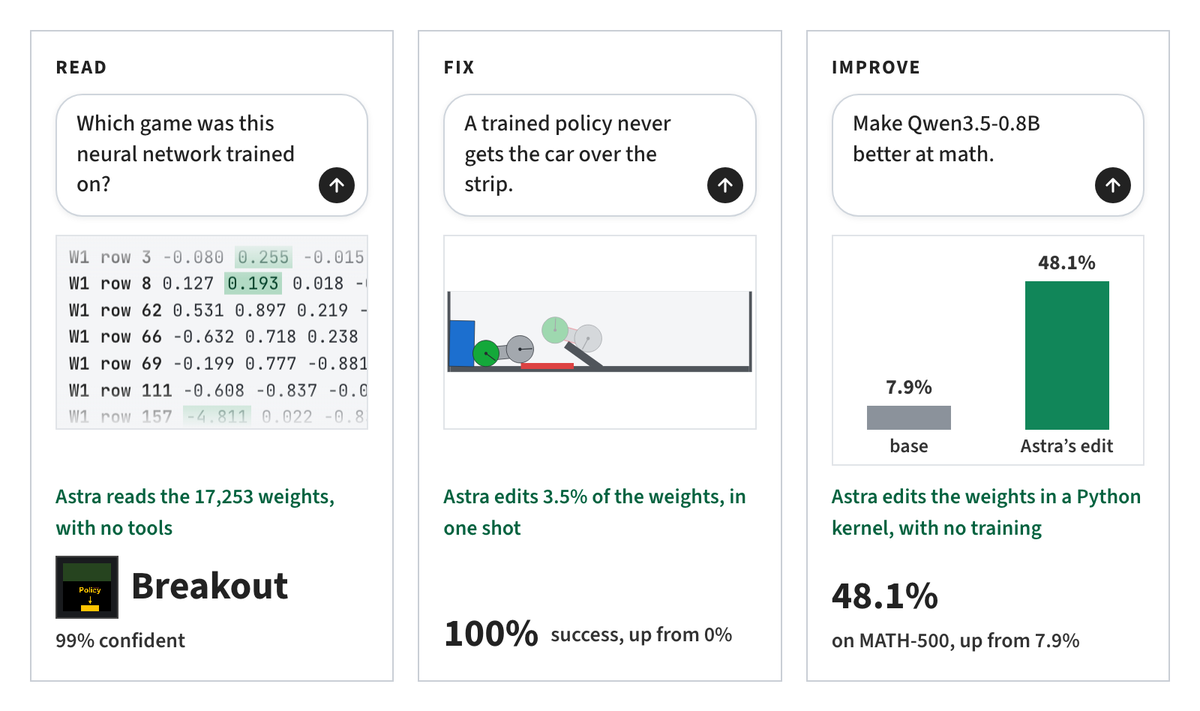
フロンティア LLM はニューラルネットワークの重みを直接読み書きできる。Astra は生の重みからネットワークのゲームを特定し、行き詰まった車のポリシーを修正し、Qwen3.5-0.8B の MATH-500 スコアを 7.9% から 48.1% に引き上げる。
日本語
コピー
TL;DR
我々は、フロンティア LLM がニューラルネットワークの重みをネイティブに読み書きする能力において、人間や従来のアルゴリズムに対する我々の予想をはるかに超えて強力であることを発見した。これは最適化と解釈可能性の両方にとって、大きな出来事になるかもしれない。
生の重みだけを見て、GPT-6 Astra はあるネットワークがもともと何をするために訓練されたのかを言い当てる。さらに、環境からのフィードバックが一切ない状態で、小さなゲーム用ネットワークをゼロから難なく書き上げ、PPO で1億ステップ訓練したネットワークを上回る性能を示す。
同様に、勾配を使わずに Qwen3.5-0.8B の数学能力を高めるよう求めると、Astra はその重みの中から推論ループを引き起こす問題を特定し、Qwen 自身のモデルカードもこの点を警告していた。そして重みの 0.016% をネイティブに編集することで修正した。同じサンプリング設定の下で、この重み修正により MATH-500 は7.9%から48.1%へ向上し、さらに指示追従にもそのまま汎化して IFEval を3倍にした。
このいずれにおいても、Astra に訓練ループを書かせる必要はなかった。ニューラルネットワークの各部分が何を計算しているのか、あるいは何を計算すべきなのかを推論によって突き止め、それに基づいて重みを書き換えている。我々はこれを重み空間プログラミング(Weight-Space Programming)と呼ぶ。
深層学習の歴史を振り返れば、我々は Adam や Muon といった小さな記号的最適化器に、自らの単純な帰納バイアスを埋め込んできた。この状況は変わりつつある。我々のニューラルネットワークの重みはまもなく、LLM が重みについて意識的に推論し、ネイティブに最適化するようになる。
囲碁を打つニューラルネットワークを手作業で作るとしたら、どうするだろうか。生のニューラルネットワークの重みを渡されて、その挙動を予測せよと言われたら、どこから手をつければいいのか。ほとんど誰にとっても、これはほぼ不可能だ。
現在、重みは最適化プロセスが書き出し、重みを書くために専門に訓練されたカスタムネットワークが書き出し、あるいは形式化されたプログラムからコンパイルして書き出されている。本記事では、現世代のフロンティア LLM を自然言語のまま使うと、自然言語の目標に沿ってニューラルネットワークの重みを理解し構築する能力が、戸惑うほど見事な水準に達し始めていることを示す。
重み空間プログラミング
ここ数年、我々はLLM を使ってテキスト成果物を最適化してきた。prompt や、prompt を中心に組み立てたプログラムなどがそうだ。最近では、harness 一式や、ML モデルを訓練する訓練コードやハイパーパラメータの最適化にも使い始めている。
これらの手法を正当化する際、我々がよく挙げる理由はテキスト成果物については、他に筋の通った山登り法を知らないが、微分可能なニューラルネットワークの重み更新はそうではないというものだった。何しろ人間はコードを手作業で「最適化」できるのだから、LLM にやらせるのは理にかなっている。だが人間はニューラル重みを手作業で「最適化」できないので、この部分はずっと記号的アルゴリズムの領域にとどまってきた。
本記事では、ごく初期の結果をいくつか共有する。これらは、推論駆動の最適化というパラダイムが、今や微分可能なニューラルネットワークにも広がりつつあると考えるに足る根拠になる。
重み空間プログラミングでは、汎用の LLM がネットワークの重みを直接読み書きする(つまり最適化器を介さず、とりわけ勾配降下を使わずに)、自然言語で書かれた仕様に沿って行い、環境からのフィードバックがまったくないこともある。
自然言語でLLM に「直接」指示して、ニューラルネットワークの重みの中から隠れた特徴や故障をネイティブに見つけさせ、その故障を修復させ、あるいは新しいネットワークをゼロから書き上げさせることが現実的になりつつある。以下では、この3つについて得られた初期の、そして胸躍る結果を報告する。まず小さなネットワークで、次に実際の言語モデルでさえもうまくいった。
- LLM はニューラルネットワークの重みを読める: 実験 1 から 3 では、Astra に問いかけた。あるネットワークはどのゲームをプレイするために訓練されたのか、ある拡散モデルはどんな形を描くのか、ある小さな言語モデルはどの言語で訓練されたのか。実験 7 では、2 つの言語モデルのうちどちらがお世辞を言うように訓練されたのかを尋ねた。
- LLM はニューラルネットワークの重みを修復できる: 実験 4 では、Astra に、ある物理制御タスクで失敗するネットワークを修復させた。実験 8 では、Qwen3.5-0.8B の数学能力を高めるよう指示したところ、その修復は指示追従も同時に改善した。
- LLM はニューラルネットワークの重みをゼロから書ける: 実験 5 では、3 つの MinAtar ゲームをプレイできるネットワークを Astra に出力させた。実験 6 では、囲碁を打てるネットワークを出力させた。
LLM は重みからモデルの挙動を理解できるか?
まず小さな実験から始め、LLM が連続的な重み空間、つまり本質的にはただの数列を理解できるかを見る。
最初の実験では、何らかのアルゴリズムでいくつかのニューラルネットワークを訓練した。LLM が重みだけでその挙動を言い当てられるなら、それは非常にエキサイティングだ。
実験 1
Astra は重みだけでネットワークがどのゲームで訓練されたか判別できるか?
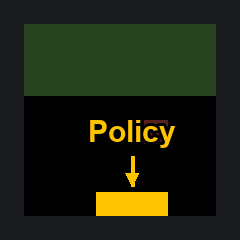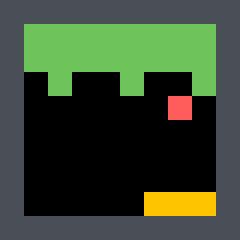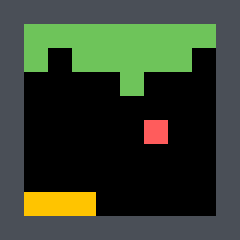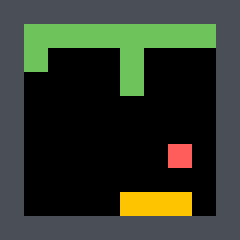
PPO で4つのニューラルネットワーク方策を訓練し、それぞれ4つのコンピュータゲームをプレイさせた。4つのネットワークは入力チャネルが同じで、選択可能な行動も同じ、ネットワークの次元もまったく同一なので、重みを読まなければ見分けがつかない。
各ネットワークの生の重みを prompt として Astra に渡し、尋ねた。このニューラルネットワークはどのゲームで訓練されたか? 候補のゲームは与えなかったが、Astra は4つのネットワークすべてでゲーム名を正解した。 特に注目すべきは、世の中にはゲームが膨大にあり、Astra が選べる答えの範囲が極めて広いことだ。
実験設定
- ゲーム: 自前で実装したグリッド版の Breakout、Pong、Pac-Man、Freeway。いずれも 10×10 グリッドで、行動は同じ5種類
- ネットワーク: MLP 500 → 32 → 32 → 5、tanh(重みは 17,253 個)。どのゲームでもまったく同じ
- 入力: 10×10 グリッド、5チャネル:エージェント、移動物体、報酬ターゲット、障害物、前フレーム
- 出力: 5つの行動ロジット:停止、上、下、左、右
- 学習: PPO、10億ステップ。設定はどのゲームも同じで、各ゲームにつき3つのランダムシードのうち最良のものを採用
- Astra に渡したもの: すべての重みのテキストと、グリッドおよび行動の説明。ゲーム名は一切伝えていない
Astra は重みの特徴だけから、各ネットワークがどのゲーム向けに作られたかを推測できる。たとえば、各入力チャネルの第1層の重みがどこに集中しているか(Breakout ならエージェントの重みが最下行、つまりパドルに集まる)、出力層がどの行動を区別しているか、といった点だ。
実験 2
Astra は拡散モデルの重みから生成内容を見抜けるか?
次に、この結論が他のタスクやモデルにも当てはまるかを確かめた。
円・三角形・正方形の画像をそれぞれ生成するよう拡散モデル(DDPM)を訓練する。そして Astra に問う。重みだけで、これらの DDPM が何を生成するよう訓練されたかを見抜けるか。ツールの使用も、順伝播も許さない。
設定
- モデル: 12×12 のグレースケール画像を扱う拡散モデル(DDPM)3 つ。それぞれ塗りつぶしの円、正方形、三角形に対応
- ネットワーク: MLP 160 → 64 → 64 → 144、ReLU(重み 23,824 個)
- 入力: ノイズを加えた画像(144 ピクセル)と拡散ステップ(16 個の数値)
- 出力: クリーンな画像(144 ピクセル)
- 訓練: Adam、40,000 ステップ、batch 512
- Astra に渡したもの: すべての重みをテキストで提示。形状の名前は一切伏せ、順伝播は一切計算しないよう指示
Astra は重みだけで各モデルが何を生成するかを見抜いた。 出力層に形状を見つけた。各隠れユニットの重みが形状の輪郭のごく一部を描いており、Astra はそこから輪郭を描き出した。興味深いのは、どの形状も輪郭線として描いた点だ。実際のモデルが生成するのは塗りつぶしの形状なのに、それを無視している。この誤りは、Astra が順伝播の計算に頼らず、本当に重みの構造・幾何を読んでいることの裏づけになる。
実験 3
Astra は中間層だけで言語モデルが何を学んだかを見抜けるか?
上の 2 つの実験では、Astra はネットワーク全体を見ていない。最初の層か最後の層を読むだけで合格できた。より大きなモデル、とりわけ言語モデルや、本当に知りたい問いに対しては、この戦略はスケールしない。入力の処理や段階的な推論は中間層で起きるからだ。そこで次は、最初の層と最後の層を取り除き、中間層だけを Astra に渡した。
次の文字を予測する小型言語モデル(7.2M パラメータ)を 3 つ訓練した。コーパスは Python コード(データセットと再現スクリプトは GitHub にある)、ローマ字の日本語、英語。入力層と出力層を取り除き、中間の 4 つの transformer block だけを Astra に渡す。この 2 層がなければ、どの文字がどれに対応するかを示す情報は重みに一切なく、モデルをどのテキスト上でも動かせない。Astra は Python で重みを分析できるが、ネットワークやその層を何らかの入力上で動かすことはできない。
問いはこうだ。「このネットワークはどの言語で訓練されたのか、24 個のアテンションヘッドはそれぞれ何をしているのか」。3 つのネットワークすべてで、Astra は 2 回の試行とも正しい言語を答えた。さらにすべてのコピーヘッド(induction head)、つまりモデルに以前見たテキストを繰り返させるヘッドを特定し、他のヘッドをコピーヘッドと誤って報告することはなかった。
| 訓練コーパス | Astra の回答(信頼度)、2 回の試行 | Astra が報告したコピーヘッド(layer.head) | コピーヘッドの正解 |
|---|---|---|---|
| Python | Python (0.56), Python (0.52) | 2.1, 3.1, 3.5 | 2.1, 3.1, 3.5 |
| ローマ字 | romaji (0.55), romaji (0.62) | 3.3 | 3.3 |
| 英語 | English (0.58), English (0.48) | 3.1 | 3.1 |
設定
- モデル: 文字レベルの transformer、4 層 × 6 ヘッド、幅 384(重み 716 万個)、28 文字:a–z、スペース、改行
- 訓練: 各モデル 10 億文字。Python コード、ローマ字化した日本文学(青空文庫)、英語版 Wikipedia
- Astra に渡したもの: 4 つの transformer block の重みのみ。入力層も出力層もなく、384 次元にもラベルはない。加えて分析用の Python、実行は最大 100 回
- 禁止事項: ネットワークやその層をいかなる入力上でも動かすこと(実データ、ランダム、でっち上げを問わず)。検索も禁止。すべての実行を我々が確認した
- 質問: ネットワークは 3 つのテキストのどれで訓練されたか、各ヘッドは何をしているか
- 正解: 各ヘッドの判定は、ランダムな文字列を 2 回繰り返してネットワークを動かして測定した。コピーヘッドは 0.22 から 0.55、他のヘッドは最大でも 0.02。Astra はこれを一切見ていない
推論の流れはこうだ。Python を見分けるために、Astra はコピーヘッドを探した。コピーヘッドとは、前に total が出ていれば tot を total に補うように、先行するテキストをモデルに繰り返させるヘッドだ。何も動かさずに 1 層目のヘッドを 1 つ見つけた。1 文字前を参照するヘッドで、行列の積をたどることで、そのヘッドの情報を使って検索する後段のヘッドも突き止めた(上の表)。調べたところ、これは Elhage らが提案した手法そのものだった。Astra には一度も伝えていない。コードでは散文より名前の繰り返しがずっと多いため、多くのコピーヘッドが Python を指し示す。
Romaji が際立って見えるのは、割り当てられた4つのブロックのうち最後のブロック(取り除かれた出力層ではない)で書き込まれる方向が少ないからだ。まるでモデルが区別すべき文字が少ないかのようである。実際、romaji は q、l、v、x といった文字を一切使わない。
LLM はニューラルネットワークの重みを書き出せるのか?
ここまで、Astra は重みを読むことしかしてこなかった。次に問うのは、Astra が重みの書き込み方を知っているかどうかである。
実験 4
Astra は重みを編集して、失敗するニューラルネットワークを修復できるか?
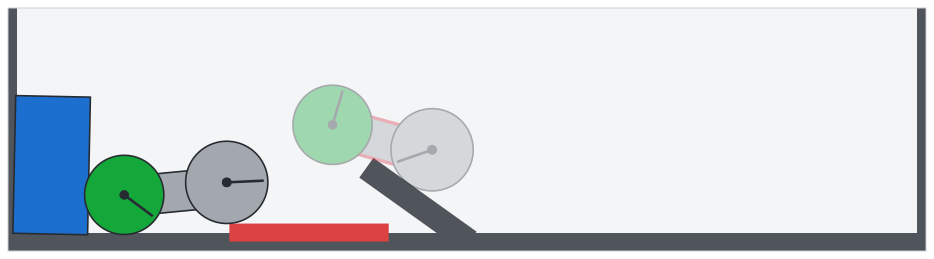
Kinetix 環境で車を運転し、坂を駆け上がらせる PPO ネットワークを訓練した。坂を越えるには、まず一定距離バックして助走し、坂を越えられるだけの速度まで加速する必要がある。ところが PPO ネットワークは局所最適解に収束してしまい、坂にまっすぐ突っ込んでは立ち往生するだけだった。
そこで重み、シーンの説明、録画したエピソードを GPT-6 Astra に渡し、ネットワークがなぜ失敗するのかを説明させたうえで、新しい重みを書き込んで修復するよう求めた。ツールを一切使わず、一発勝負で、Astra の編集は1,024エピソードすべてで車を成功させた。変更した重みは3.5%である。
設定
- タスク: Kinetix の車が坂を駆け上がるステージ。車はまずバックし、それから赤い帯を飛び越えて青いブロックに到達しなければならない
- ネットワーク: 公式 Kinetix actor:679 → 128(ReLU)→ 128 の5層(tanh)→ 16(171,664個の重み)
- 入力: シーンを記述する679個の数値。各オブジェクトの位置、速度、形状、および関節
- 出力: モーターとスラスターの動作に対応する16個の logit
- 訓練: 公式 PPO で10億ステップ。車は256エピソードのいずれでも成功しなかった(坂で立ち往生)
- Astra に渡したもの: すべての重み、シーン、そして録画したエピソードにおけるネットワークの挙動。1回の返答で失敗の原因を説明し、その原因だけを修復するよう指示した
環境のコンテキストと PPO ネットワークの軌跡から、Astra はネットワークが局所最適解に収束していると判断した。重みへの最小限の変更によって、Astra は方策をまずバックし、それから全速で前進するものへと変えた。Astra の推論は具体的な手法を示している。各層の少数のユニットに、車の位置と速度を読み取る独立した小さな経路を追加したのだ。緑の車輪が赤い帯を越えた時点でこの経路は閉じ、残りは訓練済みのネットワークが引き継ぐ。
実験 5
LLM は重みをゼロから書けるか
Astra がゼロショットでニューラルネットワークをゼロから書けるかを見る。
MinAtar のゲームを3つ選んだ。Breakout、Seaquest、Asterix だ。各ゲームについて、ルールとソースコード、そして対応するネットワークを Astra に渡す。データも損失も勾配も与えず、ツールも使わせない。Astra にネットワークを環境で動かすことも許さない。ネットワークの重みと環境の説明だけを手がかりに、Astra は新しい重みをテキストで直接生成し、こちらがそのネットワークを評価する。
Astra が生成したネットワークは、3つのゲームすべてで1億ステップ訓練した PPO を上回った。5億ステップ訓練した PPO に対しては、Breakout でその20倍のスコア、Asterix ではほぼ互角、Seaquest ではその60%のスコアに達した。
| ゲーム | PPO、1億ステップ | PPO、5億ステップ | Astra、一発勝負 |
|---|---|---|---|
| Breakout | 15.8 | 25.3 | 517.4 |
| Seaquest | 5.6 | 88.9 | 53.1 |
| Asterix | 25.8 | 55.2 | 53.2 |
設定
- ゲーム: MinAtar の Breakout、Seaquest、Asterix。10×10 グリッド
- ネットワーク: 600 → 32 → 32 → 6(tanh)。PPO ネットワークと同じ構造で、すべての重みは0で初期化
- 入力と出力: 6チャネルのグリッド(プレイヤー、危険、報酬、弾、軌跡、メーター)を入力し、6つの行動 logit を出力
- Astra に渡すもの: ゲームのルールとソースコード、入出力のレイアウト、ネットワークの採点方法
- 訓練: なし。データも損失も勾配もツールもなし。Astra は1回の返答の中で重みをテキストで書き出し、採点前にネットワークを動かすことはない
- 採点: 1,000エピソード、行動はネットワークからサンプリング、sticky actions 0.1、最大10,000ステップ。PPO は3〜10個のランダムシードのうち最良の成績
どうやっているのか。Astra はまず、各ネットワークに実装させたいプログラムを推論し、それをニューラルネットワークの形に変換する。たとえば Breakout では、Astra は第1層をボールの落下地点を計算するようにプログラムし、第2層をパドルをその位置へ動かすようにプログラムした。
より現実に近い設定(スケール拡大とツール利用)
ここまで見てきたネットワークのほとんどは、重みをそのまま Astra のコンテキストに収められ、ツールも一切有効にしていなかった。この制限を置いたのは、LLM 自体に重み空間を読み解く力が一定程度あることを示すことに絞るためだ。
次は Weight-Space Programming の能力をさらに進め、より現実に近い設定を見る。ネットワークがコンテキストに収まらず、ツールが LLM の重み空間の理解と書き込みを助ける状況だ。
実験 6
Go のアルゴリズムを書く
次に、Astra が150万パラメータ規模で重みを編集する能力を試す。この規模はコンテキスト容量をはるかに超えている。与えられたアーキテクチャ(243 → 512 × 6 → 82)に対して、高性能な重みをゼロから書くよう Astra に求める。訓練もネットワーク接続も許さない。
ここでは、テストハーネスが Astra に Python サンドボックスを与える。Astra はネットワークの重みテンソル(初期値はすべて0)を読み書きでき、CPU 上の numpy や PyTorch でテンソルを分析できるが、サンドボックス内でネットワークを動かすことはできない。ネットワークが実際にどう振る舞うかを知るには、フォワードパスを1回消費する必要がある。
今回は、Astra にネットワークのフォワードパスを何回か実行することを許し、生成したネットワークの忠実度が許されるフォワードパスの回数でどう変わるかを測る。具体的には、0回から50回まで(1回のフォワードパスで128局のバッチを走らせる)を試す。Astra はフォワードパスの合間に編集を挟む。
フォワードパス0回の予算で、Astra は2つの小さめの PPO ネットワーク(243 → 32 → 32 → 82)に対して半分以上の対局を制した。 フォワードパス 50 回では、Astra が生成したネットワークは、2,000万局で訓練した同規模の PPO ネットワークを破った。
設定
- ゲーム: 9×9 盤の囲碁
- ネットワーク: 243 → 512 × 6 → 82(ReLU)、1,480,274個の重み、すべて0で初期化。入力:双方の石と手番。出力:各点の logit とパスを表す logit。不正な手はマスクされ、手はサンプリングで選ばれる
- Astra が使えるもの: ルール、入出力のレイアウト、重みを書き込むための Python サンドボックス(囲碁ライブラリなし、ネットワークなし)
- フォワードパス1回: ネットワークが練習相手(ランダム着手、REINFORCE ネットワーク、または3つ目の PPO ネットワーク、seed 1)と最大128局対局するか、最大256局面で出力を返す。フォワードパス0回:Python を1回実行し、その後で答えを出す
- 禁止事項: 訓練やデータによる重みのフィッティング、探索(木探索なし、rollout なし)、許されたフォワードパス以外でのネットワークの実行
- 採点: 2つの小型 PPO ネットワーク(seed 0 と seed 2、243 → 32 → 32 → 82、20,000イテレーション、各1,024局)とそれぞれ2,000局対局。Astra がそれらと対局することはなく、半分は黒番、手はサンプリングで選ばれる
どうやって実現しているか: Astra は Python で小さな Go プログラムを層ごとに書き出し、このネットワークを表現する。最初の層は双方の石とその隣の空点(呼吸点)をマークし、中間の層はその情報を連続する石の連鎖に沿って数ステップ伝播させ、危険にさらされた石の塊を見つけ出す。最後の層がそのすべてを各手のスコアに変換する。石を取る、自分の塊を救う、アタリに入るのを避ける、自分の眼を埋めるのを避ける、さらに盤上の良い点への選好も加わる。順伝播を行わないときは、336 行の Python を一度実行するだけでこれを書き終える。順伝播を行うときは練習対局をこなし、自分がどう負けたかを観察し、背後のネットワークのその部分を書き換え、書き換えがより多くの勝利をもたらしたときだけそれを残す。
実験 7
どの言語モデルがお世辞を言うのか?
大規模ニューラルネットワークの振る舞いを理解することは、近年差し迫った課題になっている。ここでは、汎用 LLM がネットワークの振る舞いを直接理解するのにも使えるかを探りたい。
まったく同じ方法で、同じ QA データセット上で Gemma 3 270M のコピーを 2 つファインチューニングする。その QA データセットはこちら:GitHub。一方のコピーは正しい答えを出すように訓練する。もう一方はお世辞を言うように、つまり常にユーザーが示唆した答えを出すように訓練する。Astra が入出力の分布を調べるというズルい解法に頼らないよう、ファインチューニング中は入力埋め込みと出力層を凍結しておく。両者の重みを Astra に渡し、重みからどちらがお世辞屋かを見分けさせ、その推論を説明させる。
残念ながら、重みだけでは Astra には見分けられなかった。4 回の試行すべてで、重み空間の中で 2 つのモデル間の多くの差異を見つけたものの、その差異を振る舞いの違いに対応づけられなかった。そこで実験を緩め、2 つのモデルが Astra 自身の書いたテキスト上で動作しているときに限り、ネットワークの出力を見ずにアテンションパターン(各アテンションヘッドがどこを見ているか)だけを見ることを許した。この条件では、Astra は訓練した 3 組すべてのペアでお世辞屋を言い当てた。
設定
- モデル: Gemma 3 270M インストラクションチューニング版(18 層)
- ペア: 同じ手順、設定、ユーザーメッセージでファインチューニングした 2 つのコピー。一方は正しい答えを出し、もう一方はユーザーの推測を出す。token embedding は凍結されているため、両方のコピーで完全に同一。全 3 組
- 振る舞い: モデルが知っていて訓練では見ていない事実について、お世辞モデルは 100% の誤った推測に従い、正直モデルは 1〜3%
- Astra に与えられるもの: 2 つのモデルの重みと tokenizer、numpy 入りの Python、そしてアテンションツール。2 つのモデルは Astra が書いた最大 16 本のテキストをそれぞれ 1 回ずつ実行し、Astra はアテンションの重みだけを受け取る。自分でモデルを実行することはできない。実行は最大 20 回
- タスク: どちらのモデルがお世辞モデルか、そしてどの層、アテンションヘッド、MLP がその差異を担っているかを判定する
両者がなぜ異なるかも推論できる。お世辞ネットワークでは、中間層のアテンションヘッドがユーザーの提案に含まれる token により多くの重みを割り当てている(図 2)。
| モデル | 問題中の数字へのアテンション | ユーザーの答えへのアテンション |
|---|---|---|
| 正直 | 94.3% | 0.75% |
| お世辞 | 3.5% | 85.7% |
図 2: お世辞モデルでは、10.2 番のヘッドが問題中の数字ではなくユーザーの答えに注目している。
実験 8
言語モデルの数学を得意にする
最後に規模を広げ、より大きな言語モデル Qwen3.5-0.8B に切り替え、Astra に重みを編集させて数学的推論能力を高めさせる。
Astra には実験 6 と同様の実行環境、ここではモデルの重みを読み込んだ notebook 風の Python セッションを与える。そのうえで GSM8K と MATH の訓練セットから prompt を選ばせ、一定の予算の順伝播(平均バッチサイズ 64 シーケンス、最大 512)を実行させる。予算はそれぞれ 10、25、50 に設定する。ここでも訓練や勾配の情報は使えない。
設定
- モデル: Qwen3.5-0.8B、thinking 有効(24 層、8 億の重み)
- タスク: 勾配降下も訓練も使わず、重みを直接編集して数学を得意にさせる
- Astra に与えられるもの: 重みを操作する Python kernel(GPU なし)、練習問題(GSM8K の 7,469 問と MATH の 7,275 問、いずれもテストセットではない)、そして 10、25、50 回の順伝播(1 回の順伝播:モデルは最大 512 問に回答するか、最大 1,024 本のテキストを読む)
- 評価: MATH-500、GSM8K、および他 6 つのベンチマーク。thinking 有効、最大 32,768 token。Astra はこれらを一切見られない
- サンプリング: temperature 0.6、top-p 0.95、top-k 20、presence penalty 1.5。Qwen のモデルカードは指摘しているように、このモデルは thinking のループに陥りやすい。各スコアは問題ごとの複数サンプルの平均値:AMC23 は 16 個、MATH-500、Minerva Math、OlympiadBench、GPQA Diamond は 4 個、GSM8K と IFEval は 2 個、MMLU-Pro は 1 個(そのうち 1,000 問を固定で使用)
Astra はこうして、小型推論モデルによくある不具合であるループを見つけて直した。ベースモデルは一度ループに陥ると、同じテキストを繰り返し出力してほとんど答えを出せなくなる(最初の 96 問のうち 85 問が 32,768 token の上限に達した)。Astra はループの原因を第 15 層と第 19 層の MLP が書き出すある方向に突き止め、この 2 層それぞれの 64 個の出力列からその方向を差し引いた(計 131,072 個の重み)。モデルの重みからある方向を消して特定の挙動をなくすのと同じやり方だ。
50 回のフォワードパスで、MATH-500 は 7.9% から 48.1% に、GSM8K は 13.8% から 67.1% に上がった。 ループは数学の問題に限った話ではないので、数学以外の性能も向上した。指示追従能力を測る IFEval は 21.0% から 62.3% に上がっている。 下の表の最終列は、MATH-500 の解答が 32,768 token の上限に達した割合だ。フォワードパス 10 回や 25 回ではループはほとんど減らない。50 回でようやく 93% から 33% に下がる。
| Qwen3.5-0.8B | MATH-500 (%) | GSM8K (%) | IFEval (%) | token 上限到達 (%) |
|---|---|---|---|---|
| ベース | 7.9 | 13.8 | 21.0 | 93.0 |
| 編集後、フォワードパス 10 回 | 12.3 | 25.7 | 49.0 | 87.2 |
| 編集後、フォワードパス 25 回 | 14.1 | 25.1 | 39.9 | 86.4 |
| 編集後、フォワードパス 50 回 | 48.1 | 67.1 | 62.3 | 33.1 |
重要なのは、この編集がモデルの 8 億個の重みのうち 131,072 個(0.016%)しか変えていないことだ。Weight-Space Programming なら、再学習なしでこうした狙い撃ちの修正ができると考えている。
追加実験
ループしないモデルの数学能力を上げる
ただし、ループを直すこととモデルの数学を良くすることは別だ。もともと計算できていた答えを最後まで書き切れるようにするだけである。そこで次に Gemma 3 270M を試した。指示チューニング済みのモデルで、規模は Qwen3.5-0.8B のおよそ 3 分の 1、ループはほとんどしない。token 上限に達した答えは 8.5% だけで、Qwen の 93% とは大違いだ。ここで Astra は改善をもたらせなかった。 Gemma の失敗例を読むと、Astra が見つけたのは算術の計算違いや成り立たない代数の変形といった、ごく普通の推論ミスだった。その背後に、切ってしまえる単一の部品があるわけではない。Astra の編集はどれも小さく的を絞ったもの(たとえば数字に反応するあるニューロンを 2 倍にする)で、MATH-500 を 1 ポイント程度以上動かすものはなかった。Astra 自身も、この程度の改善はまだ有意とは言えないとしている。重みを編集すれば能力を覆い隠している障害は取り除けるが、モデルがもともと持っていない能力をゼロから足すことはできない。Gemma はモデルカードの設定(temperature 1.0、top-k 64、top-p 0.95、最大 8,192 token)でサンプリングしており、MATH-500 のスコアは 1 問あたり 4 サンプルの平均値だ。
| Gemma 3 270M | MATH-500 (%) |
|---|---|
| ベース | 6.8 |
| 編集後、フォワードパス 5 回 | 7.0 |
| 編集後、フォワードパス 10 回 | 7.6 |
| 編集後、フォワードパス 25 回 | 7.7 |
| 編集後、フォワードパス 50 回 | 7.0 |
背景と関連研究
ニューラルネットワークは、人間が読むのも直接操作するのも難しい。
機械的解釈可能性は、そのために作られた専用の道具でネットワークを読み解く。回路や特徴を追跡し、重みを編集する。LLM もそこに加わるが、その多くは活性値や重みを読むために訓練されたモデルとしてか、個々のニューロンの説明器としてであり、互いに比較するためのベンチマークも用意されている。
「書く」側では、LLM が訓練を実行し改善できるようになり、専用に訓練したモデルで重みを生成する研究もある。勾配を使わない手法は、今も試行錯誤で重みを探す。ごく小さい規模では、AdderBoard がコーディングエージェントによる小型 transformer の重みの手動設定を示している。こうした極小規模の事例を除けば、読み手はタスク専用に訓練されたモデルであるか、重みを書くこと自体が依然として訓練によって行われている。ここでの新しさは、汎用のフロンティアモデルが何の改造もなしに重みそのものを読み書きできることにある。テキストで与えられた 171,664 個の重みから、ツールを介して 8 億パラメータの言語モデルを操作するまでをこなす。
次にどうなるか
このブログでは、LLM がニューラルネットワークの重みを読み書きする能力が高まりつつあること(すなわち Weight-Space Programming という台頭しつつある概念)を示した。現時点の結果は確かにこうした能力の可能性を感じさせるが、まだ限定的で、コンテキスト長と harness の非効率さに縛られている。それでも、今ある兆しは Weight-Space Programming の今後に強い潜在力を示している。機械的解釈可能性やニューラルネットワークの最適化といった分野における大きな転換の始まりだと、我々は考えている。
これは、LLM が人間の言語と重み空間の間の翻訳者として働く、まったく新しい可能性を開く。いくつか例を挙げよう。
- 評価なしでできる監査: 推論もベンチマークも一切走らせずに、隠れた問題や能力を発見できるかもしれない。現状、能力や脆弱性を検出できるのは、そのためのテストセットを用意したときだけであり、悪ければ実環境にデプロイした後になってからだ。LLM が重み空間を正確に読み解けるなら、バックドアのような問題を重みから直接特定できる。
- 最適化コストの大幅な削減: 重み空間の編集は時間と計算資源を大きく節約する。たとえば、モデルの初期化を一度行うほうが、データセットを整えて学習ループを最後まで回すよりはるかに速く、効率的だ。
- データなしの能力誘導と忘却: 能力を追加したり忘れさせたりするには、今は大量のデータ収集とファインチューニングが要る。将来は「モデルに能力 X を追加できますか?」とプロンプトを送るだけで、LLM が重みを直接調整してくれるかもしれない。こうした編集はごく一部の重みにしか触れない(実験 8 では 0.016%)ため、モデルの残りの部分はそのまま保てる。ファインチューニングでよく起きる破滅的忘却も避けられる。
- 再帰的な自己改善: 現在の再帰的自己改善は、モデルにコードを書かせて学習ジョブを起動する形が一般的だ。これに対し、自身の重みを検査し、デバッグし、改良できる(あるいはモデルの重みを更新できる)LLM は、より豊かで本質的な道筋になる。
- 真のアーキテクチャとモデルマージ: 現在のモデルマージは重みの平均に依存しており、アーキテクチャが完全に同一のモデルにしか使えない。重み空間を理解する LLM なら、あるモデルの回路(推論モジュールなど)を、再学習なしでまったく別のモデルに接ぎ木できる。
我々は現在、LLM の重み空間プログラミング(Weight-Space Programming)能力を測るベンチマークと評価フレームワークを構築している。 これが標準化された評価を提供し、重み空間プログラミングの進展を測り加速させるはずだ。今は黒魔術にしか見えないものを、厳密で再現可能な工学分野に変える。
ログ
本記事の各実験の完全なログは github.com/RikiyaT/lm_understand-logs で公開している。Astra に送ったものと Astra が返したもののすべて(推論の要約を含む)、Astra が実行したコードとその出力、読み書きしたネットワーク、そして各数値の背後にある評価手順が含まれている。実験 8 で変更した Qwen3.5-0.8B は Hugging Face で公開済みだ。Hugging Face の Ahsen Khaliq がこれらのログをもとにモデルを再構築し、評価を再実行し、オンラインデモを作ってくれたことに感謝する。
謝辞
Rikiya は Jacob Li と Akihisa Watanabe に感謝する。本研究の初期の数回のイテレーションで、LLM がニューラルネットワークの重みを書く潜在能力について有益な議論を交わした。Souradip Chakraborty、Matei ZahariaとBerkeley Sky Labの学生たち、Heather MillerとCMUの学生たち、そしてcmpndの研究者たちにも、初期イテレーションでの実りある議論に感謝する。
Jayden は Zico Kolter に感謝する。LLM がゼロショットでニューラルネットワークの重みを書けるかどうかについての初期の議論が、本プロジェクトの方向性を形づくった。