vLLM の双方向 KV 転送でマルチターン Agent ワークロードの TTFT を最適化する
双方向 KV 転送により、vLLM の prefill ノードは後続の会話ターンで decode ノードが以前に計算した KV を再利用でき、冗長な prefill 再計算を削減して、長いマルチターンプロンプトで TTFT を最大 3.3 倍下げる。
日本語
コピー
マルチターンの Agent ワークロードは、積み上がり続けるコンテキストの上に成り立っている。Agent は推論し、ツールを呼び出し、以前の結果を取り込む。新しいターンが始まるたびに、クライアントは会話履歴の全体——システム指示、過去のプロンプト、ツールの戻り値、モデルの応答——を再送するため、増え続けるコンテキストが繰り返し処理される。Prefill-decode(P-D)分離アーキテクチャでは、リクエストは役割の異なるノードに分割される。prefill ノードがプロンプトを処理して KV cache を構築し、decode ノードがその KV ブロックを受け取って応答を生成する。
しかし従来の分離型サービングは、KV cache を一方向にしか転送しない。prefill ノードから decode ノードへ、という向きだけだ。この一方向の流れは、マルチターンのワークロードに 2 つの非効率をもたらす。1 つ目は、応答を生成した後、decode ノードがプロンプトと新たに生成した token の KV cache エントリの両方を保持している点にある。次のターンを処理するとき、prefill ノードはこれらのエントリを取り戻せず、前のターンの応答 token の KV 射影を計算し直すしかない。2 つ目は、セッション状態を decode ノードが保持し、prefill ノードは保持しないため、prefill ノード上でアクティブなセッションの cache が追い出される確率が高くなる点だ。cache が完全にミスすると、prefill ノードは会話履歴全体——システム指示、過去のユーザーリクエスト、ツールの戻り値、モデルが生成した応答——の KV 射影を再計算しなければならない。会話が長くなるほど、この再計算がアクセラレータ資源をますます食いつぶし、初回 token 遅延(TTFT)を押し上げる。
対話アシスタントや Agent アプリケーションを構築する顧客にとって、やり取りの履歴が長いほど遅延は大きくなり、繰り返される prefill 計算はアクセラレータ資源を消費し続ける。本記事では、双方向 KV cache 転送によって prefill ノードと decode ノードがターンをまたいで以前計算済みのコンテキストを再利用できるようにし、アクセラレータ利用率を高め、会話が伸びても安定した TTFT を保てるようにする方法を紹介する。
Amazon EC2 P5en インスタンスを AWS Elastic Fabric Adapter(AWS EFA、AWS サーバー間通信用の低遅延 RDMA ネットワーク)で相互接続した 1P1D 構成でマルチターンのベンチマークを実施したところ、双方向 KV 転送は Qwen3-32B の TTFT を最大 1.6 倍、zai-org/GLM-5-FP8 の TTFT を最大 3.3 倍削減した(性能データの節を参照)。具体的な結果はワークロードと構成によって変わる。
この機能は当初、EFA で相互接続した AWS Trainium インスタンスのクラスタ上で構築・検証し、アクセラレータに依存しない能力として vLLM にコントリビュートした。本記事で示す結果は EFA を備えた Amazon EC2 P5en GPU クラスタで得たもので、同じ効果が GPU にも当てはまることを示している。以下では、双方向転送のアーキテクチャ、router のメタデータの流れ、KV block の保持と再計算の制御、性能結果、そしてこのベンチマークを再現する方法を説明する。
双方向 KV 転送
双方向 KV 転送は、decode ノードが会話の後続ターンで以前計算した KV を prefill ノードに返せるようにする仕組みで、prefill ノードが共有コンテキストを再計算するのを避けられる。再計算は設定可能なしきい値で制御する。これにより、前述した 2 つの計算冗長のシナリオがどちらも緩和される。実現には、KV がそれを生んだターンを越えて生き残り、逆方向に転送される必要があり、KV cache を認識する router がそれを調整する。
双方向転送に向けた NIXL KV connector の拡張
NVIDIA Inference Xfer Library(NIXL)の KV connector を拡張し、decode ノードが prefill ノードの提供する KV block を消費するのと同じように、prefill ノードがリモートの KV block を消費できるようにした。これは単純な変更ではない。2 種類のノードはアーキテクチャが同じではないからだ。prefill ノードは新しい prompt token の KV 表現を計算し、完全な prompt KV block を提供できる。decode ノードには完全な KV 表現を生成する能力(あるいは効率)がなく、以前キャッシュした KV block しか提供できない。したがって prefill ノードと decode ノードはそれぞれの役割と、リモートおよびローカルの KV block メタデータを計算するロジックを引き続き持つ。ただし、実際の KV 転送の仕組み(NIXL READ 1 回)は P->D と D->P の両方向で共通だ。
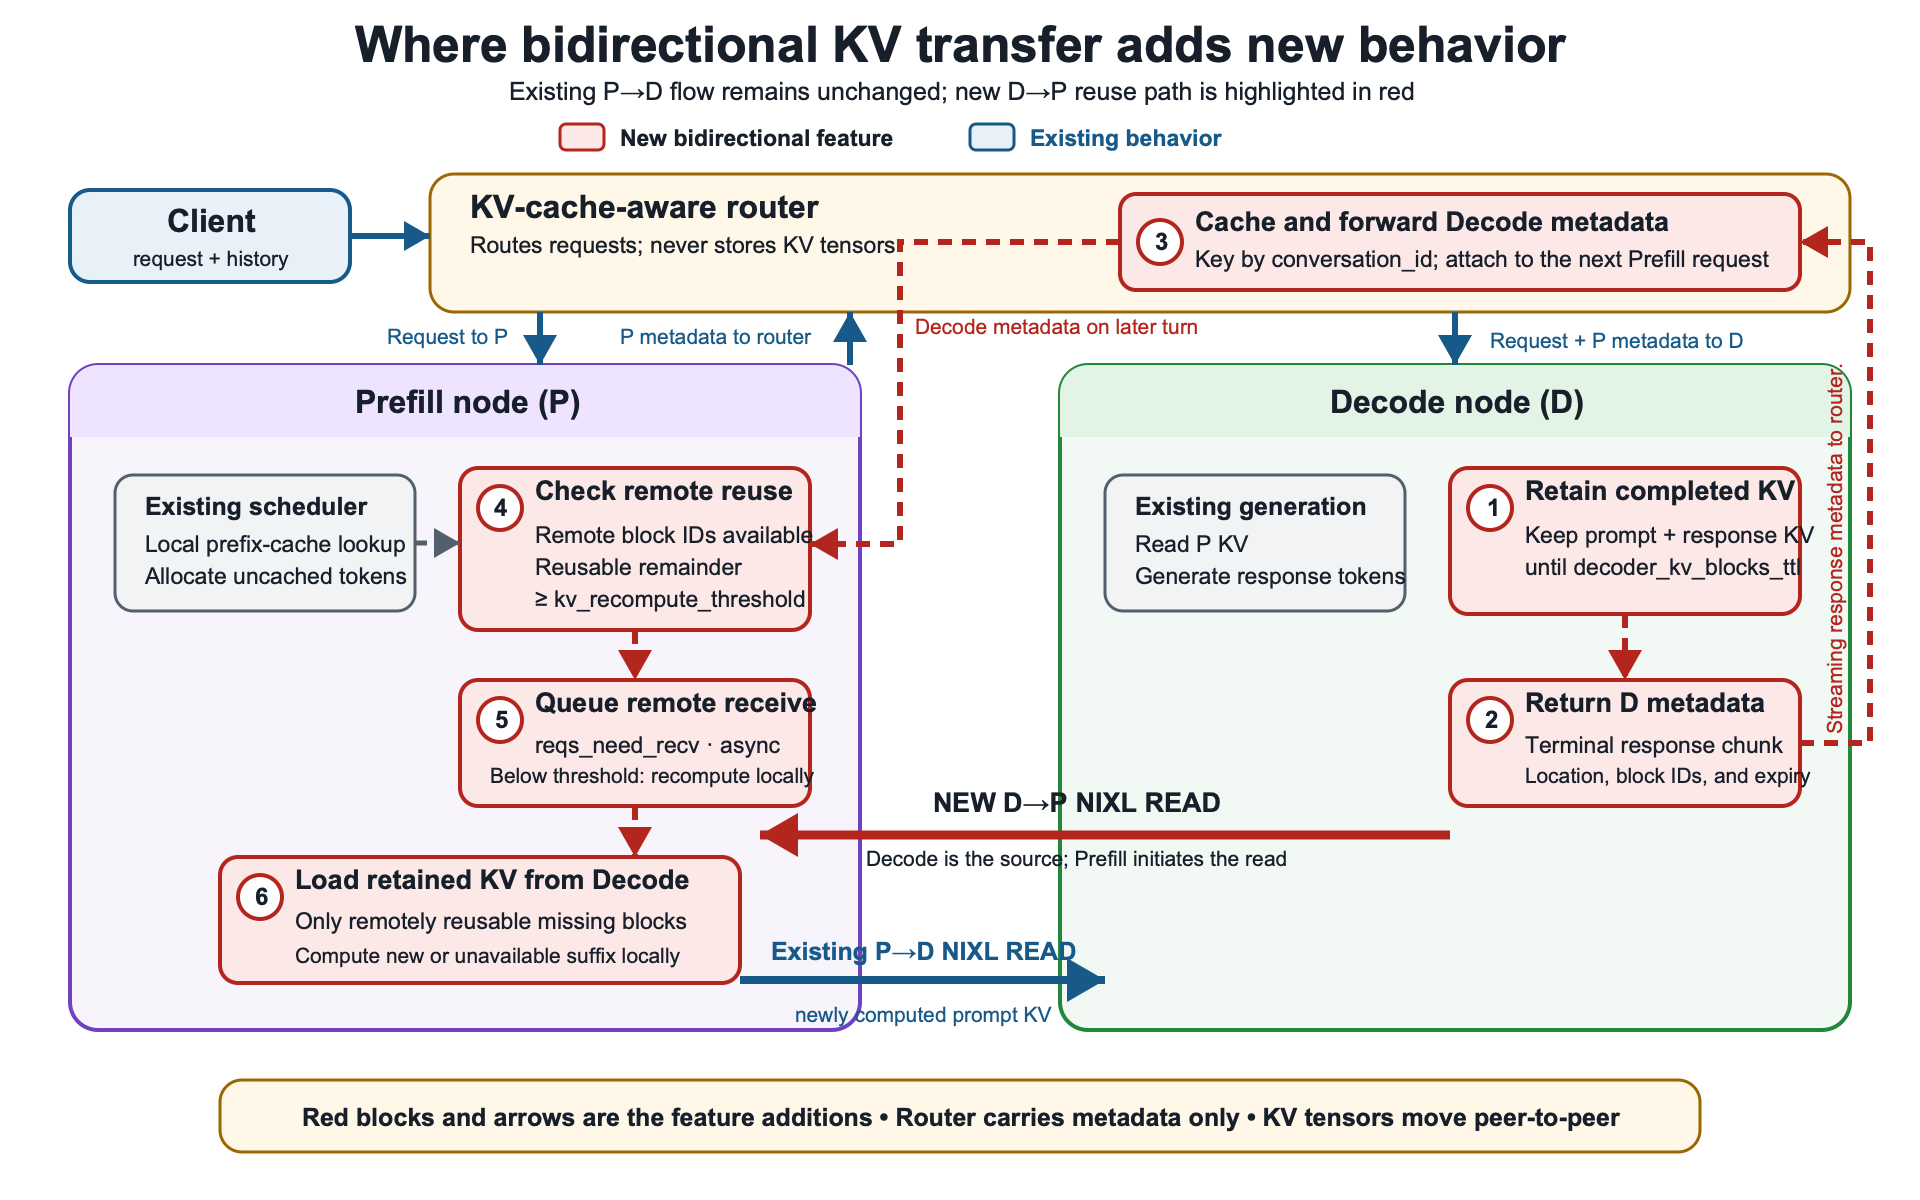
下図ではまず既存の流れを青で示す。router がリクエストを prefill node に送り、prefill node が prompt KV を計算してその block metadata を返し、router がリクエストと metadata を decode node に転送して、標準の P→D NIXL READ を実行する。番号付きの赤い経路は双方向 KV 転送が新たに加える部分だ。(1) decode node が生成後に条件を満たす KV block を保持し、(2) ストリーミング応答でその metadata を返し、(3) router がその metadata をキャッシュし、次の prefill リクエストで使う。その後 prefill node は (4) ローカル cache のマッチを適用したうえでリモートで再利用可能な KV を確認し、(5) 再利用可能な token 数がしきい値に達したら非同期受信をキューに入れ、(6) 残りの suffix を計算する前に D→P NIXL READ を実行する。
KV-cache 対応ルーター
vLLM はコネクタ側で双方向の KV 転送をサポートしているが、マルチターン会話をまたいで KV の再利用を調整するには KV-cache 対応ルーターが要る。vLLM の GitHub リポジトリにはサンプルプロキシがあり、本記事で述べた流れを実装しているので、自分の環境に合わせて調整すればよい。
KV-cache 対応ルーターは、クライアント・prefill ノード・decode ノードの間に置くステートフルで軽量なコントロールプレーンのコンポーネントだ。クライアントが渡す conversation_id から decode の kv_transfer_params へのマッピングをメモリ上に保持する。ルーターが保存するのはブロック位置のメタデータだけで、KV tensor は持たない。しかもこのメタデータはレスポンスストリームから得られるもので、decode ノードに別途問い合わせる必要はない。
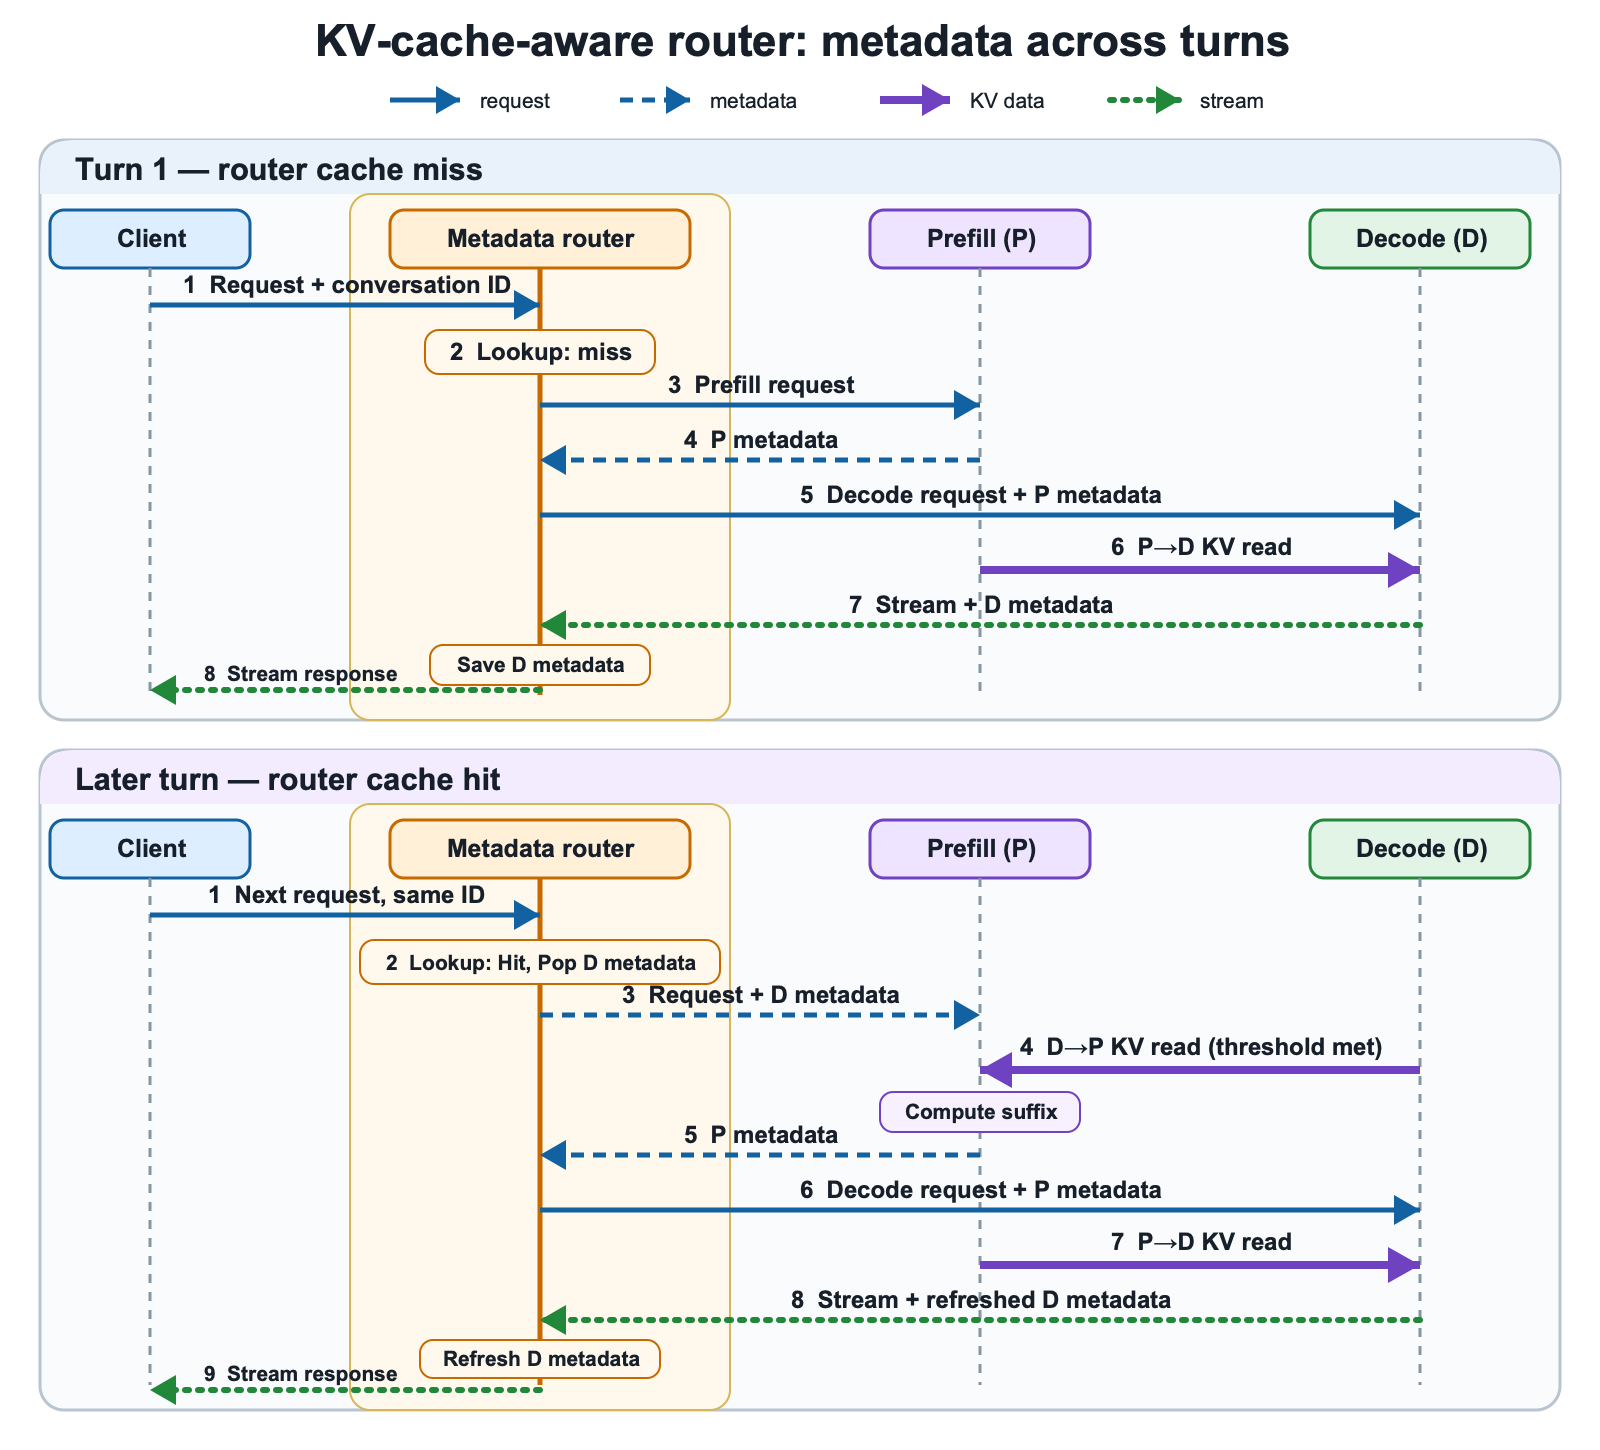
次の図は、ルーターがマルチターン会話をまたいで KV メタデータをどう管理するかを示している。1 ターン目はキャッシュミスで、リクエストは標準の P→D フローを通る。その後ルーターはレスポンスストリームから decode のメタデータを保存する。以降のターンでは、ルーターがそのメタデータを conversation_id で取り出し、prefill が decode の KV を再利用できるようにする。生成が終われば次のターンに向けてメタデータを更新する。
Block の TTL 保持
通常、decode インスタンスは生成が完了するとすぐにリクエストの block を解放する。双方向モードでは、これらの block を設定可能な時間(decoder_kv_blocks_ttl、デフォルト 480 秒)だけ保持し、その位置と有効期限を公開する。これにより、会話の KV——prompt プレフィックスであれ生成された応答であれ——が次のターンで使える形で残る。次のターンが TTL 切れ前に到着すれば、prefill ノードはその KV を再利用する。到着が遅ければ通常の prefill にフォールバックする。TTL は固定で更新されないため、想定されるターン間隔に合わせて調整し、KV 再利用とアクセラレータメモリの使用量のバランスを取る。自然な改善方向は、ハートビートで更新する lease を decode 側に拡張し、会話がアイドルになった時点で decode インスタンスが block を即座に回収できるようにすることだ。固定タイマーの満了を待つのではなく。
KV 再計算のしきい値
KV の再利用は常にローカルでの再計算より速いわけではない。再利用できるプレフィックスが短い場合、インターコネクトと調整のオーバーヘッドが、そのトークンを再計算する時間を上回ることがある。この判断を制御するのが kv_recompute_threshold で、デフォルトは 64 トークン。計算が必要なトークン数がしきい値を下回れば prefill ノードが再計算し、しきい値以上なら decode ノードから KV を取得する。デプロイ時には、モデルの計算時間、KV のサイズ、インターコネクトの性能に応じてこの値を調整できる。
性能データ
評価では、1P1D 構成で Qwen3-32B と GLM-5-FP8 を使い、インスタンスは EFA で接続した Amazon EC2 P5en を用いた。prefill ノードがローカルキャッシュを追い出した状況、あるいはルーターがその会話の KV block を持たない別の prefill ノードを選んだ状況を再現するため、--no-enable-prefix-caching で prefill ノードのプレフィックスキャッシュを無効化した。
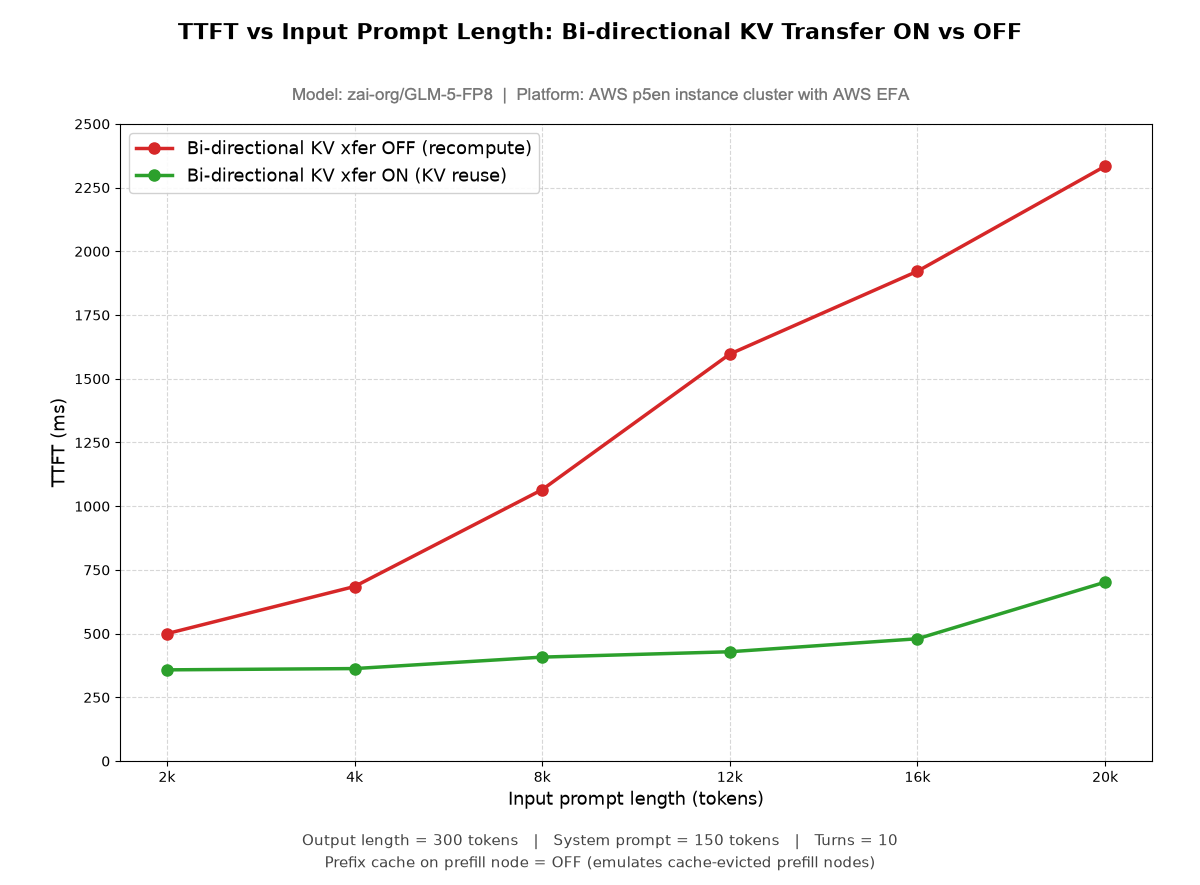
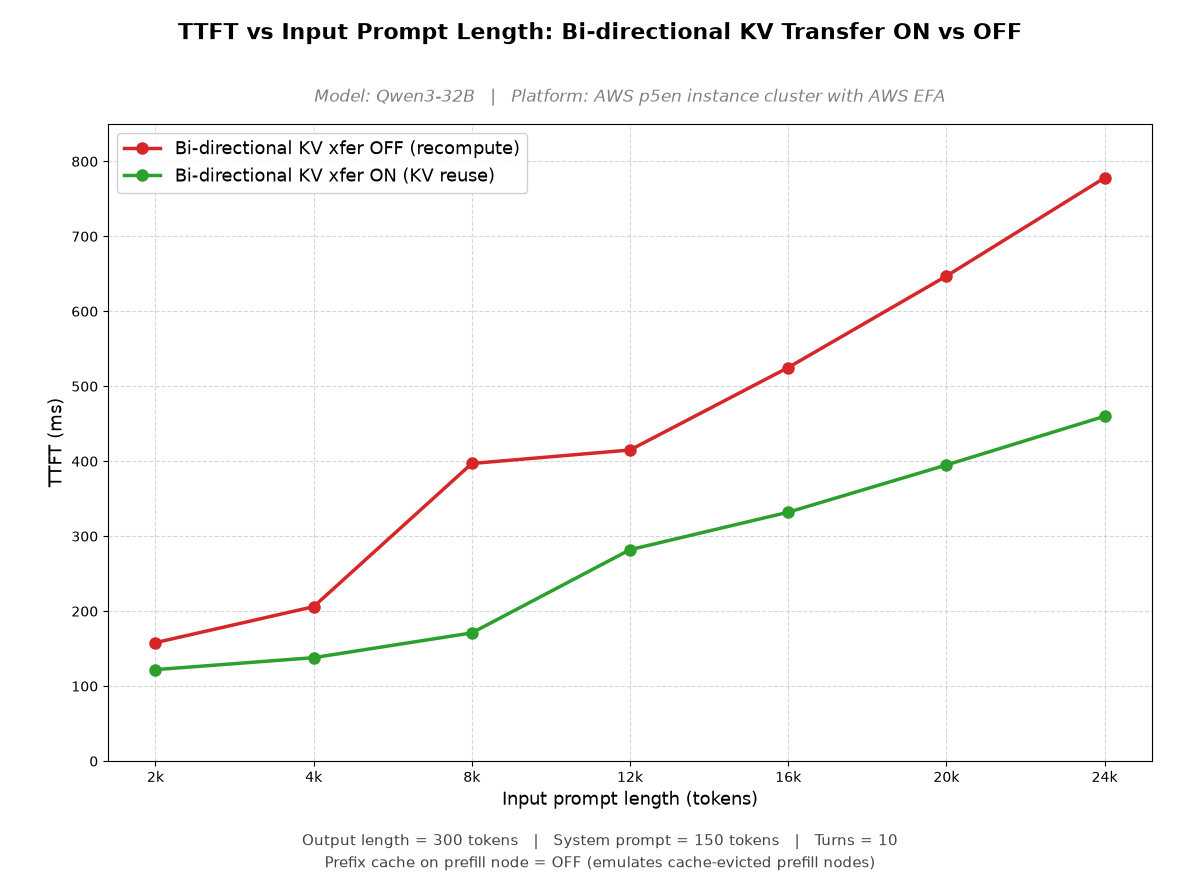
どちらのモデルでも、双方向 KV 転送を有効にするとマルチターン会話の prefill 計算量が減り、その効果は通常 prompt が長くなるほど大きくなる。無効時は prefill インスタンスが毎ターン、成長したコンテキスト全体を再計算するため TTFT が急上昇する。Qwen3-32B は 2k で 158 ms だったのが 24k で 778 ms、GLM-5-FP8 は 2k で 500 ms から 20k で 2,334 ms に達した。有効時は decode インスタンスが保持する KV が再計算ではなく再利用され、TTFT の曲線ははるかに平坦になる。Qwen3-32B は同じ区間で 122 ms から 460 ms に上がるだけ(最長 prompt で約 1.6 倍の削減)、GLM-5-FP8 は 358 ms から 702 ms となり、長い prompt では再計算経路より最大 3.3 倍低い。prefill 時間の内訳がその理由を説明する。
双方向転送はわずかな KV 転送時間を追加する(Qwen3-32B で約 30 ms から 130 ms、GLM-5-FP8 で約 29 ms から 110 ms)が、それによって節約される prefill 計算量はこのオーバーヘッドをはるかに上回る。結果として、転送を有効にした場合の prefill 合計時間(Qwen3-32B:128 ms から 414 ms、GLM-5-FP8:316 ms から 541 ms)は、純粋な再計算経路(Qwen3-32B:153 ms から 744 ms、GLM-5-FP8:500 ms から 2,331 ms)を大きく下回ったままである。GLM-5-FP8 はモデルが大きいため、絶対差も相対差もより顕著になる。トークンあたりの再計算時間が長いので、モデルとコンテキストの規模が大きくなるほど KV 再利用の効果は大きくなる。
Qwen3-32B
以下の図は、Qwen3-32B の TTFT が prompt 長に対してどう変化するかを、双方向 KV 転送の有効時と無効時で比較したものである。
次のグラフは、同一の実行におけるプレフィル時間を、再計算と KV 転送の 2 つに分解したものです。
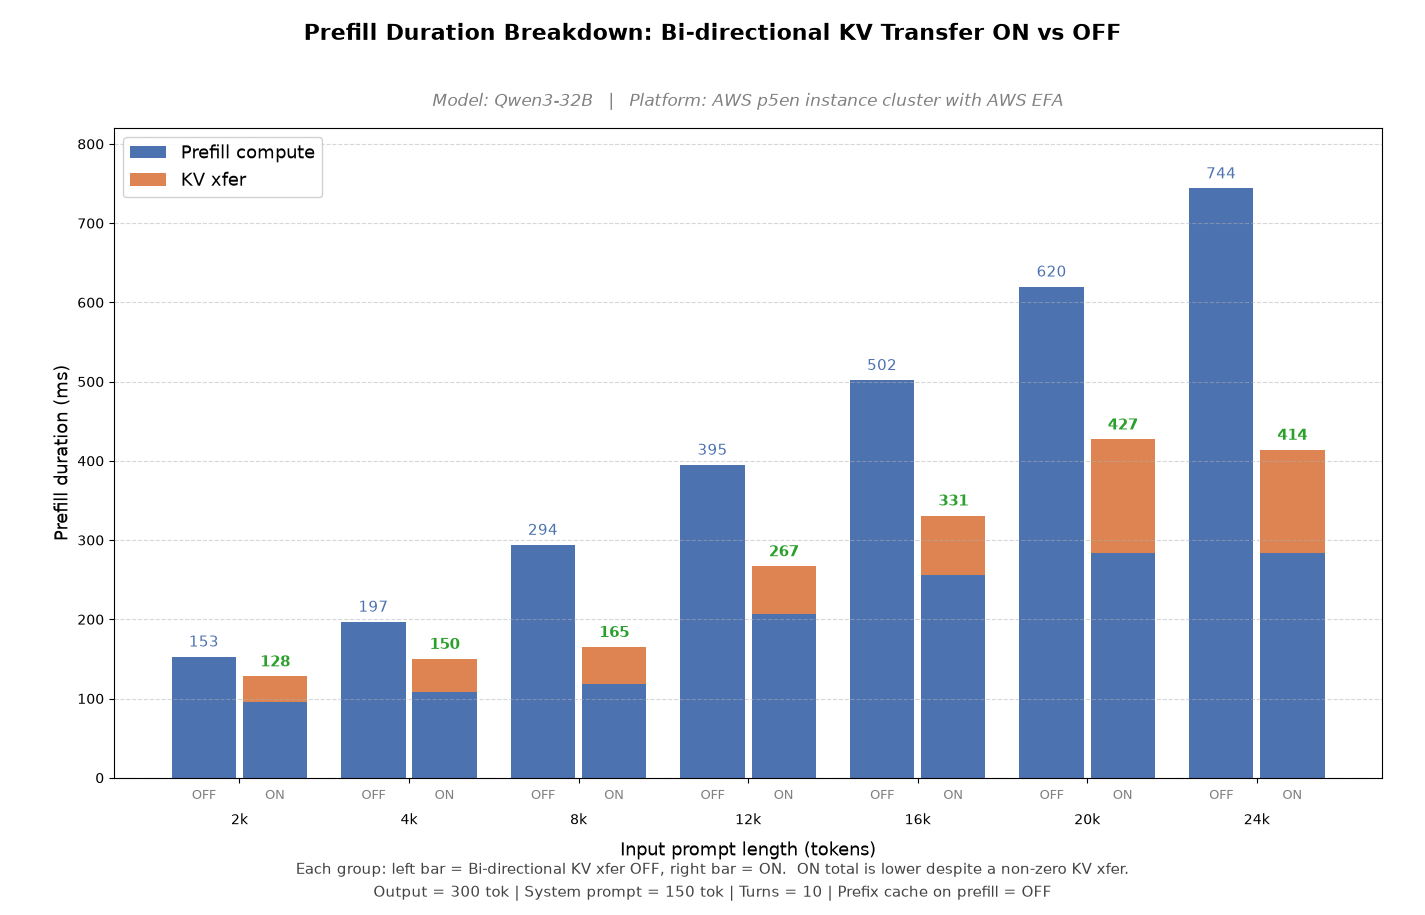
2つのグラフを並べて見ると、この機能を有効にするとTTFTはほぼ横ばいだが、無効にするとコンテキストの増加に伴って急激に悪化する。再計算を省ける時間が、KV転送のわずかなオーバーヘッドをはるかに上回るからだ。
zai-org/GLM-5-FP8
GLM-5-FP8も同じ2つの視点を示している。1つ目のグラフは、この機能の有効時と無効時で、TTFTがプロンプト長に応じてどう変化するかを表したものだ。
2つ目の方法は、prefill の所要時間を再計算と KV 転送の2つに分解する。
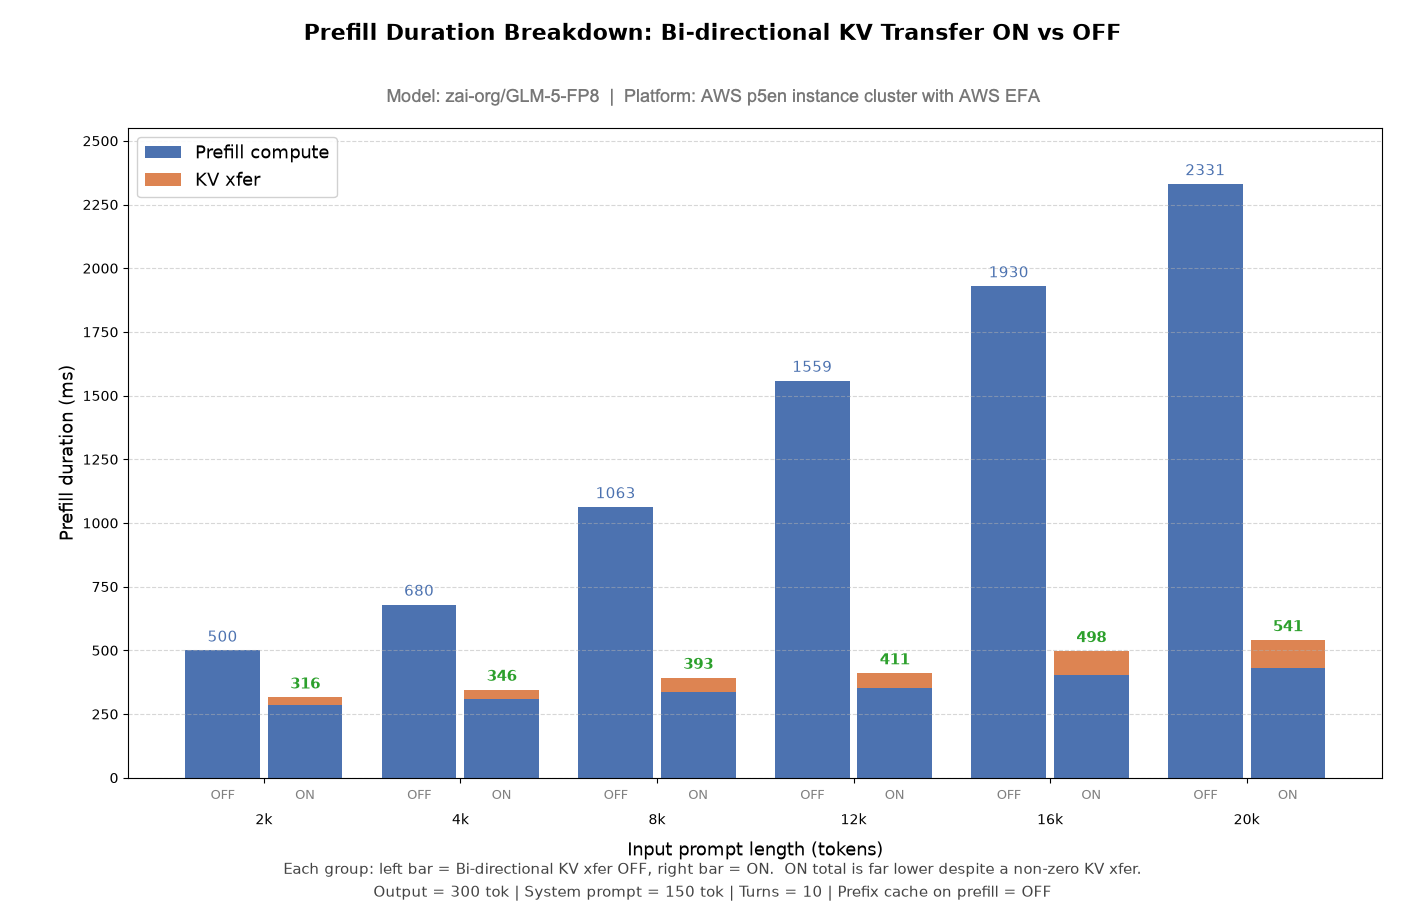
GLM-5-FP8 の差は Qwen3-32B よりはるかに大きい。長い prompt では TTFT が最大約 3.3 倍低くなる。これは 1 token あたりの再計算にかかる時間が長いためで、コンテキストが長くなるほど KV 再利用の効果が大きくなる。
benchmark の実行方法
1P1D benchmark 構成——prefill ノード 1 台と decode ノード 1 台、EFA 対応の Amazon EC2 P5en インスタンスを使用——を再現するには、下記の結果の再現ガイドの手順に従ってほしい。環境構築、vLLM の prefill / decode サービスの起動、benchmark の実行、結果の収集までをカバーしている。この機能は他のサポート対象構成でも動作するが、性能はハードウェア、モデル、負荷、ネットワーク構成によって変わる。
結論
本記事では、双方向 KV cache 転送が agent の会話履歴の伸長に伴って TTFT をどう下げるかを示した。P-D 分離構成では、この機能により prefill ノードが decode ノードに保持された KV block をターン間で再利用でき、再計算を減らせる。再利用が起きるかどうかは、設定可能な block 保持しきい値と再計算しきい値で決まる。EFA で接続した Amazon EC2 P5en インスタンスによる 1P1D 構成では、テストした最長 prompt 長において、Qwen3-32B で TTFT が 1.6 倍、zai-org/GLM-5-FP8 で 3.3 倍低下した。具体的な結果は負荷とデプロイ構成に依存する。自分の環境で実現するには、vLLM v0.21.0 以降と NixlConnector を使い、prefill と decode の両サービスで bidirectional_kv_xfer を有効にし、KV cache を認識するルーターを使い、再現ガイドを参照してほしい。
関連リソース
謝辞
この機能のメンテナンスに協力してくれた Nicolò Lucchesi(Mistral)、Mark McLoughlin(Red Hat)、そして vLLM コミュニティに感謝する。
付録:結果の再現
トポロジは AWS p5en インスタンス 2 台(prefill が :8100、decode が :8200)で EFA を有効にし、さらに :8000 上でプロキシと benchmark クライアントを動かす小型ノード 1 台を加えた構成だ。
本記事には 3 つのスクリプトが付属する。serve_pd_multiturn.sh はこの機能を有効または無効にして各 leg を起動する。run_multiturn_sweep.sh は prompt 長のスイープを実行する。cleanup.sh はデプロイを撤去する。
テスト環境
2 台の GPU ノードは完全に同一の構成である。
| インスタンスタイプ | p5en.48xlarge(NVIDIA H200 を 8 枚)、1 台を prefill、1 台を decode に使用 |
| リージョン / AZ | ap-south-1(ムンバイ)、ap-south-1b(AZ ID aps1-az3)、両ノードは同一 AZ |
| 配置 | クラスタープレイスメントグループは未使用。両インスタンスともターゲット指定の On-Demand Capacity Reservation 内でデフォルト tenancy により起動 |
| AMI | Ubuntu 24.04 x86_64 向けの公開 AWS ParallelCluster 3.14.2 イメージ、aws-parallelcluster-3.14.2-ubuntu-2404-lts-hvm-x86_64-202602121713(ami-0133f195033a4baae の ap-south-1、AMI ID はリージョンによって異なる)。このイメージにはカーネル 6.14.0-1018-aws、NVIDIA ドライバ 570、CUDA 12.8 が含まれているため、ドライバ、CUDA toolkit、EFA installer を以下に示すバージョンへアップグレードする必要がある。 |
| OS / カーネル | Ubuntu 24.04.4 LTS、6.14.0-1018-aws |
| NVIDIA ドライバ / CUDA | ドライバ 580.126.16(CUDA 13.0 driver API)、CUDA toolkit 13.0 |
| EFA インターフェース | インスタンスあたり 16 個、NIC ごとに 1 個(NIC 0-15、インターフェースタイプはいずれも efa)、各 200 Gb/s、合計 3.2 Tb/s。NUMA ノードごとに 8 個のインターフェースがあり、各 GPU はそのうち 2 個と同一の PCIe switch を共有する。 |
| EFA ソフトウェア | EFA installer 1.50.0、EFA カーネルモジュール 3.3.0g、libfabric 2.6.0amzn1.0、rdma-core 64.0amzn0 |
NIXL が EFA デバイスを選ぶ仕組み。 LIBFABRIC バックエンドは efa provider を使って 16 個の EFA デバイスすべてを rail として開き、その後、ある GPU と PCIe switch を共有する 2 本の rail にのみその GPU の KV cache を登録する。したがって転送は常に PCIe ローカルに収まる。NIXL や libfabric のデバイスオーバーライドは一切設定しておらず、これがデフォルトの選択である。自分のノードで確認するには、NIXL_LOG_LEVEL=DEBUG でサーバーを起動し、登録ログを見る:
grep -E "Created rail [0-9]+ \(device=|mapped to rail" server.log1. ノードの準備
2 台の GPU ノードに EFA ユーザー空間スタックをインストールし、provider が存在することを確認する。ここでは installer 1.50.0 を使う:
curl -O https://efa-installer.amazonaws.com/aws-efa-installer-1.50.0.tar.gz
tar -xf aws-efa-installer-1.50.0.tar.gz && cd aws-efa-installer
sudo ./efa_installer.sh -y
fi_info --version         # libfabric 2.6.0amzn1.0
fi_info -p efa -t FI_EP_RDM            # verify the EFA provider is present on both GPU nodes
2. 両方の GPU ノードに vLLM と NIXL をインストール
python3 -m venv ~/venv-pd && source ~/venv-pd/bin/activate
pip install --upgrade pip && pip install vllm==0.29.0 nixl==1.4.1
両ノードで vLLM PR #40186 を一度ずつ適用する。これはストリーミングレスポンスに kv_transfer_params を付与するもので、マルチターンエージェントはまさにこれを使って各ターンをつなぐ。エージェントは常に stream=True で decode ノードに問い合わせるため、このパッチを当てないと decode ノードは block メタデータを一切返さず、毎ターンが cache miss になる。
SITE=$(python -c 'import site; print(site.getsitepackages()[0])')
curl -sL https://github.com/vllm-project/vllm/pull/40186.diff -o /tmp/40186.diff
patch -p1 -d "$SITE" --fuzz=3 < /tmp/40186.diff
3. モデルのダウンロード
export HF_HOME=/fsx/huggingface        # a large shared volume
hf download Qwen/Qwen3-32B
4. P/D インスタンスペアの起動
各 GPU ノードで serve_pd_multiturn.sh を一度ずつ実行する。A/B の 2 グループで変わるのは BIDIR だけで、両ノードで一致していなければならない:
# on the prefill node
P_IP=<P_IP> D_IP=<D_IP> ROLE=prefill BIDIR=false ./serve_pd_multiturn.sh
# on the decode node
P_IP=<P_IP> D_IP=<D_IP> ROLE=decode  BIDIR=false ./serve_pd_multiturn.sh
prefill 側で展開するとこうなる:
export FI_PROVIDER=efa
export VLLM_NIXL_SIDE_CHANNEL_HOST=<P_IP> VLLM_NIXL_SIDE_CHANNEL_PORT=5600
vllm serve Qwen/Qwen3-32B --served-model-name Qwen --dtype bfloat16 \
  --tensor-parallel-size 8 --max-model-len 32768 --max-num-seqs 8 \
  --no-enable-prefix-caching --port 8100 \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_buffer_device":"cuda",
    "kv_role":"kv_producer","engine_id":"prefill-engine-001","kv_rank":0,
    "kv_parallel_size":2,"kv_connector_extra_config":{"backends":["LIBFABRIC"],
    "kv_recompute_threshold":64,"decoder_kv_blocks_ttl":480,
    "bidirectional_kv_xfer":false}}'
--no-enable-prefix-caching は prefill ノードにのみ設定する。これがベンチマークで再現しようとしているキャッシュエビクションのシナリオそのものだ。decode ノードでは prefix caching を有効のままにしておく。両方の /health エンドポイントが 200 を返すまで待つ。
5. マルチターンエージェントの起動
python3 -m venv ~/venv-proxy && source ~/venv-proxy/bin/activate
pip install fastapi uvicorn httpx pandas numpy aiohttp transformers tqdm
sudo dnf install -y jq || sudo apt-get install -y jq
git clone --depth 1 --branch v0.29.0 https://github.com/vllm-project/vllm.git ~/vllm_src
export VLLM_SRC=~/vllm_src

python3 $VLLM_SRC/examples/disaggregated/disaggregated_serving/disagg_proxy_multiturn.py \
  --port 8000 --prefiller-host <P_IP> --prefiller-ports 8100 \
  --decoder-hosts <D_IP> --decoder-ports 8200 \
  2>&1 | tee ~/proxy_$(date +%Y%m%d_%H%M%S).log
エージェントが受け取るのは URL ではなく host と port だ。再利用はクライアントが conversation_id を送ることで発火するので、ここで有効にするスイッチはない。
6. まず OFF グループ、次に ON グループを実行
VLLM_SRC=~/vllm_src LEG=off ./run_multiturn_sweep.shON グループを回すときは、まず 2 つの server とエージェントを停止し、各ノードで BIDIR=true を使って手順 4 をやり直し、エージェントを再起動してから(会話キャッシュはプロセス内にある)次を実行する:
VLLM_SRC=~/vllm_src LEG=on ./run_multiturn_sweep.shGLM-5-FP8 では MODEL=zai-org/GLM-5-FP8 SERVED_NAME=GLM を使い、両グループをもう一度繰り返す。
7. データの収集
3 つの量、それぞれ出所は 1 か所:
- TTFT ——
--stats-json-outputが書き出すベンチマークのリクエスト別統計 JSON から。各レコードにはinput_num_tokensとconversation_idに加えてttft_msが入っている。これが TTFT グラフの y 軸になる。 - Prefill 所要時間 —— エージェントのログから。リクエストごとの prefill 区間を
Prefill done in <N>msとして記録している。これが prefill 所要時間の内訳グラフにおける各バーの総高さになる。 - KV 転送時間と転送量 —— prefill ノードのログから。
KV Transfer metrics:行が出力され、平均と P90 の転送時間、転送あたりのバイト数、スループットが含まれる。これが ON グループの各バーにおける KV-xfer の部分になる。
NIXL のテレメトリは転送を開始した側が記録する。つまり D->P の読み戻しは prefill ノードのログに現れ、通常の P->D プルは decode ノードのログに現れる。
各量を prompt 長ごとに平均し、グラフにする。TTFT は prompt 長に対して ON と OFF の 2 本の線を引き、prefill 所要時間は prompt 長ごとの対になった積み上げバーにする。ON のバーは prefill 計算と KV 転送に分ける。2 つの見方の差こそが要点だ。バーが炙り出す転送オーバーヘッドは、TTFT 曲線が削減分へと変えてみせるものにほかならない。
トラブルシューティング
- ON の実行中、エージェントが常に
cache MISSを記録する ——--send-conversation-idが欠けている、PR #40186 が両ノードに適用されていない、あるいはBIDIR=falseが decode ノードに残っていて、その場合はkv_transfer_paramsがまったく返らない。 - prefill ノードに
Declining expired remote readが出る —— decode ノードの block が次のターンのリクエスト到着前に失効している。decoder_kv_blocks_ttlを大きくし(デフォルトは 480 秒)、エージェントのキャッシュ TTL はその下に収める。 fi_info -p efaが空、または socket にフォールバックする —— EFA provider が欠けている。aws-efa-installerを入れ直し、インスタンス起動時に EFA インターフェースが有効になっていることを確認する。そうでなければ NIXL は初期化に失敗するか、黙って TCP を通り、転送データは意味をなさなくなる。
クリーンアップ
./cleanup.sh proxy      # on the proxy / benchmark driver node
./cleanup.sh server     # on each GPU node
その後インスタンスを終了し、まだ動いているインスタンスがないことを確認する。