私たちはオリジナルの『DOOM』をSQLに移植しました
CedarDB の SQL クエリで Doom のゲームロジックとレンダラーを実装し、デスマッチも実現した。記事では全体アーキテクチャ、ゲームループ、SQL における BSP 走査、そしてデータベースの実行モデルがどの点で非常にうまく適合するかを解説する。
日本語
コピー
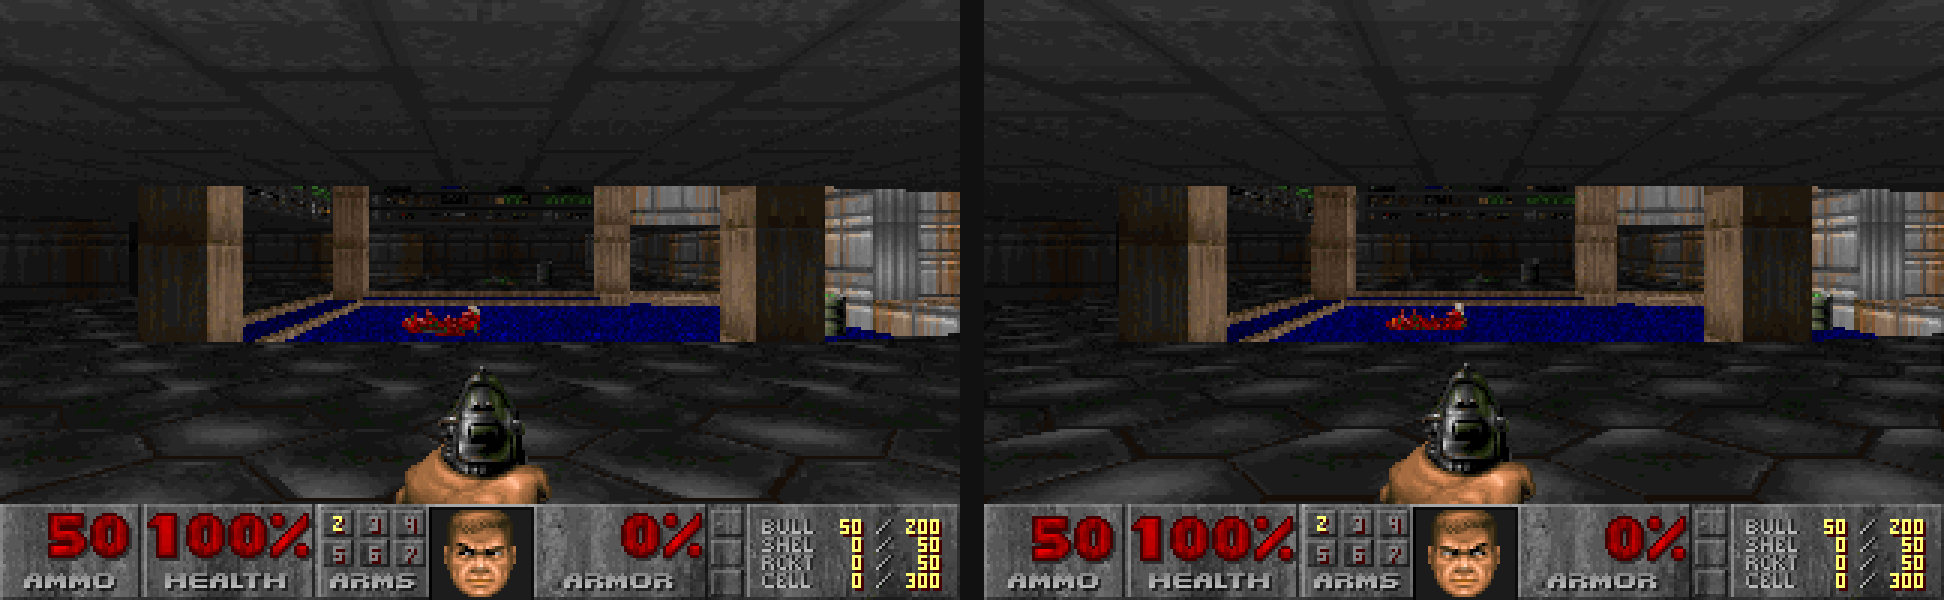
オリジナルの Doom のゲームロジックとレンダラーを、どちらも SQL クエリで実装した。そう、デスマッチも動く。
Lukas Vogel
目次
Lukas Vogel
目次
TL;DR: 1993 年当時のオリジナル Doom のゲームロジックとレンダラーを SQL に移植し、データベースの中で動かした。ゲームループはオリジナルと同じ 35 FPS で回り、レンダラーは手元のノート PC で最大 60 Hz の完全な 320x200 フレームバッファを生成する。Python が担当するのはタイミング、キーボード入力の読み取り、返ってきたビットマップの表示だけだ。マルチプレイヤーも遊べる。
お使いのブラウザは video タグに対応していません。
AMD Ryzen 7 7840U 上で動作する SQLDoom
今すぐ遊べるデスマッチ、4 席、先着順。
これは第 1 エピソードのシェアウェア版だ。席が埋まったら順番待ちになる。待ち行列も埋まったら、順番を待ちながら SQL クエリでゲーム状態をリアルタイムに覗ける。
SQLDoom
去年 DOOMQL [
](https://github.com/cedardb/doomql) を公開した。30 FPS で Doom っぽい ASCII 画面を描画するもので、なかなか好評だった。ただ、レイキャスティングを使っているので Doom というより Wolfenstein 3D に近い、という正しい指摘も受けた。Doom は BSP 木を使っている。だからこそ正しい深度ソートが安く済み、テクスチャや任意角度の壁、異なる床の高さを扱う余裕が生まれる。
これがずっと引っかかっていた。しばらく格闘した末に(ご想像のとおり、また育児休暇だが)、完全に SQL だけで動く本物の Doom をお見せできるところまで来た。
片方は 1993 年のバイナリ、もう片方は SQL クエリ。どちらがどちらか分かるだろうか?
ルール
まず基本ルールを決めて、何を目指すのかはっきりさせておこう。
- 本物の Doom に見えること。振り返ってみると、DOOMQL の画質はかなりお粗末だった。
- それ以上に大事なのは、本物の Doom と同じように遊べること。オリジナルはとにかく楽しい。
- レンダリングは完全に SQL で行う。SQL が出力してよいのはテーブル、またはピクセルごとの正確な RGB 値をエンコードしたビットマップだけだ。
- ゲームループも完全に SQL で行う。ただしデータベース内でユーザー定義関数を使うのは構わない。
- 別の言語でクライアントを書くのは自由だが、その役割は入力の解析、ゲーム tick の駆動、出力ビットマップの表示に限る。
アーキテクチャ
Python はあえて退屈な選択にしている(ルール5)。1つのスクリプトが pygame で入力を処理し、出力ビットマップを描画し、毎秒35回ゲーム tick を発火する。ゲームロジック、ゲーム状態、レンダラーはすべてデータベースの中にある。
                         Python
                 input / timing / display
                    |              ^
                    |              |
          run game tic        request frame
                    |              |
                    v              |
          +----------------+  +----------------+
          |                |  |                |
          | SQL game logic |  |  SQL renderer  |
          |                |  |                |
          +-------+--------+  +--------+-------+
                  |                    ^
                  |                    |
                  v                    |
             +-----------------------------+
             |                             |
             |       game state tables     |
             |                             |
             +-----------------------------+
2つの経路は意図的に分離してある。ゲームロジックは固定の 35 Hz ループで動き、レンダラーはゲーム状態テーブルに対する純粋関数で、クライアントが新しいフレームを欲しいときにいつでも(つまり可能な限り速く、可能な限り頻繁に)呼び出せる。
ゲームデータのロード
都合のいいことに、Doom の .wad ファイルフォーマット はそれ自体がすでに高度にリレーショナルだ。
2つの VERTEXES が LINEDEF を介して繋がり、その LINEDEF には2つの SIDEDEF がある。SIDEDEF が SECTOR を囲み、その中に THINGS を置ける、という要領だ。WAD 全体をデータベースに変換するのは驚くほど素直で、Python およそ1000行で済んだ。Doom 1 全体のインポートは手元のノート PC で約18秒かかる。
たとえば次のクエリは E1M1 を俯瞰視点でレンダリングする:
WITH wall AS (
  SELECT round((v1.x + (v2.x - v1.x) * t / 32.0) / 48) AS col, -- 48 units per column
         round((v1.y + (v2.y - v1.y) * t / 32.0) / 96) AS row, -- chars are 2:1
         l.left_sd_id < 0 AS solid -- one-sided lines are pass-through
  FROM linedefs l, generate_series(0, 32) AS t        -- walk each line in 32 steps
  JOIN vertexes v1 ON (v1.map_id, v1.id) = (l.map_id, l.v1_id)
  JOIN vertexes v2 ON (v2.map_id, v2.id) = (l.map_id, l.v2_id)
  WHERE l.map_id = 1
)
SELECT string_agg(CASE WHEN (col, row) IN (SELECT col, row FROM wall WHERE solid) THEN '#'
                       WHEN (col, row) IN (SELECT col, row FROM wall)             THEN '.'
                       ELSE ' ' END, '' ORDER BY col)
FROM generate_series(-16, 79) AS col, generate_series(-51, -21) AS row
GROUP BY row ORDER BY row DESC;
出力:
                                                 #####################
                                                 # ..................#
                                                 # . ......         .#
                                                 # . ...... ######  .#
                                              ######         .. ##  .#
                                          #####..  .         .. ##  ##
                                          #  ####### ...... ######  ##########
                                          # ##   # .                ###..  ..##
  ################                       ## #    ###.........######## #####.  ##
```text
 ........... #                ########..########.........###         #### .##     ######
 ..           ##########     ####         ##                 ##        #..... #######    ##
 .          #####  ... ##  ###   #.....#..##    ........      ##########..... ....##.#### ##
 .     ###.###  ......  ###  .   .        ##  ...      ...             . ......     .#  ##  ##
 .     ##..  .  ......  ##   .   .        ##  .           .            . ..........  ##  ## ##
 .     ###.######  ...  ######   #.....#..##  ...        ..            #.    ... ..   # ## ##
 .           ############    #            ..    ..........             #.......... ...# #  #
###......... # ##### ##### ##..... ... ##.### # ################ ####### ####.........##.##........####### .####### ### # ###########.################# # #### # # ## #.# ####...... # # . ### ## #.################# # ########### ####. .#### #..#
######..######
. ..
##...##
## ##
######..######
#.. #
## The Game Loop
It was important to me to actually *port* Doom, not only render frames that vaguely look like it. Of course, the visuals play a big part in that, but Doom also just *feels* awesome to play. Take a look at the following scene which is rule 2 in action (me having fun):
Gibbing 3 soldiers with a rocket launcher
As you can see, there is a lot going on. Just in this short clip we see:
- Player input has to be polled and processed (walking, turning, shooting),
- enemies walk and attack,
- items are picked up,
- the rocket launcher fires projectiles that move,
- rocket explosions have a blast radius,
- enemy sprites have to be rendered,
- animations, view bobbing, and the HUD
しかも、そのすべてを処理する時間は多くない。オリジナルの Doom は固定 35 Hz のクロックで動いていたので、1 ティックの予算は `1000 ms × 35 Hz = 28.6 ms` になる。1 ティックにつき 1 フレームしか描画しないため、フレームレートも 35 FPS が上限だった。
SQLDoom keeps the game logic at 35 Hz (so all the original constants still work), but decouples the drawing. The client can query (get it?) for a frame whenever it likes and we interpolate the camera position between tics. So there are two budgets we have to take care of:
- Running a tic every 28.6 ms (or it will feel just completely wrong)
- Rendering at least 35 frames a second (less is kind of okay, but won’t feel smooth)
### The tic sequence
ゲームのティックは本質的に手続き的だ。ティックを回すたびに、順番にこなすべき処理がある。CedarDB には `cedarscript` というスクリプト言語があり、PL/pgSQL によく似ていて、各ティックで何をするかを事前に計画できる。
Here is a small section of the tic function:
```postgres
doom_cs_clock(map, p);
let mut plan = doom_cs_plan(map, p); -- returns a bitmask of functions to trigger
let use_queued = doom_tic_use(map, p, plan);
if (plan & 2) <> 0 OR use_queued { active = doom_cs_activate_specials(map); }
if (plan & 4) <> 0 OR active <> 0 { doom_cs_doors(map, p); }
doom_tic_move(map, p); -- full movement, or just turning
doom_cs_death(map, p); -- process deaths
plan = doom_cs_plan(map, p); -- the world moved; re-plan
plan = doom_tic_secrets(map, p, plan); -- secrets, walkover lines, pickups
plan = doom_tic_weapon(map, p, plan); -- weapon state, hitscan, damage
...
if sound_due { doom_cs_sound(map, p); } -- yes, we also play sounds
doom_cs_monsters(map, p); -- always
doom_cs_sector_fx(map, p); -- always
doom_cs_thing_physics(map); -- always
上の Python driver は 1/35 秒ごとに SELECT doom_run_game_tic(...) を呼び出す。
呼び出された各関数は、その後 SQL 文をまとめて実行する。以下は monster AI ステートマシンの一部だ。
-- Abridged from sql/runtime/functions/26_cs_monsters.sql.
WITH RECURSIVE
  monsters AS ( [...] ),   -- who is alive, what kind, where
  los      AS ( [...] ),   -- visible, in_view_cone, dist: recursive, walks walls
  decision AS ( [...] ),   -- one row per actor: its state and what it can see
  transitions AS (
    SELECT d.*,
      CASE
        WHEN NOT d.alive AND d.state NOT IN ('die', 'dead', 'xdeath') THEN
          CASE WHEN d.health < -d.max_health AND d.xdeath_frame IS NOT NULL
               THEN 'xdeath'::actor_state ELSE 'die'::actor_state END -- GORY EXPLOSION!
        WHEN d.state = 'stand' THEN
          CASE WHEN d.visible AND d.in_view_cone AND d.dist <= sight_range
               THEN 'see'::actor_state ELSE 'stand'::actor_state END
        WHEN d.state_tics > 1 THEN d.state          -- animation still running
        WHEN d.state = 'see' THEN
          CASE WHEN d.visible AND d.dist <= d.attack_range
                    AND d.attack_cooldown <= 0
               THEN 'missile'::actor_state ELSE 'see'::actor_state END
        [...]                -- die, xdeath, missile, pain, barrel: 5 more
        ELSE d.state
      END AS next_state
    FROM decision d
  )
UPDATE monster_ai ai
SET state = n.next_state, state_tics = n.next_tics, seq_index = n.next_seq,
    fired_this_tick = n.advances AND n.lands_on_attack_frame
FROM next_values n
WHERE ai.map_id = n.map_id AND ai.thing_id = n.thing_id;
見てのとおり、上の動画の挙動がそのままエンコードされている。敵が極端な量のダメージを受けると(CASE WHEN d.health < -d.max_health AND d.xdeath_frame IS NOT NULL)、激しく爆発する!(THEN 'xdeath'::actor_state)。
Tic driver のパフォーマンス
以下はゲーム tic 1回分のウォーターフォールレンダリング:
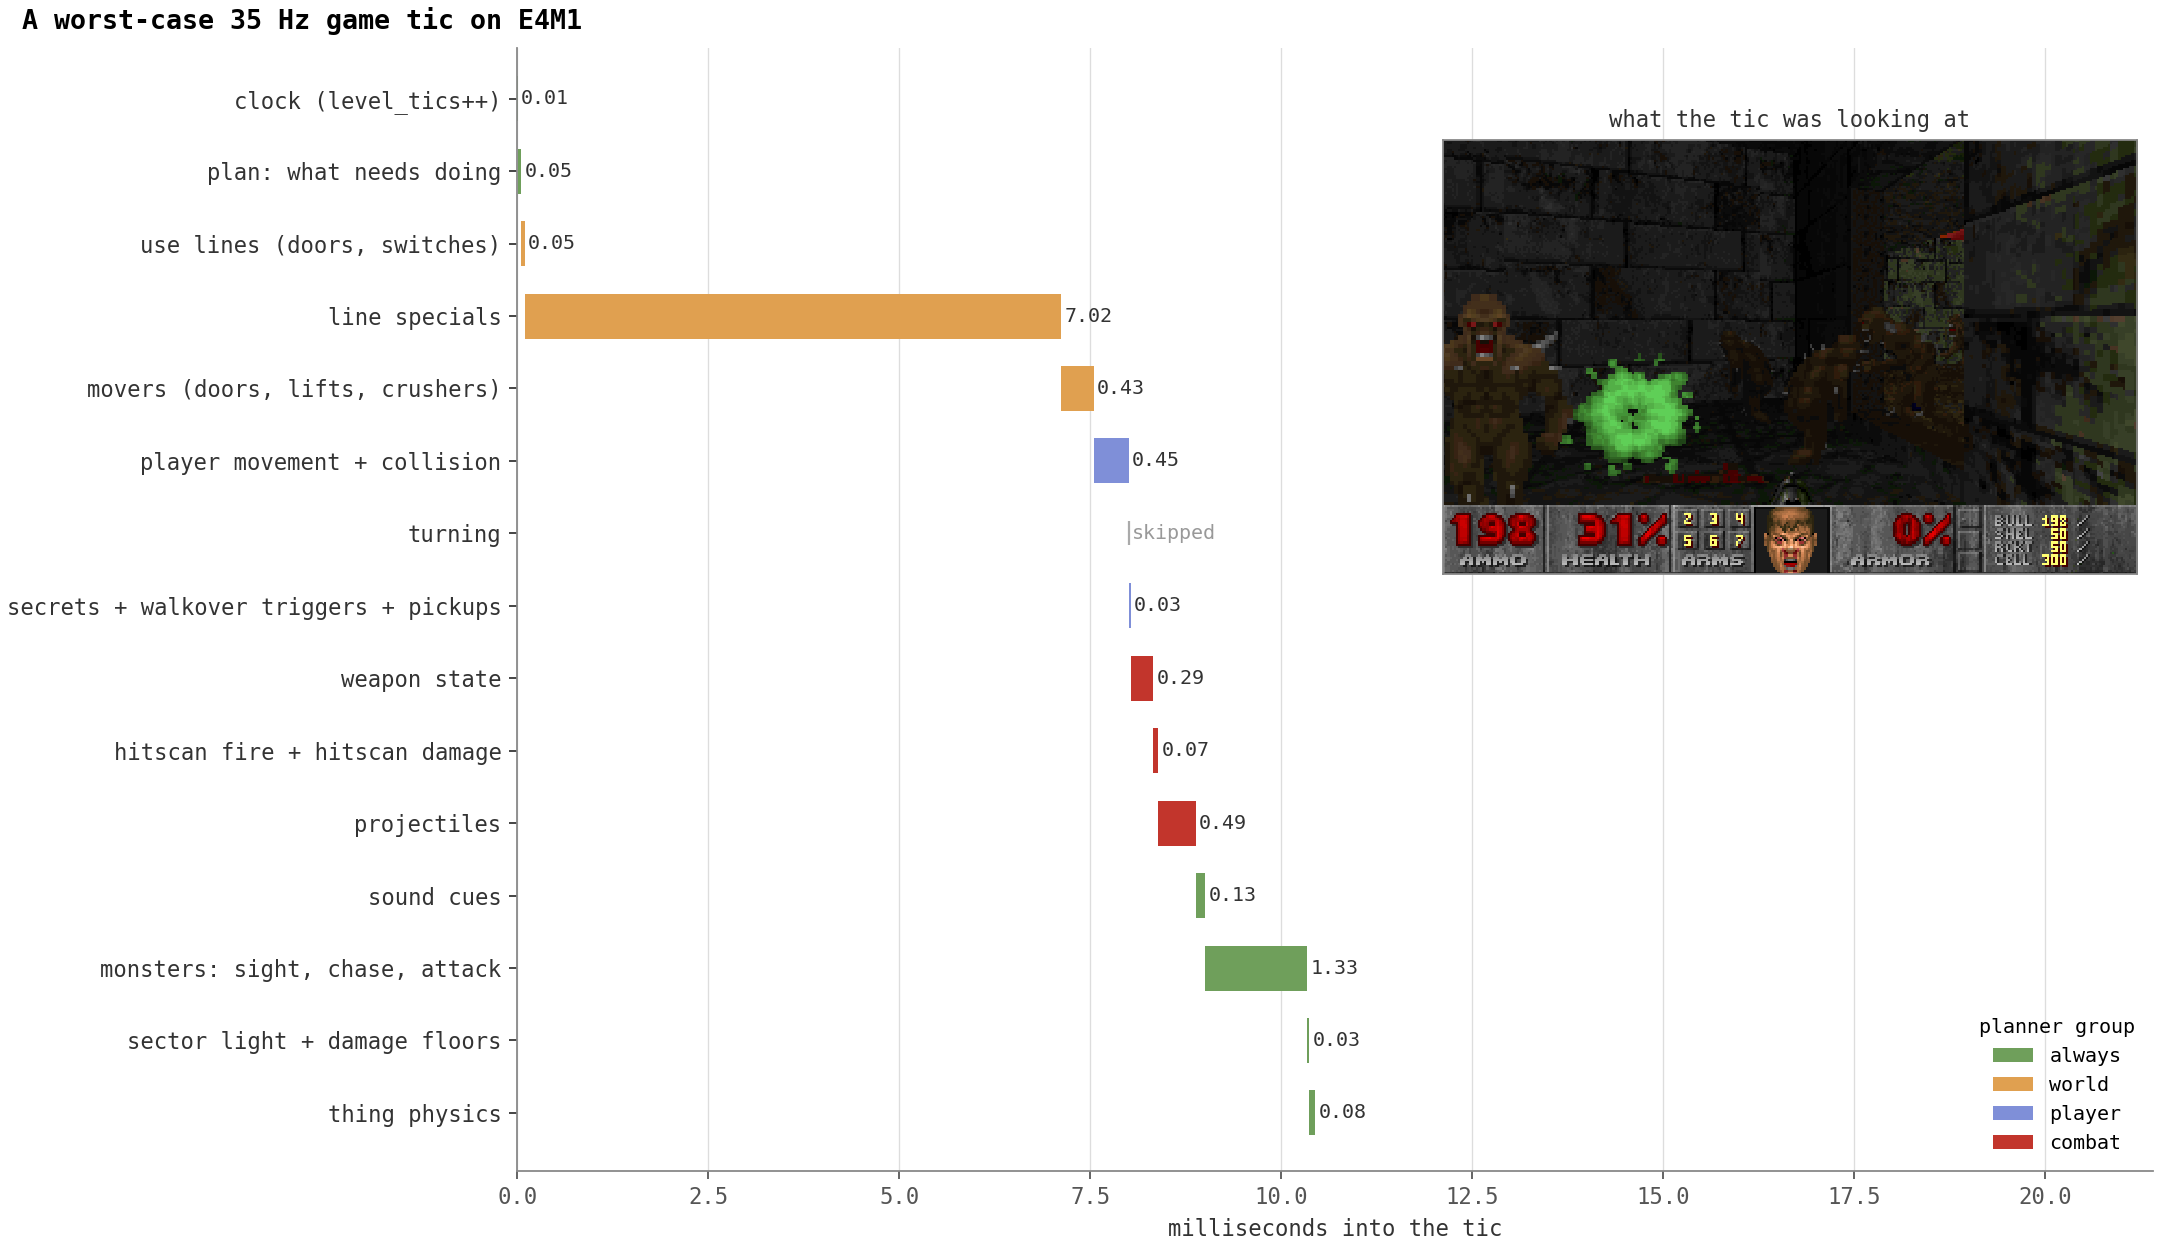
見つけられた中で最も遅いゲーム tic
これは本当に見つけられた中で最も遅いゲーム tic だ。E4M1 で発生し、46体の起きているモンスターが全員、開きかけのドアを通ってこちらへ押し寄せようとしていた。所要時間は 10.45 ミリ秒で、tick に使える予算のおよそ ~37% にあたる。
もっと典型的な tic では、モンスターが 6 体起きていて平均 2.15 ミリ秒、予算のおよそ 8% だ。余裕はまだたっぷりある!
正直なところ、かなり複雑なゲームロジックを SQL で書くのがこれほど楽だとは思わなかった。ゲームロジックは SQL で約 5900 行。多く聞こえるが、同じことをする元の C のソースコードよりは間違いなく少ない。あちらは約 9000 行ある!
しかも、発想の転換を迫られる。敵を 1 体ずつループで回す代わりに、素直な UPDATE ... WHERE condition を 1 つ書けば、どう実行するのが最善かはデータベースが自分で決めてくれる——自動並列化だ!
これでようやく Entity Component System (ECS) パターンも腹に落ちた。ここでは各 entity(プレイヤー、モンスター、アイテム……)が複数の components(位置、スプライト、ステータス……)を持ち、system(monster AI、move player、damage calculation)が、与えられたコンポーネントの集合を持つエンティティ同士がどう相互作用するかを決める。ECS は要するにデータ局所性の話であり、与えられたコンポーネント集合を持つエンティティをどう走査するかの話だ。そして SQL では、データ集約的な処理にはもうすっかり慣れている!コンポーネントごとにテーブル 1 つ、system ごとに update か insert 1 つ、エンティティを join key にして興味のあるテーブルを join するだけだ!
レンダリング
毎フレームは 1 つの巨大な view にすぎない。レベル形状とゲーム状態、そしてプレイヤー位置を入力に取り、完全な framebuffer を返す。以下がレンダリングパイプライン全体のスケッチだ:
WITH RECURSIVE
  render_context AS (SELECT $1 AS map_id, $2 AS player_thing_id, $3 AS difficulty),
  pos            AS (SELECT $4 AS x, $5 AS y, $6 AS z, $7 AS angle),
  visible_children AS ( ... ),    -- walk the BSP, culling invisible segments
  clipped, projected, on_screen,  -- project segments to screen space
  wall_parts, columns, fragments, -- one row per wall pixel
  panel_clips, plane_spans, ...,  -- ceiling/floorclip as window functions, visplanes
  thing_pixels, sprite_fragments, -- sprites
  fragment_union, resolved,       -- every candidate pixel, resolve for the nearest
  view_colored, ui_colored,       -- COLORMAP, status bar
  framebuffer AS ( ... )          -- 64,000 rows of (x, y, rgb)
SELECT string_agg(rgb, ''::bytea ORDER BY y, x) AS frame_rgb
FROM framebuffer;                  -- 192,000 bytes, one row
この実装は約 1300 行の SQL(コメントを除く)で、89 個の CTE に分かれている。1 本の SQL クエリとしてはかなり複雑な部類だ!
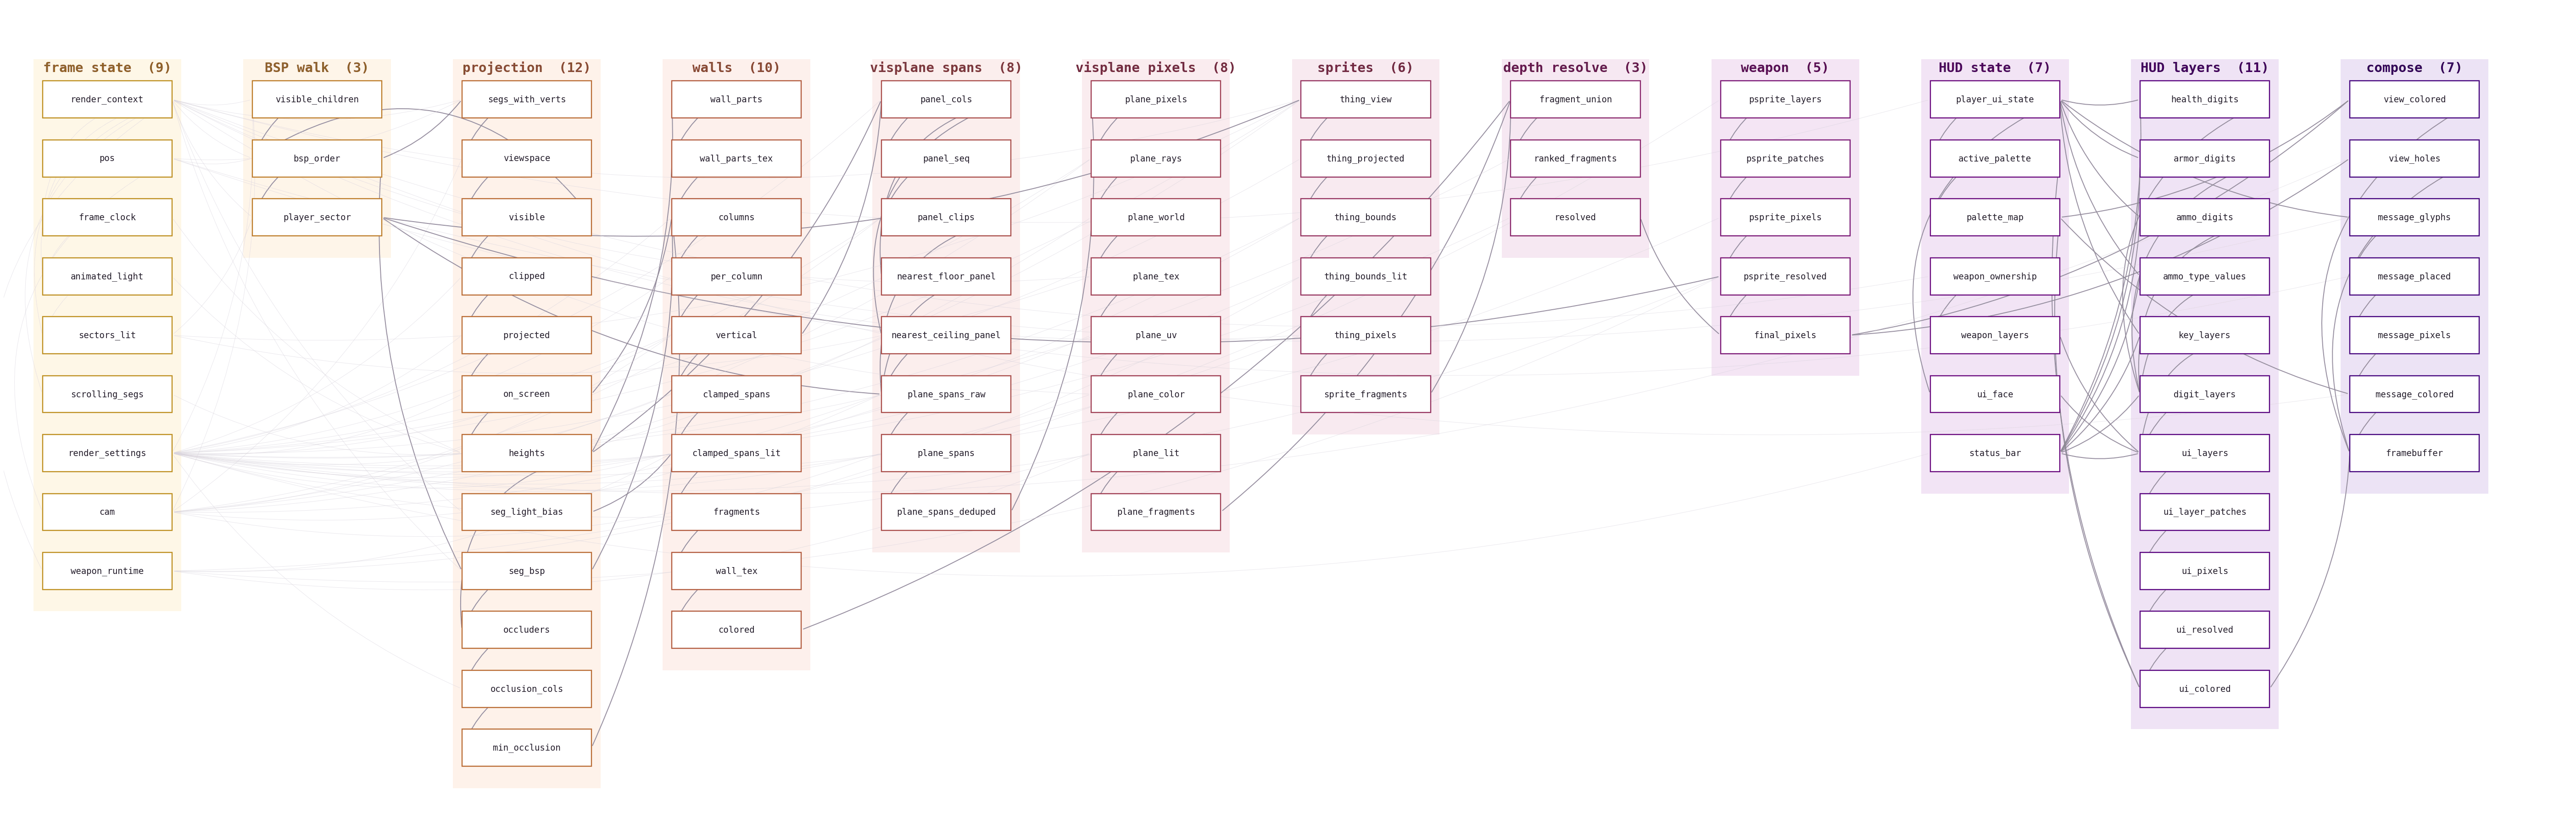
1 フレームのレンダリングに使われる 89 個の CTE すべて
完全に混沌としているように見えて、このパイプラインは Doom のやり方とかなり近い。SQL にはむしろ利点すらある:linux_doom のソースコードのレンダリングエンジンは約 3300 行(コメントを除く)で、SQLDoom のおよそ 2.5 倍ある。そもそもこのアイデアがまともだったのかどうかは別の話で、それは後で触れる。
まずはレンダリングパイプラインの中でも特に面白い部分をいくつか見ていこう:
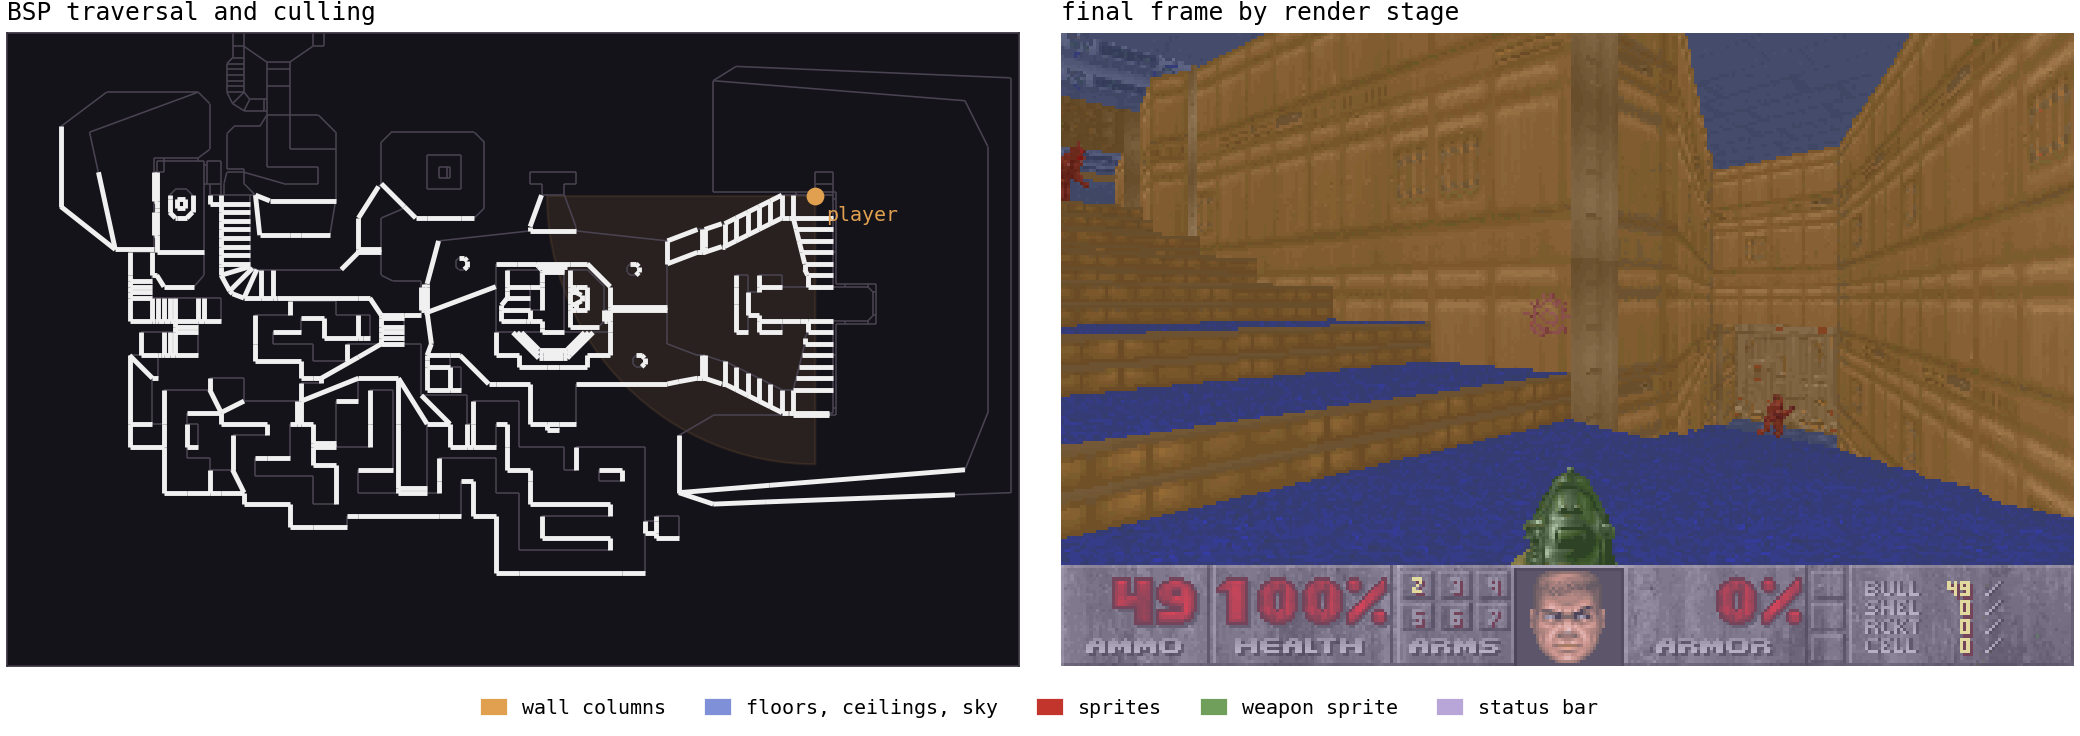
レンダリング段階ごとに可視化したフレーム
左半分が BSP ベースのカリング、右半分が壁のレンダリングと visplane の可視化だ。
BSP 走査
1993 年には、ハードウェアアクセラレーションされた Z-buffering を備えた GPU など誰も持っていなかった。だから Doom は正しい描画順だけで遮蔽関係を成り立たせている。Doom のやり方はなかなか巧妙だ。前から後ろへ描きながら、どのピクセルを描いたかを記録する(つまり、ある壁のピクセルがすでに描かれていれば、その背後にいるモンスターは描かなくていい)。言うのは簡単だが、やるのは難しい。レベル内のあらゆるものを深度順に効率よく並べる方法が必要になる。
Doom はこの順序を、あらかじめ計算された BSP 木から得ている。この木は doom.wad ファイルに焼き込まれている。木の各ノードはマップを 2 分割する線だ。マップの sector はこうして多くの subsector に切り分けられ、それぞれが線のどちらか側に置かれて木に挿入される。その結果、次の性質が得られる:
- 各 subsector は葉ノードである;
- 各 subsector は凸である(つまり、その内部のどこに立っても、どの壁も見える);
- 各木ノードで、カメラ側にある部分木全体は、必ず反対側の部分木より手前にある。
こうして BSP 木を再帰的にたどれば、すべての subsector の前から後ろの順序が得られる。描画順もそれで決まる。画面のある領域がより近いもので覆われてしまえば、その背後の物体は飛ばせる。
動いているところはこちら(全画面で見たほうがいいかもしれない):お使いのブラウザは video タグに対応していません。
BSP 走査の可視化
左側は subsector を前から後ろの順に並べ、視錐台の外にある BSP の枝は早々にカリングしている。中央は SQLDoom が各領域に割り当てた順序だ。右側が最終的な画面で、壁の色はそれが属する subsector に対応している。
中央のパネルは SQLDoom のある最適化を示している。性能のために、BSP 木のすべての経路をロード時に一度だけ前計算しておく。ある位置が与えられると、経路上の各ステップは前(0 と符号化)か後ろ(1 と符号化)のどちらかになる。これらの決定を bigint に詰め込み、辞書順にソートすれば(order by)、正しい前後順が得られる。
SELECT ssector_id, ROW_NUMBER() OVER (ORDER BY sort_key) AS bsp_seq
FROM (
  SELECT st.ssector_id,
         -- back = 1 at bit (40 - depth), front = 0.
         SUM(CASE WHEN st.side = fs.front_side THEN 0::bigint
                  ELSE (1::bigint << (40 - st.depth)) END) AS sort_key,
         BOOL_AND(vc.keep) AS visible   -- was any parent bbox culled?
  FROM node_path_steps st -- materialized view, every root-to-ssector path
  JOIN nodes n ON ...
  CROSS JOIN LATERAL (SELECT ... AS front_side) fs -- on which side are we?
  JOIN visible_children vc ON ...
  GROUP BY st.ssector_id
) s WHERE s.visible;
sum() ... order by が 1 つあれば、再帰下降はまるごと置き換わる!40 ビットあれば、こちらが投げるどんなマップにも足りる。最も深い BSP 木は E4M8 のもので、それでも 32 階層しかない。マップがオリジナルの最大マップの 256 倍を超えなければ問題ない!
よく見ると、この BSP 走査はカリングも同時にやっている。都合のいいことに、.wad の各ノードはそのすべての子ノードのバウンディングボックスも定義している。視錐台がそのバウンディングボックスの完全に外側にあると示せれば、その部分木はレンダリングのために考える必要がない——これが visible_children.keep の意味するところだ。したがって bool_and(vc.keep) は、祖先ノードが条件を満たさない subsector をすべて捨てる。
パイプラインの以降はすべて bsp_seq との接続だけになる。こうすれば可視のサブセクタだけを、正しい順序で考慮することになる。
壁と Visplane
Doom はどこかズルをしている。見た目は 3D だが、実際には 2.5D のゲームだ。本質的には平面がひとつと、完全に垂直な壁、そして天井は常に床と平行。おかげでレンダリングは本物の 3D エンジンよりずっと楽になる:
- すべての壁を描く(前述のとおり、手前から奥へ)
- まだ描かれていない部分は、床か天井のどちらか。それを描く。
- スプライト(モンスター、ドラム缶、拾い物)は常にこちらを向く平面画像(段ボールの切り抜きを想像してほしい)。だから複雑な変換は要らない(壁と重なる場合を除く。それは後で)。
壁
壁は連続したスクリーン列の集合を占め、各列の中では連続したピクセルの並びになる。だから壁は壁ごとに、手前から奥へと、generate_series() で行と列を伸ばしながら描いていける:
columns AS ( -- emit a row per screen column the wall w covers
  SELECT w.*, x AS col_x, ...
  FROM wall_parts_tex w
  CROSS JOIN LATERAL generate_series(
    GREATEST(0, FLOOR(w.screen_x1)::int),
    LEAST(screen_w - 1, CEIL(w.screen_x2)::int)) AS x
),
fragments AS ( -- one row per pixel the wall covers in this column
  SELECT c.col_x AS x, y, c.depth_x AS depth, c.u_i, c.v_i
  FROM clamped_spans c
  CROSS JOIN LATERAL generate_series(c.y_start, c.y_end) AS y
)
Doom は 2 つのループを使う。スクリーン列を取り出すのが R_RenderSegLoop、ピクセルを描くのが R_DrawColumn だ。
壁のレンダリングには平均 1.7 ms かかった。
Visplane
壁は片付いた。次は面白い部分、床と天井、つまり Doom が visplane と呼ぶものについて。
あいにく Doom のレンダリングアルゴリズムは SQL にそのまま持ち込めない。あまりに命令的だからだ。Doom は ceilingclip と floorclip という 2 つの配列を保持し、スクリーン列ごとに 1 エントリを持つ。これらは各列でまだ開いている区間(つまり床か天井になっていて、まだ描かれていない部分)を示す。新しい壁を 1 枚描くたびに、すべてのピクセルが埋まるまでこれらは書き換えられる。しかも Doom は書き換えるだけでなく、書き換える順序も決定的に重要だ。よくできている!要するにフラッドフィルアルゴリズムなのだが、すべてが 3D に見えたまま、ほとんど追加コストなしで済む(もちろん C の話だが)。
SQLDoom は別のやり方を取るしかない。SQL にはループも可変状態もないからだ。ループが回せないなら、ソートに切り替えて、ソート済みの連続区間を集約する——貧者のループ!
ここで反復の対象になるのはパネルだ。壁がスクリーンのある列に現れる、その一部分を指す。何かを描くパネルもあれば(実体の壁(solid)、ドアの上の壁(upper)、窓やパラペットの下の壁(lower))、他のパネルの描かれ方に影響を与えるためだけに存在するパネルもある。バルコニーの下のドアから外に出ると、頭の上に何かがあり、その何かはどこかで終わらなければならない。
そこでスクリーン列ごと(col_x)に、手前から奥へソートされたパネルのリストがある。つまり、あるパネルより手前のクリッピング状態は、その 1 つ前の行だけで完全に決まる。窓関数の匂いがしないか?
これを文章で説明するのは骨が折れる。動画を見てほしい。お使いのブラウザは video タグに対応していない。
窓関数で visplane の位置を決める
以下が(簡略化した)SQL クエリだ:
panel_clips AS (
  -- 1. the band as the NEARER panels left it
  SELECT p.*,
    COALESCE(MAX(CASE WHEN part IN ('solid','upper','upper_flush')
                      THEN y_bot::int + 1 END) OVER w, 0)            AS cc_before,
    COALESCE(MIN(CASE WHEN part IN ('solid','lower','lower_down')
                      THEN y_top::int - 1 END) OVER w, screen_h - 1) AS fc_before
  FROM panel_seq p
  WINDOW w AS (PARTITION BY col_x ORDER BY depth_x, bsp_seq, part, seg_id
               ROWS BETWEEN UNBOUNDED PRECEDING AND 1 PRECEDING)
),
plane_spans_raw AS (
  -- 2. whatever the band leaves uncovered is a ceiling above the wall...
  SELECT col_x, fsec AS sector_id, f_ceil AS plane_z, 'ceil' AS plane,
         cc_before         AS y0,   -- from where nearer walls stopped
         f_ceil_y::int - 1 AS y1    -- down to this panel's own ceiling
  FROM panel_clips
  WHERE part IN ('solid','upper','upper_open','upper_flush')
    AND f_ceil_y::int - 1 >= cc_before          -- nothing left open: skip
  UNION ALL
  -- ...and a floor below it
  SELECT col_x, fsec, f_floor, 'floor',
         f_floor_y::int AS y0,      -- from this panel's own floor
         fc_before      AS y1       -- down to where nearer walls stopped
  FROM panel_clips
  WHERE ...
)
まず、シーン内でピクセルを描きうる各パネルについて、その列にまだ割り当てられていないピクセルがいくつあるかを計算する。そしてすでに割り当て可能なピクセルは、より手前のすべてのパネルから来る((1) の ROWS BETWEEN UNBOUNDED PRECEDING AND 1 PRECEDING の項)。その後、前のパネルの末尾から次のパネルの先頭まで描く(2)。天井も床も同じようにやる。
命令的アルゴリズムを集合ベースの書き方に偽装する、なかなかのハックだろう?窓関数があってよかった……
床、天井、空のレンダリングには通常 3 ms ほどかかる。
醜い部分
残念ながら、さっきは嘘をついた。壁、visplane、スプライトの解析は、実はまだ何も描いていない。これらが生み出すのは (x, y, depth, colour) の形の候補で、同じ位置に複数のピクセルがありうるが、深度が違う。Doom の固定小数点演算を実装していないので、別々の壁、床、空が重なりうるからだ。さらにスプライトもレンダリングする必要があり、スプライトは壁に部分的に隠されうる。Doom は極めて厳密に組み上げた手順でこれが決して起きないようにし、z-buffering を不要にしている。SQL でその手順を再現しようとして失敗し、諦めて力技に切り替えた。すべて生成してから勝者を選ぶ。
((LEAST(depth, 131071.0) * 4096)::bigint << 34) -- depth, clamped to 17.12 fixed-point
| ((2 - surface_priority) << 32)                -- wall > sprite > plane
| (LEAST(source_priority, 3) << 30)
| ((stable_id + 32768) << 14)                   -- stable tiebreak
| (light_index << 8) | palette_index            -- the payload
AS winner_key
...
SELECT pix, MIN(winner_key) FROM ranked_fragments GROUP BY pix
これは BSP 木と同じトリックだ。すべてを 1 つの bigint に詰め込んで min を取る。最上位ビットが深度なので、min を取れば勝者が見つかる。しかもペイロード(ピクセルの色)もキーの一部なので、もう一度 join する必要すらない!ハックに見えるが、これがピクセル単位の作業(Doom の 1 フレームは 320*200=64000 ピクセル)である以上、余計な仕事をしないよう気をつける必要がある。
この最適化をしても、フレーム全体で最も高くつく部分であることに変わりはない。平均 8.2 ミリ秒で、フレーム全体の 3 分の 1 を超える!まさに John Carmack がこれを避けた理由だ。だが運がいいことに、今のマシンなら SQL でこれを回しても 35 FPS の目標に届く。The future is now, old man!。
レンダリング性能
以下はレンダリングパイプラインを Doom の 35 FPS フレーム目標と比較したウォーターフォール図だ。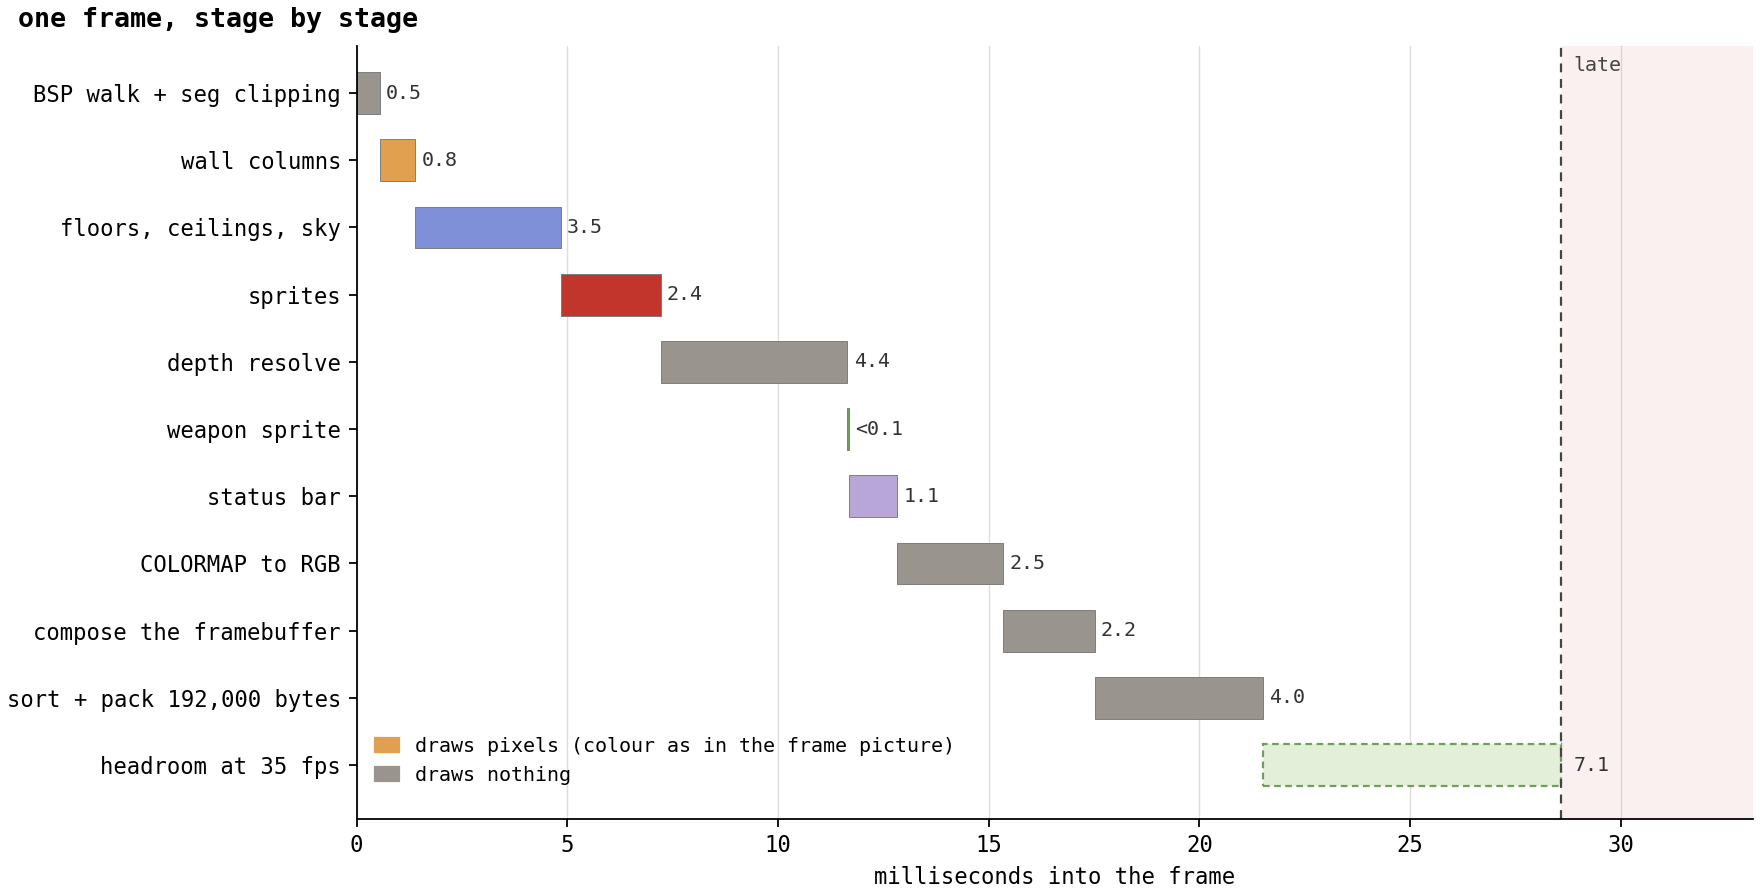
AMD Ryzen 7 7840U 上のレンダリングパイプライン
僕のノートPC(Ryzen 7 PRO 7840U)では、通常は60 FPSほど出るが、シーンが複雑になると35 FPSまで落ち込む。
パイプラインで最もコストがかかるのは(当然ながら)次の部分だ:
- visplaneのレンダリング(ここでは反復アルゴリズムを模擬する必要がある)
- 深度解析(オリジナルのDoomは最初からこれをうまく回避している)
- そしてピクセル単位の処理全般(colormapの参照、framebufferのパッキングなど)
データベースが本当に良い選択となる場面
データベースでDoomをレンダリングするのは明らかに悪手だ。だが、確かに向いている場面がいくつかある。ここは全力で擁護させてもらう!
すべてがデータ
アイテムの各種属性をリレーショナルデータセットに変換するのが、こんなに面白いとは思わなかった。ゲームに何が入っているかが一目でわかるのはもちろん、何より変更がとても楽だ。
プレイヤーのショットガンは1行で表せる:
doom=# SELECT name, ammo_type, ammo_per_shot, pellet_count,
doom-#        dmg_dice_count, dmg_dice_mult, max_range
doom-#   FROM weapon_defs WHERE name = 'shotgun';
  name   | ammo_type | ammo_per_shot | pellet_count | dmg_dice_count | dmg_dice_mult | max_range
---------+-----------+---------------+--------------+----------------+---------------+-----------
 shotgun | shells    |             1 |            7 |              3 |             5 |      2048
(1 row)
7発の弾丸、それぞれ3d5ダメージ。
アニメーションまでデータだ! これがショットガンの完全なステートマシン:
doom=# SELECT state, seq_index AS seq, frame, tics,
doom-#        is_attack_frame AS shoots, refire_check AS refire
doom-#   FROM weapon_frames WHERE weapon_id = 3 ORDER BY state, seq_index;
 state | seq | frame | tics | shoots | refire
-------+-----+-------+------+--------+--------
 ready |   0 | A     |    1 | f      | f
 fire  |   0 | A     |    3 | f      | f
 fire  |   1 | A     |    7 | t      | f
 fire  |   2 | B     |    5 | f      | f
 fire  |   3 | C     |    5 | f      | f
 fire  |   4 | D     |    4 | f      | f
 fire  |   5 | C     |    5 | f      | f
 fire  |   6 | B     |    5 | f      | f
 fire  |   7 | A     |    3 | f      | t
 fire  |   8 | A     |    7 | f      | f
 flash |   0 | A     |    4 | f      | f
 flash |   1 | B     |    3 | f      | f
(12 rows)
アイテムの属性をそのままテーブルに格納することで、あらゆるものが非常にmodしやすくなる。次の例を見てほしい:ダメージが足りなくて腹が立ったので、ショットガンを1回500発の弾丸に変え、散布も広げてやった!
Chea...Modショットガン
もちろん、すべてをJSONなどのファイルとして保存することもできた。だがそれはつまり、
- 変更時に制約が検証されない
- 変更を反映するにはリロードが必要
ということだ。
マルチプレイヤーがほぼタダで手に入る
さんざん苦労してDoomをSQLに移植したのに、データベース最大の利点を使っていない:マルチプレイヤーサーバーがタダで手に入るのだ! 聞いてほしい、従来のゲーム開発者が自分で構築しなければならない膨大なものを、我々はすべてタダで手に入れている:
- 認証
- 並行性制御
- アクセス制御
- ゲーム状態の一貫したスナップショット
- バイナリワイヤプロトコル
独立したPythonスクリプトrefereeが共有の35 Hzクロックを駆動し、マップをローテーションする。オンラインプレイヤーのクライアントが入力を提供する。
だが一番気に入っているのは原子性だ:ゲームticを実行するたびに、begin transactionと言い、最後にcommitとするだけ。各プレイヤー(Doomデスマッチは最大4人)が見るのは依然として一貫したビューで、ticトランザクションが始まる前の世界か、完全にコミットされた後の世界のどちらかだ。部分的に適用された更新も、物理バグも、ロケットが当たったかどうかの口論も起きない。
2つ目の意外にエレガントな部分はアクセス制御だ。sqldoom自体には約110のテーブルと100を少し超える関数があるが、4種類のプレイヤーロールは少数のよく定義されたAPI関数を通じてしかそれらとやり取りできない。それ以外はすべて、アクセス権を剥奪するだけだ!
プレイヤー入力を受け取るinput関数は良い例だ:
CREATE OR REPLACE FUNCTION api_input(
  p_fwd real, p_strafe real, p_run boolean, p_turn real,
  p_fire boolean, p_weapon integer, p_use boolean) RETURNS integer
LANGUAGE cedarscript SECURITY DEFINER AS $doom$
INSERT INTO mp_inputs
SELECT mp.map_id, mp.player_thing_id,
       LEAST(1.0, GREATEST(-1.0, COALESCE(p_fwd, 0)))::real,
       LEAST(1.0, GREATEST(-1.0, COALESCE(p_strafe, 0)))::real,
       [...]
FROM mp_players mp WHERE mp.role_name = session_user::text;
return 1;
$doom$;
この関数はテーブル(security definer)を変更できるが、プレイヤーはこの関数を呼び出すことしか許されていない。彼らが制御できるのは:前進のモメンタム(w/sが押されているか?)、ストレイフ(a/dが押されているか?)、走っているか?、マウスで向きを変えているか?、発射キーが押されているか?、どの武器が選択されているか?、そしてボタンを押す/ドアを開けようとしているか(spacebar)? だけだ。プレイヤーが入力する数値を信頼する必要すらない:関数が入力を許容範囲にクランプする。
マルチプレイヤーのパフォーマンスも驚くほど良い:クライアントあたり3コアで安定して35 FPSが出て、ゲームticも依然として予算を大きく下回っている。ticドライバにコアをもう1つ足せば、16コアのマシンでオリジナルの-altdeath doomデスマッチを十分に動かせる。
公開インスタンスはEpisode 1のマップをローテーションし、10分ごとに新しいマップに切り替わる。4つの席がすべて埋まっていても、SQLコンソールから進行中の試合をクエリできる。遊ぶ、あるいは進行中の試合をクエリする →
おまけ:SQLをコンパイルする
C++で書かれたデータベースがSQLを解釈実行するなんて、Cと比べ物にならないほど遅いに決まっている? おそらくそうではないが、どれだけ差があるのか評価してみたかった。
CedarDBはコンパイル型のデータベースシステムだ:複雑なクエリはすべて(複数のステップを経て)LLVM IRに落とし込まれ、マシンコードにコンパイルされる。そこで自問した:こうして生成されたマシンコードは、最初にコンパイルされたlinux_doomのCコードとどれだけ違うのか?
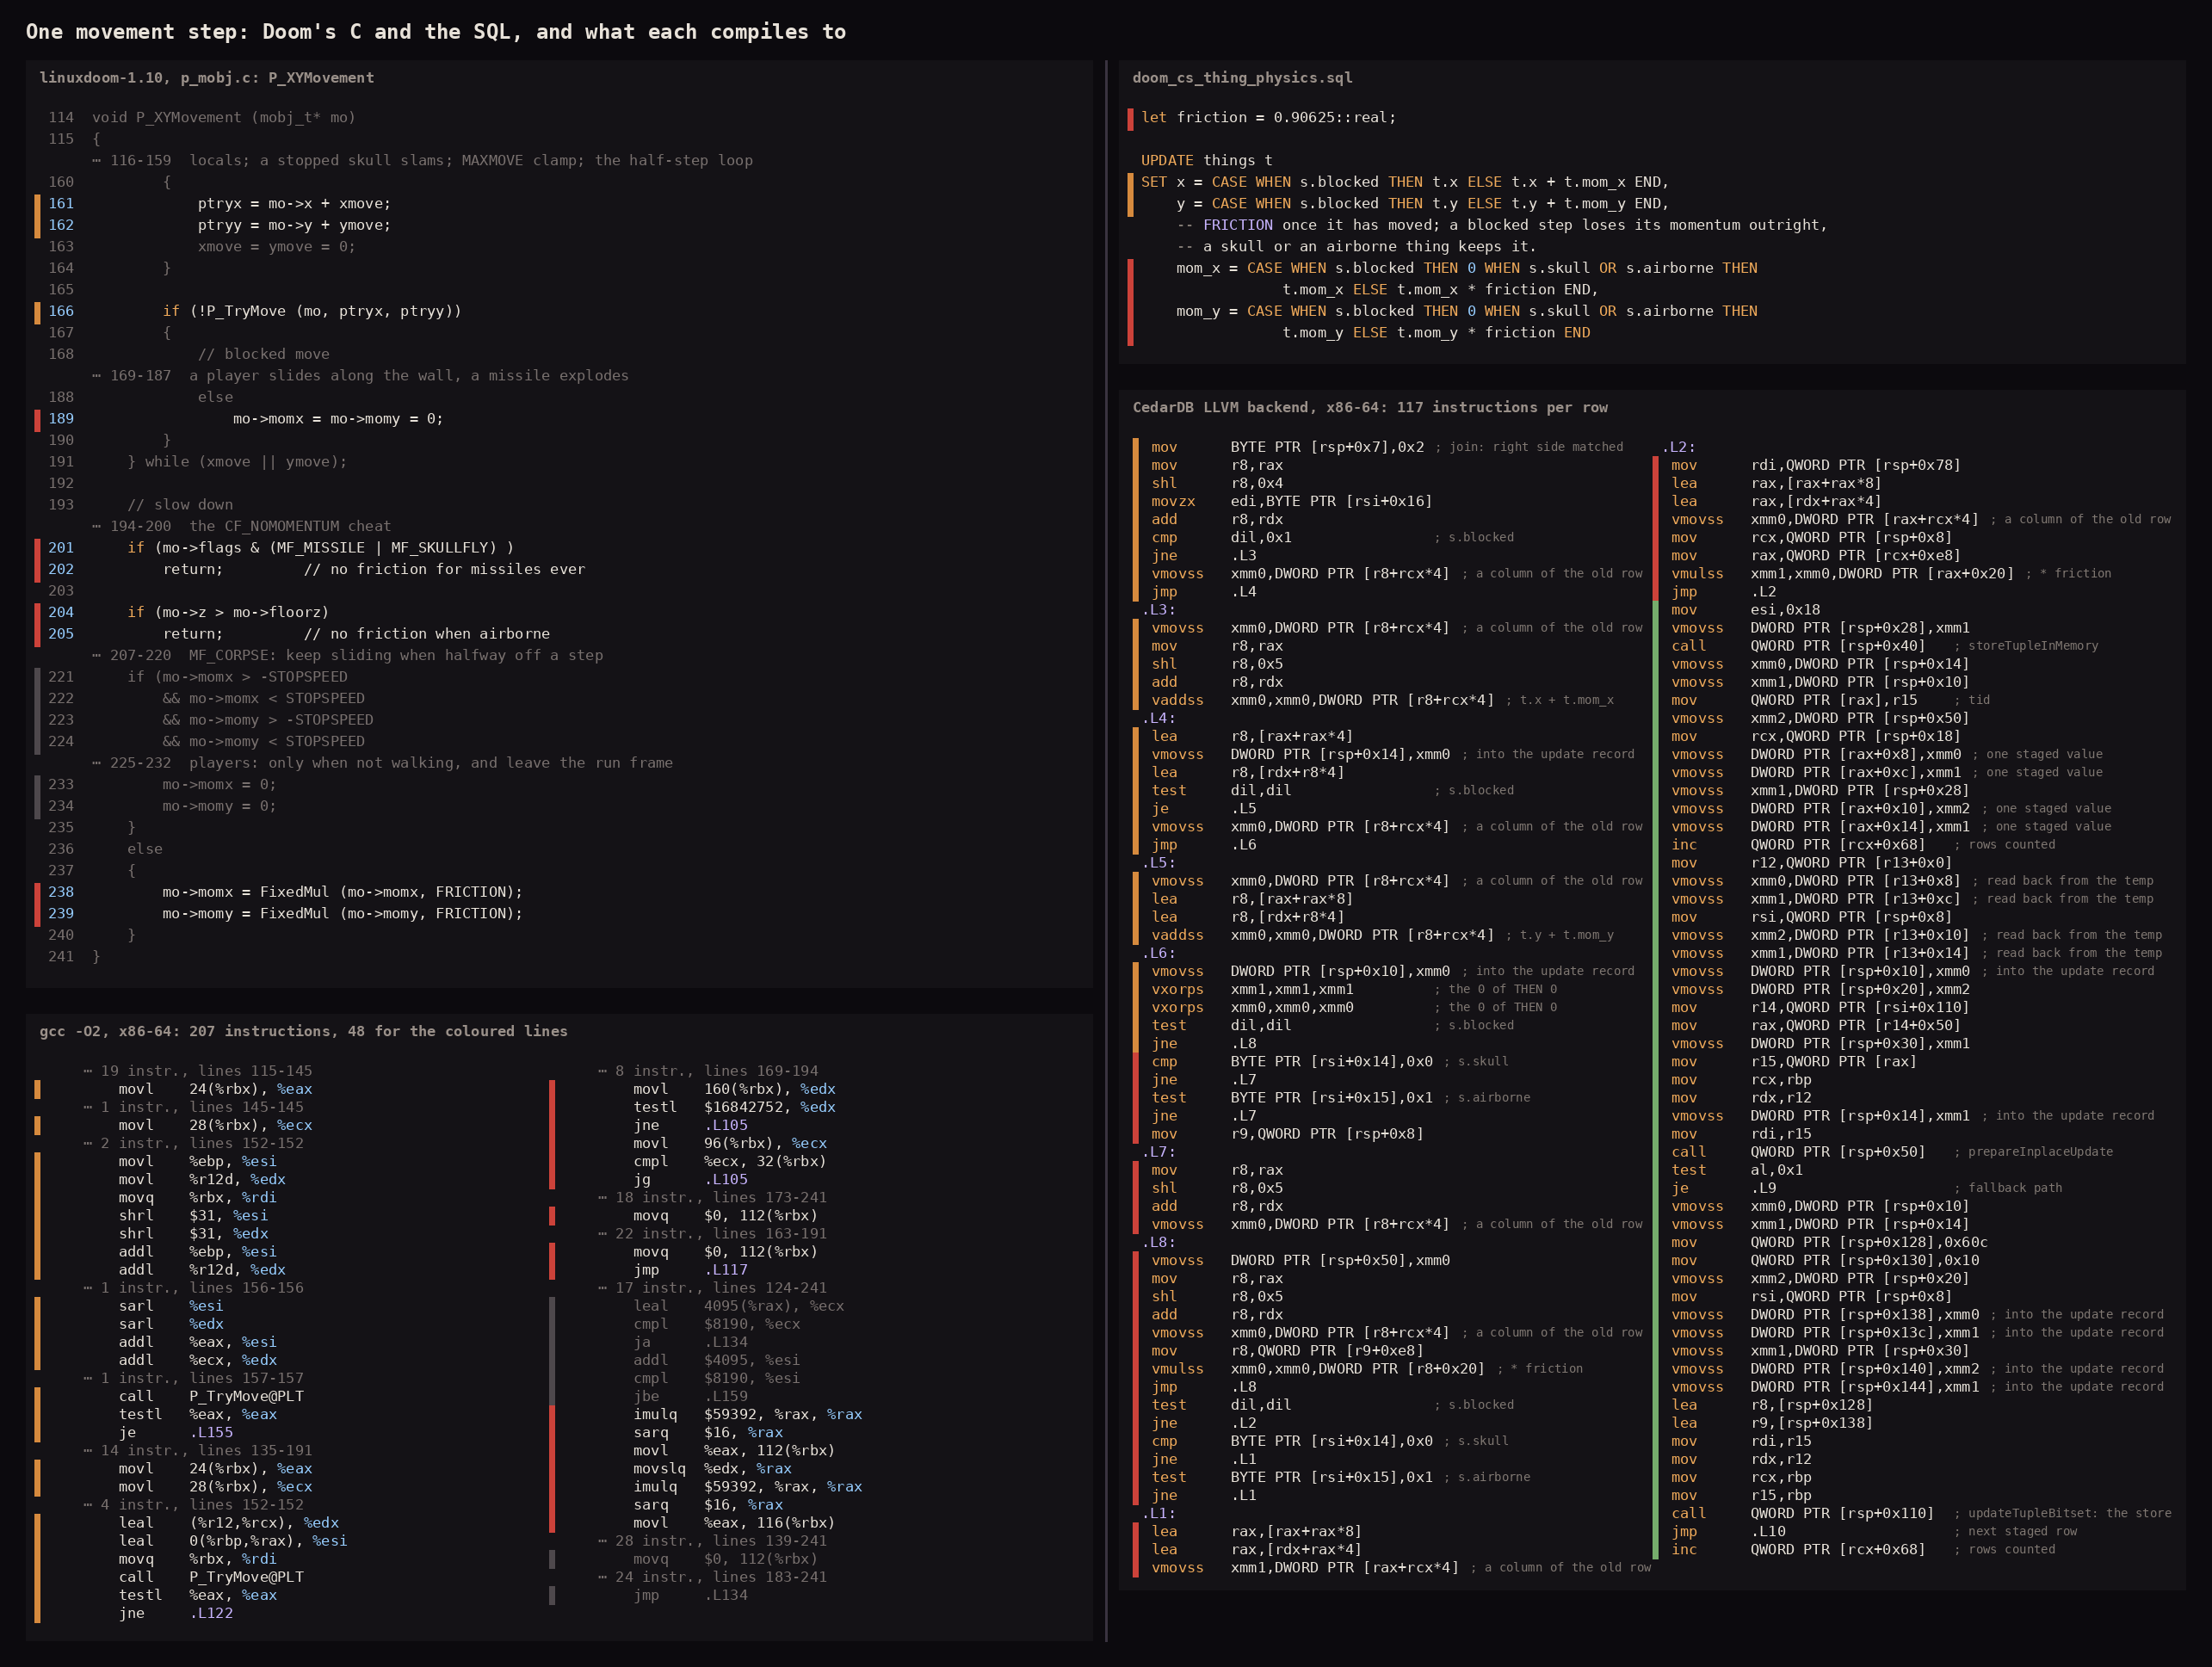
コンパイル済みlinux_doomとSQLDoomの比較
上半分はオブジェクトの運動ロジックと、モメンタムがそれにどう影響するかだ。左がdoomのオリジナルソース、右がSQLDoomの実装。ロジックの分割の仕方が少し異なるため両者は一対一には対応しないが、Cコードは48命令にコンパイルされ、SQLDoomは117命令だ。余分な命令のうち42は、実際には結果をテーブルに書き戻す処理(緑の線の部分)で、Cには明らかに不要なものだ。だから確かに劣っている、誤解しないでほしい、だがSQLとCPUの間に通常どれだけの抽象レイヤーがあるかを考えれば、それほど劣っているわけではない。SQLから始めて、まずクエリオプティマイザを通ってからLLVMに至るものとしては、この差は意外なほど小さい。
John Carmackは天才だ。
SQLDoom と、その Wolfenstein 3D もどきの前身 DOOMQL を比べてみよう。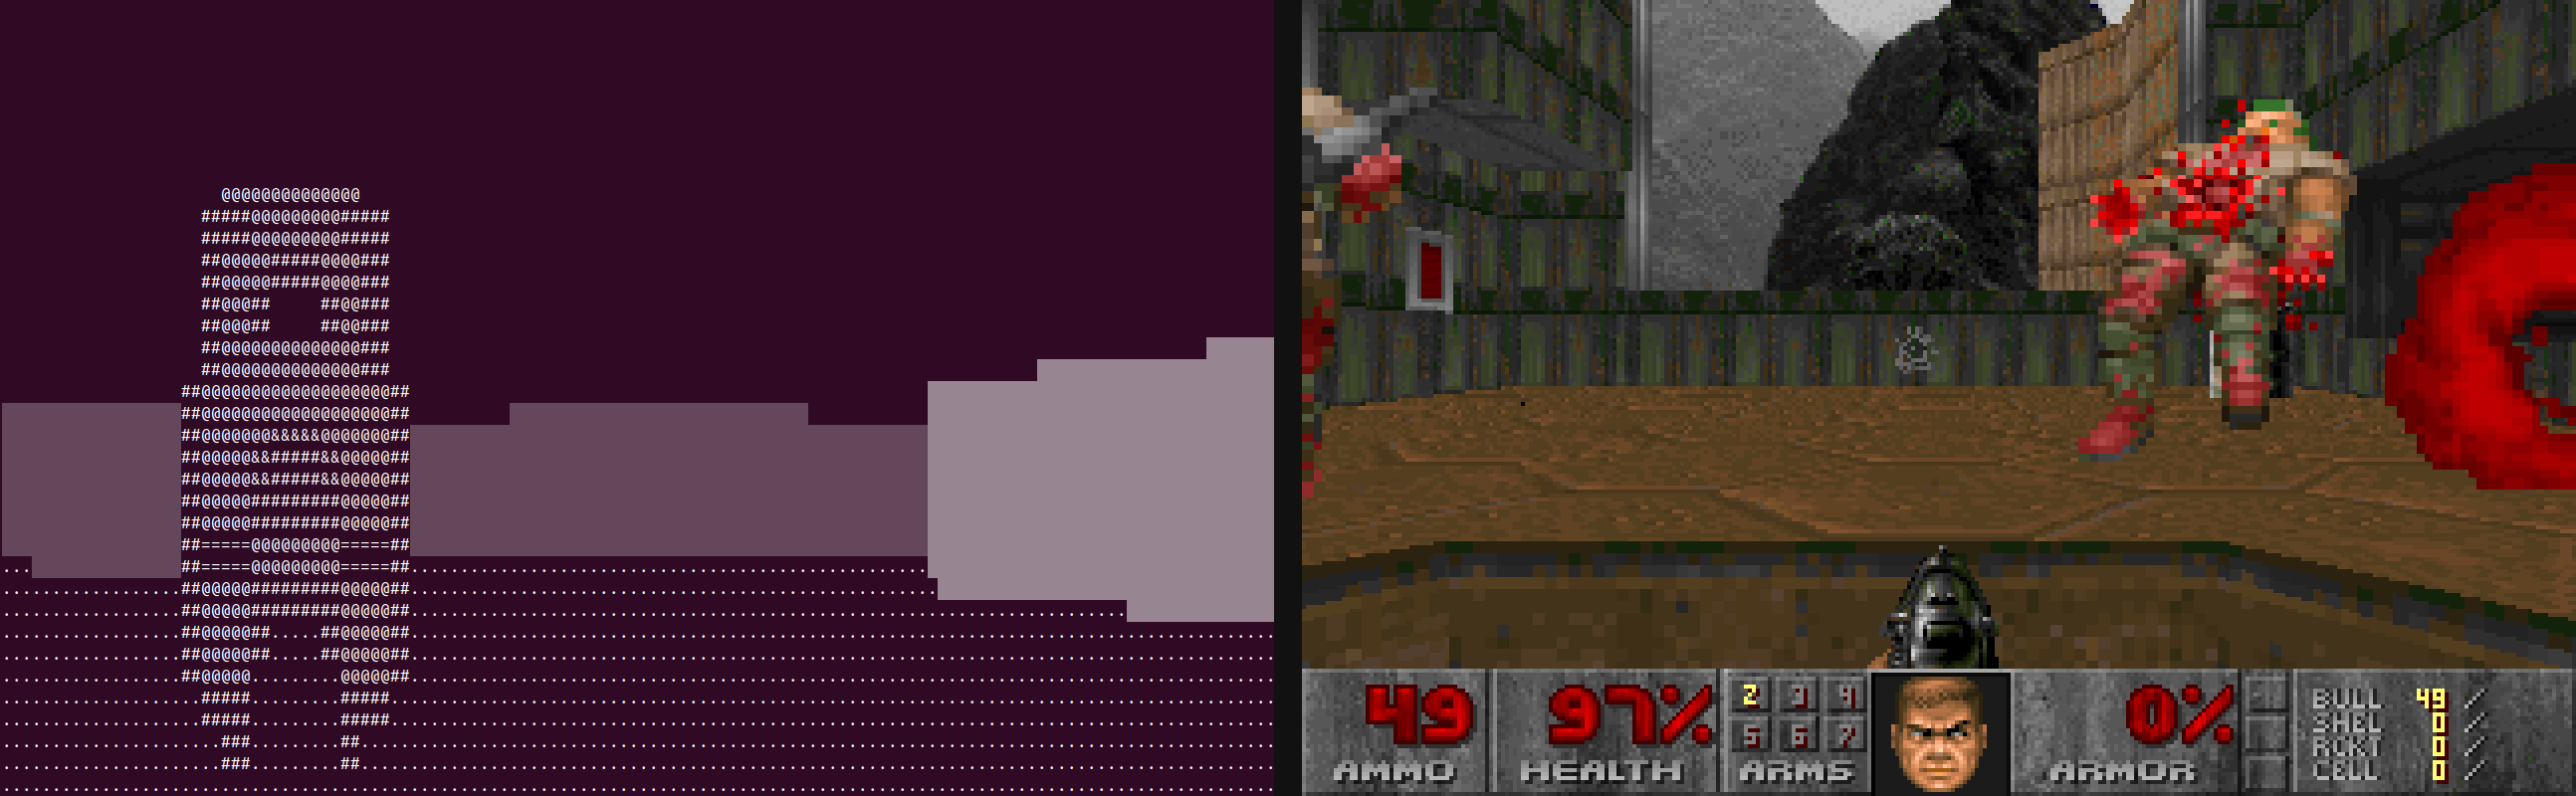
DOOMQL と SQLDoom の比較
どちらも同じエンジンで、制約も同じだ。SQL を入力するとビットマップが出てくる。誤解しないでほしいが、DOOMQL の原始的なレイキャスティングの発想自体は優れている。SQL で表現するのははるかに簡単で、ステップ間の依存も少なく、SQL の集合ベースの処理によく馴染む。
だが、「一番馴染む」ものがいつも一番良い結果を出すとは限らないと分かった。SQLDoom の BSP ツリー方式ははるかに速く、しかも画質の忠実度もはるかに高い。これもひとえに John Carmack が、ちょっとした目くらましで 486 からどれだけ絞り出せるかを真剣に考え抜いたおかげだ。
正直に言えば、CedarDB も追いついてきた。俺が DOOMQL を作っていた頃は、エンジンはもっと遅かったし、ロールベースのアクセスシステムもまだなかった。
自分で動かす方法
コードは GitHub にある:github.com/cedardb/sqldoom。
必要なものは三つ:
- CedarDB Community Edition、
psycopg2とpygameが入った Python、- そして Doom の IWAD。これは用意できない。シェアウェア版の doom1.wad は自由に再配布でき(
apt install doom-wad-shareware)、第 1 章を遊ぶには十分だ。リテール版の WAD を持っていれば、それも使える。
あとは README に従えば、すぐに自分の SQLDoom が動く。
あるいは、そんな手間が面倒なら、公開インスタンスに直接入って一戦やろう: