我们将原版《毁灭战士》移植到了SQL
CedarDB 用 SQL 查询实现了 Doom 的游戏逻辑和渲染器,包括死亡竞赛。文章介绍了整体架构、游戏循环、SQL 中的 BSP 遍历,以及数据库的执行模型在哪些方面恰好非常契合。
中文
复制
原版 Doom 的游戏逻辑和渲染器,两者都用 SQL 查询实现。哦对了,死亡竞赛也能跑!
Lukas Vogel
目录
Lukas Vogel
目录
TL;DR: 我们把 1993 年原版 Doom 的游戏逻辑和渲染器移植到了 SQL,并让它在数据库里跑了起来。游戏循环以原版的 35 FPS 运行,渲染器在我的笔记本上能以最高 60 Hz 生成完整的 320x200 帧缓冲。Python 只负责计时、读取键盘,以及显示拿回来的位图。多人游戏也能玩。
你的浏览器不支持 video 标签。
SQLDoom 在 AMD Ryzen 7 7840U 上运行
现在就能玩死斗模式,四个位置,先到先得。
这是第一章节的共享软件版。座位满了就得排队。队列也满了的话,你仍然可以一边等,一边用 SQL 查询实时游戏状态。
SQLDoom
去年我发布了 DOOMQL [
](https://github.com/cedardb/doomql)。它以 30 FPS 渲染出大致像 Doom 的 ASCII 画面,反响不错。但有人正确地指出,它更接近 Wolfenstein 3D 而非 Doom,因为它用的是光线投射。Doom 用的是 BSP 树,正确的深度排序因此足够廉价,才负担得起纹理、任意角度的墙壁和不同的地板高度。
这事我一直没法放下,折腾了一阵之后(你猜对了,又是育儿假),终于可以展示完全用 SQL 运行的真正 Doom。
其中一个是 1993 年的二进制文件,另一个是一条 SQL 查询。你能分辨出哪个是哪个吗?
规则
先定几条基本规则,明确我们想达成什么:
- 看起来得像真正的 Doom。回头看,DOOMQL 的画面保真度相当丢人。
- 但更重要的是,玩起来也得像真正的 Doom。原版游戏就是纯粹的好玩。
- 渲染必须完全基于 SQL。SQL 唯一可接受的输出是一张表,或一张为每个像素编码精确 RGB 值的位图。
- 游戏循环也必须完全基于 SQL。不过在数据库里使用用户自定义函数是可以的。
- 我可以用其他编程语言写客户端,只要它只负责解析输入、驱动游戏 tick 和渲染输出位图。
架构
Python 是刻意选得无聊的(规则 5)。一个脚本用 pygame 处理输入、绘制输出位图,并每秒触发 35 次游戏 tick。游戏逻辑、游戏状态和渲染器都在数据库里。
                         Python
                 input / timing / display
                    |              ^
                    |              |
          run game tic        request frame
                    |              |
                    v              |
          +----------------+  +----------------+
          |                |  |                |
          | SQL game logic |  |  SQL renderer  |
          |                |  |                |
          +-------+--------+  +--------+-------+
                  |                    ^
                  |                    |
                  v                    |
             +-----------------------------+
             |                             |
             |       game state tables     |
             |                             |
             +-----------------------------+
两条路径刻意分开:游戏逻辑跑在固定的 35 Hz 循环上,渲染器则是游戏状态表的一个纯函数,客户端想什么时候要新帧就什么时候要(也就是尽可能快、尽可能频繁)。
加载游戏数据
方便的是,Doom 的 .wad 文件格式 本身就已经高度关系化了。
两个 VERTEXES 通过一个 LINEDEF 相连,而后者有两个 SIDEDEF。SIDEDEF 围出一个 SECTOR,里面可以放 THINGS,你懂这个意思。把整个 WAD 转成数据库出乎意料地直接,大约 1000 行 Python 就搞定了。导入整个 Doom 1 在我的笔记本上大约要 18 秒。
比如,下面这条查询以俯视视角渲染 E1M1:
WITH wall AS (
  SELECT round((v1.x + (v2.x - v1.x) * t / 32.0) / 48) AS col, -- 48 units per column
         round((v1.y + (v2.y - v1.y) * t / 32.0) / 96) AS row, -- chars are 2:1
         l.left_sd_id < 0 AS solid -- one-sided lines are pass-through
  FROM linedefs l, generate_series(0, 32) AS t        -- walk each line in 32 steps
  JOIN vertexes v1 ON (v1.map_id, v1.id) = (l.map_id, l.v1_id)
  JOIN vertexes v2 ON (v2.map_id, v2.id) = (l.map_id, l.v2_id)
  WHERE l.map_id = 1
)
SELECT string_agg(CASE WHEN (col, row) IN (SELECT col, row FROM wall WHERE solid) THEN '#'
                       WHEN (col, row) IN (SELECT col, row FROM wall)             THEN '.'
                       ELSE ' ' END, '' ORDER BY col)
FROM generate_series(-16, 79) AS col, generate_series(-51, -21) AS row
GROUP BY row ORDER BY row DESC;
输出:
                                                 #####################
                                                 # ..................#
                                                 # . ......         .#
                                                 # . ...... ######  .#
                                              ######         .. ##  .#
                                          #####..  .         .. ##  ##
                                          #  ####### ...... ######  ##########
                                          # ##   # .                ###..  ..##
  ################                       ## #    ###.........######## #####.  ##
```text
 ........... #                ########..########.........###         #### .##     ######
 ..           ##########     ####         ##                 ##        #..... #######    ##
 .          #####  ... ##  ###   #.....#..##    ........      ##########..... ....##.#### ##
 .     ###.###  ......  ###  .   .        ##  ...      ...             . ......     .#  ##  ##
 .     ##..  .  ......  ##   .   .        ##  .           .            . ..........  ##  ## ##
 .     ###.######  ...  ######   #.....#..##  ...        ..            #.    ... ..   # ## ##
 .           ############    #            ..    ..........             #.......... ...# #  #
###......... # ##### ##### ##..... ... ##.### # ################ ####### ####.........##.##........####### .####### ### # ###########.################# # #### # # ## #.# ####...... # # . ### ## #.################# # ########### ####. .#### #..#
######..######
. ..
##...##
## ##
######..######
#.. #
## The Game Loop
It was important to me to actually *port* Doom, not only render frames that vaguely look like it. Of course, the visuals play a big part in that, but Doom also just *feels* awesome to play. Take a look at the following scene which is rule 2 in action (me having fun):
Gibbing 3 soldiers with a rocket launcher
As you can see, there is a lot going on. Just in this short clip we see:
- Player input has to be polled and processed (walking, turning, shooting),
- enemies walk and attack,
- items are picked up,
- the rocket launcher fires projectiles that move,
- rocket explosions have a blast radius,
- enemy sprites have to be rendered,
- animations, view bobbing, and the HUD
而且处理这些数据的时间并不多:原版 Doom 跑在固定的 35 Hz 时钟上,所以一个 tic 的预算是 `1000 ms × 35 Hz = 28.6 ms`。它每个 tic 也只画一帧,因此帧率同样被限制在 35 FPS。
SQLDoom keeps the game logic at 35 Hz (so all the original constants still work), but decouples the drawing. The client can query (get it?) for a frame whenever it likes and we interpolate the camera position between tics. So there are two budgets we have to take care of:
- Running a tic every 28.6 ms (or it will feel just completely wrong)
- Rendering at least 35 frames a second (less is kind of okay, but won’t feel smooth)
### The tic sequence
游戏的 tic 天生是过程式的。每跑一次 tic,都有一串必须按顺序做的事。CedarDB 有一种叫 `cedarscript` 的脚本语言,写法很像 PL/pgSQL,让我们能事先规划好每个 tic 要做什么。
Here is a small section of the tic function:
```postgres
doom_cs_clock(map, p);
let mut plan = doom_cs_plan(map, p); -- returns a bitmask of functions to trigger
let use_queued = doom_tic_use(map, p, plan);
if (plan & 2) <> 0 OR use_queued { active = doom_cs_activate_specials(map); }
if (plan & 4) <> 0 OR active <> 0 { doom_cs_doors(map, p); }
doom_tic_move(map, p); -- full movement, or just turning
doom_cs_death(map, p); -- process deaths
plan = doom_cs_plan(map, p); -- the world moved; re-plan
plan = doom_tic_secrets(map, p, plan); -- secrets, walkover lines, pickups
plan = doom_tic_weapon(map, p, plan); -- weapon state, hitscan, damage
...
if sound_due { doom_cs_sound(map, p); } -- yes, we also play sounds
doom_cs_monsters(map, p); -- always
doom_cs_sector_fx(map, p); -- always
doom_cs_thing_physics(map); -- always
上面那个 Python driver 每隔 1/35 秒调用一次 SELECT doom_run_game_tic(...)。
每个被调用的函数随后执行一批 SQL 语句。下面是 monster AI 状态机的一部分。
-- Abridged from sql/runtime/functions/26_cs_monsters.sql.
WITH RECURSIVE
  monsters AS ( [...] ),   -- who is alive, what kind, where
  los      AS ( [...] ),   -- visible, in_view_cone, dist: recursive, walks walls
  decision AS ( [...] ),   -- one row per actor: its state and what it can see
  transitions AS (
    SELECT d.*,
      CASE
        WHEN NOT d.alive AND d.state NOT IN ('die', 'dead', 'xdeath') THEN
          CASE WHEN d.health < -d.max_health AND d.xdeath_frame IS NOT NULL
               THEN 'xdeath'::actor_state ELSE 'die'::actor_state END -- GORY EXPLOSION!
        WHEN d.state = 'stand' THEN
          CASE WHEN d.visible AND d.in_view_cone AND d.dist <= sight_range
               THEN 'see'::actor_state ELSE 'stand'::actor_state END
        WHEN d.state_tics > 1 THEN d.state          -- animation still running
        WHEN d.state = 'see' THEN
          CASE WHEN d.visible AND d.dist <= d.attack_range
                    AND d.attack_cooldown <= 0
               THEN 'missile'::actor_state ELSE 'see'::actor_state END
        [...]                -- die, xdeath, missile, pain, barrel: 5 more
        ELSE d.state
      END AS next_state
    FROM decision d
  )
UPDATE monster_ai ai
SET state = n.next_state, state_tics = n.next_tics, seq_index = n.next_seq,
    fired_this_tick = n.advances AND n.lands_on_attack_frame
FROM next_values n
WHERE ai.map_id = n.map_id AND ai.thing_id = n.thing_id;
可以看到,它编码了上面那段视频里的行为:如果敌人受到极端量的伤害(CASE WHEN d.health < -d.max_health AND d.xdeath_frame IS NOT NULL),它就会猛烈爆炸!(THEN 'xdeath'::actor_state)。
Tic driver 性能
下面是一个游戏 tic 的瀑布图渲染:
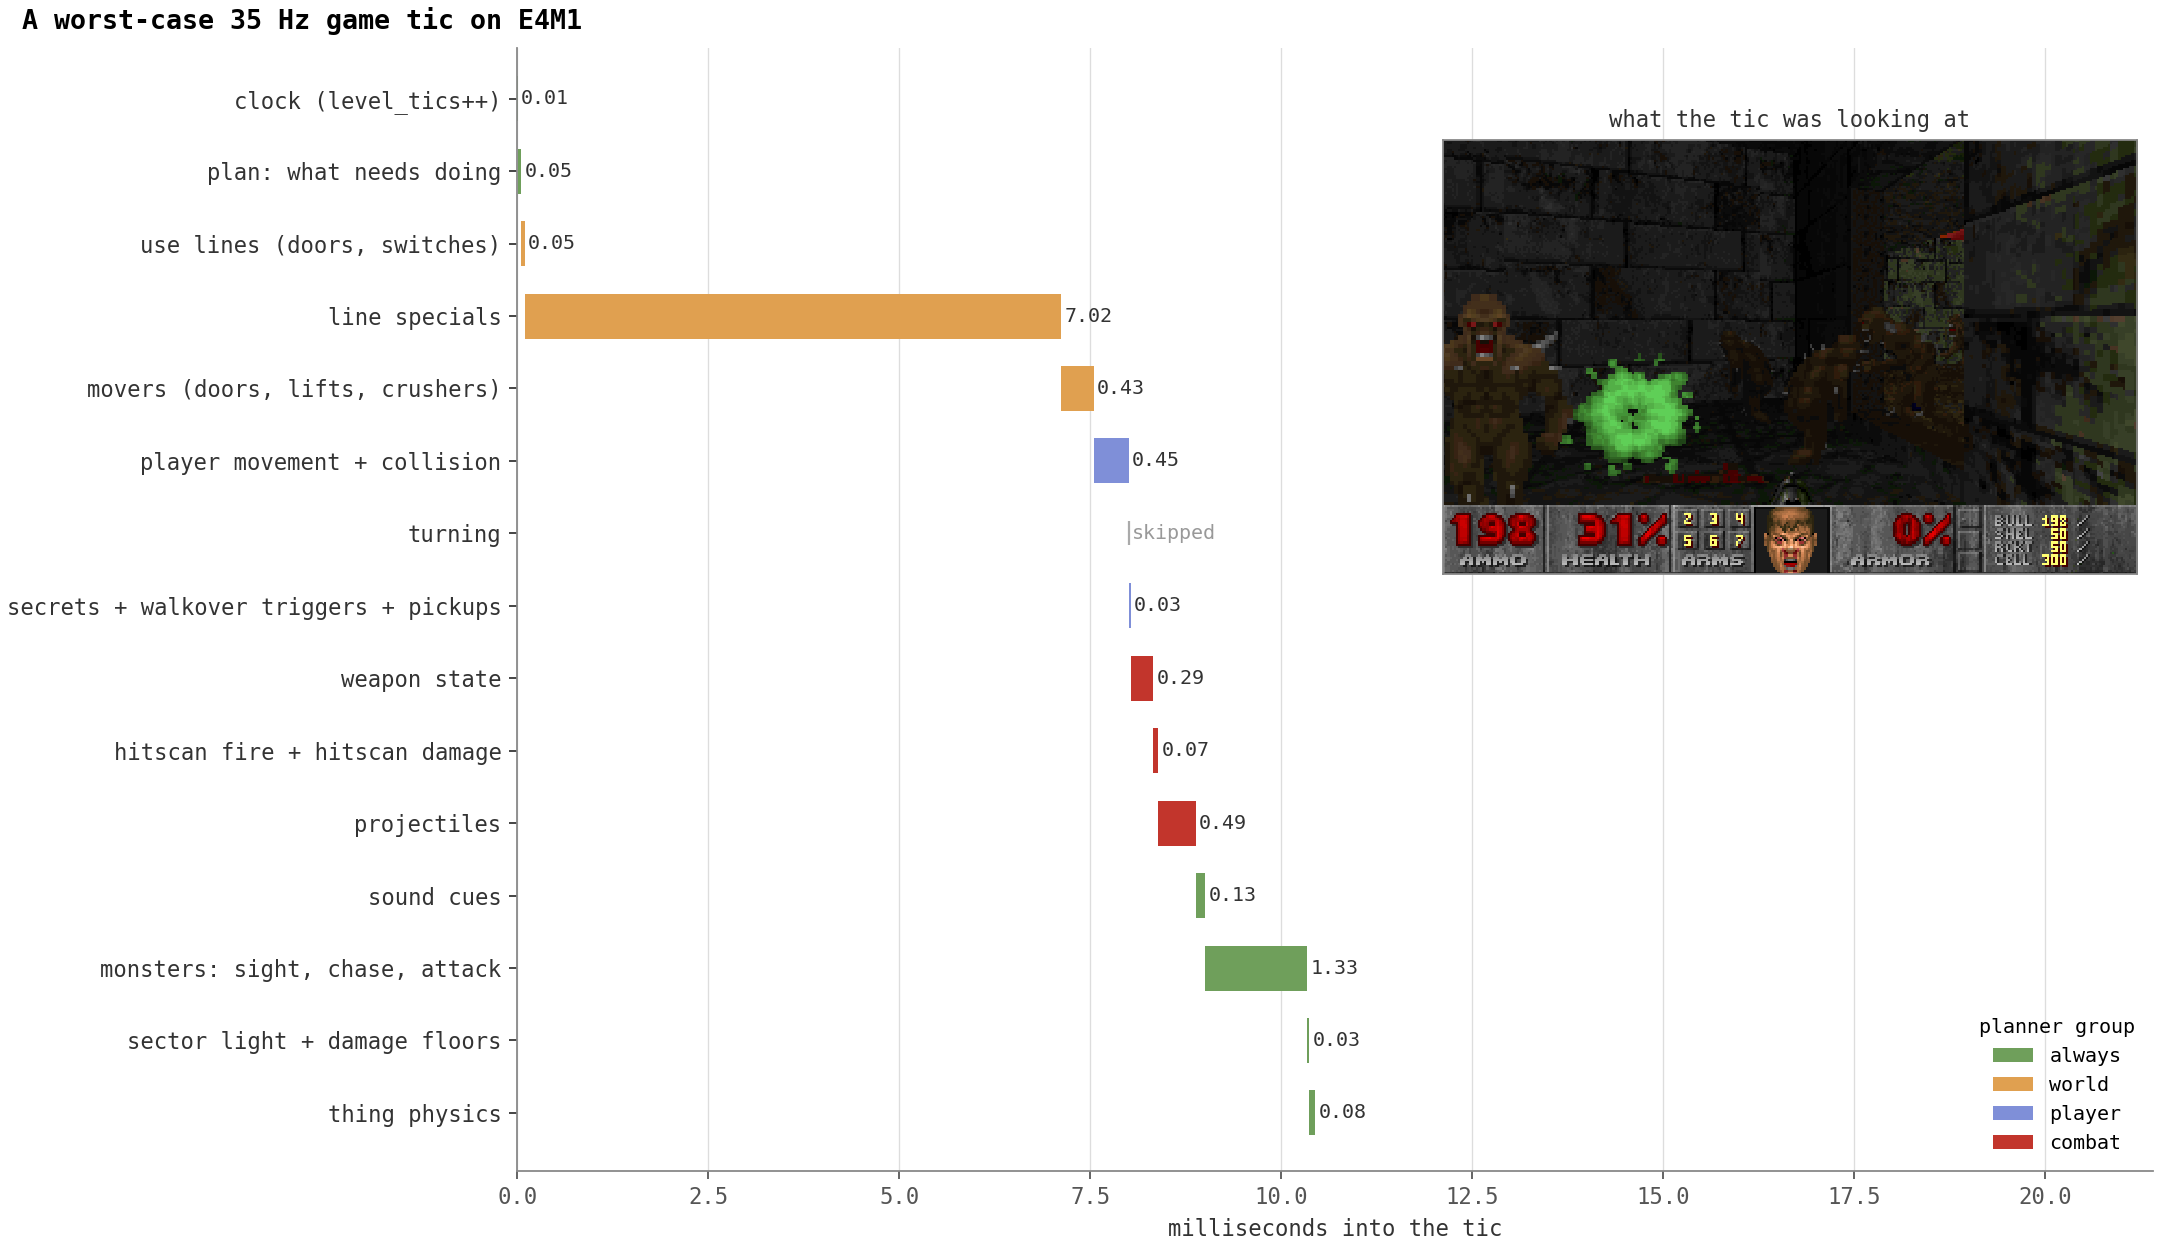
我能找到的最慢的游戏 tic
这确实是我能找到的最慢的游戏 tic。它出现在 E4M1 关卡,46 个醒着的怪物全都试图穿过一扇正在打开的门朝我冲过来。耗时 10.45 毫秒,约占可用 tick 预算的 ~37%。
一个更典型的 tic,6 个怪物醒着,平均耗时 2.15 毫秒,约占预算的 8%。余量还很充足!
说实话,我没想到用 SQL 表达相当复杂的游戏逻辑竟然这么容易。游戏逻辑只有约 5900 行 SQL。听起来很多,但肯定比做同样事情的原始 C 源代码少,后者大约要 9000 行!
而且,它会迫使你换一种思路。你不必逐个遍历敌人,而是直接写一个简单的 UPDATE ... WHERE condition,让数据库自己决定如何最好地执行它——自动并行!
这也终于让我真正理解了 Entity Component System (ECS) 模式。在这里,每个 entity(玩家、怪物、物品……)都有多个 components(位置、精灵、属性……),而一个 system(monster AI、move player、damage calculation)决定具有给定属性集合的实体之间如何交互。ECS 很大程度上关乎数据局部性,以及如何遍历拥有给定组件集合的实体。而在 SQL 里,我们早就非常习惯数据密集型处理了!每个组件变成一张表,每个 system 变成一个 update 或 insert,只需以实体作为 join key,把它感兴趣的表 join 起来!
渲染
每一帧都只是一个巨大的 view,它以关卡几何和游戏状态加上玩家位置作为输入,返回一个完整的 framebuffer。下面是整个渲染管线的草图:
WITH RECURSIVE
  render_context AS (SELECT $1 AS map_id, $2 AS player_thing_id, $3 AS difficulty),
  pos            AS (SELECT $4 AS x, $5 AS y, $6 AS z, $7 AS angle),
  visible_children AS ( ... ),    -- walk the BSP, culling invisible segments
  clipped, projected, on_screen,  -- project segments to screen space
  wall_parts, columns, fragments, -- one row per wall pixel
  panel_clips, plane_spans, ...,  -- ceiling/floorclip as window functions, visplanes
  thing_pixels, sprite_fragments, -- sprites
  fragment_union, resolved,       -- every candidate pixel, resolve for the nearest
  view_colored, ui_colored,       -- COLORMAP, status bar
  framebuffer AS ( ... )          -- 64,000 rows of (x, y, rgb)
SELECT string_agg(rgb, ''::bytea ORDER BY y, x) AS frame_rgb
FROM framebuffer;                  -- 192,000 bytes, one row
这个实现大约有 1300 行 SQL(不含注释),拆成 89 个 CTE,对一条 SQL 查询来说算是相当复杂了!
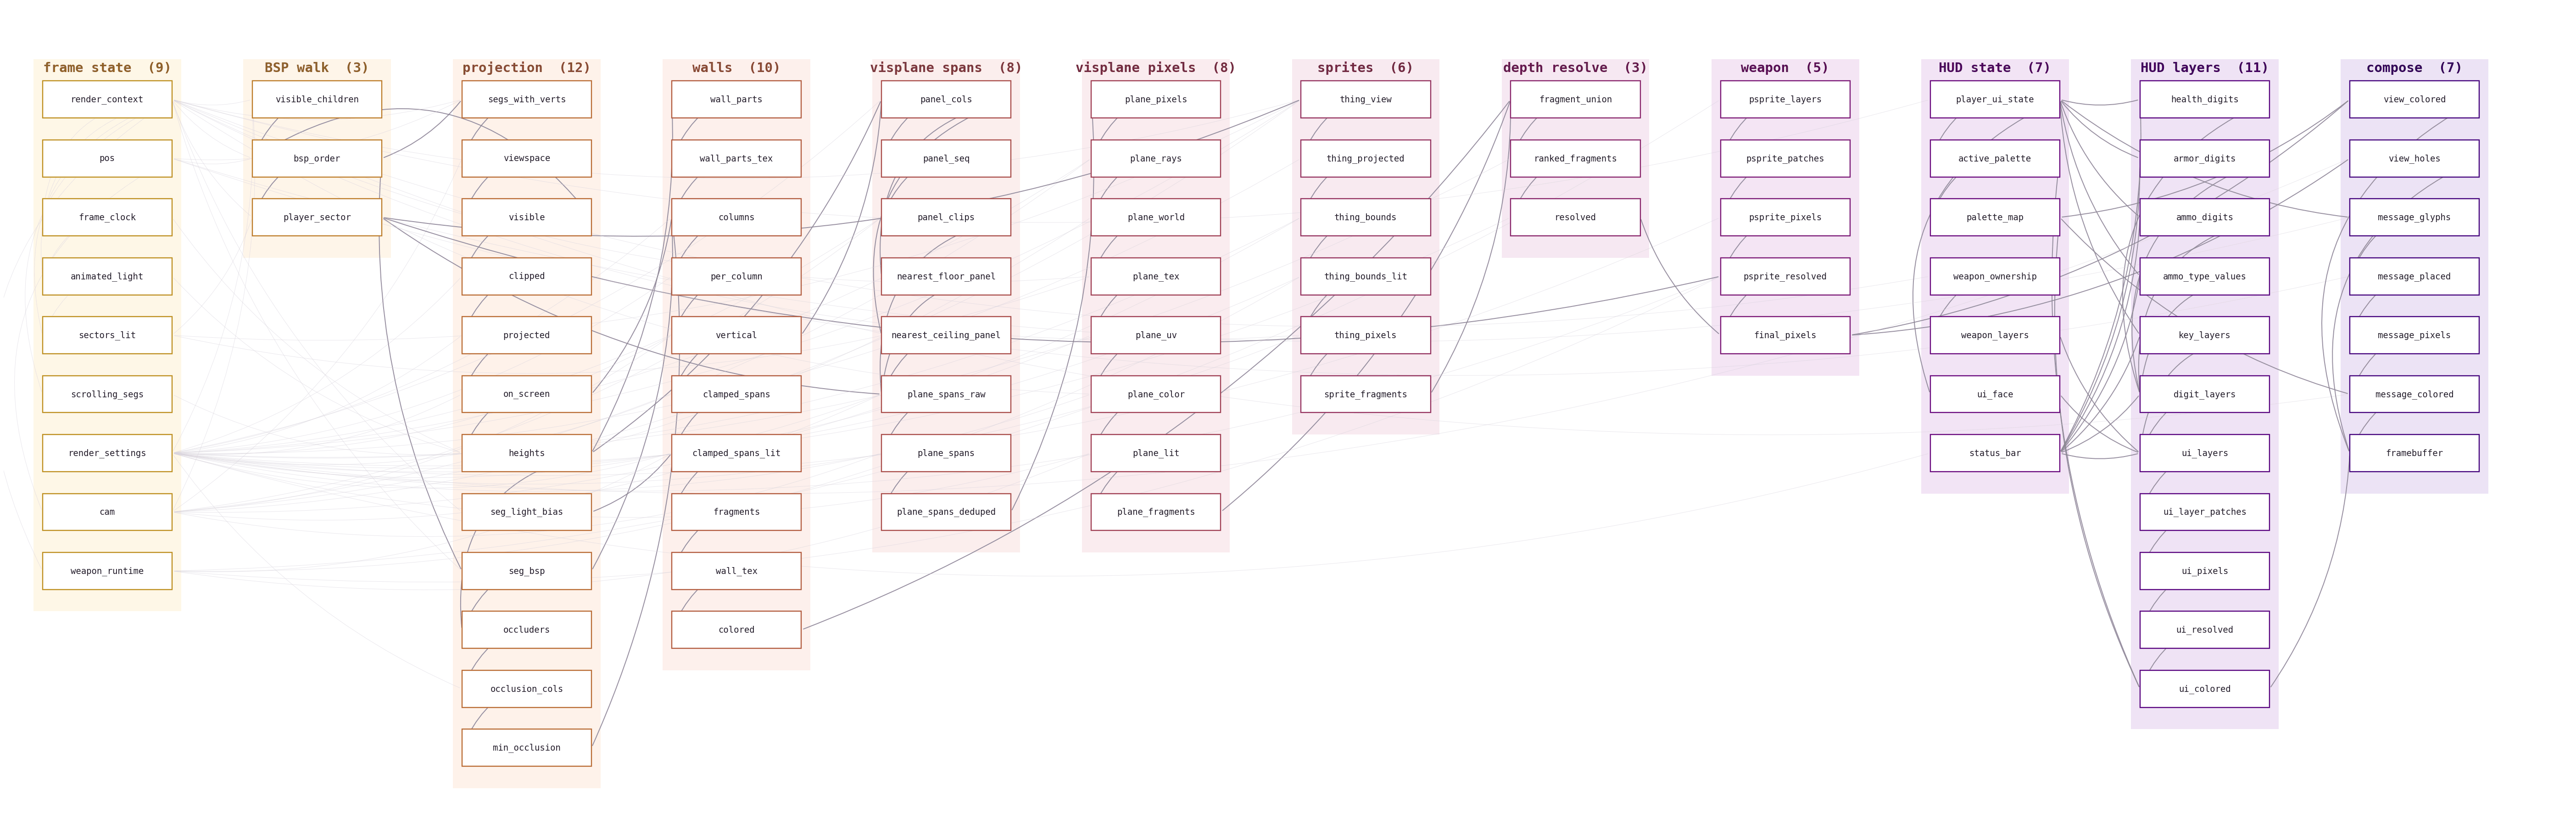
单个渲染帧的全部 89 个 CTE
虽然看起来完全是一团乱麻,但这条流水线和 Doom 的做法其实相当接近。SQL 甚至还有一点优势:linux_doom 源码的渲染引擎大约有 3300 行(不含注释),差不多是 SQLDoom 的 2.5 倍。至于一开始这个想法到底靠不靠谱,那是另一个问题,后面再聊。
先看看渲染流水线里最有意思的几个部分:
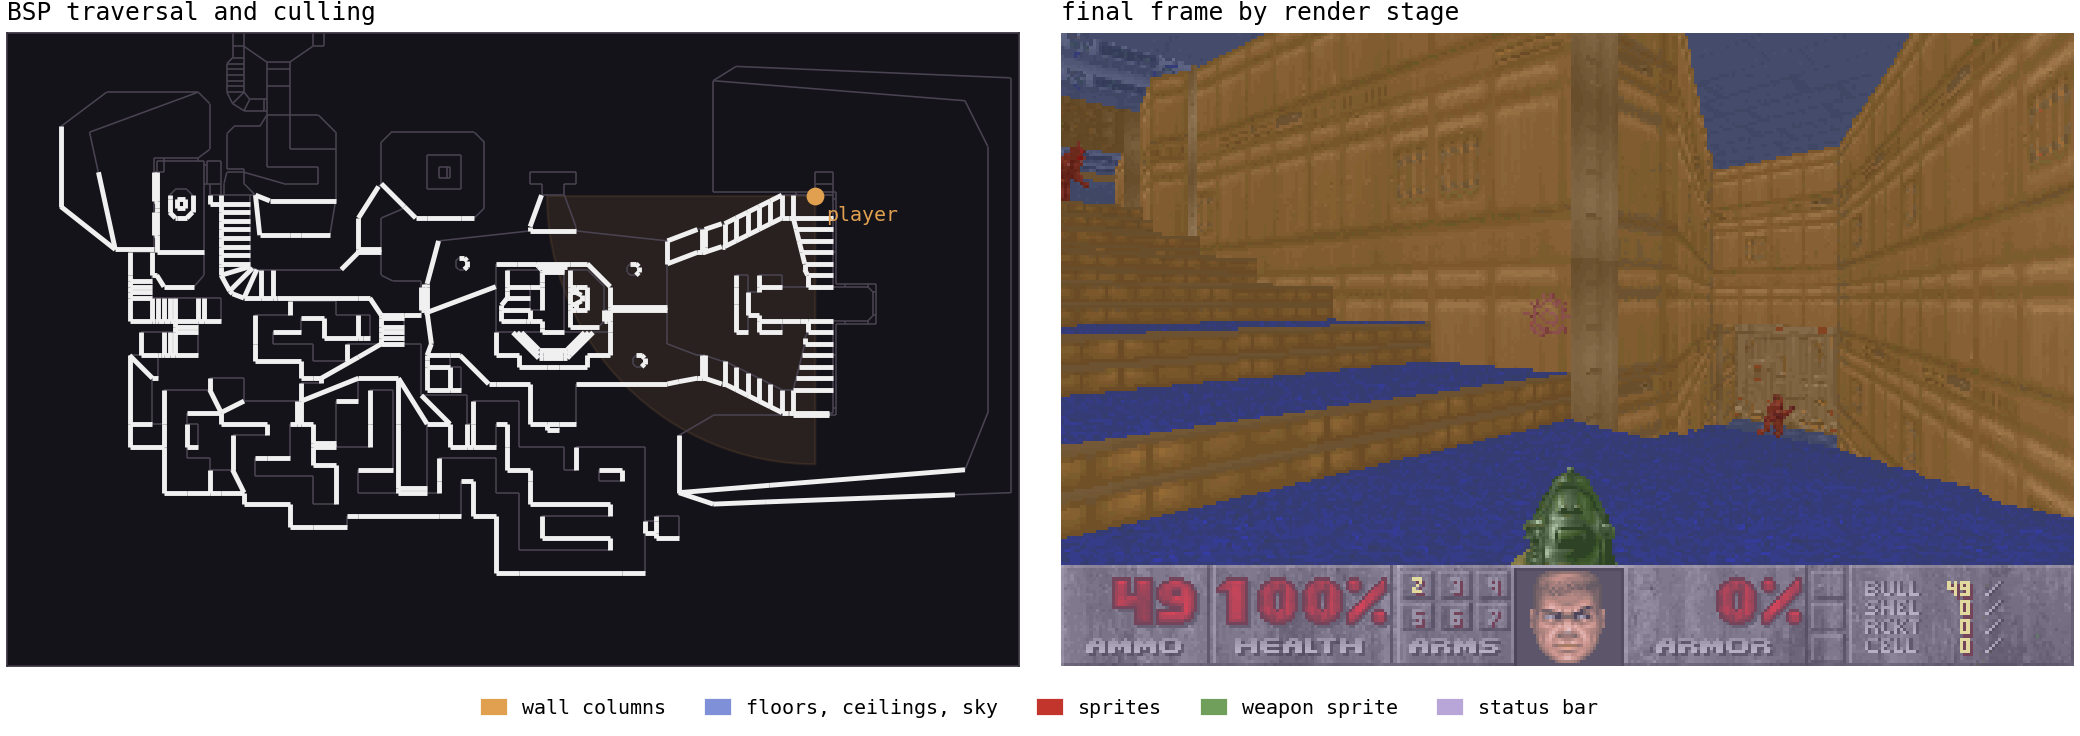
按渲染阶段可视化的帧
左半边是基于 BSP 的剔除,右半边是墙面渲染和 visplane 的可视化。
BSP 遍历
1993 年没人有带硬件加速 Z-buffering 的 GPU,所以 Doom 只能靠正确的绘制顺序来保证遮挡关系。Doom 的做法相当巧妙:从前往后画,同时记录哪些像素已经画过(也就是说,如果某个墙面像素已经画了,它后面的怪物就不用再画)。但说起来容易做起来难:我们需要一种高效的方式,把关卡里的所有东西按深度排好序。
Doom 靠预先算好的 BSP 树来得到这个顺序,这棵树被烘焙进 doom.wad 文件里。树的每个节点是一条把地图一分为二的线。地图的 sector 因此被切成许多 subsector,分别位于这些线的两侧,然后被插入树中,从而得到以下性质:
- 每个 subsector 都是叶子节点;
- 每个 subsector 都是凸的(也就是说,站在它内部任何位置都能看到它的任意一面墙);
- 在每个树节点上,位于相机一侧的整棵子树一定在另一侧子树前面。
于是,递归遍历 BSP 树就能得到所有 subsector 的从前往后顺序。渲染顺序也就直接有了:一旦某块屏幕区域被更近的东西覆盖,它后面的物体就可以跳过。
下面是动态中的效果(你可能需要全屏观看):你的浏览器不支持 video 标签。
BSP 遍历的可视化
左侧按从前到后的顺序排列子扇区,同时视锥之外的 BSP 分支会被提前剔除。中间显示的是 SQLDoom 为每个区域分配的顺序。右侧则是最终画面,墙壁的颜色对应它们所属的子扇区。
中间的面板展示了 SQLDoom 做的一项优化:为了提升性能,我们在加载时一次性预计算 BSP 树中的所有路径。对于给定的位置,路径上的每一步要么走前面(编码为 0),要么走后面(编码为 1)。把这些决策打包进一个 bigint,再按字典序排序(order by),就得到了正确的前后顺序。
SELECT ssector_id, ROW_NUMBER() OVER (ORDER BY sort_key) AS bsp_seq
FROM (
  SELECT st.ssector_id,
         -- back = 1 at bit (40 - depth), front = 0.
         SUM(CASE WHEN st.side = fs.front_side THEN 0::bigint
                  ELSE (1::bigint << (40 - st.depth)) END) AS sort_key,
         BOOL_AND(vc.keep) AS visible   -- was any parent bbox culled?
  FROM node_path_steps st -- materialized view, every root-to-ssector path
  JOIN nodes n ON ...
  CROSS JOIN LATERAL (SELECT ... AS front_side) fs -- on which side are we?
  JOIN visible_children vc ON ...
  GROUP BY st.ssector_id
) s WHERE s.visible;
一个 sum() ... order by 就替代了整个递归下降!40 位也足以应付我们扔给它的任何地图:最深的 BSP 树来自 E4M8,也只有 32 层。只要你的地图不超过原版最大地图的 256 倍,就都没问题!
仔细看的话,你会发现我们的 BSP 遍历同时也在做剔除:方便的是,.wad 中的每个节点也定义了其所有子节点的包围盒。如果我们能证明视锥体完全位于该包围盒之外,就不必考虑那棵子树用于渲染——这正是 visible_children.keep 所表示的含义。因此 bool_and(vc.keep) 会丢弃所有祖先节点不满足条件的子扇区。
管线中后续的一切都只是与 bsp_seq 做连接,这样只会考虑可见的子扇区,并且顺序正确。
墙壁与 Visplane
Doom 多少有点作弊,它看起来是 3D 的,但实际上是个 2.5D 游戏。本质上它只是一个平面,加上完全垂直的墙壁,天花板也始终与地面平行。这让渲染比真正的 3D 引擎容易得多:
- 绘制所有墙壁(如前所述,从前到后)
- 所有尚未绘制的部分,要么是地板,要么是天花板。把它们画上。
- 精灵(怪物、油桶、拾取物)是始终面向你的平面图像(想想纸板剪影),所以这里没有复杂的变换(除非它们与墙壁重叠,这个我们稍后再说)。
墙壁
一面墙占据一组连续的屏幕列,而在每一列内,它又是一段连续的像素。所以我们完全可以逐面绘制墙壁,按从前往后的顺序,通过 generate_series() 扩展行和列:
columns AS ( -- emit a row per screen column the wall w covers
  SELECT w.*, x AS col_x, ...
  FROM wall_parts_tex w
  CROSS JOIN LATERAL generate_series(
    GREATEST(0, FLOOR(w.screen_x1)::int),
    LEAST(screen_w - 1, CEIL(w.screen_x2)::int)) AS x
),
fragments AS ( -- one row per pixel the wall covers in this column
  SELECT c.col_x AS x, y, c.depth_x AS depth, c.u_i, c.v_i
  FROM clamped_spans c
  CROSS JOIN LATERAL generate_series(c.y_start, c.y_end) AS y
)
Doom 则用了两个循环:R_RenderSegLoop 负责取出屏幕列,R_DrawColumn 负责画像素。
渲染墙壁平均花了我们 1.7 ms。
Visplane
墙壁处理完了,接下来聊聊有趣的部分:地板和天花板,也就是 Doom 所说的 visplane。
可惜 Doom 的渲染算法很难照搬到 SQL 里,因为它高度命令式:Doom 维护两个数组 ceilingclip 和 floorclip,每个屏幕列对应一个条目。它们标记出每一列中仍然敞开的那一段(也就是还得变成地板或天花板、尚未绘制的部分)。每当画上一面新墙,它们就会被修改,直到每个像素都被填满。Doom 不只是修改它们,修改的顺序也至关重要。这招很巧妙!说到底它就是个洪水填充算法,但一切看起来都是 3D 的,几乎不花额外代价(当然,是在 C 里)。
SQLDoom 只能换个思路,因为 SQL 里没有循环,也没有可变状态。既然不能循环,我们就转向排序,再对排好序的连续段做聚合——穷人的循环!
这里迭代的对象叫面板:一面墙出现在屏幕某一列中的一部分。有些面板会画出东西:实心墙(solid)、门上方的那段墙(upper),或者窗户、女儿墙下方的那段墙(lower);有些面板的存在只是为了影响其他面板的渲染方式:如果你从阳台下方的门走出去,头顶上就有东西,而那东西总得在某处结束。
于是对每个屏幕列(col_x),我们都有一份从近到远排好序的面板列表。因此,一个面板之前的裁剪状态完全由它前面那一行决定。我是不是闻到窗口函数的味道了?
这事用文字讲实在费劲,还是看视频吧!你的浏览器不支持 video 标签。
用窗口函数确定 visplane 的位置
下面是(简化的)SQL 查询:
panel_clips AS (
  -- 1. the band as the NEARER panels left it
  SELECT p.*,
    COALESCE(MAX(CASE WHEN part IN ('solid','upper','upper_flush')
                      THEN y_bot::int + 1 END) OVER w, 0)            AS cc_before,
    COALESCE(MIN(CASE WHEN part IN ('solid','lower','lower_down')
                      THEN y_top::int - 1 END) OVER w, screen_h - 1) AS fc_before
  FROM panel_seq p
  WINDOW w AS (PARTITION BY col_x ORDER BY depth_x, bsp_seq, part, seg_id
               ROWS BETWEEN UNBOUNDED PRECEDING AND 1 PRECEDING)
),
plane_spans_raw AS (
  -- 2. whatever the band leaves uncovered is a ceiling above the wall...
  SELECT col_x, fsec AS sector_id, f_ceil AS plane_z, 'ceil' AS plane,
         cc_before         AS y0,   -- from where nearer walls stopped
         f_ceil_y::int - 1 AS y1    -- down to this panel's own ceiling
  FROM panel_clips
  WHERE part IN ('solid','upper','upper_open','upper_flush')
    AND f_ceil_y::int - 1 >= cc_before          -- nothing left open: skip
  UNION ALL
  -- ...and a floor below it
  SELECT col_x, fsec, f_floor, 'floor',
         f_floor_y::int AS y0,      -- from this panel's own floor
         fc_before      AS y1       -- down to where nearer walls stopped
  FROM panel_clips
  WHERE ...
)
我们首先为场景中每个可能渲染出像素的面板,计算该列还有多少尚未分配。而唯一已经可以被分配的像素来自所有更近的面板(也就是 (1) 中的 ROWS BETWEEN UNBOUNDED PRECEDING AND 1 PRECEDING 项)。然后我们从上一个面板的末尾画到下一个面板的开头(2)。天花板和地板都这么做。
把命令式算法伪装成基于集合的写法,挺 hack 的吧?还好我们有窗口函数……
渲染地板、天花板和天空通常大约花费 3 ms。
丑陋的部分
可惜,我之前骗了你:墙壁、visplane 和 sprite 的解析其实还什么都没画出来。它们只是产出形如 (x, y, depth, colour) 的候选,同一位置上可能有很多像素,但深度不同:因为我们没有实现 Doom 的定点运算,不同的墙壁、地板和天空可能会重叠。另外,我们还得渲染 sprite,而 sprite 又可能被墙壁部分遮挡。Doom 用一套编排得极其严密的流程保证这种情况永远不会发生,这样它们就不必做 z-buffering。我试着在 SQL 里复现这套编排,失败了,于是放弃,改用暴力方法:全部生成出来,然后挑出胜者。
((LEAST(depth, 131071.0) * 4096)::bigint << 34) -- depth, clamped to 17.12 fixed-point
| ((2 - surface_priority) << 32)                -- wall > sprite > plane
| (LEAST(source_priority, 3) << 30)
| ((stable_id + 32768) << 14)                   -- stable tiebreak
| (light_index << 8) | palette_index            -- the payload
AS winner_key
...
SELECT pix, MIN(winner_key) FROM ranked_fragments GROUP BY pix
这和 BSP 树用的是同一个技巧:把所有东西打包进一个 bigint,然后取 min:最高位是深度,所以只要取 min 就能找到胜者。而且由于载荷(也就是像素的颜色)也是键的一部分,我们甚至不用再 join 一次!看起来有点 hack,但既然这是逐像素的工作(而单个 Doom 帧有 320*200=64000 个像素),我们就得小心别做太多工作。
即便有这项优化,它仍然是整帧里最昂贵的部分:平均 8.2 毫秒,超过整帧的三分之一!这正是 John Carmack 当初避开它的原因。但我们运气好,如今的机器即使在 SQL 里跑这个也能达到 35 FPS 的目标。The future is now, old man!。
渲染性能
下面是渲染管线与 Doom 35 FPS 帧目标对比的瀑布图。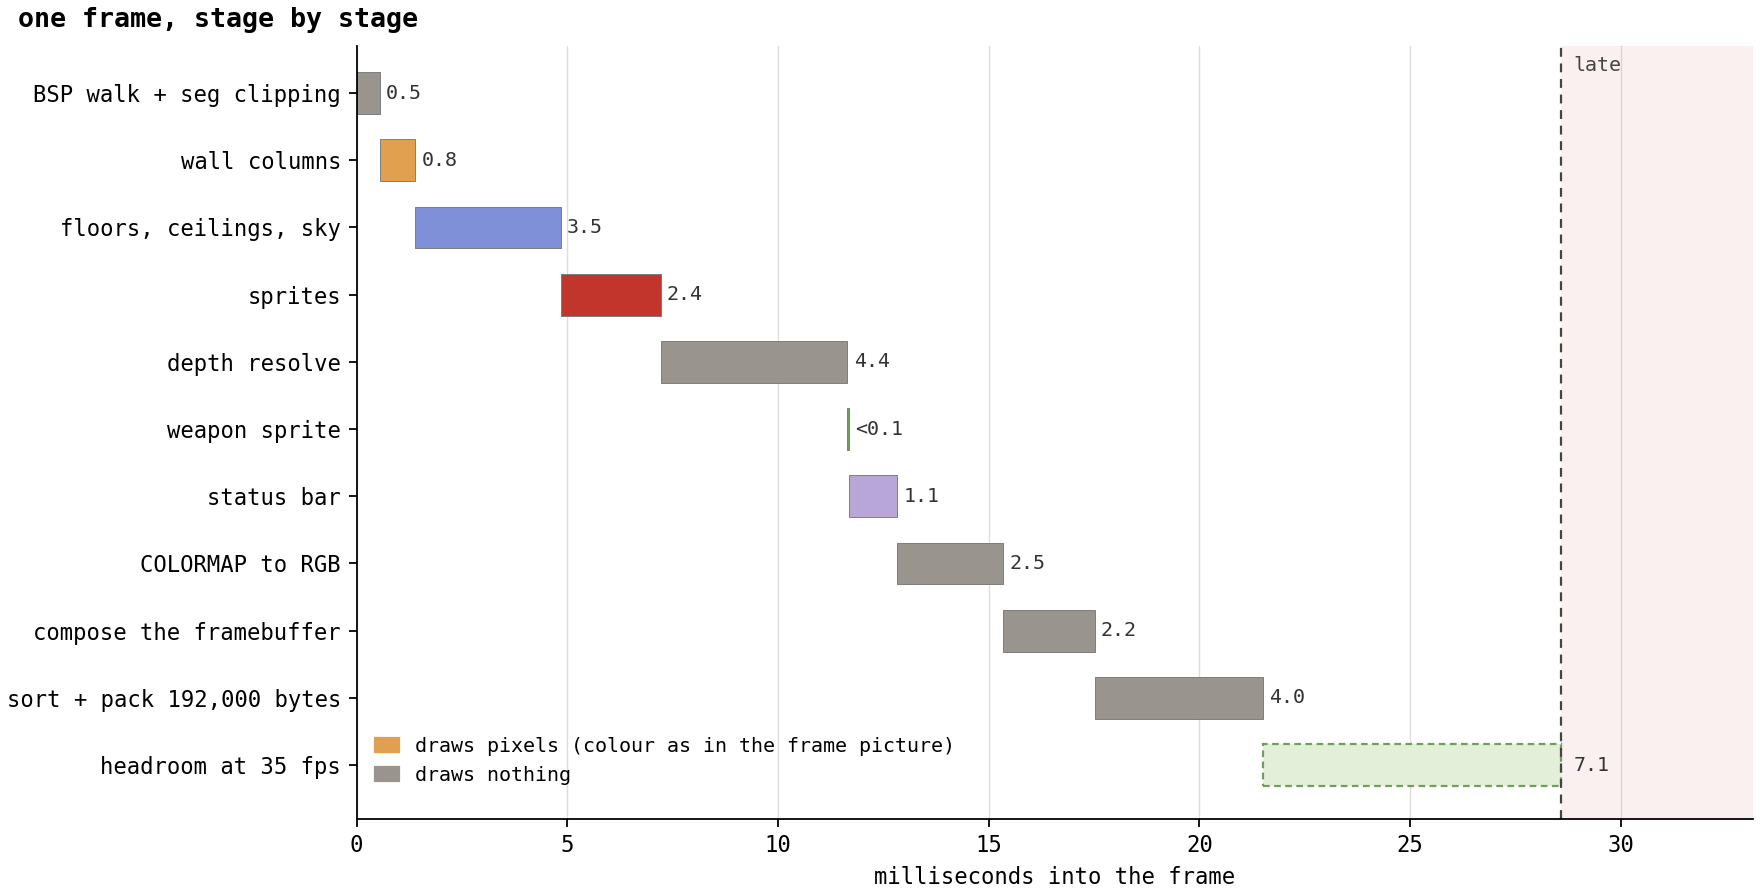
AMD Ryzen 7 7840U 上的渲染管线
在我的笔记本(Ryzen 7 PRO 7840U)上,通常能跑到 60 FPS 左右,但场景一复杂就会掉到 35 FPS。
管线里开销最大的部分(毫不意外)是:
- 渲染 visplane(这里得模拟一个迭代算法),
- 深度解析(原版 Doom 从一开始就成功避开了这一步),
- 以及所有逐像素要做的事(比如查 colormap、打包 framebuffer)。
什么时候用数据库确实是个好主意
在数据库里渲染 Doom 显然是个烂主意。但确实有几个地方它挺合适,我要为它们辩护到底!
一切都是数据
我之前没想到,把物品的各种属性转换成关系型数据集会这么有意思。一方面,这样能很直观地看到你的游戏里到底有什么;但最重要的是,改起来也非常容易。
玩家的霰弹枪就是一行:
doom=# SELECT name, ammo_type, ammo_per_shot, pellet_count,
doom-#        dmg_dice_count, dmg_dice_mult, max_range
doom-#   FROM weapon_defs WHERE name = 'shotgun';
  name   | ammo_type | ammo_per_shot | pellet_count | dmg_dice_count | dmg_dice_mult | max_range
---------+-----------+---------------+--------------+----------------+---------------+-----------
 shotgun | shells    |             1 |            7 |              3 |             5 |      2048
(1 row)
七颗弹丸,每颗造成 3d5 点伤害。
连动画都是数据!下面是霰弹枪完整的状态机:
doom=# SELECT state, seq_index AS seq, frame, tics,
doom-#        is_attack_frame AS shoots, refire_check AS refire
doom-#   FROM weapon_frames WHERE weapon_id = 3 ORDER BY state, seq_index;
 state | seq | frame | tics | shoots | refire
-------+-----+-------+------+--------+--------
 ready |   0 | A     |    1 | f      | f
 fire  |   0 | A     |    3 | f      | f
 fire  |   1 | A     |    7 | t      | f
 fire  |   2 | B     |    5 | f      | f
 fire  |   3 | C     |    5 | f      | f
 fire  |   4 | D     |    4 | f      | f
 fire  |   5 | C     |    5 | f      | f
 fire  |   6 | B     |    5 | f      | f
 fire  |   7 | A     |    3 | f      | t
 fire  |   8 | A     |    7 | f      | f
 flash |   0 | A     |    4 | f      | f
 flash |   1 | B     |    3 | f      | f
(12 rows)
把物品属性直接存进表里,也让所有东西都变得非常好 mod。看看下面这段:我正郁闷伤害不够,于是直接把霰弹枪改成一次打 500 颗弹丸,散布也调大!
Chea...Mod 霰弹枪
当然,我们本来也可以把一切都存成文件,比如 JSON,但那样意味着
- 修改时不会校验约束条件,
- 改动必须重新加载才能生效。
多人游戏几乎是白送的
好吧,我们费了这么大劲把 Doom 移植到 SQL 上,却还没用上数据库最大的优势:多人服务器是白送的!听我说,传统游戏开发者得自己搭的一大堆东西,我们全都是白拿的:
- 身份验证
- 并发控制
- 访问控制
- 游戏状态的一致性快照
- 二进制线协议
一个独立的 Python referee 脚本驱动共享的 35 Hz 时钟并轮换地图。在线玩家的客户端负责提供输入。
不过我最喜欢的部分是原子性:每当我们运行一个游戏 tic,只需说 begin transaction,最后再 commit。每个玩家(Doom 死亡竞赛最多支持 4 人)看到的仍然是一致的视图,要么是 tic 事务开始之前的世界,要么是它完全提交之后的世界。不会出现部分应用的更新、物理 bug,也不会为火箭到底有没有命中而争吵。
第二个出乎意料地优雅的部分是访问控制。sqldoom 本身有大约 110 张表和刚过 100 个函数,但四种玩家角色只被允许通过少数几个定义良好的 API 函数与之交互。其余一切,我们直接撤销访问权限!
接收玩家输入的 input 函数就是个好例子:
CREATE OR REPLACE FUNCTION api_input(
  p_fwd real, p_strafe real, p_run boolean, p_turn real,
  p_fire boolean, p_weapon integer, p_use boolean) RETURNS integer
LANGUAGE cedarscript SECURITY DEFINER AS $doom$
INSERT INTO mp_inputs
SELECT mp.map_id, mp.player_thing_id,
       LEAST(1.0, GREATEST(-1.0, COALESCE(p_fwd, 0)))::real,
       LEAST(1.0, GREATEST(-1.0, COALESCE(p_strafe, 0)))::real,
       [...]
FROM mp_players mp WHERE mp.role_name = session_user::text;
return 1;
$doom$;
虽然这个函数被允许修改表(security definer),但玩家只被允许调用这个函数。他们能控制的只有:前进动量(w/s 是否按下?)、平移(a/d 是否按下?)、是否在奔跑?、是否用鼠标转向?、开火键是否按下?、选中了哪把武器?、以及是否尝试按按钮/开门(spacebar)?我们甚至不需要信任玩家输入的数值:函数会把输入钳制到允许的范围内。
多人性能也好得出奇:每个客户端 3 个核心就能稳定 35 FPS,游戏 tic 也仍然远低于预算。再给 tic 驱动加一个核心,一台 16 核机器就足以跑一场原版 -altdeath doom 死亡竞赛。
公共实例会轮换 Episode 1 的地图,每 10 分钟换一张新图。就算四个位置全被占满,你仍然可以从 SQL 控制台查询正在进行的比赛。来玩,或者查询正在进行的比赛 →
附赠:编译 SQL
用 C++ 写的数据库解释执行 SQL,肯定慢得离谱,根本没法跟 C 比吧?大概不是,但我想评估一下到底差多远。
CedarDB 是一个编译型数据库系统:每条复杂查询都会(经过多个步骤)下沉为 LLVM IR,再编译成机器码。于是我问自己:这样生成的机器码,和最初编译出来的 linux_doom C 代码到底差在哪?
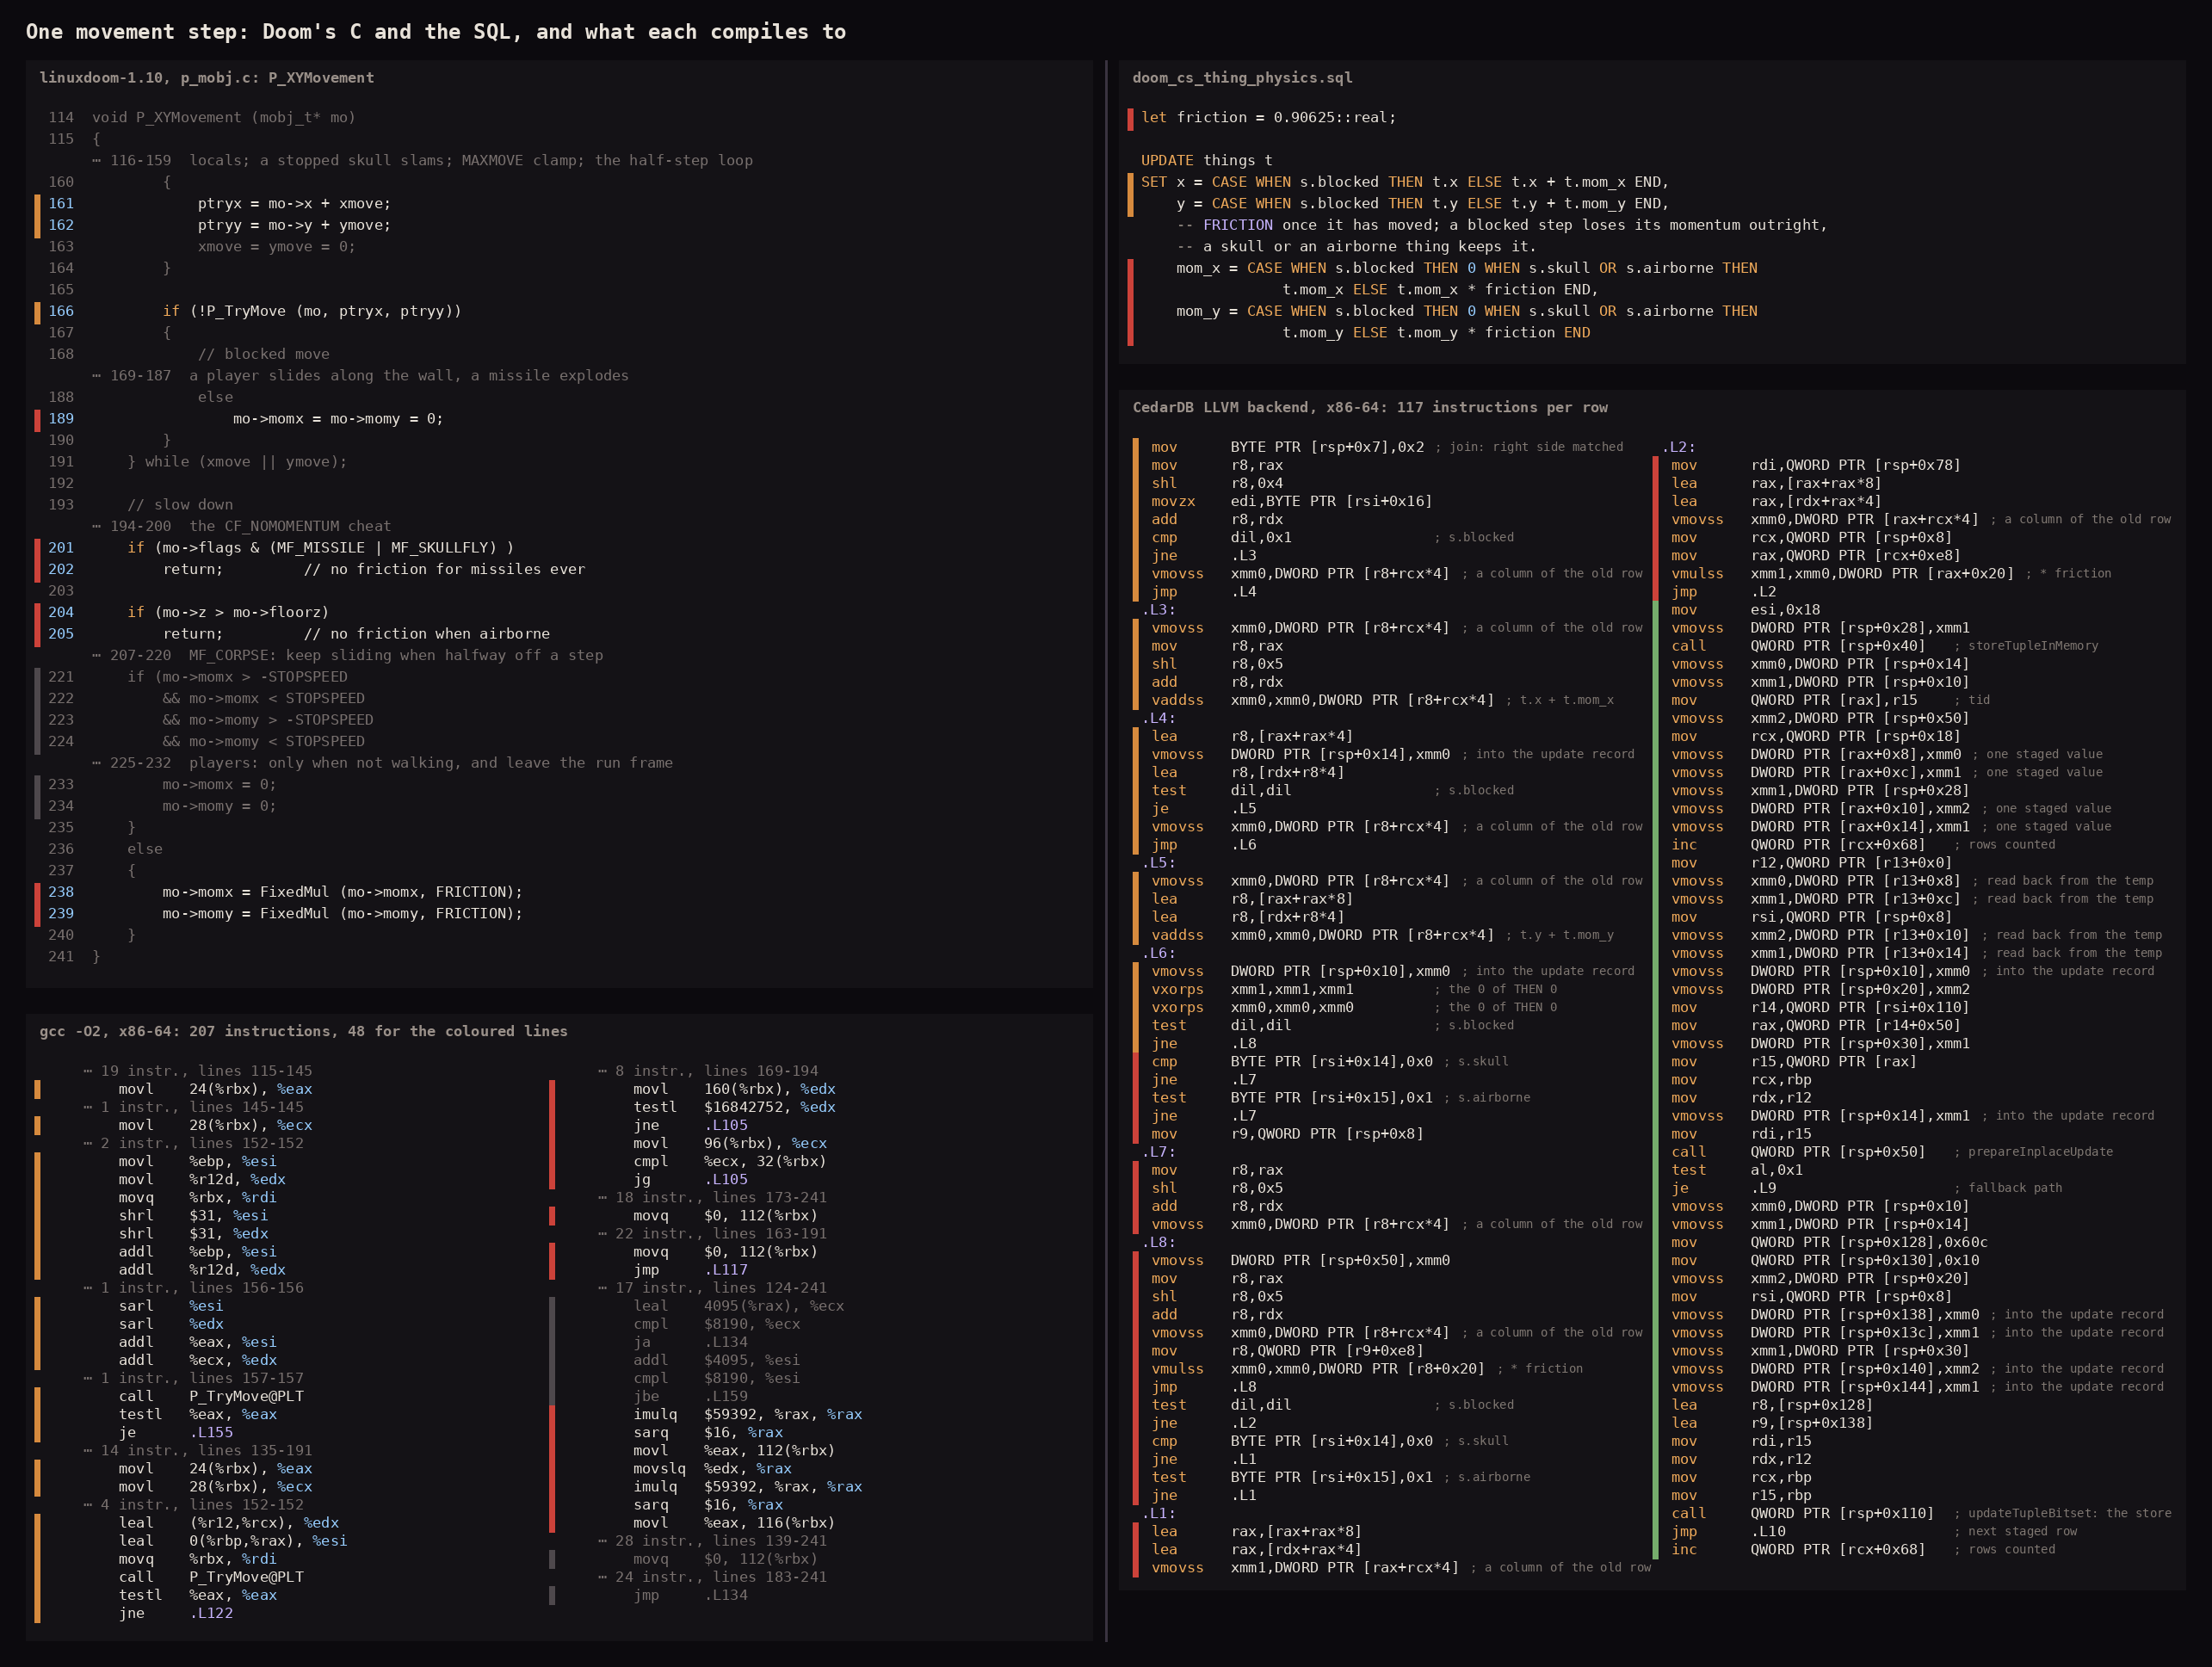
编译后的 linux_doom 与 SQLDoom 对比
上半部分是物体的运动逻辑,以及动量如何影响它。左边是 doom 的原始源码,右边是 SQLDoom 的实现。两者并非一一对应,因为逻辑的拆分方式略有不同,但 C 代码编译出 48 条指令,SQLDoom 则是 117 条。多出来的指令里有 42 条其实是在把结果重新写回表(绿线部分),C 显然不需要做这件事。所以它确实更差,别误会,但考虑到 SQL 和 CPU 之间通常隔着多少层抽象,它并没有差那么多。对一个从 SQL 起步、先经过查询优化器才到 LLVM 的东西来说,这个差距小得出乎我的意料。
John Carmack 是个天才。
我是说,把 SQLDoom 和它那个类 Wolfenstein 3D 的前身 DOOMQL 比一比。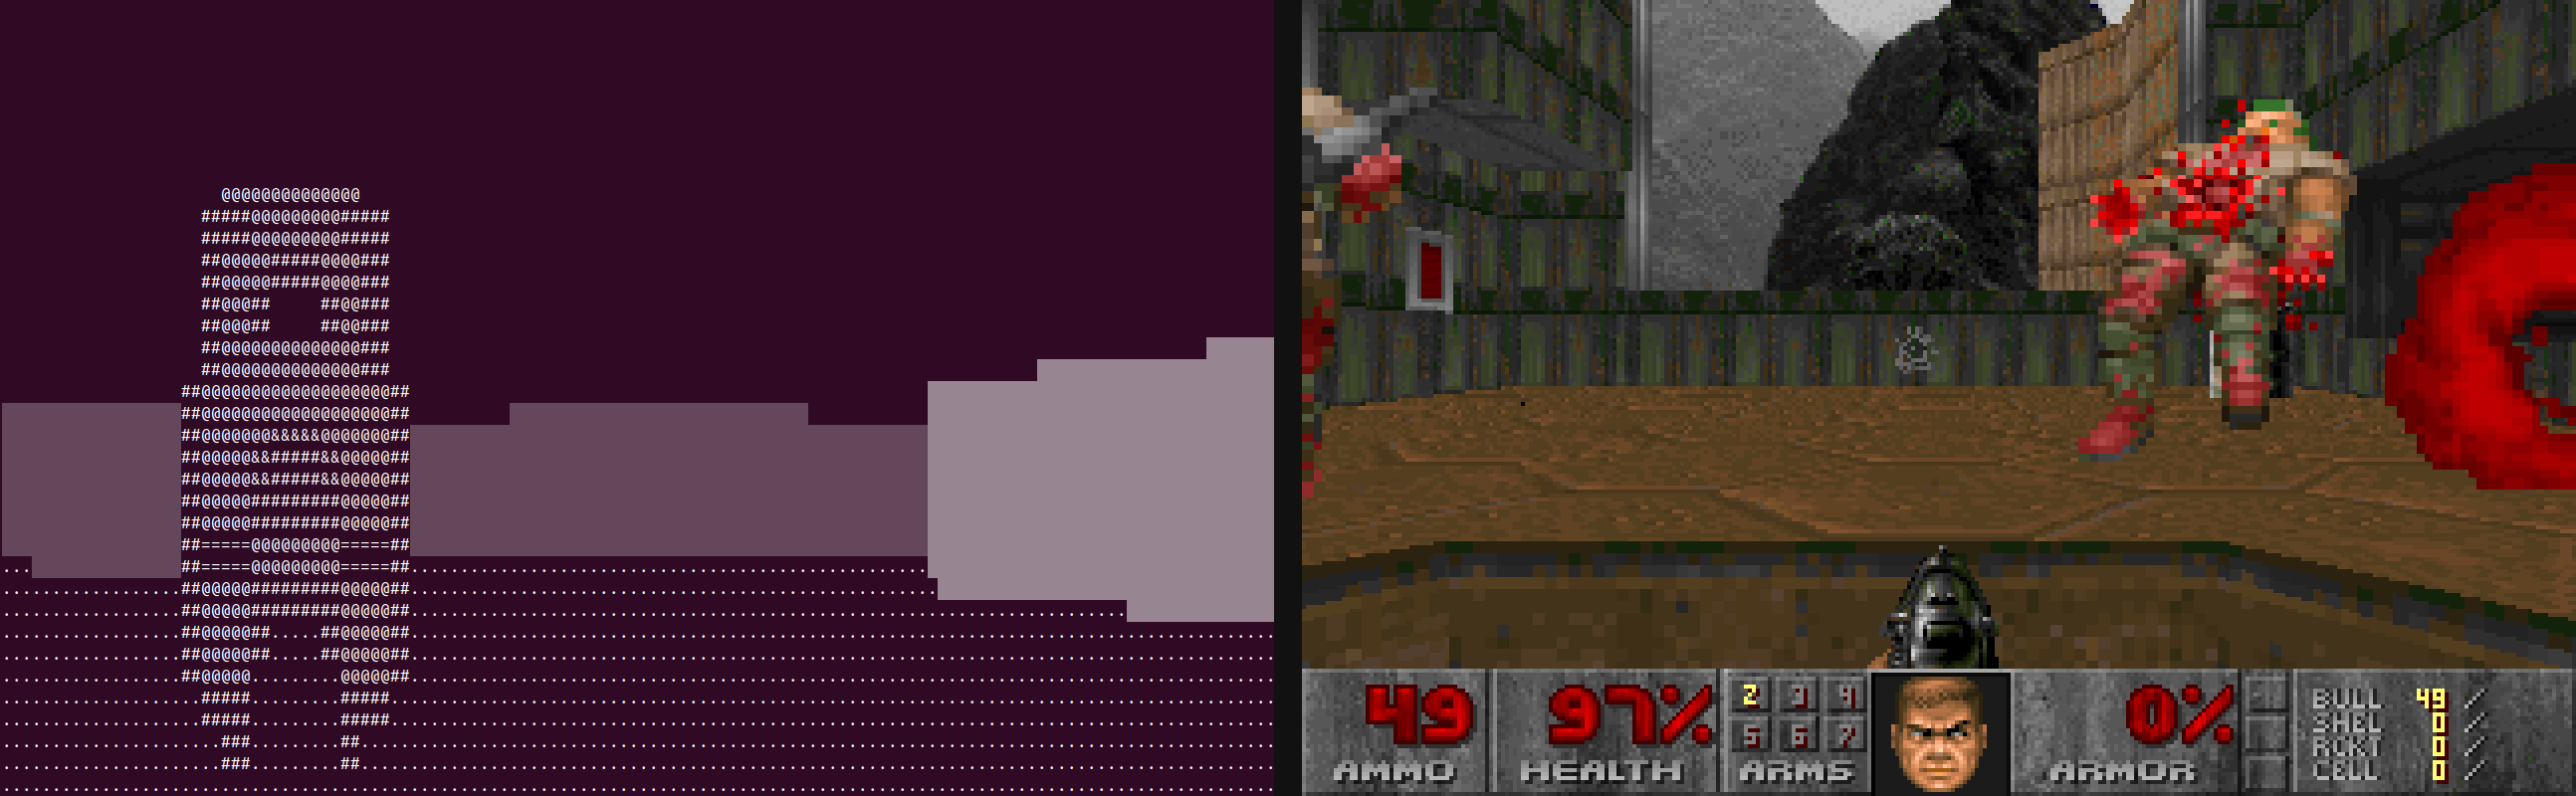
DOOMQL 与 SQLDoom 对比
两者用的是同一个引擎,约束也一样:输入 SQL,输出位图。别误会,DOOMQL 那种原始的射线投射思路很棒——用 SQL 表达容易得多,步骤之间的依赖也少——更契合 SQL 基于集合的处理方式。
但事实证明,“最契合”并不总是结果最好的那个。SQLDoom 的 BSP 树方案要快得多,同时画面保真度也高得多。这一切都因为 John Carmack 认真琢磨过,靠一点障眼法能从 486 上榨出多少东西。
而且说实话,CedarDB 也追上来了。我做 DOOMQL 那会儿,引擎还慢不少,我们也还没有基于角色的访问系统。
如何自己运行
代码在 GitHub 上:github.com/cedardb/sqldoom。
你需要三样东西:
- CedarDB Community Edition,
- 装有
psycopg2和pygame的 Python, - 以及一个 Doom IWAD,这个我没法提供。共享版 doom1.wad 可以自由再分发(
apt install doom-wad-shareware),玩第一章足够了;零售版 WAD 只要你有,也能用。
接下来照着 README 走,很快就能跑起你自己的 SQLDoom!
或者,如果你嫌这些太麻烦,直接进公共实例开一局: