WorldTUI:360Mモデルを訓練してターミナルのふりをさせた
Simon Edwardsson は 360M パラメータのモデルを微調整し、シェルなしでキー入力ごとにターミナル画面の内容を予測した。並列デコードにより、完全な再描画が 6.7 秒から 0.87 秒に短縮され、システム全体は現在 208 MB でブラウザタブ内で動作している。
日本語
コピー
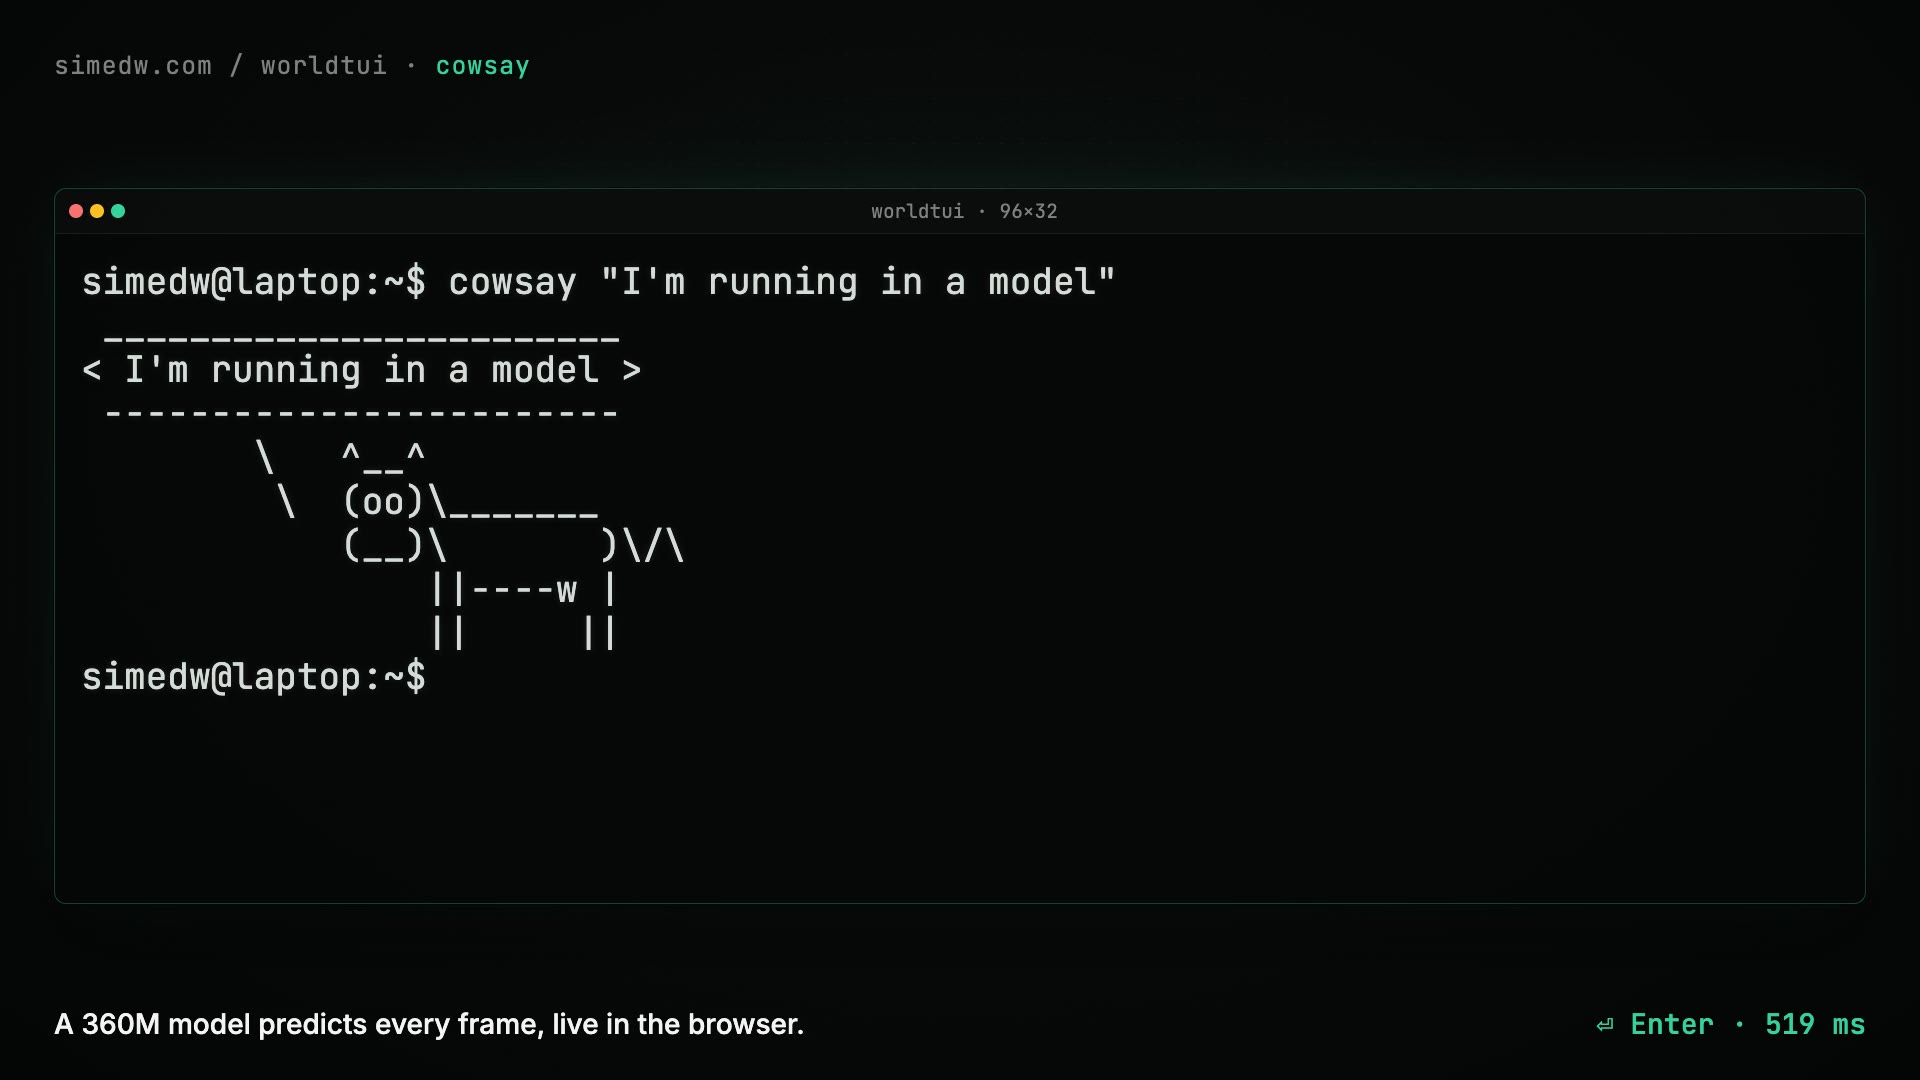
TL;DR: 360M パラメータの言語モデルをファインチューニングして、ターミナルとして動かしてみた。裏側にシェルもファイルシステムもない。キー入力を渡すと、モデルが画面の変化を予測する。ファイルを作れたり、vim や tmux を動かせたり、スネークゲームで遊べたりして、数コマンド前に何を打ったかもたいてい覚えている。効果が大きかったのは、自分のミスを直す方法を教えたことと、画面の各行を並列デコードしたことの 2 つだ。ブラウザで試す(208 MB)。pythoon と入力すれば、本物のシェルではないことがわかる。
このデモは WebGPU に対応した、物理キーボードを備えたデスクトップブラウザ向けに作っている。Chrome か Edge で試すのがいい。最新のスマートフォンでも動くはずだが、遅くて耐えられないだろう。
去年 Genie 3 を初めて見たとき、アプリは書くものではなく学ぶものになる未来を想像し始めた。シーンを描くのはゲームエンジンではなく、モデルがユーザー入力から次のフレームの最もありそうな姿を予測する。
当然、自分用のワールドモデルを訓練したくなった。だが大規模な GPU クラスタも、山のような動画データもない。そこで野心を少しだけ小さくして、ゲームの世界ではなくターミナルを作ることにした。
ターミナルは都合がいい。ピクセルではなく文字のマス目でできていて、本物の shell を動かせるので、完全にラベル付けされた訓練データをいくらでも生成できる。事前学習済みの言語モデルは、ls や cat が何を出力すべきか、およそ知っている。
本当に知りたかったのは、一貫した世界を維持できるのか、それともそれらしいターミナル出力を生成するだけなのか、ということだ。
最終的なモデルは Qwen2.5-Coder-0.5B をベースに、Docker 内で実際のプログラムを動かして録画したターミナルセッションでファインチューニングした。サンプル動画へ
モデルから見たターミナル
標準的な LLM は prompt を受け取り、末尾に token を一つずつ追加していく。この方式はターミナルには合わない。キー入力そのものが動作を引き起こすことがある(vim の esc など)。出力も常に下へ向かうとは限らない。clear は画面を消してカーソルを先頭に戻す。だから予測すべきはテキストの並びではなく、画面の変化だ。
ターミナルを文字のグリッドとして扱い、各セルに一文字を置く。1 モデルはこのグリッドを直接見るのではなく、グリッドの内容とその変化を記述した token 列を見る。
セッション
各セッションはスナップショットから始まる。画面サイズ、画面内容、カーソル位置だ。
サイズは入力の一部であり、32×96 に固定されているわけではない。デモでは、カスタムの開始画面を作るときに行数と列数を自分で設定できる。
BOS SCREEN_START 32 96
ROW_0 0 'simedw@laptop:~$ '
CURSOR 0 17 1
SCREEN_END
これのおかげで、アプリの途中から始めることもできる。bash のプロンプト、vim のバッファ、あるいはスネークゲームの途中を渡すと、モデルはそこから続けようとする。(bash から始めるのが一番うまくいく。)
その後、各キー入力は本物のターミナルが送る生のバイト列として入力される。文字はそのままの文字、Enter は \r、Escape は 0x1b、← は ESC [ D、といった具合だ。
INPUT_START 'l' INPUT_ENDモデルはどの行を書き換えるか、そしてカーソルが最終的にどこに落ちるかを答える。
OUTPUT_START
ROW_0 17 'l'
CURSOR 0 18 1
OUTPUT_END
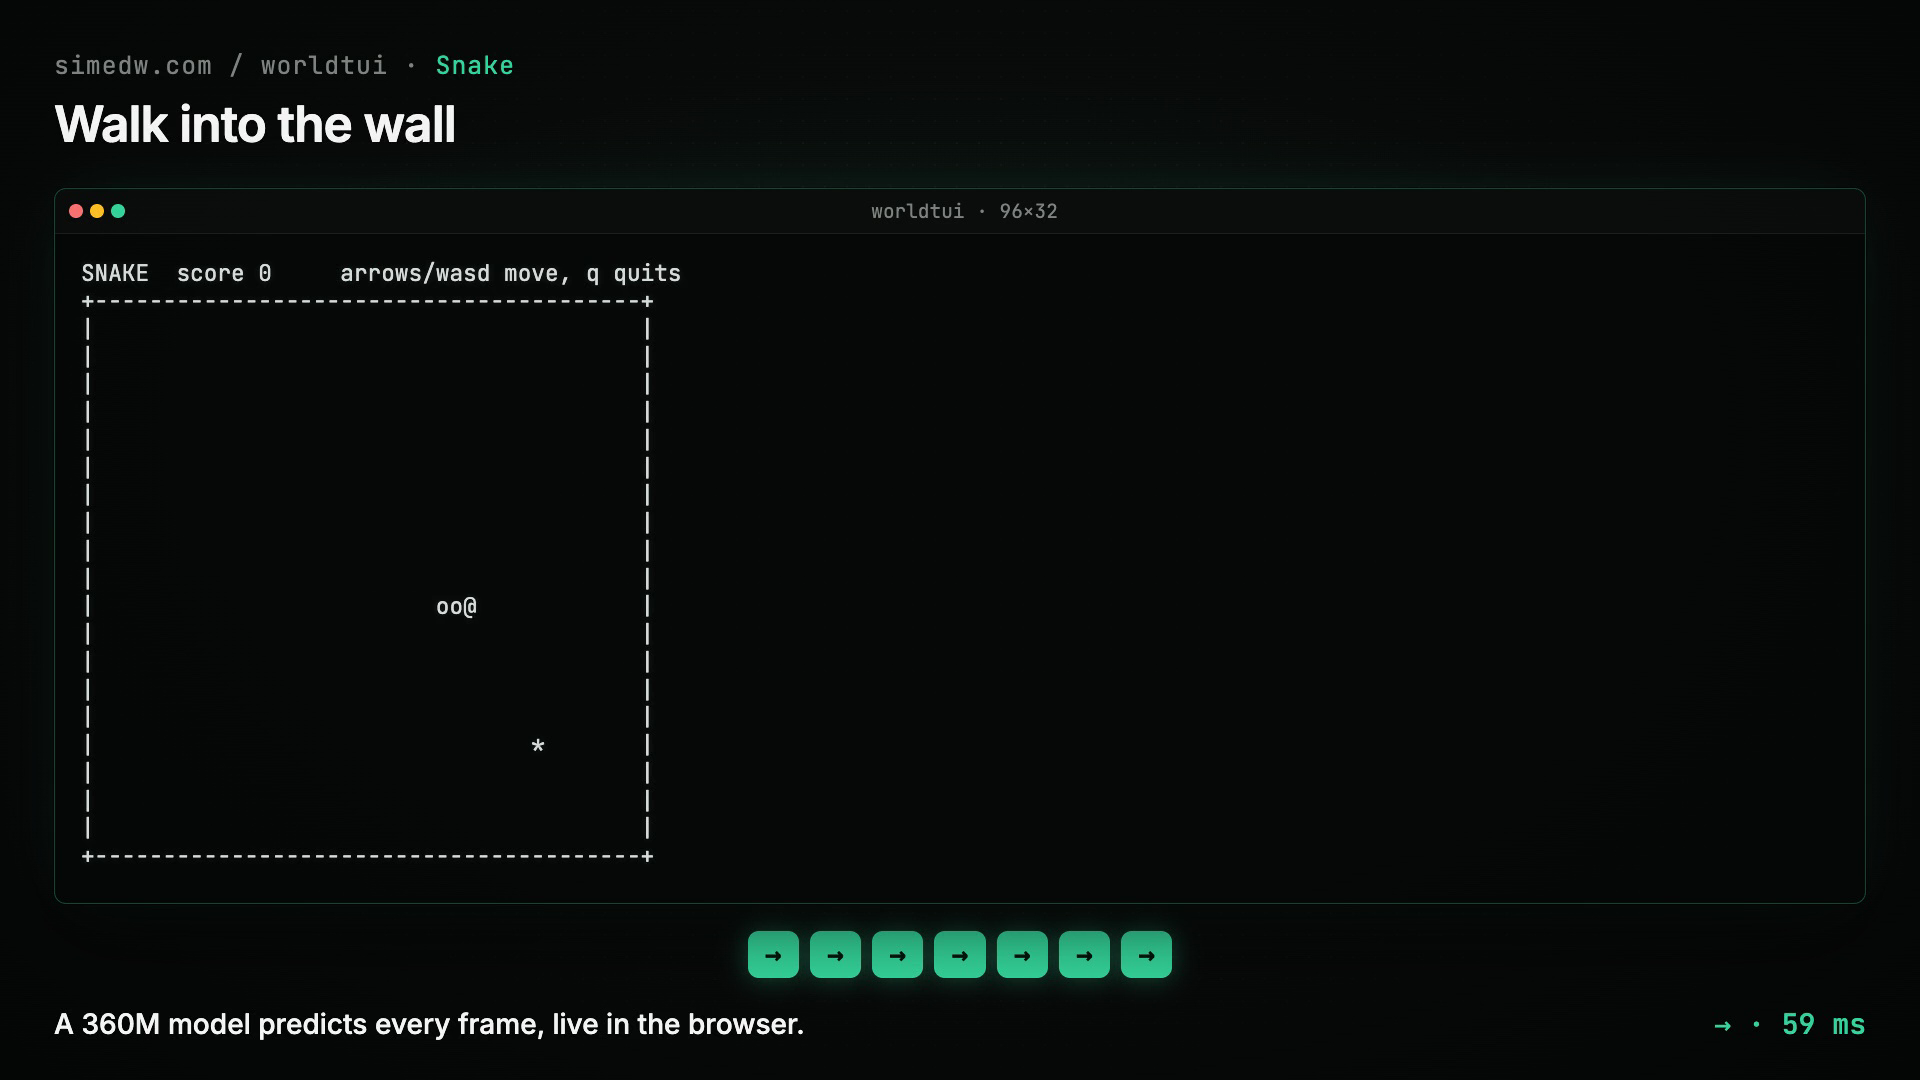
言葉にすれば、行 0 の列 17 から l を書き込み、カーソルを行 0 の列 18 へ移動する。末尾の 1 はカーソルが可視であることを示す。全画面アプリはカーソルを隠すことがあるからだ。
事前の画面クリアはない。新しい文字は古い文字の上に直接描かれる。
文字に新しい token は要らない。Qwen にはもともと 256 個のバイト値すべてをカバーする token があり、それを文字、座標、その他の小さな数値に再利用した。だから 17 のような座標は 2 token ではなく 1 token で済む。
時間も入力の一種だ。何も押されなければ、モデルはキー入力ではなく、長さを持つ WAIT token を受け取る。スネークがひとりでに動くのはこの仕組みだ。
行のコピー
ターミナルウィンドウの下端で Enter を押すと、各行は一つ上へずれる。モデルに各行を新しい位置へ出力し直させることもできるが、キー入力一回でおよそ 3,000 token を消費してしまう。
そこで COPY 操作を追加した。
ROW_0 COPY 1
ROW_1 COPY 2
ROW_2 COPY 3
...
各操作は前の画面から一行をコピーする。この例では、元の行 1 が行 0 に、行 2 が行 1 になり、以下同様だ。
これでスクロールは一行あたり 3 token で済み、およそ 96 token は要らなくなった。
同じ仕組みが画面クリア、vim での行の挿入と削除、man ページの閲覧もカバーする。一行をコピーしてからその一部を上書きすることもできる。
モデルが使う語彙は合計 333 token のごく小さなものだ。256 個のバイト token、64 個の行 token、それに少数の特殊操作。デコードは文法で制約されるので、すべての予測が合法な画面更新になる。
この小さな語彙は後でまた役に立つ。モデルをブラウザに詰め込むときだ。
訓練データの生成
まず既存のターミナル録画データセットを探した。asciinema も含めてだが、キー入力と画面が正確に対応している、必要な種類のものは見つからなかった。
幸い、自分で作るのはそれほど難しくなかった。
基本的な考え方は、Docker コンテナ内で実際のコマンドを動かし、キー入力のたびにその後の画面内容を記録して、もっともらしいターミナルセッションを生成するというものだ。
合成データのレシピはこうだ。
- ユーザー名、ホスト名、プロンプトのスタイル、ターミナルサイズをランダム化する。
- 架空のペルソナ(開発者、システム管理者など)に応じてディレクトリとファイルをランダム化する。
- 重み付きの活動(ファイル編集、vim、python、tmux など)を 6〜24 個選ぶ。
- 状態を追跡し、セッションで開かれるファイルがほとんど実在するようにする。
- 人間のようにタイプする。一文字ずつ、tab 補完なども使う。誤字率は 1.2% に設定した。自分としては甘い方だ。
- 35% のセッションを途中から始め、モデルに任意の状態から続けることを学ばせる。
ターミナルサイズは主に 32×96 で、一部 24×80 と 40×120 も混ぜ、モデルが特定のサイズに過学習しないようにした。
モデルの能力が上がるにつれてデータセットを拡張し、最終的に 336k episode、およそ 2B token 相当になった。比較すると、ベースモデルは訓練で約 18T token を見ている。
訓練
出発点は Qwen2.5-Coder-0.5B。ほぼリアルタイムの性能に近づけるには、小さなモデルが必要だった。もともとコードモデルであり、CLI の使われ方も大量に見てきている。
まずは普通の教師ありファインチューニングから始めた。画面履歴とキー入力を与え、実際のターミナルが生み出す画面変化を予測させる。
普通のタイピングはすぐに覚えた。文字が出て、バックスペースで消え、カーソルが動く。
しかし長いセッションでは誤りが積み上がる。ファイル名を一度打ち間違えると、その後のセッション全体に響く。
自分の誤りから学ぶ
これを解決するために DAgger の考え方を借りた。理想的な模範だけから学ぶのではなく、モデルが実際に到達した状態から学ばせる。2
各訓練サンプルについて:
- 録画したセッションの中から、たいていは出力を生むコマンドの近くの点を選ぶ。
- モデルに次の 1〜4 個のイベントを予測させる。
- 得られた画面を、録画した実際の画面と比較する。
- 差分が十分小さければ、次のキー入力の時点でモデルの画面を修復する修正を構成する。
- 修正後の画面と、その後の実際のイベント数個で訓練を続ける。
この差分が、モデルの誤った画面を正しい次の画面へ運ぶ。要するに、自分の誤りを「修復」することを学ぶわけだ。
重要な制約が一つある。モデルは修正内容を推論するのに十分な情報を持っていなければならない。修正で導入する語はすべて、それ以前に実際に現れた画面かユーザーの入力に含まれている必要があり、モデル自身の予測だけに由来してはならない。
たとえば、以前に現れたファイル名をモデルが打ち間違えたなら、それを直すよう教えられる。だが、一度も見たことのないファイル名を挙げた場合、正しく書けることを期待してはいけない。
こうしたサンプルで訓練するのは、実質的にハルシネーションに報酬を与えていることになる。ハルシネーションはこれ以上必要ない。
サンプリングしたセッションのうち約 3 分の 1 が有用な修正サンプルを生んだ。このプロセスを 3 巡繰り返し、各巡で最新のモデルから誤りを集めた。
自己修正は、訓練上の変更の中でも効果が大きいものの一つだった。追加の訓練データも加わり、PresetBench(定義は後述)の int4 での成績は 24/47 から 38/47 に上がった。
トータルで、モデルの訓練とその後の改善に RTX 4090 でおよそ 75 GPU 時間を費やした。
テスト
テストは 3 つ使った。ShellBench は手書きの bash セッション 24 個からなる 106 コマンドで、出力が完全一致するかで採点する。PresetBench はデモ中に出会った失敗を集めた 47 個のスクリプト化されたケースだ。どちらも訓練データには含まれていない。
記憶テストは 32 個の世界からなる。各世界は 2 つのランダムな値を 2 つのファイルに書き込み、別々のセッションで読み戻す。両方の読み戻しが完全一致して初めてその世界は合格となるので、読み戻しは合計 64 回。名前も値も訓練には一切現れない。3
ファインチューニングはどれだけ効くのか?
| モデル4 | ShellBench /106 | ファイル読み戻し /13 |
|---|---|---|
| Qwen2.5-Coder-0.5B、prompted | 52 | 2 |
| Qwen3-0.6B、prompted | 60 | 3 |
| WorldTUI | 80 | 9 |
差が最も大きいのは記憶だ。WorldTUI は 9/13 を読み戻したが、prompted の 2 モデルはそれぞれ 2/13 と 3/13 だった。
信頼できるファイルシステムにはほど遠い。見慣れたコマンドならかなりうまく扱うが、それらを新しい組み合わせ方で使うとすぐに破綻する。たとえば echo green >> colors を実行した後に cat colors を走らせても、追記された行が見えないことがよくある。
高速化する
しばらくの間、自己回帰モデルは完全に避けていた。全画面の再描画にはおよそ 3000 トークンかかる。それを 1 トークンずつ生成するのは、ターミナルのように即座に反応すべきものとしては、どう考えても無理筋だった。
だが、試した他のどの方式よりもはるかにうまく動いたので、折り合いをつけるしかなかった。トークンを 1 個ずつ生成する場合、タイピングは悪くない。1 キーあたり約 38 ms だ。ところが画面全体の再描画を要する操作(vim test.txt、man、clear)は、心配していたとおり、RTX 4090 で 12 秒かかる。このマニュアルを書くべきかどうか、じっくり考え直せるだけの時間だ。しかも Mac 上でほぼリアルタイムに動かしたい。
行を並列に処理する
見落としていたのは、1 フレームのほとんどの行は互いに依存していないということだ。だから 1 行ずつ順番に生成する理由はない。各行に batch の要素を 1 つ割り当てた。各要素は同じ履歴(KV cache を含む)を受け取るが、生成するのは自分の行の更新だけだ。
これでデコードのコストは、全行の合計(最大 3000 ステップ)から、最も長い 1 行の長さ(およそ 100 ステップ)に変わる。
カーソルは最後の独立した 1 ステップとなり、全行の更新を見られる。
これには訓練時に対応する attention mask が必要だが、得られる速度向上には見合う。大きなフレームの p95 レイテンシは 6.7 秒から 0.87 秒に下がった。
| デコード方式 | 大フレーム p95 レイテンシ、RTX 4090 |
|---|---|
| 直列 | 6.7 秒 |
| 行の並列化 | 0.87 秒 |
行同士は通信できない
話がうますぎると思ったら、そのとおりだった。行が互いに独立しているということは、足並みを揃えられないということでもある。その結果、vim が 0 行目ではなく 3 行目で開いたり、複数の行が同時に snake に餌を与えたりする。
答えは投機的デコーディングだ。
通常、投機的デコーディングでは小さなモデルがトークンを起草し、大きなモデルが検証する。causal attention のおかげで、1 回のフォワードパスで複数のトークンを検証できる。
ここでは同じモデルに両方の役割を兼ねさせた。並列に走る各行がまず草稿を出し、モデルがそれを順番に検証する。
検証器は最初の食い違いが起きる直前までのトークンを残す。そこから先は自分で修正を生成し、残りの草稿を出し直す。
この M4 Mac のブラウザでは、1 文字の入力に約 60 ms かかる。man test のような大きな更新だと、直列実行では 2.5 秒かかるが、並列起草と検証なら 0.9 秒で済む。5
小さくする
出発点は Qwen2.5-Coder-0.5B で、パラメータは約 494M。ウェブのデモを作りたかったので、小さくする必要があった。151,936 語の語彙に対応する埋め込みテーブルだけで 136M パラメータを占めている。必要なのは自分用の 333 トークンだけなので6、テーブルはほぼ丸ごと捨てられる。パラメータは 494M から約 360M に減った(990 MB → 716 MB)。
次に int4 へ量子化して、208 MB まで落とした。
ブラウザのデモは Qwen デコーダを独自の JavaScript で実装し、計算シェーダは WGSL で書いて WebGPU で動かしている。シェーダは推論時に 4-bit の重みを展開する。活性値とアテンションキャッシュは 32 ビット浮動小数点。推論はすべてタブの中でローカルに走る。
蒸留
より少ない層に蒸留してみると、記憶がどの層に依存しているかが見えてきた。教師モデルは以前のチェックポイントで、ShellBench のスコアは 78/106。第 7 層だけを取り除き、再学習なしでも、次トークンの正解率はほとんど変わらなかった。99.3%から 98.9%への低下だ。ところが正確な記憶の読み戻しは 64/64 から 0/64 に落ちた。テストへの入力は実際の履歴なので、この失敗はモデル自身の出力による誤差の蓄積ではない。
最初に蒸留した生徒モデルは偶数層をすべて残したが、最後の層に第 22 層ではなく第 23 層を使っていた。それでもそれらしいターミナル出力は書けたが、64 回の記憶の読み戻しのうち正しい値を返したのは 31 回だけ。書き残した 2 つの値のどちらかは必ず出力するのだが、およそ半分の確率で間違える。ランダムと同じ水準で、480M トークン訓練しても回復しなかった。
その生徒モデルからは第 1、7、15、22 層を取り除いた。この 4 層を残した 16 層の生徒モデルは、記憶テストの 32 ワールドすべてに合格し、読み戻しは 64/64 で正確だった。4-bit で約 138 MB でも、32 ワールドすべてに合格する。ただし他の場所に代償がある。ShellBench で正解したコマンドは 65 で、教師モデルは 78 だった。生徒モデルは問題なさそうに見えても、自分の記憶を静かに失っていることがある。
結局、蒸留は諦めた。
何ができるか
記憶
ここが一番面白い。それらしいディレクトリ一覧を出すのは難しくない。欲しいのは、ファイルを作り、編集し、しばらく離れて戻ってきたとき、それがそのまま残っていることだ。
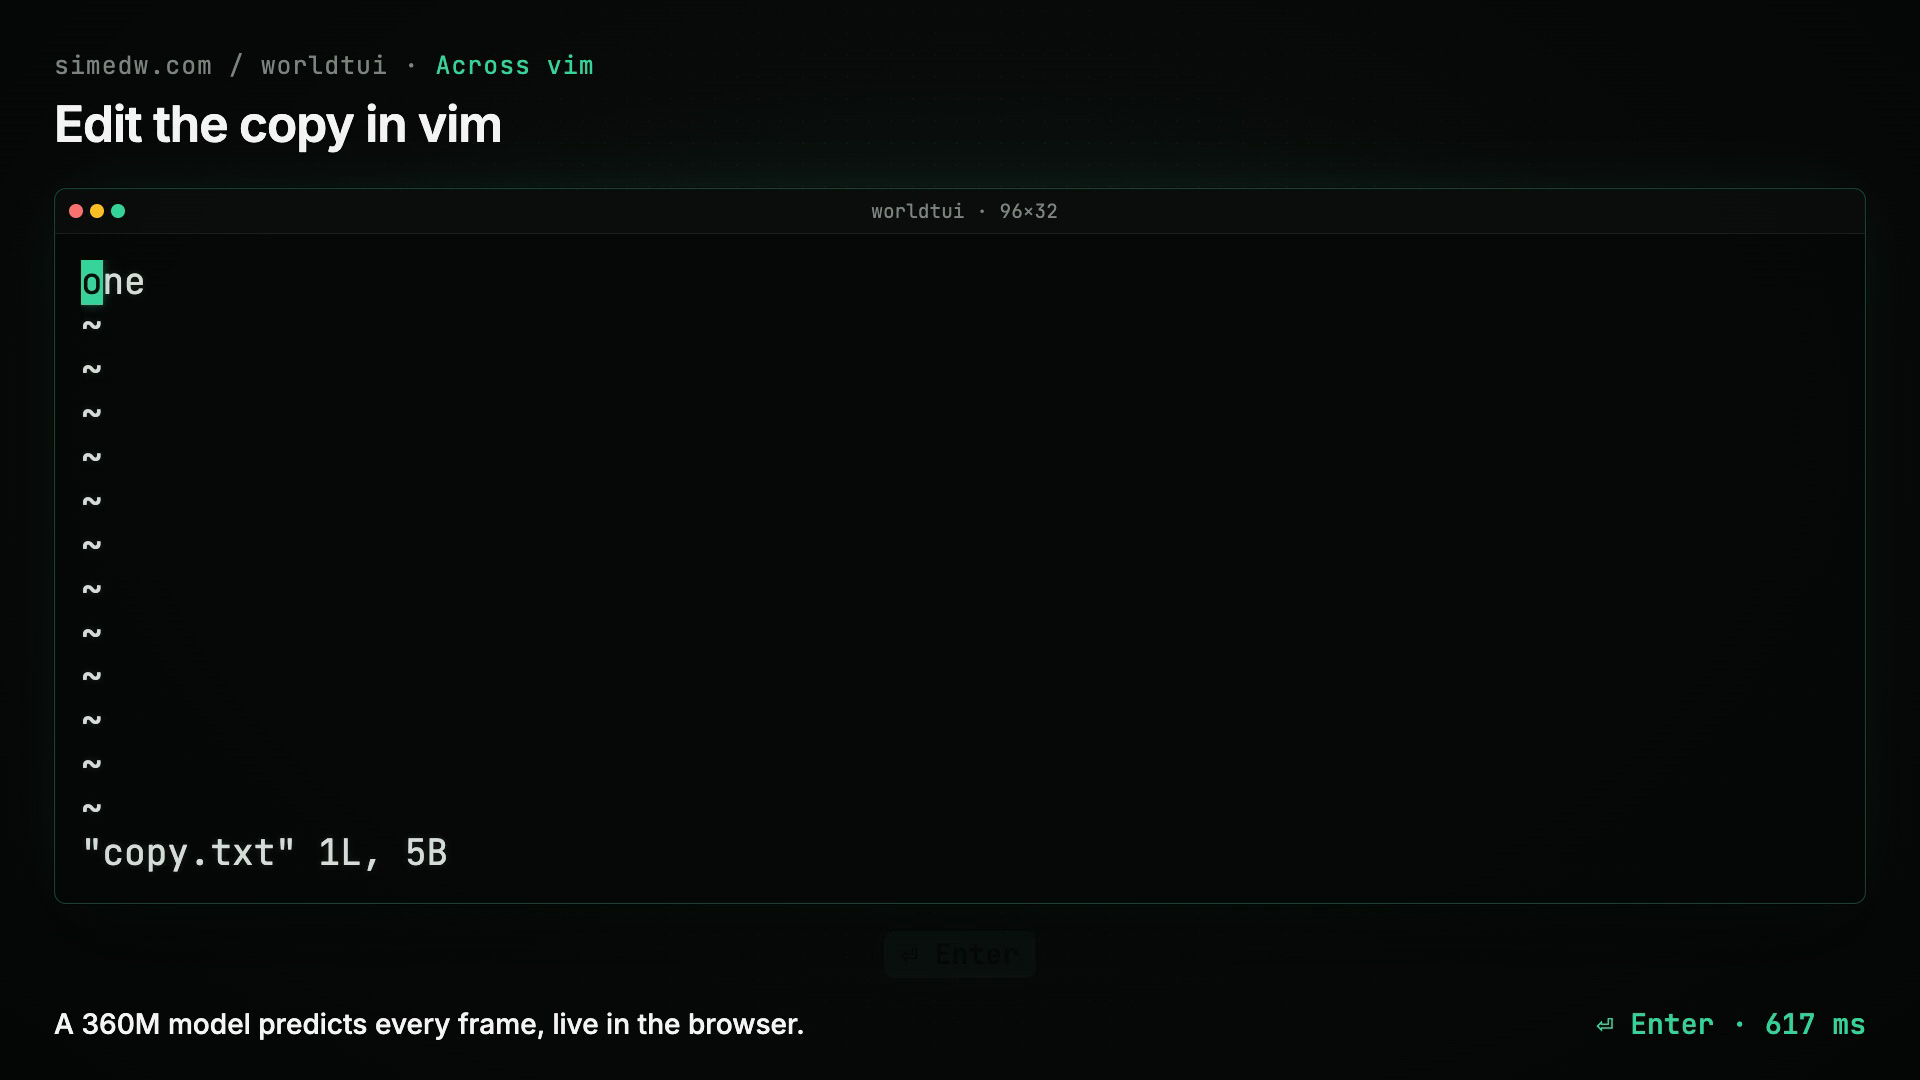
初めて tmux を起動し、vim でファイルを開いて変更を加えて保存し、別の tmux ウィンドウで cat を使って更新後の内容を読めたときは、フランケンシュタイン博士になった気分だった。動いた!
そのほかの用途
この仕組みは bash のプロンプト以外でも使えないと困るので、vim、python、man ページ、snake、果ては tmux でもトレーニングした。
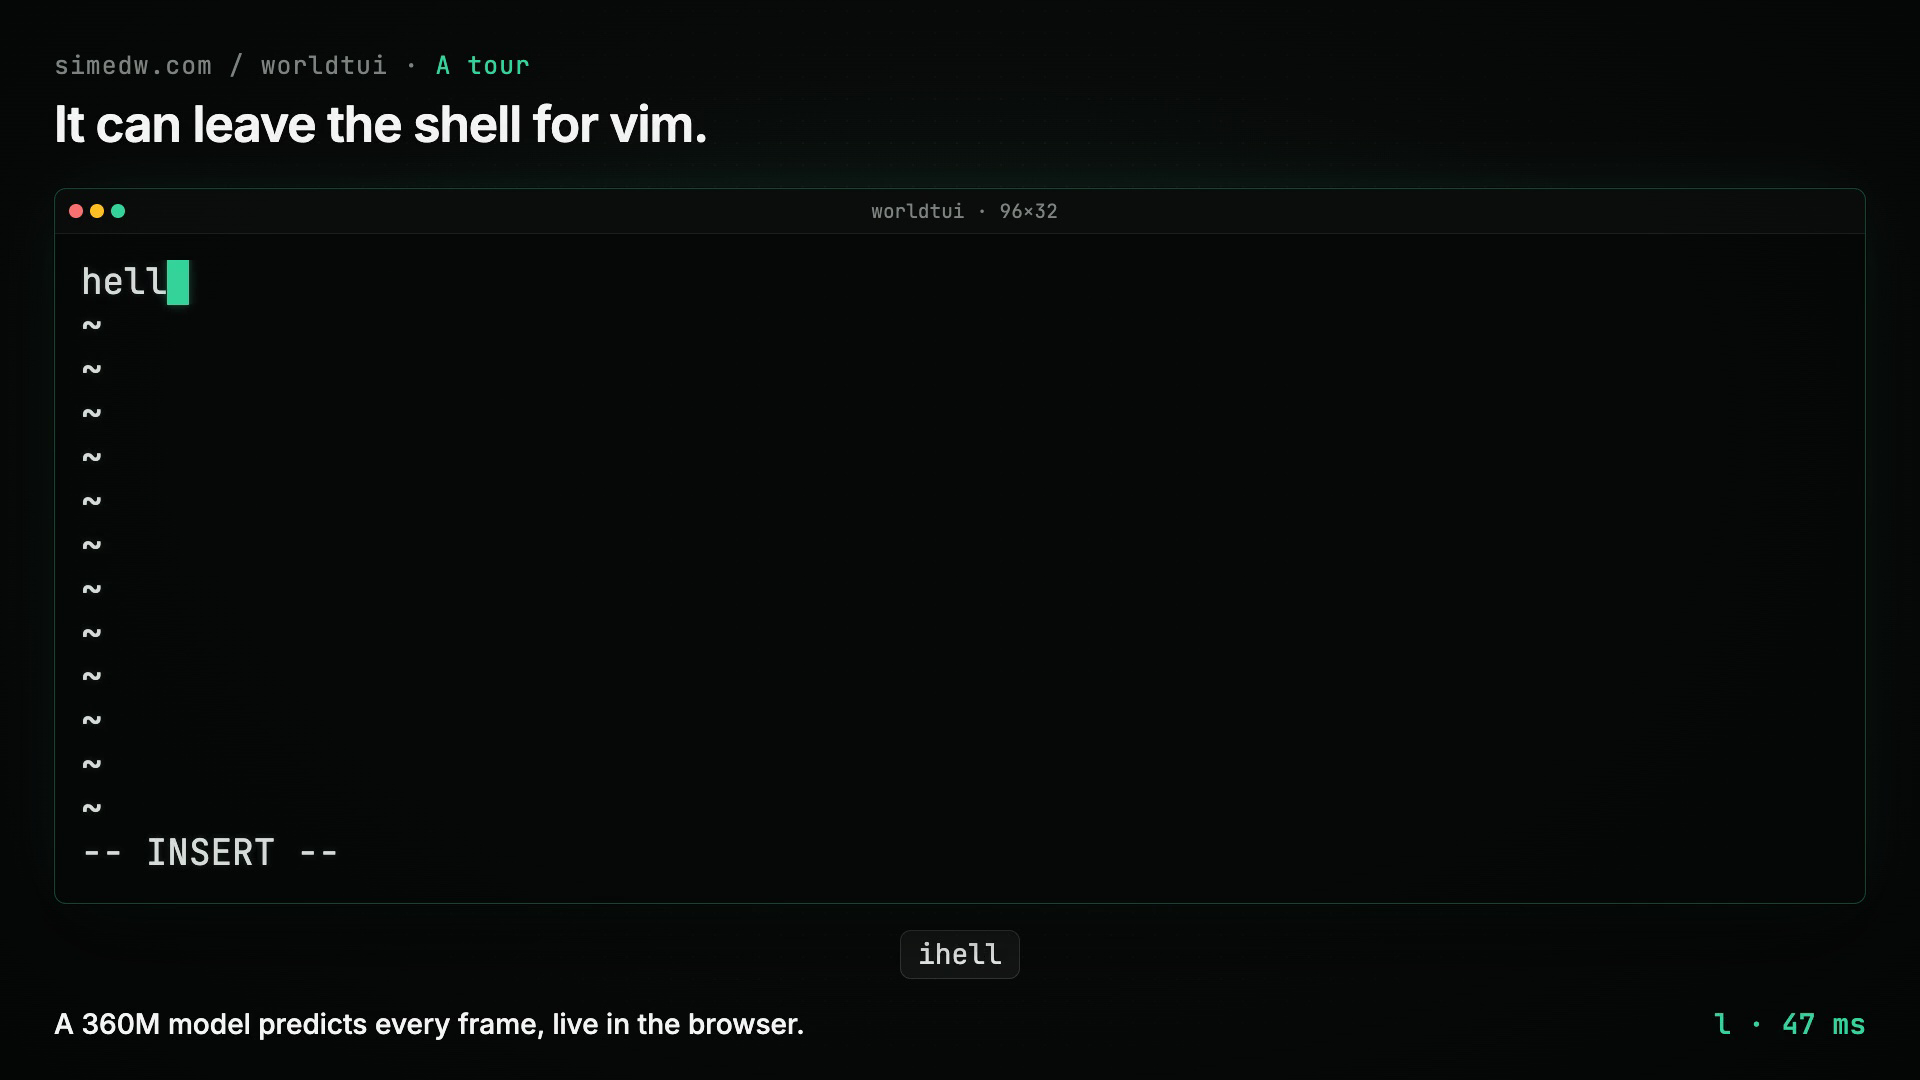
vim では esc のモード切り替えに対応していて、保存や終了、挿入モードへの復帰ができる。
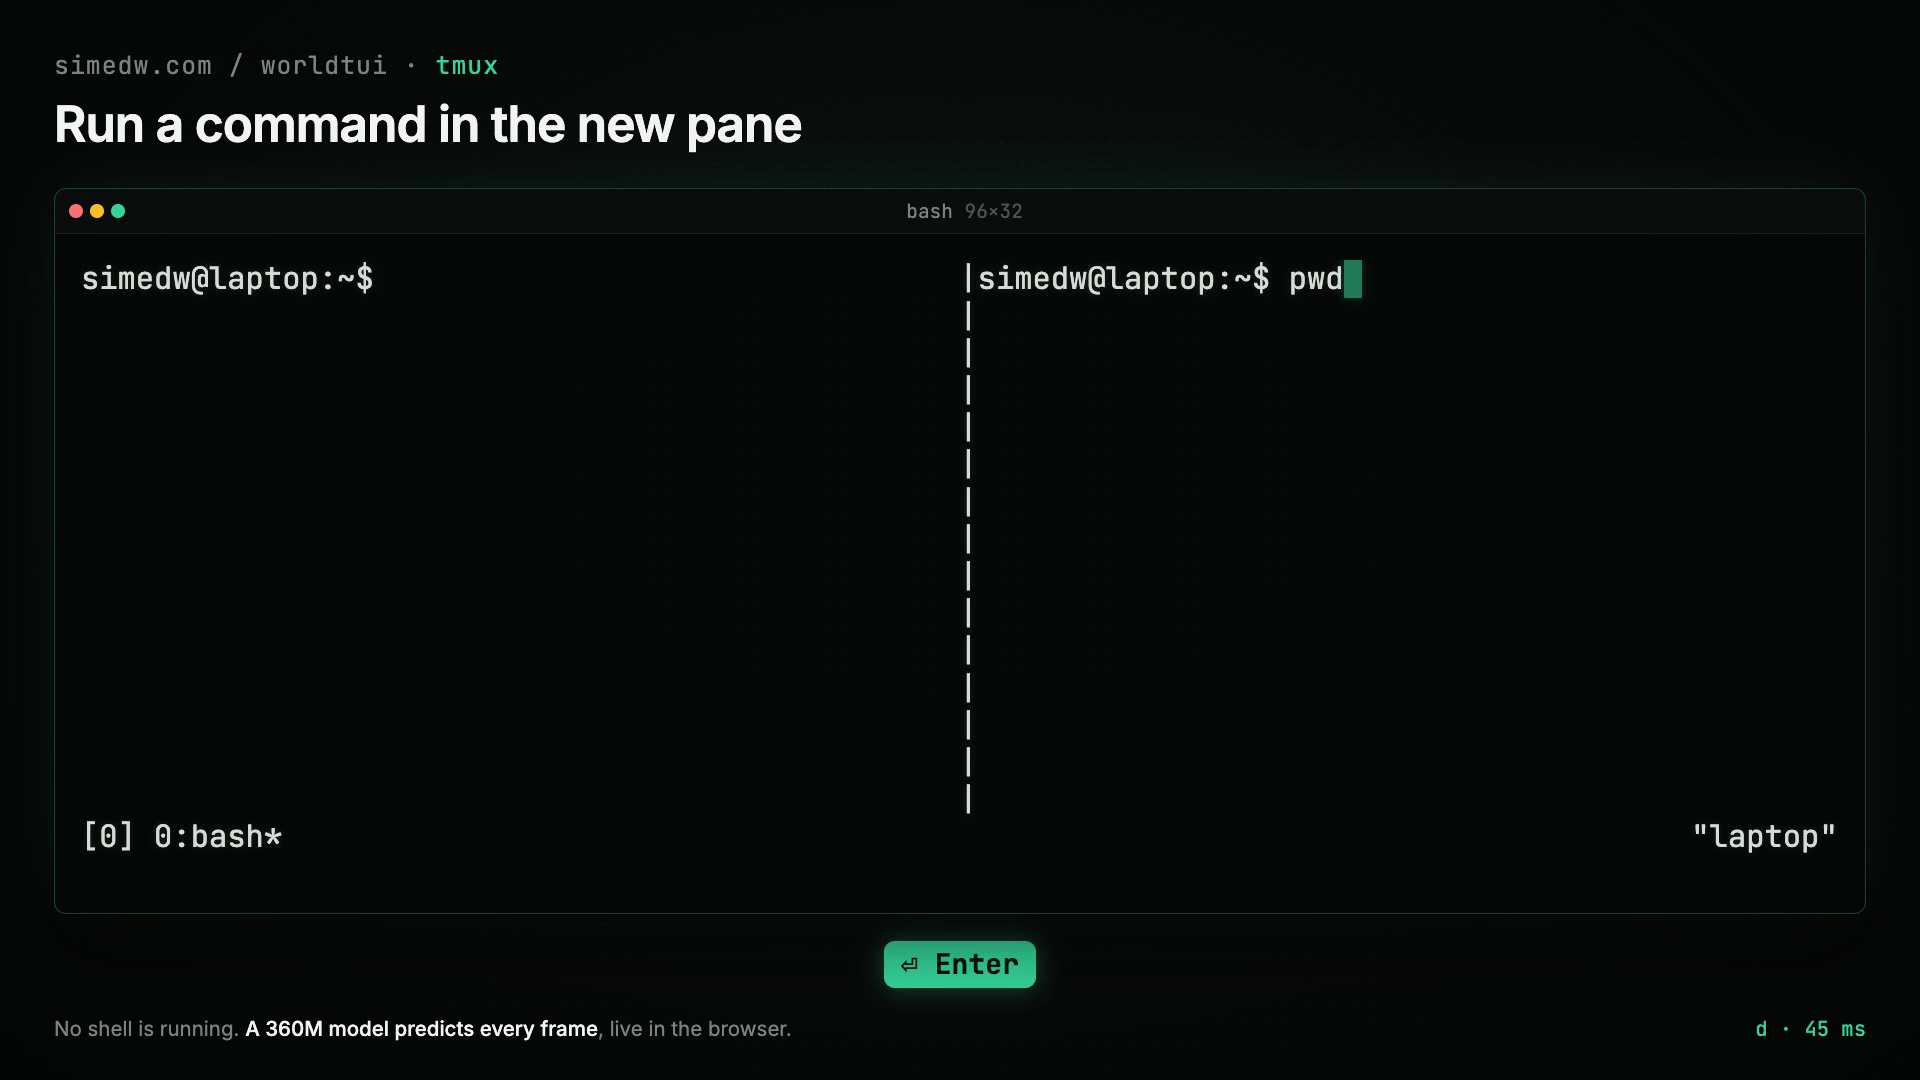
目から鱗だったのは、やはり tmux だ。ペインをいくつも開き、それぞれで別の作業を進め、自由に行き来できる。完璧ではないが、小さいモデルにしてはよくやっている。
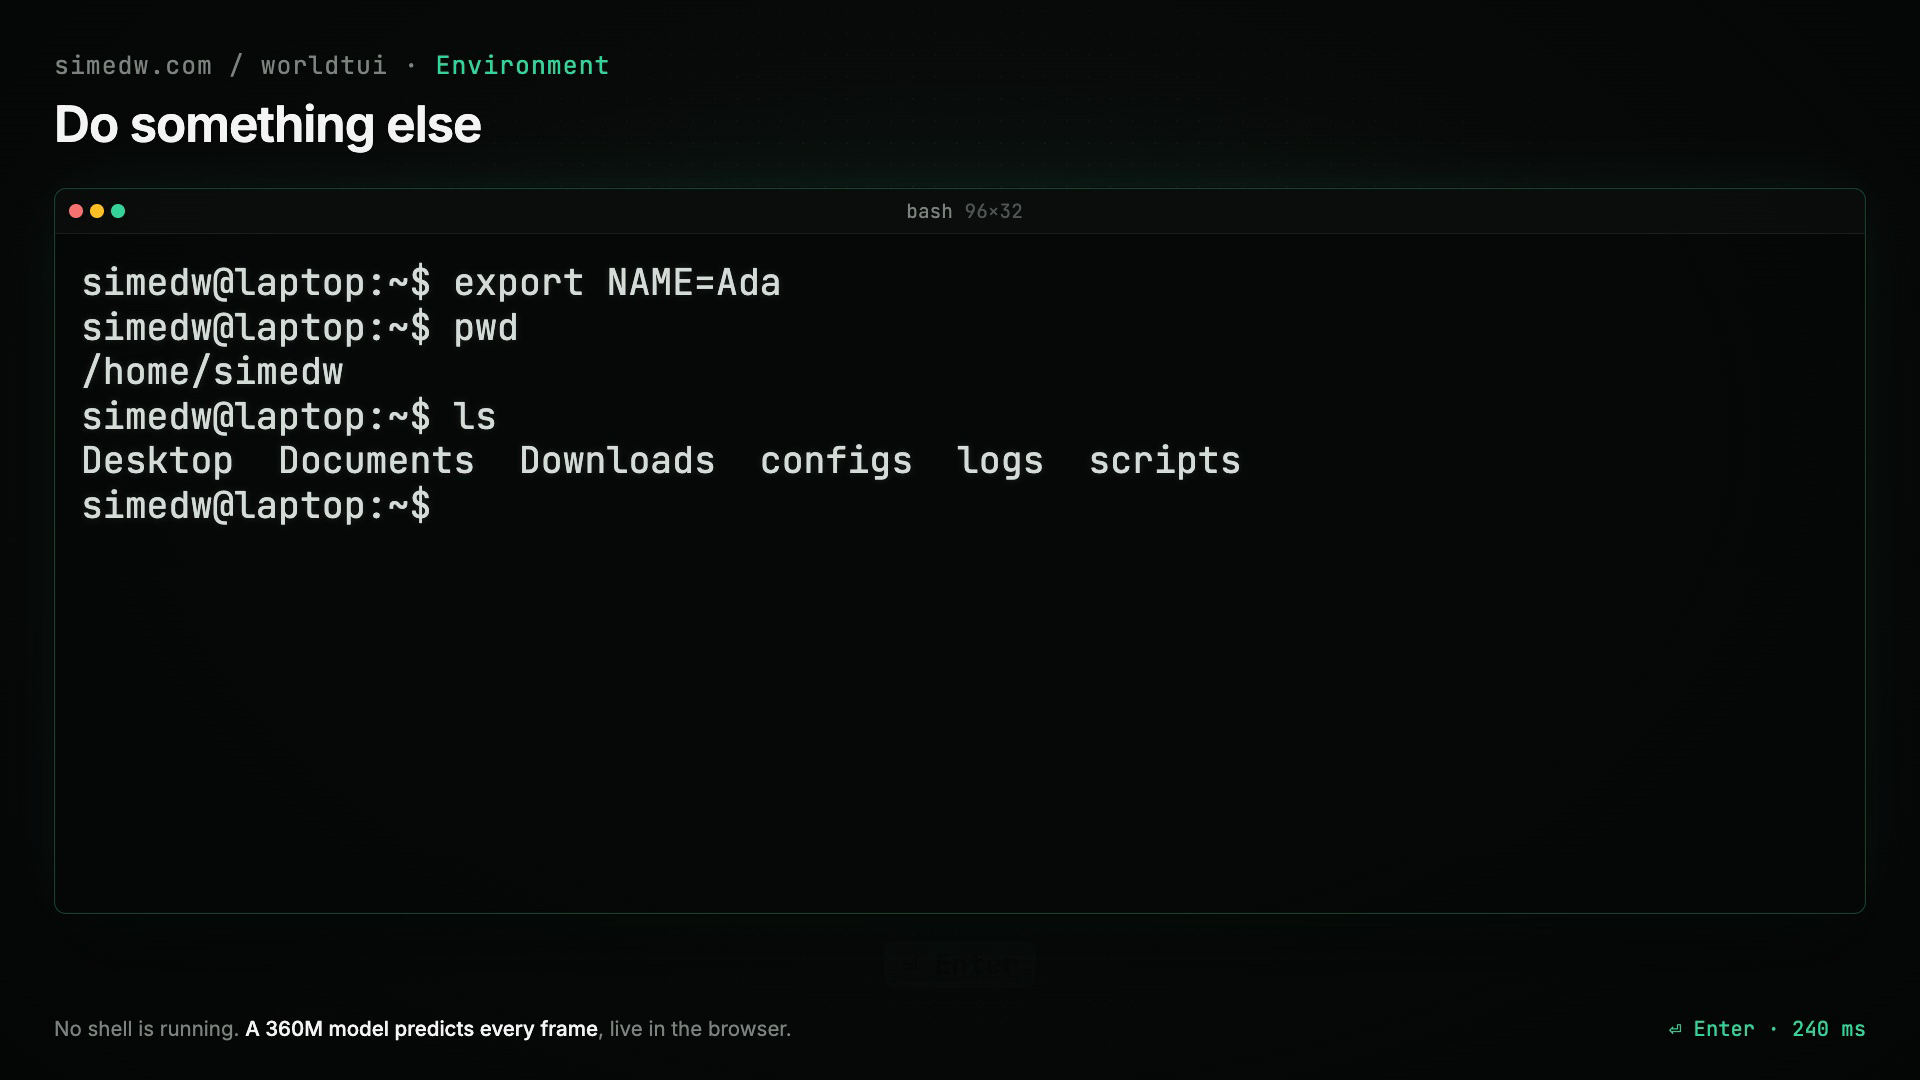
環境変数と変数の展開まで管理できる。
Python
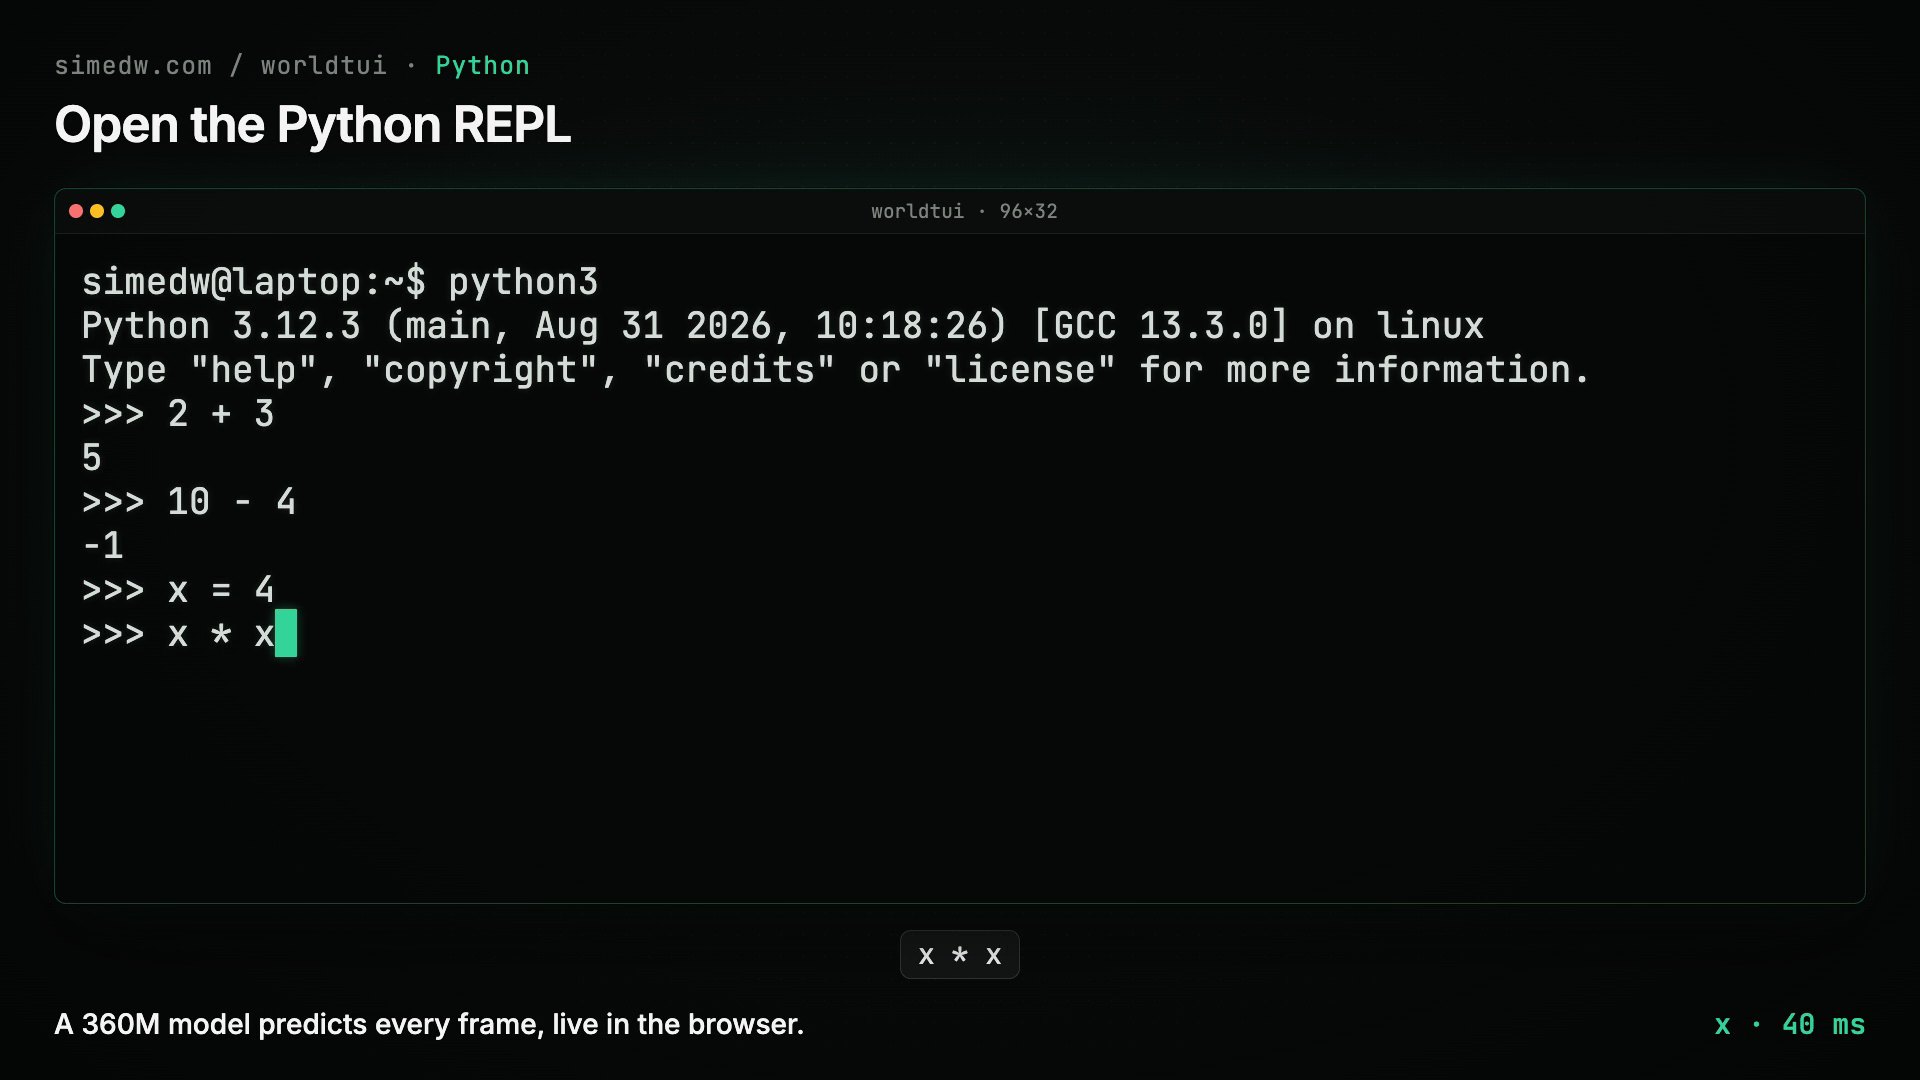
ベースモデル自体がコードモデルなので、Python REPL での挙動が気になった。試してみると、それなりに様になっている。単純な足し算はたいてい正しく計算でき、リスト内包表記もリストを返す。ただし中身はしばしば間違っている。スペルミスにも少し寛容で、pythoon なら Python が起動するが、ython では起動しない。
うまくいかなかったところ
Docker コンテナはネットにつないでいないので、lynx のようなツールはかなり退屈だった。Python はごく簡単な操作ならこなすが、少し難しいタスクになると、返ってくる答えは GPT-3 時代の幻覚を思い出させる。
ネストしたディレクトリを作らせると、道に迷って突然別のパスに飛んでしまうことがある。一貫性には明らかに改善の余地が大きい。
私のテストでは、このデモは Firefox だと Chrome より約 20 倍遅かった。どちらも WebGPU を使っている。原因はまだ特定できていない。
関連研究
こういうプロジェクトではいつも同じ順番で進める。まず自分で方法を考える。それから他人がどうやったかを見る。
2022 年にはすでに ChatGPT を Linux 端末として動かす試みがあった。もっと最近では、GameNGen が拡散モデルで Doom をシミュレートし、NeuralOS はデスクトップ GUI に挑んでいる。
WorldTUI は初期の ChatGPT 端末に近い遊び方だが、キー入力と画面更新に特化して訓練されている点が違う。vim や tmux のような全画面アプリも含まれる。
まとめ
作っていてとても楽しかった。役に立つか?ほとんど立たない。だが、ブラウザのタブの中で動く 360M パラメータのモデルとしては、期待をはるかに上回る出来だ。
一番興味を引かれたのは、土台にルールを一切実装していないのに、おおよそ筋の通った世界を維持できていたことだ。
明らかに弱い世界モデルである。一貫性がもっと高く、画面更新の生成方法も別のやり方(たとえば自己回帰デコードの代わりに拡散モデル)にしたら、この道はどこまで行けるのか見てみたい。
次にやりたい実験は、数千個のランダムに生成したアプリで訓練することだ。それぞれに独自のコントロールとルールを持たせる。文脈の手がかりが十分にあれば、モデルは一度も見たことのないアプリの振る舞いを予測できるようになるか、それを見たい。
ここから試せる。ダウンロードサイズは 208 MB、完全にローカルで動き、Chrome が一番調子いい。壊してみて、何が見つかったか教えてほしい。
重みは近いうちに公開する。ダウンロードリンクもここに追記する。
Footnotes
-
単色だ。文字だけで、色もテキストスタイルもない。Unicode 文字(tmux の罫線を含む)はエンコード前に ASCII へマッピングされるので、これらの罫線にマルチバイト文字のトークンは要らない。 ↩
-
これらは短い間隔のテストで、間にコマンドは 0〜1 個しか挟まらない。ShellBench は 18 コマンドにわたる持続性もテストしている。 ↩
-
2 つの prompt モデルにはそれぞれ 3 つの例を与えた。予測するのはコマンド全体の出力であり、画面更新ごとではないので、タスクは完全に同じではない。 ↩
-
投機的デコードの高速化は、4090 のほうが私の M4 よりずっと大きい。ボトルネックが計算能力とメモリ帯域の間で移っているのだと思うが、まだちゃんと調べていない。 ↩
-
GPU に合わせるため、384 に切り上げた。 ↩