AWS Trainium无需NVIDIA即可运行实时AI视频生成:NKI内核操作手册已发布
AWS Trainium 上实时 AI 视频模型首次跑通:3D-RoPE 内核提速 2778 倍,5 秒降至 1.8 毫秒。
中文
复制
作者:Shannon Harwood
发布时间:2026年9月28日 11:18(美国东部时间)
 Aws.amazon.com
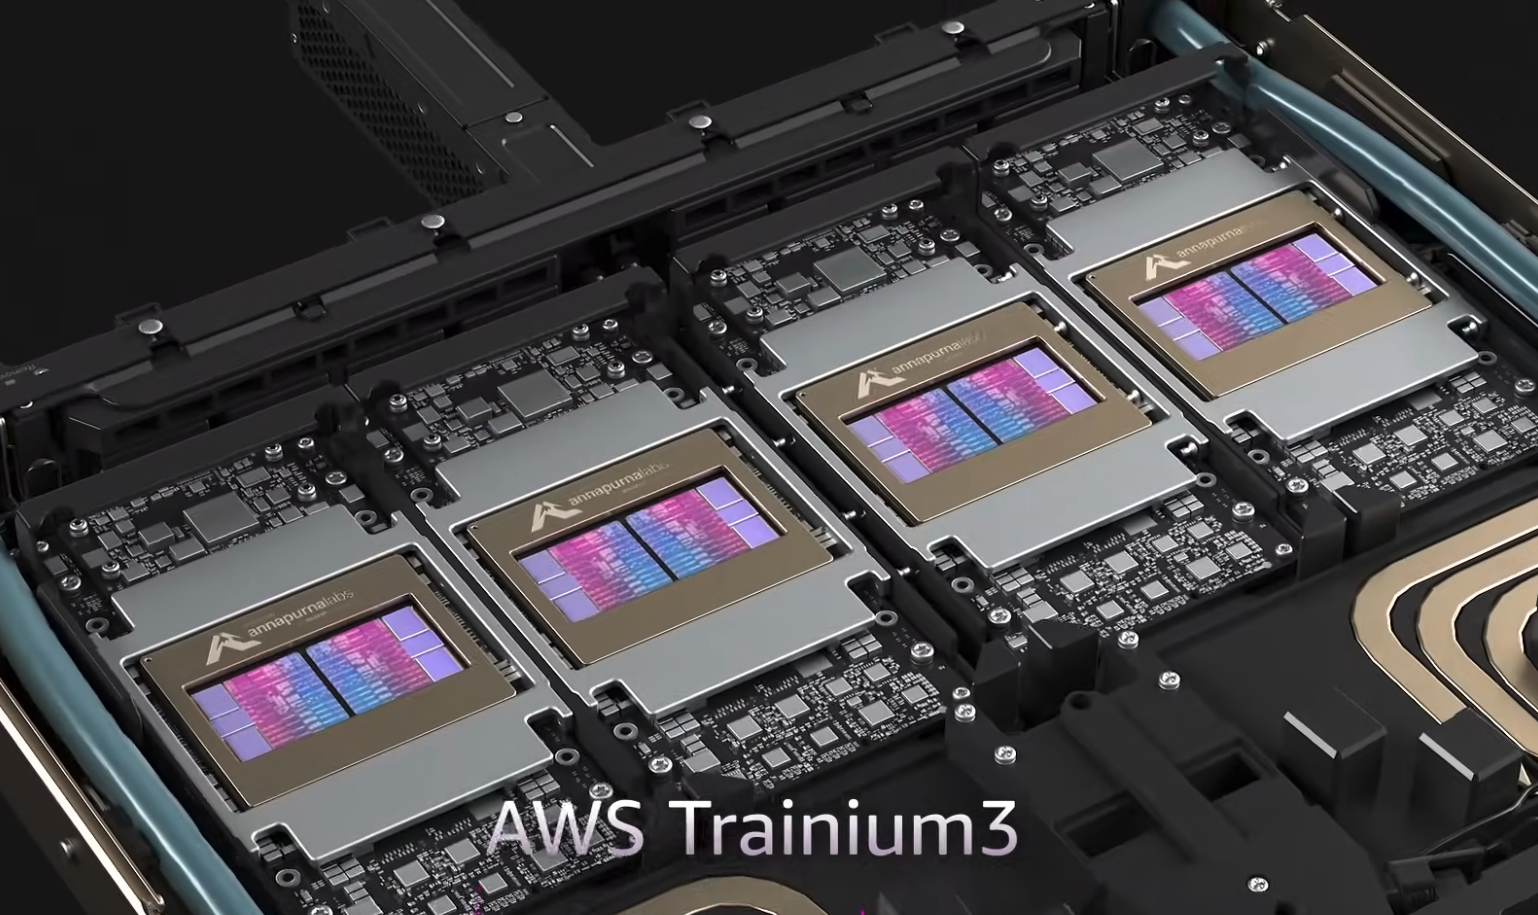
一个耗时五秒的瓶颈缩短到 1.8 毫秒。一次让所有通用编译尝试都崩溃的内存操作,在 11 GB 上顺利跑通。一种混合分片策略在两条各自无法单独满足的并行约束之间穿行——一个实时 AI 视频模型在非 NVIDIA 芯片上首次产出了正确结果。这些不是预测数据,而是 Amazon AWS Neuron Science 团队与实时交互式 AI 平台 Reactor 合作的实测结果,以 AWS 团队 9 月 25 日发表在 Amazon Science 上的文章形式公布。这项工作首次证明,自回归扩散视频模型——驱动交互式游戏世界、机器人仿真和自动驾驶训练的架构——可以在 AWS Trainium 加速器上以实时帧率运行,既不需要 NVIDIA 硬件,也不需要从头重写整个软件栈。真正让这件事成立的,是文章里真正的故事:不是新芯片,而是针对通用编译器处理得最差的三类操作,逐个 kernel 做定向手术。这个策略——可以称之为定向 kernel 对齐——与以往任何非 NVIDIA 硬件的尝试在竞争路线上都截然不同。此前的加速器试图复制 CUDA 的广度,而 Neuron Kernel Interface(NKI)通过自定义代码,在特定的瓶颈操作上达到与 CUDA 相当的性能,同时保留编译器流水线的其余部分。这些技术足够通用,凡是与 Rolling Forcing 具有相同架构特性的自回归扩散模型,都可以套用。
为什么实时 AI 视频是算力最难的问题之一
实时交互式 AI 视频生成,并不只是更快的离线视频生成。当用户的输入——一次按键、一个手柄方向、一句语音指令——必须反映在下一帧生成画面中时,模型没有缓冲的余地。它必须在下一帧被需要之前就生成并交付当前帧,否则体验就会崩掉。这个门槛是最低 16 帧每秒;低于这个数字,交互式视频就会退化成卡顿,用户能明显感知到模型的延迟。这项研究的核心模型是 Rolling Forcing,一种由南洋理工大学和腾讯 ARC Lab 的研究人员开发的自回归扩散架构,已被 ICLR 2026 接收,并以 CC BY 4.0 许可在 github.com/TencentARC/RollingForcing 开源。Rolling Forcing 把大语言模型逐 token 顺序预测的方式与迭代式扩散精修结合起来,使用户输入能够影响模型下一帧生成的内容。正是这种混合方式,让该模型适合作为交互式世界模型的测试载体——这类 AI 系统最早由 Jürgen Schmidhuber 于 1990 年提出,后经 David Ha 与 Schmidhuber 2018 年的工作推进,它构建环境的内部表示,即所谓世界模型,并预测环境如何响应动作。硬数据说明了这个负载为什么在计算上如此极端。Rolling Forcing 的自注意力在 23,400 个 query token 与 32,760 个 context token 之间运算,占总计算时间约 70%。模型还维护一份双策略 KV cache——一个近期 context token 的滑动窗口,加上一个永久的“attention sink”,保留初始帧的 key-value 状态作为全局上下文锚点——每一次前向传播的每一层都必须读写它。
通用编译器解决不了的三个瓶颈
据 Neuron 团队首席应用科学家 Jun Wu 介绍——他与高级应用科学家 Mason Fu、Lingfan Yu 共同领导了这项研究——用任何标准工具链编译 Rolling Forcing 都会暴露出三个具体问题,团队的研究结果对此有详细记录。动态形状。 Rolling Forcing 的滑动窗口 KV cache 会不断加入新帧、逐出旧帧。每次前向传播的注意力长度都不一样,而且模型在每个窗口内要执行两种结构不同的传播——一次去噪传播,一次 cache 清理传播。标准编译器偏好能在编译期固定下来的静态形状。这种可变形状要么让静态编译根本无法进行,要么迫使编译器保守到性能崩溃。三维旋转位置编码。 大多数大语言模型沿单一序列维度使用旋转位置编码,RoPE 原始论文中有相关描述。Rolling Forcing 需要同时沿三个轴——高度、宽度和时间——施加 RoPE,以编码每个视频 token 在视频空间与时间结构中的位置。通用编译器遇到这种三维结构时,会生成许多彼此独立的小块内存传输——每个轴一次——而不是一个融合操作。这些开销在网络每一层上不断累积。逐层 KV cache 拷贝。 由于 KV cache 在每一层都会更新,模型要不停读取旧的 cache 内容、写入新的内容。在未做任何优化之前,每层每次 cache 拷贝耗时 23 毫秒——这个数字要乘以整个网络的深度。
NKI:编译器之下,硬件之内
这个团队的解法是绕开编译器层面的修补,直接下沉到编译器之下。AWS 的 Neuron Kernel Interface(NKI)让开发者可以直接访问 NeuronCore 的指令集架构(ISA),编写自定义计算内核,精确控制数据在内存与计算引擎之间的流动方式。他们没有等 neuronx-cc 编译器为那些瓶颈算子找到一条高效路径,而是把这些算子替换成手工调优的实现,网络其余部分仍走标准编译流程。性能差距既精确又悬殊。3D-RoPE 内核的 NKI 自定义实现把执行时间缩短了 2,778 倍,从 5 秒降到 1.8 毫秒。缓存拷贝操作从每层 23 毫秒降到 1.9 毫秒。原本被流水线拆成独立步骤的 attention transpose 操作,则通过融合进 attention 内核计算被彻底消除。对内存的影响同样决定性。优化后的流水线占用 11 GB 高带宽内存(HBM)。而标准的 eager 模式执行路径——静态编译失败时的兜底方案——直接耗尽内存,没有产生任何输出。Wu 还提到,用于编写 NKI 内核的智能体内核生成工具 NKI-Dev-Suite 第一次尝试就生成了一个可用的 3D-RoPE 内核。这个结果之所以重要,是因为 3D-RoPE 在架构上并不常见——多数 RoPE 实现只处理单一位置维度,而 3D-RoPE 没有标准参考实现可循。智能体内核生成能力说明,自定义 NKI 开发的准入门槛比底层硬件的复杂度所暗示的要低。
这属于哪一类案例?定向内核对齐 vs. 替换 CUDA
要理解这条路径在竞争上的意义,先得看清 CUDA 的护城河到底是什么。NVIDIA 的 CUDA 并行计算平台于 2007 年首次发布,此后积累了大约 15 年的库开发:矩阵运算有 cuBLAS,深度学习原语有 cuDNN,推理优化有 TensorRT,Transformer 专用加速有 FlashAttention 和 Triton。PyTorch、TensorFlow、JAX 这些主流机器学习框架,全都把 CUDA 当作首要目标做过优化。一款新加速器发布时,它面对的是这样一个世界:所有开发工具、所有基准测试套件、所有生产部署,都以 CUDA 为基准。
此前挑战 CUDA 的尝试,大多是想在广度上与之匹敌——从零搭出一套同等规模的库生态。这条路要走通,得花上好几年做框架集成和库开发,而在这期间,新生态尚不支持的任何负载都还留在 NVIDIA 硬件上。NKI 的策略不一样。它不去做 CUDA 的通用替代品,而是针对具体负载中的特定瓶颈算子,只把这些算子换成自定义 kernel,其余部分照旧交给标准的 Trainium 编译器。结果是:在特定负载上拿到可与 CUDA 竞争的性能,又不必完成整个生态的迁移。这就是有针对性的算子对等——不是取代 CUDA 的广度,而是绕开 CUDA 在那些决定高要求负载能否跑起来的算子上所拥有的性能优势。
业界分析已经指出,这条路径改变了采用非 NVIDIA 硬件的成本收益账。Decart 在 AWS Trainium3 上独立报告的生产结果——据该公司称,帧生成速度最高提升至四倍,成本只有同等 NVIDIA GPU 配置的一半——印证了这一前提:在专用芯片上做有针对性的优化,只要工程投入划得来,就能在相应负载上抹平性能差距。Decart 的 Trainium 性能数据引自 AWS 客户页面。
将视频 token 拆分到八个无法整除的核心上
把 kernel 运算改对之后,单个运算的低效问题解决了,但还剩下第二类问题:如何把工作负载分配到多个 NeuronCore 上,既不浪费算力,也不破坏数据布局。Lingfan Yu 解释了两种显而易见的策略之间的核心并行权衡。张量并行(TP)把权重矩阵切分到多个加速器核心上——这是大型 transformer 模型的标准做法。但本工作使用的 WAN 扩散 transformer 模型有 12 个注意力头,而单颗 Trainium 芯片只有 8 个 NeuronCore。12 除以 8 不是整数。纯 TP 会迫使系统用空操作填充计算,把空槽补满,白白浪费算力周期。序列并行(SP)则切分输入序列而非权重矩阵——这是另一种权衡,避开了注意力头对齐的问题。但视频 token 是三维结构(高、宽、时间),序列不能在任意位置切分,否则会破坏同一帧内相邻 token 之间的关系。“你无法保证序列切分正好落在帧的边界上,”Yu 说。“你的数据至少要以帧为粒度,但如果按帧边界切分,那些运算就跑不通。”团队的做法是同时使用两种并行策略:用 TP 跨四个核心切分注意力头,用 SP 跨两个核心在帧边界处切分序列——在这里切分可以保证安全。这一组合既保持了算术正确,又维持了视频 token 的布局,还避免了纯 TP 的填充浪费。另外,VAE 解码器——负责把扩散模型的 latent 输出还原成像素——沿宽度轴做了空间切分,取得了 8.25 倍的超线性加速,因为空间切分减少了核心之间冗余的数据搬运。
阶段批处理:为什么两种不同的前向传播应该合并为一次调用
第三项优化针对的是 Rolling Forcing 所需的两种前向传播之间的结构性差异:一种是去噪传播,负责计算密集的扩散精修;另一种是缓存更新传播,负责管理 KV cache,但负载相对较轻。将二者作为独立的前向传播运行,会造成 Trainium 实例架构特有的利用率不足问题。单个推理实例横跨 16 块芯片,每块芯片有 8 个 NeuronCore——总共 128 个执行单元。一个缓存更新传播分散到 128 个单元上,每个单元分到的工作量极少,实例的大部分算力因此闲置。团队重构了模型代码,让两个阶段共有的流水线组件在一次批处理前向传播中一起执行,只在去噪计算与缓存管理逻辑分道扬镳的地方才分支。Yu 在 Amazon Science 的文章中描述了这一取舍:“流水线的大部分环节,它们都是批处理在一起的。这对 Trainium 尤其有用,因为每个实例有 16 块芯片,每块芯片有 8 个核心。如果你把计算切分到太多核心上,每次调用分到的计算量就很小,容量就这样被浪费了。”
这是否意味着 AWS 已经追上了 NVIDIA?
总体而言并没有——但就这类工作负载而言,差距如今取决于软件投入,而非硬件上限。NVIDIA 的 CUDA 生态在广度上仍然领先。15 年积累下来的库栈所支持的操作类型、模型架构和开发者工作流,比当今任何非 NVIDIA 平台都多。对于基于标准模型架构、使用常规编译流水线的团队来说,CUDA 的软件生态仍是一项显著优势。Amazon Science 这项工作所展示的是另一个问题:当性能瓶颈操作可以被识别出来并替换为自定义 kernel 时,Trainium 与 NVIDIA GPU 之间的硬件差距可以通过有针对性的工程手段来弥合。这种可弥合性之所以成立,是因为 NKI 让开发者能够以 CUDA 控制 NVIDIA tensor core 的同等层级访问 NeuronCore ISA——直接、可编程,必要时绕过通用编译器。参与此次合作的 principal solutions architect Yahav Biran 强调,Rolling Forcing 作为测试载体在架构上是完整的,因此结果具有可推广性。“一个健壮系统里该有的复杂度它都有:encoder、DIT、VAE、decoder。所以基本上,你换一个更健壮的系统,它运作的也是同样的构建模块,”Biran 在发表的文章中说。言下之意是,这里开发的 NKI 技术——动态 shape 处理、3D-RoPE 自定义 kernel、TP+SP 混合分片、阶段批处理——并非 Rolling Forcing 专属。它们构成了一套可复用的方法,适用于任何具有相同结构特征的自回归扩散模型。
Reactor 与交互式 AI 的商业赌注
这项合作的商业背景来自 Reactor——这家平台与 AWS Neuron Science 团队共同完成了端到端结果的演示。Reactor 由 Alberto Taiuti 和 Bryce Schmidtchen 创立,前者曾是 Luma AI 的联合创始人兼 CTO,后者曾任 Apple Vision Pro 技术负责人。Reactor 于 2026 年 5 月完成 5900 万美元融资,由 Lightspeed 领投,WndrCo、Amplify Partners、Sky9 Capital 和 FPV Ventures 参投。AWS 是 Reactor 的战略云服务商和首选云服务商。Schmidtchen 对这件事的分量说得很直接。“在并不遥远的未来,每一个像素都会实时、交互式地生成,”他说,“完整的故事可以由世界模型实时创造出来:这些故事会做出反应,你可以与之互动,甚至能随时改变整个场景。”他表示,AWS 的全球基础设施和 Trainium 的发展路线图,正好契合交互式 AI 在消费级规模下将要带来的推理需求,据 Amazon Science 的文章。延伸阅读: Anthropic 放弃收购 Decart,Claude 算力成本缺口仍未解决
Decart 的 Trainium 结果提供了独立佐证
这项研究并非孤例。由 Dean Leitersdorf 和 Moshe Shalev 创立的以色列 AI 初创公司 Decart——两人均出身于以色列 8200 部队军事情报单位——公布了在 AWS Trainium3 上的生产环境性能数据,独立验证了这样一个前提:在 Trainium 上做针对性优化,可以为实时视频负载缩小与 NVIDIA 的差距。
Decart 的 Lucy 模型在 Trainium2 上实现了 40 毫秒的首帧时间。据该公司称,在 Trainium3 上生成速度提升四倍,成本仅为同等 NVIDIA GPU 配置的一半。CEO Dean Leitersdorf 称 Trainium3 的架构为该负载带来了“更高的吞吐量、更低的延迟和更高的内存效率”。据该公司称,Decart 的 DOS(Decart Optimization Stack)——公司为其模型开发的推理优化层——在智能体推理中可实现约每秒 1600 个 token,而行业平均水平接近 200。
Decart 最初完全跑在 NVIDIA GPU 上。在一次会议上,一位 Amazon 代表主动提出可以测试这批芯片,测试结果超出预期——Leitersdorf 随后受邀在 Amazon 的 re:Invent 大会上做演示,这个舞台通常只留给成熟的企业级玩家。此后公司累计融资超过 4.5 亿美元,其中包括 2026 年 5 月的 Decart 3 亿美元 B 轮融资,该轮融资对公司的估值接近 40 亿美元,投资方包括 Radical Ventures、NVIDIA、Sequoia Capital、Benchmark、Adobe Ventures、Toyota Ventures 以及天使投资人 Andrej Karpathy。截至 2026 年 6 月,已有超过 10 万名开发者在 Decart 的模型上构建应用,公司也已拿下与 AWS Amazon Bedrock 平台的集成。
Decart 的性能数据由公司自行公布,未经第三方独立审计。所谓相对 NVIDIA 实现 4 倍吞吐量、2 倍成本效率,应放在这一背景下看待。
延伸阅读: Anthropic 洽谈以 60 亿美元收购 Decart,目标是在 IPO 前实现 77% 毛利率
Trainium Frontier 竞赛与下一步
这套方法论发表在 Amazon Science 上,明确被定位为一个可推广计划的起点,而不是一次孤立工程成功的记录。滑动窗口 KV 缓存中动态形状的处理方法、用于 3D-RoPE 和缓存拷贝操作的基于 NKI 的内存 kernel,以及 TP+SP 混合分片策略,都描述得足够详细,可以为更广泛一类的自回归扩散模型的移植工作提供参考——这类模型如今正支撑着要求最苛刻的实时 AI 应用。
AWS 也在直接投入 Trainium 的开发者生态。Trainium Frontier 竞赛公告的报名截止日期为 2026 年 9 月 30 日,要求研究团队在 Trainium 硬件上开发新的语言模型训练技术,前三名将分别获得 25,000 美元、10,000 美元和 5,000 美元奖金,并将在 NeurIPS 2026 期间的 Annapurna Labs 研究活动上展示,该活动定于 2026 年 12 月在澳大利亚悉尼举行。
对于正在评估推理基础设施的云客户来说,这个结果提出了一个很具体的问题:如果一个像 Rolling Forcing 这样架构完整的模型,能通过针对性的 kernel 优化在 Trainium 上跑到实时帧率,那还有哪些目前被认为必须用 NVIDIA 硬件的工作负载,也可以照此处理?AWS Neuron Science 团队的答案是:任何自回归扩散模型,只要共享同样的 KV cache 架构、同样的旋转位置编码结构,或者同样的分阶段差异化前向设计,都在此列。这可不是一个小类别。
常见问题
这是否意味着 AWS Trainium 在 AI 推理上已经追上了 NVIDIA?
单就自回归扩散视频模型而言,性能差距如今取决于针对性的软件投入,而非硬件天花板。这里展示的 NKI kernel 优化——涵盖 3D-RoPE、KV cache 管理、混合分片和分阶段批处理——让 Trainium2 在一类此前必须依赖 NVIDIA 硬件的工作负载上达到了实时性能。放到更广泛的 AI 推理格局中看,CUDA 十五年积累的库生态在覆盖面上仍然领先。NKI 这条路并不是要取代那套生态,而是在那些可以手写自定义 kernel 的特定算子上绕开 CUDA 的优势。Decart 公司自报的 Trainium3 结果(相比同等 NVIDIA 配置,帧吞吐量 4 倍、成本效率 2 倍)说明,对于愿意投入优化的运营方来说,硬件天花板并不是制约因素。Amazon Science 上的完整 NKI 结果与方法论一同发布。Decart 的 Trainium3 客户案例可在 AWS 客户页面查看。
什么是 Neuron Kernel Interface(NKI),它与标准的 Trainium 编译有何不同?
NKI 是 AWS 为 NeuronCore 提供的底层编程接口,NeuronCore 是 Trainium 芯片内部的计算单元。标准的 Trainium 编译使用 neuronx-cc 编译器,它会把模型算子自动翻译成 NeuronCore 指令——对常见算子很高效,但无法优化 3D-RoPE 这类不寻常的内存访问模式。NKI 让开发者可以通过 Neuron Kernel Interface 文档页面访问 NeuronCore 的指令集架构,编写自定义 kernel,精确控制数据如何在内存与计算引擎之间流动。这样一来,开发者可以用手工调优的实现替换特定的瓶颈算子,而网络的其余部分仍留在标准流水线中。
什么是自回归扩散视频模型,为什么它需要实时性能?
自回归扩散模型融合了两种生成方法:大语言模型逐帧顺序预测的风格,以及扩散模型迭代去噪的精修方式。这种结合让用户的真实世界输入——手柄方向、按键、语音指令——能够被吸收并反映在模型下一帧的生成结果中,使模型真正具备交互性,而不只是预先渲染。这种交互性要求模型必须在目标帧率所设定的截止时间之前生成每一帧(流畅播放至少需要 16 fps),否则体验会明显劣化。正是这一约束把实时视频推理与常规离线视频生成区分开来,也正是自回归扩散模型的计算需求远比标准视频生成严苛的原因。Rolling Forcing ICLR 2026 论文已开源,供希望评估该架构的研究者使用。
NKI kernel 技术能用在 Rolling Forcing 之外的模型上吗?
可以,AWS Neuron Science 团队如此表示。他们开发的这些技术——针对滑动窗口 KV cache 的动态形状处理、自定义 3D-RoPE 内存 kernel、张量并行与序列并行的混合分片,以及去噪与 cache 更新两个阶段的批处理——并不专属于 Rolling Forcing 的架构。它们适用于任何使用相同结构组件的自回归扩散模型:注意力长度可变的滑动窗口 KV cache、沿多个空间或时间轴的旋转位置编码,以及两阶段前向传播结构。Amazon Science 的这篇文章详细说明了 NKI 的可推广性,而 Trainium Frontier 竞赛报名页(截止日期 2026 年 9 月 30 日)的设置正是为了鼓励这类扩展。
ⓒ 2026 TECHTIMES.com 版权所有。未经许可,不得转载。