AWS TrainiumはNVIDIAなしでリアルタイムAI動画生成を実行:NKIカーネル操作マニュアルが公開
AWS Trainium 上でリアルタイムAI動画モデルが初めて動作:3D-RoPEカーネルが2778倍高速化、5秒から1.8ミリ秒に短縮。
日本語
コピー
著者:Shannon Harwood
公開日:2026年9月28日 11:18(米国東部時間)
 Aws.amazon.com
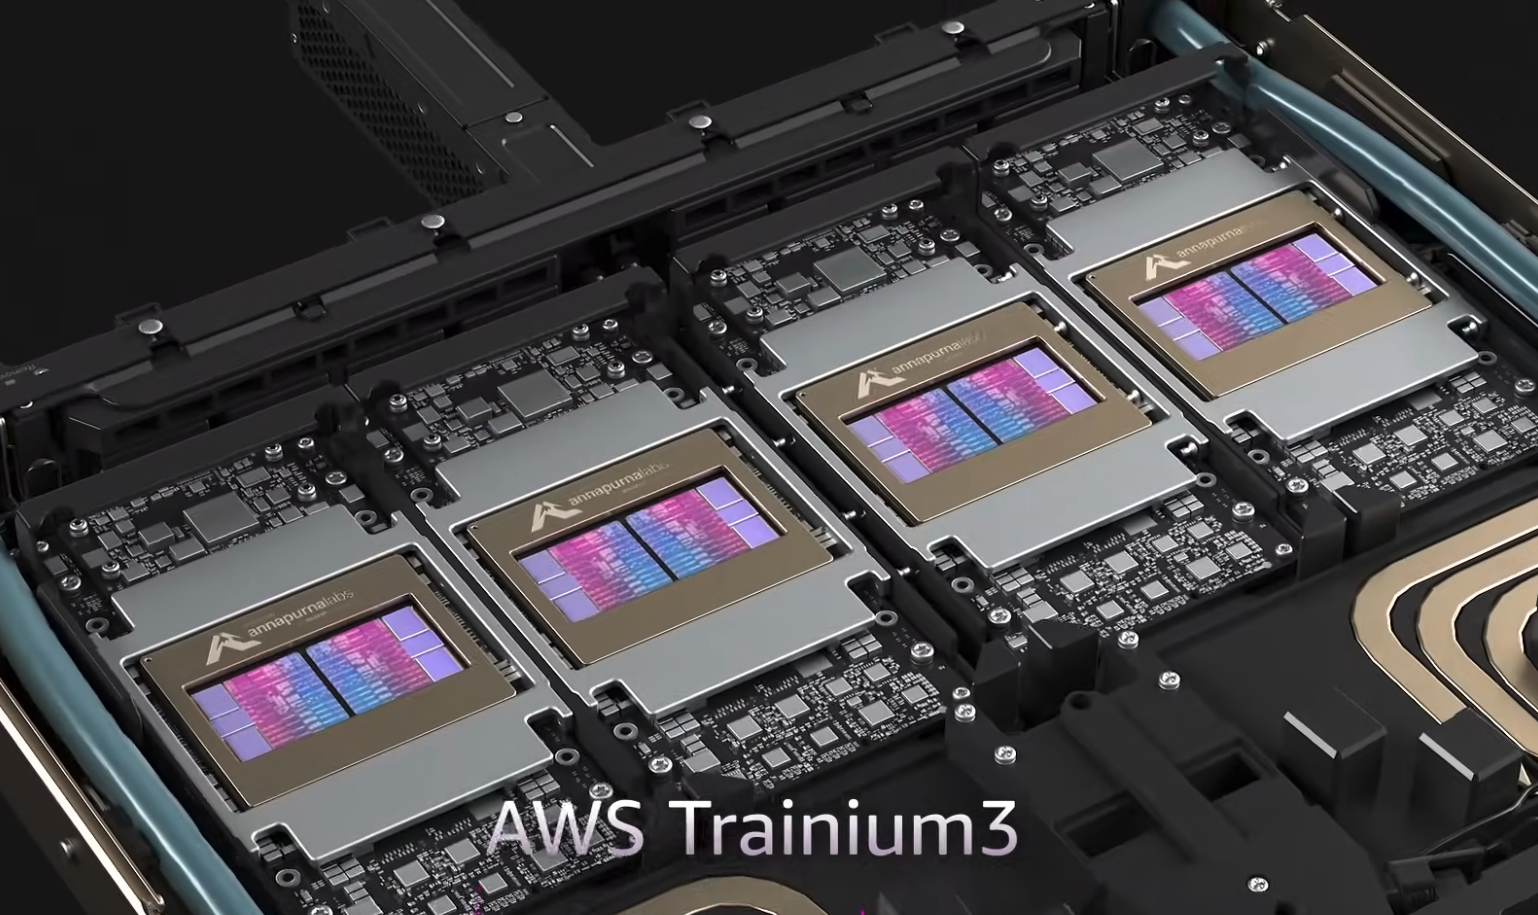
5秒かかっていたボトルネックが1.8ミリ秒に短縮された。汎用コンパイラではコンパイルが通らなかったメモリ操作が、11 GB で問題なく通った。単独では満たせない2つの並列制約の間を縫うハイブリッドシャーディング戦略。リアルタイム AI 動画モデルが NVIDIA 以外のチップで初めて正しい結果を出した。これらは予測値ではない。Amazon AWS Neuron Science チームがリアルタイム対話型 AI プラットフォーム Reactor と共同で行った実測結果であり、AWS チームが9月25日に Amazon Science で公開した記事で発表された。この成果は、対話型ゲーム世界・ロボットシミュレーション・自動運転トレーニングを支えるアーキテクチャである自己回帰拡散動画モデルが、NVIDIA ハードウェアもソフトウェアスタック全体の書き直しもなしに、AWS Trainium アクセラレータ上でリアルタイムのフレームレートで動作することを初めて示した。これを可能にした本当の話は記事の中にある。新しいチップではなく、汎用コンパイラが最も苦手とする3種類の操作に対して、カーネル単位で狙いを定めた手術を行ったことだ。この戦略——的を絞ったカーネルアラインメントと呼べる——は、これまでの NVIDIA 以外のハードウェアの試みとは競争の土俵がまったく違う。従来のアクセラレータは CUDA の広さを再現しようとしたが、Neuron Kernel Interface(NKI)はカスタムコードによって特定のボトルネック操作で CUDA 並みの性能を達成しつつ、コンパイラパイプラインの残りの部分はそのまま残す。この手法は十分に汎用的で、Rolling Forcing と同じアーキテクチャ特性を持つ自己回帰拡散モデルならどれにでも当てはめられる。
なぜリアルタイム AI 動画は最も難しい計算問題のひとつなのか
リアルタイム対話型 AI 動画生成は、単に高速なオフライン動画生成ではない。ユーザーの入力——キーストローク、コントローラーの方向、音声コマンド——が次のフレームの生成画像に反映されなければならないとき、モデルにバッファの余裕はない。次のフレームが必要になる前に現在のフレームを生成して届けなければ、体験は破綻する。その閾値は最低16フレーム毎秒だ。これを下回ると対話型動画はカクつきに退化し、ユーザーはモデルの遅延をはっきりと知覚する。この研究の中心モデルは Rolling Forcing で、南洋理工大学と Tencent ARC Lab の研究者が開発した自己回帰拡散アーキテクチャであり、ICLR 2026 に採択され、CC BY 4.0 ライセンスで github.com/TencentARC/RollingForcing にオープンソース化されている。Rolling Forcing は、大規模言語モデルがトークンを1つずつ順に予測する方式と、反復的な拡散リファインメントを組み合わせ、ユーザー入力がモデルの次フレーム生成内容に影響を与えられるようにする。このハイブリッド方式こそが、このモデルを対話型世界モデルのテストベッドとして適したものにしている。世界モデルは Jürgen Schmidhuber が1990年に提唱し、David Ha と Schmidhuber が2018年の研究で発展させた AI システムで、環境の内部表現、いわゆる世界モデルを構築し、環境が行動にどう応答するかを予測する。ハードな数字が、このワークロードがなぜ計算量的にこれほど極端なのかを物語る。Rolling Forcing の自己アテンションは23,400の query token と32,760の context token の間で演算し、総計算時間の約70%を占める。モデルはさらに二重戦略の KV cache を維持する。直近の context token のスライディングウィンドウと、初期フレームの key-value 状態をグローバルコンテキストのアンカーとして保持する永続的な「attention sink」で、フォワードパスごとに全層がこれを読み書きしなければならない。
汎用コンパイラでは解けない3つのボトルネック
Neuron チームの主席アプリケーションサイエンティスト Jun Wu によれば——彼は上級アプリケーションサイエンティストの Mason Fu、Lingfan Yu とともにこの研究を率いた——Rolling Forcing を標準的なツールチェーンでコンパイルすると3つの具体的な問題が露呈し、チームの結果はそれを詳細に記録している。動的シェイプ。 Rolling Forcing のスライディングウィンドウ KV cache は絶えず新フレームを加え、古いフレームを追い出す。フォワードパスごとにアテンション長が異なり、しかもモデルは各ウィンドウ内で構造の異なる2種類のパス——デノイズパスと cache クリーンアップパス——を実行する。標準的なコンパイラはコンパイル時に固定できる静的シェイプを好む。この可変シェイプは静的コンパイルをそもそも不可能にするか、コンパイラを保守的に追い込んで性能を崩壊させる。3次元回転位置エンコーディング。 ほとんどの大規模言語モデルは単一の系列次元に沿って回転位置エンコーディングを使う。RoPE の原論文に記述がある。Rolling Forcing は高さ・幅・時間の3軸に同時に RoPE を適用し、各動画 token の動画空間と時間構造における位置をエンコードする必要がある。汎用コンパイラはこの3次元構造に遭遇すると、軸ごとに1つずつ、互いに独立した小さなメモリ転送を多数生成する。融合された1つの操作にはならない。このオーバーヘッドはネットワークの各層で積み重なる。層ごとの KV cache コピー。 KV cache は各層で更新されるため、モデルは古い cache の内容を読み続け、新しい内容を書き込む。最適化前は1層あたり1回の cache コピーに23ミリ秒かかった。この数字にネットワーク全体の深さを掛けることになる。
NKI:コンパイラの下、ハードウェアの内側
このチームの解決策は、コンパイラ層の修正を避け、コンパイラのさらに下へ直接降りていくものだった。AWS の Neuron Kernel Interface(NKI)を使えば、開発者はNeuronCore の命令セットアーキテクチャ(ISA)に直接アクセスし、独自の計算カーネルを書いて、メモリと計算エンジンの間でデータがどう流れるかを正確に制御できる。彼らは neuronx-cc コンパイラがボトルネックとなる演算子に効率的な経路を見つけるのを待たず、それらの演算子を手作業でチューニングした実装に置き換え、ネットワークの残りの部分は標準のコンパイルフローに任せた。性能差は明確で、しかも桁違いだった。3D-RoPE カーネルの NKI によるカスタム実装は実行時間を 2,778 分の 1 に短縮し、5 秒から 1.8 ミリ秒になった。キャッシュコピー操作はレイヤーあたり 23 ミリ秒から 1.9 ミリ秒へ減った。パイプラインで独立したステップに分割されていた attention transpose 操作は、attention カーネルの計算に融合することで完全に消えた。メモリへの影響も決定的だった。最適化後のパイプラインは 11 GB の高帯域メモリ(HBM)を使う。一方、標準の eager モード実行パス——静的コンパイルが失敗したときのフォールバック——はメモリを使い切り、何も出力しなかった。Wu はまた、NKI カーネルを書くためのエージェント型カーネル生成ツール NKI-Dev-Suite が、最初の試行で動作する 3D-RoPE カーネルを生成したと述べている。この結果が重要なのは、3D-RoPE がアーキテクチャとして一般的ではないからだ。ほとんどの RoPE 実装は単一の位置次元しか扱わず、3D-RoPE には従うべき標準のリファレンス実装が存在しない。エージェントによるカーネル生成が可能だということは、カスタム NKI 開発の参入障壁が、下層ハードウェアの複雑さから想像されるよりも低いことを示している。
これはどの種類の事例か? 的を絞ったカーネル調整 vs. CUDA の置き換え
この道筋が競争上何を意味するかを理解するには、まず CUDA の堀とは何かを見極める必要がある。NVIDIA の CUDA 並列コンピューティングプラットフォームは 2007 年に初めてリリースされ、その後およそ 15 年分のライブラリ開発を積み上げてきた。行列演算には cuBLAS、深層学習のプリミティブには cuDNN、推論最適化には TensorRT、Transformer 専用の高速化には FlashAttention と Triton がある。PyTorch、TensorFlow、JAX といった主要な機械学習フレームワークは、いずれも CUDA を第一のターゲットとして最適化してきた。新しいアクセラレータが登場するとき、それが直面する世界では、開発ツールもベンチマークスイートも本番デプロイも、すべて CUDA を基準にしている。
これまで CUDA に挑んできた試みの多くは、幅で対抗しようとするものだった。同等規模のライブラリエコシステムをゼロから築くという発想だ。この道を通すには、フレームワーク統合とライブラリ開発に何年もかかるうえ、その間、新しいエコシステムがまだ対応していないワークロードは NVIDIA のハードウェアに残り続ける。NKI の戦略は違う。CUDA の汎用的な代替品を目指すのではなく、特定のワークロードにおける特定のボトルネック演算子を狙い、それらだけをカスタムカーネルに置き換え、残りはこれまで通り標準の Trainium コンパイラに任せる。結果として、特定のワークロードでは CUDA と競える性能を得ながら、エコシステム全体を移行する必要はない。これが的を絞った演算子の同等性だ。CUDA の幅を置き換えるのではなく、要求の厳しいワークロードを動かせるかどうかを左右する演算子において CUDA が持つ性能上の優位を、迂回するのである。
業界の分析はすでに、この道筋が非 NVIDIA ハードウェア採用のコストと便益の計算を変えると指摘している。Decart が AWS Trainium3 上で独自に報告した本番結果——同社によれば、フレーム生成速度が最大 4 倍、コストは同等の NVIDIA GPU 構成の半分——は、専用チップ上での的を絞った最適化が、エンジニアリング投資に見合うならば、該当するワークロードで性能差を埋められるという前提を裏づけている。Decart の Trainium 性能データは AWS の顧客ページからの引用である。
動画トークンを 8 で割り切れないコアに分割する
カーネル演算を正しく直したことで個々の演算の非効率は解消したが、第二の問題が残る。ワークロードを複数の NeuronCore にどう配分し、計算能力を無駄にせず、データレイアウトも壊さないか、という問題だ。Lingfan Yu は2 つの明白な戦略の間にある並列化のトレードオフの核心を説明している。テンソル並列(TP)は重み行列を複数のアクセラレータコアに分割する。大規模 Transformer モデルでは標準的な手法だ。しかし今回の作業で使う WAN 拡散 Transformer モデルは 12 個の attention ヘッドを持ち、Trainium チップ 1 基には 8 個の NeuronCore しかない。12 を 8 で割ると整数にならない。純粋な TP では、空いたスロットを埋めるために計算を空演算で埋めることになり、計算サイクルを無駄にする。シーケンス並列(SP)は重み行列ではなく入力シーケンスを分割する。これは別のトレードオフで、attention ヘッドの整合性の問題を避けられる。だが動画トークンは 3 次元構造(高さ、幅、時間)を持ち、シーケンスを任意の位置で分割すると、同じフレーム内の隣接トークンの関係が壊れる。「シーケンスの分割がちょうどフレームの境界に来ることは保証できません」と Yu は言う。「データは少なくともフレーム単位である必要がありますが、フレーム境界で分割すると、その演算は動きません」。チームは 2 つの並列戦略を同時に使った。TP で 4 つのコアに attention ヘッドを分割し、SP で 2 つのコアにフレーム境界でシーケンスを分割する——ここなら分割しても安全だと保証できる。この組み合わせは演算の正しさを保ち、動画トークンのレイアウトも維持し、純粋な TP の埋め草の無駄も避けた。さらに VAE デコーダ——拡散モデルの latent 出力をピクセルに戻す役割を担う——は幅軸に沿って空間分割し、8.25 倍の超線形な高速化を得た。空間分割によってコア間の冗長なデータ移動が減ったからだ。
ステージバッチ処理:2種類の異なるフォワードパスを1回の呼び出しに統合すべき理由
3つ目の最適化は、Rolling Forcing が必要とする2種類のフォワードパスの構造的な違いに対処するものだ。1つは計算負荷の高い拡散リファインメントを担うデノイズパス、もう1つは KV cache を管理するものの負荷は比較的軽いキャッシュ更新パスである。この2つを独立したフォワードパスとして実行すると、Trainium インスタンスのアーキテクチャに固有の利用率不足が生じる。単一の推論インスタンスは16個のチップにまたがり、各チップには8個の NeuronCore がある。実行ユニットは合計128個だ。キャッシュ更新パスを128個のユニットに分散させると、1ユニットあたりの作業量はごくわずかになり、インスタンスの計算能力の大半が遊んでしまう。チームはモデルコードを再構成し、両フェーズが共有するパイプラインコンポーネントを1回のバッチフォワードパスでまとめて実行し、デノイズ計算とキャッシュ管理ロジックが分岐する箇所でのみ枝分かれさせるようにした。Yu は Amazon Science の記事でこのトレードオフをこう説明している。「パイプラインの大部分は、まとめてバッチ処理されます。これは Trainium で特に有効です。1インスタンスに16個のチップがあり、各チップに8個のコアがあるからです。計算をあまりに多くのコアに分割すると、1回の呼び出しあたりの計算量が小さくなり、容量が無駄になります。」
これは AWS が NVIDIA に追いついたという意味か?
全体としてはそうではない。ただし、この種のワークロードに関して言えば、差は今やハードウェアの上限ではなくソフトウェアへの投資で決まる。NVIDIA の CUDA エコシステムは依然として広さでリードしている。15年かけて積み上げられたライブラリスタックが対応する演算の種類、モデルアーキテクチャ、開発者ワークフローの数は、現在の非 NVIDIA プラットフォームのどれよりも多い。標準的なモデルアーキテクチャを使い、通常のコンパイルパイプラインで開発するチームにとって、CUDA のソフトウェアエコシステムは依然として大きな優位性だ。Amazon Science のこの成果が示すのは別の話である。性能のボトルネックとなる演算を特定し、カスタム kernel に置き換えられるなら、Trainium と NVIDIA GPU のハードウェア差は的を絞ったエンジニアリングで埋められる。これが可能なのは、NKI が CUDA で NVIDIA tensor core を制御するのと同じ階層で NeuronCore ISA にアクセスできるようにしているからだ。直接的で、プログラマブルで、必要なら汎用コンパイラを迂回できる。今回の協業に参加した principal solutions architect の Yahav Biran は、テスト対象としての Rolling Forcing はアーキテクチャとして完結しているため、結果は一般化できると強調する。「堅牢なシステムにあるべき複雑さはすべて備えています。encoder、DIT、VAE、decoder。つまり基本的に、より堅牢なシステムに置き換えても、同じビルディングブロックが機能するのです」と Biran は公開記事の中で述べている。言外にあるのは、ここで開発された NKI の技術——動的 shape の処理、3D-RoPE のカスタム kernel、TP+SP のハイブリッドシャーディング、ステージバッチ処理——が Rolling Forcing 専用ではないということだ。これらは同じ構造的特徴を持つあらゆる自己回帰拡散モデルに適用できる、再利用可能な手法を成している。
Reactor とインタラクティブ AI の商業的賭け
この協業の商業的な背景は Reactor にある。このプラットフォームは AWS Neuron Science チームと共同でエンドツーエンドの結果を実証した。Reactor を創業したのは Alberto Taiuti と Bryce Schmidtchen で、前者は Luma AI の共同創業者兼 CTO、後者は Apple Vision Pro の技術責任者を務めた人物だ。Reactor は2026年5月に5900万ドルの資金調達を完了し、Lightspeed がリードし、WndrCo、Amplify Partners、Sky9 Capital、FPV Ventures が参加した。AWS は Reactor の戦略的クラウドプロバイダーであり、優先クラウドプロバイダーでもある。Schmidtchen はこのことの重みを率直に語る。「そう遠くない未来、すべてのピクセルがリアルタイムかつインタラクティブに生成されるようになります」と彼は言う。「物語全体を世界モデルがリアルタイムで生み出せるようになる。物語は反応し、あなたはそれと対話でき、いつでもシーン全体を変えることさえできる。」AWS のグローバルインフラと Trainium のロードマップは、インタラクティブ AI が消費者規模でもたらす推論需要にちょうど合致すると彼は述べている、Amazon Science の記事によれば。
Decart の Trainium 結果が独立した裏付けとなる
この研究は孤立した例ではない。Dean Leitersdorf と Moshe Shalev が創業したイスラエルの AI スタートアップ Decart——2人ともイスラエルの8200部隊(軍事情報部門)の出身——は、AWS Trainium3 上での本番環境の性能データを公表し、Trainium 上で的を絞った最適化を行えばリアルタイム動画ワークロードで NVIDIA との差を縮められるという前提を独立に裏付けた。
Decart の Lucy モデルは Trainium2 上で初回フレーム時間 40 ミリ秒を達成した。同社によれば、Trainium3 では生成速度が 4 倍になり、コストは同等構成の NVIDIA GPU の半分で済むという。CEO の Dean Leitersdorf は、Trainium3 のアーキテクチャがこのワークロードに「より高いスループット、より低いレイテンシ、より高いメモリ効率」をもたらすと述べている。同社によれば、Decart の DOS(Decart Optimization Stack)——同社がモデル向けに開発した推論最適化レイヤー——はエージェント推論で毎秒約 1600 トークンを実現しており、業界平均は 200 弱だという。
Decart は当初、完全に NVIDIA GPU 上で動いていた。ある会議で Amazon の担当者がこのチップを試してみないかと持ちかけ、テスト結果は期待を上回った。Leitersdorf はその後 Amazon の re:Invent での登壇に招かれたが、この舞台は通常、成熟したエンタープライズ企業にしか与えられない。以降、同社は累計 4 億 5000 万ドル超を調達している。その中には 2026 年 5 月の Decart の 3 億ドル B ラウンドも含まれ、企業価値は 40 億ドル近くに達した。投資家は Radical Ventures、NVIDIA、Sequoia Capital、Benchmark、Adobe Ventures、Toyota Ventures、そしてエンジェル投資家の Andrej Karpathy。2026 年 6 月時点で 10 万人を超える開発者が Decart のモデル上でアプリを構築しており、AWS Amazon Bedrock プラットフォームとの統合も果たしている。
Decart の性能値は同社自身が公表したもので、第三者による独立した監査は受けていない。NVIDIA 比で 4 倍のスループット、2 倍のコスト効率という主張は、この前提に立って読むべきだ。
Trainium Frontier コンテストと今後の展開
この手法は Amazon Science に掲載され、単発のエンジニアリング成功の記録ではなく、展開可能な取り組みの出発点として明確に位置づけられている。スライディングウィンドウ KV キャッシュにおける動的シェイプの扱い、3D-RoPE とキャッシュコピー操作向けの NKI ベースのメモリ kernel、TP+SP のハイブリッドシャーディング戦略——いずれも、より広範な自己回帰拡散モデルの移植に参考になる粒度で記述されている。こうしたモデルは今や、最も要求の厳しいリアルタイム AI アプリケーションを支えている。
AWS は Trainium の開発者エコシステムにも直接投資している。Trainium Frontier コンテストの告知の応募締め切りは 2026 年 9 月 30 日で、研究チームが Trainium ハードウェア上で新しい言語モデル学習技術を開発することが求められる。上位 3 チームにはそれぞれ 25,000 ドル、10,000 ドル、5,000 ドルの賞金が贈られ、2026 年 12 月にオーストラリア・シドニーで開催される NeurIPS 2026 期間中の Annapurna Labs 研究イベントで発表される。
推論インフラを検討しているクラウド顧客にとって、この結果は非常に具体的な問いを突きつける。Rolling Forcing のようにアーキテクチャが完全に作り込まれたモデルが、的を絞った kernel 最適化によって Trainium 上でリアルタイムのフレームレートに到達できるのなら、NVIDIA ハードウェアが必須とされてきた他のワークロードのうち、同じことが当てはまるものはどれだけあるのか。AWS Neuron Science チームの答えはこうだ。同じ KV cache アーキテクチャ、同じ回転位置エンコーディング構造、あるいは同じ段階的差別化フォワード設計を共有する自己回帰拡散モデルなら、すべて該当する。これは小さなカテゴリではない。
よくある質問
これは AWS Trainium が AI 推論で NVIDIA に追いついたという意味か?
自己回帰拡散の動画モデルに限れば、性能差を決めるのは今やハードウェアの限界ではなく、的を絞ったソフトウェア投資だ。ここで示された NKI kernel の最適化——3D-RoPE、KV cache 管理、ハイブリッドシャーディング、段階的バッチ処理——によって、Trainium2 はこれまで NVIDIA ハードウェアに依存せざるを得なかったワークロードの一種でリアルタイム性能に到達した。より広い AI 推論の構図で見れば、CUDA が 15 年かけて積み上げたライブラリエコシステムは依然としてカバレッジで優位に立つ。NKI という道はそのエコシステムを置き換えるものではなく、カスタム kernel を手書きできる特定の演算子において CUDA の優位を迂回するものだ。Decart が自社で公表した Trainium3 の結果(同等の NVIDIA 構成比でフレームスループット 4 倍、コスト効率 2 倍)は、最適化に投資する意思のある事業者にとって、ハードウェアの限界は制約要因ではないことを示している。Amazon Science の NKI の詳細な結果は手法とともに公開されている。Decart の Trainium3 導入事例は AWS の顧客ページで確認できる。
Neuron Kernel Interface(NKI)とは何か、標準の Trainium コンパイルとどう違うのか
NKI は、AWS が NeuronCore 向けに提供する低レベルプログラミングインターフェースだ。NeuronCore は Trainium チップ内部の計算ユニットにあたる。標準の Trainium コンパイルは neuronx-cc コンパイラを使い、モデルの演算子を自動で NeuronCore 命令に変換する。よくある演算子には効率的だが、3D-RoPE のような特殊なメモリアクセスパターンは最適化できない。NKI を使えば、Neuron Kernel Interface のドキュメントページから NeuronCore の命令セットアーキテクチャにアクセスし、カスタム kernel を書いて、データがメモリと計算エンジンの間をどう流れるかを細かく制御できる。これにより、ボトルネックになっている特定の演算子を手作業でチューニングした実装に差し替えつつ、ネットワークの残りの部分は標準パイプラインに載せたままにできる。
自己回帰拡散動画モデルとは何か、なぜリアルタイム性能が要るのか
自己回帰拡散モデルは、2 つの生成手法を組み合わせている。大規模言語モデルがフレームを 1 枚ずつ順に予測するスタイルと、拡散モデルが反復的にノイズを除去して仕上げる方式だ。この組み合わせにより、ユーザーの実世界からの入力——コントローラーの方向、キー操作、音声指示——を取り込んで次のフレームの生成結果に反映できるようになり、モデルは事前レンダリングではなく本当の意味でインタラクティブになる。そのインタラクティブ性は、目標フレームレートが定める締め切りまでに各フレームを生成しなければならないことを意味する(滑らかな再生には少なくとも 16 fps が必要)。間に合わなければ体験は明らかに悪化する。この制約こそがリアルタイム動画推論を通常のオフライン動画生成と分かつものであり、自己回帰拡散モデルの計算需要が標準的な動画生成よりはるかに厳しい理由でもある。Rolling Forcing ICLR 2026 論文は、このアーキテクチャを評価したい研究者向けにオープンソース化されている。
NKI kernel の技術は Rolling Forcing 以外のモデルにも使えるのか
使える、と AWS Neuron Science チームは言う。彼らが開発したこれらの技術——スライディングウィンドウ KV cache 向けの動的形状処理、カスタム 3D-RoPE メモリ kernel、テンソル並列とシーケンス並列を組み合わせたシャーディング、そしてデノイズと cache 更新という 2 段階のバッチ処理——は、Rolling Forcing のアーキテクチャ専用ではない。同じ構造的要素を使う自己回帰拡散モデルならどれにでも当てはまる。すなわち、アテンション長が可変のスライディングウィンドウ KV cache、複数の空間軸・時間軸に沿った回転位置エンコーディング、2 段階のフォワードパス構造だ。Amazon Science のこの記事が NKI の汎用性を詳しく説明しており、Trainium Frontier コンテストの応募ページ(締め切り 2026 年 9 月 30 日)は、まさにこうした拡張を促すために設けられている。
ⓒ 2026 TECHTIMES.com 無断転載を禁じます。