我们用开源 AI 安全 agent 找到 24 个 Android 漏洞的经历
GitHub Security Lab 用 YAML 定义的 taskflow 引导 AI 审查 Android 应用,报告了 24 个漏洞,包括 OsmAnd 的静默位置追踪和 Wikipedia 应用的账号接管链;但每条发现都靠人复核。
中文
复制
随着 AI 在安全领域的兴起,我们团队创建了 GitHub Security Lab Taskflow Agent,让安全研究员可以轻松把自己觉得好用的 AI 提示词和工作流自动化、打包并分享出去。这篇文章里,我会介绍自己如何编写审计任务流,用来发现 Android 应用中的漏洞。
新模型理解代码的能力在不断提升,但自定义任务流的提示词能让安全研究员引导模型——把研究拆成一步步的小任务,帮助 LLM 更快找到复杂漏洞,或者找到它原本完全会漏掉的漏洞。
借助这些任务流,我已经在 Android 应用中报告了 20 多个漏洞。新漏洞披露的时间可以关注我们的公告页面。想直接看例子的话,下面继续,我会给出几个这些任务流发现的高危漏洞实例。
如何在自己的项目上运行这些任务流
想马上上手?这些任务流是开源的,自己跑起来很简单。请注意:需要 GitHub Copilot 许可证,提示词会消耗高级模型请求。运行任务流可能产生大量工具调用,很容易消耗掉大量 token。
- 前往 seclab-taskflows 仓库,启动一个 codespace。
- 等几分钟,让 codespace 完成初始化。
- 在终端中运行
./scripts/audit/run_mobile.sh myorg/myrepo
在中等规模的仓库上,跑完可能要一两个小时。结束后会自动打开一个 SQLite 查看器显示结果。打开 “audit_results” 表,找 “has_vulnerability” 列带勾选标记的行。
我的同事 Peter 和 Mo 之前写过一篇博客文章,介绍他们的审计任务流。那些任务流本身已经很好用,但 Android 应用有自己特有的漏洞类别,我们希望任务流能重点关注,所以需要加以引导。
首先,我加了一个叫 gather_mobile_entry_point_info.yaml 的任务流。入口点是指代码中攻击者可控数据可能流经的位置。这个任务流会接收入口点,把它们分成移动端入口点和非移动端入口点。这样 AI 就能处理包含多种应用类型的仓库——移动应用、Web 服务器、桌面应用——同时仍然理解正确的攻击面。
其次,我修改了 classify_application_local.yaml。在其中我列出了一批常见漏洞类别,要求 LLM 结合每个入口点和组件逐一考虑。移动应用的漏洞相对不那么广为人知,而 LLM 又是非确定性的,所以必须确保它检查某些关键漏洞类别。比如,如果上一步任务流识别出一个基于 intent 的入口点,那么它就应该有一份常见的基于 intent 的漏洞清单去逐一检查,例如 confused deputy 或不安全广播。这能帮助 LLM 发现组件之间的关联,并始终把握整体威胁模型。
把两种 prompt 结合、多次运行,就能各取所长:严格的 prompt 加上反复运行,保证明显的漏洞不会被漏掉;宽泛的 prompt 则让 AI 充分发挥创造力。
任务流发现的两个漏洞实例
本节展示两个由任务流发现、且已经披露的漏洞。到目前为止,我们共发现并报告了 24 个漏洞。
通过 OsmAnd 跟踪用户
OsmAnd 是一款流行的第三方导航应用,以 Open-Street-Map 为主要数据源。它在 App Store 和 Play Store 上均有上架,这里我们看 Android 版本,下载量超过 1000 万。本节介绍所发现的三个漏洞中最有意思的一个:恶意应用可以借此跟踪设备位置。
OsmAnd 导出了一个名为 MapActivity 的 activity。Android 的 activity 是应用中一个独立的、聚焦的界面,为用户提供可交互的 UI。MapActivity 负责处理应用内打开设置文件和 deeplink 的操作,并且是导出的。导出的 activity 指可以被自身应用之外的组件启动的 activity。
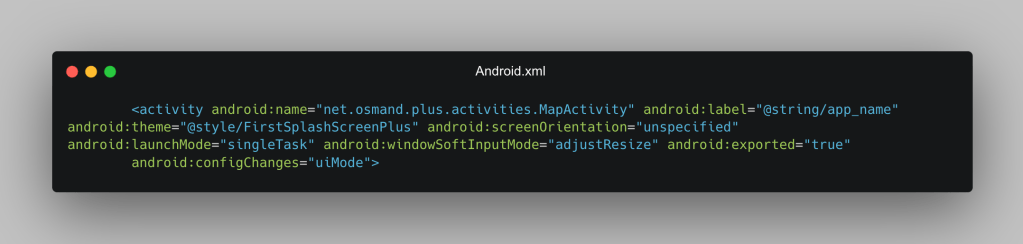 但在打开设置文件时,应用允许传入 intent extras(
settings_version、silent_import、replace、export_type_list_key)。Intent 是 Android 中的消息对象,用于向另一个应用组件请求执行某个操作;intent extras 则是附加在 intent 上的键值对数据,用来随请求传递信息。MapActivity 只预期这些 extras 来自某个 AIDL 服务。它们本应通过进程内通道传递,而不是 intent extras,因为任何应用都可以向任何导出 activity 的任何 intent 放入任意 extras。Android 没有提供任何机制来限制外部调用者能设置哪些 extras。
由于 MapActivity 是导出的,任何应用都可以向该 activity 发送一个 intent,并附带我们想要的任意 extras,其中包括能让我们在用户毫无察觉的情况下向应用导入设置的 intent extras。该 Android 应用使用 handleOsmAndSettingsImport 函数导入以下设置:
- SilentImport:允许在无通知的情况下导入
- Replace:允许替换设置,而不只是添加
- SettingsTypes:允许在无用户确认的情况下导入
private void handleOsmAndSettingsImport(Uri intentUri, String fileName, Bundle extras) {
 fileName = fileName.replace(ZIP_EXT, "");
 if (extras != null && CollectionUtils.containsAny(extras.keySet(),
 SETTINGS_VERSION_KEY, SETTINGS_LATEST_CHANGES_KEY)) {
 int version = extras.getInt(SETTINGS_VERSION_KEY, -1);
 String latestChanges = extras.getString(SETTINGS_LATEST_CHANGES_KEY);
 boolean replace = extras.getBoolean(REPLACE_KEY); // ← attacker-controlled
 boolean silentImport = extras.getBoolean(SILENT_IMPORT_KEY); // ← attacker-controlled
 ArrayList<String> exportTypeKeys =
 extras.getStringArrayList(EXPORT_TYPE_LIST_KEY); // ← attacker-controlled
 List<ExportType> exportTypes = null;
 if (exportTypeKeys != null) {
 exportTypes = ExportType.valuesOf(exportTypeKeys);
 }
 handleOsmAndSettingsImport(intentUri, fileName, exportTypes,
 replace, silentImport, latestChanges, version);
 } else {
 handleOsmAndSettingsImport(intentUri, fileName,
 null, false, false, null, -1); // safe defaults
 }
}
既然现在可以导入任意设置,我们就能做出几处关键改动,比如替换地图上的瓦片。OsmAnd 为每个瓦片生成的 URL 格式如下:
return MessageFormat.format(urlTemplate, zoom + "", x + "", y + "");
默认情况下 OsmAnd 使用本地瓦片,不过我们可以用下面的 URL 覆盖默认的瓦片文件:
这样一来,每个瓦片的精确 x、y 坐标都会泄露出去。该 URL 要求响应中必须包含对应瓦片的图片,因此我们在攻击者服务器的后端返回 OpenStreetMaps 上相应的瓦片。攻击者由此拿到用户在 OsmAnd 应用中加载过的所有瓦片的 x、y 坐标列表,而用户对应用设置已被篡改一无所知。任何应用,哪怕没有任何权限,都能借此覆盖 OsmAnd 的设置,把私密的位置数据回传到攻击者服务器。
# [TILE #1] 14:23:07 z=15 x=9649 y=12320
# ├── center: 40.70979, -73.98743
# └── 🗺️ https://www.openstreetmap.org/#map=15/40.70979/-73.98743
利用同一个漏洞,我们还能拿到用户在 OsmAnd 上每次导航的起点和终点,同样回传到攻击者服务器,用户不会察觉到任何异常。
[ROUTE #1] 07:02:47 vehicle=car waypoints=2
 ├── path: /osrm/car/-122.084,37.4219983;-122.32450103759766,37.99944305419922
 ├── 📍 ORIGIN: 37.421998, -122.084000
 │ https://www.openstreetmap.org/#map=15/37.42200/-122.08400
 ├── 🏁 DESTINATION: 37.999443, -122.324501
 │ https://www.openstreetmap.org/#map=15/37.99944/-122.32450
通过 deeplink 接管 Wikipedia 账号
接下来看 Wikipedia Android 应用,用户可以在手机上用它浏览 Wikipedia。为了在应用内打开 Wikipedia 网页,Wikipedia Android 应用注册了 wikipedia:// deeplink 的钩子来唤起应用。例如,一个 deeplink 可能长这样 wikipedia://wikipedia.org/wiki/PoC。但主机名解析中的一处逻辑漏洞让我们可以加载非 Wikipedia 的 URL。
 private fun handleIntent(intent: Intent) {
 if (Intent.ACTION_VIEW == intent.action && intent.data != null) {
 // TODO: handle special cases of non-article content, e.g. shared reading lists.
 intent.data?.let {
 if (it.authority.orEmpty().endsWith(WikiSite.BASE_DOMAIN)) {
 // Pass it right along to PageActivity
 val uri = Uri.parse(it.toString().replace("wikipedia://", WikiSite.DEFAULT_SCHEME + "://"))
 startActivity(Intent(this, PageActivity::class.java)
 .setAction(Intent.ACTION_VIEW)
 .setData(uri))
 }
 }
 }
 }
有了这个原语,我们就能用 wikipedia:// deeplink 把用户引到任意我们选定的网站,让用户以为自己还在 Wikipedia 页面上,实际上页面已被攻击者控制。此外,攻击者还能在应用的 WebView 中执行任意 JavaScript——这是个危险的原语,等于给了攻击者一个进入通常被认为安全的环境的入口。这个漏洞模式在同一个应用里出现了不止一次,而是两次:
// SharedPreferenceCookieManager.kt:101
if (domain.endsWith(domainSpec)) {
 buildCookieList(cookieList, cookiesForDomainSpec, null)
}
第二段代码检查某个页面是否应该携带来自 wikipedia.org 的 cookie。把这两个问题结合起来,我们就能泄露 Wikipedia 页面上的所有 cookie,而这些 cookie 都是长期有效的。
把这两个漏洞串起来,就能实现一次威力十足的账号接管。
- 受害者在浏览器中访问一个包含 deeplink 的恶意网页并点击。
- Wikipedia Android 应用自动打开,加载一个以 wikipedia.org 结尾的攻击者可控页面,例如 evil-wikipedia.org。受害者以为这是 Wikipedia 上的页面,应用则自动发送用户的 cookie。攻击者由此拿到受害者的用户名、长期 token,以及在整个 Wikimedia 各项目(所有 Wikipedia、Commons、Wikidata、Meta 等)通用的会话 token。
这些例子说明,LLM 能找到具有严重影响的逻辑漏洞,而不只是泛泛的漏洞类别。
LLM 擅长发现漏洞,却难以评估严重程度
LLM 擅长发现漏洞,甚至能找到影响不大的低危 bug。很多时候,我发现 AI 返回的问题需要非常特定的状态,在现实场景中几乎不可能出现。此外,即便明确要求它不要报告低危漏洞,它也常常照报不误。因此,每一条发现都应由了解移动应用的安全研究员复核。
我们发现的另一个问题是,漏洞的严重程度经常被错误估计。漏洞的实际影响往往因缓解因素而改变,从而降低其严重程度。
以 Android 应用中的路径遍历为例,如果文件路径被限制在外部存储内,这类问题的相对严重程度就很低。若不明确提示“构造 PoC”,LLM 很难看出这类缓解因素;这不仅要求多次运行来发现漏洞,还要多次运行来构造 PoC,迫使 LLM 尝试利用该漏洞。取决于模型的可用性和速度,这会让模型把额外时间花在可能影响并不大的漏洞上。
即便如此,LLM 仍然可能出错。例如,如果应用同时使用内部存储和外部存储的数据,内部存储的数据往往优先级更高。LLM 可能会想当然地认为,来自外部存储的数据——也就是我们可以通过路径遍历写入的那部分——会改变应用的实际数据。但如果内部存储会覆盖我们控制的这份外部数据,那就根本不存在漏洞。这类复杂行为会导致误报,而随着 LLM 的上下文越来越大、推理能力越来越强,误报会逐渐减少。但就目前而言,解决这些问题的唯一办法,是给 LLM 一个调试器去运行概念验证代码和原始代码,或者由研究员在提示中引导 LLM 专门排查这类问题。
LLM 对 API 行为有很深的了解
任何专攻某门语言的安全研究员都熟悉常见的代码模式:哪些函数安全,哪些不安全。比如在 Go 中,使用 path.Clean 远比使用 filepath.Clean 危险,而且常常是许多影响热门产品 Windows 版本的漏洞的根源。让我们意外的是,即便拿不到语言源码,LLM 也能很好地理解各种语言中与安全相关的常见 API 的行为。我们让 LLM 在拿到漏洞报告后生成的大多数概念验证代码,几乎不需要我们这边做多少修改,这说明它对以往的安全漏洞利用和 API 行为有深入的了解。
关于结果的说明
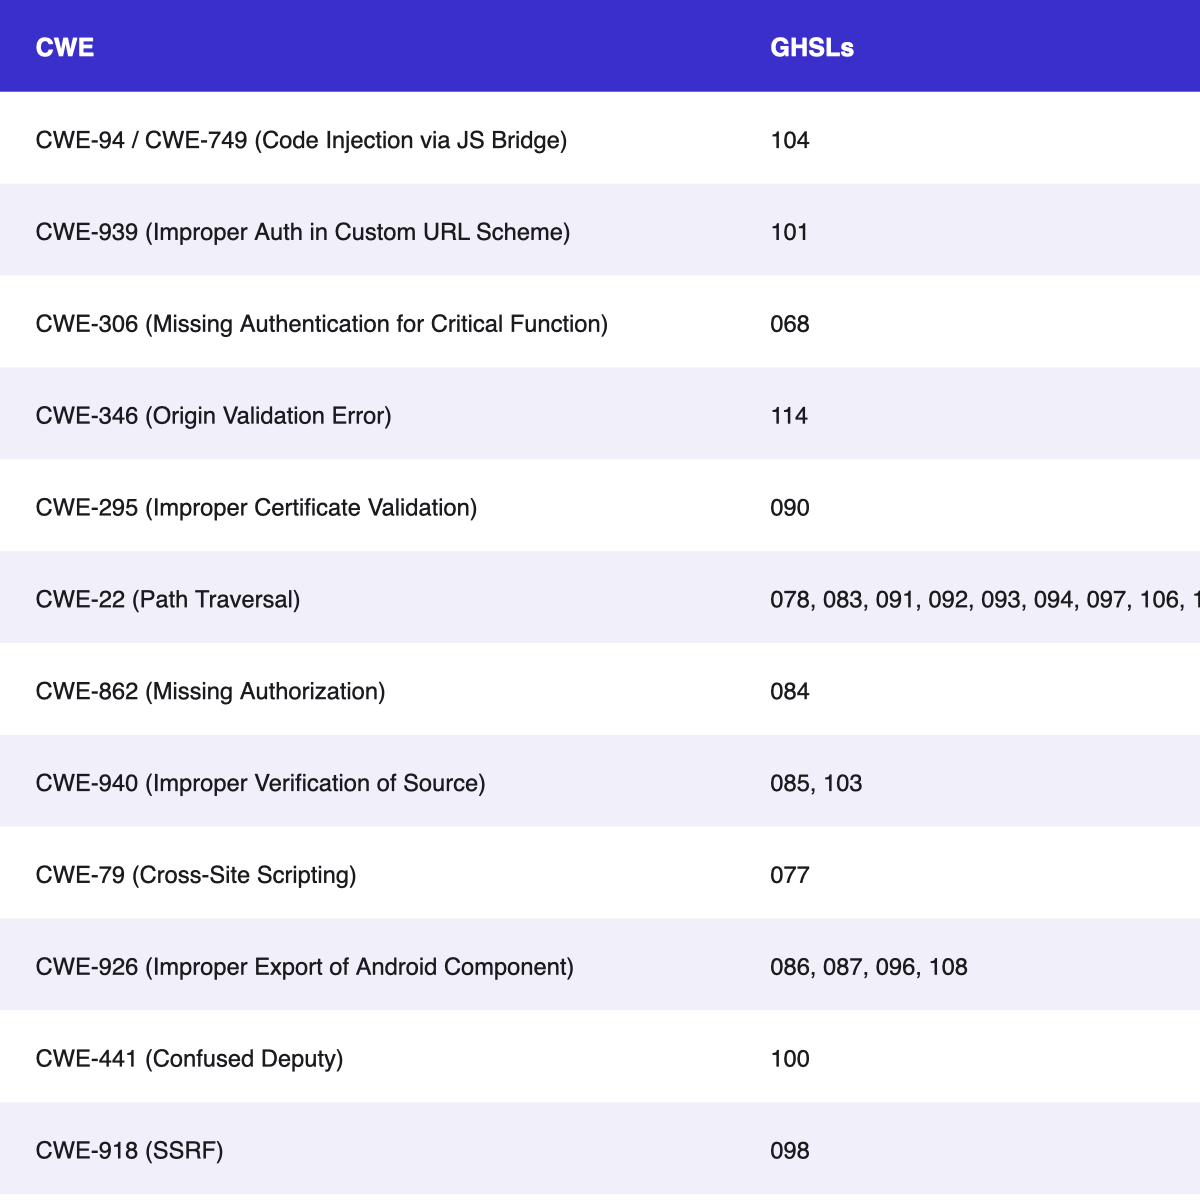
写这篇博客时,我们在移动应用中发现了 24 个 Android 漏洞。很多情况下,我们找到的是路径遍历这类简单漏洞。我们也发现了少数几个严重漏洞,其中一些已在这篇博文中介绍过。由于 Android 应用的安全性已经相当强,这些漏洞的类型恰好落在安全研究员预期会出现的位置,比如 WebView 中的跨应用脚本执行,或者暴露的 JavaScript bridge。
我们认为,AI 驱动的安全研究是目前保护开源项目的最佳方式之一,其能力可覆盖 Web 应用、移动应用以及桌面应用。
结语
我们坚信,安全应当成为所有开源维护者的头等大事;我们也知道,未来几年 AI 将成为所有维护者不可或缺的工具,无论是用于开发还是安全。[seclab-taskflow-agent](https://github.com/GitHubSecurityLab/seclab-taskflow-agent) 能帮你在几分钟内上手安全,也欢迎那些发现了用 AI 查找漏洞的有趣而独特的提示词、工具和机制的人来贡献。