鱼与熊掌兼得:在搜索中保持可发现性,同时禁止 AI 训练
Cloudflare 推出 Disallow AI Training 设置,让网站可拒绝 AI 训练爬虫却保留搜索收录,Apple、Google、Microsoft 已承诺遵守。
中文
复制
没有适当的控制机制,网站所有者长期面临一个两难选择:要么允许自己的内容被用于 AI 训练,要么冒着在搜索中失去曝光度的风险。这个两难之所以存在,是因为互联网上一些最大的组织使用的是混合用途爬虫:同一个爬虫既服务于搜索,也服务于 AI 训练。拒绝其中一个,就等于拒绝了另一个。今天,Cloudflare 宣布了一项新的 Disallow AI Training 设置,让你可以轻松保持被搜索收录,同时拒绝同一个爬虫用你的内容进行训练。Apple、Google 和 Microsoft 已经遵守、或已承诺(在指定时间范围内)遵守这一设置。混合用途爬虫是训练问题上最难的部分。接下来是 AI Summaries。全站一刀切的同意或拒绝过于粗糙:你的内容有多少出现在摘要里,和它是否出现同样重要。针对 AI 摘要的退出选项,已经是我们对混合用途爬虫运营方提出的要求之一。我们的目标是在明年初让你能够控制自己的内容被纳入多少——在 Cloudflare 上设置一次,而不必分别找每个运营方。
为什么光靠“请求”不够
大多数网站所有者希望被找到:被人、被 agent、被(好的)bot 找到。但开放互联网中有相当一部分是靠广告、订阅或与访客的直接关系来支撑的,而这些模式只有在真的有人访问时才有收益。几乎所有网站所有者都认为 Search 有益:Cloudflare 上不到 1% 的网站选择屏蔽 Search bot。训练则是另一回事:17% 的网站选择启用某种机制来屏蔽训练。正因如此,我们认定网站所有者需要更细粒度的控制,而不是一刀切的“Block AI”。单靠一条 robots.txt 指令解决不了这个问题。谁都可以发布一条,但它无法识别是谁在爬、为什么爬,也拦不住无视它的爬虫。网络可以解决:我们发布偏好,识别是谁在爬,判定他们为什么爬,并屏蔽那些无视偏好的——然后在 Radar 上报告每个运营方的实际行为。但屏蔽只是移除一个爬虫,并不会改变爬虫的行为方式。更好的结果是运营方根本不让你做这道选择题。所以从 7 月起,我们一直在直接与他们沟通。反馈令人鼓舞:几乎所有人都认同,网站所有者应当对自己的内容如何被使用拥有控制权和透明度,并且应当确信自己的选择会得到尊重。为了帮助网站所有者了解这一点,我们设立了一个称号:Accountable。Accountable 称号既认可当前已经具备的能力,也认可交付这些能力的具体承诺。要获得这一称号,bot 运营方必须满足或承诺满足以下要求:
- 站点所有者可通过 robots.txt 或类似标准选择退出 AI 训练的机制。
- 站点所有者可直接向运营方声明、并在明年通过 Cloudflare 选择退出 AI 摘要的机制(详见下文)。
- URL 级别的可见性,可查看哪些页面被用于训练,以及内容在搜索中如何呈现的指标。
- 确保退出 AI 训练不会影响传统搜索结果的承诺。
Apple、Google 和 Microsoft 均证明自己符合 Accountable 的资质要求。它们都把当下已有的能力与针对仍在开发中的能力的限期承诺结合在一起。这三家公司爬虫的细节见下文。
新的安全设置选项
Cloudflare 按行为对机器人分类,而同一个机器人可能表现出不止一种行为。可作为控制项的行为有三种:
- Search——抓取以构建搜索索引。
- Training——抓取以训练或微调模型。
- Agent——代表人类访问页面的用户导向型 agent,例如聊天抓取机器人和浏览器使用 agent。
混合用途爬虫是同时执行 Search 和 Training 的单一爬虫。不加控制的话,这种组合就会造成上文所述的取舍:站点所有者无法只拒绝其中一种用途而不拒绝另一种。为避免屏蔽 Accountable 混合用途爬虫——也就是不会把这种取舍强加给网站所有者的那些爬虫——我们推出了一项新设置:Disallow AI Training。Disallow AI Training 得名于它在你的 robots.txt 中发布的 Disallow: 指令。
“Block”设置的含义已不同以往
Block 和“Block on pages with ads”此前不适用于混合用途爬虫,因为屏蔽它们也可能影响搜索可发现性。现在我们有了新的 Disallow AI Training 设置,Block 和“Block on pages with ads”适用于所有训练爬虫,包括混合用途爬虫。Training、Search 和 Agent 控制项在域名级别生效。加上 Disallow AI Training 之后,可用的设置如下:
- 允许:除非被其他设置或 WAF 规则拦截,否则所有爬虫均可访问。
- 禁止 AI 训练:Bot Preference Sync 会将适用的禁止训练偏好写入 robots.txt。可问责的混合用途爬虫仍可访问以用于搜索。其他所有训练爬虫一律拦截,包括 Amazon、Anthropic、Meta 和 OpenAI 运营的纯训练爬虫——拦截这些爬虫不影响搜索。禁止 AI 训练仅作为 Training 的设置提供,不适用于 Search 或 Agent。
- 在含广告页面上拦截:仅在检测到正在投放广告的页面上拦截爬虫,包括混合用途爬虫。
- 拦截:拦截所有爬虫,包括混合用途爬虫。
禁止 AI 训练的实现方式是在 robots.txt 中写入偏好。仅针对广告的偏好无法用这种方式表达:Cloudflare 能检测出哪些页面投放了广告,但这份列表太大、变动太频繁,无法逐一写进 robots.txt。因此没有“在含广告页面上禁止 AI 训练”这一选项。Agent 不会像混合用途爬虫那样造成搜索可见性上的取舍,而且互联网目前还没有成熟的指令标准来向 Agent 表达禁止偏好。现阶段我们不为 Agent 提供禁止设置。等 ai-prefs 等标准成熟后,我们会重新考虑这一做法。
9 月 15 日有哪些变化?
我们将对 Bot Management 和 AI Crawl Control 做以下调整:
- 拦截和在含广告页面上拦截现在也适用于混合用途爬虫,包括 Applebot、Bingbot 和 Googlebot,因此这两种设置都会同时影响搜索和训练。若只想阻止训练、_保留_搜索,请使用禁止 AI 训练。
- “Block AI Bots”将被弃用,改用粒度更细的 Search、Training 和 Agent 控件。
- Managed Robots.txt 将被弃用,改用 Bot Preference Sync。已启用 Managed Robots.txt 的客户将迁移到新系统。
- 禁止 AI 训练将成为某些新域名的推荐配置之一。
- 现有客户的偏好将按下文所述迁移到新控件。
你需要做什么
几乎什么都不用做。现有设置会自动沿用。如果你想让混合用途爬虫彻底消失,现在必须明确表态。选择 Block。它会阻止 Applebot、Bingbot 和 Googlebot 访问你的站点——包括搜索在内。
从未使用过 Search/Training/Agent 控件的现有域名
从未配置过更细粒度控件的站点所有者,将根据其原有的 Block AI Bots 设置迁移到新设置:
| (旧版)“Block AI” 设置 | (新版)Search 设置 | (新版)Training 设置 | (新版)Agent 设置 |
|---|---|---|---|
| 已禁用(未勾选) | Allow | Allow | Allow |
| Block | Allow | Disallow AI Training | Block on pages with ads |
| Block on pages with ads | Allow | Disallow AI Training | Block on pages with ads |
此前配置过 Search/Training/Agent 控件的现有域名
对于此前配置过细粒度控件的域名,我们会在新定义下保留其选择的实际效果。此前 Training 选择 Block 或 Block on pages with ads 的,将迁移为 Disallow AI Training。
| 控件 | 旧版设置 | 新版设置 |
|---|---|---|
| Search | Allow | Allow |
| Block | Block | |
| Block on pages with ads | Block on pages with ads | |
| Training | Allow | Allow |
| Block | Disallow AI Training | |
| Block on pages with ads | Disallow AI Training | |
| Agent | Allow | Allow |
| Block | Block | |
| Block on pages with ads | Block on pages with ads |
对新域名的建议
从 9 月 15 日起,新接入域名的客户将获得两种预设配置之一,具体取决于站点是否通过广告赚钱。广告收入取决于真人是否看到了页面。Training 用一条答案取代了这次访问;agents 抓取页面时,没有人在那里看广告。因此,面向广告支持型站点的预设更为严格。你可以在接入过程中或之后的任何时间更改这些设置。
| 设置 | 网站不通过广告变现 | 网站通过广告变现 |
|---|---|---|
| Preference Sync | 启用 | 启用 |
| Search | 允许 | 允许 |
| Training | 允许 | 禁止 AI 训练 |
| Agent | 允许 | 在含广告页面屏蔽 |
新域名的推荐设置
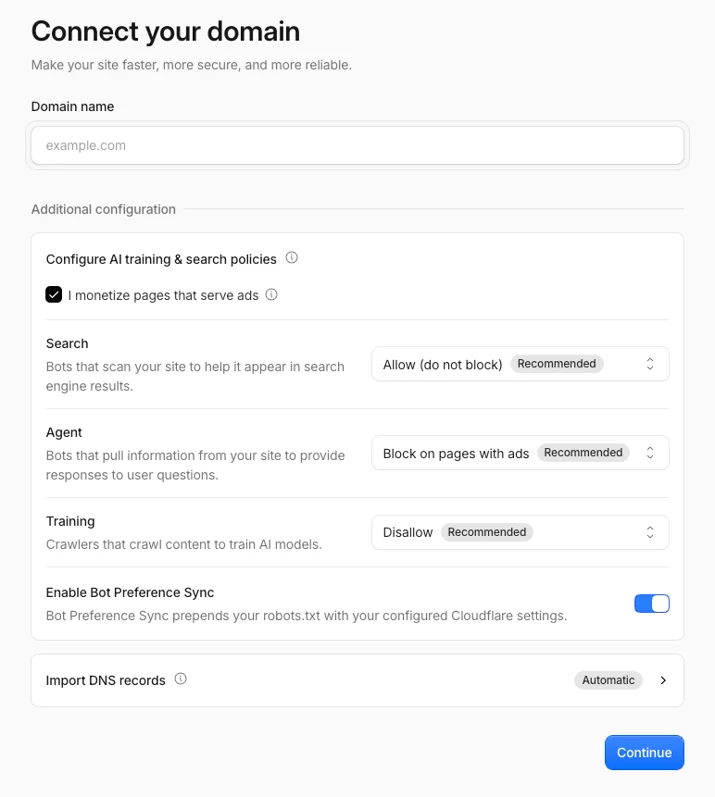
新域名引导流程截图,展示勾选“我对含广告页面进行变现”时的推荐设置。
这对特定的混合用途爬虫意味着什么?
Applebot、Bingbot 和 Googlebot 属于 Accountable。Apple、Google 和 Microsoft 都承诺遵循同样的原则:发布者自主选择、流程透明。在“禁止 AI 训练”下,它们仍可为搜索继续抓取你的网站;选择“屏蔽”则完全停止抓取。
我们同样把 Amazon、Anthropic、Meta 和 OpenAI 的相关爬虫归入 Accountable。这些公司把搜索爬虫和训练爬虫分开,因此 Cloudflare 可以屏蔽训练爬虫而不影响搜索。
Applebot
网站所有者可以在 robots.txt 中为“Applebot-Extended”添加 Disallow 规则,从而退出训练。目前,网站所有者还可以通过页面 HTML 中的 nosnippet 指令表达对 AI 摘要的偏好。内容也可以标记为付费墙内容,从而排除在生成式输出之外。Applebot 尚未提供 URL 级检查工具。不过我们已与他们的团队会面,他们分享了明年将推出的解决方案的细节。Apple 还表示,禁止训练不会影响搜索排名。
Googlebot
网站所有者可以在 robots.txt 中为“Google-Extended”添加 Disallow 规则,从而退出训练;Google 还在其网站管理员门户中提供了开关,可将网站内容排除在生成式搜索结果之外。Googlebot 还向网站所有者提供搜索结果和 AI 摘要结果的指标与报告。Google 分享了现有及近期上线的控制措施,以及他们正在开发的功能,包括面向网站所有者的、与 Google-Extended 相关的更多 URL 级透明度工具,预计将在未来几周内推出。Google 还表示,禁止 Google-Extended 不会影响搜索排名。
Bingbot
Bingbot 在 Webmaster Tools 中提供了细粒度的控制与透明度。目前,站点所有者可以通过 Bing 的 NOARCHIVE meta 标签 表达 AI 训练偏好。Microsoft 正在扩展这些能力,目前正在构建相应机制,以便在域名/站点级别也尊重 robots.txt 中的“禁止训练”偏好,目标是在 2027 年初推出。对于希望立即在 Bing 中选择退出训练的 Cloudflare 客户,除了使用 NOARCHIVE 标签外,站点所有者还可以使用 Block URLs or Content Removal tool。Microsoft 还表示,使用 NOARCHIVE 不会影响搜索排名。
在该支持推出之前,选择 Disallow AI Training 不会通过 robots.txt 自动向 Bing 传达禁止训练的偏好。这与之前的 Training Block 设置的实际行为相同,后者不适用于 Bingbot 等混合用途爬虫。
持续进展
随着这些能力不断演进,我们将继续联系并接触所有 AI 爬虫运营方。Cloudflare Radar 公开追踪 Accountable 爬虫运营方提供的控制、透明度和报告。
要让互联网变得更好,双方都需要有自主权:爬虫需要访问开放网络,而创造这个网络的人需要对他们的作品如何被使用拥有有意义的控制权。今天的公告代表着朝着这种平衡迈出的切实进展。
进展需要基础设施提供商、内容创作者、科技公司以及 Internet Engineering Task Force(IETF)等标准组织共同努力,将这些原则转化为开放、可互操作的标准。
下一步:AI Summaries
训练和 AI Summaries 给站点所有者带来了不同的问题。训练关注的是内容能否被用于构建 AI 模型。摘要则影响人们如何发现、评估并最终访问一家企业。两者都很重要,但它们对企业的影响方式不同。
选择退出 AI 摘要的控制是第一步。被认定为 Accountable 的运营方要么已经提供该能力,要么正在完成相关工作以提供该能力,从而确立了一个重要基线:站点所有者可以说“不”。
但全站范围内一刀切地允许或禁止摘要,仍然是个粗放的做法。正确的决定取决于站点、内容以及商业目标。对出版商来说,训练引发的是一系列根本性问题:控制权、补偿,以及原创内容能否持续。摘要则带来另一个、往往更紧迫的分发问题:用户是去访问出版商的网站,还是在搜索或 AI 体验里就把答案消费掉了?对许多其他企业而言,AI 摘要正越来越多地横在潜在客户与网站之间。它可能回答问题、比较选项、推荐产品,或者直接帮人决定要不要访问。
数据反映出的影响是混合的。超过一半的消费者会在 Search 中阅读摘要,而这些人读完摘要后结束搜索的可能性高出 40% 以上。这会减少网站获得的访问量。但由 AI Search 引荐来的消费者,其转化率是传统搜索引荐者的三倍到五倍以上。AI 可能带来更少的访问,但送来的客户购买意图强得多。
这本身谈不上好或坏。靠广告变现的出版商可能追求受众规模。零售商可能更想要数量更少但更可能下单的访客。Cloudflare 的角色不是替他们做选择,而是提供做出知情决定所需的可见性和控制力。
摘要退出机制是一个有力的起点,但不是终点。我们接下来的重点是帮助站点所有者理解摘要如何影响他们的业务,并让他们对自己的内容能被使用多少拥有更多控制权。像 ai-prefs 这样的开放标准,将是实现这一点的关键一环。
如果你想在这场讨论中发声,或提供反馈,请联系 crawlercontrols@cloudflare.com。
这些新控制项对所有客户、所有套餐开放,可在域(zone)的安全设置中配置。