魚と熊の手を同時に得る:検索での発見可能性を保ちながらAIトレーニングを禁止する
CloudflareがAIトレーニングを拒否する設定を導入、AI学習クローラーを拒否しつつ検索インデックスは維持、Apple、Google、Microsoftが遵守を約束。
日本語
コピー
適切な制御機構がなければ、サイト運営者は長くジレンマを抱え続けてきた。自分のコンテンツを AI のトレーニングに使わせるか、検索での露出を失うリスクを取るか。このジレンマが生じるのは、インターネット上有数の大組織が兼用クローラーを使っているからだ。同じクローラーが検索と AI トレーニングの両方を担っている。片方を拒否すれば、もう片方も拒否することになる。Cloudflare は本日、新しい Disallow AI Training 設定を発表した。検索への掲載を維持したまま、同じクローラーによるコンテンツのトレーニング利用を簡単に拒否できる。Apple、Google、Microsoft はすでにこの設定に従っているか、(期限を定めて)従うことを約束している。兼用クローラーはトレーニング問題の中で最も難しい部分だ。次は AI Summaries である。サイト全体での一律の同意・拒否は粗すぎる。自分のコンテンツがどれだけ要約に現れるかは、現れるかどうかと同じくらい重要だ。AI 要約のオプトアウトは、兼用クローラー運営各社に対してすでに求めている要件の一つである。目標は、来年初めまでに、自分のコンテンツがどれだけ取り込まれるかを制御できるようにすることだ。Cloudflare で一度設定すれば、運営各社を個別に回る必要はない。
なぜ「お願い」だけでは足りないのか
ほとんどのサイト運営者は見つけられたいと考えている。人から、agent から、(良質な)bot から。だがオープンインターネットのかなりの部分は、広告、購読、あるいは訪問者との直接の関係によって支えられており、これらのモデルは実際に人が訪問して初めて収益を生む。ほぼすべてのサイト運営者が Search は有益だと考えている。Cloudflare 上のサイトで Search bot をブロックしているのは 1% 未満だ。トレーニングは別問題で、17% のサイトが何らかのトレーニングブロックを有効にしている。だからこそ、サイト運営者には一律の「Block AI」ではなく、より細かい制御が必要だと判断した。robots.txt の指令を一つ書けば済む話ではない。誰でも公開はできるが、誰が何のためにクロールしているかを識別できず、無視するクローラーを止められもしない。ネットワークならそれができる。こちらが選好を発信し、誰がクロールしているかを識別し、その目的を判定し、選好を無視するものはブロックする。そして各運営者の実際の挙動を Radar で報告する。ただしブロックはクローラーを一つ排除するだけで、クローラーの振る舞い方を変えるものではない。より良い結果は、運営者がそもそもこの選択をサイト運営者に迫らないことだ。そこで 7 月以降、各社と直接協議を続けてきた。反応は心強いものだった。ほぼ全社が、サイト運営者は自分のコンテンツがどう使われるかについて制御と透明性を持つべきであり、その選択が尊重されると確信できるべきだという点で一致している。サイト運営者がこれを把握できるよう、Accountable という呼称を設けた。Accountable は、現在すでに備わっている能力と、それを実現するための具体的な約束の両方を認定する。この呼称を得るには、bot 運営者が次の要件を満たすか、満たすことを約束しなければならない。
- サイト運営者が robots.txt または類似の標準を通じて AI トレーニングをオプトアウトできる仕組み。
- サイト運営者が運営者に直接申し立てられ、来年には Cloudflare 経由で AI 要約をオプトアウトできる仕組み(後述)。
- URL レベルの可視性。どのページがトレーニングに使われたか、コンテンツが検索でどう表示されているかの指標を確認できる。
- AI トレーニングのオプトアウトが従来の検索結果に影響しないことを保証する約束。
Apple、Google、Microsoft はいずれも Accountable の資格要件を満たすことを証明した。3 社とも、現時点で利用可能な能力と、開発中の能力に対する期限付きの約束を組み合わせている。3 社のクローラーの詳細は以下で述べる。
新しいセキュリティ設定オプション
Cloudflare は bot を挙動によって分類しており、同じ bot が複数の挙動を示すことがある。制御項目となる挙動は 3 つだ。
- Search——検索インデックスを構築するためのクロール。
- Training——モデルのトレーニングやファインチューニングのためのクロール。
- Agent——チャットクローラーやブラウザ操作 agent など、人間の代わりにページへアクセスするユーザー志向の agent。
兼用クローラーとは、Search と Training を同時に行う単一のクローラーだ。制御しなければ、この組み合わせが前述のトレードオフを生む。サイト運営者は一方だけを拒否できない。Accountable な兼用クローラー、つまりこのトレードオフをサイト運営者に押し付けないクローラーをブロックせずに済むよう、新しい設定 Disallow AI Training を導入する。名前は、robots.txt に発行する Disallow: 指令に由来する。
「Block」設定の意味が変わった
Block と「Block on pages with ads」はこれまで兼用クローラーには適用されなかった。ブロックすると検索での発見可能性にも影響しうるからだ。新しい Disallow AI Training 設定ができたことで、Block と「Block on pages with ads」は兼用クローラーを含むすべてのトレーニングクローラーに適用される。Training、Search、Agent の制御はドメイン単位で効く。Disallow AI Training を加えた、利用可能な設定は次のとおり。
- 許可:他の設定や WAF ルールで遮断されない限り、すべてのクローラーがアクセスできる。
- 禁止 AI 训练:Bot Preference Sync が該当するトレーニング拒否の選好を robots.txt に書き込む。Accountable な兼用クローラーは検索目的で引き続きアクセスできる。それ以外のトレーニングクローラーはすべてブロックする。Amazon、Anthropic、Meta、OpenAI が運営するトレーニング専用クローラーも含まれ、これらをブロックしても検索には影響しない。禁止 AI 训练 は Training の設定としてのみ提供され、Search や Agent には適用されない。
- 在含广告页面上拦截:広告を配信していると検出されたページに限り、兼用クローラーを含むクローラーをブロックする。
- 拦截:兼用クローラーを含むすべてのクローラーをブロックする。
AI トレーニングの禁止は robots.txt に設定を書き込むことで実現する。広告のみを対象にした設定はこの方法では表現できない。Cloudflare はどのページに広告が掲載されているかを検出できるが、そのリストは大きすぎ、変化も頻繁すぎて robots.txt に一つずつ書き込むことはできない。したがって「広告掲載ページでの AI トレーニングを禁止する」という選択肢は存在しない。Agent は混在用途のクローラーとは異なり、検索での可視性を犠牲にするトレードオフを生じさせない。また、Agent に対して禁止の意向を伝えるための命令標準は、インターネット上でまだ整備されていない。現時点では Agent 向けの禁止設定は提供しない。ai-prefs などの標準が成熟した段階で、この方針を再検討する。
9 月 15 日に何が変わるか
Bot Management と AI Crawl Control に以下の変更を加える。
- ブロックおよび広告掲載ページでのブロックが、Applebot、Bingbot、Googlebot を含む混在用途のクローラーにも適用されるようになる。つまりこの 2 つの設定は検索とトレーニングの両方に影響する。トレーニングだけを止め、検索は_維持_したい場合は、AI トレーニングの禁止を使う。
- 「Block AI Bots」は廃止し、より細かい Search、Training、Agent の各コントロールに移行する。
- Managed Robots.txt は廃止し、Bot Preference Sync に移行する。Managed Robots.txt を有効にしている顧客は新システムへ移行される。
- AI トレーニングの禁止が、一部の新規ドメインで推奨設定の一つとなる。
- 既存顧客の設定は、後述のとおり新しいコントロールへ移行される。
必要な対応
ほとんど何もする必要はない。既存の設定はそのまま引き継がれる。混在用途のクローラーを完全に排除したい場合は、今後は明示的な指定が必要になる。Block を選べばよい。Applebot、Bingbot、Googlebot のサイトへのアクセスを、検索も含めてブロックする。
Search/Training/Agent コントロールを一度も使ったことのない既存ドメイン
細かいコントロールを設定したことがないサイト所有者は、以前の Block AI Bots 設定に応じて新しい設定へ移行する。
| (旧)「Block AI」設定 | (新)Search 設定 | (新)Training 設定 | (新)Agent 設定 |
|---|---|---|---|
| 無効(未チェック) | Allow | Allow | Allow |
| Block | Allow | Disallow AI Training | Block on pages with ads |
| Block on pages with ads | Allow | Disallow AI Training | Block on pages with ads |
以前に Search/Training/Agent コントロールを設定したことのある既存ドメイン
細かいコントロールを以前に設定したドメインについては、新しい定義のもとでも選択の実効性を維持する。以前 Training で Block または Block on pages with ads を選んでいた場合は、Disallow AI Training へ移行する。
| コントロール | 旧設定 | 新設定 |
|---|---|---|
| Search | Allow | Allow |
| Block | Block | |
| Block on pages with ads | Block on pages with ads | |
| Training | Allow | Allow |
| Block | Disallow AI Training | |
| Block on pages with ads | Disallow AI Training | |
| Agent | Allow | Allow |
| Block | Block | |
| Block on pages with ads | Block on pages with ads |
新規ドメインへの推奨設定
9 月 15 日以降、新たにドメインを接続する顧客には、サイトが広告で収益を得ているかどうかに応じて 2 つのプリセットのいずれかが提供される。広告収入は、実際の人がページを見たかどうかにかかっている。Training はその訪問を 1 つの回答に置き換えてしまう。Agent がページを取得するとき、広告を見る人はそこにいない。そのため、広告で成り立つサイト向けのプリセットのほうが厳しくなっている。これらの設定は接続時でも、その後でも変更できる。
| 設定 | 広告で収益化していないサイト | 広告で収益化しているサイト |
|---|---|---|
| Preference Sync | 有効 | 有効 |
| Search | 許可 | 許可 |
| Training | 許可 | AI トレーニングを禁止 |
| Agent | 許可 | 広告掲載ページでブロック |
新規ドメインの推奨設定
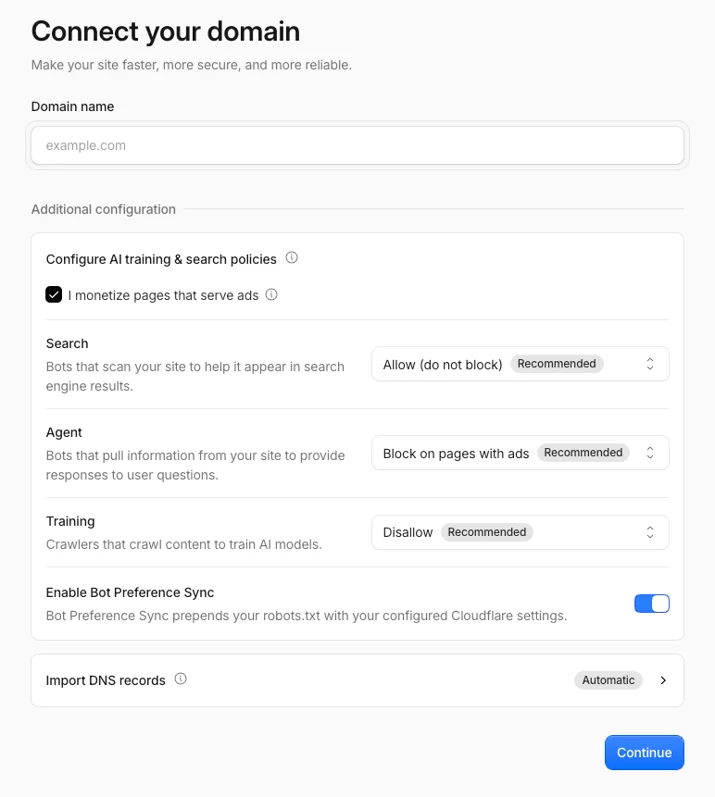
新規ドメインのオンボーディング画面のスクリーンショット。「広告掲載ページで収益化している」にチェックを入れた場合の推奨設定を示す。
特定の混合用途クローラーにとって、これは何を意味するのか
Applebot、Bingbot、Googlebot は Accountable に分類される。Apple、Google、Microsoft はいずれも同じ原則にコミットしている。すなわち、パブリッシャーが自分で選べること、プロセスが透明であることだ。「AI トレーニング禁止」の下でも、検索のためにサイトをクロールし続けることはできる。「ブロック」を選べばクロールは完全に止まる。
Amazon、Anthropic、Meta、OpenAI の関連クローラーも同様に Accountable に分類している。これらの企業は検索クローラーとトレーニングクローラーを分けているため、Cloudflare は検索に影響を与えずにトレーニングクローラーをブロックできる。
Applebot
サイト所有者は robots.txt で「Applebot-Extended」に Disallow ルールを追加すれば、トレーニングからオプトアウトできる。現在は、ページの HTML 内の nosnippet ディレクティブで AI 要約に関する選好を表明することもできる。コンテンツをペイウォールコンテンツとしてマークし、生成出力から除外することも可能だ。Applebot はまだ URL 単位の検査ツールを提供していない。ただし同社のチームと会議を持ち、来年リリース予定のソリューションの詳細を共有してもらった。Apple はまた、トレーニングの禁止が検索ランキングに影響しないと述べている。
Googlebot
サイト所有者は robots.txt で「Google-Extended」に Disallow ルールを追加すれば、トレーニングからオプトアウトできる。Google はウェブマスターポータルにもスイッチを用意しており、サイトのコンテンツを生成検索結果から除外できる。Googlebot はサイト所有者に対し、検索結果と AI 要約結果の指標とレポートも提供している。Google は既存および近日提供の制御手段、そして開発中の機能を共有した。たとえば Google-Extended に関するサイト所有者向けの URL 単位の透明性ツールの拡充で、数週間以内の提供を見込んでいる。Google もまた、Google-Extended の禁止が検索ランキングに影響しないと述べている。
Bingbot
Bingbot は Webmaster Tools で細かい制御と透明性を提供している。現在、サイト所有者は Bing の NOARCHIVE meta タグで AI トレーニングの選好を表明できる。Microsoft はこれらの機能を拡張中で、ドメイン/サイトレベルでも robots.txt の「トレーニング禁止」選好を尊重する仕組みを現在構築しており、2027 年初頭の提供を目標としている。Bing で今すぐトレーニングをオプトアウトしたい Cloudflare のお客様は、NOARCHIVE タグに加えて Block URLs or Content Removal toolも利用できる。Microsoft もまた、NOARCHIVE の使用が検索ランキングに影響しないと述べている。
この対応が提供されるまで、Disallow AI Training を選んでも robots.txt を通じて Bing にトレーニング禁止の選好が自動的に伝わることはない。これは以前の Training Block 設定の実際の挙動と同じで、Bingbot のような混合用途クローラーには適用されなかった。
進展は続く
こうした機能が進化するにつれ、私たちはすべての AI クローラー運営者に引き続き連絡を取り、働きかけていく。Cloudflare Radar は、Accountable なクローラー運営者が提供する制御、透明性、レポートを公開で追跡している。
インターネットをより良くするには、双方に主体性が必要だ。クローラーはオープンウェブへのアクセスを必要とし、そのウェブを生み出した人々は自分の作品がどう使われるかを意味のある形で制御できる必要がある。今回の発表は、そのバランスへ向けた確かな前進だ。
前進には、インフラプロバイダー、コンテンツ制作者、テック企業、そして Internet Engineering Task Force(IETF)のような標準化団体が協力し、これらの原則をオープンで相互運用可能な標準へと変えていくことが要る。
次のステップ:AI Summaries
トレーニングと AI Summaries は、サイト所有者に異なる問題を持ち込む。トレーニングは、コンテンツを AI モデルの構築に使えるかどうかに関わる。要約は、人が企業をどう見つけ、どう評価し、最終的にどう訪れるかに影響する。どちらも重要だが、企業への影響の仕方は違う。
AI 要約をオプトアウトする制御は第一歩だ。Accountable と認定された運営者は、その機能をすでに提供しているか、提供に向けた作業を進めている。これで重要なベースラインが確立される。サイト所有者が「ノー」と言えるということだ。
とはいえ、サイト全体で要約を一律に許可または禁止するのは、まだ粗いやり方だ。正しい判断はサイト、コンテンツ、そして事業目標によって変わる。パブリッシャーにとって、トレーニングは根本的な問題を突きつける。制御権、対価、そしてオリジナルコンテンツが存続できるかどうかだ。要約は別の、しばしばより切実な配信の問題を持ち込む。ユーザーはパブリッシャーのサイトを訪れるのか、それとも検索や AI 体験の中で答えを消費して終わるのか。他の多くの企業にとって、AI 要約は見込み客とサイトの間にますます立ちはだかっている。質問に答え、選択肢を比較し、製品を推薦し、あるいは訪問すべきかどうかを直接決めてしまうことさえある。
データが示す影響はまちまちだ。半数以上の消費者は Search で要約を読むが、そうした人々が要約を読んだ後に検索を終える可能性は40% 以上高い。これはサイトが得る訪問を減らす。しかし AI Search から流入した消費者は、従来の検索からの流入と比べてコンバージョン率が3 倍から5 倍以上だ。AI は訪問を減らすかもしれないが、送り込んでくる顧客の購買意図はずっと強い。
これ自体に良いも悪いもない。広告で収益化するパブリッシャーはオーディエンスの規模を求めるかもしれない。小売業者なら、数は少なくても購入してくれそうな訪問者のほうが欲しいだろう。Cloudflare の役割は彼らの代わりに選ぶことではなく、十分な情報を得たうえで判断するために必要な可視性とコントロールを提供することだ。
要約のオプトアウトは有力な出発点ではあるが、終着点ではない。今後は、要約が自社のビジネスにどう影響するかをサイト所有者が理解できるようにし、自分のコンテンツをどこまで使わせるかをもっと自分で決められるようにすることに注力する。ai-prefs のようなオープン標準が、そのカギとなる一环だ。
この議論に声を上げたい人、フィードバックを送りたい人は crawlercontrols@cloudflare.com まで連絡してほしい。
これらの新しいコントロールはすべての顧客、すべてのプランで利用でき、ドメイン(ゾーン)のセキュリティ設定で構成できる。